Przykład: co poprawić w hotelu najpierw?
Fikcyjna sieć hoteli miejskich po każdym pobycie wysyła gościom krótką ankietę. Gość ocenia pobyt ogólnie i osiem aspektów: czystość pokoju, wygodę łóżka, obsługę recepcji, szybkość zameldowania, śniadanie, Wi-Fi, lokalizację i stosunek ceny do jakości. Wszystkie oceny są na skali 1–10. Ankietę wypełniło 600 gości. Średnia ocena ogólna to 7.56 (SD = 1.56).
Dyrekcja ma budżet na dwie inwestycje i pyta: który aspekt najbardziej wpływa na ocenę ogólną i gdzie wypadamy najsłabiej? Pytanie „co jest dla Ciebie ważne?” zwykle nic nie daje – gość zaznacza „ważne” przy wszystkim. Dlatego ważność wylicza się z danych: sprawdza się, jak ocena aspektu wiąże się z oceną ogólną. To tak zwana analiza kluczowych czynników (ang. key driver analysis). Rysunek 1 pokazuje całą procedurę.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy korelacje aspektów (ogólnie .35, para czystość–łóżko .60, para recepcja–zameldowanie .80), wagi aspektów w ocenie ogólnej, średnie ocen i to, że aspekty wyjaśniają 55% zmienności oceny ogólnej przed zaokrągleniem do skali 1–10. Parametry dobraliśmy przed losowaniem tak, żeby jedna para aspektów była silnie współliniowa, a obsługa recepcji i śniadanie leżały blisko linii podziału macierzy. Ziarno 623 ustaliliśmy raz i nie zmienialiśmy go. Wszystkie parametry są w przepisie 2 kodu. Dane pobierzesz jako kluczowe-czynniki-satysfakcji-ankieta-hotel.csv.
Rysunek 1: analiza w czterech krokach
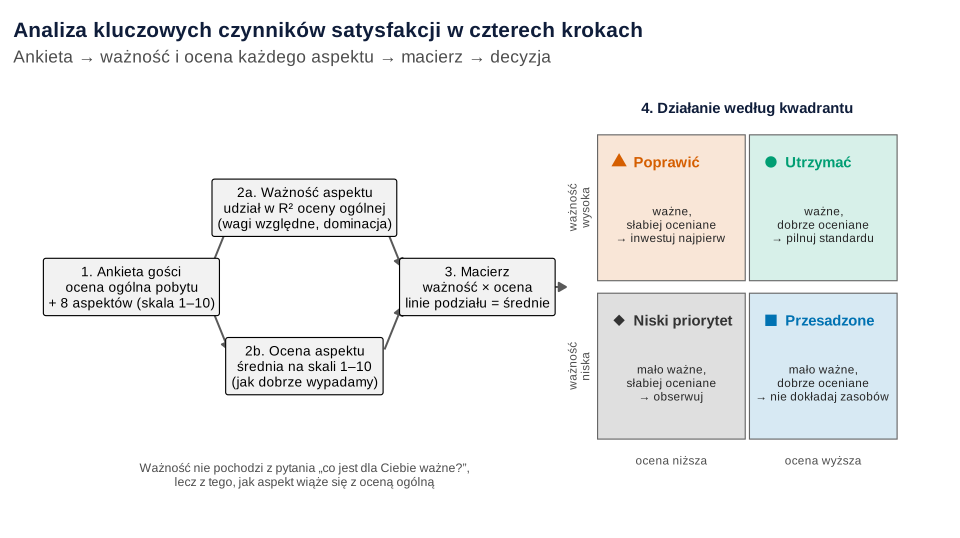
Co widać. Każdy aspekt dostaje dwie liczby. Ważność mówi, ile zmienności oceny ogólnej przypada na ten aspekt. Ocena to jego średnia. Na tych dwóch osiach powstaje macierz, którą Martilla i James (1977) opisali jako prostą technikę planowania działań marketingowych (analiza ważność–wykonanie). Wersję tej mapy dla modeli PLS-SEM opisuje hasło IPMA.
Jak może zmylić. Ważność z danych to związek, a nie dowód, że poprawa aspektu podniesie ocenę ogólną (zob. korelacja a przyczynowość). Azzopardi i Nash (2013) zebrali problemy koncepcyjne i pomiarowe tej metody w badaniach turystyki i hotelarstwa – warto je znać przed obroną.
Zdanie do Metody:
Rysunek 2: korelacje, czyli wszystko wiąże się ze wszystkim
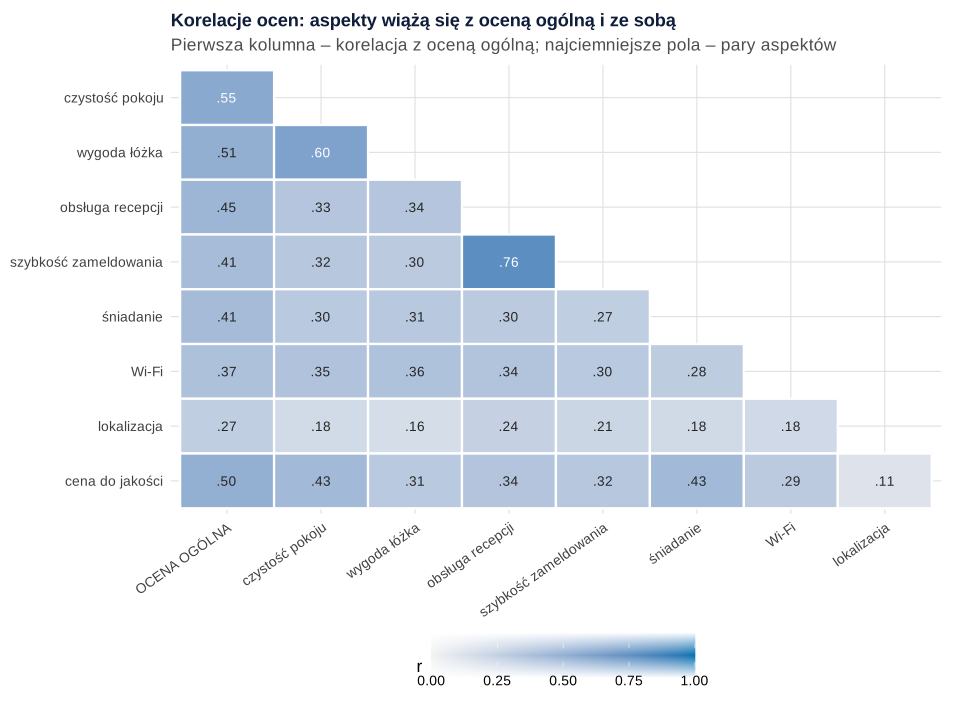
set.seed(623)).Co widać. Ocena ogólna najsilniej wiąże się z czystością pokoju (r = .55), wygodą łóżka (.51) i ceną do jakości (.50), najsłabiej z lokalizacją (.27). Aspekty korelują też ze sobą (.11–.76). Gość zadowolony z pobytu ocenia wyżej prawie wszystko – to częściowo efekt halo. Najsilniej powiązana para to obsługa recepcji i szybkość zameldowania (r = .76).
Jak może zmylić. Ranking według samych korelacji liczy każdy aspekt tak, jakby był jedyny. Szybkość zameldowania ma r = .41 głównie dlatego, że idzie w parze z obsługą recepcji. Druga pułapka to sufit skali: lokalizacji 33.8% gości dało 10, recepcji 29.7%. Przy takim efekcie sufitu korelacje są niższe, niż byłyby na dłuższej skali.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: regresja, wagi względne i analiza dominacji
Następny krok to regresja wieloraka oceny ogólnej na osiem aspektów. Model wyjaśnia R² = .497 zmienności oceny ogólnej (zob. współczynnik determinacji). Kusi, żeby uszeregować aspekty według współczynników β. Kłopot w tym, że β mierzy tylko wkład aspektu przy stałych pozostałych. Część wspólna dwóch powiązanych aspektów nie trafia do żadnego z nich – to skutek współliniowości. Najwyższy VIF mają recepcja (2.57) i zameldowanie (2.43). To niewiele, a mimo to ranking β wyraźnie się zmienia.
Dlatego stosuje się miary, które dzielą całe R² między predyktory. Analiza dominacji (Budescu, 1993) dopasowuje wszystkie modele z podzbiorami aspektów – przy ośmiu aspektach to 255 regresji. Dla każdego aspektu liczy średni przyrost R² po dodaniu go do modelu. Wagi względne Johnsona (2000) dają prawie te same liczby szybciej. Zastępują aspekty ich nieskorelowanymi odpowiednikami (z rozkładu własnego macierzy korelacji), a wyjaśnioną wariancję rozdzielają z powrotem na aspekty. W obu metodach udziały sumują się do R². Johnson i LeBreton (2004) uznali je za najlepsze dostępne miary ważności względnej. Obie liczymy w bazowym R, bez dodatkowych pakietów. Szczegóły na przykładzie z trzema predyktorami opisuje wpis trafność przyrostowa nowej skali.
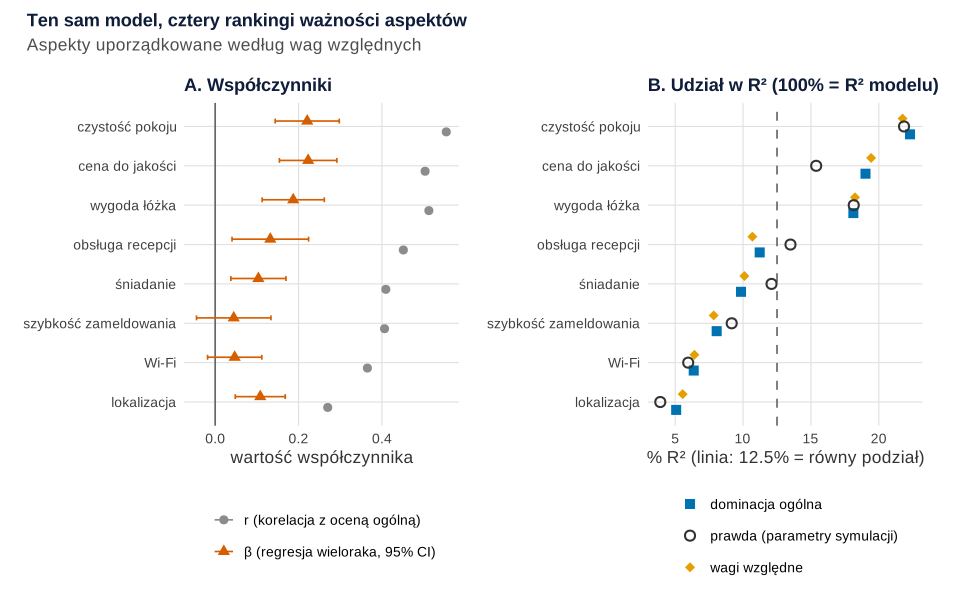
Co widać. Wagi względne i dominacja dają ten sam ranking, a ich wartości różnią się o najwyżej 0.6 punktu procentowego. Na czystość pokoju przypada 21.7% wyjaśnionej wariancji, na cenę do jakości 19.4%, na wygodę łóżka 18.2%. Najmniej waży lokalizacja (5.6%). Regresja daje inny obraz. Szybkość zameldowania spada na ostatnie miejsce (β = 0.045, 95% CI [−0.045, 0.134]), bo jej wspólną część z recepcją model „oddał” recepcji. Lokalizacja awansuje z ósmego na piąte miejsce (β = 0.108). Jest słabo związana z innymi aspektami, więc nie dzieli z nimi wariancji. Wagi względne zostawiają zameldowaniu 7.8%, bo coś z oceną ogólną jednak łączy.
Jak może zmylić. Wagi względne dzielą wspólną wariancję umownie – nie mówią, który z dwóch powiązanych aspektów „naprawdę” działa. W danych ukryliśmy dla zameldowania prawie zerowy wpływ, a jego prawdziwy udział i tak wynosi 9.2%, bo dzieli wariancję z recepcją. Kraha i in. (2012) radzą przy współliniowych predyktorach patrzeć na kilka wskaźników naraz. Co robić z wysokim VIF, opisuje wpis wysoki VIF – co zrobić.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: macierz ważność–ocena
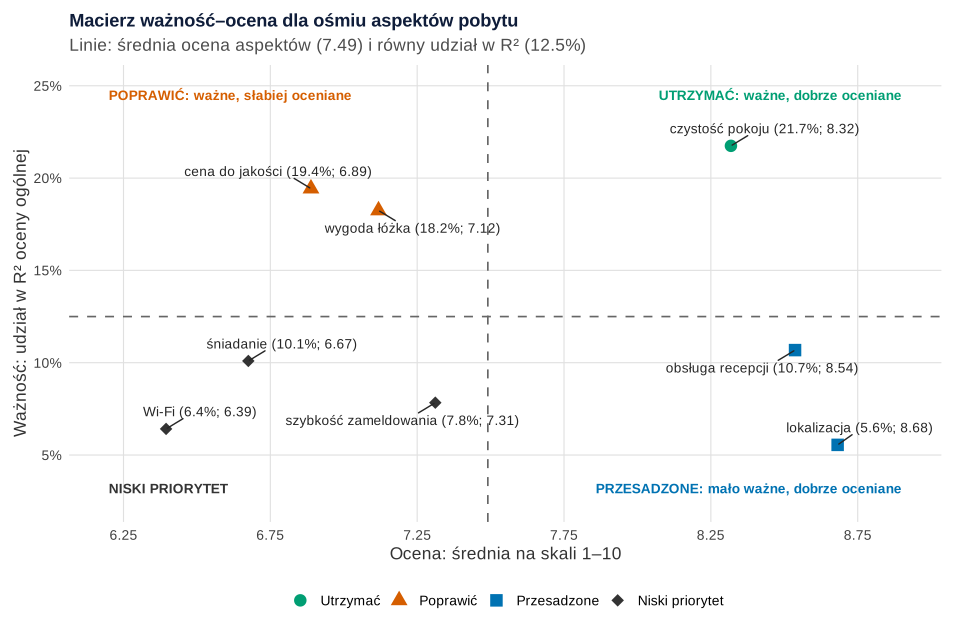
Co widać. Ważność to wagi względne z rysunku 3, ocena to średnia aspektu. Linie dzielą macierz na średniej ocenie aspektów (7.49) i na równym udziale w R² (100% / 8 = 12.5%). Poprawić wypada cenę do jakości (6.89) i wygodę łóżka (7.12). Oba aspekty są ważne i oceniane poniżej średniej. Utrzymać trzeba czystość (8.32). Obsługa recepcji i lokalizacja trafiły do kwadrantu przesadzone: oceny wysokie, udział w ocenie ogólnej mniejszy. Śniadanie, zameldowanie i Wi-Fi to niski priorytet.
Jak może zmylić. Położenie linii to decyzja analityka. Zamiast średnich można wziąć środek skali (5.5) albo medianę, a kwadranty się zmienią – zapisz wybór przed analizą. Punkty blisko linii nie należą wyraźnie do żadnego kwadrantu. Recepcja (10.7%) leży tuż pod linią, a w danych ukryliśmy dla niej 13.5%, czyli kwadrant „utrzymać”. „Przesadzone” nie znaczy też „do cięcia”: wysoka ocena recepcji może być warunkiem, bez którego goście ocenialiby pobyt gorzej.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: jak pewny jest ranking?
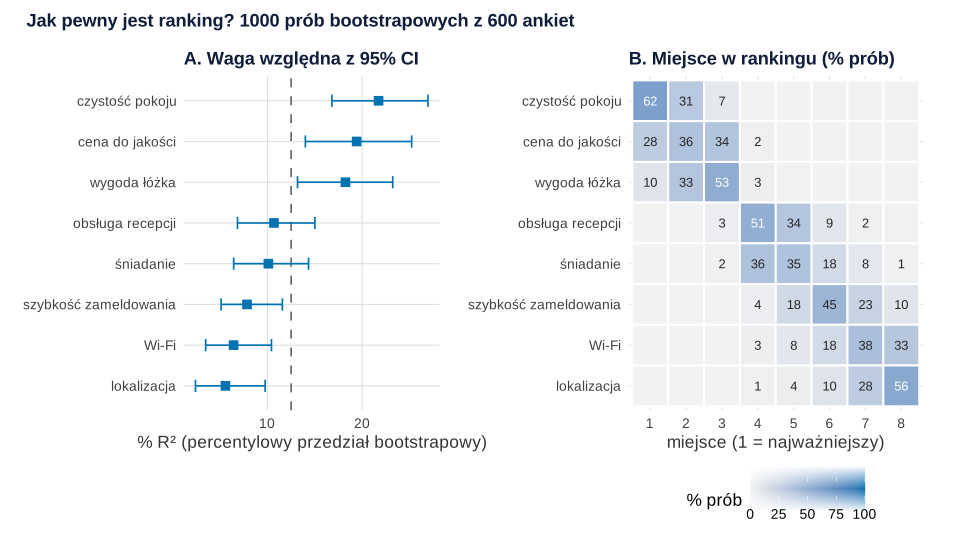
set.seed(623)).Co widać. Wylosowaliśmy ze zwracaniem 1000 prób po 600 gości (bootstrap) i w każdej policzyliśmy wagi względne od nowa. Trzy najważniejsze aspekty są dość pewne jako grupa: cena do jakości była w pierwszej trójce w 97.9% prób, łóżko w 96.6%, czystość zawsze. Kolejność w tej trójce jest już niepewna. Czystość była pierwsza w 62.1% prób, cena do jakości w 27.9%, łóżko w 10.0%. Cena do jakości trafiała do kwadrantu „poprawić” w 99.3% prób, łóżko w 98.4%. Obsługa recepcji była „przesadzona” w 80.9%, a „do utrzymania” w 19.1% prób. Śniadanie wpadało do kwadrantu „poprawić” w 12.4% prób. Błąd Monte Carlo tych odsetków nie przekracza 1.6 punktu procentowego.
Jak może zmylić. Bootstrap mierzy zmienność wokół wyniku tej próby, a nie wokół prawdy. Przedziały recepcji i śniadania przecinają linię 12.5% – oba aspekty opisz jako graniczne. Azen i Budescu (2003) używali bootstrapu właśnie do oceny, jak stabilne są wyniki analizy dominacji. O tym, jak niepewne jest pojedyncze badanie, mówi dopiero rysunek 6.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: 1000 ankiet z tej samej populacji
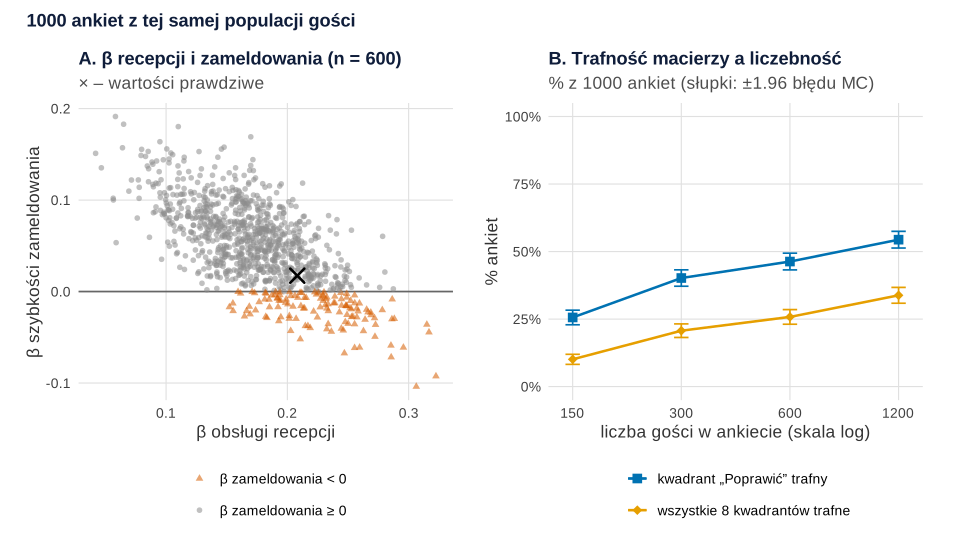
set.seed(623)).Co widać. Ta sama sieć hoteli robi ankietę 1000 razy, za każdym razem z innymi gośćmi. Panel A: przy 600 gościach oszacowania β recepcji i zameldowania są ujemnie skorelowane (−.675). Gdy jedno rośnie, drugie maleje, bo model nie umie rozdzielić wspólnej części. β zameldowania wychodzi ujemne w 12.7% ankiet, a przy 150 gościach w 30.9%. „Szybsze zameldowanie obniża satysfakcję” to wtedy artefakt współliniowości, nie odkrycie. Waga względna zameldowania nigdy nie spadła poniżej 5.3%. Panel B: kwadrant „poprawić” jest trafny (dokładnie cena i łóżko) w 46.3% ankiet po 600 gości i w 54.4% po 1200. Pełna macierz jest trafna w 25.8% i 33.8% ankiet.
Jak może zmylić. Niska trafność to skutek naszego wyboru – dwa aspekty leżą tuż przy linii (prawdziwe udziały 13.5% i 12.1%). Kwadrant takiego aspektu to prawie rzut monetą: recepcja trafiała do właściwego kwadrantu w 55.2% ankiet po 600 gości. Aspekty daleko od linii (czystość, lokalizacja, Wi-Fi) były klasyfikowane stabilnie. Wniosek: ufaj podziałowi na grupy aspektów, a nie dokładnym miejscom w rankingu.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- Cena do jakości i wygoda łóżka – pierwsze inwestycje: wymiana materacy i poduszek, a po stronie ceny pakiety ze śniadaniem lub późnym wymeldowaniem zamiast obniżki.
- Czystość pokoju – nie obniżaj standardu sprzątania; to najważniejszy aspekt, a ocena jest dobra.
- Obsługa recepcji – aspekt graniczny. Nie tnij zatrudnienia na podstawie jednej ankiety; sprawdź go w kolejnej fali.
- Wi-Fi i śniadanie – „niski priorytet” w modelu liniowym może ukrywać cechę oczywistą: słabe Wi-Fi może mocno obniżać ocenę, a dobre wcale jej nie podnosić. Taką asymetrię wykrywa model Kano.
- Efekt inwestycji sprawdź eksperymentem albo porównaniem przed i po – macierz pokazuje związki, a nie skutki zmian. Zmianę satysfakcji między falami ocenia też NPS z przedziałem ufności.
Jeśli aspekty mierzysz kilkoma pytaniami i chcesz modelu ze ścieżkami do lojalności, zajrzyj do wpisu model satysfakcji i lojalności w PLS-SEM. Inne metody z tej serii zbiera wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie podaj skale, model, metodę podziału R², sposób wyznaczenia linii macierzy i liczbę prób bootstrapowych. Oceny 1–10 traktujesz jak zmienne ilościowe – napisz to wprost (zob. czy skala Likerta jest ilościowa). W tabeli podaj dla każdego aspektu: M, SD, r z oceną ogólną, β z 95% CI, wagę względną z 95% CI i kwadrant.
W Ograniczeniach napisz, że ważność wyliczona z danych przekrojowych opisuje związek, a nie skutek zmiany, i że aspekty z przedziałem przecinającym linię są graniczne. Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Kod R: wagi względne, dominacja i macierz w bazowym R
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę i motyw, przepis 2 – dane, a kolejne korzystają z ich obiektów. Wagi względne liczy funkcja wagi_wzgledne() (rozkład własny macierzy korelacji, eigen()), a dominację – funkcja dominacja() (R² wszystkich 255 podzbiorów z macierzy korelacji). Pakiety relaimpo i dominanceanalysis liczą to samo dla większych zadań. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 2 (dane), 5 (bootstrap) i 6 (symulacja); każdy zaczyna się od własnego set.seed(623). Etykiety na rysunku 4 rozsuwa ggrepel z seed = 623. Ziarno 623 ustalono raz i nie zmieniano go. Ręcznie ustalono: 600 gości, korelacje aspektów (.35; .60; .80; .45; .20), wagi aspektów w ocenie ogólnej (.28, .22, .24, .02, .16, .04, .08, .20), średnie ocen (6.4–8.9), odchylenie 1.5 dla aspektów i 1.6 dla oceny ogólnej, 55% wyjaśnionej zmienności przed zaokrągleniem, 1000 prób bootstrapowych i 1000 ankiet dla każdej z liczebności 150, 300, 600 i 1200. Całość liczy się w kilka sekund.
1. Paleta, motyw i schemat: Rysunek 1
R
# Rysunek 1. Od ankiety gości hotelu do decyzji: schemat analizy kluczowych czynników (grafika, bez danych)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw, z których korzystają kolejne przepisy
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         blekit = "#56B4E9", fiolet = "#CC79A7", szary = "grey55", ciemny = "grey20")
kwadranty <- c("Utrzymać" = "#009E73", "Poprawić" = "#D55E00", "Przesadzone" = "#0072B2", "Niski priorytet" = "#333333")
ksztalty <- c("Utrzymać" = 16, "Poprawić" = 17, "Przesadzone" = 15, "Niski priorytet" = 18)
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

kroki <- data.frame(
  x = c(1, 3.05, 3.05, 5.1),
  y = c(3.2, 4.15, 2.25, 3.2),
  etykieta = c("1. Ankieta gości\nocena ogólna pobytu\n+ 8 aspektów (skala 1–10)",
               "2a. Ważność aspektu\nudział w R² oceny ogólnej\n(wagi względne, dominacja)",
               "2b. Ocena aspektu\nśrednia na skali 1–10\n(jak dobrze wypadamy)",
               "3. Macierz\nważność × ocena\nlinie podziału = średnie"))
dzialania <- data.frame(
  x = c(7.4, 9.2, 7.4, 9.2), y = c(4.15, 4.15, 2.25, 2.25),
  kwadrant = c("Poprawić", "Utrzymać", "Niski priorytet", "Przesadzone"),
  opis = c("ważne,\nsłabiej oceniane\n→ inwestuj najpierw", "ważne,\ndobrze oceniane\n→ pilnuj standardu",
           "mało ważne,\nsłabiej oceniane\n→ obserwuj", "mało ważne,\ndobrze oceniane\n→ nie dokładaj zasobów"))
strzalki <- data.frame(x = c(1.95, 1.95, 4.0, 4.0), xend = c(2.15, 2.15, 4.2, 4.2),
                       y = c(3.45, 2.95, 3.95, 2.45), yend = c(3.95, 2.45, 3.45, 2.95))
p1 <- ggplot() +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = yend), colour = "grey35", linewidth = 0.7,
               arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  annotate("segment", x = 6.0, xend = 6.15, y = 3.2, yend = 3.2, colour = "grey35", linewidth = 0.7,
           arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  geom_label(data = kroki, aes(x, y, label = etykieta), size = 3.6, fill = "grey95", linewidth = 0.4,
             label.padding = unit(0.5, "lines"), lineheight = 0.95) +
  geom_tile(data = dzialania, aes(x, y, fill = kwadrant), width = 1.75, height = 1.75, alpha = 0.16,
            colour = "grey40", linewidth = 0.4) +
  geom_point(data = dzialania, aes(x - 0.62, y + 0.55, colour = kwadrant, shape = kwadrant), size = 3.6) +
  geom_text(data = dzialania, aes(x - 0.45, y + 0.55, label = kwadrant, colour = kwadrant), hjust = 0,
            fontface = "bold", size = 3.9) +
  geom_text(data = dzialania, aes(x, y - 0.2, label = opis), size = 3.1, lineheight = 0.95, colour = "grey15") +
  annotate("text", x = 8.3, y = 5.35, label = "4. Działanie według kwadrantu", fontface = "bold", size = 3.9,
           colour = "#0f1d3a") +
  annotate("text", x = 6.3, y = c(4.15, 2.25), label = c("ważność\nwysoka", "ważność\nniska"), angle = 90,
           size = 3.1, colour = "grey30", lineheight = 0.9) +
  annotate("text", x = c(7.4, 9.2), y = 1.12, label = c("ocena niższa", "ocena wyższa"), size = 3.1,
           colour = "grey30") +
  annotate("text", x = 3.05, y = 0.95, size = 3.25, colour = "grey30", lineheight = 0.95,
           label = "Ważność nie pochodzi z pytania „co jest dla Ciebie ważne?”,\nlecz z tego, jak aspekt wiąże się z oceną ogólną") +
  scale_fill_manual(values = kwadranty, guide = "none") + scale_colour_manual(values = kwadranty, guide = "none") +
  scale_shape_manual(values = ksztalty, guide = "none") +
  scale_x_continuous(limits = c(0.1, 10.1)) + scale_y_continuous(limits = c(0.6, 5.6)) +
  labs(title = "Analiza kluczowych czynników satysfakcji w czterech krokach",
       subtitle = "Ankieta → ważność i ocena każdego aspektu → macierz → decyzja") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p1   # zapis: ggsave("kluczowe-czynniki-satysfakcji-schemat.svg", p1, width = 10, height = 5.6)
2. Dane i korelacje: Rysunek 2
R
# Rysunek 2. Fikcyjna ankieta 600 gości sieci hoteli miejskich: oceny 1–10 i korelacje (dane symulowane)
library(ggplot2)

aspekty <- c(czystosc = "czystość pokoju", lozko = "wygoda łóżka", recepcja = "obsługa recepcji",
             zameldowanie = "szybkość zameldowania", sniadanie = "śniadanie", wifi = "Wi-Fi",
             lokalizacja = "lokalizacja", cena_jakosc = "cena do jakości")
k <- names(aspekty)
# Parametry ustalone ręcznie: korelacje aspektów (ogólne .35; pary pokój .60 i obsługa .80; cena z czystością
# i śniadaniem .45; lokalizacja z resztą .20), wagi aspektów w ocenie ogólnej i średnie ocen
R <- matrix(.35, 8, 8, dimnames = list(k, k)); diag(R) <- 1
R["czystosc", "lozko"] <- R["lozko", "czystosc"] <- .60
R["recepcja", "zameldowanie"] <- R["zameldowanie", "recepcja"] <- .80
R["cena_jakosc", c("czystosc", "sniadanie")] <- R[c("czystosc", "sniadanie"), "cena_jakosc"] <- .45
R["lokalizacja", -7] <- R[-7, "lokalizacja"] <- .20
b <- c(czystosc = .28, lozko = .22, recepcja = .24, zameldowanie = .02, sniadanie = .16, wifi = .04,
       lokalizacja = .08, cena_jakosc = .20)
sr <- c(czystosc = 8.4, lozko = 7.1, recepcja = 8.7, zameldowanie = 7.3, sniadanie = 6.6, wifi = 6.4,
        lokalizacja = 8.9, cena_jakosc = 6.8)
R2_lat <- .55                                   # część oceny ogólnej wyjaśniana przez aspekty (przed zaokrągleniem)
s_e <- sqrt(drop(t(b) %*% R %*% b) * (1 / R2_lat - 1))
na_skale <- function(z, m, s) pmin(10, pmax(1, round(m + s * z)))   # zaokrąglenie do skali 1–10
losuj_ankiete <- function(n) {
  Z <- matrix(rnorm(n * 8), n, 8) %*% chol(R)
  y <- drop(Z %*% b) + rnorm(n, 0, s_e)
  X <- sapply(1:8, function(j) na_skale(Z[, j], sr[j], 1.5)); colnames(X) <- k
  data.frame(ogolna = na_skale(y / sd(y), 7.6, 1.6), X)
}

set.seed(623)                                   # ziarno ustalone raz, bez dobierania pod wynik
hotel <- losuj_ankiete(600)
write.csv(data.frame(id = 1:600, hotel), "kluczowe-czynniki-satysfakcji-ankieta-hotel.csv", row.names = FALSE)

round(sapply(hotel, function(x) c(M = mean(x), SD = sd(x), proc_10 = 100 * mean(x == 10))), 2)
C <- cor(hotel)
round(C, 2)
range(C[k, k][upper.tri(C[k, k])])                 # najsłabsza i najsilniejsza korelacja aspektów

kor <- expand.grid(w = colnames(C), k = colnames(C), stringsAsFactors = FALSE)
kor$r <- C[cbind(kor$w, kor$k)]
etyk <- c(ogolna = "OCENA OGÓLNA", aspekty)
kor$w <- factor(etyk[kor$w], rev(etyk)); kor$k <- factor(etyk[kor$k], etyk)
kor <- kor[as.integer(kor$w) <= length(etyk) + 1 - as.integer(kor$k), ]     # dolny trójkąt z przekątną
kor <- kor[as.character(kor$w) != as.character(kor$k), ]
p2 <- ggplot(kor, aes(k, w, fill = r)) +
  geom_tile(colour = "white", linewidth = 0.8) +
  geom_text(aes(label = sub("^0\\.", ".", sprintf("%.2f", r)), colour = r > .55), size = 3.6) +
  scale_fill_gradient(low = "#F2F2F2", high = kol[["niebieski"]], limits = c(0, 1), name = "r") +
  scale_colour_manual(values = c("TRUE" = "white", "FALSE" = "grey15"), guide = "none") +
  labs(title = "Korelacje ocen: aspekty wiążą się z oceną ogólną i ze sobą",
       subtitle = "Pierwsza kolumna – korelacja z oceną ogólną; najciemniejsze pola – pary aspektów", x = NULL, y = NULL) +
  motyw + theme(axis.text.x = element_text(angle = 35, hjust = 1), panel.grid = element_blank(),
                legend.key.width = unit(1.4, "cm"))
p2   # zapis: ggsave("kluczowe-czynniki-satysfakcji-korelacje.svg", p2, width = 10, height = 7.4)
Wynik w R
        ogolna czystosc lozko recepcja zameldowanie sniadanie wifi lokalizacja
M         7.56     8.32  7.12     8.54         7.31      6.68 6.40        8.68
SD        1.56     1.38  1.48     1.33         1.49      1.46 1.53        1.24
proc_10  13.33    23.83  6.50    29.67         7.17      1.50 2.17       33.83
        cena_jakosc
M              6.89
SD             1.48
proc_10        3.83
             ogolna czystosc lozko recepcja zameldowanie sniadanie wifi
ogolna         1.00     0.55  0.51     0.45         0.41      0.41 0.37
czystosc       0.55     1.00  0.60     0.33         0.32      0.30 0.35
lozko          0.51     0.60  1.00     0.34         0.30      0.31 0.36
recepcja       0.45     0.33  0.34     1.00         0.76      0.30 0.34
zameldowanie   0.41     0.32  0.30     0.76         1.00      0.27 0.30
sniadanie      0.41     0.30  0.31     0.30         0.27      1.00 0.28
wifi           0.37     0.35  0.36     0.34         0.30      0.28 1.00
lokalizacja    0.27     0.18  0.16     0.24         0.21      0.18 0.18
cena_jakosc    0.50     0.43  0.31     0.34         0.32      0.43 0.29
             lokalizacja cena_jakosc
ogolna              0.27        0.50
czystosc            0.18        0.43
lozko               0.16        0.31
recepcja            0.24        0.34
zameldowanie        0.21        0.32
sniadanie           0.18        0.43
wifi                0.18        0.29
lokalizacja         1.00        0.11
cena_jakosc         0.11        1.00
[1] 0.1083419 0.7621918
3. Regresja, wagi względne i analiza dominacji: Rysunek 3
R
# Rysunek 3. Cztery odpowiedzi na pytanie „co jest najważniejsze?”: r, β, wagi względne i dominacja
library(ggplot2)
library(patchwork)

# Regresja wieloraka na zmiennych standaryzowanych: β z 95% CI i VIF
model <- lm(scale(ogolna) ~ ., data = as.data.frame(scale(hotel)))
beta <- cbind(beta = coef(model)[-1], confint(model)[-1, ]); rownames(beta) <- k
summary(model)$r.squared
vif <- diag(solve(cor(hotel[k])))
round(cbind(r = cor(hotel)[k, "ogolna"], beta, VIF = vif), 3)

# Wagi względne Johnsona (2000): nieskorelowane zmienne najbliższe oryginałom z rozkładu własnego macierzy korelacji
wagi_wzgledne <- function(Rxx, rxy) {
  e <- eigen(Rxx, symmetric = TRUE)
  L <- e$vectors %*% diag(sqrt(e$values)) %*% t(e$vectors)   # korelacje predyktorów z ich wersjami nieskorelowanymi
  setNames(drop(L^2 %*% solve(L, rxy)^2), names(rxy))        # suma wag = R² modelu
}
# Analiza dominacji (Budescu, 1993): R² wszystkich 255 modeli z podzbiorami 8 aspektów
dominacja <- function(Rxx, rxy) {
  p <- length(rxy)
  R2 <- function(s) if (!length(s)) 0 else drop(rxy[s] %*% solve(Rxx[s, s, drop = FALSE], rxy[s]))
  podzb <- lapply(0:(2^p - 1), function(m) which(bitwAnd(m, 2^(0:(p - 1))) > 0))
  r2 <- vapply(podzb, R2, numeric(1))
  ogolna <- numeric(p)
  for (j in 1:p) {
    bez <- which(!vapply(podzb, function(s) j %in% s, logical(1)))      # podzbiory bez aspektu j
    przyrost <- r2[bez + 2^(j - 1)] - r2[bez]                            # dodanie j do każdego z nich
    rozm <- lengths(podzb[bez])
    ogolna[j] <- mean(tapply(przyrost, rozm, mean))                     # średnia po wielkościach podzbiorów
  }
  list(ogolna = setNames(ogolna, names(rxy)), liczba_modeli = length(podzb) - 1)
}
rxy <- cor(hotel)[k, "ogolna"]; Rxx <- cor(hotel[k])
rw <- wagi_wzgledne(Rxx, rxy)
da <- dominacja(Rxx, rxy)
da$liczba_modeli
c(suma_wag = sum(rw), suma_dominacji = sum(da$ogolna))

# „Prawda”: te same miary policzone z parametrów, z których losowano dane (skala ciągła, przed zaokrągleniem)
rxy_pop <- drop(R %*% b) / sqrt(drop(t(b) %*% R %*% b) + s_e^2)
rw_pop <- wagi_wzgledne(R, rxy_pop)
tab <- data.frame(aspekt = aspekty, r = rxy, beta = beta[, "beta"], rw_proc = 100 * rw / sum(rw),
                  da_proc = 100 * da$ogolna / sum(da$ogolna), prawda_proc = 100 * rw_pop / sum(rw_pop))
tab$ranga_r <- rank(-tab$r); tab$ranga_beta <- rank(-tab$beta); tab$ranga_rw <- rank(-tab$rw_proc)
tab$ranga_da <- rank(-tab$da_proc); tab$ranga_prawda <- rank(-tab$prawda_proc)
print(tab[order(-tab$rw_proc), -1], digits = 3)

kolejnosc <- aspekty[order(tab$rw_proc)]
d_a <- rbind(data.frame(aspekt = aspekty, miara = "r (korelacja z oceną ogólną)", w = tab$r, lo = NA, hi = NA),
             data.frame(aspekt = aspekty, miara = "β (regresja wieloraka, 95% CI)", w = beta[, 1], lo = beta[, 2], hi = beta[, 3]))
d_b <- rbind(data.frame(aspekt = aspekty, miara = "wagi względne", w = tab$rw_proc),
             data.frame(aspekt = aspekty, miara = "dominacja ogólna", w = tab$da_proc),
             data.frame(aspekt = aspekty, miara = "prawda (parametry symulacji)", w = tab$prawda_proc))
d_a$aspekt <- factor(d_a$aspekt, kolejnosc); d_b$aspekt <- factor(d_b$aspekt, kolejnosc)
pa <- ggplot(d_a, aes(w, aspekt, colour = miara, shape = miara)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = 0.25, orientation = "y", na.rm = TRUE,
                position = position_dodge(width = 0.55)) +
  geom_point(size = 2.8, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(title = "A. Współczynniki", x = "wartość współczynnika", y = NULL) + motyw
pb <- ggplot(d_b, aes(w, aspekt, colour = miara, shape = miara)) +
  geom_vline(xintercept = 12.5, linetype = "dashed", colour = "grey40") +
  geom_point(size = 2.8, position = position_dodge(width = 0.6), stroke = 1.1) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["ciemny"]], kol[["pomarancz"]]), name = NULL) +
  scale_shape_manual(values = c(15, 1, 18), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(title = "B. Udział w R² (100% = R² modelu)", x = "% R² (linia: 12.5% = równy podział)",
       y = NULL) + motyw + theme(axis.text.y = element_blank())
p3 <- pa + pb + plot_annotation(title = "Ten sam model, cztery rankingi ważności aspektów",
                                subtitle = "Aspekty uporządkowane według wag względnych", theme = motyw)
p3   # zapis: ggsave("kluczowe-czynniki-satysfakcji-rankingi.svg", p3, width = 10, height = 6.4)
Wynik w R
[1] 0.4971779
                 r  beta  2.5 % 97.5 %   VIF
czystosc     0.554 0.221  0.144  0.298 1.801
lozko        0.513 0.187  0.113  0.262 1.694
recepcja     0.451 0.132  0.040  0.224 2.571
zameldowanie 0.406 0.045 -0.045  0.134 2.428
sniadanie    0.409 0.104  0.038  0.170 1.331
wifi         0.365 0.047 -0.018  0.112 1.291
lokalizacja  0.270 0.108  0.048  0.168 1.094
cena_jakosc  0.504 0.223  0.154  0.292 1.448
[1] 255
      suma_wag suma_dominacji
     0.4971779      0.4971779
                 r   beta rw_proc da_proc prawda_proc ranga_r ranga_beta
czystosc     0.554 0.2208   21.75   22.30       21.85       1          2
cena_jakosc  0.504 0.2230   19.43   19.02       15.39       3          1
lozko        0.513 0.1872   18.24   18.12       18.15       2          3
recepcja     0.451 0.1322   10.68   11.22       13.49       4          4
sniadanie    0.409 0.1037   10.10    9.85       12.10       5          6
zameldowanie 0.406 0.0445    7.84    8.06        9.16       6          8
wifi         0.365 0.0468    6.41    6.37        5.96       7          7
lokalizacja  0.270 0.1081    5.55    5.07        3.90       8          5
             ranga_rw ranga_da ranga_prawda
czystosc            1        1            1
cena_jakosc         2        2            3
lozko               3        3            2
recepcja            4        4            4
sniadanie           5        5            5
zameldowanie        6        6            6
wifi                7        7            7
lokalizacja         8        8            8
4. Macierz ważność–ocena: Rysunek 4
R
# Rysunek 4. Macierz ważność–ocena: wagi względne (oś pionowa) i średnia ocena aspektu (oś pozioma)
library(ggplot2)
library(ggrepel)

mac <- data.frame(aspekt = aspekty, ocena = colMeans(hotel[k]), waznosc = tab$rw_proc)
prog_oceny <- mean(mac$ocena)                   # linie podziału: średnia ocen aspektów i średnia ważność (100% / 8)
prog_wazn <- 100 / length(k)
kwadrant <- function(waznosc, ocena)
  ifelse(waznosc >= prog_wazn, ifelse(ocena >= prog_oceny, "Utrzymać", "Poprawić"),
         ifelse(ocena >= prog_oceny, "Przesadzone", "Niski priorytet"))
mac$kwadrant <- factor(kwadrant(mac$waznosc, mac$ocena), names(kwadranty))
c(prog_oceny = prog_oceny, prog_waznosci = prog_wazn)
mac[order(mac$kwadrant, -mac$waznosc), ]

rogi <- data.frame(x = c(6.2, 8.9, 6.2, 8.9), y = c(24.5, 24.5, 3.2, 3.2), hjust = c(0, 1, 0, 1),
                   kwadrant = factor(names(kwadranty)[c(2, 1, 4, 3)], names(kwadranty)),
                   opis = c("POPRAWIĆ: ważne, słabiej oceniane", "UTRZYMAĆ: ważne, dobrze oceniane",
                            "NISKI PRIORYTET", "PRZESADZONE: mało ważne, dobrze oceniane"))
p4 <- ggplot(mac, aes(ocena, waznosc)) +
  geom_vline(xintercept = prog_oceny, linetype = "dashed", colour = "grey40") +
  geom_hline(yintercept = prog_wazn, linetype = "dashed", colour = "grey40") +
  geom_text(data = rogi, aes(x, y, label = opis, hjust = hjust, colour = kwadrant), fontface = "bold", size = 3.6,
            show.legend = FALSE) +
  geom_point(aes(colour = kwadrant, shape = kwadrant), size = 4) +
  geom_text_repel(aes(label = sprintf("%s (%.1f%%; %.2f)", aspekt, waznosc, ocena)), size = 3.6, seed = 623,
                  colour = "grey15", box.padding = 0.6, min.segment.length = 0.2) +
  scale_colour_manual(values = kwadranty, name = NULL, drop = FALSE) +
  scale_shape_manual(values = ksztalty, name = NULL, drop = FALSE) +
  scale_x_continuous(limits = c(6.2, 8.9), breaks = seq(6.25, 8.75, 0.5)) +
  scale_y_continuous(limits = c(2.5, 25), labels = function(x) paste0(x, "%")) +
  labs(title = "Macierz ważność–ocena dla ośmiu aspektów pobytu",
       subtitle = sprintf("Linie: średnia ocena aspektów (%.2f) i równy udział w R² (12.5%%)", prog_oceny),
       x = "Ocena: średnia na skali 1–10", y = "Ważność: udział w R² oceny ogólnej") + motyw
p4   # zapis: ggsave("kluczowe-czynniki-satysfakcji-macierz.svg", p4, width = 10, height = 6.6)
Wynik w R
   prog_oceny prog_waznosci
     7.490625     12.500000
                            aspekt    ocena   waznosc        kwadrant
czystosc           czystość pokoju 8.318333 21.746577        Utrzymać
cena_jakosc        cena do jakości 6.888333 19.429763        Poprawić
lozko                 wygoda łóżka 7.118333 18.244589        Poprawić
recepcja          obsługa recepcji 8.536667 10.683286     Przesadzone
lokalizacja            lokalizacja 8.681667  5.550384     Przesadzone
sniadanie                śniadanie 6.675000 10.095276 Niski priorytet
zameldowanie szybkość zameldowania 7.311667  7.835285 Niski priorytet
wifi                         Wi-Fi 6.395000  6.414840 Niski priorytet
5. Bootstrap wag i rankingu: Rysunek 5
R
# Rysunek 5. Niepewność rankingu: 1000 prób bootstrapowych gości (wagi względne i kwadrant)
library(ggplot2)
library(patchwork)

set.seed(623)                                   # to samo ziarno co dane, ustalone raz
B <- 1000
boot <- t(replicate(B, {
  d <- hotel[sample(nrow(hotel), replace = TRUE), ]
  w <- wagi_wzgledne(cor(d[k]), cor(d)[k, "ogolna"])
  c(100 * w / sum(w), colMeans(d[k]))
}))
w_b <- boot[, 1:8]; o_b <- boot[, 9:16]
rangi <- t(apply(-w_b, 1, rank, ties.method = "first"))
kw_b <- sapply(1:8, function(j) ifelse(   # linia podziału oceny: średnia aspektów w danej próbie
                                       w_b[, j] >= prog_wazn,
                                       ifelse(o_b[, j] >= rowMeans(o_b), "Utrzymać", "Poprawić"),
                                       ifelse(o_b[, j] >= rowMeans(o_b), "Przesadzone", "Niski priorytet")))
wynik_b <- data.frame(aspekt = aspekty, waga = tab$rw_proc,
                      lo = apply(w_b, 2, quantile, .025), hi = apply(w_b, 2, quantile, .975),
                      ranga_1 = 100 * colMeans(rangi == 1), ranga_mediana = apply(rangi, 2, median),
                      kw_jak_w_probie = 100 * colMeans(kw_b == matrix(as.character(mac$kwadrant), B, 8, byrow = TRUE)),
                      poprawic = 100 * colMeans(kw_b == "Poprawić"), utrzymac = 100 * colMeans(kw_b == "Utrzymać"))
print(wynik_b[order(-wynik_b$waga), -1], digits = 3)
round(100 * colMeans(rangi <= 3), 1)                 # % prób, w których aspekt był w pierwszej trójce
# Błąd Monte Carlo odsetka z 1000 prób (w punktach procentowych) dla odsetka 50% – największy możliwy
round(100 * sqrt(.5 * .5 / B), 1)

kolejnosc <- aspekty[order(tab$rw_proc)]
wynik_b$aspekt <- factor(wynik_b$aspekt, kolejnosc)
pa <- ggplot(wynik_b, aes(waga, aspekt)) +
  geom_vline(xintercept = prog_wazn, linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = 0.3, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 3, colour = kol[["niebieski"]], shape = 15) +
  labs(title = "A. Waga względna z 95% CI", x = "% R² (percentylowy przedział bootstrapowy)", y = NULL) + motyw
d_r <- expand.grid(aspekt = factor(aspekty, kolejnosc), ranga = 1:8)
d_r$proc <- mapply(function(a, r) 100 * mean(rangi[, match(a, aspekty)] == r), as.character(d_r$aspekt), d_r$ranga)
pb <- ggplot(d_r, aes(factor(ranga), aspekt, fill = proc)) +
  geom_tile(colour = "white", linewidth = 0.7) +
  geom_text(aes(label = ifelse(proc >= 1, sprintf("%.0f", proc), ""), colour = proc > 50), size = 3.4) +
  scale_fill_gradient(low = "#F2F2F2", high = kol[["niebieski"]], limits = c(0, 100), name = "% prób") +
  scale_colour_manual(values = c("TRUE" = "white", "FALSE" = "grey15"), guide = "none") +
  labs(title = "B. Miejsce w rankingu (% prób)", x = "miejsce (1 = najważniejszy)", y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid = element_blank())
p5 <- pa + pb + plot_layout(widths = c(1, 1.15)) +
  plot_annotation(title = "Jak pewny jest ranking? 1000 prób bootstrapowych z 600 ankiet", theme = motyw)
p5   # zapis: ggsave("kluczowe-czynniki-satysfakcji-bootstrap.svg", p5, width = 10, height = 5.8)
Wynik w R
              waga    lo    hi ranga_1 ranga_mediana kw_jak_w_probie poprawic
czystosc     21.75 16.81 26.97    62.1             1           100.0      0.0
cena_jakosc  19.43 14.01 25.25    27.9             2            99.3     99.3
lozko        18.24 13.18 23.24    10.0             3            98.4     98.4
recepcja     10.68  6.83 15.02     0.0             4            80.9      0.0
sniadanie    10.10  6.42 14.34     0.0             5            87.6     12.4
zameldowanie  7.84  5.09 11.57     0.0             6            98.8      1.2
wifi          6.41  3.46 10.42     0.0             7            99.9      0.1
lokalizacja   5.55  2.38  9.75     0.0             8            99.8      0.0
             utrzymac
czystosc        100.0
cena_jakosc       0.0
lozko             0.0
recepcja         19.1
sniadanie         0.0
zameldowanie      0.0
wifi              0.0
lokalizacja       0.2
    czystosc        lozko     recepcja zameldowanie    sniadanie         wifi
       100.0         96.6          3.6          0.0          1.8          0.0
 lokalizacja  cena_jakosc
         0.1         97.9
[1] 1.6
6. Symulacja 1000 ankiet: Rysunek 6
R
# Rysunek 6. 1000 ankiet z tej samej populacji gości: β przy współliniowości i trafność kwadrantów a liczebność próby
library(ggplot2)
library(patchwork)

# Kwadranty „prawdziwe”: wagi względne z parametrów i średnie ustalone przy losowaniu
kw_prawda <- ifelse(rw_pop / sum(rw_pop) >= 1 / 8, ifelse(sr >= mean(sr), "Utrzymać", "Poprawić"),
                    ifelse(sr >= mean(sr), "Przesadzone", "Niski priorytet"))
kw_prawda

set.seed(623)                                   # to samo ziarno, ustalone raz
liczebnosci <- c(150, 300, 600, 1200)
sym <- do.call(rbind, lapply(liczebnosci, function(n) {
  t(replicate(1000, {
    d <- losuj_ankiete(n)
    Rd <- cor(d)
    bt <- solve(Rd[k, k], Rd[k, "ogolna"])                     # β standaryzowane
    w <- wagi_wzgledne(Rd[k, k], Rd[k, "ogolna"]); w <- w / sum(w)
    o <- colMeans(d[k])
    kw <- ifelse(w >= 1 / 8, ifelse(o >= mean(o), "Utrzymać", "Poprawić"),
                 ifelse(o >= mean(o), "Przesadzone", "Niski priorytet"))
    c(n = n, beta_rec = bt[["recepcja"]], beta_zam = bt[["zameldowanie"]], rw_zam = 100 * w[["zameldowanie"]],
      poprawic_ok = all((kw == "Poprawić") == (kw_prawda == "Poprawić")), wszystkie_ok = all(kw == kw_prawda),
      recepcja_ok = kw[["recepcja"]] == kw_prawda[["recepcja"]])
  }))
}))
sym <- as.data.frame(sym)
podsum <- aggregate(cbind(beta_zam_ujemna = beta_zam < 0, poprawic_ok, wszystkie_ok, recepcja_ok) ~ n, sym, mean)
podsum[, -1] <- 100 * podsum[, -1]
podsum$bladMC_wszystkie <- sqrt(podsum$wszystkie_ok * (100 - podsum$wszystkie_ok) / 1000)
round(podsum, 1)
s600 <- sym[sym$n == 600, ]
round(c(kor_beta = cor(s600$beta_rec, s600$beta_zam), rw_zam_min = min(s600$rw_zam),
        beta_zam_2.5 = unname(quantile(s600$beta_zam, .025)),
        beta_zam_97.5 = unname(quantile(s600$beta_zam, .975))), 3)

s600$znak <- ifelse(s600$beta_zam < 0, "β zameldowania < 0", "β zameldowania ≥ 0")
pa <- ggplot(s600, aes(beta_rec, beta_zam, colour = znak, shape = znak)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_point(alpha = 0.55, size = 1.6) +
  annotate("point", x = b[["recepcja"]] / sqrt(sum(b * (R %*% b)) + s_e^2), colour = "black", shape = 4, size = 4,
           y = b[["zameldowanie"]] / sqrt(sum(b * (R %*% b)) + s_e^2), stroke = 1.4) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "A. β recepcji i zameldowania (n = 600)", subtitle = "× – wartości prawdziwe",
       x = "β obsługi recepcji", y = "β szybkości zameldowania") + motyw
d_b <- data.frame(n = rep(podsum$n, 2), proc = c(podsum$poprawic_ok, podsum$wszystkie_ok),
                  miara = rep(c("kwadrant „Poprawić” trafny", "wszystkie 8 kwadrantów trafne"), each = 4))
d_b$se <- sqrt(d_b$proc * (100 - d_b$proc) / 1000)
pb <- ggplot(d_b, aes(n, proc, colour = miara, shape = miara)) +
  geom_line(linewidth = 0.9) + geom_point(size = 3) +
  geom_errorbar(aes(ymin = proc - 1.96 * se, ymax = proc + 1.96 * se), width = 0.04) +
  scale_x_log10(breaks = liczebnosci) + scale_y_continuous(limits = c(0, 100), labels = function(x) paste0(x, "%")) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomarancz"]]), name = NULL) +
  scale_shape_manual(values = c(15, 18), name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "B. Trafność macierzy a liczebność", subtitle = "% z 1000 ankiet (słupki: ±1.96 błędu MC)",
       x = "liczba gości w ankiecie (skala log)", y = "% ankiet") + motyw
p6 <- pa + pb + plot_annotation(title = "1000 ankiet z tej samej populacji gości", theme = motyw)
p6   # zapis: ggsave("kluczowe-czynniki-satysfakcji-symulacja.svg", p6, width = 10, height = 5.8)
Wynik w R
         czystosc             lozko          recepcja      zameldowanie
       "Utrzymać"        "Poprawić"        "Utrzymać" "Niski priorytet"
        sniadanie              wifi       lokalizacja       cena_jakosc
"Niski priorytet" "Niski priorytet"     "Przesadzone"        "Poprawić"
     n beta_zam_ujemna poprawic_ok wszystkie_ok recepcja_ok bladMC_wszystkie
1  150            30.9        25.6         10.1        48.6              1.0
2  300            21.8        40.2         20.7        53.2              1.3
3  600            12.7        46.3         25.8        55.2              1.4
4 1200             4.8        54.4         33.8        57.8              1.5
     kor_beta    rw_zam_min  beta_zam_2.5 beta_zam_97.5
       -0.675         5.265        -0.033         0.141
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("zielony – cynober (Utrzymać / Poprawić)" = c("#009E73", "#D55E00"),
             "niebieski – szary (Przesadzone / Niski priorytet)" = c("#0072B2", "#333333"),
             "zielony – niebieski (Utrzymać / Przesadzone)" = c("#009E73", "#0072B2"),
             "cynober – szary (β < 0 / β ≥ 0; β / r)" = c("#D55E00", "#8C8C8C"),
             "niebieski – pomarańczowy (dominacja / wagi; dwie linie)" = c("#0072B2", "#E69F00"),
             "zielony – szary (Utrzymać / Niski priorytet)" = c("#009E73", "#333333"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                        widzenie_typowe
zielony – cynober (Utrzymać / Poprawić)                           102.4
niebieski – szary (Przesadzone / Niski priorytet)                  48.3
zielony – niebieski (Utrzymać / Przesadzone)                       70.1
cynober – szary (β < 0 / β ≥ 0; β / r)                             76.8
niebieski – pomarańczowy (dominacja / wagi; dwie linie)           120.2
zielony – szary (Utrzymać / Niski priorytet)                       59.9
czerwony – zielony (do unikania)                                  121.7
                                                        deuteranopia protanopia
zielony – cynober (Utrzymać / Poprawić)                         53.5       37.3
niebieski – szary (Przesadzone / Niski priorytet)               50.3       47.4
zielony – niebieski (Utrzymać / Przesadzone)                    55.4       58.0
cynober – szary (β < 0 / β ≥ 0; β / r)                          62.6       54.8
niebieski – pomarańczowy (dominacja / wagi; dwie linie)        121.5      109.3
zielony – szary (Utrzymać / Niski priorytet)                    35.8       43.5
czerwony – zielony (do unikania)                                21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, regresja, rozkład własny i bootstrap – pakiety base i stats). Rysunki wykonano w ggplot2, panele złożono pakietem patchwork, etykiety rozsunięto pakietem ggrepel; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ranking według β. Przy współliniowych aspektach β zależy od tego, z czym aspekt dzieli wariancję – zameldowanie spadło na ostatnie miejsce, a w 12.7% ankiet miało β ujemne.
- Ranking według samych korelacji. Każdy aspekt dostaje też zasługi sąsiadów (efekt halo).
- Usuwanie „zbędnych” aspektów po wyniku regresji – zmienia pytanie i podnosi wagi pozostałych.
- Kwadrant bez niepewności. Aspekt przy linii podaj z przedziałem bootstrapowym i nazwij granicznym.
- Linie podziału dobrane po obejrzeniu wykresu – wybierz je przed analizą.
- Zależność liniowa jako jedyna możliwa. Cechy oczywiste i zachwycające działają asymetrycznie – sprawdź je osobnym badaniem.
Najczęstsze pytania
Czym jest analiza kluczowych czynników satysfakcji?
To analiza, która wylicza ważność aspektów usługi z danych: sprawdza, jak oceny aspektów (np. czystości czy obsługi) wiążą się z oceną ogólną. Zwykle łączy regresję wieloraką z miarą podziału R², np. wagami względnymi, a wynik pokazuje na macierzy ważność–ocena. Ważność z danych opisuje związek, a nie skutek zmiany.
Dlaczego nie szeregować aspektów według współczynników β?
Bo przy skorelowanych aspektach β pokazuje tylko wkład unikalny, a część wspólna nie trafia do żadnego z nich. W przykładzie szybkość zameldowania, silnie związana z obsługą recepcji (r = .76), miała β bliskie zera, a w symulacji 1000 ankiet po 600 osób jej β było ujemne w 12.7% przypadków. Wagi względne dzielą całe R² między aspekty i nie dają wartości ujemnych.
Czym różnią się wagi względne Johnsona od analizy dominacji?
Analiza dominacji (Budescu, 1993) liczy średni przyrost R² aspektu we wszystkich modelach z podzbiorami predyktorów – przy ośmiu aspektach to 255 modeli. Wagi względne (Johnson, 2000) dochodzą do bardzo zbliżonych wartości przez rozkład własny macierzy korelacji, więc liczą się szybko przy każdej liczbie predyktorów. W przykładzie obie metody dały ten sam ranking.
Jak wyznaczyć linie podziału w macierzy ważność–ocena?
Najczęściej przez średnią ocenę aspektów i średnią ważność; przy wagach względnych średnia ważność to R² podzielone równo między aspekty (tu 12.5%). Można też użyć środka skali lub mediany. Wybór zapisz przed analizą, bo zmienia kwadranty aspektów leżących blisko linii.
Ile osób potrzeba do analizy kluczowych czynników?
Tyle, by przedziały ufności wag nie przecinały linii podziału dla aspektów, o których chcesz decydować. W symulacji z ośmioma aspektami kwadrant „poprawić” był trafny w 46.3% ankiet po 600 osób i w 54.4% po 1200 – głównie dlatego, że dwa aspekty leżały tuż przy linii. Sprawdzaj niepewność bootstrapem zamiast ufać jednemu rankingowi.
Powiązane hasła
Przeczytaj też
Model Kano krok po kroku
Ankieta 400 klientów banku o funkcjach aplikacji: tabela oceny, kategorie, SI i DI z bootstrapem, remisy i segmenty – sześć rysunków z kodem R.
Czytaj →PoradnikSatysfakcja i lojalność w PLS-SEM
Ankieta 450 kursantów szkoły językowej w modelu w stylu ECSI: diagram ścieżek, pomiar, efekty pośrednie, f² i mapa IPMA – pięć rysunków z kodem R.
Czytaj →PoradnikNPS – przedział ufności i porównania
Przedział ufności NPS ze wzoru i bootstrapu, liczba ankiet do wykrycia zmiany i porównanie dwóch NPS na przykładzie salonów optycznych – z kodem R.
Czytaj →PoradnikTrafność przyrostowa nowej skali
ΔR² z bootstrapowym CI, wagi względne i analiza dominacji, pozorny przyrost przy nierzetelnych miarach kontrolnych, przykład w R i wzór opisu.
Czytaj →PoradnikSERVQUAL – luka oczekiwania i oceny
600 klientów przychodni weterynaryjnych: luki z CI, rzetelność luk, CFA, luki vs same oceny (SERVPERF) i porównanie placówek – z kodem R.
Czytaj →Analizujesz ankietę satysfakcji w pracy z marketingu?
Pomożemy wybrać model, policzyć wagi względne i macierz ważność–ocena oraz opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Azen, R., & Budescu, D. V. (2003). The dominance analysis approach for comparing predictors in multiple regression. Psychological Methods, 8(2), 129–148. https://doi.org/10.1037/1082-989x.8.2.129
- Azzopardi, E., & Nash, R. (2013). A critical evaluation of importance–performance analysis. Tourism Management, 35, 222–233. https://doi.org/10.1016/j.tourman.2012.07.007
- Budescu, D. V. (1993). Dominance analysis: A new approach to the problem of relative importance of predictors in multiple regression. Psychological Bulletin, 114(3), 542–551. https://doi.org/10.1037/0033-2909.114.3.542
- Johnson, J. W. (2000). A heuristic method for estimating the relative weight of predictor variables in multiple regression. Multivariate Behavioral Research, 35(1), 1–19. https://doi.org/10.1207/s15327906mbr3501_1
- Johnson, J. W., & LeBreton, J. M. (2004). History and use of relative importance indices in organizational research. Organizational Research Methods, 7(3), 238–257. https://doi.org/10.1177/1094428104266510
- Kraha, A., Turner, H., Nimon, K., Zientek, L. R., & Henson, R. K. (2012). Tools to support interpreting multiple regression in the face of multicollinearity. Frontiers in Psychology, 3, Article 44. https://doi.org/10.3389/fpsyg.2012.00044 ● Otwarty dostęp
- Martilla, J. A., & James, J. C. (1977). Importance-performance analysis. Journal of Marketing, 41(1), 77–79. https://doi.org/10.1177/002224297704100112
Cytowania BibTeX
@article{azen2003dominance, author={Azen, Razia and Budescu, David V.}, title={{The dominance analysis approach for comparing predictors in multiple regression}}, journal={Psychological Methods}, year={2003}, volume={8}, number={2}, pages={129--148}, doi={10.1037/1082-989x.8.2.129}}@article{azzopardi2013critical, author={Azzopardi, Ernest and Nash, Robert}, title={{A critical evaluation of importance–performance analysis}}, journal={Tourism Management}, year={2013}, volume={35}, pages={222--233}, doi={10.1016/j.tourman.2012.07.007}}@article{budescu1993dominance, author={Budescu, David V.}, title={{Dominance analysis: A new approach to the problem of relative importance of predictors in multiple regression}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={3}, pages={542--551}, doi={10.1037/0033-2909.114.3.542}}@article{johnson2000heuristic, author={Johnson, Jeff W.}, title={{A heuristic method for estimating the relative weight of predictor variables in multiple regression}}, journal={Multivariate Behavioral Research}, year={2000}, volume={35}, number={1}, pages={1--19}, doi={10.1207/s15327906mbr3501_1}}@article{johnson2004history, author={Johnson, Jeff W. and LeBreton, James M.}, title={{History and use of relative importance indices in organizational research}}, journal={Organizational Research Methods}, year={2004}, volume={7}, number={3}, pages={238--257}, doi={10.1177/1094428104266510}}@article{kraha2012tools, author={Kraha, Amanda and Turner, Heather and Nimon, Kim and Zientek, Linda Reichwein and Henson, Robin K.}, title={{Tools to support interpreting multiple regression in the face of multicollinearity}}, journal={Frontiers in Psychology}, year={2012}, volume={3}, eid={44}, doi={10.3389/fpsyg.2012.00044}}@article{martilla1977importance, author={Martilla, John A. and James, John C.}, title={{Importance-performance analysis}}, journal={Journal of Marketing}, year={1977}, volume={41}, number={1}, pages={77--79}, doi={10.1177/002224297704100112}}