Przykład: dlaczego kursanci wracają na kolejny semestr?
Fikcyjna sieć szkół językowych po każdym semestrze prosi kursantów o krótką ankietę. 450 osób oceniło 18 stwierdzeń na skali od 1 (zdecydowanie nie) do 10 (zdecydowanie tak). Pytania dotyczą wizerunku szkoły, oczekiwań sprzed zapisu, jakości zajęć, relacji jakości do ceny, zadowolenia i zamiarów na przyszłość.
Dział marketingu pyta: co sprawia, że kursant zapisze się na kolejny semestr i poleci szkołę znajomym – i w co zainwestować najpierw: w lektorów, platformę online czy wizerunek? Średnie odpowiedzi (od 5.92 do 7.80) tego nie powiedzą, bo pytania są ze sobą powiązane. Model równań strukturalnych łączy pytania w konstrukty i szacuje, jak jeden konstrukt wiąże się z kolejnym. Logikę metody i progi ocen opisuje PLS-SEM krok po kroku, a pełną analizę w pakiecie seminr – PLS-SEM w R. Tu skupiamy się na typowym modelu marketingowym i na tym, co z wyników wynika dla decyzji.
Dane są fikcyjne i wiemy, jaki model w nich ukryliśmy. Ręcznie ustaliliśmy standaryzowane ścieżki (np. satysfakcja → lojalność .60, oczekiwania → satysfakcja tylko .05), ładunki pytań (jedno słabe pytanie o oczekiwania: .50) i średnie pytań. Po pierwszym uruchomieniu podnieśliśmy ścieżki do satysfakcji i lojalności (o .05), żeby R² przypominało typowe badania satysfakcji, i obniżyliśmy średnie pytań o jakość, żeby mapa ważności i wydajności miała wyraźny priorytet. Ziarna 625 nie zmienialiśmy. Dane pobierzesz jako model-satysfakcji-lojalnosci-ankieta.csv (kolumny wiz1–loj3, odpowiedzi 1–10).
Model w stylu ECSI: od wizerunku do lojalności
Narodowe indeksy satysfakcji klientów – amerykański ACSI (Fornell i in., 1996) i europejski ECSI (Cassel i Eklöf, 2001) – stawiają satysfakcję w środku łańcucha. Poprzedzają ją wizerunek firmy, oczekiwania, jakość postrzegana i wartość, czyli jakość w stosunku do ceny. Skutkiem satysfakcji jest lojalność. W badaniu ACSI satysfakcja zależała bardziej od jakości niż od wartości czy ceny (Fornell i in., 1996). Cassel i Eklöf (2001) pokazali, że jeden wspólny model sprawdzał się w telekomunikacji, bankowości i supermarketach w 11 krajach, choć wartość postrzegana sprawiała kłopoty z pomiarem. Oryginalne modele mają też konstrukt skarg – tu go pomijamy.
| Konstrukt | Pytania | Przykład (skala 1–10) |
|---|---|---|
| Wizerunek | 3 | „Szkoła ma dobrą opinię w moim mieście” |
| Oczekiwania | 3 | „Przed zapisem spodziewałem(-am) się zajęć wysokiej jakości” |
| Jakość | 4 | lektorzy, materiały, grafik i organizacja, platforma online |
| Wartość | 2 | „Jakość zajęć w stosunku do ceny jest dobra” |
| Satysfakcja | 3 | „Ogólnie jestem zadowolony(-a) ze szkoły” |
| Lojalność | 3 | „Zapiszę się na kolejny semestr” |
Każdy konstrukt to kompozyt, czyli ważona suma swoich pytań, liczona metodą PLS-SEM w trybie A (zob. modele refleksyjne i formatywne). Kiedy wybrać PLS, a kiedy model czynnikowy, omawia wpis PLS-SEM czy CB-SEM. Część strukturalna to układ regresji, np. dla satysfakcji:
Słowami: β mówi, o ile odchyleń standardowych zmienia się satysfakcja, gdy jeden poprzednik rośnie o jedno odchylenie, a pozostałe stoją w miejscu. Przedziały ufności daje bootstrap z 5000 prób.
Rysunek 1: diagram ścieżek z wynikami
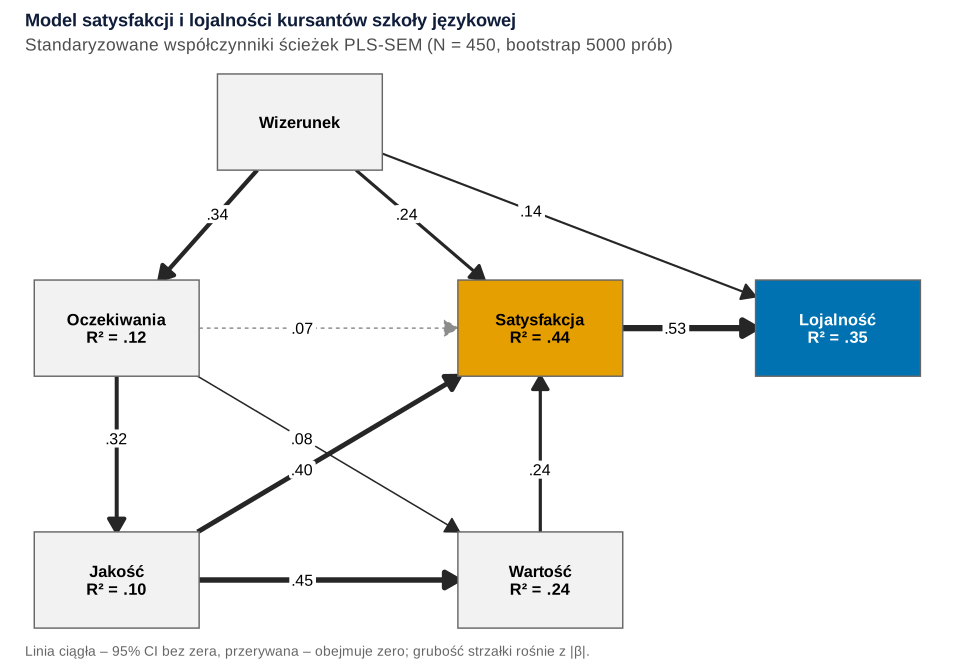
Co widać. Grubość strzałki rośnie z siłą ścieżki. Najsilniejsza prowadzi od satysfakcji do lojalności (β = 0.529, 95% CI [0.462, 0.595]). Satysfakcję najmocniej wyjaśnia jakość (β = 0.400, 95% CI [0.315, 0.480]), potem wartość (β = 0.239) i wizerunek (β = 0.236). Wizerunek działa też bezpośrednio na lojalność (β = 0.139, 95% CI [0.063, 0.217]). Ścieżka oczekiwania → satysfakcja ma przedział obejmujący zero (β = 0.072, 95% CI [−0.004, 0.151]), więc rysujemy ją linią przerywaną. Model wyjaśnia 44% zmienności satysfakcji i 35% lojalności.
Jak może zmylić. Strzałki to założenia badacza, a nie odkrycie z danych. Przy jednym pomiarze w czasie model z odwrotnymi strzałkami mógłby pasować podobnie. Druga sprawa: PLS zaniżył ścieżki ukryte w danych. Satysfakcja → lojalność miała w symulacji .60, a model dał 0.529. Wizerunek → oczekiwania miał .50, a wyszło 0.343 – tu dokłada się słabe pytanie w kompozycie oczekiwań. Kompozyt to suma z błędem pomiaru, a błąd osłabia związki – stąd korekta PLSc.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: czy pytania mierzą to, co trzeba?
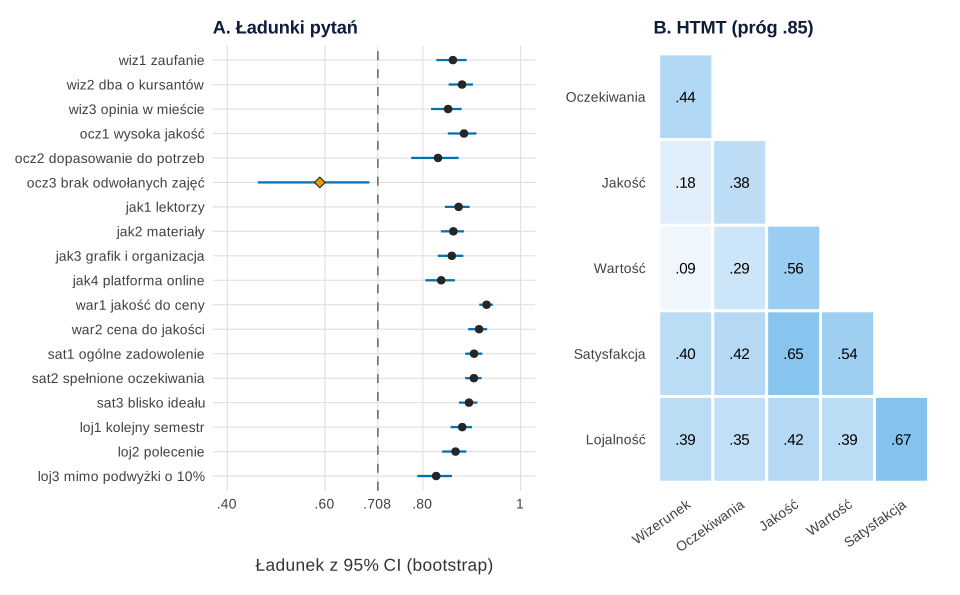
Co widać. 17 z 18 ładunków mieści się między .827 a .930. Wyjątkiem jest pytanie ocz3 o to, czy kursant spodziewał się braku odwołanych zajęć: .589, 95% CI [.462, .691]. Rzetelność kompozytowa ρC wynosi od .818 (oczekiwania) do .929 (satysfakcja), a AVE od .607 do .852. Największy HTMT łączy satysfakcję z lojalnością: .67 (górna granica 95% CI .74), czyli poniżej progu .85 (Henseler i in., 2015).
Jak może zmylić. Ładunek poniżej .708 to sygnał do namysłu, a nie automatyczne usunięcie. Pytanie o odwołane zajęcia dotyczy organizacji, a nie ogólnych oczekiwań, więc tu usunięcie ma sens merytoryczny. Gdy brak pytania zubaża treść konstruktu, zostaw je i opisz. Oczekiwania „sprzed zapisu” mierzone po semestrze są też zabarwione doświadczeniem z zajęć.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: efekty pośrednie na lojalność
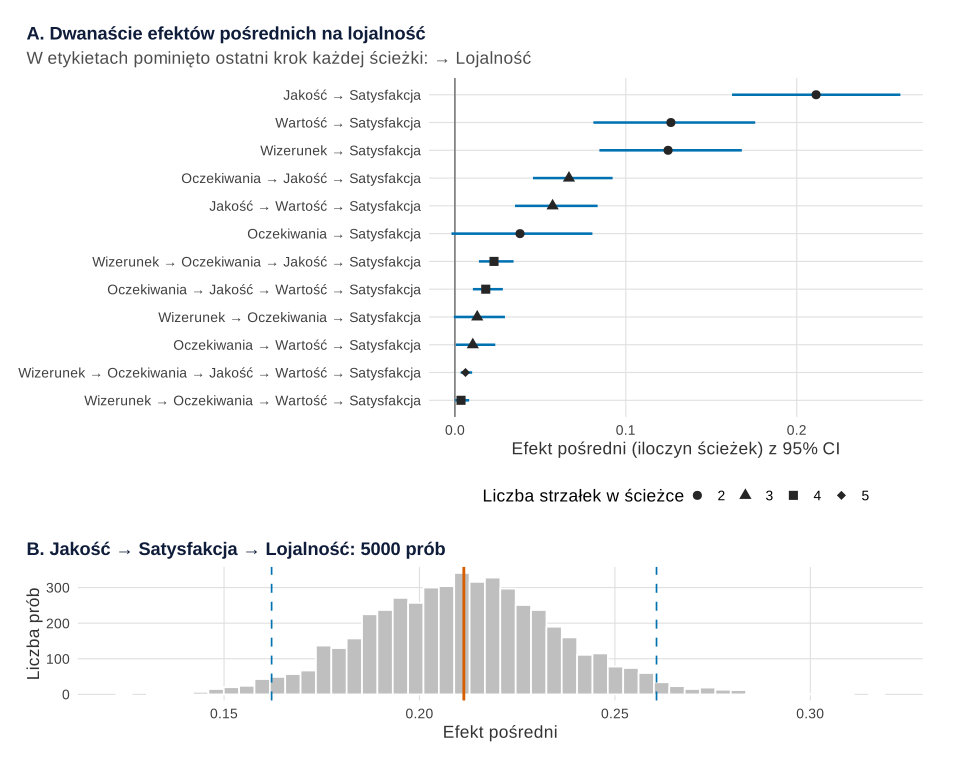
Co widać. Efekt pośredni to iloczyn ścieżek na drodze do lojalności. Największy prowadzi od jakości przez satysfakcję: 0.211, 95% CI [0.162, 0.261]. Drugie miejsce dzielą wartość (0.126) i wizerunek (0.125) – oba przez satysfakcję. Ścieżki z czterema–pięcioma strzałkami dają efekty poniżej 0.025, bo mnożymy kilka liczb mniejszych od 1. Efekt całkowity jakości na lojalność wynosi 0.269 (95% CI [0.217, 0.320]), a wizerunku 0.310 (95% CI [0.230, 0.388]). Wizerunek działa więc i bezpośrednio, i przez satysfakcję – to mediacja częściowa w klasyfikacji Nitzla i in. (2016).
Jak może zmylić. Panel B pokazuje, skąd bierze się przedział: z 5000 iloczynów policzonych na próbach bootstrapowych. Tu rozkład jest prawie symetryczny (skośność 0.11), ale przy małej próbie i słabych ścieżkach bywa skośny. Dlatego nie licz przedziału ze wzoru zakładającego normalność. Efekt pośredni z jednego badania przekrojowego nie dowodzi mechanizmu – mówi, jak dane pasują do założonego łańcucha.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: ile wnosi każda ścieżka – R² i f²
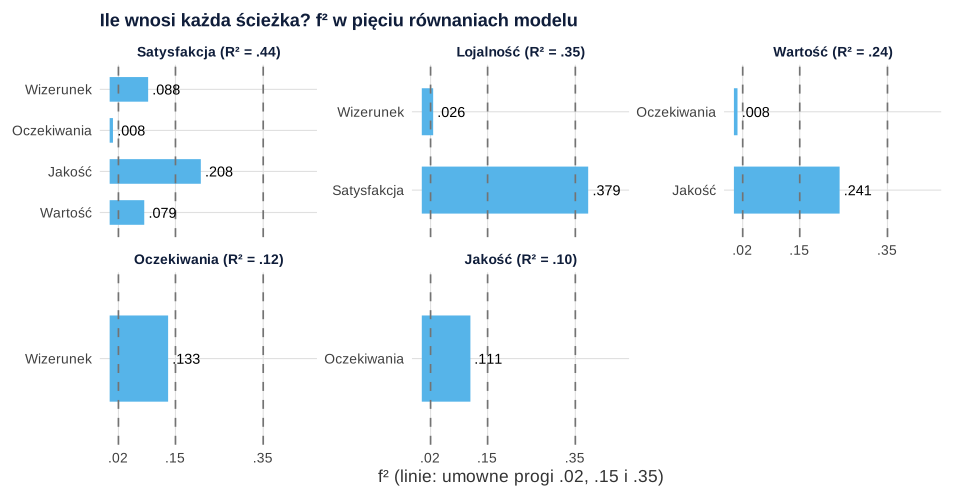
Co widać. f² mówi, o ile spadłoby R² po usunięciu jednej ścieżki, w stosunku do niewyjaśnionej części zmienności. Dla satysfakcji: R² = .444 z wartością i .400 bez niej, więc f² = (.444 − .400) / (1 − .444) = .079. Największe f² ma satysfakcja w równaniu lojalności (.379), potem jakość w równaniach wartości (.241) i satysfakcji (.208). Oczekiwania wnoszą prawie nic do satysfakcji i wartości (po .008). Umowne progi małego, średniego i dużego efektu (.02, .15, .35) wyjaśnia hasło f Cohena.
Jak może zmylić. f² zależy od pozostałych predyktorów w równaniu: gdy poprzedniki są silnie skorelowane, każdy z osobna wnosi mało (wysoki VIF). R² lojalności .35 nie oznacza złego modelu. Lojalność zależy też od rzeczy spoza ankiety, np. przeprowadzki czy oferty konkurencji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: mapa ważności i wydajności dla lojalności
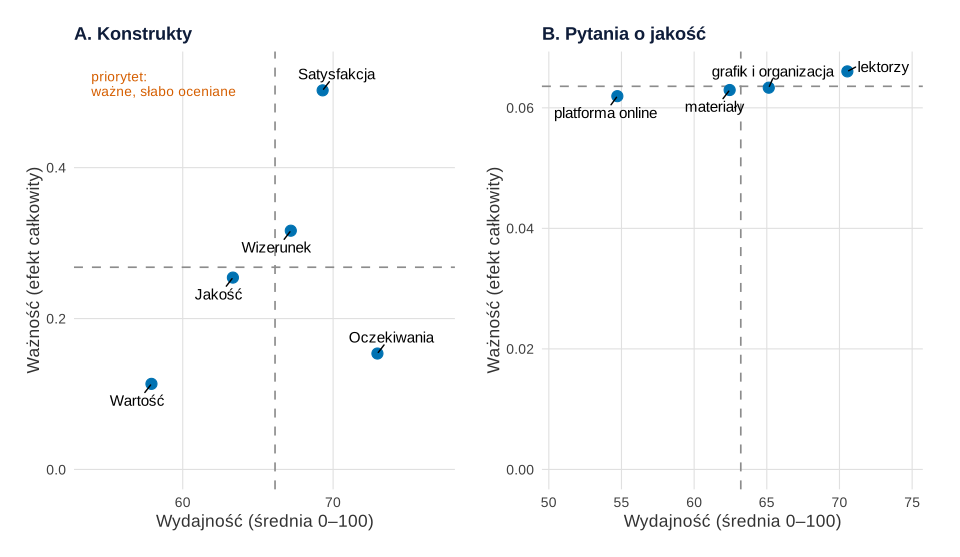
Co widać. IPMA zestawia dwie rzeczy (Ringle i Sarstedt, 2016). Wydajność to średni wynik konstruktu po przeskalowaniu odpowiedzi 1–10 na 0–100. Ważność to niestandaryzowany efekt całkowity na lojalność. Wzrost wydajności jakości o 10 punktów wiąże się ze wzrostem lojalności o 2.54 punktu, a wartości – o 1.13 punktu. Wartość jest oceniana najsłabiej (57.9), ale ma najmniejszą ważność (0.113). Jakość łączy dość dużą ważność (0.254) z niską wydajnością (63.3). W panelu B cztery pytania o jakość mają niemal tę samą ważność (od 0.062 do 0.066), bo ich wagi są podobne. Rozstrzyga więc wydajność: platforma online 54.7, materiały 62.4, organizacja 65.1, lektorzy 70.5.
Jak może zmylić. Linie przerywane to średnie z punktów na mapie, więc ćwiartki zależą od tego, co na nią włożysz. Satysfakcja (ważność 0.502) podnosi średnią ważność do 0.268, przez co jakość ląduje tuż pod linią. Tymczasem wśród czynników, na które szkoła ma wpływ, większy efekt ma tylko wizerunek (0.316). Satysfakcji nie poprawia się bezpośrednio – to wynik. Ważność to efekt w modelu przekrojowym, a nie wynik eksperymentu z poprawą platformy.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Najpierw platforma online. To najsłabiej oceniany element jakości przy tej samej ważności co pozostałe. Po poprawce zmierz zmianę w kolejnej fali tym samym kwestionariuszem (zob. badanie trackingowe).
- Lektorzy – utrzymać. Najwyższa wydajność (70.5); spadek byłby kosztowny.
- Cena – nie obniżać na ślepo. Wartość ma najniższą ocenę, ale małą ważność. Lepiej pokazać, co kursant dostaje w cenie, niż ciąć cenę.
- Wizerunek i polecenia. Wizerunek działa też bezpośrednio na lojalność, więc program poleceń i opinie absolwentów mają sens.
- Bez obietnic w reklamie. Oczekiwania prawie nie przekładają się na satysfakcję – wyższe obietnice nie podniosą lojalności.
Pułapki
- Strzałki to nie przyczyny. Kierunek pochodzi z teorii ECSI, nie z danych przekrojowych.
- Zaniżone ścieżki. Kompozyty zawierają błąd pomiaru: satysfakcja → lojalność .60 w danych, 0.529 w modelu (rysunek 1).
- Ładunek poniżej progu usunięty bez namysłu. Decyduje treść pytania, nie sama liczba (rysunek 2).
- Jeden model dla wszystkich klientów. Segmenty o różnych ścieżkach uśrednią się w nijaki wynik – sprawdź je metodą FIMIX-PLS lub segmentacją.
- Porównanie wyników między miastami lub krajami bez sprawdzenia, czy pytania znaczą to samo – zob. niezmienność pomiarowa skali marki.
- Ćwiartki IPMA czytane bez sprawdzenia, co jest na mapie (rysunek 5).
Gdy nie masz modelu pomiarowego, a tylko ogólną ocenę i oceny aspektów, prostszą drogę pokazuje analiza kluczowych czynników satysfakcji.
Jak opisać w pracy
W Metodzie podaj model (z rysunkiem), program, ustawienia bootstrapu i kryteria oceny modelu pomiarowego. W Wynikach – ocenę pomiaru, tabelę ścieżek i efekty pośrednie, a IPMA jako analizę dodatkową. Inne analizy typowe dla tego kierunku omawia wpis statystyka w pracy z marketingu.
| Ścieżka | β | 95% CI | f² |
|---|---|---|---|
| Wizerunek → Oczekiwania | 0.343 | [0.265, 0.424] | .133 |
| Wizerunek → Satysfakcja | 0.236 | [0.163, 0.310] | .088 |
| Wizerunek → Lojalność | 0.139 | [0.063, 0.217] | .026 |
| Oczekiwania → Jakość | 0.316 | [0.240, 0.397] | .111 |
| Oczekiwania → Wartość | 0.083 | [0.004, 0.164] | .008 |
| Oczekiwania → Satysfakcja | 0.072 | [−0.004, 0.151] | .008 |
| Jakość → Wartość | 0.452 | [0.371, 0.526] | .241 |
| Jakość → Satysfakcja | 0.400 | [0.315, 0.480] | .208 |
| Wartość → Satysfakcja | 0.239 | [0.158, 0.319] | .079 |
| Satysfakcja → Lojalność | 0.529 | [0.462, 0.595] | .379 |
Podpis tabeli:
Do Metody:
Pojedyncze pytanie o polecenie bywa też liczone jako NPS; jak porównywać takie wyniki między grupami, pokazuje wpis NPS na obrazkach.
Kod R: dane, model PLS-SEM, efekty pośrednie i IPMA
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane, model i bootstrap, z których korzystają kolejne. Potrzebne pakiety: seminr, ggplot2, patchwork i ggrepel (oraz colorspace w przepisie 7). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1: dane po set.seed(625) i bootstrap z argumentem seed = 625. Ziarno 625 ustalono raz i nie zmieniano go. Ręcznie ustalono: 450 kursantów, skalę 1–10, macierz prawdziwych ścieżek B (wariancje reszt dobiera pętla tak, by każdy konstrukt miał wariancję 1), ładunki i średnie pytań (lista ladunki i srednie) oraz mnożnik 1.7 przy zamianie na odpowiedzi 1–10. Po pierwszym uruchomieniu podniesiono ścieżki jakość → satysfakcja (z .40 do .45), wartość → satysfakcja (z .20 do .25) i satysfakcja → lojalność (z .55 do .60) oraz obniżono średnie czterech pytań o jakość (z 7.5, 6.9, 7.1 i 6.4 do 7.2, 6.5, 6.8 i 5.8). Całość liczy się w około 15 sekund.
1. Paleta, dane i model PLS-SEM z bootstrapem
R
# Przepis 1. Paleta, dane z ankiety szkoły językowej i model PLS-SEM w stylu ECSI (dane fikcyjne, symulowane)
library(seminr)                                  # PLS-SEM
library(ggplot2)
library(patchwork)
kol <- c(pomaranczowy = "#E69F00", niebieski = "#0072B2", zielony = "#009E73",
         cynober = "#D55E00", blekit = "#56B4E9", grafit = "#262626")   # paleta Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Prawdziwy model ukryty w danych: standaryzowane ścieżki między sześcioma konstruktami (ustalone ręcznie)
k <- c("WIZ", "OCZ", "JAK", "WAR", "SAT", "LOJ")
nazwy <- c(WIZ = "Wizerunek", OCZ = "Oczekiwania", JAK = "Jakość", WAR = "Wartość",
           SAT = "Satysfakcja", LOJ = "Lojalność")
B <- matrix(0, 6, 6, dimnames = list(k, k))     # wiersz = skutek, kolumna = przyczyna
B["OCZ", "WIZ"] <- .50; B["JAK", "OCZ"] <- .45; B["WAR", "OCZ"] <- .15; B["WAR", "JAK"] <- .50
B["SAT", "WIZ"] <- .25; B["SAT", "OCZ"] <- .05; B["SAT", "JAK"] <- .45; B["SAT", "WAR"] <- .25
B["LOJ", "WIZ"] <- .20; B["LOJ", "SAT"] <- .60
psi <- setNames(rep(1, 6), k)                   # wariancje reszt dobrane tak, by każdy konstrukt miał wariancję 1
for (i in 1:200) {
  S <- solve(diag(6) - B) %*% diag(psi) %*% t(solve(diag(6) - B))
  psi[-1] <- psi[-1] + (1 - diag(S)[-1])
}

# 450 kursantów, 18 pytań na skali 1–10; ładunki i średnie pytań ustalone ręcznie
set.seed(625)
n <- 450
eta <- matrix(rnorm(n * 6), n) %*% chol(S)
colnames(eta) <- k
ladunki <- list(WIZ = c(.85, .80, .78), OCZ = c(.80, .74, .50), JAK = c(.86, .82, .80, .76),
                WAR = c(.88, .84), SAT = c(.90, .86, .83), LOJ = c(.85, .82, .72))
srednie <- list(WIZ = c(7.4, 7.1, 6.8), OCZ = c(7.6, 7.8, 7.0), JAK = c(7.2, 6.5, 6.8, 5.8),
                WAR = c(6.1, 6.3), SAT = c(7.3, 7.0, 7.2), LOJ = c(6.9, 7.4, 6.2))
dane <- do.call(cbind, lapply(k, function(kk) {
  m <- sapply(seq_along(ladunki[[kk]]), function(j) {
    l <- ladunki[[kk]][j]
    x <- l * eta[, kk] + sqrt(1 - l^2) * rnorm(n)
    pmin(pmax(round(srednie[[kk]][j] + 1.7 * x), 1), 10)          # odpowiedź 1–10
  })
  colnames(m) <- paste0(tolower(kk), seq_along(ladunki[[kk]]))
  m
}))
dane <- as.data.frame(dane)
write.csv(dane, "model-satysfakcji-lojalnosci-ankieta.csv", row.names = FALSE)
cat("Kursanci:", nrow(dane), "| pytania:", ncol(dane), "| średnie od", min(round(colMeans(dane), 2)),
    "do", max(round(colMeans(dane), 2)), "| odpowiedzi 10:", round(100 * mean(as.matrix(dane) == 10), 1), "%\n")
print(round(colMeans(dane), 2))

# Model pomiarowy (kompozyty, tryb A) i strukturalny (ścieżki jak w ECSI, bez skarg)
pomiar <- constructs(
  composite("WIZ", multi_items("wiz", 1:3)), composite("OCZ", multi_items("ocz", 1:3)),
  composite("JAK", multi_items("jak", 1:4)), composite("WAR", multi_items("war", 1:2)),
  composite("SAT", multi_items("sat", 1:3)), composite("LOJ", multi_items("loj", 1:3)))
struktura <- relationships(
  paths(from = "WIZ", to = c("OCZ", "SAT", "LOJ")),
  paths(from = "OCZ", to = c("JAK", "WAR", "SAT")),
  paths(from = "JAK", to = c("WAR", "SAT")),
  paths(from = "WAR", to = "SAT"),
  paths(from = "SAT", to = "LOJ"))
pls <- estimate_pls(data = dane, measurement_model = pomiar, structural_model = struktura)
s <- summary(pls)

# Bootstrap: 5000 prób; seminr losuje próbę i ziarnem 625 + i, więc wynik nie zależy od liczby rdzeni
boot <- bootstrap_model(pls, nboot = 5000, seed = 625)
sb <- summary(boot)
round(s$paths, 3)
Wynik w R
Kursanci: 450 | pytania: 18 | średnie od 5.92 do 7.8 | odpowiedzi 10: 7.3 %
wiz1 wiz2 wiz3 ocz1 ocz2 ocz3 jak1 jak2 jak3 jak4 war1 war2 sat1 sat2 sat3 loj1
7.36 7.02 6.76 7.56 7.80 7.14 7.35 6.62 6.86 5.92 6.10 6.34 7.33 7.08 7.30 7.00
loj2 loj3
7.41 6.26
         OCZ   SAT   LOJ   JAK   WAR
R^2    0.118 0.444 0.349 0.100 0.235
AdjR^2 0.116 0.439 0.346 0.098 0.232
WIZ    0.343 0.236 0.139     .     .
OCZ        . 0.072     . 0.316 0.083
JAK        . 0.400     .     . 0.452
WAR        . 0.239     .     .     .
SAT        .     . 0.529     .     .
2. Diagram ścieżek: Rysunek 1
R
# Rysunek 1. Diagram ścieżek z wynikami – grafika narysowana w ggplot2 (prostokąty, strzałki, tekst)
# Dane wejściowe: s, sb, nazwy, B, kol i motyw z przepisu 1.
sciezki <- as.data.frame(sb$bootstrapped_paths)
sciezki$od <- sub("  ->  .*", "", rownames(sciezki))
sciezki$do <- sub(".*  ->  ", "", rownames(sciezki))
sciezki <- data.frame(od = sciezki$od, do = sciezki$do, beta = sciezki[["Original Est."]],
                      dolna = sciezki[["2.5% CI"]], gorna = sciezki[["97.5% CI"]],
                      prawda = B[cbind(sciezki$do, sciezki$od)])
sciezki$istotna <- sciezki$dolna > 0 | sciezki$gorna < 0
print(transform(sciezki[, c("od", "do", "prawda")], beta = round(sciezki$beta, 3),
                CI = sprintf("[%.3f, %.3f]", sciezki$dolna, sciezki$gorna)), row.names = FALSE)

poz <- data.frame(k = names(nazwy), x = c(1.6, 0, 0, 3.7, 3.7, 6.3), y = c(4.4, 2.6, 0.4, 0.4, 2.6, 2.6))
r2 <- s$paths["R^2", ]
poz$etykieta <- ifelse(poz$k %in% names(r2),
                       sprintf("%s\nR² = %s", nazwy[poz$k], sub("^0", "", sprintf("%.2f", r2[poz$k]))), nazwy[poz$k])
poz$rola <- ifelse(poz$k %in% c("SAT", "LOJ"), poz$k, "inne")
pw <- 0.72; ph <- 0.42                             # połowa szerokości i wysokości prostokąta
brzeg <- function(x0, y0, x1, y1) {                # punkt, w którym odcinek wychodzi z prostokąta
  t <- min(pw / abs(x1 - x0), ph / abs(y1 - y0))
  c(x0 + t * (x1 - x0), y0 + t * (y1 - y0))
}
odc <- t(apply(sciezki, 1, function(r) {
  a <- unlist(poz[poz$k == r[["od"]], c("x", "y")]); b <- unlist(poz[poz$k == r[["do"]], c("x", "y")])
  c(brzeg(a[1], a[2], b[1], b[2]), brzeg(b[1], b[2], a[1], a[2]))
}))
sciezki[, c("x", "y", "xend", "yend")] <- odc
sciezki$xl <- sciezki$x + 0.4 * (sciezki$xend - sciezki$x)   # etykieta w 40% długości strzałki
sciezki$yl <- sciezki$y + 0.4 * (sciezki$yend - sciezki$y)
sciezki$tekst <- sub("0\\.", ".", sprintf("%.2f", sciezki$beta))

p1 <- ggplot() +
  geom_segment(data = sciezki, aes(x, y, xend = xend, yend = yend, linetype = istotna, linewidth = abs(beta)),
               colour = ifelse(sciezki$istotna, kol[["grafit"]], "grey55"),
               arrow = arrow(length = unit(0.16, "inches"), type = "closed")) +
  geom_label(data = sciezki, aes(xl, yl, label = tekst), size = 4.2, linewidth = 0, fill = "white",
             label.padding = unit(0.12, "lines")) +
  geom_rect(data = poz, aes(xmin = x - pw, xmax = x + pw, ymin = y - ph, ymax = y + ph, fill = rola),
            colour = "grey40", linewidth = 0.5) +
  geom_text(data = poz, aes(x, y, label = etykieta), size = 4.3, lineheight = 0.9, fontface = "bold",
            colour = ifelse(poz$rola == "LOJ", "white", "black")) +
  scale_fill_manual(values = c(inne = "grey95", SAT = kol[["pomaranczowy"]], LOJ = kol[["niebieski"]]), guide = "none") +
  scale_linetype_manual(values = c(`TRUE` = "solid", `FALSE` = "22"), guide = "none") +
  scale_linewidth(range = c(0.5, 2.2), guide = "none") +
  coord_equal(xlim = c(-0.8, 7.1), ylim = c(-0.1, 4.9), expand = FALSE) +
  labs(title = "Model satysfakcji i lojalności kursantów szkoły językowej",
       subtitle = "Standaryzowane współczynniki ścieżek PLS-SEM (N = 450, bootstrap 5000 prób)",
       caption = "Linia ciągła – 95% CI bez zera, przerywana – obejmuje zero; grubość strzałki rośnie z |β|.") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # ggsave("ecsi-diagram.svg", p1, width = 10, height = 7)
Wynik w R
  od  do prawda  beta              CI
 WIZ OCZ   0.50 0.343  [0.265, 0.424]
 WIZ SAT   0.25 0.236  [0.163, 0.310]
 WIZ LOJ   0.20 0.139  [0.063, 0.217]
 OCZ JAK   0.45 0.316  [0.240, 0.397]
 OCZ WAR   0.15 0.083  [0.004, 0.164]
 OCZ SAT   0.05 0.072 [-0.004, 0.151]
 JAK WAR   0.50 0.452  [0.371, 0.526]
 JAK SAT   0.45 0.400  [0.315, 0.480]
 WAR SAT   0.25 0.239  [0.158, 0.319]
 SAT LOJ   0.60 0.529  [0.462, 0.595]
3. Model pomiarowy: Rysunek 2
R
# Rysunek 2. Model pomiarowy: ładunki z 95% CI (A) i HTMT (B)
# Dane wejściowe: s, sb, nazwy, kol i motyw z przepisu 1.
pytania <- c(wiz1 = "zaufanie", wiz2 = "dba o kursantów", wiz3 = "opinia w mieście",
             ocz1 = "wysoka jakość", ocz2 = "dopasowanie do potrzeb", ocz3 = "brak odwołanych zajęć",
             jak1 = "lektorzy", jak2 = "materiały", jak3 = "grafik i organizacja", jak4 = "platforma online",
             war1 = "jakość do ceny", war2 = "cena do jakości",
             sat1 = "ogólne zadowolenie", sat2 = "spełnione oczekiwania", sat3 = "blisko ideału",
             loj1 = "kolejny semestr", loj2 = "polecenie", loj3 = "mimo podwyżki o 10%")
ld <- as.data.frame(sb$bootstrapped_loadings)
ld <- data.frame(poz = sub("  ->  .*", "", rownames(ld)), k = sub(".*  ->  ", "", rownames(ld)),
                 l = ld[["Original Est."]], dolna = ld[["2.5% CI"]], gorna = ld[["97.5% CI"]])
ld$etyk <- factor(paste0(ld$poz, " ", pytania[ld$poz]), levels = rev(paste0(names(pytania), " ", pytania)))
ld$k <- factor(nazwy[ld$k], levels = nazwy)
print(transform(ld[, c("poz", "k")], l = round(ld$l, 3), CI = sprintf("[%.3f, %.3f]", ld$dolna, ld$gorna)),
      row.names = FALSE)
round(s$reliability, 3)                         # alfa, rho_A, rho_C, AVE

htmt <- as.data.frame(sb$bootstrapped_HTMT)
htmt <- data.frame(a = sub("  ->  .*", "", rownames(htmt)), b = sub(".*  ->  ", "", rownames(htmt)),
                   v = htmt[["Original Est."]], gorna = htmt[["97.5% CI"]])
cat("HTMT: najwyższe", round(max(htmt$v), 3), "(", paste(htmt[which.max(htmt$v), 1:2], collapse = "–"),
    ", górna granica 95% CI", round(htmt$gorna[which.max(htmt$v)], 3), ")\n")
htmt$a <- factor(nazwy[htmt$a], levels = nazwy); htmt$b <- factor(nazwy[htmt$b], levels = rev(nazwy))

pA <- ggplot(ld, aes(l, etyk)) +
  geom_vline(xintercept = .708, linetype = "dashed", colour = "grey45") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_point(aes(shape = l < .708), size = 2.6, colour = kol[["grafit"]], fill = kol[["pomaranczowy"]]) +
  scale_shape_manual(values = c(`FALSE` = 16, `TRUE` = 23), guide = "none") +
  scale_x_continuous(limits = c(.4, 1), breaks = c(.4, .6, .708, .8, 1), labels = c(".40", ".60", ".708", ".80", "1")) +
  labs(title = "A. Ładunki pytań", x = "Ładunek z 95% CI (bootstrap)", y = NULL) + motyw
pB <- ggplot(htmt, aes(a, b, fill = v)) +
  geom_tile(colour = "white", linewidth = 1) +
  geom_text(aes(label = sub("0\\.", ".", sprintf("%.2f", v))), size = 4) +
  scale_fill_gradient(low = "white", high = kol[["blekit"]], limits = c(0, .85), name = "HTMT") +
  labs(title = "B. HTMT (próg .85)", x = NULL, y = NULL) +
  motyw + theme(axis.text.x = element_text(angle = 35, hjust = 1), panel.grid.major = element_blank())
p2 <- pA + pB + plot_layout(widths = c(1.15, 1))
p2   # ggsave("ecsi-pomiar.svg", p2, width = 10, height = 6.2)
Wynik w R
  poz           k     l             CI
 wiz1   Wizerunek 0.862 [0.828, 0.890]
 wiz2   Wizerunek 0.880 [0.853, 0.903]
 wiz3   Wizerunek 0.852 [0.817, 0.879]
 ocz1 Oczekiwania 0.884 [0.851, 0.910]
 ocz2 Oczekiwania 0.831 [0.776, 0.873]
 ocz3 Oczekiwania 0.589 [0.462, 0.691]
 jak1      Jakość 0.873 [0.845, 0.896]
 jak2      Jakość 0.862 [0.837, 0.884]
 jak3      Jakość 0.859 [0.831, 0.883]
 jak4      Jakość 0.838 [0.805, 0.866]
 war1     Wartość 0.930 [0.915, 0.943]
 war2     Wartość 0.915 [0.893, 0.932]
 sat1 Satysfakcja 0.905 [0.887, 0.922]
 sat2 Satysfakcja 0.904 [0.887, 0.920]
 sat3 Satysfakcja 0.894 [0.874, 0.912]
 loj1   Lojalność 0.881 [0.857, 0.901]
 loj2   Lojalność 0.867 [0.839, 0.889]
 loj3   Lojalność 0.827 [0.789, 0.860]
    alpha  rhoA  rhoC   AVE
WIZ 0.831 0.834 0.899 0.748
OCZ 0.675 0.754 0.818 0.607
JAK 0.881 0.881 0.918 0.737
WAR 0.826 0.831 0.920 0.852
SAT 0.885 0.886 0.929 0.812
LOJ 0.822 0.826 0.894 0.737

Alpha, rhoA, and rhoC should exceed 0.7 while AVE should exceed 0.5
HTMT: najwyższe 0.673 ( SAT–LOJ , górna granica 95% CI 0.738 )
4. Efekty pośrednie: Rysunek 3
R
# Rysunek 3. Efekty pośrednie na lojalność: 12 ścieżek z 95% CI (A) i rozkład bootstrapowy jednej z nich (B)
# Dane wejściowe: pls, boot, nazwy, kol i motyw z przepisu 1.
P <- pls$path_coef                                  # wiersz = przyczyna, kolumna = skutek
wszystkie <- function(od, do) {                     # wszystkie ścieżki od -> do w modelu strukturalnym
  if (od == do) return(list(do))
  nast <- names(which(P[od, ] != 0))
  unlist(lapply(nast, function(z) lapply(wszystkie(z, do), function(r) c(od, r))), recursive = FALSE)
}
sciezki_loj <- unlist(lapply(c("WIZ", "OCZ", "JAK", "WAR"), wszystkie, do = "LOJ"), recursive = FALSE)
sciezki_loj <- Filter(function(r) length(r) > 2, sciezki_loj)        # tylko pośrednie
iloczyn <- function(r, M) prod(sapply(seq_len(length(r) - 1), function(i) M[r[i], r[i + 1]]))
posr <- do.call(rbind, lapply(sciezki_loj, function(r) {
  b <- apply(boot$boot_paths, 3, function(M) iloczyn(r, M))         # 5000 iloczynów z bootstrapu
  data.frame(sciezka = paste(nazwy[r[-length(r)]], collapse = " → "), od = r[1], kroki = length(r) - 1,
             efekt = iloczyn(r, P), dolna = quantile(b, .025), gorna = quantile(b, .975))
}))
posr <- posr[order(posr$efekt), ]
posr$sciezka <- factor(posr$sciezka, levels = posr$sciezka)
cat(paste(format(paste(posr$sciezka, "→ Lojalność")), sprintf("%.3f [%.3f, %.3f]", posr$efekt, posr$dolna, posr$gorna)), sep = "\n")

# Efekty całkowite na lojalność: bezpośredni + suma wszystkich pośrednich
calk <- as.data.frame(summary(boot)$bootstrapped_total_paths)
calk <- calk[grepl("->  LOJ$", rownames(calk)), c("Original Est.", "2.5% CI", "97.5% CI")]
round(calk, 3)

# Rozkład bootstrapowy efektu Jakość -> Satysfakcja -> Lojalność
b_jsl <- apply(boot$boot_paths, 3, function(M) iloczyn(c("JAK", "SAT", "LOJ"), M))
cat("JAK -> SAT -> LOJ: efekt", round(iloczyn(c("JAK", "SAT", "LOJ"), P), 3), "| percentylowy 95% CI [",
    round(quantile(b_jsl, .025), 3), ",", round(quantile(b_jsl, .975), 3), "] | SD bootstrapu",
    round(sd(b_jsl), 3), "| skośność", round(mean((b_jsl - mean(b_jsl))^3) / sd(b_jsl)^3, 2), "\n")

pA <- ggplot(posr, aes(efekt, sciezka)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_point(aes(shape = factor(kroki)), size = 2.8, colour = kol[["grafit"]]) +
  scale_shape_manual(values = c(`2` = 16, `3` = 17, `4` = 15, `5` = 18), name = "Liczba strzałek w ścieżce") +
  labs(title = "A. Dwanaście efektów pośrednich na lojalność",
       subtitle = "W etykietach pominięto ostatni krok każdej ścieżki: → Lojalność",
       x = "Efekt pośredni (iloczyn ścieżek) z 95% CI", y = NULL) + motyw + theme(plot.title.position = "plot")
pB <- ggplot(data.frame(b = b_jsl), aes(b)) +
  geom_histogram(bins = 50, fill = "grey75", colour = "white") +
  geom_vline(xintercept = quantile(b_jsl, c(.025, .975)), linetype = "dashed", colour = kol[["niebieski"]]) +
  geom_vline(xintercept = iloczyn(c("JAK", "SAT", "LOJ"), P), colour = kol[["cynober"]], linewidth = 1) +
  labs(title = "B. Jakość → Satysfakcja → Lojalność: 5000 prób", x = "Efekt pośredni", y = "Liczba prób") + motyw
p3 <- pA / free(pB) + plot_layout(heights = c(1.7, 1))
p3   # ggsave("ecsi-efekty-posrednie.svg", p3, width = 10, height = 8)
Wynik w R
Wizerunek → Oczekiwania → Wartość → Satysfakcja → Lojalność          0.004 [0.000, 0.008]
Wizerunek → Oczekiwania → Jakość → Wartość → Satysfakcja → Lojalność 0.006 [0.003, 0.010]
Oczekiwania → Wartość → Satysfakcja → Lojalność                      0.010 [0.000, 0.024]
Wizerunek → Oczekiwania → Satysfakcja → Lojalność                    0.013 [-0.001, 0.029]
Oczekiwania → Jakość → Wartość → Satysfakcja → Lojalność             0.018 [0.011, 0.028]
Wizerunek → Oczekiwania → Jakość → Satysfakcja → Lojalność           0.023 [0.014, 0.034]
Oczekiwania → Satysfakcja → Lojalność                                0.038 [-0.002, 0.080]
Jakość → Wartość → Satysfakcja → Lojalność                           0.057 [0.035, 0.084]
Oczekiwania → Jakość → Satysfakcja → Lojalność                       0.067 [0.046, 0.092]
Wizerunek → Satysfakcja → Lojalność                                  0.125 [0.085, 0.168]
Wartość → Satysfakcja → Lojalność                                    0.126 [0.081, 0.176]
Jakość → Satysfakcja → Lojalność                                     0.211 [0.162, 0.261]
             Original Est. 2.5% CI 97.5% CI
WIZ  ->  LOJ         0.310   0.230    0.388
OCZ  ->  LOJ         0.133   0.087    0.185
JAK  ->  LOJ         0.269   0.217    0.320
WAR  ->  LOJ         0.126   0.081    0.176
SAT  ->  LOJ         0.529   0.462    0.595
JAK -> SAT -> LOJ: efekt 0.211 | percentylowy 95% CI [ 0.162 , 0.261 ] | SD bootstrapu 0.025 | skośność 0.11
5. R² i f²: Rysunek 4
R
# Rysunek 4. R² konstruktów endogenicznych i f² każdej ścieżki
# Dane wejściowe: pls, s, nazwy, kol i motyw z przepisu 1.
round(s$paths[c("R^2", "AdjR^2"), ], 3)
f2 <- as.data.frame(as.table(s$fSquare))
names(f2) <- c("od", "do", "f2")
f2 <- f2[pls$path_coef[cbind(as.character(f2$od), as.character(f2$do))] != 0, ]
f2$od <- factor(nazwy[as.character(f2$od)], levels = rev(nazwy))
r2 <- s$paths["R^2", ]
kol_r2 <- c("SAT", "LOJ", "WAR", "OCZ", "JAK")                # kolejność paneli
f2$panel <- factor(sprintf("%s (R² = %s)", nazwy[as.character(f2$do)], sub("^0", "", sprintf("%.2f", r2[as.character(f2$do)]))),
                   levels = sprintf("%s (R² = %s)", nazwy[kol_r2], sub("^0", "", sprintf("%.2f", r2[kol_r2]))))
print(transform(f2[, c("od", "do")], f2 = round(f2$f2, 3)), row.names = FALSE)

# f² z definicji: o ile spada R² satysfakcji bez wartości, w relacji do niewyjaśnionej wariancji
w <- as.data.frame(pls$construct_scores)
r2_pelny <- summary(lm(SAT ~ WIZ + OCZ + JAK + WAR, data = w))$r.squared
r2_bez <- summary(lm(SAT ~ WIZ + OCZ + JAK, data = w))$r.squared
cat("R² SAT:", round(r2_pelny, 3), "| bez WAR:", round(r2_bez, 3),
    "| f² = (", round(r2_pelny, 3), "−", round(r2_bez, 3), ") / (1 −", round(r2_pelny, 3), ") =",
    round((r2_pelny - r2_bez) / (1 - r2_pelny), 3), "\n")

p4 <- ggplot(f2, aes(f2, od)) +
  geom_col(width = 0.6, fill = kol[["blekit"]]) +
  geom_vline(xintercept = c(.02, .15, .35), linetype = "dashed", colour = "grey45") +
  geom_text(aes(label = sub("0\\.", ".", sprintf("%.3f", f2))), hjust = -0.15, size = 3.8) +
  facet_wrap(~ panel, ncol = 3, scales = "free_y") +
  scale_x_continuous(limits = c(0, .45), breaks = c(.02, .15, .35), labels = c(".02", ".15", ".35")) +
  labs(title = "Ile wnosi każda ścieżka? f² w pięciu równaniach modelu",
       x = "f² (linie: umowne progi .02, .15 i .35)", y = NULL) + motyw
p4   # ggsave("ecsi-r2-f2.svg", p4, width = 10, height = 5.2)
Wynik w R
         OCZ   SAT   LOJ   JAK   WAR
R^2    0.118 0.444 0.349 0.100 0.235
AdjR^2 0.116 0.439 0.346 0.098 0.232
          od  do    f2
   Wizerunek OCZ 0.133
 Oczekiwania JAK 0.111
 Oczekiwania WAR 0.008
      Jakość WAR 0.241
   Wizerunek SAT 0.088
 Oczekiwania SAT 0.008
      Jakość SAT 0.208
     Wartość SAT 0.079
   Wizerunek LOJ 0.026
 Satysfakcja LOJ 0.379
R² SAT: 0.444 | bez WAR: 0.4 | f² = ( 0.444 − 0.4 ) / (1 − 0.444 ) = 0.079
6. Mapa ważności i wydajności: Rysunek 5
R
# Rysunek 5. Mapa IPMA dla lojalności: konstrukty (A) i pytania o jakość (B)
# Dane wejściowe: dane, pls, nazwy, pytania, kol i motyw z przepisów 1 i 3.
d100 <- (dane - 1) / (10 - 1) * 100              # odpowiedzi 1–10 przeskalowane na 0–100
W <- pls$outer_weights
wagi <- lapply(setNames(colnames(W), colnames(W)), function(kk) {
  w <- W[W[, kk] != 0, kk]
  w <- w / apply(dane[, names(w)], 2, sd)        # wagi niestandaryzowane
  w / sum(w)                                     # suma wag w konstrukcie = 1
})
wyniki <- as.data.frame(sapply(names(wagi), function(kk) as.matrix(d100[, names(wagi[[kk]])]) %*% wagi[[kk]]))
# Ważność: niestandaryzowany efekt całkowity na LOJ w modelu na wynikach 0–100
P <- pls$path_coef
Bn <- P * 0
for (kk in colnames(P)[colSums(P != 0) > 0]) {
  pred <- rownames(P)[P[, kk] != 0]
  Bn[pred, kk] <- coef(lm(reformulate(pred, kk), data = wyniki))[pred]
}
calkowite <- solve(diag(6) - Bn) - diag(6)       # suma efektów bezpośrednich i wszystkich pośrednich
ipma <- data.frame(k = c("WIZ", "OCZ", "JAK", "WAR", "SAT"))
ipma$waznosc <- calkowite[ipma$k, "LOJ"]
ipma$wydajnosc <- colMeans(wyniki)[ipma$k]
ipma$nazwa <- nazwy[ipma$k]
print(data.frame(konstrukt = ipma$nazwa, waznosc = round(ipma$waznosc, 3), wydajnosc = round(ipma$wydajnosc, 1)),
      row.names = FALSE)
cat("Wydajność lojalności:", round(mean(wyniki$LOJ), 1), "| średnia ważność:", round(mean(ipma$waznosc), 3),
    "| średnia wydajność:", round(mean(ipma$wydajnosc), 1), "\n")
cat("Jakość +10 pkt -> lojalność +", round(10 * ipma$waznosc[ipma$k == "JAK"], 2),
    "pkt | wartość +10 pkt -> lojalność +", round(10 * ipma$waznosc[ipma$k == "WAR"], 2), "pkt\n")

# Pytania o jakość: ważność = efekt całkowity jakości × waga pytania; wydajność = średnia pytania 0–100
pj <- data.frame(poz = names(wagi$JAK), waga = wagi$JAK)
pj$waznosc <- calkowite["JAK", "LOJ"] * pj$waga
pj$wydajnosc <- colMeans(d100[, pj$poz])
pj$nazwa <- pytania[pj$poz]
print(transform(pj[, c("poz", "nazwa")], waga = round(pj$waga, 3), waznosc = round(pj$waznosc, 3),
                wydajnosc = round(pj$wydajnosc, 1)), row.names = FALSE)

mapa <- function(d, tytul) {
  ggplot(d, aes(wydajnosc, waznosc)) +
    geom_hline(yintercept = mean(d$waznosc), linetype = "dashed", colour = "grey55") +
    geom_vline(xintercept = mean(d$wydajnosc), linetype = "dashed", colour = "grey55") +
    geom_point(size = 3.5, colour = kol[["niebieski"]]) +
    ggrepel::geom_text_repel(aes(label = nazwa), size = 4, seed = 625, min.segment.length = 0, box.padding = 0.5) +
    scale_x_continuous(limits = range(d$wydajnosc) + c(-4, 4)) + expand_limits(y = 0) +   # oś ważności od zera
    labs(title = tytul, x = "Wydajność (średnia 0–100)", y = "Ważność (efekt całkowity)") + motyw
}
pA <- mapa(ipma, "A. Konstrukty") +
  annotate("text", x = min(ipma$wydajnosc) - 4, y = max(ipma$waznosc) * 1.05, label = "priorytet:\nważne, słabo oceniane",
           hjust = 0, vjust = 1, size = 3.6, colour = kol[["cynober"]], lineheight = 0.9)
pB <- mapa(pj, "B. Pytania o jakość")
p5 <- pA + pB
p5   # ggsave("ecsi-ipma.svg", p5, width = 10, height = 5.8)
Wynik w R
   konstrukt waznosc wydajnosc
   Wizerunek   0.316      67.2
 Oczekiwania   0.154      72.9
      Jakość   0.254      63.3
     Wartość   0.113      57.9
 Satysfakcja   0.502      69.3
Wydajność lojalności: 65.8 | średnia ważność: 0.268 | średnia wydajność: 66.1
Jakość +10 pkt -> lojalność + 2.54 pkt | wartość +10 pkt -> lojalność + 1.13 pkt
  poz                nazwa  waga waznosc wydajnosc
 jak1             lektorzy 0.260   0.066      70.5
 jak2            materiały 0.248   0.063      62.4
 jak3 grafik i organizacja 0.249   0.063      65.1
 jak4     platforma online 0.244   0.062      54.7
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("pomarańczowy – niebieski (satysfakcja / lojalność)" = c("#E69F00", "#0072B2"),
             "niebieski – cynober (przedziały / oszacowanie)" = c("#0072B2", "#D55E00"),
             "błękit – biały (HTMT, f²)" = c("#56B4E9", "#FFFFFF"),
             "grafit – szary (strzałki istotne / nieistotne)" = c("#262626", "#8C8C8C"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                   widzenie_typowe deuteranopia
pomarańczowy – niebieski (satysfakcja / lojalność)           120.2        121.5
niebieski – cynober (przedziały / oszacowanie)               114.6        108.3
błękit – biały (HTMT, f²)                                     47.6         49.9
grafit – szary (strzałki istotne / nieistotne)                43.1         43.1
czerwony – zielony (do unikania)                             121.7         21.1
                                                   protanopia
pomarańczowy – niebieski (satysfakcja / lojalność)      109.3
niebieski – cynober (przedziały / oszacowanie)           91.9
błękit – biały (HTMT, f²)                                41.5
grafit – szary (strzałki istotne / nieistotne)           43.1
czerwony – zielony (do unikania)                         31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Model PLS-SEM, bootstrap, rzetelność, HTMT i f² oszacowano pakietem seminr, regresje do IPMA – funkcją lm() (pakiet stats). Rysunki wykonano w ggplot2, etykiety rozmieszczono pakietem ggrepel, panele złożono pakietem patchwork, a pliki SVG zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seminr (wersja 2.5.0): Ray, S., Danks, N., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models (R package version 2.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.seminr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różni się model ECSI od modelu ACSI?
Oba modele indeksów satysfakcji stawiają satysfakcję w środku łańcucha: poprzedzają ją oczekiwania, jakość postrzegana i wartość, a jej skutkiem jest lojalność. Europejska wersja (ECSI) ma dodatkowo wizerunek firmy, który wpływa na oczekiwania, satysfakcję i lojalność. W pracy dyplomowej zwykle korzysta się z uproszczonej wersji, np. bez konstruktu skarg, i trzeba to jasno opisać.
Jak policzyć efekt pośredni satysfakcji w modelu lojalności klientów?
Efekt pośredni to iloczyn ścieżek, np. jakość → satysfakcja razy satysfakcja → lojalność. Przedział ufności wyznacz bootstrapem: policz ten iloczyn w każdej z kilku tysięcy prób i weź 2.5 i 97.5 percentyl. W przykładzie z ankietą szkoły językowej efekt jakości przez satysfakcję wyniósł 0.211, 95% CI [0.162, 0.261]. Zob. efekt pośredni.
Jak odczytać mapę IPMA dla lojalności klientów?
Na osi poziomej jest wydajność – średnia ocena konstruktu na skali 0–100, na pionowej ważność – niestandaryzowany efekt całkowity na lojalność. Priorytetem są elementy ważne i słabo oceniane. Ćwiartki wyznaczają średnie z punktów na mapie, więc zależą od tego, jakie konstrukty na nią włożysz; satysfakcję, która jest wynikiem, warto czytać osobno.
Czy model PLS-SEM dowodzi, że jakość usług powoduje lojalność?
Nie. Kierunek strzałek pochodzi z teorii, a dane z jednej ankiety pasowałyby podobnie do modelu z odwrotnymi strzałkami. Model pokazuje, jak dane zgadzają się z założonym łańcuchem. Wnioski przyczynowe wymagają eksperymentu lub danych z kilku pomiarów w czasie.
Dlaczego PLS-SEM daje mniejsze współczynniki ścieżek niż prawdziwe?
Kompozyt to ważona suma pytań, która zawiera błąd pomiaru, a błąd osłabia związki między konstruktami. W symulacji z tego wpisu ścieżka satysfakcja → lojalność wynosiła w danych .60, a PLS-SEM oszacował 0.529. Jeśli konstrukty traktujesz jak czynniki wspólne, rozważ korektę PLSc.
Powiązane hasła
Przeczytaj też
PLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikPLS-SEM w R: seminr i cSEM
Kompletny przykład z mediacją: model pomiarowy i strukturalny, bootstrap, PLSpredict, consistent PLS i test dopasowania – z danymi, kodem i opisem APA.
Czytaj →PoradnikKluczowe czynniki satysfakcji
Ankieta gości hotelu: korelacje, β przy współliniowości, wagi względne i dominacja, macierz ważność–ocena i bootstrap rankingu z kodem R.
Czytaj →PoradnikNiezmienność skali marki w trzech krajach
Zaufanie do marki w Polsce, Czechach i na Słowacji: wielogrupowa CFA, częściowa niezmienność, średnie latentne kontra sumy i symulacja – pięć rysunków z R.
Czytaj →Model satysfakcji i lojalności w pracy z marketingu?
Pomożemy zbudować kwestionariusz, oszacować model PLS-SEM, policzyć efekty pośrednie i mapę IPMA oraz opisać wyniki z tabelą i diagramem – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cassel, C., & Eklöf, J. A. (2001). Modelling customer satisfaction and loyalty on aggregate levels: Experience from the ECSI pilot study. Total Quality Management, 12(7–8), 834–841. https://doi.org/10.1080/09544120100000004
- Fornell, C., Johnson, M. D., Anderson, E. W., Cha, J., & Bryant, B. E. (1996). The American Customer Satisfaction Index: Nature, purpose, and findings. Journal of Marketing, 60(4), 7–18. https://doi.org/10.1177/002224299606000403
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8 ● Otwarty dostęp
- Nitzl, C., Roldán, J. L., & Cepeda, G. (2016). Mediation analysis in partial least squares path modeling: Helping researchers discuss more sophisticated models. Industrial Management & Data Systems, 116(9), 1849–1864. https://doi.org/10.1108/imds-07-2015-0302 ● Otwarty dostęp: pełny tekst
- Ringle, C. M., & Sarstedt, M. (2016). Gain more insight from your PLS-SEM results. Industrial Management & Data Systems, 116(9), 1865–1886. https://doi.org/10.1108/imds-10-2015-0449
Cytowania BibTeX
@article{cassel2001modelling, author={Cassel, Claes and Eklöf, Jan A.}, title={{Modelling customer satisfaction and loyalty on aggregate levels: Experience from the ECSI pilot study}}, journal={Total Quality Management}, year={2001}, volume={12}, number={7–8}, pages={834--841}, doi={10.1080/09544120100000004}}@article{fornell1996american, author={Fornell, Claes and Johnson, Michael D. and Anderson, Eugene W. and Cha, Jaesung and Bryant, Barbara Everitt}, title={{The American Customer Satisfaction Index: Nature, purpose, and findings}}, journal={Journal of Marketing}, year={1996}, volume={60}, number={4}, pages={7--18}, doi={10.1177/002224299606000403}}@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{henseler2015new, author={Henseler, Jörg and Ringle, Christian M. and Sarstedt, Marko}, title={{A new criterion for assessing discriminant validity in variance-based structural equation modeling}}, journal={Journal of the Academy of Marketing Science}, year={2015}, volume={43}, number={1}, pages={115--135}, doi={10.1007/s11747-014-0403-8}}@article{nitzl2016mediation, author={Nitzl, Christian and Roldán, José L. and Cepeda, Gabriel}, title={{Mediation analysis in partial least squares path modeling: Helping researchers discuss more sophisticated models}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={9}, pages={1849--1864}, doi={10.1108/imds-07-2015-0302}}@article{ringle2016gain, author={Ringle, Christian M. and Sarstedt, Marko}, title={{Gain more insight from your PLS-SEM results}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={9}, pages={1865--1886}, doi={10.1108/imds-10-2015-0449}}