Przykład: marka Mewa i osiem fal badania
Fikcyjna marka napojów owsianych Mewa co kwartał pyta internautów o siebie. To badanie trackingowe (ang. brand tracking): te same pytania, nowa próba w każdej fali – 8 fal od I kwartału 2024 (F1) do IV kwartału 2025 (F8), łącznie 4021 osób, od 485 do 516 w fali. Kluczowe wskaźniki to świadomość marki („Które z tych marek znasz choćby ze słyszenia?”) i rozważanie zakupu. Są też zakup w ostatnim miesiącu i trzy oceny marki. Przed falą 6 ruszyła kampania. Dział marketingu pyta: czy świadomość wzrosła i od której fali wolno to ogłosić?
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy prawdziwe odsetki w populacji: świadomość 40% w F1–F5 i 49% od F6 (skutek kampanii), rozważanie rosnące powoli od 17% o 0.8 punktu procentowego (pp) na falę, zakup 9% z sezonowym szczytem 13% w III kwartale, trzy oceny marki stałe (31%, 24% i 14%). Panel internetowy ma za dużo młodych, kobiet i mieszkańców dużych miast (np. 42% osób w wieku 18–34 lat wobec 27% w populacji), a wszystkie wskaźniki są w tych grupach wyższe. Ziarno 633 ustalono raz; ani jego, ani parametrów nie zmienialiśmy po obejrzeniu wyników. Dane pobierzesz jako badanie-trackingowe-marki-fale.csv (wiersz = respondent, z wagą).
Rysunek 1: odsetki w falach i koszt ważenia
Bez wag wynik jest zawyżony: świadomość w F1 wynosi 46.6% wobec 40% w populacji, bo w próbie jest za dużo młodych. Dlatego każdą falę ważymy osobno metodą rakingu, czyli kalibracji do znanych rozkładów wieku, płci i miejsca zamieszkania (Haziza i Beaumont, 2017). Budowę wag opisuje wpis ważenie danych sondażowych; tu liczy się jej koszt.
Wagi wynoszą od 0.31 do 4.70. Zróżnicowane wagi zmniejszają precyzję: mówi o tym efekt schematu (deff), czyli iloraz wariancji oszacowania w danym schemacie i w prostej próbie losowej tej samej wielkości (Kish, 1965). Efektywna liczebność to nef = n / deff:
SE z wagami liczy pakiet survey metodą linearyzacji (Lumley, 2004). Szybkie przybliżenie Kisha, 1 + CV² wag, daje w naszych falach deff od 1.35 do 1.59 (średnio 1.48). Deff z linearyzacji jest mniejszy: średnio 1.24 dla świadomości i 1.09 dla rozważania. Wzór Kisha liczy sam koszt wag, a raking na zmiennych związanych ze wskaźnikiem częściowo ten koszt odzyskuje. Deff z jednej fali jest przy tym niestabilny (dla świadomości od 1.03 do 1.58), więc w raporcie podawaj średni.
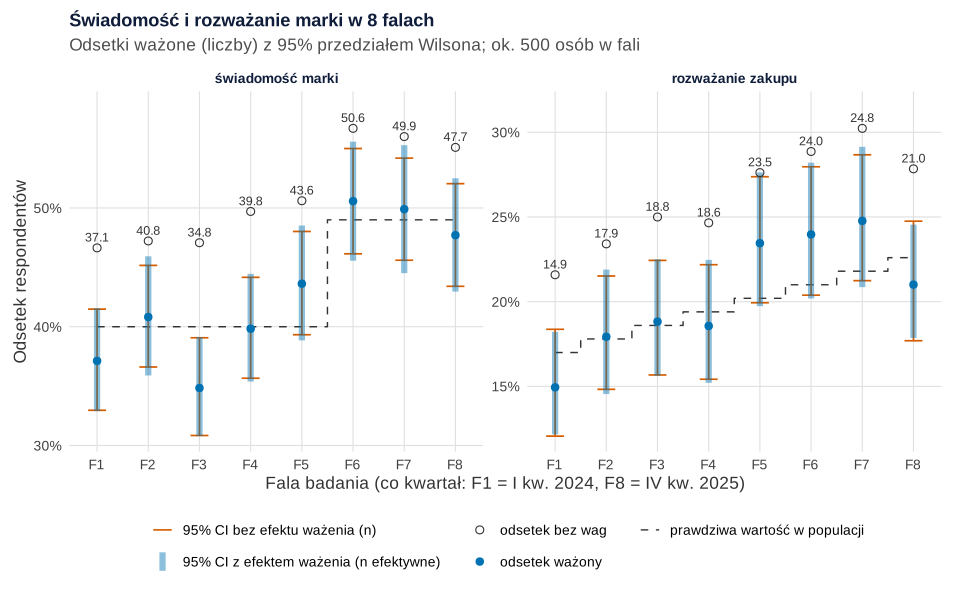
set.seed(633)).Co widać. Puste kółka (bez wag) leżą stale nad prawdą – dla świadomości o 6.1–12.2 pp. Ważenie sprowadza wyniki w okolice przerywanej linii. Przedział z efektem ważenia jest szerszy od naiwnego, ale niewiele: dla wszystkich sześciu wskaźników średnio 7.61 wobec 7.07 pp. Brown i in. (2001) zalecają przedział Wilsona zamiast wzoru Walda (zob. przedział ufności dla proporcji).
Jak może zmylić. Wagi naprawiają skład próby tylko w zmiennych ważenia. W prawdziwym panelu internetowym samoselekcja może obciążać wyniki mimo ważenia (Bethlehem, 2010). Przedziały opisują tylko błąd losowy – jak margines błędu w sondażu, o którym więcej we wpisie sondaż w obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: czy zmiana fala do fali jest istotna?
Dwie fale to dwie niezależne próby. Różnicę odsetków dzielimy przez jej błąd standardowy, w którym siedzą SE obu fal (już z efektem ważenia):
To test dla dwóch proporcji z SE z linearyzacji. Przy małych próbach lepszy jest przedział Newcombe’a, zbudowany z przedziałów Wilsona obu odsetków (Newcombe, 1998).
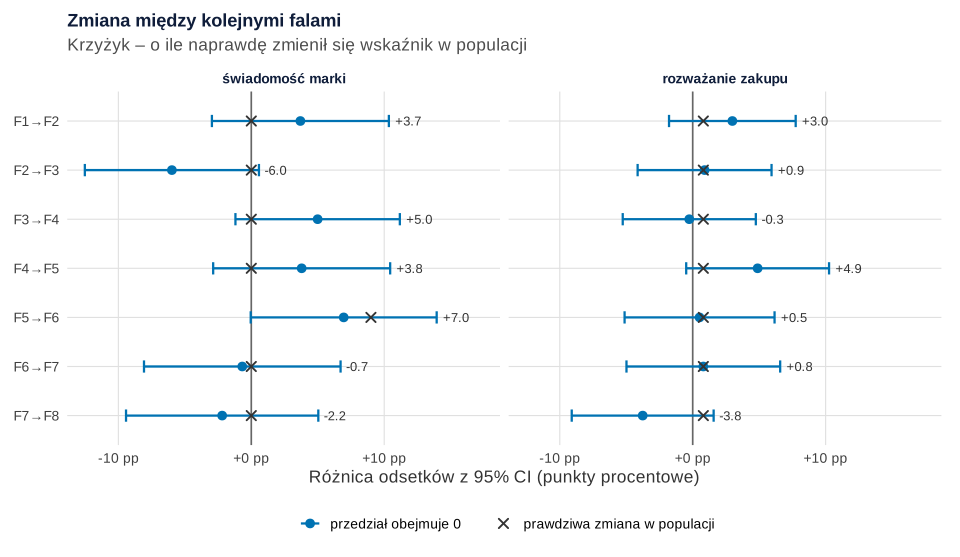
Co widać. Żaden z 14 przedziałów nie wyklucza zera. Także skok po kampanii: świadomość F5→F6 wzrosła o 7.0 pp, 95% CI [−0.04, 13.9], p = .051, choć prawdziwy wzrost to 9 pp. Rozważanie rośnie naprawdę w każdej fali, ale o 0.8 pp – ta zmiana ginie w przedziałach, których połowa szerokości to średnio 5.3 pp. Największa zmiana rozważania, F4→F5, to +4.9 pp [−0.5, 10.3].
Jak może zmylić. Przy ok. 500 osobach w fali przedział różnicy sięga średnio ±6.8 pp dla świadomości, więc porównanie sąsiednich fal wychwytuje tylko duże skoki. Brak istotności nie znaczy „brak zmiany”, a p = .051 nie znaczy „prawie efekt” (zob. p = .06 – trend czy brak efektu).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: trend przez wszystkie fale
Zamiast siedmiu porównań par zapytaj: czy wskaźnik rośnie przez całe badanie? Odpowiada regresja logistyczna z numerem fali jako predyktorem, z wagami i SE z linearyzacji (w R: svyglm()).
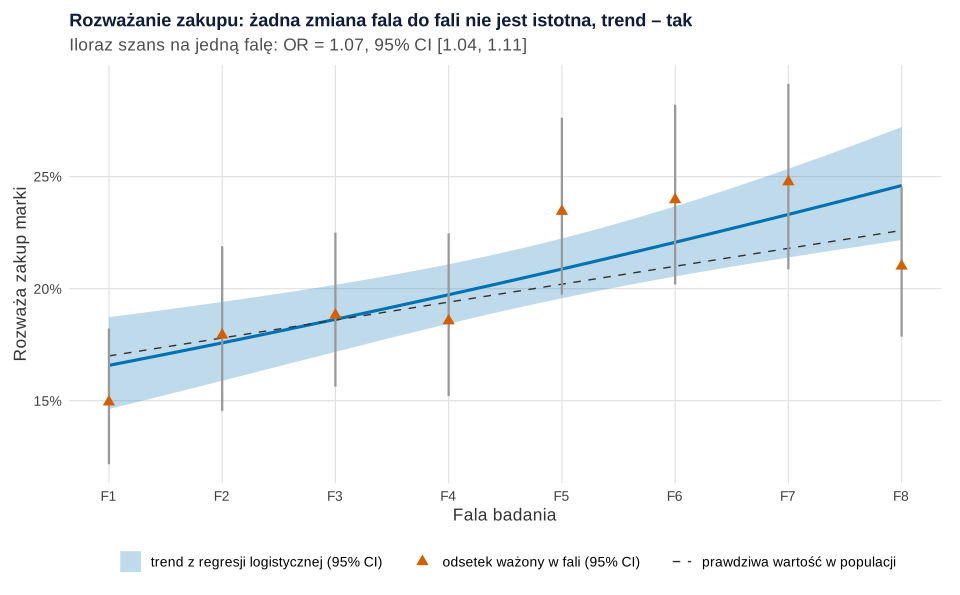
Co widać. Iloraz szans na falę: OR = 1.07, 95% CI [1.04, 1.11], p < .001. Według modelu rozważanie wzrosło z 16.6% [14.6, 18.7] w F1 do 24.6% [22.2, 27.2] w F8. Prawdziwy wzrost to 17% → 22.6%: model trochę go przecenia, bo ostatnie fale wypadły wysoko przypadkiem, ale kierunek jest trafny.
Jak może zmylić. Prosta linia na skali logitu zakłada stałe tempo zmian. Świadomość nie rośnie równo, tylko skacze po kampanii. Dla niej lepszy jest model „przed i po”: F1–F5 średnio 39.2%, F6–F8 – 49.4%, różnica +10.1 pp, 95% CI [6.6, 13.7], OR = 1.51, p < .001. Postać modelu ustal przed zobaczeniem wyników.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: średnia krocząca a opóźnienie
Raporty trackingowe często pokazują średnią ruchomą (kroczącą) z kilku fal, żeby wygładzić skoki.
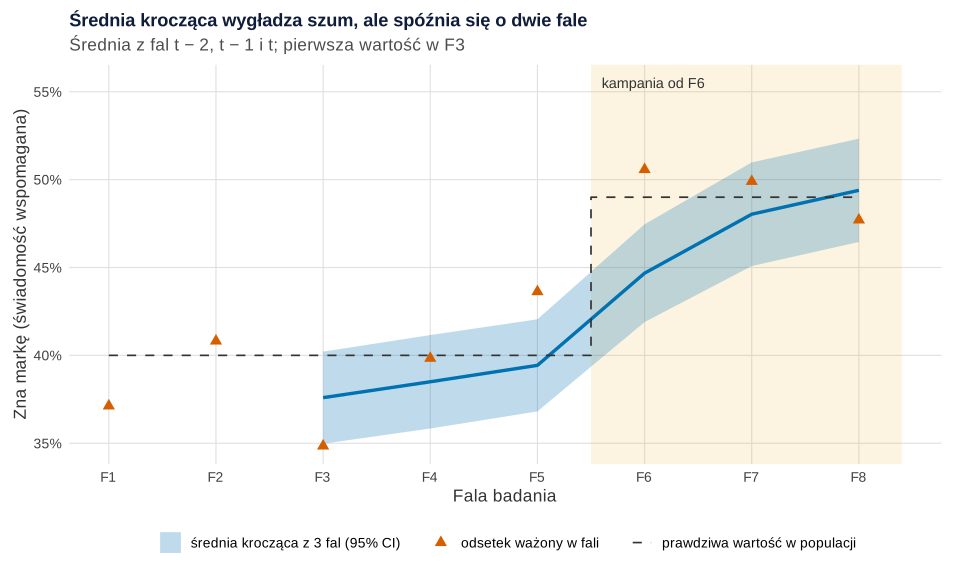
Co widać. Średnia krocząca ma przedział o szerokości średnio 5.5 pp zamiast 9.6 pp dla pojedynczej fali. Po kampanii pokazuje jednak tylko część skoku: 52% w F6, 89% w F7 i całość dopiero w F8 (49.4%). Wzrost zostałby ogłoszony o dwa kwartały za późno.
Jak może zmylić. Średnia z fal 4–6 miesza dwa okresy, więc zmiana „rozlewa się” w czasie. Sąsiednie średnie mają wspólne fale – ich różnic nie testuj jak niezależnych prób. Do porównań używaj pojedynczych fal albo rozłącznych okresów (F1–F5 vs F6–F8).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: sześć wskaźników, siedem porównań, dużo fałszywych alarmów
Sześć wskaźników × 7 par sąsiednich fal to 42 testy – problem wielokrotnych porównań. W naszych danych 5 z nich ma p < .05: zakup F2→F3 (+7.4 pp, p < .001) i F3→F4 (−5.7 pp, p = .003), „dobra jakość” F5→F6 (+8.3 pp) i F6→F7 (−8.8 pp) oraz „marka dla ludzi jak ja” F6→F7 (+6.5 pp). Trzy ostatnie to fałszywe alarmy – te oceny były stałe. Po poprawce Holma i po procedurze Benjaminiego–Hochberga, która kontroluje odsetek fałszywych odkryć (Benjamini i Hochberg, 1995), zostaje jedna zmiana: zakup F2→F3 (skorygowane p = .004).
Ile alarmów daje sam przypadek, sprawdziliśmy w 1000 symulowanych badaniach z tym samym panelem i ważeniem, w których żaden wskaźnik się nie zmieniał.
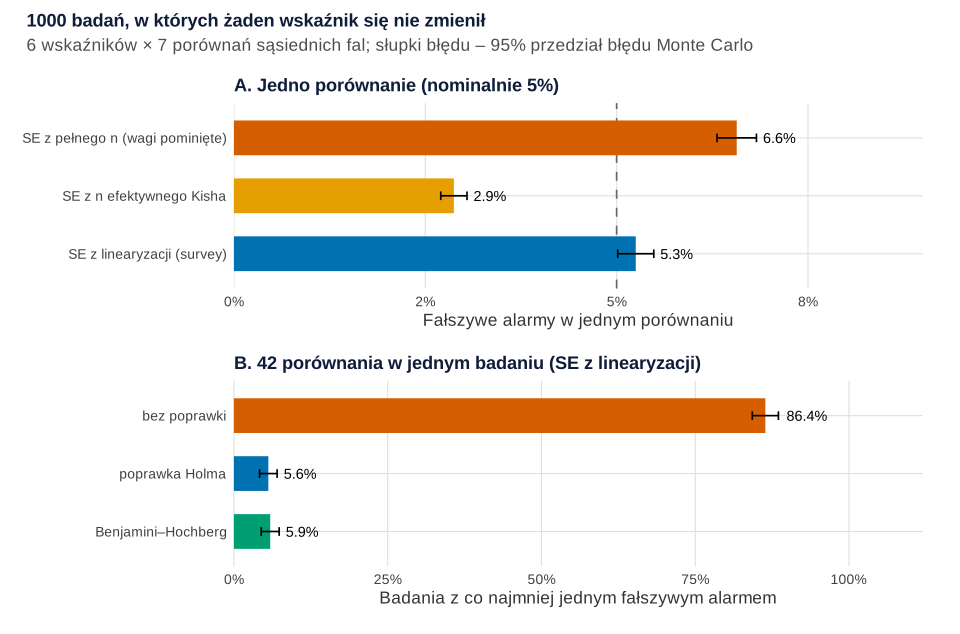
set.seed(633)).Co widać. Panel A: pojedyncze porównanie z SE z linearyzacji daje 5.3% fałszywych alarmów (błąd Monte Carlo 0.1 pp), czyli prawie nominalne 5%. Pominięcie wag w SE daje 6.6%, a wzór Kisha – tylko 2.9%, bo zawyża deff (1.44 wobec 1.12 z linearyzacji). Panel B: w 86.4% badań przynajmniej jedno z 42 porównań „wykryło” zmianę, której nie było. Poprawka Holma obniża ten odsetek do 5.6%, a BH – do 5.9%.
Jak może zmylić. Poprawka zmniejsza też moc: w naszych danych prawdziwy spadek zakupu F3→F4 (−4 pp w populacji) po poprawce Holma przestał być istotny. Mniej testów to lepsza obrona niż ostrzejszy próg – stąd model trendu zamiast 42 par. Ale także sześć testów trendu wymaga poprawki: bez niej „rośnie” również zakup (p = .018) i „marka dla ludzi jak ja” (p = .049), choć w populacji ocena była stała, a zakup miał tylko sezonowe szczyty.
Podpis do pracy:
Zdanie do Metody:
Sezonowość i zmiana metody między falami
Sezon. Zakup w ostatnim miesiącu wzrósł z F2 do F3 o 7.4 pp, 95% CI [3.7, 11.1] – to jedyna zmiana, która przetrwała poprawkę. Ale F3 to III kwartał, a w naszych danych zakup ma w III kwartale sezonowy szczyt (tak go ustaliliśmy). Porównanie rok do roku (III kw. 2025 wobec III kw. 2024) daje −1.3 pp [−5.6, 3.0], p = .558. Przy sezonowości porównuj ten sam kwartał rok do roku albo modeluj sezon wprost, jak w prognozie sprzedaży.
Nowy kwestionariusz albo nowy panel. Dopisanie marki do listy, logotypy zamiast nazw, inna kolejność pytań czy zmiana dostawcy panelu przesuwają wynik niezależnie od rynku. Gdy zmiana jest nieunikniona, zrób falę pomostową: połowa próby dostaje stary kwestionariusz, połowa nowy, a różnica mierzy efekt zmiany. W panelu, w którym te same osoby odpowiadają wielokrotnie, dochodzi efekt warunkowania panelowego: samo udzielanie odpowiedzi może zmieniać kolejne odpowiedzi, a wtedy błędnie opisuje się zmiany między falami (Warren i Halpern-Manners, 2012).
Rysunek 6: kiedy ogłosić zmianę
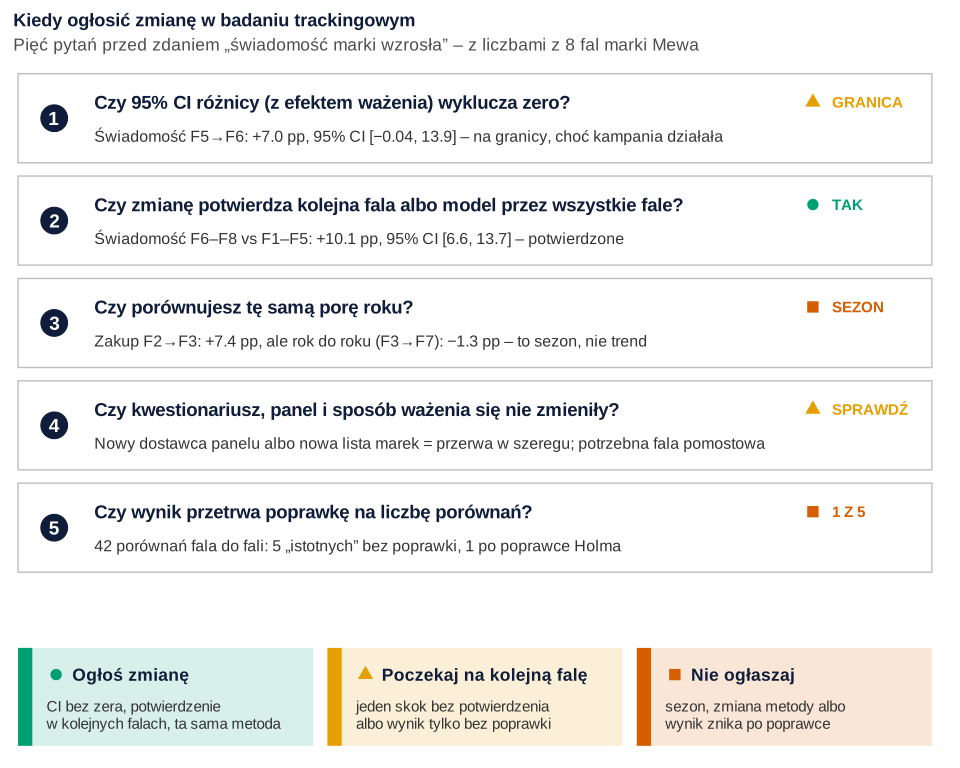
Co widać. Pięć pytań przed zdaniem „świadomość wzrosła” i trzy werdykty. W naszym przykładzie wzrost świadomości po kampanii przechodzi pytania 2 i 4, a sama różnica F5→F6 jest na granicy. Właściwa odpowiedź po fali 6 brzmiała więc „poczekaj na falę 7”; po falach 7 i 8 – „ogłoś”.
Jak może zmylić. Karta nie zastępuje planu analizy: wskaźniki główne, model i poprawkę spisz przed pierwszą falą.
Co z tym zrobić w marketingu
- Wybierz 1–2 wskaźniki główne (tu: świadomość i rozważanie) i tylko dla nich formułuj wnioski.
- Ogłaszaj zmianę dopiero po potwierdzeniu (kolejna fala albo model przez wszystkie fale). Skok oceny „dobra jakość” o 8.3 pp był przypadkiem.
- Porównuj ten sam kwartał rok do roku przy wskaźnikach sezonowych, np. zakupie.
- Nie zmieniaj kwestionariusza ani panelu w trakcie kampanii (gdy musisz – fala pomostowa).
- Tracking nie mierzy efektu kampanii. Efekt przyczynowy daje badanie brand lift z grupą kontrolną. Ciągłe monitorowanie wskaźników i alarmy opisuje wpis anomalie w KPI – karta kontrolna, a wskaźnik NPS w kolejnych pomiarach – wpis NPS na obrazkach.
Jak opisać w pracy
W Metodzie podaj źródło próby, liczebność fal, zmienne i metodę ważenia, zakres wag, deff, sposób liczenia SE i plan porównań z poprawką. W Ograniczeniach napisz, że próba jest nielosowa, a ważenie nie usuwa obciążenia z cech spoza modelu wag.
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Kod R: tracking z wagami, trend i symulacja
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane i schemat po rakingu, z których korzystają kolejne. Wagi, błędy standardowe i regresję logistyczną liczy pakiet survey (rake(), svyby(), svyglm()). Przepisy z rysunkiem kończą się nazwą wykresu (p1–p6); zapis do SVG – ggsave() z komentarza. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane) i 5 (symulacja); oba zaczynają się od własnego set.seed(633). Ziarno 633 ustalono raz i nie zmieniano go. Ręcznie ustalono: udziały wieku, płci i miejsca zamieszkania w populacji i w panelu, efekty tych cech na skali logitu (+0.6 dla 18–34 lat, −0.6 dla 55+, +0.2 dla kobiet, −0.3 dla wsi, +0.4 dla miast od 100 tys.), prawdziwe odsetki sześciu wskaźników w 8 falach, liczebność fali (480–520) oraz okno średniej kroczącej (3 fale). Parametrów nie zmieniano po obejrzeniu wyników.
1. Dane, wagi i odsetki z przedziałami: Rysunek 1
R
# Rysunek 1. Fikcyjna marka napojów owsianych „Mewa”: 8 fal badania trackingowego, wagi i odsetki z przedziałami
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Populacja dorosłych (udziały ustalone ręcznie; zakładamy niezależność trzech cech)
pop <- list(wiek = c("18–34" = .27, "35–54" = .35, "55+" = .38),
            plec = c(K = .53, M = .47),
            miejsce = c("wieś" = .40, "miasto do 100 tys." = .32, "miasto 100 tys.+" = .28))
# Panel internetowy: za dużo młodych, kobiet i mieszkańców dużych miast (ustalone ręcznie)
panel <- list(wiek = c(.42, .38, .20), plec = c(.60, .40), miejsce = c(.25, .33, .42))
komorki <- expand.grid(wiek = names(pop$wiek), plec = names(pop$plec), miejsce = names(pop$miejsce),
                       stringsAsFactors = FALSE)
komorki$udzial_pop <- pop$wiek[komorki$wiek] * pop$plec[komorki$plec] * pop$miejsce[komorki$miejsce]
komorki$udzial_panel <- with(komorki, panel$wiek[match(wiek, names(pop$wiek))] *
                               panel$plec[match(plec, names(pop$plec))] * panel$miejsce[match(miejsce, names(pop$miejsce))])
# Wszystkie wskaźniki są wyższe u młodszych, kobiet i w dużych miastach (efekty na skali logitu, ręcznie)
efekt <- with(komorki, c("18–34" = 0.6, "35–54" = 0, "55+" = -0.6)[wiek] + c(K = 0.2, M = 0)[plec] +
                c("wieś" = -0.3, "miasto do 100 tys." = 0, "miasto 100 tys.+" = 0.4)[miejsce])

# Prawdziwe odsetki w populacji (%, ustalone ręcznie): kampania przed falą 6 podnosi świadomość o 9 pp,
# rozważanie rośnie powoli o 0.8 pp na falę, zakup ma szczyt w III kwartale, trzy oceny marki stoją w miejscu
prawda <- rbind(swiadomosc = c(40, 40, 40, 40, 40, 49, 49, 49),
                rozwazanie = 17 + 0.8 * 0:7,
                zakup      = c(9, 9, 13, 9, 9, 9, 13, 9),
                jakosc     = rep(31, 8), cena = rep(24, 8), dla_mnie = rep(14, 8))
nazwy <- c(swiadomosc = "świadomość marki", rozwazanie = "rozważanie zakupu", zakup = "zakup w ostatnim miesiącu",
           jakosc = "„dobra jakość”", cena = "„rozsądna cena”", dla_mnie = "„marka dla ludzi jak ja”")
fale <- data.frame(fala = 1:8, kwartal = paste(rep(c("I", "II", "III", "IV"), 2), "kw.", rep(2024:2025, each = 4)))
# Wyraz wolny dla każdego wskaźnika i fali tak, by odsetek w populacji był równy prawdziwemu
wyraz <- apply(prawda / 100, 1:2, function(docelowy)
  uniroot(function(a) sum(komorki$udzial_pop * plogis(a + efekt)) - docelowy, c(-8, 8))$root)

# Przedział Wilsona dla odsetka p przy liczebności n (tu: efektywnej)
wilson <- function(p, n, z = qnorm(.975)) {
  srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  cbind(dol = srodek - pol, gora = srodek + pol)
}

set.seed(633)                                   # ziarno ustalone raz, bez dobierania pod wynik
dane <- do.call(rbind, lapply(1:8, function(f) {
  n <- sample(480:520, 1)                       # n ≈ 500 w każdej fali
  d <- komorki[sample(nrow(komorki), n, replace = TRUE, prob = komorki$udzial_panel), c("wiek", "plec", "miejsce")]
  e <- efekt[as.integer(rownames(d))]
  for (w in rownames(prawda)) d[[w]] <- rbinom(n, 1, plogis(wyraz[w, f] + e))
  cbind(fala = f, kwartal = fale$kwartal[f], d)
}))
rownames(dane) <- NULL

# Raking w każdej fali osobno: rozkłady wieku, płci i miejsca zamieszkania jak w populacji (pakiet survey)
library(survey)
n_fali <- table(dane$fala)
cel <- function(v) {                            # liczebności docelowe: fala × kategoria
  x <- expand.grid(fala = 1:8, k = names(pop[[v]]), stringsAsFactors = FALSE)
  x$Freq <- as.numeric(n_fali[as.character(x$fala)]) * pop[[v]][x$k]
  names(x)[2] <- v; x
}
schemat0 <- svydesign(ids = ~1, strata = ~fala, weights = ~1, data = dane)
schemat <- rake(schemat0, list(~fala + wiek, ~fala + plec, ~fala + miejsce),
                list(cel("wiek"), cel("plec"), cel("miejsce")), control = list(maxit = 50, epsilon = 1e-8))
dane$waga <- round(weights(schemat), 4)
write.csv(dane, "badanie-trackingowe-marki-fale.csv", row.names = FALSE)

# Koszt samych wag w każdej fali: deff Kisha = 1 + CV² wag, n efektywne Kisha = (Σw)² / Σw²
koszt <- do.call(rbind, lapply(split(weights(schemat), dane$fala), function(w)
  data.frame(n = length(w), waga_min = min(w), waga_max = max(w), deff_kish = 1 + mean((w - mean(w))^2) / mean(w)^2,
             n_ef_kish = sum(w)^2 / sum(w^2))))
print(transform(koszt, waga_min = round(waga_min, 2), waga_max = round(waga_max, 2),
                deff_kish = round(deff_kish, 2), n_ef_kish = round(n_ef_kish)))

# Odsetki ważone w każdej fali: SE z linearyzacji (uwzględnia raking), deff = SE² / SE² prostej próby,
# n efektywne = n / deff; przedział Wilsona na n efektywnym i – dla porównania – na pełnym n
odsetki <- do.call(rbind, lapply(names(nazwy), function(w) {
  e <- svyby(as.formula(paste0("~", w)), ~fala, schemat, svymean)
  p <- coef(e); se <- SE(e); n <- as.numeric(n_fali)
  deff <- se^2 / (p * (1 - p) / n)
  data.frame(wskaznik = w, fala = 1:8, bez_wag = tapply(dane[[w]], dane$fala, mean), p, se, n, deff,
             n_ef = n / deff, wilson(p, n / deff), naiwny = wilson(p, n), prawda = prawda[w, ] / 100)
}))
rownames(odsetki) <- NULL
pokaz <- function(x) transform(x, bez_wag = round(100 * bez_wag, 1), p = round(100 * p, 1), se = round(100 * se, 2),
                               deff = round(deff, 2), n_ef = round(n_ef), dol = round(100 * dol, 1),
                               gora = round(100 * gora, 1), naiwny.dol = round(100 * naiwny.dol, 1),
                               naiwny.gora = round(100 * naiwny.gora, 1), prawda = 100 * prawda)
print(pokaz(odsetki[odsetki$wskaznik %in% c("swiadomosc", "rozwazanie"), ]), row.names = FALSE)
# Łączna liczebność i o ile odsetek bez wag zawyża świadomość (pp, najmniej i najwięcej)
s1 <- odsetki[odsetki$wskaznik == "swiadomosc", ]
c(N = nrow(dane), round(100 * range(s1$bez_wag - s1$p), 1))
# Średni deff każdego wskaźnika (z linearyzacji) wobec średniego deff Kisha
round(c(tapply(odsetki$deff, odsetki$wskaznik, mean)[names(nazwy)], kish = mean(koszt$deff_kish)), 2)
# Średnia szerokość 95% przedziału (pp): z n efektywnym i z pełnym n
round(100 * c(z_efektem_wazenia = mean(odsetki$gora - odsetki$dol),
              bez_efektu = mean(odsetki$naiwny.gora - odsetki$naiwny.dol)), 2)

d1 <- odsetki[odsetki$wskaznik %in% c("swiadomosc", "rozwazanie"), ]
d1$panel <- factor(nazwy[d1$wskaznik], nazwy[c("swiadomosc", "rozwazanie")])
p1 <- ggplot(d1, aes(fala)) +
  geom_step(aes(y = prawda, linetype = "prawdziwa wartość w populacji"), colour = kol[["ciemny"]],
            direction = "mid", linewidth = 0.5) +
  geom_errorbar(aes(ymin = naiwny.dol, ymax = naiwny.gora, colour = "95% CI bez efektu ważenia (n)"),
                width = 0.35, linewidth = 0.6) +
  geom_linerange(aes(ymin = dol, ymax = gora, colour = "95% CI z efektem ważenia (n efektywne)"),
                 linewidth = 2.2, alpha = 0.45) +
  geom_point(aes(y = bez_wag, shape = "odsetek bez wag"), colour = kol[["ciemny"]], size = 2.4) +
  geom_point(aes(y = p, shape = "odsetek ważony"), colour = kol[["niebieski"]], size = 2.6) +
  geom_text(aes(y = pmax(gora, naiwny.gora, bez_wag), label = sprintf("%.1f", 100 * p)), vjust = -0.7,
            size = 3.3, colour = "grey20") +
  facet_wrap(~panel, ncol = 2, scales = "free_y") +
  scale_colour_manual(values = c("95% CI z efektem ważenia (n efektywne)" = kol[["niebieski"]],
                                 "95% CI bez efektu ważenia (n)" = kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c("odsetek ważony" = 16, "odsetek bez wag" = 1), name = NULL) +
  scale_linetype_manual(values = c("prawdziwa wartość w populacji" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = 1:8, labels = paste0("F", 1:8)) +
  scale_y_continuous(labels = scales::label_percent(accuracy = 1), expand = expansion(mult = c(0.05, 0.12))) +
  labs(x = "Fala badania (co kwartał: F1 = I kw. 2024, F8 = IV kw. 2025)", y = "Odsetek respondentów",
       title = "Świadomość i rozważanie marki w 8 falach",
       subtitle = "Odsetki ważone (liczby) z 95% przedziałem Wilsona; ok. 500 osób w fali") +
  motyw + guides(colour = guide_legend(nrow = 2, order = 1), shape = guide_legend(nrow = 2, order = 2),
                 linetype = guide_legend(order = 3))
p1   # zapis: ggsave("badanie-trackingowe-odsetki-w-falach.svg", p1, width = 10, height = 6)
Wynik w R
    n waga_min waga_max deff_kish n_ef_kish
1 491     0.41     4.37      1.44       340
2 504     0.38     4.15      1.57       321
3 512     0.31     4.70      1.59       322
4 507     0.32     4.18      1.54       330
5 496     0.39     3.41      1.37       362
6 485     0.43     3.31      1.39       348
7 516     0.41     4.46      1.55       333
8 510     0.41     3.00      1.35       377
   wskaznik fala bez_wag    p   se   n deff n_ef  dol gora naiwny.dol
 swiadomosc    1    46.6 37.1 2.22 491 1.04  474 32.9 41.6       33.0
 swiadomosc    2    47.2 40.8 2.57 504 1.38  366 35.9 45.9       36.6
 swiadomosc    3    47.1 34.8 2.14 512 1.03  498 30.8 39.1       30.8
 swiadomosc    4    49.7 39.8 2.32 507 1.14  444 35.4 44.5       35.7
 swiadomosc    5    50.6 43.6 2.48 496 1.24  400 38.9 48.5       39.3
 swiadomosc    6    56.7 50.6 2.57 485 1.28  379 45.6 55.6       46.1
 swiadomosc    7    56.0 49.9 2.76 516 1.58  327 44.5 55.3       45.6
 swiadomosc    8    55.1 47.7 2.45 510 1.22  417 43.0 52.5       43.4
 rozwazanie    1    21.6 14.9 1.54 491 0.92  533 12.2 18.2       12.1
 rozwazanie    2    23.4 17.9 1.88 504 1.21  418 14.5 21.9       14.8
 rozwazanie    3    25.0 18.8 1.76 512 1.03  496 15.6 22.5       15.7
 rozwazanie    4    24.7 18.6 1.85 507 1.15  440 15.2 22.5       15.4
 rozwazanie    5    27.6 23.5 2.02 496 1.13  440 19.7 27.6       19.9
 rozwazanie    6    28.9 24.0 2.05 485 1.12  433 20.2 28.2       20.4
 rozwazanie    7    30.2 24.8 2.12 516 1.24  415 20.9 29.1       21.2
 rozwazanie    8    27.8 21.0 1.71 510 0.90  567 17.9 24.6       17.7
 naiwny.gora prawda
        41.5   40.0
        45.2   40.0
        39.1   40.0
        44.2   40.0
        48.0   40.0
        55.0   49.0
        54.2   49.0
        52.0   49.0
        18.4   17.0
        21.5   17.8
        22.4   18.6
        22.2   19.4
        27.4   20.2
        28.0   21.0
        28.7   21.8
        24.8   22.6
     N
4021.0    6.1   12.2
swiadomosc rozwazanie      zakup     jakosc       cena   dla_mnie       kish
      1.24       1.09       1.01       1.25       1.20       1.11       1.48
z_efektem_wazenia        bez_efektu
             7.61              7.07
2. Zmiana fala do fali, wiele porównań i sezon: Rysunek 2
R
# Rysunek 2. Zmiana fala do fali: różnica odsetków z 95% CI, 6 wskaźników × 7 porównań
# (korzysta z odsetki, nazwy, kol i motyw z przepisu 1)
library(ggplot2)

# Różnica dwóch niezależnych odsetków; SE z n efektywnych obu fal, test z
roznica <- function(p1, n1, p2, n2) {
  d <- p2 - p1
  se <- sqrt(p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2)
  data.frame(roznica = d, dol = d - qnorm(.975) * se, gora = d + qnorm(.975) * se, z = d / se,
             p_wartosc = 2 * pnorm(-abs(d / se)))
}
zmiany <- do.call(rbind, lapply(names(nazwy), function(w) {
  o <- odsetki[odsetki$wskaznik == w, ]
  cbind(wskaznik = w, porownanie = paste0("F", 1:7, "→F", 2:8),
        roznica(o$p[1:7], o$n_ef[1:7], o$p[2:8], o$n_ef[2:8]),
        prawdziwa = o$prawda[2:8] - o$prawda[1:7])
}))
zmiany$holm <- p.adjust(zmiany$p_wartosc, "holm")    # poprawka na 42 porównania (FWER)
zmiany$bh <- p.adjust(zmiany$p_wartosc, "BH")        # Benjamini–Hochberg (FDR)
print(transform(zmiany[zmiany$wskaznik %in% c("swiadomosc", "rozwazanie"), 1:8],
                roznica = round(100 * roznica, 1), dol = round(100 * dol, 1), gora = round(100 * gora, 1),
                z = round(z, 2), p_wartosc = round(p_wartosc, 3), prawdziwa = round(100 * prawdziwa, 1)),
      row.names = FALSE)
# Ile z 42 porównań „istotnych” – bez poprawki, z poprawką Holma i BH
istotne <- zmiany[zmiany$p_wartosc < .05, ]
print(transform(istotne[, c("wskaznik", "porownanie", "roznica", "p_wartosc", "holm", "bh", "prawdziwa")],
                roznica = round(100 * roznica, 1), p_wartosc = round(p_wartosc, 3), holm = round(holm, 3),
                bh = round(bh, 3), prawdziwa = round(100 * prawdziwa, 1)), row.names = FALSE)
# Połowa szerokości 95% CI różnicy (pp): o ile musi zmienić się wskaźnik, by porównanie było istotne
round(100 * tapply((zmiany$gora - zmiany$dol) / 2, zmiany$wskaznik, mean)[names(nazwy)], 1)
c(porownan = nrow(zmiany), bez_poprawki = sum(zmiany$p_wartosc < .05), holm = sum(zmiany$holm < .05),
  bh = sum(zmiany$bh < .05))

# Sezonowość: zakup w III kwartale 2024 (F3) wobec poprzedniego kwartału (F2); III kw. 2025 (F7) wobec III kw. 2024 (F3)
z <- odsetki[odsetki$wskaznik == "zakup", ]
sezon <- rbind("F2→F3 (kwartał do kwartału)" = roznica(z$p[2], z$n_ef[2], z$p[3], z$n_ef[3]),
               "F3→F7 (rok do roku)" = roznica(z$p[3], z$n_ef[3], z$p[7], z$n_ef[7]))
print(round(transform(sezon, roznica = 100 * roznica, dol = 100 * dol, gora = 100 * gora), 3))
round(100 * z$p, 1)   # zakup w ostatnim miesiącu, F1–F8 (%)

d2 <- zmiany[zmiany$wskaznik %in% c("swiadomosc", "rozwazanie"), ]
d2$panel <- factor(nazwy[d2$wskaznik], nazwy[c("swiadomosc", "rozwazanie")])
d2$wynik <- ifelse(d2$p_wartosc < .05, "przedział nie obejmuje 0 (p < .05)", "przedział obejmuje 0")
d2$porownanie <- factor(d2$porownanie, rev(unique(d2$porownanie)))
p2 <- ggplot(d2, aes(y = porownanie)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dol, xmax = gora, colour = wynik), width = 0.25, linewidth = 0.8, orientation = "y") +
  geom_point(aes(x = roznica, colour = wynik, shape = wynik), size = 3) +
  geom_point(aes(x = prawdziwa, fill = "prawdziwa zmiana w populacji"), shape = 4, size = 2.6,
             colour = kol[["ciemny"]], stroke = 1) +
  geom_text(aes(x = gora, label = sprintf("%+.1f", 100 * roznica)), hjust = -0.25, size = 3.4, colour = "grey20") +
  facet_wrap(~panel, ncol = 2) +
  scale_colour_manual(values = c("przedział nie obejmuje 0 (p < .05)" = kol[["cynober"]],
                                 "przedział obejmuje 0" = kol[["niebieski"]]), name = NULL, drop = FALSE) +
  scale_shape_manual(values = c("przedział nie obejmuje 0 (p < .05)" = 17, "przedział obejmuje 0" = 16),
                     name = NULL, drop = FALSE) +
  scale_fill_manual(values = c("prawdziwa zmiana w populacji" = "white"), name = NULL) +
  scale_x_continuous(labels = function(x) sprintf("%+.0f pp", 100 * x), expand = expansion(mult = c(0.05, 0.18))) +
  labs(x = "Różnica odsetków z 95% CI (punkty procentowe)", y = NULL,
       title = "Zmiana między kolejnymi falami",
       subtitle = "Krzyżyk – o ile naprawdę zmienił się wskaźnik w populacji") +
  motyw + guides(colour = guide_legend(order = 1), shape = guide_legend(order = 1),
                 fill = guide_legend(order = 2, override.aes = list(shape = 4, colour = kol[["ciemny"]])))
p2   # zapis: ggsave("badanie-trackingowe-zmiana-fala-do-fali.svg", p2, width = 10, height = 5.6)
Wynik w R
   wskaznik porownanie roznica   dol gora     z p_wartosc prawdziwa
 swiadomosc      F1→F2     3.7  -3.0 10.3  1.09     0.277       0.0
 swiadomosc      F2→F3    -6.0 -12.5  0.6 -1.79     0.074       0.0
 swiadomosc      F3→F4     5.0  -1.2 11.2  1.58     0.114       0.0
 swiadomosc      F4→F5     3.8  -2.9 10.4  1.12     0.265       0.0
 swiadomosc      F5→F6     7.0   0.0 13.9  1.95     0.051       9.0
 swiadomosc      F6→F7    -0.7  -8.1  6.7 -0.18     0.857       0.0
 swiadomosc      F7→F8    -2.2  -9.4  5.0 -0.59     0.553       0.0
 rozwazanie      F1→F2     3.0  -1.8  7.7  1.23     0.220       0.8
 rozwazanie      F2→F3     0.9  -4.1  5.9  0.35     0.728       0.8
 rozwazanie      F3→F4    -0.3  -5.3  4.7 -0.10     0.920       0.8
 rozwazanie      F4→F5     4.9  -0.5 10.3  1.78     0.075       0.8
 rozwazanie      F5→F6     0.5  -5.1  6.2  0.18     0.857       0.8
 rozwazanie      F6→F7     0.8  -5.0  6.6  0.27     0.786       0.8
 rozwazanie      F7→F8    -3.8  -9.1  1.6 -1.38     0.167       0.8
 wskaznik porownanie roznica p_wartosc  holm    bh prawdziwa
    zakup      F2→F3     7.4     0.000 0.004 0.004         4
    zakup      F3→F4    -5.7     0.003 0.137 0.070        -4
   jakosc      F5→F6     8.3     0.013 0.506 0.112         0
   jakosc      F6→F7    -8.8     0.010 0.403 0.112         0
 dla_mnie      F6→F7     6.5     0.013 0.502 0.112         0
swiadomosc rozwazanie      zakup     jakosc       cena   dla_mnie
       6.8        5.3        3.7        6.4        5.9        4.6
    porownan bez_poprawki         holm           bh
          42            5            1            1
                            roznica    dol   gora      z p_wartosc
F2→F3 (kwartał do kwartału)   7.404  3.669 11.139  3.885     0.000
F3→F7 (rok do roku)          -1.284 -5.577  3.009 -0.586     0.558
[1]  8.2  6.9 14.3  8.6  7.9 10.3 13.0 11.6
3. Trend przez wszystkie fale i model „przed i po”: Rysunek 3
R
# Rysunek 3. Trend przez wszystkie fale: ważona regresja logistyczna z falą jako predyktorem
# (korzysta ze schematu po rakingu schemat, odsetki, nazwy, kol i motyw z przepisu 1)
library(ggplot2)
library(survey)

# Schemat z przepisu 1: niezależne próby w falach (warstwy), raking w każdej fali; SE z linearyzacji
schemat <- update(schemat, po_kampanii = as.integer(fala >= 6))

# Model trendu dla każdego wskaźnika: logit(p) = b0 + b1 × fala; OR = iloraz szans na jedną falę
trendy <- do.call(rbind, lapply(names(nazwy), function(w) {
  m <- svyglm(as.formula(paste(w, "~ fala")), design = schemat, family = quasibinomial())
  ci <- confint(m)["fala", ]
  data.frame(wskaznik = w, OR_na_fale = exp(coef(m)[["fala"]]), dol = exp(ci[[1]]), gora = exp(ci[[2]]),
             p_wartosc = summary(m)$coefficients["fala", 4])
}))
trendy$holm <- p.adjust(trendy$p_wartosc, "holm")   # 6 testów trendu zamiast 42 porównań fala do fali
print(transform(trendy, OR_na_fale = round(OR_na_fale, 3), dol = round(dol, 3), gora = round(gora, 3),
                p_wartosc = signif(p_wartosc, 3), holm = signif(holm, 3)), row.names = FALSE)

# Rozważanie: przewidywany odsetek w F1 i F8 z modelu trendu (z 95% CI)
m_rozw <- svyglm(rozwazanie ~ fala, design = schemat, family = quasibinomial())
siatka <- data.frame(fala = seq(1, 8, by = 0.1))
pr <- predict(m_rozw, newdata = siatka, type = "link", se.fit = TRUE)
eta <- as.numeric(pr); se_eta <- as.numeric(SE(pr))
siatka$p <- plogis(eta); siatka$dol <- plogis(eta - 1.96 * se_eta); siatka$gora <- plogis(eta + 1.96 * se_eta)
round(100 * siatka[round(siatka$fala, 1) %in% c(1, 8), c("p", "dol", "gora")], 1)

# Świadomość: model „przed i po kampanii” (F1–F5 vs F6–F8) zamiast porównania dwóch sąsiednich fal
m_kamp <- svyglm(swiadomosc ~ po_kampanii, design = schemat, family = quasibinomial())
poziomy <- svyby(~swiadomosc, ~po_kampanii, schemat, svymean, covmat = TRUE)
round(100 * cbind(odsetek = coef(poziomy), SE = SE(poziomy)), 2)
roznica_kamp <- svycontrast(poziomy, c(-1, 1))
round(100 * c(roznica = coef(roznica_kamp), dol = coef(roznica_kamp) - 1.96 * SE(roznica_kamp),
              gora = coef(roznica_kamp) + 1.96 * SE(roznica_kamp)), 1)
data.frame(OR = round(exp(coef(m_kamp)[["po_kampanii"]]), 2),
           p_wartosc = signif(summary(m_kamp)$coefficients["po_kampanii", 4], 3))

d3 <- odsetki[odsetki$wskaznik == "rozwazanie", ]
p3 <- ggplot(d3, aes(fala)) +
  geom_ribbon(data = siatka, aes(ymin = dol, ymax = gora, fill = "trend z regresji logistycznej (95% CI)"),
              alpha = 0.25) +
  geom_line(data = siatka, aes(y = p), colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_line(aes(y = prawda, linetype = "prawdziwa wartość w populacji"), colour = kol[["ciemny"]], linewidth = 0.5) +
  geom_linerange(aes(ymin = dol, ymax = gora), colour = kol[["szary"]], linewidth = 0.8) +
  geom_point(aes(y = p, shape = "odsetek ważony w fali (95% CI)"), colour = kol[["cynober"]], size = 2.8) +
  scale_fill_manual(values = c("trend z regresji logistycznej (95% CI)" = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c("odsetek ważony w fali (95% CI)" = 17), name = NULL) +
  scale_linetype_manual(values = c("prawdziwa wartość w populacji" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = 1:8, labels = paste0("F", 1:8)) +
  scale_y_continuous(labels = scales::label_percent(accuracy = 1)) +
  labs(x = "Fala badania", y = "Rozważa zakup marki",
       title = "Rozważanie zakupu: żadna zmiana fala do fali nie jest istotna, trend – tak",
       subtitle = sprintf("Iloraz szans na jedną falę: OR = %.2f, 95%% CI [%.2f, %.2f]",
                          trendy$OR_na_fale[2], trendy$dol[2], trendy$gora[2])) +
  motyw + guides(fill = guide_legend(order = 1), shape = guide_legend(order = 2), linetype = guide_legend(order = 3)) +
  theme(legend.box = "horizontal")
p3   # zapis: ggsave("badanie-trackingowe-trend-logistyczny.svg", p3, width = 10, height = 6)
Wynik w R
   wskaznik OR_na_fale   dol  gora p_wartosc     holm
 swiadomosc      1.087 1.054 1.121  1.04e-07 6.24e-07
 rozwazanie      1.073 1.038 1.110  3.40e-05 1.70e-04
      zakup      1.057 1.010 1.106  1.80e-02 7.19e-02
     jakosc      0.998 0.966 1.031  8.89e-01 1.00e+00
       cena      0.991 0.958 1.026  6.23e-01 1.00e+00
   dla_mnie      1.041 1.000 1.084  4.90e-02 1.47e-01
      p  dol gora
1  16.6 14.6 18.7
71 24.6 22.2 27.2
  odsetek   SE
0   39.23 1.05
1   49.38 1.50
roznica.contrast              dol             gora
            10.1              6.6             13.7
    OR p_wartosc
1 1.51  3.23e-08
4. Średnia krocząca z trzech fal: Rysunek 4
R
# Rysunek 4. Średnia krocząca z 3 fal: mniej szumu, ale opóźniona reakcja na kampanię
# (korzysta z odsetki, kol i motyw z przepisu 1)
library(ggplot2)

s <- odsetki[odsetki$wskaznik == "swiadomosc", ]
s$se <- sqrt(s$p * (1 - s$p) / s$n_ef)                  # SE odsetka z n efektywnego
k <- 3                                                   # okno: bieżąca fala i dwie poprzednie
s$krocz <- as.numeric(stats::filter(s$p, rep(1 / k, k), sides = 1))
s$krocz_se <- sqrt(as.numeric(stats::filter(s$se^2, rep(1, k), sides = 1))) / k
s$krocz_dol <- s$krocz - 1.96 * s$krocz_se
s$krocz_gora <- s$krocz + 1.96 * s$krocz_se
print(transform(s[, c("fala", "p", "krocz", "krocz_dol", "krocz_gora", "prawda")],
                p = round(100 * p, 1), krocz = round(100 * krocz, 1), krocz_dol = round(100 * krocz_dol, 1),
                krocz_gora = round(100 * krocz_gora, 1), prawda = 100 * prawda), row.names = FALSE)
# Szerokość 95% CI (pp): pojedyncza fala vs średnia krocząca (średnio)
round(100 * c(fala = mean(2 * 1.96 * s$se), srednia_kroczaca = mean(2 * 1.96 * s$krocz_se, na.rm = TRUE)), 1)
# Jaką część skoku o 9 pp pokazuje średnia krocząca w F6, F7 i F8 (wobec poziomu sprzed kampanii, prawda = 40%)?
round((s$krocz[6:8] - 0.40) / 0.09, 2)

p4 <- ggplot(s, aes(fala)) +
  annotate("rect", xmin = 5.5, xmax = 8.4, ymin = -Inf, ymax = Inf, fill = kol[["pomarancz"]], alpha = 0.12) +
  annotate("text", x = 5.6, y = 0.555, label = "kampania od F6", hjust = 0, size = 3.8, colour = "grey20") +
  geom_ribbon(data = s[!is.na(s$krocz), ], aes(ymin = krocz_dol, ymax = krocz_gora,
                                               fill = "średnia krocząca z 3 fal (95% CI)"), alpha = 0.25) +
  geom_line(data = s[!is.na(s$krocz), ], aes(y = krocz), colour = kol[["niebieski"]], linewidth = 1.2) +
  geom_step(aes(y = prawda, linetype = "prawdziwa wartość w populacji"), colour = kol[["ciemny"]],
            direction = "mid", linewidth = 0.6) +
  geom_point(aes(y = p, shape = "odsetek ważony w fali"), colour = kol[["cynober"]], size = 2.8) +
  scale_fill_manual(values = c("średnia krocząca z 3 fal (95% CI)" = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c("odsetek ważony w fali" = 17), name = NULL) +
  scale_linetype_manual(values = c("prawdziwa wartość w populacji" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = 1:8, labels = paste0("F", 1:8)) +
  scale_y_continuous(labels = scales::label_percent(accuracy = 1)) +
  labs(x = "Fala badania", y = "Zna markę (świadomość wspomagana)",
       title = "Średnia krocząca wygładza szum, ale spóźnia się o dwie fale",
       subtitle = "Średnia z fal t − 2, t − 1 i t; pierwsza wartość w F3") +
  motyw + guides(fill = guide_legend(order = 1), shape = guide_legend(order = 2), linetype = guide_legend(order = 3)) +
  theme(legend.box = "horizontal")
p4   # zapis: ggsave("badanie-trackingowe-srednia-kroczaca.svg", p4, width = 10, height = 5.8)
Wynik w R
 fala    p krocz krocz_dol krocz_gora prawda
    1 37.1    NA        NA         NA     40
    2 40.8    NA        NA         NA     40
    3 34.8  37.6      35.0       40.2     40
    4 39.8  38.5      35.8       41.2     40
    5 43.6  39.4      36.8       42.1     40
    6 50.6  44.7      41.9       47.5     49
    7 49.9  48.0      45.1       51.0     49
    8 47.7  49.4      46.5       52.3     49
            fala srednia_kroczaca
             9.6              5.5
[1] 0.52 0.89 1.04
5. Symulacja 1000 badań bez żadnej zmiany: Rysunek 5
R
# Rysunek 5. Symulacja: 1000 badań trackingowych, w których NIC się nie zmienia (6 wskaźników × 8 fal)
# (korzysta z komorki, pop, efekt, wyraz, prawda, kol i motyw z przepisu 1)
library(ggplot2)
library(patchwork)

# Raking na poziomie 18 komórek (wiek × płeć × miejsce): te same wagi co rake() z pakietu survey, ale szybciej
rake_komorki <- function(nk, iter = 30) {
  w <- rep(1, length(nk))
  for (k in seq_len(iter)) for (v in names(pop)) {
    suma <- tapply(w * nk, komorki[[v]], sum)[names(pop[[v]])]
    w <- as.vector(w * (pop[[v]] * sum(w * nk) / suma)[komorki[[v]]])
  }
  w
}
# SE odsetka po rakingu z linearyzacji: reszty z regresji wskaźnika na zmiennych ważenia (jak w survey)
X <- model.matrix(~ wiek + plec + miejsce, komorki)
se_lin <- function(nk, w, tak) {
  f <- lm.wfit(X, ifelse(nk > 0, tak / pmax(nk, 1), 0), w * nk)$fitted.values
  N <- sum(nk)
  sqrt(N / (N - 1) * sum(w^2 * (tak * (1 - f)^2 + (nk - tak) * f^2))) / sum(w * nk)
}
# Sprawdzenie na fali 1 z przepisu 1: ta sama wartość SE świadomości co z pakietu survey
d <- dane[dane$fala == 1, ]
nk1 <- as.vector(table(factor(do.call(paste, d[c("wiek", "plec", "miejsce")]),
                              do.call(paste, komorki[c("wiek", "plec", "miejsce")]))))
tak1 <- as.vector(tapply(d$swiadomosc, factor(do.call(paste, d[c("wiek", "plec", "miejsce")]),
                                               do.call(paste, komorki[c("wiek", "plec", "miejsce")])), sum))
round(100 * c(wlasna = se_lin(nk1, rake_komorki(nk1), ifelse(is.na(tak1), 0, tak1)),
              survey = odsetki$se[odsetki$wskaznik == "swiadomosc"][1]), 3)

p_stale <- plogis(wyraz[, 1] + matrix(efekt, nrow(prawda), length(efekt), byrow = TRUE))  # odsetki z fali 1

set.seed(633)                                  # to samo ziarno co w przepisie 1, ustalone raz
R <- 1000
wyniki <- t(replicate(R, {
  p <- n <- n_kish <- se <- matrix(NA, nrow(prawda), 8)
  for (f in 1:8) {
    nf <- sample(480:520, 1)
    nk <- as.vector(rmultinom(1, nf, komorki$udzial_panel))           # ilu respondentów w każdej komórce
    w <- rake_komorki(nk)
    tak <- matrix(rbinom(length(p_stale), rep(nk, each = nrow(prawda)), p_stale), nrow(prawda))
    p[, f] <- (tak %*% w) / sum(w * nk)                                # odsetek ważony
    n[, f] <- nf
    n_kish[, f] <- sum(w * nk)^2 / sum(w^2 * nk)                       # n efektywne Kisha
    se[, f] <- apply(tak, 1, function(t1) se_lin(nk, w, t1))           # SE z linearyzacji
  }
  test <- function(s2) {                       # 42 testy z: 6 wskaźników × 7 par sąsiednich fal
    z <- (p[, 2:8] - p[, 1:7]) / sqrt(s2[, 1:7] + s2[, 2:8])
    as.vector(2 * pnorm(-abs(z)))
  }
  p_naiw <- test(p * (1 - p) / n); p_kish <- test(p * (1 - p) / n_kish); p_lin <- test(se^2)
  c(alarmy_naiwnie = sum(p_naiw < .05), alarmy_kish = sum(p_kish < .05), alarmy_lin = sum(p_lin < .05),
    holm = sum(p.adjust(p_lin, "holm") < .05), bh = sum(p.adjust(p_lin, "BH") < .05),
    deff_kish = mean(n / n_kish), deff_lin = mean(se^2 / (p * (1 - p) / n)))
}))
# Odsetek fałszywych alarmów w pojedynczym teście (z błędem Monte Carlo liczonym po badaniach)
na_test <- wyniki[, c("alarmy_naiwnie", "alarmy_kish", "alarmy_lin")] / 42
pojedynczy <- data.frame(sposob = c("SE z pełnego n (wagi pominięte)", "SE z n efektywnego Kisha",
                                    "SE z linearyzacji (survey)"),
                         odsetek = colMeans(na_test), blad_mc = apply(na_test, 2, sd) / sqrt(R))
print(transform(pojedynczy, odsetek = round(100 * odsetek, 2), blad_mc = round(100 * blad_mc, 2)), row.names = FALSE)
# Choć jeden fałszywy alarm w 42 porównaniach (badanie trwające 2 lata); SE z linearyzacji
co_najmniej <- data.frame(sposob = c("bez poprawki", "poprawka Holma", "Benjamini–Hochberg"),
                          odsetek = colMeans(wyniki[, c("alarmy_lin", "holm", "bh")] > 0))
co_najmniej$blad_mc <- sqrt(co_najmniej$odsetek * (1 - co_najmniej$odsetek) / R)
print(transform(co_najmniej, odsetek = round(100 * odsetek, 1), blad_mc = round(100 * blad_mc, 1)), row.names = FALSE)
round(c(srednio_alarmow = mean(wyniki[, "alarmy_lin"]), deff_kish = mean(wyniki[, "deff_kish"]),
        deff_linearyzacja = mean(wyniki[, "deff_lin"])), 2)

pa <- ggplot(pojedynczy, aes(odsetek, factor(sposob, rev(sposob)))) +
  geom_vline(xintercept = 0.05, linetype = "dashed", colour = "grey40") +
  geom_col(aes(fill = sposob), width = 0.6) +
  geom_errorbar(aes(xmin = odsetek - 1.96 * blad_mc, xmax = odsetek + 1.96 * blad_mc), width = 0.15, orientation = "y") +
  geom_text(aes(x = odsetek + 1.96 * blad_mc, label = sprintf("%.1f%%", 100 * odsetek)), hjust = -0.2, size = 3.8) +
  scale_fill_manual(values = setNames(kol[c("cynober", "pomarancz", "niebieski")], pojedynczy$sposob), guide = "none") +
  scale_x_continuous(labels = scales::label_percent(accuracy = 1), limits = c(0, 0.09), expand = c(0, 0)) +
  labs(x = "Fałszywe alarmy w jednym porównaniu", y = NULL, title = "A. Jedno porównanie (nominalnie 5%)") + motyw

pb <- ggplot(co_najmniej, aes(odsetek, factor(sposob, rev(sposob)))) +
  geom_col(aes(fill = sposob), width = 0.6) +
  geom_errorbar(aes(xmin = odsetek - 1.96 * blad_mc, xmax = odsetek + 1.96 * blad_mc), width = 0.15, orientation = "y") +
  geom_text(aes(x = odsetek + 1.96 * blad_mc, label = sprintf("%.1f%%", 100 * odsetek)), hjust = -0.2, size = 3.8) +
  scale_fill_manual(values = setNames(kol[c("cynober", "niebieski", "zielony")], co_najmniej$sposob), guide = "none") +
  scale_x_continuous(labels = scales::label_percent(accuracy = 1), limits = c(0, 1.12), expand = c(0, 0),
                     breaks = seq(0, 1, 0.25)) +
  labs(x = "Badania z co najmniej jednym fałszywym alarmem", y = NULL,
       title = "B. 42 porównania w jednym badaniu (SE z linearyzacji)") + motyw

p5 <- pa / pb + plot_layout(heights = c(1, 1)) +
  plot_annotation(title = "1000 badań, w których żaden wskaźnik się nie zmienił",
                  subtitle = "6 wskaźników × 7 porównań sąsiednich fal; słupki błędu – 95% przedział błędu Monte Carlo",
                  theme = motyw)
p5   # zapis: ggsave("badanie-trackingowe-falszywe-alarmy.svg", p5, width = 10, height = 6.4)
Wynik w R
wlasna survey
 2.212  2.220
                          sposob odsetek blad_mc
 SE z pełnego n (wagi pominięte)    6.57    0.13
        SE z n efektywnego Kisha    2.87    0.09
      SE z linearyzacji (survey)    5.25    0.12
             sposob odsetek blad_mc
       bez poprawki    86.4     1.1
     poprawka Holma     5.6     0.7
 Benjamini–Hochberg     5.9     0.7
  srednio_alarmow         deff_kish deff_linearyzacja
             2.21              1.44              1.12
6. Karta „kiedy ogłosić zmianę”: Rysunek 6
R
# Rysunek 6. Karta „kiedy ogłosić zmianę” – pięć pytań z liczbami z tego badania (grafika z prostokątów i tekstu)
# (korzysta z zmiany i sezon z przepisu 2, roznica_kamp z przepisu 3 oraz kol i motyw z przepisu 1)
library(ggplot2)

liczba1 <- function(x) {                       # jedno miejsce po przecinku, minus typograficzny; −0.04 nie jako „−0.0”
  s <- ifelse(abs(x) < 0.05 & x != 0, sprintf("%.2f", x), sprintf("%.1f", x))
  gsub("-", "−", s)
}
pp <- function(x) paste0(ifelse(x > 0, "+", ""), liczba1(100 * x), " pp")
f56 <- zmiany[zmiany$wskaznik == "swiadomosc" & zmiany$porownanie == "F5→F6", ]
kamp <- as.numeric(coef(roznica_kamp)) + c(0, -1, 1) * 1.96 * as.numeric(SE(roznica_kamp))
pytania <- data.frame(
  nr = 1:5,
  pytanie = c("Czy 95% CI różnicy (z efektem ważenia) wyklucza zero?",
              "Czy zmianę potwierdza kolejna fala albo model przez wszystkie fale?",
              "Czy porównujesz tę samą porę roku?",
              "Czy kwestionariusz, panel i sposób ważenia się nie zmieniły?",
              "Czy wynik przetrwa poprawkę na liczbę porównań?"),
  przyklad = c(sprintf("Świadomość F5→F6: %s, 95%% CI [%s, %s] – na granicy, choć kampania działała",
                       pp(f56$roznica), liczba1(100 * f56$dol), liczba1(100 * f56$gora)),
               sprintf("Świadomość F6–F8 vs F1–F5: %s, 95%% CI [%s, %s] – potwierdzone",
                       pp(kamp[1]), liczba1(100 * kamp[2]), liczba1(100 * kamp[3])),
               sprintf("Zakup F2→F3: %s, ale rok do roku (F3→F7): %s – to sezon, nie trend",
                       pp(sezon$roznica[1]), pp(sezon$roznica[2])),
               "Nowy dostawca panelu albo nowa lista marek = przerwa w szeregu; potrzebna fala pomostowa",
               sprintf("%d porównań fala do fali: %d „istotnych” bez poprawki, %d po poprawce Holma",
                       nrow(zmiany), sum(zmiany$p_wartosc < .05), sum(zmiany$holm < .05))),
  status = c("GRANICA", "TAK", "SEZON", "SPRAWDŹ", sprintf("%d Z %d", sum(zmiany$holm < .05), sum(zmiany$p_wartosc < .05))),
  typ = c("uwaga", "tak", "nie", "uwaga", "nie"))
pytania$y <- rev(seq_len(nrow(pytania))) * 1.15 + 1.3
werdykty <- data.frame(
  x = c(0.45, 3.7, 6.95), y = 0.55,
  tytul = c("Ogłoś zmianę", "Poczekaj na kolejną falę", "Nie ogłaszaj"),
  opis = c("CI bez zera, potwierdzenie\nw kolejnych falach, ta sama metoda",
           "jeden skok bez potwierdzenia\nalbo wynik tylko bez poprawki",
           "sezon, zmiana metody albo\nwynik znika po poprawce"),
  typ = c("tak", "uwaga", "nie"))
kolory_typu <- c(tak = kol[["zielony"]], uwaga = kol[["pomarancz"]], nie = kol[["cynober"]])
ksztalty_typu <- c(tak = 16, uwaga = 17, nie = 15)

p6 <- ggplot() +
  geom_rect(data = pytania, aes(xmin = 0, xmax = 9.6, ymin = y - 0.5, ymax = y + 0.5), fill = "white",
            colour = "grey75", linewidth = 0.5) +
  geom_point(data = pytania, aes(x = 0.38, y = y), size = 9, colour = "#0f1d3a") +
  geom_text(data = pytania, aes(x = 0.38, y = y, label = nr), colour = "white", fontface = "bold", size = 5) +
  geom_text(data = pytania, aes(x = 0.8, y = y + 0.18, label = pytanie), hjust = 0, fontface = "bold",
            size = 4.9, colour = "#0f1d3a") +
  geom_text(data = pytania, aes(x = 0.8, y = y - 0.2, label = przyklad), hjust = 0, size = 4.2, colour = "grey20") +
  geom_point(data = pytania, aes(x = 8.35, y = y + 0.18, colour = typ, shape = typ), size = 3.6) +
  geom_text(data = pytania, aes(x = 8.55, y = y + 0.18, label = status, colour = typ), hjust = 0,
            fontface = "bold", size = 4) +
  geom_rect(data = werdykty, aes(xmin = x - 0.45, xmax = x + 2.65, ymin = y - 0.55, ymax = y + 0.55, fill = typ),
            alpha = 0.16, colour = NA) +
  geom_rect(data = werdykty, aes(xmin = x - 0.45, xmax = x - 0.3, ymin = y - 0.55, ymax = y + 0.55, fill = typ)) +
  geom_point(data = werdykty, aes(x = x - 0.05, y = y + 0.25, colour = typ, shape = typ), size = 3.6) +
  geom_text(data = werdykty, aes(x = x + 0.12, y = y + 0.25, label = tytul), hjust = 0, fontface = "bold",
            size = 4.6, colour = "#0f1d3a") +
  geom_text(data = werdykty, aes(x = x - 0.15, y = y - 0.2, label = opis), hjust = 0, size = 4,
            lineheight = 0.95, colour = "grey20") +
  scale_colour_manual(values = kolory_typu, guide = "none") +
  scale_fill_manual(values = kolory_typu, guide = "none") +
  scale_shape_manual(values = ksztalty_typu, guide = "none") +
  coord_cartesian(xlim = c(-0.05, 9.7), ylim = c(-0.1, max(pytania$y) + 0.6), expand = FALSE) +
  labs(title = "Kiedy ogłosić zmianę w badaniu trackingowym",
       subtitle = "Pięć pytań przed zdaniem „świadomość marki wzrosła” – z liczbami z 8 fal marki Mewa") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p6   # zapis: ggsave("badanie-trackingowe-karta-kiedy-oglosic.svg", p6, width = 10, height = 8)
7. Czy paleta przetrwa zaburzenia widzenia barw?
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (CI z ważeniem / bez; p < .05 / p ≥ .05)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (linearyzacja / Kish)" = c("#0072B2", "#E69F00"),
             "zielony – cynober (karta: TAK / NIE)" = c("#009E73", "#D55E00"),
             "zielony – pomarańczowy (karta: TAK / UWAGA)" = c("#009E73", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                             widzenie_typowe
niebieski – cynober (CI z ważeniem / bez; p < .05 / p ≥ .05)           114.6
niebieski – pomarańczowy (linearyzacja / Kish)                         120.2
zielony – cynober (karta: TAK / NIE)                                   102.4
zielony – pomarańczowy (karta: TAK / UWAGA)                             88.7
czerwony – zielony (do unikania)                                       121.7
                                                             deuteranopia
niebieski – cynober (CI z ważeniem / bez; p < .05 / p ≥ .05)        108.3
niebieski – pomarańczowy (linearyzacja / Kish)                      121.5
zielony – cynober (karta: TAK / NIE)                                 53.5
zielony – pomarańczowy (karta: TAK / UWAGA)                          66.3
czerwony – zielony (do unikania)                                     21.1
                                                             protanopia
niebieski – cynober (CI z ważeniem / bez; p < .05 / p ≥ .05)       91.9
niebieski – pomarańczowy (linearyzacja / Kish)                    109.3
zielony – cynober (karta: TAK / NIE)                               37.3
zielony – pomarańczowy (karta: TAK / UWAGA)                        51.5
czerwony – zielony (do unikania)                                   31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Raking, błędy standardowe z linearyzacji i ważoną regresję logistyczną policzono pakietem survey, a symulację – w bazowym R (pakiety base i stats). Rysunki wykonano w ggplot2 (osie procentowe – pakiet scales, złożenie paneli – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Odsetki bez wag z panelu internetowego (tu zawyżone o 6.1–12.2 pp) albo SE z pełnego n mimo ważenia.
- Ogłaszanie każdej „istotnej” zmiany fala do fali bez poprawki i bez potwierdzenia.
- „Nieistotne” jako „bez zmian” – rozważanie rosło, choć żadna para fal tego nie pokazała.
- Średnia krocząca jako wskaźnik bieżący i sezon, nowy kwestionariusz lub panel jako „zmiana rynku”.
Najczęstsze pytania
Jak sprawdzić, czy zmiana wyniku między dwiema falami badania jest istotna?
Każda fala to niezależna próba, więc oblicz różnicę odsetków i jej błąd standardowy jako pierwiastek z sumy kwadratów SE obu fal, a potem 95% przedział ufności. Jeśli dane są ważone, SE każdej fali policz z uwzględnieniem wag (np. linearyzacją w pakiecie survey). W przykładzie wzrost świadomości o 7.0 pp miał 95% CI [−0.04, 13.9], więc pojedyncze porównanie było na granicy.
Co to jest efektywna liczebność próby w badaniu z wagami?
To liczba osób z prostej próby losowej, która dałaby taką samą precyzję jak Twoja próba ważona: nef = n / deff. Szybkie przybliżenie Kisha, 1 + CV² wag, liczy sam koszt zróżnicowania wag; w przykładzie dawało deff 1.48, a linearyzacja – 1.24 dla świadomości. Więcej w haśle efekt schematu.
Czy w badaniu trackingowym trzeba stosować poprawkę na wielokrotne porównania?
Tak, jeśli wyciągasz wnioski z wielu wskaźników i par fal. W symulacji 1000 badań bez żadnej zmiany 42 porównania (6 wskaźników × 7 par fal) dały co najmniej jeden fałszywy alarm w 86.4% badań, a po poprawce Holma – w 5.6%. Lepiej jednak z góry wybrać 1–2 wskaźniki główne i testować trend przez wszystkie fale.
Czy średnia krocząca z kilku fal jest lepsza od wyniku pojedynczej fali?
Ma węższy przedział (w przykładzie średnio 5.5 zamiast 9.6 pp), ale reaguje z opóźnieniem. Po skoku świadomości o 9 pp średnia z trzech fal pokazała 52% zmiany w pierwszej fali po kampanii i całość dopiero dwie fale później. Do oceny momentu zmiany porównuj rozłączne okresy, np. fale przed i po kampanii.
Czy badanie trackingowe pokazuje efekt kampanii reklamowej?
Nie wprost. Tracking mierzy zmianę wskaźników w czasie, a na nią wpływają też sezon, konkurencja, zmiana kwestionariusza czy panelu. Efekt przyczynowy kampanii mierzy badanie z grupą kontrolną, np. brand lift.
Powiązane hasła
Przeczytaj też
Brand lift – efekt kampanii reklamowej
Grupa kontrolna z losowania, różnica odsetków z przedziałem Newcombe’a, liczebność próby i braki odpowiedzi na przykładzie biura podróży – z kodem R.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikAnomalie w KPI – karta kontrolna
Sklep sportowy i dzienna konwersja: karta p, dzień tygodnia, poprawka Laneya, EWMA, CUSUM i symulacja fałszywych alarmów – pięć rysunków z kodem R.
Czytaj →PoradnikIndeks zdrowia marki
Sześć marek płatków, pięć wskaźników: standaryzacja, wagi równe, eksperckie i PCA, ranking w 9 wariantach, bootstrap miejsc i karta marki – z kodem R.
Czytaj →Masz w pracy dane z kilku fal badania?
Pomożemy zważyć próbę, policzyć przedziały z efektem schematu, ocenić trend i zmiany między falami oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Haziza, D., & Beaumont, J.-F. (2017). Construction of weights in surveys: A review. Statistical Science, 32(2), 206–226. https://doi.org/10.1214/16-sts608
- Kish, L. (1965). Survey sampling. Wiley.
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Warren, J. R., & Halpern-Manners, A. (2012). Panel conditioning in longitudinal social science surveys. Sociological Methods & Research, 41(4), 491–534. https://doi.org/10.1177/0049124112460374 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{haziza2017construction, author={Haziza, David and Beaumont, Jean-François}, title={{Construction of weights in surveys: A review}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={206--226}, doi={10.1214/16-sts608}}@book{kish1965survey, author={Kish, Leslie}, title={{Survey sampling}}, year={1965}, publisher={Wiley}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{warren2012panel, author={Warren, John Robert and Halpern-Manners, Andrew}, title={{Panel conditioning in longitudinal social science surveys}}, journal={Sociological Methods \& Research}, year={2012}, volume={41}, number={4}, pages={491--534}, doi={10.1177/0049124112460374}}