Dlaczego nie „trend” ani „marginalnie istotny”
Jeśli przed analizą przyjąłeś(-ęłaś) α = .05, wynik p = .06 jest nieistotny statystycznie. To cała decyzja testu. Określenia „trend”, „tendencja” czy marginalna istotność próbują ją po fakcie złagodzić, a to rodzi trzy problemy.
- Zmieniasz regułę po zobaczeniu wyniku. Poziom istotności ustala się przed zebraniem danych. Kto przy p = .06 przesuwa granicę na .10, robi łagodną wersję p-hackingu.
- Etykieta sugeruje, że efekt jest, tylko „słabszy”. Tymczasem wartość p nie mierzy wielkości efektu ani prawdopodobieństwa, że hipoteza jest prawdziwa, a wniosek nie powinien zależeć tylko od tego, czy p przekroczyło próg. To zasady z oświadczenia Amerykańskiego Towarzystwa Statystycznego (Wasserstein i Lazar, 2016).
- Słowo „trend” ma w statystyce inne znaczenie. Oznacza monotoniczną zmianę, np. wzrost odsetka w kolejnych grupach, który sprawdza test trendu Cochrana–Armitage’a. Wynik jednego testu t nie jest trendem.
Ta praktyka była w psychologii częsta. Pritschet i in. (2016) przejrzeli ponad 1500 artykułów i stwierdzili, że skłonność do nazywania wartości p „marginalnie istotnymi” wyraźnie rosła przez cztery dekady. Olsson-Collentine i in. (2019) na znacznie większym zbiorze artykułów APA nie potwierdzili wzrostu, ale prawie 40% wartości p między .05 a .10 nadal opisywano jako marginalnie istotne. Autorzy odradzają takie opisy, bo wartości p z tego przedziału niosą mało dowodów.
Odwrotny błąd jest równie częsty: „p = .06, więc efektu nie ma”. Amrhein i in. (2019) apelują, by z samego p > .05 nie wnioskować o braku różnicy i omawiać wszystkie wartości z przedziału ufności. Jak opisać dowolny wynik nieistotny, pokazujemy w osobnym wpisie jak opisać wynik nieistotny statystycznie. Tu zajmiemy się sytuacją tuż przy progu.
Przykład: trening oddechowy a lęk egzaminacyjny
Student porównuje lęk egzaminacyjny (skala 10–40) u 40 osób po krótkim treningu oddechowym i 40 osób z grupy kontrolnej (dane symulowane). Po treningu lęk był niższy (M = 22.45, SD = 6.69) niż w grupie kontrolnej (M = 25.20, SD = 6.30). Test Welcha dał t(77.71) = −1.89, p = .062. Różnica średnich wyniosła −2.75 punktu, 95% CI [−5.64, 0.14], a d Cohena = −0.42, 95% CI [−0.87, 0.02].
Przedział ufności mówi więcej niż sama wartość p. Mieści i praktycznie zerową różnicę, i spadek lęku o prawie 0.9 odchylenia standardowego. Dane są więc zgodne zarówno z brakiem efektu, jak i z dużym efektem. To wynik nierozstrzygający, a nie „prawie potwierdzona hipoteza”.
Drugą potrzebną liczbą jest czułość badania. Przy 40 osobach w grupie test miał moc 80% dopiero dla d = 0.63, a moc 90% dla d = 0.73. Efekt rzędu 0.4 badanie mogło więc łatwo przeoczyć. Tę liczbę liczysz z założonej wielkości efektu, a nie z efektu zaobserwowanego.
Co dałaby replikacja? Symulacja
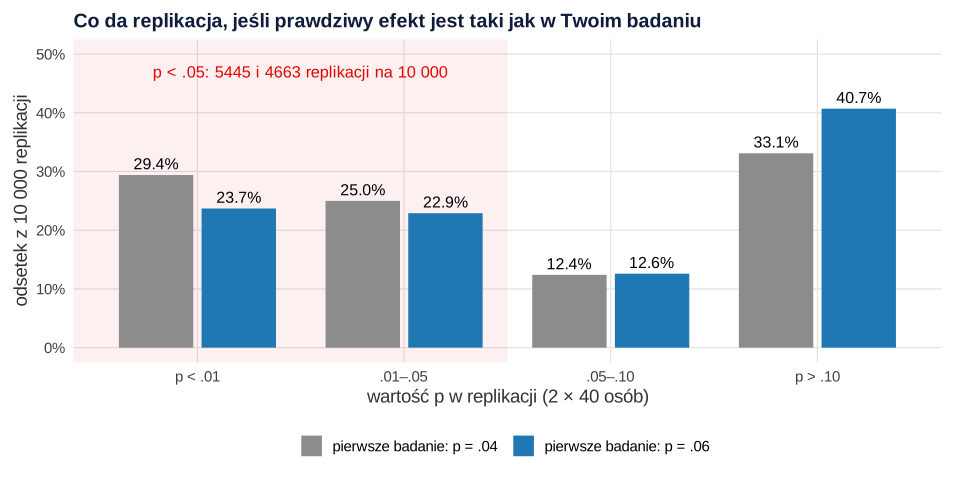
Załóżmy optymistycznie, że prawdziwy efekt jest dokładnie taki, jaki dało badanie z p = .06 (przy 2 × 40 osobach to d = 0.43). W R powtórzyliśmy to samo badanie 10 000 razy. Wynik p < .05 pojawił się w 4663 replikacjach, czyli mniej więcej w co drugiej. Dla porównania: jeśli pierwsze badanie dało p = .04 (d = 0.47), replikacja była istotna 5445 razy na 10 000 (rysunek 1).
Z symulacji wynikają dwa wnioski:
- Wyniki p = .04 i p = .06 niosą prawie te same informacje. Różnią się efektem o 0.04 odchylenia standardowego. Gelman i Stern (2006) pokazują, że różnica między wynikiem „istotnym” a „nieistotnym” sama zwykle nie jest istotna statystycznie. Nie ma więc powodu, by jeden opisywać jako odkrycie, a drugi jako „trend”.
- Wartość p w replikacjach bardzo się waha. W 80% replikacji dla scenariusza p = .06 wartość p mieściła się między .002 a .51. Cumming (2008) opisuje to samo zjawisko i dlatego zaleca przedziały ufności zamiast wnioskowania z pojedynczego p. Pełny „taniec” wartości p pokazujemy w poradniku wartość p – interpretacja.
Pojedynczy wynik przy progu nie rozstrzyga więc niczego w żadną stronę. Rozstrzyga dopiero więcej danych, np. kolejne badanie albo metaanaliza z replikacjami.
Co napisać zamiast „trendu”
W rozdziale wyników zrób cztery rzeczy:
- Napisz wprost, że wynik nie był istotny statystycznie przy przyjętym α.
- Podaj dokładne p (.062, nie „p < .10” ani „p = .06, trend”). Możesz je sprawdzić w kalkulatorze wartości p.
- Podaj różnicę lub wielkość efektu z 95% CI i jednym zdaniem powiedz, jakie efekty są zgodne z danymi.
- Dodaj czułość badania: jaki efekt badanie wykrywało z mocą 80%.
W dyskusji możesz napisać, że kierunek różnicy był zgodny z hipotezą, a wynik wymaga sprawdzenia w większej próbie. Nie pisz jednak, że hipoteza „częściowo się potwierdziła”. Sytuację odwrotną, czyli istotne p przy bardzo małym efekcie, omawiamy we wpisie wynik istotny, ale efekt mały.
Jak to opisać w pracy
Wzór dla przykładu z treningiem oddechowym:
Planowanie liczebności następnego badania i resztę rozdziału wyników krok po kroku opisujemy w przewodniku statystyka w pracy dyplomowej.
Wynik p = .06 i replikacje w R
Kod odtwarza wszystkie liczby z tekstu: test Welcha, d Cohena z 95% CI (pakiet effectsize), czułość badania (power.t.test()) i symulację 10 000 replikacji przy efekcie odpowiadającym wynikom p = .06 i p = .04.
Test Welcha, wielkość efektu, czułość i symulacja replikacji
R
# B162 – p = .06: wielkość efektu z 95% CI, czułość badania i symulacja replikacji
# Dane symulowane: 80 osób studiujących; lęk egzaminacyjny (skala 10–40)
# po krótkim treningu oddechowym (n = 40) i w grupie kontrolnej (n = 40).
library(effectsize)
set.seed(1636)
lek <- function(n, m) pmin(40, pmax(10, round(rnorm(n, m, 6))))
dane <- data.frame(grupa = factor(rep(c("trening", "kontrola"), each = 40),
                                  levels = c("trening", "kontrola")),
                   lek = c(lek(40, 23), lek(40, 25.5)))

# 1. Statystyki opisowe
aggregate(lek ~ grupa, dane, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))

# 2. Test Welcha: t, df, dokładne p i 95% CI różnicy średnich
tt <- t.test(lek ~ grupa, data = dane)
tt
round(unname(tt$estimate[1] - tt$estimate[2]), 2)   # różnica średnich (trening − kontrola)

# 3. Wielkość efektu z 95% CI
cohens_d(lek ~ grupa, data = dane, pooled_sd = TRUE)

# 4. Czułość: jaki efekt badanie wykrywało z mocą 80% i 90% (α = .05, dwustronnie)?
round(c(moc80 = power.t.test(n = 40, sd = 1, power = .80)$delta,
        moc90 = power.t.test(n = 40, sd = 1, power = .90)$delta), 2)

# 5. Symulacja: 10 000 replikacji tego samego badania (2 × 40 osób), gdy prawdziwy
#    efekt jest dokładnie taki, jaki dało badanie z p = .06, i dla porównania – z p = .04.
#    Efekt odpowiadający danemu p: d = t × √(2/n), gdzie t to kwantyl rozkładu t (df = 78).
d_z_p <- function(p, n = 40) qt(1 - p / 2, df = 2 * n - 2) * sqrt(2 / n)
replikacje <- function(d, n = 40, R = 10000) {
  replicate(R, t.test(rnorm(n, 0, 1), rnorm(n, d, 1), var.equal = TRUE)$p.value)
}
set.seed(1621)
p06 <- replikacje(d_z_p(.06))
p04 <- replikacje(d_z_p(.04))
przedzialy <- function(p) round(100 * prop.table(table(cut(p, c(0, .01, .05, .10, 1),
                                labels = c("p < .01", ".01–.05", ".05–.10", "p > .10")))), 1)
wyniki <- rbind(`p = .06` = c(d = d_z_p(.06), istotne_n = sum(p06 < .05),
                              quantile(p06, c(.10, .50, .90))),
                `p = .04` = c(d = d_z_p(.04), istotne_n = sum(p04 < .05),
                              quantile(p04, c(.10, .50, .90))))
round(wyniki, 3)
rbind(`p = .06` = przedzialy(p06), `p = .04` = przedzialy(p04))
Wynik w R
     grupa lek.n lek.M lek.SD
1  trening 40.00 22.45   6.69
2 kontrola 40.00 25.20   6.30

	Welch Two Sample t-test

data:  lek by grupa
t = -1.8924, df = 77.709, p-value = 0.06216
alternative hypothesis: true difference in means between group trening and group kontrola is not equal to 0
95 percent confidence interval:
 -5.6432287  0.1432287
sample estimates:
 mean in group trening mean in group kontrola
                 22.45                  25.20

[1] -2.75
Cohen's d |        95% CI
-------------------------
-0.42     | [-0.87, 0.02]

- Estimated using pooled SD.moc80 moc90
 0.63  0.73
            d istotne_n   10%  50%   90%
p = .06 0.427      4663 0.002 0.06 0.514
p = .04 0.467      5445 0.001 0.04 0.422
        p < .01 .01–.05 .05–.10 p > .10
p = .06    23.7    22.9    12.6    40.7
p = .04    29.4    25.0    12.4    33.1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test() i power.t.test() z pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Co napisać zamiast „wynik marginalnie istotny”?
Napisz, że różnica nie była istotna statystycznie, i podaj pełny wynik testu z dokładnym p, np. p = .062. Dodaj wielkość efektu z 95% przedziałem ufności i jedno zdanie o tym, jakie efekty są zgodne z danymi. Takie zdanie mówi czytelnikowi więcej niż etykieta „trend”.
Czy można przyjąć poziom istotności .10, żeby p = .06 było istotne?
Tylko wtedy, gdy α = .10 ustalono i uzasadniono przed zebraniem danych, np. w preregistracji albo w planie pracy. Zmiana progu po zobaczeniu wyniku to jedna z form p-hackingu i podważa sens testu. Jeśli przyjęto α = .05, wynik p = .06 opisujesz jako nieistotny.
Jaka jest szansa, że replikacja da p < .05, jeśli moje badanie dało p = .06?
Nawet przy optymistycznym założeniu, że prawdziwy efekt jest dokładnie taki jak w Twoim badaniu, w symulacji 10 000 replikacji (2 × 40 osób) wynik istotny wyszedł w 4663 przypadkach, czyli mniej więcej co drugi raz. Efekty zaobserwowane tuż przy progu bywają zawyżone, więc w praktyce szansa jest zwykle mniejsza.
Powiązane hasła
Przeczytaj też
Jak opisać wynik nieistotny
Co podać przy p > .05, jak odróżnić brak efektu od wyniku nierozstrzygającego, sformułowania źle i dobrze oraz gotowy wzór opisu w stylu APA.
Czytaj →PoradnikWartość p – interpretacja
Błędne odczytania p na jednym przykładzie, symulacja p pod H0 i H1, replikacje, p a przedział ufności i wielkość efektu – z kodem R.
Czytaj →PoradnikWynik istotny, ale efekt mały
Dlaczego przy dużej próbie słaby efekt daje p < .001, jak ocenić jego znaczenie praktyczne i jak go uczciwie opisać w pracy – przykład w R.
Czytaj →Wyszło p = .06 i nie wiesz, jak to opisać?
Sprawdzimy analizę, policzymy efekt z przedziałem ufności i czułość badania, a potem pomożemy Ci zrozumieć, co ten wynik naprawdę mówi i jak go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Amrhein, V., Greenland, S., & McShane, B. (2019). Scientists rise up against statistical significance. Nature, 567(7748), 305–307. https://doi.org/10.1038/d41586-019-00857-9 ● Otwarty dostęp
- Cumming, G. (2008). Replication and p intervals: p values predict the future only vaguely, but confidence intervals do much better. Perspectives on Psychological Science, 3(4), 286–300. https://doi.org/10.1111/j.1745-6924.2008.00079.x
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Olsson-Collentine, A., van Assen, M. A. L. M., & Hartgerink, C. H. J. (2019). The prevalence of marginally significant results in psychology over time. Psychological Science, 30(4), 576–586. https://doi.org/10.1177/0956797619830326 ● Otwarty dostęp
- Pritschet, L., Powell, D., & Horne, Z. (2016). Marginally significant effects as evidence for hypotheses: Changing attitudes over four decades. Psychological Science, 27(7), 1036–1042. https://doi.org/10.1177/0956797616645672
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
Cytowania BibTeX
@article{amrhein2019scientists, author={Amrhein, Valentin and Greenland, Sander and McShane, Blake}, title={{Scientists rise up against statistical significance}}, journal={Nature}, year={2019}, volume={567}, number={7748}, pages={305--307}, doi={10.1038/d41586-019-00857-9}}@article{cumming2008replication, author={Cumming, Geoff}, title={{Replication and p intervals: p values predict the future only vaguely, but confidence intervals do much better}}, journal={Perspectives on Psychological Science}, year={2008}, volume={3}, number={4}, pages={286--300}, doi={10.1111/j.1745-6924.2008.00079.x}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{olssoncollentine2019prevalence, author={Olsson-Collentine, Anton and van Assen, Marcel A. L. M. and Hartgerink, Chris H. J.}, title={{The prevalence of marginally significant results in psychology over time}}, journal={Psychological Science}, year={2019}, volume={30}, number={4}, pages={576--586}, doi={10.1177/0956797619830326}}@article{pritschet2016marginally, author={Pritschet, Laura and Powell, Derek and Horne, Zachary}, title={{Marginally significant effects as evidence for hypotheses: Changing attitudes over four decades}}, journal={Psychological Science}, year={2016}, volume={27}, number={7}, pages={1036--1042}, doi={10.1177/0956797616645672}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}