Przykład: sklep z zabawkami i pytanie „ile zamówień w pierwszym kwartale?”
Fikcyjny sklep internetowy z zabawkami i grami planszowymi ma dzienną liczbę zamówień z trzech lat: od 1 stycznia 2023 do 31 grudnia 2025 roku. Dział marketingu i magazyn pytają: ile zamówień przyjdzie w styczniu–kwietniu 2026 roku i ile dodadzą zaplanowane promocje? To szereg czasowy: kolejność dni ma znaczenie, a sąsiednie dni są do siebie podobne.
Wpis szeregi czasowe i ARIMA w praktyce pokazuje dane miesięczne i ocenę interwencji. Tu mamy dane dzienne, dwie sezonowości naraz, święta ruchome i promocje oraz uczciwy test prognozy. Produkt bez historii opisuje model dyfuzji Bassa.
Dane są fikcyjne, więc znamy prawdziwy mechanizm. Ręcznie ustaliliśmy: start ok. 110 zamówień dziennie i wzrost ok. 14% rocznie; rytm tygodnia (poniedziałek najwyżej, sobota najniżej); falę roczną; narastanie zakupów od 10 listopada do 20 grudnia; Black Friday z weekendem i poniedziałkiem; Dzień Dziecka (20–31 maja); tydzień przed Wielkanocą; prawie puste dni świąteczne (24–26 grudnia, 1 stycznia, Wielkanoc). Promocje trwają 3 dni, mają rabat 10, 15 albo 20%, a ich efekt rośnie z rabatem coraz wolniej (nasycenie). Do tego szum zależny od poprzedniego dnia. Ziarno 629 ustalono raz i nie zmieniano. Dane pobierzesz jako prognoza-sprzedazy-zamowienia-dzienne.csv (wiersz = dzień; w wierszach z 2026 roku są tylko kalendarz i plan promocji).
Rysunek 1: trzy lata zamówień
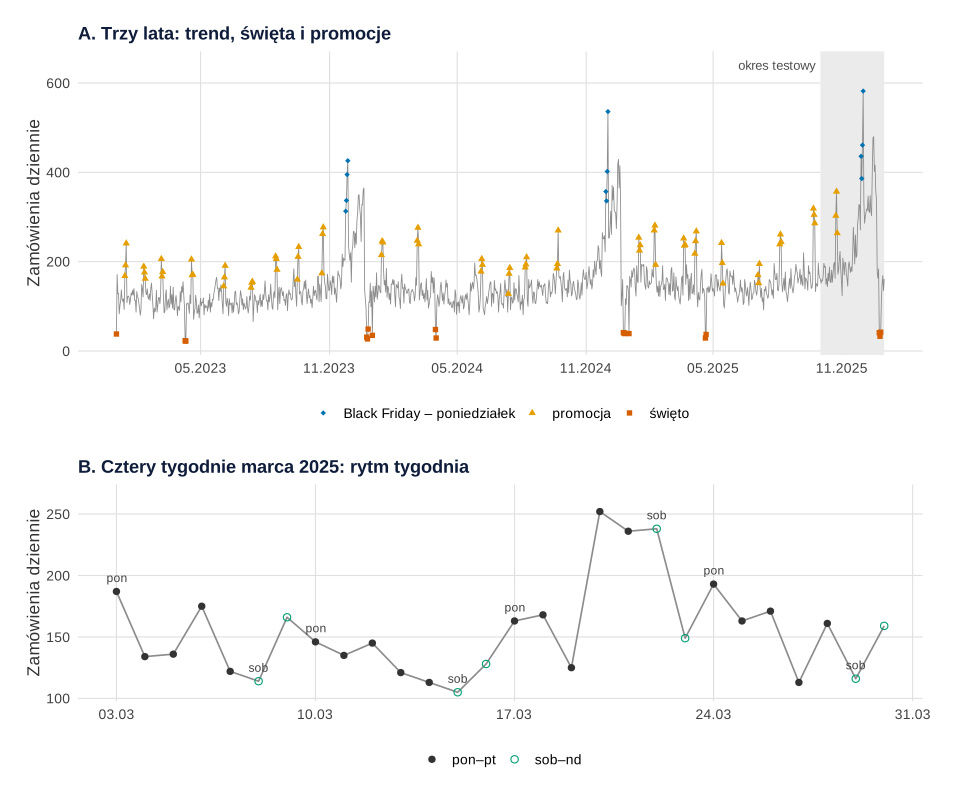
set.seed(629)).Co widać. Średnio sklep miał 136.1 zamówienia dziennie w 2023 roku, 150.7 w 2024 i 174.3 w 2025. W każdym grudniu linia rośnie, a 24–26 grudnia spada do 27–49 zamówień. Black Friday 2025 z weekendem i poniedziałkiem dał 436, 386, 461 i 582 zamówienia. W dniach promocji (styczeń–październik) średnia wynosiła 214.8, w zwykłe dni 131.5. Panel B pokazuje sezonowość tygodniową: średnio 168.5 zamówienia w poniedziałki i 134.4 w soboty.
Jak może zmylić. Różnica średnich to nie efekt promocji: akcje mogły trafiać na lepsze miesiące.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: rozkład na trend i dwie sezonowości (STL)
Dane dzienne mają dwie sezonowości: tygodniową (okres 7 dni) i roczną (365.25 dnia). Szeregi z wieloma okresami sezonowymi wymagają osobnych narzędzi; De Livera i in. (2011) opisują je wraz z reprezentacją sezonowości przez sinusy i cosinusy (wyrazy Fouriera). Funkcja mstl() z pakietu forecast rozkłada szereg metodą STL na trend, obie sezonowości i resztę. Liczymy na logarytmie liczby zamówień, więc składniki to zmiany procentowe. Do dekompozycji używamy tylko historii, bez okresu testowego.
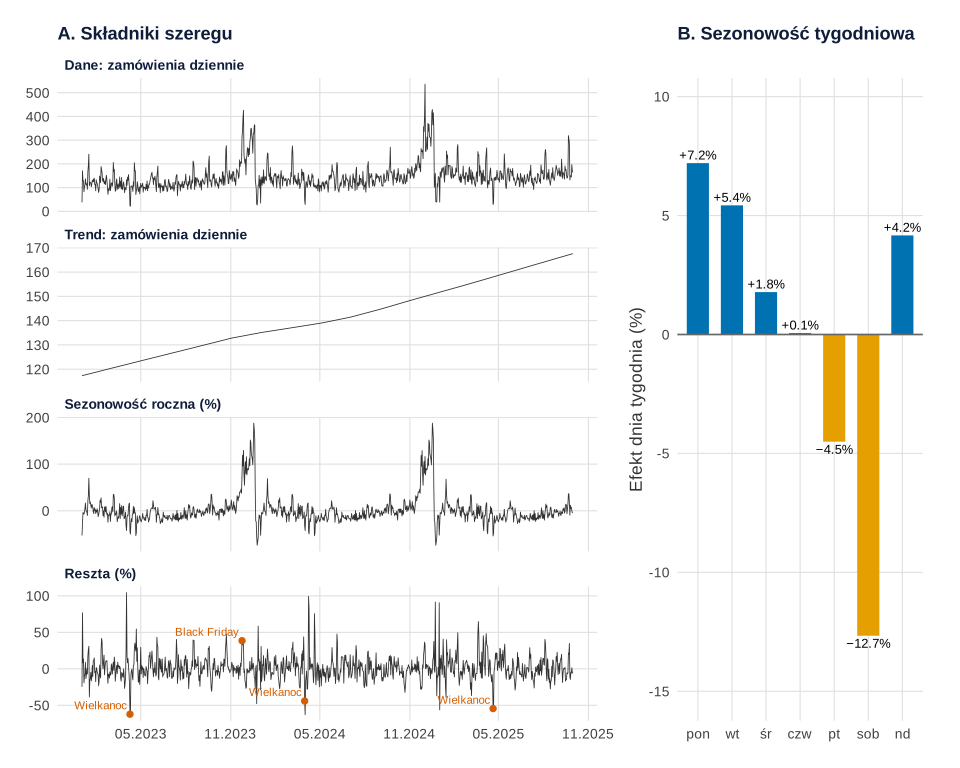
Co widać. Trend rośnie ze 117.3 do 167.6 zamówienia dziennie. Efekt tygodnia: od +7.2% w poniedziałek do −12.7% w sobotę. Sezonowość roczna sięga od −73.9% do +187.7% (szczyt 18 grudnia 2023). Największe reszty są przy Wielkanocy: −62.9% w Poniedziałek Wielkanocny 2024 i −62.2% w Niedzielę Wielkanocną 2023.
Jak może zmylić. STL zna tylko okresy stałe w kalendarzu. Wielkanoc się przesuwa, więc jej spadek trafia do reszty albo zostaje „skopiowany” na tę samą datę innego roku. Stąd reszta +104.4% 2 kwietnia 2023: składnik roczny przeniósł tam spadek z Poniedziałku Wielkanocnego 2024 (1 kwietnia). Przy niespełna trzech latach składnik roczny łapie też promocje i jest poszarpany. Dekompozycja służy do opisu, a święta ruchome i promocje trzeba dodać do modelu osobno.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: historia – walidacja – prognoza
Prognozę ocenia się na dniach, których model nie widział. W szeregu czasowym dzieli się dane w czasie, a nie losowo: model uczy się na przeszłości i prognozuje przyszłość. Losowe wycinanie dni, jak w zwykłej walidacji krzyżowej, przecieka informacją z przyszłości.
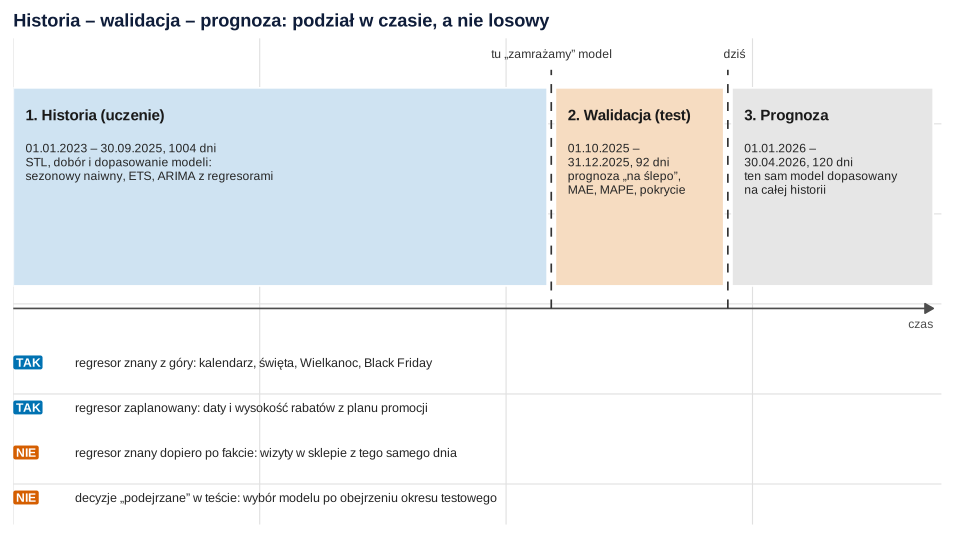
Co widać. Historia (1004 dni) służy do dekompozycji, doboru i dopasowania modeli. Na 92 dniach testu (październik–grudzień 2025, z Black Friday i świętami) model prognozuje „na ślepo”. Na końcu ten sam model dopasowujemy do wszystkich danych i prognozujemy 120 dni 2026 roku. Pod osią: jako regresor wolno użyć tylko tego, co w dniu prognozy jest znane albo zaplanowane.
Jak może zmylić. Jeden okres testowy to jedna próba. Pewniejsza ocena powtarza prognozę z kilku punktów startowych (okno kroczące).
Zdanie do Metody:
Cztery modele: od naiwnego do ARIMA z regresorami
- Sezonowy naiwny: jutro będzie tak, jak w ten sam dzień tygodnia tydzień temu. To punkt odniesienia – lepszy model musi go pobić.
- Naiwny roczny: ten sam dzień tygodnia rok wcześniej (364 dni wstecz).
- ETS, czyli wygładzanie wykładnicze w postaci przestrzeni stanów. Metoda wywodzi się z prognozowania sprzedaży: Winters (1960) opisał ją jako szybki i tani sposób rutynowego prognozowania tysięcy produktów. Funkcja
ets()wybrała model ETS(A,Ad,A) z tłumionym trendem i sezonowością tygodniową. Nie zna ani roku, ani świąt, ani promocji. - ARIMA z regresorami (regresja z błędami ARIMA) na logarytmie zamówień. Część regresyjna: trend liniowy, zmienne 0–1 dni tygodnia (kodowanie zero-jedynkowe), 4 pary wyrazów Fouriera dla roku, zmienne świąt i okresów oraz rabat. Błędy: autokorelacja sąsiednich dni. Rząd wybrała funkcja
auto.arima()(Hyndman i Khandakar, 2008) przy d = 0: ARMA(1,1).
Dlaczego d = 0 i trend? Bez trendu w regresorach auto.arima() różnicował szereg (d = 1) i wybrał ARIMA(3,1,1) ze współczynnikiem MA(1) = −0.982. MA bliskie −1 po różnicowaniu to znak nadmiernego różnicowania: model „odkręca” zbędną różnicę. Wtedy wstaw trend do regresorów i dopasuj model z d = 0. Tu prognozowały podobnie (MAE = 31.2 i 30.9), ale model z trendem jest prostszy.
Każdy współczynnik części regresyjnej to procentowa zmiana zamówień. Trend wynosi +13.2% rocznie. Rabat 15% podnosił sprzedaż o 75.7%, Black Friday o 81.2%, a dzień świąteczny obniżał o 76.2% względem zwykłego dnia. Test Ljunga–Boxa nie wykazał autokorelacji reszt, Q(12) = 15.15, p = .233. Prognozy przyszłych dni dostają przyszłe wartości regresorów: kalendarz 2026 roku i plan promocji.
Rysunek 4: prognozy na okres testowy
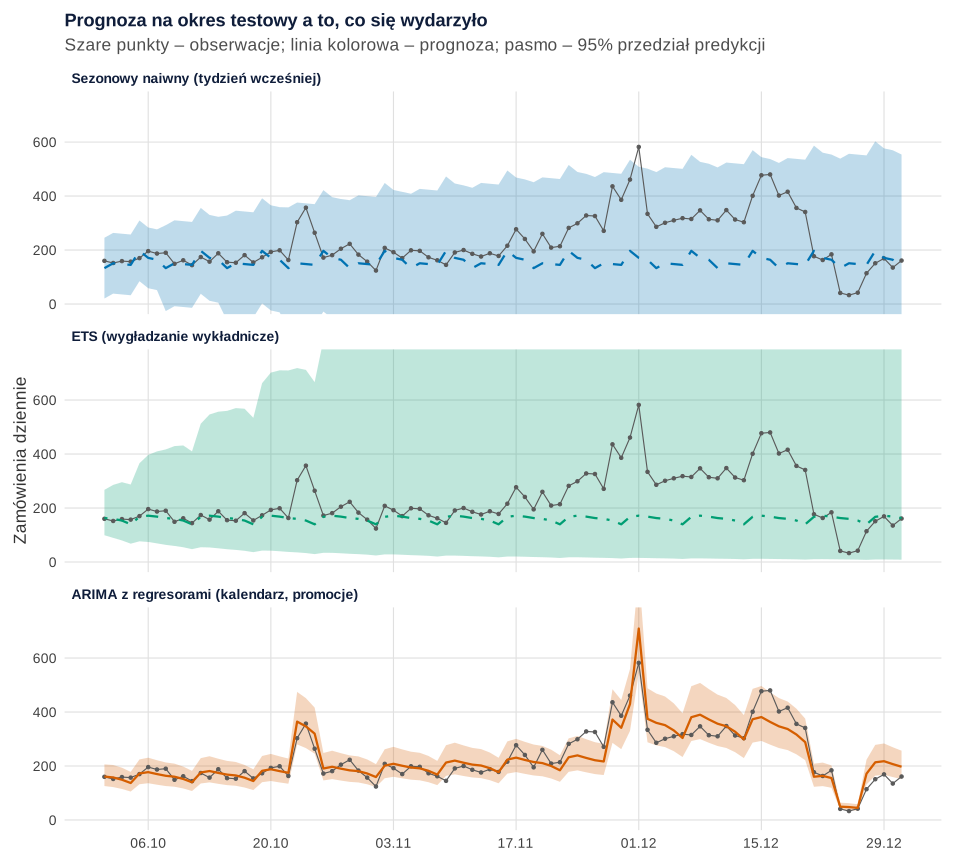
Co widać. Sezonowy naiwny i ETS powtarzają rytm tygodnia z września. Nie przewidują ani promocji, ani Black Friday, ani grudnia, ani pustych świąt. ARIMA z regresorami idzie za obserwacjami, bo dostała kalendarz i plan promocji. W paśmie 95% znalazło się 91.3% dni testowych ARIMA, 98.9% sezonowego naiwnego i 100% ETS.
Jak może zmylić. Wysokie pokrycie nie świadczy o dobrej prognozie: pasmo ETS sięga od zera ponad górną krawędź wykresu (oś ucięto na 750), więc zmieści wszystko. Przedział predykcji to inny przedział niż pasmo ufności dla średniej – zob. pasmo ufności i pasmo predykcji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: MAE, MAPE i porównanie z modelem naiwnym
Dwie najprostsze miary błędu prognozy: MAE – średni błąd bezwzględny (w zamówieniach dziennie) i MAPE – średni błąd procentowy. Hyndman i Koehler (2006) pokazali, że wiele popularnych miar zawodzi w typowych sytuacjach, i zaproponowali skalowanie błędu błędem prognozy naiwnej (MASE). W tym duchu podajemy też MAE modelu podzielone przez MAE sezonowego naiwnego w okresie testowym.
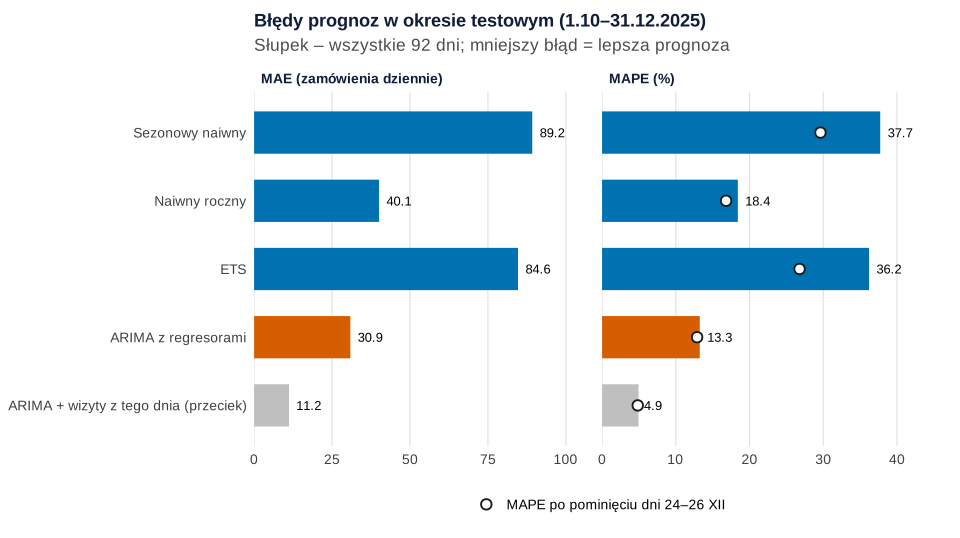
Co widać. ARIMA z regresorami ma najmniejsze błędy wśród modeli uczciwych: MAE = 30.9 zamówienia (35% błędu sezonowego naiwnego) i MAPE = 13.3%. Zaskakująco dobry jest naiwny roczny (MAE = 40.1, MAPE = 18.4%), bo pamięta zeszłoroczny grudzień. ETS (MAE = 84.6) prawie nie bije sezonowego naiwnego (89.2).
Jak może zmylić: MAPE przy małych wartościach. W dniach 24–26 grudnia przyszło 41, 33 i 42 zamówienia, a sezonowy naiwny przewidział 133, 151 i 148. Błąd procentowy tych trzech dni wynosi średnio 278.1%. Te 3 z 92 dni dają 24.0% całego MAPE sezonowego naiwnego: bez nich MAPE spada z 37.7% do 29.6%. Przy zerowej sprzedaży MAPE jest w ogóle nieokreślone. Podawaj więc MAE obok MAPE i sprawdź, czy wynik nie zależy od kilku dni.
Jak może zmylić: przeciek danych. Szary słupek to ARIMA z dodaną liczbą wizyt w sklepie z tego samego dnia: MAE = 11.2, prawie trzy razy mniej. To złudzenie. Wizyty z 15 marca poznamy dopiero 15 marca, więc w prognozie ich nie ma. Model „za dobry, by był prawdziwy” to sygnał, żeby sprawdzić, skąd pochodzą regresory.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: prognoza na styczeń–kwiecień 2026
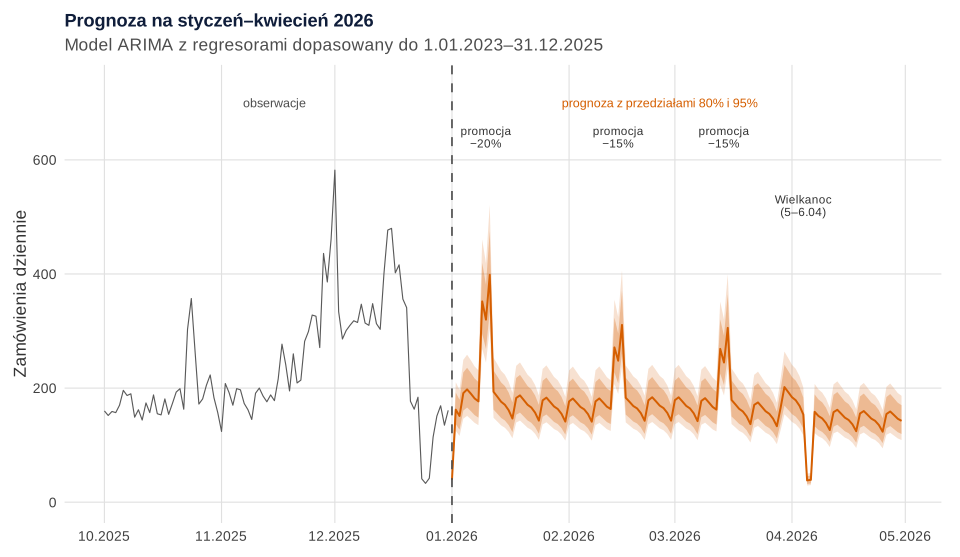
set.seed(629) dla symulacji sumy).Co widać. Model o tym samym rzędzie, dopasowany do całych trzech lat, przewiduje rytm tygodnia, spadek 1 stycznia i w Wielkanoc oraz trzy zaplanowane promocje. Rabat 15% podnosi teraz sprzedaż o 74.9%. Pasmo 95% ma 19.6 zamówienia szerokości pierwszego dnia i 77.6 sto dwudziestego. Suma zamówień w pierwszym kwartale: 16240 (suma prognoz dziennych), a 95% przedział z 1000 symulowanych ścieżek: [15549, 17203].
Jak może zmylić. Sumy kwartału nie liczy się, dodając dolne i górne granice dni – wyszłoby za szeroko. Przedziały zakładają, że model jest poprawny, a plan promocji zostanie wykonany.
Pułapka: promocja, jakiej nie było w historii. Załóżmy, że marketing zamiast rabatu 15% w marcu chce dać 40%. Model widział tylko rabaty 10–20% i ma efekt liniowy na skali logarytmu, więc przewiduje wzrost o 344.1%. W naszym symulatorze prawdziwy wzrost przy 40% to 131.1% (przy 15%: model 74.9%, prawda 76.6%). Model nie wie, że efekt się nasyca. Cooper i in. (1999) zauważają to samo w systemie prognoz promocji dla sklepów: błąd rośnie, gdy produkt promuje się w nowy sposób. Taką akcję najpierw sprawdź na części klientów albo w kilku dniach, a prognozę podaj jako scenariusz.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Zapasy i magazyn: planuj według górnej granicy przedziału w dniach promocji, a nie według linii prognozy.
- Plan promocji to dane wejściowe. Zapisuj daty i rabaty przed akcją. Bez tego model nie odróżni promocji od wzrostu i nie przewidzi kolejnej.
- Kalendarz sklepu: Wielkanoc, Black Friday, Dzień Dziecka, terminy dostaw przed świętami – każde takie zdarzenie dopisz jako zmienną.
- Nowy typ akcji (rabat 40%, nowy kanał): prognoza to zgadywanie. Sprawdź akcję w teście. Analitycy znający biznes powinni móc poprawić prognozę ręcznie; Taylor i Letham (2018) proponują w tym celu model regresyjny o interpretowalnych parametrach i automatyczne oznaczanie prognoz do przeglądu.
- Po kampanii: porównaj sprzedaż z prognozą. Duże odchylenia wykrywa karta kontrolna dla KPI na resztach z modelu. Prognoza to nie ocena przyczynowego efektu reklamy – do tego służą eksperymenty i MMM.
Jak opisać w pracy
W Metodzie podaj okres danych, podział na część uczącą i testową, modele (z punktem odniesienia), transformację, regresory i miary błędu. W Wynikach – tabelę MAE i MAPE dla wszystkich modeli, wykres prognoz na okres testowy i prognozę końcową z przedziałami. Zwróć uwagę, czy szereg jest stacjonarny – w przykładzie trend opisała część regresyjna, więc błędy modelowano bez różnicowania. Inne typowe analizy do pracy z marketingu zebraliśmy we wpisie statystyka w pracy z marketingu.
Kod R: dekompozycja, modele, ocena i prognoza
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 4 – funkcję regresory() i modele, z których korzystają kolejne. Modele dopasowuje pakiet forecast (snaive(), ets(), auto.arima(), Arima(), mstl()). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane) i 6 (1000 ścieżek do przedziału sumy kwartału); oba zaczynają się od własnego set.seed(629). Ziarno 629 ustalono raz i nie zmieniano go. Ręcznie ustalono: poziom startowy 110 zamówień, wzrost 0.13 na skali logarytmu rocznie, efekty dni tygodnia (od +0.10 w poniedziałek do −0.16 w sobotę), falę roczną (amplituda 0.12), narastanie od 10 listopada do 20 grudnia (do +0.9), efekty Black Friday (+0.55), Dnia Dziecka (+0.30), tygodnia przed Wielkanocą (+0.20), dni świątecznych (−1.40), 21–23 grudnia (−0.10) i 27–31 grudnia (−0.20), efekt rabatu 0.9 × (1 − e−rabat/15), promocje w 80% miesięcy (styczeń–październik) z rabatem 10, 15 albo 20%, plan promocji na 2026 rok (20, 15 i 15%), szum AR(1) z φ = 0.5 i SD = 0.07, konwersję wizyt 2.8%, granice okresów oraz 4 pary wyrazów Fouriera w modelu. Całość liczy się w kilkanaście sekund.
1. Paleta, dane i opis: Rysunek 1
R
# Rysunek 1. Fikcyjny sklep internetowy z zabawkami: dzienna liczba zamówień 2023–2025 (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Kalendarz: 3 lata historii i 4 miesiące, na które przygotujemy prognozę
dni <- seq(as.Date("2023-01-01"), as.Date("2026-04-30"), by = "day")
kal <- data.frame(data = dni, rok = as.integer(format(dni, "%Y")), mies = as.integer(format(dni, "%m")),
                  dzien = as.integer(format(dni, "%d")), dzien_roku = as.integer(format(dni, "%j")),
                  dt = as.integer(format(dni, "%u")))                       # 1 = poniedziałek … 7 = niedziela
kal$dzien_tyg <- factor(c("pon", "wt", "śr", "czw", "pt", "sob", "nd")[kal$dt],
                        levels = c("pon", "wt", "śr", "czw", "pt", "sob", "nd"))

# Święta i okresy specjalne (kalendarz polski; Wielkanoc to święto ruchome)
wielkanoc <- as.Date(c("2023-04-09", "2024-03-31", "2025-04-20", "2026-04-05"))
piatki_xi <- kal$data[kal$mies == 11 & kal$dt == 5]
black_friday <- as.Date(tapply(piatki_xi, format(piatki_xi, "%Y"), max))  # ostatni piątek listopada
kal$black_friday <- as.integer(sapply(kal$data, function(d) any(d - black_friday >= 0 & d - black_friday <= 3)))
kal$dzien_dziecka <- as.integer(kal$mies == 5 & kal$dzien >= 20)            # 20–31 maja
kal$grudzien <- as.integer(kal$mies == 12 & kal$dzien <= 20)                 # zakupy przed świętami
kal$po_terminie <- as.integer(kal$mies == 12 & kal$dzien %in% 21:23)         # po terminie dostawy przed Wigilią
kal$swieto <- as.integer((kal$mies == 12 & kal$dzien %in% 24:26) | (kal$mies == 1 & kal$dzien == 1) |
                         kal$data %in% c(wielkanoc, wielkanoc + 1))
kal$przed_wielkanoca <- as.integer(sapply(kal$data, function(d) any(wielkanoc - d >= 1 & wielkanoc - d <= 6)))

set.seed(629)                                   # ziarno ustalone raz, bez dobierania pod wynik
# Promocje: w każdym miesiącu poza listopadem i grudniem z p = .8 jedna 3-dniowa akcja z rabatem 10, 15 albo 20%
kal$rabat <- 0
for (r in 2023:2025) for (m in 1:10) if (runif(1) < 0.8) {
  start <- as.Date(sprintf("%d-%02d-%02d", r, m, sample(3:24, 1)))
  kal$rabat[kal$data %in% (start + 0:2)] <- sample(c(10, 15, 20), 1)
}
kal$rabat[kal$dzien_dziecka == 1 | kal$przed_wielkanoca == 1 | kal$swieto == 1] <- 0
# Akcje zaplanowane na 2026 rok (kalendarz działu marketingu)
plan_2026 <- data.frame(start = as.Date(c("2026-01-09", "2026-02-13", "2026-03-13")), rabat = c(20, 15, 15))
for (i in seq_len(nrow(plan_2026))) kal$rabat[kal$data %in% (plan_2026$start[i] + 0:2)] <- plan_2026$rabat[i]

# Prawdziwy mechanizm (ustalony ręcznie) na skali logarytmu: trend, tydzień, rok, święta, promocje, szum AR(1)
efekt_rabatu <- function(rabat) 0.9 * (1 - exp(-rabat / 15))   # efekt rośnie coraz wolniej (nasycenie)
lata <- as.numeric(kal$data - as.Date("2023-01-01")) / 365.25
tydzien <- c(0.10, 0.05, 0, -0.02, -0.08, -0.16, 0.06)[kal$dt]
rok <- 0.12 * cos(2 * pi * (kal$dzien_roku - 330) / 365.25)
dni_od_10xi <- as.numeric(kal$data - as.Date(sprintf("%d-11-10", kal$rok)))
przedswiateczne <- ifelse(dni_od_10xi >= 0 & dni_od_10xi <= 40, 0.9 * dni_od_10xi / 40, 0)
log_mu <- log(110) + 0.13 * lata + tydzien + rok + przedswiateczne +
  0.55 * kal$black_friday + 0.30 * kal$dzien_dziecka + 0.20 * kal$przed_wielkanoca -
  1.40 * kal$swieto - 0.10 * kal$po_terminie - 0.20 * (kal$mies == 12 & kal$dzien >= 27) +
  efekt_rabatu(kal$rabat)
szum <- as.numeric(arima.sim(list(ar = 0.5), n = nrow(kal), sd = 0.07))
kal$zamowienia <- rpois(nrow(kal), exp(log_mu + szum))
kal$wizyty <- round(kal$zamowienia / (0.028 * exp(rnorm(nrow(kal), 0, 0.06))))  # znane dopiero po fakcie

# Podział w czasie: historia (uczenie), okres testowy (walidacja), przyszłość (prognoza – zamówień nie znamy)
kal$okres <- cut(kal$data, as.Date(c("2023-01-01", "2025-10-01", "2026-01-01", "2026-05-01")), right = FALSE,
                 labels = c("historia", "test", "prognoza"))
kal$zamowienia[kal$okres == "prognoza"] <- NA
kal$wizyty[kal$okres == "prognoza"] <- NA
dane <- subset(kal, okres != "prognoza")
write.csv(kal[, c("data", "dzien_tyg", "okres", "zamowienia", "wizyty", "rabat", "black_friday", "dzien_dziecka",
                  "grudzien", "po_terminie", "swieto", "przed_wielkanoca")],
          "prognoza-sprzedazy-zamowienia-dzienne.csv", row.names = FALSE, na = "")

# Opis danych
c(dni_historii = sum(kal$okres == "historia"), dni_testu = sum(kal$okres == "test"),
  dni_prognozy = sum(kal$okres == "prognoza"), dni_promocji_w_historii = sum(dane$rabat > 0))
round(tapply(dane$zamowienia, dane$rok, mean), 1)                       # średnio zamówień dziennie w roku
round(tapply(dane$zamowienia, dane$dzien_tyg, mean), 1)                 # według dnia tygodnia
cbind(black_friday_pt_pn = tapply(dane$zamowienia[dane$black_friday == 1], dane$rok[dane$black_friday == 1],
                                  paste, collapse = " "),
      dni_24_26_XII = tapply(dane$zamowienia[dane$swieto == 1 & dane$mies == 12],
                             dane$rok[dane$swieto == 1 & dane$mies == 12], paste, collapse = " "))
round(c(promocja = mean(dane$zamowienia[dane$rabat > 0 & dane$mies <= 10]),
        bez_promocji = mean(dane$zamowienia[dane$rabat == 0 & dane$mies <= 10 & dane$dzien_dziecka == 0 &
                                            dane$przed_wielkanoca == 0 & dane$swieto == 0])), 1)

dane$typ <- ifelse(dane$rabat > 0, "promocja", ifelse(dane$black_friday == 1, "Black Friday – poniedziałek",
                   ifelse(dane$swieto == 1, "święto", "zwykły dzień")))
p1a <- ggplot(dane, aes(data, zamowienia)) +
  annotate("rect", xmin = as.Date("2025-10-01"), xmax = as.Date("2025-12-31"), ymin = -Inf, ymax = Inf,
           fill = "grey92") +
  annotate("text", x = as.Date("2025-09-25"), y = 640, label = "okres testowy", hjust = 1, size = 3.4, colour = "grey30") +
  geom_line(colour = kol[["szary"]], linewidth = 0.3) +
  geom_point(data = subset(dane, typ != "zwykły dzień"), aes(colour = typ, shape = typ), size = 1.5) +
  scale_colour_manual(values = c("promocja" = kol[["pomarancz"]], "Black Friday – poniedziałek" = kol[["niebieski"]],
                                 "święto" = kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c("promocja" = 17, "Black Friday – poniedziałek" = 18, "święto" = 15), name = NULL) +
  scale_x_date(date_breaks = "6 months", date_labels = "%m.%Y") +
  labs(x = NULL, y = "Zamówienia dziennie", title = "A. Trzy lata: trend, święta i promocje") + motyw
tydz <- subset(dane, data >= as.Date("2025-03-03") & data <= as.Date("2025-03-30"))
p1b <- ggplot(tydz, aes(data, zamowienia)) +
  geom_line(colour = kol[["szary"]]) +
  geom_point(aes(colour = dt >= 6, shape = dt >= 6), size = 2.2) +
  geom_text(data = subset(tydz, dt %in% c(1, 6)), aes(label = dzien_tyg), vjust = -1.1, size = 3.2,
            colour = "grey25") +
  scale_colour_manual(values = c(`FALSE` = kol[["ciemny"]], `TRUE` = kol[["zielony"]]),
                      labels = c("pon–pt", "sob–nd"), name = NULL) +
  scale_shape_manual(values = c(`FALSE` = 16, `TRUE` = 1), labels = c("pon–pt", "sob–nd"), name = NULL) +
  scale_y_continuous(expand = expansion(mult = c(0.05, 0.15))) +
  scale_x_date(date_breaks = "1 week", date_labels = "%d.%m") +
  labs(x = NULL, y = "Zamówienia dziennie", title = "B. Cztery tygodnie marca 2025: rytm tygodnia") + motyw
p1 <- p1a / p1b + plot_layout(heights = c(1.4, 1))
p1   # zapis: ggsave("prognoza-sprzedazy-dane-dzienne.svg", p1, width = 10, height = 8.4)
Wynik w R
           dni_historii               dni_testu            dni_prognozy
                   1004                      92                     120
dni_promocji_w_historii
                     72
 2023  2024  2025
136.1 150.7 174.3
  pon    wt    śr   czw    pt   sob    nd
168.5 160.5 153.3 150.9 146.5 134.4 161.6
     black_friday_pt_pn dni_24_26_XII
2023 "313 337 395 426"  "31 27 49"
2024 "357 336 402 536"  "41 41 39"
2025 "436 386 461 582"  "41 33 42"
    promocja bez_promocji
       214.8        131.5
2. Dekompozycja STL z dwiema sezonowościami: Rysunek 2
R
# Rysunek 2. Dekompozycja STL historii (1.01.2023–30.09.2025) z dwiema sezonowościami: tygodniową i roczną
library(forecast)
hist <- subset(dane, okres == "historia")
y_msts <- msts(log(hist$zamowienia), seasonal.periods = c(7, 365.25))   # logarytm: efekty jako procenty
rozklad <- mstl(y_msts)                                                  # STL (Cleveland i in.) dla wielu okresów
skl <- data.frame(data = hist$data, dt = hist$dt, dzien_tyg = hist$dzien_tyg, as.data.frame(unclass(rozklad)))
names(skl)[names(skl) == "Seasonal7"] <- "tydz"; names(skl)[names(skl) == "Seasonal365.25"] <- "rokS"
procent <- function(x) 100 * (exp(x) - 1)                                # efekt na skali log → zmiana w %

# Odczyt: trend na początku i końcu historii, profil tygodnia, sezonowość roczna, największe reszty
round(exp(skl$Trend[c(1, nrow(skl))]), 1)
round(procent(tapply(skl$tydz, skl$dzien_tyg, mean)), 1)
round(procent(range(skl$rokS)), 1); format(skl$data[which.max(skl$rokS)], "%d.%m.%Y")
naj <- head(skl[order(-abs(skl$Remainder)), c("data", "dzien_tyg", "Remainder")], 8)
naj$reszta_proc <- round(procent(naj$Remainder), 1); naj$Remainder <- NULL; naj
round(100 * c(reszty_sd = sd(skl$Remainder)), 1)

dlugi <- rbind(
  data.frame(data = skl$data, panel = "Dane: zamówienia dziennie", wartosc = exp(skl$Data)),
  data.frame(data = skl$data, panel = "Trend: zamówienia dziennie", wartosc = exp(skl$Trend)),
  data.frame(data = skl$data, panel = "Sezonowość roczna (%)", wartosc = procent(skl$rokS)),
  data.frame(data = skl$data, panel = "Reszta (%)", wartosc = procent(skl$Remainder)))
dlugi$panel <- factor(dlugi$panel, levels = unique(dlugi$panel))
etyk <- subset(transform(skl, wartosc = procent(Remainder), panel = factor("Reszta (%)", levels(dlugi$panel))),
               data %in% c(black_friday, wielkanoc, wielkanoc - 3) & abs(wartosc) > 25)
etyk$opis <- ifelse(etyk$data %in% black_friday, "Black Friday",
                    ifelse(etyk$data %in% wielkanoc, "Wielkanoc", "przed Wielkanocą"))
p2a <- ggplot(dlugi, aes(data, wartosc)) +
  geom_line(colour = kol[["ciemny"]], linewidth = 0.3) +
  geom_point(data = etyk, colour = kol[["cynober"]], size = 1.8) +
  geom_text(data = etyk, aes(label = opis), colour = kol[["cynober"]], size = 3, vjust = -0.6, hjust = 1.05) +
  facet_wrap(~ panel, ncol = 1, scales = "free_y") +
  scale_x_date(date_breaks = "6 months", date_labels = "%m.%Y") +
  labs(x = NULL, y = NULL, title = "A. Składniki szeregu") + motyw
tyg <- data.frame(dzien_tyg = factor(levels(skl$dzien_tyg), levels(skl$dzien_tyg)),
                  efekt = procent(as.numeric(tapply(skl$tydz, skl$dzien_tyg, mean))))
p2b <- ggplot(tyg, aes(dzien_tyg, efekt, fill = efekt > 0)) +
  geom_col(width = 0.65) + geom_hline(yintercept = 0, colour = "grey40") +
  geom_text(aes(label = sub("-", "−", sprintf("%+.1f%%", efekt)), vjust = ifelse(efekt > 0, -0.4, 1.3)), size = 3.4) +
  scale_fill_manual(values = c(`TRUE` = kol[["niebieski"]], `FALSE` = kol[["pomarancz"]]), guide = "none") +
  scale_y_continuous(expand = expansion(mult = 0.18)) +
  labs(x = NULL, y = "Efekt dnia tygodnia (%)", title = "B. Sezonowość tygodniowa") + motyw
p2 <- p2a + p2b + plot_layout(widths = c(2.2, 1))
p2   # zapis: ggsave("prognoza-sprzedazy-dekompozycja-stl.svg", p2, width = 10, height = 8)
Wynik w R
[1] 117.3 167.6
  pon    wt    śr   czw    pt   sob    nd
  7.2   5.4   1.8   0.1  -4.5 -12.7   4.2
[1] -73.9 187.7
[1] "18.12.2023"
          data dzien_tyg reszta_proc
457 2024-04-01       pon       -62.9
99  2023-04-09        nd       -62.2
100 2023-04-10       pon       -58.1
732 2025-01-01        śr       -56.2
842 2025-04-21       pon       -55.2
841 2025-04-20        nd       -54.5
92  2023-04-02        nd       104.4
464 2024-04-08       pon        99.3
reszty_sd
     16.8
3. Schemat podziału w czasie: Rysunek 3
R
# Rysunek 3. Schemat podziału w czasie: historia – walidacja – prognoza (grafika z prostokątów i tekstu)
okresy <- aggregate(data ~ okres, data = kal, FUN = function(d) c(min(d), max(d), length(d)))
okresy <- data.frame(okres = okresy$okres, od = as.Date(okresy$data[, 1]), do = as.Date(okresy$data[, 2]),
                     dni = okresy$data[, 3])
okresy
f <- function(d) format(d, "%d.%m.%Y")
bloki <- data.frame(
  x0 = c(0, 6.6, 8.75), x1 = c(6.5, 8.65, 11.2), y0 = 2.2, y1 = 4.4,
  kolor = c("historia", "test", "prognoza"),
  tytul = c("1. Historia (uczenie)", "2. Walidacja (test)", "3. Prognoza"),
  opis = c(sprintf("%s – %s, %d dni\nSTL, dobór i dopasowanie modeli:\nsezonowy naiwny, ETS, ARIMA z regresorami",
                   f(okresy$od[1]), f(okresy$do[1]), okresy$dni[1]),
           sprintf("%s –\n%s, %d dni\nprognoza „na ślepo”,\nMAE, MAPE, pokrycie", f(okresy$od[2]),
                   f(okresy$do[2]), okresy$dni[2]),
           sprintf("%s –\n%s, %d dni\nten sam model dopasowany\nna całej historii", f(okresy$od[3]),
                   f(okresy$do[3]), okresy$dni[3])))
reguly <- data.frame(
  x = c(0, 0, 0, 0), y = c(1.35, 0.85, 0.35, -0.15),
  znak = c("TAK", "TAK", "NIE", "NIE"),
  tekst = c("regresor znany z góry: kalendarz, święta, Wielkanoc, Black Friday",
            "regresor zaplanowany: daty i wysokość rabatów z planu promocji",
            "regresor znany dopiero po fakcie: wizyty w sklepie z tego samego dnia",
            "decyzje „podejrzane” w teście: wybór modelu po obejrzeniu okresu testowego"))
p3 <- ggplot() +
  geom_rect(data = bloki, aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1, fill = kolor), colour = "white") +
  geom_text(data = bloki, aes(x = x0 + 0.15, y = y1 - 0.3, label = tytul), hjust = 0, fontface = "bold",
            size = 4, colour = "grey10") +
  geom_text(data = bloki, aes(x = x0 + 0.15, y = y1 - 0.62, label = opis), hjust = 0, vjust = 1, size = 3.2,
            lineheight = 0.95, colour = "grey15") +
  annotate("segment", x = 0, xend = 11.2, y = 1.95, yend = 1.95, colour = "grey30",
           arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("text", x = 11.2, y = 1.78, label = "czas", hjust = 1, size = 3.2, colour = "grey30") +
  annotate("segment", x = 6.55, xend = 6.55, y = 1.95, yend = 4.6, linetype = "dashed", colour = "grey20") +
  annotate("segment", x = 8.7, xend = 8.7, y = 1.95, yend = 4.6, linetype = "dashed", colour = "grey20") +
  annotate("text", x = 6.55, y = 4.78, label = "tu „zamrażamy” model", size = 3.2, colour = "grey20") +
  annotate("text", x = 8.7, y = 4.78, label = "dziś", size = 3.2, colour = "grey20", hjust = 0.2) +
  geom_label(data = reguly, aes(x = x, y = y, label = znak, fill = znak), hjust = 0, size = 3.2,
             fontface = "bold", colour = "white", linewidth = 0, label.padding = unit(0.18, "lines")) +
  geom_text(data = reguly, aes(x = x + 0.75, y = y, label = tekst), hjust = 0, size = 3.3, colour = "grey15") +
  scale_fill_manual(values = c(historia = "#cfe3f2", test = "#f6dcc1", prognoza = "#e6e6e6",
                               TAK = kol[["niebieski"]], NIE = kol[["cynober"]]), guide = "none") +
  scale_x_continuous(limits = c(0, 11.3), expand = c(0, 0)) +
  scale_y_continuous(limits = c(-0.45, 4.95), expand = c(0, 0)) +
  labs(title = "Historia – walidacja – prognoza: podział w czasie, a nie losowy") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
p3   # zapis: ggsave("prognoza-sprzedazy-schemat-podzialu.svg", p3, width = 10, height = 5.6)
Wynik w R
     okres         od         do  dni
1 historia 2023-01-01 2025-09-30 1004
2     test 2025-10-01 2025-12-31   92
3 prognoza 2026-01-01 2026-04-30  120
4. Cztery modele i prognozy na okres testowy: Rysunek 4
R
# Rysunek 4. Cztery modele dopasowane do historii i ich prognozy na okres testowy (1.10–31.12.2025)
library(forecast)
hist <- subset(kal, okres == "historia"); test <- subset(kal, okres == "test")
h <- nrow(test)
y7 <- ts(hist$zamowienia, frequency = 7)                     # szereg dzienny z okresem tygodniowym

# Regresory znane z góry: trend, dni tygodnia, sezonowość roczna (wyrazy Fouriera), święta, plan promocji
regresory <- function(d) {
  trend <- as.numeric(d$data - as.Date("2023-01-01")) / 365.25        # lata od początku danych
  t_roku <- 2 * pi * d$dzien_roku / 365.25
  fourier_rok <- do.call(cbind, lapply(1:4, function(k) cbind(sin(k * t_roku), cos(k * t_roku))))
  colnames(fourier_rok) <- paste0(rep(c("S", "C"), 4), rep(1:4, each = 2), "_rok")
  cbind(trend, model.matrix(~ dzien_tyg, d)[, -1], fourier_rok,
        as.matrix(d[, c("black_friday", "dzien_dziecka", "grudzien", "po_terminie", "swieto", "przed_wielkanoca")]),
        rabat10 = d$rabat / 10)                               # rabat w dziesiątkach punktów procentowych
}
X_hist <- regresory(hist); X_test <- regresory(test)

# 1. Sezonowy naiwny: wartość sprzed tygodnia
m_snaive <- snaive(y7, h = h, level = 95)
# 2. Naiwny roczny: ten sam dzień tygodnia rok wcześniej (364 dni wstecz)
pr_rok <- kal$zamowienia[match(test$data - 364, kal$data)]
# 3. ETS: wygładzanie wykładnicze z sezonowością tygodniową (na logarytmie)
m_ets <- ets(y7, lambda = 0)
f_ets <- forecast(m_ets, h = h, level = 95)
# 4. ARIMA z regresorami (regresja z błędami ARIMA, na logarytmie); rząd dobiera auto.arima()
# Najpierw bez trendu – auto.arima() różnicuje szereg (d = 1), a MA(1) wychodzi bliskie −1: różnicowanie zbędne
m_d1 <- auto.arima(y7, xreg = X_hist[, -1], seasonal = FALSE, lambda = 0)
c(arimaorder(m_d1), round(coef(m_d1)[["ma1"]], 3),
  MAE_test = round(mean(abs(test$zamowienia - forecast(m_d1, xreg = X_test[, -1])$mean)), 1))
# Model końcowy: trend w regresorach, błędy stacjonarne (d = 0)
m_arima <- auto.arima(y7, xreg = X_hist, d = 0, seasonal = FALSE, lambda = 0)
f_arima <- forecast(m_arima, xreg = X_test, level = 95)

m_ets$method; m_arima
Box.test(residuals(m_arima), lag = 14, type = "Ljung-Box", fitdf = 2)  # reszty: 14 opóźnień minus 2 parametry ARMA
round(c(trend_rocznie = 100 * (exp(coef(m_arima)[["trend"]]) - 1), rabat_15 = 100 * (exp(1.5 * coef(m_arima)[["rabat10"]]) - 1),
        black_friday = 100 * (exp(coef(m_arima)[["black_friday"]]) - 1),
        swieto = 100 * (exp(coef(m_arima)[["swieto"]]) - 1)), 1)  # efekty w % względem zwykłego dnia

prognozy <- data.frame(data = test$data, obserwacja = test$zamowienia,
                       sezonowy_naiwny = as.numeric(m_snaive$mean), naiwny_roczny = pr_rok,
                       ETS = as.numeric(f_ets$mean), ARIMA = as.numeric(f_arima$mean))
pasma <- rbind(
  data.frame(model = "Sezonowy naiwny (tydzień wcześniej)", data = test$data, prognoza = as.numeric(m_snaive$mean),
             dol = as.numeric(m_snaive$lower), gora = as.numeric(m_snaive$upper)),
  data.frame(model = "ETS (wygładzanie wykładnicze)", data = test$data, prognoza = as.numeric(f_ets$mean),
             dol = as.numeric(f_ets$lower), gora = as.numeric(f_ets$upper)),
  data.frame(model = "ARIMA z regresorami (kalendarz, promocje)", data = test$data,
             prognoza = as.numeric(f_arima$mean), dol = as.numeric(f_arima$lower), gora = as.numeric(f_arima$upper)))
pasma$model <- factor(pasma$model, levels = unique(pasma$model))
obs <- merge(data.frame(model = levels(pasma$model)), data.frame(data = test$data, obserwacja = test$zamowienia))
obs$model <- factor(obs$model, levels = levels(pasma$model))
p4 <- ggplot(pasma, aes(data)) +
  geom_ribbon(aes(ymin = dol, ymax = gora, fill = model), alpha = 0.25) +
  geom_line(data = obs, aes(y = obserwacja), colour = "grey35", linewidth = 0.4) +
  geom_point(data = obs, aes(y = obserwacja), colour = "grey35", size = 0.8) +
  geom_line(aes(y = prognoza, colour = model, linetype = model), linewidth = 0.8) +
  facet_wrap(~ model, ncol = 1) +
  scale_colour_manual(values = unname(kol[c("niebieski", "zielony", "cynober")]), guide = "none") +
  scale_fill_manual(values = unname(kol[c("niebieski", "zielony", "cynober")]), guide = "none") +
  scale_linetype_manual(values = c("dashed", "dotdash", "solid"), guide = "none") +
  coord_cartesian(ylim = c(0, 750)) +
  scale_x_date(date_breaks = "2 weeks", date_labels = "%d.%m") +
  labs(x = NULL, y = "Zamówienia dziennie",
       title = "Prognoza na okres testowy a to, co się wydarzyło",
       subtitle = "Szare punkty – obserwacje; linia kolorowa – prognoza; pasmo – 95% przedział predykcji") + motyw
p4   # zapis: ggsave("prognoza-sprzedazy-modele-okres-testowy.svg", p4, width = 10, height = 9)
Wynik w R
       p        d        q          MAE_test
   3.000    1.000    1.000   -0.982   31.200
[1] "ETS(A,Ad,A)"
Series: y7
Regression with ARIMA(1,0,1) errors
Box Cox transformation: lambda= 0

Coefficients:
         ar1      ma1  intercept   trend  dzien_tygwt  dzien_tygśr
      0.6467  -0.3617     4.8247  0.1244      -0.0439      -0.0849
s.e.  0.0602   0.0715     0.0174  0.0092       0.0129       0.0138
      dzien_tygczw  dzien_tygpt  dzien_tygsob  dzien_tygnd   S1_rok  C1_rok
           -0.1088      -0.1656       -0.2533      -0.0258  -0.0897  0.1575
s.e.        0.0142       0.0142        0.0138       0.0128   0.0106  0.0117
       S2_rok  C2_rok   S3_rok  C3_rok   S4_rok   C4_rok  black_friday
      -0.0323  0.0259  -0.0408  0.0061  -0.0399  -0.0197        0.5946
s.e.   0.0110  0.0110   0.0114  0.0105   0.0111   0.0104        0.0588
      dzien_dziecka  grudzien  po_terminie   swieto  przed_wielkanoca  rabat10
             0.2655    0.4747      -0.3348  -1.4355            0.1745   0.3758
s.e.         0.0369    0.0445       0.0673   0.0382            0.0438   0.0138

sigma^2 = 0.01589:  log likelihood = 667.18
AIC=-1282.37   AICc=-1280.93   BIC=-1154.66

	Box-Ljung test

data:  residuals(m_arima)
X-squared = 15.152, df = 12, p-value = 0.2332

trend_rocznie      rabat_15  black_friday        swieto
         13.2          75.7          81.2         -76.2
5. MAE, MAPE, pokrycie przedziałów i przeciek danych: Rysunek 5
R
# Rysunek 5. Ocena prognoz w okresie testowym: MAE i MAPE (z dniami 24–26 XII i bez nich) oraz przeciek danych
mae <- function(y, f) mean(abs(y - f))
mape <- function(y, f) 100 * mean(abs(y - f) / y)
swieta_xii <- format(test$data, "%m-%d") %in% c("12-24", "12-25", "12-26")

# Przeciek: model z liczbą wizyt z tego samego dnia – w dniu prognozy tej liczby jeszcze nie znamy
m_przeciek <- auto.arima(y7, xreg = cbind(X_hist, log_wizyty = log(hist$wizyty)), seasonal = FALSE, lambda = 0)
f_przeciek <- forecast(m_przeciek, xreg = cbind(X_test, log_wizyty = log(test$wizyty)), level = 95)
prognozy$przeciek <- as.numeric(f_przeciek$mean)

modele <- c(sezonowy_naiwny = "Sezonowy naiwny", naiwny_roczny = "Naiwny roczny", ETS = "ETS",
            ARIMA = "ARIMA z regresorami", przeciek = "ARIMA + wizyty z tego dnia (przeciek)")
ocena <- data.frame(model = modele,
  MAE = sapply(names(modele), function(m) mae(prognozy$obserwacja, prognozy[[m]])),
  MAPE = sapply(names(modele), function(m) mape(prognozy$obserwacja, prognozy[[m]])),
  MAPE_bez_24_26 = sapply(names(modele), function(m) mape(prognozy$obserwacja[!swieta_xii], prognozy[[m]][!swieta_xii])),
  MAPE_24_26 = sapply(names(modele), function(m) mape(prognozy$obserwacja[swieta_xii], prognozy[[m]][swieta_xii])),
  row.names = NULL)
ocena$MAE_wzgl_naiwnego <- ocena$MAE / ocena$MAE[1]          # < 1: lepiej niż sezonowy naiwny
print(cbind(ocena[1], round(ocena[2:5], 1), MAE_wzgl_naiwnego = round(ocena$MAE_wzgl_naiwnego, 2)), row.names = FALSE)

# Dni 24–26 XII: obserwacje i prognozy; udział tych 3 z 92 dni w sumie błędów procentowych (czyli w MAPE)
cbind(test[swieta_xii, c("data", "zamowienia")], round(prognozy[swieta_xii, c("sezonowy_naiwny", "ETS", "ARIMA")], 1))
udzial <- function(f) { bp <- abs(prognozy$obserwacja - f) / prognozy$obserwacja; 100 * sum(bp[swieta_xii]) / sum(bp) }
round(sapply(prognozy[c("sezonowy_naiwny", "ETS", "ARIMA")], udzial), 1)

# Pokrycie 95% przedziałów predykcji w okresie testowym (ile obserwacji w środku)
w_srodku <- function(f) mean(test$zamowienia >= f$lower & test$zamowienia <= f$upper)
round(100 * c(sezonowy_naiwny = w_srodku(m_snaive), ETS = w_srodku(f_ets), ARIMA = w_srodku(f_arima)), 1)

dl <- rbind(data.frame(model = ocena$model, miara = "MAE (zamówienia dziennie)", wariant = "wszystkie 92 dni",
                       wartosc = ocena$MAE),
            data.frame(model = ocena$model, miara = "MAPE (%)", wariant = "wszystkie 92 dni", wartosc = ocena$MAPE),
            data.frame(model = ocena$model, miara = "MAPE (%)", wariant = "bez 24–26 XII", wartosc = ocena$MAPE_bez_24_26))
dl$model <- factor(dl$model, levels = rev(modele))
dl$miara <- factor(dl$miara, levels = c("MAE (zamówienia dziennie)", "MAPE (%)"))
dl$grupa <- ifelse(dl$model == modele[["przeciek"]], "przeciek", ifelse(dl$model == modele[["ARIMA"]], "ARIMA", "inne"))
p5 <- ggplot(dl, aes(wartosc, model)) +
  geom_col(data = subset(dl, wariant == "wszystkie 92 dni"), aes(fill = grupa), width = 0.62) +
  geom_point(data = subset(dl, wariant == "bez 24–26 XII"), aes(shape = wariant), size = 3, colour = "grey10",
             fill = "white", stroke = 1) +
  geom_text(data = subset(dl, wariant == "wszystkie 92 dni"), aes(label = sprintf("%.1f", wartosc)),
            hjust = -0.3, size = 3.4) +
  facet_wrap(~ miara, scales = "free_x") +
  scale_fill_manual(values = c(inne = kol[["niebieski"]], ARIMA = kol[["cynober"]], przeciek = "grey75"), guide = "none") +
  scale_shape_manual(values = c("bez 24–26 XII" = 21), labels = "MAPE po pominięciu dni 24–26 XII", name = NULL) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.22))) +
  labs(x = NULL, y = NULL, title = "Błędy prognoz w okresie testowym (1.10–31.12.2025)",
       subtitle = "Słupek – wszystkie 92 dni; mniejszy błąd = lepsza prognoza") + motyw +
  theme(panel.grid.major.y = element_blank())
p5   # zapis: ggsave("prognoza-sprzedazy-bledy-mae-mape.svg", p5, width = 10, height = 5.6)
Wynik w R
                                 model  MAE MAPE MAPE_bez_24_26 MAPE_24_26
                       Sezonowy naiwny 89.2 37.7           29.6      278.1
                         Naiwny roczny 40.1 18.4           16.8       65.6
                                   ETS 84.6 36.2           26.8      315.8
                   ARIMA z regresorami 30.9 13.3           12.9       24.0
 ARIMA + wizyty z tego dnia (przeciek) 11.2  4.9            4.8        8.1
 MAE_wzgl_naiwnego
              1.00
              0.45
              0.95
              0.35
              0.13
           data zamowienia sezonowy_naiwny   ETS ARIMA
1089 2025-12-24         41             133 162.8  49.3
1090 2025-12-25         33             151 159.8  47.8
1091 2025-12-26         42             148 153.6  44.9
sezonowy_naiwny             ETS           ARIMA
           24.0            28.4             5.9
sezonowy_naiwny             ETS           ARIMA
           98.9           100.0            91.3
6. Prognoza na 2026 rok, suma kwartału i rabat spoza historii: Rysunek 6
R
# Rysunek 6. Prognoza na 1.01–30.04.2026 z przedziałami: model ARIMA z regresorami dopasowany na całych danych
znane <- subset(kal, okres != "prognoza"); przysz <- subset(kal, okres == "prognoza")
y_cale <- ts(znane$zamowienia, frequency = 7)
m_final <- Arima(y_cale, order = arimaorder(m_arima), xreg = regresory(znane), lambda = 0)  # ten sam rząd modelu
X_przysz <- regresory(przysz)                     # kalendarz 2026 i plan promocji (rabaty 20, 15 i 15%)
f_final <- forecast(m_final, xreg = X_przysz, level = c(80, 95))
round(c(rabat_15_proc = 100 * (exp(1.5 * coef(m_final)[["rabat10"]]) - 1)), 1)

# Suma zamówień w I kwartale 2026: przedział z 1000 symulowanych ścieżek (sumy granic dziennych nie wolno dodawać)
set.seed(629)
kw1 <- przysz$data <= as.Date("2026-03-31")
sciezki <- replicate(1000, as.numeric(simulate(m_final, nsim = nrow(przysz), xreg = X_przysz, future = TRUE)))
suma_kw1 <- colSums(sciezki[kw1, ])
round(c(prognoza_punktowa = sum(f_final$mean[kw1]), mediana_symulacji = median(suma_kw1),
        quantile(suma_kw1, c(.025, .975))))
round(c(dzien_1 = f_final$upper[1, 2] - f_final$lower[1, 2],
        dzien_120 = f_final$upper[120, 2] - f_final$lower[120, 2]), 1)  # szerokość 95% przedziału

# Pułapka: promocja, jakiej nie było w historii (rabat 40% zamiast 15% w dniach 13–15.03.2026)
b <- coef(m_final)[["rabat10"]]
round(100 * c(model_rabat_15 = exp(1.5 * b) - 1, model_rabat_40 = exp(4 * b) - 1,
              prawda_rabat_15 = exp(efekt_rabatu(15)) - 1, prawda_rabat_40 = exp(efekt_rabatu(40)) - 1), 1)
range(kal$rabat[kal$okres != "prognoza" & kal$rabat > 0])  # rabaty, jakie model widział w danych

pokaz <- data.frame(data = znane$data, y = znane$zamowienia)[znane$data >= as.Date("2025-10-01"), ]
prog <- data.frame(data = przysz$data, prognoza = as.numeric(f_final$mean),
                   d80 = as.numeric(f_final$lower[, 1]), g80 = as.numeric(f_final$upper[, 1]),
                   d95 = as.numeric(f_final$lower[, 2]), g95 = as.numeric(f_final$upper[, 2]))
plan <- data.frame(data = plan_2026$start + 1, etykieta = paste0("promocja\n−", plan_2026$rabat, "%"))
p6 <- ggplot(prog, aes(data)) +
  geom_ribbon(aes(ymin = d95, ymax = g95), fill = kol[["cynober"]], alpha = 0.18) +
  geom_ribbon(aes(ymin = d80, ymax = g80), fill = kol[["cynober"]], alpha = 0.30) +
  geom_line(data = pokaz, aes(y = y), colour = "grey35", linewidth = 0.4) +
  geom_line(aes(y = prognoza), colour = kol[["cynober"]], linewidth = 0.7) +
  annotate("text", x = plan$data, y = 640, label = plan$etykieta, size = 3.1, colour = "grey20", lineheight = 0.9) +
  annotate("text", x = as.Date("2026-04-04"), y = 520, label = "Wielkanoc\n(5–6.04)", size = 3.1, colour = "grey20",
           lineheight = 0.9) +
  annotate("text", x = as.Date("2025-11-15"), y = 700, label = "obserwacje", size = 3.3, colour = "grey30") +
  annotate("text", x = as.Date("2026-02-25"), y = 700, label = "prognoza z przedziałami 80% i 95%", size = 3.3,
           colour = kol[["cynober"]]) +
  geom_vline(xintercept = as.Date("2026-01-01"), linetype = "dashed", colour = "grey30") +
  coord_cartesian(ylim = c(0, 730)) +
  scale_x_date(date_breaks = "1 month", date_labels = "%m.%Y") +
  labs(x = NULL, y = "Zamówienia dziennie", title = "Prognoza na styczeń–kwiecień 2026",
       subtitle = "Model ARIMA z regresorami dopasowany do 1.01.2023–31.12.2025") + motyw
p6   # zapis: ggsave("prognoza-sprzedazy-prognoza-2026.svg", p6, width = 10, height = 5.8)
Wynik w R
rabat_15_proc
         74.9
prognoza_punktowa mediana_symulacji              2.5%             97.5%
            16240             16363             15549             17203
  dzien_1.95% dzien_120.95%
         19.6          77.6
 model_rabat_15  model_rabat_40 prawda_rabat_15 prawda_rabat_40
           74.9           344.1            76.6           131.1
[1] 10 20
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (sezonowy naiwny / ARIMA; TAK / NIE na schemacie)" = c("#0072B2", "#D55E00"),
             "zielony – cynober (ETS / ARIMA)" = c("#009E73", "#D55E00"),
             "niebieski – zielony (sezonowy naiwny / ETS)" = c("#0072B2", "#009E73"),
             "pomarańczowy – niebieski (promocja / Black Friday)" = c("#E69F00", "#0072B2"),
             "pomarańczowy – cynober (promocja / święto)" = c("#E69F00", "#D55E00"),
             "jasnoniebieski – jasnopomarańczowy (historia / test na schemacie)" = c("#cfe3f2", "#f6dcc1"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                      widzenie_typowe
niebieski – cynober (sezonowy naiwny / ARIMA; TAK / NIE na schemacie)           114.6
zielony – cynober (ETS / ARIMA)                                                 102.4
niebieski – zielony (sezonowy naiwny / ETS)                                      70.1
pomarańczowy – niebieski (promocja / Black Friday)                              120.2
pomarańczowy – cynober (promocja / święto)                                       33.4
jasnoniebieski – jasnopomarańczowy (historia / test na schemacie)                27.4
czerwony – zielony (do unikania)                                                121.7
                                                                      deuteranopia
niebieski – cynober (sezonowy naiwny / ARIMA; TAK / NIE na schemacie)        108.3
zielony – cynober (ETS / ARIMA)                                               53.5
niebieski – zielony (sezonowy naiwny / ETS)                                   55.4
pomarańczowy – niebieski (promocja / Black Friday)                           121.5
pomarańczowy – cynober (promocja / święto)                                    18.4
jasnoniebieski – jasnopomarańczowy (historia / test na schemacie)             27.9
czerwony – zielony (do unikania)                                              21.1
                                                                      protanopia
niebieski – cynober (sezonowy naiwny / ARIMA; TAK / NIE na schemacie)       91.9
zielony – cynober (ETS / ARIMA)                                             37.3
niebieski – zielony (sezonowy naiwny / ETS)                                 58.0
pomarańczowy – niebieski (promocja / Black Friday)                         109.3
pomarańczowy – cynober (promocja / święto)                                  24.9
jasnoniebieski – jasnopomarańczowy (historia / test na schemacie)           24.9
czerwony – zielony (do unikania)                                            31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, test Ljunga–Boxa – pakiety base i stats; dekompozycja STL, modele i prognozy – pakiet forecast). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- forecast (wersja 9.0.2): Hyndman, R., Athanasopoulos, G., Bergmeir, C., Caceres, G., Chhay, L., O’Hara-Wild, M., Petropoulos, F., Razbash, S., Wang, E., & Yasmeen, F. (2026). forecast: Forecasting functions for time series and linear models (R package version 9.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.forecast
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ocena na danych uczących. Dopasowanie do historii zawsze wygląda lepiej niż prognoza – to przeuczenie. Oceniaj na okresie testowym.
- Sam MAPE. Kilka dni z małą sprzedażą zawyża go o kilka punktów procentowych; przy zerach jest nieokreślony.
- Przeciek danych: regresory znane dopiero po fakcie, losowy podział dni, wybór modelu po obejrzeniu testu.
- Promocja spoza zakresu historii. Model z rabatami 10–20% przewidział przy 40% wzrost 2.6 razy większy niż prawdziwy.
- Święta ruchome w sezonowości rocznej. Wielkanoc i Black Friday wymagają osobnych zmiennych.
- Nadmierne różnicowanie. Współczynnik MA bliski −1 po różnicowaniu (tu −0.982) znaczy, że różnica była zbędna – dodaj trend do regresorów i dopasuj model z d = 0.
Pomoc przy prognozie do pracy: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak prognozować sprzedaż z sezonowością i promocjami?
Dla danych dziennych użyj regresji z błędami ARIMA: w części regresyjnej trend, dni tygodnia, sezonowość roczna (np. wyrazy Fouriera), zmienne świąt i okresów specjalnych oraz plan promocji, a zależność sąsiednich dni zostaw składnikowi ARIMA. Dopasuj model na historii, sprawdź na okresie testowym i porównaj z prognozą naiwną. W przykładzie taki model zmniejszył MAE z 89.2 do 30.9 zamówienia dziennie.
Ile danych potrzeba do prognozy sprzedaży?
Do sezonowości rocznej potrzeba co najmniej dwóch–trzech pełnych lat, bo każdy miesiąc i każde święto powtarza się tylko raz w roku. W przykładzie przy niespełna trzech latach historii składnik roczny dekompozycji STL był poszarpany i „przenosił” Wielkanoc na złe daty. Do rytmu tygodnia wystarczy kilka miesięcy.
Dlaczego MAPE jest zawodne przy małej sprzedaży?
MAPE dzieli błąd przez obserwację, więc dni z małą sprzedażą dostają ogromne błędy procentowe, a przy zerze miara jest nieokreślona. W przykładzie trzy dni świąteczne (33–42 zamówienia) dały 24.0% całego MAPE prognozy naiwnej. Podawaj MAE obok MAPE i porównuj model z prognozą naiwną.
Czym jest przeciek danych w prognozie?
To użycie informacji, której w dniu prognozy jeszcze nie ma: zmiennych znanych dopiero po fakcie (np. wizyt z tego samego dnia), losowego podziału dni zamiast podziału w czasie albo wyboru modelu po obejrzeniu okresu testowego. W przykładzie model z wizytami z tego samego dnia miał MAE = 11.2 zamiast 30.9 – wynik nieosiągalny w prawdziwej prognozie.
Jak opisać prognozę sprzedaży w pracy?
W Metodzie podaj okres danych, podział na część uczącą i testową, porównywane modele z prognozą naiwną, regresory i miary błędu. W Wynikach – tabelę MAE i MAPE, wykres prognoz na okres testowy i prognozę końcową z przedziałami predykcji. Przedział dla sumy (np. kwartału) policz z symulowanych ścieżek, a nie przez dodawanie granic dziennych.
Powiązane hasła
Przeczytaj też
Szeregi czasowe i ARIMA w praktyce
Trend, sezonowość, ACF i test Ljunga–Boxa, wybór modelu ARIMA w stats::arima, prognoza kontrfaktyczna i regresja segmentowa z kodem R.
Czytaj →PoradnikMarketing mix modeling (MMM)
Producent soków, 156 tygodni i dwa kanały reklamy: adstock, nasycenie, rozkład sprzedaży, ROI z bootstrapem blokowym i pułapki – sześć rysunków z kodem R.
Czytaj →PoradnikAnomalie w KPI – karta kontrolna
Sklep sportowy i dzienna konwersja: karta p, dzień tygodnia, poprawka Laneya, EWMA, CUSUM i symulacja fałszywych alarmów – pięć rysunków z kodem R.
Czytaj →PoradnikRok do roku bez pułapek kalendarza
Sieć kwiaciarni: dzień tygodnia, Wielkanoc, święta w weekend i dni otwarte w porównaniu r/r – regresja z efektami kalendarza i kod R.
Czytaj →PoradnikPogoda a sprzedaż w modelu GAM
Wypożyczalnia kajaków: krzywe temperatury i opadów w GAM, prognoza na jutro z niepewną pogodą i liczba kajaków z kwantyla – z kodem R.
Czytaj →PoradnikNowcasting sprzedaży z wyszukiwań
Dealer kamperów zna sprzedaż po 6 tygodniach: ARIMA z indeksem i zapytaniami, ocena w kroczącym oknie, rewizje i zależność pozorna – z kodem R.
Czytaj →PoradnikPrognoza hierarchiczna i uzgadnianie MinT
Sieć 36 aptek: prognozy aptek, regionów i sieci, które się nie sumują, macierz S, od dołu, od góry i MinT ręcznie – z kodem R.
Czytaj →Prognozujesz sprzedaż w pracy z marketingu?
Pomożemy przygotować dane dzienne lub tygodniowe, dobrać model z sezonowością, świętami i promocjami, uczciwie ocenić prognozę i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cooper, L. G., Baron, P., Levy, W., Swisher, M., & Gogos, P. (1999). PromoCast™: A new forecasting method for promotion planning. Marketing Science, 18(3), 301–316. https://doi.org/10.1287/mksc.18.3.301 ● Otwarty dostęp: pełny tekst
- De Livera, A. M., Hyndman, R. J., & Snyder, R. D. (2011). Forecasting time series with complex seasonal patterns using exponential smoothing. Journal of the American Statistical Association, 106(496), 1513–1527. https://doi.org/10.1198/jasa.2011.tm09771 ● Otwarty dostęp: pełny tekst
- Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3), 1–22. https://doi.org/10.18637/jss.v027.i03 ● Otwarty dostęp
- Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. https://doi.org/10.1016/j.ijforecast.2006.03.001 ● Otwarty dostęp: pełny tekst
- Taylor, S. J., & Letham, B. (2018). Forecasting at scale. The American Statistician, 72(1), 37–45. https://doi.org/10.1080/00031305.2017.1380080 ● Otwarty dostęp: pełny tekst
- Winters, P. R. (1960). Forecasting sales by exponentially weighted moving averages. Management Science, 6(3), 324–342. https://doi.org/10.1287/mnsc.6.3.324
Cytowania BibTeX
@article{cooper1999promocast, author={Cooper, Lee G. and Baron, Penny and Levy, Wayne and Swisher, Michael and Gogos, Paris}, title={{PromoCast™: A new forecasting method for promotion planning}}, journal={Marketing Science}, year={1999}, volume={18}, number={3}, pages={301--316}, doi={10.1287/mksc.18.3.301}}@article{delivera2011forecasting, author={De Livera, Alysha M. and Hyndman, Rob J. and Snyder, Ralph D.}, title={{Forecasting time series with complex seasonal patterns using exponential smoothing}}, journal={Journal of the American Statistical Association}, year={2011}, volume={106}, number={496}, pages={1513--1527}, doi={10.1198/jasa.2011.tm09771}}@article{hyndman2008automatic, author={Hyndman, Rob J. and Khandakar, Yeasmin}, title={{Automatic time series forecasting: The forecast package for R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={3}, pages={1--22}, doi={10.18637/jss.v027.i03}}@article{hyndman2006another, author={Hyndman, Rob J. and Koehler, Anne B.}, title={{Another look at measures of forecast accuracy}}, journal={International Journal of Forecasting}, year={2006}, volume={22}, number={4}, pages={679--688}, doi={10.1016/j.ijforecast.2006.03.001}}@article{taylor2018forecasting, author={Taylor, Sean J. and Letham, Benjamin}, title={{Forecasting at scale}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={37--45}, doi={10.1080/00031305.2017.1380080}}@article{winters1960forecasting, author={Winters, Peter R.}, title={{Forecasting sales by exponentially weighted moving averages}}, journal={Management Science}, year={1960}, volume={6}, number={3}, pages={324--342}, doi={10.1287/mnsc.6.3.324}}