Przykład: dealer kamperów, który zna sprzedaż z opóźnieniem
Fikcyjny dealer kamperów i przyczep kempingowych sprzedaje średnio 66 pojazdów miesięcznie: najwięcej w maju, najmniej w grudniu. Ostateczną sprzedaż miesiąca (po rejestracjach, anulowanych umowach i decyzjach kredytowych) księgowość zamyka 6 tygodni po końcu miesiąca. Tymczasem zarząd na początku listopada musi zamówić u producenta pojazdy na wiosnę i chce wiedzieć: ile sprzedaliśmy w październiku?
Odpowiedź „zanim dane przyjdą” to nowcasting – prognoza teraźniejszości i najbliższej przeszłości. Używa danych, które są dostępne szybciej niż sprzedaż. Dealer ma dwa takie źródła: tygodniowy indeks wyszukiwań fraz o kamperach z narzędzia statystyk wyszukiwarki (skala względna; tu średnia 2018 roku = 100) i liczbę zapytań ofertowych z własnego formularza. Choi i Varian (2012) pokazali, że dane z wyszukiwarki pomagają przewidywać bieżące wartości wskaźników gospodarczych, m.in. sprzedaży samochodów.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie: start ok. 55 pojazdów miesięcznie, wzrost ok. 4% rocznie, stały profil sezonu i „nastroje rynku” – wstrząsy popytu o rozrzucie 0.18 na skali logarytmu (AR(1) z φ = 0.5), których nie widać w przeszłej sprzedaży. Indeks reaguje na te wstrząsy, ale ma własny szum i własny trend (wyszukiwań przybywa o ok. 6% rocznie niezależnie od popytu). Zapytania rosną razem z popytem, z szumem. Ziarna 703 nie zmienialiśmy; zmiany parametrów po pierwszym uruchomieniu opisujemy przy kodzie. Dane pobierzesz jako nowcasting-kampery-miesiace.csv i nowcasting-kampery-tygodnie.csv.
Rysunek 1: osiem lat sprzedaży, wyszukiwań i zapytań
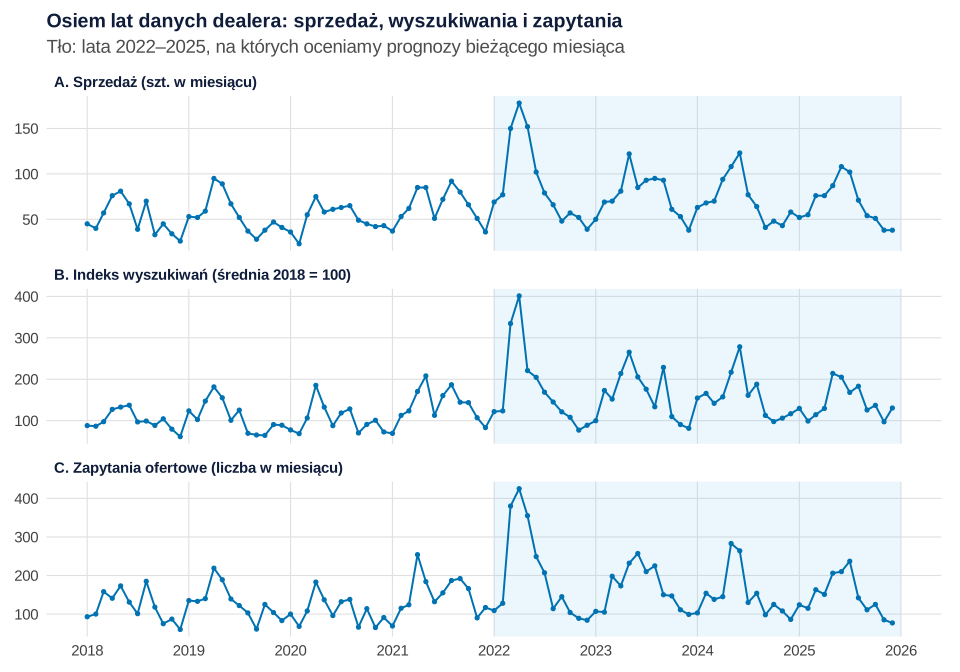
set.seed(703)).Co widać. Trzy szeregi czasowe mają ten sam rytm roku – sezonowość z maksimum w maju i minimum w grudniu – i ten sam „boom” 2022 roku: średnio 89.1 pojazdu miesięcznie wobec 64.2 rok wcześniej. Korelacja logarytmów sprzedaży i indeksu wynosi .89, a sprzedaży i zapytań – .88.
Jak może zmylić. Wysoka korelacja w poziomach niczego jeszcze nie dowodzi: wspólny sezon i trend dają ją same (rysunek 5). Liczy się to, czy indeks mówi coś o odchyleniach od sezonu, których nie zna model oparty na samej historii sprzedaży.
Rysunek 2: co wiemy w dniu prognozy
Zanim cokolwiek policzysz, ustal dzień prognozy i wypisz, co tego dnia naprawdę wiesz.
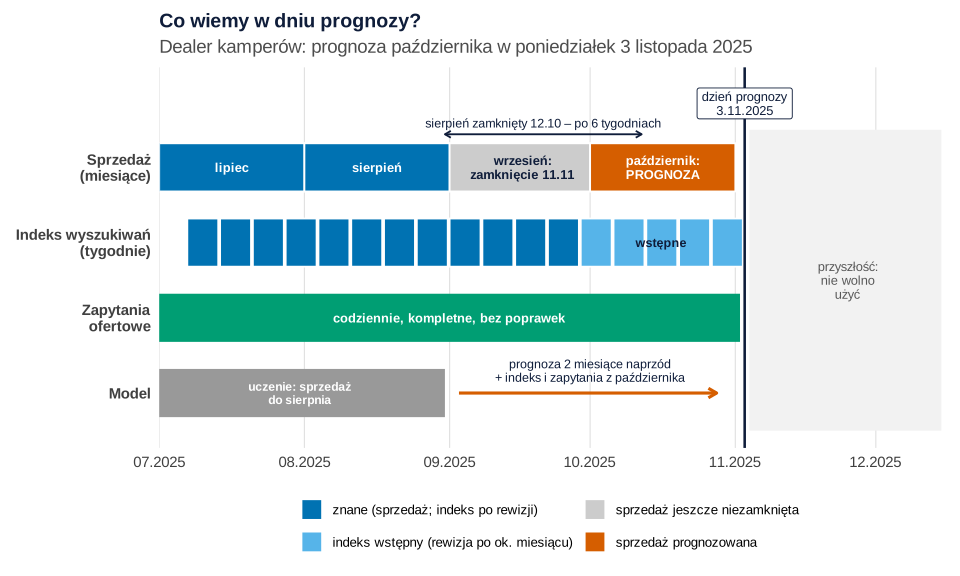
Co widać. 3 listopada znamy sprzedaż do sierpnia (zamknięty 12 października). Wrzesień zamknie się 11 listopada, październik – 12 grudnia. Indeks wyszukiwań mamy za wszystkie tygodnie października, ale wszystkie pięć w wersji wstępnej: dostawca indeksu poprawia go po ok. miesiącu. Zapytania z formularza są kompletne i nikt ich nie poprawia. Model musi więc prognozować dwa miesiące naprzód od ostatniej znanej sprzedaży, a regresory bierze z prognozowanego miesiąca.
Jak może zmylić. Wiersz „przyszłość” to nie tylko sprzedaż października. To także poprawiona wersja indeksu, której 3 listopada jeszcze nie ma. Jeśli pobierzesz dziś cały indeks i ocenisz na nim model, użyjesz informacji z przyszłości (rysunek 4) – to przeciek danych.
Podpis do pracy:
Model bazowy i model z danymi z bieżącego miesiąca
Model bazowy korzysta tylko z historii sprzedaży. Funkcja auto.arima() z pakietu forecast (Hyndman i Khandakar, 2008), uruchomiona na danych znanych przy pierwszej prognozie (do listopada 2021), wybrała sezonowy model ARIMA(1,0,0)(0,1,1)12 dla logarytmu sprzedaży. Dla porównania liczymy też wygładzanie wykładnicze (ets()) i prognozę sezonową naiwną (sprzedaż sprzed roku). Zna on sezon i trend, ale nie „nastrój rynku” z ostatnich miesięcy.
Model z regresorami to ten sam ARIMA, do którego dodajemy logarytm indeksu i logarytm liczby zapytań z prognozowanego miesiąca (regresja z błędami ARIMA):
gdzie St to sprzedaż, It – średni indeks wyszukiwań, Zt – liczba zapytań w miesiącu t. Różnicowanie sezonowe w części błędów sprawia, że współczynniki β opisują związek zmian rok do roku, a nie poziomów – wrócimy do tego przy rysunku 5. Jak budować prognozę z sezonowością, świętami i promocjami, opisuje wpis o prognozie sprzedaży; podstawy modeli ARIMA – szeregi czasowe i ARIMA w praktyce.
Rysunek 3: ocena poza próbą w kroczącym oknie
Model oceniamy tak, jak będzie używany. Dla każdego miesiąca od stycznia 2022 do grudnia 2025 (48 prognoz) cofamy się do dnia prognozy, dopasowujemy model tylko do sprzedaży znanej tego dnia, bierzemy indeks w wersji z tego dnia i prognozujemy. Potem okno przesuwa się o miesiąc. Cerqueira i in. (2020) pokazali, że dla niestacjonarnych szeregów najtrafniejsze oszacowania błędu dają właśnie metody poza próbą, powtarzane w wielu okresach testowych – a nie zwykła walidacja krzyżowa.
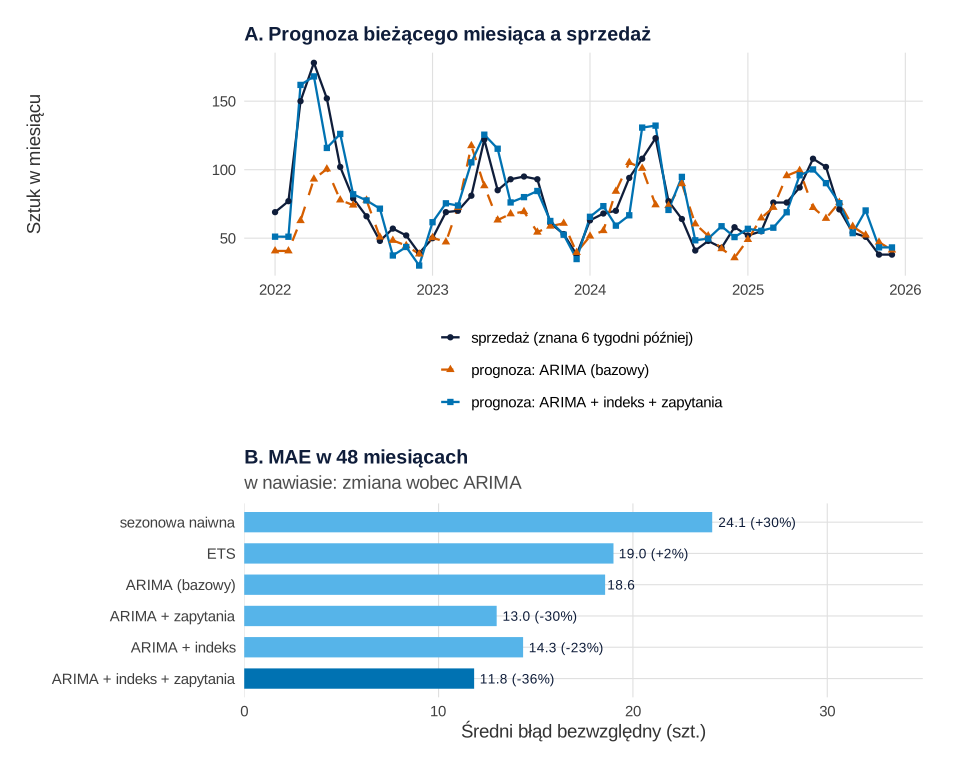
set.seed(703)).Co widać. ARIMA myli się średnio o 18.6 pojazdu (MAE; MAPE 21.0%). Dodanie zapytań obniża MAE do 13.0, dodanie indeksu – do 14.3, a obu naraz – do 11.8 pojazdu, o 36.3% mniej (MAPE 16.3%). Największy zysk przypada na boom 2022 roku (MAE 16.8 wobec 29.0): model bazowy widział tylko spokojną przeszłość, a wyszukiwania i zapytania już rosły. ETS (19.0) nie był lepszy od ARIMA.
Jak może zmylić. 48 miesięcy to niedużo. Test Diebolda–Mariano porównujący błędy bezwzględne obu modeli dał DM = 1.83, p = .074 – przewaga jest wyraźna, ale przy tej liczbie prognoz niepewna. Pojedynczy miesiąc może wypaść gorzej: w październiku 2025 roku sprzedaż wyniosła 51, ARIMA podała 52.3, a model z indeksem – 70.2.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: przeciek przez rewizje indeksu
Indeks wyszukiwań liczony jest z próby zapytań, więc pierwsza publikacja ma większy błąd niż wersja poprawiona. W naszych danych tygodniowa rewizja wynosi w medianie 23.3%, a 90% rewizji mieści się w przedziale [−43.7%, 77.7%] (fraza o kamperach jest rzadka, więc próba jest mała). Pytanie: co się stanie, gdy analityk pobierze dziś cały indeks i oceni na nim model?
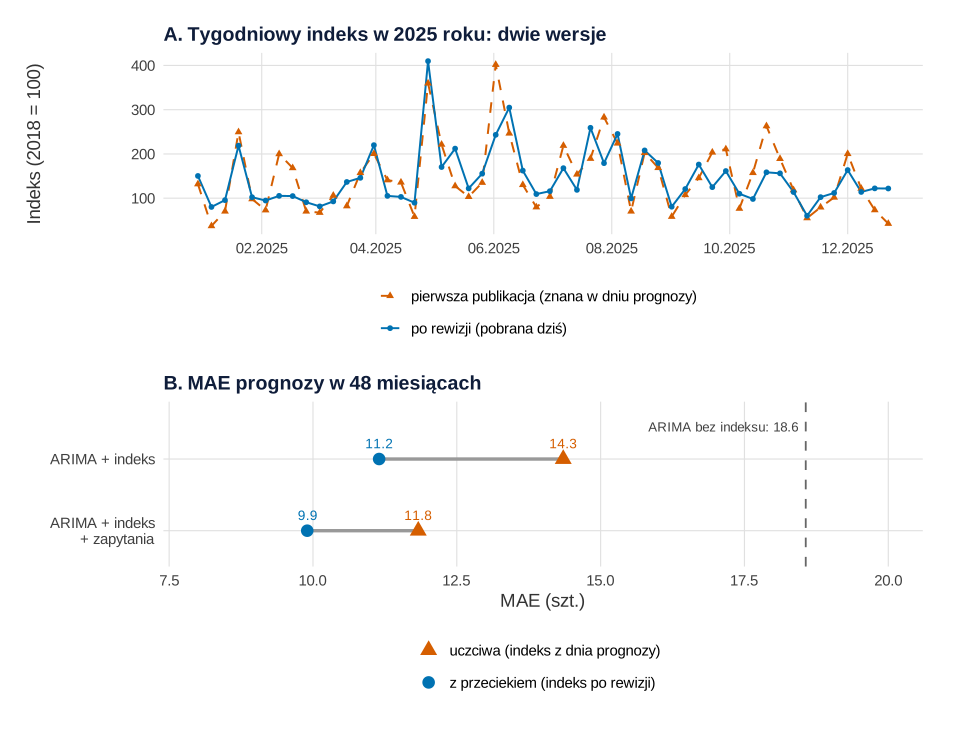
set.seed(703)).Co widać. Ocena na poprawionym indeksie obiecuje MAE 9.9 i poprawę o 46.7% wobec ARIMA. Uczciwa ocena, z indeksem takim, jaki był w dniu prognozy, daje 11.8 i 36.3%. Dla modelu z samym indeksem różnica jest większa: 11.2 wobec 14.3, czyli obiecana poprawa 39.9% zamiast 22.7%. Zapytania, które nie są poprawiane, częściowo chronią przed tym złudzeniem.
Jak może zmylić. Kaufman i in. (2012) definiują przeciek jako informację o wyniku, która nie byłaby dostępna w chwili budowy modelu; rewizje są jego trudną do zauważenia formą, bo plik „wygląda tak samo”. W ekonomii z tego powodu buduje się zbiory danych w czasie rzeczywistym – kolejne wersje (roczniki) tych samych szeregów – i bada, jak rewizje wpływają na prognozy (Croushore, 2011). Jeśli dostawca nie archiwizuje wersji, zapisuj indeks co tydzień sam, z datą pobrania.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: zależność pozorna przy wspólnym trendzie
Skąd wiadomo, że indeks fraz o kamperach niesie informację, a nie tylko powtarza sezon i trend? Porównaj go z frazą, która z kamperami ma wspólny tylko kalendarz: „wakacje nad morzem”. W danych ma ona trend i sezon, ale nie reaguje na wstrząsy popytu na kampery.
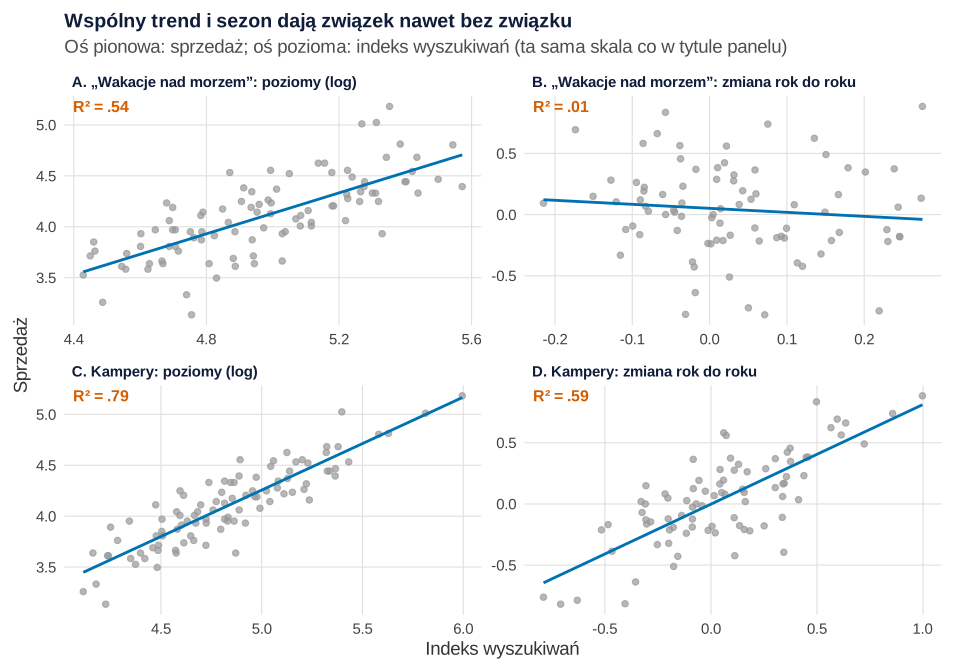
set.seed(703)).Co widać. W poziomach „wakacje nad morzem” wyjaśniają 54% zmienności logarytmu sprzedaży (R² = .54, p < .001). Po przejściu na zmiany rok do roku (różnica logarytmów z odstępem 12 miesięcy) związek znika: R² = .01, p = .360. Indeks fraz o kamperach zachowuje związek także w zmianach: R² = .59, b = 0.81, p < .001 – wzrost indeksu o 10% ponad poziom sprzed roku idzie w parze ze wzrostem sprzedaży o ok. 8%.
Jak może zmylić. To korelacja pozorna. Phillips (1986) pokazał, że w regresji poziomów szeregów niestacjonarnych zwykłe statystyki t i F rosną wraz z liczbą obserwacji, nawet gdy związku nie ma; przeanalizował też zachowanie R² i statystyki Durbina–Watsona w takich regresjach. Sygnałem ostrzegawczym jest autokorelacja reszt – tu .46. Różnicowanie usuwa wspólny trend i sezon; wyjątkiem są szeregi skointegrowane, które łączy trwała równowaga – sprawdzisz to testem opisanym w haśle kointegracja.
Zdanie do Wyników:
Rysunek 6: kiedy indeks przestaje działać
Indeks mierzy zachowanie wyszukujących, nie zamiar zakupu. Gdy zachowanie się zmienia, związek się psuje. Sprawdzamy scenariusz: od stycznia 2025 roku popularny serial o podróżach kamperem zwiększa liczbę wyszukiwań o 40%, a sprzedaż się nie zmienia (ten sam proces co wcześniej).
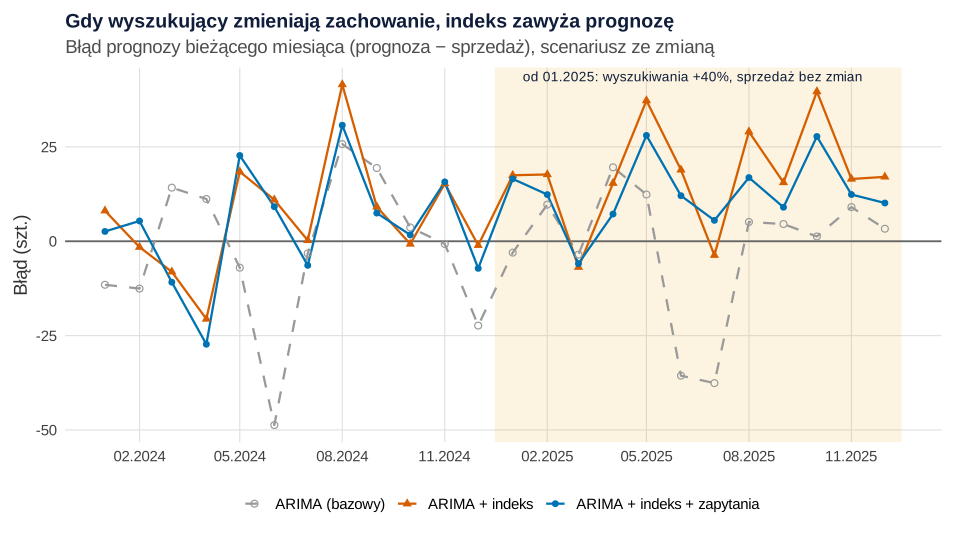
set.seed(703)).Co widać. W 2025 roku model z samym indeksem przeszacował sprzedaż w 10 z 12 miesięcy, średnio o 17.8 pojazdu (o 26.5%), a jego MAE wzrosło do 19.6 – gorzej niż ARIMA (12.1). Model z indeksem i zapytaniami przeszacował w 11 miesiącach, ale mniej: średnio o 12.7 pojazdu, MAE 13.7. Zapytania to własne dane dealera i serial ich nie zmienił.
Jak może zmylić. Jeden zły miesiąc nic nie mówi, ale seria błędów o tym samym znaku – tak. Prognozy grypy oparte na wyszukiwaniach myliły się mocno i, według Lazera i in. (2014), w dużej mierze dało się tego uniknąć. Śledź co miesiąc błąd ze znakiem obu modeli, np. na karcie kontrolnej jak przy anomaliach w KPI. Przy różnicowaniu sezonowym jednorazowy skok indeksu „wygasa” po roku, ale przez ten rok zawyża prognozy.
Podpis do pracy:
Co z tym zrobić w firmie
- Zacznij od osi czasu. Wypisz dla każdego źródła: kiedy dane przychodzą i czy są poprawiane (rysunek 2). Bez tego każda ocena modelu jest podejrzana.
- Własne dane przed cudzymi. Zapytania ofertowe, jazdy próbne, rezerwacje terminów dają podobną poprawę co indeks (MAE 13.0 wobec 14.3), nie mają rewizji i nie zależą od mody na wyszukiwanie.
- Archiwizuj wersje indeksu. Co tydzień zapisuj pobrany plik z datą. Tylko wtedy zrobisz uczciwą ocenę w czasie rzeczywistym.
- Porównuj z modelem bazowym, nie z zerem. Indeks jest wart tyle, o ile obniża błąd ARIMA lub ETS na prognozach poza próbą. Podawaj MAE w sztukach – zarząd rozumie „±12 kamperów”.
- Używaj nowcastu do decyzji, które nie mogą czekać: zamówienia u producenta, obsada salonu na wiosnę, kredyt kupiecki. Gdy sprzedaż przyjdzie, porównaj i zapisz błąd. Prognozy dla salonów, regionów i całej sieci uzgodnisz metodą z wpisu o prognozie hierarchicznej.
- Ustal regułę wyłączenia indeksu, np. trzy kolejne miesiące przeszacowania przy rosnącym indeksie i płaskich zapytaniach. Nietypowe pojedyncze zdarzenia w danych transakcyjnych opisuje wpis o wykrywaniu nietypowych transakcji.
Jak opisać w pracy
Opisz dzień prognozy i opóźnienia każdego źródła, wersje danych (czy indeks był poprawiany), model bazowy i sposób wyboru jego rzędu, regresory, schemat oceny (okno kroczące, liczba prognoz), miary błędu i test porównania. Uczciwie nazwij ograniczenia: krótki okres oceny i ryzyko zmiany zachowania wyszukujących. Więcej o analizach w pracach z ekonomii i zarządzania: statystyka w pracy z zarządzania i ekonomii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane d, przepis 3 – funkcje dopasuj() i prognozy_w_dniu() używane w przepisach 4 i 6. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1 (set.seed(703)); przepisy 2–7 nie losują. Ziarna nie zmieniano. Ręcznie ustalono (przepis 1): poziom startowy 55 pojazdów, wzrost 4% rocznie, profil sezonu, wstrząsy popytu AR(1) z φ = 0.5 i rozrzutem 0.18, trend wyszukiwań 6% rocznie, szum indeksu 0.30 i dodatkowy błąd pierwszej publikacji 0.35 (tygodniowo, na skali logarytmu), szum zapytań 0.08 oraz frazę kontrolną „wakacje nad morzem”; w przepisie 6 – skok wyszukiwań o 40% od stycznia 2025. Zmiany po pierwszym uruchomieniu: parametry ustalono w trzech próbnych uruchomieniach z tym samym ziarnem. W pierwszym sprzedaż była mniejsza (36 pojazdów na start, rozkład ujemny dwumianowy), wstrząsy popytu słabsze (φ = 0.6, rozrzut 0.13), szum indeksu 0.08, błąd pierwszej publikacji 0.15, a zapytania nie miały własnego szumu: wszystkie modele z regresorami miały błąd bliski samemu losowaniu sprzedaży, a różnica między wersjami indeksu była niewidoczna. Potem zwiększono poziom sprzedaży (rozkład Poissona), siłę wstrząsów, szum indeksu i zapytań oraz błąd pierwszej publikacji do obecnych wartości, a okres oceny wydłużono z 36 do 48 miesięcy. Zamiast wybierać model auto.arima() od nowa przy każdej prognozie (skrypt liczył się 1.6 min), rząd ARIMA wybrano raz, na danych sprzed pierwszej prognozy; ets() wybiera model przy każdej prognozie. Wszystkie przepisy liczą się w kilkanaście sekund.
1. Dane dealera: Rysunek 1
R
# Rysunek 1. Fikcyjny dealer kamperów i przyczep: sprzedaż, indeks wyszukiwań i zapytania ofertowe
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie
mies <- seq(as.Date("2018-01-01"), as.Date("2025-12-01"), by = "month")       # 96 miesięcy
sez  <- c(-0.30, -0.10, 0.20, 0.38, 0.40, 0.30, 0.15, 0.00, -0.12, -0.25, -0.40, -0.46)  # sezon (log)
poziom <- 55          # typowa sprzedaż miesięczna na początku (szt.)
wzrost <- 0.04        # trend sprzedaży: ok. 4% rocznie
ar_rynek <- 0.5       # „nastroje rynku”: wstrząsy popytu AR(1) ...
sd_rynek <- 0.18      # ... o tej sile – tych nie widać w przeszłej sprzedaży
trend_wysz <- 0.06    # wyszukiwań przybywa o ok. 6% rocznie niezależnie od popytu (wspólny trend)
sd_wysz <- 0.30       # szum tygodniowego indeksu (wersja poprawiona)
sd_rewizja <- 0.35    # dodatkowy błąd pierwszej publikacji indeksu (przed rewizją)
sd_zapyt <- 0.08      # miesięczny szum skłonności do wysyłania zapytań

set.seed(703)
Tm <- length(mies)
tyg <- seq(as.Date("2018-01-01"), as.Date("2025-12-29"), by = "week")         # poniedziałki
m_tyg <- match(format(tyg + 3, "%Y-%m"), format(mies, "%Y-%m"))               # miesiąc wg czwartku
tyg <- tyg[!is.na(m_tyg)]; m_tyg <- m_tyg[!is.na(m_tyg)]
nw <- length(tyg)
u <- as.numeric(arima.sim(list(ar = ar_rynek), Tm, sd = sd_rynek))            # wstrząsy popytu
popyt <- exp(log(poziom) + wzrost * (seq_len(Tm) - 1) / 12 + sez[as.integer(format(mies, "%m"))] + u)
sprzedaz <- rpois(Tm, popyt)
s_tyg <- sez[as.integer(format(mies[m_tyg], "%m"))]
l_popr <- trend_wysz * (seq_len(nw) - 1) / 52 + 0.9 * (s_tyg + u[m_tyg]) + rnorm(nw, 0, sd_wysz)
l_pierw <- l_popr + rnorm(nw, 0, sd_rewizja)
zapyt <- rpois(nw, 2.2 * popyt[m_tyg] / 4.35 * exp(rnorm(Tm, 0, sd_zapyt))[m_tyg])
l_plac <- 0.07 * (seq_len(nw) - 1) / 52 + 0.9 * s_tyg +                        # fraza „wakacje nad morzem”:
  as.numeric(arima.sim(list(ar = 0.97), nw, sd = 0.03))                        # trend i sezon, bez wstrząsów popytu
skala <- function(l) 100 * exp(l) / mean(exp(l_popr[1:52]))                    # średnia 2018 (wersja poprawiona) = 100

tydzien <- data.frame(tydzien = tyg, miesiac = format(mies[m_tyg], "%Y-%m"),
  indeks_pierwsza = round(skala(l_pierw), 1), indeks_poprawiony = round(skala(l_popr), 1),
  zapytania = zapyt, indeks_wakacje = round(skala(l_plac), 1))
sr <- function(x) as.numeric(tapply(x, m_tyg, mean))
d <- data.frame(miesiac = format(mies, "%Y-%m"), data = mies, sprzedaz = sprzedaz,
  indeks = sr(tydzien$indeks_poprawiony), indeks_rt = sr(tydzien$indeks_pierwsza),
  zapytania = as.numeric(tapply(zapyt, m_tyg, sum)), wakacje = sr(tydzien$indeks_wakacje))
write.csv(tydzien, "nowcasting-kampery-tygodnie.csv", row.names = FALSE)
write.csv(d[c("miesiac", "sprzedaz", "indeks", "indeks_rt", "zapytania", "wakacje")],
          "nowcasting-kampery-miesiace.csv", row.names = FALSE)

cat("Tygodni:", nw, "| miesięcy:", Tm, "\n")
cat("Sprzedaż: średnio", round(mean(d$sprzedaz), 1), "szt./mies.; min", min(d$sprzedaz), "max", max(d$sprzedaz), "\n")
print(aggregate(cbind(sprzedaz, zapytania, indeks) ~ substr(miesiac, 1, 4), data = d,
                FUN = function(x) round(mean(x), 1)))
prof <- aggregate(sprzedaz ~ substr(miesiac, 6, 7), data = d, FUN = mean)
cat("Najlepszy miesiąc sezonu:", prof[which.max(prof[, 2]), 1], "| najsłabszy:", prof[which.min(prof[, 2]), 1], "\n")
cat("Korelacja log sprzedaży z log indeksu:", round(cor(log(d$sprzedaz), log(d$indeks)), 2),
    "| z log zapytań:", round(cor(log(d$sprzedaz), log(d$zapytania)), 2), "\n")

dl <- rbind(data.frame(data = d$data, wartosc = d$sprzedaz, panel = "A. Sprzedaż (szt. w miesiącu)"),
            data.frame(data = d$data, wartosc = d$indeks, panel = "B. Indeks wyszukiwań (średnia 2018 = 100)"),
            data.frame(data = d$data, wartosc = d$zapytania, panel = "C. Zapytania ofertowe (liczba w miesiącu)"))
p1 <- ggplot(dl, aes(data, wartosc)) +
  annotate("rect", xmin = as.Date("2022-01-01"), xmax = as.Date("2025-12-31"), ymin = -Inf, ymax = Inf,
           fill = kol[["blekit"]], alpha = 0.12) +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.7) + geom_point(colour = kol[["niebieski"]], size = 1) +
  facet_wrap(~ panel, ncol = 1, scales = "free_y") +
  scale_x_date(date_breaks = "1 year", date_labels = "%Y") +
  labs(title = "Osiem lat danych dealera: sprzedaż, wyszukiwania i zapytania",
       subtitle = "Tło: lata 2022–2025, na których oceniamy prognozy bieżącego miesiąca",
       x = NULL, y = NULL) + motyw
p1                       # do pliku: ggsave("nowcasting-dane-dealer.svg", p1, width = 10, height = 7)
Wynik w R
Tygodni: 417 | miesięcy: 96
Sprzedaż: średnio 65.6 szt./mies.; min 23 max 178
  substr(miesiac, 1, 4) sprzedaz zapytania indeks
1                  2018     51.1     118.5   99.8
2                  2019     54.8     129.4  109.5
3                  2020     51.2     108.2  103.2
4                  2021     64.2     148.8  135.1
5                  2022     89.1     199.1  176.2
6                  2023     75.8     167.8  160.7
7                  2024     71.4     149.0  158.0
8                  2025     67.3     145.5  144.3
Najlepszy miesiąc sezonu: 05 | najsłabszy: 12
Korelacja log sprzedaży z log indeksu: 0.89 | z log zapytań: 0.88
2. Grafika „co wiemy w dniu prognozy”: Rysunek 2
R
# Rysunek 2. Grafika: co wiemy w dniu prognozy (poniedziałek 3 listopada 2025, prognoza października)
# (korzysta z kol i motyw z przepisu 1; przepis nie losuje)
library(ggplot2)

dzien <- as.Date("2025-11-03")
opozn <- 6 * 7                                                   # sprzedaż zamykana 6 tygodni po końcu miesiąca
konce <- seq(as.Date("2025-07-01"), as.Date("2025-11-01"), by = "month") - 1
zamkn <- data.frame(miesiac = format(konce, "%m.%Y"), koniec = konce, zamkniecie = konce + opozn)
print(zamkn, row.names = FALSE)
cat("W dniu prognozy znana sprzedaż do:", format(max(zamkn$koniec[zamkn$zamkniecie <= dzien]), "%d.%m.%Y"), "\n")
tyg <- seq(as.Date("2025-06-30"), as.Date("2025-10-27"), by = "week")   # poniedziałki tygodni indeksu
tyg_stan <- ifelse(tyg + 3 >= as.Date("2025-10-01"), "wstępny", "znane")
cat("Tygodnie października w wersji wstępnej:", sum(tyg_stan == "wstępny"), "\n")

y_s <- 4; y_i <- 3; y_z <- 2; y_m <- 1; h <- 0.32
mies_rect <- data.frame(od = as.Date(c("2025-07-01", "2025-08-01", "2025-09-01", "2025-10-01")),
                        do = as.Date(c("2025-07-31", "2025-08-31", "2025-09-30", "2025-10-31")),
                        stan = c("znane", "znane", "jeszcze nieznane", "prognozujemy"))
kolory <- c(znane = kol[["niebieski"]], `jeszcze nieznane` = "grey80", prognozujemy = kol[["pomaranczowy"]],
            wstępny = kol[["blekit"]])
p2 <- ggplot() +
  geom_rect(data = mies_rect, aes(xmin = od, xmax = do + 1, ymin = y_s - h, ymax = y_s + h, fill = stan), colour = "white") +
  geom_text(data = mies_rect, aes(x = od + 15.5, y = y_s, label = c("lipiec", "sierpień", "wrzesień:\nzamknięcie 11.11", "październik:\nPROGNOZA")),
            size = 3.4, lineheight = 0.9, colour = ifelse(mies_rect$stan == "jeszcze nieznane", "#0f1d3a", "white"), fontface = "bold") +
  annotate("segment", x = as.Date("2025-08-31"), xend = as.Date("2025-10-12"), y = y_s + h + 0.12, yend = y_s + h + 0.12,
           arrow = arrow(length = unit(0.18, "cm"), ends = "both"), colour = "#0f1d3a") +
  annotate("text", x = as.Date("2025-09-21"), y = y_s + h + 0.27, size = 3.3, colour = "#0f1d3a",
           label = "sierpień zamknięty 12.10 – po 6 tygodniach") +
  geom_rect(data = data.frame(od = tyg, stan = tyg_stan), aes(xmin = od, xmax = od + 6.6, ymin = y_i - h, ymax = y_i + h, fill = stan),
            colour = "white") +
  annotate("text", x = as.Date("2025-10-16"), y = y_i, label = "wstępne", size = 3.3, colour = "#0f1d3a", fontface = "bold") +
  annotate("rect", xmin = as.Date("2025-07-01"), xmax = dzien - 1, ymin = y_z - h, ymax = y_z + h, fill = kol[["zielony"]]) +
  annotate("text", x = as.Date("2025-09-01"), y = y_z, label = "codziennie, kompletne, bez poprawek", size = 3.4,
           colour = "white", fontface = "bold") +
  annotate("rect", xmin = as.Date("2025-07-01"), xmax = as.Date("2025-08-31"), ymin = y_m - h, ymax = y_m + h, fill = "grey60") +
  annotate("text", x = as.Date("2025-07-31"), y = y_m, label = "uczenie: sprzedaż\ndo sierpnia", size = 3.2,
           colour = "white", fontface = "bold", lineheight = 0.9) +
  annotate("segment", x = as.Date("2025-09-03"), xend = as.Date("2025-10-28"), y = y_m, yend = y_m,
           arrow = arrow(length = unit(0.25, "cm")), colour = kol[["pomaranczowy"]], linewidth = 1.1) +
  annotate("text", x = as.Date("2025-10-01"), y = y_m + 0.3, label = "prognoza 2 miesiące naprzód\n+ indeks i zapytania z października", lineheight = 0.9,
           size = 3.3, colour = "#0f1d3a") +
  geom_vline(xintercept = dzien, colour = "#0f1d3a", linewidth = 0.9) +
  annotate("label", x = dzien, y = 4.85, label = "dzień prognozy\n3.11.2025", size = 3.4, lineheight = 0.9,
           fill = "white", colour = "#0f1d3a") +
  annotate("rect", xmin = dzien + 1, xmax = as.Date("2025-12-15"), ymin = 0.5, ymax = 4.5, fill = "grey95") +
  annotate("text", x = as.Date("2025-11-25"), y = 2.5, label = "przyszłość:\nnie wolno\nużyć", size = 3.4,
           colour = "grey35", lineheight = 0.9) +
  scale_fill_manual(values = kolory, breaks = c("znane", "wstępny", "jeszcze nieznane", "prognozujemy"),
                    labels = c("znane (sprzedaż; indeks po rewizji)", "indeks wstępny (rewizja po ok. miesiącu)",
                               "sprzedaż jeszcze niezamknięta", "sprzedaż prognozowana"), name = NULL) +
  scale_y_continuous(breaks = c(y_s, y_i, y_z, y_m), limits = c(0.5, 5.1),
                     labels = c("Sprzedaż\n(miesiące)", "Indeks wyszukiwań\n(tygodnie)", "Zapytania\nofertowe", "Model")) +
  scale_x_date(date_breaks = "1 month", date_labels = "%m.%Y", limits = as.Date(c("2025-07-01", "2025-12-15")),
               expand = c(0, 0)) +
  labs(title = "Co wiemy w dniu prognozy?", subtitle = "Dealer kamperów: prognoza października w poniedziałek 3 listopada 2025",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank(), axis.text.y = element_text(colour = "#0f1d3a", face = "bold"),
                legend.text = element_text(size = 10)) +
  guides(fill = guide_legend(nrow = 2))
p2                       # do pliku: ggsave("nowcasting-os-czasu.svg", p2, width = 10, height = 6)
Wynik w R
 miesiac     koniec zamkniecie
 06.2025 2025-06-30 2025-08-11
 07.2025 2025-07-31 2025-09-11
 08.2025 2025-08-31 2025-10-12
 09.2025 2025-09-30 2025-11-11
 10.2025 2025-10-31 2025-12-12
W dniu prognozy znana sprzedaż do: 31.08.2025
Tygodnie października w wersji wstępnej: 5
3. Ocena poza próbą w kroczącym oknie: Rysunek 3
R
# Rysunek 3. Ocena poza próbą w kroczącym oknie: prognoza bieżącego miesiąca, 48 miesięcy 2022–2025
# (korzysta z kol, motyw i obiektu d z przepisu 1; przepis nie losuje)
library(ggplot2)
library(patchwork)
library(forecast)

# W dniu prognozy (ostatni dzień miesiąca t) znamy sprzedaż do t − 2 (zamknięcie po 6 tygodniach),
# indeks i zapytania – do końca miesiąca t. Prognozujemy więc 2 miesiące naprzód od ostatniej znanej sprzedaży.
X    <- cbind(log_indeks = log(d$indeks), log_zapytania = log(d$zapytania))   # wersja poprawiona indeksu
X_rt <- X                                                                       # wersja „w czasie rzeczywistym”
oryginy <- 49:96                                                                # styczeń 2022 – grudzień 2025

# Rząd modelu ARIMA wybrany raz, na danych znanych przy pierwszej prognozie (do listopada 2021)
y_start <- ts(d$sprzedaz[1:47], start = c(2018, 1), frequency = 12)
wybor <- auto.arima(y_start, lambda = 0)
o <- arimaorder(wybor)
cat("Model bazowy wybrany przez auto.arima:", sprintf("ARIMA(%d,%d,%d)(%d,%d,%d)[12] na log sprzedaży", o[1], o[2], o[3], o[4], o[5], o[6]), "\n")
dopasuj <- function(y, xr = NULL) {
  if (is.null(xr)) return(Arima(y, order = o[1:3], seasonal = list(order = o[4:6], period = 12), lambda = 0))
  Arima(y, order = o[1:3], seasonal = list(order = o[4:6], period = 12), lambda = 0, xreg = xr)
}

prognozy_w_dniu <- function(t, X_teraz) {          # X_teraz: regresory znane w dniu prognozy (wiersze t − 1, t)
  uczace <- 1:(t - 2); nowe <- (t - 1):t
  y <- ts(d$sprzedaz[uczace], start = c(2018, 1), frequency = 12)
  m_i  <- dopasuj(y, X[uczace, "log_indeks", drop = FALSE])
  m_z  <- dopasuj(y, X[uczace, "log_zapytania", drop = FALSE])
  m_iz <- dopasuj(y, X[uczace, ])
  c(sezonowa_naiwna = d$sprzedaz[t - 12],
    ETS = forecast(ets(y, lambda = 0), h = 2)$mean[2],
    ARIMA = forecast(dopasuj(y), h = 2)$mean[2],
    ARIMA_zapytania = forecast(m_z, xreg = X_teraz[nowe, "log_zapytania", drop = FALSE])$mean[2],
    ARIMA_indeks = forecast(m_i, xreg = X_teraz[nowe, "log_indeks", drop = FALSE])$mean[2],
    ARIMA_indeks_zapytania = forecast(m_iz, xreg = X_teraz[nowe, ])$mean[2])
}
X_rt[, "log_indeks"] <- log(d$indeks_rt)            # tu: pierwsza wersja dla WSZYSTKICH miesięcy;
prog <- t(sapply(oryginy, function(t) {             # indeks jest poprawiany po ok. miesiącu, więc w dniu prognozy
  Xt <- X; Xt[t, ] <- X_rt[t, ]                     # wstępny jest tylko miesiąc t – podmieniamy jeden wiersz
  prognozy_w_dniu(t, Xt) }))
fakt <- d$sprzedaz[oryginy]
bledy <- prog - fakt
mae <- colMeans(abs(bledy))
ocena <- data.frame(model = names(mae), MAE = round(mae, 2),
                    poprawa_vs_ARIMA_proc = round(100 * (1 - mae / mae[["ARIMA"]]), 1),
                    MAPE = round(100 * colMeans(abs(bledy) / fakt), 1))
print(ocena, row.names = FALSE)
dm <- dm.test(bledy[, "ARIMA"], bledy[, "ARIMA_indeks_zapytania"], h = 2, power = 1)
cat("Test Diebolda–Mariano (MAE, h = 2), ARIMA vs ARIMA + indeks + zapytania: DM =", round(dm$statistic, 2),
    "p =", sub("^0", "", formatC(dm$p.value, format = "f", digits = 3)), "\n")
lata <- substr(d$miesiac[oryginy], 1, 4)
print(round(sapply(split(as.data.frame(abs(bledy[, c("ARIMA", "ARIMA_indeks_zapytania")])), lata), colMeans), 2))
pazdz <- which(d$miesiac[oryginy] == "2025-10")
cat("Październik 2025: sprzedaż", fakt[pazdz], "| ARIMA", round(prog[pazdz, "ARIMA"], 1),
    "| ARIMA + indeks + zapytania", round(prog[pazdz, "ARIMA_indeks_zapytania"], 1), "\n")

nazwy <- c(sezonowa_naiwna = "sezonowa naiwna", ETS = "ETS", ARIMA = "ARIMA (bazowy)",
           ARIMA_zapytania = "ARIMA + zapytania", ARIMA_indeks = "ARIMA + indeks",
           ARIMA_indeks_zapytania = "ARIMA + indeks + zapytania")
dl <- rbind(data.frame(data = d$data[oryginy], szt = fakt, co = "sprzedaż (znana 6 tygodni później)"),
            data.frame(data = d$data[oryginy], szt = prog[, "ARIMA"], co = "prognoza: ARIMA (bazowy)"),
            data.frame(data = d$data[oryginy], szt = prog[, "ARIMA_indeks_zapytania"], co = "prognoza: ARIMA + indeks + zapytania"))
dl$co <- factor(dl$co, levels = unique(dl$co))
pA <- ggplot(dl, aes(data, szt, colour = co, linetype = co, shape = co)) +
  geom_line(linewidth = 0.8) + geom_point(size = 1.8) +
  scale_colour_manual(values = c(kol[["granat"]], kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "solid"), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_x_date(date_breaks = "1 year", date_labels = "%Y") +
  labs(title = "A. Prognoza bieżącego miesiąca a sprzedaż", x = NULL, y = "Sztuk w miesiącu") +
  motyw + guides(colour = guide_legend(ncol = 1))
ocena$nazwa <- factor(nazwy[ocena$model], levels = rev(nazwy))
ocena$etykieta <- ifelse(ocena$model == "ARIMA", sprintf("%.1f", ocena$MAE),
                         sprintf("%.1f (%+.0f%%)", ocena$MAE, -ocena$poprawa_vs_ARIMA_proc))
pB <- ggplot(ocena, aes(MAE, nazwa)) +
  geom_col(aes(fill = model == "ARIMA_indeks_zapytania"), width = 0.65) +
  geom_text(aes(label = etykieta), hjust = -0.08, size = 3.6, colour = "#0f1d3a") +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["niebieski"]]), guide = "none") +
  scale_x_continuous(expand = expansion(mult = c(0, 0.45))) +
  labs(title = "B. MAE w 48 miesiącach", subtitle = "w nawiasie: zmiana wobec ARIMA",
       x = "Średni błąd bezwzględny (szt.)", y = NULL) + motyw
p3 <- pA / pB + plot_layout(heights = c(1.15, 1))
p3                       # do pliku: ggsave("nowcasting-ocena-kroczaca.svg", p3, width = 10, height = 8)
Wynik w R
Model bazowy wybrany przez auto.arima: ARIMA(1,0,0)(0,1,1)[12] na log sprzedaży
                  model   MAE poprawa_vs_ARIMA_proc MAPE
        sezonowa_naiwna 24.08                 -29.7 30.4
                    ETS 19.00                  -2.3 24.2
                  ARIMA 18.57                   0.0 21.0
        ARIMA_zapytania 12.99                  30.0 16.9
           ARIMA_indeks 14.35                  22.7 20.0
 ARIMA_indeks_zapytania 11.83                  36.3 16.3
Test Diebolda–Mariano (MAE, h = 2), ARIMA vs ARIMA + indeks + zapytania: DM = 1.83 p = .074
                        2022  2023  2024  2025
ARIMA                  29.03 18.14 15.02 12.06
ARIMA_indeks_zapytania 16.75 10.49 12.26  7.82
Październik 2025: sprzedaż 51 | ARIMA 52.3 | ARIMA + indeks + zapytania 70.2
4. Przeciek przez rewizje: Rysunek 4
R
# Rysunek 4. Przeciek przez rewizje: indeks pobrany dziś (poprawiony) a indeks znany w dniu prognozy
# (korzysta z kol, motyw, d i tydzien z przepisu 1 oraz z funkcji i obiektów przepisu 3; przepis nie losuje)
library(ggplot2)
library(patchwork)
library(forecast)

# Ocena „z przeciekiem”: indeks dla miesiąca t w wersji poprawionej, której w dniu prognozy jeszcze nie było
prog_przeciek <- t(sapply(oryginy, function(t) prognozy_w_dniu(t, X)))
mae_przeciek <- colMeans(abs(prog_przeciek - fakt))
por <- data.frame(model = c("ARIMA_indeks", "ARIMA_indeks_zapytania"),
                  MAE_z_przeciekiem = round(mae_przeciek[c("ARIMA_indeks", "ARIMA_indeks_zapytania")], 2),
                  MAE_w_czasie_rzeczywistym = round(mae[c("ARIMA_indeks", "ARIMA_indeks_zapytania")], 2))
por$poprawa_vs_ARIMA_przeciek <- round(100 * (1 - por$MAE_z_przeciekiem / mae[["ARIMA"]]), 1)
por$poprawa_vs_ARIMA_rzeczywista <- round(100 * (1 - por$MAE_w_czasie_rzeczywistym / mae[["ARIMA"]]), 1)
print(por, row.names = FALSE)

rew <- 100 * (tydzien$indeks_poprawiony / tydzien$indeks_pierwsza - 1)
cat("Rewizja tygodniowa (poprawiona / pierwsza − 1): mediana bezwzględna", round(median(abs(rew)), 1),
    "%, 90% rewizji w przedziale [", paste(round(quantile(rew, c(.05, .95)), 1), collapse = ", "), "] %\n")
rew_m <- 100 * (d$indeks / d$indeks_rt - 1)
cat("Rewizja miesięczna: mediana bezwzględna", round(median(abs(rew_m)), 1), "%, największa",
    round(rew_m[which.max(abs(rew_m))], 1), "% (", d$miesiac[which.max(abs(rew_m))], ")\n")
cat("Korelacja Δ12 log sprzedaży z Δ12 log indeksu: poprawiony",
    round(cor(diff(log(d$sprzedaz), 12), diff(log(d$indeks), 12)), 2), "| pierwsza wersja",
    round(cor(diff(log(d$sprzedaz), 12), diff(log(d$indeks_rt), 12)), 2), "\n")

t25 <- subset(tydzien, substr(miesiac, 1, 4) == "2025")
dlA <- rbind(data.frame(tydzien = t25$tydzien, indeks = t25$indeks_pierwsza, wersja = "pierwsza publikacja (znana w dniu prognozy)"),
             data.frame(tydzien = t25$tydzien, indeks = t25$indeks_poprawiony, wersja = "po rewizji (pobrana dziś)"))
pA <- ggplot(dlA, aes(tydzien, indeks, colour = wersja, shape = wersja, linetype = wersja)) +
  geom_line(linewidth = 0.7) + geom_point(size = 1.6) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_x_date(date_breaks = "2 months", date_labels = "%m.%Y") +
  labs(title = "A. Tygodniowy indeks w 2025 roku: dwie wersje", x = NULL, y = "Indeks (2018 = 100)") +
  motyw + guides(colour = guide_legend(ncol = 1))
dlB <- rbind(data.frame(model = por$model, MAE = por$MAE_z_przeciekiem, ocena = "z przeciekiem (indeks po rewizji)"),
             data.frame(model = por$model, MAE = por$MAE_w_czasie_rzeczywistym, ocena = "uczciwa (indeks z dnia prognozy)"))
dlB$model <- factor(c(ARIMA_indeks = "ARIMA + indeks", ARIMA_indeks_zapytania = "ARIMA + indeks\n+ zapytania")[dlB$model],
                    levels = c("ARIMA + indeks\n+ zapytania", "ARIMA + indeks"))
pB <- ggplot(dlB, aes(MAE, model)) +
  geom_vline(xintercept = mae[["ARIMA"]], linetype = "dashed", colour = "grey40") +
  annotate("text", x = mae[["ARIMA"]], y = 2.45, label = sprintf("ARIMA bez indeksu: %.1f", mae[["ARIMA"]]),
           hjust = 1.05, size = 3.5, colour = "grey25") +
  geom_line(aes(group = model), colour = "grey60", linewidth = 1.2) +
  geom_point(aes(colour = ocena, shape = ocena), size = 4) +
  geom_text(aes(label = sprintf("%.1f", MAE), colour = ocena), vjust = -1.1, size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(limits = c(8, 20)) + scale_y_discrete(expand = expansion(add = c(0.5, 0.8))) +
  labs(title = "B. MAE prognozy w 48 miesiącach", x = "MAE (szt.)", y = NULL) +
  motyw + guides(colour = guide_legend(ncol = 1))
p4 <- pA / pB + plot_layout(heights = c(1.1, 1))
p4                       # do pliku: ggsave("nowcasting-rewizje-indeksu.svg", p4, width = 10, height = 7.6)
Wynik w R
                  model MAE_z_przeciekiem MAE_w_czasie_rzeczywistym
           ARIMA_indeks             11.15                     14.35
 ARIMA_indeks_zapytania              9.90                     11.83
 poprawa_vs_ARIMA_przeciek poprawa_vs_ARIMA_rzeczywista
                      39.9                         22.7
                      46.7                         36.3
Rewizja tygodniowa (poprawiona / pierwsza − 1): mediana bezwzględna 23.3 %, 90% rewizji w przedziale [ -43.7, 77.7 ] %
Rewizja miesięczna: mediana bezwzględna 11.7 %, największa 62.2 % ( 2019-04 )
Korelacja Δ12 log sprzedaży z Δ12 log indeksu: poprawiony 0.76 | pierwsza wersja 0.64
5. Zależność pozorna: Rysunek 5
R
# Rysunek 5. Zależność pozorna przy wspólnym trendzie i sezonie: poziomy a różnice roczne
# (korzysta z kol, motyw i d z przepisu 1; przepis nie losuje)
library(ggplot2)

opis_lm <- function(y, x) {
  m <- summary(lm(y ~ x)); p <- m$coefficients[2, 4]
  c(R2 = m$r.squared, b = m$coefficients[2, 1], p = p)
}
r12 <- function(x) diff(log(x), lag = 12)        # różnica roczna logarytmów ≈ zmiana rok do roku
wyn <- rbind(
  "wakacje nad morzem: poziomy"        = opis_lm(log(d$sprzedaz), log(d$wakacje)),
  "wakacje nad morzem: różnice roczne" = opis_lm(r12(d$sprzedaz), r12(d$wakacje)),
  "indeks kamperów: poziomy"           = opis_lm(log(d$sprzedaz), log(d$indeks)),
  "indeks kamperów: różnice roczne"    = opis_lm(r12(d$sprzedaz), r12(d$indeks)))
print(data.frame(R2 = round(wyn[, "R2"], 3), b = round(wyn[, "b"], 2),
                 p = ifelse(wyn[, "p"] < .001, "< .001", sub("^0", "", formatC(wyn[, "p"], format = "f", digits = 3)))))
acf_res <- acf(residuals(lm(log(d$sprzedaz) ~ log(d$wakacje))), plot = FALSE)$acf[2]
cat("Autokorelacja reszt (opóźnienie 1) w regresji poziomów na frazę „wakacje”:", round(acf_res, 2), "\n")

panele <- c("A. „Wakacje nad morzem”: poziomy (log)", "B. „Wakacje nad morzem”: zmiana rok do roku",
            "C. Kampery: poziomy (log)", "D. Kampery: zmiana rok do roku")
dl <- rbind(data.frame(x = log(d$wakacje), y = log(d$sprzedaz), panel = panele[1]),
            data.frame(x = r12(d$wakacje), y = r12(d$sprzedaz), panel = panele[2]),
            data.frame(x = log(d$indeks), y = log(d$sprzedaz), panel = panele[3]),
            data.frame(x = r12(d$indeks), y = r12(d$sprzedaz), panel = panele[4]))
dl$panel <- factor(dl$panel, levels = panele)
et <- data.frame(panel = factor(panele, levels = panele),
                 lab = sprintf("R² = %s", sub("^0", "", formatC(wyn[, "R2"], format = "f", digits = 2))))
p5 <- ggplot(dl, aes(x, y)) +
  geom_point(colour = kol[["szary"]], alpha = 0.7, size = 1.8) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["niebieski"]], linewidth = 1) +
  geom_text(data = et, aes(x = -Inf, y = Inf, label = lab), hjust = -0.15, vjust = 1.4, size = 4.2,
            colour = kol[["pomaranczowy"]], fontface = "bold") +
  facet_wrap(~ panel, ncol = 2, scales = "free") +
  labs(title = "Wspólny trend i sezon dają związek nawet bez związku",
       subtitle = "Oś pionowa: sprzedaż; oś pozioma: indeks wyszukiwań (ta sama skala co w tytule panelu)",
       x = "Indeks wyszukiwań", y = "Sprzedaż") + motyw
p5                       # do pliku: ggsave("nowcasting-zaleznosc-pozorna.svg", p5, width = 10, height = 7)
Wynik w R
                                      R2     b      p
wakacje nad morzem: poziomy        0.543  1.01 < .001
wakacje nad morzem: różnice roczne 0.010 -0.33   .360
indeks kamperów: poziomy           0.790  0.91 < .001
indeks kamperów: różnice roczne    0.585  0.81 < .001
Autokorelacja reszt (opóźnienie 1) w regresji poziomów na frazę „wakacje”: 0.46
6. Scenariusz zmiany zachowania wyszukujących: Rysunek 6
R
# Rysunek 6. Gdy indeks przestaje działać: od stycznia 2025 wyszukiwań przybywa o 40% bez wzrostu sprzedaży
# (korzysta z kol, motyw, d z przepisu 1 oraz dopasuj(), fakt i oryginy z przepisu 3; przepis nie losuje)
library(ggplot2)
library(forecast)

skok <- 1.40                                        # ręcznie: serial o podróżach kamperem – ludzie szukają, nie kupują
po_zmianie <- d$data >= as.Date("2025-01-01")
Xs  <- cbind(log_indeks = log(d$indeks * ifelse(po_zmianie, skok, 1)), log_zapytania = log(d$zapytania))
Xs_rt <- cbind(log_indeks = log(d$indeks_rt * ifelse(po_zmianie, skok, 1)), log_zapytania = log(d$zapytania))
okres <- 73:96                                      # prognozy na lata 2024–2025
sc <- t(sapply(okres, function(t) {
  uczace <- 1:(t - 2); nowe <- (t - 1):t
  y <- ts(d$sprzedaz[uczace], start = c(2018, 1), frequency = 12)
  Xt <- Xs; Xt[t, ] <- Xs_rt[t, ]
  c(ARIMA = forecast(dopasuj(y), h = 2)$mean[2],
    ARIMA_indeks = forecast(dopasuj(y, Xs[uczace, "log_indeks", drop = FALSE]),
                            xreg = Xt[nowe, "log_indeks", drop = FALSE])$mean[2],
    ARIMA_indeks_zapytania = forecast(dopasuj(y, Xs[uczace, ]), xreg = Xt[nowe, ])$mean[2])
}))
blad <- sc - d$sprzedaz[okres]
rok <- substr(d$miesiac[okres], 1, 4)
cat("Średni błąd (prognoza − sprzedaż), szt.:\n"); print(round(sapply(split(as.data.frame(blad), rok), colMeans), 1))
cat("MAE, szt.:\n"); print(round(sapply(split(as.data.frame(abs(blad)), rok), colMeans), 1))
cat("Odsetek przeszacowania sprzedaży w 2025 (średnia prognoza / średnia sprzedaż − 1), %:\n")
print(round(100 * (colMeans(sc[rok == "2025", ]) / mean(d$sprzedaz[okres][rok == "2025"]) - 1), 1))
cat("Błąd w pierwszych miesiącach po zmianie (szt.):\n")
print(cbind(miesiac = d$miesiac[okres][rok == "2025"][1:6], as.data.frame(round(blad[rok == "2025", ][1:6, ], 1))),
      row.names = FALSE)
cat("Miesiące 2025 z przeszacowaniem (błąd > 0):", colSums(blad[rok == "2025", ] > 0), "z 12\n")

nazwy <- c(ARIMA = "ARIMA (bazowy)", ARIMA_indeks = "ARIMA + indeks", ARIMA_indeks_zapytania = "ARIMA + indeks + zapytania")
dl <- do.call(rbind, lapply(names(nazwy), function(m)
  data.frame(data = d$data[okres], blad = blad[, m], model = nazwy[[m]])))
dl$model <- factor(dl$model, levels = nazwy)
p6 <- ggplot(dl, aes(data, blad, colour = model, shape = model, linetype = model)) +
  annotate("rect", xmin = as.Date("2024-12-16"), xmax = as.Date("2025-12-16"), ymin = -Inf, ymax = Inf,
           fill = kol[["zolty"]], alpha = 0.12) +
  annotate("text", x = as.Date("2025-01-10"), y = Inf, vjust = 1.4, hjust = 0, size = 3.6, colour = "#0f1d3a",
           label = "od 01.2025: wyszukiwania +40%, sprzedaż bez zmian") +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(linewidth = 0.8) + geom_point(size = 2) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(1, 17, 16), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid", "solid"), name = NULL) +
  scale_x_date(date_breaks = "3 months", date_labels = "%m.%Y") +
  labs(title = "Gdy wyszukujący zmieniają zachowanie, indeks zawyża prognozę",
       subtitle = "Błąd prognozy bieżącego miesiąca (prognoza − sprzedaż), scenariusz ze zmianą",
       x = NULL, y = "Błąd (szt.)") + motyw + guides(colour = guide_legend(nrow = 1))
p6                       # do pliku: ggsave("nowcasting-zmiana-zachowania.svg", p6, width = 10, height = 5.6)
Wynik w R
Średni błąd (prognoza − sprzedaż), szt.:
                       2024 2025
ARIMA                  -2.7 -1.2
ARIMA_indeks            6.0 17.8
ARIMA_indeks_zapytania  3.6 12.7
MAE, szt.:
                       2024 2025
ARIMA                  15.0 12.1
ARIMA_indeks           11.3 19.6
ARIMA_indeks_zapytania 12.3 13.7
Odsetek przeszacowania sprzedaży w 2025 (średnia prognoza / średnia sprzedaż − 1), %:
                 ARIMA           ARIMA_indeks ARIMA_indeks_zapytania
                  -1.8                   26.5                   18.8
Błąd w pierwszych miesiącach po zmianie (szt.):
 miesiac ARIMA ARIMA_indeks ARIMA_indeks_zapytania
 2025-01  -3.0         17.5                   16.5
 2025-02   9.7         17.7                   12.4
 2025-03  -3.5         -6.9                   -5.9
 2025-04  19.6         15.4                    7.2
 2025-05  12.4         37.3                   28.0
 2025-06 -35.6         18.9                   12.1
Miesiące 2025 z przeszacowaniem (błąd > 0): 8 10 11 z 12
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – niebieski" = c("#56B4E9", "#0072B2"),
             "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"), "zielony – niebieski" = c("#009E73", "#0072B2"),
             "szary – pomarańczowy" = c("#999999", "#D55E00"), "szary – niebieski" = c("#999999", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – niebieski                          26.4         24.7       24.6
błękit – pomarańczowy                      113.6        101.1       89.0
zielony – niebieski                         70.1         55.4       58.0
szary – pomarańczowy                        77.2         62.9       56.0
szary – niebieski                           44.9         48.9       40.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie i regresję liniową wykonano pakietem stats (z podstawowej instalacji R), modele ARIMA, ETS i test Diebolda–Mariano – pakietem forecast. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- forecast (wersja 9.0.2): Hyndman, R., Athanasopoulos, G., Bergmeir, C., Caceres, G., Chhay, L., O’Hara-Wild, M., Petropoulos, F., Razbash, S., Wang, E., & Yasmeen, F. (2026). forecast: Forecasting functions for time series and linear models (R package version 9.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.forecast
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ocena na danych, których w dniu prognozy nie było – poprawiony indeks obiecał MAE 9.9 zamiast 11.8 (rysunek 4).
- Losowy podział miesięcy na uczące i testowe – w szeregu czasowym model widzi wtedy sąsiednie miesiące; oceniaj w kroczącym oknie (rysunek 3).
- Związek w poziomach – wspólny trend i sezon dają R² = .54 nawet frazie bez związku z popytem (rysunek 5).
- Zapominanie o opóźnieniu sprzedaży – w dniu prognozy brakuje dwóch miesięcy, nie jednego (rysunek 2).
- Wiara, że związek jest stały – zmiana zachowania wyszukujących odwraca zysk z indeksu (rysunek 6).
- Za dużo fraz. Przy 48 miesiącach dziesiątki indeksów do wyboru prowadzą do przeuczenia; wybieraj frazy przed oceną, z wiedzy o kliencie, i porównuj ich zestawy tylko w ocenie poza próbą.
Najczęstsze pytania
Co to jest nowcasting sprzedaży?
To prognoza bieżącego lub właśnie zakończonego okresu, którego dane jeszcze nie spłynęły – np. sprzedaży października na początku listopada, gdy księgowość zamyka miesiąc po 6 tygodniach. Model łączy historię sprzedaży z danymi dostępnymi szybciej: wyszukiwaniami, zapytaniami ofertowymi, ruchem na stronie.
Jak sprawdzić, czy dane o wyszukiwaniach poprawiają prognozę?
Porównaj model z regresorami z modelem bazowym (ARIMA lub ETS na samej sprzedaży) w ocenie poza próbą z kroczącym oknem: dla każdego miesiąca dopasuj model tylko do danych znanych w dniu prognozy i policz MAE. W przykładzie dealera kamperów MAE spadło z 18.6 do 11.8 pojazdu w 48 prognozach.
Dlaczego rewizje danych to przeciek?
Bo poprawiona wersja indeksu powstaje po dniu prognozy. Jeśli ocenisz model na indeksie pobranym dziś, użyjesz informacji, której wtedy nie było, i zawyżysz trafność. W przykładzie ocena na poprawionym indeksie dawała MAE 9.9 zamiast 11.8. Zapisuj co tydzień pobraną wersję danych z datą.
Czy wysoka korelacja sprzedaży z wyszukiwaniami wystarczy?
Nie. Szeregi ze wspólnym trendem i sezonem korelują nawet bez związku: fraza „wakacje nad morzem” wyjaśniała w poziomach 54% zmienności sprzedaży kamperów, a w zmianach rok do roku 1%. Sprawdzaj związek po różnicowaniu i w ocenie poza próbą.
Kiedy indeks wyszukiwań przestaje działać?
Gdy ludzie zaczynają szukać z innych powodów niż zakup – np. po popularnym serialu. W scenariuszu ze wzrostem wyszukiwań o 40% bez zmiany sprzedaży model z indeksem przeszacował sprzedaż w 10 z 12 miesięcy, średnio o 26.5%. Śledź serię błędów o tym samym znaku i miej regułę wyłączenia indeksu.
Powiązane hasła
Przeczytaj też
Prognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →PoradnikPrzeciek danych i walidacja w czasie
Sieć siłowni i rezygnacje z karnetu: zmienne z przyszłości, losowy podział, wybór zmiennych na szumie i okno przesuwane – pięć rysunków z kodem R.
Czytaj →PoradnikWykrywanie nietypowych transakcji
Karty podarunkowe, 10 sprawdzeń dziennie: Mahalanobis klasyczny i odporny, LOF, las losowy, maskowanie i nowy wzorzec nadużyć – z kodem R.
Czytaj →Prognozujesz sprzedaż w pracy dyplomowej albo w firmie?
Pomożemy ustalić, co wiadomo w dniu prognozy, zbudować model bazowy i model z danymi o wyszukiwaniach, uczciwie ocenić je w kroczącym oknie i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cerqueira, V., Torgo, L., & Mozetič, I. (2020). Evaluating time series forecasting models: An empirical study on performance estimation methods. Machine Learning, 109(11), 1997–2028. https://doi.org/10.1007/s10994-020-05910-7 ● Otwarty dostęp
- Choi, H., & Varian, H. (2012). Predicting the present with Google Trends. Economic Record, 88(S1), 2–9. https://doi.org/10.1111/j.1475-4932.2012.00809.x ● Otwarty dostęp: pełny tekst
- Croushore, D. (2011). Frontiers of real-time data analysis. Journal of Economic Literature, 49(1), 72–100. https://doi.org/10.1257/jel.49.1.72 ● Otwarty dostęp: pełny tekst
- Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3), 1–22. https://doi.org/10.18637/jss.v027.i03 ● Otwarty dostęp
- Kaufman, S., Rosset, S., Perlich, C., & Stitelman, O. (2012). Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 1–21. https://doi.org/10.1145/2382577.2382579
- Lazer, D., Kennedy, R., King, G., & Vespignani, A. (2014). The parable of Google Flu: Traps in big data analysis. Science, 343(6176), 1203–1205. https://doi.org/10.1126/science.1248506 ● Otwarty dostęp: pełny tekst
- Phillips, P. C. B. (1986). Understanding spurious regressions in econometrics. Journal of Econometrics, 33(3), 311–340. https://doi.org/10.1016/0304-4076(86)90001-1 ● Otwarty dostęp
Cytowania BibTeX
@article{cerqueira2020evaluating, author={Cerqueira, Vitor and Torgo, Luis and Mozetič, Igor}, title={{Evaluating time series forecasting models: An empirical study on performance estimation methods}}, journal={Machine Learning}, year={2020}, volume={109}, number={11}, pages={1997--2028}, doi={10.1007/s10994-020-05910-7}}@article{choi2012predicting, author={Choi, Hyunyoung and Varian, Hal}, title={{Predicting the present with Google Trends}}, journal={Economic Record}, year={2012}, volume={88}, number={S1}, pages={2--9}, doi={10.1111/j.1475-4932.2012.00809.x}}@article{croushore2011frontiers, author={Croushore, Dean}, title={{Frontiers of real-time data analysis}}, journal={Journal of Economic Literature}, year={2011}, volume={49}, number={1}, pages={72--100}, doi={10.1257/jel.49.1.72}}@article{hyndman2008automatic, author={Hyndman, Rob J. and Khandakar, Yeasmin}, title={{Automatic time series forecasting: The forecast package for R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={3}, pages={1--22}, doi={10.18637/jss.v027.i03}}@article{kaufman2012leakage, author={Kaufman, Shachar and Rosset, Saharon and Perlich, Claudia and Stitelman, Ori}, title={{Leakage in data mining: Formulation, detection, and avoidance}}, journal={ACM Transactions on Knowledge Discovery from Data}, year={2012}, volume={6}, number={4}, pages={1--21}, doi={10.1145/2382577.2382579}}@article{lazer2014parable, author={Lazer, David and Kennedy, Ryan and King, Gary and Vespignani, Alessandro}, title={{The parable of Google Flu: Traps in big data analysis}}, journal={Science}, year={2014}, volume={343}, number={6176}, pages={1203--1205}, doi={10.1126/science.1248506}}@article{phillips1986understanding, author={Phillips, Peter C. B.}, title={{Understanding spurious regressions in econometrics}}, journal={Journal of Econometrics}, year={1986}, volume={33}, number={3}, pages={311--340}, doi={10.1016/0304-4076(86)90001-1}}