Przykład: karty podarunkowe sieci sklepów
Fikcyjny wydawca kart podarunkowych obsługuje karty sieci sklepów z artykułami domowymi (sklepy stacjonarne i sklep internetowy) – ok. 595 transakcji dziennie. Zespół bezpieczeństwa (dwie osoby) zdąży dokładnie sprawdzić 10 transakcji dziennie. Pytanie biznesowe: które 10 sprawdzić, żeby znaleźć jak najwięcej nadużyć – kradzionych kodów kart, kart opróżnianych przez oszustów?
Przy każdej transakcji znamy cztery cechy: kwotę, godzinę, czas od poprzedniego użycia tej karty (i liczbę użyć w ostatniej godzinie) oraz odległość sklepu od sklepu, w którym karta zwykle płaci. Mamy 12 tygodni, czyli 49 980 transakcji, w tym 140 nadużyć (0.28%). Mediana kwoty to 109.6 zł w transakcjach uczciwych i 249.5 zł w nadużyciach, mediana odległości – 3.0 i 37.2 km.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie. Nadużycia są trzech rodzajów: A – „opróżnianie kart” w sklepie internetowym wieczorem i w nocy (70 w tygodniach 1–8, 10 w tygodniach 9–12); B – nowy wzorzec od 9. tygodnia: drobne zakupy w dzień, kilka użyć karty w krótkim czasie, daleko od zwykłego sklepu (30); S – seria jednego wieczoru (dzień 66): 30 transakcji w jednym odległym sklepie, o podobnych kwotach. Ziarna (704 i kolejne) ustaliliśmy raz i ich nie zmienialiśmy. Po pierwszym uruchomieniu zmieniliśmy kilka parametrów – wszystkie zmiany opisujemy przy kodzie. Dane pobierzesz jako nietypowe-transakcje-karty-podarunkowe.csv.
Wynik nietypowości liczymy każdego wieczoru na transakcjach z danego dnia. Metody oceniamy na ostatnich czterech tygodniach (dni 57–84: 16 660 transakcji, 70 nadużyć), bo tylko tak naśladujemy wdrożenie – więcej o tym we wpisie przeciek danych i walidacja w czasie.
Rysunek 1: nietypowe połączenie, nie nietypowa liczba
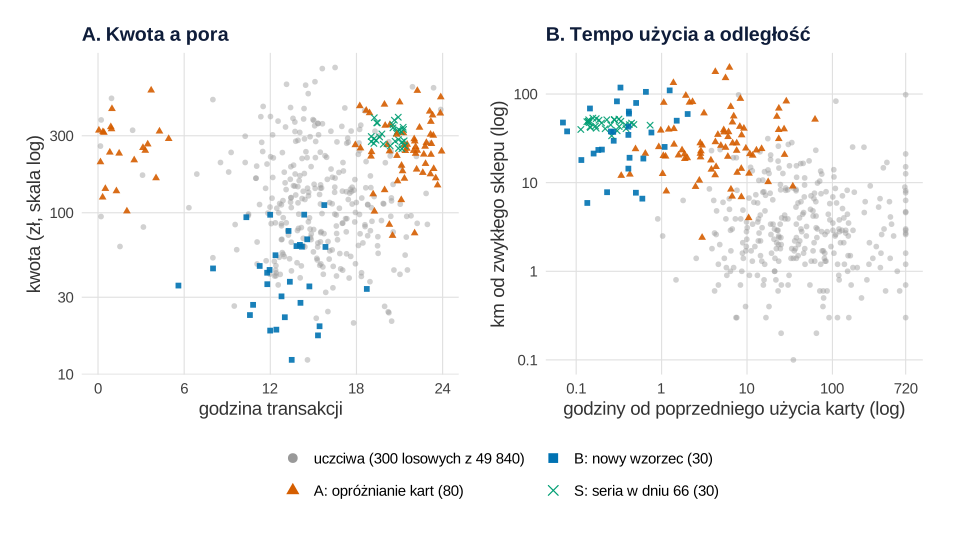
set.seed(704)).Co widać. Żadna cecha z osobna nie oddziela nadużyć. Wieczorne zakupy po 300 zł zdarzają się uczciwym klientom (panel A), a odległy sklep też (panel B). Nadużycia odstają połączeniem cech: duża kwota, nocna pora, krótka przerwa i daleki sklep naraz. Prosta reguła „wynik z powyżej 3 w choć jednej cesze” oznacza 84 ze 140 nadużyć, ale też 1340 transakcji uczciwych.
Jak może zmylić. Na wykresie nadużycia są kolorowe, w danych – nie. Do tego liczba użyć karty w ostatniej godzinie wynosi 1 w 99.1% transakcji. Odporna miara rozrzutu takiej zmiennej to zero, a odporna macierz kowariancji staje się osobliwa (sprawdziliśmy – obliczenie się zatrzymuje). Dlatego do odległości bierzemy ciągłą wersję tej samej informacji: czas od poprzedniego użycia karty (w logarytmie), a także logarytm kwoty i odległości oraz odchylenie godziny od 14:00.
Podpis do pracy:
Rysunek 2: maskowanie – klasyczna i odporna odległość Mahalanobisa
Odległość Mahalanobisa mierzy, jak daleko transakcja leży od środka danych we wszystkich cechach naraz, z uwzględnieniem ich rozrzutu i korelacji. Klasyczna wersja liczy środek i kowariancję ze wszystkich transakcji dnia – także z nadużyć. Wersja odporna (MCD, minimalny wyznacznik macierzy kowariancji) liczy je z 75% transakcji, które leżą najciaśniej. Szybki algorytm MCD opisali Rousseeuw i Van Driessen (1999). Sprawdzamy dzień 66 z serią S.
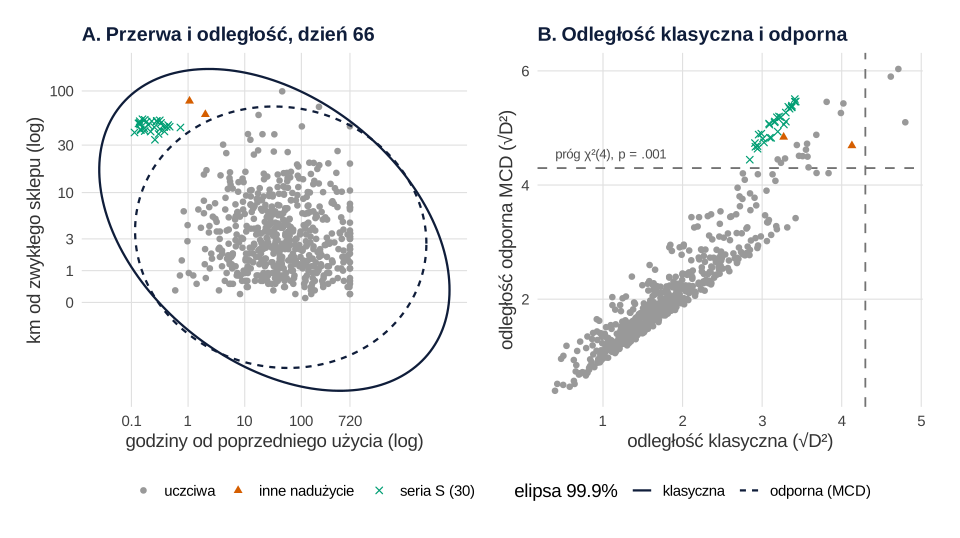
set.seed(7042)).Co widać. Progiem jest wartość krytyczna rozkładu χ² z 4 stopniami swobody dla p = .001, czyli D² = 18.47. Według odległości klasycznej żadna z 30 transakcji serii nie przekracza progu (mediana D² = 10.1). Według odległości odpornej przekraczają go wszystkie 30 (mediana D² = 25.9). Seria „rozciągnęła” klasyczną elipsę w swoją stronę (panel A) i schowała się w niej. To jest maskowanie: Rousseeuw i van Zomeren (1990) pokazali, że kilka obserwacji odstających zawyża średnią i kowariancję, z których liczy się ich własną odległość.
Jak może zmylić. Odporna odległość odsłania też więcej transakcji uczciwych: 17 wobec 3 w wersji klasycznej. Dzieje się tak, bo prawdziwe cechy nie mają rozkładu normalnego, a próg χ² to przybliżenie. Nietypowe nie znaczy oszukańcze. Szerzej o progach i rodzajach odstających obserwacji piszemy we wpisie wartości odstające: jak je wykryć.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: precyzja kolejki i zysk ze sprawdzeń
Porównujemy pięć wyników nietypowości. Trzy już znasz: najwyższe |z|, odległość klasyczną i MCD. Czwarty to LOF (lokalny współczynnik odstawania). Breunig i in. (2000) zaproponowali, by zamiast „odstaje albo nie” przypisać każdej obserwacji stopień odstawania. Zależy on od tego, jak bardzo jest ona odizolowana od swoich sąsiadów. LOF porównuje gęstość punktów wokół transakcji z gęstością wokół jej 30 najbliższych sąsiadów. Wartość wyraźnie powyżej 1 znaczy: „wokół niej jest pusto, a wokół sąsiadów tłoczno”. Piąty to model nadzorowany: las losowy (500 drzew; Breiman, 2001) uczony na etykietach z tygodni 1–8 – na tych samych cechach i liczbie użyć w godzinie.
Miarą jest precyzja wśród k najwyżej ocenionych: każdego dnia bierzemy k transakcji z najwyższym wynikiem i liczymy, jaki odsetek z nich to nadużycia. k to liczba transakcji, które zespół zdąży sprawdzić. Do tego zysk dzienny. Koszty ustaliliśmy ręcznie (to przykład, nie dane rynkowe): sprawdzenie kosztuje 10 zł, fałszywy alarm dodatkowo 20 zł (wstrzymana karta, telefon do klienta), a wykryte nadużycie ratuje kwotę transakcji i średnio 300 zł salda karty.
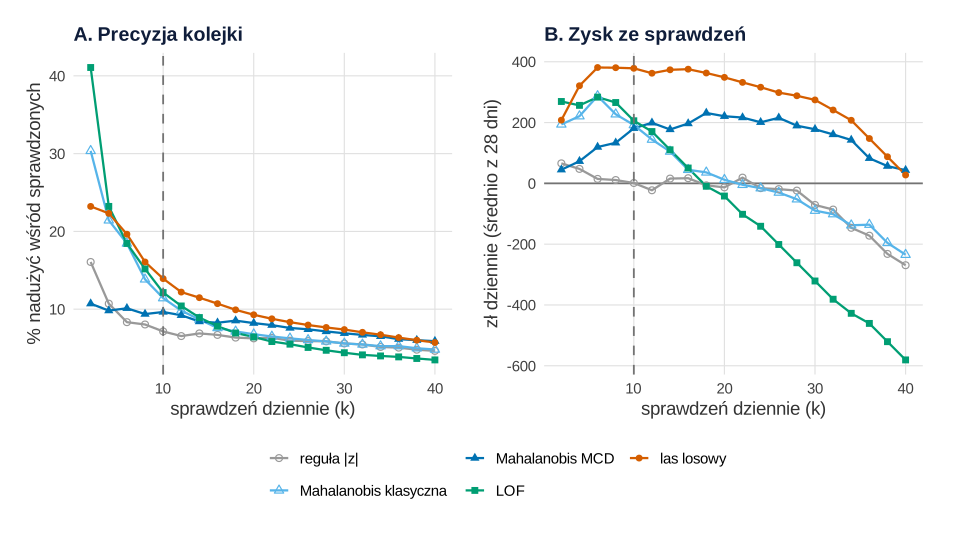
set.seed(7043)).Co widać. Przy 10 sprawdzeniach dziennie (280 w 28 dni) las losowy znajduje 39 z 70 nadużyć (precyzja 13.9%, czułość 55.7%, 378 zł dziennie). LOF znajduje 34 (12.1%, 206 zł), odległość klasyczna 32 (11.4%, 192 zł), MCD 27 (9.6%, 181 zł), a reguła |z| 20 (7.1%, 1 zł). Losowe sprawdzanie dałoby precyzję 0.42%. Zysk lasu jest największy przy 6 sprawdzeniach dziennie (381 zł). Przy 40 sprawdzeniach fałszywe alarmy zjadają prawie cały zysk lasu (28 zł dziennie), a odległość klasyczna, reguła |z| i LOF przynoszą stratę (od −235 do −581 zł). Krzywa MCD jest płaska: maksimum 232 zł przy 18 sprawdzeniach.
Jak może zmylić. Najlepszy k zależy od kosztu fałszywego alarmu – policz go dla swoich liczb. MCD wypada gorzej od wersji klasycznej, bo w zwykłe dni dokłada do kolejki uczciwe transakcje z długich ogonów rozkładów. Jej przewaga ujawnia się tylko w dniu serii. LOF i odległość Mahalanobisa nie wymagają etykiet. Inną metodą bez etykiet jest las izolacji, który zamiast opisywać typowe transakcje bezpośrednio izoluje nietypowe (Liu i in., 2008); w R wymaga pakietu, którego tu nie używamy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: krzywa ROC czy krzywa precyzja–czułość?
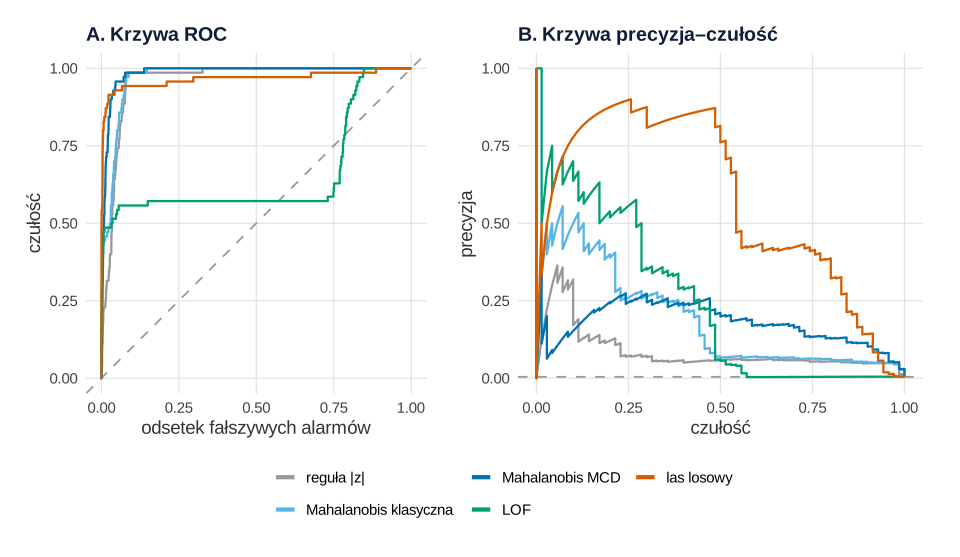
Co widać. Na krzywej ROC cztery metody wyglądają prawie tak samo: AUC = .961 (|z|), .971 (klasyczna), .985 (MCD) i .964 (las). Najwyższe AUC ma MCD. Na krzywej precyzja–czułość kolejność jest inna: średnia precyzja (AP) lasu to .573, LOF .246, odległości klasycznej .193, MCD .182, a |z| .090 – przy poziomie losowym .0042. Żeby znaleźć połowę nadużyć, las daje 8 fałszywych alarmów, MCD 131, a odległość klasyczna 461.
Jak może zmylić. 461 fałszywych alarmów to tylko 2.8% z 16 590 uczciwych transakcji, więc na osi ROC prawie ich nie widać. Zespół widzi je wszystkie. Saito i Rehmsmeier (2015) pokazali, że przy silnie niezrównoważonych klasach wykres PR lepiej oddaje praktyczną skuteczność klasyfikatora niż ROC. Więcej o rzadkich klasach: nierównowaga klas.
Podpis do pracy:
Rysunek 5: nadużycia zmieniają się w czasie
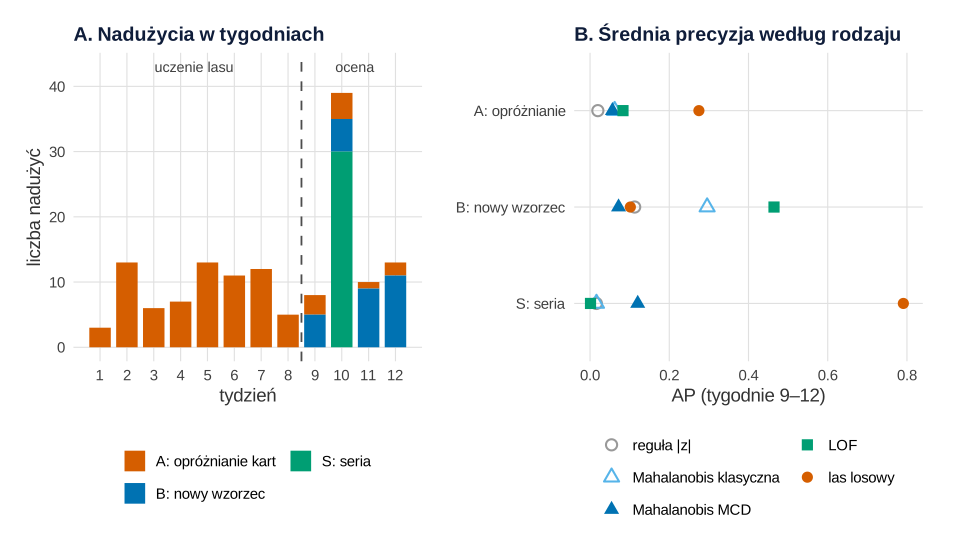
Co widać. Las losowy oceniony „losowo” – na obserwacjach spoza prób bootstrapowych z tygodni 1–8 – ma AP = .579. W tygodniach 9–12 ma AP = .573, więc na pierwszy rzut oka nic się nie zmieniło. Panel B pokazuje dlaczego. Seria S przypomina znany wzorzec A (wieczór, ok. 300 zł), więc las ją wyłapuje (AP .791). Nowego wzorca B, którego w danych uczących nie było, prawie nie widzi: AP .102 wobec .464 dla LOF i .296 dla odległości klasycznej. Za to LOF przegapia serię S (AP .001, AUC .211): 30 podobnych transakcji tworzy gęste skupisko, a LOF szuka punktów odizolowanych.
Jak może zmylić. Dryf pojęć – zmiana zachowań klientów i strategii oszustów w czasie – to obok nierównowagi klas i opóźnionej weryfikacji główna trudność wykrywania nadużyć kartowych (Dal Pozzolo i in., 2018). Sprawcy dostosowują się do zabezpieczeń (Bolton i Hand, 2002). Ocena na losowym podziale nie pokaże, co model przegapi jutro. Oceniaj w czasie i osobno dla każdego rodzaju nadużyć. W naszym przykładzie kolejka mieszana (5 transakcji z lasu i 5 z LOF dziennie) znalazła 40 nadużyć, w tym 28 z 30 nowego wzorca B (las sam – 22), przy zysku 341 zł dziennie.
Podpis do pracy:
Zdanie do Metody:
Rysunek 6: od wyniku do decyzji
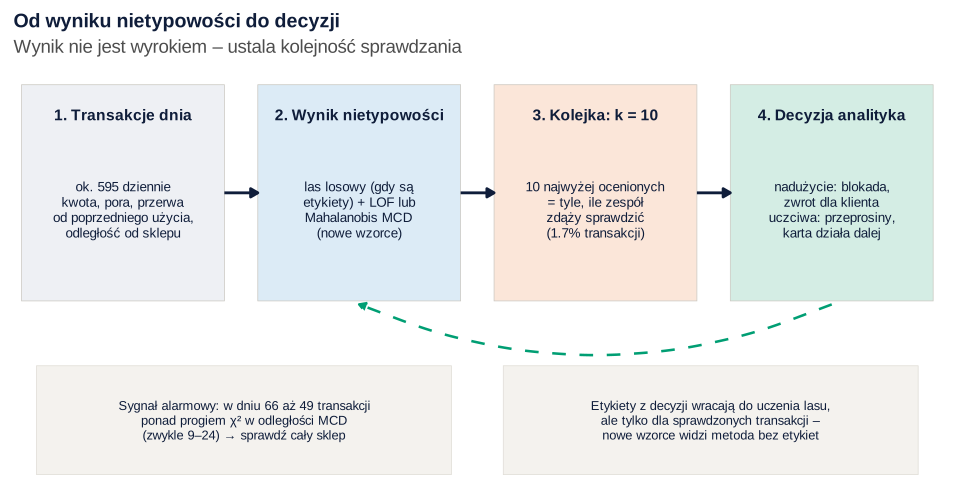
Co widać. Wynik nietypowości nie jest wyrokiem – ustala kolejność sprawdzania. Liczba transakcji ponad progiem to osobny sygnał: w zwykłe dni odległość MCD przekracza próg χ² w 9–24 transakcjach (mediana 14), w dniu 66 – w 49. Kolejka 10 pozycji przepuści większość serii, ale skok liczby alarmów każe sprawdzić cały sklep.
Jak może zmylić. Etykiety mamy tylko dla sprawdzonych transakcji. Las uczony na nich widzi świat oczami dawnej kolejki – dlatego metodę bez etykiet warto utrzymać obok niego.
Podpis do pracy:
Co z tym zrobić w firmie
- Zacznij od k, nie od progu. Ustal, ile transakcji zespół zdąży sprawdzić, i oceniaj metody precyzją wśród k najwyżej ocenionych oraz zyskiem (rysunek 3). Koszt fałszywego alarmu wpisz wprost – od niego zależy, czy opłaca się 6, czy 20 sprawdzeń.
- Licz odległość odporną obok klasycznej. Gdy w jednym dniu pojawia się seria podobnych nadużyć, wersja klasyczna je maskuje (rysunek 2). Pilnuj też liczby alarmów ponad progiem – jej skok to sygnał ataku.
- Łącz model z etykietami z metodą bez etykiet. Las wygrywa na znanych wzorcach, LOF i Mahalanobis łapią nowe (rysunek 5). Część kolejki oddaj metodzie bez etykiet.
- Oceniaj w czasie i według rodzaju nadużyć. Ucz na przeszłości, sprawdzaj na kolejnych tygodniach, a co miesiąc licz AP osobno dla nowych wzorców.
- Nie traktuj „nietypowego” jak „oszukańczego”. Uczciwy klient na wakacjach też jest daleko od swojego sklepu.
Podobna logika „sito, potem kontrola” działa w audycie (prawo Benforda w audycie) i przy monitorowaniu wskaźników (anomalie w KPI – karta kontrolna). Wybór progu przy znanych kosztach, kalibrację i SMOTE w modelu nadzorowanym omawia wpis o wykrywaniu nadużyć przy rzadkich zdarzeniach. W tej serii piszemy też o nowcastingu sprzedaży i o skargach na 1000 zamówień.
Jak opisać w pracy
Opisz cechy, sposób liczenia każdego wyniku (próbka odniesienia, estymator, liczba sąsiadów), sposób oceny (podział w czasie, k sprawdzeń dziennie, AP z poziomem losowym) i założone koszty. Więcej o analizach w pracach z finansów: statystyka w pracy z finansów i rachunkowości.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane d i macierz cech X, przepis 3 – wyniki W i las las używane dalej. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 704 i 7040 w przepisie 1, 7042 w przepisie 2 (funkcja covMcd losuje podzbiory startowe), 7043 w przepisie 3 (MCD i las losowy); przepisy 4–7 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: liczbę transakcji (595 dziennie przez 84 dni), rozkłady cech, rodzaje, liczby i rozkłady cech nadużyć (przepis 1), 75% obserwacji w MCD, 30 sąsiadów w LOF, 500 drzew, 10 sprawdzeń dziennie i koszty (przepis 3). Po pierwszym uruchomieniu zmieniono: (1) nadużycia A i B przybliżono do transakcji uczciwych (niższe kwoty, pory bliższe zwykłym, dłuższe przerwy, bliższe sklepy), bo wszystkie metody miały AUC ok. .999 i nie było czego porównywać; (2) liczbę użyć w godzinie zastąpiono w odległościach czasem od poprzedniego użycia, bo MCD zatrzymywało się na osobliwej macierzy; (3) usunięto zaplanowaną grupę uczciwych kart firmowych (duże kwoty, wiele użyć), która zapełniała kolejki wszystkich metod; (4) dodano serię S w dniu 66, bo przy 0.3% rozproszonych nadużyć maskowanie nie występuje; (5) koszty zmieniono z 20 zł za sprawdzenie, 30 zł za fałszywy alarm i 120 zł ochrony salda na 10, 20 i 300 zł, bo przy pierwszych wartościach każda kolejka przynosiła stratę; (6) w kolejce mieszanej zamiast MCD użyto LOF, bo MCD słabo wykrywało wzorzec B; (7) na rysunku 1 zmniejszono liczbę pokazanych transakcji uczciwych (z 5000 do 300) ze względu na rozmiar pliku. Wszystkie przepisy liczą się w kilka sekund.
1. Dane i cechy transakcji: Rysunek 1
R
# Rysunek 1. Fikcyjny wydawca kart podarunkowych: 12 tygodni transakcji i ukryte nadużycia
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie: 84 dni po 595 zwykłych transakcji, 20% zakupów w sklepie internetowym sieci
set.seed(704)
n_dni <- 84
dzien <- rep(1:n_dni, each = 595)
n <- length(dzien)
kanal <- ifelse(runif(n) < 0.20, "internet", "sklep")
kwota <- rlnorm(n, log(110), 0.75)                                    # zł, mediana 110
godz <- ifelse(kanal == "sklep", pmin(pmax(rnorm(n, 15, 2.8), 8), 21.9), rnorm(n, 19, 4) %% 24)
przerwa <- rlnorm(n, log(3000), 1.6)                                  # minuty od poprzedniego użycia karty
odl <- rlnorm(n, log(3), 1.1)                                         # km od sklepu, w którym karta zwykle płaci
d <- data.frame(dzien, tydzien = ceiling(dzien / 7), kanal, kwota, godz, przerwa, odl,
                naduzycie = 0, rodzaj = "uczciwa")

# Nadużycia (parametry ustawione ręcznie; w prawdziwych danych ich nie znamy):
# A – „opróżnianie kart” w sklepie internetowym wieczorem i w nocy: 70 w tygodniach 1–8, 10 w tygodniach 9–12
# B – nowy wzorzec od tygodnia 9: drobne zakupy w dzień, wiele użyć karty w krótkim czasie, daleko (30)
# S – seria jednego wieczoru (dzień 66): 30 transakcji w jednym odległym sklepie, podobne kwoty
iA <- c(sample(which(d$tydzien <= 8), 70), sample(which(d$tydzien > 8), 10))
iB <- sample(setdiff(which(d$tydzien > 8), iA), 30)
iS <- sample(setdiff(which(d$dzien == 66), c(iA, iB)), 30)
d$naduzycie[c(iA, iB, iS)] <- 1
d$rodzaj[iA] <- "A"; d$rodzaj[iB] <- "B"; d$rodzaj[iS] <- "S"
d$kanal[iA] <- "internet"; d$kanal[c(iB, iS)] <- "sklep"
d$kwota[iA] <- rlnorm(80, log(260), 0.5); d$godz[iA] <- rnorm(80, 22.5, 2.5) %% 24
d$przerwa[iA] <- rlnorm(80, log(240), 1); d$odl[iA] <- rlnorm(80, log(25), 0.9)
d$kwota[iB] <- rlnorm(30, log(40), 0.5); d$godz[iB] <- rnorm(30, 13, 2.5)
d$przerwa[iB] <- rlnorm(30, log(20), 1); d$odl[iB] <- rlnorm(30, log(30), 0.8)
d$kwota[iS] <- rlnorm(30, log(300), 0.15); d$godz[iS] <- runif(30, 19, 21.5)
d$przerwa[iS] <- rlnorm(30, log(12), 0.5); d$odl[iS] <- rlnorm(30, log(45), 0.1)
d$kwota <- round(d$kwota, 2); d$godz <- round(d$godz, 2); d$odl <- round(d$odl, 1)
d$przerwa <- pmin(round(d$przerwa, 1), 43200)                          # najwyżej 30 dni
# liczba użyć karty w ostatniej godzinie (z tą transakcją)
d$uzycia <- ifelse(d$przerwa < 60, 2 + rpois(n, ifelse(d$przerwa < 15, 1.5, 0.5)), 1)
write.csv(d[c("dzien", "kanal", "kwota", "godz", "przerwa", "odl", "uzycia", "naduzycie", "rodzaj")],
          "nietypowe-transakcje-karty-podarunkowe.csv", row.names = FALSE)

cat("Transakcje:", n, "| nadużycia:", sum(d$naduzycie), "=", round(100 * mean(d$naduzycie), 2), "%\n")
print(table(tydzien_9_12 = d$tydzien > 8, rodzaj = d$rodzaj))
cat("Mediany (uczciwe / nadużycia):\n")
print(round(sapply(split(d[c("kwota", "przerwa", "odl")], d$naduzycie), function(x) sapply(x, median)), 1))
cat("Odsetek transakcji z 1 użyciem karty w godzinie:", round(100 * mean(d$uzycia == 1), 1), "%\n")

# Cechy do odległości: logarytm kwoty, odchylenie pory od 14:00 (godz.), logarytm przerwy i odległości
d$od14 <- abs((d$godz - 14 + 12) %% 24 - 12)
X <- with(d, cbind(log_kwota = log(kwota), od14 = od14, log_przerwa = log(przerwa), log_odl = log1p(odl)))
z <- abs(scale(X))
cat("Nadużycia z |z| > 3 choć w jednej cesze:", sum(apply(z[d$naduzycie == 1, ], 1, max) > 3), "z",
    sum(d$naduzycie), "| uczciwe:", sum(apply(z[d$naduzycie == 0, ], 1, max) > 3), "\n")

# Rysunek: 300 losowych uczciwych transakcji (szare) i wszystkie nadużycia
set.seed(7040)
pokaz <- rbind(d[sample(which(d$naduzycie == 0), 300), ], d[d$naduzycie == 1, ])
pokaz$grupa <- factor(pokaz$rodzaj, c("uczciwa", "A", "B", "S"),
                      c("uczciwa (300 losowych z 49 840)", "A: opróżnianie kart (80)", "B: nowy wzorzec (30)", "S: seria w dniu 66 (30)"))
ksztalty <- c(16, 17, 15, 4)
kolory <- c(kol[["szary"]], kol[["pomaranczowy"]], kol[["niebieski"]], kol[["zielony"]])
pa <- ggplot(pokaz, aes(godz, kwota, colour = grupa, shape = grupa, alpha = grupa)) + geom_point(size = 1.6) +
  scale_y_log10(breaks = c(10, 30, 100, 300, 1000)) + scale_x_continuous(breaks = seq(0, 24, 6)) +
  labs(title = "A. Kwota a pora", x = "godzina transakcji", y = "kwota (zł, skala log)")
pb <- ggplot(pokaz, aes(przerwa / 60, odl, colour = grupa, shape = grupa, alpha = grupa)) + geom_point(size = 1.6) +
  scale_x_log10(breaks = c(0.1, 1, 10, 100, 720), labels = c("0.1", "1", "10", "100", "720")) +
  scale_y_log10(breaks = c(0.1, 1, 10, 100), labels = c("0.1", "1", "10", "100")) +
  labs(title = "B. Tempo użycia a odległość", x = "godziny od poprzedniego użycia karty (log)",
       y = "km od zwykłego sklepu (log)")
p1 <- (pa + pb) + plot_layout(guides = "collect") &
  scale_colour_manual(values = kolory, name = NULL) & scale_shape_manual(values = ksztalty, name = NULL) &
  scale_alpha_manual(values = c(0.45, 0.9, 0.9, 0.9), guide = "none") &
  guides(colour = guide_legend(nrow = 2, override.aes = list(size = 3, alpha = 1))) & motyw
p1                       # do pliku: ggsave("nietypowe-transakcje-dane.svg", p1, width = 10, height = 5.6)
Wynik w R
Transakcje: 49980 | nadużycia: 140 = 0.28 %
            rodzaj
tydzien_9_12     A     B     S uczciwa
       FALSE    70     0     0   33250
       TRUE     10    30    30   16590
Mediany (uczciwe / nadużycia):
             0     1
kwota    109.6 249.5
przerwa 2986.8  78.6
odl        3.0  37.2
Odsetek transakcji z 1 użyciem karty w godzinie: 99.1 %
Nadużycia z |z| > 3 choć w jednej cesze: 84 z 140 | uczciwe: 1340
2. Maskowanie w dniu serii: Rysunek 2
R
# Rysunek 2. Maskowanie: dzień 66 – odległość Mahalanobisa klasyczna i odporna (MCD)
# (korzysta z d, X, kol i motyw z przepisu 1)
library(ggplot2)
library(patchwork)
library(robustbase)

prog <- qchisq(0.999, df = 4)                         # próg χ²(4) dla p = .001
i66 <- which(d$dzien == 66)
x66 <- X[i66, ]
D2_klas <- mahalanobis(x66, colMeans(x66), cov(x66))
set.seed(7042)                                        # covMcd losuje podzbiory startowe
mcd66 <- covMcd(x66, alpha = 0.75)
D2_odp <- mahalanobis(x66, mcd66$center, mcd66$cov)
seria <- d$rodzaj[i66] == "S"
cat("Dzień 66:", length(i66), "transakcji, w tym seria:", sum(seria), "i inne nadużycia:",
    sum(d$naduzycie[i66] == 1 & !seria), "| próg χ²(4) =", round(prog, 2), "\n")
cat("Seria powyżej progu – klasyczna:", sum(D2_klas[seria] > prog), "| odporna:", sum(D2_odp[seria] > prog), "\n")
cat("Uczciwe powyżej progu – klasyczna:", sum(D2_klas[d$naduzycie[i66] == 0] > prog),
    "| odporna:", sum(D2_odp[d$naduzycie[i66] == 0] > prog), "\n")
cat("Mediana D² serii – klasyczna:", round(median(D2_klas[seria]), 1), "| odporna:", round(median(D2_odp[seria]), 1), "\n")
cat("Korelacja log kwoty i log odległości – klasyczna:", round(cov2cor(cov(x66))[1, 4], 2),
    "| odporna:", round(cov2cor(mcd66$cov)[1, 4], 2), "\n")

# Elipsy 99.9% dla przerwy i odległości (wycinek 4-wymiarowych oszacowań): klasyczna i odporna
elipsa <- function(srodek, S, nazwa, r = sqrt(qchisq(0.999, 2))) {
  t <- seq(0, 2 * pi, length.out = 200)
  e <- t(srodek + r * t(chol(S)) %*% rbind(cos(t), sin(t)))
  data.frame(log_przerwa = e[, 1], log_odl = e[, 2], metoda = nazwa)
}
el <- rbind(elipsa(colMeans(x66)[c(3, 4)], cov(x66)[c(3, 4), c(3, 4)], "klasyczna"),
            elipsa(mcd66$center[c(3, 4)], mcd66$cov[c(3, 4), c(3, 4)], "odporna (MCD)"))
dd <- data.frame(x66, D_klas = sqrt(D2_klas), D_odp = sqrt(D2_odp),
                 grupa = ifelse(seria, "seria S (30)", ifelse(d$naduzycie[i66] == 1, "inne nadużycie", "uczciwa")))
dd$grupa <- factor(dd$grupa, c("uczciwa", "inne nadużycie", "seria S (30)"))
pa <- ggplot(dd, aes(log_przerwa, log_odl)) +
  geom_point(aes(colour = grupa, shape = grupa), size = 1.9) +
  geom_path(data = el, aes(log_przerwa, log_odl, linetype = metoda), colour = kol[["granat"]], linewidth = 0.8) +
  scale_x_continuous(breaks = log(60 * c(0.1, 1, 10, 100, 720)), labels = c("0.1", "1", "10", "100", "720")) +
  scale_y_continuous(breaks = log1p(c(0, 1, 3, 10, 30, 100)), labels = c(0, 1, 3, 10, 30, 100)) +
  labs(title = "A. Przerwa i odległość, dzień 66", x = "godziny od poprzedniego użycia (log)", y = "km od zwykłego sklepu (log)",
       linetype = "elipsa 99.9%")
pb <- ggplot(dd, aes(D_klas, D_odp, colour = grupa, shape = grupa)) +
  geom_vline(xintercept = sqrt(prog), linetype = 2, colour = "grey45") +
  geom_hline(yintercept = sqrt(prog), linetype = 2, colour = "grey45") +
  geom_point(size = 1.9) +
  annotate("text", x = 0.4, y = sqrt(prog) + 0.25, label = "próg χ²(4), p = .001", hjust = 0, size = 3.5, colour = "grey30") +
  labs(title = "B. Odległość klasyczna i odporna", x = "odległość klasyczna (√D²)", y = "odległość odporna MCD (√D²)")
p2 <- (pa + pb) + plot_layout(guides = "collect") &
  scale_colour_manual(values = c(kol[["szary"]], kol[["pomaranczowy"]], kol[["zielony"]]), name = NULL) &
  scale_shape_manual(values = c(16, 17, 4), name = NULL) & motyw
p2                       # do pliku: ggsave("nietypowe-transakcje-maskowanie.svg", p2, width = 10, height = 5.6)
Wynik w R
Dzień 66: 595 transakcji, w tym seria: 30 i inne nadużycia: 2 | próg χ²(4) = 18.47
Seria powyżej progu – klasyczna: 0 | odporna: 30
Uczciwe powyżej progu – klasyczna: 3 | odporna: 17
Mediana D² serii – klasyczna: 10.1 | odporna: 25.9
Korelacja log kwoty i log odległości – klasyczna: 0.15 | odporna: -0.04
3. Pięć wyników nietypowości i kolejka: Rysunek 3
R
# Rysunek 3. Kolejka do sprawdzenia: precyzja wśród k najwyżej ocenionych i zysk dzienny
# (korzysta z d, X, kol i motyw z przepisu 1)
library(ggplot2)
library(patchwork)
library(robustbase)
library(dbscan)
library(ranger)

test <- d$tydzien > 8                                  # tygodnie 9–12 (dni 57–84) – okres oceny
# Wynik nietypowości liczony każdego wieczoru na transakcjach z danego dnia
wynik <- matrix(NA, nrow(d), 5, dimnames = list(NULL, c("z", "klasyczna", "MCD", "LOF", "las")))
set.seed(7043)                                         # covMcd losuje podzbiory startowe
for (dz in 57:84) {
  i <- which(d$dzien == dz)
  x <- X[i, ]
  wynik[i, "z"] <- apply(abs(scale(x)), 1, max)                         # największe |z| z 4 cech
  wynik[i, "klasyczna"] <- mahalanobis(x, colMeans(x), cov(x))
  m <- covMcd(x, alpha = 0.75)
  wynik[i, "MCD"] <- mahalanobis(x, m$center, m$cov)
  wynik[i, "LOF"] <- lof(scale(x), minPts = 30)                          # 30 najbliższych sąsiadów
}
# Model nadzorowany: las losowy uczony na etykietach z tygodni 1–8
dane_las <- data.frame(X, uzycia = d$uzycia, y = factor(d$naduzycie))
las <- ranger(y ~ ., data = dane_las[!test, ], num.trees = 500, probability = TRUE, seed = 7043)
wynik[test, "las"] <- predict(las, dane_las[test, ])$predictions[, "1"]

dt <- d[test, ]
W <- wynik[test, ]
y <- dt$naduzycie
cat("Okres oceny: 28 dni,", nrow(dt), "transakcji,", sum(y), "nadużyć (A:", sum(dt$rodzaj == "A"), "B:",
    sum(dt$rodzaj == "B"), "S:", sum(dt$rodzaj == "S"), ")\n")
alarmy <- tapply(W[, "MCD"] > qchisq(0.999, 4), dt$dzien, sum)        # transakcje ponad progiem χ²(4), p = .001
cat("Odległość MCD ponad progiem – dzień 66:", alarmy[["66"]], "| pozostałe dni: mediana", median(alarmy[names(alarmy) != "66"]),
    "zakres", paste(range(alarmy[names(alarmy) != "66"]), collapse = "–"), "\n")
kolejka <- function(s, k) unlist(lapply(split(seq_along(s), dt$dzien), function(i) i[order(-s[i])][seq_len(k)]))

# Koszty i korzyści ustalone ręcznie (przykład, nie dane rynkowe)
koszt_sprawdzenia <- 10      # zł – kilka minut pracy analityka
koszt_falszywego <- 20       # zł – wstrzymana karta i telefon do uczciwego klienta
ochrona <- 300               # zł – średnio uratowane saldo karty po zablokowaniu, ponad kwotę transakcji
zysk <- function(idx) sum(ifelse(y[idx] == 1, dt$kwota[idx] + ochrona, -koszt_falszywego)) - koszt_sprawdzenia * length(idx)

k <- 10                      # zespół sprawdza 10 transakcji dziennie
tab <- t(sapply(colnames(W), function(m) {
  q <- kolejka(W[, m], k)
  c(trafne = sum(y[q]), precyzja = round(100 * mean(y[q]), 1), czulosc = round(100 * sum(y[q]) / sum(y), 1),
    A = sum(dt$rodzaj[q] == "A"), B = sum(dt$rodzaj[q] == "B"), S = sum(dt$rodzaj[q] == "S"),
    zysk_dzien = round(zysk(q) / 28))
}))
print(tab)
# Kolejka mieszana: 5 transakcji z lasu i 5 z LOF (bez powtórzeń)
mieszana <- unlist(lapply(split(seq_len(nrow(dt)), dt$dzien), function(i) {
  a <- i[order(-W[i, "las"])][1:5]
  b <- setdiff(i[order(-W[i, "LOF"])], a)[1:5]
  c(a, b) }))
cat("Kolejka mieszana (5 z lasu + 5 z LOF): trafne", sum(y[mieszana]), "| A", sum(dt$rodzaj[mieszana] == "A"),
    "B", sum(dt$rodzaj[mieszana] == "B"), "S", sum(dt$rodzaj[mieszana] == "S"),
    "| zysk na dzień", round(zysk(mieszana) / 28), "zł\n")

# Krzywe dla k = 2…40 sprawdzeń dziennie
ks <- seq(2, 40, 2)
krzywe <- do.call(rbind, lapply(colnames(W), function(m) do.call(rbind, lapply(ks, function(kk) {
  q <- kolejka(W[, m], kk)
  data.frame(metoda = m, k = kk, precyzja = 100 * mean(y[q]), zysk = zysk(q) / 28) }))))
najlepsze <- do.call(rbind, lapply(split(krzywe, krzywe$metoda), function(x) x[which.max(x$zysk), ]))
print(data.frame(metoda = najlepsze$metoda, k_najlepsze = najlepsze$k, zysk_dzien = round(najlepsze$zysk)), row.names = FALSE)
cat("Zysk dzienny (zł) przy k = 10, 20 i 40:\n")
print(round(xtabs(zysk ~ metoda + k, data = krzywe[krzywe$k %in% c(10, 20, 40), ])))

krzywe$metoda <- factor(krzywe$metoda, colnames(W), c("reguła |z|", "Mahalanobis klasyczna", "Mahalanobis MCD", "LOF", "las losowy"))
kol5 <- c(kol[["szary"]], kol[["blekit"]], kol[["niebieski"]], kol[["zielony"]], kol[["pomaranczowy"]])
pa <- ggplot(krzywe, aes(k, precyzja, colour = metoda, shape = metoda)) + geom_line(linewidth = 0.8) + geom_point(size = 2) +
  geom_vline(xintercept = 10, linetype = 2, colour = "grey45") +
  labs(title = "A. Precyzja kolejki", x = "sprawdzeń dziennie (k)", y = "% nadużyć wśród sprawdzonych")
pb <- ggplot(krzywe, aes(k, zysk, colour = metoda, shape = metoda)) + geom_hline(yintercept = 0, colour = "grey45") +
  geom_line(linewidth = 0.8) + geom_point(size = 2) + geom_vline(xintercept = 10, linetype = 2, colour = "grey45") +
  labs(title = "B. Zysk ze sprawdzeń", x = "sprawdzeń dziennie (k)", y = "zł dziennie (średnio z 28 dni)")
p3 <- (pa + pb) + plot_layout(guides = "collect") & scale_colour_manual(values = kol5, name = NULL) &
  scale_shape_manual(values = c(1, 2, 17, 15, 16), name = NULL) & guides(colour = guide_legend(nrow = 2)) & motyw
p3                       # do pliku: ggsave("nietypowe-transakcje-kolejka.svg", p3, width = 10, height = 5.6)
Wynik w R
Okres oceny: 28 dni, 16660 transakcji, 70 nadużyć (A: 10 B: 30 S: 30 )
Odległość MCD ponad progiem – dzień 66: 49 | pozostałe dni: mediana 14 zakres 9–24
          trafne precyzja czulosc A  B  S zysk_dzien
z             20      7.1    28.6 2 17  1          1
klasyczna     32     11.4    45.7 6 26  0        192
MCD           27      9.6    38.6 6 15  6        181
LOF           34     12.1    48.6 5 29  0        206
las           39     13.9    55.7 7 22 10        378
Kolejka mieszana (5 z lasu + 5 z LOF): trafne 40 | A 7 B 28 S 5 | zysk na dzień 341 zł
    metoda k_najlepsze zysk_dzien
 klasyczna           6        287
       las           6        381
       LOF           6        284
       MCD          18        232
         z           2         66
Zysk dzienny (zł) przy k = 10, 20 i 40:
           k
metoda        10   20   40
  klasyczna  192   12 -235
  las        378  349   28
  LOF        206  -42 -581
  MCD        181  221   43
  z            1  -13 -269
4. Krzywe ROC i PR: Rysunek 4
R
# Rysunek 4. Krzywa ROC i krzywa precyzja–czułość pięciu wyników w tygodniach 9–12
# (korzysta z W, y, kol, kol5 i motyw z przepisów 1 i 3; bez nowego losowania)
library(ggplot2)
library(patchwork)

krzywa <- function(s, y) {             # czułość, odsetek fałszywych alarmów i precyzja przy kolejnych progach
  o <- order(-s); tp <- cumsum(y[o]); fp <- cumsum(1 - y[o])
  wierz <- sort(unique(c(which(y[o] == 1), which(y[o] == 1) - 1, length(o))))   # tylko wierzchołki schodków
  wierz <- wierz[wierz > 0]
  data.frame(fpr = c(0, fp[wierz] / sum(1 - y)), tpr = c(0, tp[wierz] / sum(y)), precyzja = c(1, tp[wierz] / wierz))
}
auc <- function(s, y) { r <- rank(s); (sum(r[y == 1]) - sum(y) * (sum(y) + 1) / 2) / (sum(y) * sum(1 - y)) }
ap <- function(s, y) { o <- order(-s); yy <- y[o]; mean((cumsum(yy) / seq_along(yy))[yy == 1]) }   # średnia precyzja
miary <- data.frame(metoda = colnames(W), AUC = sapply(colnames(W), function(m) round(auc(W[, m], y), 3)),
                    AP = sapply(colnames(W), function(m) round(ap(W[, m], y), 3)), row.names = NULL)
print(miary)
cat("Poziom losowy AP (odsetek nadużyć):", round(mean(y), 4), "\n")
# Ile fałszywych alarmów trzeba przejrzeć, żeby znaleźć połowę nadużyć?
pol <- sapply(colnames(W), function(m) { o <- order(-W[, m]); j <- which(cumsum(y[o]) >= sum(y) / 2)[1]
  c(FPR_proc = round(100 * sum(1 - y[o][1:j]) / sum(1 - y), 2), falszywe = sum(1 - y[o][1:j])) })
print(pol)

kr <- do.call(rbind, lapply(colnames(W), function(m) cbind(metoda = m, krzywa(W[, m], y))))
kr$metoda <- factor(kr$metoda, colnames(W), c("reguła |z|", "Mahalanobis klasyczna", "Mahalanobis MCD", "LOF", "las losowy"))
pa <- ggplot(kr, aes(fpr, tpr, colour = metoda)) + geom_abline(linetype = 2, colour = "grey60") +
  geom_path(linewidth = 0.8) + coord_equal() +
  labs(title = "A. Krzywa ROC", x = "odsetek fałszywych alarmów", y = "czułość")
pb <- ggplot(kr, aes(tpr, precyzja, colour = metoda)) + geom_hline(yintercept = mean(y), linetype = 2, colour = "grey60") +
  geom_path(linewidth = 0.8) + coord_cartesian(ylim = c(0, 1)) +
  labs(title = "B. Krzywa precyzja–czułość", x = "czułość", y = "precyzja")
p4 <- (pa + pb) + plot_layout(guides = "collect") & scale_colour_manual(values = kol5, name = NULL) &
  guides(colour = guide_legend(nrow = 2, override.aes = list(linewidth = 1.5))) & motyw
p4                       # do pliku: ggsave("nietypowe-transakcje-roc-pr.svg", p4, width = 10, height = 5.8)
Wynik w R
     metoda   AUC    AP
1         z 0.961 0.090
2 klasyczna 0.971 0.193
3       MCD 0.985 0.182
4       LOF 0.656 0.246
5       las 0.964 0.573
Poziom losowy AP (odsetek nadużyć): 0.0042
              z klasyczna    MCD    LOF  las
FPR_proc   3.41      2.78   0.79   3.25 0.05
falszywe 565.00    461.00 131.00 539.00 8.00
5. Walidacja w czasie i rodzaje nadużyć: Rysunek 5
R
# Rysunek 5. Nadużycia zmieniają się w czasie: walidacja losowa a walidacja w czasie
# (korzysta z d, test, las, dt, W, y, kol, kol5, motyw i funkcji auc, ap z przepisów 1, 3 i 4)
library(ggplot2)
library(patchwork)

# Ocena „losowa”: prognozy z obserwacji spoza próby bootstrapowej (OOB) w tygodniach 1–8
oob <- las$predictions[, "1"]
y_ucz <- d$naduzycie[!test]
cat("Las losowy – ocena losowa (OOB, tygodnie 1–8): AUC", round(auc(oob, y_ucz), 3), "AP", round(ap(oob, y_ucz), 3), "\n")
cat("Las losowy – ocena w czasie (tygodnie 9–12):    AUC", round(auc(W[, "las"], y), 3), "AP", round(ap(W[, "las"], y), 3), "\n")
# AUC i średnia precyzja (AP) osobno dla każdego rodzaju nadużyć (nadużycia danego rodzaju vs wszystkie uczciwe)
auc_rodz <- do.call(rbind, lapply(c("A", "B", "S"), function(r) {
  j <- dt$rodzaj %in% c("uczciwa", r)
  data.frame(rodzaj = r, metoda = colnames(W), AUC = sapply(colnames(W), function(m) auc(W[j, m], y[j])),
             AP = sapply(colnames(W), function(m) ap(W[j, m], y[j])))
}))
print(reshape(transform(auc_rodz, AUC = round(AUC, 3), AP = round(AP, 3)), idvar = "metoda", timevar = "rodzaj", direction = "wide"), row.names = FALSE)

tyg <- as.data.frame(table(tydzien = d$tydzien[d$naduzycie == 1], rodzaj = d$rodzaj[d$naduzycie == 1]))
print(xtabs(Freq ~ rodzaj + tydzien, data = tyg))
tyg$rodzaj <- factor(tyg$rodzaj, c("A", "B", "S"), c("A: opróżnianie kart", "B: nowy wzorzec", "S: seria"))
pa <- ggplot(tyg, aes(as.integer(as.character(tydzien)), Freq, fill = rodzaj)) + geom_col(width = 0.8) +
  geom_vline(xintercept = 8.5, linetype = 2, colour = "grey30") +
  annotate("text", x = 4.5, y = 43, label = "uczenie lasu", size = 3.8, colour = "grey25") +
  annotate("text", x = 10.5, y = 43, label = "ocena", size = 3.8, colour = "grey25") +
  scale_fill_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]], kol[["zielony"]]), name = NULL) +
  scale_x_continuous(breaks = 1:12) + guides(fill = guide_legend(nrow = 2)) +
  labs(title = "A. Nadużycia w tygodniach", x = "tydzień", y = "liczba nadużyć")
auc_rodz$metoda <- factor(auc_rodz$metoda, colnames(W), c("reguła |z|", "Mahalanobis klasyczna", "Mahalanobis MCD", "LOF", "las losowy"))
auc_rodz$rodzaj <- factor(auc_rodz$rodzaj, c("S", "B", "A"), c("S: seria", "B: nowy wzorzec", "A: opróżnianie"))
pb <- ggplot(auc_rodz, aes(AP, rodzaj, colour = metoda, shape = metoda)) + geom_point(size = 3.2, stroke = 1.1) +
  scale_colour_manual(values = kol5, name = NULL) + scale_shape_manual(values = c(1, 2, 17, 15, 16), name = NULL) +
  guides(colour = guide_legend(nrow = 3)) + coord_cartesian(xlim = c(0, 0.8)) +
  labs(title = "B. Średnia precyzja według rodzaju", x = "AP (tygodnie 9–12)", y = NULL)
p5 <- (pa + pb) & motyw
p5                       # do pliku: ggsave("nietypowe-transakcje-czas.svg", p5, width = 10, height = 5.8)
Wynik w R
Las losowy – ocena losowa (OOB, tygodnie 1–8): AUC 0.973 AP 0.579
Las losowy – ocena w czasie (tygodnie 9–12):    AUC 0.964 AP 0.573
    metoda AUC.A  AP.A AUC.B  AP.B AUC.S  AP.S
         z 0.937 0.020 0.983 0.113 0.947 0.016
 klasyczna 0.973 0.062 0.994 0.296 0.948 0.016
       MCD 0.972 0.056 0.981 0.072 0.993 0.120
       LOF 0.967 0.083 0.996 0.464 0.211 0.001
       las 0.940 0.275 0.937 0.102 1.000 0.791
      tydzien
rodzaj  1  2  3  4  5  6  7  8  9 10 11 12
     A  3 13  6  7 13 11 12  5  3  4  1  2
     B  0  0  0  0  0  0  0  0  5  5  9 11
     S  0  0  0  0  0  0  0  0  0 30  0  0
6. Schemat „wynik → kolejka → decyzja”: Rysunek 6
R
# Rysunek 6. Schemat: wynik nietypowości → kolejka do sprawdzenia → decyzja
# (korzysta z kol i motyw z przepisu 1; liczby z przepisów 2 i 3 wpisane ręcznie; bez losowania)
library(ggplot2)

pola <- data.frame(
  x = c(1, 3.05, 5.1, 7.15), y = 2.35,
  tytul = c("1. Transakcje dnia", "2. Wynik nietypowości", "3. Kolejka: k = 10", "4. Decyzja analityka"),
  tekst = c("ok. 595 dziennie\nkwota, pora, przerwa\nod poprzedniego użycia,\nodległość od sklepu",
            "las losowy (gdy są\netykiety) + LOF lub\nMahalanobis MCD\n(nowe wzorce)",
            "10 najwyżej ocenionych\n= tyle, ile zespół\nzdąży sprawdzić\n(1.7% transakcji)",
            "nadużycie: blokada,\nzwrot dla klienta\nuczciwa: przeprosiny,\nkarta działa dalej"))
pola$tlo <- c("#eef0f4", "#dcebf6", "#fbe6d9", "#d4ede4")
strzalki <- data.frame(x = pola$x[1:3] + 0.88, xend = pola$x[2:4] - 0.88, y = 2.35)
dol <- data.frame(x = c(2.05, 6.1), y = 0.72, tekst = c(
  "Sygnał alarmowy: w dniu 66 aż 49 transakcji\nponad progiem χ² w odległości MCD\n(zwykle 9–24) → sprawdź cały sklep",
  "Etykiety z decyzji wracają do uczenia lasu,\nale tylko dla sprawdzonych transakcji –\nnowe wzorce widzi metoda bez etykiet"))
p6 <- ggplot() +
  geom_tile(data = pola, aes(x, y), width = 1.76, height = 1.55, fill = pola$tlo, colour = "#c9c6bf") +
  geom_text(data = pola, aes(x, y + 0.56, label = tytul), fontface = "bold", size = 4.1, colour = "#0f1d3a") +
  geom_text(data = pola, aes(x, y - 0.12, label = tekst), size = 3.55, lineheight = 0.95, colour = "#0f1d3a") +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = y), colour = kol[["granat"]], linewidth = 1,
               arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  geom_curve(aes(x = 7.15, y = 1.55, xend = 3.05, yend = 1.55), curvature = -0.22, colour = kol[["zielony"]],
             linewidth = 0.9, linetype = 2, arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  geom_tile(data = dol, aes(x, y), width = 3.6, height = 0.78, fill = "#f4f2ee", colour = "#dedbd4") +
  geom_text(data = dol, aes(x, y, label = tekst), size = 3.4, lineheight = 0.95, colour = "#0f1d3a") +
  coord_cartesian(xlim = c(0.05, 8.1), ylim = c(0.25, 3.25), expand = FALSE) +
  labs(title = "Od wyniku nietypowości do decyzji",
       subtitle = "Wynik nie jest wyrokiem – ustala kolejność sprawdzania", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p6                       # do pliku: ggsave("nietypowe-transakcje-schemat.svg", p6, width = 10, height = 5.2)
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – niebieski" = c("#56B4E9", "#0072B2"),
             "niebieski – zielony" = c("#0072B2", "#009E73"), "pomarańczowy – zielony" = c("#D55E00", "#009E73"),
             "szary – pomarańczowy" = c("#999999", "#D55E00"), "szary – zielony" = c("#999999", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – niebieski                          26.4         24.7       24.6
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
szary – pomarańczowy                        77.2         62.9       56.0
szary – zielony                             47.8         11.8       19.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, odległość klasyczną (mahalanobis) i wartości krytyczne χ² obliczono pakietem stats (z podstawowej instalacji R). Odporne oszacowania MCD obliczono pakietem robustbase, LOF – pakietem dbscan, las losowy – pakietem ranger. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- robustbase (wersja 0.99.7): Maechler, M., Rousseeuw, P., Croux, C., Todorov, V., Ruckstuhl, A., Salibian-Barrera, M., Verbeke, T., Koller, M., Conceicao, E. L. T., & Anna di Palma, M. (2026). robustbase: Basic robust statistics [R package]. http://robustbase.r-forge.r-project.org/
- dbscan (wersja 1.2.4): Hahsler, M., Piekenbrock, M., & Doran, D. (2019). dbscan: Fast density-based clustering with R. Journal of Statistical Software, 91(1), 1–30. https://doi.org/10.18637/jss.v091.i01
- ranger (wersja 0.18.0): Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Trafność zamiast precyzji wśród k. Reguła „wszystko uczciwe” ma 99.7% trafności i nie znajduje nic.
- Tylko klasyczna odległość – seria podobnych nadużyć maskuje samą siebie (rysunek 2).
- Tylko ROC – przy 0.42% nadużyć setki fałszywych alarmów nie zmieniają AUC (rysunek 4).
- Losowy podział danych z czasem – nie pokaże, że model nie widzi nowego wzorca (rysunek 5).
- LOF przy gęstej serii – 30 podobnych transakcji to dla LOF „tłum”, nie odstające (rysunek 5).
- Zmienna licznikowa w MCD – gdy prawie wszystkie wartości są równe, odporna kowariancja jest osobliwa (rysunek 1).
- Pominięty koszt fałszywego alarmu – więcej sprawdzeń nie zawsze daje więcej zysku (rysunek 3). Wartość predykcyjna dodatnia zależy od tego, jak rzadkie są nadużycia.
Najczęstsze pytania
Jak wykryć nietypowe transakcje bez etykiet nadużyć?
Użyj miary odległości od typowych transakcji, np. odporną odległość Mahalanobisa (MCD) albo lokalny współczynnik odstawania (LOF), i sprawdzaj codziennie k transakcji z najwyższym wynikiem. W przykładzie przy 10 sprawdzeniach dziennie LOF znalazł 34 z 70 nadużyć, a odległość klasyczna 32. Etykiety z tych sprawdzeń pozwolą potem uczyć model nadzorowany.
Czym jest maskowanie w odległości Mahalanobisa?
Maskowanie to sytuacja, w której kilka podobnych obserwacji odstających zawyża średnią i kowariancję, z których liczy się ich własną odległość, i przez to nie przekraczają progu. W przykładzie żadna z 30 transakcji serii nie przekroczyła progu χ²(4) w wersji klasycznej, a w odpornej (MCD) – wszystkie 30.
Co to jest precyzja wśród k najwyżej ocenionych?
To odsetek prawdziwych nadużyć wśród k transakcji o najwyższym wyniku, gdzie k to liczba transakcji, które zespół zdąży sprawdzić. Odpowiada wprost na pytanie zespołu: ile z moich sprawdzeń trafi. Przy 0.42% nadużyć precyzja 13.9% lasu losowego to ponad 30 razy więcej niż przy losowym wyborze.
Kiedy LOF jest lepszy od odległości Mahalanobisa?
Gdy nadużycie leży w pustym miejscu między skupiskami typowych transakcji – LOF porównuje gęstość wokół punktu z gęstością wokół jego sąsiadów. Gorzej radzi sobie z gęstą serią podobnych nadużyć: w przykładzie seria 30 transakcji dostała AUC = .211. Dlatego warto liczyć obie miary.
Dlaczego model wykrywania nadużyć trzeba oceniać w czasie?
Bo oszuści zmieniają sposób działania, a model uczony na przeszłości zna tylko dawne wzorce. W przykładzie las losowy miał podobną średnią precyzję w ocenie losowej i w czasie (.579 i .573), ale nowy wzorzec wykrywał słabo (AP .102 wobec .464 dla LOF). Ucz na wcześniejszych tygodniach, oceniaj na późniejszych i osobno dla nowych rodzajów nadużyć.
Powiązane hasła
Przeczytaj też
Wykrywanie nadużyć przy rzadkich zdarzeniach
Ubezpieczyciel, 60 000 szkód i 200 kontroli miesięcznie: krzywe ROC i PR, macierz kosztów, wybór według zysku, SMOTE a kalibracja i etykiety z kontroli – pięć rysunków z kodem R.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikPrzeciek danych i walidacja w czasie
Sieć siłowni i rezygnacje z karnetu: zmienne z przyszłości, losowy podział, wybór zmiennych na szumie i okno przesuwane – pięć rysunków z kodem R.
Czytaj →PoradnikWykrywanie fałszywych opinii
Portal z opiniami o warsztatach: skupiska ocen, profil konta, las losowy, 5 kontroli dziennie, krzywa PR i ranking po moderacji – z kodem R.
Czytaj →Piszesz pracę o wykrywaniu nadużyć albo budujesz takie sito w firmie?
Pomożemy dobrać miary nietypowości, zaplanować ocenę w czasie i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bolton, R. J., & Hand, D. J. (2002). Statistical fraud detection: A review. Statistical Science, 17(3), 235–255. https://doi.org/10.1214/ss/1042727940 ● Otwarty dostęp
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/a:1010933404324 ● Otwarty dostęp: pełny tekst
- Breunig, M. M., Kriegel, H.-P., Ng, R. T., & Sander, J. (2000). LOF: Identifying density-based local outliers. In Proceedings of the 2000 ACM SIGMOD International Conference on Management of Data (pp. 93–104). ACM. https://doi.org/10.1145/342009.335388 ● Otwarty dostęp
- Dal Pozzolo, A., Boracchi, G., Caelen, O., Alippi, C., & Bontempi, G. (2018). Credit card fraud detection: A realistic modeling and a novel learning strategy. IEEE Transactions on Neural Networks and Learning Systems, 29(8), 3784–3797. https://doi.org/10.1109/tnnls.2017.2736643 ● Otwarty dostęp: pełny tekst
- Liu, F. T., Ting, K. M., & Zhou, Z.-H. (2008). Isolation forest. In 2008 Eighth IEEE International Conference on Data Mining (pp. 413–422). IEEE. https://doi.org/10.1109/icdm.2008.17
- Rousseeuw, P. J., & Van Driessen, K. (1999). A fast algorithm for the minimum covariance determinant estimator. Technometrics, 41(3), 212–223. https://doi.org/10.1080/00401706.1999.10485670
- Rousseeuw, P. J., & van Zomeren, B. C. (1990). Unmasking multivariate outliers and leverage points. Journal of the American Statistical Association, 85(411), 633–639. https://doi.org/10.1080/01621459.1990.10474920
- Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLOS ONE, 10(3), Article e0118432. https://doi.org/10.1371/journal.pone.0118432 ● Otwarty dostęp
Cytowania BibTeX
@article{bolton2002statistical, author={Bolton, Richard J. and Hand, David J.}, title={{Statistical fraud detection: A review}}, journal={Statistical Science}, year={2002}, volume={17}, number={3}, pages={235--255}, doi={10.1214/ss/1042727940}}@article{breiman2001random, author={Breiman, Leo}, title={{Random forests}}, journal={Machine Learning}, year={2001}, volume={45}, number={1}, pages={5--32}, doi={10.1023/a:1010933404324}}@inproceedings{breunig2000lof, author={Breunig, Markus M. and Kriegel, Hans-Peter and Ng, Raymond T. and Sander, Jörg}, title={{LOF: Identifying density-based local outliers}}, booktitle={Proceedings of the 2000 ACM SIGMOD International Conference on Management of Data}, year={2000}, pages={93--104}, publisher={ACM}, doi={10.1145/342009.335388}}@article{dalpozzolo2018credit, author={Dal Pozzolo, Andrea and Boracchi, Giacomo and Caelen, Olivier and Alippi, Cesare and Bontempi, Gianluca}, title={{Credit card fraud detection: A realistic modeling and a novel learning strategy}}, journal={IEEE Transactions on Neural Networks and Learning Systems}, year={2018}, volume={29}, number={8}, pages={3784--3797}, doi={10.1109/tnnls.2017.2736643}}@inproceedings{liu2008isolation, author={Liu, Fei Tony and Ting, Kai Ming and Zhou, Zhi-Hua}, title={{Isolation forest}}, booktitle={2008 Eighth IEEE International Conference on Data Mining}, year={2008}, pages={413--422}, publisher={IEEE}, doi={10.1109/icdm.2008.17}}@article{rousseeuw1999fast, author={Rousseeuw, Peter J. and Van Driessen, Katrien}, title={{A fast algorithm for the minimum covariance determinant estimator}}, journal={Technometrics}, year={1999}, volume={41}, number={3}, pages={212--223}, doi={10.1080/00401706.1999.10485670}}@article{rousseeuw1990unmasking, author={Rousseeuw, Peter J. and van Zomeren, Bert C.}, title={{Unmasking multivariate outliers and leverage points}}, journal={Journal of the American Statistical Association}, year={1990}, volume={85}, number={411}, pages={633--639}, doi={10.1080/01621459.1990.10474920}}@article{saito2015precision, author={Saito, Takaya and Rehmsmeier, Marc}, title={{The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets}}, journal={PLOS ONE}, year={2015}, volume={10}, number={3}, eid={e0118432}, doi={10.1371/journal.pone.0118432}}