Przykład: sieć pralni chemicznych i 25 punktów
Fikcyjna sieć pralni chemicznych ma 25 punktów: od małego okienka w osiedlowym pawilonie (1400 zleceń rocznie) po duży punkt przy galerii handlowej (26 000). Co kwartał dział jakości dostaje tabelę „skargi na 1000 zleceń” i ogłasza listę najgorszych punktów. Kierownicy z góry listy mają przygotować plan naprawczy. Pytanie zarządu: które punkty naprawdę mają za dużo skarg, a które trafiły na górę przez przypadek albo przez to, co piorą?
Zliczamy zlecenia ze skargą (jedno zlecenie liczy się raz, nawet gdy klient wracał kilka razy) i dzielimy je przez liczbę zleceń. Zlecenia dzielą się na zwykłe (koszule, spodnie, kurtki) i delikatne (jedwab, skóry, suknie wieczorowe), a te drugie częściej kończą się reklamacją. W całym roku sieć przyjęła 216 028 zleceń, z których 1401 skończyło się skargą: 6.49 na 1000 zleceń, 95% CI [6.15, 6.83]. Przy zleceniach zwykłych było to 4.40 na 1000, przy delikatnych 12.62.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie: wielkość punktów (od 1400 do 26 000 zleceń rocznie, rozdane punktom losowo), udział zleceń delikatnych (8–45%), prawdziwą częstość skarg 4.0 na 1000 przy zleceniach zwykłych i 11.0 przy delikatnych, prawdziwe różnice punktów (odchylenie standardowe 0.20 na skali logarytmu), wahania kwartalne (0.10) i dwa punkty naprawdę gorsze – P20 i P11, w których częstość pomnożyliśmy przez 1.9. Prawdziwa częstość każdego punktu jest stała przez cały rok. Ziarno 705 ustaliliśmy raz i nie zmienialiśmy go. Dane (punkt × kwartał × rodzaj usługi) pobierzesz jako skargi-pralnie-25-punktow-kwartaly.csv.
Rysunek 1: ranking, który wszyscy znają
Tak wygląda roczna tabela, tyle że z przedziałami ufności (dokładnymi, z rozkładu Poissona), których w firmowych raportach zwykle nie ma.
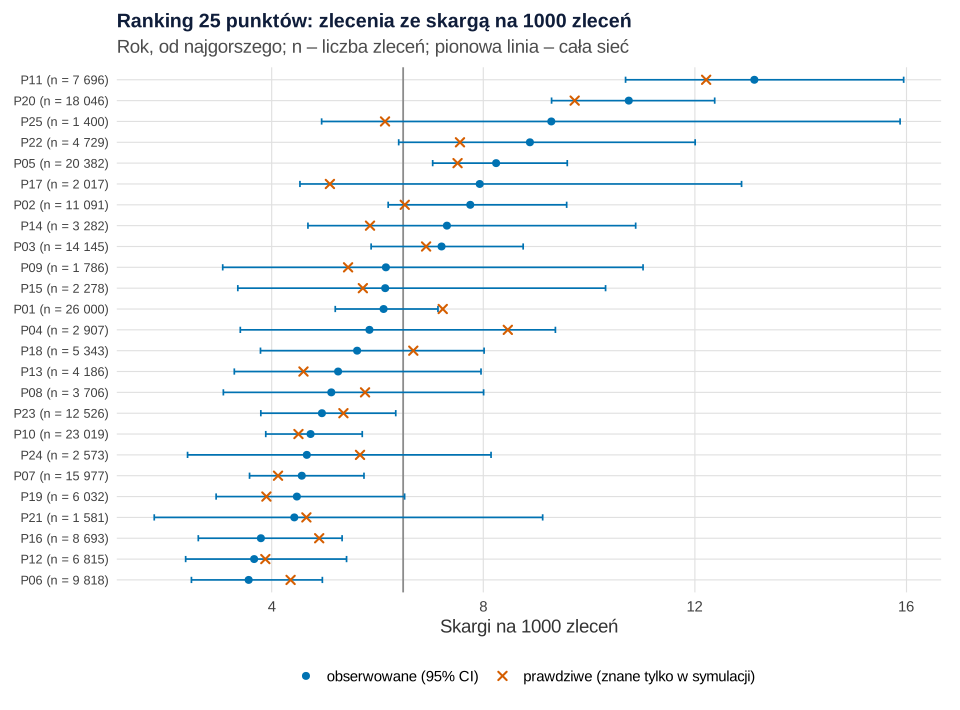
set.seed(705)).Co widać. Pierwsze miejsca zajmują P11 (13.12 na 1000) i P20 (10.75) – to rzeczywiście dwa punkty, które ustawiliśmy jako gorsze. Na trzecim miejscu jest jednak P25, najmniejszy punkt sieci: 13 skarg na 1400 zleceń, czyli 9.29 na 1000, ale z przedziałem od 4.94 do 15.88. Jego prawdziwa częstość to 6.14, czyli mniej niż średnia sieci. Gdyby miał dwie skargi mniej, spadłby do środka tabeli.
Jak może zmylić. Ranking ustawia punkty w kolejce, choć większość przedziałów na siebie zachodzi. Nie pokazuje, jak duży jest punkt, ani co w nim się pierze: P11, P20 i P22 mają ok. 40% zleceń delikatnych, a P06 – 11%. O tym, jak mało rankingi mówią po uwzględnieniu niepewności, piszą Leckie i Goldstein (2009) na przykładzie tabel szkół; ogólniej o pozycjach i ocenach – hasło ranking a ocena pozycji.
Podpis do pracy:
Rysunek 2: regresja Poissona z offsetem i ujemna dwumianowa
Liczba skarg zależy od liczby zleceń, więc nie modelujemy samej liczby, tylko częstość. Służy do tego regresja Poissona z offsetem, czyli logarytmem liczby zleceń dodanym ze współczynnikiem ustalonym na 1. Tak analizuje się częstości zdarzeń od dawna (Frome, 1983). Jednostką jest punkt × kwartał × rodzaj usługi (200 wierszy):
Po przeniesieniu ln(zlecenia) na lewą stronę model opisuje logarytm częstości skarg na jedno zlecenie, a exp(b1) to iloraz częstości (IRR): ile razy częściej skarżą się klienci zleceń delikatnych.
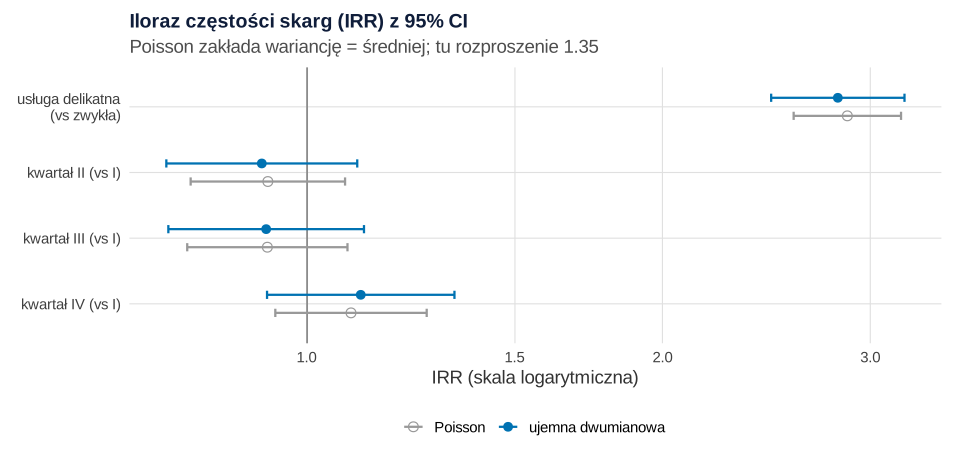
Co widać. Zlecenia delikatne mają skargi 2.87 razy częściej niż zwykłe (Poisson; 95% CI [2.58, 3.19]); prawdziwy iloraz to 11 / 4 = 2.75. Kwartały się nie różnią (IRR od 0.92 do 1.11, wszystkie p > .25). Model Poissona ma jednak współczynnik rozproszenia 1.35: wariancja jest większa, niż zakłada rozkład Poissona (nadmierna dyspersja). Regresja ujemna dwumianowa to uwzględnia (θ = 20.9, AIC 914.5 wobec 925.2) i daje IRR = 2.82, 95% CI [2.47, 3.21] – podobny wynik z szerszym przedziałem.
Jak może zmylić. Skąd nadmierna dyspersja? Z punktów, których model nie zna. Po dodaniu punktu jako czynnika dewiancja spada o χ²(24) = 107.2, p < .001, a rozproszenie – do 0.93. Nadmierna dyspersja jest więc tu sygnałem: punkty naprawdę się różnią. Regresja Poissona przy nadmiernie rozproszonych danych wprowadza w błąd, dlatego porównuje się ją z modelem nadmiernie rozproszonym i ujemnym dwumianowym (Gardner i in., 1995). Model ujemny dwumianowy i quasi-Poisson dają często podobne wyniki, ale ważą małe i duże zliczenia inaczej (Ver Hoef i Boveng, 2007). Pełną procedurę z rootogramem i modelami z nadmiarem zer pokazuje wpis regresja dla zliczeń krok po kroku.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: wykres lejkowy – surowo i po korekcie o rodzaj usług
Wykres lejkowy zastępuje ranking: oś pozioma to wielkość punktu, pionowa – wskaźnik, a granice 95% i 99.8% pokazują, gdzie może trafić punkt o przeciętnym ryzyku tylko przez przypadek (Spiegelhalter, 2005a). Dla zliczeń granice liczymy z rozkładu Poissona. Panel B robi korektę o rodzaj usług: z modelu ujemnego dwumianowego bez punktu liczymy, ile skarg punkt powinien mieć przy swoim udziale zleceń delikatnych (E), i porównujemy z obserwowaną liczbą (O). Iloraz O/E działa jak SMR w epidemiologii: 1.40 znaczy „o 40% więcej skarg, niż wynika z tego, co punkt pierze”.
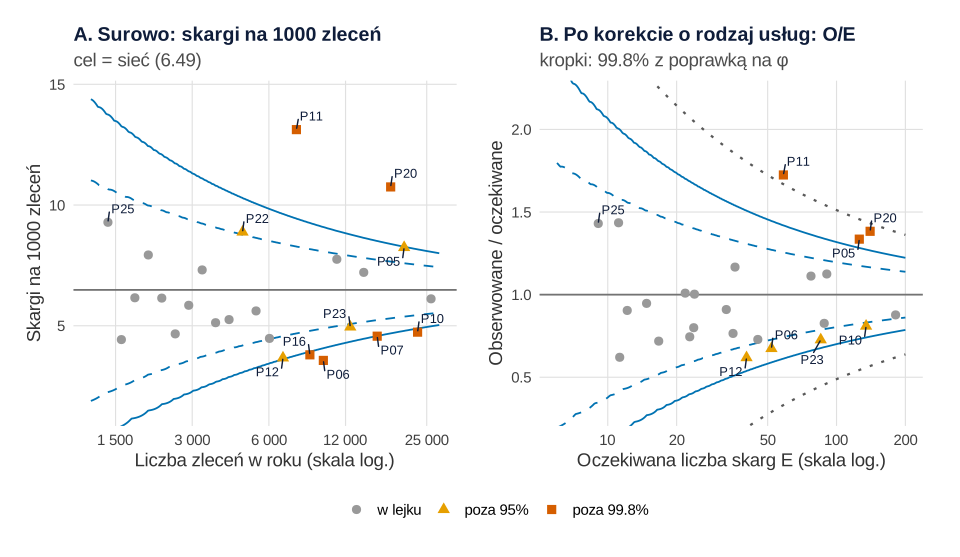
Co widać. P25, trzeci w rankingu, leży w lejku na obu panelach (O/E = 1.43 przy zaledwie kilku oczekiwanych skargach). Surowo poza granice 95% wychodzi aż 10 z 25 punktów, choć przy samym przypadku spodziewalibyśmy się około jednego. Cztery z nich (P07, P10, P16, P06) leżą pod lejkiem – to duże punkty z prostymi usługami (10–18% zleceń delikatnych). Po korekcie o rodzaj usług P07 i P16 wracają do lejka, podobnie P22, który był wysoko, bo ma 40% zleceń delikatnych. Ponad granicą 99.8% zostają P11 (O/E = 1.72), P20 (1.38) i P05 (1.34). Ten ostatni nie był ustawiony ręcznie jako gorszy, ale wylosował się z częstością o 36% wyższą od typowej – lejek go słusznie wskazuje.
Jak może zmylić. Granice zakładają, że po korekcie wszystkie punkty mają to samo ryzyko. Tu tak nie jest: nadrozproszenie wyników z wynosi φ = 4.47, a po przycięciu 10% skrajnych wyników z z każdej strony (żeby same podejrzane punkty go nie zawyżały) – 2.74. Granice poszerzone o √φ (kropkowane) zostawiają powyżej 99.8% tylko P11; P05 i P20 przekraczają poszerzoną granicę 95%. Wybór sposobu radzenia sobie z nadrozproszeniem zmienia to, które instytucje zostaną oznaczone (Spiegelhalter, 2005b) – ustal go przed obejrzeniem wyników. Przy 25 porównaniach pamiętaj też o problemie wielokrotnych porównań.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: kwartał po kwartale – kto się „poprawił”?
Załóżmy, że po kwartale I pięć punktów z góry listy dostało szkolenie. W danych nic się nie zmieniło – prawdziwe częstości są stałe przez cały rok. Co pokażą kolejne kwartały?
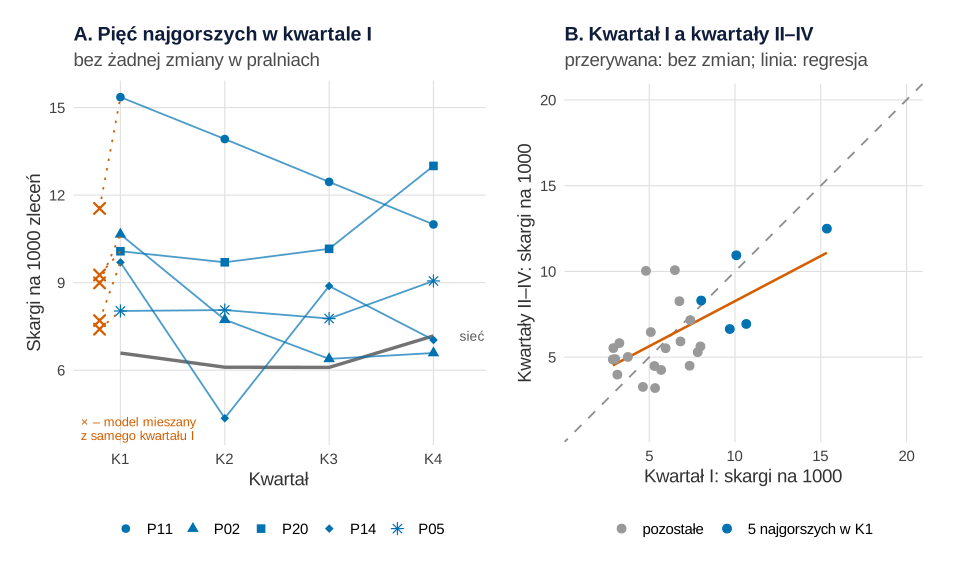
Co widać. Pięć najgorszych punktów miało w kwartale I średnio 10.76 skargi na 1000 zleceń, a w kwartałach II–IV – 9.06; ich prawdziwa średnia to 8.37. Spadek wystąpił w trzech z pięciu punktów. Najbardziej „poprawił się” P02: z 10.66 do 6.94, iloraz 0.65, 95% CI [0.40, 1.07], p = .069 – kierownik dostałby pochwałę za szkolenie, które nic nie zmieniło. To regresja do średniej: wybieramy punkty po wyniku, który przypadek zawyżył (Barnett i in., 2005). W panelu B korelacja kwartału I z resztą roku wynosi tylko r = .64, więc linia jest bardziej płaska niż przekątna.
Jak może zmylić. Nie wszystko wraca do średniej sieci: P11 i P20, naprawdę gorsze, zostają wysoko. Wynik wraca do prawdziwego poziomu punktu. Ten poziom lepiej niż surowy wynik przewiduje uogólniony model mieszany z losowym efektem punktu, dopasowany do samego kwartału I: średnio 8.98 dla piątki (krzyżyki), bardzo blisko późniejszych 9.06. Ten sam mechanizm przy kampaniach reklamowych pokazuje wpis kampania miesiąca i regresja do średniej.
Zdanie do Metody:
Rysunek 5: karta „jak czytać wykres lejkowy”
Karta jest do pokazania na zebraniu kierowników. Cztery punkty są poglądowe – położone tak, by leżały w opisanych strefach.
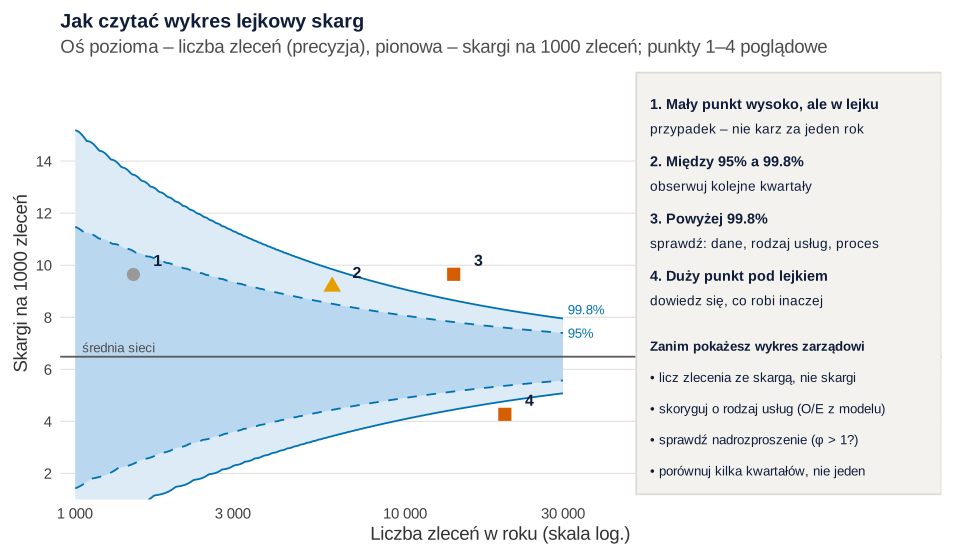
Co widać. Lejek zwęża się z wielkością punktu, bo większy punkt to precyzyjniejsza częstość. Wysoko nie znaczy źle, nisko nie znaczy dobrze – liczy się położenie względem granic. Wykres lejkowy działa jak karta kontrolna Shewharta, tylko na osi poziomej jest wielkość, a nie czas (Spiegelhalter, 2005a).
Jak może zmylić. Karta mówi, co sprawdzić, nie kogo ukarać. Strefa „powyżej 99.8%” to sygnał do sprawdzenia danych i rodzaju usług, a dopiero potem procesu.
Co z tym zrobić w firmie
- Zastąp ranking wykresem lejkowym. Tabela z miejscami nagradza i karze małe punkty za przypadek (P25 na trzecim miejscu, rysunek 1).
- Licz częstość, nie liczbę skarg, i koryguj o to, co punkt pierze. Model z offsetem i O/E wyrównują szanse punktów z sukniami wieczorowymi i punktów z koszulami (rysunek 3B).
- Interweniuj tam, gdzie sygnał się powtarza. P11 jest poza lejkiem w całym roku i nawet po poprawce na nadrozproszenie. Tam zacznij od rozmowy i przeglądu procesu (rysunek 3).
- Ucz się od punktów pod lejkiem po korekcie (P10, P23, P06, P12) – zapytaj, co robią przy przyjęciu zlecenia.
- Ocenę „poprawy” planuj przed szkoleniem. Porównuj z przewidywaniem modelu mieszanego albo z punktami bez szkolenia, nie z kwartałem, w którym wynik był najgorszy (rysunek 4). Do bieżącego śledzenia jednego punktu w czasie przyda się wpis o anomaliach w KPI i karcie kontrolnej.
- Zdefiniuj skargę raz dla całej sieci. Jedna klientka, siedem skarg na jedną suknię, to jedno zlecenie ze skargą (pułapki niżej).
Jak opisać w pracy
Opisz jednostkę analizy, miarę (zlecenia ze skargą, nie skargi), ekspozycję, model i sposób oceny nadmiernej dyspersji, sposób korekty o rodzaj usług, granice lejka i postępowanie z nadrozproszeniem. Więcej o analizach w pracach z zarządzania: statystyka w pracy z zarządzania i ekonomii.
Kod R: dane, modele, wykres lejkowy i kwartały
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 2 – model m_nb, przepis 3 – funkcję granica_pois(), z których korzystają dalsze przepisy. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1 i ma własne set.seed(705); przepisy 2–6 nie losują (etykiety pakietu ggrepel w przepisie 3 rozmieszcza stałe seed = 1). Ziarno ustalono raz i nie zmieniano go. Ręcznie ustalono (przepis 1): wielkości punktów od 1400 do 26 000 zleceń rocznie, podział zleceń na kwartały (22, 28, 24 i 26%), udział zleceń delikatnych 8–45%, częstość 4.0 i 11.0 skarg na 1000 zleceń, rozrzut punktów 0.20 i kwartałów 0.10, mnożnik 1.9 dla dwóch punktów gorszych, średnio 0.15 skargi powtórnej na zlecenie ze skargą i jedno zlecenie z sześcioma dodatkowymi skargami w małym punkcie. Po pierwszym uruchomieniu nie zmieniano parametrów danych. Zmieniono sposób liczenia i prezentacji: w przepisie 3 dodano winsoryzację wyników z przy szacowaniu φ, bo bez niej (φ = 4.47) granice poszerzone nie wskazywały żadnego punktu – na stronie podajemy oba warianty; w przepisie 4 do naiwnego testu „poprawy” wybrano punkt z największym spadkiem wśród pięciu najgorszych (P02) zamiast pierwszego z listy (P11: iloraz 0.81, p = .400) – celowo, bo tak właśnie wybiera się „sukcesy”; w przepisie 1 dodano przeliczenie rankingu na wszystkie skargi; poprawiono też etykiety i układ rysunków 1, 3, 4 i 5. Kolory żółty i pomarańczowy są przy deuteranopii słabo rozróżnialne (przepis 6), dlatego strefy lejka różnią się też kształtem punktu. Wszystkie przepisy liczą się w kilka sekund.
1. Dane i ranking surowy: Rysunek 1
R
# Rysunek 1. Fikcyjna sieć pralni chemicznych: 25 punktów, 4 kwartały, skargi na 1000 zleceń
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie
k_punktow   <- 25
wielkosc    <- round(exp(seq(log(1400), log(26000), length.out = k_punktow)))  # zleceń rocznie
kwartaly    <- c(0.22, 0.28, 0.24, 0.26)  # udział zleceń w kwartałach I–IV (wiosną płaszcze i kurtki)
stopa_std   <- 4.0 / 1000                 # zlecenia ze skargą: odzież zwykła
stopa_del   <- 11.0 / 1000                # tkaniny delikatne, skóry, suknie wieczorowe
sd_punktu   <- 0.20                       # prawdziwe różnice punktów (log skali)
sd_kwartalu <- 0.10                       # wahania punkt × kwartał (log skali)
mnoznik_gorszych <- 1.9                   # dwa punkty naprawdę gorsze
powtorne    <- 0.15                       # średnia liczba dodatkowych skarg do jednego zlecenia

set.seed(705)
punkty <- data.frame(punkt = sprintf("P%02d", 1:k_punktow),
                     zlecenia_rok = sample(wielkosc),                 # wielkości rozdane losowo
                     udzial_delik = round(runif(k_punktow, 0.08, 0.45), 2),
                     efekt = exp(rnorm(k_punktow, 0, sd_punktu)))
gorsze <- punkty$punkt[order(-punkty$zlecenia_rok)][c(4, 11)]       # 4. i 11. co do wielkości
punkty$efekt[punkty$punkt %in% gorsze] <- punkty$efekt[punkty$punkt %in% gorsze] * mnoznik_gorszych
punkty$stopa_prawdziwa <- 1000 * punkty$efekt *
  ((1 - punkty$udzial_delik) * stopa_std + punkty$udzial_delik * stopa_del)

dane <- expand.grid(usluga = c("zwykła", "delikatna"), kwartal = paste0("K", 1:4), punkt = punkty$punkt,
                    stringsAsFactors = FALSE)[, 3:1]
i <- match(dane$punkt, punkty$punkt)
udz <- ifelse(dane$usluga == "delikatna", punkty$udzial_delik[i], 1 - punkty$udzial_delik[i])
dane$zlecenia <- round(punkty$zlecenia_rok[i] * kwartaly[as.integer(substr(dane$kwartal, 2, 2))] * udz)
szum_pk <- exp(rnorm(k_punktow * 4, 0, sd_kwartalu))                   # jeden szum na punkt × kwartał
dane$mu <- dane$zlecenia * punkty$efekt[i] * ifelse(dane$usluga == "delikatna", stopa_del, stopa_std) *
  szum_pk[(i - 1) * 4 + as.integer(substr(dane$kwartal, 2, 2))]
dane$zlecenia_ze_skarga <- rpois(nrow(dane), dane$mu)
dane$skargi_wszystkie <- dane$zlecenia_ze_skarga + rpois(nrow(dane), powtorne * dane$zlecenia_ze_skarga)
# Jedno zlecenie (suknia wieczorowa) w małym punkcie: klientka składa 6 skarg więcej w kwartale III
maly <- punkty$punkt[order(punkty$zlecenia_rok)][3]
j <- which(dane$punkt == maly & dane$kwartal == "K3" & dane$usluga == "delikatna")
dane$skargi_wszystkie[j] <- dane$skargi_wszystkie[j] + 6
dane$mu <- NULL
write.csv(dane, "skargi-pralnie-25-punktow-kwartaly.csv", row.names = FALSE)

# Cała sieć
N <- sum(dane$zlecenia); O <- sum(dane$zlecenia_ze_skarga)
ci_siec <- poisson.test(O, N)$conf.int * 1000
cat("Zleceń:", N, "| zleceń ze skargą:", O, "| wszystkich skarg:", sum(dane$skargi_wszystkie), "\n")
cat("Sieć: ", round(1000 * O / N, 2), "na 1000 zleceń, 95% CI [", round(ci_siec[1], 2), ",",
    round(ci_siec[2], 2), "]\n")
for (u in c("zwykła", "delikatna")) {
  d <- dane[dane$usluga == u, ]
  cat("  usługa", u, ":", sum(d$zlecenia_ze_skarga), "/", sum(d$zlecenia), "=",
      round(1000 * sum(d$zlecenia_ze_skarga) / sum(d$zlecenia), 2), "na 1000\n")
}

# Ranking surowy: rok, punkt po punkcie, z dokładnym 95% CI Poissona
rok <- aggregate(cbind(zlecenia, zlecenia_ze_skarga, skargi_wszystkie) ~ punkt, data = dane, FUN = sum)
rok <- merge(rok, punkty[c("punkt", "udzial_delik", "stopa_prawdziwa")])
rok$na1000 <- 1000 * rok$zlecenia_ze_skarga / rok$zlecenia
ci <- t(sapply(seq_len(nrow(rok)), function(r) poisson.test(rok$zlecenia_ze_skarga[r], rok$zlecenia[r])$conf.int))
rok$dolna <- 1000 * ci[, 1]; rok$gorna <- 1000 * ci[, 2]
rok <- rok[order(-rok$na1000), ]
rok$miejsce <- seq_len(nrow(rok))
pokaz <- function(d) print(data.frame(miejsce = d$miejsce, punkt = d$punkt, zlecen = d$zlecenia,
  skarg = d$zlecenia_ze_skarga, na1000 = round(d$na1000, 2), CI = sprintf("[%.2f, %.2f]", d$dolna, d$gorna),
  delik = d$udzial_delik, prawda = round(d$stopa_prawdziwa, 2)), row.names = FALSE)
cat("\nPierwsze pięć miejsc (najwięcej skarg) i ostatnie trzy:\n"); pokaz(rok[c(1:5, 23:25), ])
cat("\nNaprawdę gorsze punkty (ustawione ręcznie):", gorsze, "| miejsca w rankingu:",
    rok$miejsce[match(gorsze, rok$punkt)], "\n")
cat("Najmniejszy i największy punkt:", range(rok$zlecenia), "zleceń rocznie\n")
cat("Rozstęp prawdziwych stóp:", round(range(rok$stopa_prawdziwa), 2), "na 1000\n")

# Pułapka: liczenie wszystkich skarg zamiast zleceń ze skargą (powtórne skargi do jednego zlecenia)
rok$wszystkie_na1000 <- 1000 * rok$skargi_wszystkie / rok$zlecenia
rok$miejsce_wszystkie <- rank(-rok$wszystkie_na1000, ties.method = "min")
cat("\nPunkt", maly, ": zleceń ze skargą", rok$zlecenia_ze_skarga[rok$punkt == maly], "| wszystkich skarg",
    rok$skargi_wszystkie[rok$punkt == maly], "| miejsce:", rok$miejsce[rok$punkt == maly], "->",
    rok$miejsce_wszystkie[rok$punkt == maly], "(",
    round(rok$na1000[rok$punkt == maly], 2), "->", round(rok$wszystkie_na1000[rok$punkt == maly], 2), "na 1000 )\n")

rok$etykieta <- sprintf("%s (n = %s)", rok$punkt, trimws(format(rok$zlecenia, big.mark = " ")))
rok$etykieta <- factor(rok$etykieta, levels = rev(rok$etykieta))
p1 <- ggplot(rok, aes(y = etykieta)) +
  geom_vline(xintercept = 1000 * O / N, colour = "grey55") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.3, orientation = "y", colour = kol[["niebieski"]],
                linewidth = 0.6) +
  geom_point(aes(x = na1000, shape = "obserwowane (95% CI)"), colour = kol[["niebieski"]], size = 2.4) +
  geom_point(aes(x = stopa_prawdziwa, shape = "prawdziwe (znane tylko w symulacji)"),
             colour = kol[["pomaranczowy"]], size = 2.2, stroke = 1.1) +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  labs(title = "Ranking 25 punktów: zlecenia ze skargą na 1000 zleceń",
       subtitle = "Rok, od najgorszego; n – liczba zleceń; pionowa linia – cała sieć", x = "Skargi na 1000 zleceń", y = NULL) +
  motyw + theme(axis.text.y = element_text(size = rel(0.85)))
p1                       # do pliku: ggsave("skargi-ranking-surowy.svg", p1, width = 10, height = 7.4)
Wynik w R
Zleceń: 216028 | zleceń ze skargą: 1401 | wszystkich skarg: 1624
Sieć:  6.49 na 1000 zleceń, 95% CI [ 6.15 , 6.83 ]
  usługa zwykła : 709 / 161187 = 4.4 na 1000
  usługa delikatna : 692 / 54841 = 12.62 na 1000

Pierwsze pięć miejsc (najwięcej skarg) i ostatnie trzy:
 miejsce punkt zlecen skarg na1000             CI delik prawda
       1   P11   7696   101  13.12 [10.69, 15.95]  0.40  12.21
       2   P20  18046   194  10.75  [9.29, 12.37]  0.42   9.73
       3   P25   1400    13   9.29  [4.94, 15.88]  0.26   6.14
       4   P22   4729    42   8.88  [6.40, 12.01]  0.40   7.56
       5   P05  20382   168   8.24   [7.04, 9.59]  0.22   7.51
      23   P16   8693    33   3.80   [2.61, 5.33]  0.10   4.90
      24   P12   6815    25   3.67   [2.37, 5.42]  0.19   3.88
      25   P06   9818    35   3.56   [2.48, 4.96]  0.11   4.36

Naprawdę gorsze punkty (ustawione ręcznie): P20 P11 | miejsca w rankingu: 2 1
Najmniejszy i największy punkt: 1400 26000 zleceń rocznie
Rozstęp prawdziwych stóp: 3.88 12.21 na 1000

Punkt P09 : zleceń ze skargą 11 | wszystkich skarg 19 | miejsce: 10 -> 4 ( 6.16 -> 10.64 na 1000 )
2. Poisson z offsetem i ujemna dwumianowa: Rysunek 2
R
# Rysunek 2. Regresja Poissona z offsetem i regresja ujemna dwumianowa
# (korzysta z kol, motyw i obiektu dane z przepisu 1 – bez nowego losowania)
library(ggplot2)
library(MASS)
fp <- function(p) ifelse(p < .001, "< .001", paste("=", sub("^0", "", sprintf("%.3f", p))))   # zapis p jak w APA

dane$usluga  <- factor(dane$usluga, levels = c("zwykła", "delikatna"))
dane$kwartal <- factor(dane$kwartal)
dane$punkt   <- factor(dane$punkt)

# 1. Poisson z offsetem: częstość skarg zależy od rodzaju usługi i kwartału, ekspozycja = liczba zleceń
m_pois <- glm(zlecenia_ze_skarga ~ usluga + kwartal + offset(log(zlecenia)), family = poisson, data = dane)
phi <- sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois)
cat("Poisson: współczynnik rozproszenia (Pearson chi2 / df) =", round(phi, 2), "\n")

# 2. Czy punkty różnią się bardziej niż przypadek? Test ilorazu wiarygodności dla czynnika punkt
m_pois_p <- update(m_pois, . ~ . + punkt)
lr <- anova(m_pois, m_pois_p, test = "Chisq")
cat("Dodanie punktu: chi2(", lr$Df[2], ") =", round(lr$Deviance[2], 1), ", p", fp(lr$`Pr(>Chi)`[2]), "\n")
cat("Rozproszenie po dodaniu punktu:", round(sum(residuals(m_pois_p, type = "pearson")^2) /
                                            df.residual(m_pois_p), 2), "\n")

# 3. Ujemna dwumianowa: ta sama część systematyczna, wariancja = mu + mu^2 / theta
m_nb <- glm.nb(zlecenia_ze_skarga ~ usluga + kwartal + offset(log(zlecenia)), data = dane)
cat("Ujemna dwumianowa: theta =", round(m_nb$theta, 1), "(SE", round(m_nb$SE.theta, 1), ")\n")
cat("AIC Poisson =", round(AIC(m_pois), 1), "| AIC ujemna dwumianowa =", round(AIC(m_nb), 1), "\n")

irr <- function(m, nazwa) {
  b <- coef(m)[-1]; se <- sqrt(diag(vcov(m)))[-1]
  data.frame(model = nazwa, czlon = names(b), IRR = exp(b), dolna = exp(b - 1.96 * se),
             gorna = exp(b + 1.96 * se), p = 2 * pnorm(-abs(b / se)))
}
tab <- rbind(irr(m_pois, "Poisson"), irr(m_nb, "ujemna dwumianowa"))
print(data.frame(tab[1:2], round(tab[3:5], 3), p = fp(tab$p)), row.names = FALSE)
cat("Stopa bazowa (zwykła, K1) na 1000 zleceń: Poisson", round(1000 * exp(coef(m_pois)[1]), 2),
    "| NB", round(1000 * exp(coef(m_nb)[1]), 2), "\n")

tab$czlon <- factor(tab$czlon, levels = rev(c("uslugadelikatna", "kwartalK2", "kwartalK3", "kwartalK4")),
                    labels = rev(c("usługa delikatna\n(vs zwykła)", "kwartał II (vs I)", "kwartał III (vs I)",
                                   "kwartał IV (vs I)")))
p2 <- ggplot(tab, aes(IRR, czlon, colour = model, shape = model)) +
  geom_vline(xintercept = 1, colour = "grey55") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", linewidth = 0.8,
                position = position_dodge(width = 0.55)) +
  geom_point(size = 3, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(1, 16), name = NULL) +
  scale_x_log10(breaks = c(0.7, 1, 1.5, 2, 3, 4)) +
  labs(title = "Iloraz częstości skarg (IRR) z 95% CI",
       subtitle = sprintf("Poisson zakłada wariancję = średniej; tu rozproszenie %.2f", phi),
       x = "IRR (skala logarytmiczna)", y = NULL) + motyw
p2                       # do pliku: ggsave("skargi-poisson-a-ujemna-dwumianowa.svg", p2, width = 10, height = 4.8)
Wynik w R
Poisson: współczynnik rozproszenia (Pearson chi2 / df) = 1.35
Dodanie punktu: chi2( 24 ) = 107.2 , p < .001
Rozproszenie po dodaniu punktu: 0.93
Ujemna dwumianowa: theta = 20.9 (SE 8.1 )
AIC Poisson = 925.2 | AIC ujemna dwumianowa = 914.5
             model           czlon   IRR dolna gorna      p
           Poisson uslugadelikatna 2.869 2.583 3.185 < .001
           Poisson       kwartalK2 0.926 0.797 1.077 = .319
           Poisson       kwartalK3 0.925 0.791 1.082 = .331
           Poisson       kwartalK4 1.089 0.940 1.263 = .256
 ujemna dwumianowa uslugadelikatna 2.816 2.473 3.207 < .001
 ujemna dwumianowa       kwartalK2 0.915 0.760 1.103 = .352
 ujemna dwumianowa       kwartalK3 0.923 0.763 1.117 = .412
 ujemna dwumianowa       kwartalK4 1.110 0.925 1.333 = .262
Stopa bazowa (zwykła, K1) na 1000 zleceń: Poisson 4.47 | NB 4.47
3. Wykres lejkowy surowy i O/E: Rysunek 3
R
# Rysunek 3. Wykres lejkowy: surowy odsetek skarg i wskaźnik skorygowany o rodzaj usług (O/E)
# (korzysta z kol, motyw, dane, rok z przepisu 1 i m_nb z przepisu 2 – bez nowego losowania)
library(ggplot2)
suppressPackageStartupMessages(library(patchwork))   # patchwork zasłania MASS::area – bez znaczenia tutaj
library(ggrepel)

# Granice lejka dla zliczeń Poissona o średniej lambda (z interpolacją, żeby nie były schodkami)
granica_pois <- function(p, lambda) {
  y <- qpois(p, lambda)
  y - (ppois(y, lambda) - p) / dpois(y, lambda)
}
poziomy <- c(0.001, 0.025, 0.975, 0.999)

# A. Surowo: zlecenia ze skargą / zlecenia, cel = odsetek w całej sieci
theta <- sum(dane$zlecenia_ze_skarga) / sum(dane$zlecenia)
siatka <- data.frame(n = exp(seq(log(1200), log(28000), length.out = 300)))
for (p in poziomy) siatka[[paste0("g", p)]] <- 1000 * granica_pois(p, theta * siatka$n) / siatka$n

# B. Skorygowane: oczekiwana liczba skarg z modelu ujemnego dwumianowego bez punktu
#    (rodzaj usługi + kwartał, offset = log liczby zleceń), zsumowana dla punktu
dane$oczekiwane <- predict(m_nb, newdata = dane, type = "response")
oe <- aggregate(cbind(O = zlecenia_ze_skarga, E = oczekiwane) ~ punkt, data = dane, FUN = sum)
rok <- merge(rok, oe)
rok$OE <- rok$O / rok$E
strefa <- function(x, dol95, gor95, dol998, gor998)
  factor(ifelse(x > gor998 | x < dol998, "poza 99.8%", ifelse(x > gor95 | x < dol95, "poza 95%", "w lejku")),
         levels = c("w lejku", "poza 95%", "poza 99.8%"))
rok$strefa_surowa <- strefa(rok$na1000, 1000 * granica_pois(0.025, theta * rok$zlecenia) / rok$zlecenia,
                            1000 * granica_pois(0.975, theta * rok$zlecenia) / rok$zlecenia,
                            1000 * granica_pois(0.001, theta * rok$zlecenia) / rok$zlecenia,
                            1000 * granica_pois(0.999, theta * rok$zlecenia) / rok$zlecenia)
rok$strefa_OE <- strefa(rok$OE, granica_pois(0.025, rok$E) / rok$E, granica_pois(0.975, rok$E) / rok$E,
                        granica_pois(0.001, rok$E) / rok$E, granica_pois(0.999, rok$E) / rok$E)
siatkaE <- data.frame(E = exp(seq(log(6), log(200), length.out = 300)))
for (p in poziomy) siatkaE[[paste0("g", p)]] <- granica_pois(p, siatkaE$E) / siatkaE$E

# Nadrozproszenie: phi = średni kwadrat wyniku z; granice poszerzone o pierwiastek z phi.
# Żeby same odstające punkty nie rozdmuchały phi, 10% najniższych i 10% najwyższych z przycinamy
# do 10. i 90. centyla (winsoryzacja); dla porównania phi bez przycięcia.
rok$z <- (rok$O - rok$E) / sqrt(rok$E)
q <- quantile(rok$z, c(0.10, 0.90))
phi_bez <- sum(rok$z^2) / nrow(rok)
phi_l <- sum(pmin(pmax(rok$z, q[1]), q[2])^2) / nrow(rok)
siatkaE$phi_gor <- 1 + qnorm(0.999) * sqrt(phi_l / siatkaE$E)
siatkaE$phi_dol <- 1 - qnorm(0.999) * sqrt(phi_l / siatkaE$E)
rok$poza_phi998 <- abs(rok$z) > qnorm(0.999) * sqrt(phi_l)
rok$poza_phi95 <- abs(rok$z) > qnorm(0.975) * sqrt(phi_l)

wypisz <- function(kol_strefy) {
  d <- rok[rok[[kol_strefy]] != "w lejku", ]
  d <- d[order(-d$OE), ]
  print(data.frame(punkt = d$punkt, zlecen = d$zlecenia, O = d$O, E = round(d$E, 1), na1000 = round(d$na1000, 2),
                   OE = round(d$OE, 2), strefa = as.character(d[[kol_strefy]]), delik = d$udzial_delik), row.names = FALSE)
}
cat("Cel sieci:", round(1000 * theta, 2), "na 1000\nA. Surowo – punkty poza lejkiem 95%:\n"); wypisz("strefa_surowa")
cat("\nB. Skorygowane O/E – punkty poza lejkiem 95%:\n"); wypisz("strefa_OE")
cat("\nPunkt z 3. miejsca rankingu:", rok$punkt[rok$miejsce == 3], "| O/E =", round(rok$OE[rok$miejsce == 3], 2),
    "| strefa O/E:", as.character(rok$strefa_OE[rok$miejsce == 3]), "\n")
cat("Nadrozproszenie: phi bez przycięcia =", round(phi_bez, 2), "| phi po winsoryzacji =", round(phi_l, 2), "\n")
cat("Poza poszerzonymi granicami 99.8%:", paste(rok$punkt[rok$poza_phi998], collapse = ", "),
    "| poza poszerzonymi 95%:", paste(rok$punkt[rok$poza_phi95], collapse = ", "), "\n")
cat("Oczekiwana liczba punktów poza 95% przy samym przypadku: 25 × 0.05 =", 25 * 0.05, "\n")

ksztalty <- c("w lejku" = 16, "poza 95%" = 17, "poza 99.8%" = 15)
kolory <- c("w lejku" = kol[["szary"]], "poza 95%" = kol[["zolty"]], "poza 99.8%" = kol[["pomaranczowy"]])
linie <- function(s, x) list(
  geom_line(data = s, aes(.data[[x]], .data[["g0.025"]]), linetype = "dashed", colour = kol[["niebieski"]]),
  geom_line(data = s, aes(.data[[x]], .data[["g0.975"]]), linetype = "dashed", colour = kol[["niebieski"]]),
  geom_line(data = s, aes(.data[[x]], .data[["g0.001"]]), colour = kol[["niebieski"]]),
  geom_line(data = s, aes(.data[[x]], .data[["g0.999"]]), colour = kol[["niebieski"]]))
etyk <- function(d, kol_strefy) d[d[[kol_strefy]] != "w lejku" | d$miejsce == 3, ]
pA <- ggplot() + linie(siatka, "n") +
  geom_hline(yintercept = 1000 * theta, colour = "grey45") +
  geom_point(data = rok, aes(zlecenia, na1000, shape = strefa_surowa, colour = strefa_surowa), size = 2.8) +
  geom_text_repel(data = etyk(rok, "strefa_surowa"), aes(zlecenia, na1000, label = punkt), size = 3.4,
                  colour = "#0f1d3a", seed = 1, min.segment.length = 0.2, box.padding = 0.4) +
  scale_x_log10(breaks = c(1500, 3000, 6000, 12000, 25000), labels = function(x) format(x, big.mark = " ")) +
  scale_shape_manual(values = ksztalty, name = NULL, drop = FALSE) +
  scale_colour_manual(values = kolory, name = NULL, drop = FALSE) +
  coord_cartesian(ylim = c(1.5, 14.5)) +
  labs(title = "A. Surowo: skargi na 1000 zleceń", subtitle = sprintf("cel = sieć (%.2f)", 1000 * theta),
       x = "Liczba zleceń w roku (skala log.)", y = "Skargi na 1000 zleceń") + motyw
pB <- ggplot() + linie(siatkaE, "E") +
  geom_line(data = siatkaE, aes(E, phi_gor), linetype = "dotted", colour = "grey35", linewidth = 0.8) +
  geom_line(data = siatkaE, aes(E, phi_dol), linetype = "dotted", colour = "grey35", linewidth = 0.8) +
  geom_hline(yintercept = 1, colour = "grey45") +
  geom_point(data = rok, aes(E, OE, shape = strefa_OE, colour = strefa_OE), size = 2.8) +
  geom_text_repel(data = etyk(rok, "strefa_OE"), aes(E, OE, label = punkt), size = 3.4, colour = "#0f1d3a",
                  seed = 1, min.segment.length = 0.2, box.padding = 0.4) +
  scale_x_log10(breaks = c(10, 20, 50, 100, 200)) +
  scale_shape_manual(values = ksztalty, name = NULL, drop = FALSE) +
  scale_colour_manual(values = kolory, name = NULL, drop = FALSE) +
  coord_cartesian(ylim = c(0.3, 2.2)) +
  labs(title = "B. Po korekcie o rodzaj usług: O/E", subtitle = "kropki: 99.8% z poprawką na φ",
       x = "Oczekiwana liczba skarg E (skala log.)", y = "Obserwowane / oczekiwane") + motyw
p3 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p3                       # do pliku: ggsave("skargi-wykres-lejkowy.svg", p3, width = 10, height = 5.8)
Wynik w R
Cel sieci: 6.49 na 1000
A. Surowo – punkty poza lejkiem 95%:
 punkt zlecen   O     E na1000   OE     strefa delik
   P11   7696 101  58.6  13.12 1.72 poza 99.8%  0.40
   P20  18046 194 140.2  10.75 1.38 poza 99.8%  0.42
   P05  20382 168 125.8   8.24 1.34   poza 95%  0.22
   P22   4729  42  36.0   8.88 1.17   poza 95%  0.40
   P07  15977  73  88.3   4.57 0.83 poza 99.8%  0.14
   P10  23019 109 134.7   4.74 0.81 poza 99.8%  0.18
   P16   8693  33  45.3   3.80 0.73 poza 99.8%  0.10
   P23  12526  62  85.3   4.95 0.73   poza 95%  0.30
   P06   9818  35  51.9   3.56 0.67 poza 99.8%  0.11
   P12   6815  25  40.4   3.67 0.62   poza 95%  0.19

B. Skorygowane O/E – punkty poza lejkiem 95%:
 punkt zlecen   O     E na1000   OE     strefa delik
   P11   7696 101  58.6  13.12 1.72 poza 99.8%  0.40
   P20  18046 194 140.2  10.75 1.38 poza 99.8%  0.42
   P05  20382 168 125.8   8.24 1.34 poza 99.8%  0.22
   P10  23019 109 134.7   4.74 0.81   poza 95%  0.18
   P23  12526  62  85.3   4.95 0.73   poza 95%  0.30
   P06   9818  35  51.9   3.56 0.67   poza 95%  0.11
   P12   6815  25  40.4   3.67 0.62   poza 95%  0.19

Punkt z 3. miejsca rankingu: P25 | O/E = 1.43 | strefa O/E: w lejku
Nadrozproszenie: phi bez przycięcia = 4.47 | phi po winsoryzacji = 2.74
Poza poszerzonymi granicami 99.8%: P11 | poza poszerzonymi 95%: P05, P11, P20
Oczekiwana liczba punktów poza 95% przy samym przypadku: 25 × 0.05 = 1.25
4. Kwartały i regresja do średniej: Rysunek 4
R
# Rysunek 4. Kwartały: czy najgorsze punkty z kwartału I się poprawiły? Regresja do średniej
# (korzysta z kol, motyw, dane, punkty z przepisów 1–2 – bez nowego losowania; prawdziwe stopy są stałe w roku)
library(ggplot2)
suppressPackageStartupMessages(library(patchwork))
suppressPackageStartupMessages(library(lme4))

kw <- aggregate(cbind(zlecenia, zlecenia_ze_skarga) ~ punkt + kwartal, data = dane, FUN = sum)
kw$na1000 <- 1000 * kw$zlecenia_ze_skarga / kw$zlecenia
k1 <- kw[kw$kwartal == "K1", ]
reszta <- aggregate(cbind(zlecenia, zlecenia_ze_skarga) ~ punkt, data = kw[kw$kwartal != "K1", ], FUN = sum)
porown <- merge(data.frame(punkt = k1$punkt, zlec_K1 = k1$zlecenia, O_K1 = k1$zlecenia_ze_skarga, K1 = k1$na1000),
                data.frame(punkt = reszta$punkt, zlec_K24 = reszta$zlecenia, O_K24 = reszta$zlecenia_ze_skarga,
                           K2_4 = 1000 * reszta$zlecenia_ze_skarga / reszta$zlecenia))
porown <- merge(porown, punkty[c("punkt", "stopa_prawdziwa")])

# Model mieszany na samym kwartale I: losowy efekt punktu ściąga wynik małych punktów do średniej
d1 <- dane[dane$kwartal == "K1", ]
m_mix <- glmer(zlecenia_ze_skarga ~ usluga + offset(log(zlecenia)) + (1 | punkt), family = poisson, data = d1)
d1$przew <- predict(m_mix, type = "response")
przew <- aggregate(cbind(przew, zlecenia) ~ punkt, data = d1, FUN = sum)
porown$model_K1 <- 1000 * przew$przew[match(porown$punkt, przew$punkt)] /
  przew$zlecenia[match(porown$punkt, przew$punkt)]
cat("SD losowego efektu punktu (log skali) w kwartale I:", round(sqrt(VarCorr(m_mix)$punkt[1]), 3), "\n")

top <- porown[order(-porown$K1), ][1:5, ]
print(data.frame(punkt = as.character(top$punkt), zlecen_K1 = top$zlec_K1, skarg_K1 = top$O_K1, K1 = round(top$K1, 2),
                 model_K1 = round(top$model_K1, 2), K2_4 = round(top$K2_4, 2),
                 prawda = round(top$stopa_prawdziwa, 2)), row.names = FALSE)
cat("Średnio 5 najgorszych z kwartału I: K1 =", round(mean(top$K1), 2), "| model mieszany z K1 =",
    round(mean(top$model_K1), 2), "| K2–K4 =", round(mean(top$K2_4), 2), "| prawda =",
    round(mean(top$stopa_prawdziwa), 2), "\n")
cat("Spadek w K2–K4:", sum(top$K2_4 < top$K1), "z 5 punktów\n")

# „Czy punkt się poprawił?” – naiwne porównanie K1 z K2–K4 dokładnym testem Poissona
# dla punktu z największym spadkiem wśród pięciu najgorszych
p1o <- top[which.min(top$K2_4 / top$K1), ]
t_pop <- poisson.test(c(p1o$O_K24, p1o$O_K1), c(p1o$zlec_K24, p1o$zlec_K1))
cat(sprintf("Punkt %s: iloraz częstości K2–K4 / K1 = %.2f, 95%% CI [%.2f, %.2f], p = %s\n", p1o$punkt,
            t_pop$estimate, t_pop$conf.int[1], t_pop$conf.int[2], sub("^0", "", sprintf("%.3f", t_pop$p.value))))
cat("Korelacja K1 z K2–K4 (25 punktów): r =", sub("^0", "", sprintf("%.2f", cor(porown$K1, porown$K2_4))), "\n")

# A. Ścieżki pięciu „najgorszych” z kwartału I
sc <- kw[kw$punkt %in% top$punkt, ]
sc$punkt <- factor(sc$punkt, levels = top$punkt)
siec_kw <- aggregate(cbind(zlecenia, zlecenia_ze_skarga) ~ kwartal, data = kw, FUN = sum)
siec_kw$na1000 <- 1000 * siec_kw$zlecenia_ze_skarga / siec_kw$zlecenia
pA <- ggplot(sc, aes(kwartal, na1000, group = punkt)) +
  geom_line(data = siec_kw, aes(group = 1), colour = "grey45", linewidth = 1.2) +
  annotate("text", x = 4.25, y = siec_kw$na1000[4], label = "sieć", hjust = 0, colour = "grey35", size = 3.6) +
  geom_line(colour = kol[["niebieski"]], alpha = 0.7) +
  geom_point(aes(shape = punkt), colour = kol[["niebieski"]], size = 2.6) +
  geom_segment(data = top, aes(x = 0.8, xend = 1, y = model_K1, yend = K1, group = punkt), colour = kol[["pomaranczowy"]],
               linetype = "dotted") +
  geom_point(data = top, aes(x = 0.8, y = model_K1, group = punkt), shape = 4, colour = kol[["pomaranczowy"]],
             size = 3, stroke = 1.2) +
  annotate("text", x = 0.62, y = 4, label = "× – model mieszany\nz samego kwartału I", hjust = 0, size = 3.4,
           colour = kol[["pomaranczowy"]], lineheight = 0.9) +
  scale_shape_manual(values = c(16, 17, 15, 18, 8), name = NULL) +
  scale_x_discrete(expand = expansion(add = c(0.45, 0.5))) +
  labs(title = "A. Pięć najgorszych w kwartale I", subtitle = "bez żadnej zmiany w pralniach",
       x = "Kwartał", y = "Skargi na 1000 zleceń") + motyw + guides(shape = guide_legend(nrow = 1))
pB <- ggplot(porown, aes(K1, K2_4)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey55", linetype = "dashed") +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["pomaranczowy"]], linewidth = 0.9) +
  geom_point(aes(colour = punkt %in% top$punkt), size = 2.6) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]]), labels = c("pozostałe", "5 najgorszych w K1"),
                      name = NULL) +
  coord_equal(xlim = c(1, 20), ylim = c(1, 20)) +
  labs(title = "B. Kwartał I a kwartały II–IV", subtitle = "przerywana: bez zmian; linia: regresja",
       x = "Kwartał I: skargi na 1000", y = "Kwartały II–IV: skargi na 1000") + motyw
p4 <- pA + pB + plot_layout(widths = c(1.15, 1))
p4                       # do pliku: ggsave("skargi-kwartaly-regresja-do-sredniej.svg", p4, width = 10, height = 6)
Wynik w R
SD losowego efektu punktu (log skali) w kwartale I: 0.271
 punkt zlecen_K1 skarg_K1    K1 model_K1  K2_4 prawda
   P11      1693       26 15.36    11.54 12.49  12.21
   P02      2440       26 10.66     8.99  6.94   6.52
   P20      3970       40 10.08     9.26 10.94   9.73
   P14       722        7  9.70     7.70  6.64   5.86
   P05      4484       36  8.03     7.40  8.30   7.51
Średnio 5 najgorszych z kwartału I: K1 = 10.76 | model mieszany z K1 = 8.98 | K2–K4 = 9.06 | prawda = 8.37
Spadek w K2–K4: 3 z 5 punktów
Punkt P02: iloraz częstości K2–K4 / K1 = 0.65, 95% CI [0.40, 1.07], p = .069
Korelacja K1 z K2–K4 (25 punktów): r = .64
5. Karta „jak czytać wykres lejkowy”: Rysunek 5
R
# Rysunek 5. Karta „jak czytać wykres lejkowy” – grafika (punkty poglądowe, nie dane)
# (korzysta z kol, motyw z przepisu 1 i funkcji granica_pois, theta z przepisu 3)
library(ggplot2)

s <- data.frame(n = exp(seq(log(1000), log(30000), length.out = 300)))
for (p in c(0.001, 0.025, 0.975, 0.999)) s[[paste0("g", p)]] <- 1000 * granica_pois(p, theta * s$n) / s$n
gr <- function(p, n) 1000 * granica_pois(p, theta * n) / n
# Cztery punkty poglądowe: położenie wyliczone z granic, żeby leżały w opisanych strefach
pkt <- data.frame(n = c(1500, 6000, 14000, 20000), nr = c("1", "2", "3", "4"))
pkt$y <- c(gr(0.975, 1500) - 0.9, (gr(0.975, 6000) + gr(0.999, 6000)) / 2, gr(0.999, 14000) + 1.0,
           gr(0.001, 20000) - 0.5)
pkt$strefa <- c("w lejku", "poza 95%", "poza 99.8%", "poza 99.8%")
opisy <- data.frame(
  y = c(16.2, 14.0, 11.8, 9.6),
  tytul = c("1. Mały punkt wysoko, ale w lejku", "2. Między 95% a 99.8%", "3. Powyżej 99.8%",
            "4. Duży punkt pod lejkiem"),
  tekst = c("przypadek – nie karz za jeden rok", "obserwuj kolejne kwartały",
            "sprawdź: dane, rodzaj usług, proces", "dowiedz się, co robi inaczej"))
reguly <- data.frame(y = c(6.9, 5.7, 4.5, 3.3, 2.1), tekst = c(
  "Zanim pokażesz wykres zarządowi",
  "• licz zlecenia ze skargą, nie skargi",
  "• skoryguj o rodzaj usług (O/E z modelu)",
  "• sprawdź nadrozproszenie (φ > 1?)",
  "• porównuj kilka kwartałów, nie jeden"))
p5 <- ggplot() +
  geom_ribbon(data = s, aes(n, ymin = g0.001, ymax = g0.999), fill = "#dcebf6") +
  geom_ribbon(data = s, aes(n, ymin = g0.025, ymax = g0.975), fill = "#b9d7ee") +
  geom_line(data = s, aes(n, g0.025), linetype = "dashed", colour = kol[["niebieski"]]) +
  geom_line(data = s, aes(n, g0.975), linetype = "dashed", colour = kol[["niebieski"]]) +
  geom_line(data = s, aes(n, g0.001), colour = kol[["niebieski"]]) +
  geom_line(data = s, aes(n, g0.999), colour = kol[["niebieski"]]) +
  geom_hline(yintercept = 1000 * theta, colour = "grey35") +
  annotate("text", x = 1050, y = 1000 * theta + 0.35, label = "średnia sieci", hjust = 0, size = 3.5, colour = "grey30") +
  annotate("text", x = 31000, y = gr(0.975, 30000), label = "95%", hjust = 0, size = 3.5, colour = kol[["niebieski"]]) +
  annotate("text", x = 31000, y = gr(0.999, 30000) + 0.35, label = "99.8%", hjust = 0, size = 3.5,
           colour = kol[["niebieski"]]) +
  geom_point(data = pkt, aes(n, y, shape = strefa, colour = strefa), size = 4.2) +
  geom_text(data = pkt, aes(n, y, label = nr), nudge_x = 0.075, nudge_y = 0.55, size = 4.2, fontface = "bold",
            colour = "#0f1d3a") +
  scale_shape_manual(values = c("w lejku" = 16, "poza 95%" = 17, "poza 99.8%" = 15), guide = "none") +
  scale_colour_manual(values = c("w lejku" = kol[["szary"]], "poza 95%" = kol[["zolty"]],
                                 "poza 99.8%" = kol[["pomaranczowy"]]), guide = "none") +
  annotate("rect", xmin = 50000, xmax = 420000, ymin = 1.2, ymax = 17.4, fill = "#f4f2ee", colour = "#dedbd4") +
  geom_text(data = opisy, aes(x = 55000, y = y, label = tytul), hjust = 0, size = 3.8, fontface = "bold",
            colour = "#0f1d3a") +
  geom_text(data = opisy, aes(x = 55000, y = y - 0.95, label = tekst), hjust = 0, size = 3.6, colour = "#0f1d3a") +
  geom_text(data = reguly, aes(x = 55000, y = y, label = tekst), hjust = 0, size = 3.5, colour = "#0f1d3a",
            fontface = c("bold", rep("plain", 4))) +
  scale_x_log10(breaks = c(1000, 3000, 10000, 30000), labels = c("1 000", "3 000", "10 000", "30 000")) +
  scale_y_continuous(breaks = seq(2, 14, 2)) +
  coord_cartesian(xlim = c(900, 420000), ylim = c(1, 17.6), expand = FALSE) +
  labs(title = "Jak czytać wykres lejkowy skarg",
       subtitle = "Oś pozioma – liczba zleceń (precyzja), pionowa – skargi na 1000 zleceń; punkty 1–4 poglądowe",
       x = "Liczba zleceń w roku (skala log.)", y = "Skargi na 1000 zleceń") +
  motyw + theme(panel.grid.major.x = element_blank())
p5                       # do pliku: ggsave("skargi-karta-jak-czytac-lejek.svg", p5, width = 10, height = 5.8)
6. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "szary – żółty" = c("#999999", "#E69F00"),
             "szary – pomarańczowy" = c("#999999", "#D55E00"), "żółty – pomarańczowy" = c("#E69F00", "#D55E00"),
             "niebieski – szary" = c("#0072B2", "#999999"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
szary – żółty                               76.8         73.9       70.0
szary – pomarańczowy                        77.2         62.9       56.0
żółty – pomarańczowy                        33.4         18.4       24.9
niebieski – szary                           44.9         48.9       40.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, regresję Poissona (glm), dokładne przedziały i test Poissona (poisson.test) wykonano pakietem stats (z podstawowej instalacji R), regresję ujemną dwumianową – pakietem MASS, model mieszany – pakietem lme4. Rysunki wykonano w pakiecie ggplot2, etykiety rozmieszczono pakietem ggrepel, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Skargi powtórne. W małym punkcie P09 jedna klientka złożyła siedem skarg do jednej sukni. Liczone wszystkie skargi przesuwają P09 z 10. na 4. miejsce (z 6.16 na 10.64 na 1000); liczone zlecenia ze skargą – nie.
- Różna skłonność klientów do skarg. Klient sukni wieczorowej skarży się łatwiej niż klient koszuli. Bez korekty o rodzaj usług lejek wskazuje „najlepsze” punkty, które po prostu piorą prostsze rzeczy (P07 i P16 na rysunku 3A).
- Jeden kwartał to za mało. Kwartalny wynik małego punktu opiera się na kilku skargach – P14 miał w kwartale I siedem skarg na 722 zlecenia.
- Nadrozproszenie bez decyzji. Zwykłe granice oznaczają 10 z 25 punktów; wybór poprawki ustal z góry (rysunek 3).
- Korekta, która ukrywa problem. Koryguj o to, czego punkt nie wybiera (rodzaj zleceń), nie o to, za co odpowiada (np. czas realizacji). Podobny problem przy ocenach opinii klientów opisuje wpis o ocenach gwiazdkowych i rankingu produktów.
Skargi to jeden sygnał jakości. Jak mierzyć oczekiwania i oceny klientów, pokazuje wpis o SERVQUAL, a jak wyłapywać pojedyncze nietypowe zdarzenia zamiast punktów – wpis o wykrywaniu nietypowych transakcji.
Najczęstsze pytania
Jak policzyć liczbę skarg na 1000 zamówień?
Podziel liczbę zamówień (zleceń) ze skargą przez liczbę wszystkich zamówień i pomnóż przez 1000. Licz zamówienia ze skargą, a nie wszystkie skargi, bo jeden klient może złożyć kilka. Do wyniku dodaj przedział ufności, np. dokładny z rozkładu Poissona (poisson.test w R): w przykładzie sieci pralni 1401 skarg na 216 028 zleceń daje 6.49 na 1000, 95% CI [6.15, 6.83].
Po co offset w regresji Poissona dla skarg?
Punkty mają różną liczbę zleceń, więc więcej skarg w dużym punkcie nie znaczy gorszej jakości. Offset, czyli logarytm liczby zleceń ze współczynnikiem ustalonym na 1, sprawia, że model opisuje częstość skarg na zlecenie, a exp(b) to iloraz częstości (IRR). W R: glm(skargi ~ usluga + offset(log(zlecenia)), family = poisson).
Kiedy zamiast regresji Poissona użyć ujemnej dwumianowej?
Gdy wariancja zliczeń jest większa od średniej – współczynnik rozproszenia (suma kwadratów reszt Pearsona przez stopnie swobody) wyraźnie powyżej 1. W przykładzie wynosił 1.35, a po dodaniu punktu do modelu spadał do 0.93: nadmierna dyspersja wynikała z różnic między punktami. Ujemna dwumianowa dała podobny IRR (2.82 wobec 2.87) z szerszym przedziałem.
Jak czytać wykres lejkowy dla oddziałów firmy?
Oś pozioma to wielkość oddziału (liczba zleceń albo oczekiwana liczba skarg), pionowa – wskaźnik. Granice 95% i 99.8% pokazują, gdzie może trafić oddział o przeciętnym ryzyku tylko przez przypadek, i zwężają się z wielkością. Oddział w lejku nie różni się wyraźnie od średniej, nawet jeśli jest wysoko w rankingu; poza granicą 99.8% – warto sprawdzić dane, rodzaj usług i proces.
Dlaczego najgorszy oddział w kwartale poprawia się w następnym?
Często to regresja do średniej: na górę listy trafiają oddziały, którym przypadek dodał skarg, więc w kolejnym kwartale wypadają lepiej bez żadnej zmiany. W przykładzie pięć najgorszych punktów miało w kwartale I średnio 10.76 skargi na 1000 zleceń, a w kolejnych 9.06, choć prawdziwe częstości się nie zmieniły. Poprawę oceniaj względem przewidywania modelu mieszanego albo grupy porównawczej.
Powiązane hasła
Przeczytaj też
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikKampania miesiąca i regresja do średniej
Sieć szkół jazdy i 60 kampanii: wykres lejkowy, spadek zwycięzcy w następnym miesiącu, ściąganie w modelu mieszanym i symulacja – z kodem R.
Czytaj →PoradnikWykrywanie nietypowych transakcji
Karty podarunkowe, 10 sprawdzeń dziennie: Mahalanobis klasyczny i odporny, LOF, las losowy, maskowanie i nowy wzorzec nadużyć – z kodem R.
Czytaj →Porównujesz oddziały, sklepy albo punkty usługowe w pracy?
Pomożemy dobrać model dla zliczeń, przygotować wykres lejkowy z korektą o ryzyko i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Frome, E. L. (1983). The analysis of rates using Poisson regression models. Biometrics, 39(3), 665–674. https://doi.org/10.2307/2531094
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
- Spiegelhalter, D. J. (2005). Funnel plots for comparing institutional performance. Statistics in Medicine, 24(8), 1185–1202. https://doi.org/10.1002/sim.1970
- Spiegelhalter, D. J. (2005). Handling over-dispersion of performance indicators. Quality and Safety in Health Care, 14(5), 347–351. https://doi.org/10.1136/qshc.2005.013755 ● Otwarty dostęp
- Ver Hoef, J. M., & Boveng, P. L. (2007). Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data? Ecology, 88(11), 2766–2772. https://doi.org/10.1890/07-0043.1
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{frome1983analysis, author={Frome, Edward L.}, title={{The analysis of rates using Poisson regression models}}, journal={Biometrics}, year={1983}, volume={39}, number={3}, pages={665--674}, doi={10.2307/2531094}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}@article{spiegelhalter2005funnel, author={Spiegelhalter, David J.}, title={{Funnel plots for comparing institutional performance}}, journal={Statistics in Medicine}, year={2005}, volume={24}, number={8}, pages={1185--1202}, doi={10.1002/sim.1970}}@article{spiegelhalter2005handling, author={Spiegelhalter, D. J.}, title={{Handling over-dispersion of performance indicators}}, journal={Quality and Safety in Health Care}, year={2005}, volume={14}, number={5}, pages={347--351}, doi={10.1136/qshc.2005.013755}}@article{verhoef2007quasi, author={Ver Hoef, Jay M. and Boveng, Peter L.}, title={{Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data?}}, journal={Ecology}, year={2007}, volume={88}, number={11}, pages={2766--2772}, doi={10.1890/07-0043.1}}