Co to jest SMR?
Standaryzowany współczynnik umieralności (ang. standardized mortality ratio, SMR) to iloraz liczby zgonów zaobserwowanych w badanej grupie do liczby zgonów oczekiwanych, gdyby ta grupa umierała tak jak populacja odniesienia w tych samych grupach wieku (zwykle też płci). To wynik standaryzacji względem wieku metodą pośrednią. Tak samo z nowych zachorowań liczy się standaryzowany współczynnik zachorowalności (SIR), oparty na zapadalności.
SMR = O / E, E = Σ osobolatai · stopa referencyjnai
SMR = 1 oznacza umieralność taką jak w populacji odniesienia, SMR = 1.3 – o 30% wyższą, a SMR = 0.8 – o 20% niższą.
Przykład
W symulowanej kohorcie pracowników (22 500 osobolat w trzech grupach wieku) zaobserwowano 133 zgony. Przy stopach z populacji ogólnej należałoby oczekiwać 103.5 zgonu, więc SMR = 1.285, 95% CI [1.076, 1.523]. Umieralność w kohorcie była więc o około 29% wyższa niż w populacji ogólnej o tej samej strukturze wieku, a przedział nie obejmuje 1. Liczbę zgonów traktuje się jako zmienną z rozkładu Poissona; Ulm (1990) pokazał, że dokładne granice przedziału można policzyć wprost z kwantyli rozkładu chi-kwadrat.
Na rysunku
Panel A pokazuje kohortę z przykładu, rozbitą na grupy wieku. W panelu B dodano pięć fikcyjnych zakładów. Ich parametry (wielkość i prawdziwy SMR od 0.85 do 1.3) ustawiono ręcznie, a struktura wieku jest wszędzie taka sama jak w kohorcie. Ziarna nie zmieniano.
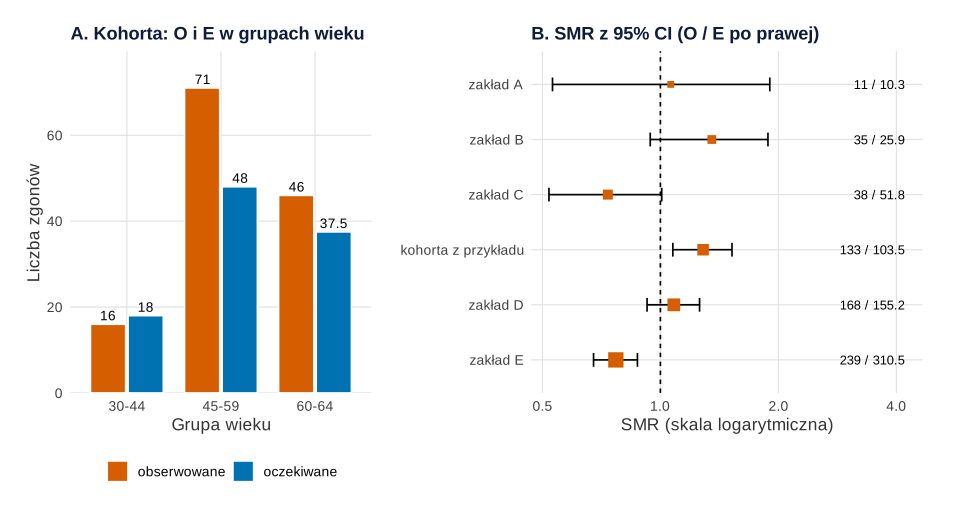
set.seed(529)).Co widać. SMR kohorty, 1.29, jest sumą trzech różnych obrazów. W grupie 30–44 lat zgonów było mniej niż oczekiwanych (16 wobec 18, O/E = 0.89), a nadwyżka pochodzi głównie z grupy 45–59 lat (71 wobec 48, O/E = 1.48). Panel B pokazuje, że szerokość przedziału zależy od liczby oczekiwanych zgonów. W zakładzie A (10.3 oczekiwanych) przedział sięga od 0.53 do 1.90, a w zakładzie E (310.5 oczekiwanych) – od 0.68 do 0.87. Zakład C ma podobny SMR jak zakład E (0.73 wobec 0.77), ale jego przedział dotyka 1, [0.52, 1.01].
Na co uważać. Kolejność jednostek w panelu B to nie ranking. W tej symulacji struktura wieku jest wszędzie taka sama. W prawdziwych danych SMR różnych jednostek mają różne mianowniki, więc ich porównywanie bywa obciążone (Julious i in., 2001). Do porównań między jednostkami lepsza jest standaryzacja bezpośrednia. Wykres nie pokazuje też, skąd wzięły się stopy referencyjne – podaj to w podpisie.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Zgony obserwowane i oczekiwane w grupach wieku (A) oraz SMR z 95% CI w kilku zakładach (B)
library(ggplot2)
library(patchwork)

kol <- c(obserwowane = "#D55E00", oczekiwane = "#0072B2")   # Okabe–Ito, czytelne przy deuteranopii
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))
smr_ci <- function(O, E) c(SMR = O / E, dolna = qchisq(0.025, 2 * O) / (2 * E),
                           gorna = qchisq(0.975, 2 * (O + 1)) / (2 * E))   # dokładny przedział Poissona

set.seed(529)                                   # ziarno z przykładu w haśle
wiek <- c("30-44", "45-59", "60-64")
osobolata <- c(12000, 8000, 2500)
stopa_ref <- c(1.5, 6.0, 15.0) / 1000
zgony <- rpois(3, osobolata * stopa_ref * 1.25)  # kohorta z przykładu (pierwsze losowanie po ziarnie)
oczek <- osobolata * stopa_ref
print(data.frame(wiek, zgony, oczekiwane = oczek, O_do_E = round(zgony / oczek, 2)))

# Pięć innych zakładów – parametry ustawione ręcznie: ta sama struktura wieku, różna wielkość
# (mnożnik osobolat) i różny prawdziwy SMR
zaklady <- data.frame(zaklad = c("A", "B", "C", "D", "E"), mnoznik = c(0.1, 0.25, 0.5, 1.5, 3),
                      smr_prawdziwy = c(1.0, 1.3, 0.9, 1.1, 0.85))
wyn <- t(sapply(seq_len(nrow(zaklady)), function(i) {
  E <- sum(osobolata * zaklady$mnoznik[i] * stopa_ref)
  O <- sum(rpois(3, osobolata * zaklady$mnoznik[i] * stopa_ref * zaklady$smr_prawdziwy[i]))
  c(O = O, E = E, smr_ci(O, E))
}))
tab <- rbind(data.frame(zaklad = "kohorta z przykładu", t(c(O = sum(zgony), E = sum(oczek), smr_ci(sum(zgony), sum(oczek))))),
             data.frame(zaklad = paste("zakład", zaklady$zaklad), wyn))
tab$zaklad <- factor(tab$zaklad, rev(tab$zaklad[order(tab$E)]))
print(transform(tab, E = round(E, 1), SMR = round(SMR, 2), dolna = round(dolna, 2), gorna = round(gorna, 2)),
      row.names = FALSE)

# A: słupki obserwowanych i oczekiwanych zgonów w grupach wieku
dA <- rbind(data.frame(wiek, typ = "obserwowane", liczba = zgony),
            data.frame(wiek, typ = "oczekiwane", liczba = oczek))
pA <- ggplot(dA, aes(wiek, liczba, fill = typ)) +
  geom_col(position = position_dodge(0.8), width = 0.75, colour = "white") +
  geom_text(aes(label = liczba), position = position_dodge(0.8), vjust = -0.4, size = 3.6) +
  scale_fill_manual(NULL, values = kol) +
  scale_y_continuous("Liczba zgonów", expand = expansion(mult = c(0, 0.12))) +
  labs(x = "Grupa wieku", title = "A. Kohorta: O i E w grupach wieku")

# B: SMR z 95% CI na skali logarytmicznej, od najmniejszego E do największego
pB <- ggplot(tab, aes(SMR, zaklad)) +
  geom_vline(xintercept = 1, linetype = "22") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y") +
  geom_point(aes(size = E), shape = 15, colour = kol[["obserwowane"]]) +
  geom_text(aes(x = 4.2, label = sprintf("%d / %.1f", as.integer(O), E)), hjust = 1, size = 3.4) +
  scale_x_log10("SMR (skala logarytmiczna)", breaks = c(0.25, 0.5, 1, 2, 4)) +
  scale_size(range = c(2, 5), guide = "none") +
  labs(y = NULL, title = "B. SMR z 95% CI (O / E po prawej)")
p1 <- (pA | pB) + plot_layout(widths = c(1, 1.3)) & motyw
p1
Wynik w R
   wiek zgony oczekiwane O_do_E
1 30-44    16       18.0   0.89
2 45-59    71       48.0   1.48
3 60-64    46       37.5   1.23
              zaklad   O     E  SMR dolna gorna
 kohorta z przykładu 133 103.5 1.29  1.08  1.52
            zakład A  11  10.3 1.06  0.53  1.90
            zakład B  35  25.9 1.35  0.94  1.88
            zakład C  38  51.8 0.73  0.52  1.01
            zakład D 168 155.2 1.08  0.92  1.26
            zakład E 239 310.5 0.77  0.68  0.87
Jak opisać w pracy
Na co uważać
- Porównywanie SMR różnych grup. Oczekiwane zgony liczy się na strukturze wieku każdej grupy, więc SMR dwóch regionów mają różne mianowniki. Julious i in. (2001) pokazali na danych z okręgów Sheffield, że takie porównania są obciążone, i zalecają SMR tylko wtedy, gdy brakuje stóp w podgrupach wieku. W pozostałych sytuacjach lepsza jest standaryzacja bezpośrednia.
- Populacja odniesienia nie jest neutralna. Pracownicy są zdrowsi od ogółu ludności, co zaniża SMR w kohortach zawodowych – to efekt zdrowego pracownika.
- Standaryzacja nie usuwa wszystkiego. Kontroluje tylko wiek i płeć; inne zmienne zakłócające pozostają.
Przykład z hospitalizacjami w powiatach omawia wpis Statystyka w pracy ze zdrowia publicznego.
SMR w R
Kod liczy oczekiwane zgony jako sumę iloczynów osobolat i stóp referencyjnych w grupach wieku, a potem SMR z dokładnym przedziałem ufności z kwantyli rozkładu chi-kwadrat. poisson.test() daje ten sam przedział i wartość p dla hipotezy SMR = 1. Liczby w tekście pochodzą z tego kodu.
Obserwowane i oczekiwane zgony, SMR i 95% CI
R
set.seed(529)                                   # kohorta pracowników, trzy grupy wieku
wiek  <- c("30-44", "45-59", "60-64")
osobolata <- c(12000, 8000, 2500)               # osobolata obserwacji w kohorcie
stopa_ref <- c(1.5, 6.0, 15.0) / 1000           # stopy zgonów w populacji odniesienia (na osobolato)
zgony <- rpois(3, osobolata * stopa_ref * 1.25) # obserwowane zgony w kohorcie
O <- sum(zgony); E <- sum(osobolata * stopa_ref) # obserwowane i oczekiwane
smr <- O / E
ci <- c(qchisq(0.025, 2 * O), qchisq(0.975, 2 * (O + 1))) / (2 * E)  # dokładny przedział (chi-kwadrat/Poisson)
print(data.frame(wiek, osobolata, zgony, oczekiwane = osobolata * stopa_ref))
round(c(O = O, E = E, SMR = smr, dolna = ci[1], gorna = ci[2],
        p = poisson.test(O, E)$p.value), 3)
Wynik w R
   wiek osobolata zgony oczekiwane
1 30-44     12000    16       18.0
2 45-59      8000    71       48.0
3 60-64      2500    46       37.5
      O       E     SMR   dolna   gorna       p
133.000 103.500   1.285   1.076   1.523   0.005
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak interpretować SMR mniejszy od 1?
W grupie zmarło mniej osób, niż wynikałoby ze stóp populacji odniesienia: SMR = 0.85 oznacza o 15% mniej zgonów. W kohortach zawodowych bywa to skutkiem efektu zdrowego pracownika, a nie ochronnego działania pracy.
Czym SMR różni się od standaryzacji bezpośredniej?
W metodzie bezpośredniej stopy badanej grupy przenosi się na wspólną populację standardową. W pośredniej (SMR) stopy standardu przenosi się na badaną grupę, więc wystarczy łączna liczba zgonów i osobolata w grupach wieku.
Jak policzyć przedział ufności dla SMR?
Traktuj liczbę zgonów O jako zmienną Poissona: dolna granica to kwantyl 0.025 rozkładu chi-kwadrat z 2O stopniami swobody podzielony przez 2E, a górna – kwantyl 0.975 z 2O + 2 stopniami podzielony przez 2E (Ulm, 1990). W R ten sam przedział daje poisson.test(O, E).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Julious, S. A., Nicholl, J., & George, S. (2001). Why do we continue to use standardized mortality ratios for small area comparisons? Journal of Public Health Medicine, 23(1), 40–46. https://doi.org/10.1093/pubmed/23.1.40
- Ulm, K. (1990). A simple method to calculate the confidence interval of a standardized mortality ratio (SMR). American Journal of Epidemiology, 131(2), 373–375. https://doi.org/10.1093/oxfordjournals.aje.a115507
Cytowania BibTeX
@article{julious2001why, author={Julious, S. A. and Nicholl, J. and George, S.}, title={{Why do we continue to use standardized mortality ratios for small area comparisons?}}, journal={Journal of Public Health Medicine}, year={2001}, volume={23}, number={1}, pages={40--46}, doi={10.1093/pubmed/23.1.40}}@article{ulm1990simple, author={Ulm, K.}, title={{A simple method to calculate the confidence interval of a standardized mortality ratio (SMR)}}, journal={American Journal of Epidemiology}, year={1990}, volume={131}, number={2}, pages={373--375}, doi={10.1093/oxfordjournals.aje.a115507}}