Co to jest efekt zdrowego pracownika?
Efekt zdrowego pracownika (ang. healthy worker effect, HWE) to niższa umieralność lub zachorowalność osób pracujących w porównaniu z populacją ogólną, wynikająca z tego, że do pracy trafiają i w niej pozostają osoby zdrowsze. Chowdhury i in. (2017) opisują go jako szczególną postać błędu selekcji, typową dla kohort zawodowych i znaną od 1885 roku. Przez niego szkodliwe narażenie zawodowe może wyglądać na obojętne, a nawet ochronne.
Skąd się bierze
Li i Sung (1999) wskazują dwa główne źródła: niezatrudnianie osób chorych i badanie wyłącznie osób aktualnie pracujących, bo chorzy częściej odchodzą z pracy. Autorzy proponują traktować ten mechanizm raczej jako źródło zakłócenia niż błąd selekcji, ponieważ stan zdrowia wpływa zarówno na zatrudnienie, jak i na wynik – działa jak zmienna zakłócająca. Odchodzenie chorych z pracy przypomina błąd przeżywalności. Efekt nie jest stały: różni się według wieku, płci, rasy i rodzaju pracy oraz zmienia się w czasie (Chowdhury i in., 2017).
Przykład
W symulacji z R narażenie zwiększało umieralność pracowników o 30%. Porównanie z populacją ogólną dało jednak dla narażonych SMR = 0.99, 95% CI [0.92, 1.06], a dla całej kohorty 0.85, bo do zakładu przyjmowano głównie osoby zdrowe. Porównanie wewnętrzne narażonych z nienarażonymi pracownikami dało iloraz stóp 1.37, 95% CI [1.22, 1.53], bliski prawdziwemu 1.3.
Na rysunku
Przykład wyżej miał narażenie, które szkodzi. Na rysunku jest wariant skrajny: narażenie nie zmienia ryzyka zgonu wcale, a jedyną różnicą między pracownikami a populacją jest selekcja do pracy według zdrowia. Symulacja obejmuje 50 000 dorosłych i 10 lat obserwacji. Siłę selekcji i wpływ zdrowia na umieralność ustawiono ręcznie; ziarna nie zmieniano. Wszyscy są w jednej grupie wieku, więc rysunek pomija standaryzację.
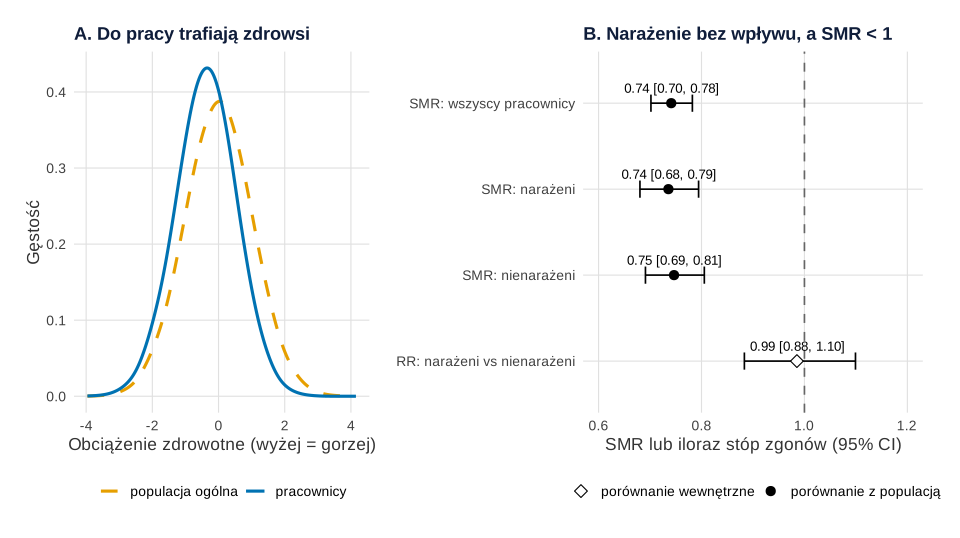
set.seed(532)).Co widać. Pracuje 59.7% dorosłych, ale nie losowo: średnie obciążenie zdrowotne pracowników wynosi −0.38 SD, a w populacji 0.00 (panel A). Skutek widać w panelu B. Wszystkie trzy SMR leżą wyraźnie poniżej 1 – także dla narażonych (0.74, 95% CI [0.68, 0.79]), choć narażenie z założenia nie ma żadnego wpływu. Porównanie wewnętrzne narażonych z nienarażonymi daje iloraz stóp 0.99, 95% CI [0.88, 1.10], czyli prawidłowo – brak efektu.
Na co uważać. SMR = 0.74 nie znaczy, że praca chroni przed zgonem; to różnica składu grup, nie skutek pracy. Przy szkodliwym narażeniu ten sam mechanizm ciągnie SMR w dół i może ukryć nadumieralność, jak w przykładzie wyżej (SMR = 0.99 przy prawdziwym wzroście ryzyka o 30%). Porównanie wewnętrzne działa tu dlatego, że narażenie przydzielono losowo wśród pracowników. Jeśli do pracy w narażeniu też trafiają zdrowsi, i ono będzie obciążone – zdrowie działa wtedy jak zmienna zakłócająca.
Podpis do pracy:
Kod rysunku jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Obciążenie zdrowotne w populacji i wśród pracowników (A) oraz SMR i porównanie wewnętrzne (B)
library(ggplot2)
library(patchwork)

kol <- c("populacja ogólna" = "#E69F00", "pracownicy" = "#0072B2")   # Okabe–Ito
lin <- c("populacja ogólna" = "dashed", "pracownicy" = "solid")      # rodzaj linii dubluje kolor
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))
smr_ci <- function(o, e) c(est = o / e, dolna = qchisq(0.025, 2 * o) / (2 * e),
                           gorna = qchisq(0.975, 2 * (o + 1)) / (2 * e))   # dokładny przedział Poissona

set.seed(532)
N <- 50000                                       # dorośli w populacji ogólnej
obciazenie <- rnorm(N)                           # ukryte obciążenie zdrowotne (wyżej = gorzej)
stopa <- 0.005 * exp(0.6 * obciazenie)           # roczna stopa zgonów – zależy tylko od zdrowia
pracuje <- rbinom(N, 1, plogis(0.5 - 1.2 * obciazenie)) == 1   # zdrowsi częściej zatrudnieni
narazony <- pracuje & rbinom(N, 1, 0.5) == 1     # połowa pracowników narażona – losowo
zgony <- rpois(N, 10 * stopa)                    # 10 lat obserwacji; narażenie NIE zmienia ryzyka
osobolata <- rep(10, N)
stopa_ref <- sum(zgony) / sum(osobolata)         # stopa populacji ogólnej (wszyscy dorośli)

grupy <- list("wszyscy pracownicy" = pracuje, "narażeni" = narazony, "nienarażeni" = pracuje & !narazony)
wyn <- t(sapply(grupy, function(g) c(O = sum(zgony[g]), E = sum(osobolata[g]) * stopa_ref,
                                     smr_ci(sum(zgony[g]), sum(osobolata[g]) * stopa_ref))))
we <- poisson.test(c(sum(zgony[narazony]), sum(zgony[pracuje & !narazony])),
                   c(sum(osobolata[narazony]), sum(osobolata[pracuje & !narazony])))
tab <- data.frame(miara = c(paste("SMR:", names(grupy)), "RR: narażeni vs nienarażeni"),
                  rbind(wyn[, c("est", "dolna", "gorna")],
                        c(we$estimate, we$conf.int)), row.names = NULL)
print(round(c(odsetek_pracujacych = mean(pracuje), obciazenie_populacja = mean(obciazenie),
              obciazenie_pracownicy = mean(obciazenie[pracuje])), 3))
print(transform(tab, est = round(est, 2), dolna = round(dolna, 2), gorna = round(gorna, 2)))

# A: rozkład obciążenia zdrowotnego w populacji ogólnej i wśród zatrudnionych
dA <- rbind(data.frame(grupa = "populacja ogólna", obciazenie),
            data.frame(grupa = "pracownicy", obciazenie = obciazenie[pracuje]))
pA <- ggplot(dA, aes(obciazenie, colour = grupa, linetype = grupa)) +
  geom_density(linewidth = 1.1, bw = 0.25, key_glyph = "path") +
  scale_colour_manual(NULL, values = kol) +
  scale_linetype_manual(NULL, values = lin) +
  labs(x = "Obciążenie zdrowotne (wyżej = gorzej)", y = "Gęstość",
       title = "A. Do pracy trafiają zdrowsi")

# B: SMR względem populacji ogólnej i iloraz stóp wewnątrz zakładu; linia 1 = brak różnicy
tab$miara <- factor(tab$miara, rev(tab$miara))
tab$typ <- ifelse(grepl("^SMR", tab$miara), "porównanie z populacją", "porównanie wewnętrzne")
pB <- ggplot(tab, aes(est, miara, shape = typ)) +
  geom_vline(xintercept = 1, linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y") +
  geom_point(size = 3.2, fill = "white") +
  geom_text(aes(label = sprintf("%.2f [%.2f, %.2f]", est, dolna, gorna)), vjust = -1.1, size = 3.5) +
  scale_shape_manual(NULL, values = c("porównanie z populacją" = 16, "porównanie wewnętrzne" = 23)) +
  scale_x_continuous(limits = c(0.6, 1.2)) +
  labs(x = "SMR lub iloraz stóp zgonów (95% CI)", y = NULL,
       title = "B. Narażenie bez wpływu, a SMR < 1")
p1 <- (pA | pB) + plot_layout(widths = c(1, 1.15)) & motyw
p1
Wynik w R
  odsetek_pracujacych  obciazenie_populacja obciazenie_pracownicy
                0.597                 0.003                -0.379
                        miara  est dolna gorna
1     SMR: wszyscy pracownicy 0.74  0.70  0.78
2               SMR: narażeni 0.74  0.68  0.79
3            SMR: nienarażeni 0.75  0.69  0.81
4 RR: narażeni vs nienarażeni 0.99  0.88  1.10
Jak ograniczyć efekt
- Wewnętrzna grupa kontrolna. Porównuj z nienarażonymi pracownikami; Li i Sung (1999) zalecają w miarę możliwości unikać populacji ogólnej jako grupy porównawczej.
- Cała kohorta. Obserwuj także osoby, które odeszły z pracy, i uwzględniaj czas od zatrudnienia.
- Standaryzacja nie wystarczy. Standaryzacja względem wieku i płci jest konieczna, ale nie usuwa różnic w stanie zdrowia.
Jak opisać w pracy
Efekt zdrowego pracownika w R
Kod porównuje zgony pracowników z oczekiwanymi według stóp populacji ogólnej (SMR z dokładnym przedziałem) oraz narażonych z nienarażonymi w tym samym zakładzie (poisson.test() dla dwóch stóp). Liczby w tekście pochodzą z tego kodu.
SMR wobec populacji ogólnej i porównanie wewnętrzne
R
set.seed(53201)
# Populacja ogólna: 15% osób przewlekle chorych, umierających 4 razy częściej
stopa_zdr <- 5 / 1000                           # zgony na osobolato u osób zdrowych
stopa_pop <- 0.85 * stopa_zdr + 0.15 * 4 * stopa_zdr   # stopa w populacji ogólnej
# Zakład zatrudnia głównie zdrowych: tylko 3% przewlekle chorych
stopa_prac <- 0.97 * stopa_zdr + 0.03 * 4 * stopa_zdr
osobolata <- c(nienarazeni = 100000, narazeni = 100000)
zgony <- rpois(2, osobolata * stopa_prac * c(1, 1.3))  # narażenie zwiększa ryzyko o 30%
E <- osobolata * stopa_pop                      # oczekiwane według populacji ogólnej
smr <- function(o, e) c(SMR = o / e, dolna = qchisq(0.025, 2 * o) / (2 * e),
                        gorna = qchisq(0.975, 2 * (o + 1)) / (2 * e))
porownanie <- poisson.test(c(zgony[2], zgony[1]), c(osobolata[2], osobolata[1]))  # narażeni vs nienarażeni
print(c(zgony_nienarazeni = zgony[1], zgony_narazeni = zgony[2]))
round(rbind(wszyscy = smr(sum(zgony), sum(E)), narazeni = smr(zgony[2], E[2]),
            nienarazeni = smr(zgony[1], E[1])), 3)
round(c(RR_wewnetrzne = unname(porownanie$estimate), dolna = porownanie$conf.int[1],
        gorna = porownanie$conf.int[2]), 3)
Wynik w R
zgony_nienarazeni    zgony_narazeni
              523               715
              SMR dolna gorna
wszyscy     0.854 0.807 0.903
narazeni    0.986 0.915 1.061
nienarazeni 0.721 0.661 0.786
RR_wewnetrzne         dolna         gorna
        1.367         1.220         1.533
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia nie wymagają dodatkowych pakietów; rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego pracownicy mają SMR poniżej 1 nawet przy szkodliwej pracy?
Bo populacja ogólna obejmuje osoby zbyt chore, by pracować. W przykładzie narażenie zwiększało umieralność o 30%, a SMR całej kohorty wyniósł 0.85.
Czy efekt zdrowego pracownika to błąd selekcji czy zakłócenie?
Opisuje się go jako postać błędu selekcji (Chowdhury i in., 2017), ale Li i Sung (1999) proponują traktować go raczej jako zakłócenie, bo stan zdrowia wpływa i na zatrudnienie, i na wynik.
Jak ograniczyć efekt zdrowego pracownika w analizie?
Porównuj narażonych z nienarażonymi pracownikami, obserwuj także osoby, które odeszły z pracy, i uwzględniaj czas od zatrudnienia. W przykładzie porównanie wewnętrzne dało 1.37 przy prawdziwym 1.3.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka w pracy z BHP i ergonomii
Klimat bezpieczeństwa w brygadach, NASA-TLX, wypadki na roboczogodziny, dolegliwości i percentyle antropometryczne: modele, efekty, zdania APA i kod R.
Czytaj →PoradnikStatystyka w pracy ze zdrowia publicznego
Chorobowość z CI, iloraz szans a iloraz chorobowości, standaryzacja względem wieku, ważenie próby i trend z rejestrów: analizy, APA i kod R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Chowdhury, R., Shah, D., & Payal, A. R. (2017). Healthy worker effect phenomenon: Revisited with emphasis on statistical methods – A review. Indian Journal of Occupational and Environmental Medicine, 21(1), 2–8. https://doi.org/10.4103/ijoem.ijoem_53_16 ● Otwarty dostęp: pełny tekst
- Li, C.-Y., & Sung, F.-C. (1999). A review of the healthy worker effect in occupational epidemiology. Occupational Medicine, 49(4), 225–229. https://doi.org/10.1093/occmed/49.4.225
Cytowania BibTeX
@article{chowdhury2017healthy, author={Chowdhury, Ritam and Shah, Divyang and Payal, Abhishek R.}, title={{Healthy worker effect phenomenon: Revisited with emphasis on statistical methods – A review}}, journal={Indian Journal of Occupational and Environmental Medicine}, year={2017}, volume={21}, number={1}, pages={2--8}, doi={10.4103/ijoem.ijoem_53_16}}@article{li1999review, author={Li, C.-Y. and Sung, F.-C.}, title={{A review of the healthy worker effect in occupational epidemiology}}, journal={Occupational Medicine}, year={1999}, volume={49}, number={4}, pages={225--229}, doi={10.1093/occmed/49.4.225}}