Co to jest wykres lejkowy do porównywania instytucji?
Wykres lejkowy do porównywania instytucji (ang. funnel plot for institutional comparisons) pokazuje wskaźnik jakości, np. odsetek powikłań w szpitalach, względem liczby przypadków, na których go policzono. Wokół wartości docelowej rysuje się granice kontrolne, które zwężają się wraz z liczbą przypadków i tworzą lejek. Spiegelhalter (2005a) zaproponował go jako zamiennik rankingów: granice działają jak na karcie kontrolnej Shewharta, tylko oś pozioma to wielkość instytucji, a nie czas. To inny wykres niż wykres lejkowy w metaanalizie (tam lejek służy do oceny asymetrii).
Jak czytać wykres
- Oś pozioma – liczba przypadków (precyzja); oś pionowa – wskaźnik.
- Linia pozioma – cel, zwykle odsetek w całej próbie albo norma zewnętrzna.
- Granice – zwykle 95% (ok. 2 błędy standardowe) i 99.8% (ok. 3 błędy standardowe). Dla odsetków liczy się je z rozkładu dwumianowego, dlatego u małych instytucji są szerokie i niesymetryczne.
- Punkt poza lejkiem – wynik, który trudno wyjaśnić samym przypadkiem przy założeniu, że instytucja ma ryzyko równe celowi. Punkt w lejku nie dowodzi przeciętności – przy małym n lejek jest szeroki.
Przykład
Zasymulowano 40 szpitali z liczbą pacjentów od 40 do 1196 (13 534 osoby, ziarno 775). Wszystkie mają ryzyko powikłań 8%, oprócz dwóch (S07 i S23), którym ręcznie ustawiono 14%, żeby było co wykryć. Odsetek w całej próbie wyniósł 9.02%. Pierwsze miejsce w rankingu zajął S37: 6 powikłań na 40 pacjentów, 15.0% – mieści się jednak w granicach. Poza granicami 99.8% znalazły się właśnie S07 (14.9%, n = 477) i S23 (14.1%, n = 739). Kolejne trzy szpitale (S36, S16, S32) wypadły tylko poza granice 95% – przy 38 szpitalach o ryzyku 8% około dwóch takich fałszywych alarmów to norma (problem wielokrotnych porównań).
Na rysunku
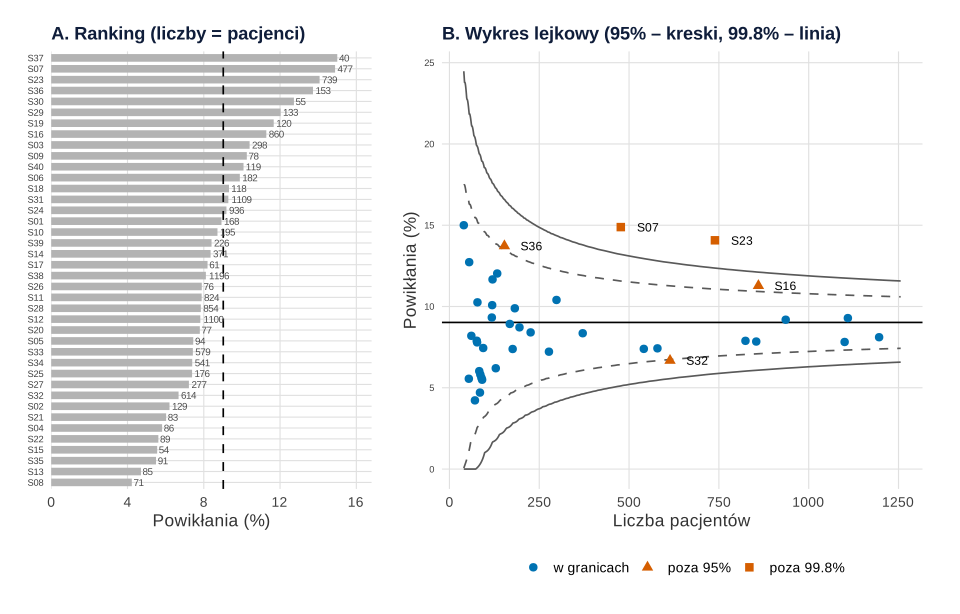
set.seed(775)).Co widać. Ranking (A) sugeruje, że S37 jest najgorszy. Na wykresie lejkowym (B) S37 leży w szerokiej części lejka: przy 40 pacjentach 15% mieści się w granicach przypadku. Naprawdę gorsze szpitale wyróżniają się dzięki kilkuset pacjentom.
Na co uważać. Granice zakładają, że po uwzględnieniu ryzyka pacjentów wszystkie instytucje mają to samo ryzyko. Przy różnym profilu pacjentów porównuj wskaźniki skorygowane o ryzyko (np. SMR, czyli zdarzenia obserwowane do oczekiwanych).
Podpis do pracy:
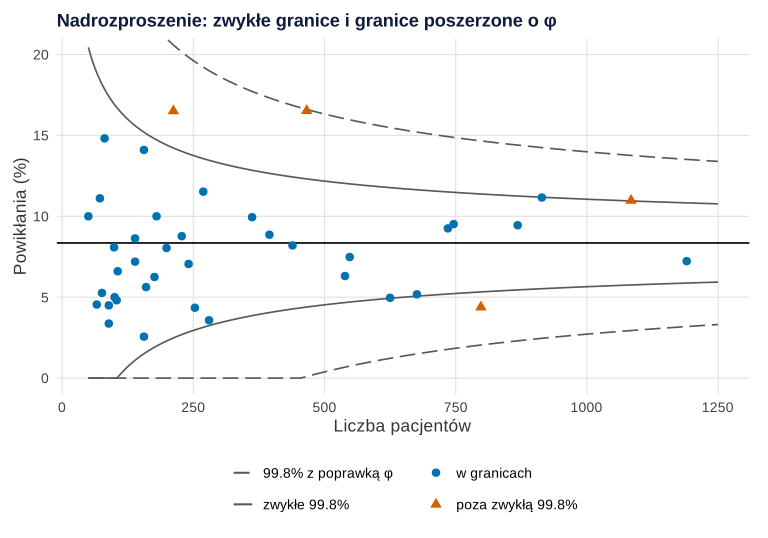
set.seed(7750)).Co widać. W drugiej symulacji każdy z 40 szpitali ma własne ryzyko (średnio 8%; rozrzut ustawiony ręcznie). Punkty rozlewają się poza lejek: suma kwadratów wyników z wynosi 173.79 przy 39 stopniach swobody (p < .001), czynnik nadrozproszenia φ = 4.34. Poza zwykłe granice 99.8% wypadają 4 szpitale, poza granice pomnożone przez √φ – żaden.
Na co uważać. Poprawka φ zmienia pytanie: zamiast „czy szpital różni się od celu” pyta „czy różni się bardziej niż typowy szpital od innych”. Spiegelhalter (2005b) opisuje też wariant addytywny z efektem losowym i ostrzega, że wybór metody zmienia, które instytucje zostaną oznaczone. Duże φ to najpierw sygnał do sprawdzenia korekty ryzyka.
Podpis do pracy:
Jak opisać w pracy
Podaj cel, sposób liczenia granic, ich poziomy i to, czy wskaźnik skorygowano o ryzyko. Przy instytucjach poza lejkiem dodaj wynik z przedziałem ufności dla proporcji.
Na co uważać
Nie numeruj instytucji według miejsca w rankingu. Leckie i Goldstein (2009) pokazali na rankingach szkół, że po uwzględnieniu niepewności tylko nieliczne szkoły da się odróżnić od średniej. Granice ustal przed obejrzeniem danych. Ten sam problem małych liczb psuje mapy – zob. kartogram, gdzie najjaskrawsze obszary to często te najmniejsze.
Wykres lejkowy instytucji w R
Dokładne granice dwumianowe liczy funkcja granica() – kwantyl qbinom() z interpolacją między liczbami całkowitymi (Spiegelhalter, 2005a). Część z nadrozproszeniem używa przybliżenia normalnego, bo na nim opiera się poprawka φ. Rysunki na stronie powstały z obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Ranking, lejek z granicami 95% i 99.8% oraz poprawka na nadrozproszenie
R
# Wykres lejkowy do porównywania instytucji (Spiegelhalter): odsetek powikłań w 40 szpitalach
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(w = "#0072B2", poza = "#D55E00", granica = "grey35")   # Okabe–Ito; poza granicami też inny kształt
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
# Dokładne granice dwumianowe z interpolacją (Spiegelhalter, 2005): p – rząd kwantyla, n – liczba pacjentów
granica <- function(p, n, theta) {
  r <- qbinom(p, n, theta)
  a <- (pbinom(r, n, theta) - p) / dbinom(r, n, theta)
  pmax((r - a) / n, 0)                                   # odsetek nie spada poniżej 0
}
# A. Dane: 40 szpitali, wspólne ryzyko 8%; dwa szpitale (S07, S23) naprawdę gorsze – 14%
set.seed(775)
n <- round(exp(runif(40, log(40), log(1200))))
ryzyko <- rep(0.08, 40); ryzyko[c(7, 23)] <- 0.14
szp <- data.frame(szpital = sprintf("S%02d", 1:40), n = n, powiklania = rbinom(40, n, ryzyko))
szp$odsetek <- szp$powiklania / szp$n
theta <- sum(szp$powiklania) / sum(szp$n)               # cel: odsetek w całej próbie
siatka <- data.frame(n = unique(round(exp(seq(log(min(n)), log(max(n) * 1.05), length.out = 200)))))   # całkowite n
for (p in c(0.001, 0.025, 0.975, 0.999)) siatka[[paste0("g", p * 1000)]] <- granica(p, siatka$n, theta)
szp$poza95 <- szp$odsetek < granica(0.025, szp$n, theta) | szp$odsetek > granica(0.975, szp$n, theta)
szp$poza998 <- szp$odsetek < granica(0.001, szp$n, theta) | szp$odsetek > granica(0.999, szp$n, theta)
szp$status <- factor(ifelse(szp$poza998, "poza 99.8%", ifelse(szp$poza95, "poza 95%", "w granicach")),
                     levels = c("w granicach", "poza 95%", "poza 99.8%"))
# Ranking słupkowy: te same dane, posortowane od najgorszego
szp$szpital_r <- reorder(szp$szpital, szp$odsetek)
pA <- ggplot(szp, aes(odsetek * 100, szpital_r)) +
  geom_col(fill = "grey70", width = 0.7) + geom_vline(xintercept = theta * 100, linetype = "dashed") +
  geom_text(aes(label = n), hjust = -0.15, size = 2.6, colour = "grey30") +
  scale_x_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "A. Ranking (liczby = pacjenci)", x = "Powikłania (%)", y = NULL) +
  theme(axis.text.y = element_text(size = 7))
pB <- ggplot(szp, aes(n, odsetek * 100)) +
  geom_line(data = siatka, aes(n, g975 * 100), linetype = "dashed", colour = kol[["granica"]]) +
  geom_line(data = siatka, aes(n, g25 * 100), linetype = "dashed", colour = kol[["granica"]]) +
  geom_line(data = siatka, aes(n, g999 * 100), colour = kol[["granica"]]) +
  geom_line(data = siatka, aes(n, g1 * 100), colour = kol[["granica"]]) +
  geom_hline(yintercept = theta * 100) +
  geom_point(aes(colour = status, shape = status), size = 2.6) +
  geom_text(data = subset(szp, poza95), aes(label = szpital), nudge_x = 45, hjust = 0, size = 3.2) +
  scale_colour_manual(values = c(kol[["w"]], kol[["poza"]], kol[["poza"]]), name = NULL, drop = FALSE) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL, drop = FALSE) +
  labs(title = "B. Wykres lejkowy (95% – kreski, 99.8% – linia)", x = "Liczba pacjentów", y = "Powikłania (%)")
p1 <- (pA + pB + plot_layout(widths = c(1, 1.5))) & motyw
# Wyniki: cel, szpitale z „najgorszego” końca rankingu i szpitale poza granicami
round(c(cel_proc = theta * 100, szpitale = nrow(szp), pacjenci = sum(szp$n)), 2)
skrajne <- szp[order(-szp$odsetek), c("szpital", "n", "powiklania", "odsetek", "status")]
skrajne$odsetek <- round(skrajne$odsetek * 100, 1)
print(head(skrajne, 5), row.names = FALSE)
print(subset(skrajne, status != "w granicach"), row.names = FALSE)
table(szp$status)
# B. Nadrozproszenie: 40 szpitali, ryzyko różne w każdym (np. inny profil pacjentów), średnio 8%
set.seed(7750)
n2 <- round(exp(runif(40, log(40), log(1200))))
ryzyko2 <- plogis(rnorm(40, qlogis(0.08), 0.35))
nad <- data.frame(n = n2, powiklania = rbinom(40, n2, ryzyko2))
nad$odsetek <- nad$powiklania / nad$n
theta2 <- sum(nad$powiklania) / sum(nad$n)
z <- (nad$odsetek - theta2) / sqrt(theta2 * (1 - theta2) / nad$n)
phi <- sum(z^2) / nrow(nad)                               # czynnik nadrozproszenia (1 = brak)
p_chi2 <- pchisq(sum(z^2), df = nrow(nad) - 1, lower.tail = FALSE)
siatka2 <- data.frame(n = seq(min(n2), max(n2) * 1.05, length.out = 200))
se2 <- sqrt(theta2 * (1 - theta2) / siatka2$n)
siatka2$zwykla_d <- pmax(theta2 - 3.09 * se2, 0);               siatka2$zwykla_g <- theta2 + 3.09 * se2
siatka2$phi_d <- pmax(theta2 - 3.09 * sqrt(phi) * se2, 0);      siatka2$phi_g <- theta2 + 3.09 * sqrt(phi) * se2
nad$poza_zwykle <- abs(z) > 3.09; nad$poza_phi <- abs(z) > 3.09 * sqrt(phi)
nad$status <- factor(ifelse(nad$poza_phi, "poza obiema", ifelse(nad$poza_zwykle, "poza zwykłą 99.8%", "w granicach")),
                     levels = c("w granicach", "poza zwykłą 99.8%", "poza obiema"))   # pusta kategoria nie trafia do legendy
p2 <- ggplot(nad, aes(n, odsetek * 100)) +
  geom_line(data = siatka2, aes(n, zwykla_d * 100, linetype = "zwykłe 99.8%"), colour = kol[["granica"]]) +
  geom_line(data = siatka2, aes(n, zwykla_g * 100, linetype = "zwykłe 99.8%"), colour = kol[["granica"]]) +
  geom_line(data = siatka2, aes(n, phi_d * 100, linetype = "99.8% z poprawką φ"), colour = kol[["granica"]]) +
  geom_line(data = siatka2, aes(n, phi_g * 100, linetype = "99.8% z poprawką φ"), colour = kol[["granica"]]) +
  geom_hline(yintercept = theta2 * 100) +
  geom_point(aes(colour = status, shape = status), size = 2.6) +
  scale_linetype_manual(values = c("zwykłe 99.8%" = "solid", "99.8% z poprawką φ" = "longdash"), name = NULL) +
  scale_colour_manual(values = c(kol[["w"]], kol[["poza"]], kol[["poza"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  coord_cartesian(ylim = c(0, 20)) +
  labs(title = "Nadrozproszenie: zwykłe granice i granice poszerzone o φ",
       x = "Liczba pacjentów", y = "Powikłania (%)") + motyw +
  guides(linetype = guide_legend(order = 1, nrow = 2), colour = guide_legend(order = 2, nrow = 2), shape = guide_legend(order = 2, nrow = 2))
round(c(cel_proc = theta2 * 100, chi2 = sum(z^2), df = nrow(nad) - 1, phi = phi,
        poza_zwyklymi = sum(nad$poza_zwykle), poza_z_phi = sum(nad$poza_phi)), 2)
cat("p (chi-kwadrat nadrozproszenia) =", format(p_chi2, digits = 2), "\n")
p1
p2
Wynik w R
cel_proc szpitale pacjenci
    9.02    40.00 13534.00
 szpital   n powiklania odsetek      status
     S37  40          6    15.0 w granicach
     S07 477         71    14.9  poza 99.8%
     S23 739        104    14.1  poza 99.8%
     S36 153         21    13.7    poza 95%
     S30  55          7    12.7 w granicach
 szpital   n powiklania odsetek     status
     S07 477         71    14.9 poza 99.8%
     S23 739        104    14.1 poza 99.8%
     S36 153         21    13.7   poza 95%
     S16 860         97    11.3   poza 95%
     S32 614         41     6.7   poza 95%

w granicach    poza 95%  poza 99.8%
         35           3           2
     cel_proc          chi2            df           phi poza_zwyklymi
         8.35        173.79         39.00          4.34          4.00
   poza_z_phi
         0.00
p (chi-kwadrat nadrozproszenia) = 6.2e-19
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe qbinom(), pbinom(), rbinom(), pchisq(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym ten wykres różni się od wykresu lejkowego w metaanalizie?
W metaanalizie punktami są badania, a lejek służy do oceny asymetrii, np. błędu publikacji. Przy porównaniu instytucji punktami są szpitale, szkoły czy poradnie, a lejek to granice kontrolne: oddzielają zmienność przypadkową od wyników, które odbiegają od celu.
Dlaczego na wykresie lejkowym instytucji rysuje się granice 95% i 99.8%?
To odpowiednik ok. 2 i 3 błędów standardowych z karty kontrolnej. Granica 95% jest ostrzeżeniem – przy wielu instytucjach część trafi poza nią przypadkiem. Granica 99.8% to sygnał do działania, bo przypadkowe przekroczenia zdarzają się rzadko.
Co zrobić, gdy wiele instytucji wypada poza lejek?
Najpierw sprawdź korektę ryzyka: instytucje mogą przyjmować różnych pacjentów lub uczniów. Jeśli rozrzut nadal jest za duży (nadrozproszenie), oszacuj czynnik φ albo wariancję między instytucjami i poszerz granice – i napisz w pracy, którą metodę wybrano.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wielokrotne testy w obrazkach
Pięć symulacji w R: 20 testów bez efektu, krzywa FWER, histogram wartości p, progi Holma i BH oraz ogród ścieżek – z kodem i podpisami.
Czytaj →PoradnikOceny gwiazdkowe i ranking produktów
Sklep z artykułami kuchennymi: rozkład J, wykres lejkowy, przedział Wilsona, średnia wygładzona i symulacja 1000 sklepów z kodem R.
Czytaj →PoradnikKampania miesiąca i regresja do średniej
Sieć szkół jazdy i 60 kampanii: wykres lejkowy, spadek zwycięzcy w następnym miesiącu, ściąganie w modelu mieszanym i symulacja – z kodem R.
Czytaj →PoradnikSkargi na 1000 zamówień
25 pralni i tabela skarg: regresja Poissona z offsetem, wykres lejkowy po korekcie o rodzaj usług i pozorna poprawa – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
- Spiegelhalter, D. J. (2005). Funnel plots for comparing institutional performance. Statistics in Medicine, 24(8), 1185–1202. https://doi.org/10.1002/sim.1970
- Spiegelhalter, D. J. (2005). Handling over-dispersion of performance indicators. Quality and Safety in Health Care, 14(5), 347–351. https://doi.org/10.1136/qshc.2005.013755 ● Otwarty dostęp
Cytowania BibTeX
@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}@article{spiegelhalter2005funnel, author={Spiegelhalter, David J.}, title={{Funnel plots for comparing institutional performance}}, journal={Statistics in Medicine}, year={2005}, volume={24}, number={8}, pages={1185--1202}, doi={10.1002/sim.1970}}@article{spiegelhalter2005handling, author={Spiegelhalter, D. J.}, title={{Handling over-dispersion of performance indicators}}, journal={Quality and Safety in Health Care}, year={2005}, volume={14}, number={5}, pages={347--351}, doi={10.1136/qshc.2005.013755}}