Co to jest kartogram?
Kartogram, czyli mapa choropletyczna (ang. choropleth map), to mapa, na której każdy obszar – gmina, powiat, województwo – ma kolor zależny od wartości wskaźnika, np. zapadalności, odsetka bezrobotnych albo średniego wyniku egzaminu. Wartości dzieli się na kilka klas, a każdej klasie przypisuje odcień: im ciemniej, tym więcej. Kartogram pokazuje wskaźniki względne (na 1000 mieszkańców, odsetki), nie liczby bezwzględne – te zależą głównie od wielkości obszaru.
Jak czytać kartogram
- Legenda – sprawdź granice klas i to, czy klasy to kwantyle (po tyle samo obszarów), czy równe przedziały wartości. Ta sama mapa przy innych klasach wygląda inaczej.
- Powierzchnia ≠ waga – duży, słabo zaludniony obszar przyciąga wzrok bardziej niż mały i ludny.
- Mianownik – wskaźnik z małego obszaru opiera się na kilku zdarzeniach, więc skacze bardziej niż z dużego. Najjaśniejsze i najciemniejsze plamy to często obszary najmniejsze (Gelman i Price, 1999).
- Skupiska – wrażenie, że ciemne obszary się grupują, sprawdź testem, np. I Morana; oko widzi wzory także w przypadkowych układach.
Przykład
Wbudowany w pakiet sf zbiór nc zawiera nagłe zgony niemowląt (SIDS) w 100 hrabstwach Karoliny Północnej w latach 1974–1978: 667 zgonów na 329 962 urodzenia, czyli 2.02 na 1000. Liczba urodzeń w hrabstwie wahała się od 248 do 21 588 (mediana 2180.5). Najwyższy wskaźnik miało Anson (9.55 na 1000: 15 zgonów na 1570 urodzeń). W 13 hrabstwach nie było żadnego zgonu – mediana urodzeń w nich wyniosła 487. Z pięciu hrabstw o najwyższym wskaźniku dwa (Washington – 5 zgonów na 990 urodzeń, i Hertford) mieszczą się w dokładnych granicach dwumianowych 99.8% wokół średniej stanu. Poza nimi są Anson, Northampton, Halifax i ludne Robeson (3.93 na 1000 przy 7889 urodzeniach).
Na rysunku
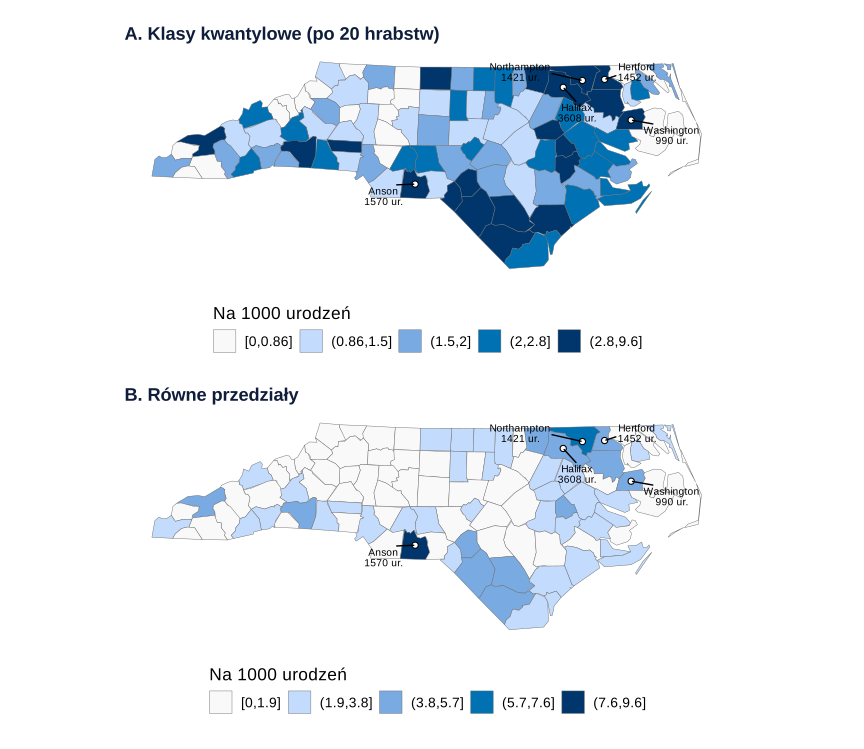
nc z pakietu sf).Co widać. Przy kwantylach (A) 20 hrabstw jest najciemniejszych i mapa wygląda alarmująco. Przy równych przedziałach (B) w dwóch najwyższych klasach jest po jednym hrabstwie, a 53 trafia do najniższej – mapa wygląda spokojnie, choć dane są te same. Brewer i Pickle (2002) w eksperymencie z mapami umieralności stwierdzili, że do ogólnego czytania map najlepiej nadają się klasy kwantylowe.
Na co uważać. Żaden podział nie pokazuje liczby urodzeń. Washington ma najciemniejszy kolor w panelu A, ale jego wskaźnik opiera się na 5 zgonach. Porównując kilka map, użyj tych samych granic klas.
Podpis do pracy:
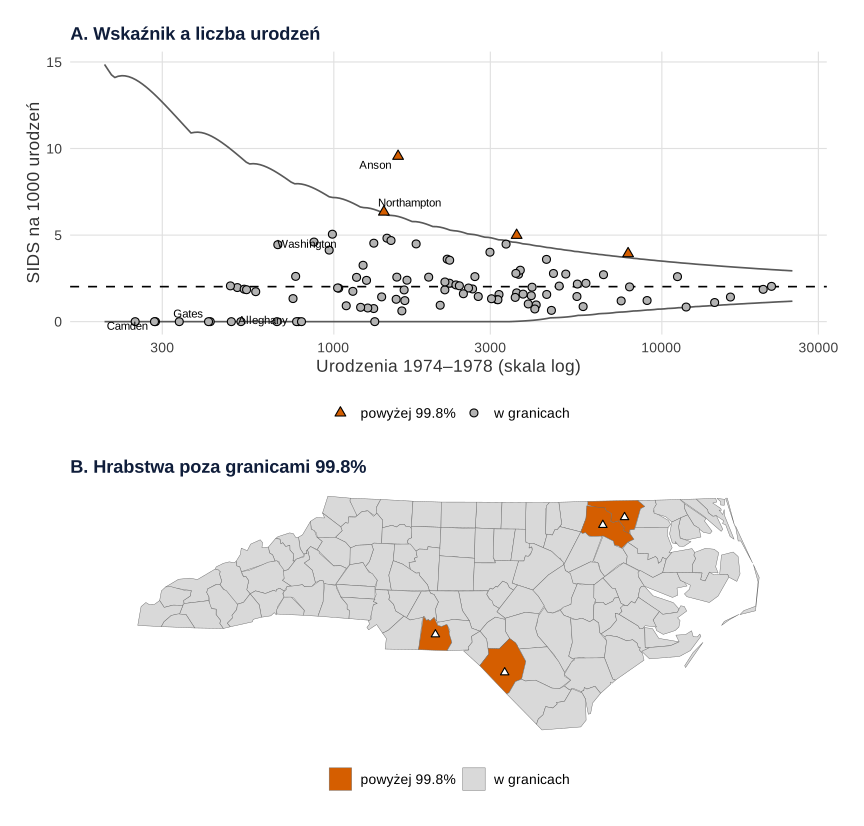
Co widać. Wskaźniki małych hrabstw rozrzucają się szeroko: od zera do ponad 5 na 1000. Lejek (A; Spiegelhalter, 2005) pokazuje, ile rozrzutu wynika z samej liczby urodzeń. Mapa (B) zaznacza tylko cztery hrabstwa, których wyniku przypadek nie tłumaczy.
Na co uważać. Granice zakładają jednakowe ryzyko we wszystkich hrabstwach i nie uwzględniają struktury populacji – przy różnym składzie wieku potrzebna jest standaryzacja. W hrabstwie z 300 urodzeniami dolna granica wynosi 0, więc nawet zero zgonów nie jest „za mało”. Gelman i Price (1999) ostrzegają, że także mapy wskaźników wygładzonych mają artefakty. Szczegóły lejka – w haśle wykres lejkowy do porównywania instytucji.
Podpis do pracy:
Jak opisać w pracy
Podaj wskaźnik i jego mianownik, okres, sposób podziału na klasy i źródło granic administracyjnych. Jeśli opisujesz skupiska, dołącz test autokorelacji przestrzennej albo model, np. regresję geograficznie ważoną.
Na co uważać
Nie koloruj liczb bezwzględnych. Nie używaj tęczowej palety – dla wskaźnika rosnącego wybierz jeden odcień od jasnego do ciemnego, a dla odchyleń od średniej paletę rozbieżną. Obok mapy pokaż mianowniki albo przedziały ufności wskaźników.
Kartogram w R
Kod wczytuje mapę hrabstw z pakietu sf, przelicza ją na układ w metrach i upraszcza granice (mniejszy plik), liczy wskaźnik, dzieli go na klasy dwoma sposobami i wyznacza dokładne granice dwumianowe granica() jak w wykresie lejkowym. Kod nie losuje – argument seed ustala tylko położenie etykiet. Rysunki na stronie powstały z obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Klasy kwantylowe i równe przedziały, wskaźnik a mianownik
R
# Kartogram (mapa choropletyczna): nagłe zgony niemowląt (SIDS) w 100 hrabstwach Karoliny Północnej, 1974–1978
suppressPackageStartupMessages({library(sf); library(ggplot2); library(patchwork)})
kol <- c(nad = "#D55E00", pod = "#0072B2", w = "grey85")                  # Okabe–Ito
skala <- rev(colorspace::sequential_hcl(5, "Blues 3"))                     # jeden odcień: jaśniej = mniej
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
nc <- st_read(system.file("shape/nc.shp", package = "sf"), quiet = TRUE)
nc <- st_simplify(st_transform(nc, 32119), dTolerance = 1500, preserveTopology = TRUE)   # metry, lżejsze granice
nc$wsk <- 1000 * nc$SID74 / nc$BIR74                                       # zgony SIDS na 1000 urodzeń
theta <- sum(nc$SID74) / sum(nc$BIR74)
# A. Te same wskaźniki, dwa podziały na 5 klas: kwantyle i równe przedziały
klasy <- function(x, granice) cut(x, granice, include.lowest = TRUE, dig.lab = 2)
nc$kwantyle <- klasy(nc$wsk, quantile(nc$wsk, 0:5 / 5))
nc$rowne <- klasy(nc$wsk, seq(min(nc$wsk), max(nc$wsk), length.out = 6))
top5 <- nc[order(-nc$wsk), ][1:5, ]
etyk <- cbind(st_drop_geometry(top5), st_coordinates(st_point_on_surface(st_geometry(top5))))
etyk$tekst <- paste0(etyk$NAME, "\n", etyk$BIR74, " ur.")
mapa <- function(zmienna, tytul) {
  ggplot(nc) + geom_sf(aes(fill = .data[[zmienna]]), colour = "grey40", linewidth = 0.15) +
    geom_point(data = etyk, aes(X, Y), shape = 21, fill = "white", size = 1.8) +
    ggrepel::geom_text_repel(data = etyk, aes(X, Y, label = tekst), size = 2.7, lineheight = 0.85,
                             min.segment.length = 0, box.padding = 0.6, seed = 774) +
    scale_fill_manual(values = skala, name = "Na 1000 urodzeń", drop = FALSE) +
    coord_sf(datum = NA) + labs(title = tytul, x = NULL, y = NULL) +
    guides(fill = guide_legend(nrow = 1, title.position = "top"))
}
p1 <- (mapa("kwantyle", "A. Klasy kwantylowe (po 20 hrabstw)") /
       mapa("rowne", "B. Równe przedziały")) & motyw
# B. Skrajne wskaźniki a liczba urodzeń: dokładne granice dwumianowe (Spiegelhalter, 2005)
granica <- function(p, n, theta) {
  r <- qbinom(p, n, theta)
  a <- (pbinom(r, n, theta) - p) / dbinom(r, n, theta)
  pmax((r - a) / n, 0)
}
nc$status <- factor(ifelse(nc$wsk / 1000 > granica(0.999, nc$BIR74, theta), "powyżej 99.8%",
                    ifelse(nc$wsk / 1000 < granica(0.001, nc$BIR74, theta), "poniżej 99.8%", "w granicach")),
                    levels = c("powyżej 99.8%", "w granicach", "poniżej 99.8%"))
siatka <- data.frame(n = unique(round(exp(seq(log(200), log(25000), length.out = 200)))))
siatka$g <- 1000 * granica(0.999, siatka$n, theta); siatka$d <- 1000 * granica(0.001, siatka$n, theta)
skr <- rbind(nc[order(-nc$wsk), ][1:3, ], nc[order(nc$wsk), ][1:3, ])
pA <- ggplot(st_drop_geometry(nc), aes(BIR74, wsk)) +
  geom_line(data = siatka, aes(n, g), colour = "grey35") + geom_line(data = siatka, aes(n, d), colour = "grey35") +
  geom_hline(yintercept = 1000 * theta, linetype = "dashed") +
  geom_point(aes(shape = status, fill = status), size = 2.4) +
  ggrepel::geom_text_repel(data = st_drop_geometry(skr), aes(label = NAME), size = 3, seed = 774) +
  scale_x_log10() + scale_shape_manual(values = c(24, 21, 25), name = NULL) +
  scale_fill_manual(values = c(kol[["nad"]], "grey70", kol[["pod"]]), name = NULL) +
  labs(title = "A. Wskaźnik a liczba urodzeń", x = "Urodzenia 1974–1978 (skala log)", y = "SIDS na 1000 urodzeń")
srodki <- cbind(st_drop_geometry(nc), st_coordinates(st_point_on_surface(st_geometry(nc))))
pB <- ggplot(nc) + geom_sf(aes(fill = status), colour = "grey40", linewidth = 0.15) +
  geom_point(data = subset(srodki, status != "w granicach"), aes(X, Y, shape = status), size = 1.8, fill = "white") +
  scale_fill_manual(values = c(kol[["nad"]], kol[["w"]], kol[["pod"]]), name = NULL) +
  scale_shape_manual(values = c(24, 21, 25), name = NULL, drop = FALSE, guide = "none") +
  coord_sf(datum = NA) + labs(title = "B. Hrabstwa poza granicami 99.8%", x = NULL, y = NULL)
p2 <- (pA / pB + plot_layout(heights = c(1.1, 1))) & motyw
# Wyniki
round(c(hrabstwa = nrow(nc), urodzenia = sum(nc$BIR74), zgony = sum(nc$SID74), wsk_stanu = 1000 * theta,
        mediana_urodzen = median(nc$BIR74)), 2)
skrajne <- st_drop_geometry(nc)[order(-nc$wsk), c("NAME", "BIR74", "SID74", "wsk", "status")]
skrajne$wsk <- round(skrajne$wsk, 2)
print(head(skrajne, 5), row.names = FALSE); print(tail(skrajne, 3), row.names = FALSE)
print(subset(skrajne, status != "w granicach"), row.names = FALSE)
c(hrabstwa_bez_zgonu = sum(nc$SID74 == 0), mediana_urodzen_w_nich = median(nc$BIR74[nc$SID74 == 0]),
  mediana_urodzen_10_najwyzszych = median(head(skrajne$BIR74, 10)))
table(nc$status)
rbind(kwantyle = table(as.integer(nc$kwantyle)), rowne_przedzialy = table(factor(as.integer(nc$rowne), 1:5)))
levels(nc$rowne)
p1
p2
Wynik w R
       hrabstwa       urodzenia           zgony       wsk_stanu mediana_urodzen
         100.00       329962.00          667.00            2.02         2180.50
        NAME BIR74 SID74  wsk        status
       Anson  1570    15 9.55 powyżej 99.8%
 Northampton  1421     9 6.33 powyżej 99.8%
  Washington   990     5 5.05   w granicach
     Halifax  3608    18 4.99 powyżej 99.8%
    Hertford  1452     7 4.82   w granicach
  NAME BIR74 SID74 wsk      status
 Macon   797     0   0 w granicach
  Hyde   338     0   0 w granicach
  Clay   284     0   0 w granicach
        NAME BIR74 SID74  wsk        status
       Anson  1570    15 9.55 powyżej 99.8%
 Northampton  1421     9 6.33 powyżej 99.8%
     Halifax  3608    18 4.99 powyżej 99.8%
     Robeson  7889    31 3.93 powyżej 99.8%
            hrabstwa_bez_zgonu         mediana_urodzen_w_nich
                            13                            487
mediana_urodzen_10_najwyzszych
                          1473

powyżej 99.8%   w granicach poniżej 99.8%
            4            96             0
                  1  2  3  4  5
kwantyle         20 20 20 20 20
rowne_przedzialy 53 33 12  1  1
[1] "[0,1.9]"   "(1.9,3.8]" "(3.8,5.7]" "(5.7,7.6]" "(7.6,9.6]"
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (mapa – pakiet sf; granice – funkcje bazowe qbinom(), pbinom(); rysunki – pakiety ggplot2, ggrepel, colorspace i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sf (wersja 1.1.3): Pebesma, E. (2018). Simple features for R: Standardized support for spatial vector data. The R Journal, 10(1), 439–446. https://doi.org/10.32614/RJ-2018-009
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym kartogram różni się od mapy z symbolami (kartodiagramu)?
Kartogram koloruje cały obszar według wskaźnika względnego, np. na 1000 mieszkańców. Mapa z symbolami (kartodiagram) stawia w obszarze znak – koło, słupek – którego wielkość pokazuje liczbę bezwzględną. Liczby bezwzględne lepiej pokazać symbolem niż kolorem.
Ile klas wybrać na kartogramie i jak wyznaczyć ich granice?
Zwykle 4–7 klas. Kwantyle dają po tyle samo obszarów w klasie i dobrze sprawdzają się do ogólnego czytania mapy; równe przedziały lepiej pokazują rzadkie skrajne wartości. W serii map użyj tych samych granic.
Jak pokazać na kartogramie niepewność wskaźnika z małych obszarów?
Dodaj drugą mapę albo oznaczenie obszarów, których wskaźnik wychodzi poza granice przypadku (np. 99.8% z rozkładu dwumianowego), wykres wskaźnika względem mianownika (lejek) albo tabelę z liczbą zdarzeń i przedziałami ufności.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Brewer, C. A., & Pickle, L. (2002). Evaluation of methods for classifying epidemiological data on choropleth maps in series. Annals of the Association of American Geographers, 92(4), 662–681. https://doi.org/10.1111/1467-8306.00310
- Gelman, A., & Price, P. N. (1999). All maps of parameter estimates are misleading. Statistics in Medicine, 18(23), 3221–3234. https://doi.org/10.1002/(sici)1097-0258(19991215)18:23<3221::aid-sim312>3.0.co;2-m
- Spiegelhalter, D. J. (2005). Funnel plots for comparing institutional performance. Statistics in Medicine, 24(8), 1185–1202. https://doi.org/10.1002/sim.1970
Cytowania BibTeX
@article{brewer2002evaluation, author={Brewer, Cynthia A. and Pickle, Linda}, title={{Evaluation of methods for classifying epidemiological data on choropleth maps in series}}, journal={Annals of the Association of American Geographers}, year={2002}, volume={92}, number={4}, pages={662--681}, doi={10.1111/1467-8306.00310}}@article{gelman1999all, author={Gelman, Andrew and Price, Phillip N.}, title={{All maps of parameter estimates are misleading}}, journal={Statistics in Medicine}, year={1999}, volume={18}, number={23}, pages={3221--3234}, doi={10.1002/(sici)1097-0258(19991215)18:23<3221::aid-sim312>3.0.co;2-m}}@article{spiegelhalter2005funnel, author={Spiegelhalter, David J.}, title={{Funnel plots for comparing institutional performance}}, journal={Statistics in Medicine}, year={2005}, volume={24}, number={8}, pages={1185--1202}, doi={10.1002/sim.1970}}