Co to jest autokorelacja przestrzenna i I Morana?
Autokorelacja przestrzenna oznacza, że wartości zmiennej w miejscach położonych blisko siebie (gminach, szkołach, punktach pomiaru) są do siebie bardziej podobne (autokorelacja dodatnia) albo mniej podobne (ujemna), niż wynikałoby z losowego rozmieszczenia. To przestrzenny odpowiednik autokorelacji w szeregu czasowym: zamiast „wcześniej – później” mamy „blisko – daleko”. Najczęściej mierzy się ją globalną statystyką I Morana, wywodzoną od pracy Morana (1950).
Jak liczyć
I = (n/S0) · ΣiΣj wij(xi − x̄)(xj − x̄) / Σi(xi − x̄)², gdzie wij to wagi przestrzenne (np. 1 dla obszarów ze wspólną granicą, potem standaryzacja wierszami), a S0 – suma wag. Przy braku autokorelacji wartość oczekiwana wynosi −1/(n − 1), a nie zero. Wartości dodatnie oznaczają skupienia podobnych wartości, ujemne – układ „szachownicy”. Istotność ocenia się przybliżeniem normalnym albo testem permutacyjnym (losowe przestawianie wartości między obszarami). Anselin (1995) pokazał, jak rozłożyć globalne I na lokalne wskaźniki (LISA), które wskazują lokalne skupienia („gorące punkty”) i obserwacje nietypowe.
Przykład
Na symulowanej siatce 10 × 10 obszarów (sąsiedzi ze wspólnym bokiem) I Morana wyniosło 0.240 przy wartości oczekiwanej −0.010 (z = 3.38, p < .001); test permutacyjny z 999 losowaniami dał p = .002. Te same wartości losowo przemieszane dały I = 0.051. W regresji liniowej z przestrzennie skorelowanym błędem I Morana dla reszt wyniosło 0.226 (p < .001), więc założenie niezależnych błędów nie było spełnione.
Na rysunku
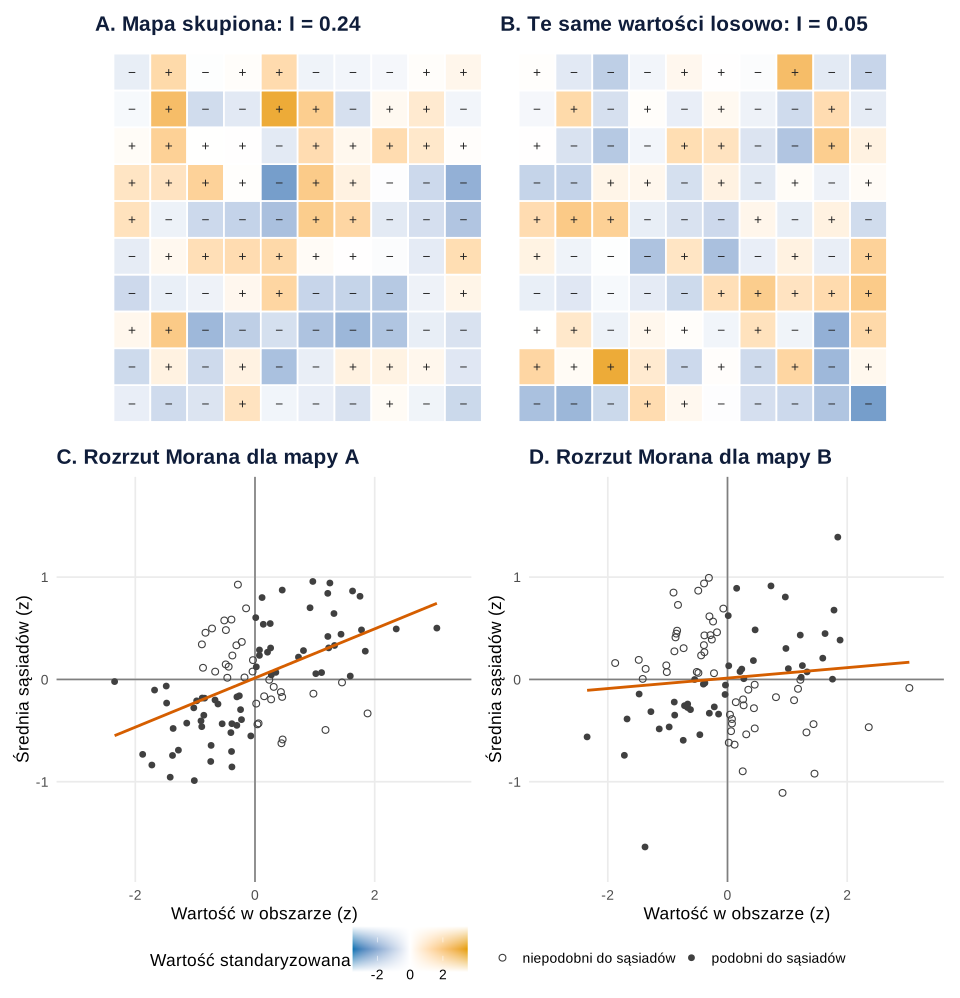
set.seed(675)).Co widać. Obie mapy mają dokładnie te same wartości – różni je tylko rozmieszczenie. Na mapie A plusy i minusy tworzą skupiska, na mapie B są rozrzucone. Dolne panele to wykres rozrzutu Morana: na osi poziomej wartość w obszarze, na pionowej średnia jego sąsiadów (oba w jednostkach standaryzowanych). Nachylenie prostej to dokładnie I Morana: 0.24 dla mapy A i 0.05 dla mapy B. Pełne kółka w ćwiartkach „wysoko–wysoko” i „nisko–nisko” to obszary podobne do sąsiadów: na mapie A jest ich 66 ze 100, na mapie B – 46. Dla mapy B test nie wskazuje autokorelacji (p = .204).
Na co uważać. I = 0.24 jest wyraźnie istotne, a mimo to mapy A nie da się na oko pewnie odróżnić od losowej. Oko widzi wzory także w przypadkowych układach, więc mapa nie zastąpi testu. Wykres nie pokazuje też, że wynik zależy od macierzy wag. Tu sąsiedzi to komórki ze wspólnym bokiem; przy innym sąsiedztwie zmieni się średnia sąsiadów na osi pionowej, a więc i nachylenie. Pojedyncze punkty daleko od prostej w ćwiartkach „niepodobnych” warto sprawdzić lokalnymi wskaźnikami (LISA) – rozrzut wskazuje kandydatów, ale ich nie testuje.
Podpis do pracy:
Kod rysunku ma jedno ziarno (set.seed(675), to samo co w przykładzie, niezmieniane); wywołanie moran.mc() przed sample() zostawiono, żeby losowa mapa B była dokładnie tą z przykładu. Siła zależności od sąsiadów (0.8) jest ustalona ręcznie, jak w przykładzie. Rysunek na stronie powstał z obiektu p1 z motywem serwisu; dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Mapa skupiona i ta sama mapa losowo przemieszana, z wykresami rozrzutu Morana (siatka 10 × 10)
suppressPackageStartupMessages({library(spdep); library(ggplot2); library(patchwork)})
kol <- c(nisko = "#0072B2", wysoko = "#E69F00", linia = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(675)                                       # te same dane co w przykładzie
nb <- cell2nb(10, 10, type = "rook")               # sąsiedzi: wspólny bok
lw <- nb2listw(nb, style = "W")
e  <- rnorm(100)
y  <- e + 0.8 * lag.listw(lw, e)                   # mapa skupiona
mc <- moran.mc(y, lw, nsim = 999)                  # jak w przykładzie (zużywa losowania)
y_los <- sample(y)                                 # te same wartości, losowo rozmieszczone
siatka <- expand.grid(kol_x = 1:10, wiersz = 1:10) # kolejność komórek jak w cell2nb()
mapy <- list("skupiona" = y, "losowa" = y_los)
I_wart <- sapply(mapy, function(v) moran.test(v, lw)$estimate[[1]])
p_val  <- sapply(mapy, function(v) moran.test(v, lw)$p.value)
rysuj_mape <- function(v, tytul) {
  d <- cbind(siatka, z = as.numeric(scale(v)))
  ggplot(d, aes(kol_x, wiersz, fill = z)) +
    geom_tile(colour = "white", linewidth = 0.6) +
    geom_text(aes(label = ifelse(z > 0, "+", "−")), size = 3.6, colour = "grey15") +
    scale_fill_gradient2(low = kol[["nisko"]], mid = "white", high = kol[["wysoko"]], limits = c(-3.5, 3.5),
                         name = "Wartość standaryzowana") +
    coord_equal() + theme_void(base_size = 13) +
    theme(legend.position = "bottom", plot.title = element_text(face = "bold")) +
    labs(title = tytul)
}
rysuj_rozrzut <- function(v, tytul) {
  z <- as.numeric(scale(v)); wz <- lag.listw(lw, z)  # opóźnienie przestrzenne: średnia sąsiadów
  d <- data.frame(z, wz, cwiartka = ifelse(z > 0 & wz > 0 | z < 0 & wz < 0, "podobni do sąsiadów", "niepodobni do sąsiadów"))
  ggplot(d, aes(z, wz)) +
    geom_hline(yintercept = 0, colour = "grey50") + geom_vline(xintercept = 0, colour = "grey50") +
    geom_point(aes(shape = cwiartka), size = 2, colour = "grey25") +
    geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["linia"]], linewidth = 1) +
    scale_shape_manual(values = c("niepodobni do sąsiadów" = 1, "podobni do sąsiadów" = 16), name = NULL) +
    coord_cartesian(xlim = c(-3, 3.3), ylim = c(-1.8, 1.8)) +
    labs(title = tytul, x = "Wartość w obszarze (z)", y = "Średnia sąsiadów (z)") + motyw
}
p1 <- (rysuj_mape(y, sprintf("A. Mapa skupiona: I = %.2f", I_wart[1])) +
       rysuj_mape(y_los, sprintf("B. Te same wartości losowo: I = %.2f", I_wart[2]))) /
      (rysuj_rozrzut(y, "C. Rozrzut Morana dla mapy A") + rysuj_rozrzut(y_los, "D. Rozrzut Morana dla mapy B")) +
      plot_layout(guides = "collect") & theme(legend.position = "bottom")
nachylenie <- sapply(mapy, function(v) { z <- as.numeric(scale(v)); unname(coef(lm(lag.listw(lw, z) ~ z))[2]) })
podobni <- sapply(mapy, function(v) { z <- as.numeric(scale(v)); wz <- lag.listw(lw, z); sum(sign(z) == sign(wz)) })
round(rbind(I_Morana = I_wart, nachylenie_rozrzutu = nachylenie, p_normalne = p_val, podobni_do_sasiadow = podobni), 4)
round(c(p_permutacyjne_mapa_A = mc$p.value), 3)
p1
Wynik w R
                    skupiona  losowa
I_Morana              0.2403  0.0511
nachylenie_rozrzutu   0.2403  0.0511
p_normalne            0.0004  0.2044
podobni_do_sasiadow  66.0000 46.0000
p_permutacyjne_mapa_A
                0.002
Jak opisać w pracy
Na co uważać
- Wynik zależy od macierzy wag. Inne sąsiedztwo (wspólny wierzchołek, k najbliższych, próg odległości) może zmienić I; podaj i uzasadnij wybór.
- Sprawdzaj reszty, nie tylko zmienną. Skupienie może wynikać z rozmieszczenia predyktorów; w regresji liczy się I dla reszt, tak jak autokorelację reszt w czasie.
- Globalne I uśrednia. Wartość bliska zera może ukrywać lokalne skupienia o przeciwnych znakach. Gdy sam związek zmiennych różni się między regionami, rozważ GWR.
- Obszar to nie osoba. Wnioski o osobach z danych dla gmin grożą błędem ekologicznym.
I Morana w R
Kod buduje sąsiedztwo na siatce, liczy I Morana ręcznie ze wzoru, a następnie testuje je funkcjami spdep::moran.test(), moran.mc() i lm.morantest() dla reszt regresji. Liczby w tekście pochodzą z tego kodu.
I Morana dla zmiennej, wersja permutacyjna i reszty regresji
R
set.seed(675)                                       # dane symulowane: siatka 10 × 10 obszarów
suppressPackageStartupMessages(library(spdep))
nb <- cell2nb(10, 10, type = "rook")               # sąsiedzi: wspólny bok
lw <- nb2listw(nb, style = "W")                    # wagi standaryzowane wierszami
e  <- rnorm(100)
y  <- e + 0.8 * lag.listw(lw, e)                   # wartość zależy od sąsiadów
z  <- y - mean(y)                                  # I Morana ręcznie
W  <- listw2mat(lw)
I_recznie <- (length(z) / sum(W)) * sum(W * outer(z, z)) / sum(z^2)
round(c(I_recznie = I_recznie, E_I = -1 / (length(z) - 1)), 4)
moran.test(y, lw)                                   # test przy założeniu losowości
moran.mc(y, lw, nsim = 999)                         # test permutacyjny
y_los <- sample(y)                                  # te same wartości, losowo rozmieszczone
round(moran.test(y_los, lw)$estimate[1], 4)
x <- rnorm(100)                                     # regresja z przestrzennie skorelowanym błędem
d <- data.frame(x, wynik = 2 + 0.5 * x + y)
fit <- lm(wynik ~ x, data = d)
lm.morantest(fit, lw)                               # I Morana dla reszt regresji
Wynik w R
I_recznie       E_I
   0.2403   -0.0101

	Moran I test under randomisation

data:  y
weights: lw

Moran I statistic standard deviate = 3.3824, p-value = 0.0003593
alternative hypothesis: greater
sample estimates:
Moran I statistic       Expectation          Variance
      0.240282534      -0.010101010       0.005479914


	Monte-Carlo simulation of Moran I

data:  y
weights: lw
number of simulations + 1: 1000

statistic = 0.24028, observed rank = 998, p-value = 0.002
alternative hypothesis: greater

Moran I statistic
           0.0511

	Global Moran I for regression residuals

data:
model: lm(formula = wynik ~ x, data = d)
weights: lw

Moran I statistic standard deviate = 3.2028, p-value = 0.0006806
alternative hypothesis: greater
sample estimates:
Observed Moran I      Expectation         Variance
      0.22580561      -0.01131293       0.00548126
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet spdep 1.4-2; rysunek 1 – także pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- spdep (wersja 1.4-2): Bivand, R. (2026). spdep: Spatial dependence: Weighting schemes, statistics (R package version 1.4-2) [Computer software]. https://CRAN.R-project.org/package=spdep
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym I Morana różni się od zwykłej korelacji?
Korelacja Pearsona łączy dwie zmienne, a I Morana – jedną zmienną z jej wartościami u sąsiadów. To, kto jest sąsiadem, określa macierz wag, więc ta sama zmienna może mieć różne I przy różnych definicjach sąsiedztwa.
Jak interpretować I Morana bliskie zera?
Jako brak wyraźnej globalnej autokorelacji przy wybranych wagach. Porównuj wynik z wartością oczekiwaną −1/(n − 1), a nie z zerem, i sprawdź lokalne wskaźniki: mogą istnieć skupienia, które się znoszą.
Co zrobić, gdy reszty regresji są przestrzennie skorelowane?
Błędy standardowe zwykłej regresji przestają być wiarygodne. Można dodać pominięte predyktory zróżnicowane przestrzennie, zastosować model przestrzenny (opóźnienia lub błędu), model wielopoziomowy z efektem regionu albo GWR, jeśli zależności zmieniają się w przestrzeni.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Diagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikSprzedaż na mapie – I Morana, LISA i GWR
120 powiatów i sprzedaż fotowoltaiki: macierz wag, I Morana, skupiska LISA, modele przestrzenne i GWR – sześć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anselin, L. (1995). Local indicators of spatial association—LISA. Geographical Analysis, 27(2), 93–115. https://doi.org/10.1111/j.1538-4632.1995.tb00338.x ● Otwarty dostęp
- Moran, P. A. P. (1950). Notes on continuous stochastic phenomena. Biometrika, 37(1–2), 17–23. https://doi.org/10.1093/biomet/37.1-2.17
Cytowania BibTeX
@article{anselin1995local, author={Anselin, Luc}, title={{Local indicators of spatial association—LISA}}, journal={Geographical Analysis}, year={1995}, volume={27}, number={2}, pages={93--115}, doi={10.1111/j.1538-4632.1995.tb00338.x}}@article{moran1950notes, author={Moran, Patrick A. P.}, title={{Notes on continuous stochastic phenomena}}, journal={Biometrika}, year={1950}, volume={37}, number={1–2}, pages={17--23}, doi={10.1093/biomet/37.1-2.17}}