Przykład: instalacje fotowoltaiczne w 120 powiatach
Fikcyjny producent instalacji fotowoltaicznych sprzedaje domom w 120 powiatach. Dział sprzedaży ma roczne dane: liczbę sprzedanych instalacji, liczbę gospodarstw domowych, odsetek gospodarstw w domach jednorodzinnych i średni dochód na osobę. Zarząd pyta: czy sprzedaż tworzy skupiska na mapie, gdzie one są i czy te same czynniki działają wszędzie tak samo?
Wynikiem jest liczba instalacji na 1000 gospodarstw. Powiaty nie mają prawdziwych granic. To siatka 12 × 10 sześciokątów: dół mapy to południe, góra – północ. Dzięki temu każdy wewnętrzny powiat ma sześciu sąsiadów, a rysunek jest czytelny także na telefonie.
Dane są fikcyjne i znamy prawdę. Ręcznie ustaliliśmy: oczekiwana sprzedaż = 8.5 na 1000 gospodarstw + efekt domów jednorodzinnych + 5 na każdy 1 tys. zł dochodu powyżej 3.2 tys. + niemierzony czynnik regionalny (np. nasłonecznienie, gminne programy dopłat; SD = 1.5). Efekt +10 pp domów jednorodzinnych maleje z południa na północ od 2.5 do 0.3 instalacji na 1000 gospodarstw. Odsetek domów, dochód i czynnik regionalny są przestrzennie skupione, ale sprzedaż w powiecie nie zależy od sprzedaży u sąsiadów: w danych nie ma naśladownictwa. Liczba gospodarstw waha się od 2845 do 81 991 (mediana ok. 13.3 tys.). Oczekiwaną sprzedaż obcięliśmy od dołu na 1 na 1000 (dotyczyło jednego powiatu). Po pierwszym uruchomieniu zmieniliśmy model generujący z logitowego na liniowy w skali „na 1000 gospodarstw” i wzmocniliśmy różnicę efektu domów między południem a północą. Prawdziwy lokalny efekt jest wtedy w tej samej skali co współczynniki GWR. Ziarna 690 nie zmienialiśmy. Dane pobierzesz jako sprzedaz-fotowoltaika-120-powiatow.csv.
Rysunek 1: mapa sprzedaży i małe powiaty
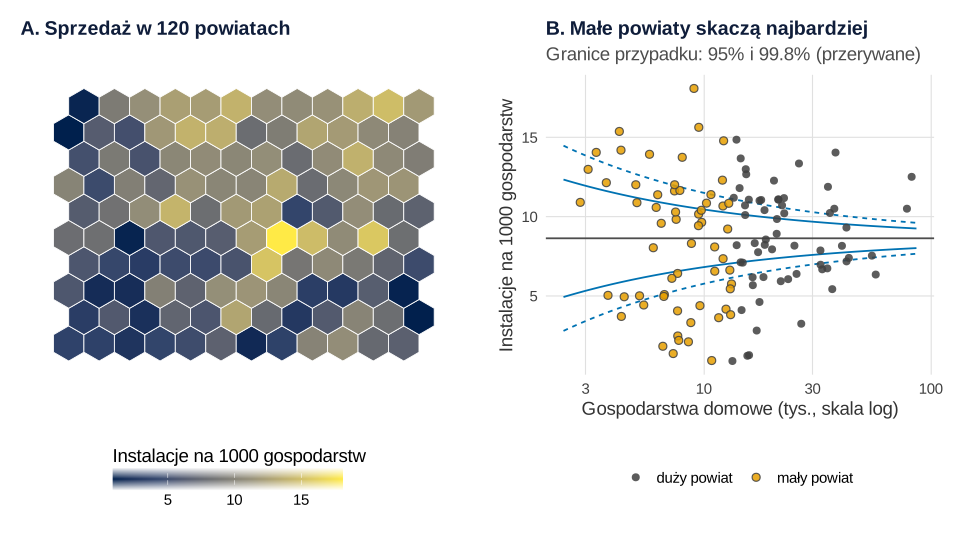
set.seed(690)).Co widać. Sieć sprzedała 17 569 instalacji na 2 034 418 gospodarstw, czyli 8.64 na 1000. W powiatach wynik waha się od 0.90 do 18.08. Na mapie (A) jasne powiaty wydają się trzymać razem, ale oko widzi wzory także w przypadkowych układach – to sprawdzi test na rysunku 3. Panel B to wykres lejkowy: sam przypadek przesuwa wynik najmniejszego powiatu o ±3.40, a największego o ±0.63 (95%). Wśród 20 najbardziej skrajnych powiatów (10 najwyższych i 10 najniższych wyników) aż 14 ma mniej gospodarstw niż mediana.
Jak może zmylić. Gelman i Price (1999) pokazali, że na mapach wskaźników skrajne wartości pojawiają się nieproporcjonalnie często w obszarach o małej liczebności. Ciemny lub jasny kolor małego powiatu może więc być szumem. Poza granicami 99.8% leży 68 powiatów, więc różnice są też prawdziwe, ale z samej mapy nie odróżnisz jednych od drugich. Więcej o wyborze klas kolorów mówi hasło kartogram.
Podpis do pracy:
Rysunek 2: kto jest sąsiadem – macierz wag
Każda miara „przestrzenna” zaczyna się od decyzji, kogo uznać za sąsiada. Zapisuje się ją w macierzy wag W: wiersz to powiat, kolumna – potencjalny sąsiad. Najprostsza reguła: sąsiad to powiat ze wspólnym bokiem. Wagi standaryzujemy wierszami, czyli każdy sąsiad dostaje 1 / liczba sąsiadów.
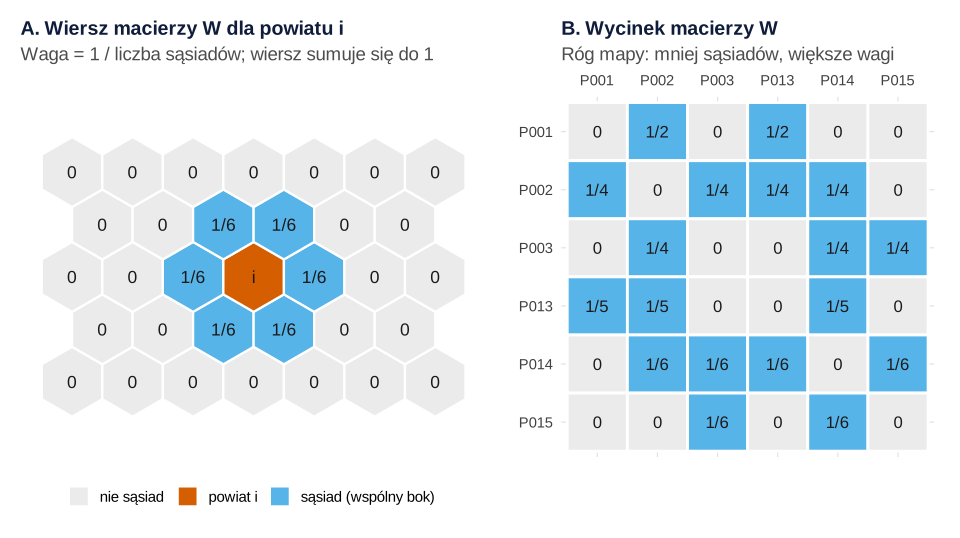
Co widać. Powiat P054 ma sześciu sąsiadów, każdy z wagą 1/6. Narożny P001 ma tylko dwóch, więc każdy waży 1/2. Na przekątnej są zera: powiat nie jest swoim sąsiadem. Pomnożenie wiersza przez wyniki daje opóźnienie przestrzenne, czyli średnią sąsiadów. P054 sprzedał 6.68 instalacji na 1000 gospodarstw, a jego sąsiedzi średnio 8.23. W całej mapie 80 powiatów ma po sześciu sąsiadów, a 40 brzegowych – od dwóch do pięciu.
Jak może zmylić. Macierz wygląda na fakt, a jest założeniem. Sąsiedztwem mogą być wspólna granica, k najbliższych powiatów albo odległość, np. czas dojazdu montażysty. Jak bardzo zmienia to wynik, pokazujemy przy rysunku 3.
Podpis do pracy:
Rysunek 3: I Morana i test permutacyjny
Autokorelacja przestrzenna oznacza, że sąsiednie powiaty mają podobne wyniki. Mierzy ją globalne I Morana (Moran, 1950). To w praktyce nachylenie prostej, gdy na osi poziomej jest wynik powiatu, a na pionowej średnia jego sąsiadów (oba standaryzowane). Przy braku autokorelacji wartość oczekiwana to −1/(n − 1), tu −0.008.
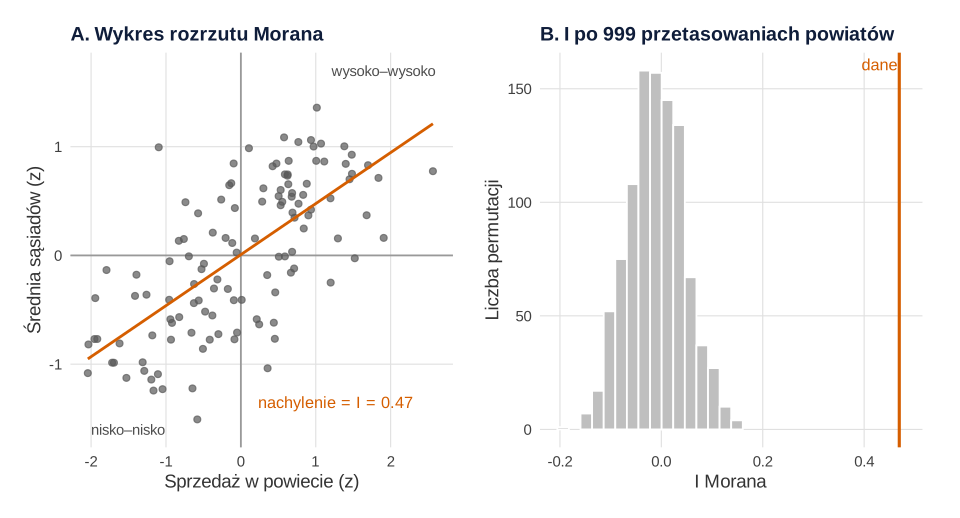
set.seed(6901)).Co widać. I Morana = 0.47 (z = 8.49). Panel B to test permutacyjny: przetasowaliśmy wyniki między powiatami 999 razy, zachowując mapę i sąsiedztwo. Największe I z permutacji wyniosło 0.159, więc p = 1/1000 = .001 – mniej przy 999 losowaniach się nie da.
Jak może zmylić. Wynik zależy od macierzy wag. Przy sąsiedztwie przez wspólny bok (średnio 5.28 sąsiada) I = 0.469, przy czterech najbliższych powiatach 0.472, a przy dwóch pierścieniach sąsiadów (średnio 14.63) – 0.346. Wniosek „są skupiska” się nie zmienia, ale liczby tak. Macierz wybierz przed analizą i uzasadnij. I Morana nie mówi też, dlaczego są skupiska – to pytanie do regresji (rysunek 5).
Zdanie do Wyników:
Rysunek 4: lokalne skupiska LISA
Globalne I mówi „są skupiska”, ale nie gdzie. Anselin (1995) rozłożył je na lokalne wskaźniki LISA: każdy powiat dostaje własne I i własny test permutacyjny. Z ćwiartki wykresu rozrzutu wynika typ: WW (wysoki wśród wysokich), NN, WN i NW.
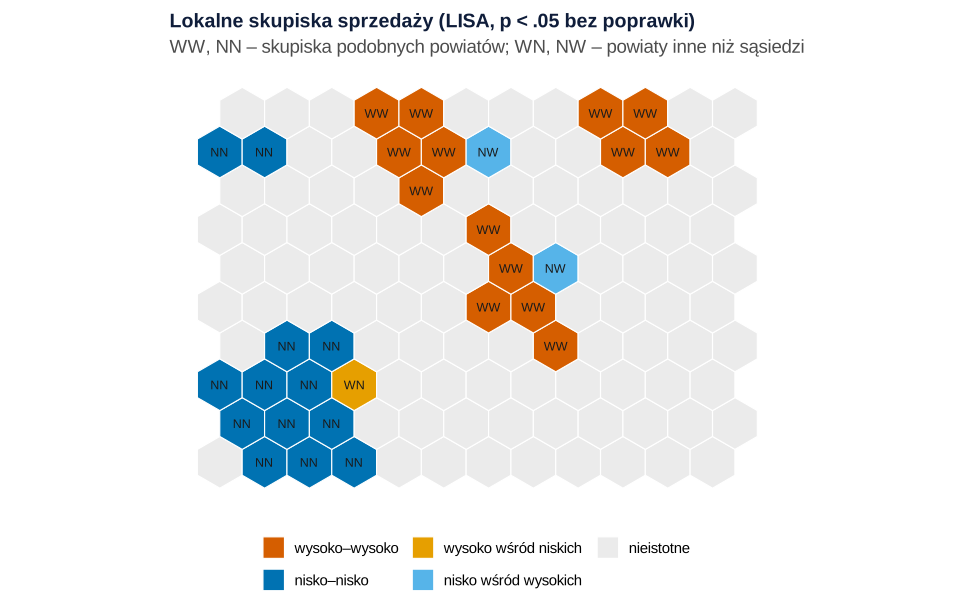
set.seed(6903)).Co widać. Przy p < .05 jest 14 powiatów WW (średnio 12.40 instalacji na 1000 gospodarstw) i 13 powiatów NN (3.85). W powiatach WW 61.8% gospodarstw mieszka w domach jednorodzinnych, w NN – 44.7%. Trzy powiaty odstają od sąsiadów: P028 (WN) oraz P068 i P103 (NW).
Jak może zmylić. To 120 testów naraz, czyli problem wielokrotnych porównań. Po procedurze Benjaminiego–Hochberga (FDR 5%) z 30 istotnych powiatów nie zostaje żaden. Testy lokalne są przy tym zależne, bo sąsiedzi dzielą sąsiadów. Mapę LISA traktuj więc jako wskazówkę, gdzie patrzeć, a nie jako listę „udowodnionych” skupisk.
Podpis do pracy:
Rysunek 5: OLS, opóźnienie i błąd przestrzenny
Zwykła regresja liniowa (OLS) z odsetkiem domów i dochodem wyjaśnia 76% zmienności (R² = .76). Każde +1 pp domów jednorodzinnych to średnio +0.179 instalacji na 1000 gospodarstw, a +1 tys. zł dochodu – +5.99. Ale I Morana dla reszt wynosi 0.33 (p < .001). Dormann i in. (2007) przypominają, że taka autokorelacja reszt narusza założenie niezależnych błędów i może zawyżać odsetek błędów I rodzaju. Są dwa typowe modele naprawcze:
- z opóźnieniem przestrzennym (lag) – sprzedaż w powiecie zależy od sprzedaży sąsiadów (parametr ρ);
- z błędem przestrzennym (error) – skorelowane są tylko reszty, np. przez niemierzony czynnik regionalny (parametr λ).
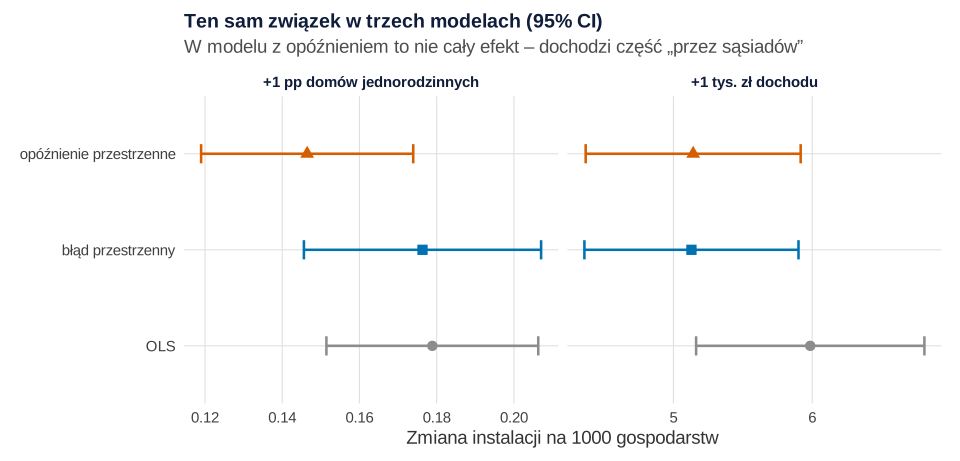
set.seed(690)).Co widać. Model z błędem ma najniższe AIC (462.6 wobec 465.6 dla lag i 490.7 dla OLS) i usuwa autokorelację reszt (I = −0.007; w lag zostaje 0.094). Współczynnik domów prawie się nie zmienia (0.176). W modelu lag współczynnik 0.146 to nie cały efekt: łączny, z częścią „przez sąsiadów”, wynosi 0.229.
Jak może zmylić. W modelu lag ρ = 0.36 (SE = 0.066, p < .001), choć w danych nie ma naśladownictwa. W 200 nowych zbiorach z tymi samymi parametrami model lag pokazał istotne ρ > 0 w 98% (błąd MC 1 pp). Istotne ρ to nie dowód, że klienci kopiują sąsiadów: podobny ślad zostawia pominięty czynnik o przestrzennym rozkładzie. Bez zmiennych objaśniających ρ wynosi nawet 0.70 – część skupisk wyjaśniają domy i dochód.
Zdanie do Wyników:
Rysunek 6: regresja geograficznie ważona
OLS i modele przestrzenne dają jeden współczynnik dla całej mapy. Regresja geograficznie ważona (GWR) dopasowuje w każdym powiecie osobną regresję, w której bliskie powiaty ważą więcej (Brunsdon i in., 1996). Liczyliśmy ją pakietem GWmodel (Gollini i in., 2015): jądro bisquare, pasmo adaptacyjne dobrane według AICc.
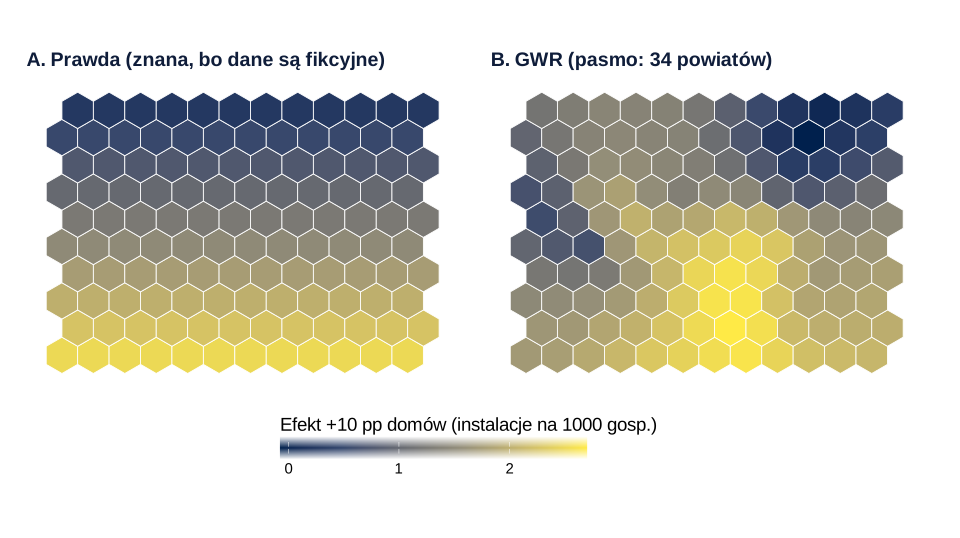
set.seed(690)).Co widać. AICc wybrało pasmo 34 najbliższych powiatów. GWR opisuje dane lepiej niż OLS (AICc = 443.9 wobec 491.0). Lokalny efekt +10 pp domów waha się od −0.07 do 2.70, podczas gdy OLS daje jedno 1.79. Na południu GWR daje średnio 2.04 (prawda 2.13), na północy 0.93 (prawda 0.54). Korelacja z prawdziwym efektem wynosi r = .73. Test Monte Carlo (99 losowań) wskazał, że efekt domów zmienia się w przestrzeni (p < .01).
Jak może zmylić. GWR ma tu 31.8 efektywnego parametru przy 120 powiatach, więc część plam to szum, a wartości na brzegach mapy (jak −0.07) są najmniej pewne. Lokalny wyraz wolny też „pływa” (p < .01), bo wchłania niemierzony czynnik regionalny. Zmienność współczynników może więc wynikać z pominiętej zmiennej, a nie z innego działania domów. Lokalne współczynniki bywają też współliniowe (współliniowość) i dotyczą powiatów, nie gospodarstw (błąd ekologiczny).
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Nie oceniaj przedstawicieli po kolorze małego powiatu. Przy 3 tys. gospodarstw sam przypadek przesuwa wynik o ±3.4 instalacji na 1000. Porównuj z lejkiem albo łącz małe powiaty z sąsiednimi.
- Powiaty NW to kandydaci, nie przegrani. P068 i P103 sprzedają wyraźnie mniej niż ich sąsiedzi, którym idzie dobrze. Sprawdź najpierw dostępność montażystów i działania konkurencji, potem uruchom tam kampanię – najlepiej jako geo-eksperyment z losowaniem regionów.
- Różnicuj przekaz według mapy GWR. Na południu każde +10 pp domów jednorodzinnych to ok. 2 instalacje na 1000 gospodarstw, na północy mniej niż jedna. Kampania do właścicieli domów ma więc większy sens na południu, a na północy warto szukać innych argumentów (np. magazyn energii).
- Nie płać za „efekt sąsiada”, którego nie sprawdziłeś. Program poleceń uzasadniony istotnym ρ może być strzałem w ciemno. Wpływ sąsiadów sprawdza eksperyment, a nie model obserwacyjny.
- Łącz mapę z modelem lokalizacji. Gdzie otworzyć punkt sprzedaży, pokazuje model Huffa, a jak cena i promocja dzielą rynek – model atrakcyjności udziałów (MCI).
Inne tematy do pracy z marketingu zbiera wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie podaj jednostkę (powiat), definicję sąsiedztwa i standaryzację wag, liczbę permutacji oraz kryterium wyboru modelu i pasma. W Wynikach – globalne I, liczbę powiatów w każdym typie LISA z informacją o poprawce, porównanie modeli i zakres lokalnych współczynników. W Dyskusji nazwij ograniczenia: dane zagregowane, wybór sąsiedztwa i możliwe pominięte zmienne.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy siatkę, sąsiedztwo, dane, paletę i motyw, przepis 3 – listę wag lw, przepis 5 – model ols używany w przepisie 6. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki) – dane, geometrie i skale są identyczne.
Każdy losujący blok zaczyna od własnego ziarna: 690 (dane, przepis 1), 6901 i 6902 (permutacje, przepis 3), 6903 (LISA, przepis 4), 6904 (200 powtórzeń, przepis 5) i 6905 (test Monte Carlo GWR, przepis 6). Ziaren nie dobieraliśmy pod wynik. Ręcznie ustalono (przepis 1): siatkę 12 × 10, siłę skupienia pól przestrzennych (ρ = 0.8 dla domów, 0.6 dla dochodu, 0.85 dla czynnika regionalnego), średni odsetek domów (50%, SD 12, zakres 15–85%), dochód (3.2 tys. zł, SD 0.4), poziom sprzedaży (8.5 na 1000), efekt domów (od 0.03 na północy do 0.25 na południu na 1 pp), efekt dochodu (5 na 1 tys. zł), SD czynnika regionalnego (1.5), dolne obcięcie na 1 na 1000 i rozkład liczby gospodarstw (mediana 14 tys., co najmniej 2500). Po pierwszym uruchomieniu zmieniono model generujący z logitowego na liniowy i wzmocniono różnicę efektu domów między południem a północą (wcześniej od 0.10 do 0.40 na 10 pp w skali logitu). Liczba permutacji (999), powtórzeń (200) i losowań Monte Carlo (99) też jest ustalona ręcznie. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w około pół minuty, głównie przez 200 powtórzeń w przepisie 5.
1. Dane: 120 powiatów na siatce, mapa i lejek: Rysunek 1
R
# Przepis 1. Fikcyjny producent instalacji fotowoltaicznych: sprzedaż w 120 powiatach na siatce sześciokątów
library(sf); library(spdep); library(ggplot2); library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", blekit = "#56B4E9",
         zielony = "#009E73", szary = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bez_osi <- theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
mapa <- coord_sf(datum = NA)                                  # mapa bez siatki współrzędnych

# Siatka 12 × 10 sześciokątów zamiast prawdziwych granic: co drugi rząd przesunięty o pół komórki
szesciokat <- function(x, y, r = 1 / sqrt(3)) {
  k <- (30 + 60 * 0:5) * pi / 180
  w <- cbind(x + r * cos(k), y + r * sin(k))
  st_polygon(list(rbind(w, w[1, ])))                          # wielokąt musi być zamknięty
}
siatka <- expand.grid(kol_nr = 0:11, rzad = 0:9)
siatka$x <- siatka$kol_nr + 0.5 * (siatka$rzad %% 2)
siatka$y <- siatka$rzad * sqrt(3) / 2                         # y = 0 to południe, y = 7.8 to północ
powiaty <- st_sf(powiat = sprintf("P%03d", 1:120), x = siatka$x, y = siatka$y,
                 geometry = st_sfc(mapply(szesciokat, siatka$x, siatka$y, SIMPLIFY = FALSE)))
nb <- poly2nb(powiaty, snap = 1e-6)                           # sąsiad = wspólny bok
W  <- nb2mat(nb, style = "W")                                 # wagi standaryzowane wierszami (suma = 1)
cat("Powiatów:", nrow(powiaty), "| liczba sąsiadów (ile powiatów):"); print(table(card(nb)))

# Ręczne parametry: pola przestrzenne z procesu autoregresyjnego (z = (I − ρW)^(−1) e), siła związków,
# poziom sprzedaży i liczba gospodarstw. Brak naśladownictwa: sprzedaż w powiecie NIE zależy od sprzedaży sąsiadów.
pole <- function(rho) { z <- solve(diag(120) - rho * W, rnorm(120)); as.numeric(scale(z)) }
b_domy <- 0.03 + 0.22 * (1 - powiaty$y / max(powiaty$y))     # +1 pp domów: +0.25 na południu, +0.03 na północy
generuj <- function() {
  d <- data.frame(domy = round(pmin(85, pmax(15, 50 + 12 * pole(0.8))), 1),   # % gospodarstw w domach jednorodzinnych
                  dochod = round(3.2 + 0.4 * pole(0.6), 2))                  # średni dochód na osobę (tys. zł)
  u <- 1.5 * pole(0.85)                                       # niemierzony czynnik regionalny (np. nasłonecznienie)
  d$gosp <- round(pmax(2500, exp(rnorm(120, log(14000), 0.7))))             # liczba gospodarstw domowych
  d$oczek <- pmax(1, 8.5 + b_domy * (d$domy - 50) + 5 * (d$dochod - 3.2) + u) # oczekiwane instalacje na 1000 gosp.
  d$instalacje <- rbinom(120, d$gosp, d$oczek / 1000)         # sprzedane instalacje w roku
  d$na1000 <- round(1000 * d$instalacje / d$gosp, 2)          # instalacje na 1000 gospodarstw
  d
}
set.seed(690)                                                 # ziarno ustalone raz, bez dobierania pod wynik
powiaty <- cbind(powiaty, generuj())
powiaty$efekt_prawd <- 10 * b_domy                            # prawdziwy efekt +10 pp domów (do porównania z GWR)
cat("Powiatów z oczekiwaną sprzedażą obciętą do 1 na 1000:", sum(powiaty$oczek == 1), "\n")
write.csv(st_drop_geometry(powiaty[, c("powiat", "x", "y", "domy", "dochod", "gosp", "instalacje", "na1000")]),
          "sprzedaz-fotowoltaika-120-powiatow.csv", row.names = FALSE)

srednia <- 1000 * sum(powiaty$instalacje) / sum(powiaty$gosp)
cat("Instalacji razem:", sum(powiaty$instalacje), "| gospodarstw:", sum(powiaty$gosp),
    "| średnio na 1000 gospodarstw:", round(srednia, 2), "\n")
cat("Na 1000 gospodarstw w powiatach: min", min(powiaty$na1000), "mediana", median(powiaty$na1000),
    "max", max(powiaty$na1000), "\n")
cat("Gospodarstw w powiecie: min", min(powiaty$gosp), "mediana", median(powiaty$gosp), "max", max(powiaty$gosp), "\n")
cat("Prawdziwy efekt +10 pp domów (na 1000 gospodarstw): od", round(min(powiaty$efekt_prawd), 2),
    "do", round(max(powiaty$efekt_prawd), 2), "\n")

# Małe powiaty: ile z 10 najwyższych i 10 najniższych wyników ma mniej gospodarstw niż mediana?
male <- powiaty$gosp < median(powiaty$gosp)
skrajne <- c(order(-powiaty$na1000)[1:10], order(powiaty$na1000)[1:10])
cat("Z 20 najbardziej skrajnych powiatów małych (poniżej mediany gospodarstw):", sum(male[skrajne]), "\n")

# Lejek: granice 95% i 99.8% wokół średniej sieci, gdyby wszystkie powiaty miały tę samą prawdziwą sprzedaż
# (przybliżenie normalne rozkładu dwumianowego: średnia ± z · √(p(1 − p)/n))
pol <- function(n, z) 1000 * z * sqrt(srednia / 1000 * (1 - srednia / 1000) / n)
lejek <- data.frame(gosp = exp(seq(log(2400), log(max(powiaty$gosp) * 1.05), length.out = 200)))
lejek$d95 <- srednia - pol(lejek$gosp, 1.96);  lejek$g95 <- srednia + pol(lejek$gosp, 1.96)
lejek$d998 <- srednia - pol(lejek$gosp, 3.09); lejek$g998 <- srednia + pol(lejek$gosp, 3.09)
poza <- abs(powiaty$na1000 - srednia) > pol(powiaty$gosp, 3.09)
cat("Powiaty poza granicami 99.8%:", sum(poza), "z 120\n")
cat("Połowa szerokości lejka 95% (sam przypadek): najmniejszy powiat ±", round(pol(min(powiaty$gosp), 1.96), 2),
    "| największy ±", round(pol(max(powiaty$gosp), 1.96), 2), "\n")

p1a <- ggplot(powiaty) + geom_sf(aes(fill = na1000), colour = "white", linewidth = 0.3) +
  scale_fill_viridis_c(option = "cividis", name = "Instalacje na 1000 gospodarstw") +
  guides(fill = guide_colourbar(barwidth = 12, barheight = 0.6, title.position = "top")) +
  labs(title = "A. Sprzedaż w 120 powiatach") + mapa + motyw + bez_osi
p1b <- ggplot(powiaty, aes(gosp / 1000, na1000)) +
  geom_line(data = lejek, aes(gosp / 1000, d998), colour = kol[["niebieski"]], linetype = "22") +
  geom_line(data = lejek, aes(gosp / 1000, g998), colour = kol[["niebieski"]], linetype = "22") +
  geom_line(data = lejek, aes(gosp / 1000, d95), colour = kol[["niebieski"]]) +
  geom_line(data = lejek, aes(gosp / 1000, g95), colour = kol[["niebieski"]]) +
  geom_hline(yintercept = srednia, colour = "grey30") +
  geom_point(aes(shape = male), colour = "grey25", fill = kol[["pomaranczowy"]], size = 2.4, alpha = 0.85) +
  scale_shape_manual(values = c(`TRUE` = 21, `FALSE` = 16), labels = c(`TRUE` = "mały powiat", `FALSE` = "duży powiat"),
                     name = NULL) +
  scale_x_log10() +
  labs(title = "B. Małe powiaty skaczą najbardziej", subtitle = "Granice przypadku: 95% i 99.8% (przerywane)", x = "Gospodarstwa domowe (tys., skala log)",
       y = "Instalacje na 1000 gospodarstw") + motyw
p1 <- p1a + p1b + plot_layout(widths = c(1.15, 1))
p1   # zapis: ggsave("fotowoltaika-mapa-i-lejek.svg", p1, width = 10, height = 5.6)
Wynik w R
Powiatów: 120 | liczba sąsiadów (ile powiatów):
 2  3  4  5  6
 2 10 20  8 80
Powiatów z oczekiwaną sprzedażą obciętą do 1 na 1000: 1
Instalacji razem: 17569 | gospodarstw: 2034418 | średnio na 1000 gospodarstw: 8.64
Na 1000 gospodarstw w powiatach: min 0.9 mediana 8.445 max 18.08
Gospodarstw w powiecie: min 2845 mediana 13253.5 max 81991
Prawdziwy efekt +10 pp domów (na 1000 gospodarstw): od 0.3 do 2.5
Z 20 najbardziej skrajnych powiatów małych (poniżej mediany gospodarstw): 14
Powiaty poza granicami 99.8%: 68 z 120
Połowa szerokości lejka 95% (sam przypadek): najmniejszy powiat ± 3.4 | największy ± 0.63
2. Grafika: macierz wag: Rysunek 2
R
# Przepis 2. Grafika: kto jest sąsiadem i jak wygląda macierz wag W (wycinek siatki)
# (korzysta z powiaty, nb, W, kol, motyw, bez_osi z przepisu 1)
library(sf); library(ggplot2); library(patchwork)

srodek <- 54                                                  # powiat P054 w środku mapy
sas <- nb[[srodek]]
cat("Sąsiedzi", powiaty$powiat[srodek], ":", powiaty$powiat[sas], "| waga każdego:", round(W[srodek, sas[1]], 3), "\n")
cat("Wynik", powiaty$powiat[srodek], ":", powiaty$na1000[srodek], "| średnia sąsiadów (opóźnienie przestrzenne):",
    round(sum(W[srodek, ] * powiaty$na1000), 2), "\n")
cat("Narożny powiat P001 ma", length(nb[[1]]), "sąsiadów – każdy z wagą", round(W[1, nb[[1]][1]], 3), "\n")

fragment <- powiaty[abs(powiaty$x - powiaty$x[srodek]) <= 3.1 & abs(powiaty$y - powiaty$y[srodek]) <= 1.9, ]
fragment$rola <- ifelse(fragment$powiat == powiaty$powiat[srodek], "powiat i",
                        ifelse(fragment$powiat %in% powiaty$powiat[sas], "sąsiad (wspólny bok)", "nie sąsiad"))
fragment$etykieta <- ifelse(fragment$rola == "powiat i", "i",
                            ifelse(fragment$rola == "nie sąsiad", "0", "1/6"))
wyp <- c("powiat i" = kol[["cynober"]], "sąsiad (wspólny bok)" = kol[["blekit"]], "nie sąsiad" = "grey92")
p2a <- ggplot(fragment) + geom_sf(aes(fill = rola), colour = "white", linewidth = 0.8) +
  geom_text(aes(x, y, label = etykieta), size = 4.6, colour = "grey10") +
  scale_fill_manual(values = wyp, name = NULL) +
  labs(title = "A. Wiersz macierzy W dla powiatu i",
       subtitle = "Waga = 1 / liczba sąsiadów; wiersz sumuje się do 1") + mapa + motyw + bez_osi +
  theme(legend.position = "bottom")

# Wycinek macierzy W: sześć powiatów z południowo-zachodniego rogu (rzędy 0–1, kolumny 0–2)
wyc <- c(1, 2, 3, 13, 14, 15)
mac <- expand.grid(wiersz = wyc, kolumna = wyc)
mac$w <- W[cbind(mac$wiersz, mac$kolumna)]
mac$etyk <- ifelse(mac$w == 0, "0", paste0("1/", round(1 / mac$w)))
mac$wiersz <- factor(powiaty$powiat[mac$wiersz], rev(powiaty$powiat[wyc]))
mac$kolumna <- factor(powiaty$powiat[mac$kolumna], powiaty$powiat[wyc])
p2b <- ggplot(mac, aes(kolumna, wiersz, fill = w > 0)) +
  geom_tile(colour = "white", linewidth = 1) +
  geom_text(aes(label = etyk), size = 4.4, colour = "grey10") +
  scale_fill_manual(values = c(`TRUE` = kol[["blekit"]], `FALSE` = "grey92"), guide = "none") +
  scale_x_discrete(position = "top") +
  labs(title = "B. Wycinek macierzy W",
       subtitle = "Róg mapy: mniej sąsiadów, większe wagi", x = NULL, y = NULL) +
  motyw + theme(panel.grid = element_blank(), axis.text = element_text(size = 11))
p2 <- p2a + p2b + plot_layout(widths = c(1.25, 1))
p2   # zapis: ggsave("fotowoltaika-macierz-wag.svg", p2, width = 10, height = 5.6)
Wynik w R
Sąsiedzi P054 : P041 P042 P053 P055 P065 P066 | waga każdego: 0.167
Wynik P054 : 6.68 | średnia sąsiadów (opóźnienie przestrzenne): 8.23
Narożny powiat P001 ma 2 sąsiadów – każdy z wagą 0.5
3. I Morana, test permutacyjny i trzy sąsiedztwa: Rysunek 3
R
# Przepis 3. Globalne I Morana: test analityczny, test permutacyjny i wybór sąsiedztwa
# (korzysta z powiaty, nb, kol, motyw z przepisu 1)
library(spdep); library(ggplot2); library(patchwork)

lw <- nb2listw(nb, style = "W")
mt <- moran.test(powiaty$na1000, lw)
set.seed(6901)                                                # osobne ziarno dla permutacji
mc <- moran.mc(powiaty$na1000, lw, nsim = 999)
cat("I Morana =", round(mt$estimate[["Moran I statistic"]], 3), "| wartość oczekiwana =",
    round(mt$estimate[["Expectation"]], 3), "| z =", round(mt$statistic, 2), "\n")
cat("Test permutacyjny (999 losowań): p =", sub("^0", "", mc$p.value), "| największe I z permutacji =", round(max(mc$res[1:999]), 3), "\n")

# Trzy definicje sąsiedztwa dają różne I
wsp <- st_coordinates(st_centroid(st_geometry(powiaty)))
warianty <- list("wspólny bok (2–6 sąsiadów)" = nb,
                 "4 najbliższe centroidy" = knn2nb(knearneigh(wsp, k = 4)),
                 "do 2 pierścieni (do 18 sąsiadów)" = dnearneigh(wsp, 0, 2.01))
set.seed(6902)
porown <- t(sapply(warianty, function(n) {
  l <- nb2listw(n, style = "W")
  c(sasiadow_srednio = mean(card(n)), I = moran.test(powiaty$na1000, l, randomisation = TRUE)$estimate[[1]],
    p_perm = moran.mc(powiaty$na1000, l, nsim = 999)$p.value)
}))
print(round(porown, 3))

z <- as.numeric(scale(powiaty$na1000))
rozrzut <- data.frame(z = z, lag_z = lag.listw(lw, z))
p3a <- ggplot(rozrzut, aes(z, lag_z)) +
  geom_hline(yintercept = 0, colour = "grey60") + geom_vline(xintercept = 0, colour = "grey60") +
  geom_point(colour = "grey35", alpha = 0.7, size = 2) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["cynober"]], linewidth = 1) +
  annotate("text", x = 2.3, y = -1.35, label = paste0("nachylenie = I = ", sprintf("%.2f", mt$estimate[[1]])),
           colour = kol[["cynober"]], size = 4.3, hjust = 1) +
  annotate("text", x = c(2.6, -2), y = c(1.7, -1.6), label = c("wysoko–wysoko", "nisko–nisko"),
           colour = "grey30", size = 3.9, hjust = c(1, 0)) +
  labs(title = "A. Wykres rozrzutu Morana", x = "Sprzedaż w powiecie (z)", y = "Średnia sąsiadów (z)") + motyw
perm <- data.frame(I = mc$res[1:999])
p3b <- ggplot(perm, aes(I)) +
  geom_histogram(bins = 30, fill = "grey75", colour = "white") +
  geom_vline(xintercept = mt$estimate[[1]], colour = kol[["cynober"]], linewidth = 1.1) +
  annotate("text", x = mt$estimate[[1]], y = Inf, vjust = 1.5, hjust = 1.05, label = "dane", colour = kol[["cynober"]],
           size = 4.3) +
  labs(title = "B. I po 999 przetasowaniach powiatów", x = "I Morana", y = "Liczba permutacji") + motyw
p3 <- p3a + p3b
p3   # zapis: ggsave("fotowoltaika-moran.svg", p3, width = 10, height = 5.4)
Wynik w R
I Morana = 0.469 | wartość oczekiwana = -0.008 | z = 8.49
Test permutacyjny (999 losowań): p = .001 | największe I z permutacji = 0.159
                                 sasiadow_srednio     I p_perm
wspólny bok (2–6 sąsiadów)                  5.283 0.469  0.001
4 najbliższe centroidy                      4.000 0.472  0.001
do 2 pierścieni (do 18 sąsiadów)           14.633 0.346  0.001
4. Lokalne skupiska LISA: Rysunek 4
R
# Przepis 4. Lokalne skupiska LISA (lokalne I Morana z permutacjami warunkowymi) i mapa skupisk
# (korzysta z powiaty, lw, kol, motyw, bez_osi z przepisów 1 i 3)
library(spdep); library(sf); library(ggplot2)

set.seed(6903)
li <- localmoran_perm(powiaty$na1000, lw, nsim = 999)
p_lok <- li[, "Pr(z != E(Ii)) Sim"]                           # p z 999 permutacji warunkowych
cwiartka <- as.character(attr(li, "quadr")$mean)              # High-High, Low-Low, Low-High, High-Low
nazwy <- c("High-High" = "wysoko–wysoko", "Low-Low" = "nisko–nisko", "High-Low" = "wysoko wśród niskich",
           "Low-High" = "nisko wśród wysokich")
powiaty$lisa <- ifelse(p_lok < 0.05, nazwy[cwiartka], "nieistotne")
powiaty$lisa <- factor(powiaty$lisa, c(nazwy, "nieistotne"))
cat("Powiaty według typu (p < .05, bez poprawki):\n"); print(table(powiaty$lisa))
p_bh <- p.adjust(p_lok, "BH")
cat("Po poprawce Benjaminiego–Hochberga (FDR 5%) istotnych zostaje:", sum(p_bh < 0.05), "z", sum(p_lok < 0.05), "\n")
odst <- powiaty$lisa %in% nazwy[c("High-Low", "Low-High")]
cat("Powiaty odstające od sąsiadów:", powiaty$powiat[odst], "| ich gospodarstwa:", powiaty$gosp[odst], "\n")
cat("Mediana gospodarstw: w skupiskach wysoko–wysoko", median(powiaty$gosp[powiaty$lisa == nazwy[["High-High"]]]),
    "| wszystkie powiaty", median(powiaty$gosp), "\n")
cat("Średnio na 1000 gospodarstw: wysoko–wysoko", round(mean(powiaty$na1000[powiaty$lisa == nazwy[["High-High"]]]), 2),
    "| nisko–nisko", round(mean(powiaty$na1000[powiaty$lisa == nazwy[["Low-Low"]]]), 2), "\n")
cat("Średnio % domów: wysoko–wysoko", round(mean(powiaty$domy[powiaty$lisa == nazwy[["High-High"]]]), 1),
    "| nisko–nisko", round(mean(powiaty$domy[powiaty$lisa == nazwy[["Low-Low"]]]), 1), "\n")

kol_lisa <- c("wysoko–wysoko" = kol[["cynober"]], "nisko–nisko" = kol[["niebieski"]],
              "wysoko wśród niskich" = kol[["pomaranczowy"]], "nisko wśród wysokich" = kol[["blekit"]],
              "nieistotne" = "grey92")
ozn <- c("wysoko–wysoko" = "WW", "nisko–nisko" = "NN", "wysoko wśród niskich" = "WN",
         "nisko wśród wysokich" = "NW", "nieistotne" = "")
p4 <- ggplot(powiaty) + geom_sf(aes(fill = lisa), colour = "white", linewidth = 0.4) +
  geom_text(aes(x, y, label = ozn[as.character(lisa)]), size = 3.3, colour = "grey10") +
  scale_fill_manual(values = kol_lisa, drop = FALSE, name = NULL) +
  guides(fill = guide_legend(nrow = 2)) +
  labs(title = "Lokalne skupiska sprzedaży (LISA, p < .05 bez poprawki)",
       subtitle = "WW, NN – skupiska podobnych powiatów; WN, NW – powiaty inne niż sąsiedzi") + mapa + motyw + bez_osi
p4   # zapis: ggsave("fotowoltaika-lisa.svg", p4, width = 10, height = 6.4)
Wynik w R
Powiaty według typu (p < .05, bez poprawki):

       wysoko–wysoko          nisko–nisko wysoko wśród niskich
                  14                   13                    1
nisko wśród wysokich           nieistotne
                   2                   90
Po poprawce Benjaminiego–Hochberga (FDR 5%) istotnych zostaje: 0 z 30
Powiaty odstające od sąsiadów: P028 P068 P103 | ich gospodarstwa: 20915 5416 40434
Mediana gospodarstw: w skupiskach wysoko–wysoko 12063 | wszystkie powiaty 13253.5
Średnio na 1000 gospodarstw: wysoko–wysoko 12.4 | nisko–nisko 3.85
Średnio % domów: wysoko–wysoko 61.8 | nisko–nisko 44.7
5. OLS, model z opóźnieniem i z błędem; 200 powtórzeń: Rysunek 5
R
# Przepis 5. Regresja OLS, model z opóźnieniem przestrzennym (lag) i z błędem przestrzennym (error)
# (korzysta z powiaty, nb, W, lw, kol, motyw z przepisów 1 i 3)
library(spdep); library(spatialreg); library(ggplot2)

ols <- lm(na1000 ~ domy + dochod, data = powiaty)
cat("OLS: współczynniki\n"); print(round(summary(ols)$coefficients, 3))
cat("R² =", sub("^0", "", round(summary(ols)$r.squared, 3)), "\n")
mr <- lm.morantest(ols, lw)
cat("I Morana dla reszt OLS =", round(mr$estimate[[1]], 3), "| p =", signif(mr$p.value, 2), "\n")
lag0 <- lagsarlm(na1000 ~ 1, data = powiaty, listw = lw)      # model bez zmiennych objaśniających
lag  <- lagsarlm(na1000 ~ domy + dochod, data = powiaty, listw = lw)
err  <- errorsarlm(na1000 ~ domy + dochod, data = powiaty, listw = lw)
cat("Lag bez zmiennych: rho =", round(lag0$rho, 3), "\n")
cat("Lag ze zmiennymi: rho =", round(lag$rho, 3), "| SE =", round(lag$rho.se, 3), "| p =", signif(summary(lag)$LR1$p.value, 2), "\n")
cat("Error: lambda =", round(err$lambda, 3), "| SE =", round(err$lambda.se, 3), "\n")
cat("AIC: OLS", round(AIC(ols), 1), "| lag", round(AIC(lag), 1), "| error", round(AIC(err), 1), "\n")
cat("I Morana reszt: lag", round(moran.test(residuals(lag), lw)$estimate[[1]], 3),
    "| error", round(moran.test(residuals(err), lw)$estimate[[1]], 3), "\n")
eff <- impacts(lag, listw = lw)                               # efekt bezpośredni, pośredni (przez sąsiadów) i łączny
cat("Lag – efekty zmiennej domy: bezpośredni", round(eff$direct[1], 3), "pośredni", round(eff$indirect[1], 3),
    "łączny", round(eff$total[1], 3), "\n")

wsp <- rbind(
  data.frame(model = "OLS", zm = c("domy", "dochod"), b = coef(ols)[2:3], se = summary(ols)$coefficients[2:3, 2]),
  data.frame(model = "błąd przestrzenny", zm = c("domy", "dochod"), b = coef(err)[3:4] , se = err$rest.se[2:3]),
  data.frame(model = "opóźnienie przestrzenne", zm = c("domy", "dochod"), b = coef(lag)[3:4], se = lag$rest.se[2:3]))
wsp$zm <- factor(wsp$zm, c("domy", "dochod"), c("+1 pp domów jednorodzinnych", "+1 tys. zł dochodu"))
wsp$model <- factor(wsp$model, c("OLS", "błąd przestrzenny", "opóźnienie przestrzenne"))
print(transform(wsp, b = round(b, 3), se = round(se, 3)), row.names = FALSE)

# Naśladownictwa w danych nie ma (przepis 1). Jak często model lag i tak „widzi” istotne rho > 0?
# 200 nowych zbiorów z tymi samymi parametrami, bez wpływu sąsiadów na sprzedaż
set.seed(6904)
istotne <- replicate(200, {
  d <- generuj()                                              # ta sama funkcja co w przepisie 1
  m <- lagsarlm(na1000 ~ domy + dochod, data = d, listw = lw)
  summary(m)$LR1$p.value < 0.05 && m$rho > 0
})
cat("Istotne rho > 0 w modelu lag bez naśladownictwa:", 100 * mean(istotne), "% z 200 (błąd MC",
    round(100 * sqrt(mean(istotne) * (1 - mean(istotne)) / 200), 1), "pp)\n")

p5 <- ggplot(wsp, aes(b, model, colour = model, shape = model)) +
  geom_errorbar(aes(xmin = b - 1.96 * se, xmax = b + 1.96 * se), width = 0.2, linewidth = 0.9, orientation = "y") +
  geom_point(size = 3.2) +
  facet_wrap(~ zm, scales = "free_x") +
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]], kol[["cynober"]]), guide = "none") +
  scale_shape_manual(values = c(16, 15, 17), guide = "none") +
  labs(title = "Ten sam związek w trzech modelach (95% CI)",
       subtitle = "W modelu z opóźnieniem to nie cały efekt – dochodzi część „przez sąsiadów”",
       x = "Zmiana instalacji na 1000 gospodarstw", y = NULL) + motyw
p5   # zapis: ggsave("fotowoltaika-ols-lag-error.svg", p5, width = 10, height = 4.8)
Wynik w R
OLS: współczynniki
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  -19.581      1.508 -12.988        0
domy           0.179      0.014  12.780        0
dochod         5.986      0.420  14.261        0
R² = .763
I Morana dla reszt OLS = 0.33 | p = 2.3e-10
Lag bez zmiennych: rho = 0.7
Lag ze zmiennymi: rho = 0.36 | SE = 0.066 | p = 2e-07
Error: lambda = 0.614 | SE = 0.09
AIC: OLS 490.7 | lag 465.6 | error 462.6
I Morana reszt: lag 0.094 | error -0.007
Lag – efekty zmiennej domy: bezpośredni 0.151 pośredni 0.078 łączny 0.229
                   model                          zm     b    se
                     OLS +1 pp domów jednorodzinnych 0.179 0.014
                     OLS          +1 tys. zł dochodu 5.986 0.420
       błąd przestrzenny +1 pp domów jednorodzinnych 0.176 0.016
       błąd przestrzenny          +1 tys. zł dochodu 5.130 0.394
 opóźnienie przestrzenne +1 pp domów jednorodzinnych 0.146 0.014
 opóźnienie przestrzenne          +1 tys. zł dochodu 5.142 0.395
Istotne rho > 0 w modelu lag bez naśladownictwa: 98 % z 200 (błąd MC 1 pp)
6. Regresja geograficznie ważona: Rysunek 6
R
# Przepis 6. Regresja geograficznie ważona (GWR): pasmo adaptacyjne wg AICc i mapa lokalnych współczynników
# (korzysta z powiaty, ols, kol, motyw, bez_osi z przepisów 1 i 5)
library(GWmodel); library(sf); library(ggplot2); library(patchwork)

dane_sp <- as(st_sf(st_drop_geometry(powiaty[, c("na1000", "domy", "dochod")]),
                    geometry = st_centroid(st_geometry(powiaty))), "Spatial")   # GWR liczy na środkach powiatów
invisible(capture.output(                                    # bw.gwr wypisuje każdy krok szukania – ukrywamy
  bw <- bw.gwr(na1000 ~ domy + dochod, data = dane_sp, approach = "AICc", kernel = "bisquare", adaptive = TRUE)))
gw <- gwr.basic(na1000 ~ domy + dochod, data = dane_sp, bw = bw, kernel = "bisquare", adaptive = TRUE)
cat("Pasmo adaptacyjne:", bw, "najbliższych powiatów\n")
# AICc modelu globalnego tym samym wzorem co w GWmodel (ślad macierzy kapelusza = 3 parametry)
n <- 120; s <- sqrt(sum(residuals(ols)^2) / n)
aicc_ols <- 2 * n * log(s) + n * log(2 * pi) + n * (n + 3) / (n - 2 - 3)
cat("AICc: OLS", round(aicc_ols, 1), "| GWR", round(gw$GW.diagnostic$AICc, 1),
    "| efektywna liczba parametrów GWR:", round(gw$GW.diagnostic$enp, 1), "\n")
powiaty$b_domy <- gw$SDF$domy * 10                            # efekt +10 pp domów
cat("Lokalny efekt +10 pp domów: od", round(min(powiaty$b_domy), 2), "do", round(max(powiaty$b_domy), 2),
    "| OLS (jeden dla wszystkich):", round(10 * coef(ols)[["domy"]], 2), "\n")
cat("Korelacja z prawdziwym lokalnym efektem: r =", sub("^0", "", round(cor(powiaty$b_domy, powiaty$efekt_prawd), 2)), "\n")
poludnie <- powiaty$y < 2.6; polnoc <- powiaty$y > 5.2
cat("Średni efekt +10 pp: południe (3 dolne rzędy) GWR", round(mean(powiaty$b_domy[poludnie]), 2),
    "prawda", round(mean(powiaty$efekt_prawd[poludnie]), 2), "| północ (3 górne rzędy) GWR",
    round(mean(powiaty$b_domy[polnoc]), 2), "prawda", round(mean(powiaty$efekt_prawd[polnoc]), 2), "\n")
set.seed(6905)
# test Monte Carlo stałości współczynników (99 losowań położeń); funkcja sama wypisuje tabelę p
mcg <- gwr.montecarlo(na1000 ~ domy + dochod, data = dane_sp, nsims = 99, kernel = "bisquare", adaptive = TRUE, bw = bw)

granice <- range(c(powiaty$b_domy, powiaty$efekt_prawd))
skala <- scale_fill_viridis_c(option = "cividis", limits = granice, name = "Efekt +10 pp domów (instalacje na 1000 gosp.)")
p6a <- ggplot(powiaty) + geom_sf(aes(fill = efekt_prawd), colour = "white", linewidth = 0.3) + skala +
  labs(title = "A. Prawda (znana, bo dane są fikcyjne)") + mapa + motyw + bez_osi
p6b <- ggplot(powiaty) + geom_sf(aes(fill = b_domy), colour = "white", linewidth = 0.3) + skala +
  labs(title = paste0("B. GWR (pasmo: ", bw, " powiatów)")) + mapa + motyw + bez_osi
p6 <- (p6a + p6b) + plot_layout(guides = "collect") &
  theme(legend.position = "bottom") & guides(fill = guide_colourbar(barwidth = 16, barheight = 0.6, title.position = "top"))
p6   # zapis: ggsave("fotowoltaika-gwr-mapa.svg", p6, width = 10, height = 5.6)
Wynik w R
Pasmo adaptacyjne: 34 najbliższych powiatów
AICc: OLS 491 | GWR 443.9 | efektywna liczba parametrów GWR: 31.8
Lokalny efekt +10 pp domów: od -0.07 do 2.7 | OLS (jeden dla wszystkich): 1.79
Korelacja z prawdziwym lokalnym efektem: r = .73
Średni efekt +10 pp: południe (3 dolne rzędy) GWR 2.04 prawda 2.13 | północ (3 górne rzędy) GWR 0.93 prawda 0.54

Tests based on the Monte Carlo significance test

            p-value
(Intercept)    0.00
domy           0.00
dochod         0.04
7. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("skupisko WW – skupisko NN" = c("#D55E00", "#0072B2"), "WW – WN (odstający wysoki)" = c("#D55E00", "#E69F00"),
             "NN – NW (odstający niski)" = c("#0072B2", "#56B4E9"), "WN – NW" = c("#E69F00", "#56B4E9"),
             "OLS – błąd przestrzenny" = c("grey55", "#0072B2"), "błąd – opóźnienie" = c("#0072B2", "#D55E00"),
             "cividis: dół – góra skali" = viridisLite::cividis(2),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  k <- rgb(t(col2rgb(k)), maxColorValue = 255)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(rgb(t(col2rgb(k)), maxColorValue = 255))),
                                   protanopia = roznica(protan(rgb(t(col2rgb(k)), maxColorValue = 255)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
skupisko WW – skupisko NN                  114.6        108.3       91.9
WW – WN (odstający wysoki)                  33.4         18.4       24.9
NN – NW (odstający niski)                   26.4         24.7       24.6
WN – NW                                    113.1        111.4      101.5
OLS – błąd przestrzenny                     43.2         47.1       39.2
błąd – opóźnienie                          114.6        108.3       91.9
cividis: dół – góra skali                  135.2        134.0      136.7
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Siatkę powiatów zbudowano pakietem sf, sąsiedztwo, I Morana i LISA policzono pakietem spdep, modele z opóźnieniem i z błędem przestrzennym – pakietem spatialreg, a GWR – pakietem GWmodel; OLS to funkcja lm() z pakietu stats. Rysunki wykonano w pakiecie ggplot2 (skala cividis z pakietu viridisLite), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sf (wersja 1.1.3): Pebesma, E. (2018). Simple features for R: Standardized support for spatial vector data. The R Journal, 10(1), 439–446. https://doi.org/10.32614/RJ-2018-009
- spdep (wersja 1.4-2): Bivand, R. (2026). spdep: Spatial dependence: Weighting schemes, statistics (R package version 1.4-2) [Computer software]. https://CRAN.R-project.org/package=spdep
- spatialreg (wersja 1.4-3): Bivand, R., & Piras, G. (2015). Comparing implementations of estimation methods for spatial econometrics. Journal of Statistical Software, 63(18), 1–36. https://doi.org/10.18637/jss.v063.i18
- GWmodel (wersja 2.4-1): Lu, B., Harris, P., Charlton, M., Brunsdon, C., & Nakaya, T. (2024). GWmodel: Geographically-weighted models (R package version 2.4-1) [Computer software]. https://CRAN.R-project.org/package=GWmodel
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [Computer software]. https://doi.org/10.5281/zenodo.4678326
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Małe powiaty. Skrajne kolory i część skupisk to szum małych mianowników. Pokaż lejek albo modeluj liczbę instalacji (np. regresja dwumianowa z wagą liczby gospodarstw).
- Wybór sąsiedztwa po wyniku. I spadło z 0.47 do 0.35 przy szerszym sąsiedztwie. Zmienianie macierzy, aż wynik będzie „lepszy”, to ukryte wielokrotne porównania.
- „Efekt sąsiada” to nie zawsze naśladownictwo. Istotne ρ wychodzi też wtedy, gdy podobni klienci po prostu mieszkają blisko siebie. Bez eksperymentu nie odróżnisz korelacji od przyczynowości.
- Mapa LISA jako lista celów. Bez poprawki na 120 testów część skupisk pojawi się przypadkiem; po FDR tu nie zostało nic.
- Przeuczona GWR. Wąskie pasmo dopasowuje szum (przeuczenie). Patrz na AICc, test Monte Carlo i spójność plam z wiedzą o rynku, a nie na pojedyncze powiaty na brzegu mapy.
- Prawdziwe granice. Na realnej mapie wynik zależy też od podziału na jednostki: powiaty dadzą inny obraz niż gminy. Gdy interesuje cię ciągła powierzchnia, a nie obszary, sięga się po kriging.
Najczęstsze pytania
Jak sprawdzić, czy sprzedaż w regionach tworzy skupiska na mapie?
Policz globalne I Morana dla wyniku na mieszkańca lub gospodarstwo i sprawdź je testem permutacyjnym: przetasuj wyniki między obszarami, np. 999 razy, i zobacz, jak często I jest co najmniej tak duże. W przykładzie I = 0.47, a największe I z permutacji 0.159, więc p = .001. Najpierw jednak ustal, kto jest sąsiadem – od tego zależy wynik.
Jak czytać mapę skupisk LISA w analizie sprzedaży?
LISA daje każdemu obszarowi lokalne I Morana i typ: wysoki wśród wysokich (WW), niski wśród niskich (NN) albo odstający od sąsiadów (WN, NW). W przykładzie przy p < .05 było 14 powiatów WW i 13 NN, ale to 120 testów naraz: po korekcie Benjaminiego–Hochberga nie został żaden. Traktuj mapę jako wskazówkę, gdzie patrzeć.
Model z opóźnieniem przestrzennym czy z błędem przestrzennym?
Model z opóźnieniem zakłada, że wynik obszaru zależy od wyników sąsiadów, a model z błędem – że skorelowane są tylko reszty, np. przez pominięty czynnik regionalny. Porównaj AIC i autokorelację reszt. W przykładzie lepszy był model z błędem (AIC = 462.6 wobec 465.6), a istotne ρ w modelu z opóźnieniem pojawiało się w 98% danych bez żadnego naśladownictwa.
Kiedy w marketingu użyć regresji geograficznie ważonej (GWR)?
Gdy podejrzewasz, że ten sam czynnik działa różnie w różnych regionach, np. odsetek domów jednorodzinnych mocniej podnosi sprzedaż na południu. W przykładzie GWR z pasmem 34 powiatów miała AICc 443.9 wobec 491.0 dla OLS, a lokalny efekt +10 pp domów wahał się od −0.07 do 2.70. Pamiętaj, że plamy mogą też wynikać z pominiętej zmiennej.
Jak wybrać macierz wag przestrzennych dla powiatów?
Najczęściej sąsiad to obszar ze wspólną granicą, a wagi standaryzuje się wierszami (każdy sąsiad dostaje 1 / liczba sąsiadów). Inne opcje to k najbliższych obszarów albo odległość. W przykładzie I Morana wyniosło 0.469 przy wspólnej granicy, 0.472 przy 4 najbliższych i 0.346 przy dwóch pierścieniach sąsiadów – wybierz macierz przed analizą i uzasadnij ją w pracy.
Powiązane hasła
Przeczytaj też
Gdzie otworzyć sklep – model Huffa
Sieć sklepów ogrodniczych i trzy działki: model Huffa z kart lojalnościowych, mapa udziałów, kanibalizacja, bootstrap i pułapka linii prostej – sześć rysunków z kodem R.
Czytaj →PoradnikModel atrakcyjności udziałów (MCI)
Rynek proszków do prania: udział jako atrakcyjność, log-centrowanie, elastyczności krzyżowe, symulacja obniżki ceny i logit udziałów – z kodem R.
Czytaj →PoradnikGeo-eksperyment – plan testu w regionach
40 regionów, pary z historii sprzedaży, losowanie w parach, analiza z poziomem sprzed testu i krzywe mocy – sześć rysunków z kodem R.
Czytaj →Analizujesz sprzedaż w regionach albo dane przestrzenne w pracy?
Pomożemy zdefiniować sąsiedztwo, policzyć I Morana i LISA, dobrać model przestrzenny lub GWR oraz opisać wyniki i ich ograniczenia tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Anselin, L. (1995). Local indicators of spatial association—LISA. Geographical Analysis, 27(2), 93–115. https://doi.org/10.1111/j.1538-4632.1995.tb00338.x ● Otwarty dostęp
- Brunsdon, C., Fotheringham, A. S., & Charlton, M. E. (1996). Geographically weighted regression: A method for exploring spatial nonstationarity. Geographical Analysis, 28(4), 281–298. https://doi.org/10.1111/j.1538-4632.1996.tb00936.x ● Otwarty dostęp
- Dormann, C. F., McPherson, J. M., Araújo, M. B., Bivand, R., Bolliger, J., Carl, G., Davies, R. G., Hirzel, A., Jetz, W., Kissling, W. D., Kühn, I., Ohlemüller, R., Peres-Neto, P. R., Reineking, B., Schröder, B., Schurr, F. M., & Wilson, R. (2007). Methods to account for spatial autocorrelation in the analysis of species distributional data: A review. Ecography, 30(5), 609–628. https://doi.org/10.1111/j.2007.0906-7590.05171.x ● Otwarty dostęp: pełny tekst
- Gelman, A., & Price, P. N. (1999). All maps of parameter estimates are misleading. Statistics in Medicine, 18(23), 3221–3234. https://doi.org/10.1002/(sici)1097-0258(19991215)18:23<3221::aid-sim312>3.0.co;2-m
- Gollini, I., Lu, B., Charlton, M., Brunsdon, C., & Harris, P. (2015). GWmodel: An R package for exploring spatial heterogeneity using geographically weighted models. Journal of Statistical Software, 63(17). https://doi.org/10.18637/jss.v063.i17 ● Otwarty dostęp
- Moran, P. A. P. (1950). Notes on continuous stochastic phenomena. Biometrika, 37(1–2), 17–23. https://doi.org/10.1093/biomet/37.1-2.17
Cytowania BibTeX
@article{anselin1995local, author={Anselin, Luc}, title={{Local indicators of spatial association—LISA}}, journal={Geographical Analysis}, year={1995}, volume={27}, number={2}, pages={93--115}, doi={10.1111/j.1538-4632.1995.tb00338.x}}@article{brunsdon1996geographically, author={Brunsdon, Chris and Fotheringham, A. Stewart and Charlton, Martin E.}, title={{Geographically weighted regression: A method for exploring spatial nonstationarity}}, journal={Geographical Analysis}, year={1996}, volume={28}, number={4}, pages={281--298}, doi={10.1111/j.1538-4632.1996.tb00936.x}}@article{dormann2007methods, author={Dormann, Carsten F. and McPherson, Jana M. and Araújo, Miguel B. and Bivand, Roger and Bolliger, Janine and Carl, Gudrun and Davies, Richard G. and Hirzel, Alexandre and Jetz, Walter and Kissling, W. Daniel and Kühn, Ingolf and Ohlemüller, Ralf and Peres-Neto, Pedro R. and Reineking, Björn and Schröder, Boris and Schurr, Frank M. and Wilson, Robert}, title={{Methods to account for spatial autocorrelation in the analysis of species distributional data: A review}}, journal={Ecography}, year={2007}, volume={30}, number={5}, pages={609--628}, doi={10.1111/j.2007.0906-7590.05171.x}}@article{gelman1999all, author={Gelman, Andrew and Price, Phillip N.}, title={{All maps of parameter estimates are misleading}}, journal={Statistics in Medicine}, year={1999}, volume={18}, number={23}, pages={3221--3234}, doi={10.1002/(sici)1097-0258(19991215)18:23<3221::aid-sim312>3.0.co;2-m}}@article{gollini2015gwmodel, author={Gollini, Isabella and Lu, Binbin and Charlton, Martin and Brunsdon, Christopher and Harris, Paul}, title={{GWmodel: An R package for exploring spatial heterogeneity using geographically weighted models}}, journal={Journal of Statistical Software}, year={2015}, volume={63}, number={17}, doi={10.18637/jss.v063.i17}}@article{moran1950notes, author={Moran, Patrick A. P.}, title={{Notes on continuous stochastic phenomena}}, journal={Biometrika}, year={1950}, volume={37}, number={1–2}, pages={17--23}, doi={10.1093/biomet/37.1-2.17}}