Przykład: sieć sklepów ogrodniczych i trzy działki
Fikcyjna sieć sklepów ogrodniczych ma w mieście dwa sklepy (N1, N2) i chce otworzyć trzeci. Do wyboru są działki: A w gęsto zabudowanej części zachodniej, B za rzeką, wśród domów jednorodzinnych, i C na północno-zachodnim skraju. Działają też cztery sklepy konkurencji (K1–K4), w tym duży market budowlany (K3). Zarząd pyta: w której lokalizacji nowy sklep da sieci najwięcej dodatkowego przychodu – po odjęciu tego, co zabierze naszym własnym sklepom?
Narzędziem jest model Huffa – najprostszy model „przyciągania” klientów przez sklepy. Huff (1964) pytał, czym właściwie jest obszar handlowy sklepu i jak go zdefiniować, żeby dało się to sprawdzić w danych. Model nazwany jego imieniem zamiast linii na mapie podaje prawdopodobieństwa: mieszkaniec każdego osiedla może pojechać do każdego sklepu, tylko z różną szansą. Szansa rośnie z atrakcyjnością sklepu (tu: powierzchnią sprzedaży) i maleje z czasem dojazdu:
Słowami: udział sklepu w zakupach osiedla to jego „siła” (powierzchniaα × czas−β) podzielona przez sumę sił wszystkich sklepów. α mówi, jak bardzo liczy się wielkość sklepu, β – jak szybko chęć dojazdu spada z czasem. Obie liczby trzeba oszacować z danych.
Dane są fikcyjne, więc znamy prawdę. Miasto to siatka 6 × 5 osiedli po 1 km: na zachodzie bloki (1200–2600 gospodarstw, ok. 350 zł rocznie na ogród i balkon), na wschodzie domy (450–900 gospodarstw, ok. 900 zł). Rzeka ma jeden most, na południu. Czas dojazdu = 3 min + 2.4 min na kilometr drogi. W danych ukryliśmy α = 1 i β = 2. W aplikacji lojalnościowej sieci klienci rejestrują paragony z dowolnego sklepu ogrodniczego; mamy 2400 gospodarstw z osiedlem i sklepem ostatnich wiosennych zakupów. Parametry miasta i sklepów ustawiliśmy ręcznie, a most przesunęliśmy na południe po pierwszych próbach, żeby pułapka z rysunku 6 była wyraźna. Ziarna 652 nie zmieniano. Dane pobierzesz jako lokalizacja-sklepu-karty-lojalnosciowe.csv (wiersz = gospodarstwo z kartą).
Rysunek 1: miasto w 30 kratkach
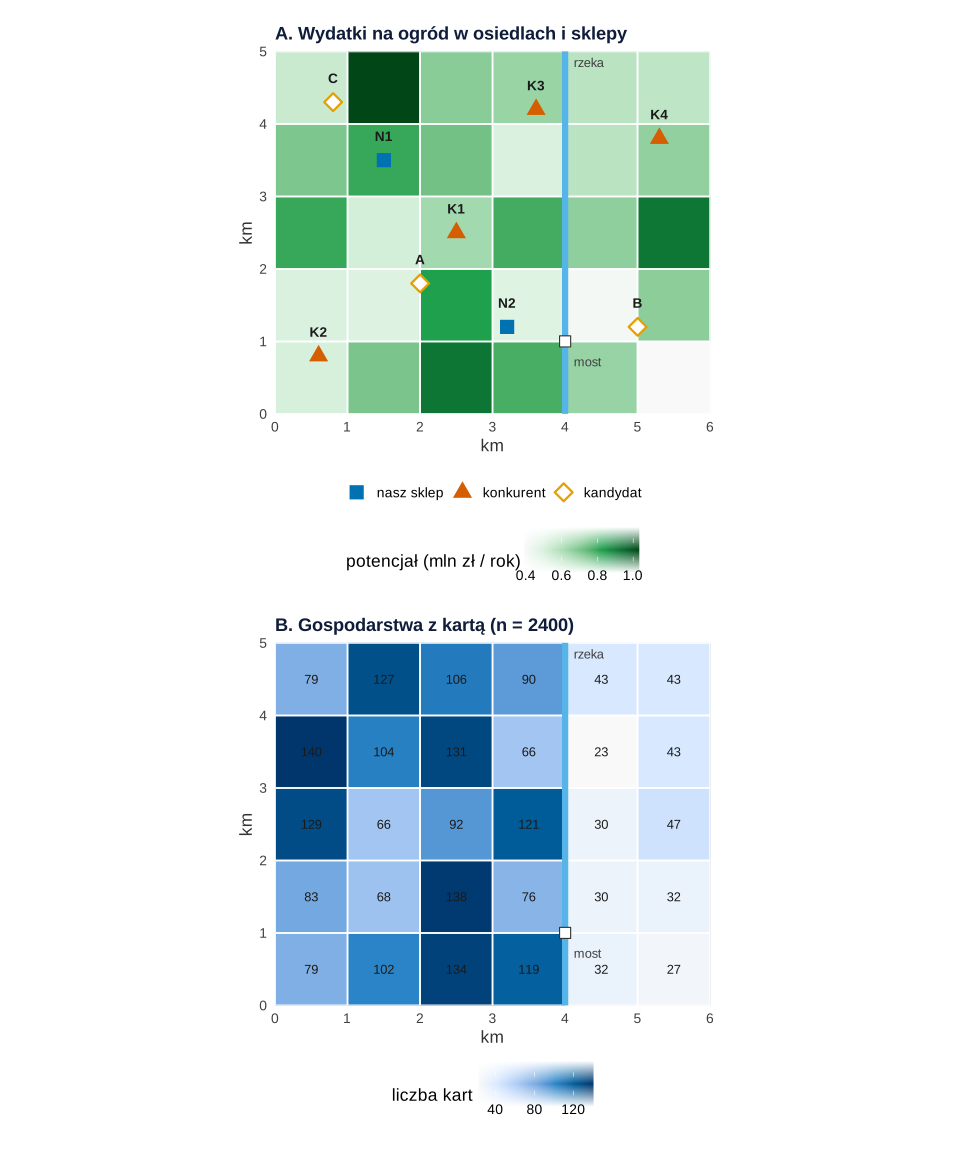
set.seed(652)).Co widać. Panel A to potencjał rynku (gospodarstwa × wydatki): razem 45 320 gospodarstw i 19.53 mln zł rocznie, z czego 31.0% na wschodnim brzegu, gdzie mieszka znacznie mniej ludzi i jest tylko mały konkurent K4. Panel B pokazuje, ile kart mamy z każdego osiedla: na wschodzie 23–47, na zachodzie 66–140. W kartach 26.8% ostatnich zakupów przypadło na K1, 28.1% na K3, a nasze dwa sklepy razem miały 31.3%.
Jak może zmylić. Wszyscy mieszkańcy kratki „startują” z jej środka; w prawdziwej analizie jednostkami są rejony statystyczne albo kody pocztowe, a wynik zależy od ich granic. Kolor to potencjał, nie gęstość zaludnienia. To odmiana kartogramu na regularnej siatce.
Podpis do pracy:
Rysunek 2: skąd wziąć α i β – wiarygodność wielomianowa
Każde gospodarstwo z kartą wybrało jeden z sześciu sklepów. Model Huffa daje dla jego osiedla sześć prawdopodobieństw, więc wybór ma rozkład wielomianowy. Logarytm wiarygodności to suma po osiedlach i sklepach: liczba kart z osiedla i w sklepie j razy log Pij. Szukamy takich α i β, przy których zaobserwowane wybory są najbardziej prawdopodobne – to metoda największej wiarygodności, którą dla modelu Huffa opisali Haines, Simon i Alexis (1972). W R wystarczy optim() z ujemną log-wiarygodnością; błędy standardowe daje macierz drugich pochodnych (hessian = TRUE). Starsza droga to estymacja metodą najmniejszych kwadratów dla multiplikatywnych modeli tego typu (Nakanishi i Cooper, 1974); przy danych o pojedynczych wyborach wiarygodność wielomianowa korzysta wprost z liczebności, także zerowych.
Model Huffa to wielomianowy model logitowy z cechami sklepów (log powierzchni, log czasu) i wspólnymi współczynnikami – jak warunkowa regresja logistyczna we wpisie o conjoincie wyborczym.
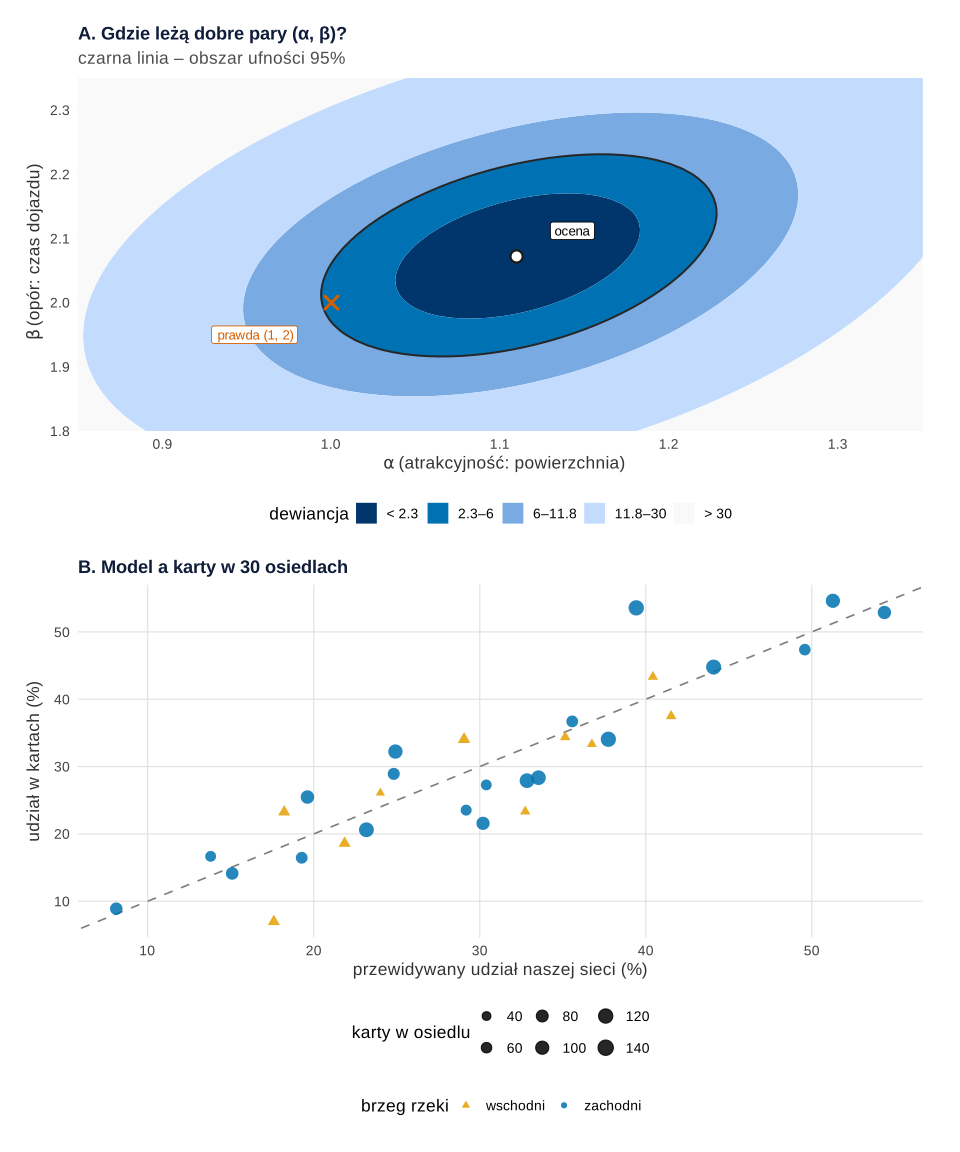
optim(), ggplot2 i patchwork (dane symulowane, set.seed(652)).Co widać – panel A. Ocena to α = 1.11 (SE = 0.048; 95% CI [1.02, 1.20]) i β = 2.07 (SE = 0.064; 95% CI [1.95, 2.20]). Kolory pokazują dewiancję – o ile gorzej pasuje model przy innej parze (α, β); czarna linia to wspólny obszar ufności 95%. Prawdziwa para (1, 2) leży w nim, choć przedział dla samego α minimalnie ją omija – co dwudziesty przedział 95% tak ma. Elipsa jest pochylona, bo oceny są skorelowane (r = .40).
Co widać – panel B. Przewidywany udział naszej sieci w osiedlach zgadza się z kartami – punkty leżą wokół przekątnej, z większym rozrzutem tam, gdzie kart jest mało. Pseudo-R² McFaddena wynosi .213 – w modelach wyboru ta miara jest zwykle dużo niższa niż R² w regresji liniowej, więc nie porównuj jej z tamtą skalą (zob. pseudo-R²). Sprawdziliśmy też, czy błędy modelu skupiają się w sąsiednich osiedlach: I Morana dla reszt wynosi −0.214 (wartość oczekiwana −0.034; p = .130 w teście permutacyjnym z 999 permutacji). Skupisko reszt jednego znaku sugerowałoby brakujący czynnik (parking, tramwaj), a różny opór odległości w częściach miasta – lokalne parametry, jak w regresji geograficznie ważonej.
Jak może zmylić. Wąskie przedziały mówią tylko o losowości próby kart, nie o tym, czy wzór Huffa jest dobry.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: jak osiedle dzieli swoje wydatki
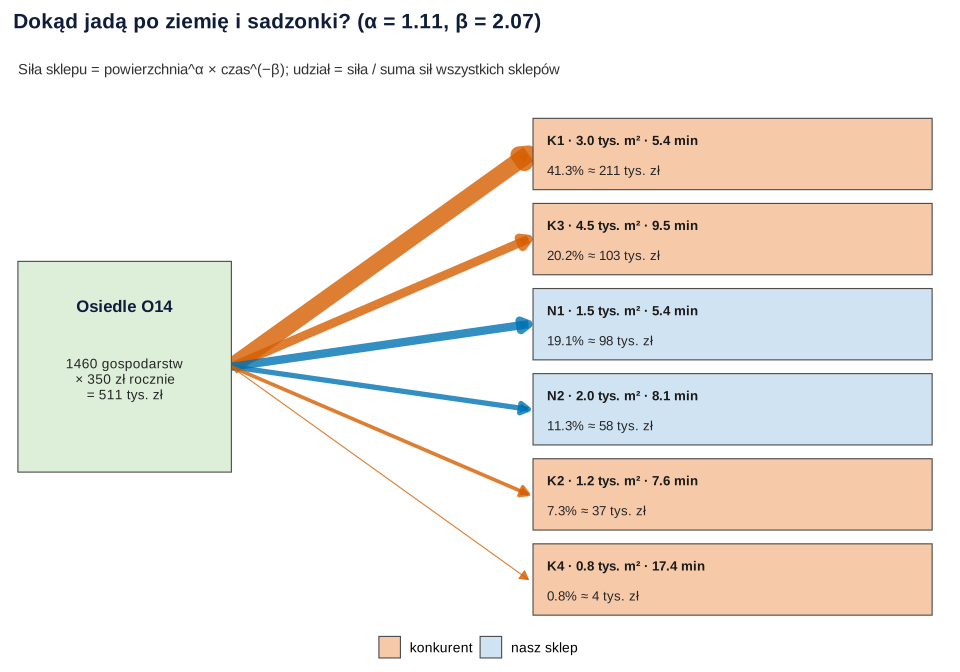
Co widać. Osiedle O14 (1460 gospodarstw × 350 zł = 511 tys. zł rocznie) leży tak samo daleko od naszego N1 i od konkurenta K1 – po 5.4 minuty. K1 ma jednak dwa razy większą powierzchnię (3.0 wobec 1.5 tys. m²), więc przy α = 1.11 przyciąga 41.3% wydatków osiedla (ok. 211 tys. zł), a N1 – 19.1% (98 tys. zł). Duży K3 jest prawie dwa razy dalej (9.5 min), a bierze 20.2%. Przychód sklepu to suma takich kwot ze wszystkich 30 osiedli.
Jak może zmylić. Model zakłada stałe wydatki osiedla – nowy sklep dzieli istniejący „tort”, a nie powiększa go.
Podpis do pracy:
Rysunek 4: mapa udziałów przed i po otwarciu
Teraz dokładamy do modelu nowy sklep (2 tys. m²) kolejno w lokalizacjach A, B i C i liczymy udziały od nowa. Dziś według modelu N1 ma 2.39 mln zł przychodu rocznie, a N2 – 3.68 mln zł.
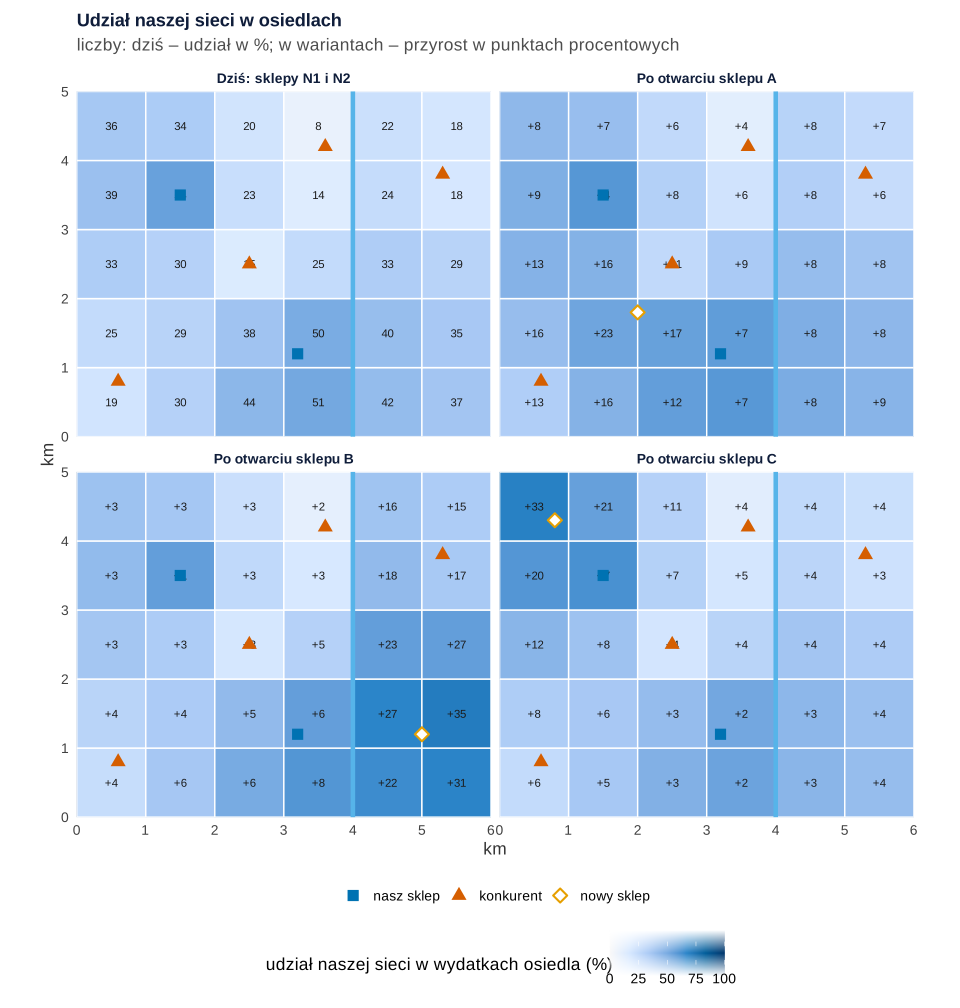
set.seed(652)).Co widać. Pierwszy panel to udział naszej sieci dziś: najwyższy wokół N2 (do 51%), najniższy przy K3 na północy (8%). W pozostałych panelach liczby w kratkach to przyrost udziału naszej sieci w punktach procentowych. A dodaje najwięcej w centrum zachodu (do +23 pkt), gdzie już jesteśmy silni; B – na całym wschodnim brzegu (+15 do +35 pkt), gdzie wydaje się najwięcej; C – na północnym zachodzie (do +33 pkt).
Jak może zmylić. Przyrost udziału to nie przyrost przychodu: 10 punktów w osiedlu wydającym 1 mln zł znaczy więcej niż 20 w osiedlu wydającym 300 tys. zł. Mapa nie pokazuje też, ile nowy sklep zabrał naszym sklepom.
Podpis do pracy:
Rysunek 5: przychód, kanibalizacja i niepewność
Dla każdej lokalizacji liczymy trzy liczby: przychód nowego sklepu, kanibalizację (o ile spadnie przychód N1 i N2) i przyrost przychodu całej sieci = przychód nowego − kanibalizacja. Niepewność parametrów przenosimy na przychody bootstrapem (Efron, 1979): 1000 razy losujemy ze zwracaniem 2400 gospodarstw, szacujemy α i β i liczymy przychody. Przedziały percentylowe parametrów prawie pokrywają się z przedziałami Walda: α [1.02, 1.21], β [1.96, 2.21].
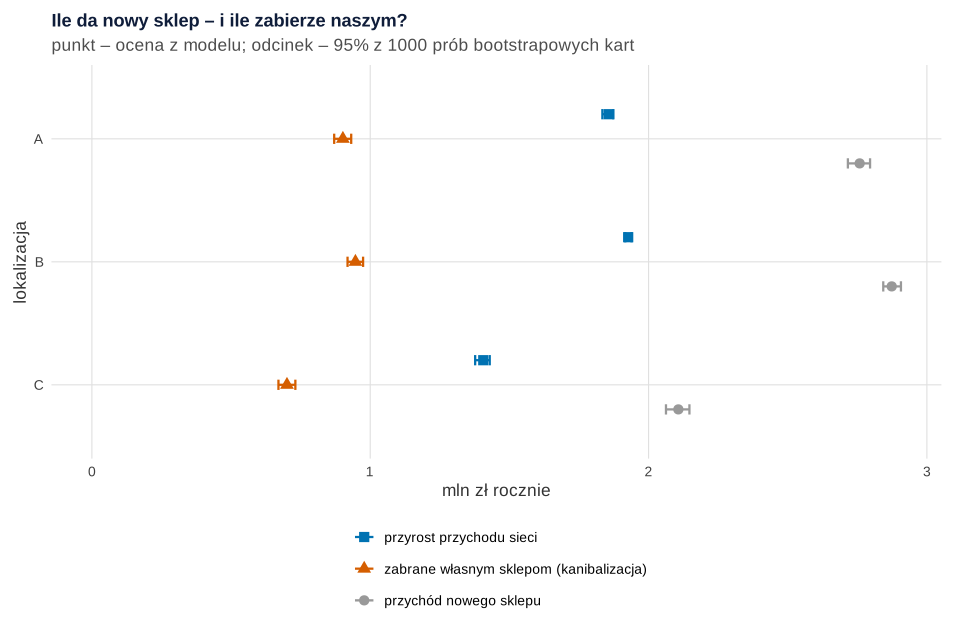
set.seed(652), 1000 prób).Co widać. Najwięcej przychodu dałby sklep B: 2.87 mln zł rocznie (95% CI [2.84, 2.91]), ale 0.95 mln zł [0.92, 0.97] z tego zabrałby naszym sklepom, głównie N2 (0.73 mln zł), do którego mieszkańcy wschodu jeżdżą dziś przez most. Przyrost sieci: B 1.93 mln zł [1.92, 1.94], A 1.86 mln zł [1.83, 1.87], C 1.41 mln zł [1.38, 1.43]. We wszystkich trzech wariantach kanibalizacja to ok. jednej trzeciej przychodu nowego sklepu (32.7–33.3%). B wygrał we wszystkich 1000 próbach bootstrapowych, a różnica B − A wynosi 71 tys. zł rocznie (95% CI [43, 104] tys. zł).
Jak może zmylić. Przedziały są wąskie, bo obejmują tylko losowość kart – bez niepewności potencjału rynku, reakcji konkurencji i błędu wzoru. Przyrost sieci jest tu z definicji równy temu, co zabierzemy konkurencji, bo rynek się nie powiększa. Kanibalizację z modelu warto po otwarciu porównać z rzeczywistą – jak to zrobić, pokazuje wpis kanibalizacja po otwarciu nowego lokalu – różnica w różnicach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: pułapka – odległość w linii prostej
Częsty skrót: zamiast czasu dojazdu wziąć odległość w linii prostej ze współrzędnych. Co by się stało, gdyby analityk nie wiedział o rzece?
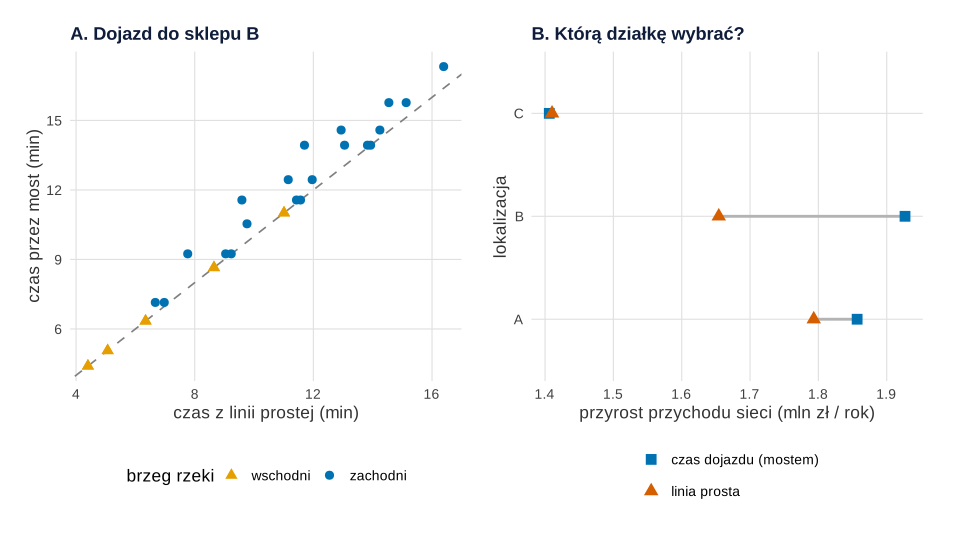
set.seed(652)).Co widać. Panel A: z zachodu dojazd do działki B przez most trwa dłużej, niż wynika z linii prostej (to samo dotyczy dojazdu ze wschodu do sklepów zachodu). Model z linią prostą pasuje do kart wyraźnie gorzej (log-wiarygodność −3447.5 wobec −3386.2; AIC 6899.1 wobec 6776.4), a jego parametry (α = 0.97, β = 2.10) wyglądają niewinnie. Groźny jest panel B: według linii prostej najlepsza jest działka A (przyrost 1.79 mln zł), a B spada na drugie miejsce (1.65 mln zł zamiast 1.93). Model „nie widzi”, że wschodni brzeg jest odcięty od konkurencji.
Jak może zmylić. Różnica między metrykami (0.28 mln zł dla B) jest kilkanaście razy większa niż szerokość przedziału bootstrapowego. Źle zmierzona odległość to błąd specyfikacji – żaden bootstrap go nie pokaże.
Podpis do pracy:
Co z tym zrobić w firmie
- Wybierz B, ale z warunkami. Działka B daje sieci najwięcej (ok. 1.93 mln zł rocznie), mimo że jedna trzecia jej przychodu to klienci przejęci od N2. Obniż z góry plan sprzedaży N2.
- Licz przyrost sieci, nie przychód nowego sklepu – różnica to 0.7–0.95 mln zł rocznie.
- Licz czasy dojazdu po drogach (rzeki, tory, korki) – tu ta decyzja zmieniła ranking.
- Przetestuj założenia. Policz wariant z innym potencjałem wschodu, z ruchem konkurencji (np. K4 się powiększa) i z innym β – to analiza wrażliwości. Przychód wstaw potem do rachunku inwestycji, jak we wpisie symulacja Monte Carlo opłacalności projektu.
- Po otwarciu porównaj karty z mapą z rysunku 4 i przelicz α i β.
Jak opisać w pracy
W Metodzie podaj jednostki przestrzenne i potencjał, miary atrakcyjności i odległości, źródło danych o wyborach, metodę estymacji i sposób liczenia niepewności. W Wynikach – α i β z przedziałami, dopasowanie, przychody wariantów z kanibalizacją i porównanie miar odległości. Ogólny układ takiej pracy opisuje jak napisać pracę z zarządzania i ekonomii, a inne metody dla tej dziedziny – statystyka w pracy z zarządzania i ekonomii.
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Kod R: model Huffa, optim, bootstrap i mapy
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, miasto, karty i funkcje, z których korzystają kolejne. Model Huffa liczymy bez specjalnych pakietów – ujemną log-wiarygodność minimalizuje funkcja optim() z bazowego R. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (osiedla i karty), 2 (test permutacyjny I Morana) i 5 (bootstrap); każdy zaczyna losowanie od własnego set.seed(652). Ziarno 652 ustalono raz i nie zmieniano go. Ręcznie ustalono: siatkę 6 × 5 osiedli po 1 km, liczbę gospodarstw (1200–2600 na zachodzie, 450–900 na wschodzie) i wydatki (350 i 900 zł rocznie, rozrzut SD 0.15 w skali logarytmu), położenie i powierzchnię sześciu sklepów oraz trzech kandydatów (po 2 tys. m²), rzekę na x = 4 km z jednym mostem w punkcie (4, 1) – most przesunęliśmy na południe po pierwszych próbach, żeby pułapka z rysunku 6 była wyraźna – wzór czasu dojazdu (3 min + 2.4 min/km), prawdziwe α = 1 i β = 2, liczbę kart (2400) i liczbę prób bootstrapowych (1000). Całość liczy się w kilka sekund.
1. Miasto, sklepy, czasy dojazdu i karty: Rysunek 1
R
# Rysunek 1. Fikcyjne miasto w 30 kratkach: osiedla, sklepy ogrodnicze, rzeka i dane z kart lojalnościowych
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(nasz = "#0072B2", konkurent = "#D55E00", kandydat = "#E69F00", rzeka = "#56B4E9",
         zielony = "#009E73", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Miasto: siatka 6 × 5 osiedli po 1 km; rzeka płynie z północy na południe na x = 4 km,
# jedyny most stoi na południu, w punkcie (4, 1). Parametry miasta i sklepów ustalone ręcznie.
osiedla <- expand.grid(kol_x = 1:6, rzad_y = 1:5)
osiedla$osiedle <- sprintf("O%02d", seq_len(nrow(osiedla)))
osiedla$x <- osiedla$kol_x - 0.5
osiedla$y <- osiedla$rzad_y - 0.5
osiedla$brzeg <- ifelse(osiedla$x < 4, "zachodni", "wschodni")
set.seed(652)
# zachód: bloki (1200–2600 gospodarstw, ok. 350 zł rocznie na ogród i balkon),
# wschód: domy jednorodzinne (450–900 gospodarstw, ok. 900 zł rocznie)
osiedla$gospodarstwa <- round(ifelse(osiedla$brzeg == "zachodni", runif(30, 1200, 2600), runif(30, 450, 900)), -1)
osiedla$wydatki <- round(ifelse(osiedla$brzeg == "zachodni", 350, 900) * exp(rnorm(30, 0, 0.15)), -1)
osiedla$potencjal <- osiedla$gospodarstwa * osiedla$wydatki            # zł rocznie

sklepy <- data.frame(
  sklep = c("N1", "N2", "K1", "K2", "K3", "K4"),
  typ = c("nasz", "nasz", "konkurent", "konkurent", "konkurent", "konkurent"),
  x = c(1.5, 3.2, 2.5, 0.6, 3.6, 5.3), y = c(3.5, 1.2, 2.5, 0.8, 4.2, 3.8),
  powierzchnia = c(1.5, 2.0, 3.0, 1.2, 4.5, 0.8))                    # tys. m² sprzedaży
kandydaci <- data.frame(sklep = c("A", "B", "C"), typ = "kandydat",
                        x = c(2.0, 5.0, 0.8), y = c(1.8, 1.2, 4.3), powierzchnia = 2.0)

# Czas dojazdu (min): 3 min na start + 2.4 min na każdy km drogi; przez rzekę tylko mostem
most <- c(4, 1)
czas_dojazdu <- function(ox, oy, sx, sy) {
  euk <- function(x1, y1, x2, y2) sqrt((x1 - x2)^2 + (y1 - y2)^2)
  przez_rzeke <- (ox < 4) != (sx < 4)
  droga <- ifelse(przez_rzeke, euk(ox, oy, most[1], most[2]) + euk(most[1], most[2], sx, sy),
                  euk(ox, oy, sx, sy))
  3 + 2.4 * droga
}
macierz <- function(sk, f) outer(seq_len(nrow(osiedla)), seq_len(nrow(sk)),
                                 function(i, j) f(osiedla$x[i], osiedla$y[i], sk$x[j], sk$y[j]))
T_czas <- macierz(sklepy, czas_dojazdu)                               # 30 × 6, minuty
dimnames(T_czas) <- list(osiedla$osiedle, sklepy$sklep)

# Model Huffa: P(osiedle i wybiera sklep j) = A_j^alfa · t_ij^(−beta) / suma po sklepach
huff <- function(alfa, beta, A, Tm) {
  u <- sweep(Tm^(-beta), 2, A^alfa, "*")
  u / rowSums(u)
}
# Prawdziwe parametry ukryte w danych: alfa = 1.0, beta = 2.0 (czas dojazdu w minutach)
P_prawd <- huff(1.0, 2.0, sklepy$powierzchnia, T_czas)

# Karty lojalnościowe: 2400 losowych gospodarstw (aplikacja z rejestracją paragonów
# z dowolnego sklepu ogrodniczego) – osiedle i sklep ostatnich zakupów wiosną
set.seed(652)
n_kart <- 2400
os_karty <- sample(seq_len(nrow(osiedla)), n_kart, replace = TRUE, prob = osiedla$gospodarstwa)
wybor <- vapply(os_karty, function(i) sample(sklepy$sklep, 1, prob = P_prawd[i, ]), character(1))
karty <- data.frame(id = seq_len(n_kart), osiedle = osiedla$osiedle[os_karty], sklep = wybor)
write.csv(merge(karty, osiedla[, c("osiedle", "x", "y", "brzeg", "gospodarstwa", "wydatki")], by = "osiedle")[
  , c("id", "osiedle", "x", "y", "brzeg", "gospodarstwa", "wydatki", "sklep")],
  "lokalizacja-sklepu-karty-lojalnosciowe.csv", row.names = FALSE)

# Przegląd: potencjał rynku, wybory w kartach, nasz udział
c(gospodarstwa = sum(osiedla$gospodarstwa), potencjal_mln_zl = round(sum(osiedla$potencjal) / 1e6, 2),
  potencjal_wschod_proc = round(100 * sum(osiedla$potencjal[osiedla$brzeg == "wschodni"]) / sum(osiedla$potencjal), 1))
round(100 * prop.table(table(factor(karty$sklep, levels = sklepy$sklep))), 1)
c(nasz_udzial_w_kartach_proc = round(100 * mean(karty$sklep %in% c("N1", "N2")), 1))

# Rysunek 1: A – potencjał osiedli i położenie sklepów; B – liczba kart na osiedle
wszystkie <- rbind(sklepy, kandydaci)
wszystkie$rola <- factor(c(nasz = "nasz sklep", konkurent = "konkurent", kandydat = "kandydat")[wszystkie$typ],
                         levels = c("nasz sklep", "konkurent", "kandydat"))
warstwa_rzeki <- list(
  annotate("segment", x = 4, xend = 4, y = 0, yend = 5, colour = kol[["rzeka"]], linewidth = 2.2),
  annotate("point", x = most[1], y = most[2], shape = 22, size = 4, fill = "white", colour = "grey20"),
  annotate("text", x = 4.12, y = 4.85, label = "rzeka", hjust = 0, size = 3.4, colour = "grey25"),
  annotate("text", x = 4.12, y = 0.72, label = "most", hjust = 0, size = 3.4, colour = "grey25"))
p1a <- ggplot(osiedla, aes(x, y)) +
  geom_tile(aes(fill = potencjal / 1e6), colour = "white", linewidth = 0.6) +
  warstwa_rzeki +
  geom_point(data = wszystkie, aes(shape = rola, colour = rola), size = 4.2, stroke = 1.2, fill = "white") +
  geom_text(data = wszystkie, aes(label = sklep), nudge_y = 0.33, size = 3.6, fontface = "bold", colour = "grey10") +
  scale_fill_gradientn(colours = colorspace::sequential_hcl(7, "Greens 3", rev = TRUE), name = "potencjał (mln zł / rok)") +
  scale_shape_manual(values = c("nasz sklep" = 15, "konkurent" = 17, "kandydat" = 23), name = NULL) +
  scale_colour_manual(values = c("nasz sklep" = kol[["nasz"]], "konkurent" = kol[["konkurent"]],
                                 "kandydat" = kol[["kandydat"]]), name = NULL) +
  coord_equal(expand = FALSE) + labs(x = "km", y = "km", title = "A. Wydatki na ogród w osiedlach i sklepy") +
  motyw + theme(legend.box = "vertical")
liczba_kart <- as.data.frame(table(osiedle = karty$osiedle), responseName = "karty")
liczba_kart <- merge(osiedla, liczba_kart, by = "osiedle")
p1b <- ggplot(liczba_kart, aes(x, y)) +
  geom_tile(aes(fill = karty), colour = "white", linewidth = 0.6) +
  geom_text(aes(label = karty), size = 3.4, colour = "grey10") +
  warstwa_rzeki +
  scale_fill_gradientn(colours = colorspace::sequential_hcl(7, "Blues 3", rev = TRUE), name = "liczba kart",
                       breaks = c(40, 80, 120)) +
  coord_equal(expand = FALSE) + labs(x = "km", y = "km", title = "B. Gospodarstwa z kartą (n = 2400)") + motyw
p1 <- p1a / p1b
p1   # zapis: ggsave("lokalizacja-sklepu-mapa-miasta.svg", p1, width = 10, height = 12)
Wynik w R
         gospodarstwa      potencjal_mln_zl potencjal_wschod_proc
             45320.00                 19.53                 31.00

  N1   N2   K1   K2   K3   K4
13.5 17.9 26.8  9.0 28.1  4.8
nasz_udzial_w_kartach_proc
                      31.3
2. Wiarygodność wielomianowa i optim(): Rysunek 2
R
# Rysunek 2. Dopasowanie modelu Huffa do kart lojalnościowych: wiarygodność wielomianowa i optim()
library(ggplot2)
library(patchwork)

# Tabela liczebności: osiedle (wiersz) × sklep wybrany przez gospodarstwo z kartą (kolumna)
N <- table(factor(karty$osiedle, levels = osiedla$osiedle), factor(karty$sklep, levels = sklepy$sklep))
N <- unclass(N)

# Ujemna log-wiarygodność wielomianowa: −Σ n_ij · log P_ij(alfa, beta)
ujemna_logL <- function(par, Nm = N, A = sklepy$powierzchnia, Tm = T_czas) {
  -sum(Nm * log(huff(par[1], par[2], A, Tm)))
}
fit <- optim(c(alfa = 0.5, beta = 1), ujemna_logL, method = "BFGS", hessian = TRUE)
se <- sqrt(diag(solve(fit$hessian)))
wyniki <- data.frame(parametr = c("alfa", "beta"), prawda = c(1.0, 2.0), ocena = fit$par, SE = se,
                     dolna_95 = fit$par - 1.96 * se, gorna_95 = fit$par + 1.96 * se)
print(wyniki, digits = 3, row.names = FALSE)
c(logL = round(-fit$value, 1), zbieznosc = fit$convergence,
  korelacja_alfa_beta = round(cov2cor(solve(fit$hessian))[1, 2], 2))
alfa_hat <- fit$par[[1]]; beta_hat <- fit$par[[2]]

# Model zerowy (każdy sklep jednakowo prawdopodobny) – pseudo-R² McFaddena
logL0 <- sum(N) * log(1 / ncol(N))
c(pseudo_R2_McFadden = round(1 - (-fit$value) / logL0, 3))

# Dopasowanie w osiedlach: udział naszej sieci (N1 + N2) w kartach vs przewidywany
P_hat <- huff(alfa_hat, beta_hat, sklepy$powierzchnia, T_czas)
dop <- data.frame(osiedla[, c("osiedle", "x", "y", "brzeg")], n = rowSums(N),
                  obserwowany = rowSums(N[, c("N1", "N2")]) / rowSums(N),
                  przewidywany = rowSums(P_hat[, c("N1", "N2")]))
dop$z <- (dop$obserwowany - dop$przewidywany) / sqrt(dop$przewidywany * (1 - dop$przewidywany) / dop$n)
# I Morana dla reszt z: sąsiedzi przez wspólny bok kratki (wagi standaryzowane wierszami)
W <- outer(seq_len(30), seq_len(30), function(i, j)
  as.numeric(abs(osiedla$x[i] - osiedla$x[j]) + abs(osiedla$y[i] - osiedla$y[j]) == 1))
W <- W / rowSums(W)
moran <- function(v) { v <- v - mean(v); (length(v) / sum(W)) * sum(W * outer(v, v)) / sum(v^2) }
set.seed(652)
I_perm <- replicate(999, moran(sample(dop$z)))
c(I_Morana = round(moran(dop$z), 3), oczekiwane = round(-1 / 29, 3),
  p_permutacyjne = round((1 + sum(abs(I_perm) >= abs(moran(dop$z)))) / 1000, 3))

# Rysunek 2: A – mapa wiarygodności (alfa, beta) z obszarem 95%; B – dopasowanie w osiedlach
siatka <- expand.grid(alfa = seq(0.85, 1.35, length.out = 71), beta = seq(1.8, 2.35, length.out = 71))
siatka$dewiancja <- 2 * (apply(siatka, 1, ujemna_logL) - fit$value)
p2a <- ggplot(siatka, aes(alfa, beta)) +
  geom_contour_filled(aes(z = dewiancja), breaks = c(0, 2.3, 5.99, 11.8, 30, Inf)) +
  geom_contour(aes(z = dewiancja), breaks = 5.99, colour = "grey15", linewidth = 0.7) +
  annotate("point", x = alfa_hat, y = beta_hat, shape = 21, size = 3.5, fill = "white", colour = "grey10", stroke = 1.2) +
  annotate("point", x = 1, y = 2, shape = 4, size = 3.5, colour = kol[["konkurent"]], stroke = 1.6) +
  annotate("label", x = alfa_hat + 0.02, y = beta_hat + 0.04, label = "ocena", hjust = 0, size = 3.5, fill = "white") +
  annotate("label", x = 0.98, y = 1.95, label = "prawda (1, 2)", hjust = 1, size = 3.5, colour = kol[["konkurent"]], fill = "white") +
  scale_fill_manual(values = colorspace::sequential_hcl(5, "Blues 3"),
                    labels = c("< 2.3", "2.3–6", "6–11.8", "11.8–30", "> 30"), name = "dewiancja") +
  coord_cartesian(expand = FALSE) +
  labs(x = expression(alpha ~ "(atrakcyjność: powierzchnia)"), y = expression(beta ~ "(opór: czas dojazdu)"),
       title = "A. Gdzie leżą dobre pary (α, β)?", subtitle = "czarna linia – obszar ufności 95%") + motyw
p2b <- ggplot(dop, aes(100 * przewidywany, 100 * obserwowany)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey50", linetype = "dashed") +
  geom_point(aes(size = n, shape = brzeg, colour = brzeg), alpha = 0.85) +
  scale_colour_manual(values = c(zachodni = kol[["nasz"]], wschodni = kol[["kandydat"]]), name = "brzeg rzeki") +
  scale_shape_manual(values = c(zachodni = 16, wschodni = 17), name = "brzeg rzeki") +
  scale_size_area(max_size = 5, name = "karty w osiedlu") +
  labs(x = "przewidywany udział naszej sieci (%)", y = "udział w kartach (%)",
       title = "B. Model a karty w 30 osiedlach") + motyw + theme(legend.box = "vertical")
p2 <- p2a / p2b
p2   # zapis: ggsave("lokalizacja-sklepu-dopasowanie.svg", p2, width = 10, height = 12)
Wynik w R
 parametr prawda ocena     SE dolna_95 gorna_95
     alfa      1  1.11 0.0478     1.02      1.2
     beta      2  2.07 0.0644     1.95      2.2
               logL           zbieznosc korelacja_alfa_beta
            -3386.2                 0.0                 0.4
pseudo_R2_McFadden
             0.213
      I_Morana     oczekiwane p_permutacyjne
        -0.214         -0.034          0.130
3. Grafika przyciągania dla osiedla O14: Rysunek 3
R
# Rysunek 3. Grafika: jak model Huffa dzieli wydatki jednego osiedla (O14) między sklepy
# Korzysta z osiedla, sklepów, czasów dojazdu i ocen alfa, beta z przepisów 1–2. Niczego nie losuje.
library(ggplot2)

i <- "O14"
pot <- osiedla$potencjal[osiedla$osiedle == i]
sila <- sklepy$powierzchnia^alfa_hat * T_czas[i, ]^(-beta_hat)          # „siła przyciągania” sklepu
schemat <- data.frame(sklep = sklepy$sklep, typ = sklepy$typ, A = sklepy$powierzchnia, t = T_czas[i, ],
                      sila = sila, P = sila / sum(sila))
schemat$zl <- pot * schemat$P
schemat <- schemat[order(-schemat$P), ]
schemat$yy <- rev(seq(0.6, by = 1.05, length.out = nrow(schemat)))
print(transform(schemat[, c("sklep", "A", "t", "P", "zl")], t = round(t, 1), P = round(100 * P, 1),
                zl = round(zl / 1000)), row.names = FALSE)

y_os <- mean(schemat$yy)
schemat$etykieta <- sprintf("%s  ·  %.1f tys. m²  ·  %.1f min", schemat$sklep, schemat$A, schemat$t)
schemat$wynik <- sprintf("%.1f%%  ≈  %.0f tys. zł", 100 * schemat$P, schemat$zl / 1000)
p3 <- ggplot(schemat) +
  geom_segment(aes(x = 2.35, y = y_os, xend = 5.55, yend = yy, linewidth = P, colour = typ),
               arrow = arrow(length = unit(0.25, "cm"), type = "closed"), lineend = "butt", alpha = 0.8) +
  annotate("rect", xmin = 0.05, xmax = 2.35, ymin = y_os - 1.3, ymax = y_os + 1.3,
           fill = "#DDEFD9", colour = "grey30", linewidth = 0.4) +
  annotate("text", x = 1.2, y = y_os + 0.75, label = "Osiedle O14", fontface = "bold", size = 4.4, colour = "#0f1d3a") +
  annotate("text", x = 1.2, y = y_os - 0.15, size = 3.6, lineheight = 0.95, colour = "grey15",
           label = sprintf("%d gospodarstw\n× %d zł rocznie\n= %.0f tys. zł", osiedla$gospodarstwa[osiedla$osiedle == i],
                           osiedla$wydatki[osiedla$osiedle == i], pot / 1000)) +
  geom_rect(aes(xmin = 5.6, xmax = 9.9, ymin = yy - 0.44, ymax = yy + 0.44, fill = typ), colour = "grey30", linewidth = 0.4) +
  geom_text(aes(x = 5.75, y = yy + 0.17, label = etykieta), hjust = 0, size = 3.5, fontface = "bold", colour = "grey10") +
  geom_text(aes(x = 5.75, y = yy - 0.2, label = wynik), hjust = 0, size = 3.5, colour = "grey15") +
  annotate("text", x = 0.05, y = max(schemat$yy) + 1.05, hjust = 0, size = 3.9, colour = "grey20",
           label = "Siła sklepu = powierzchnia^α × czas^(−β);  udział = siła / suma sił wszystkich sklepów") +
  scale_linewidth(range = c(0.4, 6), guide = "none") +
  scale_colour_manual(values = c(nasz = kol[["nasz"]], konkurent = kol[["konkurent"]]), guide = "none") +
  scale_fill_manual(values = c(nasz = "#CFE3F2", konkurent = "#F6C9A9"),
                    labels = c(nasz = "nasz sklep", konkurent = "konkurent"), name = NULL) +
  coord_cartesian(xlim = c(0, 10), ylim = c(0, max(schemat$yy) + 1.4), expand = FALSE) +
  labs(title = sprintf("Dokąd jadą po ziemię i sadzonki? (α = %.2f, β = %.2f)", alfa_hat, beta_hat)) +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
p3   # zapis: ggsave("lokalizacja-sklepu-schemat-przyciagania.svg", p3, width = 10, height = 7)
Wynik w R
 sklep   A    t    P  zl
    K1 3.0  5.4 41.3 211
    K3 4.5  9.5 20.2 103
    N1 1.5  5.4 19.1  98
    N2 2.0  8.1 11.3  58
    K2 1.2  7.6  7.3  37
    K4 0.8 17.4  0.8   4
4. Warianty lokalizacji i mapa udziałów: Rysunek 4
R
# Rysunek 4. Mapa udziałów naszej sieci dziś i po otwarciu sklepu w lokalizacji A, B albo C
# Korzysta z obiektów z przepisów 1–2. Niczego nie losuje.
library(ggplot2)

# Przychód roczny sklepów = Σ po osiedlach (potencjał osiedla × udział sklepu); sklep nowy ma 2 tys. m²
scenariusz <- function(alfa, beta, kand = NULL, czas = czas_dojazdu) {
  sk <- if (is.null(kand)) sklepy else rbind(sklepy, kandydaci[kandydaci$sklep == kand, ])
  P <- huff(alfa, beta, sk$powierzchnia, macierz(sk, czas)); colnames(P) <- sk$sklep
  list(P = P, przychod = setNames(colSums(osiedla$potencjal * P), sk$sklep))
}
dzis <- scenariusz(alfa_hat, beta_hat)
bilans <- function(alfa, beta, kand, czas = czas_dojazdu) {
  d0 <- scenariusz(alfa, beta, czas = czas)$przychod
  d1 <- scenariusz(alfa, beta, kand, czas)$przychod
  c(nowy = d1[[kand]], kanibalizacja = (d0[["N1"]] + d0[["N2"]]) - (d1[["N1"]] + d1[["N2"]]),
    od_konkurencji = sum(d0[c("K1", "K2", "K3", "K4")]) - sum(d1[c("K1", "K2", "K3", "K4")]),
    przyrost_sieci = d1[[kand]] - ((d0[["N1"]] + d0[["N2"]]) - (d1[["N1"]] + d1[["N2"]])))
}
round(dzis$przychod / 1e6, 2)                                    # dziś, mln zł rocznie
tab <- sapply(kandydaci$sklep, function(k) bilans(alfa_hat, beta_hat, k))
round(tab / 1e6, 2)                                              # mln zł rocznie
round(100 * tab["kanibalizacja", ] / tab["nowy", ], 1)           # % przychodu nowego sklepu zabrane własnym
# Ile traci każdy z naszych sklepów (mln zł rocznie)?
round(sapply(kandydaci$sklep, function(k) dzis$przychod[c("N1", "N2")] -
               scenariusz(alfa_hat, beta_hat, k)$przychod[c("N1", "N2")]) / 1e6, 2)

# Udział naszej sieci w wydatkach osiedla: dziś i w trzech wariantach
udzial <- function(sc) rowSums(sc$P[, colnames(sc$P) %in% c("N1", "N2", "A", "B", "C"), drop = FALSE])
mapy <- do.call(rbind, lapply(c("dziś", "A", "B", "C"), function(w) {
  sc <- if (w == "dziś") dzis else scenariusz(alfa_hat, beta_hat, w)
  data.frame(osiedla[, c("x", "y")], wariant = w, udzial = 100 * udzial(sc),
             zmiana = 100 * (udzial(sc) - udzial(dzis)))
}))
mapy$panel <- factor(ifelse(mapy$wariant == "dziś", "Dziś: sklepy N1 i N2",
                            paste0("Po otwarciu sklepu ", mapy$wariant)),
                     levels = c("Dziś: sklepy N1 i N2", paste0("Po otwarciu sklepu ", c("A", "B", "C"))))
mapy$tekst <- ifelse(mapy$wariant == "dziś", sprintf("%.0f", mapy$udzial), sprintf("+%.0f", mapy$zmiana))
pkt <- do.call(rbind, lapply(levels(mapy$panel), function(p) {
  k <- sub("Po otwarciu sklepu ", "", p)
  d <- rbind(sklepy, kandydaci[kandydaci$sklep == k, ])
  d$panel <- p; d
}))
pkt$panel <- factor(pkt$panel, levels = levels(mapy$panel))
pkt$rola <- factor(c(nasz = "nasz sklep", konkurent = "konkurent", kandydat = "nowy sklep")[pkt$typ],
                   levels = c("nasz sklep", "konkurent", "nowy sklep"))
p4 <- ggplot(mapy, aes(x, y)) +
  geom_tile(aes(fill = udzial), colour = "white", linewidth = 0.5) +
  geom_text(aes(label = tekst), size = 3, colour = "grey10") +
  annotate("segment", x = 4, xend = 4, y = 0, yend = 5, colour = kol[["rzeka"]], linewidth = 1.6) +
  geom_point(data = pkt, aes(shape = rola, colour = rola), size = 3.2, stroke = 1.1, fill = "white") +
  facet_wrap(~ panel, ncol = 2) +
  scale_fill_gradientn(colours = colorspace::sequential_hcl(7, "Blues 3", rev = TRUE), limits = c(0, 100),
                       name = "udział naszej sieci w wydatkach osiedla (%)") +
  scale_shape_manual(values = c("nasz sklep" = 15, "konkurent" = 17, "nowy sklep" = 23), name = NULL) +
  scale_colour_manual(values = c("nasz sklep" = kol[["nasz"]], "konkurent" = kol[["konkurent"]],
                                 "nowy sklep" = kol[["kandydat"]]), name = NULL) +
  coord_equal(expand = FALSE) +
  labs(x = "km", y = "km", title = "Udział naszej sieci w osiedlach",
       subtitle = "liczby: dziś – udział w %; w wariantach – przyrost w punktach procentowych") +
  motyw + theme(legend.box = "vertical", axis.text = element_text(size = rel(0.8)))
p4   # zapis: ggsave("lokalizacja-sklepu-mapa-udzialow.svg", p4, width = 10, height = 10.5)
Wynik w R
  N1   N2   K1   K2   K3   K4
2.39 3.68 5.10 1.53 5.19 1.64
                  A    B    C
nowy           2.76 2.87 2.11
kanibalizacja  0.90 0.95 0.70
od_konkurencji 1.86 1.93 1.41
przyrost_sieci 1.86 1.93 1.41
   A    B    C
32.7 32.9 33.3
      A    B    C
N1 0.33 0.22 0.41
N2 0.57 0.73 0.29
5. Bootstrap kart: Rysunek 5
R
# Rysunek 5. Przychód nowego sklepu, kanibalizacja i przyrost sieci z niepewnością (bootstrap kart)
# Korzysta z obiektów z przepisów 1–4. Losuje: własne set.seed(652).
library(ggplot2)

set.seed(652)
B <- 1000
boot <- t(replicate(B, {
  ind <- sample(nrow(karty), replace = TRUE)                     # losowanie gospodarstw ze zwracaniem
  Nb <- unclass(table(factor(karty$osiedle[ind], levels = osiedla$osiedle),
                      factor(karty$sklep[ind], levels = sklepy$sklep)))
  pb <- optim(fit$par, ujemna_logL, Nm = Nb, method = "BFGS")$par
  c(alfa = pb[[1]], beta = pb[[2]], unlist(lapply(kandydaci$sklep, function(k) {
    b <- bilans(pb[[1]], pb[[2]], k); setNames(b, paste(k, names(b), sep = "_")) })))
}))
# Przedziały percentylowe 95% dla parametrów (porównaj z przedziałami Walda z przepisu 2)
round(apply(boot[, c("alfa", "beta")], 2, quantile, c(0.025, 0.975)), 2)
# Przychód roczny (mln zł): ocena punktowa i przedział percentylowy 95%
miary <- c("nowy", "kanibalizacja", "przyrost_sieci")
podsum <- do.call(rbind, lapply(kandydaci$sklep, function(k) do.call(rbind, lapply(miary, function(m) {
  v <- boot[, paste(k, m, sep = "_")]
  data.frame(kandydat = k, miara = m, ocena = tab[m, k] / 1e6,
             dolna = quantile(v, 0.025) / 1e6, gorna = quantile(v, 0.975) / 1e6)
}))))
print(podsum, digits = 3, row.names = FALSE)
# Jak często każda lokalizacja daje największy przyrost sieci? Różnica B − A z przedziałem
najlepsza <- apply(boot[, paste(kandydaci$sklep, "przyrost_sieci", sep = "_")], 1, which.max)
round(100 * prop.table(table(factor(kandydaci$sklep[najlepsza], levels = kandydaci$sklep))), 1)
round(quantile((boot[, "B_przyrost_sieci"] - boot[, "A_przyrost_sieci"]) / 1e3, c(0.025, 0.5, 0.975)), 1)  # tys. zł

# Rysunek 5: ocena i przedział 95% dla trzech miar w trzech lokalizacjach
podsum$miara <- factor(podsum$miara, levels = miary,
                       labels = c("przychód nowego sklepu", "zabrane własnym sklepom (kanibalizacja)",
                                  "przyrost przychodu sieci"))
podsum$kandydat <- factor(podsum$kandydat, levels = rev(kandydaci$sklep))
p5 <- ggplot(podsum, aes(ocena, kandydat, colour = miara, shape = miara)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 0.8, orientation = "y",
                 position = position_dodge(width = 0.6)) +
  geom_point(size = 3.2, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["konkurent"]], kol[["nasz"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_x_continuous(limits = c(0, NA)) +
  guides(colour = guide_legend(ncol = 1, reverse = TRUE), shape = guide_legend(ncol = 1, reverse = TRUE)) +
  labs(x = "mln zł rocznie", y = "lokalizacja",
       title = "Ile da nowy sklep – i ile zabierze naszym?",
       subtitle = "punkt – ocena z modelu; odcinek – 95% z 1000 prób bootstrapowych kart") + motyw
p5   # zapis: ggsave("lokalizacja-sklepu-przychod-bootstrap.svg", p5, width = 10, height = 6.6)
Wynik w R
      alfa beta
2.5%  1.02 1.96
97.5% 1.21 2.21
 kandydat          miara ocena dolna gorna
        A           nowy 2.758 2.716 2.796
        A  kanibalizacja 0.902 0.871 0.932
        A przyrost_sieci 1.857 1.834 1.874
        B           nowy 2.874 2.843 2.907
        B  kanibalizacja 0.947 0.919 0.974
        B przyrost_sieci 1.927 1.916 1.939
        C           nowy 2.107 2.063 2.147
        C  kanibalizacja 0.701 0.670 0.731
        C przyrost_sieci 1.406 1.377 1.429

  A   B   C
  0 100   0
 2.5%   50% 97.5%
 43.2  70.9 103.6
6. Linia prosta zamiast czasu dojazdu: Rysunek 6
R
# Rysunek 6. Pułapka: odległość w linii prostej zamiast czasu dojazdu (rzeka z jednym mostem)
# Korzysta z obiektów z przepisów 1–5. Niczego nie losuje.
library(ggplot2)
library(patchwork)

# Ten sam wzór na czas (3 min + 2.4 min/km), ale z odległości w linii prostej – jakby rzeki nie było
czas_prosto <- function(ox, oy, sx, sy) 3 + 2.4 * sqrt((ox - sx)^2 + (oy - sy)^2)
T_prosto <- macierz(sklepy, czas_prosto)
fit_p <- optim(c(alfa = 0.5, beta = 1), ujemna_logL, Tm = T_prosto, method = "BFGS", hessian = TRUE)
se_p <- sqrt(diag(solve(fit_p$hessian)))
data.frame(model = c("czas dojazdu (mostem)", "linia prosta"),
           alfa = round(c(alfa_hat, fit_p$par[[1]]), 2), beta = round(c(beta_hat, fit_p$par[[2]]), 2),
           SE_beta = round(c(se[[2]], se_p[[2]]), 3), logL = round(-c(fit$value, fit_p$value), 1),
           AIC = round(2 * c(fit$value, fit_p$value) + 2 * 2, 1))
porown <- data.frame(kandydat = rep(kandydaci$sklep, 2),
                     model = rep(c("czas dojazdu (mostem)", "linia prosta"), each = 3),
                     nowy = c(tab["nowy", ], sapply(kandydaci$sklep, function(k)
                       bilans(fit_p$par[[1]], fit_p$par[[2]], k, czas_prosto)[["nowy"]])),
                     przyrost = c(tab["przyrost_sieci", ], sapply(kandydaci$sklep, function(k)
                       bilans(fit_p$par[[1]], fit_p$par[[2]], k, czas_prosto)[["przyrost_sieci"]])))
transform(porown, nowy = round(nowy / 1e6, 2), przyrost = round(przyrost / 1e6, 2))
# Skąd sklep B (wschodni brzeg) bierze klientów: udział przychodu z zachodniego brzegu
zach <- osiedla$brzeg == "zachodni"
udz_zach <- function(alfa, beta, czas) {
  sc <- scenariusz(alfa, beta, "B", czas)
  100 * sum((osiedla$potencjal * sc$P[, "B"])[zach]) / sc$przychod[["B"]]
}
c(czas_dojazdu = round(udz_zach(alfa_hat, beta_hat, czas_dojazdu), 1),
  linia_prosta = round(udz_zach(fit_p$par[[1]], fit_p$par[[2]], czas_prosto), 1))

# Rysunek 6: A – czas do sklepu B z obu metod; B – przyrost sieci w trzech lokalizacjach
dB <- data.frame(osiedla[, c("osiedle", "brzeg")],
                 prosto = macierz(kandydaci[2, ], czas_prosto)[, 1], mostem = macierz(kandydaci[2, ], czas_dojazdu)[, 1])
p6a <- ggplot(dB, aes(prosto, mostem, colour = brzeg, shape = brzeg)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey50", linetype = "dashed") +
  geom_point(size = 2.8) +
  scale_colour_manual(values = c(zachodni = kol[["nasz"]], wschodni = kol[["kandydat"]]), name = "brzeg rzeki") +
  scale_shape_manual(values = c(zachodni = 16, wschodni = 17), name = "brzeg rzeki") +
  labs(x = "czas z linii prostej (min)", y = "czas przez most (min)", title = "A. Dojazd do sklepu B") + motyw
p6b <- ggplot(porown, aes(przyrost / 1e6, kandydat, colour = model, shape = model)) +
  geom_line(aes(group = kandydat), colour = "grey70", linewidth = 1) +
  geom_point(size = 3.4) +
  scale_colour_manual(values = c("czas dojazdu (mostem)" = kol[["nasz"]], "linia prosta" = kol[["konkurent"]]), name = NULL) +
  scale_shape_manual(values = c("czas dojazdu (mostem)" = 15, "linia prosta" = 17), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = "przyrost przychodu sieci (mln zł / rok)", y = "lokalizacja", title = "B. Którą działkę wybrać?") + motyw
p6 <- p6a + p6b
p6   # zapis: ggsave("lokalizacja-sklepu-odleglosc-prosta.svg", p6, width = 10, height = 5.6)
Wynik w R
                  model alfa beta SE_beta    logL    AIC
1 czas dojazdu (mostem) 1.11 2.07   0.064 -3386.2 6776.4
2          linia prosta 0.97 2.10   0.066 -3447.5 6899.1
  kandydat                 model nowy przyrost
1        A czas dojazdu (mostem) 2.76     1.86
2        B czas dojazdu (mostem) 2.87     1.93
3        C czas dojazdu (mostem) 2.11     1.41
4        A          linia prosta 2.68     1.79
5        B          linia prosta 2.45     1.65
6        C          linia prosta 2.13     1.41
czas_dojazdu linia_prosta
        28.7         37.5
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (nasz sklep / konkurent)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (nasz / kandydat; zachodni / wschodni brzeg)" = c("#0072B2", "#E69F00"),
             "cynober – pomarańczowy (konkurent / kandydat)" = c("#D55E00", "#E69F00"),
             "szary – cynober (przychód / kanibalizacja)" = c("#999999", "#D55E00"),
             "jasnoniebieski – jasnopomarańczowy (pola schematu)" = c("#CFE3F2", "#F6C9A9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                      widzenie_typowe
niebieski – cynober (nasz sklep / konkurent)                                    114.6
niebieski – pomarańczowy (nasz / kandydat; zachodni / wschodni brzeg)           120.2
cynober – pomarańczowy (konkurent / kandydat)                                    33.4
szary – cynober (przychód / kanibalizacja)                                       77.2
jasnoniebieski – jasnopomarańczowy (pola schematu)                               35.4
czerwony – zielony (do unikania)                                                121.7
                                                                      deuteranopia
niebieski – cynober (nasz sklep / konkurent)                                 108.3
niebieski – pomarańczowy (nasz / kandydat; zachodni / wschodni brzeg)        121.5
cynober – pomarańczowy (konkurent / kandydat)                                 18.4
szary – cynober (przychód / kanibalizacja)                                    62.9
jasnoniebieski – jasnopomarańczowy (pola schematu)                            34.6
czerwony – zielony (do unikania)                                              21.1
                                                                      protanopia
niebieski – cynober (nasz sklep / konkurent)                                91.9
niebieski – pomarańczowy (nasz / kandydat; zachodni / wschodni brzeg)      109.3
cynober – pomarańczowy (konkurent / kandydat)                               24.9
szary – cynober (przychód / kanibalizacja)                                  56.0
jasnoniebieski – jasnopomarańczowy (pola schematu)                          29.9
czerwony – zielony (do unikania)                                            31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, optymalizacja optim() i bootstrap – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a skale kolorów i paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Odległość w linii prostej zamiast czasu dojazdu. Rzeka, tory czy brak zjazdu z drogi szybkiego ruchu potrafią zmienić ranking lokalizacji (rysunek 6).
- Parametry „z literatury”. Ocena β zależy od przestrzennego układu sklepów (Fotheringham, 1983), a do tego od branży: ziemię ogrodową kupuje się blisko, po meble ogrodowe jedzie się dalej. Szacuj α i β na własnych danych.
- Założenie IIA. Model Huffa ma postać modelu logitowego, więc w obrębie jednego osiedla nowy sklep zabiera wszystkim sklepom ten sam odsetek udziału. Przy sklepach będących bliskimi substytutami to założenie zawodzi, a testy IIA są mało wiarygodne (Cheng i Long, 2007).
- Posiadacze kart to nie wszyscy mieszkańcy. Jeśli osoby z kartą wybierają inaczej niż reszta, α i β będą obciążone.
- Stały rynek. Model nie przewiduje wzrostu wydatków po otwarciu sklepu.
- Atrakcyjność to nie tylko metry. Parking, asortyment, ceny i godziny otwarcia też się liczą. Można je dodać jako kolejne czynniki z wykładnikami.
Najczęstsze pytania
Na czym polega model Huffa?
Model Huffa podaje prawdopodobieństwo, że mieszkaniec danego obszaru wybierze dany sklep: atrakcyjność sklepu (np. powierzchnia) do potęgi α razy odległość lub czas dojazdu do potęgi −β, podzielone przez sumę takich wartości dla wszystkich sklepów. Przychód sklepu to suma wydatków obszarów pomnożonych przez te prawdopodobieństwa.
Jak oszacować parametry α i β modelu Huffa?
Najlepiej metodą największej wiarygodności z danych o wyborach: dla każdej osoby znasz obszar zamieszkania i wybrany sklep, więc wybory mają rozkład wielomianowy. W R wystarczy funkcja optim() z opcją hessian = TRUE. W przykładzie z 2400 kart wyszło α = 1.11 i β = 2.07, przy wartościach ukrytych w danych 1 i 2 (Haines i in., 1972).
Jak policzyć kanibalizację nowego sklepu?
Policz przychody wszystkich sklepów sieci bez nowego sklepu i z nim. Kanibalizacja to spadek przychodu istniejących sklepów, a przyrost sieci = przychód nowego sklepu − kanibalizacja. W przykładzie sklep B miał 2.87 mln zł przychodu, ale 0.95 mln zł zabrał własnym sklepom. Po otwarciu sprawdź to na danych, np. metodą różnicy w różnicach.
Czy w modelu Huffa można użyć odległości w linii prostej?
Można, ale to ryzykowne tam, gdzie drogę wydłużają rzeki, tory czy brak mostów. W przykładzie model z linią prostą pasował gorzej (AIC 6899.1 wobec 6776.4) i zmienił ranking: działka A wyszła lepsza od B, choć w danych było odwrotnie. Używaj czasu dojazdu po sieci dróg.
Jaką niepewność ma prognoza przychodu z modelu Huffa?
Bootstrap danych o wyborach pokazuje tylko niepewność oszacowania α i β – w przykładzie przedziały były bardzo wąskie (±0.01–0.04 mln zł). Nie obejmuje błędów potencjału rynku, reakcji konkurencji ani złej miary odległości, dlatego dodaj analizę wrażliwości tych założeń.
Powiązane hasła
Przeczytaj też
Wielomianowa regresja logistyczna
Kategoria odniesienia, RRR, test predyktorów, prawdopodobieństwa przewidywane, założenie IIA i tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikConjoint wyborczy (CBC) – analiza
400 osób wybiera abonament: warunkowy model logitowy, ważność atrybutów, gotowość do zapłaty, symulator udziałów i pułapki IIA – pięć rysunków z kodem R.
Czytaj →PoradnikKanibalizacja nowego lokalu – DiD
Sieć pizzerii i nowy lokal: różnica w różnicach według odległości, event study, efekt nowości i bilans netto sieci – pięć rysunków z kodem R.
Czytaj →PoradnikMonte Carlo NPV – opłacalność projektu
Linia produkcyjna w mleczarni: NPV, rozkłady założeń, 10 000 symulacji, P(NPV < 0), tornado i korelacja ceny z popytem – sześć rysunków z kodem R.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →Analizujesz lokalizację sklepu w pracy dyplomowej?
Pomożemy przygotować dane o osiedlach i wyborach klientów, oszacować model Huffa, policzyć przychody wariantów z kanibalizacją i niepewnością oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cheng, S., & Long, J. S. (2007). Testing for IIA in the multinomial logit model. Sociological Methods & Research, 35(4), 583–600. https://doi.org/10.1177/0049124106292361
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Fotheringham, A. S. (1983). A new set of spatial-interaction models: The theory of competing destinations. Environment and Planning A: Economy and Space, 15(1), 15–36. https://doi.org/10.1177/0308518x8301500103
- Haines, G. H., Simon, L. S., & Alexis, M. (1972). Maximum likelihood estimation of central-city food trading areas. Journal of Marketing Research, 9(2), 154–159. https://doi.org/10.1177/002224377200900206
- Huff, D. L. (1964). Defining and estimating a trading area. Journal of Marketing, 28(3), 34–38. https://doi.org/10.1177/002224296402800307
- Nakanishi, M., & Cooper, L. G. (1974). Parameter estimation for a multiplicative competitive interaction model: Least squares approach. Journal of Marketing Research, 11(3), 303–311. https://doi.org/10.1177/002224377401100309
Cytowania BibTeX
@article{cheng2007testing, author={Cheng, Simon and Long, J. Scott}, title={{Testing for IIA in the multinomial logit model}}, journal={Sociological Methods \& Research}, year={2007}, volume={35}, number={4}, pages={583--600}, doi={10.1177/0049124106292361}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{fotheringham1983new, author={Fotheringham, A. S.}, title={{A new set of spatial-interaction models: The theory of competing destinations}}, journal={Environment and Planning A: Economy and Space}, year={1983}, volume={15}, number={1}, pages={15--36}, doi={10.1177/0308518x8301500103}}@article{haines1972maximum, author={Haines, George H. and Simon, Leonard S. and Alexis, Marcus}, title={{Maximum likelihood estimation of central-city food trading areas}}, journal={Journal of Marketing Research}, year={1972}, volume={9}, number={2}, pages={154--159}, doi={10.1177/002224377200900206}}@article{huff1964defining, author={Huff, David L.}, title={{Defining and estimating a trading area}}, journal={Journal of Marketing}, year={1964}, volume={28}, number={3}, pages={34--38}, doi={10.1177/002224296402800307}}@article{nakanishi1974parameter, author={Nakanishi, Masao and Cooper, Lee G.}, title={{Parameter estimation for a multiplicative competitive interaction model: Least squares approach}}, journal={Journal of Marketing Research}, year={1974}, volume={11}, number={3}, pages={303--311}, doi={10.1177/002224377401100309}}