Przykład: jaki abonament wprowadzić na rynek?
Fikcyjna sieć komórkowa Orbita chce wprowadzić nowy abonament. Dział marketingu pyta: co klienci cenią najbardziej, ile dopłacą za transfer bez limitu i jaki udział w rynku zdobędzie nowa oferta przy różnych cenach? Odpowiada na to ankieta z conjointem wyborczym (CBC, ang. choice-based conjoint).
Ankietę wypełniło 400 osób. Każda wykonała 8 zadań wyboru. W zadaniu widziała trzy oferty i mogła też odpowiedzieć „nie wybrał(a)bym żadnej z tych ofert”. Oferty różniły się czterema atrybutami: siecią (Fala, Orbita, Zasięg – wszystkie fikcyjne), transferem (20 GB, 60 GB, bez limitu), umową (bez umowy, 12 lub 24 miesiące) i ceną (35, 45, 55 lub 65 zł miesięcznie). Poziomy losowano niezależnie dla każdej oferty – to randomizacja pełna. Razem 3200 zadań i 12 800 wierszy danych. W 17.9% zadań respondent nie wybrał żadnej oferty.
Jak zaplanować taki eksperyment (liczba atrybutów, poziomów i zadań, ograniczenia), opisuje wpis eksperyment conjoint i winietowy w ankiecie. Tam wynik to AMCE z regresji liniowej. Tutaj zajmujemy się analizą typową dla marketingu: modelem logitowym, ważnością atrybutów, gotowością do zapłaty i symulatorem rynku. Definicje są w haśle analiza conjoint.
Dane są fikcyjne i wiemy, jakie preferencje w nich ukryliśmy. Ręcznie ustaliliśmy dwa segmenty klientów. „Oszczędni” silnie reagują na cenę i mało cenią transfer. „Intensywni” mniej patrzą na cenę i płacą za duży pakiet danych. Młodsi częściej należą do intensywnych (w próbie intensywnych jest 46.2%). Wszystkie parametry są w przepisie 1 kodu, a ziarno 620 ustalono raz i go nie zmieniano. Dane pobierzesz jako conjoint-cbc-abonament-wybory.csv (jeden wiersz = jedna alternatywa w jednym zadaniu; wybor = 1 przy wybranej, brak = 1 dla opcji „żadna”).
Rysunek 1: jak wygląda zadanie wyboru
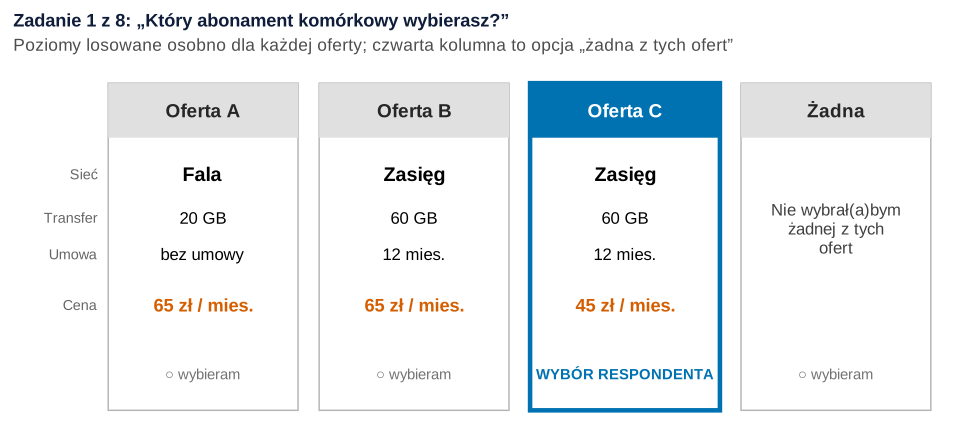
set.seed(620)).Co widać. Tak respondent widzi zadanie. Ta osoba wybrała ofertę C. Oferty B i C różnią się tylko ceną – przy pełnym losowaniu takie pary się zdarzają.
Jak może zmylić. Zwykle wyklucza się oferty identyczne i zdominowane, ale ograniczenia zmieniają plan i estymand (zob. projekt eksperymentu conjoint).
Podpis do pracy:
Zdanie do Metody:
Jak działa warunkowy model logitowy
Model zakłada, że każda oferta ma dla klienta pewną „atrakcyjność” – użyteczność V. To suma punktów za poziomy atrybutów minus kwota za każdą złotówkę ceny; opcja „żadna” ma własną stałą. Do gry wchodzą też czynniki, których nie widzimy, więc wybór opisuje prawdopodobieństwo:
Słowami: im wyższa użyteczność oferty względem pozostałych w tym samym zadaniu, tym większa szansa, że zostanie wybrana. To warunkowa regresja logistyczna, w której warstwą jest zadanie. Ten sam model liczy wpis o MaxDiff. W odróżnieniu od wielomianowej regresji logistycznej predyktorami są cechy alternatyw. Parametry szacuje się metodą największej wiarygodności; w R wystarczy funkcja clogit() z pakietu survival z strata(zadanie_id). Atrybuty kodujemy zero-jedynkowo (dummy coding), a cenę liczbowo, w złotych. Każda osoba daje 8 odpowiedzi, dlatego błędy standardowe liczymy jako odporne na klastrowanie w osobach. Inne metody analizy eksperymentów wyboru przegląda raport Hauber i in. (2016).
Rysunek 2: użyteczności cząstkowe
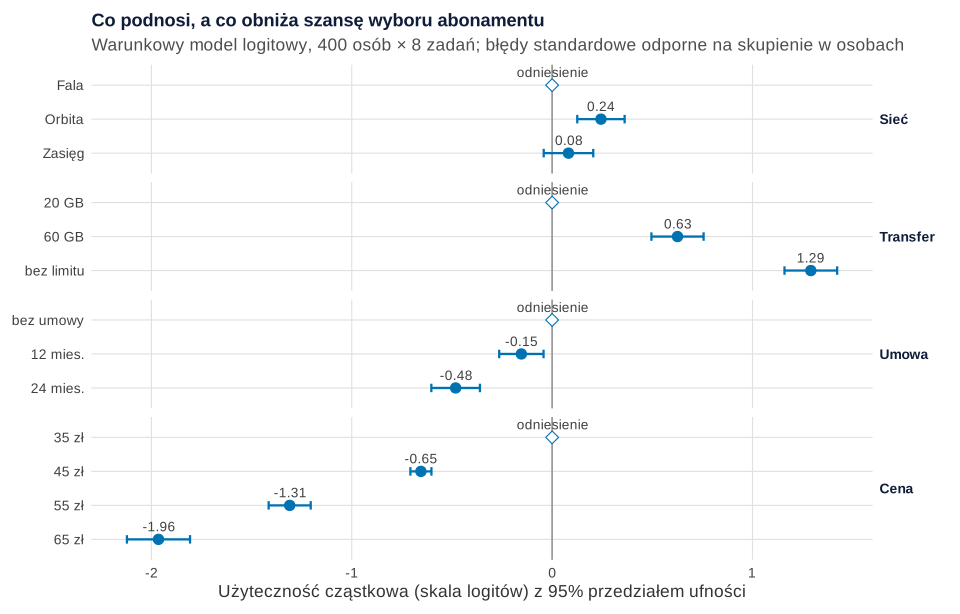
Co widać. Punkty to użyteczności cząstkowe względem poziomu odniesienia (romb). Najwięcej dodaje transfer bez limitu: 1.29, 95% CI [1.16, 1.42]. To 3.64 raza wyższe szanse wyboru niż przy 20 GB. Umowa na 24 miesiące odejmuje 0.48, a każde 10 zł ceny – 0.65 (β ceny = −0.065 na 1 zł). Między sieciami różnice są małe, a Zasięg nie różni się wyraźnie od Fali (przedział obejmuje zero). Model jest dużo lepszy od wyboru losowego (LR = 1408.5, df = 8, p < .001). Pseudo-R² McFaddena wynosi .159 (zob. pseudo-R²). W 48.3% zadań największe prawdopodobieństwo model dał alternatywie, którą wybrano (losowo: 25%).
Jak może zmylić. Użyteczności są na skali logitów i mają sens tylko w porównaniach wewnątrz modelu. Nie porównuj ich wprost między badaniami, bo skala zależy od ilości „szumu” w wyborach. Cena wchodzi liniowo – sprawdź to, szacując ją jako cztery poziomy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: ważność atrybutów i gotowość do zapłaty
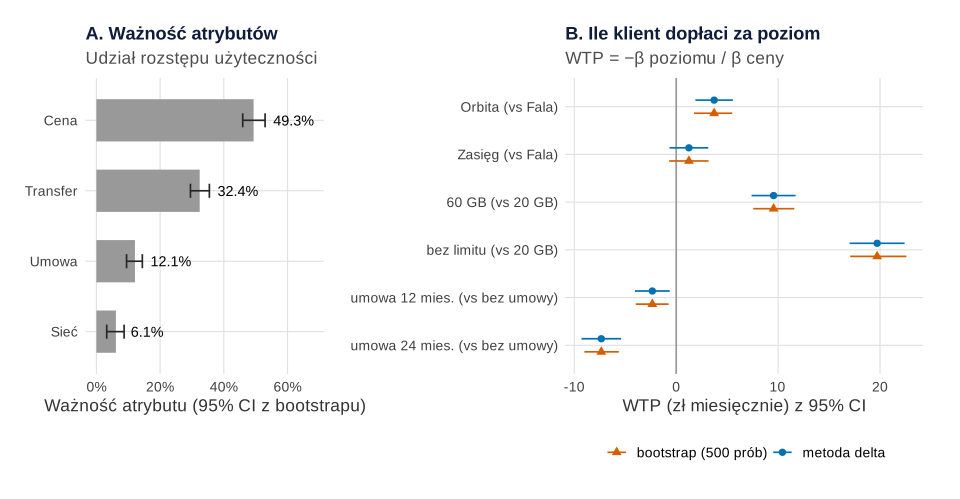
set.seed(620)).Co widać. Panel A: ważność to rozstęp użyteczności atrybutu podzielony przez sumę rozstępów. Cena odpowiada za 49.3% (95% CI [45.9, 53.0]), transfer za 32.4%, umowa za 12.1%, sieć za 6.1%. Panel B: gotowość do zapłaty (WTP, ang. willingness to pay) przelicza użyteczność na złotówki: WTP = −βpoziomu / βceny. Transfer bez limitu jest wart przeciętnie 19.7 zł miesięcznie więcej niż 20 GB, a 60 GB – 9.6 zł. Umowa na 24 miesiące „kosztuje” klienta 7.4 zł miesięcznie. Przedziały policzyliśmy dwiema metodami. Metoda delta dała dla transferu bez limitu [17.0, 22.4] zł. Bootstrap z losowaniem całych osób (500 prób) dał [17.1, 22.6] zł. Przy dobrze uwarunkowanych danych obie metody dają podobne wyniki, a bootstrap jest odporniejszy na szum i błędną specyfikację (Hole, 2007).
Jak może zmylić. Ważność zależy od zakresu poziomów. Gdyby ceny w ankiecie sięgały od 35 do 95 zł, „ważność ceny” wzrosłaby, choć klienci by się nie zmienili. WTP to iloraz, więc przy słabym β ceny przedział jest szeroki i niesymetryczny. Cenę rynkową z danych sprzedażowych pokazuje wpis o elastyczności cenowej, a pytania wprost o cenę – metoda van Westendorpa i Gabora–Grangera.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: symulator rynku
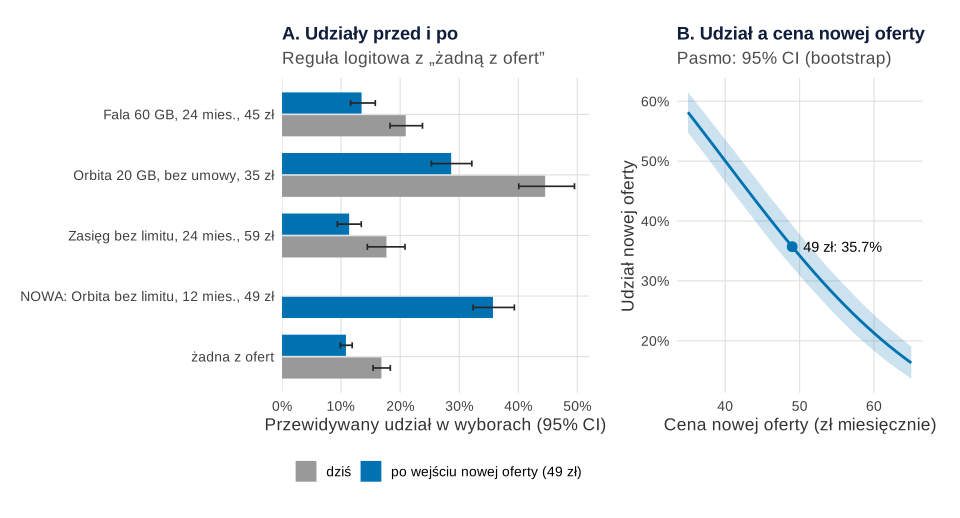
Co widać. Symulator to ten sam wzór logitowy zastosowany do wymyślonego rynku. Dziś są na nim trzy oferty (opis w legendzie panelu A) i opcja „żadna”. Najtańsza oferta Orbity (20 GB, 35 zł) ma 44.5% udziału w wyborach (95% CI [40.1, 49.5]). Orbita dodaje nową ofertę: bez limitu, umowa 12 miesięcy, 49 zł. Model daje jej 35.7% udziału [32.3, 39.3], a odsetek osób, które nie wybierają nic, spada z 16.8% do 10.8%. Panel B pokazuje udział nowej oferty przy cenach 35–65 zł: 41.9% przy 45 zł i 27.3% przy 55 zł.
Jak może zmylić. Udział w wyborach w ankiecie to nie udział w rynku. Hainmueller i in. (2015) pokazali jednak, że efekty z dobrze zaprojektowanych eksperymentów conjoint dość dobrze odtwarzały prawdziwe decyzje. Nie licz udziałów dla cen spoza badanego zakresu (np. 79 zł) – to ekstrapolacja. Zauważ też kanibalizację. Nowa oferta zabiera Orbicie 15.9 punktu procentowego z jej własnej taniej oferty, więc łączny udział sieci rośnie z 44.5% tylko do 64.4%.
Co z tym zrobić w marketingu
- Transfer to karta przetargowa – za „bez limitu” klienci dopłacą przeciętnie około 20 zł miesięcznie.
- Długa umowa wymaga rekompensaty. Umowa na 24 miesiące jest dla klienta warta −7.4 zł, więc rabat za lojalność powinien być co najmniej taki.
- Sieć znaczy mało (6.1% ważności). Kampania wizerunkowa przegra z ofertą cenową.
- Nowa oferta – licz kanibalizację. Wybrany wariant sprawdź na rynku, np. w teście A/B na stronie z cennikiem.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: różne preferencje i założenie IIA
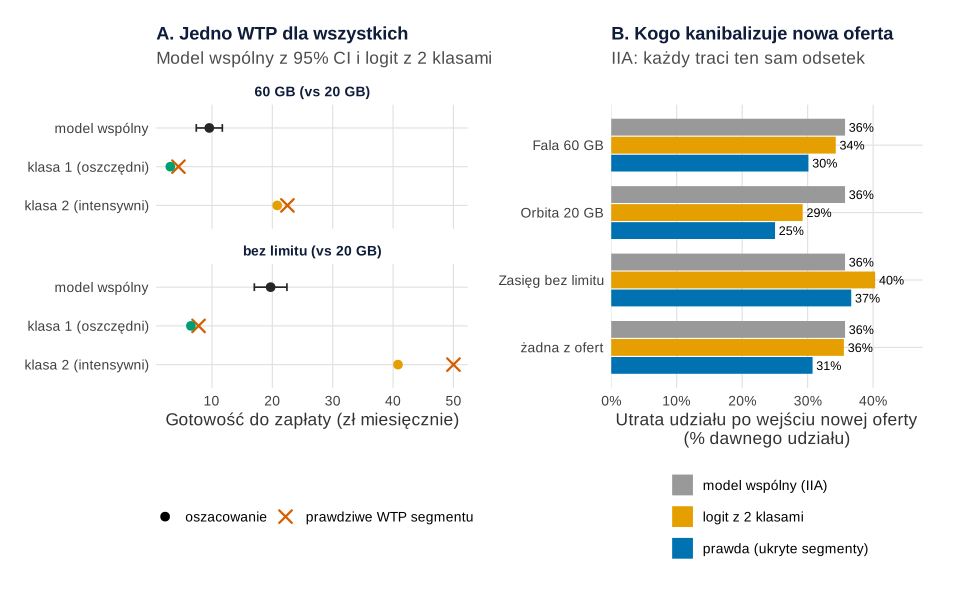
set.seed(620)).Co widać. Panel A: model wspólny mówi, że transfer bez limitu jest wart 19.7 zł. W danych ukryliśmy jednak dwa segmenty: dla oszczędnych jest wart 7.8 zł, dla intensywnych – 50.0 zł. Prawie nikt nie ma przeciętnego WTP. Podział na młodszych i starszych nic nie wykazał (LR = 10.1, df = 8, p = .256). Logit z dwiema klasami latentnymi (algorytm EM liczony ręcznie) znalazł klasę oszczędnych (WTP 6.5 zł) i intensywnych (40.8 zł). Przypisał do właściwego segmentu 75.8% osób. Segmenty różniące się wrażliwością na cenę i preferencją marek modelowali Kamakura i Russell (1989). Logikę klas opisuje wpis o klasach latentnych w marketingu.
Panel B: IIA (niezależność od nieistotnych alternatyw) to założenie modelu logitowego. Nowa oferta zabiera każdej obecnej ten sam odsetek udziału – tu 35.7%. Według parametrów ukrytych w danych Orbita 20 GB traci tylko 25.0%, bo jej klienci to głównie oszczędni, a Zasięg bez limitu traci 36.7%, bo walczy o tych samych intensywnych. Model wspólny przeszacował też udział nowej oferty: 35.7% wobec prawdziwych 29.6% (logit z dwiema klasami: 33.6%).
Jak może zmylić. W danych rzeczywistych nie ma „prawdy”, a BIC ledwie wskazał dwie klasy (7509.9 wobec 7511.7). Klasy oszacowano z jednego losowego startu, a w prawdziwym badaniu potrzeba ich wielu. Testy IIA często zawodzą akurat przy bliskich substytutach (Cheng i Long, 2007).
Podpis do pracy:
Zdanie do Wyników:
Pułapki
- Bez opcji „żadna”. Gdy respondent musi coś wybrać, symulator pokazuje popyt także tam, gdzie go nie ma. W przykładzie 17.9% zadań kończyło się odpowiedzią „żadna” – bez tej opcji te osoby trafiłyby do którejś oferty. Opcja „żadna” wymaga własnej stałej w modelu (tu
brak, β = −3.02). - IIA w symulatorze – nowa oferta zabiera wszystkim po równo (rysunek 5B).
- Jedna średnia dla różnych klientów (rysunek 5A).
- Ekstrapolacja ceny poza badany zakres i liniowa cena bez sprawdzenia.
- Deklaracje to nie zakupy – ankieta nie zna kosztu zmiany sieci.
Jak opisać w pracy
W Metodzie podaj atrybuty i poziomy, liczbę zadań i alternatyw, sposób losowania, opcję „żadna”, model i sposób liczenia błędów. W Wynikach – tabelę współczynników, ważność, WTP i scenariusze. Symulatory wyborów jako element badań conjoint omawiali już Green i Srinivasan (1990). Inne analizy do pracy z marketingu zebraliśmy we wpisie statystyka w pracy z marketingu, a zasięg zestawu produktów – w analizie TURF.
| Poziom (odniesienie) | β | SE | 95% CI | WTP (zł) |
|---|---|---|---|---|
| Orbita (Fala) | 0.244 | 0.060 | [0.126, 0.362] | 3.7 |
| Zasięg (Fala) | 0.082 | 0.063 | [−0.042, 0.205] | 1.2 |
| 60 GB (20 GB) | 0.626 | 0.066 | [0.496, 0.756] | 9.6 |
| Bez limitu (20 GB) | 1.291 | 0.067 | [1.160, 1.423] | 19.7 |
| Umowa 12 mies. (bez umowy) | −0.153 | 0.056 | [−0.264, −0.043] | −2.3 |
| Umowa 24 mies. (bez umowy) | −0.482 | 0.062 | [−0.603, −0.360] | −7.4 |
| Cena (za 1 zł) | −0.065 | 0.003 | [−0.071, −0.060] | – |
| „Żadna z ofert” (stała) | −3.022 | 0.155 | [−3.325, −2.719] | – |
Podpis tabeli:
Do Metody:
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Przepisy, które losują (1, 3 i 5), mają własne set.seed(620) przed losowaniem. Ziarno 620 ustalono raz i nie zmieniano go. Ręcznie ustalono: 400 osób, 8 zadań po 3 oferty i opcję „żadna”, poziomy atrybutów, wiek z rozkładu jednostajnego 18–65 lat, udział intensywnych zależny od wieku (logit 0.6 − 0.07 × (wiek − 30)), parametry obu segmentów (macierz beta_prawda; stałe opcji „żadna” dobrano tak, by tę opcję wybierano w 10–20% zadań), obecne oferty na rynku i nową ofertę w symulatorze, 500 prób bootstrapowych i jeden losowy start algorytmu EM. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym.
1. Paleta, dane i zadanie wyboru: Rysunek 1
R
# Rysunek 1. Jedno zadanie wyboru z ankiety: trzy oferty abonamentu i „żadna z nich” (dane fikcyjne)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomarancz = "#E69F00", zielony = "#009E73", cynober = "#D55E00",
         grafit = "#262626", jasny = "grey92", szary = "grey60")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Fikcyjna ankieta: 400 osób, każda wykonuje 8 zadań wyboru abonamentu komórkowego.
# W zadaniu: 3 oferty o losowych poziomach atrybutów + opcja „żadna z tych ofert”.
poziomy <- list(marka = c("Fala", "Orbita", "Zasięg"),              # fikcyjne sieci komórkowe
                transfer = c("20 GB", "60 GB", "bez limitu"),
                umowa = c("bez umowy", "12 mies.", "24 mies."),
                cena = c(35, 45, 55, 65))                            # zł miesięcznie
N <- 400; zadan <- 8; ofert <- 3

# Prawdziwe preferencje ukryte w danych – dwa segmenty, parametry ustalone ręcznie
# (kolejno: Orbita, Zasięg, 60 GB, bez limitu, 12 mies., 24 mies., cena za 1 zł, „żadna”)
beta_prawda <- rbind(
  oszczedni  = c(orbita = 0.20, zasieg = -0.10, gb60 = 0.40, bezlimitu = 0.70,
                 m12 = -0.30, m24 = -0.70, cena = -0.090, brak = -4.6),
  intensywni = c(orbita = 0.10, zasieg = 0.40, gb60 = 0.90, bezlimitu = 2.00,
                 m12 = -0.20, m24 = -0.40, cena = -0.040, brak = -1.4))

set.seed(620)                                    # ziarno ustalone raz, bez dobierania pod wynik
wiek <- round(runif(N, 18, 65))
p_int <- plogis(0.6 - 0.07 * (wiek - 30))        # młodsi częściej „intensywni” (ręcznie)
segment <- ifelse(runif(N) < p_int, "intensywni", "oszczedni")
osoby <- data.frame(id = 1:N, wiek, segment)

# Pełna randomizacja: każdy poziom każdego atrybutu losowany niezależnie dla każdej oferty
dane <- expand.grid(alt = 1:(ofert + 1), zadanie = 1:zadan, id = 1:N)[, 3:1]
n <- nrow(dane)
dane$marka    <- sample(poziomy$marka, n, replace = TRUE)
dane$transfer <- sample(poziomy$transfer, n, replace = TRUE)
dane$umowa    <- sample(poziomy$umowa, n, replace = TRUE)
dane$cena     <- sample(poziomy$cena, n, replace = TRUE)
dane$brak     <- as.integer(dane$alt == ofert + 1)              # 4. alternatywa = „żadna z tych ofert”
dane[dane$brak == 1, c("marka", "transfer", "umowa")] <- NA
dane$cena[dane$brak == 1] <- 0
dane$wiek <- osoby$wiek[dane$id]

# Kodowanie zero-jedynkowe (poziomy odniesienia: Fala, 20 GB, bez umowy; dla „żadnej” wszystko = 0)
kod01 <- function(x, poziom) as.integer(!is.na(x) & x == poziom)
X <- with(dane, cbind(orbita = kod01(marka, "Orbita"), zasieg = kod01(marka, "Zasięg"),
                      gb60 = kod01(transfer, "60 GB"), bezlimitu = kod01(transfer, "bez limitu"),
                      m12 = kod01(umowa, "12 mies."), m24 = kod01(umowa, "24 mies."),
                      cena = cena, brak = brak))
dane <- cbind(dane, X[, 1:6])
# Użyteczność = część systematyczna (z segmentu osoby) + losowy błąd Gumbela → wybór największej
V <- rowSums(X * beta_prawda[osoby$segment[dane$id], ])
U <- V - log(-log(runif(n)))
dane$zadanie_id <- (dane$id - 1) * zadan + dane$zadanie
dane$wybor <- as.integer(ave(U, dane$zadanie_id, FUN = function(u) u == max(u)))
write.csv(dane[c("id", "wiek", "zadanie", "alt", "marka", "transfer", "umowa", "cena", "brak", "wybor")],
          "conjoint-cbc-abonament-wybory.csv", row.names = FALSE, na = "")

# Opis danych
c(osoby = N, zadania = N * zadan, wiersze = n,
  intensywni_proc = round(100 * mean(segment == "intensywni"), 1), sredni_wiek = round(mean(wiek), 1))
wybrane <- dane[dane$wybor == 1, ]
round(100 * mean(wybrane$brak), 1)               # % zadań, w których wybrano „żadną z tych ofert”
round(100 * prop.table(table(wybrane$transfer)), 1)   # wśród wybranych ofert
round(tapply(wybrane$cena[wybrane$brak == 0], wybrane$transfer[wybrane$brak == 0], mean), 1)

# Grafika: zadanie 1 osoby nr 1 tak, jak widział je respondent
z <- dane[dane$id == 1 & dane$zadanie == 1, ]
z
karta <- data.frame(x = 1:4, naglowek = c(paste("Oferta", LETTERS[1:3]), "Żadna"),
                    marka = c(z$marka[1:3], ""), transfer = c(z$transfer[1:3], ""),
                    umowa = c(z$umowa[1:3], ""), cena = c(paste(z$cena[1:3], "zł / mies."), ""),
                    wybor = z$wybor == 1)
p1 <- ggplot(karta) +
  geom_rect(aes(xmin = x - 0.45, xmax = x + 0.45, ymin = 0.05, ymax = 0.95, linewidth = wybor),
            fill = "white", colour = ifelse(karta$wybor, kol[["niebieski"]], "grey70")) +
  geom_rect(aes(xmin = x - 0.45, xmax = x + 0.45, ymin = 0.80, ymax = 0.95),
            fill = ifelse(karta$wybor, kol[["niebieski"]], "grey88")) +
  geom_text(aes(x, 0.875, label = naglowek), fontface = "bold", size = 5,
            colour = ifelse(karta$wybor, "white", "grey15")) +
  geom_text(aes(x, 0.70, label = marka), fontface = "bold", size = 5.2) +
  geom_text(aes(x, 0.58, label = transfer), size = 4.4) +
  geom_text(aes(x, 0.48, label = umowa), size = 4.4) +
  geom_text(aes(x, 0.34, label = cena), fontface = "bold", size = 4.8, colour = kol[["cynober"]]) +
  geom_text(data = karta[4, ], aes(x, 0.55, label = "Nie wybrał(a)bym\nżadnej z tych\nofert"),
            size = 4.4, lineheight = 0.95, colour = "grey25") +
  geom_text(aes(x, 0.15, label = ifelse(wybor, "WYBÓR RESPONDENTA", "○ wybieram")),
            size = 3.9, fontface = ifelse(karta$wybor, "bold", "plain"),
            colour = ifelse(karta$wybor, kol[["niebieski"]], "grey45")) +
  annotate("text", x = 0.5, y = c(0.70, 0.58, 0.48, 0.34), label = c("Sieć", "Transfer", "Umowa", "Cena"),
           hjust = 1, size = 3.8, colour = "grey40") +
  scale_linewidth_manual(values = c(`FALSE` = 0.5, `TRUE` = 1.6), guide = "none") +
  coord_cartesian(xlim = c(0.1, 4.5), ylim = c(0, 1), expand = FALSE) +
  labs(title = "Zadanie 1 z 8: „Który abonament komórkowy wybierasz?”",
       subtitle = "Poziomy losowane osobno dla każdej oferty; czwarta kolumna to opcja „żadna z tych ofert”") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(),
                panel.grid.major = element_blank(), panel.grid.minor = element_blank())
p1   # ggsave("cbc-zadanie.svg", p1, width = 10, height = 4.6)
Wynik w R
          osoby         zadania         wiersze intensywni_proc     sredni_wiek
          400.0          3200.0         12800.0            46.2            43.0
[1] 17.9

     20 GB      60 GB bez limitu
      21.3       31.1       47.6
     20 GB      60 GB bez limitu
      43.8       44.6       46.0
  id zadanie alt  marka transfer     umowa cena brak wiek orbita zasieg gb60
1  1       1   1   Fala    20 GB bez umowy   65    0   26      0      0    0
2  1       1   2 Zasięg    60 GB  12 mies.   65    0   26      0      1    1
3  1       1   3 Zasięg    60 GB  12 mies.   45    0   26      0      1    1
4  1       1   4   <NA>     <NA>      <NA>    0    1   26      0      0    0
  bezlimitu m12 m24 zadanie_id wybor
1         0   0   0          1     0
2         0   1   0          1     0
3         0   1   0          1     1
4         0   0   0          1     0
2. Warunkowy model logitowy: Rysunek 2
R
# Rysunek 2. Warunkowy model logitowy: użyteczności cząstkowe z 95% przedziałami ufności
# Dane wejściowe: dane, kol i motyw z przepisu 1 (albo plik CSV – zob. komentarz niżej).
library(survival)                                # clogit(): warunkowy model logitowy
# Gdy zaczynasz od pliku CSV:
# dane <- read.csv("conjoint-cbc-abonament-wybory.csv")
# kod01 <- function(x, poziom) as.integer(!is.na(x) & x == poziom)
# dane <- transform(dane, orbita = kod01(marka, "Orbita"), zasieg = kod01(marka, "Zasięg"),
#                   gb60 = kod01(transfer, "60 GB"), bezlimitu = kod01(transfer, "bez limitu"),
#                   m12 = kod01(umowa, "12 mies."), m24 = kod01(umowa, "24 mies."),
#                   zadanie_id = (id - 1) * 8 + zadanie)

# Jedno zadanie = jedna warstwa (strata): model porównuje oferty w obrębie zadania.
# cluster = id: błędy standardowe odporne na powtarzane wybory tej samej osoby.
wzor <- wybor ~ orbita + zasieg + gb60 + bezlimitu + m12 + m24 + cena + brak + strata(zadanie_id)
# method = "efron": przy jednym wyborze w zadaniu daje to samo co dokładna wiarygodność,
# a pozwala policzyć odporne błędy standardowe
m <- clogit(wzor, data = dane, cluster = id, method = "efron")
b <- coef(m); V_b <- vcov(m)                     # vcov = odporna macierz kowariancji
wyn <- data.frame(b = b, se = sqrt(diag(V_b)), dolna = b - 1.96 * sqrt(diag(V_b)), gorna = b + 1.96 * sqrt(diag(V_b)))
round(wyn, 3)
round(exp(b[c("orbita", "zasieg", "gb60", "bezlimitu", "m12", "m24")]), 2)   # ilorazy szans względem odniesienia
# Test ilorazu wiarygodności względem modelu „wybór losowy” i pseudo-R² McFaddena
c(LR = round(2 * diff(m$loglik), 1), df = length(b), logL_0 = round(m$loglik[1], 1), logL = round(m$loglik[2], 1),
  pseudo_R2 = round(1 - m$loglik[2] / m$loglik[1], 3))
# Trafność: w ilu zadaniach model wskazuje alternatywę o największym prawdopodobieństwie, którą wybrano
X <- as.matrix(dane[c("orbita", "zasieg", "gb60", "bezlimitu", "m12", "m24", "cena", "brak")])
dane$V_hat <- drop(X %*% b)
trafione <- tapply(seq_len(nrow(dane)), dane$zadanie_id, function(i) dane$wybor[i][which.max(dane$V_hat[i])] == 1)
round(100 * mean(trafione), 1)                   # % trafień (losowo: 25%)

# Użyteczności cząstkowe względem poziomów odniesienia; cenę przeliczamy na poziomy 45, 55, 65 zł
pw <- data.frame(
  atrybut = rep(c("Sieć", "Transfer", "Umowa", "Cena"), c(3, 3, 3, 4)),
  poziom = c("Fala", "Orbita", "Zasięg", "20 GB", "60 GB", "bez limitu", "bez umowy", "12 mies.", "24 mies.",
             "35 zł", "45 zł", "55 zł", "65 zł"),
  u = c(0, b["orbita"], b["zasieg"], 0, b["gb60"], b["bezlimitu"], 0, b["m12"], b["m24"], b["cena"] * c(0, 10, 20, 30)),
  se = c(0, wyn["orbita", "se"], wyn["zasieg", "se"], 0, wyn["gb60", "se"], wyn["bezlimitu", "se"], 0,
         wyn["m12", "se"], wyn["m24", "se"], wyn["cena", "se"] * c(0, 10, 20, 30)))
pw$odniesienie <- pw$se == 0
pw$atrybut <- factor(pw$atrybut, levels = c("Sieć", "Transfer", "Umowa", "Cena"))
pw$poziom <- factor(pw$poziom, levels = rev(pw$poziom))
print(transform(pw[c("atrybut", "poziom", "u")], u = round(u, 2)), row.names = FALSE)

p2 <- ggplot(pw, aes(u, poziom)) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_errorbar(aes(xmin = u - 1.96 * se, xmax = u + 1.96 * se), orientation = "y", width = 0.25, colour = kol[["niebieski"]],
                 linewidth = 0.8) +
  geom_point(aes(shape = odniesienie, fill = odniesienie), size = 3.2, colour = kol[["niebieski"]]) +
  geom_text(aes(label = ifelse(odniesienie, "odniesienie", sprintf("%.2f", u))), nudge_y = 0.38, size = 3.6,
            colour = "grey25") +
  facet_grid(atrybut ~ ., scales = "free_y", space = "free_y") +
  scale_shape_manual(values = c(`FALSE` = 21, `TRUE` = 23), guide = "none") +
  scale_fill_manual(values = c(`FALSE` = kol[["niebieski"]], `TRUE` = "white"), guide = "none") +
  labs(x = "Użyteczność cząstkowa (skala logitów) z 95% przedziałem ufności", y = NULL,
       title = "Co podnosi, a co obniża szansę wyboru abonamentu",
       subtitle = "Warunkowy model logitowy, 400 osób × 8 zadań; błędy standardowe odporne na skupienie w osobach") +
  motyw + theme(strip.text.y = element_text(angle = 0, hjust = 0))
p2   # ggsave("cbc-uzytecznosci.svg", p2, width = 10, height = 6.4)
Wynik w R
               b    se  dolna  gorna
orbita     0.244 0.060  0.126  0.362
zasieg     0.082 0.063 -0.042  0.205
gb60       0.626 0.066  0.496  0.756
bezlimitu  1.291 0.067  1.160  1.423
m12       -0.153 0.056 -0.264 -0.043
m24       -0.482 0.062 -0.603 -0.360
cena      -0.065 0.003 -0.071 -0.060
brak      -3.022 0.155 -3.325 -2.719
   orbita    zasieg      gb60 bezlimitu       m12       m24
     1.28      1.09      1.87      3.64      0.86      0.62
       LR        df    logL_0      logL pseudo_R2
 1408.500     8.000 -4436.100 -3731.900     0.159
[1] 48.3
  atrybut     poziom     u
     Sieć       Fala  0.00
     Sieć     Orbita  0.24
     Sieć     Zasięg  0.08
 Transfer      20 GB  0.00
 Transfer      60 GB  0.63
 Transfer bez limitu  1.29
    Umowa  bez umowy  0.00
    Umowa   12 mies. -0.15
    Umowa   24 mies. -0.48
     Cena      35 zł  0.00
     Cena      45 zł -0.65
     Cena      55 zł -1.31
     Cena      65 zł -1.96
3. Ważność atrybutów i gotowość do zapłaty: Rysunek 3
R
# Rysunek 3. Ważność atrybutów i gotowość do zapłaty (WTP): metoda delta i bootstrap po osobach
# Dane wejściowe: dane, wzor, m, b, V_b, kol i motyw z przepisów 1–2.
library(patchwork)
# Ważność = rozstęp użyteczności cząstkowych atrybutu / suma rozstępów (cena: 35–65 zł, czyli 30 zł)
waznosc <- function(b) {
  b <- unname(b[c("orbita", "zasieg", "gb60", "bezlimitu", "m12", "m24", "cena")])
  r <- c(Sieć = diff(range(c(0, b[1:2]))), Transfer = diff(range(c(0, b[3:4]))),
         Umowa = diff(range(c(0, b[5:6]))), Cena = abs(b[7]) * 30)
  100 * r / sum(r)
}
# WTP poziomu = −β_poziomu / β_ceny: ile zł miesięcznie wart jest poziom względem poziomu odniesienia
poz <- c(orbita = "Orbita (vs Fala)", zasieg = "Zasięg (vs Fala)", gb60 = "60 GB (vs 20 GB)",
         bezlimitu = "bez limitu (vs 20 GB)", m12 = "umowa 12 mies. (vs bez umowy)", m24 = "umowa 24 mies. (vs bez umowy)")
wtp <- function(b) -b[names(poz)] / b["cena"]
# Metoda delta: gradient WTP względem (β_poziomu, β_ceny) = (−1/β_ceny, β_poziomu/β_ceny²)
se_delta <- sapply(names(poz), function(k) {
  g <- c(-1 / b["cena"], b[k] / b["cena"]^2)
  sqrt(drop(t(g) %*% V_b[c(k, "cena"), c(k, "cena")] %*% g))
})

# Bootstrap po osobach: losujemy 400 osób ze zwracaniem (z kompletem ich zadań), 500 powtórzeń
set.seed(620)
B <- 500
wiersze_osoby <- split(seq_len(nrow(dane)), dane$id)
boot_b <- t(replicate(B, {
  ido <- sample(names(wiersze_osoby), replace = TRUE)
  d <- dane[unlist(wiersze_osoby[ido], use.names = FALSE), ]
  d$zadanie_id <- rep(seq_len(length(ido) * 8), each = 4)   # kopie tej samej osoby = osobne zadania
  coef(clogit(wzor, data = d, method = "efron"))
}))
dim(boot_b)

tab_w <- data.frame(atrybut = names(waznosc(b)), proc = waznosc(b),
                    t(apply(apply(boot_b, 1, waznosc), 1, quantile, c(.025, .975))), row.names = NULL)
names(tab_w)[3:4] <- c("dolna", "gorna")
print(transform(tab_w, proc = round(proc, 1), dolna = round(dolna, 1), gorna = round(gorna, 1)), row.names = FALSE)

w_boot <- apply(boot_b, 1, wtp)
tab_wtp <- data.frame(poziom = poz, wtp = wtp(b),
                      delta_dolna = wtp(b) - 1.96 * se_delta, delta_gorna = wtp(b) + 1.96 * se_delta,
                      boot_dolna = apply(w_boot, 1, quantile, .025), boot_gorna = apply(w_boot, 1, quantile, .975))
print(cbind(tab_wtp[1], round(tab_wtp[-1], 1)), row.names = FALSE)

tab_w$atrybut <- factor(tab_w$atrybut, levels = tab_w$atrybut[order(tab_w$proc)])
p3a <- ggplot(tab_w, aes(proc, atrybut)) +
  geom_col(fill = kol[["szary"]], width = 0.6) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), orientation = "y", width = 0.2, colour = kol[["grafit"]]) +
  geom_text(aes(x = gorna, label = sprintf("%.1f%%", proc)), hjust = -0.2, size = 3.8) +
  scale_x_continuous(limits = c(0, 68), breaks = seq(0, 60, 20), labels = function(x) paste0(x, "%")) +
  labs(x = "Ważność atrybutu (95% CI z bootstrapu)", y = NULL, title = "A. Ważność atrybutów",
       subtitle = "Udział rozstępu użyteczności") + motyw
dw <- rbind(data.frame(poziom = tab_wtp$poziom, wtp = tab_wtp$wtp, dolna = tab_wtp$delta_dolna,
                       gorna = tab_wtp$delta_gorna, metoda = "metoda delta"),
            data.frame(poziom = tab_wtp$poziom, wtp = tab_wtp$wtp, dolna = tab_wtp$boot_dolna,
                       gorna = tab_wtp$boot_gorna, metoda = "bootstrap (500 prób)"))
dw$poziom <- factor(dw$poziom, levels = rev(poz))
p3b <- ggplot(dw, aes(wtp, poziom, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_pointrange(aes(xmin = dolna, xmax = gorna), position = position_dodge(width = 0.55), size = 0.45) +
  scale_colour_manual(values = c("metoda delta" = kol[["niebieski"]], "bootstrap (500 prób)" = kol[["cynober"]]),
                      name = NULL) +
  scale_shape_manual(values = c("metoda delta" = 16, "bootstrap (500 prób)" = 17), name = NULL) +
  labs(x = "WTP (zł miesięcznie) z 95% CI", y = NULL, title = "B. Ile klient dopłaci za poziom",
       subtitle = "WTP = −β poziomu / β ceny") + motyw
p3 <- p3a + p3b + plot_layout(widths = c(1, 1.5))
p3   # ggsave("cbc-waznosc-wtp.svg", p3, width = 10, height = 5.2)
Wynik w R
[1] 500   8
  atrybut proc dolna gorna
     Sieć  6.1   3.2   8.7
 Transfer 32.4  29.5  35.5
    Umowa 12.1   9.5  14.4
     Cena 49.3  45.9  53.0
                        poziom  wtp delta_dolna delta_gorna boot_dolna
              Orbita (vs Fala)  3.7         1.9         5.6        1.7
              Zasięg (vs Fala)  1.2        -0.7         3.1       -0.7
              60 GB (vs 20 GB)  9.6         7.4        11.7        7.6
         bez limitu (vs 20 GB) 19.7        17.0        22.4       17.1
 umowa 12 mies. (vs bez umowy) -2.3        -4.1        -0.6       -4.0
 umowa 24 mies. (vs bez umowy) -7.4        -9.3        -5.4       -9.0
 boot_gorna
        5.5
        3.2
       11.6
       22.6
       -0.7
       -5.6
4. Symulator rynku: Rysunek 4
R
# Rysunek 4. Symulator rynku: udziały ofert przed i po wejściu nowej oferty oraz udział nowej oferty a jej cena
# Dane wejściowe: b, boot_b, kol i motyw z przepisów 1–3.
# Rynek (fikcyjny): trzy obecne oferty i „żadna”; kolumny jak w modelu
oferta <- function(marka, transfer, umowa, cena)
  c(orbita = marka == "Orbita", zasieg = marka == "Zasięg", gb60 = transfer == "60 GB",
    bezlimitu = transfer == "bez limitu", m12 = umowa == "12 mies.", m24 = umowa == "24 mies.", cena = cena, brak = 0)
rynek <- rbind("Fala 60 GB, 24 mies., 45 zł"         = oferta("Fala", "60 GB", "24 mies.", 45),
               "Orbita 20 GB, bez umowy, 35 zł"      = oferta("Orbita", "20 GB", "bez umowy", 35),
               "Zasięg bez limitu, 24 mies., 59 zł"  = oferta("Zasięg", "bez limitu", "24 mies.", 59),
               "żadna z ofert"                       = c(rep(0, 7), brak = 1))
nowa <- function(cena) oferta("Orbita", "bez limitu", "12 mies.", cena)   # nowa oferta: Orbita bez limitu, 12 mies.
udzialy <- function(b, Xm) { e <- exp(drop(Xm %*% b)); 100 * e / sum(e) }    # reguła logitowa (z „żadną”)
cena_nowej <- 49
przed <- udzialy(b, rynek)
X_po <- rbind(rynek[1:3, ], "NOWA: Orbita bez limitu, 12 mies., 49 zł" = nowa(cena_nowej), rynek[4, , drop = FALSE])
po <- udzialy(b, X_po)
ci <- function(M) t(apply(M, 1, quantile, c(.025, .975)))           # przedziały z prób bootstrapowych
przed_ci <- ci(apply(boot_b, 1, udzialy, Xm = rynek)); po_ci <- ci(apply(boot_b, 1, udzialy, Xm = X_po))
round(cbind(przed = przed, przed_ci), 1)
round(cbind(po = po, po_ci), 1)
# Skąd nowa oferta bierze klientów: utrata w punktach procentowych i jako % dawnego udziału
round(cbind(strata_pp = przed - po[-4], strata_proc_udzialu = 100 * (przed - po[-4]) / przed), 1)

# Udział nowej oferty w funkcji jej ceny – tylko w badanym zakresie cen 35–65 zł (bez ekstrapolacji)
siatka <- seq(35, 65, 1)
udz_nowej <- function(b, c0) udzialy(b, rbind(rynek[1:3, ], nowa(c0), rynek[4, ]))[4]
krzywa <- data.frame(cena = siatka, udzial = sapply(siatka, function(c0) udz_nowej(b, c0)),
                     t(sapply(siatka, function(c0) quantile(apply(boot_b, 1, udz_nowej, c0 = c0), c(.025, .975)))))
names(krzywa)[3:4] <- c("dolna", "gorna")
round(krzywa[krzywa$cena %in% c(35, 45, 49, 55, 65), ], 1)
# Kanibalizacja: łączny udział sieci Orbita (stara + nowa oferta) przed i po
c(orbita_przed = round(przed[2], 1), orbita_po = round(po[2] + po[4], 1))

d4 <- rbind(data.frame(oferta = rownames(rynek), udzial = przed, dolna = przed_ci[, 1], gorna = przed_ci[, 2],
                       scenariusz = "dziś"),
            data.frame(oferta = rownames(X_po), udzial = po, dolna = po_ci[, 1], gorna = po_ci[, 2],
                       scenariusz = "po wejściu nowej oferty (49 zł)"))
d4$oferta <- factor(d4$oferta, levels = rev(rownames(X_po)))
p4a <- ggplot(d4, aes(udzial, oferta, fill = scenariusz)) +
  geom_col(position = position_dodge(width = 0.75, preserve = "single"), width = 0.7) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), orientation = "y", position = position_dodge(width = 0.75, preserve = "single"),
                 width = 0.2, colour = kol[["grafit"]]) +
  scale_fill_manual(values = c("dziś" = kol[["szary"]], "po wejściu nowej oferty (49 zł)" = kol[["niebieski"]]),
                    name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), expand = expansion(mult = c(0, 0.05))) +
  labs(x = "Przewidywany udział w wyborach (95% CI)", y = NULL, title = "A. Udziały przed i po",
       subtitle = "Reguła logitowa z „żadną z ofert”") + motyw
p4b <- ggplot(krzywa, aes(cena, udzial)) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), fill = kol[["niebieski"]], alpha = 0.2) +
  geom_line(colour = kol[["niebieski"]], linewidth = 1) +
  geom_point(data = krzywa[krzywa$cena == cena_nowej, ], size = 3, colour = kol[["niebieski"]]) +
  annotate("text", x = cena_nowej + 1.5, y = krzywa$udzial[krzywa$cena == cena_nowej],
           label = sprintf("49 zł: %.1f%%", krzywa$udzial[krzywa$cena == cena_nowej]), hjust = 0, size = 3.8) +
  scale_y_continuous(labels = function(x) paste0(x, "%")) +
  labs(x = "Cena nowej oferty (zł miesięcznie)", y = "Udział nowej oferty", title = "B. Udział a cena nowej oferty",
       subtitle = "Pasmo: 95% CI (bootstrap)") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1.25, 1))
p4   # ggsave("cbc-symulator.svg", p4, width = 10, height = 5.4)
Wynik w R
                                   przed 2.5% 97.5%
Fala 60 GB, 24 mies., 45 zł         21.0 18.3  23.8
Orbita 20 GB, bez umowy, 35 zł      44.5 40.1  49.5
Zasięg bez limitu, 24 mies., 59 zł  17.7 14.4  20.8
żadna z ofert                       16.8 15.4  18.3
                                           po 2.5% 97.5%
Fala 60 GB, 24 mies., 45 zł              13.5 11.6  15.8
Orbita 20 GB, bez umowy, 35 zł           28.6 25.3  32.1
Zasięg bez limitu, 24 mies., 59 zł       11.4  9.4  13.4
NOWA: Orbita bez limitu, 12 mies., 49 zł 35.7 32.3  39.3
żadna z ofert                            10.8  9.9  11.9
                                   strata_pp strata_proc_udzialu
Fala 60 GB, 24 mies., 45 zł              7.5                35.7
Orbita 20 GB, bez umowy, 35 zł          15.9                35.7
Zasięg bez limitu, 24 mies., 59 zł       6.3                35.7
żadna z ofert                            6.0                35.7
   cena udzial dolna gorna
1    35   58.2  54.7  61.5
11   45   41.9  38.4  45.6
15   49   35.7  32.3  39.3
21   55   27.3  24.1  30.6
31   65   16.3  13.7  19.0
orbita_przed.Orbita 20 GB, bez umowy, 35 zł
                                       44.5
   orbita_po.Orbita 20 GB, bez umowy, 35 zł
                                       64.4
5. Grupy wieku, logit z dwiema klasami i IIA: Rysunek 5
R
# Rysunek 5. Pułapki: jedno WTP dla wszystkich (A) i założenie IIA w symulatorze (B)
# Dane wejściowe: dane, osoby, beta_prawda, wzor, m, b, V_b, rynek, X_po, przed, po, kol i motyw z przepisów 1–4.
zm <- c("orbita", "zasieg", "gb60", "bezlimitu", "m12", "m24", "cena", "brak")
X <- as.matrix(dane[zm])

# 1) Najprostsza próba: osobne parametry dla młodszych (< 35 lat) i starszych – interakcje z grupą wieku
dane$mlodszy <- as.integer(dane$wiek < 35)
wzor_w <- update(wzor, paste(". ~ . +", paste0(zm, ":mlodszy", collapse = " + ")))
mw <- clogit(wzor_w, data = dane, cluster = id, method = "efron")
LR_w <- 2 * (mw$loglik[2] - m$loglik[2])
c(mlodsi_osoby = sum(osoby$wiek < 35), LR = round(LR_w, 1), df = length(zm),
  p = round(pchisq(LR_w, length(zm), lower.tail = FALSE), 3))

# 2) Logit z dwiema klasami latentnymi (algorytm EM, liczony ręcznie):
#    E – prawdopodobieństwo, że osoba należy do klasy, z iloczynu prawdopodobieństw jej 8 wyborów;
#    M – w każdej klasie clogit ważony tymi prawdopodobieństwami.
log_wiar_osoby <- function(bb) {                # log-wiarygodność 8 wyborów każdej osoby przy parametrach bb
  v <- drop(X %*% bb)
  lp <- v - ave(v, dane$zadanie_id, FUN = function(x) log(sum(exp(x))))
  tapply(lp * dane$wybor, dane$id, sum)
}
set.seed(620)
post <- runif(nrow(osoby)); post <- cbind(post, 1 - post)     # losowy start przynależności
ll_stare <- -Inf
for (iter in 1:200) {
  bk <- lapply(1:2, function(k) {
    d <- dane; d$w <- post[d$id, k]
    coef(clogit(wzor, data = d, weights = w, method = "efron"))
  })
  pi_k <- colMeans(post)
  L <- sapply(1:2, function(k) log(pi_k[k]) + log_wiar_osoby(bk[[k]]))
  mx <- apply(L, 1, max); ll <- sum(mx + log(rowSums(exp(L - mx))))
  post <- exp(L - mx); post <- post / rowSums(post)
  if (ll - ll_stare < 1e-6) break
  ll_stare <- ll
}
kol_cena <- order(sapply(bk, function(x) x["cena"]))          # klasa 1 = silniej reaguje na cenę
bk <- bk[kol_cena]; post <- post[, kol_cena]; pi_k <- colMeans(post)
c(iteracje = iter, logL_2klasy = round(ll, 1), logL_1klasa = round(m$loglik[2], 1),
  BIC_1klasa = round(-2 * m$loglik[2] + 8 * log(nrow(osoby)), 1), BIC_2klasy = round(-2 * ll + 17 * log(nrow(osoby)), 1))
round(rbind(klasa_1 = bk[[1]], klasa_2 = bk[[2]]), 3)
round(100 * pi_k, 1)                             # udziały klas
klasa <- apply(post, 1, which.max)
table(klasa, prawdziwy_segment = osoby$segment)  # zgodność z segmentami ukrytymi w danych
round(100 * mean(c("oszczedni", "intensywni")[klasa] == osoby$segment), 1)   # % osób przypisanych do właściwego segmentu
round(c(wiek_klasa1 = sum(post[, 1] * osoby$wiek) / sum(post[, 1]), wiek_klasa2 = sum(post[, 2] * osoby$wiek) / sum(post[, 2])), 1)

# WTP: model wspólny (z 95% CI metodą delta), dwie klasy i prawda z ukrytych segmentów
wtp_tab <- do.call(rbind, lapply(c("gb60", "bezlimitu"), function(k) {
  g <- c(-1 / b["cena"], b[k] / b["cena"]^2); se <- sqrt(drop(t(g) %*% V_b[c(k, "cena"), c(k, "cena")] %*% g))
  data.frame(poziom = ifelse(k == "gb60", "60 GB (vs 20 GB)", "bez limitu (vs 20 GB)"),
             model = c("model wspólny", "klasa 1 (oszczędni)", "klasa 2 (intensywni)"),
             wtp = c(-b[k] / b["cena"], -bk[[1]][k] / bk[[1]]["cena"], -bk[[2]][k] / bk[[2]]["cena"]),
             dolna = c(-b[k] / b["cena"] - 1.96 * se, NA, NA), gorna = c(-b[k] / b["cena"] + 1.96 * se, NA, NA),
             prawda = c(NA, -beta_prawda[c("oszczedni", "intensywni"), k] / beta_prawda[c("oszczedni", "intensywni"), "cena"]),
             row.names = NULL)
}))
print(cbind(wtp_tab[1:2], round(wtp_tab[3:6], 1)), row.names = FALSE)

# Skąd nowa oferta bierze klientów: utrata jako % dawnego udziału każdej oferty
udz_klasy <- function(Xm) 100 * Reduce(`+`, lapply(1:2, function(k) {      # mieszanina: Σ π_k × udział w klasie k
  e <- exp(drop(Xm %*% bk[[k]])); pi_k[k] * e / sum(e) }))
udz_prawda <- function(Xm) {                     # średnia udziałów liczonych dla każdej osoby z jej segmentu
  B_os <- beta_prawda[osoby$segment, ]
  100 * rowMeans(apply(B_os, 1, function(bb) { e <- exp(drop(Xm %*% bb)); e / sum(e) }))
}
utrata <- function(pr, po) 100 * (pr - po[-4]) / pr
d5b <- data.frame(oferta = rep(rownames(rynek), 3),
                  model = rep(c("model wspólny (IIA)", "logit z 2 klasami", "prawda (ukryte segmenty)"), each = 4),
                  utrata = c(utrata(przed, po), utrata(udz_klasy(rynek), udz_klasy(X_po)),
                             utrata(udz_prawda(rynek), udz_prawda(X_po))))
print(transform(d5b, utrata = round(utrata, 1)), row.names = FALSE)
round(c(nowa_model_wspolny = po[[4]], nowa_2klasy = udz_klasy(X_po)[[4]], nowa_prawda = udz_prawda(X_po)[[4]]), 1)

wtp_tab$model <- factor(wtp_tab$model, levels = rev(c("model wspólny", "klasa 1 (oszczędni)", "klasa 2 (intensywni)")))
p5a <- ggplot(wtp_tab, aes(wtp, model)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), orientation = "y", width = 0.2, colour = kol[["grafit"]], na.rm = TRUE) +
  geom_point(aes(x = prawda, shape = "prawdziwe WTP segmentu"), size = 3.6, stroke = 1.2, colour = kol[["cynober"]], na.rm = TRUE) +
  geom_point(aes(colour = model, shape = "oszacowanie"), size = 3) +
  facet_wrap(~ poziom, ncol = 1) +
  scale_colour_manual(values = c("model wspólny" = kol[["grafit"]], "klasa 1 (oszczędni)" = kol[["zielony"]],
                                 "klasa 2 (intensywni)" = kol[["pomarancz"]]), guide = "none") +
  scale_shape_manual(values = c("oszacowanie" = 16, "prawdziwe WTP segmentu" = 4), name = NULL) +
  labs(x = "Gotowość do zapłaty (zł miesięcznie)", y = NULL, title = "A. Jedno WTP dla wszystkich",
       subtitle = "Model wspólny z 95% CI i logit z 2 klasami") + motyw
d5b$oferta <- factor(sub(",.*", "", d5b$oferta), levels = rev(sub(",.*", "", rownames(rynek))))
d5b$model <- factor(d5b$model, levels = rev(unique(d5b$model)))
p5b <- ggplot(d5b, aes(utrata, oferta, fill = model)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75) +
  geom_text(aes(label = sprintf("%.0f%%", utrata)), position = position_dodge(width = 0.8), hjust = -0.15, size = 3.3) +
  scale_fill_manual(values = c("model wspólny (IIA)" = kol[["szary"]], "logit z 2 klasami" = kol[["pomarancz"]],
                               "prawda (ukryte segmenty)" = kol[["niebieski"]]), name = NULL,
                    breaks = c("model wspólny (IIA)", "logit z 2 klasami", "prawda (ukryte segmenty)")) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), expand = expansion(mult = c(0, 0.18))) +
  guides(fill = guide_legend(ncol = 1)) +
  labs(x = "Utrata udziału po wejściu nowej oferty\n(% dawnego udziału)", y = NULL,
       title = "B. Kogo kanibalizuje nowa oferta", subtitle = "IIA: każdy traci ten sam odsetek") + motyw
p5 <- p5a + p5b
p5   # ggsave("cbc-heterogenicznosc-iia.svg", p5, width = 10, height = 6.2)
Wynik w R
mlodsi_osoby           LR           df            p
     115.000       10.100        8.000        0.256
   iteracje logL_2klasy logL_1klasa  BIC_1klasa  BIC_2klasy
      128.0     -3704.0     -3731.9      7511.7      7509.9
        orbita zasieg  gb60 bezlimitu    m12    m24   cena   brak
klasa_1  0.260 -0.253 0.308     0.646 -0.086 -0.424 -0.099 -4.940
klasa_2  0.233  0.319 0.930     1.823 -0.201 -0.560 -0.045 -1.722
[1] 43.4 56.6
     prawdziwy_segment
klasa intensywni oszczedni
    1         25       143
    2        160        72
[1] 75.8
wiek_klasa1 wiek_klasa2
       44.3        41.9
                poziom                model  wtp dolna gorna prawda
      60 GB (vs 20 GB)        model wspólny  9.6   7.4  11.7     NA
      60 GB (vs 20 GB)  klasa 1 (oszczędni)  3.1    NA    NA    4.4
      60 GB (vs 20 GB) klasa 2 (intensywni) 20.8    NA    NA   22.5
 bez limitu (vs 20 GB)        model wspólny 19.7  17.0  22.4     NA
 bez limitu (vs 20 GB)  klasa 1 (oszczędni)  6.5    NA    NA    7.8
 bez limitu (vs 20 GB) klasa 2 (intensywni) 40.8    NA    NA   50.0
                             oferta                    model utrata
        Fala 60 GB, 24 mies., 45 zł      model wspólny (IIA)   35.7
     Orbita 20 GB, bez umowy, 35 zł      model wspólny (IIA)   35.7
 Zasięg bez limitu, 24 mies., 59 zł      model wspólny (IIA)   35.7
                      żadna z ofert      model wspólny (IIA)   35.7
        Fala 60 GB, 24 mies., 45 zł        logit z 2 klasami   34.3
     Orbita 20 GB, bez umowy, 35 zł        logit z 2 klasami   29.2
 Zasięg bez limitu, 24 mies., 59 zł        logit z 2 klasami   40.3
                      żadna z ofert        logit z 2 klasami   35.5
        Fala 60 GB, 24 mies., 45 zł prawda (ukryte segmenty)   30.1
     Orbita 20 GB, bez umowy, 35 zł prawda (ukryte segmenty)   25.0
 Zasięg bez limitu, 24 mies., 59 zł prawda (ukryte segmenty)   36.7
                      żadna z ofert prawda (ukryte segmenty)   30.8
nowa_model_wspolny        nowa_2klasy        nowa_prawda
              35.7               33.6               29.6
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (delta / bootstrap)" = c("#0072B2", "#D55E00"),
             "szary – niebieski (dziś / po wejściu oferty)" = c("grey60", "#0072B2"),
             "zielony – pomarańczowy (klasa 1 / klasa 2)" = c("#009E73", "#E69F00"),
             "zielony – grafit (klasa 1 / model wspólny)" = c("#009E73", "#262626"),
             "cynober – zielony (prawda / klasa 1)" = c("#D55E00", "#009E73"),
             "cynober – pomarańczowy (prawda / klasa 2)" = c("#D55E00", "#E69F00"),
             "szary – pomarańczowy (IIA / 2 klasy)" = c("grey60", "#E69F00"),
             "pomarańczowy – niebieski (2 klasy / prawda)" = c("#E69F00", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  k <- col2rgb(k) / 255
  lab <- coords(as(sRGB(t(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                             widzenie_typowe deuteranopia
niebieski – cynober (delta / bootstrap)                114.6        108.3
szary – niebieski (dziś / po wejściu oferty)            44.9         48.9
zielony – pomarańczowy (klasa 1 / klasa 2)              88.7         66.3
zielony – grafit (klasa 1 / model wspólny)              63.8         41.7
cynober – zielony (prawda / klasa 1)                   102.4         53.5
cynober – pomarańczowy (prawda / klasa 2)               33.4         18.4
szary – pomarańczowy (IIA / 2 klasy)                    76.8         73.9
pomarańczowy – niebieski (2 klasy / prawda)            120.2        121.5
czerwony – zielony (do unikania)                       121.7         21.1
                                             protanopia
niebieski – cynober (delta / bootstrap)            91.9
szary – niebieski (dziś / po wejściu oferty)       40.6
zielony – pomarańczowy (klasa 1 / klasa 2)         51.5
zielony – grafit (klasa 1 / model wspólny)         49.0
cynober – zielony (prawda / klasa 1)               37.3
cynober – pomarańczowy (prawda / klasa 2)          24.9
szary – pomarańczowy (IIA / 2 klasy)               70.0
pomarańczowy – niebieski (2 klasy / prawda)       109.3
czerwony – zielony (do unikania)                   31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Warunkowy model logitowy oszacowano funkcją clogit() z pakietu survival; bootstrap, metodę delta, symulator rynku i algorytm EM dla modelu z dwiema klasami zapisano w bazowym R. Rysunki wykonano w ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak policzyć conjoint wyborczy (CBC) w R bez specjalnych pakietów?
Zapisz dane w formacie długim (jeden wiersz = jedna alternatywa w jednym zadaniu), zakoduj atrybuty zero-jedynkowo, a cenę liczbowo, i oszacuj warunkowy model logitowy funkcją clogit() z pakietu survival z strata(zadanie). Opcja „żadna z ofert” dostaje własną stałą. Przy powtarzanych zadaniach dodaj cluster = id i method = "efron", żeby uzyskać błędy standardowe odporne na skupienie w osobach.
Jak obliczyć gotowość do zapłaty (WTP) z analizy conjoint?
Podziel współczynnik poziomu przez współczynnik ceny ze znakiem minus: WTP = −β poziomu / β ceny. Cena musi być w modelu zmienną liczbową. W przykładzie β transferu bez limitu wyniosło 1.291, a β ceny −0.065 na 1 zł, co daje 19.7 zł miesięcznie. Przedział ufności policz metodą delta albo bootstrapem po respondentach – w przykładzie oba dały prawie to samo: [17.0, 22.4] i [17.1, 22.6] zł.
Czym różni się ważność atrybutu od gotowości do zapłaty w conjoint?
Ważność to procent sumy rozstępów użyteczności, który przypada na atrybut – mówi, jak bardzo atrybut różnicował wybory w badanym zakresie poziomów. Gotowość do zapłaty przelicza różnicę między dwoma poziomami na złotówki. Ważność zmienia się, gdy rozszerzysz zakres cen lub poziomów, a WTP dotyczy konkretnej pary poziomów.
Co oznacza założenie IIA w symulatorze udziałów conjoint?
Niezależność od nieistotnych alternatyw oznacza, że nowa oferta zabiera każdej obecnej ten sam odsetek udziału. W przykładzie model wspólny przewidział utratę 35.7% udziału dla wszystkich ofert, a według parametrów ukrytych w danych oferta podobna do nowej traciła 36.7%, a tania oferta dla oszczędnych tylko 25.0%. Model z klasami latentnymi lub inne modele dopuszczające różne preferencje osłabiają ten problem.
Czy w zadaniach conjoint wyborczego potrzebna jest opcja „żadna z ofert”?
Zwykle tak, jeśli chcesz szacować popyt. Bez niej respondent musi coś wybrać, więc symulator przypisuje popyt także osobom, które nie kupiłyby żadnej oferty. W przykładzie odpowiedź „żadna” padła w 17.9% zadań. W modelu opcja ta wymaga osobnej stałej.
Powiązane hasła
Przeczytaj też
Eksperyment conjoint i winietowy
Atrybuty i zadania, AMCE z błędami klastrowanymi, średnie brzegowe w podgrupach i winiety w modelu mieszanym – na danych w R.
Czytaj →PoradnikMaxDiff – plan badania i analiza
Plan BIBD, wyniki B − W, warunkowy logit i udziały preferencji w R oraz porównanie ze skalą Likerta na tych samych osobach.
Czytaj →PoradnikBadanie ceny: van Westendorp i Gabor–Granger
Abonament serwisu rowerowego: krzywe van Westendorpa z bootstrapem, popyt i przychód Gabora–Grangera, zakotwiczenie i deklaracje a zakupy – z kodem R.
Czytaj →PoradnikAnaliza TURF
Który zestaw smaków dotrze do największej liczby klientów: zasięg, częstość, przegląd 495 zestawów i bootstrap zwycięzcy z kodem R.
Czytaj →PoradnikKlasy latentne w marketingu
Ankieta 1000 klientów drogerii: ile klas, profil, entropia, karty segmentów z działaniami, wiek jako kowariant i LCA a k-średnich – sześć rysunków z kodem R.
Czytaj →PoradnikModel atrakcyjności udziałów (MCI)
Rynek proszków do prania: udział jako atrakcyjność, log-centrowanie, elastyczności krzyżowe, symulacja obniżki ceny i logit udziałów – z kodem R.
Czytaj →PoradnikEfekt wabika w pakietach
Trzeci, gorszy pakiet w cenniku: eksperyment A/B, model wielomianowy, naruszenie IIA, przychód na odwiedzającego i moc – z kodem R.
Czytaj →Analizujesz conjoint w pracy z marketingu?
Pomożemy zaplanować zadania wyboru, oszacować model, policzyć ważność atrybutów i gotowość do zapłaty, zbudować symulator rynku i opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cheng, S., & Long, J. S. (2007). Testing for IIA in the multinomial logit model. Sociological Methods & Research, 35(4), 583–600. https://doi.org/10.1177/0049124106292361
- Green, P. E., & Srinivasan, V. (1990). Conjoint analysis in marketing: New developments with implications for research and practice. Journal of Marketing, 54(4), 3–19. https://doi.org/10.1177/002224299005400402
- Hainmueller, J., Hangartner, D., & Yamamoto, T. (2015). Validating vignette and conjoint survey experiments against real-world behavior. Proceedings of the National Academy of Sciences, 112(8), 2395–2400. https://doi.org/10.1073/pnas.1416587112 ● Otwarty dostęp
- Hauber, A. B., González, J. M., Groothuis-Oudshoorn, C. G. M., Prior, T., Marshall, D. A., Cunningham, C., IJzerman, M. J., & Bridges, J. F. P. (2016). Statistical methods for the analysis of discrete choice experiments: A report of the ISPOR Conjoint Analysis Good Research Practices Task Force. Value in Health, 19(4), 300–315. https://doi.org/10.1016/j.jval.2016.04.004 ● Otwarty dostęp
- Hole, A. R. (2007). A comparison of approaches to estimating confidence intervals for willingness to pay measures. Health Economics, 16(8), 827–840. https://doi.org/10.1002/hec.1197
- Kamakura, W. A., & Russell, G. J. (1989). A probabilistic choice model for market segmentation and elasticity structure. Journal of Marketing Research, 26(4), 379–390. https://doi.org/10.1177/002224378902600401
Cytowania BibTeX
@article{cheng2007testing, author={Cheng, Simon and Long, J. Scott}, title={{Testing for IIA in the multinomial logit model}}, journal={Sociological Methods \& Research}, year={2007}, volume={35}, number={4}, pages={583--600}, doi={10.1177/0049124106292361}}@article{green1990conjoint, author={Green, Paul E. and Srinivasan, V.}, title={{Conjoint analysis in marketing: New developments with implications for research and practice}}, journal={Journal of Marketing}, year={1990}, volume={54}, number={4}, pages={3--19}, doi={10.1177/002224299005400402}}@article{hainmueller2015validating, author={Hainmueller, Jens and Hangartner, Dominik and Yamamoto, Teppei}, title={{Validating vignette and conjoint survey experiments against real-world behavior}}, journal={Proceedings of the National Academy of Sciences}, year={2015}, volume={112}, number={8}, pages={2395--2400}, doi={10.1073/pnas.1416587112}}@article{hauber2016statistical, author={Hauber, A. Brett and González, Juan Marcos and Groothuis-Oudshoorn, Catharina G. M. and Prior, Thomas and Marshall, Deborah A. and Cunningham, Charles and IJzerman, Maarten J. and Bridges, John F. P.}, title={{Statistical methods for the analysis of discrete choice experiments: A report of the ISPOR Conjoint Analysis Good Research Practices Task Force}}, journal={Value in Health}, year={2016}, volume={19}, number={4}, pages={300--315}, doi={10.1016/j.jval.2016.04.004}}@article{hole2007comparison, author={Hole, Arne Risa}, title={{A comparison of approaches to estimating confidence intervals for willingness to pay measures}}, journal={Health Economics}, year={2007}, volume={16}, number={8}, pages={827--840}, doi={10.1002/hec.1197}}@article{kamakura1989probabilistic, author={Kamakura, Wagner A. and Russell, Gary J.}, title={{A probabilistic choice model for market segmentation and elasticity structure}}, journal={Journal of Marketing Research}, year={1989}, volume={26}, number={4}, pages={379--390}, doi={10.1177/002224378902600401}}