MaxDiff: wybór zamiast oceny
MaxDiff, czyli best–worst scaling (BWS), mierzy względną ważność kilkunastu elementów: cech pracy, oczekiwań pacjentów, argumentów kampanii, celów polityki. Respondent widzi kilka zestawów po kilka elementów i w każdym wskazuje najważniejszy i najmniej ważny. Louviere i in. (2015) opisują tę metodę jako rozszerzenie porównań parami na wybory z większych zbiorów. Krótką definicję znajdziesz w haśle MaxDiff (best–worst scaling), a tutaj pokazujemy, jak zaplanować badanie i jak je policzyć.
Pierwotną postacią metody jest przypadek obiektów (ang. object case, case 1), zaproponowany przez Finna i Louviere'a (1992) w badaniu oczekiwań wobec polityki bezpieczeństwa żywności. Mühlbacher i in. (2016) wyróżniają jeszcze przypadek profili i wielu profili. Te dwa warianty są bliżej analizy conjoint, bo respondent ocenia poziomy atrybutów, a nie same elementy. Flynn i in. (2007) pokazują, że zadanie best–worst pozwala porównać ważność cech między sobą, czego nie dają parametry zwykłego eksperymentu wyboru. W tym wpisie zajmujemy się wyłącznie przypadkiem obiektów.
| Metoda | Zadanie respondenta | Co otrzymujesz | Główne ograniczenie |
|---|---|---|---|
| Skala Likerta | ocenia każdy element osobno, np. 1–5 | średnie ocen, wyniki porównywalne między osobami tylko przy tym samym stylu odpowiadania | wszystko może być „bardzo ważne”; style odpowiedzi i efekt sufitu |
| Ranking | porządkuje wszystkie elementy | pełny porządek u każdej osoby | przy kilkunastu elementach zadanie męczy, a środkowe pozycje bywają przypadkowe |
| MaxDiff | w każdym małym zestawie wskazuje element najlepszy i najgorszy | wyniki na wspólnej skali ważności, liczone z wyborów | wynik względny (ipsatywny); brak informacji, czy cokolwiek jest ważne w sensie bezwzględnym |
Mühlbacher i in. (2016) przypominają, że przypadek obiektów pomyślano jako zastępstwo ocen i skal Likerta, bo omija ich znane słabości. Lee i in. (2007) porównali MaxDiff z ocenami i rangowaniem na liście wartości Kahle'a. Wyniki sugerują, że wybory best–worst mogą dawać lepsze oszacowania. Ceną jest to, że wynik jest ipsatywny: mówi, co jest ważniejsze od czego, a nie, czy coś jest ważne w ogóle. Jeśli to drugie też Cię interesuje, dodaj jedno pytanie z oceną porządkową albo pozostań przy skali (zob. ile stopni skali Likerta wybrać).
Plan badania: lista elementów i zestawy
Lista elementów. Elementy muszą być jednowymiarowe, krótkie i porównywalne. Element „dobra atmosfera i miły szef” łączy dwie rzeczy i psuje pomiar tak samo jak pytanie dwuznaczne w zwykłej ankiecie. Listę sprawdź w badaniu pilotażowym: czy respondenci rozumieją każdy element tak samo i czy żaden nie dominuje wszystkich wyborów.
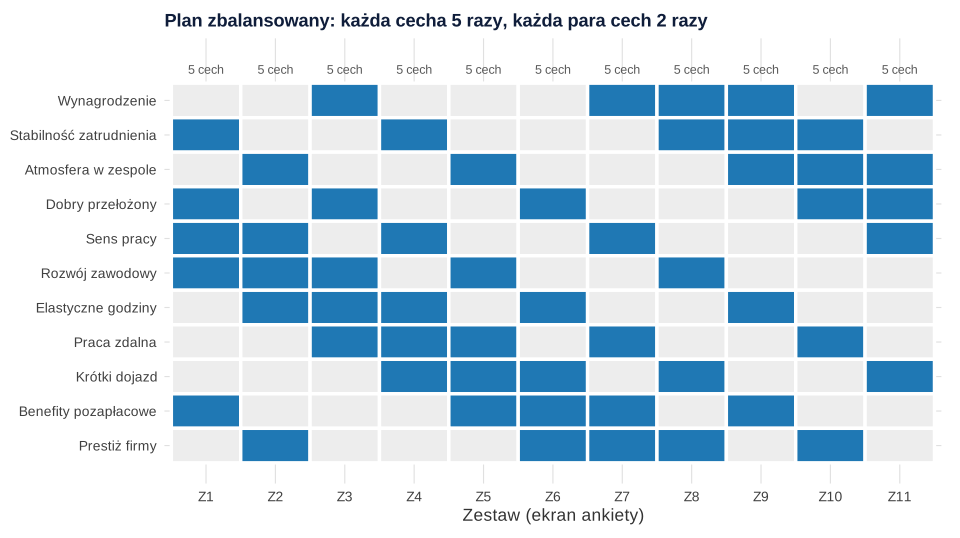
Plan zbalansowany. Najczęściej używa się zbalansowanego niekompletnego układu blokowego (BIBD). Każdy element pojawia się tyle samo razy (r), każdy zestaw ma tyle samo elementów (k), a każda para elementów występuje razem tyle samo razy (λ). W przeglądzie badań zdrowotnych Cheunga i in. (2016) ten plan miało 54% badań typu obiektów. Liczby nie są dowolne: z v elementów otrzymasz b = v × r / k zestawów, a λ = r × (k − 1) / (v − 1) musi być liczbą całkowitą.
| Elementy v | Elementów w zestawie k | Pokazań elementu r | Zestawy b | Wspólne wystąpienia pary λ |
|---|---|---|---|---|
| 7 | 3 | 3 | 7 | 1 |
| 9 | 3 | 4 | 12 | 1 |
| 11 | 5 | 5 | 11 | 2 |
| 13 | 4 | 4 | 13 | 1 |
| 16 | 4 | 5 | 20 | 1 |
Zwykle stosuje się małe zestawy, np. po 4–5 elementów: większy zestaw daje więcej informacji z jednego ekranu, ale utrudnia wybór. Gdy żaden BIBD nie pasuje do Twojej listy, użyj planu prawie zbalansowanego i sprawdź częstości elementów i par. Kolejność zestawów i pozycje elementów w zestawie losuj dla każdej osoby (randomizacja), bo element pokazywany zawsze na górze może dostawać dodatkowe wskazania. To ten sam mechanizm co efekt kolejności pytań.
Ile zestawów na osobę? W podstawowym wariancie każdy respondent odpowiada na wszystkie b zestawów. Dzięki temu masz wyniki indywidualne i możesz szukać segmentów. Przy długiej liście plan dzieli się na wersje (bloki) przydzielane losowo. Wyniki indywidualne są wtedy mniej dokładne. Plan, liczbę wersji i regułę analizy zapisz przed zebraniem danych (zob. plan analizy i prerejestracja).
Przykład: co jest najważniejsze w pracy
Pracownicy (N = 300, dane symulowane, set.seed(3250)) wybierali spośród 11 cech pracy, m.in. wynagrodzenia, stabilności zatrudnienia, atmosfery w zespole i pracy zdalnej. Plan to cykliczny BIBD z v = 11, k = 5, r = 5, czyli 11 zestawów, w których każda para cech występuje razem dokładnie 2 razy (rysunek 1). Razem daje to 3300 odpowiedzi na zestawy. Dane w formacie jeden wiersz = jeden zestaw u jednej osoby są w pliku CSV.
Wyniki zliczeniowe: B, W i B − W
Najprostsza analiza to zliczenie, ile razy każdą cechę wskazano jako najważniejszą (B) i najmniej ważną (W). Mühlbacher i in. (2016) opisują wynik B − W oraz pierwiastek z ilorazu B/W. Wynik standaryzowany (B − W) / (n × r) leży między −1 a 1 i nie zależy od liczby respondentów. Wartość 1 oznacza cechę wybieraną jako najważniejsza za każdym razem, gdy ją pokazano.
| Cecha | B | W | B − W | (B − W) / (n × r) | √(B/W) | Wynik indywidualny M [95% CI] |
|---|---|---|---|---|---|---|
| Wynagrodzenie | 574 | 119 | 455 | .303 | 2.20 | 1.52 [1.34, 1.70] |
| Atmosfera w zespole | 465 | 130 | 335 | .223 | 1.89 | 1.12 [0.94, 1.29] |
| Stabilność zatrudnienia | 443 | 127 | 316 | .211 | 1.87 | 1.05 [0.89, 1.22] |
| Dobry przełożony | 395 | 193 | 202 | .135 | 1.43 | 0.67 [0.49, 0.86] |
| Sens pracy | 305 | 218 | 87 | .058 | 1.18 | 0.29 [0.11, 0.47] |
| Rozwój zawodowy | 280 | 249 | 31 | .021 | 1.06 | 0.10 [−0.08, 0.28] |
| Elastyczne godziny | 238 | 296 | −58 | −.039 | 0.90 | −0.19 [−0.37, −0.02] |
| Praca zdalna | 207 | 355 | −148 | −.099 | 0.76 | −0.49 [−0.68, −0.30] |
| Krótki dojazd | 173 | 442 | −269 | −.179 | 0.63 | −0.90 [−1.09, −0.71] |
| Benefity pozapłacowe | 123 | 551 | −428 | −.285 | 0.47 | −1.43 [−1.60, −1.25] |
| Prestiż firmy | 97 | 620 | −523 | −.349 | 0.40 | −1.74 [−1.91, −1.58] |
Wynagrodzenie wygrywa wyraźnie, a atmosfera w zespole i stabilność zatrudnienia są praktycznie na równi. Prestiż firmy i benefity pozapłacowe są na końcu. Wynik indywidualny to dla każdej osoby liczba wskazań „najważniejsza” minus „najmniej ważna”, od −5 do 5. Średnie z przedziałami ufności pokazują, które różnice są oszacowane pewnie. Rozwój zawodowy (M = 0.10, 95% CI [−0.08, 0.28]) nie odróżnia się od zera, czyli od przeciętnej cechy z listy. Suma wyników indywidualnych każdej osoby wynosi 0. To właśnie ipsatywność: wyników tych nie wolno traktować jak 11 niezależnych zmiennych, np. w analizie czynnikowej (zob. ipsatyzacja).
Warunkowy model logitowy i udziały preferencji
Zliczenia opisują dane, model daje skalę z błędami standardowymi. Każdy zestaw zamieniamy na dwa zbiory wyboru. W zbiorze „najlepsza” cechy mają kodowanie +1, a w zbiorze „najgorsza” −1, bo wybór najgorszej to wybór najniższej użyteczności. Model logitowy szacuje użyteczność każdej cechy względem cechy odniesienia (tu: prestiż firmy = 0), porównując wybór z pozostałymi cechami w tym samym zbiorze. To ten sam model co w wielomianowej regresji logistycznej, tyle że zbiór możliwych odpowiedzi zmienia się z zestawu na zestaw. W R liczymy go funkcją survival::clogit z warstwami (strata) równymi zbiorom wyboru.
Uproszczenie. Traktujemy najgorszą cechę jako wybraną z całego zestawu pięciu, choć respondent wybierał ją z czterech pozostałych po wskazaniu najlepszej. Oba zbiory są też traktowane jak niezależne, choć pochodzą z jednego ekranu. W dokumentacji pakietu support.BWS ten wariant nazywa się modelem brzegowym (marginal), a wariant z czterema cechami – sekwencyjnym. Ponieważ każda osoba dokonuje 22 wyborów, błędy standardowe liczymy jako odporne na klastrowanie w osobach.
| Cecha | b | SE odporny | SE modelowy | Udział preferencji |
|---|---|---|---|---|
| Wynagrodzenie | 1.971 | 0.080 | 0.065 | 19.1% |
| Atmosfera w zespole | 1.727 | 0.079 | 0.064 | 15.0% |
| Stabilność zatrudnienia | 1.703 | 0.076 | 0.065 | 14.6% |
| Dobry przełożony | 1.457 | 0.081 | 0.064 | 11.4% |
| Sens pracy | 1.240 | 0.081 | 0.065 | 9.2% |
| Rozwój zawodowy | 1.116 | 0.080 | 0.064 | 8.1% |
| Elastyczne godziny | 0.921 | 0.078 | 0.064 | 6.7% |
| Praca zdalna | 0.742 | 0.084 | 0.063 | 5.6% |
| Krótki dojazd | 0.503 | 0.081 | 0.063 | 4.4% |
| Benefity pozapłacowe | 0.194 | 0.072 | 0.062 | 3.2% |
| Prestiż firmy | 0 (odniesienie) | – | – | 2.7% |
Odporne błędy standardowe są większe od modelowych (np. 0.080 wobec 0.065 dla wynagrodzenia), bo preferencje różnią się między osobami, a wybory tej samej osoby są powiązane. Udział preferencji to exp(b) podzielone przez sumę exp(b) wszystkich cech. Oznacza przewidywaną szansę, że cecha zostanie wybrana jako najważniejsza, gdyby pokazać wszystkie 11 naraz. Udziały sumują się do 100% i są łatwiejsze w odbiorze niż logity. Wynagrodzenie (19.1%) jest około 7.2 razy częściej wybierane niż prestiż firmy (2.7%).
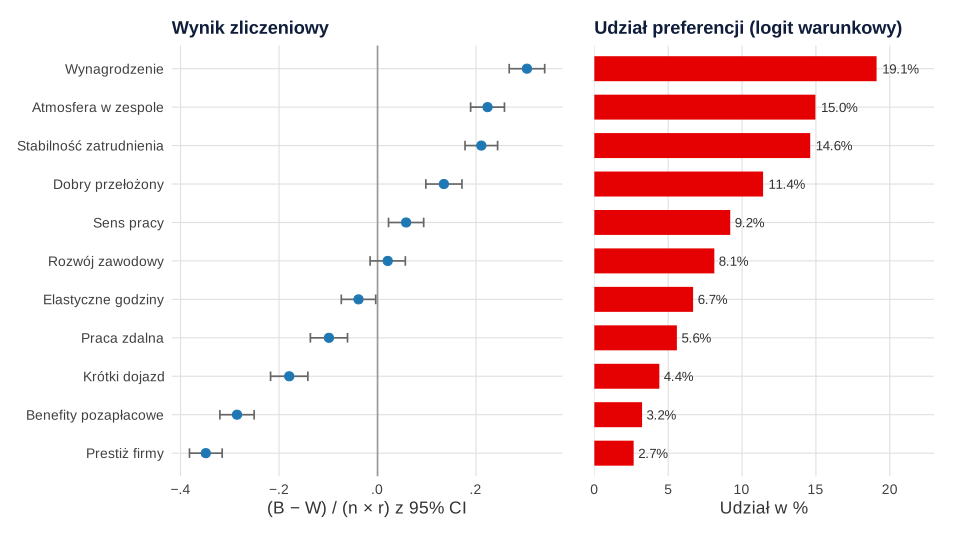
Przy planie zbalansowanym zliczenia i model są prawie zamienne. Korelacja wyniku standaryzowanego ze współczynnikami wynosi r > .999, a ze średnimi użytecznościami z symulacji r = .998. Model przydaje się, gdy plan nie jest zbalansowany, gdy chcesz testować różnice (np. testem ilorazu wiarygodności) albo dodać zmienne opisujące respondentów. Sprawdziliśmy też wrażliwość na uproszczenie. Model sekwencyjny dał współczynniki mniejsze średnio o około jedną dziesiątą (średni stosunek 0.904; 1.811 zamiast 1.971 dla wynagrodzenia), ale o tej samej kolejności (r > .999). Udział najważniejszej cechy zmienił się z 19.1% na 18.4%. Skala logitów zależy więc od wariantu modelu i należy go podać w raporcie.
Cheung i in. (2016) zauważają, że większość badań nie uwzględniała różnic w preferencjach między osobami. Jeśli spodziewasz się segmentów, kolejnym krokiem jest model klas latentnych na wyborach albo na wynikach indywidualnych (zob. analiza klas latentnych krok po kroku).
MaxDiff a skala Likerta na tych samych osobach
W symulacji te same 300 osób oceniło też 11 cech na skali 1–5. Oceny zależały od tych samych preferencji i od indywidualnego stylu korzystania ze skali. Średnie ułożyły się w tej samej kolejności co wyniki MaxDiff (ρ Spearmana z prawdziwymi użytecznościami: 1.000 dla Likerta i .991 dla B − W). Na poziomie grupy Likert nie przegrał. Różnice widać dopiero niżej:
- Ściśnięta skala. Średnie od 2.66 do 4.38, a wynagrodzenie oceniło na „5” 56.7% osób. Średnie czterech pierwszych cech mieszczą się w przedziale 0.32 punktu (zob. efekt sufitu).
- Remisy u osób. Mediana liczby cech z najwyższą oceną u jednej osoby to 3, a remis na pierwszym miejscu miało 81.3% osób. W indywidualnych wynikach MaxDiff remis na szczycie miało 37.3%.
- Styl odpowiedzi. Średnia ocen osoby korelowała ze stylem skali na poziomie r = .93. Różnice między osobami odpowiadały za 35.9% wariancji wszystkich ocen. Tę część wariancji tworzą m.in. tendencja do zgadzania się i style skrajnych odpowiedzi. W MaxDiff tej części nie ma, bo wybór najlepszy–najgorszy nie zależy od tego, jak hojnie ktoś używa skali.
Wniosek: MaxDiff wybierz, gdy chcesz uporządkować elementy i odróżnić je od siebie, także u pojedynczych osób. Skalę Likerta zostaw, gdy potrzebujesz bezwzględnego poziomu ważności albo wyniku, który dodasz do innych pozycji kwestionariusza (zob. skala Likerta: średnia czy mediana).
Jak opisać badanie MaxDiff
W metodzie podaj listę elementów i sposób jej powstania, parametry planu (v, k, r, b, λ, liczba wersji), randomizację kolejności, dokładne brzmienie pytania („najważniejsza” / „najmniej ważna”) i liczbę osób wykluczonych z analizy. W wynikach pokaż wyniki zliczeniowe i model, wariant modelu (brzegowy czy sekwencyjny), rodzaj błędów standardowych i udziały preferencji.
Jeśli planujesz badanie preferencji do artykułu lub projektu i chcesz sprawdzić plan zestawów albo analizę wyborów, zajrzyj do oferty analiz statystycznych dla badaczy. Szerszy kontekst metod ankietowych i eksperymentalnych znajdziesz w przewodniku po ankietach i eksperymentach, a zastosowania w naukach o rynku – w tekście o statystyce w pracy z marketingu.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji. W przepisach 1–3 nie używamy pakietów do MaxDiff: plan i zliczenia liczymy w bazowym R, a warunkowy model logitowy w pakiecie survival. Czwarty przepis powtarza tę analizę w pakiecie support.BWS (Aizaki i Fogarty, 2023) i daje te same zliczenia B, W i B − W oraz te same udziały preferencji co przepisy 1–2.
1. Plan BIBD, symulacja wyborów i wyniki zliczeniowe
R
# Dane symulowane: co pracownicy uważają za najważniejsze w pracy? 11 cech, MaxDiff (best–worst scaling, przypadek obiektów).
# Plan: zbalansowany niekompletny układ blokowy (BIBD) z v = 11, b = 11 zestawów po k = 5 cech.
set.seed(3250)
cechy <- c("Wynagrodzenie", "Stabilność zatrudnienia", "Atmosfera w zespole", "Dobry przełożony",
           "Sens pracy", "Rozwój zawodowy", "Elastyczne godziny", "Praca zdalna",
           "Krótki dojazd", "Benefity pozapłacowe", "Prestiż firmy")
v <- length(cechy)

# Układ cykliczny: zestaw j zawiera cechy {1, 3, 4, 5, 9} + j (mod 11); + 1 zamienia numery 0–10 na 1–11
baza <- c(1, 3, 4, 5, 9)
plan <- t(sapply(0:(v - 1), function(j) sort((baza + j) %% v) + 1))
dimnames(plan) <- list(paste0("Z", 1:v), paste0("poz", 1:5))
plan[1:3, ]
c(zestawy = nrow(plan), cech_w_zestawie = ncol(plan))
table(plan)                                  # r: ile razy pokazano każdą cechę
inc <- sapply(1:v, function(j) as.integer(1:v %in% plan[j, ]))   # macierz incydencji: cechy × zestawy
pary <- inc %*% t(inc)                       # współwystępowanie cech w zestawach
range(pary[upper.tri(pary)])                 # lambda: ile razy pojawia się każda para

# Warunki BIBD: b = v × r / k zestawów, lambda = r × (k − 1) / (v − 1) – obie liczby muszą być całkowite
parametry <- data.frame(v = c(7, 9, 11, 13, 16), k = c(3, 3, 5, 4, 4), r = c(3, 4, 5, 4, 5))
parametry$b <- with(parametry, v * r / k); parametry$lambda <- with(parametry, r * (k - 1) / (v - 1))
parametry

# Symulacja odpowiedzi: 300 osób, użyteczności indywidualne = średnie + zmienność między osobami
n <- 300
u_sr <- c(1.2, 0.9, 0.8, 0.6, 0.5, 0.3, 0.2, 0.0, -0.3, -0.6, -0.9)
U <- matrix(rnorm(n * v, rep(u_sr, each = n), 0.6), n, v)
odp <- do.call(rbind, lapply(1:n, function(i) {
  do.call(rbind, lapply(sample(v), function(z) {     # kolejność zestawów losowa dla każdej osoby
    pokaz <- sample(plan[z, ])                         # kolejność cech w zestawie też losowa
    naj <- pokaz[sample.int(5, 1, prob = exp(U[i, pokaz]))]
    reszta <- setdiff(pokaz, naj)
    gor <- reszta[sample.int(4, 1, prob = exp(-U[i, reszta]))]
    data.frame(osoba = i, zestaw = z, pokazane = paste(pokaz, collapse = " "), najlepsza = naj, najgorsza = gor, row.names = NULL)
  }))
}))
nrow(odp); head(odp, 3)

# Wyniki zliczeniowe: B, W, B − W, wynik standaryzowany (B − W) / (n × r) i pierwiastek z B/W
r <- 5
B <- tabulate(odp$najlepsza, v); W <- tabulate(odp$najgorsza, v)
zlicz <- data.frame(cecha = cechy, B = B, W = W, BW = B - W, BW_std = (B - W) / (n * r), sqrtBW = sqrt(B / W))
zlicz <- zlicz[order(-zlicz$BW), ]
print(transform(zlicz, BW_std = round(BW_std, 3), sqrtBW = round(sqrtBW, 2)), row.names = FALSE)

# Wyniki indywidualne: (liczba wskazań „najważniejsza” − „najmniej ważna”) dla każdej osoby, zakres od −5 do 5
ind <- matrix(0, n, v, dimnames = list(NULL, cechy))
for (k in seq_len(nrow(odp))) {
  ind[odp$osoba[k], odp$najlepsza[k]] <- ind[odp$osoba[k], odp$najlepsza[k]] + 1
  ind[odp$osoba[k], odp$najgorsza[k]] <- ind[odp$osoba[k], odp$najgorsza[k]] - 1
}
range(rowSums(ind))                           # suma wyników każdej osoby = 0 (dane ipsatywne)
ci <- t(apply(ind, 2, function(x) { tt <- t.test(x); c(M = mean(x), SD = sd(x), dolny = tt$conf.int[1], gorny = tt$conf.int[2]) }))
round(ci[order(-ci[, "M"]), ], 2)

# Plik do pobrania: jeden wiersz = jeden zestaw u jednej osoby, cechy podane nazwami
csv <- data.frame(osoba = odp$osoba, zestaw = odp$zestaw,
                  pokazane = sapply(strsplit(odp$pokazane, " "), function(x) paste(cechy[as.integer(x)], collapse = "; ")),
                  najwazniejsza = cechy[odp$najlepsza], najmniej_wazna = cechy[odp$najgorsza])
write.csv(csv, "../maxdiff-dane-wybory.csv", row.names = FALSE, fileEncoding = "UTF-8")
Wynik w R
   poz1 poz2 poz3 poz4 poz5
Z1    2    4    5    6   10
Z2    3    5    6    7   11
Z3    1    4    6    7    8
        zestawy cech_w_zestawie
             11               5
plan
 1  2  3  4  5  6  7  8  9 10 11
 5  5  5  5  5  5  5  5  5  5  5
[1] 2 2
   v k r  b lambda
1  7 3 3  7      1
2  9 3 4 12      1
3 11 5 5 11      2
4 13 4 4 13      1
5 16 4 5 20      1
[1] 3300
  osoba zestaw   pokazane najlepsza najgorsza
1     1      3  6 7 8 1 4         7         8
2     1      5 9 10 3 8 6         6         3
3     1     10 2 8 11 3 4         4        11
                   cecha   B   W   BW BW_std sqrtBW
           Wynagrodzenie 574 119  455  0.303   2.20
     Atmosfera w zespole 465 130  335  0.223   1.89
 Stabilność zatrudnienia 443 127  316  0.211   1.87
        Dobry przełożony 395 193  202  0.135   1.43
              Sens pracy 305 218   87  0.058   1.18
         Rozwój zawodowy 280 249   31  0.021   1.06
      Elastyczne godziny 238 296  -58 -0.039   0.90
            Praca zdalna 207 355 -148 -0.099   0.76
           Krótki dojazd 173 442 -269 -0.179   0.63
    Benefity pozapłacowe 123 551 -428 -0.285   0.47
           Prestiż firmy  97 620 -523 -0.349   0.40
[1] 0 0
                            M   SD dolny gorny
Wynagrodzenie            1.52 1.58  1.34  1.70
Atmosfera w zespole      1.12 1.51  0.94  1.29
Stabilność zatrudnienia  1.05 1.46  0.89  1.22
Dobry przełożony         0.67 1.61  0.49  0.86
Sens pracy               0.29 1.57  0.11  0.47
Rozwój zawodowy          0.10 1.57 -0.08  0.28
Elastyczne godziny      -0.19 1.54 -0.37 -0.02
Praca zdalna            -0.49 1.66 -0.68 -0.30
Krótki dojazd           -0.90 1.67 -1.09 -0.71
Benefity pozapłacowe    -1.43 1.53 -1.60 -1.25
Prestiż firmy           -1.74 1.46 -1.91 -1.58
2. Warunkowy model logitowy i udziały preferencji
R
# Warunkowy model logitowy (survival::clogit) na danych z przepisu 1 (obiekty cechy, plan, odp, zlicz, U, n, v).
suppressPackageStartupMessages(library(survival))

# Format wyboru: każdy zestaw daje dwa zbiory wyboru po 5 wierszy.
# Zbiór „najlepsza”: zmienne cech = 1. Zbiór „najgorsza”: zmienne cech = −1 (wybór najgorszej to wybór najmniejszej użyteczności).
# Uproszczenie: najgorszą traktujemy jako wybraną z całego zestawu (5 cech), a nie z 4 pozostałych po wskazaniu najlepszej.
dlugie <- function(odp, sekwencyjnie = FALSE) {
  do.call(rbind, lapply(seq_len(nrow(odp)), function(k) {
    pokaz <- as.integer(strsplit(odp$pokazane[k], " ")[[1]])
    gorsze <- if (sekwencyjnie) setdiff(pokaz, odp$najlepsza[k]) else pokaz
    rbind(data.frame(osoba = odp$osoba[k], zbior = paste(k, "B"), cecha = pokaz, znak = 1,
                     wybor = as.integer(pokaz == odp$najlepsza[k])),
          data.frame(osoba = odp$osoba[k], zbior = paste(k, "W"), cecha = gorsze, znak = -1,
                     wybor = as.integer(gorsze == odp$najgorsza[k])))
  }))
}
X <- function(d) {                              # kodowanie efektów cech; odniesienie: „Prestiż firmy” = 0
  m <- sapply(1:(v - 1), function(j) d$znak * (d$cecha == j))
  colnames(m) <- paste0("c", 1:(v - 1)); m
}
d_marg <- dlugie(odp)
dim(d_marg); sum(d_marg$wybor)                  # 2 zbiory × 3300 zestawów, po jednym wyborze w zbiorze
# Jeden wybór w zbiorze, więc method = "efron" daje tę samą wiarygodność co "exact" i pozwala policzyć SE odporne na skupienie w osobach
m1 <- clogit(d_marg$wybor ~ X(d_marg) + strata(d_marg$zbior), cluster = d_marg$osoba, method = "efron")
wsp <- data.frame(cecha = cechy, b = c(coef(m1), 0), se_odporny = c(sqrt(diag(vcov(m1))), NA))
wsp$se_modelowy <- c(sqrt(diag(m1$naive.var)), NA)

# Udziały preferencji: exp(b) / suma exp(b) × 100 = szansa wyboru cechy jako najważniejszej spośród wszystkich 11
wsp$udzial <- 100 * exp(wsp$b) / sum(exp(wsp$b))
wsp <- wsp[order(-wsp$b), ]
print(transform(wsp, b = round(b, 3), se_odporny = round(se_odporny, 3), se_modelowy = round(se_modelowy, 3),
                udzial = round(udzial, 1)), row.names = FALSE)
round(sum(wsp$udzial), 1)
round(max(wsp$udzial) / min(wsp$udzial), 1)          # ile razy częściej wybierana jest cecha pierwsza niż ostatnia

# Zgodność z wynikami zliczeniowymi i z prawdziwymi (symulowanymi) średnimi użytecznościami
b_wg_cech <- wsp$b[match(cechy, wsp$cecha)]
bw_wg_cech <- zlicz$BW_std[match(cechy, zlicz$cecha)]
round(c(r_BW_logit = cor(bw_wg_cech, b_wg_cech), r_logit_prawda = cor(b_wg_cech, colMeans(U) - colMeans(U)[v])), 4)

# Wrażliwość na uproszczenie: model sekwencyjny (najgorsza wybierana z 4 pozostałych cech)
d_sekw <- dlugie(odp, sekwencyjnie = TRUE)
m2 <- clogit(d_sekw$wybor ~ X(d_sekw) + strata(d_sekw$zbior), cluster = d_sekw$osoba, method = "efron")
porown <- data.frame(cecha = cechy[-v], uproszczony = coef(m1), sekwencyjny = coef(m2), row.names = NULL)
print(transform(porown, uproszczony = round(uproszczony, 3), sekwencyjny = round(sekwencyjny, 3)), row.names = FALSE)
round(cor(porown$uproszczony, porown$sekwencyjny), 4)
round(mean(porown$sekwencyjny / porown$uproszczony), 3)   # średni stosunek współczynników
udzial_sekw <- 100 * exp(c(coef(m2), 0)) / sum(exp(c(coef(m2), 0)))
round(c(uproszczony = max(wsp$udzial), sekwencyjny = max(udzial_sekw)), 1)   # udział najważniejszej cechy w obu modelach
Wynik w R
[1] 33000     5
[1] 6600
                   cecha     b se_odporny se_modelowy udzial
           Wynagrodzenie 1.971      0.080       0.065   19.1
     Atmosfera w zespole 1.727      0.079       0.064   15.0
 Stabilność zatrudnienia 1.703      0.076       0.065   14.6
        Dobry przełożony 1.457      0.081       0.064   11.4
              Sens pracy 1.240      0.081       0.065    9.2
         Rozwój zawodowy 1.116      0.080       0.064    8.1
      Elastyczne godziny 0.921      0.078       0.064    6.7
            Praca zdalna 0.742      0.084       0.063    5.6
           Krótki dojazd 0.503      0.081       0.063    4.4
    Benefity pozapłacowe 0.194      0.072       0.062    3.2
           Prestiż firmy 0.000         NA          NA    2.7
[1] 100
[1] 7.2
    r_BW_logit r_logit_prawda
        0.9999         0.9983
                   cecha uproszczony sekwencyjny
           Wynagrodzenie       1.971       1.811
 Stabilność zatrudnienia       1.703       1.558
     Atmosfera w zespole       1.727       1.578
        Dobry przełożony       1.457       1.322
              Sens pracy       1.240       1.122
         Rozwój zawodowy       1.116       1.010
      Elastyczne godziny       0.921       0.835
            Praca zdalna       0.742       0.661
           Krótki dojazd       0.503       0.454
    Benefity pozapłacowe       0.194       0.170
[1] 0.9999
[1] 0.904
uproszczony sekwencyjny
       19.1        18.4
3. Porównanie ze skalą Likerta
R
# Dla porównania: te same 300 osób ocenia te same 11 cech na skali Likerta 1–5 („zupełnie nieważne” – „bardzo ważne”).
# Oceny zależą od tych samych użyteczności U oraz od indywidualnego stylu korzystania ze skali (przesunięcie s).
set.seed(3251)
s <- rnorm(n, 0, 0.8)
lat <- 1 + U + s + matrix(rnorm(n * v, 0, 0.7), n, v)
lik <- matrix(findInterval(lat, c(-1, 0, 1, 2)) + 1, n, v, dimnames = list(NULL, cechy))
opis <- data.frame(cecha = cechy, M = colMeans(lik), SD = apply(lik, 2, sd), proc_5 = 100 * colMeans(lik == 5))
print(transform(opis[order(-opis$M), ], M = round(M, 2), SD = round(SD, 2), proc_5 = round(proc_5, 1)), row.names = FALSE)
round(diff(range(sort(opis$M, decreasing = TRUE)[1:4])), 2)   # rozpiętość średnich czterech pierwszych cech

# Ile cech dostaje u jednej osoby najwyższą ocenę i ile osób ma remis na pierwszym miejscu
n_max <- apply(lik, 1, function(x) sum(x == max(x)))
round(c(mediana_cech_z_ocena_max = median(n_max), proc_osob_z_remisem = 100 * mean(n_max > 1)), 1)
# Jaka część wariancji ocen to różnice między osobami (średnia osoby), a jaka – między cechami
sr_osoby <- rowMeans(lik)
round(c(r_srednia_osoby_styl = cor(sr_osoby, s),
        proc_wariancji_osoby = 100 * var(rep(sr_osoby, v)) / var(as.vector(lik))), 3)
# To samo w indywidualnych wynikach MaxDiff (B − W osoby): ile osób ma remis na pierwszym miejscu
n_max_bw <- apply(ind, 1, function(x) sum(x == max(x)))
round(100 * mean(n_max_bw > 1), 1)
# Zgodność kolejności cech z prawdziwymi średnimi użytecznościami (rho Spearmana)
prawda <- colMeans(U)
round(c(Likert = cor(colMeans(lik), prawda, method = "spearman"),
        MaxDiff_BW = cor(zlicz$BW_std[match(cechy, zlicz$cecha)], prawda, method = "spearman")), 3)
Wynik w R
                   cecha    M   SD proc_5
           Wynagrodzenie 4.38 0.84   56.7
 Stabilność zatrudnienia 4.19 0.91   46.0
     Atmosfera w zespole 4.09 0.99   45.3
        Dobry przełożony 4.06 1.00   43.0
              Sens pracy 3.84 1.03   32.7
         Rozwój zawodowy 3.76 1.05   29.0
      Elastyczne godziny 3.57 1.06   22.3
            Praca zdalna 3.43 1.14   21.3
           Krótki dojazd 3.23 1.17   16.3
    Benefity pozapłacowe 2.98 1.16   11.0
           Prestiż firmy 2.66 1.20    8.7
[1] 0.32
mediana_cech_z_ocena_max      proc_osob_z_remisem
                     3.0                     81.3
r_srednia_osoby_styl proc_wariancji_osoby
               0.926               35.855
[1] 37.3
    Likert MaxDiff_BW
     1.000      0.991
4. Ta sama analiza w pakiecie support.BWS
R
# Ta sama analiza w pakiecie support.BWS na danych z przepisu 1 (obiekty odp, plan, n, v).
suppressPackageStartupMessages({library(support.BWS); library(survival)})
nazwy <- c("wynagrodzenie", "stabilnosc", "atmosfera", "przelozony", "sens", "rozwoj",
           "elastycznosc", "zdalna", "dojazd", "benefity", "prestiz")
# Dane szerokie: jeden wiersz na osobę – id, potem B1 W1 B2 W2 ... B11 W11 (numery cech, kolejność zestawów jak w planie)
odp_szer <- data.frame(id = 1:n)
for (z in 1:v) {
  dz <- odp[odp$zestaw == z, ]; dz <- dz[order(dz$osoba), ]
  odp_szer[[paste0("B", z)]] <- dz$najlepsza
  odp_szer[[paste0("W", z)]] <- dz$najgorsza
}
dane_bws <- bws.dataset(data = odp_szer, response.type = 2,   # 2 = odpowiedzi jako numery cech
                        choice.sets = plan, design.type = 2,    # 2 = plan BIBD
                        item.names = nazwy, id = "id", response = names(odp_szer)[-1],
                        model = "marginal")                     # albo "sequential" / "maxdiff"
zl <- bws.count(dane_bws, cl = 2)
summary(zl)                                                     # B, W, B − W i standaryzowane B − W
m <- clogit(RES ~ wynagrodzenie + stabilnosc + atmosfera + przelozony + sens + rozwoj +
              elastycznosc + zdalna + dojazd + benefity + strata(STR), data = dane_bws)
round(100 * bws.sp(m, base = "prestiz"), 1)                     # udziały preferencji (%)
Wynik w R
Number of respondents : 300

                B   W   BW Rank  meanB  meanW  meanBW mean.stdBW sqrtBW
wynagrodzenie 574 119  455    1 1.9133 0.3967  1.5167    0.30333 2.1963
stabilnosc    443 127  316    3 1.4767 0.4233  1.0533    0.21067 1.8677
atmosfera     465 130  335    2 1.5500 0.4333  1.1167    0.22333 1.8913
przelozony    395 193  202    4 1.3167 0.6433  0.6733    0.13467 1.4306
sens          305 218   87    5 1.0167 0.7267  0.2900    0.05800 1.1828
rozwoj        280 249   31    6 0.9333 0.8300  0.1033    0.02067 1.0604
elastycznosc  238 296  -58    7 0.7933 0.9867 -0.1933   -0.03867 0.8967
zdalna        207 355 -148    8 0.6900 1.1833 -0.4933   -0.09867 0.7636
dojazd        173 442 -269    9 0.5767 1.4733 -0.8967   -0.17933 0.6256
benefity      123 551 -428   10 0.4100 1.8367 -1.4267   -0.28533 0.4725
prestiz        97 620 -523   11 0.3233 2.0667 -1.7433   -0.34867 0.3955
              std.sqrtBW
wynagrodzenie     1.0000
stabilnosc        0.8504
atmosfera         0.8611
przelozony        0.6514
sens              0.5386
rozwoj            0.4828
elastycznosc      0.4083
zdalna            0.3477
dojazd            0.2849
benefity          0.2151
prestiz           0.1801
wynagrodzenie    stabilnosc     atmosfera    przelozony          sens
         19.1          14.6          15.0          11.4           9.2
       rozwoj  elastycznosc        zdalna        dojazd      benefity
          8.1           6.7           5.6           4.4           3.2
      prestiz
          2.7
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje sample(), tabulate(), t.test(), findInterval()) i pakietu survival (clogit()) oraz przepisu 4 w pakiecie support.BWS 0.4.6 (bws.dataset(), bws.count(), bws.sp()); rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- support.BWS (wersja 0.4.6): Aizaki, H., & Fogarty, J. (2023). R packages and tutorial for case 1 best–worst scaling. Journal of Choice Modelling, 46, 100394. https://doi.org/10.1016/j.jocm.2022.100394
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Plan niezbalansowany bez kontroli. Jeśli jedna cecha jest pokazywana częściej albo zawsze w towarzystwie słabych cech, surowe zliczenia są obciążone. Sprawdź częstości elementów i par przed uruchomieniem ankiety.
- Stała kolejność zestawów i pozycji. Losuj kolejność zestawów i miejsce elementów na ekranie.
- Za długie zestawy i lista elementów. Lepiej 11 dobrze opisanych elementów niż 30 podobnych do siebie.
- Wyniki indywidualne jak zwykłe skale. Sumują się do zera, więc korelacje między nimi są sztucznie ujemne. Analiza czynnikowa takich wyników nie ma sensu.
- Odczytywanie MaxDiff jako ważności bezwzględnej. Ostatnie miejsce nie znaczy „nieważne”, tylko „najmniej ważne z tej listy”.
- Zwykłe błędy standardowe w modelu. Wybory tej samej osoby są zależne. Użyj błędów odpornych na klastrowanie albo modelu z heterogenicznością.
- Brak opisu uproszczenia modelu. Napisz, czy zbiór „najgorsza” obejmował cały zestaw, czy tylko pozostałe elementy.
Najczęstsze pytania
Ile elementów i ile zestawów zaplanować w badaniu MaxDiff?
Liczba zestawów wynika z planu: przy v elementach, k elementach w zestawie i r pokazaniach każdego elementu potrzebujesz b = v × r / k zestawów. Dla 11 elementów po 5 w zestawie daje to 11 zestawów, w których każda para elementów występuje 2 razy. Zwykle stosuje się małe zestawy, np. po 4–5 elementów, bo większy zestaw utrudnia wybór.
Czy indywidualne wyniki MaxDiff można analizować jak wyniki skali Likerta?
Tylko ostrożnie. Wyniki B − W jednej osoby sumują się do zera, więc są ipsatywne: korelacje między elementami są sztucznie ujemne, a analiza czynnikowa takich wyników nie ma sensu. Do porównań grup lepiej użyć modelu wyboru albo porównywać pojedyncze elementy z poprawką na wielokrotne testy.
Czym różni się model brzegowy od sekwencyjnego w analizie MaxDiff?
W modelu brzegowym najgorszy element traktuje się jako wybrany z całego zestawu, a w sekwencyjnym – z elementów pozostałych po wskazaniu najlepszego. Kolejność elementów jest zwykle taka sama, ale skala współczynników i udziały preferencji trochę się różnią, dlatego wariant modelu trzeba podać w raporcie.
Jak interpretować udział preferencji w MaxDiff?
Udział preferencji to exp(b) danego elementu podzielone przez sumę exp(b) wszystkich elementów. Oznacza przewidywaną szansę, że element zostanie wybrany jako najważniejszy, gdyby pokazać całą listę naraz. Udziały sumują się do 100% i zależą od tego, jakie elementy znalazły się na liście.
Czy do analizy MaxDiff potrzebne jest specjalne oprogramowanie?
Nie. Wyniki zliczeniowe policzysz w arkuszu albo w bazowym R, a warunkowy model logitowy – funkcją clogit z pakietu survival na danych w formacie wyboru. Pakiety specjalistyczne, np. support.BWS, ułatwiają przygotowanie danych, ale nie są konieczne.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikAnkiety i eksperymenty – przewodnik
Osiem etapów od pytania badawczego do analizy: pytania i kafeterie, manipulacja i randomizacja, etyka, pilotaż, rekrutacja i czyszczenie danych.
Czytaj →PoradnikIle stopni skali Likerta wybrać?
4, 5, 7 czy więcej punktów: co mówią badania, środek skali, etykiety, tabela decyzyjna, symulacja w R i wzór opisu do pracy.
Czytaj →PoradnikAnaliza TURF
Który zestaw smaków dotrze do największej liczby klientów: zasięg, częstość, przegląd 495 zestawów i bootstrap zwycięzcy z kodem R.
Czytaj →PoradnikConjoint wyborczy (CBC) – analiza
400 osób wybiera abonament: warunkowy model logitowy, ważność atrybutów, gotowość do zapłaty, symulator udziałów i pułapki IIA – pięć rysunków z kodem R.
Czytaj →Planujesz badanie preferencji i nie wiesz, jak ułożyć zestawy?
Pomożemy dobrać listę elementów i plan zestawów, policzyć wyniki zliczeniowe i model wyboru oraz opisać je tak, żebyś mógł(a) samodzielnie obronić analizę przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Aizaki, H., & Fogarty, J. (2023). R packages and tutorial for case 1 best–worst scaling. Journal of Choice Modelling, 46, Article 100394. https://doi.org/10.1016/j.jocm.2022.100394 ● Otwarty dostęp
- Cheung, K. L., Wijnen, B. F. M., Hollin, I. L., Janssen, E. M., Bridges, J. F., Evers, S. M. A. A., & Hiligsmann, M. (2016). Using best–worst scaling to investigate preferences in health care. PharmacoEconomics, 34(12), 1195–1209. https://doi.org/10.1007/s40273-016-0429-5 ● Otwarty dostęp
- Finn, A., & Louviere, J. J. (1992). Determining the appropriate response to evidence of public concern: The case of food safety. Journal of Public Policy & Marketing, 11(2), 12–25. https://doi.org/10.1177/074391569201100202
- Flynn, T. N., Louviere, J. J., Peters, T. J., & Coast, J. (2007). Best–worst scaling: What it can do for health care research and how to do it. Journal of Health Economics, 26(1), 171–189. https://doi.org/10.1016/j.jhealeco.2006.04.002
- Lee, J. A., Soutar, G. N., & Louviere, J. (2007). Measuring values using best-worst scaling: The LOV example. Psychology & Marketing, 24(12), 1043–1058. https://doi.org/10.1002/mar.20197
- Louviere, J. J., Flynn, T. N., & Marley, A. A. J. (2015). Best-worst scaling: Theory, methods and applications. Cambridge University Press. https://doi.org/10.1017/cbo9781107337855
- Mühlbacher, A. C., Kaczynski, A., Zweifel, P., & Johnson, F. R. (2016). Experimental measurement of preferences in health and healthcare using best-worst scaling: An overview. Health Economics Review, 6(1), Article 2. https://doi.org/10.1186/s13561-015-0079-x ● Otwarty dostęp
Cytowania BibTeX
@article{aizaki2023r, author={Aizaki, Hideo and Fogarty, James}, title={{R packages and tutorial for case 1 best–worst scaling}}, journal={Journal of Choice Modelling}, year={2023}, volume={46}, eid={100394}, doi={10.1016/j.jocm.2022.100394}}@article{cheung2016using, author={Cheung, Kei Long and Wijnen, Ben F. M. and Hollin, Ilene L. and Janssen, Ellen M. and Bridges, John F. and Evers, Silvia M. A. A. and Hiligsmann, Mickael}, title={{Using best–worst scaling to investigate preferences in health care}}, journal={PharmacoEconomics}, year={2016}, volume={34}, number={12}, pages={1195--1209}, doi={10.1007/s40273-016-0429-5}}@article{finn1992determining, author={Finn, Adam and Louviere, Jordan J.}, title={{Determining the appropriate response to evidence of public concern: The case of food safety}}, journal={Journal of Public Policy \& Marketing}, year={1992}, volume={11}, number={2}, pages={12--25}, doi={10.1177/074391569201100202}}@article{flynn2007best, author={Flynn, Terry N. and Louviere, Jordan J. and Peters, Tim J. and Coast, Joanna}, title={{Best–worst scaling: What it can do for health care research and how to do it}}, journal={Journal of Health Economics}, year={2007}, volume={26}, number={1}, pages={171--189}, doi={10.1016/j.jhealeco.2006.04.002}}@article{lee2007measuring, author={Lee, Julie Anne and Soutar, Geoffrey N. and Louviere, Jordan}, title={{Measuring values using best-worst scaling: The LOV example}}, journal={Psychology \& Marketing}, year={2007}, volume={24}, number={12}, pages={1043--1058}, doi={10.1002/mar.20197}}@book{louviere2015best, author={Louviere, Jordan J. and Flynn, Terry N. and Marley, A. A. J.}, title={{Best-worst scaling: Theory, methods and applications}}, year={2015}, publisher={Cambridge University Press}, doi={10.1017/cbo9781107337855}}@article{muhlbacher2016experimental, author={Mühlbacher, Axel C. and Kaczynski, Anika and Zweifel, Peter and Johnson, F. Reed}, title={{Experimental measurement of preferences in health and healthcare using best-worst scaling: An overview}}, journal={Health Economics Review}, year={2016}, volume={6}, number={1}, eid={2}, doi={10.1186/s13561-015-0079-x}}