Przykład: lodziarnia i pytanie „które cztery smaki wstawić do zamrażarki?”
Fikcyjna lodziarnia rzemieślnicza wchodzi do sklepów osiedlowych. W każdej zamrażarce zmieszczą się tylko cztery smaki, a w ofercie testowej jest dwanaście. W ankiecie 500 osób odpowiedziało na pytanie: „Które z tych smaków kupił(a)byś? Zaznacz wszystkie”. Dział marketingu pyta: który zestaw czterech smaków trafi do największej liczby klientów?
Odpowiada na to analiza TURF (ang. total unduplicated reach and frequency – łączny zasięg bez powtórzeń i częstość). Nie szuka najlepszych smaków osobno. Szuka zestawu, w którym jak najwięcej osób znajdzie coś dla siebie. Dane mają postać zwykłego pytania wielokrotnego wyboru: każdy smak to kolumna 0/1, tak jak w haśle analiza pytań wielokrotnego wyboru. Jak przygotować takie kolumny z eksportu ankiety, pokazuje wpis pytania wielokrotnego wyboru – jak policzyć.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Przed pierwszym uruchomieniem ręcznie ustaliliśmy cztery „gusty” klientów: klasyczny (34% osób; wanilia, czekolada, stracciatella, truskawka), deserowy (24%; czekolada, słony karmel, pistacja, ciasteczkowe), owocowy (22%; truskawka, mango, malina, cytryna z bazylią) i roślinny (14%; kokos, matcha, mango, malina). Smak ze swojego gustu osoba wskazuje z prawdopodobieństwem od .25 do .60, smak spoza gustu – .06. Pozostałe 6% osób prawie nic nie lubi (.01). Ziarno 621 ustalono raz i nie zmieniano go; parametrów też nie poprawialiśmy po obejrzeniu wyników. Dane pobierzesz jako analiza-turf-smaki.csv (wiersz = respondent, 12 kolumn 0/1 i kolumna z ukrytym gustem).
Rysunek 1: mapa respondent × smak
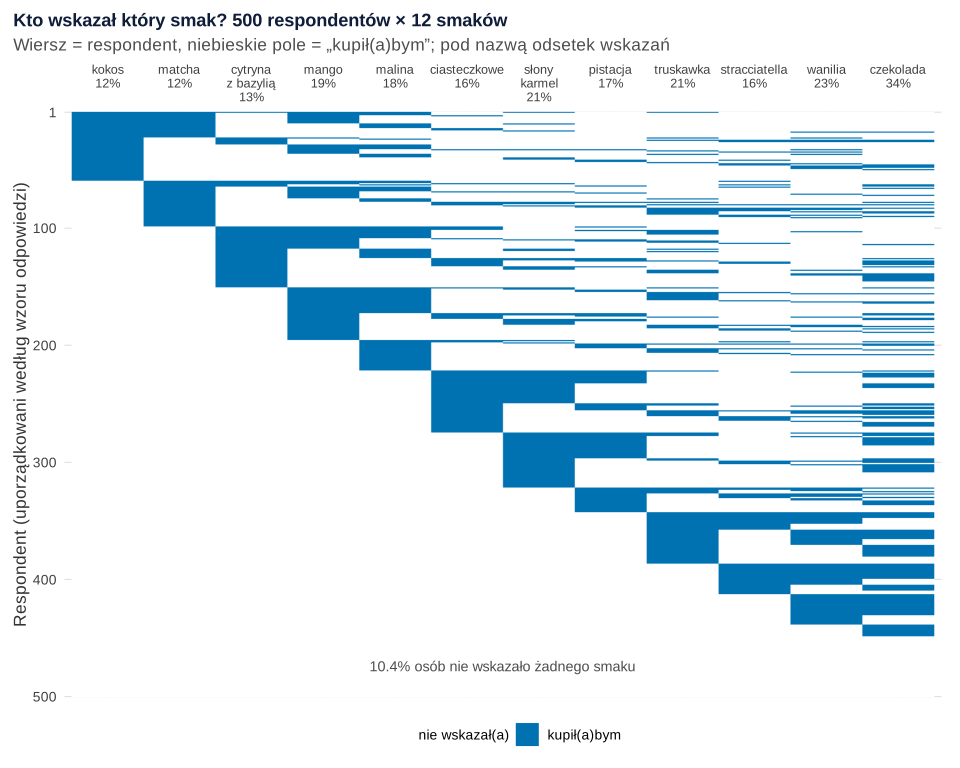
set.seed(621)).Co widać. Każdy wiersz to jedna osoba, każda kolumna – smak. Respondent wskazał średnio 2.23 smaku, a 18.2% osób – dokładnie jeden. Najczęściej wybierano czekoladę (33.6%), potem wanilię (23.4%), truskawkę (21.2%) i słony karmel (21.0%). Najrzadziej kokos (11.8%). Bloki w lewej części to osoby o wąskim guście: kto wybrał kokos, często wybrał też matchę. Na dole zostaje pusty pas: 10.4% osób nie wskazało żadnego smaku.
Jak może zmylić. Kolejność wierszy ustala kod (sortowanie po wzorze odpowiedzi), więc bloki są wyraźniejsze niż w surowym pliku. Mapa nie mówi też, ile osób „zdobywa” smak, którego nie zdobył inny. To pokazuje dopiero zasięg. Gdy smaków jest mniej, te same nakładania pokaże wykres UpSet.
Podpis do pracy:
Zdanie do Wyników:
Zasięg i częstość na dziesięciu osobach
Najprostszy pomysł to wziąć cztery najpopularniejsze smaki: czekoladę, wanilię, truskawkę i słony karmel. Sprawdźmy, do kogo dotrze ten zestaw. Dwie miary TURF:
- Zasięg (ang. reach) – odsetek osób, które w zestawie mają co najmniej jeden wskazany smak. Każdą osobę liczysz raz, ile smaków by nie wskazała – stąd „bez powtórzeń”.
- Częstość (ang. frequency) – średnia liczba smaków z zestawu, które osoba wskazała. Mówi, czy klienci mają wybór, czy jeden ulubiony smak.
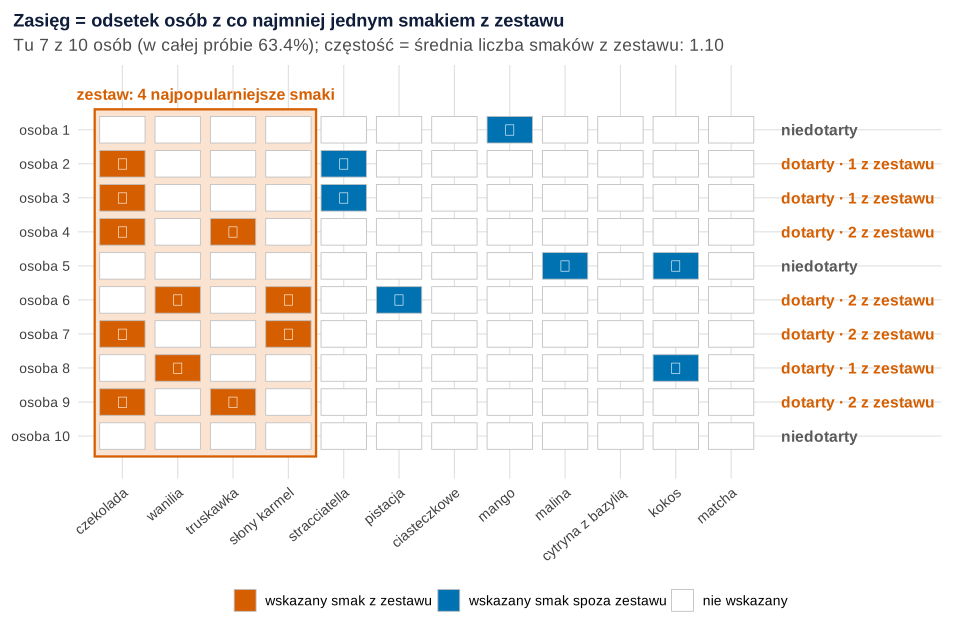
Co widać. Wśród pierwszych dziesięciu osób w pliku zestaw „najpopularniejszy” dociera do siedmiu. Osoba 1 lubi tylko mango, osoba 5 – malinę i kokos, a osoba 10 nic. Osoby 4, 6, 7 i 9 mają w zestawie po dwa swoje smaki. W całej próbie zasięg wynosi 63.4%, a częstość 0.99 smaku na osobę (1.56 wśród dotartych).
Jak może zmylić. Czekolada i wanilia „łowią” w dużej mierze tych samych klientów z gustu klasycznego. Dwa popularne smaki w zestawie nie dają dwa razy większego zasięgu. Dziesięć osób to tylko ilustracja – wybraliśmy je z góry (pierwsze w pliku), a nie pod ładny obraz.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: przegląd zupełny 495 zestawów
Z 12 smaków da się ułożyć 495 różnych zestawów po cztery. Komputer policzy zasięg każdego w ułamku sekundy – to przegląd zupełny (ang. complete enumeration). Wynik nie zależy od kolejności ani od punktu startu.
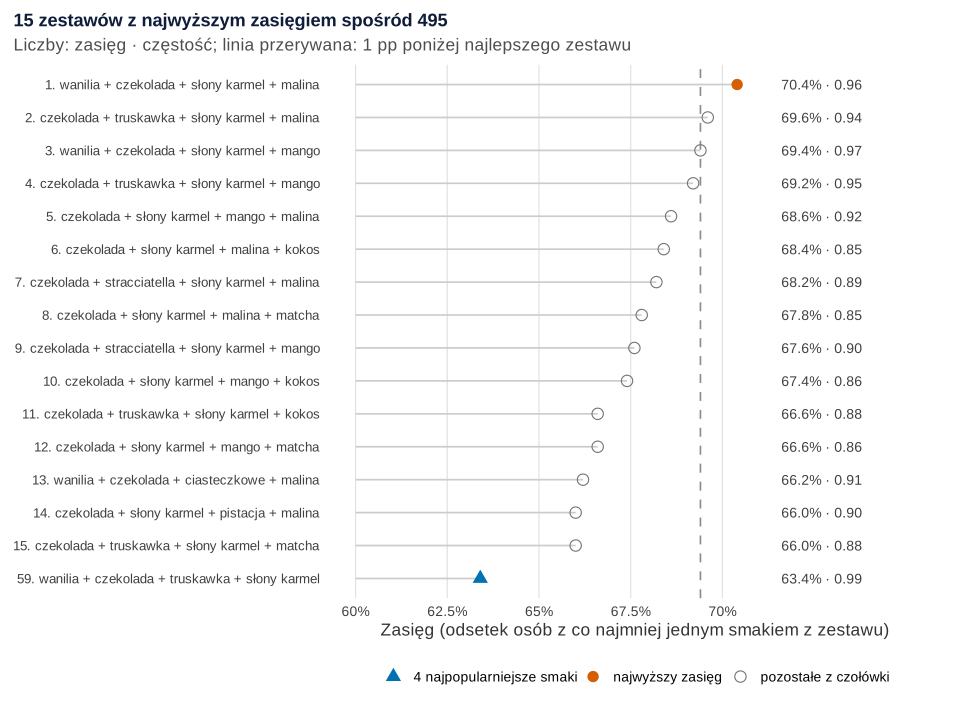
Co widać. Najwyższy zasięg ma zestaw wanilia + czekolada + słony karmel + malina: 70.4%. Zestaw czterech najpopularniejszych smaków jest dopiero na 59. miejscu z zasięgiem 63.4%. Różnica to 7.0 punktu procentowego, czyli 35 osób na 500. Malina „wymienia” truskawkę: truskawkę lubią też klasycy, a malinę – grupa owocowa i roślinna, do której zestaw popularny nie docierał. Mediana zasięgu wszystkich 495 zestawów to 56.6%.
Jak może zmylić: remisy. Czołówka jest ciasna. Trzy zestawy mieszczą się w 1 punkcie procentowym od najlepszego, sześć – w 2 punktach. Na 500 osobach 0.8 punktu to 4 respondentów. Przy takiej różnicy patrz też na częstość: zestaw nr 3 (wanilia + czekolada + słony karmel + mango) ma zasięg 69.4%, ale częstość 0.97 wobec 0.96. Zestaw popularny ma najwyższą częstość (0.99), bo jego smaki dublują się u tych samych osób.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: ile daje kolejny smak? Zachłannie a optymalnie
Przy 12 smakach przegląd zupełny jest tani. Przy 40 wariantach i zestawie 10 zestawów są setki milionów. Wtedy stosuje się algorytm zachłanny (ang. greedy): weź smak o największym zasięgu, potem dokładaj ten, który dodaje najwięcej nowych osób. To szybkie, ale nie gwarantuje najlepszego zestawu. Dokładne rozwiązanie dla dużych list daje programowanie całkowitoliczbowe. W dużej firmie dóbr konsumpcyjnych zastąpiło ono przegląd zupełny i wyraźnie przyspieszyło analizy (Camm i in., 2022).
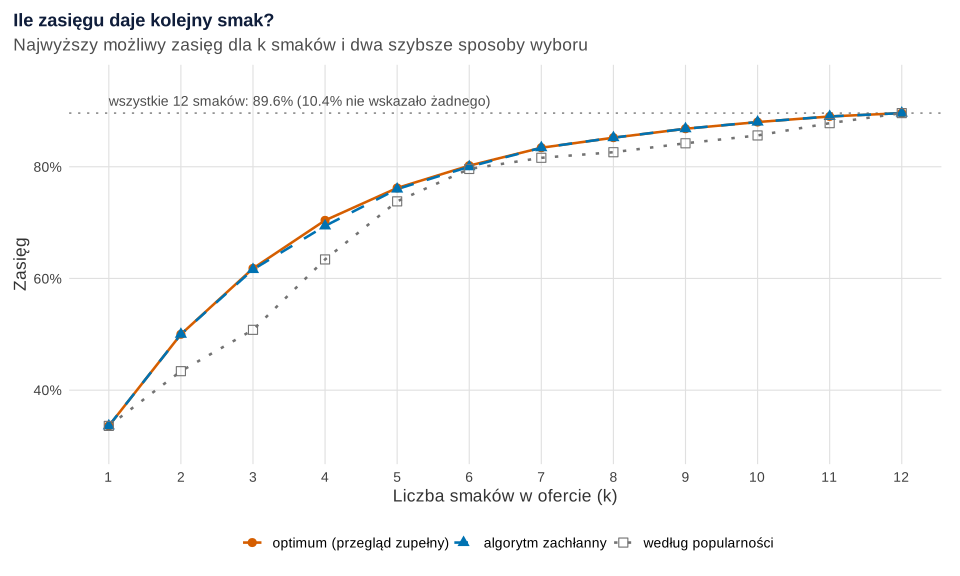
Co widać. Czerwona linia to najwyższy możliwy zasięg dla k smaków. Pierwszy smak (czekolada) daje 33.6%, drugi dokłada 16.4 punktu, trzeci 11.8, czwarty 8.6, a dwunasty już tylko 0.6. Algorytm zachłanny (niebieskie trójkąty) wybrał czekoladę, mango, słony karmel i wanilię. Przy k = 4 dał 69.4%, czyli o 1.0 punktu mniej niż optimum; przy k = 3 – o 0.2 punktu. Od siedmiu smaków obie linie się pokrywają. Kolejność według popularności (szare kwadraty) traci najwięcej przy 2–4 smakach: przy trzech aż 11.0 punktu.
Jak może zmylić. Krzywa zawsze rośnie i spłaszcza się – to arytmetyka, a nie odkrycie. Nie wynika z niej, ile smaków opłaca się produkować. Pułap 89.6% to osoby, które wskazały cokolwiek. Pozostałych 10.4% nie zdobędzie żaden zestaw.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: czy zwycięzca jest pewny? Bootstrap
Zasięg 70.4% pochodzi z jednej próby 500 osób. Gdyby zapytać inne 500, zwycięzca mógłby być inny. Sprawdzimy to bootstrapem (Efron, 1979): 1000 razy losujemy 500 respondentów ze zwracaniem i za każdym razem powtarzamy przegląd 495 zestawów. Mechanikę losowania ze zwracaniem pokazuje wpis bootstrap – wizualizacja na obrazkach.
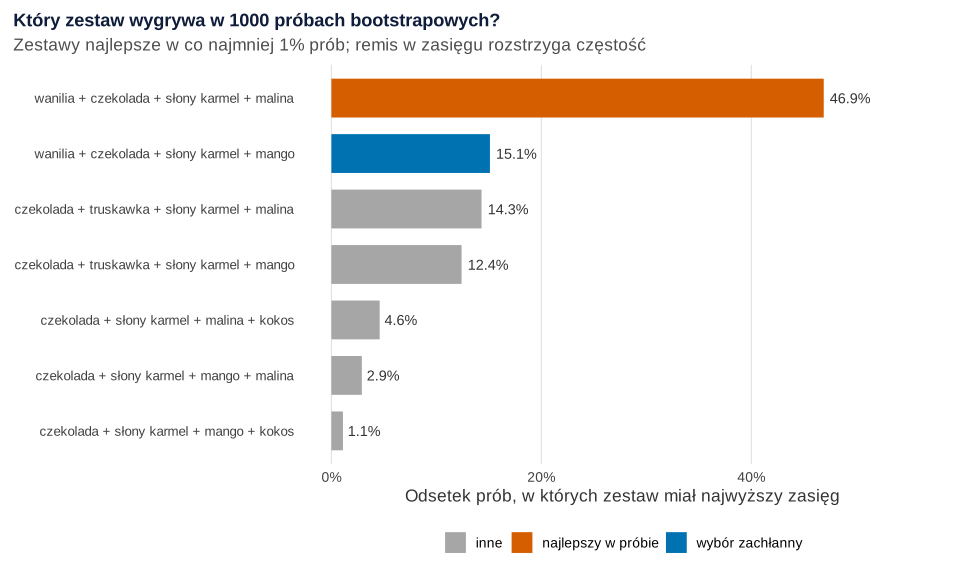
set.seed(621)).Co widać. Zestaw wanilia + czekolada + słony karmel + malina wygrał w 46.9% prób (błąd Monte Carlo ± 1.6 punktu). Zestaw z zachłannego wyboru – w 15.1%, dwa warianty z truskawką zamiast wanilii – w 14.3% i 12.4%. Łącznie wygrywało 13 różnych zestawów, ale każdy zawierał czekoladę i słony karmel. Zestaw najpopularniejszy nie wygrał ani razu. Zasięg najlepszego zestawu: 70.4%, 95% CI [66.0, 74.4]. Przewaga nad zestawem popularnym: 7.0 punktu, 95% CI [3.6, 10.4]. Przewaga nad zachłannym: 1.0 punktu, 95% CI [−1.8, 4.2].
Jak może zmylić. „Wygrał w 47% prób” nie znaczy „z prawdopodobieństwem 47% jest najlepszy w populacji”. To miara stabilności wyboru w tych danych. Pewne jest jądro (czekolada + słony karmel) i to, że zestaw popularny jest gorszy. Wybór między maliną, mango, wanilią i truskawką to w tych danych remis.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Jądro oferty: czekolada i słony karmel – są w każdym zwycięskim zestawie.
- Dwa pozostałe miejsca: wanilia + malina albo ich bliskie zamienniki (mango, truskawka). Decyzję podejmij na podstawie kosztu, marży i dostępności owoców, bo dane nie rozstrzygają.
- Nie wybieraj z rankingu popularności. Cztery najczęściej wskazywane smaki dublują tych samych klientów i tracą 7 punktów zasięgu.
- Piąte miejsce? Najlepszy zestaw pięciu smaków ma zasięg 76.2%, o 5.8 punktu więcej niż najlepszy z czterech (rysunek 4). Jeśli zamrażarka jest większa, policz, czy ten przyrost pokrywa koszt kolejnego smaku. Kokos i matcha mają małe grupy chętnych – nadają się raczej na smak sezonowy.
- Różne segmenty, różne zestawy: w sklepie przy siłowni może wygrać inny zestaw. TURF łączy się z segmentacją, np. z analizą skupień w marketingu lub klasami latentnymi. Lipovetsky (2008) łączy TURF z analizą struktur latentnych i proponuje porządkować produkty wartością Shapleya, co daje stabilniejsze wyniki niż samo TURF.
- Sprawdź w sprzedaży: dwa zestawy w losowo wybranych sklepach to prosty test A/B (plan: test A/B – plan i analiza).
Jak opisać w pracy
W Metodzie podaj pytanie i format odpowiedzi, liczbę wariantów, wielkość zestawu, definicję zasięgu (co najmniej jeden wariant) i sposób przeszukania (przegląd zupełny czy algorytm). Dodaj, jak rozstrzygasz remisy i jak oceniasz stabilność wyniku. Zasięg da się też zdefiniować jako „co najmniej dwa warianty” i uwzględnić wagi z ankiety (Antipov i Pokryshevskaya, 2025) – jeśli to robisz, napisz o tym wprost.
W Wynikach pokaż tabelę kilku najlepszych zestawów (zasięg, częstość, odsetek wygranych w bootstrapie) i krzywą przyrostu zasięgu. Przy odsetkach pojedynczych smaków możesz podać przedział ufności dla proporcji. W Ograniczeniach napisz, że analiza opiera się na deklaracjach i na próbie, która nie musi odpowiadać klientom sklepów. Inne projekty tego typu zebraliśmy we wpisie statystyka w pracy z marketingu.
Kod R: analiza TURF w bazowym R
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Zasięg, przegląd zupełny, algorytm zachłanny i bootstrap liczy bazowy R (combn(), rowSums(), mnożenie macierzy) – bez specjalnych pakietów. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane) i 5 (bootstrap); oba zaczynają się od własnego set.seed(621). Ziarno 621 ustalono raz i nie zmieniano go. Ręcznie ustalono: 500 respondentów, 12 smaków, udziały gustów (.34, .24, .22, .14 i .06 bez gustu), prawdopodobieństwa wskazań smaków z gustu (.25–.60), spoza gustu (.06) i u osób bez gustu (.01), wielkość zestawu (4), liczbę prób bootstrapowych (1000) oraz kryterium wyboru osób na rysunku 2 (pierwsze 10 w pliku). Parametrów nie zmieniano po pierwszym uruchomieniu. Całość liczy się w kilka sekund.
1. Dane, popularność smaków i mapa: Rysunek 1
R
# Rysunek 1. Fikcyjny producent lodów: 500 respondentów wskazuje, które z 12 smaków by kupili (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        legend.position = "bottom", plot.title.position = "plot")

# Parametry ustalone ręcznie przed pierwszym uruchomieniem: cztery ukryte gusty i prawdopodobieństwa wskazań
set.seed(621)
smaki <- c("wanilia", "czekolada", "stracciatella", "truskawka", "słony karmel", "pistacja", "ciasteczkowe",
           "mango", "malina", "cytryna z bazylią", "kokos", "matcha")
gusty <- c("klasyczny", "deserowy", "owocowy", "roślinny", "żaden")
n <- 500
gust <- sample(gusty, n, replace = TRUE, prob = c(.34, .24, .22, .14, .06))
P <- matrix(0.06, length(gusty), length(smaki), dimnames = list(gusty, smaki))  # tło: 6% dla smaku „spoza gustu”
P["klasyczny", c("wanilia", "czekolada", "stracciatella", "truskawka")] <- c(.55, .60, .45, .40)
P["deserowy",  c("czekolada", "słony karmel", "pistacja", "ciasteczkowe")] <- c(.45, .60, .50, .50)
P["owocowy",   c("truskawka", "mango", "malina", "cytryna z bazylią")] <- c(.35, .55, .50, .45)
P["roślinny",  c("kokos", "matcha", "mango", "malina")] <- c(.55, .50, .30, .25)
P["żaden", ] <- 0.01                                      # osoby, którym żaden smak nie odpowiada
X <- t(sapply(gust, function(g) rbinom(length(smaki), 1, P[g, ])))
dimnames(X) <- list(NULL, smaki)                          # X: respondent × smak, 1 = „kupił(a)bym”

dane <- data.frame(id = 1:n, X, gust_ukryty = gust, check.names = FALSE)
write.csv(dane, "analiza-turf-smaki.csv", row.names = FALSE, fileEncoding = "UTF-8")

wsk <- rowSums(X)
round(c(respondenci = n, smakow_na_osobe = mean(wsk), proc_zaden = 100 * mean(wsk == 0),
        proc_jeden = 100 * mean(wsk == 1), max_wskazan = max(wsk)), 2)
popularnosc <- sort(colMeans(X), decreasing = TRUE)
round(100 * popularnosc, 1)

# Mapa respondent × smak: smaki ułożone według podobieństwa, respondenci według wzoru odpowiedzi
kol_smaki <- smaki[hclust(dist(t(X), method = "binary"), method = "average")$order]
wiersze <- do.call(order, c(as.data.frame(-X[, kol_smaki]), list(-wsk)))
mapa <- data.frame(osoba = rep(seq_len(n), times = length(smaki)),
                   smak = factor(rep(kol_smaki, each = n), levels = kol_smaki),
                   wybor = as.vector(X[wiersze, kol_smaki]))
etykiety <- sprintf("%s\n%.0f%%", sub(" ", "\n", sub("cytryna z ", "cytryna z\u00a0", kol_smaki)), 100 * colMeans(X)[kol_smaki])
p1 <- ggplot(mapa, aes(smak, osoba, fill = factor(wybor))) +
  geom_raster() +
  annotate("text", x = 6.5, y = n - 0.104 * n / 2, size = 3.8, colour = "grey30",
           label = sprintf("%.1f%% osób nie wskazało żadnego smaku", 100 * mean(wsk == 0))) +
  scale_fill_manual(values = c("0" = "white", "1" = kol[["niebieski"]]), labels = c("nie wskazał(a)", "kupił(a)bym"),
                    name = NULL) +
  guides(fill = guide_legend(override.aes = list(colour = "grey50"))) +
  scale_x_discrete(labels = etykiety, position = "top") +
  scale_y_reverse(breaks = c(1, 100, 200, 300, 400, 500), expand = c(0, 0)) +
  labs(title = "Kto wskazał który smak? 500 respondentów × 12 smaków",
       subtitle = "Wiersz = respondent, niebieskie pole = „kupił(a)bym”; pod nazwą odsetek wskazań",
       x = NULL, y = "Respondent (uporządkowani według wzoru odpowiedzi)") +
  motyw + theme(panel.grid = element_blank(), axis.text.x = element_text(size = 9.5, lineheight = 0.9))
p1   # zapis: ggsave("analiza-turf-mapa-respondent-smak.svg", p1, width = 10, height = 8)
Wynik w R
    respondenci smakow_na_osobe      proc_zaden      proc_jeden     max_wskazan
         500.00            2.23           10.40           18.20            7.00
        czekolada           wanilia         truskawka      słony karmel
             33.6              23.4              21.2              21.0
            mango            malina          pistacja     stracciatella
             19.2              18.2              17.4              16.4
     ciasteczkowe cytryna z bazylią            matcha             kokos
             16.2              12.8              12.2              11.8
2. Zasięg i częstość jednego zestawu: Rysunek 2
R
# Rysunek 2. Jak liczy się zasięg i częstość: zestaw „cztery najpopularniejsze” na pierwszych 10 respondentach
# Korzysta z obiektów przepisu 1: X, smaki, popularnosc, kol, motyw. Niczego nie losuje.
library(ggplot2)

zasieg <- function(zestaw, M = X) mean(rowSums(M[, zestaw, drop = FALSE]) > 0)   # odsetek z ≥ 1 smakiem z zestawu
czestosc <- function(zestaw, M = X) {                                                # średnia liczba „trafionych” smaków
  t <- rowSums(M[, zestaw, drop = FALSE]); c(wszyscy = mean(t), dotarci = mean(t[t > 0]))
}
top4 <- names(popularnosc)[1:4]                       # czekolada, wanilia, truskawka, słony karmel
round(c(zasieg = zasieg(top4), czestosc(top4)), 3)

pokaz <- 1:10                                          # kryterium z góry: pierwszych 10 osób w pliku
trafienia <- rowSums(X[pokaz, top4])
data.frame(osoba = pokaz, wskazane = apply(X[pokaz, ], 1, function(w) paste(smaki[w == 1], collapse = ", ")),
           z_zestawu = trafienia)
round(c(dotarci_w_10 = sum(trafienia > 0), czestosc_w_10 = mean(trafienia)), 2)

kolejnosc <- c(top4, setdiff(smaki, top4))
siatka <- expand.grid(osoba = pokaz, smak = kolejnosc, stringsAsFactors = FALSE)
siatka$wybor <- X[cbind(siatka$osoba, match(siatka$smak, smaki))]
siatka$x <- match(siatka$smak, kolejnosc)
siatka$w_zestawie <- siatka$smak %in% top4
siatka$typ <- ifelse(siatka$wybor == 0, "brak", ifelse(siatka$w_zestawie, "trafiony", "poza"))
opis <- data.frame(osoba = pokaz, trafione = trafienia,
                   tekst = ifelse(trafienia > 0, sprintf("dotarty · %d z zestawu", trafienia), "niedotarty"),
                   kolor = ifelse(trafienia > 0, kol[["cynober"]], "grey35"))
p2 <- ggplot() +
  annotate("rect", xmin = 0.5, xmax = 4.5, ymin = 0.4, ymax = 10.6, fill = "#FBE3D2", colour = kol[["cynober"]],
           linewidth = 0.8) +
  annotate("text", x = 2.5, y = -0.05, label = "zestaw: 4 najpopularniejsze smaki", colour = kol[["cynober"]],
           fontface = "bold", size = 4.2) +
  geom_tile(data = siatka, aes(x, osoba, fill = typ), width = 0.82, height = 0.78, colour = "grey75",
            linewidth = 0.3) +
  geom_text(data = subset(siatka, wybor == 1), aes(x, osoba), label = "✓", colour = "white", size = 4.2,
            fontface = "bold") +
  geom_text(data = opis, aes(x = 12.9, y = osoba, label = tekst, colour = kolor), hjust = 0, size = 4.1,
            fontface = "bold") +
  scale_fill_manual(values = c(brak = "white", trafiony = kol[["cynober"]], poza = kol[["niebieski"]]),
                    breaks = c("trafiony", "poza", "brak"),
                    labels = c("wskazany smak z zestawu", "wskazany smak spoza zestawu", "nie wskazany"), name = NULL) +
  scale_colour_identity() +
  scale_x_continuous(breaks = seq_along(kolejnosc), labels = kolejnosc, expand = expansion(add = c(0.3, 0.2))) +
  scale_y_reverse(breaks = pokaz, labels = paste("osoba", pokaz)) +
  coord_cartesian(xlim = c(0.5, 15.6), ylim = c(10.7, -0.35), clip = "off") +
  labs(title = "Zasięg = odsetek osób z co najmniej jednym smakiem z zestawu",
       subtitle = sprintf("Tu %d z 10 osób (w całej próbie %.1f%%); częstość = średnia liczba smaków z zestawu: %.2f",
                          sum(trafienia > 0), 100 * zasieg(top4), mean(trafienia)),
       x = NULL, y = NULL) +
  motyw + theme(panel.grid = element_blank(), axis.text.x = element_text(angle = 40, hjust = 1, size = 10.5))
p2   # zapis: ggsave("analiza-turf-schemat-zasiegu.svg", p2, width = 10, height = 6.6)
Wynik w R
 zasieg wszyscy dotarci
  0.634   0.992   1.565
   osoba                        wskazane z_zestawu
1      1                           mango         0
2      2        czekolada, stracciatella         1
3      3        czekolada, stracciatella         1
4      4            czekolada, truskawka         2
5      5                   malina, kokos         0
6      6 wanilia, słony karmel, pistacja         2
7      7         czekolada, słony karmel         2
8      8                  wanilia, kokos         1
9      9            czekolada, truskawka         2
10    10                                         0
 dotarci_w_10 czestosc_w_10
          7.0           1.1
3. Przegląd zupełny 495 zestawów: Rysunek 3
R
# Rysunek 3. Przegląd zupełny: zasięg i częstość wszystkich 495 zestawów 4 z 12 smaków
# Korzysta z obiektów przepisów 1–2: X, smaki, top4, zasieg, kol, motyw. Niczego nie losuje.
library(ggplot2)

zestawy <- combn(length(smaki), 4)                    # 12 nad 4 = 495 kolumn z numerami smaków
ncol(zestawy)
D <- sapply(seq_len(ncol(zestawy)), function(j) rowSums(X[, zestawy[, j]]))  # 500 × 495: liczba trafień osoby
wyniki <- data.frame(zestaw = apply(zestawy, 2, function(z) paste(smaki[z], collapse = " + ")),
                     zasieg = colMeans(D > 0), czestosc = colMeans(D))
wyniki <- wyniki[order(-wyniki$zasieg, -wyniki$czestosc), ]
wyniki$miejsce <- seq_len(nrow(wyniki))
najlepszy <- wyniki$zestaw[1]
head(transform(wyniki, zasieg = round(100 * zasieg, 1), czestosc = round(czestosc, 3)), 12)
pop_nazwa <- paste(smaki[sort(match(top4, smaki))], collapse = " + ")
subset(transform(wyniki, zasieg = round(100 * zasieg, 1), czestosc = round(czestosc, 3)), zestaw == pop_nazwa)
round(c(roznica_pp = 100 * (wyniki$zasieg[1] - zasieg(top4)),
        zestawow_do_1pp = sum(wyniki$zasieg >= wyniki$zasieg[1] - 0.01),
        zestawow_do_2pp = sum(wyniki$zasieg >= wyniki$zasieg[1] - 0.02),
        mediana_wszystkich = 100 * median(wyniki$zasieg)), 1)

pokaz <- head(wyniki, 15)
if (!pop_nazwa %in% pokaz$zestaw) pokaz <- rbind(pokaz, subset(wyniki, zestaw == pop_nazwa))
pokaz$etykieta <- factor(sprintf("%d. %s", pokaz$miejsce, pokaz$zestaw),
                         levels = rev(sprintf("%d. %s", pokaz$miejsce, pokaz$zestaw)))
pokaz$rodzaj <- ifelse(pokaz$miejsce == 1, "najwyższy zasięg",
                       ifelse(pokaz$zestaw == pop_nazwa, "4 najpopularniejsze smaki", "pozostałe z czołówki"))
p3 <- ggplot(pokaz, aes(100 * zasieg, etykieta)) +
  geom_vline(xintercept = 100 * (wyniki$zasieg[1] - 0.01), linetype = "dashed", colour = "grey55") +
  geom_segment(aes(x = 60, xend = 100 * zasieg, yend = etykieta), colour = "grey80", linewidth = 0.6) +
  geom_point(aes(colour = rodzaj, shape = rodzaj), size = 3.6) +
  geom_text(aes(x = 71.6, label = sprintf("%.1f%% · %.2f", 100 * zasieg, czestosc)), hjust = 0, size = 3.7,
            colour = "grey25") +
  scale_colour_manual(values = c("najwyższy zasięg" = kol[["cynober"]], "4 najpopularniejsze smaki" = kol[["niebieski"]],
                                 "pozostałe z czołówki" = "grey45"), name = NULL) +
  scale_shape_manual(values = c("najwyższy zasięg" = 16, "4 najpopularniejsze smaki" = 17,
                                "pozostałe z czołówki" = 1), name = NULL) +
  scale_x_continuous(limits = c(60, 75.2), breaks = seq(60, 70, 2.5), labels = function(x) paste0(x, "%")) +
  labs(title = "15 zestawów z najwyższym zasięgiem spośród 495",
       subtitle = "Liczby: zasięg · częstość; linia przerywana: 1 pp poniżej najlepszego zestawu",
       x = "Zasięg (odsetek osób z co najmniej jednym smakiem z zestawu)", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank(), axis.text.y = element_text(size = 10))
p3   # zapis: ggsave("analiza-turf-najlepsze-zestawy.svg", p3, width = 10, height = 7.4)
Wynik w R
[1] 495
                                               zestaw zasieg czestosc miejsce
21        wanilia + czekolada + słony karmel + malina   70.4    0.962       1
205     czekolada + truskawka + słony karmel + malina   69.6    0.940       2
20         wanilia + czekolada + słony karmel + mango   69.4    0.972       3
204      czekolada + truskawka + słony karmel + mango   69.2    0.950       4
241         czekolada + słony karmel + mango + malina   68.6    0.920       5
246         czekolada + słony karmel + malina + kokos   68.4    0.846       6
177 czekolada + stracciatella + słony karmel + malina   68.2    0.892       7
247        czekolada + słony karmel + malina + matcha   67.8    0.850       8
176  czekolada + stracciatella + słony karmel + mango   67.6    0.902       9
243          czekolada + słony karmel + mango + kokos   67.4    0.856      10
207      czekolada + truskawka + słony karmel + kokos   66.6    0.876      11
244         czekolada + słony karmel + mango + matcha   66.6    0.860      12
                                           zestaw zasieg czestosc miejsce
10 wanilia + czekolada + truskawka + słony karmel   63.4    0.992      59
        roznica_pp    zestawow_do_1pp    zestawow_do_2pp mediana_wszystkich
               7.0                3.0                6.0               56.6
4. Krzywa przyrostu zasięgu: Rysunek 4
R
# Rysunek 4. Krzywa przyrostu zasięgu: ile daje kolejny smak? Optymalnie, zachłannie i według popularności
# Korzysta z obiektów przepisów 1–2: X, smaki, popularnosc, zasieg, kol, motyw. Niczego nie losuje.
library(ggplot2)

k_max <- length(smaki)
optimum <- sapply(1:k_max, function(k) max(apply(combn(k_max, k), 2, function(z) zasieg(smaki[z]))))
zachlanny <- character(0)                              # algorytm zachłanny: dokładaj smak o największym przyroście
for (k in 1:k_max) {
  kandydaci <- setdiff(smaki, zachlanny)
  zachlanny <- c(zachlanny, kandydaci[which.max(sapply(kandydaci, function(s) zasieg(c(zachlanny, s))))])
}
kolejnosc_zachlanna <- zachlanny
metody <- c("optimum (przegląd zupełny)", "algorytm zachłanny", "według popularności")
krzywa <- data.frame(k = rep(1:k_max, 3), metoda = factor(rep(metody, each = k_max), levels = metody),
                     zasieg = c(optimum, sapply(1:k_max, function(k) zasieg(kolejnosc_zachlanna[1:k])),
                                sapply(1:k_max, function(k) zasieg(names(popularnosc)[1:k]))))
tab <- reshape(krzywa, idvar = "k", timevar = "metoda", direction = "wide")
names(tab) <- c("k", "optimum", "zachlanny", "popularnosc")
tab$przyrost_opt <- c(tab$optimum[1], diff(tab$optimum))
print(transform(tab, optimum = round(100 * optimum, 1), zachlanny = round(100 * zachlanny, 1),
                popularnosc = round(100 * popularnosc, 1), przyrost_opt = round(100 * przyrost_opt, 1)),
      row.names = FALSE)
kolejnosc_zachlanna

p4 <- ggplot(krzywa, aes(k, 100 * zasieg, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_hline(yintercept = 100 * optimum[k_max], colour = "grey55", linetype = "dotted") +
  annotate("text", x = 1, y = 100 * optimum[k_max] + 2.2, hjust = 0, size = 3.7, colour = "grey30",
           label = sprintf("wszystkie 12 smaków: %.1f%% (%.1f%% nie wskazało żadnego)",
                           100 * optimum[k_max], 100 * (1 - optimum[k_max]))) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.8) +
  scale_colour_manual(values = c("optimum (przegląd zupełny)" = kol[["cynober"]], "algorytm zachłanny" = kol[["niebieski"]],
                                 "według popularności" = "grey45"), name = NULL) +
  scale_shape_manual(values = c("optimum (przegląd zupełny)" = 16, "algorytm zachłanny" = 17,
                                "według popularności" = 0), name = NULL) +
  scale_linetype_manual(values = c("optimum (przegląd zupełny)" = "solid", "algorytm zachłanny" = "dashed",
                                   "według popularności" = "dotted"), name = NULL) +
  scale_x_continuous(breaks = 1:k_max) +
  scale_y_continuous(limits = c(30, 95), labels = function(x) paste0(x, "%")) +
  labs(title = "Ile zasięgu daje kolejny smak?",
       subtitle = "Najwyższy możliwy zasięg dla k smaków i dwa szybsze sposoby wyboru",
       x = "Liczba smaków w ofercie (k)", y = "Zasięg") +
  motyw + guides(colour = guide_legend(nrow = 1))
p4   # zapis: ggsave("analiza-turf-krzywa-zasiegu.svg", p4, width = 10, height = 6)
Wynik w R
  k optimum zachlanny popularnosc przyrost_opt
  1    33.6      33.6        33.6         33.6
  2    50.0      50.0        43.4         16.4
  3    61.8      61.6        50.8         11.8
  4    70.4      69.4        63.4          8.6
  5    76.2      76.0        73.8          5.8
  6    80.2      80.0        79.6          4.0
  7    83.4      83.4        81.6          3.2
  8    85.2      85.2        82.6          1.8
  9    86.8      86.8        84.2          1.6
 10    88.0      88.0        85.6          1.2
 11    89.0      89.0        87.8          1.0
 12    89.6      89.6        89.6          0.6
 [1] "czekolada"         "mango"             "słony karmel"
 [4] "wanilia"           "malina"            "kokos"
 [7] "truskawka"         "ciasteczkowe"      "matcha"
[10] "pistacja"          "cytryna z bazylią" "stracciatella"
5. Bootstrap: stabilność zwycięzcy: Rysunek 5
R
# Rysunek 5. Bootstrap: jak często każdy zestaw wygrywa, gdy losujemy respondentów ze zwracaniem
# Korzysta z obiektów przepisów 1–4: X, n, D, wyniki, najlepszy, pop_nazwa, kolejnosc_zachlanna, smaki, kol, motyw.
library(ggplot2)

R <- (D > 0) * 1                                       # 500 × 495: czy osoba jest dotarta przez zestaw
C <- D                                                 # liczba trafień (do rozstrzygania remisów częstością)
nazwy <- apply(combn(length(smaki), 4), 2, function(z) paste(smaki[z], collapse = " + "))
j_best <- match(najlepszy, nazwy); j_pop <- match(pop_nazwa, nazwy)
zach_nazwa <- paste(smaki[sort(match(kolejnosc_zachlanna[1:4], smaki))], collapse = " + ")
j_zach <- match(zach_nazwa, nazwy)
set.seed(621)
B <- 1000
zwyciezca <- integer(B); roznice <- matrix(NA, B, 3, dimnames = list(NULL, c("najlepszy", "najl_minus_pop", "najl_minus_zach")))
for (b in 1:B) {
  w <- tabulate(sample.int(n, n, replace = TRUE), n)   # ile razy każda osoba trafiła do próby bootstrapowej
  zas <- drop(w %*% R) / n
  cz <- drop(w %*% C) / n
  zwyciezca[b] <- order(-zas, -cz)[1]                  # remis w zasięgu rozstrzyga częstość
  roznice[b, ] <- c(zas[j_best], zas[j_best] - zas[j_pop], zas[j_best] - zas[j_zach])
}
wygrane <- sort(table(nazwy[zwyciezca]), decreasing = TRUE)
round(c(roznych_zwyciezcow = length(wygrane), proc_wygranych_najlepszego = 100 * mean(zwyciezca == j_best),
        blad_mc_pp = 100 * sqrt(mean(zwyciezca == j_best) * (1 - mean(zwyciezca == j_best)) / B),
        proc_wygranych_zachlannego = 100 * mean(zwyciezca == j_zach)), 1)
round(100 * head(wygrane, 8) / B, 1)
round(100 * t(apply(roznice, 2, quantile, c(.025, .975))), 1)
round(c(proc_pop_wygrywa_kiedykolwiek = 100 * mean(zwyciezca == j_pop),
        proc_zestawow_z_czekolada_i_karmelem = 100 * mean(grepl("czekolada", nazwy[zwyciezca]) &
                                                            grepl("słony karmel", nazwy[zwyciezca]))), 1)

pokaz <- data.frame(zestaw = names(wygrane), proc = 100 * as.numeric(wygrane) / B)
pokaz <- subset(pokaz, proc >= 1)
pokaz$zestaw <- factor(pokaz$zestaw, levels = rev(pokaz$zestaw))
pokaz$rodzaj <- ifelse(pokaz$zestaw == najlepszy, "najlepszy w próbie",
                       ifelse(pokaz$zestaw == zach_nazwa, "wybór zachłanny", "inne"))
p5 <- ggplot(pokaz, aes(proc, zestaw, fill = rodzaj)) +
  geom_col(width = 0.7) +
  geom_text(aes(label = sprintf("%.1f%%", proc)), hjust = -0.15, size = 3.8, colour = "grey20") +
  scale_fill_manual(values = c("najlepszy w próbie" = kol[["cynober"]], "wybór zachłanny" = kol[["niebieski"]],
                               "inne" = "grey65"), name = NULL) +
  scale_x_continuous(limits = c(0, max(pokaz$proc) * 1.18), labels = function(x) paste0(x, "%")) +
  labs(title = "Który zestaw wygrywa w 1000 próbach bootstrapowych?",
       subtitle = "Zestawy najlepsze w co najmniej 1% prób; remis w zasięgu rozstrzyga częstość",
       x = "Odsetek prób, w których zestaw miał najwyższy zasięg", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank(), axis.text.y = element_text(size = 10))
p5   # zapis: ggsave("analiza-turf-bootstrap-zwyciezcy.svg", p5, width = 10, height = 6)
Wynik w R
        roznych_zwyciezcow proc_wygranych_najlepszego
                      13.0                       46.9
                blad_mc_pp proc_wygranych_zachlannego
                       1.6                       15.1

  wanilia + czekolada + słony karmel + malina
                                         46.9
   wanilia + czekolada + słony karmel + mango
                                         15.1
czekolada + truskawka + słony karmel + malina
                                         14.3
 czekolada + truskawka + słony karmel + mango
                                         12.4
    czekolada + słony karmel + malina + kokos
                                          4.6
    czekolada + słony karmel + mango + malina
                                          2.9
     czekolada + słony karmel + mango + kokos
                                          1.1
   czekolada + słony karmel + malina + matcha
                                          0.9
                2.5% 97.5%
najlepszy       66.0  74.4
najl_minus_pop   3.6  10.4
najl_minus_zach -1.8   4.2
       proc_pop_wygrywa_kiedykolwiek proc_zestawow_z_czekolada_i_karmelem
                                   0                                  100
6. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (smak spoza / z zestawu; zachłanny / optimum)" = c("#0072B2", "#D55E00"),
             "cynober – szary (najlepszy zestaw / pozostałe)" = c("#D55E00", "#737373"),
             "niebieski – szary (zachłanny / pozostałe)" = c("#0072B2", "#A6A6A6"),
             "niebieski – biały (wskazał / nie wskazał na mapie)" = c("#0072B2", "#FFFFFF"),
             "jasnopomarańczowy – biały (tło zestawu na schemacie)" = c("#FBE3D2", "#FFFFFF"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                  widzenie_typowe
niebieski – cynober (smak spoza / z zestawu; zachłanny / optimum)           114.6
cynober – szary (najlepszy zestaw / pozostałe)                               76.9
niebieski – szary (zachłanny / pozostałe)                                    47.0
niebieski – biały (wskazał / nie wskazał na mapie)                           68.1
jasnopomarańczowy – biały (tło zestawu na schemacie)                         15.0
czerwony – zielony (do unikania)                                            121.7
                                                                  deuteranopia
niebieski – cynober (smak spoza / z zestawu; zachłanny / optimum)        108.3
cynober – szary (najlepszy zestaw / pozostałe)                            63.4
niebieski – szary (zachłanny / pozostałe)                                 51.0
niebieski – biały (wskazał / nie wskazał na mapie)                        71.8
jasnopomarańczowy – biały (tło zestawu na schemacie)                      14.3
czerwony – zielony (do unikania)                                          21.1
                                                                  protanopia
niebieski – cynober (smak spoza / z zestawu; zachłanny / optimum)       91.9
cynober – szary (najlepszy zestaw / pozostałe)                          53.8
niebieski – szary (zachłanny / pozostałe)                               42.5
niebieski – biały (wskazał / nie wskazał na mapie)                      63.4
jasnopomarańczowy – biały (tło zestawu na schemacie)                    13.8
czerwony – zielony (do unikania)                                        31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, macierze, kombinacje i grupowanie hierarchiczne smaków – pakiety base i stats). Rysunki wykonano w ggplot2, pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Deklaracje to nie zakupy. „Kupił(a)bym” nie oznacza zakupu. Morwitz i in. (2007) pokazali, że deklaracje słabiej przewidują zakupy nowych produktów niż istniejących, a lepiej przy krótkim horyzoncie czasowym i konkretnym produkcie. Nowe smaki to właśnie przypadek gorszy. Pytaj o konkretną sytuację („w najbliższym miesiącu w tym sklepie”).
- Format pytania zmienia odsetki. Przy formacie „tak/nie przy każdym smaku” respondenci zaznaczają więcej opcji niż przy „zaznacz wszystkie”, choć kolejność opcji się nie zmienia (Callegaro i in., 2015). Wyższe wskazania podnoszą zasięg wszystkich zestawów, więc nie porównuj zasięgów z badań w różnych formatach. Długą kafeterię sprawdź w pilotażu.
- Remisy. Różnicę kilku osób traktuj jak remis. Podawaj kilka zestawów i wynik bootstrapu, a nie jednego „zwycięzcę”.
- Zawyżony zasięg zwycięzcy. Zestaw wybrany jako najlepszy spośród 495 ma zasięg zawyżony przez przypadek – podobnie jak model dopasowany do próby (przeuczenie). Jeśli możesz, sprawdź go na nowej próbie.
- Zasięg to nie sprzedaż. TURF nie mówi, ile porcji kupi klient ani czy nowy smak zabierze sprzedaż staremu. Do udziałów w rynku i ceny służy conjoint wyborczy (CBC), a do pytania, czy cecha zachwyca, czy jest oczywista – model Kano.
- Niereprezentatywna próba. Zasięg dotyczy osób z badania. Jeśli struktura próby odbiega od klientów, rozważ ważenie danych.
Zamiast pytania „zaznacz wszystkie” możesz zebrać dane metodą MaxDiff i liczyć zasięg na smakach najwyżej ocenionych przez każdą osobę. Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Co to jest analiza TURF?
TURF (total unduplicated reach and frequency) to metoda wyboru zestawu wariantów produktu, np. smaków, które razem dotrą do jak największej liczby klientów. Zasięg to odsetek osób, które w zestawie mają co najmniej jeden wskazany wariant, a częstość – średnia liczba takich wariantów na osobę. Dane to zwykle pytanie wielokrotnego wyboru „które byś kupił(a)?”.
Czym się różni TURF od rankingu popularności?
Ranking ocenia każdy wariant osobno, a TURF – zestaw jako całość. Dwa popularne warianty mogą przyciągać tych samych klientów, więc razem dodają niewiele. W przykładzie cztery najpopularniejsze smaki miały zasięg 63.4%, a najlepszy zestaw 70.4%, bo malina zastąpiła truskawkę i dotarła do innej grupy klientów.
Jak policzyć analizę TURF w R lub Excelu?
Zakoduj każdy wariant jako kolumnę 0/1. Dla zestawu zsumuj kolumny w wierszu: osoba jest dotarta, gdy suma jest większa od zera, a średnia sum to częstość. W R funkcja combn() wypisze wszystkie zestawy i policzy zasięg każdego; w Excelu to samo zrobisz formułą dla kilku wybranych zestawów.
Czy algorytm zachłanny w TURF daje najlepszy zestaw?
Nie zawsze. Algorytm dokłada kolejno wariant dodający najwięcej nowych osób i jest szybki, ale może pominąć lepszą kombinację. W przykładzie dał przy czterech smakach zasięg 69.4% wobec 70.4% w przeglądzie zupełnym. Przy kilkunastu wariantach policz wszystkie zestawy, a przy dużych listach użyj optymalizacji całkowitoliczbowej.
Jak sprawdzić, czy wynik TURF jest stabilny?
Wylosuj wielokrotnie respondentów ze zwracaniem (bootstrap) i za każdym razem wybierz najlepszy zestaw. Podaj, jak często wygrywa każdy zestaw, i przedział ufności dla różnicy zasięgów. W przykładzie zwycięzca wygrał w 46.9% z 1000 prób, ale czekolada i słony karmel były we wszystkich zwycięskich zestawach.
Powiązane hasła
Przeczytaj też
MaxDiff – plan badania i analiza
Plan BIBD, wyniki B − W, warunkowy logit i udziały preferencji w R oraz porównanie ze skalą Likerta na tych samych osobach.
Czytaj →PoradnikConjoint wyborczy (CBC) – analiza
400 osób wybiera abonament: warunkowy model logitowy, ważność atrybutów, gotowość do zapłaty, symulator udziałów i pułapki IIA – pięć rysunków z kodem R.
Czytaj →PoradnikModel Kano krok po kroku
Ankieta 400 klientów banku o funkcjach aplikacji: tabela oceny, kategorie, SI i DI z bootstrapem, remisy i segmenty – sześć rysunków z kodem R.
Czytaj →Masz w pracy ankietę o wyborze produktów lub wariantów oferty?
Pomożemy przygotować pytanie, policzyć zasięg i częstość zestawów, sprawdzić stabilność wyniku i opisać analizę TURF tak, żebyś umiał(a) ją obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Antipov, E. A., & Pokryshevskaya, E. B. (2025). Weighted TURF analysis for product line optimisation as a maximum coverage problem with a customisable definition of reach: Methodology and open source implementation. Applied Marketing Analytics, 11(2), Article AMA-vol11-iss2-pg165. https://doi.org/10.69554/edwi9488
- Callegaro, M., Murakami, M. H., Tepman, Z., & Henderson, V. (2015). Yes–no answers versus check-all in self-administered modes: A systematic review and analyses. International Journal of Market Research, 57(2), 203–224. https://doi.org/10.2501/ijmr-2015-014a
- Camm, J. D., Christman, J., & Narayanan, A. (2022). Total unduplicated reach and frequency optimization at Procter & Gamble. INFORMS Journal on Applied Analytics, 52(2), 149–157. https://doi.org/10.1287/inte.2021.1096
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Lipovetsky, S. (2008). SURF—Structural unduplicated reach and frequency: Latent class TURF and Shapley value analyses. International Journal of Information Technology & Decision Making, 07(02), 203–216. https://doi.org/10.1142/s0219622008002909
- Morwitz, V. G., Steckel, J. H., & Gupta, A. (2007). When do purchase intentions predict sales? International Journal of Forecasting, 23(3), 347–364. https://doi.org/10.1016/j.ijforecast.2007.05.015 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{antipov2025weighted, author={Antipov, Evgeny A. and Pokryshevskaya, Elena B.}, title={{Weighted TURF analysis for product line optimisation as a maximum coverage problem with a customisable definition of reach: Methodology and open source implementation}}, journal={Applied Marketing Analytics}, year={2025}, volume={11}, number={2}, eid={AMA-vol11-iss2-pg165}, doi={10.69554/edwi9488}}@article{callegaro2015yes, author={Callegaro, Mario and Murakami, Michael H. and Tepman, Ziv and Henderson, Vani}, title={{Yes–no answers versus check-all in self-administered modes: A systematic review and analyses}}, journal={International Journal of Market Research}, year={2015}, volume={57}, number={2}, pages={203--224}, doi={10.2501/ijmr-2015-014a}}@article{camm2022total, author={Camm, Jeffrey D. and Christman, Jeremy and Narayanan, A.}, title={{Total unduplicated reach and frequency optimization at Procter \& Gamble}}, journal={INFORMS Journal on Applied Analytics}, year={2022}, volume={52}, number={2}, pages={149--157}, doi={10.1287/inte.2021.1096}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{lipovetsky2008surf, author={Lipovetsky, Stan}, title={{SURF—Structural unduplicated reach and frequency: Latent class TURF and Shapley value analyses}}, journal={International Journal of Information Technology \& Decision Making}, year={2008}, volume={07}, number={02}, pages={203--216}, doi={10.1142/s0219622008002909}}@article{morwitz2007when, author={Morwitz, Vicki G. and Steckel, Joel H. and Gupta, Alok}, title={{When do purchase intentions predict sales?}}, journal={International Journal of Forecasting}, year={2007}, volume={23}, number={3}, pages={347--364}, doi={10.1016/j.ijforecast.2007.05.015}}