Co to jest wykres UpSet?
Wykres UpSet pokazuje, jak często występują razem cechy, które mogą się nakładać: objawy, zaznaczone odpowiedzi w pytaniu wielokrotnego wyboru albo brakujące zmienne. Każda cecha wyznacza zbiór osób, a wykres liczy osoby w każdym przecięciu zbiorów. Lex i in. (2014) zaproponowali go jako odpowiedź na problem, że liczba przecięć rośnie kombinatorycznie wraz z liczbą zbiorów. Przy pięciu cechach możliwych kombinacji jest 32, przy dziesięciu – 1024. Diagram Venna przestaje wtedy być czytelny.
Jak czytać wykres
- Macierz kropek pod wykresem opisuje kombinację: wypełnione i połączone kropki to cechy, które wystąpiły razem. Kolumna z jedną kropką oznacza osoby z tą jedną cechą i żadną inną.
- Słupki u góry to liczba osób z dokładnie tą kombinacją. Każda osoba trafia do jednego słupka, więc słupki sumują się do liczby osób z co najmniej jedną cechą.
- Słupki z boku to wielkości całych zbiorów, czyli liczba osób z daną cechą niezależnie od innych.
- Sortowanie zwykle idzie według liczebności kombinacji, a rzadkie kombinacje można uciąć.
Przykład
W symulowanych danych 300 osób po infekcji zgłaszało pięć objawów. Najczęstsze było zmęczenie (136 osób), potem problemy z koncentracją (98), ból głowy (64), bezsenność (58) i duszność (33). Bez żadnego objawu było 111 osób, a 189 miało co najmniej jeden. Wystąpiło 27 z 32 możliwych kombinacji. Najczęstsze było samo zmęczenie (34 osoby), potem zmęczenie z problemami z koncentracją (23). Objawy symulowano ze wspólnego czynnika nasilenia, a progi i ładunki ustawiono ręcznie tak, by objawy wyraźnie współwystępowały; ziarna (758) nie zmieniano.
Na rysunku
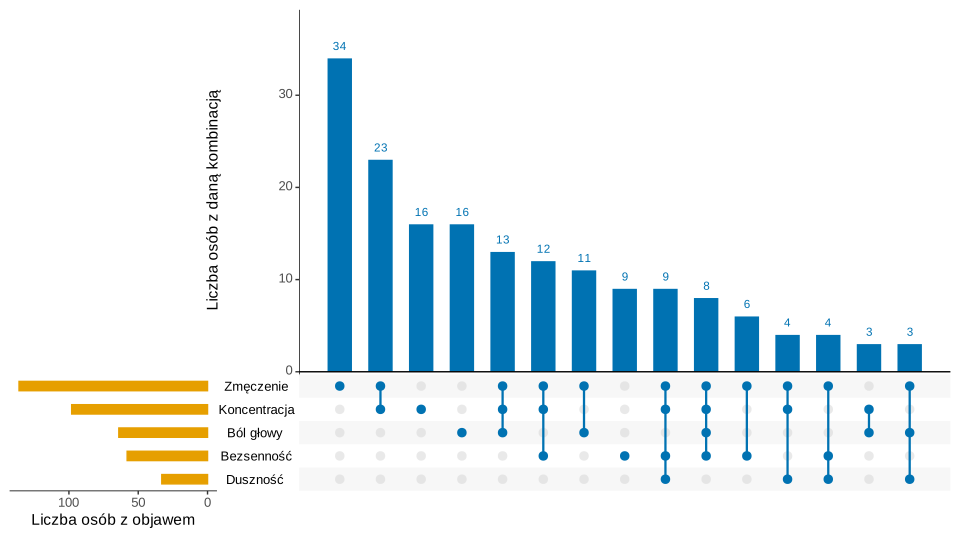
set.seed(758)).Co widać. Najliczniejsze kombinacje to pojedyncze objawy i para zmęczenie–koncentracja. Wszystkie pięć objawów naraz mają tylko 3 osoby. Boczne słupki pokazują, że zmęczenie jest najczęstsze, ale wiele osób ma je razem z innymi objawami.
Na co uważać. Wykres pokazuje 15 kombinacji, w których jest 171 ze 189 osób z objawem; pozostałe 18 osób jest w kombinacjach uciętych. Nie pokazuje też 111 osób bez objawów, bo pusta kombinacja domyślnie nie jest rysowana – podaj tę liczbę w podpisie. Słupki to liczby bezwzględne, więc przy porównaniu grup potrzebujesz odsetków.
Podpis do pracy:
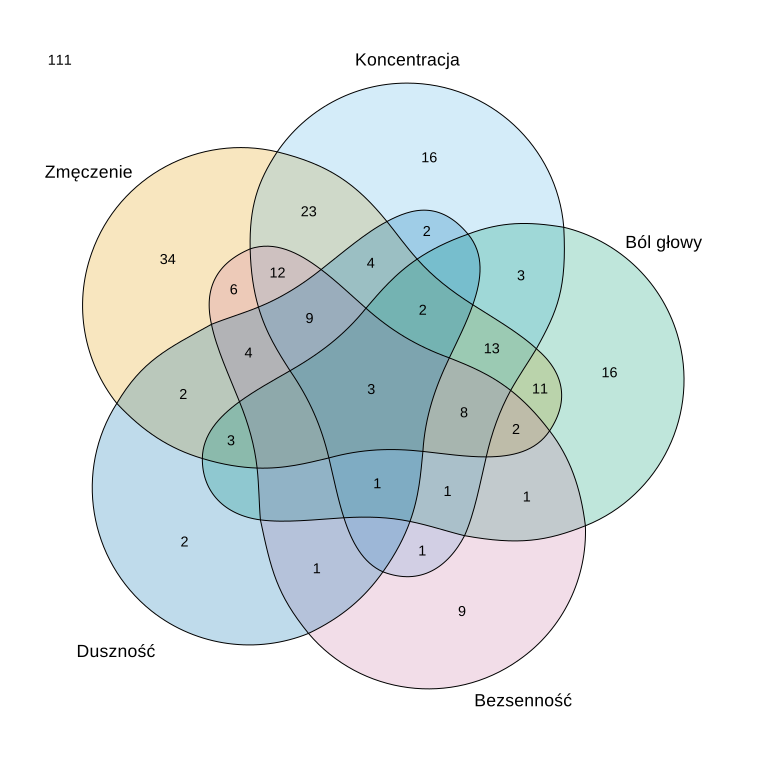
Co widać. Diagram zawiera wszystkie 32 obszary, ale żeby znaleźć osoby z bólem głowy i bezsennością, trzeba przejrzeć kilka małych pól. Wielkość pól nie zależy od liczebności: środkowe pole z liczbą 3 (wszystkie pięć objawów) jest jednym z największych.
Na co uważać. Powierzchnia obszarów w diagramie Venna dla pięciu zbiorów nie odpowiada liczebnościom, a puste kombinacje wyglądają tak samo jak rzadkie. Conway i in. (2017) nazywają diagramy Venna i Eulera popularnym, ale nieadekwatnym sposobem pokazywania liczebności przecięć. Do trzech zbiorów diagram Venna jest jeszcze czytelny; od czterech lepszy jest UpSet. Tego rysunku nie zamieszczaj w pracy – służy tu tylko do porównania.
Kod obu rysunków znajdziesz w sekcji Wykres UpSet w R. Ten sam typ rysunku narysowany w samym ggplot2, z tabelą APA dla pytania wielokrotnego wyboru, pokazuje wpis tabela i wykres pytania wielokrotnego wyboru, a wzorce brakujących odpowiedzi – wpis braki danych na wykresie.
Jak opisać w pracy
Na co uważać
- Kombinacja to nie para. Słupek „zmęczenie + koncentracja” to osoby z tymi dwoma objawami i żadnym innym. Jeśli pytasz o wszystkie osoby z oboma objawami, zsumuj słupki zawierające tę parę albo policz tabelę krzyżową.
- Ucinanie kombinacji. Napisz, ile kombinacji i osób pokazano.
- Odsetki odpowiedzi. Przy pytaniu wielokrotnego wyboru podaj, czy odsetki liczysz od osób, czy od zaznaczeń. Kodowanie i liczenie opisuje wpis pytania wielokrotnego wyboru – kodowanie i liczenie.
Wykres UpSet w R
Kod symuluje pięć objawów jako zmienne 0/1, liczy wielkości zbiorów i liczebności kombinacji, a potem rysuje wykres UpSet funkcją upset() z pakietu UpSetR i diagram Venna funkcją venn() z pakietu venn. Obie funkcje przyjmują ramkę danych z kolumnami 0/1. Rysunki na stronie powstały z tych samych wywołań, zapisanych do plików SVG.
Wielkości zbiorów, kombinacje i oba rysunki
R
# Wykres UpSet i diagram Venna dla pięciu objawów (te same dane)
suppressPackageStartupMessages({library(UpSetR); library(venn)})
set.seed(758)                                       # 300 osób po infekcji, 5 objawów (0/1)
n <- 300
nasilenie <- rnorm(n)                               # wspólny czynnik: objawy występują razem
prog <- c(0.3, 0.8, 1.0, 1.2, 1.6)                  # progi i ładunki ustawione ręcznie
ladunek <- c(1.0, 0.9, 0.6, 1.1, 0.7)
objawy <- as.data.frame(sapply(1:5, function(j) as.integer(ladunek[j] * nasilenie + rnorm(n) > prog[j])))
names(objawy) <- c("Zmęczenie", "Koncentracja", "Ból głowy", "Bezsenność", "Duszność")
colSums(objawy)                                     # wielkości zbiorów
kombinacja <- apply(objawy, 1, function(x) paste(names(objawy)[x == 1], collapse = " + "))
kombinacja[kombinacja == ""] <- "(brak objawów)"
tab <- sort(table(kombinacja), decreasing = TRUE)
length(tab)                                         # ile z 32 możliwych kombinacji wystąpiło
head(tab, 8)
z_objawem <- tab[names(tab) != "(brak objawów)"]
c(osoby_z_objawem = sum(z_objawem), w_15_najczestszych = sum(head(z_objawem, 15)))
# Rysunek 1: UpSet – słupki = liczba osób z dokładnie tą kombinacją objawów
p1 <- upset(objawy, sets = rev(names(objawy)), keep.order = TRUE, order.by = "freq", nintersects = 15,
            mainbar.y.label = "Liczba osób z daną kombinacją", sets.x.label = "Liczba osób z objawem",
            main.bar.color = "#0072B2", sets.bar.color = "#E69F00", matrix.color = "#0072B2",
            point.size = 3, line.size = 0.8, text.scale = 1.4)
p1
# Rysunek 2: diagram Venna tych samych pięciu zbiorów (32 obszary z liczebnościami)
venn(objawy, ilabels = "counts", zcolor = c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#0072B2"),
     opacity = 0.25, box = FALSE, ilcs = 0.9, sncs = 1.1)
Wynik w R
   Zmęczenie Koncentracja    Ból głowy   Bezsenność     Duszność
         136           98           64           58           33
[1] 27
kombinacja
                       (brak objawów)                             Zmęczenie
                                  111                                    34
             Zmęczenie + Koncentracja                             Ból głowy
                                   23                                    16
                         Koncentracja  Zmęczenie + Koncentracja + Ból głowy
                                   16                                    13
Zmęczenie + Koncentracja + Bezsenność                 Zmęczenie + Ból głowy
                                   12                                    11
   osoby_z_objawem w_15_najczestszych
               189                171
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety UpSetR i venn). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- UpSetR (wersja 1.4.1): Conway, J. R., Lex, A., & Gehlenborg, N. (2017). UpSetR: An R package for the visualization of intersecting sets and their properties. Bioinformatics, 33(18), 2938–2940. https://doi.org/10.1093/bioinformatics/btx364
- venn (wersja 1.13): Dusa, A. (2026). venn: Draw Venn diagrams [R package]. https://doi.org/10.32614/CRAN.package.venn
Najczęstsze pytania
Kiedy wykres UpSet jest lepszy od diagramu Venna?
Gdy zbiorów jest cztery lub więcej. Przy pięciu zbiorach diagram Venna ma 32 obszary, których wielkość nie odpowiada liczebnościom. UpSet pokazuje każdą kombinację jako słupek na wspólnej osi, więc łatwo je porównać i posortować.
Czy słupki na wykresie UpSet sumują się do liczby osób?
Słupki kombinacji tak, bo każda osoba należy do jednej kombinacji – sumują się do liczby osób z co najmniej jedną cechą, jeśli pokazano wszystkie kombinacje. Słupki wielkości zbiorów się nie sumują, bo jedna osoba może być w kilku zbiorach.
Jak pokazać na wykresie UpSet osoby bez żadnej cechy?
W pakiecie UpSetR pustą kombinację włącza argument empty.intersections = "on". Częściej podaje się jednak liczbę takich osób w podpisie rysunku, bo zwykle dominuje ona nad pozostałymi słupkami – w przykładzie to 111 z 300 osób.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Pytanie wielokrotnego wyboru: tabela i wykres APA
Tabela APA z % osób i 95% CI, porównanie grup, poziome słupki, punkty dla grup, macierz współwystępowania i wykres kombinacji – z kodem R.
Czytaj →PoradnikPytania wielokrotnego wyboru – kodowanie i liczenie
Eksport z Google Forms i LimeSurvey, zmienne 0/1, mianownik, % osób z przedziałem Wilsona i liczenie w R, Excelu, SPSS, jamovi i SZTOS.
Czytaj →PoradnikBraki danych na wykresie
Mapa braków, wzorce UpSet, braki na wykresie rozrzutu i w grupach oraz schodek porzucenia ankiety w R – z podpisami do pracy i zdaniami do Wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Conway, J. R., Lex, A., & Gehlenborg, N. (2017). UpSetR: An R package for the visualization of intersecting sets and their properties. Bioinformatics, 33(18), 2938–2940. https://doi.org/10.1093/bioinformatics/btx364 ● Otwarty dostęp
- Lex, A., Gehlenborg, N., Strobelt, H., Vuillemot, R., & Pfister, H. (2014). UpSet: Visualization of intersecting sets. IEEE Transactions on Visualization and Computer Graphics, 20(12), 1983–1992. https://doi.org/10.1109/tvcg.2014.2346248 ● Otwarty dostęp
Cytowania BibTeX
@article{conway2017upsetr, author={Conway, Jake R. and Lex, Alexander and Gehlenborg, Nils}, title={{UpSetR: An R package for the visualization of intersecting sets and their properties}}, journal={Bioinformatics}, year={2017}, volume={33}, number={18}, pages={2938--2940}, doi={10.1093/bioinformatics/btx364}}@article{lex2014upset, author={Lex, Alexander and Gehlenborg, Nils and Strobelt, Hendrik and Vuillemot, Romain and Pfister, Hanspeter}, title={{UpSet: Visualization of intersecting sets}}, journal={IEEE Transactions on Visualization and Computer Graphics}, year={2014}, volume={20}, number={12}, pages={1983--1992}, doi={10.1109/tvcg.2014.2346248}}