Przykład: które funkcje dodać do aplikacji banku?
Fikcyjny bank planuje nową wersję aplikacji mobilnej, a budżet wystarczy na kilka funkcji. Zespół produktu pyta: bez czego klienci odejdą, za co nas polubią, a co jest im obojętne? Pytanie o ważność na skali Likerta tego nie rozdzieli – prawie wszystko dostaje 4 lub 5.
Model Kano pyta o każdą funkcję dwa razy: co czujesz, gdy aplikacja ją ma, i gdy jej nie ma. Bank zebrał takie pary odpowiedzi od 400 klientów (130 w wieku 18–34 lat i 270 w wieku 35+, średnio 40.8 roku) dla dziesięciu funkcji – od powiadomień o transakcjach po oferty kredytów wysyłane w powiadomieniach.
Dane są fikcyjne i wiemy, jakie kategorie w nich ukryliśmy. Udziały prawdziwych kategorii ustaliliśmy ręcznie (np. asystent głosowy: 38% „atrakcyjna”, 40% „obojętna”); tylko wyzwania oszczędnościowe różnią się między grupami wieku, a 8% par to losowe kliknięcia. Wszystkie parametry są w przepisie 2 kodu, a ziarno 622 ustalono raz i nie zmieniano go. Dane pobierzesz jako model-kano-ankieta-aplikacji-bankowej.csv. Kolumny *_f i *_d to odpowiedzi funkcjonalne i dysfunkcjonalne (1 = „Lubię to”, 5 = „Nie lubię tego”).
Rysunek 1: pięć typów cech
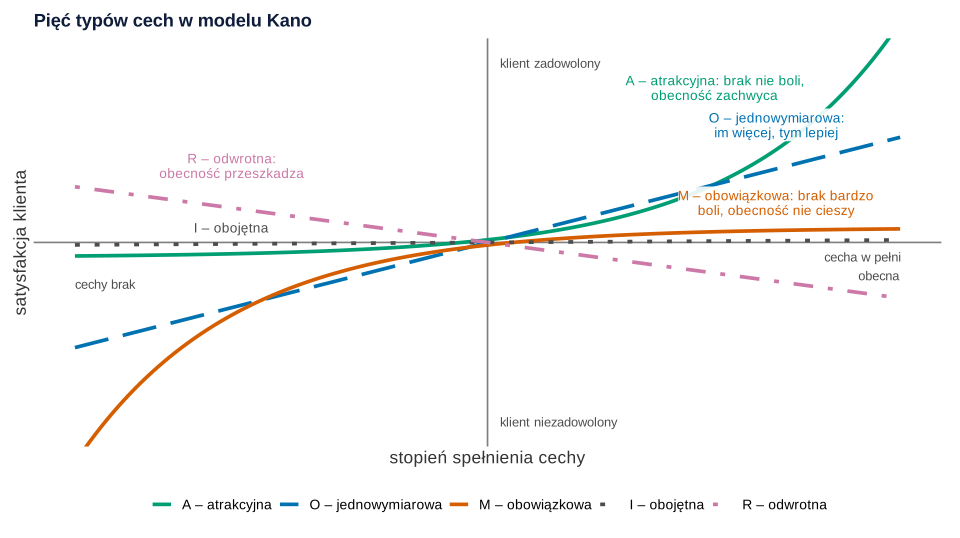
Co widać. Według modelu Kano satysfakcja nie rośnie z każdą cechą tak samo (Matzler i in., 1996). Cechy obowiązkowe (M, must-be) są oczywiste: ich brak bardzo irytuje, a obecność nie cieszy. Cechy jednowymiarowe (O, one-dimensional) działają liniowo: im lepiej, tym większe zadowolenie. Cechy atrakcyjne (A, attractive) zachwycają, choć klient ich nie oczekuje – ich brak nie przeszkadza. Cechy obojętne (I, indifferent) nie zmieniają nic, a odwrotne (R, reverse) przeszkadzają, gdy są. Szósta kategoria, wątpliwa (Q, questionable), to sprzeczne odpowiedzi – np. „lubię, gdy jest” i „lubię, gdy jej nie ma”.
Jak może zmylić. To schemat, a nie dane – kwestionariusz Kano przypisuje tylko kategorię, kształtu krzywych nie mierzy. Model wyjaśnia rolę cech dla klientów (Witell i in., 2013), ale ta rola się zmienia: dzisiejsza cecha atrakcyjna za kilka lat może być oczywista.
Podpis do pracy:
Rysunek 2: tabela oceny – z dwóch odpowiedzi jedna kategoria
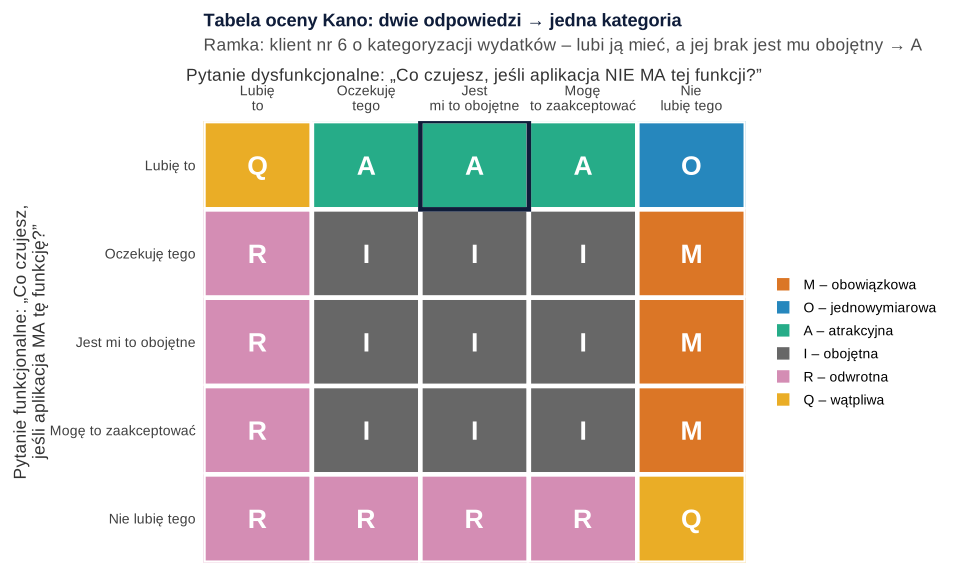
Co widać. Każda funkcja ma dwa pytania z tymi samymi pięcioma odpowiedziami: pytanie funkcjonalne („Co czujesz, jeśli aplikacja MA tę funkcję?”) i dysfunkcjonalne („…NIE MA tej funkcji?”). Tabela oceny zamienia parę odpowiedzi w literę. Klient nr 6 o kategoryzacji wydatków odpowiedział „Lubię to” i „Jest mi to obojętne”. To komórka A: cieszy, gdy jest, a jej brak nie boli. Kategorie to zmienna nominalna – liczymy je, nie uśredniamy.
Jak może zmylić. Dziewięć z 25 komórek to I, więc niezdecydowany klient najczęściej trafia do kategorii obojętnej. Według Mikulicia i Prebežaca (2011) kwestionariusz Kano (obok klasyfikacji bezpośredniej) jako jedyna z porównanych metod klasyfikuje cechy jeszcze przed wprowadzeniem produktu. Nie zamieniaj więc pytania dysfunkcjonalnego na „Jak ważna jest funkcja?”.
Podpis do pracy:
Rysunek 3: rozkład kategorii dla każdej funkcji
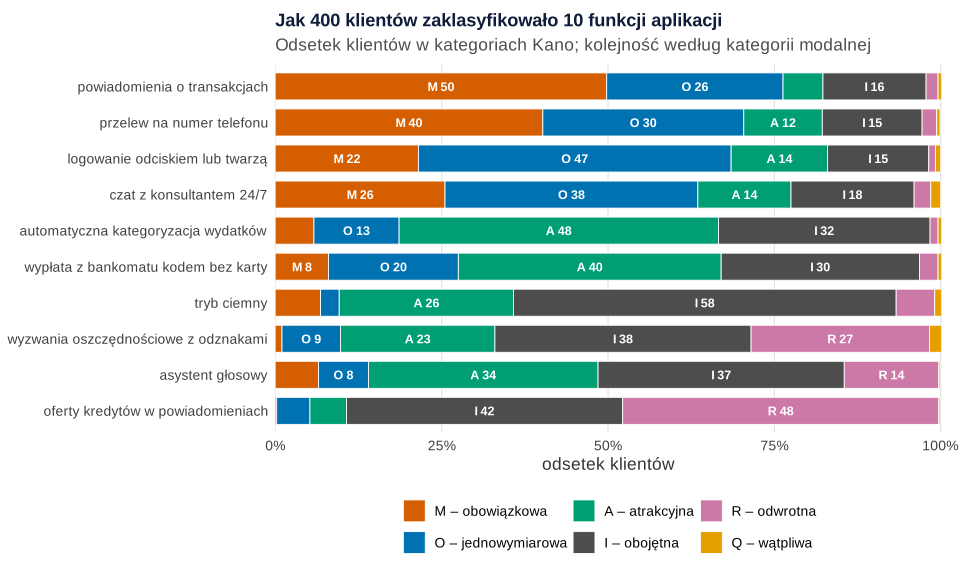
set.seed(622)).Co widać. Funkcji przypisuje się kategorię najczęstszą, czyli dominantę. Powiadomienia o transakcjach są obowiązkowe (M 49.8%), podobnie przelew na numer telefonu (M 40.2%). Logowanie odciskiem lub twarzą (O 47.0%) i czat z konsultantem (O 38.0%) są jednowymiarowe. Atrakcyjne są kategoryzacja wydatków (A 48.0%) i wypłata z bankomatu kodem (A 39.5%). Tryb ciemny jest obojętny (I 57.5%), a oferty kredytów w powiadomieniach – odwrotne (R 47.5%). Odpowiedzi wątpliwych było 0.8%, a dwie lub więcej miały tylko 2 osoby z 400.
Jak może zmylić. Dominanta ukrywa resztę słupka. Przy asystencie głosowym I (37.0%) wygrywa z A (34.5%) o 2.5 punktu procentowego, czyli o 10 osób. Wyzwania oszczędnościowe mają aż trzy duże kategorie: I 38.5%, R 26.8% i A 23.2%. Klienci są podzieleni (rysunek 6). Podawaj zawsze cały rozkład, a nie samą literę.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: współczynniki satysfakcji i niezadowolenia
Do rankingu służą dwa współczynniki: satysfakcji (SI) i niezadowolenia (DI). Mkpojiogu i Hashim (2016) pokazali, że oba wiążą się z deklarowaną ważnością wymagań:
Słowami: SI to udział klientów, których obecność funkcji ucieszy. |DI| to udział tych, których jej brak rozczaruje. Odpowiedzi R i Q pomija się w mianowniku.
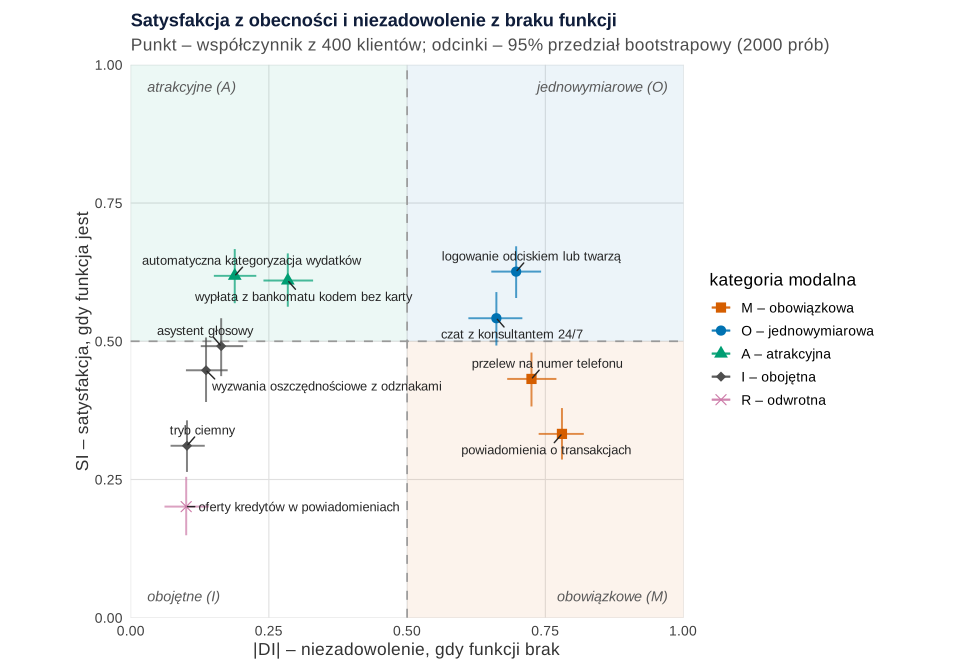
set.seed(622)).Co widać. Na wykresie rozrzutu funkcje układają się w cztery ćwiartki. Brak powiadomień rozczaruje czterech klientów na pięciu (|DI| = .78, 95% CI [.74, .82]), a ich obecność ucieszy jednego na trzech (SI = .33). Kategoryzacja wydatków ma odwrotny profil: SI = .62 [.57, .67], |DI| = .19 [.15, .23]. Przedziały dał bootstrap: 2000 razy losowaliśmy 400 klientów ze zwracaniem i liczyliśmy oba współczynniki (Efron, 1979). Mają szerokość około 0.1, więc bliskich punktów nie da się uporządkować.
Jak może zmylić. Ćwiartki to nie kategorie, a granica .5 jest umowna – asystent głosowy (SI = .49 [.44, .54]) leży na niej. Wykres przypomina macierz ważność–ocena z wpisu o kluczowych czynnikach satysfakcji i mapę IPMA, ale tam ważność pochodzi z regresji ocen obecnego produktu, a tu – z deklarowanych reakcji na obecność lub brak funkcji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: jak pewna jest kategoria?
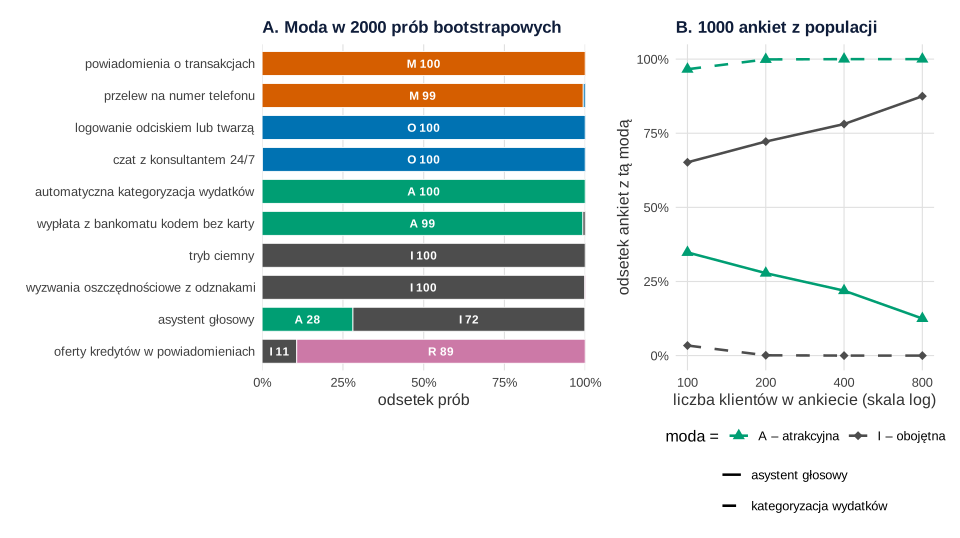
set.seed(622)).Co widać. Panel A: osiem funkcji zachowało kategorię w co najmniej 99.3% z 2000 prób bootstrapowych. Asystent głosowy był obojętny w 71.8% prób, a atrakcyjny w 28.1%; oferty kredytów – odwrotne w 89.3%. Ten sam obraz daje przedział ufności dla proporcji metodą Wilsona (Brown i in., 2001): dla asystenta A = 34.5%, 95% CI [30.0, 39.3], a I = 37.0%, 95% CI [32.4, 41.8]. Różnica I − A (2.5 punktu) ma 95% przedział bootstrapowy [−5.5, 10.7] – obejmuje zero.
Panel B – 1000 ankiet. Znamy rozkład odpowiedzi w całej populacji: dla asystenta to 35.9% A i 39.7% I, więc prawdziwa dominanta to I. W 1000 ankietach po 100 osób I wygrywa w 65.2% przypadków, po 400 – w 78.1%. Nawet przy 800 osobach co ósma ankieta (12.5%) ogłosi asystenta atrakcyjnym (błąd Monte Carlo do 1.5 punktu). Kategoryzacja wydatków, z wyraźną przewagą A, przy 200 osobach wychodzi atrakcyjna w 99.9% ankiet. Ile osób zaplanować, opisuje hasło liczebność próby w ankiecie.
Jak może zmylić. Stabilna moda nie znaczy, że kategoria pasuje do każdego klienta – połowa może myśleć inaczej. Przy remisie napisz, że funkcja leży na granicy dwóch kategorii, i podaj oba odsetki. Wielu modyfikacjom metody Kano brakuje rygorystycznego uzasadnienia (Löfgren i Witell, 2008), więc zamiast własnej reguły rozstrzygania remisów pokaż niepewność.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: segmenty – ta sama funkcja, inna kategoria
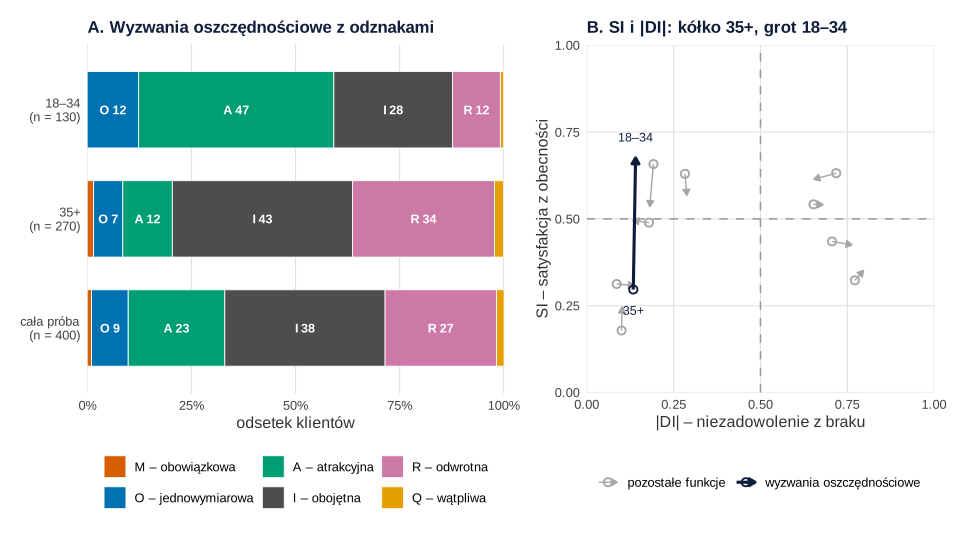
set.seed(622)).Co widać. W całej próbie wyzwania oszczędnościowe wyglądają na obojętne (I 38.5%), ale to średnia z dwóch różnych grup. Wśród klientów 18–34 lat dominuje A (46.9%), a wśród klientów 35+ – I (43.3%) i R (34.1%). Rozkład kategorii zależy od grupy wieku: test χ² niezależności (p z 10 000 symulacji – małe liczebności w części komórek) dał χ² = 73.89, p < .001, V Craméra = .43. W panelu B SI wyzwań wynosi .68 u młodszych i .30 u starszych. Pozostałe funkcje mają w obu grupach tę samą dominantę.
Jak może zmylić. Funkcja „obojętna” w całej próbie może być atrakcyjna dla jednych i odwrotna dla innych. Zanim ją skreślisz, sprawdź segmenty, które mają sens biznesowy (wiek, staż klienta). Segmenty można też wyznaczyć z danych, np. analizą klas latentnych. Nie przeglądaj jednak dziesiątek podziałów – to problem wielokrotnych porównań.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Najpierw cechy obowiązkowe. Powiadomienia i przelew na numer telefonu muszą działać bez zarzutu; nie reklamuj ich jako nowości.
- Cechy jednowymiarowe ulepszaj stale. Szybsze logowanie i krótszy czas odpowiedzi czatu to więcej zadowolenia.
- Cechy atrakcyjne to wyróżnik w komunikacji. Kategoryzację wydatków i wypłatę kodem pokaż w kampanii, a jej skuteczność sprawdź w teście A/B.
- Funkcje odwrotne usuń lub daj wybór. Oferty kredytów w powiadomieniach – tylko za zgodą klienta.
- Funkcje podzielone kieruj do segmentu – wyzwania oszczędnościowe jako opcja dla młodszych.
- Remis (asystent głosowy) to nie decyzja. Sprawdź funkcję w badaniu pilotażowym z prototypem.
Ile klient zapłaci za funkcję, pokaże conjoint wyborczy; zestaw funkcji, który ucieszy najwięcej osób, wskaże analiza TURF, a ranking preferencji – MaxDiff.
Pułapki
- Tylko pytanie funkcjonalne. Bez pytania o brak funkcji nie odróżnisz cech M, O i A.
- Funkcja opisana zbyt ogólnie („lepsza obsługa”) – każdy zrozumie ją inaczej.
- Przypisanie przez dominantę przy remisie – kategoria zmienia się z próby na próbę (rysunek 5).
- Pominięte segmenty – funkcja „obojętna” może łączyć zachwyconych i zirytowanych (rysunek 6).
- Odpowiedzi wątpliwe zostawione bez sprawdzenia. Kilka Q u jednej osoby sygnalizuje nieuważne wypełnianie (zob. czyszczenie danych z ankiety online).
- Deklaracje zamiast zachowania. Kategorie to hipotezy do sprawdzenia, a nie prognoza sprzedaży.
- Ranking według samego SI – spycha na dół cechy obowiązkowe, których brak kosztuje najwięcej.
Jak opisać w pracy
W Wynikach podaj pełny rozkład kategorii, SI i DI z przedziałami oraz funkcje na granicy kategorii. Inne analizy opisuje wpis statystyka w pracy z marketingu.
| Funkcja | M | O | A | I | R | Q | Kategoria | SI [95% CI] | DI [95% CI] |
|---|---|---|---|---|---|---|---|---|---|
| Powiadomienia o transakcjach | 49.8 | 26.5 | 6.0 | 15.5 | 1.8 | 0.5 | M | .33 [.29, .38] | −.78 [−.82, −.74] |
| Logowanie odciskiem lub twarzą | 21.5 | 47.0 | 14.5 | 15.2 | 1.0 | 0.8 | O | .63 [.58, .67] | −.70 [−.74, −.65] |
| Przelew na numer telefonu | 40.2 | 30.2 | 11.8 | 15.0 | 2.2 | 0.5 | M | .43 [.38, .48] | −.72 [−.77, −.68] |
| Czat z konsultantem 24/7 | 25.5 | 38.0 | 14.0 | 18.5 | 2.5 | 1.5 | O | .54 [.49, .59] | −.66 [−.71, −.61] |
| Automatyczna kategoryzacja wydatków | 5.8 | 12.8 | 48.0 | 31.8 | 1.2 | 0.5 | A | .62 [.57, .67] | −.19 [−.23, −.15] |
| Wypłata z bankomatu kodem bez karty | 8.0 | 19.5 | 39.5 | 29.8 | 2.8 | 0.5 | A | .61 [.56, .66] | −.28 [−.33, −.24] |
| Tryb ciemny | 6.8 | 2.8 | 26.2 | 57.5 | 5.8 | 1.0 | I | .31 [.26, .36] | −.10 [−.13, −.07] |
| Asystent głosowy | 6.5 | 7.5 | 34.5 | 37.0 | 14.2 | 0.2 | I | .49 [.44, .54] | −.16 [−.20, −.13] |
| Wyzwania oszczędnościowe z odznakami | 1.0 | 8.8 | 23.2 | 38.5 | 26.8 | 1.8 | I | .45 [.39, .51] | −.14 [−.18, −.10] |
| Oferty kredytów w powiadomieniach | 0.2 | 5.0 | 5.5 | 41.5 | 47.5 | 0.2 | R | .20 [.15, .25] | −.10 [−.14, −.06] |
Podpis tabeli:
Do Metody:
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę i motyw, przepis 2 – dane, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Przepisy, które losują (2, 4, 5 i 6), mają własne set.seed(622) przed każdym losowaniem. Ziarno 622 ustalono raz i nie zmieniano go. Ręcznie ustalono: 400 klientów, wiek z rozkładu normalnego (średnia 40, odchylenie 13, zakres 18–75) i podział na grupy 18–34 oraz 35+, udziały prawdziwych kategorii M, O, A, I, R dla każdej funkcji (macierze p_mlodsi i p_starsi; różnią się tylko wyzwaniami oszczędnościowymi), typowe pary odpowiedzi dla każdej kategorii (funkcja losuj_pare()), 8% par odpowiedzi losowych, 2000 prób bootstrapowych, 1000 symulowanych ankiet po 100, 200, 400 i 800 osób oraz 10 000 symulacji w teście χ². Cały kod liczy się w kilka sekund.
1. Paleta, motyw i krzywe Kano: Rysunek 1
R
# Rysunek 1. Krzywe Kano – schemat pięciu typów cech (grafika, bez danych)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) – jeden kolor na kategorię Kano
kol_kat <- c(M = "#D55E00", O = "#0072B2", A = "#009E73", I = "#4D4D4D", R = "#CC79A7", Q = "#E69F00")
nazwy_kat <- c(M = "M – obowiązkowa", O = "O – jednowymiarowa", A = "A – atrakcyjna",
               I = "I – obojętna", R = "R – odwrotna", Q = "Q – wątpliwa")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Oś x: stopień spełnienia cechy (−1 = brak, 1 = w pełni); oś y: satysfakcja klienta
x <- seq(-1, 1, length.out = 201)
krzywe <- rbind(
  data.frame(kat = "O", x = x, y = 0.85 * x),                       # proporcjonalnie
  data.frame(kat = "M", x = x, y = -exp(-2.6 * (x + 1)) * 1.9 + 0.12), # brak boli, obecność nie cieszy
  data.frame(kat = "A", x = x, y = exp(2.6 * (x - 1)) * 1.9 - 0.12),   # brak nie boli, obecność zachwyca
  data.frame(kat = "I", x = x, y = 0.02 * x),                         # bez znaczenia
  data.frame(kat = "R", x = x, y = -0.45 * x))                        # obecność przeszkadza
krzywe$kat <- factor(krzywe$kat, levels = c("A", "O", "M", "I", "R"))
etykiety <- data.frame(kat = factor(c("A", "O", "M", "I", "R"), levels = levels(krzywe$kat)),
  x = c(0.55, 0.70, 0.70, -0.62, -0.62), y = c(1.25, 0.95, 0.32, 0.12, 0.62),
  tekst = c("A – atrakcyjna: brak nie boli,\nobecność zachwyca", "O – jednowymiarowa:\nim więcej, tym lepiej",
            "M – obowiązkowa: brak bardzo\nboli, obecność nie cieszy", "I – obojętna", "R – odwrotna:\nobecność przeszkadza"))
p1 <- ggplot(krzywe, aes(x, y, colour = kat, linetype = kat)) +
  geom_hline(yintercept = 0, colour = "grey50") + geom_vline(xintercept = 0, colour = "grey50") +
  geom_line(linewidth = 1.3) +
  geom_label(data = etykiety, aes(label = tekst), size = 3.6, hjust = 0.5, lineheight = 0.9,
             linewidth = 0, fill = "white", alpha = 0.9, show.legend = FALSE) +
  annotate("text", x = 1, y = -0.08, label = "cecha w pełni\nobecna", hjust = 1, vjust = 1, size = 3.4, colour = "grey30") +
  annotate("text", x = -1, y = -0.3, label = "cechy brak", hjust = 0, vjust = 1, size = 3.4, colour = "grey30") +
  annotate("text", x = 0.03, y = 1.45, label = "klient zadowolony", hjust = 0, size = 3.4, colour = "grey30") +
  annotate("text", x = 0.03, y = -1.45, label = "klient niezadowolony", hjust = 0, size = 3.4, colour = "grey30") +
  scale_colour_manual(values = kol_kat, labels = nazwy_kat, name = NULL) +
  scale_linetype_manual(values = c(A = "solid", O = "longdash", M = "solid", I = "dotted", R = "dotdash"),
                        labels = nazwy_kat, name = NULL) +
  scale_x_continuous(breaks = NULL) + scale_y_continuous(breaks = NULL) +
  coord_cartesian(xlim = c(-1, 1), ylim = c(-1.5, 1.5)) +
  labs(title = "Pięć typów cech w modelu Kano", x = "stopień spełnienia cechy", y = "satysfakcja klienta") +
  motyw + theme(panel.grid.major = element_blank())
p1
# ggsave("kano-krzywe-schemat.svg", p1, width = 10, height = 5.6)
2. Tabela oceny, dane i Rysunek 2
R
# Rysunek 2. Tabela oceny Kano i dane z ankiety (dane fikcyjne, symulowane)
library(ggplot2)

# Pięć odpowiedzi – takie same w pytaniu funkcjonalnym i dysfunkcjonalnym
odpowiedzi <- c("Lubię to", "Oczekuję tego", "Jest mi to obojętne", "Mogę to zaakceptować", "Nie lubię tego")
# Tabela oceny Kano: wiersz = odpowiedź funkcjonalna (funkcja JEST), kolumna = dysfunkcjonalna (funkcji NIE MA)
tabela_kano <- matrix(c("Q", "A", "A", "A", "O",
                        "R", "I", "I", "I", "M",
                        "R", "I", "I", "I", "M",
                        "R", "I", "I", "I", "M",
                        "R", "R", "R", "R", "Q"), nrow = 5, byrow = TRUE, dimnames = list(odpowiedzi, odpowiedzi))
kat6 <- c("M", "O", "A", "I", "R", "Q")             # kolejność kategorii w tabelach i legendach
kategoria_kano <- function(f, d) tabela_kano[cbind(f, d)]   # f, d = numery odpowiedzi 1–5

# Fikcyjny bank: ankieta w aplikacji mobilnej, 400 klientów, 10 funkcji (planowanych lub istniejących)
cechy <- c(powiadomienia = "powiadomienia o transakcjach", biometria = "logowanie odciskiem lub twarzą",
           telefon = "przelew na numer telefonu", czat = "czat z konsultantem 24/7",
           kategorie = "automatyczna kategoryzacja wydatków", bankomat = "wypłata z bankomatu kodem bez karty",
           ciemny = "tryb ciemny", asystent = "asystent głosowy",
           wyzwania = "wyzwania oszczędnościowe z odznakami", oferty = "oferty kredytów w powiadomieniach")
kat <- c("M", "O", "A", "I", "R")
# Prawdziwe udziały kategorii (M, O, A, I, R) w populacji – ustalone ręcznie
p_mlodsi <- rbind(powiadomienia = c(.55, .25, .05, .15, 0), biometria = c(.25, .45, .15, .15, 0),
                  telefon = c(.40, .35, .10, .15, 0), czat = c(.30, .40, .15, .15, 0),
                  kategorie = c(.05, .15, .50, .30, 0), bankomat = c(.10, .20, .40, .30, 0),
                  ciemny = c(.05, .05, .25, .60, .05), asystent = c(.05, .07, .38, .40, .10),
                  wyzwania = c(0, .10, .50, .30, .10), oferty = c(0, .05, .05, .40, .50))
p_starsi <- p_mlodsi
p_starsi["wyzwania", ] <- c(0, .05, .10, .45, .40)   # jedyna cecha, która różni grupy wieku
colnames(p_mlodsi) <- colnames(p_starsi) <- kat

# Para odpowiedzi (funkcjonalna, dysfunkcjonalna) typowa dla prawdziwej kategorii
losuj_pare <- function(k) switch(k,
  A = c(1, sample(2:4, 1, prob = c(.1, .6, .3))),
  O = c(1, 5),
  M = c(sample(2:4, 1, prob = c(.5, .3, .2)), 5),
  I = sample(list(c(3, 3), c(2, 3), c(3, 4), c(4, 4), c(2, 2)), 1, prob = c(.4, .15, .2, .15, .1))[[1]],
  R = sample(list(c(5, 1), c(5, 3), c(3, 1), c(4, 1)), 1, prob = c(.4, .2, .2, .2))[[1]])

set.seed(622)                                      # ziarno ustalone raz, bez dobierania pod wynik
N <- 400
wiek <- pmin(pmax(round(rnorm(N, 40, 13)), 18), 75)
grupa <- ifelse(wiek < 35, "18–34", "35+")
p_nieuwaga <- 0.08                                 # 8% par odpowiedzi losowych (nieuważne klikanie)
f <- d <- prawdziwa <- matrix(NA, N, length(cechy), dimnames = list(NULL, names(cechy)))
for (j in names(cechy)) for (i in 1:N) {
  pr <- if (grupa[i] == "18–34") p_mlodsi[j, ] else p_starsi[j, ]
  prawdziwa[i, j] <- sample(kat, 1, prob = pr)
  para <- if (runif(1) < p_nieuwaga) sample(1:5, 2, replace = TRUE) else losuj_pare(prawdziwa[i, j])
  f[i, j] <- para[1]; d[i, j] <- para[2]
}
kano <- matrix(kategoria_kano(as.vector(f), as.vector(d)), N, dimnames = dimnames(f))
dane <- data.frame(id = 1:N, wiek, grupa, setNames(as.data.frame(f), paste0(names(cechy), "_f")),
                   setNames(as.data.frame(d), paste0(names(cechy), "_d")))
write.csv(dane, "model-kano-ankieta-aplikacji-bankowej.csv", row.names = FALSE)
table(grupa)
c(sredni_wiek = round(mean(wiek), 1))
# Przykład: pierwszy klient z odpowiedziami „Lubię to” / „Jest mi to obojętne” przy kategoryzacji wydatków
k1 <- which(f[, "kategorie"] == 1 & d[, "kategorie"] == 3)[1]
c(klient = k1, funkcjonalna = odpowiedzi[f[k1, "kategorie"]], dysfunkcjonalna = odpowiedzi[d[k1, "kategorie"]],
  kategoria = kano[k1, "kategorie"])

# Rysunek: tabela oceny jako diagram, z zaznaczoną odpowiedzią klienta k1
siatka <- expand.grid(f = 1:5, d = 1:5)
siatka$kat <- tabela_kano[cbind(siatka$f, siatka$d)]
p2 <- ggplot(siatka, aes(d, f)) +
  geom_tile(aes(fill = kat), colour = "white", linewidth = 1.6, alpha = 0.85) +
  geom_text(aes(label = kat), size = 7, fontface = "bold", colour = "white") +
  annotate("rect", xmin = 2.5, xmax = 3.5, ymin = 0.5, ymax = 1.5,
           fill = NA, colour = "#0f1d3a", linewidth = 1.6) +
  scale_fill_manual(values = kol_kat, labels = nazwy_kat, name = NULL, breaks = kat6) +
  scale_x_continuous(breaks = 1:5, labels = sub(" ", "\n", odpowiedzi), position = "top", expand = c(0, 0)) +
  scale_y_reverse(breaks = 1:5, labels = odpowiedzi, expand = c(0, 0)) +
  labs(title = "Tabela oceny Kano: dwie odpowiedzi → jedna kategoria",
       subtitle = paste0("Ramka: klient nr ", k1, " o kategoryzacji wydatków – lubi ją mieć, a jej brak jest mu obojętny → A"),
       x = "Pytanie dysfunkcjonalne: „Co czujesz, jeśli aplikacja NIE MA tej funkcji?”",
       y = "Pytanie funkcjonalne: „Co czujesz,\njeśli aplikacja MA tę funkcję?”") +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_text(size = 10.5),
                legend.position = "right") +
  guides(fill = guide_legend(ncol = 1))
p2
# ggsave("kano-tabela-oceny.svg", p2, width = 10, height = 6)
Wynik w R
grupa
18–34   35+
  130   270
sredni_wiek
       40.8
               klient          funkcjonalna       dysfunkcjonalna
                  "6"            "Lubię to" "Jest mi to obojętne"
  kategoria.kategorie
                  "A"
3. Rozkład kategorii: Rysunek 3
R
# Rysunek 3. Rozkład kategorii Kano dla każdej funkcji (korzysta z obiektów z przepisów 1–2)
library(ggplot2)

liczby <- t(sapply(names(cechy), function(j) table(factor(kano[, j], levels = kat6))))
odsetki <- round(100 * liczby / N, 1)
moda <- apply(liczby, 1, function(x) kat6[which.max(x)])
# Różnica między dwiema najczęstszymi kategoriami (w punktach procentowych)
przewaga <- apply(odsetki, 1, function(x) { s <- sort(x, decreasing = TRUE); s[1] - s[2] })
druga <- apply(liczby, 1, function(x) kat6[order(-x)[2]])
wynik3 <- data.frame(odsetki, moda, druga, przewaga_pp = przewaga)
wynik3
# Respondenci z co najmniej dwiema odpowiedziami wątpliwymi (Q) – kandydaci do sprawdzenia
q_na_osobe <- rowSums(kano == "Q")
table(q_na_osobe)
c(odsetek_Q_wszystkie = round(100 * mean(kano == "Q"), 1), osoby_z_2_Q = sum(q_na_osobe >= 2))

# Kolejność na wykresie: według kategorii modalnej, w jej obrębie według jej udziału
kol_kolejnosc <- order(match(moda, c("M", "O", "A", "I", "R")), -apply(odsetki, 1, max))
dl <- data.frame(cecha = rep(rownames(odsetki), times = 6), kat = rep(kat6, each = nrow(odsetki)),
                 proc = as.vector(odsetki))
dl$cecha <- factor(cechy[dl$cecha], levels = rev(cechy[rownames(odsetki)[kol_kolejnosc]]))
dl$kat <- factor(dl$kat, levels = rev(kat6))
p3 <- ggplot(dl, aes(proc, cecha, fill = kat)) +
  geom_col(width = 0.75, colour = "white", linewidth = 0.3) +
  geom_text(aes(label = ifelse(proc >= 7, paste0(kat, " ", round(proc)), "")),
            position = position_stack(vjust = 0.5), size = 3.3, colour = "white", fontface = "bold") +
  scale_fill_manual(values = kol_kat, labels = nazwy_kat, name = NULL, breaks = kat6) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), expand = c(0, 0)) +
  labs(title = "Jak 400 klientów zaklasyfikowało 10 funkcji aplikacji",
       subtitle = "Odsetek klientów w kategoriach Kano; kolejność według kategorii modalnej",
       x = "odsetek klientów", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank()) + guides(fill = guide_legend(nrow = 2))
p3
# ggsave("kano-kategorie-funkcji.svg", p3, width = 10, height = 6)
Wynik w R
                 M    O    A    I    R   Q moda druga przewaga_pp
powiadomienia 49.8 26.5  6.0 15.5  1.8 0.5    M     O        23.3
biometria     21.5 47.0 14.5 15.2  1.0 0.8    O     M        25.5
telefon       40.2 30.2 11.8 15.0  2.2 0.5    M     O        10.0
czat          25.5 38.0 14.0 18.5  2.5 1.5    O     M        12.5
kategorie      5.8 12.8 48.0 31.8  1.2 0.5    A     I        16.2
bankomat       8.0 19.5 39.5 29.8  2.8 0.5    A     I         9.7
ciemny         6.8  2.8 26.2 57.5  5.8 1.0    I     A        31.3
asystent       6.5  7.5 34.5 37.0 14.2 0.2    I     A         2.5
wyzwania       1.0  8.8 23.2 38.5 26.8 1.8    I     R        11.7
oferty         0.2  5.0  5.5 41.5 47.5 0.2    R     I         6.0
q_na_osobe
  0   1   2
372  26   2
odsetek_Q_wszystkie         osoby_z_2_Q
                0.8                 2.0
4. Współczynniki SI i DI z bootstrapem: Rysunek 4
R
# Rysunek 4. Współczynniki satysfakcji (SI) i niezadowolenia (DI) z przedziałami bootstrapowymi
library(ggplot2)
library(ggrepel)

# SI = (A + O) / (A + O + M + I); DI = −(O + M) / (A + O + M + I); odpowiedzi R i Q pomijamy
wspolczynniki <- function(k) {           # k – macierz kategorii (osoby × funkcje)
  t(apply(k, 2, function(x) {
    n <- sum(x %in% c("A", "O", "M", "I"))
    c(SI = sum(x %in% c("A", "O")) / n, DI = -sum(x %in% c("O", "M")) / n)
  }))
}
w <- wspolczynniki(kano)
set.seed(622)                            # bootstrap: losowanie klientów ze zwracaniem
B <- 2000
boot <- replicate(B, wspolczynniki(kano[sample(N, N, replace = TRUE), ]))   # funkcje × 2 × B
ci <- function(v) quantile(v, c(.025, .975))
wynik4 <- data.frame(SI = w[, "SI"], SI_dol = apply(boot[, "SI", ], 1, ci)[1, ], SI_gor = apply(boot[, "SI", ], 1, ci)[2, ],
                     DI = w[, "DI"], DI_dol = apply(boot[, "DI", ], 1, ci)[1, ], DI_gor = apply(boot[, "DI", ], 1, ci)[2, ])
round(wynik4, 2)

wy <- data.frame(cecha = cechy[rownames(wynik4)], moda = moda[rownames(wynik4)],
                 x = -wynik4$DI, x_dol = -wynik4$DI_gor, x_gor = -wynik4$DI_dol,
                 y = wynik4$SI, y_dol = wynik4$SI_dol, y_gor = wynik4$SI_gor)
cwiartki <- data.frame(x = c(0.03, 0.97, 0.97, 0.03), y = c(0.97, 0.97, 0.03, 0.03), hjust = c(0, 1, 1, 0),
                       vjust = c(1, 1, 0, 0), tekst = c("atrakcyjne (A)", "jednowymiarowe (O)", "obowiązkowe (M)", "obojętne (I)"))
p4 <- ggplot(wy, aes(x, y)) +
  annotate("rect", xmin = 0, xmax = 0.5, ymin = 0.5, ymax = 1, fill = kol_kat[["A"]], alpha = 0.08) +
  annotate("rect", xmin = 0.5, xmax = 1, ymin = 0.5, ymax = 1, fill = kol_kat[["O"]], alpha = 0.08) +
  annotate("rect", xmin = 0.5, xmax = 1, ymin = 0, ymax = 0.5, fill = kol_kat[["M"]], alpha = 0.08) +
  geom_hline(yintercept = 0.5, colour = "grey60", linetype = "dashed") +
  geom_vline(xintercept = 0.5, colour = "grey60", linetype = "dashed") +
  geom_text(data = cwiartki, aes(label = tekst, hjust = hjust, vjust = vjust), size = 3.8, colour = "grey35", fontface = "italic") +
  geom_errorbar(aes(ymin = y_dol, ymax = y_gor, colour = moda), width = 0, linewidth = 0.7, alpha = 0.7) +
  geom_errorbar(aes(xmin = x_dol, xmax = x_gor, colour = moda), width = 0, linewidth = 0.7, alpha = 0.7, orientation = "y") +
  geom_point(aes(colour = moda, shape = moda), size = 3.2) +
  geom_text_repel(aes(label = cecha), size = 3.4, colour = "grey15", seed = 622, box.padding = 0.5,
                  min.segment.length = 0, max.overlaps = Inf) +
  scale_colour_manual(values = kol_kat, labels = nazwy_kat[1:5], name = "kategoria modalna", breaks = kat6[1:5]) +
  scale_shape_manual(values = c(M = 15, O = 16, A = 17, I = 18, R = 4), labels = nazwy_kat[1:5], name = "kategoria modalna", breaks = kat6[1:5]) +
  scale_x_continuous(limits = c(0, 1), expand = c(0, 0)) + scale_y_continuous(limits = c(0, 1), expand = c(0, 0)) +
  coord_equal() +
  labs(title = "Satysfakcja z obecności i niezadowolenie z braku funkcji",
       subtitle = "Punkt – współczynnik z 400 klientów; odcinki – 95% przedział bootstrapowy (2000 prób)",
       x = "|DI| – niezadowolenie, gdy funkcji brak", y = "SI – satysfakcja, gdy funkcja jest") +
  motyw + theme(legend.position = "right")
p4
# ggsave("kano-satysfakcja-niezadowolenie.svg", p4, width = 10, height = 7)
Wynik w R
                SI SI_dol SI_gor    DI DI_dol DI_gor
powiadomienia 0.33   0.29   0.38 -0.78  -0.82  -0.74
biometria     0.63   0.58   0.67 -0.70  -0.74  -0.65
telefon       0.43   0.38   0.48 -0.72  -0.77  -0.68
czat          0.54   0.49   0.59 -0.66  -0.71  -0.61
kategorie     0.62   0.57   0.67 -0.19  -0.23  -0.15
bankomat      0.61   0.56   0.66 -0.28  -0.33  -0.24
ciemny        0.31   0.26   0.36 -0.10  -0.13  -0.07
asystent      0.49   0.44   0.54 -0.16  -0.20  -0.13
wyzwania      0.45   0.39   0.51 -0.14  -0.18  -0.10
oferty        0.20   0.15   0.25 -0.10  -0.14  -0.06
5. Niepewność kategorii: Rysunek 5
R
# Rysunek 5. Jak pewna jest kategoria modalna? Bootstrap i 1000 powtórzonych ankiet
library(ggplot2)
library(patchwork)

# A. Bootstrap: w ilu z 2000 prób bootstrapowych każda kategoria jest modalna
set.seed(622)
B <- 2000
mody_boot <- replicate(B, {
  kb <- kano[sample(N, N, replace = TRUE), ]
  apply(kb, 2, function(x) { t <- table(factor(x, levels = kat6)); kat6[which.max(t)] })
})
pewnosc <- t(apply(mody_boot, 1, function(x) round(100 * table(factor(x, levels = kat6)) / B, 1)))
pewnosc
# Przedziały Wilsona dla dwóch najczęstszych kategorii asystenta głosowego i bootstrapowy przedział ich różnicy
wilson <- function(x, n) round(100 * prop.test(x, n, correct = FALSE)$conf.int, 1)
rbind(A = c(proc = odsetki["asystent", "A"], wilson(liczby["asystent", "A"], N)),
      I = c(proc = odsetki["asystent", "I"], wilson(liczby["asystent", "I"], N)))
set.seed(622)
roznica_AI <- replicate(B, { x <- kano[sample(N, N, replace = TRUE), "asystent"]; 100 * (mean(x == "I") - mean(x == "A")) })
round(c(roznica_pp = odsetki["asystent", "I"] - odsetki["asystent", "A"], quantile(roznica_AI, c(.025, .975))), 1)

# B. 1000 ankiet z tej samej populacji przy różnych n. Rozkład obserwowanych kategorii wynika wprost
# z mechanizmu danych: (1 − 8%) × prawdziwe udziały + 8% × udziały kategorii w losowej parze (z tabeli oceny).
u <- table(factor(as.vector(tabela_kano), levels = kat6)) / 25
p_mlody <- pnorm(34.5, 40, 13)                    # udział osób 18–34 w populacji z przepisu 2
pi_obs <- function(j) {
  pt <- p_mlody * p_mlodsi[j, ] + (1 - p_mlody) * p_starsi[j, ]
  (1 - p_nieuwaga) * c(pt, Q = 0)[kat6] + p_nieuwaga * as.vector(u)
}
round(100 * rbind(asystent = pi_obs("asystent"), kategorie = pi_obs("kategorie")), 1)
set.seed(622)
sym <- expand.grid(cecha = c("asystent", "kategorie"), n = c(100, 200, 400, 800), stringsAsFactors = FALSE)
sym <- do.call(rbind, lapply(seq_len(nrow(sym)), function(r) {
  m <- apply(rmultinom(1000, sym$n[r], pi_obs(sym$cecha[r])), 2, function(x) kat6[which.max(x)])
  data.frame(cecha = sym$cecha[r], n = sym$n[r], kat = c("A", "I"), proc = c(100 * mean(m == "A"), 100 * mean(m == "I")))
}))
sym$blad_mc <- round(sqrt(sym$proc * (100 - sym$proc) / 1000), 1)   # błąd Monte Carlo (pp)
sym

kol_kolej5 <- rev(cechy[rownames(odsetki)[kol_kolejnosc]])
d5 <- data.frame(cecha = factor(rep(cechy[rownames(pewnosc)], 6), levels = kol_kolej5),
                 kat = factor(rep(kat6, each = nrow(pewnosc)), levels = rev(kat6)), proc = as.vector(pewnosc))
p5a <- ggplot(d5, aes(proc, cecha, fill = kat)) +
  geom_col(width = 0.75, colour = "white", linewidth = 0.3) +
  geom_text(aes(label = ifelse(proc >= 9, paste0(kat, " ", round(proc)), "")), position = position_stack(vjust = 0.5),
            size = 3.1, colour = "white", fontface = "bold") +
  scale_fill_manual(values = kol_kat, labels = nazwy_kat, name = NULL, breaks = kat6, drop = FALSE) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), expand = c(0, 0)) +
  labs(title = "A. Moda w 2000 prób bootstrapowych", x = "odsetek prób", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank()) + guides(fill = "none")
sym$opis <- ifelse(sym$cecha == "asystent", "asystent głosowy", "kategoryzacja wydatków")
p5b <- ggplot(sym, aes(n, proc, colour = kat, shape = kat, linetype = opis)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.8) +
  scale_colour_manual(values = kol_kat[c("A", "I")], labels = nazwy_kat[c("A", "I")], name = "moda =") +
  scale_shape_manual(values = c(A = 17, I = 18), labels = nazwy_kat[c("A", "I")], name = "moda =") +
  scale_linetype_manual(values = c("asystent głosowy" = "solid", "kategoryzacja wydatków" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(100, 200, 400, 800), trans = "log2") +
  scale_y_continuous(limits = c(0, 100), labels = function(x) paste0(x, "%")) +
  labs(title = "B. 1000 ankiet z populacji", x = "liczba klientów w ankiecie (skala log)",
       y = "odsetek ankiet z tą modą") +
  motyw + theme(legend.position = "bottom", legend.box = "vertical", legend.margin = margin(0, 0, 0, 0)) +
  guides(colour = guide_legend(order = 1), shape = guide_legend(order = 1), linetype = guide_legend(order = 2, nrow = 2))
p5 <- p5a + p5b + plot_layout(widths = c(1.25, 1))
p5
# ggsave("kano-niepewnosc-kategorii.svg", p5, width = 10, height = 5.6)
Wynik w R
                  M     O     A     I    R Q
powiadomienia 100.0   0.0   0.0   0.0  0.0 0
biometria       0.0 100.0   0.0   0.0  0.0 0
telefon        99.4   0.6   0.0   0.0  0.0 0
czat            0.1  99.9   0.0   0.0  0.0 0
kategorie       0.0   0.0 100.0   0.0  0.0 0
bankomat        0.0   0.0  99.3   0.7  0.0 0
ciemny          0.0   0.0   0.0 100.0  0.0 0
asystent        0.0   0.0  28.1  71.8  0.0 0
wyzwania        0.0   0.0   0.0  99.9  0.1 0
oferty          0.0   0.0   0.0  10.7 89.3 0
  proc
A 34.5 30.0 39.3
I 37.0 32.4 41.8
roznica_pp       2.5%      97.5%
       2.5       -5.5       10.7
            M    O    A    I    R   Q
asystent  5.6  6.8 35.9 39.7 11.4 0.6
kategorie 5.6 14.1 47.0 30.5  2.2 0.6
       cecha   n kat  proc blad_mc
1   asystent 100   A  34.8     1.5
2   asystent 100   I  65.2     1.5
3  kategorie 100   A  96.6     0.6
4  kategorie 100   I   3.4     0.6
5   asystent 200   A  27.8     1.4
6   asystent 200   I  72.2     1.4
7  kategorie 200   A  99.9     0.1
8  kategorie 200   I   0.1     0.1
9   asystent 400   A  21.9     1.3
10  asystent 400   I  78.1     1.3
11 kategorie 400   A 100.0     0.0
12 kategorie 400   I   0.0     0.0
13  asystent 800   A  12.5     1.0
14  asystent 800   I  87.5     1.0
15 kategorie 800   A 100.0     0.0
16 kategorie 800   I   0.0     0.0
6. Segmenty wieku: Rysunek 6
R
# Rysunek 6. Segmenty: ta sama funkcja, inna kategoria w dwóch grupach wieku
library(ggplot2)
library(patchwork)

# Rozkład kategorii i kategoria modalna w grupach wieku
seg <- lapply(split(seq_len(N), grupa), function(i) {
  l <- t(sapply(names(cechy), function(j) table(factor(kano[i, j], levels = kat6))))
  list(n = length(i), odsetki = round(100 * l / length(i), 1), moda = apply(l, 1, function(x) kat6[which.max(x)]),
       w = wspolczynniki(kano[i, , drop = FALSE]))
})
data.frame(cala_proba = moda, mlodsi = seg[["18–34"]]$moda, starsi = seg[["35+"]]$moda)
rbind(`18–34` = seg[["18–34"]]$odsetki["wyzwania", ], `35+` = seg[["35+"]]$odsetki["wyzwania", ],
      razem = odsetki["wyzwania", ])
# Test niezależności kategorii od grupy wieku (wartość p z symulacji – małe liczebności w części komórek)
set.seed(622)
tab_w <- table(grupa, factor(kano[, "wyzwania"], levels = kat6))
tab_w
test6 <- chisq.test(tab_w, simulate.p.value = TRUE, B = 10000)
test6
c(V_Cramera = round(sqrt(unname(test6$statistic) / (N * (min(dim(tab_w)) - 1))), 2))
round(cbind(SI_mlodsi = seg[["18–34"]]$w[, "SI"], SI_starsi = seg[["35+"]]$w[, "SI"],
            DI_mlodsi = seg[["18–34"]]$w[, "DI"], DI_starsi = seg[["35+"]]$w[, "DI"]), 2)

# A. Rozkład kategorii dla wyzwań oszczędnościowych: dwie grupy i cała próba
d6 <- data.frame(gr = factor(rep(c("18–34", "35+", "cała próba"), each = 6), levels = rev(c("18–34", "35+", "cała próba"))),
                 kat = factor(rep(kat6, 3), levels = rev(kat6)),
                 proc = c(seg[["18–34"]]$odsetki["wyzwania", ], seg[["35+"]]$odsetki["wyzwania", ], odsetki["wyzwania", ]))
n_gr <- c(`18–34` = seg[["18–34"]]$n, `35+` = seg[["35+"]]$n, `cała próba` = N)
p6a <- ggplot(d6, aes(proc, gr, fill = kat)) +
  geom_col(width = 0.7, colour = "white", linewidth = 0.3) +
  geom_text(aes(label = ifelse(proc >= 7, paste0(kat, " ", round(proc)), "")), position = position_stack(vjust = 0.5),
            size = 3.3, colour = "white", fontface = "bold") +
  scale_fill_manual(values = kol_kat, labels = nazwy_kat, name = NULL, breaks = kat6) +
  scale_y_discrete(labels = function(g) paste0(g, "\n(n = ", n_gr[g], ")")) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), expand = c(0, 0)) +
  labs(title = "A. Wyzwania oszczędnościowe z odznakami", x = "odsetek klientów", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank()) + guides(fill = guide_legend(nrow = 2))
# B. Przesunięcie punktów SI–|DI| między grupami (strzałka od 35+ do 18–34)
d6b <- data.frame(cecha = cechy[names(cechy)], x0 = -seg[["35+"]]$w[, "DI"], y0 = seg[["35+"]]$w[, "SI"],
                  x1 = -seg[["18–34"]]$w[, "DI"], y1 = seg[["18–34"]]$w[, "SI"])
d6b$wyr <- ifelse(rownames(d6b) == "wyzwania", "wyzwania oszczędnościowe", "pozostałe funkcje")
p6b <- ggplot(d6b) +
  geom_hline(yintercept = 0.5, colour = "grey60", linetype = "dashed") +
  geom_vline(xintercept = 0.5, colour = "grey60", linetype = "dashed") +
  geom_segment(aes(x = x0, y = y0, xend = x1, yend = y1, colour = wyr, linewidth = wyr),
               arrow = arrow(length = unit(0.18, "cm"), type = "closed")) +
  geom_point(aes(x0, y0, colour = wyr), shape = 1, size = 2.2, stroke = 1) +
  annotate("text", x = d6b["wyzwania", "x1"], y = d6b["wyzwania", "y1"] + 0.06, label = "18–34", size = 3.3, colour = "#0f1d3a") +
  annotate("text", x = d6b["wyzwania", "x0"], y = d6b["wyzwania", "y0"] - 0.06, label = "35+", size = 3.3, colour = "#0f1d3a") +
  scale_colour_manual(values = c("wyzwania oszczędnościowe" = "#0f1d3a", "pozostałe funkcje" = "grey65"), name = NULL) +
  scale_linewidth_manual(values = c("wyzwania oszczędnościowe" = 1.1, "pozostałe funkcje" = 0.5), name = NULL) +
  scale_x_continuous(limits = c(0, 1), expand = c(0, 0)) + scale_y_continuous(limits = c(0, 1), expand = c(0, 0)) +
  coord_equal() +
  labs(title = "B. SI i |DI|: kółko 35+, grot 18–34", x = "|DI| – niezadowolenie z braku", y = "SI – satysfakcja z obecności") +
  motyw + theme(legend.position = "bottom")
p6 <- p6a + p6b + plot_layout(widths = c(1.2, 1))
p6
# ggsave("kano-segmenty-wieku.svg", p6, width = 10, height = 5.6)
Wynik w R
              cala_proba mlodsi starsi
powiadomienia          M      M      M
biometria              O      O      O
telefon                M      M      M
czat                   O      O      O
kategorie              A      A      A
bankomat               A      A      A
ciemny                 I      I      I
asystent               I      I      I
wyzwania               I      A      I
oferty                 R      R      R
        M    O    A    I    R   Q
18–34 0.0 12.3 46.9 28.5 11.5 0.8
35+   1.5  7.0 11.9 43.3 34.1 2.2
razem 1.0  8.8 23.2 38.5 26.8 1.8

grupa     M   O   A   I   R   Q
  18–34   0  16  61  37  15   1
  35+     4  19  32 117  92   6

	Pearson's Chi-squared test with simulated p-value (based on 10000
	replicates)

data:  tab_w
X-squared = 73.893, df = NA, p-value = 9.999e-05

V_Cramera
     0.43
              SI_mlodsi SI_starsi DI_mlodsi DI_starsi
powiadomienia      0.35      0.32     -0.80     -0.77
biometria          0.61      0.63     -0.65     -0.72
telefon            0.43      0.44     -0.76     -0.71
czat               0.54      0.54     -0.68     -0.65
kategorie          0.54      0.66     -0.18     -0.19
bankomat           0.57      0.63     -0.29     -0.28
ciemny             0.31      0.31     -0.14     -0.09
asystent           0.50      0.49     -0.13     -0.18
wyzwania           0.68      0.30     -0.14     -0.13
oferty             0.25      0.18     -0.10     -0.10
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
pary <- combn(names(kol_kat), 2, simplify = FALSE)
wynik7 <- t(sapply(pary, function(p) { k <- unname(kol_kat[p])
  c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)), protanopia = roznica(protan(k))) }))
rownames(wynik7) <- sapply(pary, paste, collapse = "–")
round(wynik7[order(wynik7[, "deuteranopia"]), ], 1)
Wynik w R
    widzenie_typowe deuteranopia protanopia
A–R            87.5         18.1       36.2
M–Q            33.4         18.4       24.9
A–I            53.7         24.9       33.5
I–R            49.0         31.0       30.6
O–R            53.6         42.0       22.5
O–I            43.5         46.3       41.6
M–A           102.4         53.5       37.3
O–A            70.1         55.4       58.0
A–Q            88.7         66.3       51.5
M–I            79.6         67.6       55.8
M–R            74.3         70.2       71.9
R–Q            88.6         81.3       87.6
I–Q            85.3         83.6       77.7
M–O           114.6        108.3       91.9
O–Q           120.2        121.5      109.3
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Kategorie, współczynniki, bootstrap i symulacje policzono w bazowym R (pakiety base i stats; przedziały Wilsona – funkcją prop.test(), test χ² – funkcją chisq.test()). Rysunki wykonano w ggplot2, etykiety rozsunięto pakietem ggrepel, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak policzyć model Kano z ankiety?
Dla każdej funkcji zadaj pytanie funkcjonalne („Co czujesz, jeśli produkt ma tę funkcję?”) i dysfunkcjonalne („…jeśli jej nie ma?”) z pięcioma odpowiedziami od „Lubię to” do „Nie lubię tego”. Parę odpowiedzi każdej osoby zamień na kategorię według tabeli oceny Kano (A, O, M, I, R, Q), a potem policz odsetki kategorii dla każdej funkcji. Funkcji przypisuje się zwykle kategorię najczęstszą, ale zawsze pokaż cały rozkład.
Jak obliczyć współczynnik satysfakcji i niezadowolenia w modelu Kano?
Współczynnik satysfakcji to SI = (A + O) / (A + O + M + I), a niezadowolenia DI = −(O + M) / (A + O + M + I); litery oznaczają liczby osób w kategoriach, a odpowiedzi R i Q się pomija. SI mówi, jaka część klientów ucieszy się z obecności funkcji, a |DI| – jaką część rozczaruje jej brak. W przykładzie powiadomienia o transakcjach miały DI = −.78, a kategoryzacja wydatków SI = .62.
Co zrobić, gdy w modelu Kano dwie kategorie mają prawie tyle samo odpowiedzi?
Nie rozstrzygaj remisu na siłę. Podaj oba odsetki z przedziałami ufności i sprawdź bootstrapem, jak często każda kategoria wygrywa. W przykładzie asystent głosowy miał 37.0% odpowiedzi I i 34.5% A, a różnica 2.5 punktu miała 95% CI [−5.5, 10.7]; kategoria I wygrywała w 71.8% prób bootstrapowych. Opisz taką funkcję jako leżącą na granicy kategorii i sprawdź, czy nie dzielą jej segmenty klientów.
Ile osób potrzeba do badania Kano?
Tyle, by odróżnić najczęstszą kategorię od drugiej. Gdy w populacji jedna kategoria wyraźnie przeważa (47% A wobec 31% I), w symulacji 200 osób dawało tę samą kategorię w 99.9% ankiet. Przy niemal remisie (36% A wobec 40% I) nawet 800 osób myliło kategorię w 12.5% ankiet. Jeśli chcesz porównywać segmenty, planuj liczebność osobno dla każdego z nich.
Czym różni się model Kano od pytania o ważność funkcji?
Pytanie o ważność na skali 1–5 daje wysokie oceny prawie wszystkim funkcjom i nie odróżnia cech oczywistych od zachwycających. Model Kano pyta osobno o reakcję na obecność i brak funkcji, dlatego oddziela cechy, których brak boli (M), od tych, których obecność cieszy (A). Gdy potrzebujesz rankingu preferencji, lepszy od skali ocen bywa MaxDiff, a gdy ceny i kompromisów – conjoint.
Powiązane hasła
Przeczytaj też
Kluczowe czynniki satysfakcji
Ankieta gości hotelu: korelacje, β przy współliniowości, wagi względne i dominacja, macierz ważność–ocena i bootstrap rankingu z kodem R.
Czytaj →PoradnikConjoint wyborczy (CBC) – analiza
400 osób wybiera abonament: warunkowy model logitowy, ważność atrybutów, gotowość do zapłaty, symulator udziałów i pułapki IIA – pięć rysunków z kodem R.
Czytaj →PoradnikAnaliza TURF
Który zestaw smaków dotrze do największej liczby klientów: zasięg, częstość, przegląd 495 zestawów i bootstrap zwycięzcy z kodem R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →Badasz oczekiwania klientów w pracy z marketingu?
Pomożemy przygotować kwestionariusz Kano, sklasyfikować funkcje, policzyć współczynniki satysfakcji z przedziałami i opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Löfgren, M., & Witell, L. (2008). Two decades of using Kano's theory of attractive quality: A literature review. Quality Management Journal, 15(1), 59–75. https://doi.org/10.1080/10686967.2008.11918056
- Matzler, K., Hinterhuber, H. H., Bailom, F., & Sauerwein, E. (1996). How to delight your customers. Journal of Product & Brand Management, 5(2), 6–18. https://doi.org/10.1108/10610429610119469
- Mikulić, J., & Prebežac, D. (2011). A critical review of techniques for classifying quality attributes in the Kano model. Managing Service Quality: An International Journal, 21(1), 46–66. https://doi.org/10.1108/09604521111100243
- Mkpojiogu, E. O. C., & Hashim, N. L. (2016). Understanding the relationship between Kano model's customer satisfaction scores and self-stated requirements importance. SpringerPlus, 5(1), Article 197. https://doi.org/10.1186/s40064-016-1860-y ● Otwarty dostęp
- Witell, L., Löfgren, M., & Dahlgaard, J. J. (2013). Theory of attractive quality and the Kano methodology – the past, the present, and the future. Total Quality Management & Business Excellence, 24(11–12), 1241–1252. https://doi.org/10.1080/14783363.2013.791117 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{lofgren2008two, author={Löfgren, Martin and Witell, Lars}, title={{Two decades of using Kano's theory of attractive quality: A literature review}}, journal={Quality Management Journal}, year={2008}, volume={15}, number={1}, pages={59--75}, doi={10.1080/10686967.2008.11918056}}@article{matzler1996delight, author={Matzler, Kurt and Hinterhuber, Hans H. and Bailom, Franz and Sauerwein, Elmar}, title={{How to delight your customers}}, journal={Journal of Product \& Brand Management}, year={1996}, volume={5}, number={2}, pages={6--18}, doi={10.1108/10610429610119469}}@article{mikulic2011critical, author={Mikulić, Josip and Prebežac, Darko}, title={{A critical review of techniques for classifying quality attributes in the Kano model}}, journal={Managing Service Quality: An International Journal}, year={2011}, volume={21}, number={1}, pages={46--66}, doi={10.1108/09604521111100243}}@article{mkpojiogu2016understanding, author={Mkpojiogu, Emmanuel O. C. and Hashim, Nor Laily}, title={{Understanding the relationship between Kano model's customer satisfaction scores and self-stated requirements importance}}, journal={SpringerPlus}, year={2016}, volume={5}, number={1}, eid={197}, doi={10.1186/s40064-016-1860-y}}@article{witell2013theory, author={Witell, Lars and Löfgren, Martin and Dahlgaard, Jens J.}, title={{Theory of attractive quality and the Kano methodology – the past, the present, and the future}}, journal={Total Quality Management \& Business Excellence}, year={2013}, volume={24}, number={11–12}, pages={1241--1252}, doi={10.1080/14783363.2013.791117}}