Przykład: firma hostingowa i dwie wersje cennika
Fikcyjna firma hostingowa sprzedaje dwa pakiety dla stron internetowych: Podstawowy za 19 zł miesięcznie i Pro za 39 zł. Zespół marketingu chce, żeby więcej osób wybierało Pro. Pomysł: dodać trzeci pakiet Pro− za 45 zł, który jest gorszy od Pro w każdej cesze, a mimo to droższy. Nikt rozsądny go nie kupi, ale obok niego Pro może wyglądać na okazję. To efekt wabika (ang. decoy effect, attraction effect): Huber i in. (1982) opisali, że dodanie opcji zdominowanej tylko przez jedną z istniejących może zwiększyć szansę wyboru tej, która ją dominuje.
Zamiast wierzyć w efekt z podręcznika, firma robi test A/B. Przez 4 tygodnie 18 000 osób, które wchodzą na stronę cennika, jest losowo dzielonych po równo: wersja A pokazuje dwa pakiety, wersja B – trzy. Notujemy, co każda osoba wybrała: „nie kupuję”, Podstawowy, Pro albo Pro−. Plan i analizę zwykłego testu opisuje wpis test A/B – plan i analiza; tu wynik nie jest zero-jedynkowy, tylko ma cztery kategorie.
Dane są fikcyjne i znamy prawdę. Parametry ustawiliśmy ręcznie przed pierwszym uruchomieniem, w skali logitu względem „nie kupuję”. Nowa osoba prywatna ma atrakcyjność Podstawowego −2.75, a Pro −3.05. Firmy (35% odwiedzających) wolą Pro (+0.70, Podstawowy −0.30), a powracający (30%) częściej kupują cokolwiek (+0.45). Pro− ma atrakcyjność Pro minus 2.0. W wersji B Pro zyskuje +0.40 u osób prywatnych i +0.20 u firm, a u powracających tylko 1/4 tego. Wabik też dezorientuje: w wersji B osoby prywatne mają atrakcyjność każdego pakietu niższą o 0.12. Przychód liczymy za pierwszy rok: 228, 468 i 540 zł. Ziaren i parametrów danych po pierwszym uruchomieniu nie zmienialiśmy; poprawki kodu opisujemy przy kodzie. Dane: efekt-wabika-hosting.csv.
Rysunek 1: karta trzech pakietów
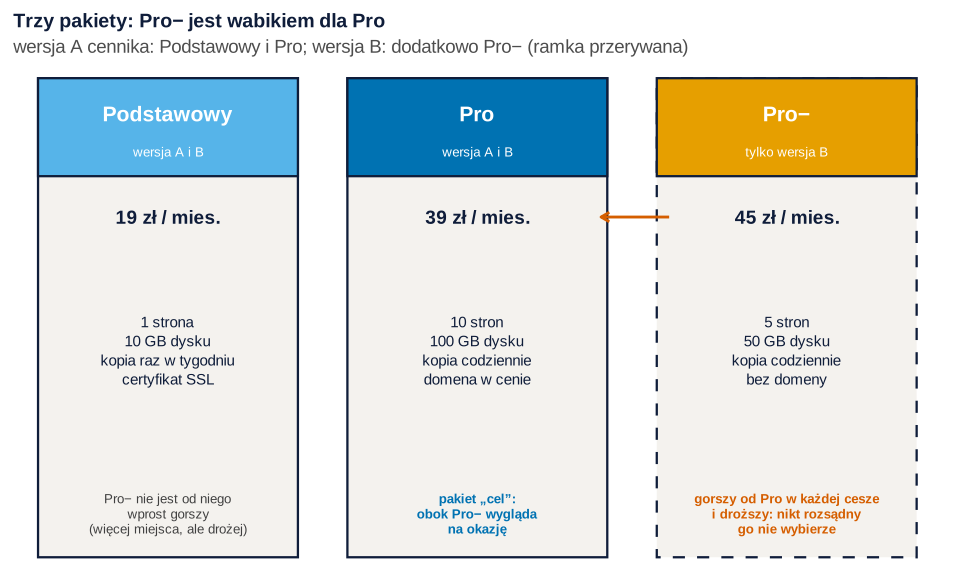
Co widać. Pro− przegrywa z Pro w każdej cesze: mniej stron, mniej miejsca, brak domeny i wyższa cena. Z Podstawowym nie da się go porównać wprost: daje więcej, ale kosztuje więcej. Taka opcja jest asymetrycznie zdominowana – i właśnie ona ma podnosić udział Pro.
Jak może zmylić. Na karcie każda cecha jest liczbą. Frederick i in. (2014) pokazali, że efekt wabika zwykle znika, gdy klient doświadcza produktu albo choć jedna cecha jest pokazana obrazem, a Yang i Lynn (2014) w 91 próbach uzyskali tylko 11 rzetelnych efektów. Huber i in. (2014) odpowiadają, że efekt powtarza się, gdy warunki są odtworzone. Nie zakładaj efektu – sprawdź go.
Podpis do pracy:
Rysunek 2: udziały wyborów z przedziałami ufności
Każdy odwiedzający wybiera jedną z kilku opcji, więc liczby wyborów w wersji mają rozkład wielomianowy. Dla takiego rozkładu przedziały liczymy razem dla wszystkich kategorii metodą Sisona–Glaza (pakiet DescTools), a nie osobno dla każdej proporcji.
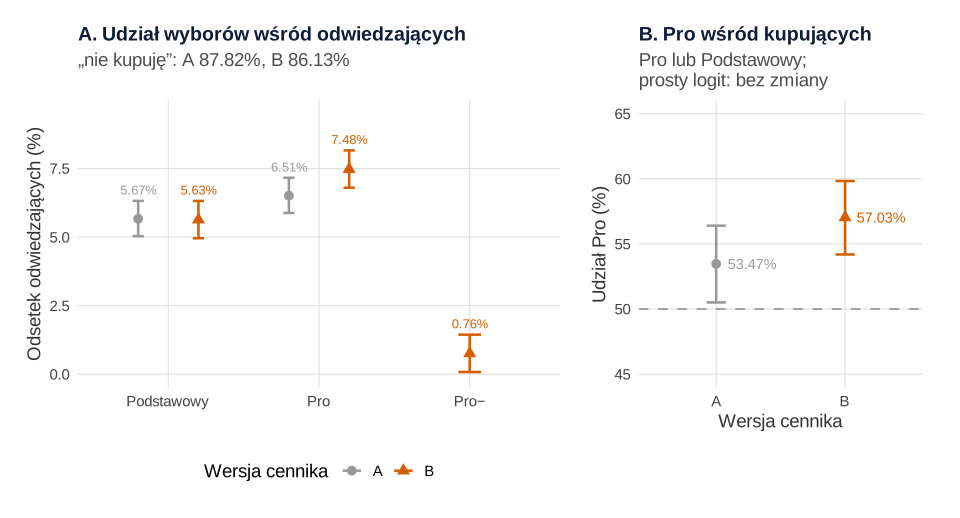
set.seed(726)).Co widać. W wersji A Pro wybrało 6.51% odwiedzających (95% CI [5.88, 7.16]), w wersji B – 7.48% [6.80, 8.16]. Podstawowy prawie się nie zmienił: 5.67% wobec 5.63%. Pro− kupiło 68 osób (0.76%). Odsetek osób, które nic nie kupiły, spadł z 87.82% do 86.13%.
Jak może zmylić. Panel B wygląda na najprostszy test efektu wabika: wśród kupujących Pro lub Podstawowy udział Pro wzrósł z 53.47% do 57.03%, ale χ²(1) = 2.92, p = .087. To nie dowód braku efektu. Ten test ma tu tylko około 1100 kupujących na wersję; rysunek 5 pokazuje, że przy prawdziwych parametrach wykrywa efekt w 81% powtórzeń. Przedziały Sisona–Glaza są szerokie przy rzadkich kategoriach (Pro−: [0.08, 1.44]), bo chronią wszystkie kategorie naraz.
Podpis do pracy:
Lepszy test daje wielomianowa regresja logistyczna (funkcja multinom w pakiecie nnet) na wszystkich odwiedzających, z kategorią odniesienia „nie kupuję” i z segmentem oraz powrotem jako kowariantami. Osoby, które wybrały Pro−, pomijamy, bo w wersji A tej opcji nie było. Wersja B zwiększyła szansę wyboru Pro względem „nie kupuję”: RRR = 1.17, 95% CI [1.04, 1.32], p = .007, a dla Podstawowego RRR = 1.02 [0.90, 1.15], p = .803. Test ilorazu wiarygodności dla wersji cennika: χ²(2) = 7.21, p = .027.
Zdanie do Wyników:
Rysunek 3: co przewiduje prosty logit, a co się stało
Prosty model logitowy – wielomianowy albo warunkowy, jak w conjoincie wyborczym – daje każdej opcji jedną atrakcyjność. Z tego wynika założenie niezależności od nieistotnych alternatyw (IIA): stosunek szans dwóch opcji nie zależy od tego, jakie inne opcje są w zbiorze. Gdy dodasz Pro−, model musi oddać mu klientów proporcjonalnie od wszystkich opcji. Udział Pro może tylko spaść. Efekt wabika to dokładnie to, czego taki model nie dopuszcza: dodana opcja zwiększa udział innej. Metaanaliza Heatha i Chatterjee (1995) opisuje go jako naruszenie IIA, a gdy udział celu rośnie nawet w liczbach bezwzględnych – także zasady regularności.
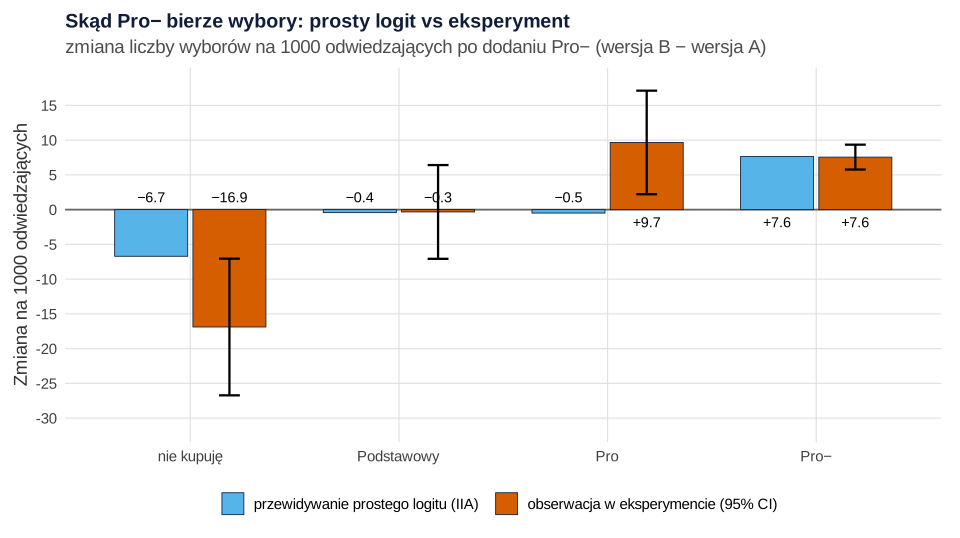
set.seed(726)).Co widać. Warunkowy model logitowy (funkcja clogit, warstwa = odwiedzający) z atrakcyjnościami z wersji A przewiduje, że 7.6 wyborów Pro− na 1000 odwiedzających przyjdzie głównie od „nie kupuję” (−6.7), a Pro straci 0.5. W eksperymencie Pro zyskało 9.7 wyboru na 1000 (95% CI [2.2, 17.1]). Kupujących było 138.7 na 1000 wobec 121.8 w wersji A i 128.5 w przewidywaniu modelu. Model, w którym atrakcyjność Pro i Podstawowego może zależeć od wersji, pasuje lepiej: χ²(2) = 7.24, p = .027.
Jak może zmylić. Problem nie leży w logicie, tylko w prognozie po zmianie zbioru opcji. Ten sam problem dotyczy symulatora rynku w conjoincie i modelu atrakcyjności udziałów. Formalne testy IIA bywają zawodne właśnie przy bliskich substytutach (Cheng i Long, 2007), dlatego lepiej mieć eksperyment z obiema wersjami zbioru, jak tutaj.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: przychód na odwiedzającego i metryka ochronna
Udział Pro to nie cel sam w sobie. Firmę interesuje przychód na odwiedzającego (pierwszy rok), a przy okazji – czy wabik nie zniechęca do zakupu. Przychód ma bardzo dużo zer, więc przedział liczymy bootstrapem po odwiedzających (2000 prób), a dla porównania także testem Welcha. O analizie przychodu z zerami więcej we wpisie o przychodzie na klienta.
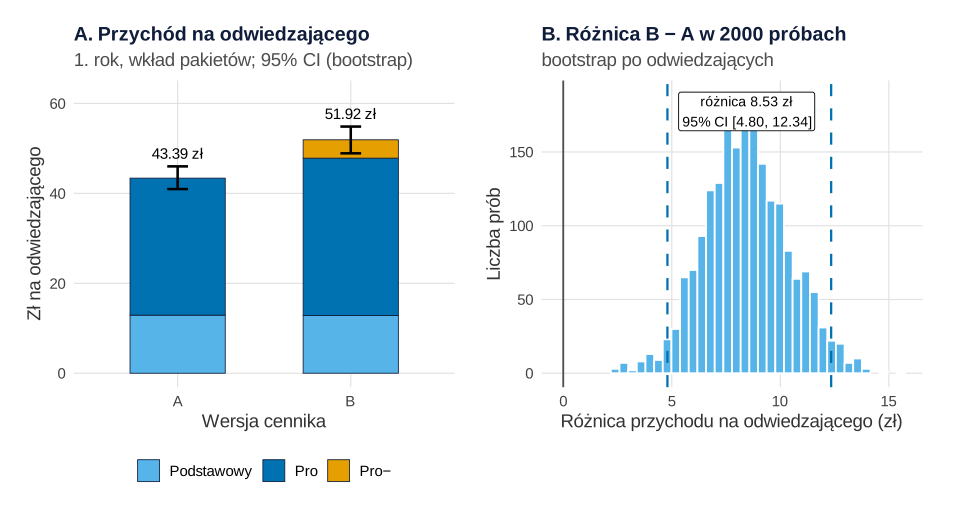
set.seed(726) i set.seed(7261)).Co widać. Odwiedzający przyniósł 43.39 zł w wersji A i 51.92 zł w wersji B. Różnica to 8.53 zł, 95% CI [4.80, 12.34] z bootstrapu (Welch: t(17811.8) = 4.38, p < .001), czyli wzrost o 19.7%. Prawdziwa różnica w symulacji to 44.03 wobec 51.81 zł. Pro dało 35.00 zł zamiast 30.47 zł, a Pro− dołożył 4.08 zł.
Jak może zmylić. Prawie połowa wzrostu pochodzi od 68 osób, które kupiły pakiet gorszy i droższy. To mogą być klienci, którzy pomylili pakiety – częściej zrezygnują i napiszą do obsługi. Dlatego przychód z pierwszego roku warto uzupełnić o rezygnacje i zgłoszenia po kilku miesiącach. Metryka ochronna – odsetek kupujących cokolwiek – wypadła dobrze: 12.18% w A i 13.87% w B, a jednostronna dolna granica 95% dla różnicy to +0.86 pp, powyżej marginesu −1 pp ustalonego przed testem. Tak sprawdza się metryki ochronne testem nie-gorszości.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: dla kogo działa wabik i ilu odwiedzających potrzeba
Heath i Chatterjee (1995) zauważyli, że efekt wabika nie musi dotyczyć wszystkich segmentów rynku. Sprawdzamy więc zmianę w grupach i interakcje wersji z segmentem i z powrotem na stronę. Do tego symulacja 1000 eksperymentów z prawdziwymi parametrami pokazuje moc przy różnej liczbie odwiedzających.
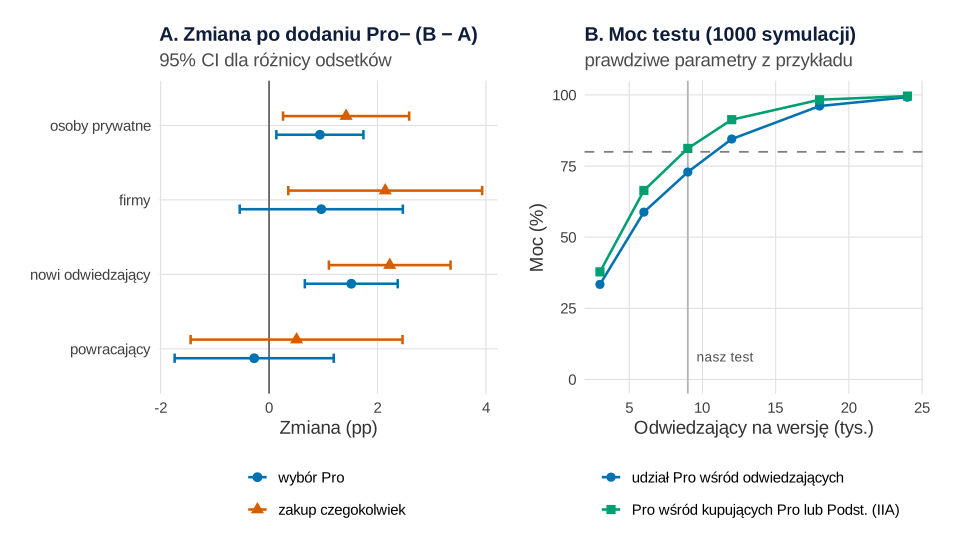
set.seed(726) i set.seed(7262)).Co widać. U nowych odwiedzających udział Pro wzrósł o 1.52 pp [0.66, 2.37], u powracających się nie zmienił (−0.27 pp [−1.74, 1.19]). Interakcja wersji z powrotem dla Pro: RRR = 0.74, 95% CI [0.58, 0.94]. U osób prywatnych i firm wzrost jest podobny (0.94 i 0.96 pp), choć u firm przedział obejmuje zero. Panel B: przy 9000 osób na wersję test udziału Pro wśród odwiedzających ma moc 72.9%, a test wśród kupujących Pro lub Podstawowy – 81.2% (błąd Monte Carlo ok. 1.3 pp). Mamy więc ok. 1 szansę na 5, że prawdziwy efekt nie wyjdzie istotny – jak w panelu B rysunku 2.
Jak może zmylić. Łączny test czterech interakcji nie jest istotny: χ²(4) = 6.59, p = .159. Różnice między grupami to hipoteza do następnego testu, nie gotowy wniosek – zasady opisuje hasło analiza podgrup. W prawdziwych danych dezorientacja osób prywatnych (−0.12 w parametrach) nie jest widoczna, bo przykrył ją wzrost Pro i szum.
Podpis do pracy:
Co z tym zrobić w marketingu
- Sprawdzaj wabika eksperymentem z dwiema wersjami cennika, losując odwiedzających, nie dni. Sam efekt bywa słaby i zależy od sposobu prezentacji (rysunek 1).
- Decyzję opieraj na przychodzie na odwiedzającego, nie na udziale Pro. W przykładzie +8.53 zł [4.80, 12.34] na osobę (rysunek 4).
- Ustal metrykę ochronną i margines przed testem: odsetek zakupów, a po kilku miesiącach rezygnacje i zgłoszenia od kupujących Pro−.
- Nie prognozuj skutków nowego pakietu prostym logitem. Zakłada, że nowa opcja zabierze klientów wszystkim proporcjonalnie (rysunek 3).
- Licz się z tym, że efekt słabnie u stałych klientów (rysunek 5).
- Zaplanuj liczbę odwiedzających symulacją: przy efekcie rzędu 1 pp 9000 osób na wersję to za mało na 80% mocy dla udziału Pro.
- Pakiet, który ma tylko wabić, to też decyzja etyczna. Jeśli ktoś go kupuje, rozważ jego usunięcie albo zmianę w uczciwą opcję. Jak ustalić cenę zestawu z gotowości do zapłaty, pokazuje wpis o cenie zestawu (bundlingu), a o pomiarze samej ceny – badanie ceny metodą van Westendorpa i Gabora–Grangera.
Jak opisać w pracy
Opisz losowanie i jego jednostkę, czas trwania, cztery możliwe wyniki, model i kategorię odniesienia, metrykę ochronną z marginesem oraz to, jak potraktowano wybory opcji obecnej tylko w jednej wersji. Raportuj kontrolowane eksperymenty z metryką główną i ochronnymi ustalonymi przed startem (Kohavi i in., 2020). Więcej przykładów: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, parametry i dane używane dalej. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Każdy przepis liczy się w 1–2 s.
Każdy blok, który losuje, ma własne set.seed(): 726 w przepisie 1 (dane), 7261 w przepisie 4 (bootstrap) i 7262 w przepisie 5 (symulacja mocy); przepisy 2, 3 i 6 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): 18 000 odwiedzających, przydział 1:1, 35% firm, 30% powracających, atrakcyjności pakietów (−2.75 i −3.05), efekty firmy (−0.30 i +0.70) i powrotu (+0.45), efekt wabika (+0.40 u osób prywatnych, +0.20 u firm, 1/4 tego u powracających), atrakcyjność Pro− (Pro − 2.0), dezorientację (−0.12 u osób prywatnych w wersji B) i ceny; w przepisie 4 – 2000 prób bootstrapowych i margines −1 pp; w przepisie 5 – 1000 symulacji dla 3000–24 000 osób na wersję. Po pierwszym uruchomieniu nie zmieniano parametrów danych ani ziaren. Poprawiono błąd w kodzie: w pierwszej wersji opcja „nie kupuję” miała wagę 0 zamiast exp(0) = 1, przez co wszyscy coś kupowali. Zmieniono też tylko wygląd: siatkę liczebności w symulacji mocy (z 3000–36 000 na 3000–24 000), położenie etykiet na rysunkach 2 i 3, tytuł panelu B rysunku 2 i zapis wartości p w wyniku testu Welcha.
1. Dane eksperymentu i karta pakietów: Rysunek 1
R
# Rysunek 1. Fikcyjna firma hostingowa: cennik z dwoma pakietami (A) albo z trzecim, gorszym pakietem Pro− (B)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
kol_opcje <- c(brak = "#999999", Podstawowy = "#56B4E9", Pro = "#0072B2", "Pro−" = "#E69F00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie (prawda, którą w prawdziwym eksperymencie trzeba oszacować).
# Użyteczność opcji względem „nie kupuję” (skala logitu; exp(0) = 1 dla „nie kupuję”), wybór z modelu logitowego.
N <- 18000                                   # odwiedzający stronę cennika w 4 tygodnie
cena_rok <- c(brak = 0, Podstawowy = 19 * 12, Pro = 39 * 12, "Pro−" = 45 * 12)   # przychód z 1. roku (zł)
a_pod <- -2.75; a_pro <- -3.05               # wyrazy wolne: Podstawowy i Pro u nowej osoby prywatnej
b_firma <- c(pod = -0.30, pro = 0.70)        # firmy częściej wybierają Pro
b_powrot <- 0.45                             # powracający częściej kupują cokolwiek
wabik <- c(osoba = 0.40, firma = 0.20)       # efekt wabika: Pro zyskuje w wersji B ...
mnoz_powrot <- 0.25                          # ... u powracających tylko w 1/4
a_wabik <- -2.0                              # Pro− = Pro gorszy o 2.0 na skali logitu
dezorientacja <- 0.12                        # w wersji B osoby prywatne rzadziej kupują cokolwiek

set.seed(726)
d <- data.frame(id = 1:N, wersja = sample(rep(c("A", "B"), N / 2)),
                segment = ifelse(rbinom(N, 1, 0.35) == 1, "firma", "osoba"),
                powrot = rbinom(N, 1, 0.30))
B <- d$wersja == "B"; firma <- d$segment == "firma"
v_pod <- a_pod + b_firma[["pod"]] * firma + b_powrot * d$powrot
v_pro <- a_pro + b_firma[["pro"]] * firma + b_powrot * d$powrot
v_min <- v_pro + a_wabik
v_pro <- v_pro + B * ifelse(firma, wabik[["firma"]], wabik[["osoba"]]) * ifelse(d$powrot == 1, mnoz_powrot, 1)
kara <- B * (!firma) * dezorientacja
U <- cbind(brak = 1, Podstawowy = exp(v_pod - kara), Pro = exp(v_pro - kara),
           "Pro−" = ifelse(B, exp(v_min - kara), 0))       # w wersji A pakietu Pro− nie ma
P <- U / rowSums(U)
d$wybor <- factor(colnames(P)[apply(P, 1, function(p) sample(4, 1, prob = p))], levels = colnames(P))
d$przychod <- cena_rok[as.character(d$wybor)]
write.csv(d[c("id", "wersja", "segment", "powrot", "wybor", "przychod")], "efekt-wabika-hosting.csv", row.names = FALSE)

cat("Odwiedzających:", N, "| w wersji A:", sum(!B), "| w wersji B:", sum(B), "| firm:", sum(firma),
    "| powracających:", sum(d$powrot), "\n")
print(addmargins(table(d$wersja, d$wybor), 2))
cat("Kupujących: A", sum(d$wybor[!B] != "brak"), "| B", sum(d$wybor[B] != "brak"), "\n")

# Grafika: karta trzech pakietów (Pro− tylko w wersji B)
karty <- data.frame(x = c(1, 2, 3), nazwa = c("Podstawowy", "Pro", "Pro−"),
                    cena = c("19 zł / mies.", "39 zł / mies.", "45 zł / mies."),
                    cechy = c("1 strona\n10 GB dysku\nkopia raz w tygodniu\ncertyfikat SSL",
                              "10 stron\n100 GB dysku\nkopia codziennie\ndomena w cenie",
                              "5 stron\n50 GB dysku\nkopia codziennie\nbez domeny"),
                    gdzie = c("wersja A i B", "wersja A i B", "tylko wersja B"))
p1 <- ggplot(karty) +
  geom_rect(aes(xmin = x - 0.42, xmax = x + 0.42, ymin = 0.6, ymax = 9.4, linetype = gdzie == "tylko wersja B"),
            fill = "#f4f2ee", colour = "#0f1d3a", linewidth = 0.8) +
  geom_rect(aes(xmin = x - 0.42, xmax = x + 0.42, ymin = 7.6, ymax = 9.4, fill = nazwa), colour = "#0f1d3a",
            linewidth = 0.8) +
  geom_text(aes(x, 8.75, label = nazwa), size = 5.6, fontface = "bold", colour = "white") +
  geom_text(aes(x, 8.05, label = gdzie), size = 3.5, colour = "white") +
  geom_text(aes(x, 6.85, label = cena), size = 5, fontface = "bold", colour = "#0f1d3a") +
  geom_text(aes(x, 4.4, label = cechy), size = 4, lineheight = 1.05, colour = "#0f1d3a") +
  annotate("text", x = 3, y = 1.4, label = "gorszy od Pro w każdej cesze\ni droższy: nikt rozsądny\ngo nie wybierze",
           size = 3.5, lineheight = 0.95, colour = "#D55E00", fontface = "bold") +
  annotate("text", x = 2, y = 1.4, label = "pakiet „cel”:\nobok Pro− wygląda\nna okazję", size = 3.5,
           lineheight = 0.95, colour = "#0072B2", fontface = "bold") +
  annotate("text", x = 1, y = 1.4, label = "Pro− nie jest od niego\nwprost gorszy\n(więcej miejsca, ale drożej)",
           size = 3.5, lineheight = 0.95, colour = "grey25") +
  annotate("segment", x = 2.62, xend = 2.4, y = 6.85, yend = 6.85, colour = "#D55E00", linewidth = 1,
           arrow = arrow(length = unit(0.25, "cm"))) +
  scale_fill_manual(values = c(Podstawowy = "#56B4E9", Pro = "#0072B2", "Pro−" = "#E69F00"), guide = "none") +
  scale_linetype_manual(values = c("solid", "dashed"), guide = "none") +
  coord_cartesian(xlim = c(0.5, 3.5), ylim = c(0.5, 9.6), expand = FALSE) +
  labs(title = "Trzy pakiety: Pro− jest wabikiem dla Pro",
       subtitle = "wersja A cennika: Podstawowy i Pro; wersja B: dodatkowo Pro− (ramka przerywana)", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p1                       # do pliku: ggsave("efekt-wabika-karta-pakietow.svg", p1, width = 10, height = 6)
Wynik w R
Odwiedzających: 18000 | w wersji A: 9000 | w wersji B: 9000 | firm: 6307 | powracających: 5462

    brak Podstawowy  Pro Pro−  Sum
  A 7904        510  586    0 9000
  B 7752        507  673   68 9000
Kupujących: A 1096 | B 1248
2. Udziały z przedziałami Sisona–Glaza i model wielomianowy: Rysunek 2
R
# Rysunek 2. Udziały wyborów w wersjach A i B z 95% przedziałami (Sison–Glaz) i model wielomianowy
# (korzysta z kol, kol_opcje, motyw i danych d z przepisu 1)
library(ggplot2)
library(patchwork)
library(DescTools)
library(nnet)

# Udziały czterech wyników w każdej wersji z jednoczesnymi 95% przedziałami dla rozkładu wielomianowego
udz <- do.call(rbind, lapply(c("A", "B"), function(w) {
  n <- table(d$wybor[d$wersja == w])
  if (w == "A") n <- n[names(n) != "Pro−"]                 # w wersji A pakietu Pro− nie było
  ci <- MultinomCI(n, conf.level = 0.95, method = "sisonglaz")
  data.frame(wersja = w, opcja = names(n), n = as.vector(n), proc = 100 * ci[, "est"],
             dol = 100 * ci[, "lwr.ci"], gor = 100 * ci[, "upr.ci"])
}))
rownames(udz) <- NULL
print(transform(udz, proc = round(proc, 2), dol = round(dol, 2), gor = round(gor, 2)), row.names = FALSE)

# Udział Pro wśród kupujących Podstawowy albo Pro (w prostym logicie nie powinien zależeć od Pro−)
kp <- subset(d, wybor %in% c("Podstawowy", "Pro"))
tk <- table(kp$wersja, kp$wybor == "Pro")
pt <- prop.test(tk[, 2:1], correct = FALSE)
cat("Udział Pro wśród kupujących Podstawowy/Pro: A", round(100 * pt$estimate[1], 2), "% | B",
    round(100 * pt$estimate[2], 2), "% | chi2(1) =", round(pt$statistic, 2), "| p =", sub("^0", "", formatC(pt$p.value, format = "f", digits = 3)), "\n")

# Model wielomianowy (kategoria odniesienia: „nie kupuję”); osoby, które wybrały Pro−, pomijamy,
# bo w wersji A tej opcji nie było – w prostym logicie (IIA) wersja nie powinna zmieniać szans pozostałych opcji
d3 <- subset(d, wybor != "Pro−")
d3$wybor3 <- factor(as.character(d3$wybor), levels = c("brak", "Podstawowy", "Pro"))
m0 <- multinom(wybor3 ~ segment + powrot, data = d3, trace = FALSE)
m1 <- multinom(wybor3 ~ wersja + segment + powrot, data = d3, trace = FALSE)
b <- coef(m1); se <- summary(m1)$standard.errors
rrr <- data.frame(rownanie = rep(rownames(b), ncol(b)), predyktor = rep(colnames(b), each = nrow(b)),
                  RRR = exp(as.vector(b)), dol = exp(as.vector(b - 1.96 * se)), gor = exp(as.vector(b + 1.96 * se)),
                  p = 2 * pnorm(-abs(as.vector(b / se))))
rrr <- subset(rrr, predyktor != "(Intercept)")
print(transform(rrr, RRR = round(RRR, 3), dol = round(dol, 3), gor = round(gor, 3), p = sub("^0", "", formatC(p, format = "f", digits = 3))), row.names = FALSE)
lr <- anova(m0, m1)
cat("Test ilorazu wiarygodności dla wersji cennika: chi2(", lr$`   Df`[2], ") =", round(lr$`LR stat.`[2], 2),
    ", p =", sub("^0", "", formatC(lr$`Pr(Chi)`[2], format = "f", digits = 3)), "\n")

udz$opcja <- factor(udz$opcja, levels = c("brak", "Podstawowy", "Pro", "Pro−"))
pA <- ggplot(subset(udz, opcja != "brak"), aes(opcja, proc, colour = wersja, shape = wersja)) +
  geom_errorbar(aes(ymin = dol, ymax = gor), width = 0.15, linewidth = 0.9, position = position_dodge(0.8)) +
  geom_point(size = 3, position = position_dodge(0.8)) +
  geom_text(aes(label = sprintf("%.2f%%", proc), y = gor + 0.4), size = 3.4, position = position_dodge(0.8),
            show.legend = FALSE) +
  scale_colour_manual(values = c(A = kol[["szary"]], B = kol[["pomaranczowy"]]), name = "Wersja cennika") +
  scale_shape_manual(values = c(A = 16, B = 17), name = "Wersja cennika") +
  scale_y_continuous(limits = c(0, 9.5)) +
  labs(title = "A. Udział wyborów wśród odwiedzających",
       subtitle = sprintf("„nie kupuję”: A %.2f%%, B %.2f%%", udz$proc[udz$wersja == "A" & udz$opcja == "brak"],
                          udz$proc[udz$wersja == "B" & udz$opcja == "brak"]),
       x = NULL, y = "Odsetek odwiedzających (%)") + motyw
ci_k <- do.call(rbind, lapply(1:2, function(i) {
  t <- prop.test(tk[i, 2], sum(tk[i, ]), correct = FALSE)
  data.frame(wersja = rownames(tk)[i], proc = 100 * t$estimate, dol = 100 * t$conf.int[1], gor = 100 * t$conf.int[2])
}))
pB <- ggplot(ci_k, aes(wersja, proc, colour = wersja, shape = wersja)) +
  geom_hline(yintercept = 50, colour = "grey60", linetype = "dashed") +
  geom_errorbar(aes(ymin = dol, ymax = gor), width = 0.15, linewidth = 0.9) +
  geom_point(size = 3) +
  geom_text(aes(label = sprintf("%.2f%%", proc)), nudge_x = 0.28, size = 3.8, show.legend = FALSE) +
  scale_colour_manual(values = c(A = kol[["szary"]], B = kol[["pomaranczowy"]]), guide = "none") +
  scale_shape_manual(values = c(A = 16, B = 17), guide = "none") +
  scale_y_continuous(limits = c(45, 65)) +
  labs(title = "B. Pro wśród kupujących", subtitle = "Pro lub Podstawowy;\nprosty logit: bez zmiany",
       x = "Wersja cennika", y = "Udział Pro (%)") + motyw
p2 <- pA + pB + plot_layout(widths = c(1.7, 1))
p2                       # do pliku: ggsave("efekt-wabika-udzialy.svg", p2, width = 10, height = 5.4)
Wynik w R
 wersja      opcja    n  proc   dol   gor
      A       brak 7904 87.82 87.19 88.48
      A Podstawowy  510  5.67  5.03  6.32
      A        Pro  586  6.51  5.88  7.16
      B       brak 7752 86.13 85.46 86.82
      B Podstawowy  507  5.63  4.96  6.32
      B        Pro  673  7.48  6.80  8.16
      B       Pro−   68  0.76  0.08  1.44
Udział Pro wśród kupujących Podstawowy/Pro: A 53.47 % | B 57.03 % | chi2(1) = 2.92 | p = .087
   rownanie    predyktor   RRR   dol   gor    p
 Podstawowy      wersjaB 1.016 0.895 1.154 .803
        Pro      wersjaB 1.172 1.044 1.315 .007
 Podstawowy segmentosoba 1.307 1.136 1.505 .000
        Pro segmentosoba 0.478 0.425 0.536 .000
 Podstawowy       powrot 1.617 1.419 1.841 .000
        Pro       powrot 1.371 1.215 1.547 .000
Test ilorazu wiarygodności dla wersji cennika: chi2( 2 ) = 7.21 , p = .027
3. Prosty logit (IIA) a obserwacja: Rysunek 3
R
# Rysunek 3. Co przewiduje prosty logit (IIA), a co się stało: warunkowy model logitowy w pakiecie survival
# (korzysta z kol, kol_opcje, motyw i danych d z przepisu 1)
library(ggplot2)
library(survival)

# Format długi: jeden wiersz = odwiedzający × dostępna opcja (w wersji A bez Pro−)
opcje <- c("brak", "Podstawowy", "Pro", "Pro−")
dl <- do.call(rbind, lapply(opcje, function(o) {
  x <- d[if (o == "Pro−") d$wersja == "B" else TRUE, c("id", "wersja", "wybor")]
  data.frame(id = x$id, B = as.integer(x$wersja == "B"), opcja = o, wybrano = as.integer(x$wybor == o))
}))
dl <- dl[order(dl$id, match(dl$opcja, opcje)), ]
dl$asc_pod <- as.integer(dl$opcja == "Podstawowy"); dl$asc_pro <- as.integer(dl$opcja == "Pro")
dl$asc_min <- as.integer(dl$opcja == "Pro−")
# Model 1 (prosty logit, IIA): każda opcja ma jedną atrakcyjność, taką samą w obu wersjach cennika
c1 <- clogit(wybrano ~ asc_pod + asc_pro + asc_min + strata(id), data = dl)
# Model 2: atrakcyjność Podstawowego i Pro może zależeć od tego, czy w cenniku jest Pro−
c2 <- clogit(wybrano ~ asc_pod + asc_pro + asc_min + asc_pod:B + asc_pro:B + strata(id), data = dl)
print(round(cbind(oszacowanie = coef(c2), SE = sqrt(diag(vcov(c2)))), 4))
lr <- 2 * (c2$loglik[2] - c1$loglik[2])
cat("LR: model z IIA vs model bez IIA: chi2(2) =", round(lr, 2), ", p =", sub("^0", "", formatC(pchisq(lr, 2, lower.tail = FALSE), format = "f", digits = 3)), "\n")

# Przewidywanie prostego logitu dla wersji B: atrakcyjności z wersji A + atrakcyjność Pro− z wersji B
b <- coef(c2)
eA <- c(brak = 1, Podstawowy = exp(b[["asc_pod"]]), Pro = exp(b[["asc_pro"]]), "Pro−" = 0)
eB_iia <- eA; eB_iia["Pro−"] <- exp(b[["asc_min"]])
pA <- eA / sum(eA); pB_iia <- eB_iia / sum(eB_iia)
pB_obs <- prop.table(table(factor(d$wybor[d$wersja == "B"], levels = opcje)))
nA <- sum(d$wersja == "A"); nB <- sum(d$wersja == "B")
# Zmiana na 1000 odwiedzających (B − A): przewidywanie IIA i obserwacja z 95% CI dla różnicy proporcji
zm <- data.frame(opcja = opcje, A = 1000 * as.vector(pA), B_iia = 1000 * as.vector(pB_iia), B_obs = 1000 * as.vector(pB_obs))
zm$iia <- zm$B_iia - zm$A; zm$obs <- zm$B_obs - zm$A
se_r <- sqrt(as.vector(pA) * (1 - as.vector(pA)) / nA + as.vector(pB_obs) * (1 - as.vector(pB_obs)) / nB)
zm$dol <- zm$obs - 1.96 * 1000 * se_r; zm$gor <- zm$obs + 1.96 * 1000 * se_r
print(transform(zm, A = round(A, 1), B_iia = round(B_iia, 1), B_obs = round(B_obs, 1), iia = round(iia, 1),
                obs = round(obs, 1), dol = round(dol, 1), gor = round(gor, 1)), row.names = FALSE)
cat("Kupujący na 1000 odwiedzających: A", round(1000 * (1 - pA[["brak"]]), 1), "| B przewidywanie IIA",
    round(1000 * (1 - pB_iia[["brak"]]), 1), "| B obserwacja", round(1000 * (1 - pB_obs[["brak"]]), 1), "\n")

zl <- rbind(data.frame(opcja = zm$opcja, rodzaj = "przewidywanie prostego logitu (IIA)", zmiana = zm$iia, dol = NA, gor = NA),
            data.frame(opcja = zm$opcja, rodzaj = "obserwacja w eksperymencie (95% CI)", zmiana = zm$obs, dol = zm$dol, gor = zm$gor))
zl$opcja <- factor(zl$opcja, levels = opcje, labels = c("nie kupuję", "Podstawowy", "Pro", "Pro−"))
zl$rodzaj <- factor(zl$rodzaj, levels = unique(zl$rodzaj))
p3 <- ggplot(zl, aes(opcja, zmiana, fill = rodzaj)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_col(position = position_dodge(0.75), width = 0.7, colour = "#0f1d3a", linewidth = 0.3) +
  geom_errorbar(aes(ymin = dol, ymax = gor), position = position_dodge(0.75), width = 0.2, linewidth = 0.8,
                na.rm = TRUE) +
  geom_text(aes(label = sub("-", "−", sprintf("%+.1f", zmiana)), y = ifelse(zmiana >= 0, -1.8, 1.8)),
            position = position_dodge(0.75), size = 3.8) +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_y_continuous(limits = c(-31, 18), breaks = seq(-30, 15, 5)) +
  labs(title = "Skąd Pro− bierze wybory: prosty logit vs eksperyment",
       subtitle = "zmiana liczby wyborów na 1000 odwiedzających po dodaniu Pro− (wersja B − wersja A)",
       x = NULL, y = "Zmiana na 1000 odwiedzających") + motyw + guides(fill = guide_legend(nrow = 1))
p3                       # do pliku: ggsave("efekt-wabika-iia.svg", p3, width = 10, height = 5.6)
Wynik w R
          oszacowanie     SE
asc_pod       -2.7407 0.0457
asc_pro       -2.6018 0.0428
asc_min       -4.7362 0.1218
asc_pod:B      0.0135 0.0647
asc_pro:B      0.1578 0.0587
LR: model z IIA vs model bez IIA: chi2(2) = 7.24 , p = .027
      opcja     A B_iia B_obs  iia   obs   dol  gor
       brak 878.2 871.5 861.3 -6.7 -16.9 -26.7 -7.1
 Podstawowy  56.7  56.2  56.3 -0.4  -0.3  -7.1  6.4
        Pro  65.1  64.6  74.8 -0.5   9.7   2.2 17.1
       Pro−   0.0   7.6   7.6  7.6   7.6   5.8  9.3
Kupujący na 1000 odwiedzających: A 121.8 | B przewidywanie IIA 128.5 | B obserwacja 138.7
4. Przychód na odwiedzającego i metryka ochronna: Rysunek 4
R
# Rysunek 4. Przychód na odwiedzającego (1. rok) z bootstrapowym 95% CI i metryka ochronna: odsetek zakupów
# (korzysta z kol, kol_opcje, motyw, cena_rok i danych d z przepisu 1)
library(ggplot2)
library(patchwork)

xA <- d$przychod[d$wersja == "A"]; xB <- d$przychod[d$wersja == "B"]
cat("Przychód na odwiedzającego (zł): A", round(mean(xA), 2), "| B", round(mean(xB), 2),
    "| różnica", round(mean(xB) - mean(xA), 2), "\n")
wt <- t.test(xB, xA)                                   # test Welcha na surowych przychodach (dużo zer)
cat("Test Welcha: t(", round(wt$parameter, 1), ") =", round(wt$statistic, 2), ", p", ifelse(wt$p.value < .001, "< .001", paste("=", sub("^0", "", formatC(wt$p.value, format = "f", digits = 3)))),
    ", 95% CI [", round(wt$conf.int[1], 2), ",", round(wt$conf.int[2], 2), "]\n")
set.seed(7261)
R <- 2000
boot_A <- replicate(R, mean(sample(xA, replace = TRUE)))
boot_B <- replicate(R, mean(sample(xB, replace = TRUE)))
roz <- boot_B - boot_A
q <- function(x) quantile(x, c(0.025, 0.975))
cat("Bootstrap (", R, "prób, percentylowy) 95% CI: A [", round(q(boot_A), 2), "] | B [", round(q(boot_B), 2),
    "] | różnica [", round(q(roz), 2), "] | względny wzrost", round(100 * (mean(xB) / mean(xA) - 1), 1), "%\n")
# Ile z różnicy daje sam wabik (zakupy Pro−)? Przychód bez zakupów Pro− w wersji B
cat("Wkład pakietów w przychód na odwiedzającego (zł):\n")
wk <- sapply(c("Podstawowy", "Pro", "Pro−"), function(o) c(A = mean(xA * (d$wybor[d$wersja == "A"] == o)),
                                                         B = mean(xB * (d$wybor[d$wersja == "B"] == o))))
print(round(wk, 2))

# Metryka ochronna: odsetek odwiedzających, którzy kupili cokolwiek. Nie-gorszość z marginesem −1 pp
# ustalonym przed testem: jednostronna dolna granica 95% (= dolna granica dwustronnego 90% CI)
kA <- mean(xA > 0); kB <- mean(xB > 0)
se_k <- sqrt(kA * (1 - kA) / length(xA) + kB * (1 - kB) / length(xB))
cat("Zakup czegokolwiek: A", round(100 * kA, 2), "% | B", round(100 * kB, 2), "% | różnica",
    round(100 * (kB - kA), 2), "pp | jednostronna dolna granica 95%:", round(100 * (kB - kA - 1.645 * se_k), 2),
    "pp (margines −1 pp)\n")

ra <- data.frame(wersja = c("A", "B"), m = c(mean(xA), mean(xB)), dol = c(q(boot_A)[1], q(boot_B)[1]),
                 gor = c(q(boot_A)[2], q(boot_B)[2]))
sk <- data.frame(wersja = rep(c("A", "B"), each = 3), pakiet = rep(colnames(wk), 2), zl = as.vector(t(wk)))
sk$pakiet <- factor(sk$pakiet, levels = c("Pro−", "Pro", "Podstawowy"))
pA <- ggplot(sk, aes(wersja, zl)) +
  geom_col(aes(fill = pakiet), width = 0.55, colour = "#0f1d3a", linewidth = 0.3) +
  geom_errorbar(data = ra, aes(y = m, ymin = dol, ymax = gor), width = 0.12, linewidth = 0.9) +
  geom_text(data = ra, aes(y = gor, label = sprintf("%.2f zł", m)), vjust = -0.7, size = 4) +
  scale_fill_manual(values = kol_opcje[c("Pro−", "Pro", "Podstawowy")], name = NULL,
                    breaks = c("Podstawowy", "Pro", "Pro−")) +
  scale_y_continuous(limits = c(0, 62)) +
  labs(title = "A. Przychód na odwiedzającego", subtitle = "1. rok, wkład pakietów; 95% CI (bootstrap)",
       x = "Wersja cennika", y = "Zł na odwiedzającego") + motyw
pB <- ggplot(data.frame(roz), aes(roz)) +
  geom_histogram(bins = 40, fill = kol[["blekit"]], colour = "white") +
  geom_vline(xintercept = q(roz), colour = kol[["niebieski"]], linetype = "dashed", linewidth = 0.8) +
  geom_vline(xintercept = 0, colour = "grey30") +
  annotate("label", x = mean(roz), y = Inf, vjust = 1.3, size = 3.7,
           label = sprintf("różnica %.2f zł\n95%% CI [%.2f, %.2f]", mean(xB) - mean(xA), q(roz)[1], q(roz)[2])) +
  labs(title = "B. Różnica B − A w 2000 próbach", subtitle = "bootstrap po odwiedzających",
       x = "Różnica przychodu na odwiedzającego (zł)", y = "Liczba prób") + motyw
p4 <- pA + pB
p4                       # do pliku: ggsave("efekt-wabika-przychod.svg", p4, width = 10, height = 5.4)
Wynik w R
Przychód na odwiedzającego (zł): A 43.39 | B 51.92 | różnica 8.53
Test Welcha: t( 17811.8 ) = 4.38 , p < .001 , 95% CI [ 4.71 , 12.35 ]
Bootstrap ( 2000 prób, percentylowy) 95% CI: A [ 40.96 46.01 ] | B [ 48.91 54.86 ] | różnica [ 4.8 12.34 ] | względny wzrost 19.7 %
Wkład pakietów w przychód na odwiedzającego (zł):
  Podstawowy   Pro Pro−
A      12.92 30.47 0.00
B      12.84 35.00 4.08
Zakup czegokolwiek: A 12.18 % | B 13.87 % | różnica 1.69 pp | jednostronna dolna granica 95%: 0.86 pp (margines −1 pp)
5. Grupy odwiedzających i symulacja mocy: Rysunek 5
R
# Rysunek 5. Dla kogo działa wabik (firmy vs osoby, nowi vs powracający) i ilu odwiedzających trzeba,
# żeby go wykryć (symulacja 1000 eksperymentów)
# (korzysta z kol, motyw, parametrów i danych d z przepisu 1)
library(ggplot2)
library(patchwork)
library(nnet)

# Zmiana udziału Pro i odsetka zakupów (B − A, pp) w grupach, z 95% CI dla różnicy proporcji
grupy <- list("osoby prywatne" = d$segment == "osoba", "firmy" = d$segment == "firma",
              "nowi odwiedzający" = d$powrot == 0, "powracający" = d$powrot == 1)
roznica <- function(y, w) {
  pa <- mean(y[w == "A"]); pb <- mean(y[w == "B"])
  se <- sqrt(pa * (1 - pa) / sum(w == "A") + pb * (1 - pb) / sum(w == "B"))
  100 * c(roz = pb - pa, dol = pb - pa - 1.96 * se, gor = pb - pa + 1.96 * se)
}
het <- do.call(rbind, lapply(names(grupy), function(g) {
  x <- d[grupy[[g]], ]
  rbind(data.frame(grupa = g, n = nrow(x), miara = "wybór Pro", t(roznica(x$wybor == "Pro", x$wersja))),
        data.frame(grupa = g, n = nrow(x), miara = "zakup czegokolwiek", t(roznica(x$wybor != "brak", x$wersja))))
}))
print(transform(het, roz = round(roz, 2), dol = round(dol, 2), gor = round(gor, 2)), row.names = FALSE)

# Czy efekt wersji różni się w grupach? Model wielomianowy z interakcjami (bez osób, które wybrały Pro−)
d3 <- subset(d, wybor != "Pro−")
d3$wybor3 <- factor(as.character(d3$wybor), levels = c("brak", "Podstawowy", "Pro"))
m1 <- multinom(wybor3 ~ wersja + segment + powrot, data = d3, trace = FALSE)
m2 <- multinom(wybor3 ~ wersja * segment + wersja * powrot, data = d3, trace = FALSE)
lr <- anova(m1, m2)
cat("Interakcje wersja × segment i wersja × powrót: chi2(", lr$`   Df`[2], ") =", round(lr$`LR stat.`[2], 2),
    ", p =", sub("^0", "", formatC(lr$`Pr(Chi)`[2], format = "f", digits = 3)), "\n")
b <- coef(m2)["Pro", ]; se <- summary(m2)$standard.errors["Pro", ]
cat("RRR(Pro vs nie kupuję) dla wersji B u nowej osoby prywatnej:", round(exp(b[["wersjaB"]] + b[["wersjaB:segmentosoba"]]), 3),
    "| interakcja wersja × powrót: RRR =", round(exp(b[["wersjaB:powrot"]]), 3), "95% CI [",
    round(exp(b[["wersjaB:powrot"]] - 1.96 * se[["wersjaB:powrot"]]), 3), ",",
    round(exp(b[["wersjaB:powrot"]] + 1.96 * se[["wersjaB:powrot"]]), 3), "]\n")

# Prawdziwe prawdopodobieństwa wyborów każdego odwiedzającego w obu wersjach (znamy je, bo dane są fikcyjne)
firma <- d$segment == "firma"
prawd <- function(B) {
  v_pod <- a_pod + b_firma[["pod"]] * firma + b_powrot * d$powrot
  v_pro <- a_pro + b_firma[["pro"]] * firma + b_powrot * d$powrot
  v_min <- v_pro + a_wabik
  v_pro <- v_pro + B * ifelse(firma, wabik[["firma"]], wabik[["osoba"]]) * ifelse(d$powrot == 1, mnoz_powrot, 1)
  kara <- B * (!firma) * dezorientacja
  U <- cbind(brak = 1, Podstawowy = exp(v_pod - kara), Pro = exp(v_pro - kara), "Pro−" = B * exp(v_min - kara))
  colMeans(U / rowSums(U))
}
pr_A <- prawd(0); pr_B <- prawd(1)
cat("Prawdziwe udziały (%), A:", round(100 * pr_A, 2), "| B:", round(100 * pr_B, 2), "\n")
cat("Prawdziwy przychód na odwiedzającego (zł): A", round(sum(pr_A * cena_rok), 2), "| B", round(sum(pr_B * cena_rok), 2), "\n")

# Moc: 1000 eksperymentów dla każdej liczby odwiedzających na wersję; dwa testy (dwustronne, α = .05):
# (1) udział Pro wśród wszystkich odwiedzających, (2) udział Pro wśród kupujących Pro lub Podstawowy (IIA)
set.seed(7262)
R <- 1000
n_wersja <- c(3000, 6000, 9000, 12000, 18000, 24000)
z2 <- function(x1, n1, x2, n2) { p <- (x1 + x2) / (n1 + n2); (x2 / n2 - x1 / n1) / sqrt(p * (1 - p) * (1 / n1 + 1 / n2)) }
moc <- do.call(rbind, lapply(n_wersja, function(n) {
  cA <- rmultinom(R, n, pr_A); cB <- rmultinom(R, n, pr_B)
  t1 <- abs(z2(cA[3, ], n, cB[3, ], n)) > 1.96
  t2 <- abs(z2(cA[3, ], cA[2, ] + cA[3, ], cB[3, ], cB[2, ] + cB[3, ])) > 1.96
  data.frame(n = n, test = c("udział Pro wśród odwiedzających", "Pro wśród kupujących Pro lub Podst. (IIA)"),
             moc = c(mean(t1), mean(t2)))
}))
moc$bladMC <- sqrt(moc$moc * (1 - moc$moc) / R)
print(transform(moc, moc = round(moc, 3), bladMC = round(bladMC, 3)), row.names = FALSE)

het$grupa <- factor(het$grupa, levels = rev(names(grupy)))
pA <- ggplot(het, aes(roz, grupa, colour = miara, shape = miara)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dol, xmax = gor), width = 0.25, linewidth = 0.9, orientation = "y",
                position = position_dodge(0.5)) +
  geom_point(size = 3, position = position_dodge(0.5)) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(title = "A. Zmiana po dodaniu Pro− (B − A)", subtitle = "95% CI dla różnicy odsetków",
       x = "Zmiana (pp)", y = NULL) + motyw + guides(colour = guide_legend(ncol = 1))
moc$test <- factor(moc$test, levels = unique(moc$test))
pB <- ggplot(moc, aes(n / 1000, 100 * moc, colour = test, shape = test)) +
  geom_hline(yintercept = 80, colour = "grey50", linetype = "dashed") +
  geom_vline(xintercept = 9, colour = "grey70") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.8) +
  annotate("text", x = 9.6, y = 8, label = "nasz test", hjust = 0, size = 3.6, colour = "grey30") +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["zielony"]]), name = NULL) +
  scale_shape_manual(values = c(16, 15), name = NULL) +
  scale_y_continuous(limits = c(0, 100)) +
  labs(title = "B. Moc testu (1000 symulacji)", subtitle = "prawdziwe parametry z przykładu",
       x = "Odwiedzający na wersję (tys.)", y = "Moc (%)") + motyw + guides(colour = guide_legend(ncol = 1))
p5 <- pA + pB
p5                       # do pliku: ggsave("efekt-wabika-segmenty-moc.svg", p5, width = 10, height = 5.8)
Wynik w R
             grupa     n              miara   roz   dol  gor
    osoby prywatne 11693          wybór Pro  0.94  0.13 1.74
    osoby prywatne 11693 zakup czegokolwiek  1.42  0.26 2.58
             firmy  6307          wybór Pro  0.96 -0.54 2.47
             firmy  6307 zakup czegokolwiek  2.14  0.35 3.93
 nowi odwiedzający 12538          wybór Pro  1.52  0.66 2.37
 nowi odwiedzający 12538 zakup czegokolwiek  2.23  1.10 3.35
       powracający  5462          wybór Pro -0.27 -1.74 1.19
       powracający  5462 zakup czegokolwiek  0.51 -1.45 2.46
Interakcje wersja × segment i wersja × powrót: chi2( 4 ) = 6.59 , p = .159
RRR(Pro vs nie kupuję) dla wersji B u nowej osoby prywatnej: 1.363 | interakcja wersja × powrót: RRR = 0.738 95% CI [ 0.579 , 0.94 ]
Prawdziwe udziały (%), A: 87.55 5.94 6.51 0 | B: 86.29 5.39 7.5 0.82
Prawdziwy przychód na odwiedzającego (zł): A 44.03 | B 51.81
     n                                      test   moc bladMC
  3000           udział Pro wśród odwiedzających 0.334  0.015
  3000 Pro wśród kupujących Pro lub Podst. (IIA) 0.378  0.015
  6000           udział Pro wśród odwiedzających 0.588  0.016
  6000 Pro wśród kupujących Pro lub Podst. (IIA) 0.664  0.015
  9000           udział Pro wśród odwiedzających 0.729  0.014
  9000 Pro wśród kupujących Pro lub Podst. (IIA) 0.812  0.012
 12000           udział Pro wśród odwiedzających 0.845  0.011
 12000 Pro wśród kupujących Pro lub Podst. (IIA) 0.913  0.009
 18000           udział Pro wśród odwiedzających 0.961  0.006
 18000 Pro wśród kupujących Pro lub Podst. (IIA) 0.983  0.004
 24000           udział Pro wśród odwiedzających 0.992  0.003
 24000 Pro wśród kupujących Pro lub Podst. (IIA) 0.996  0.002
6. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("Podstawowy – Pro" = c("#56B4E9", "#0072B2"), "Pro – Pro−" = c("#0072B2", "#E69F00"),
             "Podstawowy – Pro−" = c("#56B4E9", "#E69F00"), "nie kupuję – Pro−" = c("#999999", "#E69F00"),
             "wersja A – wersja B" = c("#999999", "#D55E00"), "przewidywanie – obserwacja" = c("#56B4E9", "#D55E00"),
             "wybór Pro – zakup" = c("#0072B2", "#D55E00"), "moc: dwa testy" = c("#0072B2", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
Podstawowy – Pro                            26.4         24.7       24.6
Pro – Pro−                                 120.2        121.5      109.3
Podstawowy – Pro−                          113.1        111.4      101.5
nie kupuję – Pro−                           76.8         73.9       70.0
wersja A – wersja B                         77.2         62.9       56.0
przewidywanie – obserwacja                 113.6        101.1       89.0
wybór Pro – zakup                          114.6        108.3       91.9
moc: dwa testy                              70.1         55.4       58.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, test Welcha (t.test), test proporcji (prop.test) i bootstrap wykonano pakietem stats (z podstawowej instalacji R). Przedziały Sisona–Glaza policzono pakietem DescTools, wielomianową regresję logistyczną – pakietem nnet, warunkowy model logitowy – pakietem survival, rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- nnet (wersja 7.3.20): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Prognoza nowego pakietu z prostego logitu – zakłada proporcjonalne straty i nie zobaczy wabika (rysunek 3).
- „Nieistotny” test przy małej mocy uznany za brak efektu (rysunki 2 i 5).
- Wabik, który ktoś kupuje – część wzrostu przychodu może wrócić jako rezygnacje i reklamacje (rysunek 4).
- Efekt u nowych przeniesiony na stałych klientów – u powracających wzrostu nie było (rysunek 5).
Najczęstsze pytania
Co to jest efekt wabika w marketingu?
To wzrost udziału jednej oferty po dodaniu do wyboru trzeciej opcji, która jest od niej gorsza i nie jest wyraźnie gorsza od pozostałych (opcja asymetrycznie zdominowana). Opisali go Huber i in. (1982). Przykład: pakiet „Pro−” droższy i słabszy od „Pro” ma sprawić, że Pro wygląda na okazję.
Jak sprawdzić efekt wabika na własnym cenniku?
Zrób eksperyment: losowo pokazuj odwiedzającym cennik bez wabika i z wabikiem, notuj wybór (w tym brak zakupu) i porównaj udziały oraz przychód na odwiedzającego. Udział celu analizuj wielomianową regresją logistyczną, a przychód – z przedziałem bootstrapowym. Przy efekcie rzędu 1 pp potrzebujesz kilkunastu tysięcy odwiedzających na wersję.
Co ma wspólnego efekt wabika z założeniem IIA?
Prosty model logitowy zakłada niezależność od nieistotnych alternatyw (IIA): dodana opcja zabiera klientów wszystkim proporcjonalnie, więc udział żadnej innej nie może wzrosnąć. Efekt wabika jest naruszeniem IIA. W przykładzie model przewidywał spadek wyborów Pro o 0.5 na 1000 odwiedzających, a w eksperymencie Pro zyskało 9.7 na 1000.
Czy efekt wabika zawsze działa?
Nie. Frederick i in. (2014) oraz Yang i Lynn (2014) pokazali, że efekt często znika, gdy cechy produktu nie są podane liczbami albo klient zna produkt. W przykładzie hostingowym wzrost udziału Pro był u nowych odwiedzających (+1.52 pp), a u powracających nie (−0.27 pp). Dlatego testuj go na własnych klientach.
Czy wabik może zaszkodzić sprzedaży?
Może, jeśli dezorientuje i część osób rezygnuje z zakupu albo kupuje gorszy pakiet przez pomyłkę. Dlatego ustal metrykę ochronną (np. odsetek zakupów) i margines przed testem, a po kilku miesiącach sprawdź rezygnacje kupujących wabika.
Powiązane hasła
Przeczytaj też
Conjoint wyborczy (CBC) – analiza
400 osób wybiera abonament: warunkowy model logitowy, ważność atrybutów, gotowość do zapłaty, symulator udziałów i pułapki IIA – pięć rysunków z kodem R.
Czytaj →PoradnikMetryki ochronne w teście A/B
Test nie-gorszości z marginesem, symulacja, moc dla rzadkich metryk i reguła decyzji – na fikcyjnym teście serwisu biletowego, z kodem R.
Czytaj →PoradnikCena zestawu (bundling)
Sieć kin studyjnych: ankieta WTP, czysty i mieszany pakiet, wpływ korelacji, optymalna cena zestawu z bootstrapem i kanibalizacja – z kodem R.
Czytaj →Planujesz eksperyment z cennikiem albo piszesz o nim pracę?
Pomożemy zaplanować losowanie i liczebność, dobrać model wyboru i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cheng, S., & Long, J. S. (2007). Testing for IIA in the multinomial logit model. Sociological Methods & Research, 35(4), 583–600. https://doi.org/10.1177/0049124106292361
- Frederick, S., Lee, L., & Baskin, E. (2014). The limits of attraction. Journal of Marketing Research, 51(4), 487–507. https://doi.org/10.1509/jmr.12.0061
- Heath, T. B., & Chatterjee, S. (1995). Asymmetric decoy effects on lower-quality versus higher-quality brands: Meta-analytic and experimental evidence. Journal of Consumer Research, 22(3), 268–284. https://doi.org/10.1086/209449
- Huber, J., Payne, J. W., & Puto, C. (1982). Adding asymmetrically dominated alternatives: Violations of regularity and the similarity hypothesis. Journal of Consumer Research, 9(1), 90–98. https://doi.org/10.1086/208899
- Huber, J., Payne, J. W., & Puto, C. P. (2014). Let's be honest about the attraction effect. Journal of Marketing Research, 51(4), 520–525. https://doi.org/10.1509/jmr.14.0208
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Yang, S., & Lynn, M. (2014). More evidence challenging the robustness and usefulness of the attraction effect. Journal of Marketing Research, 51(4), 508–513. https://doi.org/10.1509/jmr.14.0020
Cytowania BibTeX
@article{cheng2007testing, author={Cheng, Simon and Long, J. Scott}, title={{Testing for IIA in the multinomial logit model}}, journal={Sociological Methods \& Research}, year={2007}, volume={35}, number={4}, pages={583--600}, doi={10.1177/0049124106292361}}@article{frederick2014limits, author={Frederick, Shane and Lee, Leonard and Baskin, Ernest}, title={{The limits of attraction}}, journal={Journal of Marketing Research}, year={2014}, volume={51}, number={4}, pages={487--507}, doi={10.1509/jmr.12.0061}}@article{heath1995asymmetric, author={Heath, Timothy B. and Chatterjee, Subimal}, title={{Asymmetric decoy effects on lower-quality versus higher-quality brands: Meta-analytic and experimental evidence}}, journal={Journal of Consumer Research}, year={1995}, volume={22}, number={3}, pages={268--284}, doi={10.1086/209449}}@article{huber1982adding, author={Huber, Joel and Payne, John W. and Puto, Christopher}, title={{Adding asymmetrically dominated alternatives: Violations of regularity and the similarity hypothesis}}, journal={Journal of Consumer Research}, year={1982}, volume={9}, number={1}, pages={90--98}, doi={10.1086/208899}}@article{huber2014honest, author={Huber, Joel and Payne, John W. and Puto, Christopher P.}, title={{Let's be honest about the attraction effect}}, journal={Journal of Marketing Research}, year={2014}, volume={51}, number={4}, pages={520--525}, doi={10.1509/jmr.14.0208}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{yang2014more, author={Yang, Sybil and Lynn, Michael}, title={{More evidence challenging the robustness and usefulness of the attraction effect}}, journal={Journal of Marketing Research}, year={2014}, volume={51}, number={4}, pages={508--513}, doi={10.1509/jmr.14.0020}}