Przykład: abonament w serwisie rowerowym
Fikcyjny serwis rowerowy w dużym mieście chce sprzedawać abonament: przegląd co kwartał, naprawy bez opłaty za robociznę i rower zastępczy na czas naprawy. Pytanie biznesowe brzmi: ile brać miesięcznie? Usługi jeszcze nie ma, więc nie ma też danych o sprzedaży, z których dałoby się policzyć elastyczność cenową. Zostaje ankieta.
Ankietę online wypełniło 1200 osób dojeżdżających rowerem do pracy. Program losowo podzielił je na dwie połowy. Pierwsze 600 osób dostało cztery pytania van Westendorpa, a drugie 600 – pytania Gabora–Grangera. Dzięki temu odpowiedzi z jednej metody nie podsuwają liczb drugiej. Definicję metody van Westendorpa i treść pytań znajdziesz w haśle metoda van Westendorpa (PSM).
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Parametry ustalono ręcznie przed pierwszym uruchomieniem kodu. W module van Westendorpa „cena odniesienia” osoby ma medianę 36 zł, a 70% osób zaokrągla kwoty do 5 zł. Do danych wstawiono 42 nielogiczne odpowiedzi. W module Gabora–Grangera deklarowana gotowość do zapłaty ma medianę 40 zł. Pierwsza pokazana cena działa jak kotwica (mnożnik 0.90 przy starcie od najniższej ceny i 1.12 przy starcie od najwyższej), a 24 osoby odpowiadają losowo. Najważniejsze założenie: w prawdziwym sklepie ludzie zapłaciliby 1.3 raza mniej, niż deklarują. W prawdziwym badaniu tej liczby nie znamy – w symulacji pozwala pokazać, ile kosztuje wiara w deklaracje. Ziarno 619 ustalono raz i nie zmieniano. Dane pobierzesz jako badanie-ceny-van-westendorp-ankieta.csv i badanie-ceny-gabor-granger-ankieta.csv.
Rysunek 1: cztery pytania i jedna respondentka
Van Westendorp nie pokazuje respondentowi żadnej ceny. Każda osoba podaje cztery własne kwoty w pytaniach otwartych.
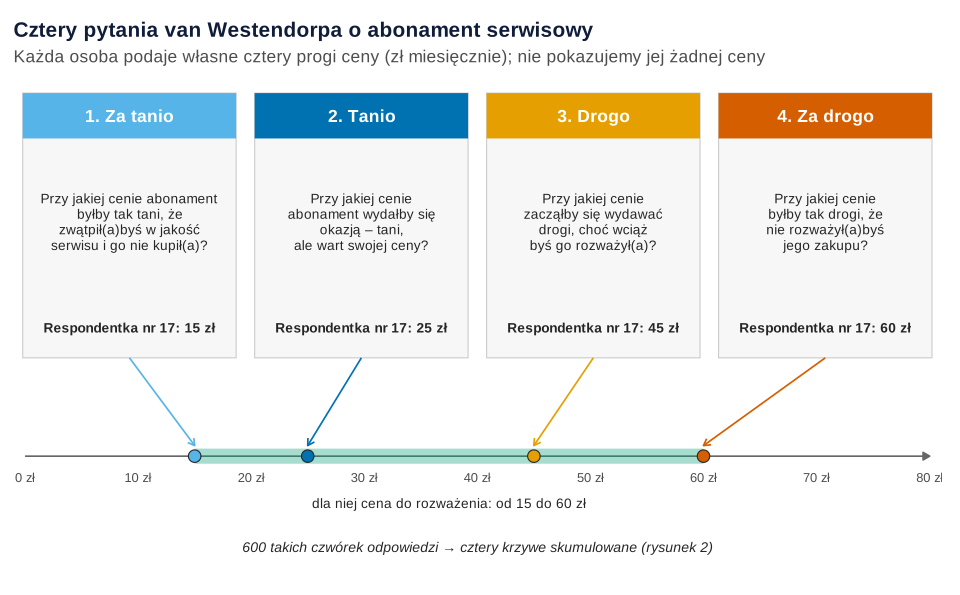
Co widać. Respondentka nr 17 uważa abonament za 15 zł za podejrzanie tani, za 25 zł – za okazję, za 45 zł – za drogi, a za 60 zł – za zbyt drogi, by go rozważyć. Sześćset takich czwórek daje cztery krzywe z rysunku 2.
Jak może zmylić. Odpowiedzi tej osoby wyglądają wzorowo: rosną od „za tanio” do „za drogo”. Nie wszyscy tak odpowiadają – części osób myli się kolejność pytań albo wpisują przypadkowe kwoty (rysunek 3). Pytanie „za tanio” ma sens, bo cena bywa sygnałem jakości. Gabor i Granger (1966) zwracali uwagę, że cena działa dla kupującego nie tylko jako koszt, ale też jako wskaźnik jakości.
Podpis do pracy:
Cztery krzywe i cztery punkty
Dla każdej ceny liczymy odsetek osób, dla których jest ona „za tania” (ich próg „za tanio” jest równy tej cenie lub wyższy), „tania”, „droga” i „za droga”. To nic innego jak dystrybuanta empiryczna każdej odpowiedzi; dwie pierwsze są odwrócone, żeby malały z ceną. Mediany progów wyniosły 20, 25, 45 i 60 zł – to percentyle 50. tych samych rozkładów.
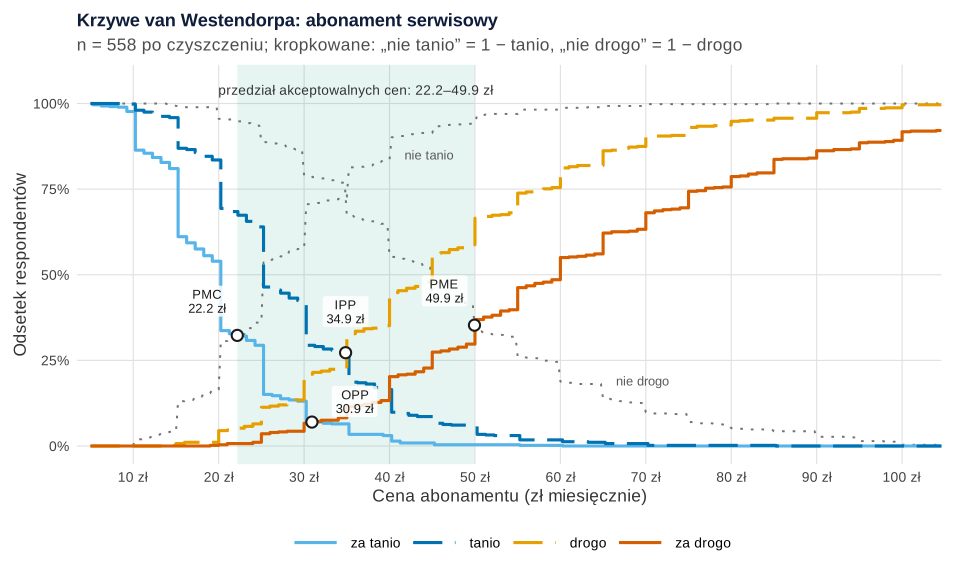
set.seed(619)).Co widać. Cztery przecięcia, odczytane z kodu:
- PMC (punkt marginalnej taniości, „za tanio” × „nie tanio”): 22.2 zł – poniżej tej ceny więcej osób uważa abonament za podejrzanie tani niż za „już nie tani”;
- OPP (punkt ceny optymalnej, „za tanio” × „za drogo”): 30.9 zł – tu najmniej osób odrzuca cenę z któregokolwiek powodu;
- IPP (punkt obojętności, „tanio” × „drogo”): 34.9 zł – tyle samo osób uważa cenę za tanią co za drogą;
- PME (punkt marginalnej drogości, „nie drogo” × „za drogo”): 49.9 zł.
Przedział akceptowalnych cen to 22.2–49.9 zł. Lipovetsky i in. (2011) opisują go jako granice wyznaczone przez punkty marginalnej taniości i drogości.
Jak może zmylić. Źródła różnią się tym, które krzywe przecinać. W wariancie „za tanio” × „drogo” i „tanio” × „za drogo” te same dane dają przedział 29.0–39.9 zł, czyli dwa razy węższy. Podaj w pracy, którą wersję liczysz. Krzywe są schodkowe, bo ludzie zaokrąglają do 5 zł; przecięcia często wypadają na „okrągłych” kwotach. Żaden punkt nie jest ceną maksymalizującą przychód: metoda nie pyta, czy ktoś kupi.
Podpis do pracy:
Zdanie do Wyników:
Nielogiczne odpowiedzi i niepewność punktów
Zanim policzysz krzywe, sprawdź każdą czwórkę odpowiedzi (zasady ogólne – hasło czyszczenie danych z ankiety online). W metodzie van Westendorpa reguły są proste: progi muszą rosnąć od „za tanio” do „za drogo”, nie mogą być wszystkie takie same i muszą mieścić się w rozsądnym zakresie (tu 1–300 zł). Ta sama kwota w czterech pytaniach przypomina straightlining. Ward i Meade (2023) radzą takim odpowiedziom zapobiegać, wykrywać je i opisywać w raporcie, jak je usunięto.
Ile znaczy pojedynczy wynik z próby 558 osób? Odpowiada na to bootstrap (Efron, 1979): losujemy 2000 razy 558 osób ze zwracaniem, w każdej próbie liczymy cztery punkty od nowa i bierzemy 2.5 i 97.5 percentyl. Mechanizm krok po kroku pokazuje wpis bootstrap – wizualizacja na obrazkach.
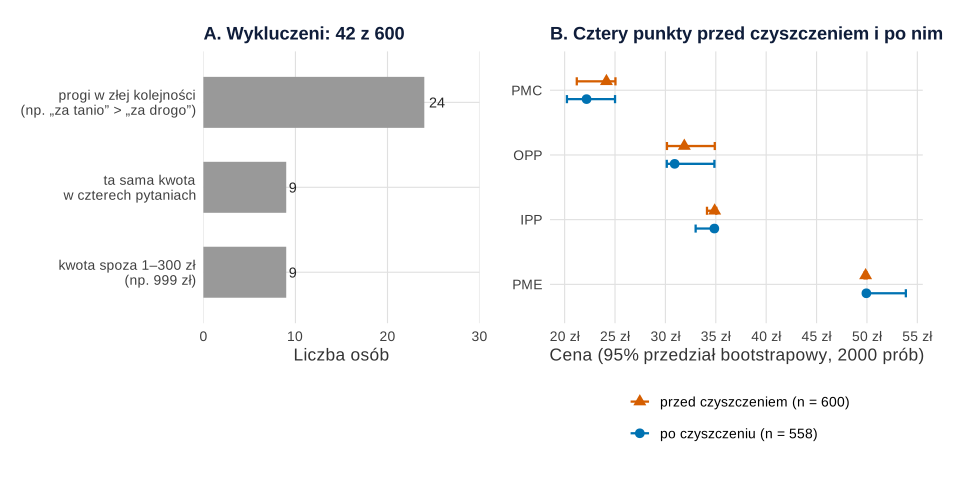
set.seed(619)).Co widać. Z 600 osób odpadły 42: 24 z progami w złej kolejności, 9 z tą samą kwotą i 9 z kwotą spoza zakresu. Krzywe okazały się dość odporne. Najbardziej przesunął się PMC: z 24.2 zł przed czyszczeniem do 22.2 zł po nim. Za to średnia odpowiedzi „za drogo” spadła po czyszczeniu ze 102.2 do 63.6 zł, bo kilka osób wpisało 999 albo 5000 zł. Dlatego średnich progów nie raportuj, a do opisu używaj median i krzywych (por. obserwacja odstająca).
Przedziały po czyszczeniu: PMC 22.2 zł, 95% CI [20.2, 25.0]; OPP 30.9 zł [30.1, 34.9]; IPP 34.9 zł [33.0, 35.0]; PME 49.9 zł [49.8, 53.9]. Szerokość przedziału akceptowalnych cen: 27.8 zł [25.9, 29.7].
Jak może zmylić. Przedziały są nierówne i „przyklejone” do 25, 35 i 50 zł, bo tam leżą zaokrąglone odpowiedzi. To nie błąd bootstrapu, tylko cecha danych. Wąski przedział dla PME nie znaczy, że 49.9 zł to „prawdziwa” granica dla rynku: bootstrap mierzy tylko losowość próby. Lipovetsky i in. (2011) zwracają uwagę, że krzywe bywają niestabilne przy zmianie próby, a przedział – szeroki.
Podpis do pracy:
Zdanie do Metody:
Gabor–Granger: popyt, przychód i zakotwiczenie
Druga połowa ankiety odpowiadała na pytanie „Czy wykupił(a)byś abonament za X zł miesięcznie?” przy sześciu cenach: 19, 29, 39, 49, 59 i 69 zł. Lipovetsky i in. (2011) wymieniają tę technikę Gabora–Grangera obok metody van Westendorpa jako sposób ustalania ceny w badaniach marketingowych. Odsetek odpowiedzi „tak” przy każdej cenie to deklarowana krzywa popytu. Cena razy ten odsetek to przychód na 100 zapytanych osób.
Kolejność cen ma znaczenie. Dlatego randomizacja przydzieliła połowie osób ceny rosnąco (od 19 zł), a połowie malejąco (od 69 zł). Odpowiedź nielogiczna to „tak” przy wyższej cenie po „nie” przy niższej. Takich osób było 19 i wszystkie należały do 24 odpowiadających losowo. Pięciu nieuważnych przypadkiem odpowiedziało spójnie i zostało w danych. Po wykluczeniu zostało 581 osób.
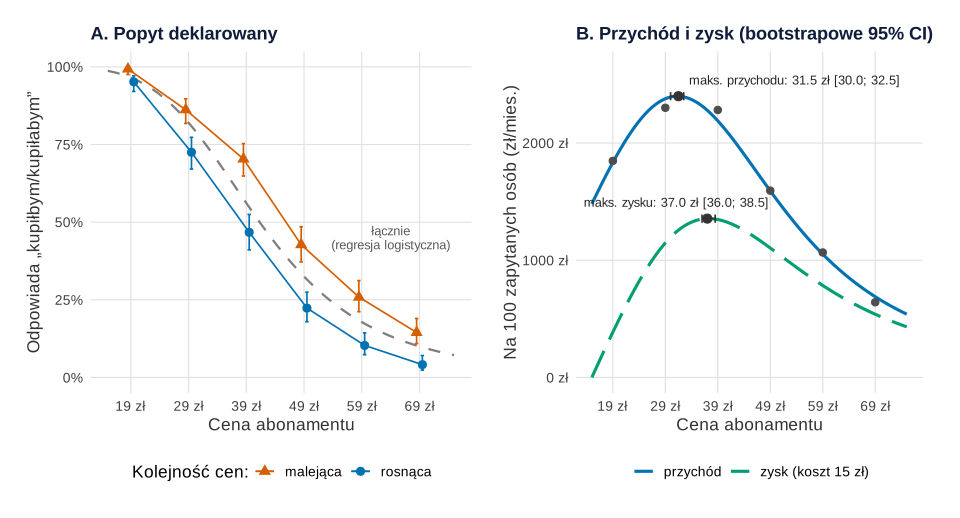
set.seed(619)).Co widać. Panel A: przy 39 zł „tak” odpowiedziało 46.7% osób, które zaczynały od 19 zł (95% CI [41.1, 52.5]), i 70.3% osób, które zaczynały od 69 zł [64.8, 75.3]. To efekt zakotwiczenia: pierwsza cena ustawia punkt odniesienia dla kolejnych. Ariely i in. (2003) pokazali, że nawet przypadkowe kotwice silnie przesuwają wyceny, a kolejne odpowiedzi są z nimi „spójne”, co daje złudzenie stabilnych preferencji. Panel B: krzywa łączna to regresja logistyczna odpowiedzi „tak” na logarytm ceny. Przychód jest największy przy 31.5 zł (bootstrap osób, 1000 prób: 95% CI [30.0, 32.5]). Przy koszcie obsługi 15 zł na abonenta zysk jest największy przy 37.0 zł [36.0, 38.5].
Jak może zmylić. Gdyby wszyscy dostali ceny rosnąco, popyt wyszedłby zaniżony; gdyby malejąco – zawyżony. Losowa kolejność nie usuwa kotwicy z odpowiedzi pojedynczej osoby, tylko ją równoważy w średniej. Przedziały Wilsona (zob. przedział ufności dla proporcji) dotyczą każdej ceny osobno, choć te same osoby odpowiadają przy wszystkich cenach. Dlatego przedział dla ceny optymalnej liczymy bootstrapem po osobach, a nie po odpowiedziach. Wąski przedział wynika też z założonego kształtu krzywej logistycznej.
Podpis do pracy:
Zdanie do Wyników:
Deklaracje a zakupy
Ankieta mierzy deklaracje. W symulacji znamy też prawdziwe zachowanie: ci sami ludzie zapłaciliby 1.3 raza mniej (mediana gotowości do zapłaty 31.7 zł zamiast deklarowanych 41.2 zł). Sprawdzamy też drugi wariant Gabora–Grangera: każda osoba widzi tylko jedną cenę wylosowaną z puli (od 89 do 115 osób na cenę), więc nie ma kotwicy z poprzednich pytań.
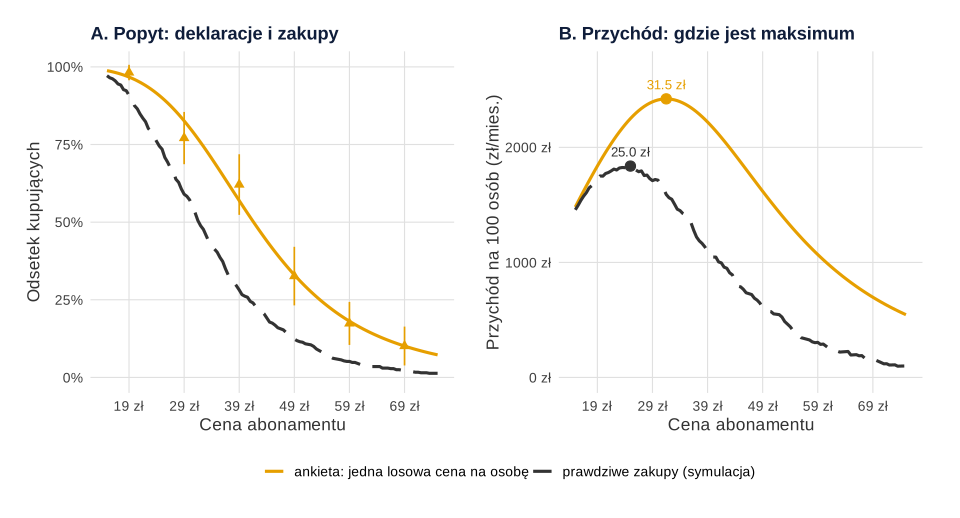
set.seed(619)).Co widać. Wersja z jedną losową ceną dała to samo maksimum przychodu co sześć cen w losowej kolejności: 31.5 zł. Zrównoważenie kolejności działa. Obie wersje zawyżają jednak popyt, bo obie mierzą deklaracje. Przychód z prawdziwych zakupów jest największy przy 25.0 zł, a zysk przy 30.0 zł. Gdyby serwis ustalił cenę 31.5 zł, w rzeczywistości uzyskałby 1591 zł zamiast 1838 zł na 100 osób, czyli o 13.4% mniej.
Jak może zmylić. Współczynnik 1.3 jest założeniem tej symulacji, a nie stałą przyrody. Miller i in. (2011) porównali kilka metod z danymi o prawdziwych zakupach: odpowiedzi hipotetyczne były obciążone, ale mimo to mogły prowadzić do trafnych krzywych popytu i decyzji cenowych. Kloss i Kunter (2016) opisują obciążenie wyników metody van Westendorpa przy dobrej trafności predykcyjnej. Wielkość obciążenia na Twoim rynku pokaże dopiero porównanie z prawdziwymi zakupami.
Podpis do pracy:
Van Westendorp czy Gabor–Granger?
| Cecha | Van Westendorp | Gabor–Granger |
|---|---|---|
| Co pokazujesz respondentowi | nic – podaje własne kwoty | konkretne ceny |
| Wynik | przedział akceptowalnych cen i cztery punkty | krzywa popytu, cena maksymalizująca przychód lub zysk |
| W przykładzie | 22.2–49.9 zł, OPP 30.9 zł | przychód: 31.5 zł; zysk: 37.0 zł |
| Główna pułapka | nielogiczne odpowiedzi, wybór wariantu przecięć | zakotwiczenie pierwszą ceną |
| Wspólny problem | deklaracje zamiast zakupów, brak konkurencji | deklaracje zamiast zakupów, brak konkurencji |
Gdy ważna jest cena na tle cech oferty i konkurencji, sięgnij po analizę conjoint; analizę wyborów między abonamentami pokazuje wpis conjoint wyborczy (CBC).
Co z tym zrobić w marketingu
- Przedział z metody van Westendorpa (22–50 zł) traktuj jako granice rozmowy o cenie, a nie jako odpowiedź. Ceny poniżej PMC grożą sygnałem „tanie = słabe”.
- Cenę startową wybieraj z krzywej przychodu lub zysku Gabora–Grangera, ale przesuń ją w dół: deklaracje zwykle zawyżają popyt. W przykładzie optimum z ankiety (31.5 zł) leżało powyżej prawdziwego (25.0 zł).
- Sprawdź cenę na prawdziwych zakupach: dwie ceny w teście A/B na stronie zapisu albo w dwóch dzielnicach. Ankieta zawęża wybór, test go rozstrzyga.
- Licz zysk, nie tylko przychód. Przy koszcie 15 zł na abonenta najlepsza cena z ankiety rośnie z 31.5 do 37.0 zł.
Jak opisać w pracy
W Metodzie opisz podział na moduły, treść pytań, wariant przecięć, reguły czyszczenia i kolejność cen. W Wynikach podaj liczbę wykluczonych, punkty i cenę maksymalizującą przychód z przedziałami. W ograniczeniach napisz wprost, że to deklaracje. Więcej przykładów z prac z marketingu zebrano we wpisie statystyka w pracy z marketingu.
Kod R: van Westendorp i Gabor–Granger krok po kroku
Kod odtwarza wszystkie liczby z tekstu, pięć rysunków i dwa pliki CSV. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę i motyw, przepis 2 – dane i funkcje do punktów, z których korzysta przepis 3, a przepis 5 korzysta z obiektów przepisu 4. Wszystko liczy bazowy R (ecdf(), glm(), bootstrap pętlą replicate()); rysunki – ggplot2 i patchwork. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 2–5; każdy losujący blok zaczyna się od własnego set.seed(619). Ziarno 619 ustalono raz i nie zmieniano go. Ręcznie ustalono: w module van Westendorpa „cenę odniesienia” (mediana 36 zł, odchylenie logarytmu 0.35), przesunięcia progów (exp(−0.65), exp(−0.30), exp(0.20), exp(0.50)), 70% osób zaokrąglających do 5 zł oraz 24 odwrócone, 9 absurdalnych i 9 jednakowych czwórek odpowiedzi; w module Gabora–Grangera sześć cen (19–69 zł), deklarowaną gotowość do zapłaty (mediana 40 zł, odchylenie logarytmu 0.40), mnożniki kotwicy 0.90 i 1.12, 24 osoby odpowiadające losowo, koszt obsługi 15 zł i obciążenie deklaracji 1.3. Parametrów nie zmieniano po obejrzeniu wyników. Całość liczy się w ok. 10 sekund.
1. Paleta, motyw i schemat czterech pytań: Rysunek 1
R
# Rysunek 1. Cztery pytania van Westendorpa – od odpowiedzi jednej osoby do krzywych (grafika)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw – korzystają z nich kolejne przepisy
kol <- c(za_tanio = "#56B4E9", tanio = "#0072B2", drogo = "#E69F00", za_drogo = "#D55E00",
         zielony = "#009E73", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Cztery karty z pytaniami i odpowiedziami jednej (fikcyjnej) respondentki
karty <- data.frame(
  x = 1:4,
  naglowek = c("1. Za tanio", "2. Tanio", "3. Drogo", "4. Za drogo"),
  pytanie = c("Przy jakiej cenie abonament\nbyłby tak tani, że\nzwątpił(a)byś w jakość\nserwisu i go nie kupił(a)?",
              "Przy jakiej cenie\nabonament wydałby się\nokazją – tani,\nale wart swojej ceny?",
              "Przy jakiej cenie\nzacząłby się wydawać\ndrogi, choć wciąż\nbyś go rozważył(a)?",
              "Przy jakiej cenie\nbyłby tak drogi, że\nnie rozważył(a)byś\njego zakupu?"),
  odpowiedz = c(15, 25, 45, 60),
  kolor = kol[c("za_tanio", "tanio", "drogo", "za_drogo")])
os_y <- 1.25                                         # wysokość osi cen pod kartami
skala_x <- function(cena) 0.55 + cena / 80 * 3.9     # cena 0–80 zł → szerokość rysunku
p1 <- ggplot() +
  geom_rect(data = karty, aes(xmin = x - 0.46, xmax = x + 0.46, ymin = 2.55, ymax = 6.05), fill = "grey97",
            colour = "grey80", linewidth = 0.4) +
  geom_rect(data = karty, aes(xmin = x - 0.46, xmax = x + 0.46, ymin = 5.45, ymax = 6.05, fill = kolor)) +
  geom_text(data = karty, aes(x, 5.75, label = naglowek), colour = "white", fontface = "bold", size = 4.6) +
  geom_text(data = karty, aes(x, 4.35, label = pytanie), size = 3.6, lineheight = 0.95, colour = "grey15") +
  geom_text(data = karty, aes(x, 2.95, label = paste0("Respondentka nr 17: ", odpowiedz, " zł")),
            size = 3.6, fontface = "bold", colour = "grey15") +
  # oś cen z czterema progami tej samej osoby
  annotate("segment", x = skala_x(0), xend = skala_x(80), y = os_y, yend = os_y, colour = "grey40",
           arrow = arrow(length = unit(2, "mm"), type = "closed")) +
  annotate("text", x = skala_x(seq(0, 80, 10)), y = os_y - 0.28, label = paste(seq(0, 80, 10), "zł"),
           size = 3.4, colour = "grey30") +
  annotate("rect", xmin = skala_x(15), xmax = skala_x(60), ymin = os_y - 0.1, ymax = os_y + 0.1,
           fill = kol[["zielony"]], alpha = 0.35) +
  annotate("text", x = skala_x(37.5), y = os_y - 0.62, label = "dla niej cena do rozważenia: od 15 do 60 zł",
           size = 3.6, colour = "grey15") +
  geom_segment(data = karty, aes(x = x, xend = skala_x(odpowiedz), y = 2.55, yend = os_y + 0.14, colour = kolor),
               linewidth = 0.6, arrow = arrow(length = unit(2, "mm"))) +
  geom_point(data = karty, aes(skala_x(odpowiedz), os_y, fill = kolor), shape = 21, size = 4, colour = "grey15") +
  annotate("text", x = 2.5, y = 0.05, size = 3.7, colour = "grey15", fontface = "italic",
           label = "600 takich czwórek odpowiedzi → cztery krzywe skumulowane (rysunek 2)") +
  scale_fill_identity() + scale_colour_identity() +
  scale_x_continuous(limits = c(0.5, 4.5), expand = c(0, 0)) + scale_y_continuous(limits = c(-0.1, 6.1)) +
  labs(title = "Cztery pytania van Westendorpa o abonament serwisowy",
       subtitle = "Każda osoba podaje własne cztery progi ceny (zł miesięcznie); nie pokazujemy jej żadnej ceny") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p1   # zapis: ggsave("badanie-ceny-schemat-czterech-pytan.svg", p1, width = 10, height = 6.2)
2. Dane van Westendorpa, czyszczenie, krzywe i punkty: Rysunek 2 i plik CSV
R
# Rysunek 2. Cztery krzywe skumulowane van Westendorpa i punkty OPP, IPP, PMC, PME (dane symulowane)
# Korzysta z palety kol i motywu motyw z przepisu 1.
library(ggplot2)

# Fikcyjny serwis rowerowy planuje abonament: przegląd co kwartał, naprawy bez opłaty za robociznę,
# rower zastępczy. Ankieta online wśród 600 osób dojeżdżających rowerem do pracy (moduł van Westendorpa).
# Parametry ustalone ręcznie: „cena odniesienia” osoby ~ lognormalny (mediana 36 zł, sdlog 0.35),
# progi to ta cena razy exp(−0.65), exp(−0.30), exp(0.20), exp(0.50) z szumem; 70% osób zaokrągla do 5 zł.
set.seed(619)                                    # ziarno ustalone raz, bez dobierania pod wynik
n_psm <- 600
odniesienie <- exp(rnorm(n_psm, log(36), 0.35))
prog <- function(przesuniecie, szum) odniesienie * exp(przesuniecie + rnorm(n_psm, 0, szum))
psm <- data.frame(id = 1:n_psm, za_tanio = prog(-0.65, 0.12), tanio = prog(-0.30, 0.10),
                  drogo = prog(0.20, 0.10), za_drogo = prog(0.50, 0.12))
do_piatki <- runif(n_psm) < 0.70                 # zaokrąglanie „do piątki”, jak w prawdziwych ankietach
for (v in c("za_tanio", "tanio", "drogo", "za_drogo"))
  psm[[v]] <- ifelse(do_piatki, 5 * round(psm[[v]] / 5), round(psm[[v]]))
psm[, 2:5] <- t(apply(psm[, 2:5], 1, sort))      # uważne osoby odpowiadają w logicznej kolejności

# Nielogiczne odpowiedzi (wstawione ręcznie): 24 osoby odwracają skalę, 9 wpisuje absurdalną kwotę,
# 9 podaje tę samą kwotę w czterech pytaniach
odwrocone <- sample(n_psm, 24)
psm[odwrocone, 2:5] <- psm[odwrocone, 5:2]
absurd <- sample(setdiff(1:n_psm, odwrocone), 9)
psm$za_drogo[absurd] <- sample(c(500, 999, 1000, 5000), 9, replace = TRUE)
te_same <- sample(setdiff(1:n_psm, c(odwrocone, absurd)), 9)
psm[te_same, 2:5] <- sample(c(20, 30, 50), 9, replace = TRUE)

# Czyszczenie: kolejność progów, różne skrajne odpowiedzi, kwoty w zakresie 1–300 zł
psm$zla_kolejnosc <- with(psm, !(za_tanio <= tanio & tanio <= drogo & drogo <= za_drogo))
psm$te_same_kwoty <- with(psm, !zla_kolejnosc & za_tanio == za_drogo)
psm$poza_zakresem <- apply(psm[, 2:5] < 1 | psm[, 2:5] > 300, 1, any)
psm$wykluczony <- psm$zla_kolejnosc | psm$te_same_kwoty | psm$poza_zakresem
write.csv(psm, "badanie-ceny-van-westendorp-ankieta.csv", row.names = FALSE)
colSums(psm[, c("zla_kolejnosc", "te_same_kwoty", "poza_zakresem", "wykluczony")])
czyste <- subset(psm, !wykluczony)
nrow(czyste)

# Krzywe: odsetek osób, dla których cena p jest „za tania” (próg ≥ p), „tania” (próg ≥ p),
# „droga” (próg ≤ p) i „za droga” (próg ≤ p); do PMC i PME dochodzą „nie tanio” i „nie drogo”
ceny <- seq(5, 120, by = 0.25)
krzywe <- function(d) {
  ponad <- function(x) 1 - ecdf(x)(ceny - 1e-9)  # odsetek z progiem ≥ p
  data.frame(cena = ceny, za_tanio = ponad(d$za_tanio), tanio = ponad(d$tanio),
             drogo = ecdf(d$drogo)(ceny), za_drogo = ecdf(d$za_drogo)(ceny))
}
przeciecie <- function(f, g) {                    # f maleje, g rośnie: pierwsza cena, gdzie f ≤ g
  r <- f - g; i <- which(r[-length(r)] > 0 & r[-1] <= 0)[1]
  ceny[i] + 0.25 * r[i] / (r[i] - r[i + 1])      # interpolacja liniowa między punktami siatki
}
punkty <- function(d) {
  k <- krzywe(d)
  c(PMC = przeciecie(k$za_tanio, 1 - k$tanio),    # za tanio × nie tanio – dolna granica przedziału
    OPP = przeciecie(k$za_tanio, k$za_drogo),     # za tanio × za drogo – cena optymalna
    IPP = przeciecie(k$tanio, k$drogo),           # tanio × drogo – punkt obojętności
    PME = przeciecie(1 - k$drogo, k$za_drogo))    # nie drogo × za drogo – górna granica przedziału
}
pkt <- punkty(czyste)
round(pkt, 2)
# Wariant spotykany w innych źródłach: PMC = za tanio × drogo, PME = za drogo × tanio
k <- krzywe(czyste)
round(c(PMC_wariant = przeciecie(k$za_tanio, k$drogo), PME_wariant = przeciecie(k$tanio, k$za_drogo)), 2)
round(sapply(czyste[, 2:5], median), 1)          # mediany progów

# Rysunek: cztery krzywe (pełne) i dwie dopełniające (cienkie kropkowane), przedział akceptowalnych cen
dl <- rbind(data.frame(cena = ceny, odsetek = k$za_tanio, krzywa = "za tanio"),
            data.frame(cena = ceny, odsetek = k$tanio, krzywa = "tanio"),
            data.frame(cena = ceny, odsetek = k$drogo, krzywa = "drogo"),
            data.frame(cena = ceny, odsetek = k$za_drogo, krzywa = "za drogo"))
dl$krzywa <- factor(dl$krzywa, c("za tanio", "tanio", "drogo", "za drogo"))
dop <- rbind(data.frame(cena = ceny, odsetek = 1 - k$tanio, krzywa = "nie tanio"),
             data.frame(cena = ceny, odsetek = 1 - k$drogo, krzywa = "nie drogo"))
wys <- c(PMC = approx(ceny, k$za_tanio, pkt[["PMC"]])$y, OPP = approx(ceny, k$za_tanio, pkt[["OPP"]])$y,
         IPP = approx(ceny, k$tanio, pkt[["IPP"]])$y, PME = approx(ceny, k$za_drogo, pkt[["PME"]])$y)
oznacz <- data.frame(punkt = names(pkt), cena = pkt, y = wys, etykieta = sprintf("%s\n%.1f zł", names(pkt), pkt),
                     dx = c(-3.5, 5, 0, -3.5), dy = c(0.10, 0.06, 0.12, 0.10))
x_nt <- ceny[which(1 - k$tanio >= 0.85)[1]]      # gdzie podpisać krzywe dopełniające
x_nd <- ceny[which(1 - k$drogo <= 0.15)[1]]
p2 <- ggplot(dl, aes(cena, odsetek)) +
  annotate("rect", xmin = pkt[["PMC"]], xmax = pkt[["PME"]], ymin = -Inf, ymax = Inf, fill = kol[["zielony"]],
           alpha = 0.10) +
  annotate("text", x = mean(pkt[c("PMC", "PME")]), y = 1.04, size = 3.6, colour = "grey20",
           label = sprintf("przedział akceptowalnych cen: %.1f–%.1f zł", pkt[["PMC"]], pkt[["PME"]])) +
  geom_line(data = dop, aes(group = krzywa), colour = "grey45", linetype = "dotted", linewidth = 0.7) +
  annotate("text", x = c(x_nt, x_nd) + 1.5, y = c(0.85, 0.19), label = c("nie tanio", "nie drogo"), hjust = 0, size = 3.4,
           colour = "grey35") +
  geom_step(aes(colour = krzywa, linetype = krzywa), linewidth = 1.1) +
  geom_point(data = oznacz, aes(cena, y), inherit.aes = FALSE, shape = 21, size = 3.2, fill = "white",
             colour = "grey10", stroke = 1.1) +
  geom_label(data = oznacz, aes(cena + dx, y + dy, label = etykieta), inherit.aes = FALSE, size = 3.4,
             lineheight = 0.9, colour = "grey10", fill = "white", alpha = 0.85, linewidth = 0) +
  scale_colour_manual(values = c("za tanio" = kol[["za_tanio"]], "tanio" = kol[["tanio"]],
                                 "drogo" = kol[["drogo"]], "za drogo" = kol[["za_drogo"]]), name = NULL) +
  scale_linetype_manual(values = c("za tanio" = "solid", "tanio" = "longdash", "drogo" = "longdash",
                                   "za drogo" = "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(10, 100, 10), labels = function(x) paste(x, "zł")) +
  scale_y_continuous(labels = scales::percent, breaks = seq(0, 1, 0.25)) +
  coord_cartesian(xlim = c(8, 100), ylim = c(0, 1.06)) +
  labs(x = "Cena abonamentu (zł miesięcznie)", y = "Odsetek respondentów",
       title = "Krzywe van Westendorpa: abonament serwisowy",
       subtitle = sprintf("n = %d po czyszczeniu; kropkowane: „nie tanio” = 1 − tanio, „nie drogo” = 1 − drogo",
                         nrow(czyste))) +
  motyw + theme(legend.key.width = unit(1.4, "cm"))
p2   # zapis: ggsave("badanie-ceny-krzywe-van-westendorpa.svg", p2, width = 10, height = 6)
Wynik w R
zla_kolejnosc te_same_kwoty poza_zakresem    wykluczony
           24             9             9            42
[1] 558
  PMC   OPP   IPP   PME
22.18 30.92 34.86 49.94
PMC_wariant PME_wariant
      29.00       39.87
za_tanio    tanio    drogo za_drogo
      20       25       45       60
3. Czyszczenie a wynik i bootstrap punktów: Rysunek 3
R
# Rysunek 3. Nielogiczne odpowiedzi i bootstrapowe 95% przedziały dla czterech punktów cenowych
# Korzysta z kol, motyw, psm, czyste i funkcji punkty() z przepisów 1–2.
library(ggplot2)
library(patchwork)

# Co robią nielogiczne odpowiedzi? Punkty i średnie przed czyszczeniem i po nim
round(rbind(przed = punkty(psm), po = punkty(czyste)), 2)
round(rbind(przed = colMeans(psm[, 2:5]), po = colMeans(czyste[, 2:5])), 1)   # średnie progów

# Bootstrap: 2000 prób osób ze zwracaniem, w każdej cztery punkty od nowa; przedział percentylowy 95%
bootstrap_punktow <- function(d, B = 2000) t(replicate(B, punkty(d[sample(nrow(d), replace = TRUE), ])))
set.seed(619)                                    # to samo ziarno co w przepisie 2
boot_po <- bootstrap_punktow(czyste)
set.seed(619)
boot_przed <- bootstrap_punktow(psm)
przedzialy <- function(b, d, wersja) data.frame(punkt = colnames(b), wersja = wersja, cena = punkty(d),
                                                dolna = apply(b, 2, quantile, 0.025, na.rm = TRUE),
                                                gorna = apply(b, 2, quantile, 0.975, na.rm = TRUE))
ci <- rbind(przedzialy(boot_przed, psm, "przed czyszczeniem (n = 600)"),
            przedzialy(boot_po, czyste, sprintf("po czyszczeniu (n = %d)", nrow(czyste))))
print(transform(ci, cena = round(cena, 2), dolna = round(dolna, 2), gorna = round(gorna, 2)), row.names = FALSE)
szer <- boot_po[, "PME"] - boot_po[, "PMC"]      # szerokość przedziału akceptowalnych cen
round(c(szerokosc = punkty(czyste)[["PME"]] - punkty(czyste)[["PMC"]], quantile(szer, c(0.025, 0.975))), 2)

# Rysunek: A – ile osób odpadło i dlaczego; B – punkty z przedziałami przed i po czyszczeniu
powody <- data.frame(powod = c("progi w złej kolejności\n(np. „za tanio” > „za drogo”)",
                               "ta sama kwota\nw czterech pytaniach", "kwota spoza 1–300 zł\n(np. 999 zł)"),
                     n = c(sum(psm$zla_kolejnosc), sum(psm$te_same_kwoty), sum(psm$poza_zakresem)))
powody$powod <- factor(powody$powod, rev(powody$powod))
pA <- ggplot(powody, aes(n, powod)) +
  geom_col(fill = kol[["szary"]], width = 0.6) +
  geom_text(aes(label = n), hjust = -0.3, size = 3.8, colour = "grey15") +
  scale_x_continuous(limits = c(0, 30), expand = c(0, 0)) +
  labs(x = "Liczba osób", y = NULL, title = sprintf("A. Wykluczeni: %d z 600", sum(psm$wykluczony))) + motyw
ci$punkt <- factor(ci$punkt, rev(c("PMC", "OPP", "IPP", "PME")))
ci$wersja <- factor(ci$wersja, rev(unique(ci$wersja)))   # „przed” rysowane nad „po”
pB <- ggplot(ci, aes(cena, punkt, colour = wersja, shape = wersja)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), orientation = "y", width = 0.25, linewidth = 0.8,
                 position = position_dodge(width = 0.55)) +
  geom_point(size = 3, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = c(kol[["tanio"]], kol[["za_drogo"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = seq(15, 60, 5), labels = function(x) paste(x, "zł")) +
  labs(x = "Cena (95% przedział bootstrapowy, 2000 prób)", y = NULL,
       title = "B. Cztery punkty przed czyszczeniem i po nim") +
  motyw + guides(colour = guide_legend(nrow = 2, reverse = TRUE), shape = guide_legend(nrow = 2, reverse = TRUE))
p3 <- pA + pB + plot_layout(widths = c(1, 1.35))
p3   # zapis: ggsave("badanie-ceny-czyszczenie-i-bootstrap.svg", p3, width = 10, height = 5)
Wynik w R
        PMC   OPP   IPP   PME
przed 24.15 31.88 34.89 49.87
po    22.18 30.92 34.86 49.94
      za_tanio tanio drogo za_drogo
przed     22.1  29.3  46.4    102.2
po        19.9  28.1  47.1     63.6
 punkt                       wersja  cena dolna gorna
   PMC przed czyszczeniem (n = 600) 24.15 21.20 25.04
   OPP przed czyszczeniem (n = 600) 31.88 30.15 34.90
   IPP przed czyszczeniem (n = 600) 34.89 34.12 35.05
   PME przed czyszczeniem (n = 600) 49.87 49.76 49.98
   PMC     po czyszczeniu (n = 558) 22.18 20.23 25.00
   OPP     po czyszczeniu (n = 558) 30.92 30.13 34.86
   IPP     po czyszczeniu (n = 558) 34.86 33.00 35.03
   PME     po czyszczeniu (n = 558) 49.94 49.83 53.86
szerokosc      2.5%     97.5%
    27.77     25.93     29.73
4. Gabor–Granger: popyt, przychód i zysk: Rysunek 4 i plik CSV
R
# Rysunek 4. Gabor–Granger: krzywa popytu przy dwóch kolejnościach cen i krzywa przychodu (dane symulowane)
# Korzysta z palety kol i motywu motyw z przepisu 1.
library(ggplot2)
library(patchwork)

# Druga, losowo wybrana połowa ankiety (600 innych osób) dostała moduł Gabora–Grangera:
# sześć cen po kolei i pytanie „Czy wykupił(a)byś abonament za X zł miesięcznie?” (tak/nie).
# Kolejność cen losowana: rosnąca (od 19 zł) albo malejąca (od 69 zł) – po 300 osób.
# Parametry ustalone ręcznie: deklarowana gotowość do zapłaty ~ lognormalny (mediana 40 zł, sdlog 0.40);
# kotwica pierwszej ceny mnoży ją przez 0.90 (start od 19 zł) albo 1.12 (start od 69 zł);
# 24 osoby odpowiadają losowo (nieuważnie).
set.seed(619)
n_gg <- 600
ceny_gg <- c(19, 29, 39, 49, 59, 69)
kolejnosc <- sample(rep(c("rosnąca", "malejąca"), each = n_gg / 2))
gotowosc <- exp(rnorm(n_gg, log(40), 0.40))       # deklarowana gotowość do zapłaty bez kotwicy
kotwica <- ifelse(kolejnosc == "malejąca", 1.12, 0.90)
tak <- outer(gotowosc * kotwica, ceny_gg, ">=")   # wiersz = osoba, kolumna = cena
nieuwazni <- sample(n_gg, 24)
tak[nieuwazni, ] <- runif(24 * 6) < 0.5
gg <- data.frame(id = 1:n_gg, kolejnosc, tak * 1)
names(gg)[3:8] <- paste0("cena_", ceny_gg)
# Czyszczenie: „tak” przy wyższej cenie po „nie” przy niższej to odpowiedź nielogiczna
gg$nielogiczna <- apply(tak, 1, function(w) any(diff(w) > 0))
write.csv(gg, "badanie-ceny-gabor-granger-ankieta.csv", row.names = FALSE)
c(nielogiczne = sum(gg$nielogiczna), w_tym_nieuwazni = sum(gg$nielogiczna[nieuwazni]))
gg_c <- subset(gg, !nielogiczna)
table(gg_c$kolejnosc)

# Popyt: odsetek „tak” przy każdej cenie, z 95% przedziałem Wilsona, osobno dla kolejności i łącznie
wilson <- function(x, n) {
  p <- x / n; z <- 1.96; s <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  c(p = p, dolna = (p + z^2 / (2 * n)) / (1 + z^2 / n) - s, gorna = (p + z^2 / (2 * n)) / (1 + z^2 / n) + s)
}
popyt <- do.call(rbind, lapply(c("rosnąca", "malejąca", "łącznie"), function(k) {
  d <- if (k == "łącznie") gg_c else subset(gg_c, kolejnosc == k)
  do.call(rbind, lapply(seq_along(ceny_gg), function(j)
    data.frame(kolejnosc = k, cena = ceny_gg[j], t(wilson(sum(d[[2 + j]]), nrow(d))))))
}))
popyt$przychod_na_100 <- 100 * popyt$cena * popyt$p   # przychód miesięczny na 100 zapytanych osób (zł)
print(transform(popyt, p = round(100 * p, 1), dolna = round(100 * dolna, 1), gorna = round(100 * gorna, 1),
                przychod_na_100 = round(przychod_na_100)), row.names = FALSE)

# Gładka krzywa popytu: regresja logistyczna „tak” na log(cena) na danych łącznych (6 odpowiedzi na osobę)
dlugie <- function(d) data.frame(id = rep(d$id, 6), cena = rep(ceny_gg, each = nrow(d)),
                                 tak = unlist(d[, 3:8]), use.names = FALSE)
siatka <- seq(15, 75, by = 0.5)
koszt <- 15                                      # koszt obsługi abonenta miesięcznie (zł) – założenie ręczne
optimum <- function(d) {
  m <- glm(tak ~ log(cena), binomial, data = dlugie(d))
  udzial <- predict(m, data.frame(cena = siatka), type = "response")
  c(cena_max_przychod = siatka[which.max(siatka * udzial)],
    cena_max_zysk = siatka[which.max((siatka - koszt) * udzial)])
}
opt <- optimum(gg_c)
opt
set.seed(619)
boot_opt <- t(replicate(1000, optimum(gg_c[sample(nrow(gg_c), replace = TRUE), ])))   # bootstrap osób
round(apply(boot_opt, 2, quantile, c(0.025, 0.975)), 1)

# Rysunek: A – popyt przy dwóch kolejnościach cen; B – przychód i zysk z krzywej łącznej
m_l <- glm(tak ~ log(cena), binomial, data = dlugie(gg_c))
gladka <- data.frame(cena = siatka, udzial = predict(m_l, data.frame(cena = siatka), type = "response"))
gladka$przychod <- 100 * gladka$cena * gladka$udzial
gladka$zysk <- 100 * (gladka$cena - koszt) * gladka$udzial
pop_k <- subset(popyt, kolejnosc != "łącznie")
przedz <- apply(boot_opt, 2, quantile, c(0.025, 0.975))
maksima <- data.frame(x = opt, y = c(max(gladka$przychod), max(gladka$zysk)), dolna = przedz[1, ], gorna = przedz[2, ],
                      etykieta = sprintf("maks. %s: %.1f zł [%.1f; %.1f]", c("przychodu", "zysku"), opt,
                                         przedz[1, ], przedz[2, ]),
                      tx = c(przedz[2, 1] + 1, opt[[2]] - 6), hj = c(0, 0.5))
pA <- ggplot(pop_k, aes(cena, p, colour = kolejnosc, shape = kolejnosc)) +
  geom_line(data = gladka, aes(cena, udzial), inherit.aes = FALSE, colour = "grey50", linewidth = 0.8,
            linetype = "dashed") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 1.2, position = position_dodge(2)) +
  geom_line(position = position_dodge(2)) + geom_point(size = 2.8, position = position_dodge(2)) +
  annotate("text", x = 64, y = 0.45, label = "łącznie\n(regresja logistyczna)", size = 3.4,
           colour = "grey35", lineheight = 0.9) +
  scale_colour_manual(values = c("rosnąca" = kol[["tanio"]], "malejąca" = kol[["za_drogo"]]),
                      name = "Kolejność cen:") +
  scale_shape_manual(values = c("rosnąca" = 16, "malejąca" = 17), name = "Kolejność cen:") +
  scale_x_continuous(breaks = ceny_gg, labels = function(x) paste(x, "zł")) +
  scale_y_continuous(labels = scales::percent, limits = c(0, 1)) +
  labs(x = "Cena abonamentu", y = "Odpowiada „kupiłbym/kupiłabym”", title = "A. Popyt deklarowany") + motyw
pB <- ggplot(gladka, aes(cena)) +
  geom_line(aes(y = przychod, linetype = "przychód"), colour = kol[["tanio"]], linewidth = 1.1) +
  geom_line(aes(y = zysk, linetype = "zysk (koszt 15 zł)"), colour = kol[["zielony"]], linewidth = 1.1) +
  geom_errorbar(data = maksima, aes(y = y, xmin = dolna, xmax = gorna), inherit.aes = FALSE, orientation = "y",
                width = 70, colour = "grey20") +
  geom_point(data = maksima, aes(x = x, y = y), inherit.aes = FALSE, size = 2.8, colour = "grey20") +
  geom_text(data = maksima, aes(x = tx, y = y + 140, label = etykieta, hjust = hj), inherit.aes = FALSE,
            size = 3.4, colour = "grey15") +
  geom_point(data = subset(popyt, kolejnosc == "łącznie"), aes(cena, przychod_na_100), colour = "grey30",
             size = 2.2) +
  scale_linetype_manual(values = c("przychód" = "solid", "zysk (koszt 15 zł)" = "longdash"), name = NULL) +
  scale_x_continuous(breaks = ceny_gg, labels = function(x) paste(x, "zł")) +
  scale_y_continuous(limits = c(0, 2650), labels = function(x) paste(x, "zł")) +
  labs(x = "Cena abonamentu", y = "Na 100 zapytanych osób (zł/mies.)",
       title = "B. Przychód i zysk (bootstrapowe 95% CI)") + motyw
p4 <- pA + pB + plot_layout(widths = c(1.1, 1))
p4   # zapis: ggsave("badanie-ceny-gabor-granger.svg", p4, width = 10, height = 5.4)
Wynik w R
    nielogiczne w_tym_nieuwazni
             19              19

malejąca  rosnąca
     290      291
 kolejnosc cena    p dolna gorna przychod_na_100
   rosnąca   19 95.2  92.1  97.1            1809
   rosnąca   29 72.5  67.1  77.3            2103
   rosnąca   39 46.7  41.1  52.5            1823
   rosnąca   49 22.3  17.9  27.5            1095
   rosnąca   59 10.3   7.3  14.3             608
   rosnąca   69  4.1   2.4   7.1             285
  malejąca   19 99.3  97.5  99.8            1887
  malejąca   29 86.2  81.8  89.7            2500
  malejąca   39 70.3  64.8  75.3            2743
  malejąca   49 42.8  37.2  48.5            2095
  malejąca   59 25.9  21.2  31.2            1526
  malejąca   69 14.5  10.9  19.0             999
   łącznie   19 97.2  95.6  98.3            1848
   łącznie   29 79.3  75.9  82.4            2301
   łącznie   39 58.5  54.5  62.5            2282
   łącznie   49 32.5  28.8  36.4            1594
   łącznie   59 18.1  15.2  21.4            1066
   łącznie   69  9.3   7.2  11.9             641
cena_max_przychod     cena_max_zysk
             31.5              37.0
      cena_max_przychod cena_max_zysk
2.5%               30.0          36.0
97.5%              32.5          38.5
5. Deklaracje a zakupy i wersja z jedną ceną: Rysunek 5
R
# Rysunek 5. Deklaracje a zakupy: popyt i przychód z ankiety vs prawdziwe zachowanie (znane w symulacji)
# Korzysta z kol, motyw, ceny_gg, gotowosc, nieuwazni, siatka, gladka i opt z przepisów 1 i 4.
library(ggplot2)
library(patchwork)

# Założenie ręczne: w prawdziwym sklepie ludzie płacą mniej, niż deklarują – prawdziwa gotowość do zapłaty
# to deklarowana podzielona przez 1.3 (obciążenie hipotetyczne; w realnym badaniu tej liczby nie znamy).
prawdziwa <- gotowosc / 1.3
zakup <- sapply(siatka, function(p) mean(prawdziwa >= p))        # odsetek, który naprawdę by kupił
c(mediana_deklarowana = round(median(gotowosc), 1), mediana_prawdziwa = round(median(prawdziwa), 1),
  cena_max_przychod_prawda = siatka[which.max(siatka * zakup)],
  cena_max_zysk_prawda = siatka[which.max((siatka - 15) * zakup)])

# Wersja monadyczna: każda osoba widzi tylko JEDNĄ cenę wylosowaną z puli – bez kotwicy z poprzednich cen
set.seed(619)
cena_mon <- sample(ceny_gg, length(gotowosc), replace = TRUE)
tak_mon <- gotowosc >= cena_mon
tak_mon[nieuwazni] <- runif(length(nieuwazni)) < 0.5            # ci sami nieuważni odpowiadają losowo
table(cena_mon)
m_mon <- glm(tak_mon ~ log(cena_mon), binomial)
udzial_mon <- predict(m_mon, data.frame(cena_mon = siatka), type = "response")
c(cena_max_przychod_monadycznie = siatka[which.max(siatka * udzial_mon)],
  cena_max_przychod_sekwencyjnie = opt[["cena_max_przychod"]])
# Ile przychodu traci serwis, gdy ustali cenę z deklaracji zamiast z prawdziwego optimum?
przychod_prawda <- function(p) 100 * p * mean(prawdziwa >= p)
straty <- c(przy_cenie_z_ankiety = przychod_prawda(opt[["cena_max_przychod"]]),
            przy_prawdziwym_optimum = max(100 * siatka * zakup))
round(c(straty, strata_proc = 100 * (1 - straty[[1]] / straty[[2]])), 1)

# Rysunek: A – popyt; B – przychód na 100 osób z zaznaczonym maksimum
# (krzywa „6 cen po kolei, łącznie” z przepisu 4 niemal pokrywa się z wersją monadyczną, więc jej nie rysujemy)
krzywe5 <- rbind(data.frame(cena = siatka, udzial = udzial_mon, zrodlo = "ankieta: jedna losowa cena na osobę"),
                 data.frame(cena = siatka, udzial = zakup, zrodlo = "prawdziwe zakupy (symulacja)"))
krzywe5$zrodlo <- factor(krzywe5$zrodlo, unique(krzywe5$zrodlo))
krzywe5$przychod <- 100 * krzywe5$cena * krzywe5$udzial
maks <- do.call(rbind, lapply(split(krzywe5, krzywe5$zrodlo), function(d) d[which.max(d$przychod), ]))
punkty_mon <- do.call(rbind, lapply(ceny_gg, function(p) {
  x <- sum(tak_mon[cena_mon == p]); n <- sum(cena_mon == p)
  data.frame(cena = p, udzial = x / n, se = sqrt(x / n * (1 - x / n) / n))
}))
kolory5 <- c(kol[["drogo"]], kol[["ciemny"]])
names(kolory5) <- levels(krzywe5$zrodlo)
typy5 <- setNames(c("solid", "longdash"), levels(krzywe5$zrodlo))
pA <- ggplot(krzywe5, aes(cena, udzial, colour = zrodlo, linetype = zrodlo)) +
  geom_line(linewidth = 1.1) +
  geom_pointrange(data = punkty_mon, aes(cena, udzial, ymin = udzial - 1.96 * se, ymax = udzial + 1.96 * se),
                  inherit.aes = FALSE, colour = kol[["drogo"]], shape = 17, size = 0.5) +
  scale_colour_manual(values = kolory5, name = NULL) + scale_linetype_manual(values = typy5, name = NULL) +
  scale_x_continuous(breaks = ceny_gg, labels = function(x) paste(x, "zł")) +
  scale_y_continuous(labels = scales::percent, breaks = seq(0, 1, 0.25)) + coord_cartesian(ylim = c(0, 1)) +
  labs(x = "Cena abonamentu", y = "Odsetek kupujących", title = "A. Popyt: deklaracje i zakupy") + motyw
pB <- ggplot(krzywe5, aes(cena, przychod, colour = zrodlo, linetype = zrodlo)) +
  geom_line(linewidth = 1.1) +
  geom_point(data = maks, size = 3.2, show.legend = FALSE) +
  geom_text(data = maks, aes(label = sprintf("%.1f zł", cena)), vjust = -1.0, size = 3.5, show.legend = FALSE) +
  scale_colour_manual(values = kolory5, name = NULL) + scale_linetype_manual(values = typy5, name = NULL) +
  scale_x_continuous(breaks = ceny_gg, labels = function(x) paste(x, "zł")) +
  scale_y_continuous(limits = c(0, 2700), labels = function(x) paste(x, "zł")) +
  labs(x = "Cena abonamentu", y = "Przychód na 100 osób (zł/mies.)", title = "B. Przychód: gdzie jest maksimum") +
  motyw
p5 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("badanie-ceny-deklaracje-a-zakupy.svg", p5, width = 10, height = 5.4)
Wynik w R
     mediana_deklarowana        mediana_prawdziwa cena_max_przychod_prawda
                    41.2                     31.7                     25.0
    cena_max_zysk_prawda
                    30.0
cena_mon
 19  29  39  49  59  69
110  96  95  95 115  89
 cena_max_przychod_monadycznie cena_max_przychod_sekwencyjnie
                          31.5                           31.5
   przy_cenie_z_ankiety przy_prawdziwym_optimum             strata_proc
                 1590.8                  1837.5                    13.4
6. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("za tanio – tanio (jasno- i ciemnoniebieski)" = c("#56B4E9", "#0072B2"),
             "drogo – za drogo (pomarańczowy – cynober)" = c("#E69F00", "#D55E00"),
             "tanio – drogo (niebieski – pomarańczowy)" = c("#0072B2", "#E69F00"),
             "za tanio – za drogo (jasnoniebieski – cynober)" = c("#56B4E9", "#D55E00"),
             "przed / po czyszczeniu; rosnąca / malejąca (cynober – niebieski)" = c("#D55E00", "#0072B2"),
             "przychód / zysk (niebieski – zielony)" = c("#0072B2", "#009E73"),
             "jedna cena / zakupy (pomarańczowy – grafit)" = c("#E69F00", "#333333"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                 widzenie_typowe
za tanio – tanio (jasno- i ciemnoniebieski)                                 26.4
drogo – za drogo (pomarańczowy – cynober)                                   33.4
tanio – drogo (niebieski – pomarańczowy)                                   120.2
za tanio – za drogo (jasnoniebieski – cynober)                             113.6
przed / po czyszczeniu; rosnąca / malejąca (cynober – niebieski)           114.6
przychód / zysk (niebieski – zielony)                                       70.1
jedna cena / zakupy (pomarańczowy – grafit)                                 91.0
czerwony – zielony (do unikania)                                           121.7
                                                                 deuteranopia
za tanio – tanio (jasno- i ciemnoniebieski)                              24.7
drogo – za drogo (pomarańczowy – cynober)                                18.4
tanio – drogo (niebieski – pomarańczowy)                                121.5
za tanio – za drogo (jasnoniebieski – cynober)                          101.1
przed / po czyszczeniu; rosnąca / malejąca (cynober – niebieski)        108.3
przychód / zysk (niebieski – zielony)                                    55.4
jedna cena / zakupy (pomarańczowy – grafit)                              89.7
czerwony – zielony (do unikania)                                         21.1
                                                                 protanopia
za tanio – tanio (jasno- i ciemnoniebieski)                            24.6
drogo – za drogo (pomarańczowy – cynober)                              24.9
tanio – drogo (niebieski – pomarańczowy)                              109.3
za tanio – za drogo (jasnoniebieski – cynober)                         89.0
przed / po czyszczeniu; rosnąca / malejąca (cynober – niebieski)       91.9
przychód / zysk (niebieski – zielony)                                  58.0
jedna cena / zakupy (pomarańczowy – grafit)                            83.3
czerwony – zielony (do unikania)                                       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, dystrybuanty empiryczne, regresja logistyczna, bootstrap i przedziały Wilsona – pakiety base i stats). Rysunki wykonano w ggplot2 i patchwork (osie procentowe – pakiet scales); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki w skrócie
- Jedna metoda po drugiej u tych samych osób. Kwoty z pytań van Westendorpa stają się kotwicą dla Gabora–Grangera (i odwrotnie). Losuj moduły albo ich kolejność – por. efekt kolejności pytań.
- Przykładowa kwota w treści pytania („np. 30 zł”) działa jak kotwica dla wszystkich.
- OPP jako „cena optymalna” dla firmy. To punkt najmniejszego odrzucenia ceny, nie maksimum przychodu ani zysku.
- Średnie progów. Kwoty typu 999 zł i odwrócone odpowiedzi podniosły średnią „za drogo” z 63.6 do 102.2 zł; mediany i krzywe są na to odporne.
Pomoc przy projekcie ankiety cenowej i analizie do pracy: analizy statystyczne dla studentów.
Najczęstsze pytania
Czym różni się metoda van Westendorpa od metody Gabora–Grangera?
Van Westendorp nie pokazuje cen – respondent podaje cztery własne progi (za tanio, tanio, drogo, za drogo), a wynikiem jest przedział akceptowalnych cen. Gabor–Granger pokazuje konkretne ceny i pyta, czy osoba kupi, więc daje krzywą popytu i cenę maksymalizującą przychód lub zysk. W przykładzie z abonamentem przedział wyniósł 22.2–49.9 zł, a maksimum przychodu – 31.5 zł.
Jak policzyć przedział ufności dla punktów van Westendorpa?
Bootstrapem: losuj osoby ze zwracaniem (np. 2000 razy), w każdej próbie licz krzywe i cztery przecięcia od nowa, a za granice przedziału weź 2.5 i 97.5 percentyl. Gdy ludzie zaokrąglają kwoty do 5 zł, przedziały bywają nierówne i „przyklejone” do okrągłych kwot.
Czy cena optymalna OPP to cena, przy której firma zarobi najwięcej?
Nie. OPP to cena, przy której najmniej osób uważa produkt za zbyt tani lub zbyt drogi. Metoda van Westendorpa nie pyta o zakup, więc nie wyznacza przychodu. Cenę maksymalizującą przychód lub zysk daje krzywa popytu, np. z pytań Gabora–Grangera, a najlepiej test z prawdziwymi zakupami.
W jakiej kolejności pokazywać ceny w metodzie Gabora–Grangera?
Losowo – połowie osób rosnąco, połowie malejąco – albo pokaż każdej osobie tylko jedną cenę wylosowaną z puli. Pierwsza cena działa jak kotwica: w przykładzie przy 39 zł zakup zadeklarowało 46.7% osób zaczynających od najniższej ceny i 70.3% zaczynających od najwyższej.
Które odpowiedzi usunąć w badaniu van Westendorpa?
Najczęściej usuwa się osoby z progami w złej kolejności (np. „za tanio” wyżej niż „za drogo”), z tą samą kwotą we wszystkich czterech pytaniach i z kwotami niemożliwymi (np. 999 zł za abonament). Reguły ustal przed analizą i podaj w pracy liczbę wykluczonych według powodu.
Powiązane hasła
Przeczytaj też
Elastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikConjoint wyborczy (CBC) – analiza
400 osób wybiera abonament: warunkowy model logitowy, ważność atrybutów, gotowość do zapłaty, symulator udziałów i pułapki IIA – pięć rysunków z kodem R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikLosowy test ceny i krzywa popytu
Aplikacja z subskrypcją i pięć losowych cen: konwersja, retencja, zysk i cena optymalna z bootstrapem oraz pułapka krzywej z historii – z kodem R.
Czytaj →PoradnikDeklaracja zakupu a faktyczny zakup
Catering dietetyczny: top-2-box, wykres kalibracji, konwersje deklaracji w segmentach i prognoza sprzedaży z bootstrapem – pięć rysunków z kodem R.
Czytaj →Badasz cenę w pracy z marketingu?
Pomożemy ułożyć pytania cenowe, zaplanować losową kolejność cen, wyczyścić odpowiedzi, policzyć krzywe z przedziałami i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ariely, D., Loewenstein, G., & Prelec, D. (2003). “Coherent arbitrariness”: Stable demand curves without stable preferences. The Quarterly Journal of Economics, 118(1), 73–106. https://doi.org/10.1162/00335530360535153
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Gabor, A., & Granger, C. W. J. (1966). Price as an indicator of quality: Report on an enquiry. Economica, 33(129), 43. https://doi.org/10.2307/2552272
- Kloss, D., & Kunter, M. (2016). The van Westendorp price-sensitivity meter as a direct measure of willingness-to-pay. European Journal of Management, 16(2), 45–54. https://doi.org/10.18374/ejm-16-2.4
- Lipovetsky, S., Magnan, S., & Zanetti-Polzi, A. (2011). Pricing models in marketing research. Intelligent Information Management, 03(05), 167–174. https://doi.org/10.4236/iim.2011.35020 ● Otwarty dostęp
- Miller, K. M., Hofstetter, R., Krohmer, H., & Zhang, Z. J. (2011). How should consumers’ willingness to pay be measured? An empirical comparison of state-of-the-art approaches. Journal of Marketing Research, 48(1), 172–184. https://doi.org/10.1509/jmkr.48.1.172 ● Otwarty dostęp: pełny tekst
- Ward, M. K., & Meade, A. W. (2023). Dealing with careless responding in survey data: Prevention, identification, and recommended best practices. Annual Review of Psychology, 74(1), 577–596. https://doi.org/10.1146/annurev-psych-040422-045007 ● Otwarty dostęp
Cytowania BibTeX
@article{ariely2003coherent, author={Ariely, Dan and Loewenstein, George and Prelec, Drazen}, title={{“Coherent arbitrariness”: Stable demand curves without stable preferences}}, journal={The Quarterly Journal of Economics}, year={2003}, volume={118}, number={1}, pages={73--106}, doi={10.1162/00335530360535153}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{gabor1966price, author={Gabor, Andre and Granger, Clive W. J.}, title={{Price as an indicator of quality: Report on an enquiry}}, journal={Economica}, year={1966}, volume={33}, number={129}, pages={43}, doi={10.2307/2552272}}@article{kloss2016van, author={Kloss, Dennis and Kunter, Marcus}, title={{The van Westendorp price-sensitivity meter as a direct measure of willingness-to-pay}}, journal={European Journal of Management}, year={2016}, volume={16}, number={2}, pages={45--54}, doi={10.18374/ejm-16-2.4}}@article{lipovetsky2011pricing, author={Lipovetsky, Stan and Magnan, Shon and Zanetti-Polzi, Andrea}, title={{Pricing models in marketing research}}, journal={Intelligent Information Management}, year={2011}, volume={03}, number={05}, pages={167--174}, doi={10.4236/iim.2011.35020}}@article{miller2011how, author={Miller, Klaus M. and Hofstetter, Reto and Krohmer, Harley and Zhang, Z. John}, title={{How should consumers’ willingness to pay be measured? An empirical comparison of state-of-the-art approaches}}, journal={Journal of Marketing Research}, year={2011}, volume={48}, number={1}, pages={172--184}, doi={10.1509/jmkr.48.1.172}}@article{ward2023dealing, author={Ward, M. K. and Meade, Adam W.}, title={{Dealing with careless responding in survey data: Prevention, identification, and recommended best practices}}, journal={Annual Review of Psychology}, year={2023}, volume={74}, number={1}, pages={577--596}, doi={10.1146/annurev-psych-040422-045007}}