Przykład: aplikacja do budżetu domowego i pięć cen
Fikcyjna aplikacja do planowania budżetu domowego łączy się z kontem w banku i sama kategoryzuje wydatki. Pełna wersja kosztuje 14.99 zł miesięcznie. Zespół pyta: czy ta cena jest dobra, czy zostawiamy pieniądze na stole?
Zamiast zgadywać, zespół zrobił test A/B z pięcioma wersjami. Przez 8 tygodni każdy nowy użytkownik po instalacji losowo widział jedną cenę: 9.99, 14.99, 19.99, 24.99 albo 29.99 zł miesięcznie. O cenie decydowało tylko losowanie (randomizacja), a nie kanał czy pora roku. Mierzymy trzy rzeczy: czy osoba wykupiła subskrypcję w ciągu 14 dni, ile miesięcy opłaciła w pierwszych trzech i czy nadal płaciła w 3. miesiącu.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Prawdziwe nachylenie krzywej popytu to −1.5 (regresja logistyczna z logarytmem ceny), konwersja przy 19.99 zł to 5.5%, a szansa opłacenia kolejnego miesiąca rośnie z ceną (0.80 przy 19.99 zł, nachylenie 0.6). Te wartości, liczbę 20 000 użytkowników, prowizję 15% i koszt obsługi 4 zł miesięcznie ustawiliśmy ręcznie przed wygenerowaniem danych. Ziarna (675, 6750, 6751) ustalono raz i nie zmieniano. Po pierwszym uruchomieniu poprawiliśmy tylko wygląd rysunków i opis jednego wydruku – żadnych parametrów danych. Dane pobierzesz jako test-ceny-aplikacja-budzetowa-uzytkownicy.csv (użytkownicy testu) i test-ceny-historia-miesieczna.csv (24 miesiące historii).
Wpis uzupełnia tekst o elastyczności cenowej z danych sprzedażowych: tam cena ustalana pod popyt psuła regresję, tu cenę wylosowano.
Rysunek 1: konwersja i krzywa popytu
Najpierw kontrola losowania. Grupy mają 4005, 4026, 3958, 4003 i 4008 osób. Test χ² zgodności z podziałem po równo daje p = .959, więc nic nie wskazuje na błąd w przydziale (nierówny podział ruchu omawia wpis o pułapkach testów A/B).
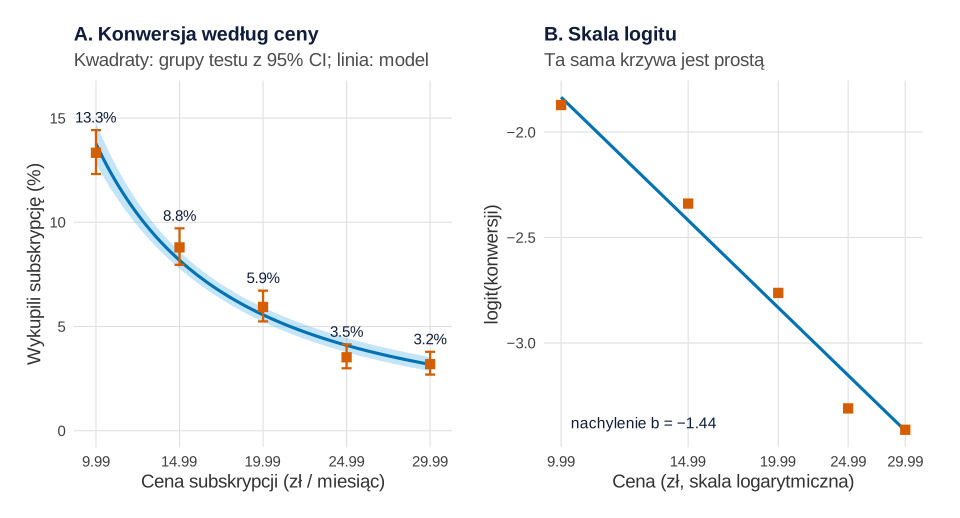
set.seed(675)).Co widać. Przy 9.99 zł subskrypcję wykupiło 13.33% osób, 95% CI [12.32, 14.42], przy obecnych 14.99 zł – 8.79% [7.96, 9.71], a przy 29.99 zł – 3.19% [2.69, 3.78]. Przedziały to przedziały Wilsona (przedział ufności dla proporcji). Linia to krzywa popytu z regresji logistycznej, w której ceną jest jej logarytm:
Wyszło b = −1.44, 95% CI [−1.58, −1.30], p < .001; prawda (−1.5) mieści się w przedziale. W języku ilorazu szans: cena wyższa o 10% mnoży szanse zakupu przez 0.872 [0.860, 0.884]. Przy małych odsetkach b jest blisko elastyczności konwersji: z modelu wynosi ona −1.24 przy 9.99 zł i −1.39 przy 29.99 zł. Podwyżka o 1% zabiera więc trochę ponad 1% kupujących.
Jak może zmylić. Model wygładza grupy. Przy 24.99 zł konwersja (3.52%) wypadła niżej niż linia, a przy 29.99 zł (3.19%) prawie na niej – to losowość, nie „próg psychologiczny 25 zł”. Między testowanymi cenami model interpoluje, ale poza zakresem 9.99–29.99 zł nic nie wiemy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: cena a jakość klientów
Subskrypcja zarabia co miesiąc, więc liczy się też, kto zostaje. Sprawdzamy, jaki odsetek subskrybentów opłacił 3. miesiąc.
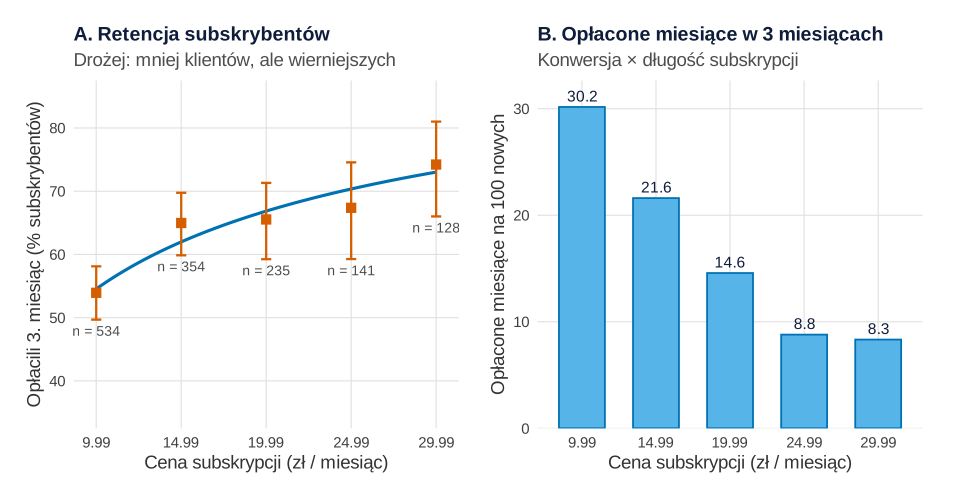
set.seed(675)).Co widać. Przy 9.99 zł do 3. miesiąca dotrwało 53.9% subskrybentów, 95% CI [49.7, 58.1], a przy 29.99 zł – 74.2% [66.0, 81.0]. Niska cena przyciąga też osoby, które „spróbują i zobaczą”. Model przejść (czy subskrybent opłaca kolejny miesiąc) daje nachylenie 0.67, 95% CI [0.41, 0.93], p < .001: szansa opłacenia kolejnego miesiąca rośnie z 73.9% przy 9.99 zł do 85.5% przy 29.99 zł. Subskrybent opłaca średnio 2.28 miesiąca z trzech przy najniższej cenie i 2.58 przy najwyższej.
Jak może zmylić. Panel A dotyczy tylko tych, którzy kupili, a ta grupa przy każdej cenie jest inna. To nie jest efekt ceny na tę samą osobę, tylko efekt ceny na skład klientów. Dlatego decyzję liczymy na wszystkich nowych użytkownikach (panel B): przy 9.99 zł 100 nowych osób opłaca 30.2 miesiąca, przy 29.99 zł – 8.3. Wyższa retencja nie odrabia więc utraty kupujących, ale zmienia rachunek zysku (rysunek 3). Przy cenach 24.99 i 29.99 zł subskrybentów jest tylko 141 i 128, stąd szerokie przedziały. Dłuższą perspektywę liczy się jak wartość klienta (CLV) albo churn jako analizę przeżycia.
Podpis do pracy:
Rysunek 3: przychód, zysk i cena optymalna z przedziałem
Przychód z 1. miesiąca na 100 nowych użytkowników spada z ceną: według modelu 137.5 zł przy 9.99 zł, 122.6 zł przy 14.99 zł i 95.4 zł przy 29.99 zł. To jednak nie zysk. Aplikacja oddaje 15% prowizji sklepowi z aplikacjami i operatorowi płatności, a każdy subskrybent kosztuje ją 4 zł miesięcznie (dostęp do danych z banku, serwery, pomoc). Zysk z opłaconego miesiąca to więc 0.85 × cena − 4 zł. Niepewność daje bootstrap (Efron, 1979): 2000 razy losujemy ze zwracaniem użytkowników w obrębie każdej grupy cenowej i liczymy oba modele od nowa.
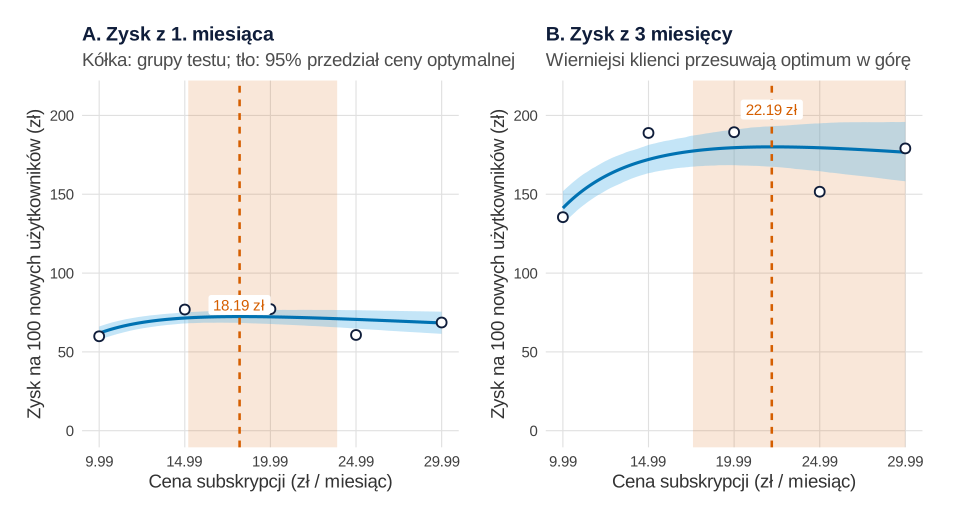
set.seed(675) i set.seed(6750)).Co widać. Licząc tylko 1. miesiąc, najwyższy zysk daje 18.19 zł, 95% przedział bootstrapowy [15.19, 23.89] zł. Licząc 3 miesiące, optimum przesuwa się do 22.19 zł [17.59, 29.99], bo drożsi klienci zostają dłużej. Prawdziwe optima ukryte w danych to 16.69 i 19.69 zł – oba w przedziałach. Konkretne porównanie: przy 19.99 zł model daje 179.6 zł zysku z 3 miesięcy na 100 nowych osób, przy 14.99 zł – 172.1 zł. Różnica to 7.5 zł, 95% przedział bootstrapowy [0.7, 14.7].
Jak może zmylić. Szczyt jest płaski, a przedział ceny optymalnej sięga górnej granicy testu (29.99 zł) – wyżej po prostu nie mierzyliśmy. Same grupy, bez modelu, mówią mniej: zysk z 3 miesięcy przy 14.99 i 19.99 zł to 188.9 i 189.4 zł na 100 osób. W próbach bootstrapowych najwyższy zysk dawała cena 19.99 zł w 42.5% prób, 14.99 zł w 38.5%, a 29.99 zł w 18.8%. To nie jest prawdopodobieństwo, że cena jest najlepsza, tylko miara chwiejności zwycięzcy. Model łączy informację z pięciu grup, ale zakłada kształt krzywej. Porównywanie każdej pary cen osobno to też wiele testów naraz (zob. test A/B z wieloma wariantami).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: dlaczego nie z historii sprzedaży
Zespół miał też 24 miesiące historii: w każdym miesiącu jedną cenę i odsetek nowych osób, które kupiły. Cenę ustalano jednak pod popyt. W styczniu (postanowienia noworoczne) i we wrześniu ludzie chętniej porządkują finanse, więc zespół podnosił cenę do 17.99–19.99 zł, a latem dawał promocję 9.99 zł. Popyt zależy od sezonu i szumu, a zespół dopasowuje do niego cenę. Parametry ustawiliśmy ręcznie, ziarno 6751.
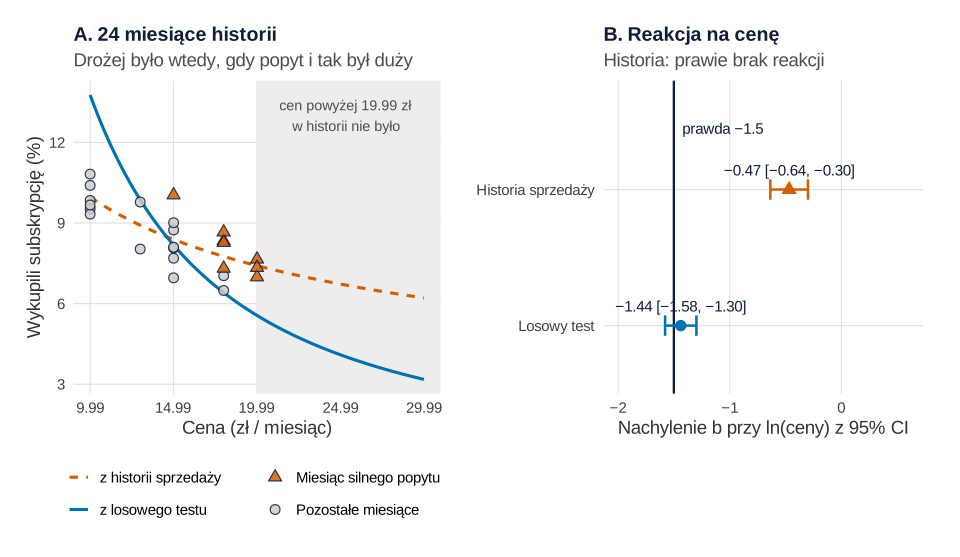
set.seed(675) i set.seed(6751)).Co widać. W historii cena i konwersja wciąż są ujemnie skorelowane (r = −.78), więc dane wyglądają rozsądnie. Ta sama regresja logistyczna daje jednak nachylenie −0.47, 95% CI [−0.64, −0.30], zamiast −1.5. Drogo było wtedy, gdy ludzie i tak chcieli kupować, więc reakcja na cenę wychodzi trzy razy słabsza. Cena jest tu powiązana ze zmienną zakłócającą – popytem. Taki problem endogeniczności opisują Villas-Boas i Winer (1999), a metaanaliza Bijmolta i in. (2005) pokazuje, że po jego uwzględnieniu elastyczności cenowe wyraźnie rosną co do wartości bezwzględnej.
Jak może zmylić. Skutki dla decyzji są duże. Z historii wynika, że przy 29.99 zł zysk z 1. miesiąca na 100 nowych osób wyniesie 133.5 zł, czyli prawie dwa razy więcej niż przy 14.99 zł (73.3 zł). Test mówi: 68.3 zł. Na dodatek cen powyżej 19.99 zł w historii w ogóle nie było, więc ta obietnica to czysta ekstrapolacja. Rozrzut między miesiącami był 4.07 razy większy niż przy samej losowości, dlatego użyliśmy modelu quasi-dwumianowego, ale szerszy przedział nie naprawia obciążenia.
Podpis do pracy:
Rysunek 5: 5 cen, 1 decyzja
Na koniec wszystkie liczby w jednym miejscu – dla zarządu.
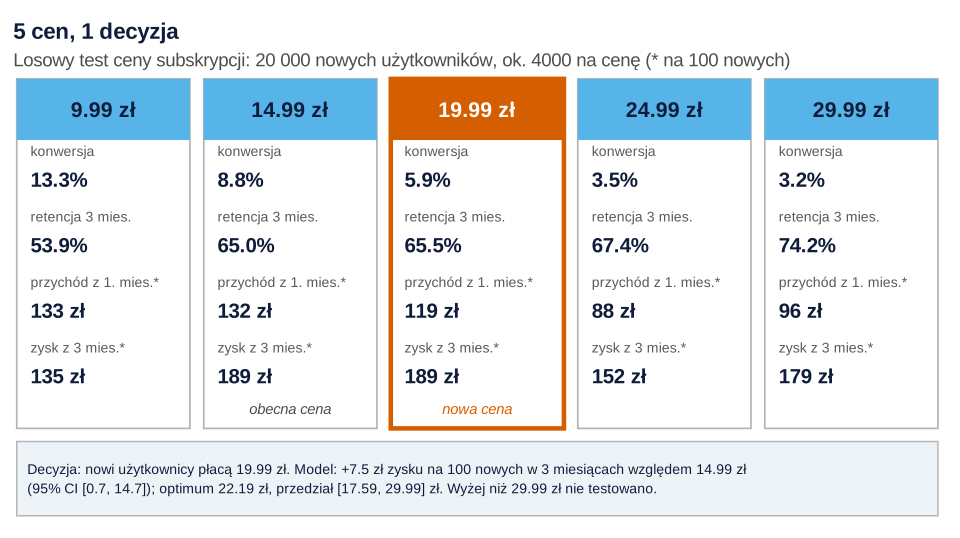
set.seed(675) i set.seed(6750)).Co widać. Najtańsza cena wygrywa w konwersji i przychodzie z 1. miesiąca, ale przegrywa w zysku z 3 miesięcy. Ceny 14.99 i 19.99 zł dają w grupach ten sam zysk (189 zł na 100 osób), a model – z przewagą 19.99 zł. Decyzja: nowi użytkownicy płacą 19.99 zł, a zespół dalej śledzi retencję.
Jak może zmylić. Karta pokazuje jeden horyzont – 3 miesiące; przy 12 miesiącach ranking może się zmienić.
Podpis do pracy:
Co z tym zrobić w marketingu
- Losuj cenę, nie wybieraj jej. Krzywa z historii obiecywała prawie dwa razy większy zysk przy 29.99 zł, niż dał test. Tylko losowanie odcina cenę od popytu. Kohavi i in. (2020) opisują kontrolowane eksperymenty online jako narzędzie do oceny takich zmian i podkreślają testy wiarygodności wyniku.
- Decyduj po zysku z kilku miesięcy, nie po konwersji. Konwersja i przychód z 1. miesiąca wskazywały 9.99 zł, a zysk z 3 miesięcy – 19.99–22 zł.
- Podnoś cenę krokiem, nie skokiem. Przedział ceny optymalnej sięga 29.99 zł, ale wyżej nie testowaliśmy. Następny test: 19.99, 22.99 i 25.99 zł.
- Testuj na nowych użytkownikach. Obecni płacą dotychczasową cenę; podwyżka dla nich to osobna decyzja i osobny test.
- Zaplanuj metrykę i horyzont z góry. Zapisz przed startem, że decyduje zysk z 3 miesięcy, i nie zmieniaj tego po obejrzeniu wyników.
Przed startem produktu zwykle pyta się klientów w ankiecie (badanie ceny metodami van Westendorpa i Gabora–Grangera). W sklepie stacjonarnym podobne pytanie dotyczy formy promocji („2 za 1” czy −50%) i głębokości rabatu (głębokość rabatu a sprzedaż). Szerzej o metodach w pracach z tej dziedziny pisze statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie opisz losowanie cen, wynik główny z horyzontem, założenia ekonomiczne i sposób liczenia niepewności. W Wynikach podaj konwersję z przedziałami, nachylenie krzywej popytu i cenę optymalną z przedziałem.
Gdy w pracy masz tylko dane historyczne, napisz wprost w ograniczeniach, że cena mogła reagować na popyt, a oszacowana reakcja na cenę może być zaniżona.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 3 korzysta z danych, przepis 4 – z modelu z przepisu 1, a przepis 5 – z wyników przepisów 1–3. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 1, 3 i 4), zaczyna od własnego set.seed(): 675 w przepisie 1, 6750 w przepisie 3 i 6751 w przepisie 4. Skopiowany osobno (z przepisami, z których korzysta) da te same liczby co na stronie. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: ceny testu, liczbę użytkowników (20 000) i czas testu (8 tygodni), konwersję przy 19.99 zł (5.5%), nachylenie krzywej popytu (−1.5), szansę opłacenia kolejnego miesiąca (0.80 przy 19.99 zł) i jej zależność od ceny (0.6) (przepis 1); prowizję 15%, koszt obsługi 4 zł miesięcznie, siatkę cen co 0.10 zł i 2000 prób bootstrapowych (przepis 3); profil sezonu, rozrzut popytu (SD = 0.10), reguły ustalania ceny przez zespół, poziomy cen i liczbę nowych użytkowników w historii (przepis 4). Cały kod liczy się w kilka sekund.
1. Dane testu, konwersja i krzywa popytu: Rysunek 1
R
# Rysunek 1. Losowy test pięciu cen subskrypcji: konwersja według ceny i krzywa popytu z regresji logistycznej
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)

# Parametry ustawione ręcznie (znamy je tylko dlatego, że dane są fikcyjne)
prawda <- c(konwersja_przy_19.99 = 0.055, b_cena = -1.5,      # logit(konwersji) = a + b × ln(cena / 19.99)
            kolejny_mies_przy_19.99 = 0.80, b_cena_retencja = 0.6)   # szansa opłacenia kolejnego miesiąca
ceny <- c(9.99, 14.99, 19.99, 24.99, 29.99)       # zł miesięcznie; obecna cena to 14.99 zł

set.seed(675)                                      # ziarno ustalone raz, bez dobierania pod wynik
N <- 20000                                         # nowi użytkownicy z 8 tygodni testu
d <- data.frame(id = 1:N, tydzien = sample(1:8, N, replace = TRUE),
                cena = ceny[sample(5, N, replace = TRUE)])      # każdy losowo widzi jedną z 5 cen
p_kup <- plogis(qlogis(prawda[["konwersja_przy_19.99"]]) + prawda[["b_cena"]] * log(d$cena / 19.99))
d$kupil <- rbinom(N, 1, p_kup)                     # wykupił subskrypcję w ciągu 14 dni
q <- plogis(qlogis(prawda[["kolejny_mies_przy_19.99"]]) + prawda[["b_cena_retencja"]] * log(d$cena / 19.99))
mies2 <- d$kupil * rbinom(N, 1, q)                 # opłacił 2. miesiąc
mies3 <- mies2 * rbinom(N, 1, q)                   # opłacił 3. miesiąc
d$miesiace <- d$kupil + mies2 + mies3              # opłacone miesiące w pierwszych 3 (0–3)
d$aktywny_3m <- mies3                              # nadal subskrybent w 3. miesiącu
write.csv(d, "test-ceny-aplikacja-budzetowa-uzytkownicy.csv", row.names = FALSE)

# Kontrola losowania: czy liczebności grup są zgodne z podziałem po równo (SRM)?
table(d$cena)
chisq.test(table(d$cena))$p.value

# Konwersja w każdej grupie cenowej z 95% przedziałem Wilsona
tab <- do.call(rbind, lapply(ceny, function(cc) {
  x <- d$kupil[d$cena == cc]
  ci <- prop.test(sum(x), length(x), correct = FALSE)$conf.int     # przedział Wilsona
  data.frame(cena = cc, n = length(x), kupilo = sum(x), konwersja = 100 * mean(x),
             dolna = 100 * ci[1], gorna = 100 * ci[2])
}))
print(transform(tab, konwersja = round(konwersja, 2), dolna = round(dolna, 2), gorna = round(gorna, 2)), row.names = FALSE)

# Krzywa popytu: regresja logistyczna konwersji na logarytm ceny
m_konw <- glm(kupil ~ log(cena), family = binomial, data = d)
round(cbind(b = coef(m_konw), confint.default(m_konw)), 3)
summary(m_konw)$coefficients[2, 4]                 # wartość p dla nachylenia
b <- coef(m_konw)[["log(cena)"]]; ci_b <- confint.default(m_konw)[2, ]
round(c(OR_cena_plus_10proc = 1.1^b, dolna = 1.1^ci_b[[1]], gorna = 1.1^ci_b[[2]]), 3)
# Elastyczność konwersji względem ceny (zmiana % konwersji przy cenie +1%) = b × (1 − p)
p_hat <- predict(m_konw, data.frame(cena = ceny), type = "response")
round(rbind(konwersja_z_modelu = 100 * p_hat, elastycznosc = b * (1 - p_hat)), 2)

# Rysunek: A – skala zł; B – skala logitu i logarytmu ceny (krzywa staje się prostą)
siatka <- data.frame(cena = seq(9.99, 29.99, length.out = 200))
pr <- predict(m_konw, siatka, se.fit = TRUE)
siatka$p <- 100 * plogis(pr$fit)
siatka$dolna <- 100 * plogis(pr$fit - 1.96 * pr$se.fit); siatka$gorna <- 100 * plogis(pr$fit + 1.96 * pr$se.fit)
tab$etykieta <- sprintf("%.1f%%", tab$konwersja)
pa <- ggplot(tab, aes(cena)) +
  geom_ribbon(data = siatka, aes(ymin = dolna, ymax = gorna), fill = kol[["blekit"]], alpha = 0.35) +
  geom_line(data = siatka, aes(y = p), colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.6, colour = kol[["pomaranczowy"]], linewidth = 0.8) +
  geom_point(aes(y = konwersja), colour = kol[["pomaranczowy"]], shape = 15, size = 3.2) +
  geom_text(aes(y = gorna, label = etykieta), vjust = -0.7, size = 4, colour = "#0f1d3a") +
  scale_x_continuous(breaks = ceny) + scale_y_continuous(limits = c(0, 16)) +
  labs(x = "Cena subskrypcji (zł / miesiąc)", y = "Wykupili subskrypcję (%)", title = "A. Konwersja według ceny",
       subtitle = "Kwadraty: grupy testu z 95% CI; linia: model") + motyw
tab$logit <- qlogis(tab$konwersja / 100)
pb <- ggplot(tab, aes(log(cena), logit)) +
  geom_line(data = siatka, aes(log(cena), qlogis(p / 100)), colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_point(colour = kol[["pomaranczowy"]], shape = 15, size = 3.2) +
  annotate("text", x = log(10.3), y = qlogis(0.033), hjust = 0, size = 4.1, colour = "#0f1d3a",
           label = minus(sprintf("nachylenie b = %.2f", b))) +
  scale_x_continuous(breaks = log(ceny), labels = format(ceny)) +
  scale_y_continuous(labels = function(x) minus(format(x))) +
  labs(x = "Cena (zł, skala logarytmiczna)", y = "logit(konwersji)", title = "B. Skala logitu",
       subtitle = "Ta sama krzywa jest prostą") + motyw
p1 <- pa + pb
p1   # zapis: ggsave("test-ceny-konwersja-krzywa-popytu.svg", p1, width = 10, height = 5.4)
Wynik w R
 9.99 14.99 19.99 24.99 29.99
 4005  4026  3958  4003  4008
[1] 0.9591539
  cena    n kupilo konwersja dolna gorna
  9.99 4005    534     13.33 12.32 14.42
 14.99 4026    354      8.79  7.96  9.71
 19.99 3958    235      5.94  5.24  6.72
 24.99 4003    141      3.52  2.99  4.14
 29.99 4008    128      3.19  2.69  3.78
                 b  2.5 % 97.5 %
(Intercept)  1.476  1.088  1.863
log(cena)   -1.438 -1.579 -1.298
[1] 9.309924e-90
OR_cena_plus_10proc               dolna               gorna
              0.872               0.860               0.884
                       1     2     3     4     5
konwersja_z_modelu 13.77  8.18  5.56  4.10  3.18
elastycznosc       -1.24 -1.32 -1.36 -1.38 -1.39
2. Retencja i opłacone miesiące: Rysunek 2
R
# Rysunek 2. Cena a jakość klientów: kto zostaje na 3. miesiąc i ile miesięcy opłaca 100 nowych użytkowników
# (korzysta z d, ceny, kol, motyw i minus z przepisu 1)
library(ggplot2)
library(patchwork)

sub <- subset(d, kupil == 1)                       # tylko ci, którzy wykupili subskrypcję
ret <- do.call(rbind, lapply(ceny, function(cc) {
  x <- sub$aktywny_3m[sub$cena == cc]
  ci <- prop.test(sum(x), length(x), correct = FALSE)$conf.int     # przedział Wilsona
  data.frame(cena = cc, subskrybenci = length(x), w_3_mies = sum(x), retencja = 100 * mean(x),
             dolna = 100 * ci[1], gorna = 100 * ci[2],
             miesiace_na_100_nowych = 100 * mean(d$miesiace[d$cena == cc]))
}))
print(transform(ret, retencja = round(retencja, 1), dolna = round(dolna, 1), gorna = round(gorna, 1),
                miesiace_na_100_nowych = round(miesiace_na_100_nowych, 1)), row.names = FALSE)

# Model przejść: szansa, że subskrybent opłaci kolejny miesiąc (przejścia 1→2 i 2→3 w jednym zbiorze)
przejscia <- rbind(data.frame(cena = sub$cena, dalej = as.integer(sub$miesiace >= 2)),
                   data.frame(cena = sub$cena[sub$miesiace >= 2], dalej = as.integer(sub$miesiace[sub$miesiace >= 2] == 3)))
m_ret <- glm(dalej ~ log(cena), family = binomial, data = przejscia)
round(cbind(b = coef(m_ret), confint.default(m_ret)), 3)
summary(m_ret)$coefficients[2, 4]                  # wartość p dla nachylenia
q_hat <- predict(m_ret, data.frame(cena = ceny), type = "response")
round(rbind(kolejny_miesiac = 100 * q_hat, retencja_3m_z_modelu = 100 * q_hat^2,
            sr_miesiecy_na_subskrybenta = 1 + q_hat + q_hat^2), 2)

# Rysunek: A – retencja w 3. miesiącu (95% CI) z linią modelu; B – opłacone miesiące na 100 nowych użytkowników
siatka2 <- data.frame(cena = seq(9.99, 29.99, length.out = 200))
siatka2$ret <- 100 * predict(m_ret, siatka2, type = "response")^2
pa <- ggplot(ret, aes(cena)) +
  geom_line(data = siatka2, aes(y = ret), colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.6, colour = kol[["pomaranczowy"]], linewidth = 0.8) +
  geom_point(aes(y = retencja), colour = kol[["pomaranczowy"]], shape = 15, size = 3.2) +
  geom_text(aes(y = dolna, label = sprintf("n = %d", subskrybenci)), vjust = 1.6, size = 3.7, colour = "grey30") +
  scale_x_continuous(breaks = ceny) + scale_y_continuous(limits = c(35, 85)) +
  labs(x = "Cena subskrypcji (zł / miesiąc)", y = "Opłacili 3. miesiąc (% subskrybentów)",
       title = "A. Retencja subskrybentów", subtitle = "Drożej: mniej klientów, ale wierniejszych") + motyw
pb <- ggplot(ret, aes(factor(cena), miesiace_na_100_nowych)) +
  geom_col(fill = kol[["blekit"]], colour = kol[["niebieski"]], width = 0.62) +
  geom_text(aes(label = sprintf("%.1f", miesiace_na_100_nowych)), vjust = -0.5, size = 4.1, colour = "#0f1d3a") +
  scale_y_continuous(limits = c(0, 32), expand = expansion(mult = c(0, 0.02))) +
  labs(x = "Cena subskrypcji (zł / miesiąc)", y = "Opłacone miesiące na 100 nowych",
       title = "B. Opłacone miesiące w 3 miesiącach", subtitle = "Konwersja × długość subskrypcji") + motyw
p2 <- pa + pb
p2   # zapis: ggsave("test-ceny-retencja-3-miesiace.svg", p2, width = 10, height = 5.2)
Wynik w R
  cena subskrybenci w_3_mies retencja dolna gorna miesiace_na_100_nowych
  9.99          534      288     53.9  49.7  58.1                   30.2
 14.99          354      230     65.0  59.9  69.8                   21.6
 19.99          235      154     65.5  59.2  71.3                   14.6
 24.99          141       95     67.4  59.3  74.6                    8.8
 29.99          128       95     74.2  66.0  81.0                    8.3
                 b  2.5 % 97.5 %
(Intercept) -0.494 -1.193  0.204
log(cena)    0.666  0.407  0.925
[1] 4.66382e-07
                                1     2     3     4     5
kolejny_miesiac             73.86 78.73 81.76 83.88 85.45
retencja_3m_z_modelu        54.55 61.98 66.85 70.35 73.02
sr_miesiecy_na_subskrybenta  2.28  2.41  2.49  2.54  2.58
3. Zysk, cena optymalna i bootstrap: Rysunek 3
R
# Rysunek 3. Przychód i zysk na nowego użytkownika w funkcji ceny – cena optymalna z przedziałem (bootstrap)
# (korzysta z d, ceny, kol, motyw i minus z przepisu 1)
library(ggplot2)
library(patchwork)

prowizja <- 0.15     # prowizja sklepu z aplikacjami i operatora płatności (ustalona ręcznie)
koszt_mies <- 4      # koszt obsługi subskrybenta: dostęp do danych bankowych, serwery, pomoc (zł / mies.)
siatka_cen <- seq(9.99, 29.99, by = 0.10)          # tylko zakres cen sprawdzonych w teście

# Dane zagregowane: w każdej grupie cenowej liczba osób z 0, 1, 2 i 3 opłaconymi miesiącami
agreguj <- function(miesiace, cena) {
  t(sapply(ceny, function(cc) tabulate(miesiace[cena == cc] + 1, nbins = 4)))
}
# Z tabeli liczebności: dwie regresje logistyczne (konwersja i kolejny miesiąc) oraz krzywe na siatce cen
krzywe <- function(tb) {
  n <- rowSums(tb); kup <- n - tb[, 1]; m2 <- tb[, 3] + tb[, 4]; m3 <- tb[, 4]
  mk <- unname(coef(glm(cbind(kup, n - kup) ~ log(ceny), family = binomial)))
  mr <- unname(coef(glm(cbind(c(m2, m3), c(kup - m2, m2 - m3)) ~ log(rep(ceny, 2)), family = binomial)))
  p <- plogis(mk[1] + mk[2] * log(siatka_cen))
  q <- plogis(mr[1] + mr[2] * log(siatka_cen))
  marza <- (1 - prowizja) * siatka_cen - koszt_mies                 # zysk z jednego opłaconego miesiąca
  zysk1 <- p * marza; zysk3 <- p * marza * (1 + q + q^2)
  # Bez modelu: średni zysk na nowego użytkownika w każdej z 5 grup (1. miesiąc i 3 miesiące)
  marza5 <- (1 - prowizja) * ceny - koszt_mies
  list(b = mk[2], przychod1 = p * siatka_cen, zysk1 = zysk1, zysk3 = zysk3,
       opt1 = siatka_cen[which.max(zysk1)], opt3 = siatka_cen[which.max(zysk3)],
       obs1 = unname(kup / n * marza5), obs3 = unname((kup + m2 + m3) / n * marza5))
}
tb0 <- agreguj(d$miesiace, d$cena)
k0 <- krzywe(tb0)
round(c(cena_opt_1_mies = k0$opt1, cena_opt_3_mies = k0$opt3), 2)
round(rbind(zysk_1_mies_na_nowego = k0$obs1, zysk_3_mies_na_nowego = k0$obs3), 3)
# Prawdziwe optimum (z parametrów ukrytych w danych – znamy je tylko w symulacji)
p_pr <- plogis(qlogis(0.055) - 1.5 * log(siatka_cen / 19.99)); q_pr <- plogis(qlogis(0.80) + 0.6 * log(siatka_cen / 19.99))
z_pr <- p_pr * ((1 - prowizja) * siatka_cen - koszt_mies)
round(c(prawdziwa_opt_1 = siatka_cen[which.max(z_pr)], prawdziwa_opt_3 = siatka_cen[which.max(z_pr * (1 + q_pr + q_pr^2))]), 2)

# Bootstrap: 2000 razy losujemy ze zwracaniem użytkowników w obrębie każdej grupy cenowej
set.seed(6750)
B <- 2000
grupy <- split(d$miesiace, d$cena)
boot <- replicate(B, {
  tb <- t(sapply(grupy, function(x) tabulate(sample(x, replace = TRUE) + 1, nbins = 4)))
  k <- krzywe(tb)
  c(opt1 = k$opt1, opt3 = k$opt3, k$zysk1, k$zysk3, wygrywa = which.max(k$obs3),
    roznica = k$zysk3[which.min(abs(siatka_cen - 19.99))] - k$zysk3[which.min(abs(siatka_cen - 14.99))])
})
round(quantile(boot["opt1", ], c(0.025, 0.5, 0.975)), 2)
round(quantile(boot["opt3", ], c(0.025, 0.5, 0.975)), 2)
# W ilu próbach bootstrapowych każda z 5 cen dała najwyższy zysk w 3 miesiącach (bez modelu)
round(100 * table(factor(ceny[boot["wygrywa", ]], ceny)) / B, 1)
# Zysk w 3 miesiącach na 100 nowych użytkowników: 19.99 zł minus 14.99 zł (z modelu), 95% przedział
i15 <- which.min(abs(siatka_cen - 14.99)); i20 <- which.min(abs(siatka_cen - 19.99))
round(100 * c(przy_14.99 = k0$zysk3[i15], przy_19.99 = k0$zysk3[i20], roznica = k0$zysk3[i20] - k0$zysk3[i15],
              quantile(boot["roznica", ], c(0.025, 0.975))), 1)
round(100 * c(przychod_1_mies_przy_9.99 = k0$przychod1[1], przy_14.99 = k0$przychod1[i15],
              przy_29.99 = k0$przychod1[length(siatka_cen)]), 1)

# Rysunek: zysk na 100 nowych użytkowników – A: 1. miesiąc, B: 3 miesiące; pasma 95% z bootstrapu
nS <- length(siatka_cen)
pas <- function(wiersze, srodek) data.frame(cena = siatka_cen, srodek = 100 * srodek,
  dolna = 100 * apply(boot[wiersze, ], 1, quantile, 0.025), gorna = 100 * apply(boot[wiersze, ], 1, quantile, 0.975))
z1 <- pas(2 + 1:nS, k0$zysk1); z3 <- pas(2 + nS + 1:nS, k0$zysk3)
panel <- function(z, opt, ci, obs, tytul, podtytul) {
  ggplot(z, aes(cena)) +
    annotate("rect", xmin = ci[1], xmax = ci[2], ymin = -Inf, ymax = Inf, fill = kol[["pomaranczowy"]], alpha = 0.15) +
    geom_ribbon(aes(ymin = dolna, ymax = gorna), fill = kol[["blekit"]], alpha = 0.35) +
    geom_line(aes(y = srodek), colour = kol[["niebieski"]], linewidth = 1.1) +
    geom_point(data = data.frame(cena = ceny, y = 100 * obs), aes(y = y), colour = "#0f1d3a", shape = 21,
               fill = "white", size = 2.8, stroke = 1) +
    geom_vline(xintercept = opt, colour = kol[["pomaranczowy"]], linetype = "22", linewidth = 0.9) +
    annotate("label", x = opt, y = max(z$gorna) * 1.04, label = sprintf("%.2f zł", opt), size = 4,
             colour = kol[["pomaranczowy"]], fill = "white", linewidth = 0) +
    scale_x_continuous(breaks = ceny) + scale_y_continuous(limits = c(0, max(z3$gorna) * 1.08)) +
    labs(x = "Cena subskrypcji (zł / miesiąc)", y = "Zysk na 100 nowych użytkowników (zł)", title = tytul,
         subtitle = podtytul) + motyw
}
p3 <- panel(z1, k0$opt1, quantile(boot["opt1", ], c(0.025, 0.975)), k0$obs1, "A. Zysk z 1. miesiąca",
            "Kółka: grupy testu; tło: 95% przedział ceny optymalnej") +
  panel(z3, k0$opt3, quantile(boot["opt3", ], c(0.025, 0.975)), k0$obs3, "B. Zysk z 3 miesięcy",
        "Wierniejsi klienci przesuwają optimum w górę")
p3   # zapis: ggsave("test-ceny-zysk-cena-optymalna.svg", p3, width = 10, height = 5.4)
Wynik w R
cena_opt_1_mies cena_opt_3_mies
          18.19           22.19
                       [,1]  [,2]  [,3]  [,4]  [,5]
zysk_1_mies_na_nowego 0.599 0.769 0.771 0.607 0.686
zysk_3_mies_na_nowego 1.355 1.889 1.894 1.516 1.791
prawdziwa_opt_1 prawdziwa_opt_3
          16.69           19.69
 2.5%   50% 97.5%
15.19 18.19 23.89
 2.5%   50% 97.5%
17.59 22.14 29.99

 9.99 14.99 19.99 24.99 29.99
  0.0  38.5  42.5   0.2  18.8
przy_14.99 przy_19.99    roznica       2.5%      97.5%
     172.1      179.6        7.5        0.7       14.7
przychod_1_mies_przy_9.99                przy_14.99                przy_29.99
                    137.5                     122.6                      95.4
4. Historia sprzedaży a test: Rysunek 4
R
# Rysunek 4. Ta sama aplikacja, 24 miesiące historii sprzedaży: krzywa popytu z cen ustalanych przez zespół
# (korzysta z m_konw, ceny, prawda, kol, motyw i minus z przepisu 1)
library(ggplot2)
library(patchwork)

set.seed(6751)
miesiac <- rep(1:12, 2)                             # styczeń 2024 – grudzień 2025 (fikcyjne)
# Popyt sezonowy: w styczniu (postanowienia noworoczne) i we wrześniu ludzie chętniej porządkują budżet
sezon <- c(0.45, 0.25, 0.05, -0.05, -0.15, -0.30, -0.35, -0.25, 0.20, 0.05, -0.05, 0.15)[miesiac]
popyt <- sezon + rnorm(24, 0, 0.10)                 # szok popytu w miesiącu (na skali logitu)
# Zespół ustala cenę pod popyt: w dobrych miesiącach drożej, w słabych – promocja
poziomy <- c(9.99, 12.99, 14.99, 17.99, 19.99)
cena_hist <- poziomy[findInterval(popyt + rnorm(24, 0, 0.08), c(-Inf, -0.25, -0.08, 0.10, 0.30, Inf))]
nowi <- round(5000 * exp(0.8 * sezon))              # nowi użytkownicy w miesiącu
p_hist <- plogis(qlogis(prawda[["konwersja_przy_19.99"]]) + prawda[["b_cena"]] * log(cena_hist / 19.99) + popyt)
kupili <- rbinom(24, nowi, p_hist)
h <- data.frame(okres = sprintf("%d-%02d", rep(2024:2025, each = 12), miesiac), miesiac, cena = cena_hist,
                nowi, kupili, konwersja = round(100 * kupili / nowi, 2))
write.csv(h, "test-ceny-historia-miesieczna.csv", row.names = FALSE)
table(h$cena)
round(cor(h$cena, h$konwersja), 3)

# Ta sama regresja logistyczna na danych miesięcznych (quasi-dwumianowa: miesiące różnią się bardziej niż losowo)
m_hist <- glm(cbind(kupili, nowi - kupili) ~ log(cena), family = quasibinomial, data = h)
porown <- rbind(historia = c(coef(m_hist)[2], confint.default(m_hist)[2, ]),
                eksperyment = c(coef(m_konw)[2], confint.default(m_konw)[2, ]))
colnames(porown) <- c("b", "dolna", "gorna")
round(porown, 3)
round(summary(m_hist)$dispersion, 2)                # nadmierna dyspersja

# Co z tego wynika dla ceny? Zysk z 1. miesiąca na 100 nowych przy cenach 14.99 i 29.99 zł
marza <- function(cc) 0.85 * cc - 4
zysk100 <- function(m, cc) 100 * predict(m, data.frame(cena = cc), type = "response") * marza(cc)
round(rbind(historia = zysk100(m_hist, c(14.99, 29.99)), eksperyment = zysk100(m_konw, c(14.99, 29.99))), 1)

# Rysunek: A – miesiące historii (kolor i kształt: sezon) z krzywą z historii i z eksperymentu; B – nachylenia z CI
h$pora <- factor(ifelse(sezon[h$miesiac] > 0.1, "Miesiąc silnego popytu", "Pozostałe miesiące"),
                 c("Miesiąc silnego popytu", "Pozostałe miesiące"))
siatka4 <- data.frame(cena = seq(9.99, 29.99, length.out = 200))
krz <- rbind(data.frame(cena = siatka4$cena, p = 100 * predict(m_hist, siatka4, type = "response"),
                        zrodlo = "z historii sprzedaży"),
             data.frame(cena = siatka4$cena, p = 100 * predict(m_konw, siatka4, type = "response"),
                        zrodlo = "z losowego testu"))
pa <- ggplot(h, aes(cena, konwersja)) +
  annotate("rect", xmin = max(h$cena), xmax = Inf, ymin = -Inf, ymax = Inf, fill = "grey93") +
  annotate("text", x = 25.3, y = 13, label = "cen powyżej 19.99 zł\nw historii nie było", size = 3.8, colour = "grey30") +
  geom_line(data = krz, aes(y = p, colour = zrodlo, linetype = zrodlo), linewidth = 1.1) +
  geom_point(aes(shape = pora, fill = pora), size = 3, colour = "#0f1d3a", alpha = 0.85) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("22", "solid"), name = NULL) +
  scale_shape_manual(values = c(24, 21), name = NULL) +
  scale_fill_manual(values = c(kol[["pomaranczowy"]], "grey80"), name = NULL) +
  scale_x_continuous(breaks = ceny) +
  guides(colour = guide_legend(nrow = 2, order = 1), linetype = guide_legend(nrow = 2, order = 1),
         shape = guide_legend(nrow = 2, order = 2), fill = guide_legend(nrow = 2, order = 2)) +
  labs(x = "Cena (zł / miesiąc)", y = "Wykupili subskrypcję (%)", title = "A. 24 miesiące historii",
       subtitle = "Drożej było wtedy, gdy popyt i tak był duży") + motyw
porown_df <- data.frame(zrodlo = factor(c("Historia sprzedaży", "Losowy test"), c("Losowy test", "Historia sprzedaży")),
                        porown)
pb <- ggplot(porown_df, aes(b, zrodlo)) +
  geom_vline(xintercept = prawda[["b_cena"]], colour = "#0f1d3a", linewidth = 0.8) +
  annotate("text", x = prawda[["b_cena"]], y = 2.45, label = "prawda −1.5", hjust = -0.1, size = 4, colour = "#0f1d3a") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna, colour = zrodlo), width = 0.15, orientation = "y", linewidth = 0.9) +
  geom_point(aes(colour = zrodlo, shape = zrodlo), size = 3.6) +
  geom_text(aes(label = minus(sprintf("%.2f [%.2f, %.2f]", b, dolna, gorna))), vjust = -1.3, size = 4, colour = "#0f1d3a") +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), guide = "none") +
  scale_shape_manual(values = c(16, 17), guide = "none") +
  scale_x_continuous(limits = c(-2, 0.6), labels = function(x) minus(format(x))) +
  scale_y_discrete(expand = expansion(add = c(0.5, 0.8))) +
  labs(x = "Nachylenie b przy ln(ceny) z 95% CI", y = NULL, title = "B. Reakcja na cenę",
       subtitle = "Historia: prawie brak reakcji") + motyw
p4 <- pa + pb + plot_layout(widths = c(1.15, 1)) & theme(legend.position = "bottom")
p4   # zapis: ggsave("test-ceny-historia-a-eksperyment.svg", p4, width = 10, height = 5.8)
Wynik w R
 9.99 12.99 14.99 17.99 19.99
    6     2     7     6     3
[1] -0.78
                 b  dolna  gorna
historia    -0.467 -0.636 -0.299
eksperyment -1.438 -1.579 -1.298
[1] 4.07
               1     2
historia    73.3 133.5
eksperyment 71.5  68.3
5. Karta „5 cen, 1 decyzja”: Rysunek 5
R
# Rysunek 5. Karta „5 cen, 1 decyzja”: wyniki testu dla każdej ceny w jednym miejscu
# (korzysta z ceny, tab i kol z przepisu 1, ret z przepisu 2 oraz k0, boot, i15 i i20 z przepisu 3)
library(ggplot2)

przecinek <- function(x, d = 1) formatC(x, format = "f", digits = d)
karty <- data.frame(x0 = (0:4) * 1.08, cena = ceny,
                    konw = przecinek(tab$konwersja), ret = przecinek(ret$retencja),
                    przych = przecinek(100 * tab$konwersja / 100 * ceny, 0),
                    zysk3 = przecinek(100 * k0$obs3, 0))
karty$naglowek <- sprintf("%s zł", format(ceny))
wiersze <- data.frame(etykieta = c("konwersja", "retencja 3 mies.", "przychód z 1. mies.*", "zysk z 3 mies.*"),
                      y = c(0.835, 0.685, 0.535, 0.385))
pola <- do.call(rbind, lapply(seq_len(nrow(karty)), function(i)
  data.frame(x = karty$x0[i] + 0.08, y = wiersze$y, etykieta = wiersze$etykieta,
             wartosc = c(paste0(karty$konw[i], "%"), paste0(karty$ret[i], "%"),
                         paste0(karty$przych[i], " zł"), paste0(karty$zysk3[i], " zł")))))
karty$znacznik <- c("", "obecna cena", "nowa cena", "", "")
karty$ramka <- ifelse(ceny == 19.99, kol[["pomaranczowy"]], "grey70")
karty$gr <- ifelse(ceny == 19.99, 1.6, 0.6)
decyzja <- sprintf(paste0("Decyzja: nowi użytkownicy płacą 19.99 zł. Model: +%s zł zysku na 100 nowych w 3 miesiącach względem 14.99 zł\n",
                          "(95%% CI [%s, %s]); optimum %s zł, przedział [%s, %s] zł. Wyżej niż 29.99 zł nie testowano."),
                   przecinek(100 * (k0$zysk3[i20] - k0$zysk3[i15])),
                   przecinek(100 * quantile(boot["roznica", ], 0.025)), przecinek(100 * quantile(boot["roznica", ], 0.975)),
                   przecinek(k0$opt3, 2), przecinek(quantile(boot["opt3", ], 0.025), 2), przecinek(quantile(boot["opt3", ], 0.975), 2))
cat(decyzja, "\n")
p5 <- ggplot() +
  geom_rect(data = karty, aes(xmin = x0, xmax = x0 + 1, ymin = 0.2, ymax = 1), fill = "white",
            colour = karty$ramka, linewidth = karty$gr) +
  geom_rect(data = karty, aes(xmin = x0, xmax = x0 + 1, ymin = 0.86, ymax = 1),
            fill = ifelse(ceny == 19.99, kol[["pomaranczowy"]], kol[["blekit"]]), colour = NA) +
  geom_text(data = karty, aes(x = x0 + 0.5, y = 0.93, label = naglowek), fontface = "bold", size = 5.6,
            colour = ifelse(ceny == 19.99, "white", "#0f1d3a")) +
  geom_text(data = pola, aes(x, y, label = etykieta), hjust = 0, size = 3.7, colour = "grey35") +
  geom_text(data = pola, aes(x, y - 0.065, label = wartosc), hjust = 0, size = 5.4, fontface = "bold", colour = "#0f1d3a") +
  geom_text(data = karty, aes(x = x0 + 0.5, y = 0.245, label = znacznik), fontface = "italic", size = 3.9,
            colour = ifelse(ceny == 19.99, kol[["pomaranczowy"]], "grey30")) +
  annotate("rect", xmin = 0, xmax = 5.32, ymin = 0, ymax = 0.17, fill = "#eef3f8", colour = "grey70", linewidth = 0.5) +
  annotate("text", x = 0.06, y = 0.085, label = decyzja, hjust = 0, size = 3.7, lineheight = 1.15, colour = "#0f1d3a") +
  coord_cartesian(xlim = c(-0.02, 5.34), ylim = c(-0.02, 1.02), expand = FALSE) +
  labs(title = "5 cen, 1 decyzja",
       subtitle = "Losowy test ceny subskrypcji: 20 000 nowych użytkowników, ok. 4000 na cenę (* na 100 nowych)") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p5   # zapis: ggsave("test-ceny-karta-5-cen.svg", p5, width = 10, height = 5.6)
Wynik w R
Decyzja: nowi użytkownicy płacą 19.99 zł. Model: +7.5 zł zysku na 100 nowych w 3 miesiącach względem 14.99 zł
(95% CI [0.7, 14.7]); optimum 22.19 zł, przedział [17.59, 29.99] zł. Wyżej niż 29.99 zł nie testowano.
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "szary – pomarańczowy" = c("#999999", "#D55E00"), "niebieski – błękit" = c("#0072B2", "#56B4E9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
szary – pomarańczowy                        77.2         62.9       56.0
niebieski – błękit                          26.4         24.7       24.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja logistyczna (glm()), przedziały Wilsona (prop.test()), test χ² i bootstrap – pakiet stats z podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Krzywa z historii. Cena ustalana pod popyt daje zbyt płaską krzywą (rysunek 4) i zachęca do podwyżek, których nie da się obronić.
- Konwersja zamiast zysku. Najtańsza cena zawsze „wygrywa” w odsetku kupujących. Licz zysk na wszystkich nowych użytkownikach, nie tylko na kupujących.
- Retencja tylko wśród kupujących. To porównanie różnych grup ludzi. Cena zmienia skład klientów (rysunek 2), a nie zachowanie jednej osoby.
- Porównywanie cen między użytkownikami. Osoby, które zobaczyły różne ceny, mogą się porównać na forum. Postrzegana niesprawiedliwość ceny jest osobnym problemem badawczym i praktycznym (Xia i in., 2004). Ogranicz test w czasie, dotrzymuj ceny tym, którzy kupili, i sprawdź zasady prawa konsumenckiego. Dubé i Misra (2023) zbudowali z randomizowanego eksperymentu cenowego ceny spersonalizowane: zysk wzrósł, ale łączna nadwyżka konsumentów spadła.
- Efekt krótkoterminowy. Test mierzy 14 dni i 3 miesiące. Efekty w eksperymentach online mogą z czasem słabnąć albo rosnąć (Sadeghi i in., 2022), a wpływu ceny na polecenia i opinie o aplikacji test nie pokazuje.
- Cena optymalna „co do grosza”. Przedział [17.59, 29.99] zł pokazuje, że wynik to kierunek, nie liczba do cennika.
Najczęstsze pytania
Jak przeprowadzić losowy test ceny subskrypcji?
Wybierz 3–5 cen wokół obecnej i losowo przydzielaj je nowym użytkownikom na poziomie osoby, a nie dnia czy kanału. Z góry ustal wynik główny i horyzont, np. zysk z pierwszych 3 miesięcy, i sprawdź testem χ², czy grupy mają planowane liczebności. W przykładzie 20 000 osób w 8 tygodni dało po około 4000 na cenę.
Jak wyznaczyć krzywą popytu z testu cenowego?
Policz regresję logistyczną zakupu (0/1) na logarytm ceny. Współczynnik przy ln(ceny) opisuje, jak szybko spada konwersja: w przykładzie −1.44, 95% CI [−1.58, −1.30], czyli cena wyższa o 10% mnoży szanse zakupu przez 0.872. Przy małych odsetkach kupujących współczynnik jest bliski elastyczności konwersji.
Dlaczego krzywa popytu z historii sprzedaży bywa zbyt płaska?
Bo w historii cenę zwykle ustala się pod popyt: drożej w dobrych miesiącach, promocje w słabych. Wysokie ceny trafiają wtedy na chętnych klientów i reakcja na cenę wychodzi słabsza. W przykładzie historia dała nachylenie −0.47 zamiast −1.5 i obiecywała przy 29.99 zł prawie dwa razy większy zysk, niż pokazał test.
Jak policzyć cenę optymalną z przedziałem ufności?
Zapisz zysk na nowego użytkownika jako konwersję × marżę z miesiąca × liczbę opłaconych miesięcy, oblicz go z modeli na siatce cen i wybierz maksimum w zakresie testowanych cen. Przedział daje bootstrap: losuj użytkowników ze zwracaniem w grupach cenowych i powtarzaj obliczenia, np. 2000 razy. W przykładzie optimum wyniosło 22.19 zł, 95% przedział [17.59, 29.99] zł.
Czy niższa cena przyciąga gorszych klientów?
Może tak być, dlatego w teście cenowym mierz też retencję. W przykładzie 3. miesiąc opłaciło 53.9% subskrybentów przy 9.99 zł i 74.2% przy 29.99 zł. To różnica w składzie klientów, a nie w zachowaniu tej samej osoby, więc zysk licz na wszystkich nowych użytkownikach danej grupy cenowej.
Powiązane hasła
Przeczytaj też
Elastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikBadanie ceny: van Westendorp i Gabor–Granger
Abonament serwisu rowerowego: krzywe van Westendorpa z bootstrapem, popyt i przychód Gabora–Grangera, zakotwiczenie i deklaracje a zakupy – z kodem R.
Czytaj →Poradnik„2 za 1” czy −50%? Forma promocji
Sieć sklepów papierniczych: eksperyment z trzema formami promocji, sztuki na paragon, model mieszany, kanibalizacja, dołek i bilans marży – z kodem R.
Czytaj →PoradnikGłębokość rabatu a sprzedaż
Sieć sklepów z elektroniką: krzywa odpowiedzi na rabat 10–40%, dołek po promocji, kanibalizacja, zysk zamiast przychodu i pułapka dobrych tygodni – z kodem R.
Czytaj →PoradnikPozycja cenowa wobec konkurencji
Sklep z oponami i trzech konkurentów: względny indeks ceny, regresja z efektami stałymi, próg najtańszej oferty i pułapka odwrotnej przyczynowości – z kodem R.
Czytaj →Analizujesz test cenowy do pracy?
Pomożemy zaplanować losowanie cen, dobrać model krzywej popytu, policzyć zysk i cenę optymalną z niepewnością i opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bijmolt, T. H. A., van Heerde, H. J., & Pieters, R. G. M. (2005). New empirical generalizations on the determinants of price elasticity. Journal of Marketing Research, 42(2), 141–156. https://doi.org/10.1509/jmkr.42.2.141.62296
- Dubé, J.-P., & Misra, S. (2023). Personalized pricing and consumer welfare. Journal of Political Economy, 131(1), 131–189. https://doi.org/10.1086/720793 ● Otwarty dostęp: pełny tekst
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Sadeghi, S., Gupta, S., Gramatovici, S., Lu, J., Ai, H., & Zhang, R. (2022). Novelty and primacy: A long-term estimator for online experiments. Technometrics, 64(4), 524–534. https://doi.org/10.1080/00401706.2022.2124309 ● Otwarty dostęp: pełny tekst
- Villas-Boas, J. M., & Winer, R. S. (1999). Endogeneity in brand choice models. Management Science, 45(10), 1324–1338. https://doi.org/10.1287/mnsc.45.10.1324
- Xia, L., Monroe, K. B., & Cox, J. L. (2004). The price is unfair! A conceptual framework of price fairness perceptions. Journal of Marketing, 68(4), 1–15. https://doi.org/10.1509/jmkg.68.4.1.42733 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bijmolt2005new, author={Bijmolt, Tammo H. A. and van Heerde, Harald J. and Pieters, Rik G. M.}, title={{New empirical generalizations on the determinants of price elasticity}}, journal={Journal of Marketing Research}, year={2005}, volume={42}, number={2}, pages={141--156}, doi={10.1509/jmkr.42.2.141.62296}}@article{dube2023personalized, author={Dub{\'e}, Jean-Pierre and Misra, Sanjog}, title={{Personalized pricing and consumer welfare}}, journal={Journal of Political Economy}, year={2023}, volume={131}, number={1}, pages={131--189}, doi={10.1086/720793}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{sadeghi2022novelty, author={Sadeghi, Soheil and Gupta, Somit and Gramatovici, Stefan and Lu, Jiannan and Ai, Hao and Zhang, Ruhan}, title={{Novelty and primacy: A long-term estimator for online experiments}}, journal={Technometrics}, year={2022}, volume={64}, number={4}, pages={524--534}, doi={10.1080/00401706.2022.2124309}}@article{villasboas1999endogeneity, author={Villas-Boas, J. Miguel and Winer, Russell S.}, title={{Endogeneity in brand choice models}}, journal={Management Science}, year={1999}, volume={45}, number={10}, pages={1324--1338}, doi={10.1287/mnsc.45.10.1324}}@article{xia2004price, author={Xia, Lan and Monroe, Kent B. and Cox, Jennifer L.}, title={{The price is unfair! A conceptual framework of price fairness perceptions}}, journal={Journal of Marketing}, year={2004}, volume={68}, number={4}, pages={1--15}, doi={10.1509/jmkg.68.4.1.42733}}