Przykład: sklep z oponami i trzech konkurentów
Fikcyjny sklep internetowy z oponami sprzedaje 60 modeli (30 letnich, 30 zimowych) po 180–650 zł za sztukę. Codziennie zapisuje swoją cenę, ceny tych samych opon u trzech konkurentów (A, B, C) z porównywarki, ich dostępność i liczbę zamówień każdego modelu. Rok danych to 21 840 wierszy (model × dzień) i 26 294 zamówienia. Kierownik sprzedaży pyta: czy opłaca się być 5% taniej niż konkurencja, czy raczej 5% drożej?
Dane pobierzesz jako pozycja-cenowa-opony-60-modeli-364-dni.csv.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Klienci reagują na pozycję cenową: współczynnik −4.0 przy logarytmie dzisiejszego indeksu, −1.5 przy wczorajszym (część osób porównuje oferty dzień wcześniej) i 0 przy indeksie sprzed tygodnia. Bycie najtańszym w porównywarce dodaje 22.1% zamówień. Popyt ma dwa szczyty: opony letnie około 10 kwietnia, zimowe około 27 października. Te wartości, ceny, promocje i przerwy w dostępności ustawiliśmy ręcznie. Po pierwszym przebiegu osłabiliśmy trwałość dziennych wahań cen konkurentów i wzmocniliśmy reakcję klientów (z −2.0 i −0.8); ziarna 697 nie zmienialiśmy. Pełna lista parametrów i powody zmian są w sekcji z kodem.
Samą elastyczność cenową opisuje wpis elastyczność cenowa z danych sprzedażowych; tu chodzi o cenę względem rynku.
Względny indeks ceny
Klient w porównywarce widzi listę ofert, więc pozycję cenową mierzymy względnym indeksem:
Indeks 1.00 to cena równa typowej ofercie rynku, 0.95 – o 5% taniej, 1.05 – o 5% drożej. Mediana, bo jeden konkurent z absurdalną ceną jej nie przesuwa. Przykład: nasza opona kosztuje 370 zł z darmową dostawą, konkurenci żądają 372, 365 i 379 zł plus 0, 10 i 15 zł dostawy. Indeks z dostawą wynosi 0.987 i jesteśmy najtańsi. Bez dostawy wyszłoby 0.995 i drugie miejsce. Gdy konkurent A nie ma towaru, indeks spada do 0.962. Ta sama cena daje trzy różne pozycje. Indeks koszyka wielu produktów w czasie to inna miara – zob. indeks cen Laspeyresa, Paaschego i Fishera.
Rysunek 1: sezon wymiany opon i indeks
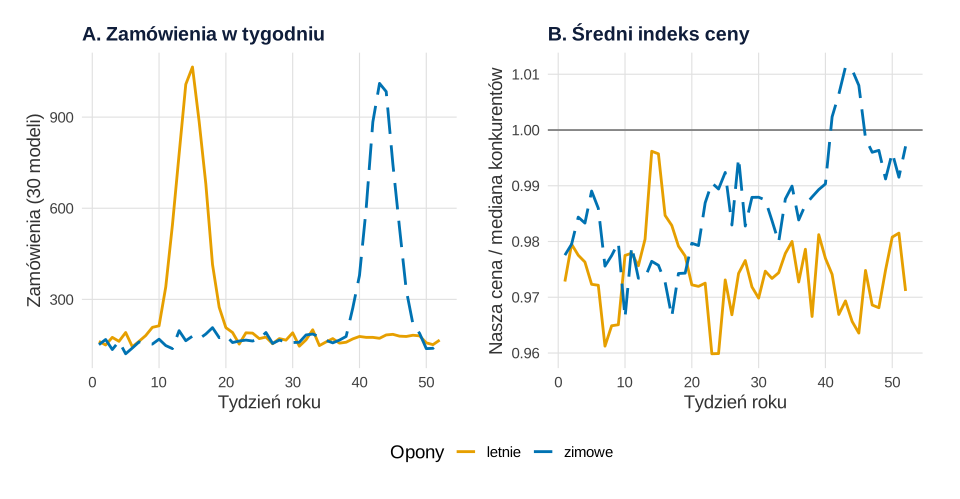
set.seed(697)).Co widać. Opony letnie mają poza sezonem średnio 162 zamówienia tygodniowo, a w szczycie (15. tydzień) 1065; zimowe – 154 i 1011 (43. tydzień). W szczycie sklep podnosi ceny mocniej niż konkurenci: indeks zimowych rośnie z 0.985 do 1.011, letnich z 0.974 do 0.996. Przez cały rok mediana indeksu to 0.979, a 90% dni mieści się między 0.838 i 1.134.
Jak może zmylić. Najdrożej jesteśmy wtedy, gdy sprzedajemy najwięcej, więc prosta korelacja podpowie, że „wyższa cena nie szkodzi”. To sezonowość działa jak zmienna zakłócająca: podnosi i popyt, i nasze ceny. Podobnie pogoda podnosi sprzedaż w innych branżach (zob. pogoda a sprzedaż).
Podpis do pracy:
Rysunek 2: regresja log–log z efektami stałymi
W 43.0% dni model opony nie ma zamówień, a logarytmu zera nie policzymy. Poza tym logarytmowanie zmiennej zależnej i zwykła regresja przy niejednorodnej wariancji obciążają elastyczności (Santos Silva i Tenreyro, 2006). Dlatego liczymy regresję Poissona, w której logarytm dotyczy oczekiwanej liczby zamówień, a predyktorem jest logarytm indeksu (transformacja logarytmiczna). Współczynnik czytamy jak elastyczność. Model wygląda tak:
α to efekty stałe modelu opony: porównujemy model z samym sobą, więc jego popularność nie miesza się z ceną. δ to osobny efekt każdego dnia dla opon letnich i zimowych – usuwa sezon, dzień tygodnia i pogodę. Więcej w artykule o danych panelowych i efektach stałych. Suma β to efekt trwałej zmiany indeksu. Błędy standardowe są odporne na klastrowanie po modelach opon, bo dni tego samego modelu nie są niezależne (Cameron i Miller, 2015).
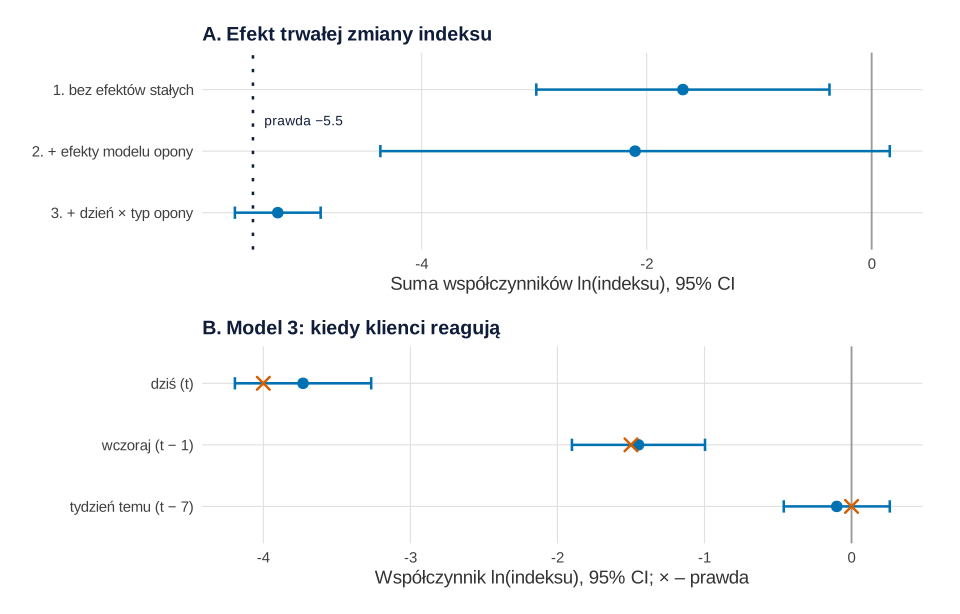
set.seed(697)).Co widać. Bez efektów stałych suma współczynników wynosi −1.68, 95% CI [−2.98, −0.38], z efektami modelu −2.10 [−4.37, 0.16]. Dopiero model 3 (opony tego samego typu tego samego dnia) daje −5.28 [−5.66, −4.90] przy prawdzie −5.5. Indeks wyższy trwale o 1% to 5.1% mniej zamówień; o 5% – 22.7% mniej, a niższy o 5% – 31.1% więcej. Na wykresie współczynników w panelu B widać, że klienci reagują na indeks z dziś (−3.73 [−4.19, −3.27]) i z wczoraj (−1.45 [−1.90, −1.00]), a na indeks sprzed tygodnia już nie (−0.10 [−0.46, 0.26]).
Jak może zmylić. Efekty stałe nie usuwają tego, co zmienia się w obrębie jednego modelu – o tym rysunek 4. Indeks dziś i wczoraj jest silnie skorelowany (r = .93), więc pojedyncze współczynniki mają szerokie przedziały (współliniowość); suma jest precyzyjniejsza. Duża elastyczność nie dziwi: w otoczeniu porównywarki cen popyt na część produktów bywa ogromnie wrażliwy na cenę (Ellison i Ellison, 2009).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: próg „najtańszy w porównywarce”
Porównywarka sortuje oferty od najtańszej. Pierwsze miejsce może dawać więcej, niż wynika z gładkiej krzywej popytu. Sprawdzamy to zmienną 0/1 „najtańszy” (zmienna zero-jedynkowa) oraz rysunkiem: dzielimy dni według stosunku naszej ceny do najtańszego dostępnego konkurenta i porównujemy zamówienia z liczbą oczekiwaną z modelu bez tej zmiennej.
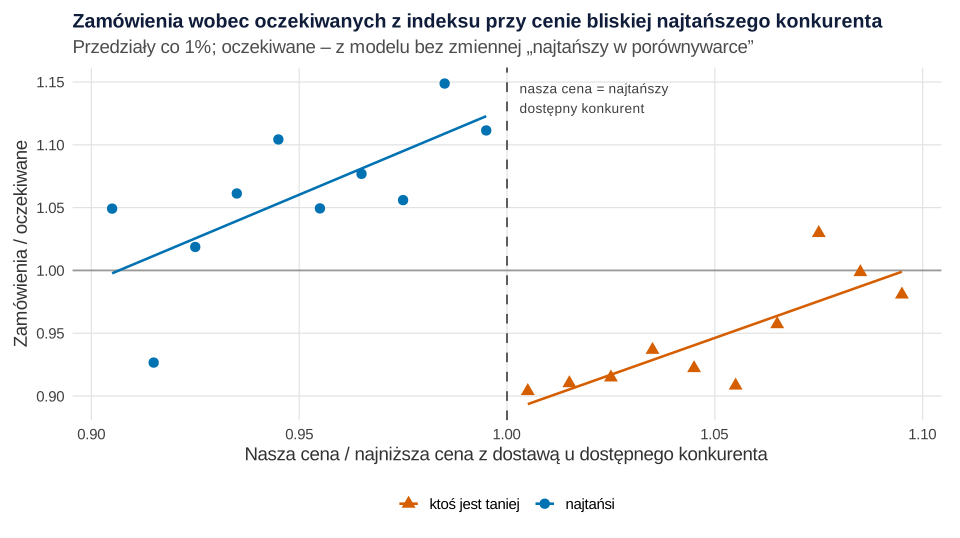
set.seed(697)).Co widać. Gdy nasza cena jest do 3% niższa od najtańszego konkurenta, zamówień jest o 10.7% więcej, niż przewiduje sam indeks (stosunek 1.107). Gdy jest do 3% wyższa – o 9.1% mniej (0.909). W modelu 3 bycie najtańszym podnosi zamówienia o 25.4%, 95% CI [20.0, 31.1], przy prawdzie 22.1%. Sam skok przy progu przypomina regresję nieciągłą: tylko w dniach z ceną w odległości do 3% od najtańszego (5298 obserwacji) wychodzi +31.5% [24.2, 39.2].
Jak może zmylić. Wąskie okno daje szerszy przedział. Pierwsze miejsce na liście nie gwarantuje sprzedaży: w badaniu 20 268 klientów porównywarki książek trzy najbardziej znane sklepy mogły być o 1.72 USD drożej i nadal wygrywać w bezpośrednich porównaniach, bo marka sklepu jest dla klientów sygnałem m.in. niezawodnej dostawy (Smith i Brynjolfsson, 2001). W Twoich danych skok może być mniejszy.
Podpis do pracy:
Rysunek 4: sklep tnie cenę, gdy sprzedaż spada
W naszych danych sklep zmieniał ceny według cennika hurtowego i zaplanowanych promocji. Często jest inaczej: gdy model słabo się sprzedaje, kierownik daje rabat. Wtedy strzałka biegnie także od sprzedaży do ceny – to odwrotna przyczynowość (korelacja a przyczynowość). Ceny są ustalane przez menedżerów, a pominięcie tego może znacznie obciążać oszacowania (Villas-Boas i Winer, 1999).
Symulujemy 3 × 1000 prostszych sklepów (40 modeli × 52 tygodnie, prawdziwa elastyczność −2.5, trwałe szoki popytu). W wariancie „reaktywnym” sklep daje rabat 8% po tygodniu poniżej 85% planu i podnosi cenę o 4% po tygodniu powyżej 115%. W wariancie losowym rabaty i podwyżki trafiają w losowe tygodnie z podobną częstością (rabat w 32.9 i 34.1% tygodni w przykładowym sklepie). Regułę zmieniliśmy po pierwszym przebiegu (zob. kod).
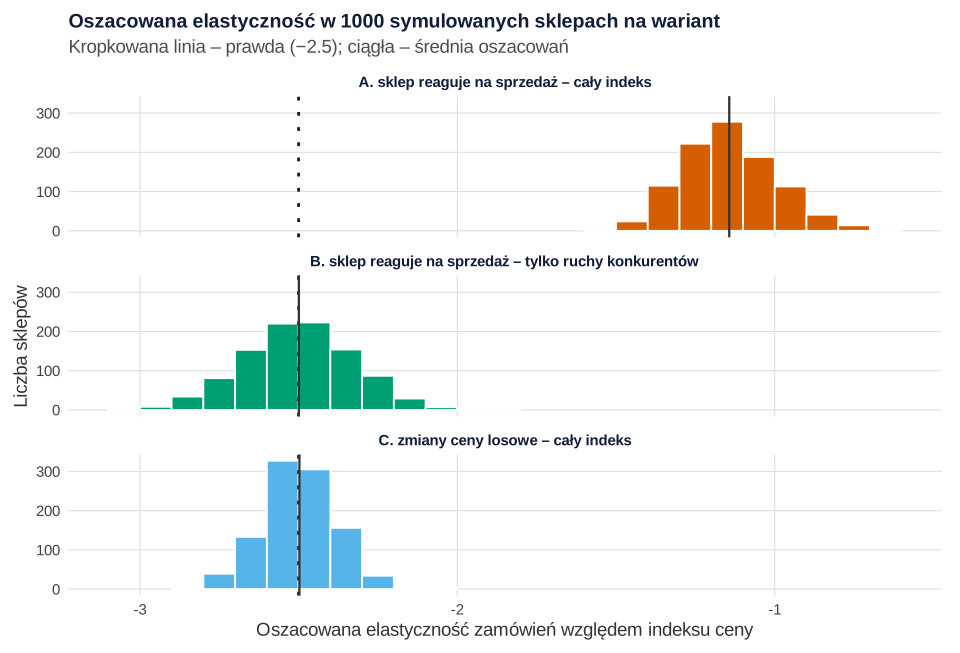
set.seed(6971)).Co widać. Gdy sklep reaguje na sprzedaż, model Poissona z efektami stałymi daje średnio −1.14 (błąd Monte Carlo 0.005) zamiast −2.5: rabat trafia na słabe tygodnie, więc tania cena „idzie w parze” z niską sprzedażą. Wszystkie 1000 oszacowań leży powyżej −2. Gdy ceny zmieniają się losowo, średnia to −2.50 (SD = 0.111). Ratunek w wariancie reaktywnym to zmienność, której sklep nie wybiera: ruchy cen konkurentów. Jeśli klienci patrzą na indeks, podwyżka u konkurentów o 1% działa jak nasza obniżka o 1%. To daje średnio −2.50, z większym rozrzutem (SD = 0.172).
Jak może zmylić. To logika zmiennej instrumentalnej: korzystamy tylko z części zmienności, niezwiązanej z pominiętymi zmiennymi (Angrist i Krueger, 2001). Działa, gdy konkurenci nie reagują na nasze szoki popytu. Na chmurze punktów z kasy problemu nie zobaczysz. Metaanaliza 1851 elastyczności pokazała, że uwzględnienie endogeniczności ceny wyraźnie zwiększa ich wartość bezwzględną (Bijmolt i in., 2005). Losowe zmiany ceny opisuje wpis o losowym teście ceny.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: brak towaru i koszt dostawy
Liczymy model 3 jeszcze trzy razy: z cenami konkurentów bez towaru (5.9% dni), bez dostawy i z oboma błędami.
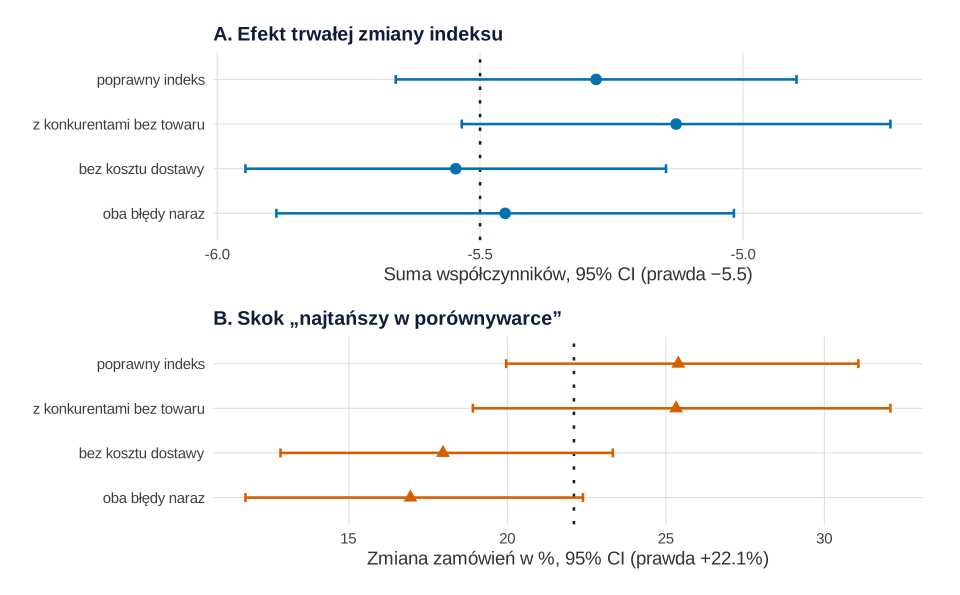
set.seed(697)).Co widać. Elastyczność prawie się nie zmienia (od −5.55 do −5.13). Zmienia się za to pozycja: bez dostawy mediana indeksu rośnie z 0.979 do 1.002, a odsetek dni, w których jesteśmy najtańsi, spada z 35.4 do 30.8%. Skok „najtańszy” spada z 25.4% do 18.0% [12.8, 23.3], a przy obu błędach do 16.9%.
Jak może zmylić. Dostawa konkurenta jest stała, więc efekty stałe modelu ją „zjadają”. Ale decyzje zapadają na poziomie indeksu: sklep, który myśli, że jest „po rynku” (1.00), naprawdę jest o ponad 2% tańszy. Sklepy stosują też praktyki, które utrudniają porównanie ofert i zmniejszają wrażliwość klientów na cenę (Ellison i Ellison, 2009), dlatego porównuj pełny koszt dla klienta. Braki towaru to w praktyce braki danych nie losowe: częstsze w szczycie sezonu.
Podpis do pracy:
Rysunek 6: karta „indeks 0.95 / 1.00 / 1.05”
Z modelu 3 liczymy, co by było, gdyby sklep przez cały rok trzymał stały indeks, a konkurenci zachowywali się jak w danych. Koszt opony (zakup i obsługa zamówienia) ustaliliśmy ręcznie na 82% mediany cen konkurentów, czyli marża przy indeksie 1.00 to 18%.
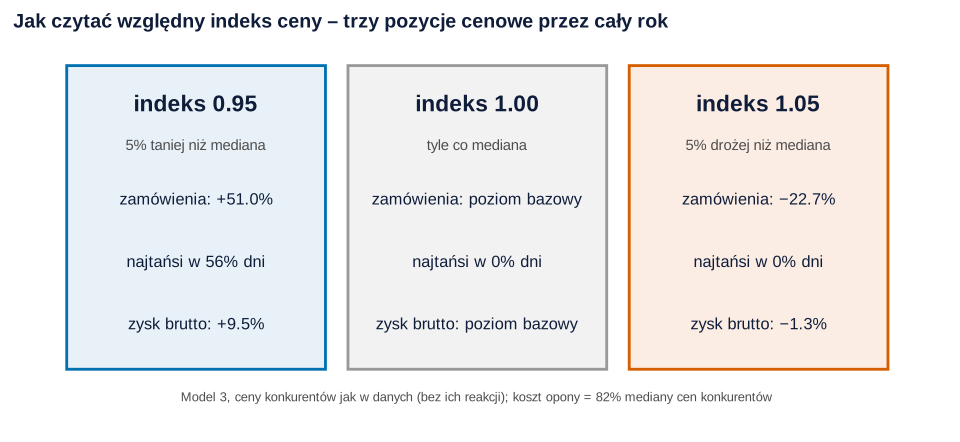
set.seed(697); koszt opony ustalony ręcznie).Co widać. Przy indeksie 1.00 model przewiduje 21 425 zamówień i 1730 tys. zł zysku brutto w 357 dniach. Indeks 0.95 daje 51.0% więcej zamówień, pierwsze miejsce w 56% dni i 9.5% więcej zysku. Indeks 1.05 to 22.7% mniej zamówień i zysk o 1.3% niższy. Bez skoku „najtańszy” indeks 0.95 dałby 31.1% więcej zamówień, ale zysk niższy o 5.3%: przewagę w zysku daje pierwsze miejsce w porównywarce.
Jak może zmylić. Karta zakłada, że konkurenci nie odpowiedzą. Jeśli dorównają do 0.95, próg znika, a zostaje niższa marża.
Podpis do pracy:
Co z tym zrobić w marketingu
- Licz indeks tak, jak widzi go klient: z dostawą i tylko z ofert z towarem. Inaczej mylisz się co do pozycji o ponad 2%.
- Szukaj progów, nie tylko krzywej. Pierwsze miejsce w porównywarce dało +25.4% zamówień; cena tuż pod najtańszym konkurentem bywa warta więcej niż ogólna obniżka.
- Nie wierz elastyczności z danych, w których sam sterujesz ceną pod sprzedaż. Analizuj ruchy cen konkurentów albo wprowadź losowe zmiany ceny na części modeli – to test A/B ceny.
- Odróżnij sezon od ceny: porównuj opony tego samego typu tego samego dnia.
- Licz zysk, nie zamówienia: przy indeksie 1.05 zamówień jest o 22.7% mniej, zysku – o 1.3%.
Jak opisać w pracy
Opisz źródło cen konkurentów, definicję indeksu, efekty stałe i to, kto ustalał ceny. Szerzej o analizach w pracach z marketingu: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane i funkcje indeks_ceny() i opoznij(), przepis 2 – modele d i m3 używane w przepisach 3 i 6. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 697 w przepisie 1, 6971 (1000 powtórzeń) i 6972 (przykładowy sklep) w przepisie 4; pozostałe przepisy nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: w przepisie 1 – ceny przykładowej opony, 60 modeli (po 30 letnich i zimowych) z ceną 180–650 zł, popularność modeli (SD = 0.5 na skali ln), szczyty sezonu (10 kwietnia i 27 października, SD 14 dni, popyt 7 razy większy), narzuty konkurentów (−2, 0 i +3%), dzienne wahania ich cen (AR 0.3, SD 0.03; po pierwszym przebiegu zmienione z 0.7 i 0.02, bo indeks dziś i wczoraj był prawie identyczny i opóźnień nie dało się rozdzielić), promocje konkurentów (−6% przez 5 dni) i nasze (−7% przez tydzień), podwyżki w szczycie (konkurenci +3%, nasz sklep +5%), dostawę (0, 10 i 15 zł za oponę), przerwy w dostępności oraz prawdziwe współczynniki popytu (−4.0 i −1.5 przy ln indeksu dziś i wczoraj, 0 sprzed tygodnia; po pierwszym przebiegu zmienione z −2.0 i −0.8, bo przy słabszej reakcji sklep z marżą 18% zarabiałby najwięcej na cenach o kilkanaście procent wyższych od rynku, co w porównywarce jest mało realne; +0.20 za bycie najtańszym, szum SD = 0.25); w przepisie 3 – okno ±3% wokół progu; w przepisie 4 – 40 modeli × 52 tygodnie, elastyczność −2.5, szoki popytu (AR 0.8, SD 0.15), regułę rabatu 8% poniżej 85% planu i podwyżki 4% powyżej 115% (po pierwszym przebiegu zamiast trwałych zmian ceny o −4% i +3% – cena błądziła wtedy jak spacer losowy, a obciążenie było małe: średnio −2.59); w przepisie 6 – koszt opony 82% mediany cen konkurentów. Przepis 4 liczy się około pół minuty, pozostałe kilka sekund.
1. Dane: 60 modeli opon przez 364 dni – Rysunek 1
R
# Dane: fikcyjny sklep internetowy z oponami, 60 modeli opon, ceny 3 konkurentów, 364 dni
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw – używane w dalszych przepisach
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Indeks na jednym przykładzie (liczby ustawione ręcznie): nasza opona 370 zł z dostawą gratis
nasza <- 370
konk <- c(A = 372, B = 365, C = 379); dostawa <- c(A = 0, B = 10, C = 15)    # cena za oponę i dostawa za oponę
przyklad <- function(ceny) c(indeks = round(nasza / median(ceny), 3), najtanszy = nasza < min(ceny))
rbind("z dostawą"           = przyklad(konk + dostawa),
      "bez dostawy"         = przyklad(konk),
      "z dostawą, A bez towaru" = przyklad((konk + dostawa)[c("B", "C")]))

# Parametry ustawione ręcznie:
#   60 modeli: 30 letnich, 30 zimowych; cena katalogowa 180–650 zł za oponę
#   sezon wymiany: szczyt opon letnich ok. 10 kwietnia, zimowych ok. 27 października (SD 14 dni),
#                  w szczycie popyt 7 razy większy niż poza sezonem
#   konkurenci A, B, C: narzut −2%, 0%, +3%; zmiany cen prawie codziennie (szum AR(1): SD 0.03, współczynnik 0.3),
#                  promocje −6% przez 5 dni; w szczycie sezonu podnoszą ceny o 3%; dostawa za oponę: 0, 10, 15 zł
#   brak towaru u konkurenta: ok. 5% dni poza sezonem, ok. 15% w szczycie (przerwy trwające kilka dni)
#   nasz sklep: dostawa gratis; narzut wyższy na popularnych modelach; zmiany cennika w poniedziałki,
#                  tygodniowe promocje −7% zaplanowane z góry; w szczycie sezonu podnosi ceny o 5%
#   PRAWDA w popycie (regresja Poissona na logarytmach):
#     log(zamówienia) = poziom modelu + sezon + dzień tygodnia
#                       − 4.0 × ln(indeks dziś) − 1.5 × ln(indeks wczoraj) + 0 × ln(indeks sprzed tygodnia)
#                       + 0.20 × [najtańszy w porównywarce] + szum (SD 0.25)
#   indeks = nasza cena / mediana (cena + dostawa) konkurentów, u których opona jest dostępna
symuluj_opony <- function(n_modeli = 60, dni = 364) {
  model <- data.frame(model = sprintf("M%02d", 1:n_modeli), typ = rep(c("letnie", "zimowe"), each = n_modeli / 2))
  model$cena_kat <- round(runif(n_modeli, 180, 650))
  model$poziom <- rnorm(n_modeli, log(0.6), 0.5)                       # popularność modelu
  model$narzut <- 0.01 + 0.04 * as.numeric(scale(model$poziom)) + rnorm(n_modeli, 0, 0.02)
  t <- 1:dni
  szczyt <- rbind(letnie = exp(-(t - 100)^2 / (2 * 14^2)), zimowe = exp(-(t - 300)^2 / (2 * 14^2)))
  dzien_tyg <- (t - 1) %% 7 + 1                                         # 1 = poniedziałek
  efekt_dnia <- log(c(1.15, 1.10, 1.05, 1.05, 1.0, 0.8, 0.7))[dzien_tyg]
  dostawa <- c(A = 0, B = 10, C = 15)
  wiersze <- vector("list", n_modeli)
  for (i in seq_len(n_modeli)) {
    sz <- szczyt[model$typ[i], ]
    ceny <- sapply(c(A = -0.02, B = 0, C = 0.03), function(m) {     # ceny konkurentów (zł za oponę)
      szum <- as.numeric(stats::filter(rnorm(dni, 0, 0.03), 0.3, method = "recursive"))
      promo <- as.numeric(stats::filter(rbinom(dni, 1, 0.012), rep(1, 5), sides = 1)); promo[is.na(promo)] <- 0
      model$cena_kat[i] * exp(m + rnorm(1, 0, 0.03) + szum - 0.06 * (promo > 0) + 0.03 * sz)
    })
    dost <- sapply(1:3, function(k) {                                   # dostępność: przerwy po kilka dni
      d <- integer(dni); d[1] <- 1
      for (s in 2:dni) d[s] <- if (d[s - 1] == 1) rbinom(1, 1, 1 - (0.01 + 0.04 * sz[s])) else rbinom(1, 1, 0.2)
      d
    })
    tydz <- (t - 1) %/% 7 + 1
    cennik <- cumsum(ifelse(rbinom(52, 1, 0.15) == 1, rnorm(52, 0, 0.03), 0))[tydz]
    promo_wl <- rbinom(52, 1, 0.06)[tydz]
    nasza <- model$cena_kat[i] * exp(model$narzut[i] + cennik - 0.07 * promo_wl + 0.05 * sz)
    koszt_kl <- sweep(ceny, 2, dostawa, "+")                            # cena + dostawa dla klienta
    dostepne <- ifelse(dost == 1, koszt_kl, NA)
    med <- apply(dostepne, 1, median, na.rm = TRUE); mn <- suppressWarnings(apply(dostepne, 1, min, na.rm = TRUE))
    brak_wsz <- !is.finite(mn); med[brak_wsz] <- apply(koszt_kl[brak_wsz, , drop = FALSE], 1, median); mn[brak_wsz] <- Inf
    li <- log(nasza / med)
    li1 <- c(li[1], li[-dni]); li7 <- c(rep(li[1], 7), li[1:(dni - 7)])
    najtanszy <- as.integer(nasza < mn)
    eta <- model$poziom[i] + log(1 + 6 * sz) + efekt_dnia - 4.0 * li - 1.5 * li1 + 0 * li7 + 0.20 * najtanszy +
      rnorm(dni, 0, 0.25)
    wiersze[[i]] <- data.frame(model = model$model[i], typ = model$typ[i], dzien = t, tydzien = tydz,
      dzien_tyg = dzien_tyg, cena_wlasna = round(nasza, 2),
      cena_A = round(ceny[, 1], 2), cena_B = round(ceny[, 2], 2), cena_C = round(ceny[, 3], 2),
      dostepna_A = dost[, 1], dostepna_B = dost[, 2], dostepna_C = dost[, 3], zamowienia = rpois(dni, exp(eta)))
  }
  do.call(rbind, wiersze)
}

set.seed(697)
opony <- symuluj_opony()
write.csv(opony, "pozycja-cenowa-opony-60-modeli-364-dni.csv", row.names = FALSE)

# Względny indeks ceny: nasza cena / mediana (cena + dostawa) dostępnych konkurentów
indeks_ceny <- function(d, dostawa = c(A = 0, B = 10, C = 15), tylko_dostepne = TRUE) {
  k_wsz <- sweep(as.matrix(d[c("cena_A", "cena_B", "cena_C")]), 2, dostawa, "+")
  k <- k_wsz
  if (tylko_dostepne) k[as.matrix(d[c("dostepna_A", "dostepna_B", "dostepna_C")]) == 0] <- NA
  med <- apply(k, 1, median, na.rm = TRUE)
  mn <- suppressWarnings(apply(k, 1, min, na.rm = TRUE))        # Inf, gdy nikt nie ma opony
  brak <- is.na(med); med[brak] <- apply(k_wsz[brak, , drop = FALSE], 1, median)
  data.frame(indeks = d$cena_wlasna / med, najtanszy = as.integer(d$cena_wlasna < mn))
}
opony <- cbind(opony, indeks_ceny(opony))

cat("Wiersze (model × dzień):", nrow(opony), "| modele:", length(unique(opony$model)), "\n")
cat("Zamówienia razem:", sum(opony$zamowienia), "| dni bez zamówienia danego modelu:",
    sprintf("%.1f%%", 100 * mean(opony$zamowienia == 0)), "\n")
cat(sprintf("Indeks ceny: mediana %.3f, 5. i 95. centyl %.3f i %.3f | najtańszy w porównywarce: %.1f%% dni\n",
            median(opony$indeks), quantile(opony$indeks, 0.05), quantile(opony$indeks, 0.95), 100 * mean(opony$najtanszy)))
cat(sprintf("Opona niedostępna u konkurenta: %.1f%% dni (A, B, C razem)\n",
            100 * mean(as.matrix(opony[c("dostepna_A", "dostepna_B", "dostepna_C")]) == 0)))
# Opóźnienia indeksu w obrębie modelu: wczoraj (t − 1) i tydzień wcześniej (t − 7)
opoznij <- function(x, k) ave(x, opony$model, FUN = function(v) c(rep(NA, k), head(v, -k)))
opony$ln_i <- log(opony$indeks)
opony$ln_i1 <- opoznij(opony$ln_i, 1)
opony$ln_i7 <- opoznij(opony$ln_i, 7)
cat(sprintf("Korelacja ln(indeksu) dziś z wczoraj: %.2f, z tygodniem wcześniej: %.2f\n",
            cor(opony$ln_i, opony$ln_i1, use = "complete"), cor(opony$ln_i, opony$ln_i7, use = "complete")))

# Rysunek 1. Sezon wymiany opon (A) i średni indeks ceny w tygodniach (B)
tyg <- merge(aggregate(zamowienia ~ tydzien + typ, data = opony, FUN = sum),
             aggregate(indeks ~ tydzien + typ, data = opony, FUN = mean))
cat("\nTydzień szczytu i średnio w pozostałych tygodniach:\n")
for (ty in c("letnie", "zimowe")) {
  x <- tyg[tyg$typ == ty, ]; s <- which.max(x$zamowienia); poza <- x$zamowienia < median(x$zamowienia)
  cat(sprintf("  %s: szczyt w tygodniu %d (%d zamówień, indeks %.3f) | poza sezonem średnio %.0f zamówień, indeks %.3f\n",
              ty, x$tydzien[s], x$zamowienia[s], x$indeks[s], mean(x$zamowienia[poza]), mean(x$indeks[poza])))
}
p1a <- ggplot(tyg, aes(tydzien, zamowienia, colour = typ, linetype = typ)) +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = c(letnie = kol[["zolty"]], zimowe = kol[["niebieski"]]), name = "Opony") +
  scale_linetype_manual(values = c(letnie = "solid", zimowe = "longdash"), name = "Opony") +
  labs(title = "A. Zamówienia w tygodniu", x = "Tydzień roku", y = "Zamówienia (30 modeli)") + motyw
p1b <- ggplot(tyg, aes(tydzien, indeks, colour = typ, linetype = typ)) +
  geom_hline(yintercept = 1, colour = "grey50") +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = c(letnie = kol[["zolty"]], zimowe = kol[["niebieski"]]), name = "Opony") +
  scale_linetype_manual(values = c(letnie = "solid", zimowe = "longdash"), name = "Opony") +
  labs(title = "B. Średni indeks ceny", x = "Tydzień roku", y = "Nasza cena / mediana konkurentów") + motyw
p1 <- (p1a | p1b) + plot_layout(guides = "collect") &
  theme(legend.position = "bottom")
p1                       # do pliku: ggsave("pozycja-cenowa-sezon-i-indeks.svg", p1, width = 10, height = 5.2)
Wynik w R
                        indeks najtanszy
z dostawą                0.987         1
bez dostawy              0.995         0
z dostawą, A bez towaru  0.962         1
Wiersze (model × dzień): 21840 | modele: 60
Zamówienia razem: 26294 | dni bez zamówienia danego modelu: 43.0%
Indeks ceny: mediana 0.979, 5. i 95. centyl 0.838 i 1.134 | najtańszy w porównywarce: 35.4% dni
Opona niedostępna u konkurenta: 5.9% dni (A, B, C razem)
Korelacja ln(indeksu) dziś z wczoraj: 0.93, z tygodniem wcześniej: 0.86

Tydzień szczytu i średnio w pozostałych tygodniach:
  letnie: szczyt w tygodniu 15 (1065 zamówień, indeks 0.996) | poza sezonem średnio 162 zamówień, indeks 0.974
  zimowe: szczyt w tygodniu 43 (1011 zamówień, indeks 1.011) | poza sezonem średnio 154 zamówień, indeks 0.985
2. Regresja log–log z efektami stałymi – Rysunek 2
R
# Rysunek 2. Regresja log–log (Poissona) z efektami stałymi i opóźnieniami indeksu
# (korzysta z opony, kol i motyw z przepisu 1; nie losuje)
library(fixest)
d <- subset(opony, dzien > 7)            # pierwszy tydzień nie ma indeksu sprzed 7 dni
# ln(indeks): dziś, wczoraj, tydzień temu; najtanszy = 1, gdy jesteśmy najtańsi w porównywarce
m1 <- fepois(zamowienia ~ ln_i + ln_i1 + ln_i7 + najtanszy, data = d, cluster = ~model)          # bez efektów stałych
m2 <- fepois(zamowienia ~ ln_i + ln_i1 + ln_i7 + najtanszy | model, data = d, cluster = ~model)  # efekty modelu opony
m3 <- fepois(zamowienia ~ ln_i + ln_i1 + ln_i7 + najtanszy | model + typ^dzien,                  # + każdy dzień osobno
             data = d, cluster = ~model)                                                         #   dla letnich i zimowych
etable(m1, m2, m3, digits = 3, fitstat = ~n)

# Efekt trwałej zmiany indeksu = suma współczynników przy ln(indeksu) dziś, wczoraj i sprzed tygodnia
trwaly <- function(m, nazwa) {
  b <- coef(m)[c("ln_i", "ln_i1", "ln_i7")]; V <- vcov(m)[names(b), names(b)]
  s <- sum(b); se <- sqrt(sum(V))
  data.frame(model = nazwa, oszac = s, dolna = s - 1.96 * se, gorna = s + 1.96 * se)
}
tab <- rbind(trwaly(m1, "1. bez efektów stałych"), trwaly(m2, "2. + efekty modelu opony"),
             trwaly(m3, "3. + dzień × typ opony"))
cat("\nEfekt trwałej zmiany indeksu (prawda: −5.5):\n"); print(tab, digits = 3, row.names = FALSE)
cat(sprintf("Model 3: indeks wyższy o 1%% -> zamówienia %+.1f%%; o 5%% -> %+.1f%%; niższy o 5%% -> %+.1f%%\n",
            100 * (1.01^tab$oszac[3] - 1), 100 * (1.05^tab$oszac[3] - 1), 100 * (0.95^tab$oszac[3] - 1)))
op <- data.frame(skladnik = c("dziś (t)", "wczoraj (t − 1)", "tydzień temu (t − 7)"),
                 oszac = coef(m3)[c("ln_i", "ln_i1", "ln_i7")], se = se(m3)[c("ln_i", "ln_i1", "ln_i7")],
                 prawda = c(-4.0, -1.5, 0))
op$dolna <- op$oszac - 1.96 * op$se; op$gorna <- op$oszac + 1.96 * op$se
cat("\nOpóźnienia w modelu 3:\n"); print(op, digits = 3, row.names = FALSE)

p2a <- ggplot(tab, aes(oszac, factor(model, rev(model)))) +
  geom_vline(xintercept = -5.5, linetype = "dotted", colour = kol[["granat"]], linewidth = 0.9) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_point(size = 3.2, colour = kol[["niebieski"]]) +
  annotate("text", x = -5.4, y = 2.5, label = "prawda −5.5", hjust = 0, size = 3.6, colour = kol[["granat"]]) +
  labs(title = "A. Efekt trwałej zmiany indeksu", x = "Suma współczynników ln(indeksu), 95% CI", y = NULL) + motyw
p2b <- ggplot(op, aes(oszac, factor(skladnik, rev(skladnik)))) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_point(size = 3.2, colour = kol[["niebieski"]]) +
  geom_point(aes(x = prawda), shape = 4, size = 3.6, stroke = 1.3, colour = kol[["pomaranczowy"]]) +
  labs(title = "B. Model 3: kiedy klienci reagują", x = "Współczynnik ln(indeksu), 95% CI; × – prawda", y = NULL) + motyw
p2 <- p2a / p2b
p2                       # do pliku: ggsave("pozycja-cenowa-modele-log-log.svg", p2, width = 10, height = 6.4)
Wynik w R
                              m1               m2               m3
Dependent Var.:       zamowienia       zamowienia       zamowienia

Constant           0.018 (0.044)
ln_i            -2.70*** (0.336) -2.79*** (0.366) -3.73*** (0.236)
ln_i1             -0.472 (0.295)   -0.580 (0.396) -1.45*** (0.231)
ln_i7            1.49*** (0.417)    1.27* (0.615)   -0.100 (0.184)
najtanszy       0.263*** (0.071) 0.282*** (0.057) 0.226*** (0.023)
Fixed-Effects:  ---------------- ---------------- ----------------
model                         No              Yes              Yes
typ-dzien                     No               No              Yes
_______________ ________________ ________________ ________________
S.E.: Clustered        by: model        by: model        by: model
Observations              21,420           21,420           21,420
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Efekt trwałej zmiany indeksu (prawda: −5.5):
                    model oszac dolna  gorna
   1. bez efektów stałych -1.68 -2.98 -0.375
 2. + efekty modelu opony -2.10 -4.37  0.161
   3. + dzień × typ opony -5.28 -5.66 -4.898
Model 3: indeks wyższy o 1% -> zamówienia -5.1%; o 5% -> -22.7%; niższy o 5% -> +31.1%

Opóźnienia w modelu 3:
             skladnik oszac    se prawda  dolna  gorna
             dziś (t) -3.73 0.236   -4.0 -4.193 -3.267
      wczoraj (t − 1) -1.45 0.231   -1.5 -1.901 -0.996
 tydzień temu (t − 7) -0.10 0.184    0.0 -0.461  0.260
3. Próg „najtańszy w porównywarce” – Rysunek 3
R
# Rysunek 3. Próg „najtańszy w porównywarce” – skok zamówień przy cenie tuż poniżej najtańszego konkurenta
# (korzysta z d, m3, kol i motyw z przepisów 1–2; nie losuje)
k <- sweep(as.matrix(d[c("cena_A", "cena_B", "cena_C")]), 2, c(0, 10, 15), "+")
k[as.matrix(d[c("dostepna_A", "dostepna_B", "dostepna_C")]) == 0] <- NA
d$do_min <- d$cena_wlasna / suppressWarnings(apply(k, 1, min, na.rm = TRUE))  # nasza cena / najtańszy konkurent
# Model bez zmiennej „najtańszy”: ile zamówień „powinno” być przy danym indeksie
m_bez <- fepois(zamowienia ~ ln_i + ln_i1 + ln_i7 | model + typ^dzien, data = d)
d$oczekiwane <- predict(m_bez, newdata = d)
okno <- subset(d, is.finite(do_min) & do_min > 0.9 & do_min < 1.1)
okno$przedzial <- cut(okno$do_min, seq(0.9, 1.1, by = 0.01))
kosz <- aggregate(cbind(zamowienia, oczekiwane) ~ przedzial, data = okno, FUN = sum)
kosz$x <- seq(0.905, 1.095, by = 0.01)[as.integer(kosz$przedzial)]
kosz$stosunek <- kosz$zamowienia / kosz$oczekiwane
kosz$strona <- ifelse(kosz$x < 1, "najtańsi", "ktoś jest taniej")
cat("Dni w oknie 0.90–1.10 ceny najtańszego konkurenta:", nrow(okno), "\n")
cat(sprintf("Zamówienia / oczekiwane: tuż poniżej progu (0.97–1.00) %.3f, tuż powyżej (1.00–1.03) %.3f\n",
            with(subset(okno, do_min >= 0.97 & do_min < 1), sum(zamowienia) / sum(oczekiwane)),
            with(subset(okno, do_min >= 1 & do_min < 1.03), sum(zamowienia) / sum(oczekiwane))))
g <- coeftable(m3)["najtanszy", ]
cat(sprintf("Model 3: skok przy byciu najtańszym exp(%.3f) - 1 = %+.1f%%, 95%% CI [%+.1f%%, %+.1f%%] (prawda +22.1%%)\n",
            g[1], 100 * (exp(g[1]) - 1), 100 * (exp(g[1] - 1.96 * g[2]) - 1), 100 * (exp(g[1] + 1.96 * g[2]) - 1)))
# Sprawdzenie lokalne: tylko dni, gdy nasza cena była w odległości do 3% od najtańszego konkurenta
m_lok <- fepois(zamowienia ~ ln_i + ln_i1 + ln_i7 + najtanszy | model + typ^dzien,
                data = subset(d, abs(do_min - 1) < 0.03), cluster = ~model)
gl <- coeftable(m_lok)["najtanszy", ]
cat(sprintf("Tylko okno ±3%% (n = %d): skok %+.1f%%, 95%% CI [%+.1f%%, %+.1f%%]\n", nobs(m_lok),
            100 * (exp(gl[1]) - 1), 100 * (exp(gl[1] - 1.96 * gl[2]) - 1), 100 * (exp(gl[1] + 1.96 * gl[2]) - 1)))

p3 <- ggplot(kosz, aes(x, stosunek, colour = strona, shape = strona)) +
  geom_hline(yintercept = 1, colour = "grey60") +
  geom_vline(xintercept = 1, linetype = "dashed", colour = "grey30") +
  geom_smooth(aes(group = strona), method = "lm", formula = y ~ x, se = FALSE, linewidth = 0.9) +
  geom_point(size = 3.2) +
  scale_colour_manual(values = c("najtańsi" = kol[["niebieski"]], "ktoś jest taniej" = kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c("najtańsi" = 16, "ktoś jest taniej" = 17), name = NULL) +
  annotate("text", x = 1.003, y = max(kosz$stosunek), hjust = 0, vjust = 1, size = 3.6, colour = "grey25",
           label = "nasza cena = najtańszy\ndostępny konkurent") +
  labs(title = "Zamówienia wobec oczekiwanych z indeksu przy cenie bliskiej najtańszego konkurenta",
       subtitle = "Przedziały co 1%; oczekiwane – z modelu bez zmiennej „najtańszy w porównywarce”",
       x = "Nasza cena / najniższa cena z dostawą u dostępnego konkurenta", y = "Zamówienia / oczekiwane") + motyw
p3                       # do pliku: ggsave("pozycja-cenowa-prog-najtanszy.svg", p3, width = 10, height = 5.6)
Wynik w R
Dni w oknie 0.90–1.10 ceny najtańszego konkurenta: 15167
Zamówienia / oczekiwane: tuż poniżej progu (0.97–1.00) 1.107, tuż powyżej (1.00–1.03) 0.909
Model 3: skok przy byciu najtańszym exp(0.226) - 1 = +25.4%, 95% CI [+20.0%, +31.1%] (prawda +22.1%)
Tylko okno ±3% (n = 5298): skok +31.5%, 95% CI [+24.2%, +39.2%]
4. Odwrotna przyczynowość: 3 × 1000 sklepów – Rysunek 4
R
# Rysunek 4. Odwrotna przyczynowość: sklep tnie cenę, gdy sprzedaż spada – 3 × 1000 symulowanych sklepów
# (korzysta z kol i motyw z przepisu 1)
library(fixest)
# Jeden sklep: 40 modeli × 52 tygodnie. Parametry ustawione ręcznie:
#   prawdziwa elastyczność względem indeksu: −2.5; ok. 20 zamówień modelu tygodniowo
#   szok popytu modelu (pogoda, opinie, moda) – trwały: AR(1), współczynnik 0.8, SD 0.15
#   ceny konkurentów: niezależne od naszego popytu (szum SD 0.04 tygodniowo)
#   reguła „reaktywna”: zamówienia w zeszłym tygodniu < 85% planu -> rabat 8% na ten tydzień;
#                       > 115% planu -> cena +4%; inaczej cena regularna
#   reguła „losowa”: rabat 8% i podwyżka 4% w losowych tygodniach (co trzeci tydzień każde), bez patrzenia na sprzedaż
symuluj_sklep <- function(regula = c("reaktywna", "losowa"), n_mod = 40, tyg = 52, e = -2.5) {
  regula <- match.arg(regula)
  poziom <- log(20) + rnorm(n_mod, 0, 0.4)
  szok <- matrix(0, n_mod, tyg); szok[, 1] <- rnorm(n_mod, 0, 0.25)
  for (s in 2:tyg) szok[, s] <- 0.8 * szok[, s - 1] + rnorm(n_mod, 0, 0.15)
  ln_konk <- matrix(log(400) + rnorm(n_mod * tyg, 0, 0.04), n_mod, tyg)
  ln_nasza <- matrix(log(400), n_mod, tyg); y <- matrix(0, n_mod, tyg)
  for (s in 1:tyg) {
    if (s > 1) {
      plan <- exp(poziom + e * (ln_nasza[, s - 1] - ln_konk[, s - 1]))   # sprzedaż oczekiwana bez szoku
      zmiana <- if (regula == "reaktywna") ifelse(y[, s - 1] < 0.85 * plan, -0.08, ifelse(y[, s - 1] > 1.15 * plan, 0.04, 0))
                else sample(c(-0.08, 0, 0.04), n_mod, replace = TRUE)
      ln_nasza[, s] <- log(400) + zmiana
    }
    y[, s] <- rpois(n_mod, exp(poziom + szok[, s] + e * (ln_nasza[, s] - ln_konk[, s])))
  }
  data.frame(model = rep(1:n_mod, tyg), tydzien = rep(1:tyg, each = n_mod), y = as.vector(y),
             ln_i = as.vector(ln_nasza - ln_konk), ln_konk = as.vector(ln_konk), rabat = as.vector(ln_nasza < log(400)))
}
szacuj <- function(s, zmienna) coef(fepois(as.formula(paste("y ~", zmienna, "| model + tydzien")), data = s))[[1]]

set.seed(6971)

wyniki <- do.call(rbind, lapply(1:1000, function(r) {
  s_r <- symuluj_sklep("reaktywna"); s_l <- symuluj_sklep("losowa")
  data.frame(sym = r,
             reaktywna_indeks = szacuj(s_r, "ln_i"),            # cała zmienność indeksu
             reaktywna_konkurenci = -szacuj(s_r, "ln_konk"),    # tylko ruchy cen konkurentów (znak odwrócony)
             losowa_indeks = szacuj(s_l, "ln_i"))               # cena zmieniana losowo
}))
podsum <- data.frame(wariant = c("A. sklep reaguje na sprzedaż – cały indeks",
                                 "B. sklep reaguje na sprzedaż – tylko ruchy konkurentów",
                                 "C. zmiany ceny losowe – cały indeks"),
                     srednia = sapply(wyniki[-1], mean), sd = sapply(wyniki[-1], sd))
podsum$blad_MC <- podsum$sd / sqrt(nrow(wyniki))
podsum$proc_powyzej_minus2 <- sapply(wyniki[-1], function(x) 100 * mean(x > -2))
print(podsum, digits = 3, row.names = FALSE)
set.seed(6972); s_r <- symuluj_sklep("reaktywna"); s_l <- symuluj_sklep("losowa")   # po jednym sklepie do opisu
cat(sprintf("Przykładowy sklep: tygodnie z rabatem %.1f%% (reaktywna) i %.1f%% (losowa)\n", 100 * mean(s_r$rabat), 100 * mean(s_l$rabat)))
cat("Prawda: −2.5\n")

dl <- data.frame(wariant = rep(podsum$wariant, each = nrow(wyniki)), oszac = unlist(wyniki[-1]))
dl$wariant <- factor(dl$wariant, podsum$wariant)
srednie <- data.frame(wariant = factor(podsum$wariant, podsum$wariant), srednia = podsum$srednia)
p4 <- ggplot(dl, aes(oszac, fill = wariant)) +
  geom_histogram(binwidth = 0.1, colour = "white", boundary = 0) +
  geom_vline(xintercept = -2.5, linetype = "dotted", colour = kol[["granat"]], linewidth = 1) +
  geom_vline(data = srednie, aes(xintercept = srednia), colour = "grey20", linewidth = 0.8) +
  facet_wrap(~wariant, ncol = 1) +
  scale_fill_manual(values = unname(kol[c("pomaranczowy", "zielony", "blekit")]), guide = "none") +
  labs(title = "Oszacowana elastyczność w 1000 symulowanych sklepach na wariant",
       subtitle = "Kropkowana linia – prawda (−2.5); ciągła – średnia oszacowań",
       x = "Oszacowana elastyczność zamówień względem indeksu ceny", y = "Liczba sklepów") + motyw
p4                       # do pliku: ggsave("pozycja-cenowa-odwrotna-przyczynowosc.svg", p4, width = 10, height = 6.8)
Wynik w R
                                                wariant srednia    sd blad_MC
             A. sklep reaguje na sprzedaż – cały indeks   -1.14 0.148 0.00468
 B. sklep reaguje na sprzedaż – tylko ruchy konkurentów   -2.50 0.172 0.00545
                    C. zmiany ceny losowe – cały indeks   -2.50 0.111 0.00352
 proc_powyzej_minus2
               100.0
                 0.3
                 0.0
Przykładowy sklep: tygodnie z rabatem 32.9% (reaktywna) i 34.1% (losowa)
Prawda: −2.5
5. Brak towaru i koszt dostawy – Rysunek 5
R
# Rysunek 5. Pułapki pomiaru indeksu: brak towaru u konkurenta i koszt dostawy
# poprawny indeks: tylko konkurenci, u których opona jest dostępna, cena z dostawą
# (korzysta z opony, indeks_ceny(), opoznij(), kol i motyw z przepisu 1; nie losuje)
warianty <- list("poprawny indeks" = list(dostawa = c(0, 10, 15), dost = TRUE),
                 "z konkurentami bez towaru"             = list(dostawa = c(0, 10, 15), dost = FALSE),
                 "bez kosztu dostawy"                      = list(dostawa = c(0, 0, 0), dost = TRUE),
                 "oba błędy naraz"                         = list(dostawa = c(0, 0, 0), dost = FALSE))
pulapki <- do.call(rbind, lapply(names(warianty), function(w) {
  x <- opony[c("model", "typ", "dzien", "zamowienia", "cena_wlasna", "cena_A", "cena_B", "cena_C",
               "dostepna_A", "dostepna_B", "dostepna_C")]
  ix <- indeks_ceny(x, dostawa = warianty[[w]]$dostawa, tylko_dostepne = warianty[[w]]$dost)
  x$ln_i <- log(ix$indeks); x$najtanszy <- ix$najtanszy
  x$ln_i1 <- opoznij(x$ln_i, 1); x$ln_i7 <- opoznij(x$ln_i, 7)
  m <- fepois(zamowienia ~ ln_i + ln_i1 + ln_i7 + najtanszy | model + typ^dzien, data = subset(x, dzien > 7),
              cluster = ~model)
  b <- coef(m)[c("ln_i", "ln_i1", "ln_i7")]; se_s <- sqrt(sum(vcov(m)[names(b), names(b)]))
  g <- coeftable(m)["najtanszy", ]
  data.frame(wariant = w, mediana_indeksu = median(ix$indeks), proc_najtanszy = 100 * mean(ix$najtanszy),
             trwaly = sum(b), trwaly_dolna = sum(b) - 1.96 * se_s, trwaly_gorna = sum(b) + 1.96 * se_s,
             skok = 100 * (exp(g[1]) - 1), skok_dolna = 100 * (exp(g[1] - 1.96 * g[2]) - 1),
             skok_gorna = 100 * (exp(g[1] + 1.96 * g[2]) - 1))
}))
print(pulapki, digits = 3, row.names = FALSE)
cat("Prawda: efekt trwałej zmiany −5.5, skok „najtańszy” +22.1%\n")

pulapki$wariant <- factor(pulapki$wariant, rev(names(warianty)))
pA <- ggplot(pulapki, aes(trwaly, wariant)) +
  geom_vline(xintercept = -5.5, linetype = "dotted", colour = kol[["granat"]], linewidth = 0.9) +
  geom_errorbar(aes(xmin = trwaly_dolna, xmax = trwaly_gorna), width = 0.2, orientation = "y",
                colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_point(size = 3.2, colour = kol[["niebieski"]]) +
  labs(title = "A. Efekt trwałej zmiany indeksu", x = "Suma współczynników, 95% CI (prawda −5.5)", y = NULL) + motyw
pB <- ggplot(pulapki, aes(skok, wariant)) +
  geom_vline(xintercept = 22.1, linetype = "dotted", colour = kol[["granat"]], linewidth = 0.9) +
  geom_errorbar(aes(xmin = skok_dolna, xmax = skok_gorna), width = 0.2, orientation = "y",
                colour = kol[["pomaranczowy"]], linewidth = 0.9) +
  geom_point(size = 3.2, shape = 17, colour = kol[["pomaranczowy"]]) +
  labs(title = "B. Skok „najtańszy w porównywarce”", x = "Zmiana zamówień w %, 95% CI (prawda +22.1%)", y = NULL) +
  motyw
p5 <- pA / pB
p5                       # do pliku: ggsave("pozycja-cenowa-pulapki-pomiaru.svg", p5, width = 10, height = 6.2)
Wynik w R
                   wariant mediana_indeksu proc_najtanszy trwaly trwaly_dolna
           poprawny indeks           0.979           35.4  -5.28        -5.66
 z konkurentami bez towaru           0.980           34.1  -5.13        -5.53
        bez kosztu dostawy           1.002           30.8  -5.55        -5.95
           oba błędy naraz           1.003           29.8  -5.45        -5.89
 trwaly_gorna skok skok_dolna skok_gorna
        -4.90 25.4       20.0       31.1
        -4.72 25.3       18.9       32.1
        -5.15 18.0       12.8       23.3
        -5.02 16.9       11.7       22.4
Prawda: efekt trwałej zmiany −5.5, skok „najtańszy” +22.1%
6. Karta „indeks 0.95 / 1.00 / 1.05” – Rysunek 6
R
# Rysunek 6. Karta „indeks 0.95 / 1.00 / 1.05” – symulacja z modelu 3 przy stałych cenach konkurentów
# (korzysta z d, m3, kol i motyw z przepisów 1–2; nie losuje)
# Ręcznie: koszt opony (zakup + obsługa zamówienia) = 82% mediany cen konkurentów z dostawą
k_dost <- sweep(as.matrix(d[c("cena_A", "cena_B", "cena_C")]), 2, c(0, 10, 15), "+")
k_dost[as.matrix(d[c("dostepna_A", "dostepna_B", "dostepna_C")]) == 0] <- NA
d$mediana_konk <- d$cena_wlasna / d$indeks
d$min_konk <- suppressWarnings(apply(k_dost, 1, min, na.rm = TRUE))
scenariusz <- function(k, prog = TRUE) {      # prog = FALSE: bez skoku „najtańszy” (gładka krzywa)
  x <- d
  x$cena_wlasna <- k * x$mediana_konk                      # stała pozycja cenowa przez cały rok
  x$ln_i <- x$ln_i1 <- x$ln_i7 <- log(k)
  x$najtanszy <- if (prog) as.integer(x$cena_wlasna < x$min_konk) else 0
  zam <- predict(m3, newdata = x)
  data.frame(indeks = k, zamowienia = sum(zam), proc_najtanszy = 100 * mean(x$najtanszy),
             przychod = sum(zam * x$cena_wlasna), zysk = sum(zam * (x$cena_wlasna - 0.82 * x$mediana_konk)))
}
karta <- do.call(rbind, lapply(c(0.95, 1, 1.05), scenariusz))
baza <- karta[karta$indeks == 1, ]
karta$zam_zmiana <- 100 * (karta$zamowienia / baza$zamowienia - 1)
karta$zysk_zmiana <- 100 * (karta$zysk / baza$zysk - 1)
print(transform(karta, zamowienia = round(zamowienia), przychod = round(przychod / 1e3), zysk = round(zysk / 1e3)),
      digits = 3, row.names = FALSE)
cat("(przychód i zysk brutto w tys. zł w 357 dniach; zysk = zamówienia × (cena − koszt))\n")
bez <- scenariusz(0.95, prog = FALSE); baza_bez <- scenariusz(1, prog = FALSE)
cat(sprintf("Indeks 0.95 bez skoku „najtańszy”: zamówienia %+.1f%%, zysk brutto %+.1f%%\n",
            100 * (bez$zamowienia / baza_bez$zamowienia - 1), 100 * (bez$zysk / baza_bez$zysk - 1)))

kafle <- data.frame(x = 1:3, naglowek = c("indeks 0.95", "indeks 1.00", "indeks 1.05"),
                    opis = c("5% taniej niż mediana", "tyle co mediana", "5% drożej niż mediana"))
wiersze <- data.frame(x = rep(1:3, each = 3), y = rep(c(3.0, 2.25, 1.5), 3),
  tekst = as.vector(rbind(sprintf("zamówienia: %+.1f%%", karta$zam_zmiana),
                          sprintf("najtańsi w %.0f%% dni", karta$proc_najtanszy),
                          sprintf("zysk brutto: %+.1f%%", karta$zysk_zmiana))))
wiersze$tekst <- gsub("-", "\u2212", wiersze$tekst)                         # znak minus
wiersze$tekst[c(4, 6)] <- c("zamówienia: poziom bazowy", "zysk brutto: poziom bazowy")   # indeks 1.00
p6 <- ggplot() +
  geom_rect(data = kafle, aes(xmin = x - 0.46, xmax = x + 0.46, ymin = 0.95, ymax = 4.6),
            fill = c("#E8F1F8", "grey95", "#FBEDE4"), colour = c(kol[["niebieski"]], "grey60", kol[["pomaranczowy"]]),
            linewidth = 1) +
  geom_text(data = kafle, aes(x, 4.15, label = naglowek), fontface = "bold", size = 6, colour = "#0f1d3a") +
  geom_text(data = kafle, aes(x, 3.65, label = opis), size = 3.9, colour = "grey30") +
  geom_text(data = wiersze, aes(x, y, label = tekst), size = 4.3, colour = "#0f1d3a") +
  annotate("text", x = 2, y = 0.62, size = 3.4, colour = "grey30",
           label = "Model 3, ceny konkurentów jak w danych (bez ich reakcji); koszt opony = 82% mediany cen konkurentów") +
  scale_x_continuous(limits = c(0.5, 3.5), breaks = NULL) + scale_y_continuous(limits = c(0.45, 4.7), breaks = NULL) +
  labs(title = "Jak czytać względny indeks ceny – trzy pozycje cenowe przez cały rok", x = NULL, y = NULL) +
  motyw + theme(panel.grid = element_blank())
p6                       # do pliku: ggsave("pozycja-cenowa-karta-indeksu.svg", p6, width = 10, height = 4.6)
Wynik w R
 indeks zamowienia proc_najtanszy przychod zysk zam_zmiana zysk_zmiana
   0.95      32348        56.1018    13842 1894       51.0        9.51
   1.00      21425         0.0607     9609 1730        0.0        0.00
   1.05      16557         0.0327     7797 1708      -22.7       -1.26
(przychód i zysk brutto w tys. zł w 357 dniach; zysk = zamówienia × (cena − koszt))
Indeks 0.95 bez skoku „najtańszy”: zamówienia +31.1%, zysk brutto -5.3%
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("żółty – niebieski (opony letnie, zimowe)" = c("#E69F00", "#0072B2"),
             "niebieski – pomarańczowy" = c("#0072B2", "#D55E00"),
             "pomarańczowy – zielony (symulacja)" = c("#D55E00", "#009E73"),
             "zielony – błękit (symulacja)" = c("#009E73", "#56B4E9"),
             "niebieski – granat (prawda)" = c("#0072B2", "#0f1d3a"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                         widzenie_typowe deuteranopia
żółty – niebieski (opony letnie, zimowe)           120.2        121.5
niebieski – pomarańczowy                           114.6        108.3
pomarańczowy – zielony (symulacja)                 102.4         53.5
zielony – błękit (symulacja)                        59.5         48.8
niebieski – granat (prawda)                         41.3         40.8
czerwony – zielony (do unikania)                   121.7         21.1
                                         protanopia
żółty – niebieski (opony letnie, zimowe)      109.3
niebieski – pomarańczowy                       91.9
pomarańczowy – zielony (symulacja)             37.3
zielony – błękit (symulacja)                   51.9
niebieski – granat (prawda)                    41.3
czerwony – zielony (do unikania)               31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych policzono pakietem stats (z podstawowej instalacji R). Regresje Poissona z efektami stałymi i błędami odpornymi na klastrowanie dopasowano pakietem fixest. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
Trzy pułapki pokazały rysunki: sezon i stałe różnice modeli (rysunek 2), odwrotna przyczynowość (rysunek 4) i indeks z błędnych cen (rysunek 5). Do tego:
- Zbyt wiele opóźnień. Indeks dziś i wczoraj jest skorelowany (r = .93). Dodawaj opóźnienia uzasadnione zachowaniem klientów i raportuj ich sumę.
- Reakcja konkurentów. Model opisuje klientów przy dawnych cenach konkurentów, nie wojnę cenową.
- Ekstrapolacja. W 90% dni indeks mieścił się między 0.838 a 1.134. Prognoz dla 0.75 czy 1.30 model nie uzasadnia.
Najczęstsze pytania
Co to jest względny indeks ceny?
To cena produktu podzielona przez typową cenę konkurentów, zwykle medianę. Indeks 1.00 oznacza cenę równą rynkowi, 0.95 – o 5% niższą, 1.05 – o 5% wyższą. Licz go z ceną dostawy i tylko z ofert konkurentów, którzy mają produkt na stanie, bo tak porównuje klient.
Jak policzyć wpływ ceny względem konkurencji na sprzedaż?
Regresją, w której zmienną zależną jest liczba zamówień, a predyktorem logarytm indeksu ceny. Przy małych liczbach zamówień użyj regresji Poissona (np. fixest::fepois) z efektami stałymi produktu i dnia. Współczynnik czytasz jak elastyczność: o ile procent zmieniają się zamówienia, gdy indeks rośnie o 1%.
Dlaczego elastyczność z danych sklepu wychodzi za mała?
Często dlatego, że sklep sam obniża cenę, gdy sprzedaż spada. Tania cena trafia wtedy na słabe tygodnie i reakcja klientów wygląda na słabszą. W symulacji 1000 takich sklepów średnie oszacowanie wyniosło −1.14 przy prawdzie −2.5. Pomaga analiza samych ruchów cen konkurentów albo losowy test ceny.
Czy opłaca się być najtańszym w porównywarce?
Bywa, bo pierwsze miejsce na liście daje dodatkowy skok sprzedaży ponad gładką krzywą popytu. W przykładzie było to +25.4% zamówień, a indeks 0.95 dawał 9.5% więcej zysku brutto niż 1.00 – ale tylko przy założeniu, że konkurenci nie obniżą cen. Licz zysk, nie same zamówienia.
Po co efekty stałe w analizie ceny?
Efekty stałe produktu porównują produkt z samym sobą, więc jego popularność nie miesza się z ceną. Efekty stałe dnia usuwają sezon, dzień tygodnia i pogodę. W przykładzie opon bez nich suma współczynników indeksu wynosiła −1.68 zamiast prawdziwych −5.5.
Powiązane hasła
Przeczytaj też
Elastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikLosowy test ceny i krzywa popytu
Aplikacja z subskrypcją i pięć losowych cen: konwersja, retencja, zysk i cena optymalna z bootstrapem oraz pułapka krzywej z historii – z kodem R.
Czytaj →PoradnikIndeks cen: Laspeyres, Paasche i Fisher
30 produktów bezglutenowych i 3 lata cen: trzy wzory ręcznie w R, substytucja, dryf łańcucha, przychód na ceny i ilości oraz mniejsza paczka.
Czytaj →Analizujesz ceny konkurencji w pracy dyplomowej?
Pomożemy zbudować indeks ceny z danych z porównywarki, dobrać model z efektami stałymi i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Angrist, J. D., & Krueger, A. B. (2001). Instrumental variables and the search for identification: From supply and demand to natural experiments. Journal of Economic Perspectives, 15(4), 69–85. https://doi.org/10.1257/jep.15.4.69 ● Otwarty dostęp
- Bijmolt, T. H. A., van Heerde, H. J., & Pieters, R. G. M. (2005). New empirical generalizations on the determinants of price elasticity. Journal of Marketing Research, 42(2), 141–156. https://doi.org/10.1509/jmkr.42.2.141.62296
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Ellison, G., & Ellison, S. F. (2009). Search, obfuscation, and price elasticities on the Internet. Econometrica, 77(2), 427–452. https://doi.org/10.3982/ecta5708 ● Otwarty dostęp
- Santos Silva, J. M. C., & Tenreyro, S. (2006). The log of gravity. The Review of Economics and Statistics, 88(4), 641–658. https://doi.org/10.1162/rest.88.4.641 ● Otwarty dostęp
- Smith, M. D., & Brynjolfsson, E. (2001). Consumer decision-making at an Internet shopbot: Brand still matters. The Journal of Industrial Economics, 49(4), 541–558. https://doi.org/10.1111/1467-6451.00162 ● Otwarty dostęp: pełny tekst
- Villas-Boas, J. M., & Winer, R. S. (1999). Endogeneity in brand choice models. Management Science, 45(10), 1324–1338. https://doi.org/10.1287/mnsc.45.10.1324
Cytowania BibTeX
@article{angrist2001instrumental, author={Angrist, Joshua D and Krueger, Alan B}, title={{Instrumental variables and the search for identification: From supply and demand to natural experiments}}, journal={Journal of Economic Perspectives}, year={2001}, volume={15}, number={4}, pages={69--85}, doi={10.1257/jep.15.4.69}}@article{bijmolt2005new, author={Bijmolt, Tammo H. A. and van Heerde, Harald J. and Pieters, Rik G. M.}, title={{New empirical generalizations on the determinants of price elasticity}}, journal={Journal of Marketing Research}, year={2005}, volume={42}, number={2}, pages={141--156}, doi={10.1509/jmkr.42.2.141.62296}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{ellison2009search, author={Ellison, Glenn and Ellison, Sara Fisher}, title={{Search, obfuscation, and price elasticities on the Internet}}, journal={Econometrica}, year={2009}, volume={77}, number={2}, pages={427--452}, doi={10.3982/ecta5708}}@article{santossilva2006log, author={Santos Silva, J. M. C. and Tenreyro, Silvana}, title={{The log of gravity}}, journal={The Review of Economics and Statistics}, year={2006}, volume={88}, number={4}, pages={641--658}, doi={10.1162/rest.88.4.641}}@article{smith2001consumer, author={Smith, Michael D. and Brynjolfsson, Erik}, title={{Consumer decision-making at an Internet shopbot: Brand still matters}}, journal={The Journal of Industrial Economics}, year={2001}, volume={49}, number={4}, pages={541--558}, doi={10.1111/1467-6451.00162}}@article{villasboas1999endogeneity, author={Villas-Boas, J. Miguel and Winer, Russell S.}, title={{Endogeneity in brand choice models}}, journal={Management Science}, year={1999}, volume={45}, number={10}, pages={1324--1338}, doi={10.1287/mnsc.45.10.1324}}