Przykład: wypożyczalnia kajaków i pytanie „ile kajaków na jutro?”
Fikcyjna wypożyczalnia kajaków i sprzętu wodnego ma 10 przystani (A–J). Sezon trwa od maja do września. Każdego popołudnia kierownik przystani decyduje, ile kajaków przywieźć na jutro i ilu pracowników wezwać. Pytanie biznesowe: o ile pogoda zmienia liczbę wypożyczeń i jak z prognozy pogody zrobić plan na jutro?
Mamy 3 sezony danych dziennych z każdej przystani: 4590 wierszy (10 przystani × 3 sezony × 153 dni). Znamy temperaturę maksymalną, opady, wiatr, dzień tygodnia, wakacje (26 czerwca – 31 sierpnia), liczbę wypożyczeń i to, czy przystań zamknięto z powodu burzy. Zamknięć było 128 (2.8%). W 4462 dni otwarte przystań wypożyczała średnio 48.2 kajaka (mediana 37, SD = 39.8). Temperatura wahała się od 7.5 do 34.5 °C, a deszcz padał w 27.3% dni. Dane pobierzesz jako pogoda-wypozyczalnia-kajakow.csv.
Dane są fikcyjne i znamy prawdziwy mechanizm. Wypożyczenia rosną z temperaturą do ok. 28 °C, a w upale lekko spadają; weekend wzmacnia efekt ciepła, wakacje dodają ok. 40%, deszcz i wiatr zmniejszają ruch. Wartości ustawiliśmy ręcznie (lista przy kodzie), ziaren nie zmienialiśmy. Dzięki temu widać, co model odtworzył, a co przeoczył.
Rysunek 1: trzy sezony w danych
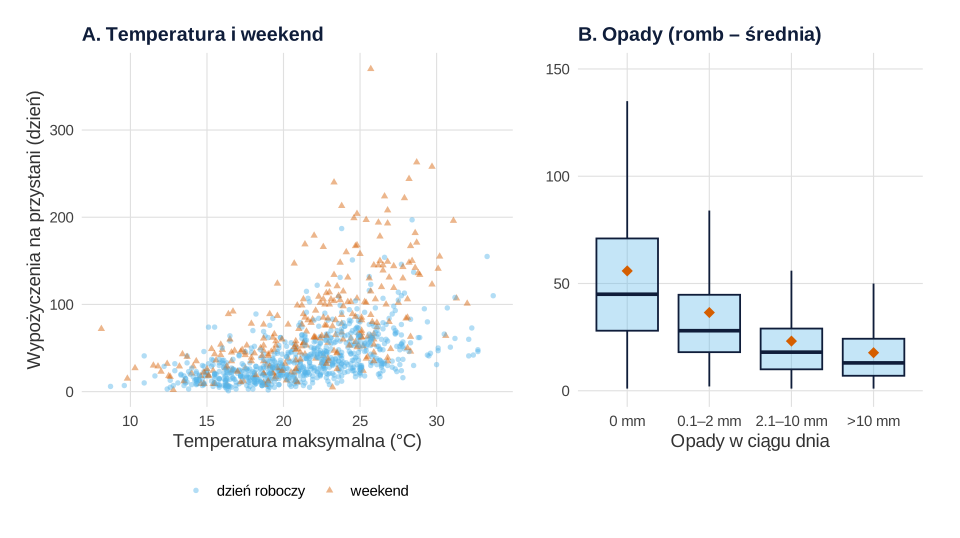
set.seed(698), set.seed(6981)).Co widać. W dni robocze poniżej 14 °C przystań wypożycza średnio 16.9 kajaka, przy 26–30 °C – 66.6, a w weekendy 24.9 i 128.4: im cieplej, tym większa przewaga soboty i niedzieli. Deszcz działa w drugą stronę: bez opadów średnio 55.9 wypożyczenia, przy 0.1–2 mm 36.5, a powyżej 10 mm 17.7.
Jak może zmylić. Rozrzut rośnie razem ze średnią, co typowe dla zliczeń. Średnie w kategoriach mieszają czynniki: deszczowe dni są chłodniejsze, a ciepłe częściej wypadają w wakacje. Rozdziela je dopiero model.
Podpis do pracy:
Rysunek 2: krzywe temperatury i opadów w modelu GAM
Wypożyczenia to zliczenia, więc punktem wyjścia jest regresja Poissona. Tu jednak statystyka rozrzutu Pearsona wynosi 7.24 zamiast ok. 1 – to nadmierna dyspersja. Dlatego używamy regresji ujemnej dwumianowej: statystyka spada do 1.00, a AIC z 55 673.6 do 36 800.8. W tym modelu wariancja rośnie z kwadratem średniej (Ver Hoef i Boveng, 2007). Więcej w poradniku o regresji dla zliczeń.
Związek z pogodą nie jest prostą linią, więc używamy uogólnionego modelu addytywnego (GAM): pogoda dostaje gładkie krzywe f, a kara za krzywiznę pilnuje, by nie goniły szumu:
Krzywa temperatury jest osobna dla dni roboczych i weekendów, a u to efekt przystani. Siłę wygładzania dobiera REML (Wood, 2011; zob. REML a ML). Podstawy opisuje poradnik o nieliniowych zależnościach, a pełny wykład – Wood (2017). Model wyjaśnia 73.3% dewiancji, a θ = 7.63 (prawda: 8).
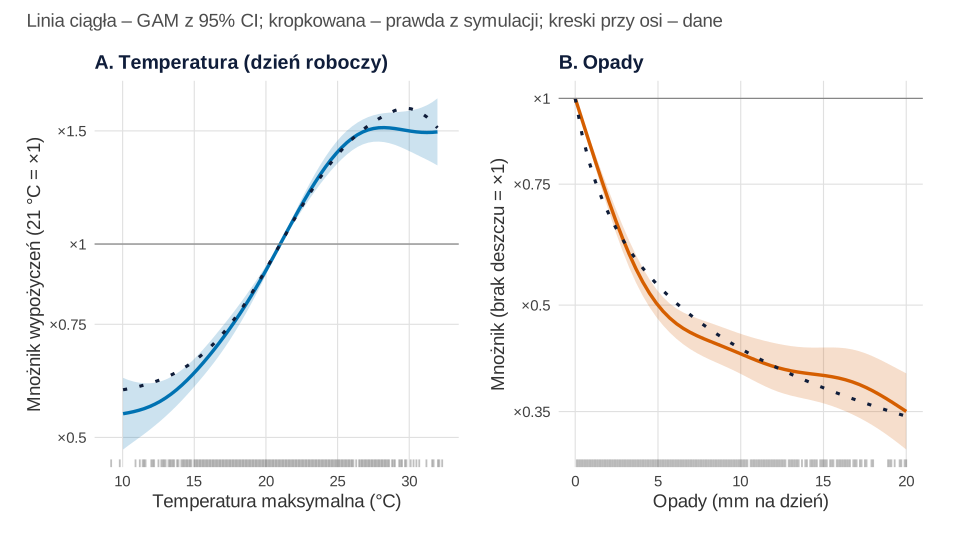
Co widać. Przy 12 °C przystań ma 0.56 ruchu z dnia o 21 °C, 95% CI [0.52, 0.61], a przy 26 °C – 1.46 raza więcej [1.40, 1.52], dokładnie jak w prawdziwym mechanizmie. Pierwsze 5 mm deszczu zmniejsza ruch o połowę (×0.50 [0.48, 0.52]), a 20 mm – do ×0.35 [0.31, 0.40]. Wiatr obniża ruch o 5.4% na każdy 1 m/s (×0.946 [0.939, 0.952]; prawda: ×0.94), a wakacje podnoszą go o 41%.
Jak może zmylić. Na krańcach zakresu danych krzywa jest najmniej pewna. Prawdziwy spadek w upale (×1.63 przy 30 °C i ×1.40 przy 33 °C) model wygładził do płaskiego ×1.50–1.51, bo dni powyżej 32 °C było tylko 20. Pasmo przy 33 °C sięga od 1.28 do 1.78. Takie pasma mają pokrycie bliskie nominalnemu dla krzywej jako całości, a nie w każdym punkcie (Marra i Wood, 2012) – czytaj je razem z kreskami danych przy osi. Ostry początek krzywej deszczu model też spłaszcza (×0.84 przy 1 mm wobec prawdziwych ×0.78).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: weekend i przystanie
Ciepło działa mocniej w weekend. To interakcja temperatury i dnia tygodnia – w GAM to dwie krzywe temperatury (argument by). Dni z jednej przystani nie są niezależne, więc przystań jest efektem losowym (s(przystan, bs = "re"); zob. efekty stałe i losowe).
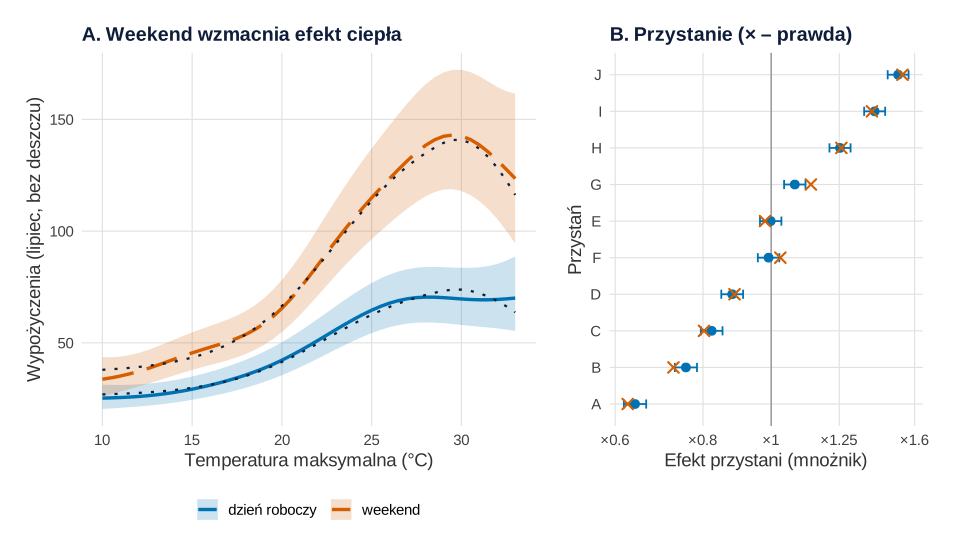
Co widać. W lipcowy dzień roboczy przeciętna przystań wypożycza 29.3 kajaka przy 15 °C, 95% CI [24.5, 35.0], i 69.7 [58.6, 83.0] przy 27 °C – 2.38 raza więcej. W weekend ten sam wzrost temperatury daje 45.5 i 131.6 wypożyczenia, czyli 2.89 raza więcej (prawda: 2.31 i 2.97). Model z osobnymi krzywymi pasuje lepiej niż model ze wspólną krzywą, χ²(6.62) = 49.96, p < .001 (przybliżony test ilorazu wiarygodności). Przystanie mają od ×0.64 (A) do ×1.52 (J) ruchu przeciętnej; SD efektu przystani (skala log) to 0.275, 95% CI [0.173, 0.437] (prawda: 0.289).
Jak może zmylić. Pasma w panelu A zawierają też niepewność „przeciętnej przystani” – dla konkretnej przystani prognoza jest dokładniejsza. Efekt losowy i stały dają tu prawie to samo (różnica najwyżej 0.002 przy ok. 450 dniach na przystań); różnica pojawi się przy nowej przystani z kilkoma tygodniami danych.
Podpis do pracy:
Rysunek 4: prognoza na jutro z niepewną pogodą
Model znał pogodę, która wystąpiła; planując jutro, znamy tylko prognozę. Jutro jest sobota w lipcu, przystań H: 27 °C, szansa deszczu 40% (jeśli spadnie – średnio 5.4 mm), wiatr 5 m/s, błąd prognozy temperatury SD = 1.8 °C (wartości ustawione ręcznie). Meteorolodzy podają prognozę jako zbiór scenariuszy, a nie jedną liczbę (Gneiting i Raftery, 2005) – tak samo potraktujemy prognozę wypożyczeń.
Porównujemy dwa podejścia. Prognoza punktowa wstawia do modelu jedną pogodę: 27 °C i oczekiwane opady 0.4 × 5.4 = 2.2 mm. Przeniesienie niepewności to prosta symulacja Monte Carlo: losujemy 5000 scenariuszy pogody, a w każdym współczynniki modelu z ich przybliżonego rozkładu i liczbę wypożyczeń z rozkładu ujemnego dwumianowego – jak w symulacji Monte Carlo opłacalności projektu.
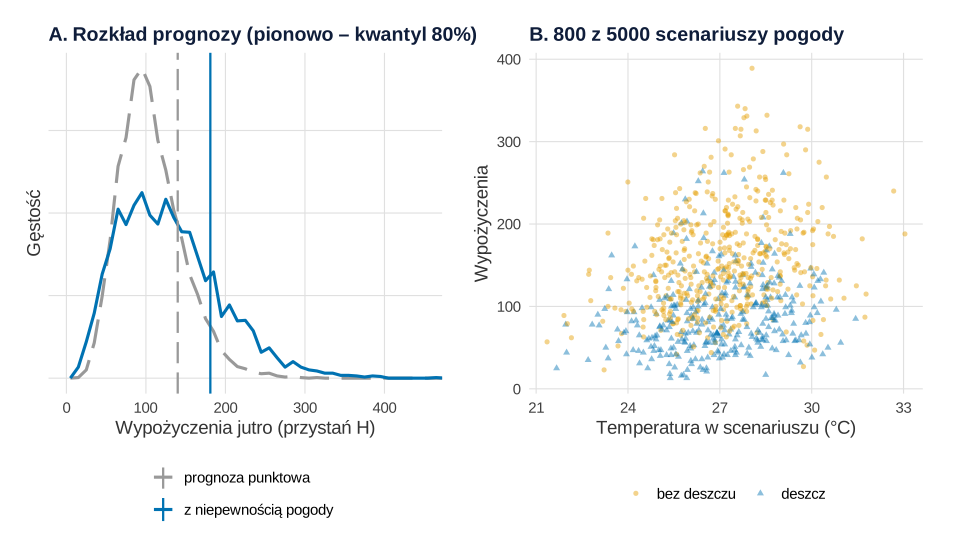
set.seed(6982)).Co widać. Prognoza punktowa daje średnią 108.2 wypożyczenia i kwantyl 80% równy 140. Po przeniesieniu niepewności pogody średnia wynosi 130.0, mediana 122, a kwantyl 80% – 181. To rozkład pojedynczego dnia, czyli pasmo predykcji, a nie ufności. Przy 140 kajakach zabraknie ich w 38.8% scenariuszy, a nie w 20%. Panel B tłumaczy dlaczego: jutro to mieszanka dwóch światów – bez deszczu mediana 147 wypożyczeń, z deszczem 84. „Średnie” 2.2 mm prawie się nie zdarzają.
Jak może zmylić. Przy 0 mm (najczęstszy scenariusz) prognoza punktowa daje średnią 155.9, czyli za dużo. W modelu nieliniowym uśredniaj wyniki, a nie pogodę. Steinker i in. (2017) pokazali na danych dużego sklepu internetowego, że dodanie prognoz pogody zmniejszało błędy prognozy sprzedaży średnio o 8.6–12.2%, a w letnie weekendy do 50.6%.
Podpis do pracy:
Rysunek 5: ile kajaków i ilu pracowników
Wypożyczenie daje 50 zł marży, a przygotowanie kajaka kosztuje 10 zł (wartości ustawione ręcznie). Brakujący kajak to strata 40 zł, a zbędny – 10 zł, więc opłaca się przywieźć tyle kajaków, ile wynosi kwantyl 40 / (40 + 10) = 80% prognozy. Skąd ten wzór, wyjaśnia wpis o modelu gazeciarza i zapasie bezpieczeństwa. Regułę sprawdziliśmy na 1000 symulowanych dniach, w których pogoda różniła się od prognozy (błąd temperatury 1.8 °C na jutro i 3.5 °C na 4 dni). Plan bez pogody to stały kwantyl 80% wypożyczeń danej przystani z trzech sezonów.
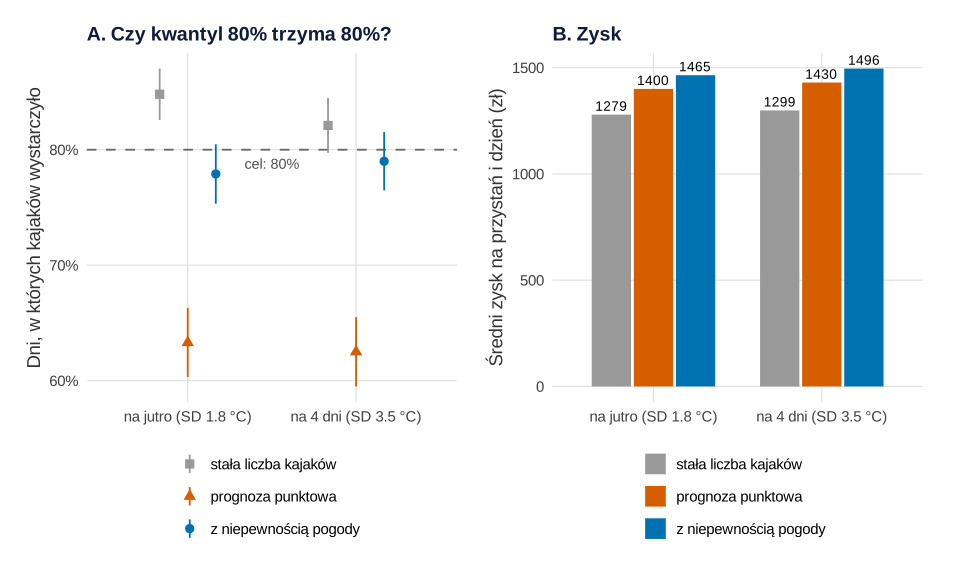
set.seed(6983)).Co widać. Kwantyl 80% z prognozy punktowej trzyma cel tylko w 63.3% dni (błąd Monte Carlo 1.5 pp), a z przeniesioną niepewnością pogody – w 77.9% (1.3 pp). Na 4 dni: 62.5% i 79.0%. Plan z niepewnością przywozi średnio 59.7 zamiast 48.7 kajaka, ale zarabia o 64.4 zł więcej (1464.6 wobec 1400.2 zł na przystań i dzień). Stała liczba kajaków wystarcza najczęściej (84.8%), a zarabia najmniej (1279.3 zł): w chłodne dni kajaki stoją, w upalną sobotę brakuje.
Jak może zmylić. Cel 80% to odsetek dni bez braków, a nie zadowolonych klientów. Plan z niepewnością jest blisko celu (77.9% i 79.0%) – odchylenie jest rzędu błędu Monte Carlo i niedokładności modelu. Obsadę liczymy z tego samego kwantyla (1 osoba na 35 wypożyczeń); jeśli zależy ona od kolejki przy pomoście, potrzebny jest model kolejki – jak przy obsadzie infolinii.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: karta „plan na jutro”
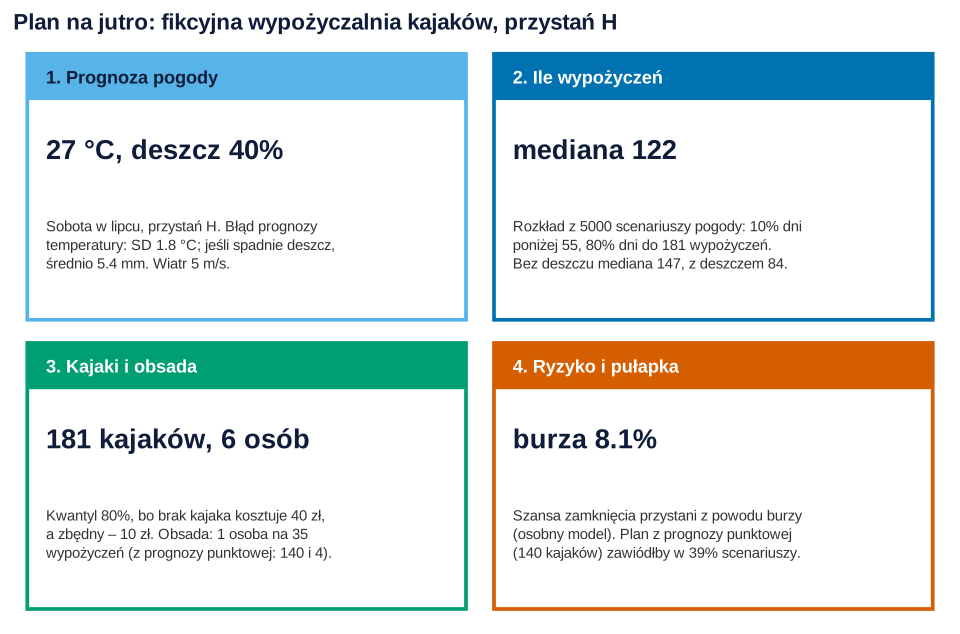
Plan dla kierownika przystani: 181 kajaków i 6 osób zamiast 140 kajaków i 4 osób z prognozy punktowej. Ryzyko burzy liczy osobny model logistyczny (zamknięcie to inny proces niż popyt): szansa rośnie z temperaturą (0.200 log-szans na 1 °C) i w dni z deszczem (1.18), a na jutro wynosi 8.1%.
Co z tym zrobić w firmie
- Planuj z kwantyla, nie ze średniej. Wybór kwantyla wynika z kosztów: tu brak kajaka kosztuje 4 razy więcej niż zbędny kajak, więc kwantyl 80%.
- Przenoś niepewność prognozy pogody. Losuj scenariusze pogody i licz wypożyczenia w każdym. Jedna „średnia pogoda” zaniżyła tu plan o 41 kajaków na przystań.
- Zapisuj prognozy, nie tylko pogodę. Wtedy oszacujesz błąd prognozy w Twoim regionie zamiast zgadywać SD = 1.8 °C.
- Modeluj burze osobno. Dni zamknięte to nie brak chętnych.
- Obsadę ustalaj według weekendu. W sobotę ruch rośnie z temperaturą szybciej (2.89 wobec 2.38 raza między 15 a 27 °C).
Sezonowość i święta w dłuższym horyzoncie omawia wpis o prognozie sprzedaży z sezonowością i promocjami, a wpływ ceny na popyt – wpis o pozycji cenowej wobec konkurencji, w którym sezon też miesza się z ceną. Ogólne wskazówki do pracy dyplomowej zebraliśmy w tekście statystyka w pracy z zarządzania i ekonomii.
Jak opisać w pracy
Opisz wybór rozkładu, sposób wprowadzenia pogody, efekt przystani, wyłączenie dni zamkniętych i przeniesienie niepewności prognozy. Krzywe pokaż na rysunku – współczynników gładkich funkcji nie czyta się z tabeli.
Kod R: GAM, prognoza z niepewną pogodą i plan kajaków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, prawdziwy mechanizm i dane, przepis 2 – model m, a przepis 4 – scenariusze, z których korzysta karta w przepisie 6. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, ma własne set.seed(): 698 i 6981 w przepisie 1, 6982 w przepisie 4 i 6983 w przepisie 5; pozostałe przepisy nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: prawdziwy mechanizm (średnia 32 wypożyczenia w chłodny dzień roboczy przy 21 °C, krzywa temperatury 1.1 × (logistyczna((t − 21)/3) − 0.5) − 0.012 × (t − 29)² powyżej 29 °C, wzmocnienie jej w weekend o 30%, weekend +0.5, wakacje +0.35, deszcz −0.35 × log(1 + mm), wiatr −0.06 na 1 m/s ponad 4 m/s, efekty przystani od −0.45 do 0.45, θ = 8); pogodę sezonu (średnia 15.5 + 8.5 × sin, wahania AR(1) z φ = 0.7 i SD 2.2 °C, szansa deszczu zależna od chłodu, ilość deszczu z rozkładu gamma, wiatr z rozkładu gamma); szansę zamknięcia z powodu burzy (logistyczna: −4.8 + 0.2 × (t − 20) + 1.5 × deszcz); k = 10 w gładkich funkcjach (przepis 2); prognozę na jutro: 27 °C, SD błędu 1.8 °C, deszcz 40%, wiatr 5 m/s (przepis 4); marżę 50 zł, koszt kajaka 10 zł, błąd prognozy 1.8 i 3.5 °C, 1000 dni i 400 scenariuszy na dzień (przepis 5); 35 wypożyczeń na pracownika (przepis 6). Po pierwszym przebiegu zmieniliśmy, nie zmieniając ziaren: szansę zamknięcia z powodu burzy (z −5.2 + 0.18 × (t − 20) + 1.2 × deszcz na obecną), bo przy 1.6% dni zamkniętych pułapka zer z burzy była prawie niewidoczna; liczbę węzłów krzywej opadów (k z 6 na 10), bo krzywa za mocno spłaszczała początek; plan „stała liczba kajaków” w przepisie 5 (z kwantyla popytu w dniach testowych, co było nieuczciwą przewagą, na kwantyl z danych historycznych przystani); sposób liczenia przedziałów dla efektów przystani (wyśrodkowane efekty zamiast surowych współczynników); liczbę punktów na rysunkach 1 i 4 (z 1800 i 1500 na 1000 i 800, by pliki SVG były mniejsze), ukrycie punktów odstających w panelu B rysunku 1 i kolejność grup na rysunku 5. Całość liczy się w ok. 20 sekund.
1. Prawdziwy mechanizm i dane z trzech sezonów: Rysunek 1
R
# Rysunek 1. Trzy sezony wypożyczeń: temperatura, opady i weekend
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Prawdziwy mechanizm (ustawiony ręcznie; znamy go tylko dlatego, że dane są fikcyjne).
# log(średnia wypożyczeń) = log(32) + efekt przystani + f(temp) × (1 + 0.3 × weekend) + 0.5 × weekend
#                           + 0.35 × wakacje − 0.35 × log(1 + opady) − 0.06 × (wiatr − 4)
f_temp <- function(t) 1.1 * (plogis((t - 21) / 3) - 0.5) - 0.012 * pmax(t - 29, 0)^2  # 0 przy 21 °C
mu_prawda <- function(temp, opady, wiatr, weekend, wakacje, u)
  exp(log(32) + u + f_temp(temp) * (1 + 0.3 * weekend) + 0.5 * weekend + 0.35 * wakacje -
      0.35 * log1p(opady) - 0.06 * (wiatr - 4))
theta_prawda <- 8                                     # rozrzut ujemny dwumianowy: var = mu + mu^2 / 8
u_prawda <- setNames(c(-0.45, -0.30, -0.20, -0.10, 0, 0.05, 0.15, 0.25, 0.35, 0.45), LETTERS[1:10])
p_burza <- function(temp, deszcz) plogis(-4.8 + 0.2 * (temp - 20) + 1.5 * deszcz)  # zamknięcie przystani

# Pogoda i wypożyczenia: 10 przystani × 3 sezony × 153 dni (1 maja – 30 września)
set.seed(698)
dni <- 153
pogoda_sezonu <- function(s) {
  klimat <- 15.5 + 8.5 * sin(pi * (1:dni - 5) / 160)             # średnia temperatura maksymalna w sezonie
  anom <- as.numeric(arima.sim(list(ar = 0.7), dni, sd = 2.2))   # ciepłe i chłodne okresy w regionie
  deszcz <- rbinom(dni, 1, plogis(-0.7 - 0.25 * anom))          # w chłodne dni częściej pada
  data.frame(sezon = s, dzien = 1:dni, temp_reg = klimat + anom, deszcz_reg = deszcz,
             opady_reg = deszcz * rgamma(dni, shape = 0.9, scale = 6), wiatr_reg = rgamma(dni, 6, 1.5))
}
reg <- do.call(rbind, lapply(1:3, pogoda_sezonu))
d <- merge(reg, data.frame(przystan = LETTERS[1:10]))
d <- d[order(d$sezon, d$dzien, d$przystan), ]
n <- nrow(d)
d$temp <- round(d$temp_reg + rnorm(n, 0, 1), 1)                        # lokalne różnice pogody
d$opady <- round(d$opady_reg * rgamma(n, 4, 4) * rbinom(n, 1, 0.9), 1)
d$wiatr <- round(pmax(d$wiatr_reg + rnorm(n, 0, 0.8), 0.5), 1)
d$dzien_tyg <- factor(c("pn", "wt", "śr", "cz", "pt", "so", "nd")[(d$dzien + c(2, 3, 4)[d$sezon] - 1) %% 7 + 1],
                      levels = c("pn", "wt", "śr", "cz", "pt", "so", "nd"))
d$weekend <- as.integer(d$dzien_tyg %in% c("so", "nd"))
d$wakacje <- as.integer(d$dzien >= 57 & d$dzien <= 123)                  # 26 czerwca – 31 sierpnia
d$zamkniete <- rbinom(n, 1, p_burza(d$temp, d$opady > 0))                # burza: przystań zamknięta
d$mu <- mu_prawda(d$temp, d$opady, d$wiatr, d$weekend, d$wakacje, u_prawda[d$przystan])
d$wypozyczenia <- ifelse(d$zamkniete == 1, 0, rnbinom(n, size = theta_prawda, mu = d$mu))
d$przystan <- factor(d$przystan)
d$weekend_f <- factor(d$weekend, 0:1, c("dzień roboczy", "weekend"))

c(wiersze = n, otwarte = sum(d$zamkniete == 0), zamkniete = sum(d$zamkniete),
  suma_wypozyczen = sum(d$wypozyczenia))
otw <- subset(d, zamkniete == 0)
round(c(srednia = mean(otw$wypozyczenia), mediana = median(otw$wypozyczenia), sd = sd(otw$wypozyczenia),
        min_temp = min(d$temp), max_temp = max(d$temp), proc_dni_z_deszczem = 100 * mean(d$opady > 0),
        p99_opady = unname(quantile(d$opady, 0.99))), 1)
# Średnia wypożyczeń w dni otwarte według temperatury i weekendu
otw$temp_kat <- cut(otw$temp, c(-Inf, 14, 18, 22, 26, 30, Inf),
                    labels = c("<14", "14–18", "18–22", "22–26", "26–30", "30+"))
with(otw, round(tapply(wypozyczenia, list(temp_kat, weekend_f), mean), 1))
# … i według opadów
otw$opady_kat <- cut(otw$opady, c(-Inf, 0, 2, 10, Inf), labels = c("0 mm", "0.1–2 mm", "2.1–10 mm", ">10 mm"))
with(otw, round(cbind(n = table(opady_kat), srednia = tapply(wypozyczenia, opady_kat, mean)), 1))
# Zamknięcia z powodu burzy: w dni z deszczem i bez
with(d, round(100 * tapply(zamkniete, opady > 0, mean), 2))

set.seed(6981)
pr <- otw[sample(nrow(otw), 1000), ]                                     # 1000 punktów, by SVG był lekki
pa <- ggplot(pr, aes(temp, wypozyczenia, colour = weekend_f, shape = weekend_f)) +
  geom_point(alpha = 0.45, size = 1.5) +
  scale_colour_manual(values = c(kol[["blekit"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(x = "Temperatura maksymalna (°C)", y = "Wypożyczenia na przystani (dzień)",
       title = "A. Temperatura i weekend") + motyw
pb <- ggplot(otw, aes(opady_kat, wypozyczenia)) +
  geom_boxplot(fill = kol[["blekit"]], alpha = 0.35, colour = "#0f1d3a", outlier.shape = NA) +
  stat_summary(fun = mean, geom = "point", shape = 18, size = 3.5, colour = kol[["pomaranczowy"]]) +
  coord_cartesian(ylim = c(0, 150)) +                                   # pudełka bez punktów odstających
  labs(x = "Opady w ciągu dnia", y = NULL, title = "B. Opady (romb – średnia)") + motyw +
  theme(axis.text.x = element_text(size = rel(0.85)))
p1 <- pa + pb + plot_layout(widths = c(1.25, 1))
p1   # zapis: ggsave("pogoda-dane-wypozyczenia.svg", p1, width = 10, height = 5.6)
Wynik w R
        wiersze         otwarte       zamkniete suma_wypozyczen
           4590            4462             128          214989
            srednia             mediana                  sd            min_temp
               48.2                37.0                39.8                 7.5
           max_temp proc_dni_z_deszczem           p99_opady
               34.5                27.3                19.7
      dzień roboczy weekend
<14            16.9    24.9
14–18          19.9    33.2
18–22          31.9    49.8
22–26          51.9    85.9
26–30          66.6   128.4
30+            71.8   139.8
             n srednia
0 mm      3260    55.9
0.1–2 mm   462    36.5
2.1–10 mm  532    23.2
>10 mm     208    17.7
FALSE  TRUE
 2.25  4.22
2. GAM ujemny dwumianowy i krzywe pogody: Rysunek 2
R
# Rysunek 2. GAM ujemny dwumianowy: krzywe temperatury i opadów z 95% CI
# (korzysta z kol, motyw, f_temp, u_prawda i danych d z przepisu 1)
library(ggplot2)
library(patchwork)
library(mgcv)

otw <- subset(d, zamkniete == 0)                 # dni z burzą (przystań zamknięta) modelujemy osobno
# Model: gładkie funkcje temperatury (osobno w dni robocze i weekendy) i opadów, wiatr liniowo,
# wakacje i weekend jako efekty stałe, przystań jako efekt losowy (s(przystan, bs = "re"))
m <- gam(wypozyczenia ~ weekend_f + wakacje + s(temp, by = weekend_f, k = 10) + s(opady, k = 10) + wiatr +
           s(przystan, bs = "re"), family = nb(), data = otw, method = "REML")
summary(m)$p.table[, 1:2]
round(summary(m)$s.table, 2)
c(theta = round(m$family$getTheta(TRUE), 2), dewiancja_wyjasniona_proc = round(100 * summary(m)$dev.expl, 1))
# Dlaczego nie Poisson? Statystyka rozrzutu (suma kwadratów reszt Pearsona / df) – powinna być bliska 1
m_pois <- gam(wypozyczenia ~ weekend_f + wakacje + s(temp, by = weekend_f, k = 10) + s(opady, k = 10) + wiatr +
                s(przystan, bs = "re"), family = poisson, data = otw, method = "REML")
round(c(poisson = sum(residuals(m_pois, "pearson")^2) / df.residual(m_pois),
        ujemny_dwumianowy = sum(residuals(m, "pearson")^2) / df.residual(m),
        AIC_poisson = AIC(m_pois), AIC_nb = AIC(m)), 2)

# Krzywa „mnożnik wypożyczeń względem punktu odniesienia” z 95% CI: różnica wierszy macierzy modelu
mnoznik <- function(nowe, odn) {
  X <- predict(m, nowe, type = "lpmatrix") - predict(m, odn, type = "lpmatrix")[rep(1, nrow(nowe)), ]
  e <- drop(X %*% coef(m)); se <- sqrt(rowSums((X %*% vcov(m)) * X))
  data.frame(nowe, mn = exp(e), dol = exp(e - 1.96 * se), gora = exp(e + 1.96 * se))
}
baza <- data.frame(weekend_f = factor("dzień roboczy", levels(d$weekend_f)), wakacje = 0, temp = 21, opady = 0,
                   wiatr = 4, przystan = "E")
zakres_t <- quantile(otw$temp, c(0.005, 0.995))
kt <- mnoznik(transform(baza[rep(1, 60), ], temp = seq(zakres_t[1], zakres_t[2], length.out = 60)), baza)
kt$prawda <- exp(f_temp(kt$temp))
ko <- mnoznik(transform(baza[rep(1, 50), ], opady = seq(0, 20, length.out = 50)), baza)
ko$prawda <- exp(-0.35 * log1p(ko$opady))
# Wybrane punkty krzywych (dzień roboczy; 1 = 21 °C i brak deszczu)
round(subset(mnoznik(transform(baza[rep(1, 5), ], temp = c(12, 16, 26, 30, 33)), baza),
             select = c(temp, mn, dol, gora)), 2)
round(cbind(temp = c(12, 16, 26, 30, 33), prawda = exp(f_temp(c(12, 16, 26, 30, 33)))), 2)
round(subset(mnoznik(transform(baza[rep(1, 4), ], opady = c(1, 5, 10, 20)), baza),
             select = c(opady, mn, dol, gora)), 2)
round(cbind(opady = c(1, 5, 10, 20), prawda = exp(-0.35 * log1p(c(1, 5, 10, 20)))), 2)
# Wiatr: mnożnik za każdy 1 m/s (prawda: exp(−0.06) = 0.94)
round(exp(coef(m)["wiatr"] + c(0, -1.96, 1.96) * sqrt(vcov(m)["wiatr", "wiatr"])), 3)

pa <- ggplot(kt, aes(temp)) +
  geom_ribbon(aes(ymin = dol, ymax = gora), fill = kol[["niebieski"]], alpha = 0.2) +
  geom_line(aes(y = mn), colour = kol[["niebieski"]], linewidth = 1.2) +
  geom_line(aes(y = prawda), colour = "#0f1d3a", linetype = "dotted", linewidth = 1.1) +
  geom_rug(data = otw[seq(1, nrow(otw), 6), ], aes(x = temp), inherit.aes = FALSE, alpha = 0.25, length = unit(0.02, "npc")) +
  geom_hline(yintercept = 1, colour = "grey50", linewidth = 0.4) +
  scale_y_continuous(trans = "log", breaks = c(0.5, 0.75, 1, 1.5, 2), labels = c("×0.5", "×0.75", "×1", "×1.5", "×2")) +
  labs(x = "Temperatura maksymalna (°C)", y = "Mnożnik wypożyczeń (21 °C = ×1)",
       title = "A. Temperatura (dzień roboczy)") + motyw
pb <- ggplot(ko, aes(opady)) +
  geom_ribbon(aes(ymin = dol, ymax = gora), fill = kol[["pomaranczowy"]], alpha = 0.2) +
  geom_line(aes(y = mn), colour = kol[["pomaranczowy"]], linewidth = 1.2) +
  geom_line(aes(y = prawda), colour = "#0f1d3a", linetype = "dotted", linewidth = 1.1) +
  geom_rug(data = subset(otw, opady > 0), aes(x = pmin(opady, 20)), inherit.aes = FALSE, alpha = 0.25,
           length = unit(0.02, "npc")) +
  geom_hline(yintercept = 1, colour = "grey50", linewidth = 0.4) +
  scale_y_continuous(trans = "log", breaks = c(0.25, 0.35, 0.5, 0.75, 1), labels = c("×0.25", "×0.35", "×0.5", "×0.75", "×1")) +
  labs(x = "Opady (mm na dzień)", y = "Mnożnik (brak deszczu = ×1)", title = "B. Opady") + motyw
p2 <- pa + pb + plot_annotation(subtitle = "Linia ciągła – GAM z 95% CI; kropkowana – prawda z symulacji; kreski przy osi – dane",
                                theme = motyw)
p2   # zapis: ggsave("pogoda-gam-temperatura-opady.svg", p2, width = 10, height = 5.6)
Wynik w R
                    Estimate  Std. Error
(Intercept)       3.58936834 0.088439018
weekend_fweekend  0.50315940 0.013132238
wakacje           0.34377788 0.014933285
wiatr            -0.05594431 0.003303413
                                edf Ref.df  Chi.sq p-value
s(temp):weekend_fdzień roboczy 5.64   6.73 1225.39       0
s(temp):weekend_fweekend       5.81   6.92 1076.35       0
s(opady)                       6.97   7.96 1840.96       0
s(przystan)                    8.96   9.00 1874.53       0
                    theta dewiancja_wyjasniona_proc
                     7.63                     73.30
          poisson ujemny_dwumianowy       AIC_poisson            AIC_nb
             7.24              1.00          55673.60          36800.84
    temp   mn  dol gora
1     12 0.56 0.52 0.61
1.1   16 0.67 0.64 0.70
1.2   26 1.46 1.40 1.52
1.3   30 1.50 1.40 1.61
1.4   33 1.51 1.28 1.78
     temp prawda
[1,]   12   0.61
[2,]   16   0.69
[3,]   26   1.46
[4,]   30   1.63
[5,]   33   1.40
    opady   mn  dol gora
1       1 0.84 0.83 0.86
1.1     5 0.50 0.48 0.52
1.2    10 0.42 0.40 0.45
1.3    20 0.35 0.31 0.40
     opady prawda
[1,]     1   0.78
[2,]     5   0.53
[3,]    10   0.43
[4,]    20   0.34
[1] 0.946 0.939 0.952
3. Temperatura × weekend i efekt przystani: Rysunek 3
R
# Rysunek 3. Temperatura × weekend i efekt przystani
# (korzysta z kol, motyw, f_temp, mu_prawda, u_prawda, d z przepisu 1 oraz m, otw z przepisu 2)
library(ggplot2)
library(patchwork)
library(mgcv)

# A. Przewidywana liczba wypożyczeń w lipcu (wakacje, bez deszczu, wiatr 4 m/s) na typowej przystani
siatka <- expand.grid(temp = seq(10, 33, by = 0.5), weekend_f = levels(d$weekend_f))
siatka <- transform(siatka, wakacje = 1, opady = 0, wiatr = 4, przystan = "E")
pr <- predict(m, siatka, se.fit = TRUE, exclude = "s(przystan)")   # bez efektu przystani = przystań „przeciętna”
siatka <- transform(siatka, fit = exp(pr$fit), dol = exp(pr$fit - 1.96 * pr$se.fit), gora = exp(pr$fit + 1.96 * pr$se.fit),
                    prawda = mu_prawda(temp, 0, 4, as.integer(weekend_f == "weekend"), 1, 0))
w <- subset(siatka, temp %in% c(15, 21, 27))
data.frame(w[c("temp", "weekend_f")], round(w[c("fit", "dol", "gora", "prawda")], 1))
# O ile więcej wypożyczeń przy 27 °C niż przy 15 °C? (iloraz, dzień roboczy i weekend)
ilor <- function(g) with(subset(siatka, weekend_f == g), fit[temp == 27] / fit[temp == 15])
round(c(roboczy = ilor("dzień roboczy"), weekend = ilor("weekend"),
        prawda_roboczy = exp(f_temp(27) - f_temp(15)), prawda_weekend = exp(1.3 * (f_temp(27) - f_temp(15)))), 2)
# Czy krzywe naprawdę się różnią? Porównanie z modelem, w którym kształt jest wspólny (test ilorazu wiarygodności, ML)
m_wsp <- gam(wypozyczenia ~ weekend_f + wakacje + s(temp, k = 10) + s(opady, k = 10) + wiatr + s(przystan, bs = "re"),
             family = nb(theta = m$family$getTheta(TRUE)), data = otw, method = "ML")
m_ml2 <- gam(formula(m), family = nb(theta = m$family$getTheta(TRUE)), data = otw, method = "ML")
anova(m_wsp, m_ml2, test = "Chisq")

# B. Efekt przystani: oszacowania efektu losowego (log-mnożnik) z 95% CI i prawdziwe wartości
idx <- grep("s\\(przystan\\)", names(coef(m)))
C <- diag(10) - 1 / 10                    # efekty wyśrodkowane: odchylenie przystani od średniej przystani
ef <- data.frame(przystan = levels(d$przystan), est = drop(C %*% coef(m)[idx]),
                 se = sqrt(diag(C %*% vcov(m)[idx, idx] %*% t(C))), prawda = u_prawda[levels(d$przystan)] - mean(u_prawda))
ef$dol <- ef$est - 1.96 * ef$se; ef$gora <- ef$est + 1.96 * ef$se
round(cbind(est = ef$est, dol = ef$dol, gora = ef$gora, prawda = ef$prawda), 2)
invisible(capture.output(vc <- gam.vcomp(m)))   # odchylenie standardowe efektu przystani (skala log) z 95% CI
round(vc$vc["s(przystan)", ], 3)
round(sd(u_prawda), 3)                    # prawdziwe odchylenie efektów przystani
# Ten sam model z przystanią jako efektem stałym (factor) – czy wynik się zmienia?
m_fe <- gam(wypozyczenia ~ weekend_f + wakacje + s(temp, by = weekend_f, k = 10) + s(opady, k = 10) + wiatr + przystan,
            family = nb(), data = otw, method = "REML")
fe <- c(0, coef(m_fe)[grep("^przystan", names(coef(m_fe)))]); fe <- fe - mean(fe)
round(max(abs(fe - ef$est)), 3)

ef$przystan <- factor(ef$przystan, ef$przystan[order(ef$est)])
pa <- ggplot(siatka, aes(temp, fit, colour = weekend_f, fill = weekend_f, linetype = weekend_f)) +
  geom_ribbon(aes(ymin = dol, ymax = gora), alpha = 0.2, colour = NA) +
  geom_line(linewidth = 1.2) +
  geom_line(aes(y = prawda), linewidth = 0.8, linetype = "dotted", colour = "#0f1d3a") +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_fill_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  labs(x = "Temperatura maksymalna (°C)", y = "Wypożyczenia (lipiec, bez deszczu)",
       title = "A. Weekend wzmacnia efekt ciepła") + motyw
pb <- ggplot(ef, aes(est, przystan)) +
  geom_vline(xintercept = 0, colour = "grey50", linewidth = 0.4) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.25, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 2.6, colour = kol[["niebieski"]]) +
  geom_point(aes(x = prawda), shape = 4, size = 3, stroke = 1.1, colour = kol[["pomaranczowy"]]) +
  scale_x_continuous(breaks = log(c(0.6, 0.8, 1, 1.25, 1.6)), labels = c("×0.6", "×0.8", "×1", "×1.25", "×1.6")) +
  labs(x = "Efekt przystani (mnożnik)", y = "Przystań", title = "B. Przystanie (× – prawda)") + motyw
p3 <- pa + pb + plot_layout(widths = c(1.45, 1))
p3   # zapis: ggsave("pogoda-weekend-przystanie.svg", p3, width = 10, height = 5.8)
Wynik w R
   temp     weekend_f   fit   dol  gora prawda
11   15 dzień roboczy  29.3  24.5  35.0   29.9
23   21 dzień roboczy  46.4  39.0  55.2   45.4
35   27 dzień roboczy  69.7  58.6  83.0   69.0
58   15       weekend  45.5  37.9  54.7   43.4
70   21       weekend  74.4  62.4  88.8   74.9
82   27       weekend 131.6 110.1 157.2  129.1
       roboczy        weekend prawda_roboczy prawda_weekend
          2.38           2.89           2.31           2.97
Analysis of Deviance Table

Model 1: wypozyczenia ~ weekend_f + wakacje + s(temp, k = 10) + s(opady,
    k = 10) + wiatr + s(przystan, bs = "re")
Model 2: wypozyczenia ~ weekend_f + wakacje + s(temp, by = weekend_f,
    k = 10) + s(opady, k = 10) + wiatr + s(przystan, bs = "re")
  Resid. Df Resid. Dev     Df Deviance  Pr(>Chi)
1    4433.2      36785
2    4426.6      36735 6.6184   49.963 9.672e-09 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
        est   dol  gora prawda
 [1,] -0.45 -0.48 -0.41  -0.47
 [2,] -0.28 -0.32 -0.24  -0.32
 [3,] -0.19 -0.23 -0.16  -0.22
 [4,] -0.13 -0.16 -0.09  -0.12
 [5,]  0.00 -0.04  0.03  -0.02
 [6,] -0.01 -0.04  0.03   0.03
 [7,]  0.08  0.04  0.11   0.13
 [8,]  0.23  0.19  0.26   0.23
 [9,]  0.34  0.30  0.37   0.33
[10,]  0.42  0.38  0.45   0.43
std.dev   lower   upper
  0.275   0.173   0.437
[1] 0.289
[1] 0.002
4. Prognoza na jutro i przeniesienie niepewności pogody: Rysunek 4
R
# Rysunek 4. Prognoza na jutro: niepewność prognozy pogody przenosi się na wypożyczenia
# (korzysta z kol, motyw, d z przepisu 1 oraz m, otw z przepisu 2)
library(ggplot2)
library(patchwork)
library(mgcv)

# Jutro: sobota w lipcu, przystań H. Prognoza pogody (ustawiona ręcznie): 27 °C (błąd prognozy SD 1.8 °C),
# szansa deszczu 40%, a jeśli spadnie – średnio 5.4 mm; wiatr 5 m/s (SD 1 m/s)
prog <- list(temp = 27, sd_temp = 1.8, p_deszcz = 0.4, ksztalt = 0.9, skala = 6, wiatr = 5, sd_wiatr = 1)
jutro <- data.frame(weekend_f = factor("weekend", levels(d$weekend_f)), wakacje = 1, przystan = "H")
theta <- m$family$getTheta(TRUE)

# 1) „Prognoza punktowa”: jedna pogoda (27 °C, oczekiwane opady 0.4 × 5.4 = 2.2 mm, 5 m/s) i rozkład NB wokół średniej
pkt <- transform(jutro, temp = prog$temp, opady = prog$p_deszcz * prog$ksztalt * prog$skala, wiatr = prog$wiatr)
mu_pkt <- exp(predict(m, pkt))
round(c(mu_przy_2.2_mm = unname(mu_pkt), mu_przy_0_mm = unname(exp(predict(m, transform(pkt, opady = 0))))), 1)
# 2) Przeniesienie niepewności: 5000 scenariuszy pogody × losowe współczynniki modelu × losowanie NB
set.seed(6982)
R <- 5000
scen <- transform(jutro[rep(1, R), ], temp = rnorm(R, prog$temp, prog$sd_temp),
                  opady = rbinom(R, 1, prog$p_deszcz) * rgamma(R, prog$ksztalt, scale = prog$skala),
                  wiatr = pmax(rnorm(R, prog$wiatr, prog$sd_wiatr), 0.5))
X <- predict(m, scen, type = "lpmatrix")
B <- rmvn(R, coef(m), vcov(m))                         # niepewność oszacowania modelu
scen$mu <- exp(rowSums(X * B))
scen$wyp <- rnbinom(R, size = theta, mu = scen$mu)
pkt_los <- rnbinom(R, size = theta, mu = mu_pkt)        # to samo losowanie przy jednej, „pewnej” pogodzie
podsum <- function(x) round(c(srednia = mean(x), mediana = median(x), q10 = quantile(x, 0.1, names = FALSE),
                              q80 = quantile(x, 0.8, names = FALSE), q90 = quantile(x, 0.9, names = FALSE)), 1)
rbind(punktowa = c(podsum(pkt_los), mu = round(unname(mu_pkt), 1)), z_niepewnoscia_pogody = c(podsum(scen$wyp), mu = NA))
# Kwantyl 80% z prognozy punktowej liczony dokładnie z rozkładu NB i jak często zabraknie kajaków
q80_pkt <- qnbinom(0.8, size = theta, mu = mu_pkt)
c(q80_punktowa = q80_pkt, q80_z_niepewnoscia = unname(quantile(scen$wyp, 0.8)),
  proc_dni_ponad_q80_punktowa = round(100 * mean(scen$wyp > q80_pkt), 1))
# Wypożyczenia w scenariuszach z deszczem i bez
round(tapply(scen$wyp, ifelse(scen$opady > 0, "deszcz", "bez deszczu"), median), 1)
# Ryzyko zamknięcia przystani z powodu burzy – osobny model logistyczny (burza to inny proces niż popyt)
m_burza <- glm(zamkniete ~ temp + I(opady > 0), family = binomial, data = d)
round(coef(summary(m_burza)), 3)
p_zamk <- mean(predict(m_burza, scen, type = "response"))
round(100 * p_zamk, 1)

scen$deszcz <- factor(scen$opady > 0, c(FALSE, TRUE), c("bez deszczu", "deszcz"))
rozk <- rbind(data.frame(wyp = pkt_los, wersja = "prognoza punktowa"),
              data.frame(wyp = scen$wyp, wersja = "z niepewnością pogody"))
q <- data.frame(wersja = c("prognoza punktowa", "z niepewnością pogody"),
                q80 = c(q80_pkt, quantile(scen$wyp, 0.8)))
pa <- ggplot(rozk, aes(wyp, colour = wersja, linetype = wersja)) +
  geom_freqpoly(aes(y = after_stat(density)), binwidth = 10, boundary = 0, linewidth = 1.1) +
  geom_vline(data = q, aes(xintercept = q80, colour = wersja, linetype = wersja), linewidth = 0.8) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("longdash", "solid"), name = NULL) +
  scale_y_continuous(labels = NULL) + coord_cartesian(xlim = c(0, 450)) +
  labs(x = "Wypożyczenia jutro (przystań H)", y = "Gęstość", title = "A. Rozkład prognozy (pionowo – kwantyl 80%)") +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) + motyw
pb <- ggplot(scen[1:800, ], aes(temp, wyp, colour = deszcz, shape = deszcz)) +
  geom_point(alpha = 0.45, size = 1.4) +
  scale_colour_manual(values = c(kol[["zolty"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(x = "Temperatura w scenariuszu (°C)", y = "Wypożyczenia", title = "B. 800 z 5000 scenariuszy pogody") + motyw
p4 <- pa + pb
p4   # zapis: ggsave("pogoda-prognoza-na-jutro.svg", p4, width = 10, height = 5.8)
Wynik w R
mu_przy_2.2_mm   mu_przy_0_mm
         108.2          155.9
                      srednia mediana q10 q80 q90    mu
punktowa                107.5     102  61 138 161 108.2
z_niepewnoscia_pogody   130.0     122  55 181 217    NA
               q80_punktowa          q80_z_niepewnoscia
                      140.0                       181.0
proc_dni_ponad_q80_punktowa
                       38.8
bez deszczu      deszcz
        147          84
                 Estimate Std. Error z value Pr(>|z|)
(Intercept)        -8.512      0.604 -14.100        0
temp                0.200      0.024   8.493        0
I(opady > 0)TRUE    1.180      0.195   6.061        0
[1] 8.1
5. Ile kajaków: sprawdzenie na 1000 symulowanych dniach: Rysunek 5
R
# Rysunek 5. Ile kajaków przygotować: kwantyl prognozy sprawdzony na 1000 symulowanych dniach
# (korzysta z kol, motyw, mu_prawda, u_prawda, theta_prawda, d z przepisu 1 oraz m i otw z przepisu 2)
library(ggplot2)
library(patchwork)
library(mgcv)

# Ekonomia (ustawiona ręcznie): wypożyczenie daje 50 zł marży, przygotowanie kajaka (dowóz, obsługa) kosztuje 10 zł.
# Kajaków brakuje → tracimy 50 − 10 = 40 zł; kajak stoi → tracimy 10 zł. Optymalny kwantyl: 40 / (40 + 10) = 0.8
marza <- 50; koszt <- 10; poziom <- (marza - koszt) / marza
theta <- m$family$getTheta(TRUE)
set.seed(6983)
N <- 1000; S <- 400                                   # 1000 dni testowych, 400 scenariuszy pogody na dzień
B <- rmvn(S, coef(m), vcov(m))
# Plan bez pogody: zawsze kwantyl 80% wypożyczeń z trzech sezonów na danej przystani
K_hist <- ceiling(tapply(otw$wypozyczenia, otw$przystan, quantile, poziom))
testuj <- function(sd_temp, etykieta) {
  dzien <- sample(1:153, N, TRUE)
  dni <- data.frame(weekend_f = factor(ifelse(runif(N) < 2 / 7, "weekend", "dzień roboczy"), levels(d$weekend_f)),
                    wakacje = as.integer(dzien >= 57 & dzien <= 123), przystan = sample(LETTERS[1:10], N, TRUE),
                    t_prog = 15.5 + 8.5 * sin(pi * (dzien - 5) / 160) + rnorm(N, 0, 3),   # prognoza temperatury
                    p_prog = rbeta(N, 1.2, 2.2), w_prog = rgamma(N, 6, 1.5))              # szansa deszczu, wiatr
  # Pogoda, która naprawdę wystąpi (błąd prognozy temperatury SD = sd_temp), i prawdziwy popyt
  t_rz <- dni$t_prog + rnorm(N, 0, sd_temp)
  o_rz <- rbinom(N, 1, dni$p_prog) * rgamma(N, 0.9, scale = 6)
  w_rz <- pmax(dni$w_prog + rnorm(N, 0, 1), 0.5)
  popyt <- rnbinom(N, size = theta_prawda, mu = mu_prawda(t_rz, o_rz, w_rz, as.integer(dni$weekend_f == "weekend"),
                                                            dni$wakacje, u_prawda[dni$przystan]))
  # Plan A: prognoza punktowa (temperatura z prognozy, opady oczekiwane) i kwantyl rozkładu NB
  pkt <- transform(dni, temp = t_prog, opady = p_prog * 0.9 * 6, wiatr = w_prog)
  K_pkt <- qnbinom(poziom, size = theta, mu = exp(predict(m, pkt)))
  # Plan B: kwantyl z 400 scenariuszy pogody (z niepewnością prognozy i współczynników)
  K_scen <- sapply(1:N, function(i) {
    sc <- transform(dni[rep(i, S), ], temp = rnorm(S, t_prog, sd_temp),
                    opady = rbinom(S, 1, p_prog) * rgamma(S, 0.9, scale = 6), wiatr = pmax(rnorm(S, w_prog, 1), 0.5))
    quantile(rnbinom(S, size = theta, mu = exp(rowSums(predict(m, sc, type = "lpmatrix") * B))), poziom, names = FALSE)
  })
  K_scen <- ceiling(K_scen)
  zysk <- function(K) marza * pmin(popyt, K) - koszt * K
  ocena <- function(K, plan) {
    wyst <- popyt <= K
    data.frame(prognoza = etykieta, plan = plan, proc_wystarczylo = 100 * mean(wyst),
               blad_mc = 100 * sqrt(mean(wyst) * (1 - mean(wyst)) / N), sr_kajakow = mean(K),
               sr_zysk = mean(zysk(K)), sr_brak = mean(pmax(popyt - K, 0)))
  }
  rbind(ocena(K_pkt, "prognoza punktowa"), ocena(K_scen, "z niepewnością pogody"),
        ocena(K_hist[dni$przystan], "stała liczba kajaków"))
}
wyn <- rbind(testuj(1.8, "na jutro (SD 1.8 °C)"), testuj(3.5, "na 4 dni (SD 3.5 °C)"))
data.frame(wyn[1:2], round(wyn[-(1:2)], 1))
# Różnica średniego zysku na dzień: plan B − plan A
round(sapply(split(wyn, wyn$prognoza), function(w) w$sr_zysk[2] - w$sr_zysk[1]), 1)

wyn$prognoza <- factor(wyn$prognoza, unique(wyn$prognoza))
wyn$plan <- factor(wyn$plan, c("stała liczba kajaków", "prognoza punktowa", "z niepewnością pogody"))
kol3 <- c(kol[["szary"]], kol[["pomaranczowy"]], kol[["niebieski"]])
pa <- ggplot(wyn, aes(prognoza, proc_wystarczylo, colour = plan, shape = plan)) +
  geom_hline(yintercept = 100 * poziom, linetype = "dashed", colour = "grey40") +
  geom_pointrange(aes(ymin = proc_wystarczylo - 1.96 * blad_mc, ymax = proc_wystarczylo + 1.96 * blad_mc),
                  position = position_dodge(width = 0.5), size = 0.6) +
  annotate("text", x = 1.5, y = 100 * poziom - 1.2, label = "cel: 80%", hjust = 0.5, size = 3.8, colour = "grey30") +
  scale_colour_manual(values = kol3, name = NULL) + scale_shape_manual(values = c(15, 17, 16), name = NULL) +
  scale_y_continuous(labels = function(v) paste0(v, "%")) +
  labs(x = NULL, y = "Dni, w których kajaków wystarczyło", title = "A. Czy kwantyl 80% trzyma 80%?") +
  guides(colour = guide_legend(nrow = 3), shape = guide_legend(nrow = 3)) + motyw
pb <- ggplot(wyn, aes(prognoza, sr_zysk, fill = plan)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = round(sr_zysk)), position = position_dodge(width = 0.75), vjust = -0.4, size = 3.6) +
  scale_fill_manual(values = kol3, name = NULL) +
  labs(x = NULL, y = "Średni zysk na przystań i dzień (zł)", title = "B. Zysk") +
  guides(fill = guide_legend(nrow = 3)) + motyw
p5 <- pa + pb
p5   # zapis: ggsave("pogoda-kwantyl-kajaki.svg", p5, width = 10, height = 6)
Wynik w R
              prognoza                  plan proc_wystarczylo blad_mc
1 na jutro (SD 1.8 °C)     prognoza punktowa             63.3     1.5
2 na jutro (SD 1.8 °C) z niepewnością pogody             77.9     1.3
3 na jutro (SD 1.8 °C)  stała liczba kajaków             84.8     1.1
4 na 4 dni (SD 3.5 °C)     prognoza punktowa             62.5     1.5
5 na 4 dni (SD 3.5 °C) z niepewnością pogody             79.0     1.3
6 na 4 dni (SD 3.5 °C)  stała liczba kajaków             82.1     1.2
  sr_kajakow sr_zysk sr_brak
1       48.7  1400.2     7.6
2       59.7  1464.6     4.1
3       69.9  1279.3     5.8
4       51.4  1430.2     7.8
5       64.1  1495.9     4.0
6       71.4  1298.8     6.5
na 4 dni (SD 3.5 °C) na jutro (SD 1.8 °C)
                65.7                 64.4
6. Karta „plan na jutro”: Rysunek 6
R
# Rysunek 6. Karta „plan na jutro” – liczby wstawiane z wyników przepisu 4
# (korzysta z kol z przepisu 1 oraz prog, scen, q80_pkt i p_zamk z przepisu 4)
library(ggplot2)

na_osobe <- 35                                           # jeden pracownik obsługuje do 35 wypożyczeń dziennie
q80 <- ceiling(quantile(scen$wyp, 0.8, names = FALSE))
plan <- c(mediana = median(scen$wyp), kajaki = q80, obsada = ceiling(q80 / na_osobe),
          obsada_punktowa = ceiling(q80_pkt / na_osobe), burza_proc = round(100 * p_zamk, 1))
plan
karty <- data.frame(
  x = c(0, 1, 0, 1), y = c(1, 1, 0, 0),
  naglowek = c("1. Prognoza pogody", "2. Ile wypożyczeń", "3. Kajaki i obsada", "4. Ryzyko i pułapka"),
  liczba = c(sprintf("%d °C, deszcz %d%%", prog$temp, round(100 * prog$p_deszcz)),
             sprintf("mediana %d", round(plan[["mediana"]])),
             sprintf("%d kajaków, %d osób", plan[["kajaki"]], plan[["obsada"]]),
             sprintf("burza %s%%", formatC(plan[["burza_proc"]], format = "f", digits = 1))),
  opis = c(sprintf("Sobota w lipcu, przystań H. Błąd prognozy\ntemperatury: SD %.1f °C; jeśli spadnie deszcz,\nśrednio %.1f mm. Wiatr %d m/s.", prog$sd_temp,
                   prog$ksztalt * prog$skala, prog$wiatr),
           sprintf("Rozkład z 5000 scenariuszy pogody: 10%% dni\nponiżej %d, 80%% dni do %d wypożyczeń.\nBez deszczu mediana %d, z deszczem %d.",
                   round(quantile(scen$wyp, 0.1)), q80, round(median(scen$wyp[scen$opady == 0])),
                   round(median(scen$wyp[scen$opady > 0]))),
           sprintf("Kwantyl 80%%, bo brak kajaka kosztuje 40 zł,\na zbędny – 10 zł. Obsada: 1 osoba na %d\nwypożyczeń (z prognozy punktowej: %d i %d).", na_osobe,
                   q80_pkt, plan[["obsada_punktowa"]]),
           sprintf("Szansa zamknięcia przystani z powodu burzy\n(osobny model). Plan z prognozy punktowej\n(%d kajaków) zawiódłby w %.0f%% scenariuszy.",
                   q80_pkt, 100 * mean(scen$wyp > q80_pkt))),
  kolor = c(kol[["blekit"]], kol[["niebieski"]], kol[["zielony"]], kol[["pomaranczowy"]]))
p6 <- ggplot(karty) +
  geom_rect(aes(xmin = x + 0.03, xmax = x + 0.97, ymin = y + 0.04, ymax = y + 0.96), fill = "white",
            colour = karty$kolor, linewidth = 1.3) +
  geom_rect(aes(xmin = x + 0.03, xmax = x + 0.97, ymin = y + 0.80, ymax = y + 0.96), fill = karty$kolor) +
  geom_text(aes(x + 0.07, y + 0.88, label = naglowek), hjust = 0, size = 4.8, fontface = "bold",
            colour = ifelse(karty$kolor == kol[["blekit"]], "#0f1d3a", "white")) +
  geom_text(aes(x + 0.07, y + 0.63, label = liczba), hjust = 0, size = 7.2, fontface = "bold", colour = "#0f1d3a") +
  geom_text(aes(x + 0.07, y + 0.30, label = opis), hjust = 0, size = 3.9, colour = "grey20", lineheight = 1.05) +
  scale_x_continuous(limits = c(0, 2), expand = c(0, 0)) + scale_y_continuous(limits = c(0, 2), expand = c(0, 0)) +
  labs(title = "Plan na jutro: fikcyjna wypożyczalnia kajaków, przystań H") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 10, 10, 10))
karty[c("naglowek", "liczba")]
p6   # zapis: ggsave("pogoda-karta-plan-na-jutro.svg", p6, width = 10, height = 6.6)
Wynik w R
        mediana          kajaki          obsada obsada_punktowa      burza_proc
          122.0           181.0             6.0             4.0             8.1
             naglowek              liczba
1  1. Prognoza pogody   27 °C, deszcz 40%
2   2. Ile wypożyczeń         mediana 122
3  3. Kajaki i obsada 181 kajaków, 6 osób
4 4. Ryzyko i pułapka          burza 8.1%
7. Pułapki: zera z burzy i ekstrapolacja
R
# Pułapki: zera z burzy w modelu popytu i ekstrapolacja poza zakres temperatur
# (korzysta z mu_prawda i d z przepisu 1 oraz m i otw z przepisu 2)
library(mgcv)

# 1. Dni zamknięte (burza) potraktowane jak zwykłe dni z zerowym popytem
m_zera <- gam(formula(m), family = nb(), data = d, method = "REML")
upal <- data.frame(weekend_f = factor("weekend", levels(d$weekend_f)), wakacje = 1, temp = c(20, 28, 32),
                   opady = 0, wiatr = 4, przystan = "E")
round(rbind(bez_dni_zamknietych = exp(predict(m, upal, exclude = "s(przystan)")),
            z_zerami_z_burz = exp(predict(m_zera, upal, exclude = "s(przystan)")),
            prawda = mu_prawda(upal$temp, 0, 4, 1, 1, 0)), 1)
round(c(theta_bez = m$family$getTheta(TRUE), theta_z_zerami = m_zera$family$getTheta(TRUE)), 2)

# 2. Ekstrapolacja: ile dni było bardzo gorących i co model mówi o upale spoza danych
c(dni_powyzej_32 = sum(otw$temp > 32), max_temp = max(otw$temp))
ekstr <- transform(upal[rep(1, 4), ], temp = c(27, 33, 36, 38))
pr <- predict(m, ekstr, se.fit = TRUE, exclude = "s(przystan)")
round(data.frame(temp = ekstr$temp, gam = exp(pr$fit), dol = exp(pr$fit - 1.96 * pr$se.fit),
                 gora = exp(pr$fit + 1.96 * pr$se.fit), prawda = mu_prawda(ekstr$temp, 0, 4, 1, 1, 0)), 1)
Wynik w R
                       1     2     3
bez_dni_zamknietych 65.5 138.4 131.7
z_zerami_z_burz     64.0 133.5 113.1
prawda              66.5 134.9 128.3
     theta_bez theta_z_zerami
          7.63           4.07
dni_powyzej_32       max_temp
          20.0           34.1
    temp   gam   dol  gora prawda
1     27 131.6 110.1 157.2  129.1
1.1   33 123.5  94.5 161.5  116.2
1.2   36 100.5  60.6 166.7   70.6
1.3   38  87.6  43.9 174.8   43.0
8. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "żółty – niebieski" = c("#E69F00", "#0072B2"), "szary – pomarańczowy" = c("#999999", "#D55E00"),
             "szary – niebieski" = c("#999999", "#0072B2"), "zielony – pomarańczowy" = c("#009E73", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
żółty – niebieski                          120.2        121.5      109.3
szary – pomarańczowy                        77.2         62.9       56.0
szary – niebieski                           44.9         48.9       40.6
zielony – pomarańczowy                     102.4         53.5       37.3
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja logistyczna ryzyka burzy i kwantyle rozkładu ujemnego dwumianowego – pakiet stats z podstawowej instalacji R. Modele GAM (rodzina nb(), efekt losowy bs = "re") i losowanie współczynników (rmvn) – pakiet mgcv. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mgcv (wersja 1.9.4): Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Zera z burzy to nie brak chętnych. Jeśli 128 dni zamkniętych zostanie w danych jako zwykłe zera, model przewiduje na upalną lipcową sobotę (32 °C) 113.1 wypożyczenia zamiast 131.7 (prawda: 128.3), bo burze częściej zdarzają się w upał. Parametr θ spada z 7.63 do 4.07, więc przedziały prognozy niepotrzebnie się rozszerzają. Zera z innego procesu opisują modele z nadmiarem zer (Lambert, 1992); gdy znasz przyczynę zamknięcia, modeluj ją osobno.
- Ekstrapolacja poza zakres temperatur. Najcieplejszy dzień otwarty miał 34.1 °C. Na 38 °C GAM daje 87.6 wypożyczenia, 95% CI [43.9, 174.8], a prawda to 43.0 – tuż poniżej przedziału. Poza danymi krzywa tylko przedłuża ostatni odcinek.
- Wypożyczenia to nie popyt. Gdy na przystani skończą się kajaki, dane pokażą liczbę kajaków, a nie chętnych. Takie dni trzeba oznaczać i modelować jako obcięte (tak jak sprzedaż w dniach wyprzedanych we wpisie o modelu gazeciarza). W naszych danych flota była wystarczająca.
- Zależność to nie czysty efekt pogody. Słońce zmienia też nastrój i skłonność do wydatków (Murray i in., 2010), a pogodne weekendy zbiegają się z wydarzeniami w okolicy.
Najczęstsze pytania
Jak zbadać wpływ pogody na sprzedaż?
Zbierz dane dzienne (sprzedaż, temperatura, opady, wiatr, dzień tygodnia, święta) i dopasuj model, w którym pogoda wchodzi jako gładkie krzywe – np. GAM w pakiecie mgcv. Gdy sprzedaż to liczba sztuk lub wypożyczeń, użyj rozkładu ujemnego dwumianowego. Wynik pokaż na rysunku krzywych z 95% przedziałami ufności, bo z tabeli współczynników gładkich funkcji nie da się go odczytać.
Dlaczego GAM, a nie zwykła regresja z temperaturą?
Bo związek pogody ze sprzedażą rzadko jest prostą linią: w chłodne dni ruch jest mały, potem rośnie, a powyżej pewnej temperatury się wypłaszcza lub spada. GAM dopasowuje kształt krzywej do danych, a kara za krzywiznę (dobierana metodą REML) chroni przed goniącą szum, falującą linią. W przykładzie wypożyczalni krzywa wypłaszczała się powyżej ok. 28 °C.
Jak uwzględnić niepewność prognozy pogody w prognozie sprzedaży?
Zamiast wstawiać do modelu jedną wartość prognozy, wylosuj wiele scenariuszy pogody zgodnych z prognozą i jej błędem, policz sprzedaż w każdym i odczytaj kwantyle z całego rozkładu. W przykładzie kwantyl 80% wzrósł tak z 140 do 181 wypożyczeń, a plan pokrywał popyt w 77.9% zamiast w 63.3% dni.
Co zrobić z dniami, w których sklep był zamknięty z powodu pogody?
Nie traktuj ich jak dni z zerowym popytem – to zera z innego procesu. Usuń je z modelu popytu i modeluj osobno, np. regresją logistyczną ryzyka zamknięcia, albo użyj modelu z nadmiarem zer. W przykładzie pozostawienie 128 dni zamkniętych zaniżyło prognozę na upalną sobotę ze 131.7 do 113.1 wypożyczenia.
Czy model pogody można użyć przy rekordowym upale?
Ostrożnie: poza zakresem danych krzywa GAM tylko przedłuża ostatni odcinek, a przedział ufności gwałtownie się rozszerza. W przykładzie najcieplejszy dzień miał 34.1 °C; przy 38 °C model przewidywał 87.6 wypożyczenia, 95% CI [43.9, 174.8], a prawda wynosiła 43.0. Taką prognozę oznacz jako ekstrapolację.
Powiązane hasła
Przeczytaj też
Nieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikPrognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →PoradnikPozycja cenowa wobec konkurencji
Sklep z oponami i trzech konkurentów: względny indeks ceny, regresja z efektami stałymi, próg najtańszej oferty i pułapka odwrotnej przyczynowości – z kodem R.
Czytaj →Badasz wpływ pogody na sprzedaż w pracy dyplomowej?
Pomożemy przygotować dane dzienne z pogodą, dopasować model GAM dla zliczeń, zbudować prognozę z niepewnością i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Gneiting, T., & Raftery, A. E. (2005). Weather forecasting with ensemble methods. Science, 310(5746), 248–249. https://doi.org/10.1126/science.1115255
- Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1–14. https://doi.org/10.2307/1269547
- Marra, G., & Wood, S. N. (2012). Coverage properties of confidence intervals for generalized additive model components. Scandinavian Journal of Statistics, 39(1), 53–74. https://doi.org/10.1111/j.1467-9469.2011.00760.x ● Otwarty dostęp: pełny tekst
- Murray, K. B., Di Muro, F., Finn, A., & Popkowski Leszczyc, P. (2010). The effect of weather on consumer spending. Journal of Retailing and Consumer Services, 17(6), 512–520. https://doi.org/10.1016/j.jretconser.2010.08.006 ● Otwarty dostęp: pełny tekst
- Steinker, S., Hoberg, K., & Thonemann, U. W. (2017). The value of weather information for e-commerce operations. Production and Operations Management, 26(10), 1854–1874. https://doi.org/10.1111/poms.12721
- Ver Hoef, J. M., & Boveng, P. L. (2007). Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data? Ecology, 88(11), 2766–2772. https://doi.org/10.1890/07-0043.1
- Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x ● Otwarty dostęp
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
Cytowania BibTeX
@article{gneiting2005weather, author={Gneiting, Tilmann and Raftery, Adrian E.}, title={{Weather forecasting with ensemble methods}}, journal={Science}, year={2005}, volume={310}, number={5746}, pages={248--249}, doi={10.1126/science.1115255}}@article{lambert1992zero, author={Lambert, Diane}, title={{Zero-inflated Poisson regression, with an application to defects in manufacturing}}, journal={Technometrics}, year={1992}, volume={34}, number={1}, pages={1--14}, doi={10.2307/1269547}}@article{marra2012coverage, author={Marra, Giampiero and Wood, Simon N.}, title={{Coverage properties of confidence intervals for generalized additive model components}}, journal={Scandinavian Journal of Statistics}, year={2012}, volume={39}, number={1}, pages={53--74}, doi={10.1111/j.1467-9469.2011.00760.x}}@article{murray2010effect, author={Murray, Kyle B. and Di Muro, Fabrizio and Finn, Adam and Popkowski Leszczyc, Peter}, title={{The effect of weather on consumer spending}}, journal={Journal of Retailing and Consumer Services}, year={2010}, volume={17}, number={6}, pages={512--520}, doi={10.1016/j.jretconser.2010.08.006}}@article{steinker2017value, author={Steinker, Sebastian and Hoberg, Kai and Thonemann, Ulrich W.}, title={{The value of weather information for e-commerce operations}}, journal={Production and Operations Management}, year={2017}, volume={26}, number={10}, pages={1854--1874}, doi={10.1111/poms.12721}}@article{verhoef2007quasi, author={Ver Hoef, Jay M. and Boveng, Peter L.}, title={{Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data?}}, journal={Ecology}, year={2007}, volume={88}, number={11}, pages={2766--2772}, doi={10.1890/07-0043.1}}@article{wood2011fast, author={Wood, Simon N.}, title={{Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2011}, volume={73}, number={1}, pages={3--36}, doi={10.1111/j.1467-9868.2010.00749.x}}@book{wood2017generalized, author={Wood, Simon N.}, title={{Generalized additive models: An introduction with R (2nd ed.)}}, year={2017}, publisher={Chapman and Hall/CRC}, doi={10.1201/9781315370279}}