Przykład: infolinia dostawcy energii i pytanie „ilu nas potrzeba?”
Fikcyjny dostawca energii prowadzi infolinię czynną od 8:00 do 20:00. Kierownik obsługi klienta układa grafik i pyta: ilu konsultantów musi siedzieć przy telefonach w każdym kwadransie, żeby 80% połączeń odebrać w ciągu 20 sekund (cel „80/20”)? Za mało osób – klienci czekają i się rozłączają; za dużo – firma płaci za czekanie konsultantów.
Odpowiedź daje teoria kolejek: wzór Erlanga C. Ma on założenia, które trzeba sprawdzić na danych, a gdzie się nie trzymają – zastąpić symulacją. Przegląd badań nad infoliniami (Gans i in., 2003) podkreśla, że klasyczne modele kolejek są bardzo przydatne, ale mają wyraźne ograniczenia.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy: 20 dni roboczych, 48 kwadransów dziennie, profil dnia ze szczytem o 10:00 (średnio 80 połączeń na kwadrans) i drugim garbem około 13:30, losowe natężenie dnia (±10%: mnożnik z rozkładu gamma o średniej 1), lognormalny czas rozmowy (średnio 300 s, sdlog = 0.8) oraz – tylko w symulacji – cierpliwość klientów z rozkładu wykładniczego ze średnią 180 s. Ziarna 648 ani parametrów nie zmienialiśmy po pierwszym uruchomieniu. Dane: infolinia-energia-polaczenia.csv (wiersz = połączenie).
Rysunek 1: infolinia jako kolejka
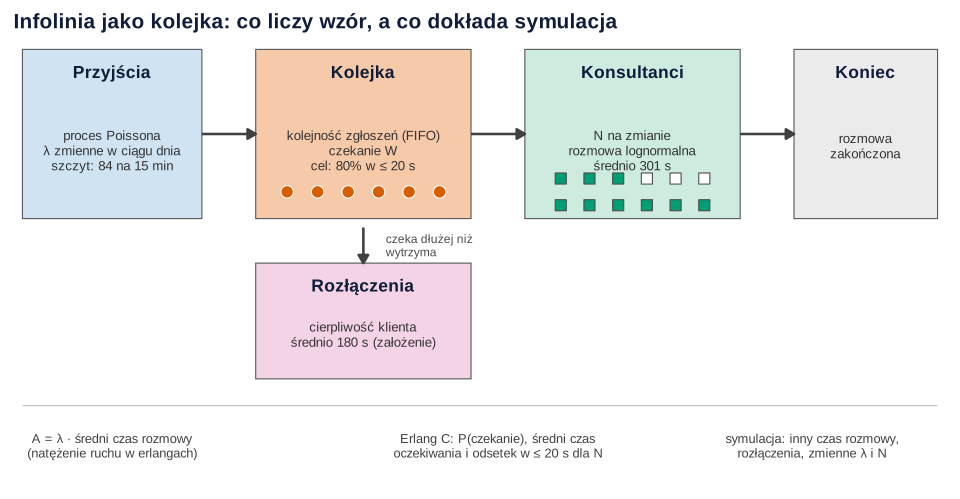
Co widać. Gdy wszyscy konsultanci rozmawiają, klient czeka w kolejce; część klientów się rozłącza. Kluczowa liczba to natężenie ruchu A w erlangach: połączenia na sekundę razy średni czas rozmowy, czyli średnia liczba zajętych konsultantów. Konsultantów musi być więcej niż A – inaczej kolejka rośnie bez końca.
Jak może zmylić. Schemat pomija ponowne dzwonienie, przerwy konsultantów i pracę po rozmowie (tę dolicz do czasu obsługi).
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: przyjścia połączeń – czy to Poisson?
Erlang C zakłada, że połączenia przychodzą jak w rozkładzie Poissona: niezależnie od siebie, ze stałym natężeniem. (odstępy mają wtedy rozkład wykładniczy). Natężenie zmienia się w ciągu dnia, więc sprawdzamy to w kwadransach.
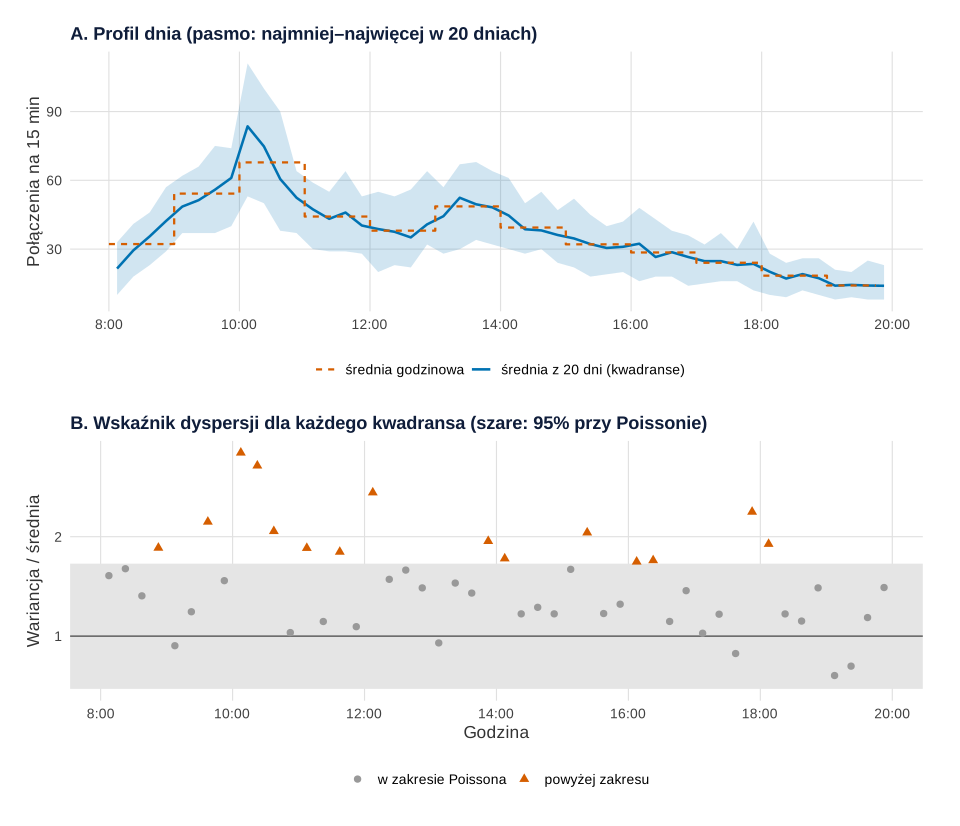
set.seed(648)).Co widać – panel A. W 20 dni do infolinii wpłynęło 35 336 połączeń, średnio 1766.8 dziennie. Szczyt przypada na kwadrans 10:00–10:15 (83.6 połączenia), ale średnia z godziny 10:00–11:00 to tylko 67.8. Pasmo pokazuje, jak bardzo ten sam kwadrans różni się między dniami.
Co widać – panel B. Przy rozkładzie Poissona wskaźnik dyspersji (wariancja / średnia z 20 dni) jest bliski 1; szare pasmo to zakres 95% z rozkładu chi-kwadrat z 19 stopniami swobody (jak w teście chi-kwadrat). Mediana wskaźnika wynosi 1.49, a 15 z 48 kwadransów leży powyżej pasma – to nadmierna dyspersja. Źródło widać w sumach dziennych: SD wynosi 205.2, a przy samym Poissonie byłoby ok. 42.
A wewnątrz kwadransa? Kim i Whitt (2014) proponują test: przy stałym natężeniu momenty połączeń w przedziale są rozłożone jednostajnie. Sprawdziliśmy to testem Kołmogorowa–Smirnowa dla wszystkich połączeń: D = 0.0046, p = .437. Wniosek: w obrębie dnia przyjścia zachowują się jak Poisson, ale natężenie różni się między dniami. Podobnie było w prawdziwych danych call center i szpitala analizowanych przez autorów: odrzucenia wynikały m.in. z łączenia tygodni o różnym natężeniu.
Jak może zmylić. Brak odrzucenia nie dowodzi, że założenie jest prawdziwe. Średnia z 20 dni to też tylko prognoza – w praktyce natężenie przewiduje się modelem z sezonowością (jak w prognozie sprzedaży z sezonowością i promocjami), uwzględniając wysyłkę faktur czy awarie sieci.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: czas rozmowy – wykładniczy czy lognormalny?
Drugie założenie Erlanga C: czas rozmowy ma rozkład wykładniczy. Brown i in. (2005), analizując roczne dane bankowego call center, pokazują, że przyjścia, cierpliwość i czas obsługi wymagają osobnej analizy (używają m.in. regresji z błędami lognormalnymi). Porównujemy więc rozkład wykładniczy z lognormalnym, oba dopasowane metodą największej wiarygodności.
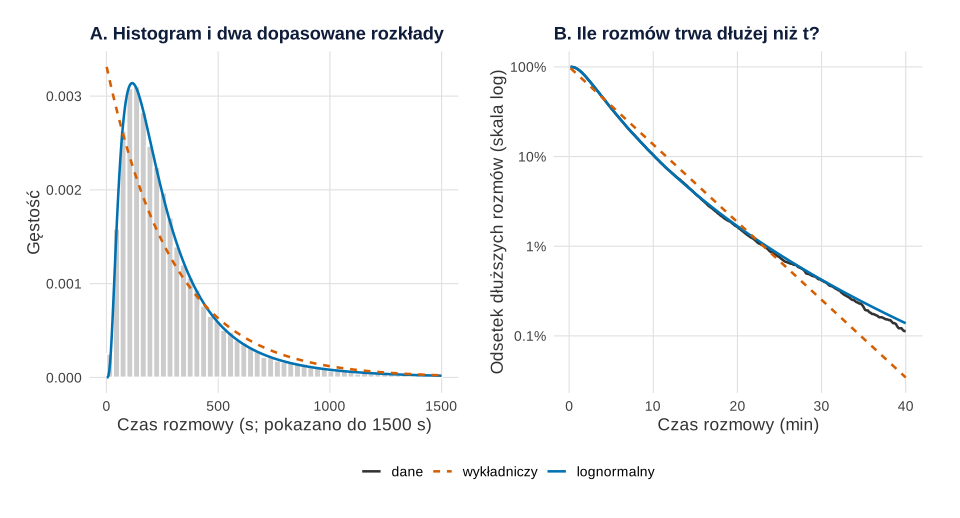
Co widać. Średni czas rozmowy to 301 s, mediana 219 s, odchylenie standardowe 283.1 s. Wykładniczy przewiduje 9.5% rozmów krótszych niż 30 s (dane: 0.6%, lognormalny: 0.7%) i 5.0% dłuższych niż 15 min (dane: 3.8%, lognormalny: 3.9%). Kryterium AIC wskazuje lognormalny: 465 331 wobec 474 000.
Jak może zmylić. Współczynnik zmienności wynosi 0.94 – prawie jak w rozkładzie wykładniczym (1), a czekanie zależy głównie od średniej i zmienności czasu obsługi. „Zły” kształt nie musi więc psuć wyniku – sprawdzimy to w symulacji. Skośne czasy opisuj też medianą (zob. czas na stronie i inne skośne metryki), ale do kolejki potrzebna jest średnia.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: Erlang C ręcznie – ilu konsultantów w szczycie?
W szczytowym kwadransie przychodzi średnio 83.6 połączenia; przy średniej rozmowie 301 s daje to A = 27.94 erlanga. Erlang C podaje prawdopodobieństwo czekania C(N, A) przy N konsultantach, a z niego wynikają dwie miary dla kierownika:
odsetek odebranych w ≤ t s = 1 − C(N, A) · e−(N − A) · t / AHT
gdzie AHT to średni czas obsługi. Kod liczy C ręcznie, przez rekurencyjny wzór Erlanga B, stabilny także przy dużym N.
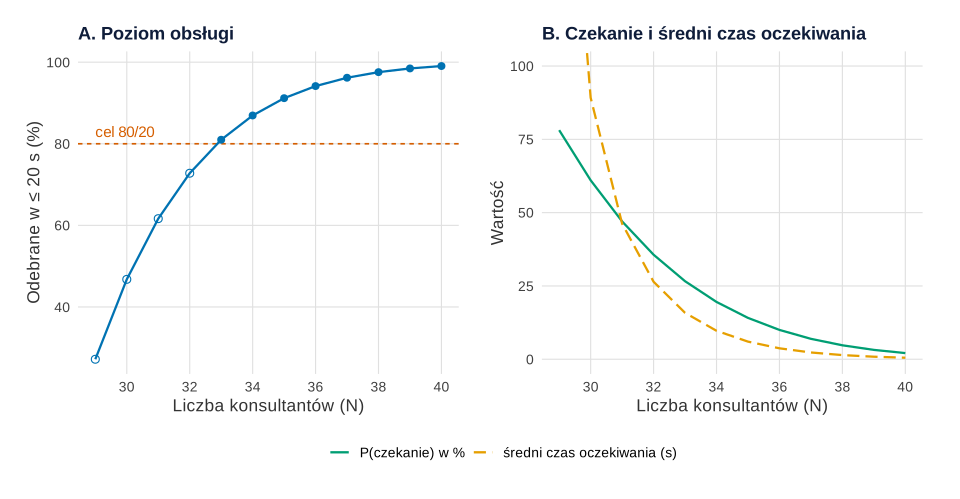
Co widać. Przy 28 konsultantach (obciążenie 99.8%) średnie czekanie to 4973.6 s – ponad godzina. Przy 32 osobach odbieramy w 20 s 72.8% połączeń, przy 33 – 81.0%, więc 33 to najmniejsza obsada spełniająca cel 80/20. Czeka wtedy 26.6% klientów, średnio 15.8 s, a z prawa Little'a (Little, 1961: liczba w kolejce = natężenie przyjść × średni czas czekania) – w kolejce jest średnio 1.47 osoby. Krzywa jest silnie nieliniowa: piąty konsultant ponad A daje więcej niż dziesiąty.
Jak może zmylić. Wzór opisuje stan ustalony – jakby szczyt trwał bez końca – i zakłada, że nikt się nie rozłącza. Garnett i in. (2002) podkreślają, że modele bez rozłączeń pomijają kluczową cechę prawdziwych infolinii.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: symulacja – rozłączenia i lognormalny czas rozmowy
Gdy założenia wzoru nie pasują, kolejkę można przeliczyć na komputerze. Symulacja zdarzeń dyskretnych bierze połączenia w kolejności przyjścia i każde daje konsultantowi, który najwcześniej się zwolni; jeśli czekanie przekroczyłoby cierpliwość klienta, klient się rozłącza. Funkcja ma ok. 30 linijek bazowego R. Plan (por. jak zaplanować badanie symulacyjne (ADEMP)): trzy warianty, N od 29 do 38, po 100 powtórzeń 3 godzin szczytowego natężenia (bez pierwszych 30 minut rozgrzewki); miara – odsetek wszystkich połączeń odebranych w ≤ 20 s (rozłączenia to nieodebrane) z błędem Monte Carlo, jak w symulacji Monte Carlo opłacalności projektu.
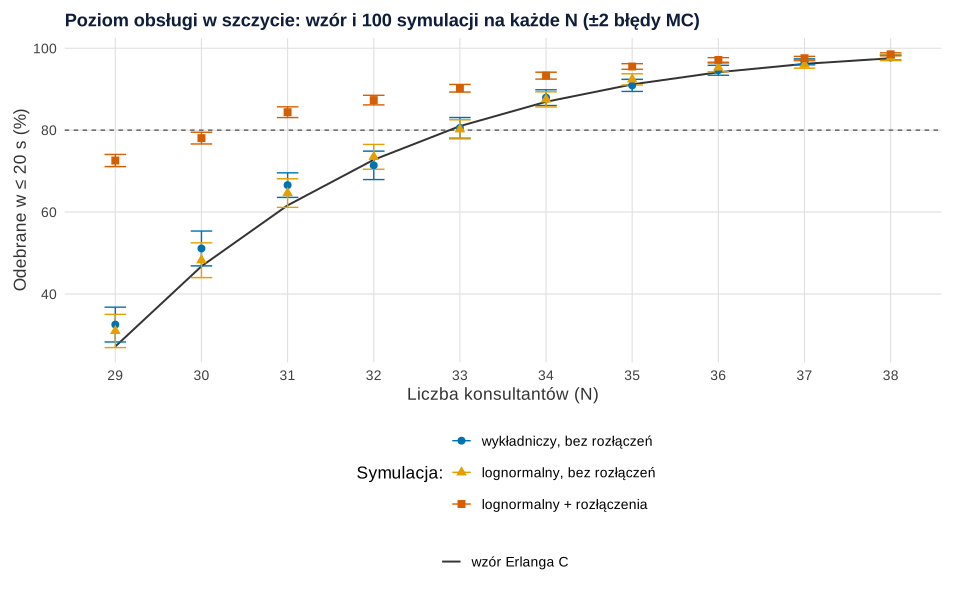
set.seed(648)).Co widać. Kontrola: z wykładniczym czasem rozmowy i bez rozłączeń przy 33 konsultantach symulacja daje 80.6% (błąd MC 1.3 pp), wzór 81.0% – symulator działa. Lognormalny czas rozmowy prawie nic nie zmienia (80.2%). Zmienia za to wiele rozłączanie się: przy 33 osobach odbieramy w 20 s 90.2% połączeń, a cel 80/20 spełnia już 31 konsultantów (84.4%, błąd MC 0.7 pp; rozłącza się 3.8% klientów). Kto się rozłączył, skraca kolejkę następnym – Erlang C zaleca tu o dwie osoby za dużo.
Jak może zmylić. Zysk opiera się na założonej cierpliwości (180 s). W danych jej nie widać – dla odebranych połączeń znamy tylko dolną granicę (obserwacja cenzurowana) – więc zrób analizę wrażliwości. Rozłączony klient często dzwoni ponownie. Przy 29 konsultantach (obciążenie 96%) symulacja daje więcej niż wzór, bo w 3 godziny kolejka nie dochodzi do stanu ustalonego.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: grafik dnia – kwadranse zamiast średnich godzinowych
Teraz cały dzień. Plan 1 liczy Erlanga C dla każdego z 48 kwadransów, plan 2 – dla średnich godzinowych, z tą samą obsadą przez cztery kwadranse. Podejście „przedział po przedziale” sprawdza się, gdy rozmowy są krótkie względem przedziału (Green i in., 2007) – u nas 5 minut wobec 15. Oba plany sprawdziliśmy w symulacji 200 dni z losowym natężeniem dnia, lognormalnym czasem rozmowy i rozłączeniami.
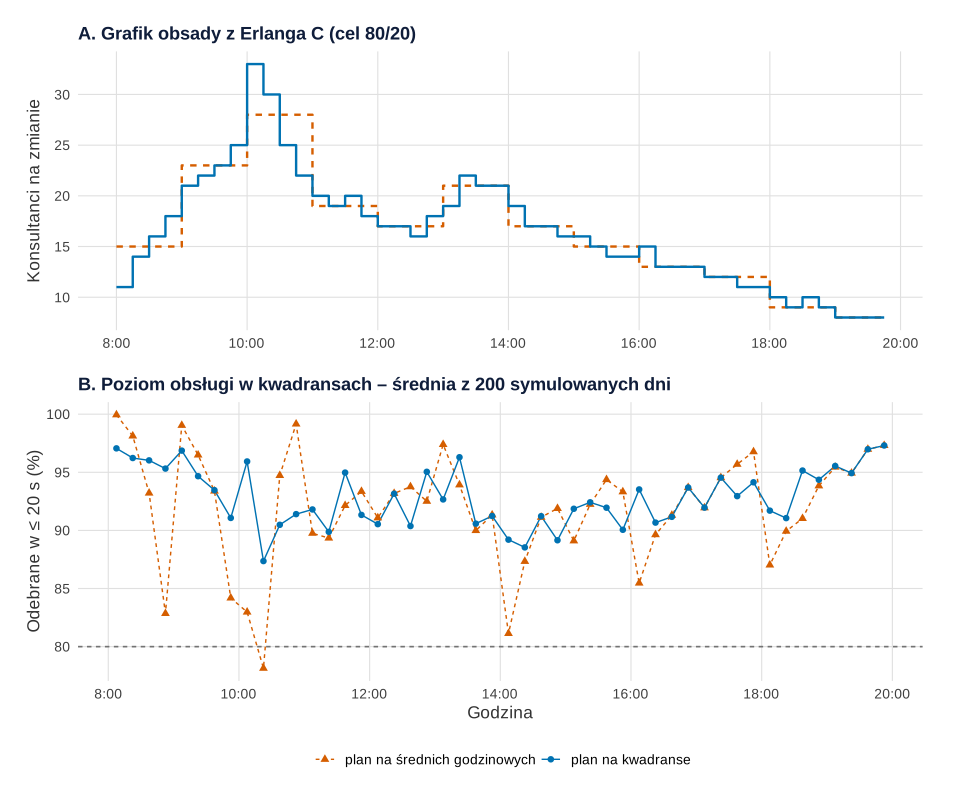
set.seed(648)).Co widać. Oba plany kosztują tyle samo: 196.5 i 197.0 konsultantogodzin dziennie. Różni je to, gdzie są ludzie: plan godzinowy daje 28 osób na całą godzinę 10:00–11:00, plan na kwadranse – 33 o 10:00, 30 o 10:15, potem 25 i 22. Plan godzinowy odbiera w 20 s o 10:00 83.0% połączeń, a o 10:15 – 78.1% (plan na kwadranse: 95.9% i 87.4%), za to o 10:45 ma 99.2% – konsultanci czekają na telefony. To pułapka średnich godzinowych: agregacja ukrywa szczyt. Spadek planu 1 o 10:15 to kolejka „przeniesiona” z 10:00 – na takie opóźnienie Green i in. (2007) proponują poprawki.
Jak może zmylić. W skali dnia różnica jest mała: 91.7% wobec 90.2% odebranych w 20 s, 2.2% wobec 2.7% rozłączeń, 6.0% wobec 7.5% dni poniżej celu (błąd MC 1.7 i 1.9 pp) – to głównie dni z natężeniem wyższym niż średnie. Dzienny wynik ukrywa kwadranse poniżej celu: 13.1% przy planie 1 i 15.0% przy planie 2.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Planuj w kwadransach. Przesuń początki zmian i przerwy tak, by szczyt 10:00–10:30 miał pełną obsadę – za ten sam koszt.
- Licz Erlanga C, ale sprawdź go symulacją. Przy rozłączeniach wzór zawyża obsadę, a przy długich rozmowach i gwałtownych zmianach natężenia może ją zaniżać.
- Mierz cierpliwość i ponowne połączenia. Bez tego zysk z rozłączeń jest tylko założeniem.
- Zostaw zapas na niepewność prognozy. Natężenie dnia różni się o ok. 10% – podobną logikę zapasu opisuje wpis o zapasach przy niepewnym popycie.
- Raportuj poziom obsługi w kwadransach, nie tylko dzienny. Dzienne 90% może ukrywać kwadranse poniżej 80%.
Jak opisać w pracy
W Metodzie podaj dane (okres, liczba połączeń, przedział), sprawdzenie założeń, model z definicją poziomu obsługi i plan symulacji (warianty, powtórzenia, rozgrzewka, założona cierpliwość, ziarno); w Wynikach – obsadę z modelu i z symulacji oraz porównanie grafików. Ogólne wskazówki: statystyka w pracy z logistyki, statystyka w pracy z zarządzania i ekonomii oraz jak napisać pracę z zarządzania i ekonomii.
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Kod R: dane, Erlang C, symulacja kolejki i grafik
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, a kolejne korzystają z obiektów i funkcji poprzednich. Erlanga C i symulację kolejki liczymy w bazowym R, bez pakietów do teorii kolejek. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Numeracja przepisów idzie za obliczeniami, dlatego schemat (rysunek 1) powstaje w przepisie 6.
Losują przepisy 1 (dane), 4 (symulacja w szczycie) i 5 (symulacja dni); każdy zaczyna się od własnego set.seed(648). Ziarno 648 ustalono raz i nie zmieniano go. Ręcznie ustalono: 20 dni, godziny 8:00–20:00 w 48 kwadransach, profil dnia (oczekiwana liczba połączeń w każdym kwadransie – wektor lambda_q), mnożnik natężenia dnia z rozkładu gamma (kształt 100, średnia 1), lognormalny czas rozmowy (średnio 300 s, sdlog = 0.8), wykładniczą cierpliwość klientów o średniej 180 s, cel 80/20, w symulacji szczytu – 3 godziny z 30 minutami rozgrzewki i 100 powtórzeń, w symulacji grafiku – 200 dni. Całość liczy się w niecałe pół minuty.
1. Paleta, dane, profil dnia i sprawdzenie Poissona: Rysunek 2
R
# Rysunek 2. Fikcyjna infolinia dostawcy energii: połączenia w 15-minutowych przedziałach i sprawdzenie rozkładu Poissona
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie: 20 dni roboczych, infolinia czynna 8:00–20:00 (48 przedziałów po 15 min)
set.seed(648)
dni <- 20
start_q <- seq(8 * 3600, by = 900, length.out = 48)              # początek przedziału w sekundach od północy
etykieta <- sprintf("%02d:%02d", start_q %/% 3600, (start_q %% 3600) %/% 60)
# Oczekiwana liczba połączeń na 15 min (profil dnia): narastanie rano, krótki szczyt 10:00–10:30,
# spadek w południe, drugi garb 13:00–14:00, wygaszanie wieczorem
lambda_q <- c(22, 28, 34, 40,  46, 50, 54, 62,  80, 78, 58, 50,  46, 44, 42, 40,
              38, 36, 36, 38,  44, 48, 50, 48,  44, 40, 38, 36,  34, 32, 30, 30,
              30, 28, 28, 26,  24, 24, 22, 22,  20, 18, 18, 16,  14, 14, 12, 12)
# Dzień do dnia natężenie różni się o ok. 10% (mnożnik z rozkładu gamma o średniej 1)
mnoznik_dnia <- rgamma(dni, shape = 100, rate = 100)
# Czas rozmowy: lognormalny, średnio 300 s, sdlog = 0.8 (ręcznie)
sdlog <- 0.8; meanlog <- log(300) - sdlog^2 / 2
polaczenia <- do.call(rbind, lapply(seq_len(dni), function(d) {
  n <- rpois(48, lambda_q * mnoznik_dnia[d])                     # liczba połączeń w każdym przedziale
  t <- unlist(mapply(function(s, k) sort(s + runif(k, 0, 900)), start_q, n))  # momenty w przedziale
  data.frame(dzien = d, przyjscie_s = round(t, 1), czas_obslugi_s = round(rlnorm(length(t), meanlog, sdlog)))
}))
polaczenia$godzina <- sprintf("%02d:%02d:%02d", as.integer(polaczenia$przyjscie_s %/% 3600),
                              as.integer((polaczenia$przyjscie_s %% 3600) %/% 60), as.integer(polaczenia$przyjscie_s %% 60))
write.csv(polaczenia[, c("dzien", "godzina", "przyjscie_s", "czas_obslugi_s")],
          "infolinia-energia-polaczenia.csv", row.names = FALSE)

# Liczby połączeń w przedziałach: macierz 20 dni × 48 przedziałów
polaczenia$q <- findInterval(polaczenia$przyjscie_s, start_q)
liczby <- table(factor(polaczenia$dzien, 1:dni), factor(polaczenia$q, 1:48))
prof <- data.frame(q = 1:48, start = start_q / 3600, srednia = colMeans(liczby),
                   min = apply(liczby, 2, min), max = apply(liczby, 2, max),
                   wariancja = apply(liczby, 2, var))
prof$godz_srednia <- ave(prof$srednia, (prof$q - 1) %/% 4)       # średnia z czterech kwadransów godziny
prof$D <- prof$wariancja / prof$srednia                           # wskaźnik dyspersji (Poisson: ok. 1)
# Pod Poissonem (dni - 1) · D ma w przybliżeniu rozkład chi-kwadrat z (dni - 1) stopniami swobody
granice_D <- qchisq(c(0.025, 0.975), dni - 1) / (dni - 1)

# Test Poissona w obrębie przedziału: przy stałym natężeniu momenty połączeń w kwadransie są jednostajne
# (Kim i Whitt, 2014). Łączymy pozycje w przedziale ze wszystkich 960 przedziałów i stosujemy test K–S
u <- (polaczenia$przyjscie_s - start_q[polaczenia$q]) / 900
ks <- suppressWarnings(ks.test(u, "punif"))
# Dzień do dnia: wariancja dziennych sum w porównaniu ze średnią
sumy <- rowSums(liczby)

print(data.frame(polaczen = nrow(polaczenia), dziennie_srednio = round(mean(sumy), 1),
                 dziennie_sd = round(sd(sumy), 1), sd_gdyby_poisson = round(sqrt(mean(sumy)), 1)))
print(data.frame(szczyt_kwadrans = etykieta[which.max(prof$srednia)], szczyt_srednio = round(max(prof$srednia), 1),
                 srednia_godziny_10 = round(prof$godz_srednia[prof$q == 9], 1),
                 D_mediana = round(median(prof$D), 2), D_powyzej_granicy = sum(prof$D > granice_D[2]),
                 granica_dolna = round(granice_D[1], 2), granica_gorna = round(granice_D[2], 2), KS_D = round(unname(ks$statistic), 4), KS_p = round(ks$p.value, 3)))

pA <- ggplot(prof, aes(start + 0.125)) +
  geom_ribbon(aes(ymin = min, ymax = max), fill = kol[["niebieski"]], alpha = 0.18) +
  geom_line(aes(y = srednia, colour = "średnia z 20 dni (kwadranse)"), linewidth = 0.9) +
  geom_step(aes(x = start, y = godz_srednia, colour = "średnia godzinowa"), linewidth = 0.8,
            linetype = "22", direction = "hv") +
  scale_colour_manual(values = c("średnia z 20 dni (kwadranse)" = kol[["niebieski"]],
                                 "średnia godzinowa" = kol[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(8, 20, 2), labels = function(x) paste0(x, ":00")) +
  labs(x = NULL, y = "Połączenia na 15 min", title = "A. Profil dnia (pasmo: najmniej–najwięcej w 20 dniach)") + motyw
pB <- ggplot(prof, aes(start + 0.125, D)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = granice_D[1], ymax = granice_D[2], fill = "grey90") +
  geom_hline(yintercept = 1, colour = kol[["ciemny"]], linewidth = 0.4) +
  geom_point(aes(shape = D > granice_D[2], colour = D > granice_D[2]), size = 2.2) +
  scale_colour_manual(values = c("FALSE" = kol[["szary"]], "TRUE" = kol[["cynober"]]),
                      labels = c("w zakresie Poissona", "powyżej zakresu"), name = NULL) +
  scale_shape_manual(values = c("FALSE" = 16, "TRUE" = 17), labels = c("w zakresie Poissona", "powyżej zakresu"), name = NULL) +
  scale_x_continuous(breaks = seq(8, 20, 2), labels = function(x) paste0(x, ":00")) +
  labs(x = "Godzina", y = "Wariancja / średnia",
       title = "B. Wskaźnik dyspersji dla każdego kwadransa (szare: 95% przy Poissonie)") + motyw
p1 <- pA / pB
p1   # zapis: ggsave("infolinia-przyjscia-poisson.svg", p1, width = 10, height = 8.6)
Wynik w R
  polaczen dziennie_srednio dziennie_sd sd_gdyby_poisson
1    35336           1766.8       205.2               42
  szczyt_kwadrans szczyt_srednio srednia_godziny_10 D_mediana D_powyzej_granicy
1           10:00           83.6               67.8      1.49                15
  granica_dolna granica_gorna   KS_D  KS_p
1          0.47          1.73 0.0046 0.437
2. Czas rozmowy – wykładniczy czy lognormalny: Rysunek 3
R
# Rysunek 3. Czas rozmowy: rozkład wykładniczy czy lognormalny? (korzysta z obiektów z przepisu 1)
x <- polaczenia$czas_obslugi_s
# Dopasowanie metodą największej wiarygodności – oba rozkłady mają wzory jawne
rate_exp <- 1 / mean(x)
ml <- mean(log(x)); sl <- sqrt(mean((log(x) - ml)^2))
logLik_exp <- sum(dexp(x, rate_exp, log = TRUE))
logLik_ln <- sum(dlnorm(x, ml, sl, log = TRUE))
print(data.frame(srednia = round(mean(x), 1), mediana = median(x), sd = round(sd(x), 1),
                 wsp_zmiennosci = round(sd(x) / mean(x), 2), meanlog = round(ml, 3), sdlog = round(sl, 3)))
print(data.frame(model = c("wykładniczy", "lognormalny"), parametry = c(1, 2),
                 AIC = round(c(-2 * logLik_exp + 2, -2 * logLik_ln + 4)),
                 krotsze_niz_30s_proc = round(100 * c(pexp(30, rate_exp), plnorm(30, ml, sl)), 1),
                 dluzsze_niz_15min_proc = round(100 * c(1 - pexp(900, rate_exp), 1 - plnorm(900, ml, sl)), 1)))
print(data.frame(dane_krotsze_niz_30s_proc = round(100 * mean(x < 30), 1),
                 dane_dluzsze_niz_15min_proc = round(100 * mean(x > 900), 1)))

siatka <- data.frame(t = seq(1, 1500, length.out = 400))
gest <- rbind(data.frame(t = siatka$t, g = dexp(siatka$t, rate_exp), model = "wykładniczy"),
              data.frame(t = siatka$t, g = dlnorm(siatka$t, ml, sl), model = "lognormalny"))
kolory_modeli <- c("dane" = kol[["ciemny"]], "wykładniczy" = kol[["cynober"]], "lognormalny" = kol[["niebieski"]])
linie_modeli <- c("dane" = "solid", "wykładniczy" = "22", "lognormalny" = "solid")
n_x <- length(x)
pA <- ggplot(data.frame(x = x[x <= 1500]), aes(x)) +
  geom_histogram(aes(y = after_stat(count / (n_x * 30))), binwidth = 30, boundary = 0,
                 fill = "grey80", colour = "white") +
  geom_line(data = gest, aes(t, g, colour = model, linetype = model), linewidth = 0.9) +
  scale_colour_manual(values = kolory_modeli, limits = names(kolory_modeli), name = NULL) +
  scale_linetype_manual(values = linie_modeli, limits = names(linie_modeli), name = NULL) +
  guides(colour = "none", linetype = "none") +                      # legenda wspólna – pod panelem B
  labs(x = "Czas rozmowy (s; pokazano do 1500 s)", y = "Gęstość", title = "A. Histogram i dwa dopasowane rozkłady") + motyw
t_ogon <- c(seq(10, 2400, by = 10))
ogon <- rbind(data.frame(t = t_ogon, S = sapply(t_ogon, function(s) mean(x > s)), model = "dane"),
              data.frame(t = t_ogon, S = 1 - pexp(t_ogon, rate_exp), model = "wykładniczy"),
              data.frame(t = t_ogon, S = 1 - plnorm(t_ogon, ml, sl), model = "lognormalny"))
pB <- ggplot(ogon, aes(t / 60, S, colour = model, linetype = model)) +
  geom_line(linewidth = 0.9) +
  scale_y_log10(labels = function(v) paste0(100 * v, "%"), breaks = c(0.001, 0.01, 0.1, 1)) +
  scale_colour_manual(values = kolory_modeli, limits = names(kolory_modeli), name = NULL) +
  scale_linetype_manual(values = linie_modeli, limits = names(linie_modeli), name = NULL) +
  labs(x = "Czas rozmowy (min)", y = "Odsetek dłuższych rozmów (skala log)",
       title = "B. Ile rozmów trwa dłużej niż t?") + motyw
p2 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("infolinia-czas-rozmowy.svg", p2, width = 10, height = 5.4)
Wynik w R
  srednia mediana    sd wsp_zmiennosci meanlog sdlog
1     301     219 283.1           0.94   5.388   0.8
        model parametry    AIC krotsze_niz_30s_proc dluzsze_niz_15min_proc
1 wykładniczy         1 474000                  9.5                    5.0
2 lognormalny         2 465331                  0.7                    3.9
  dane_krotsze_niz_30s_proc dane_dluzsze_niz_15min_proc
1                       0.6                         3.8
3. Erlang C liczony ręcznie: Rysunek 4
R
# Rysunek 4. Erlang C liczony ręcznie: prawdopodobieństwo czekania, średni czas oczekiwania i poziom obsługi
# Wzory dla kolejki M/M/N (przyjścia Poissona, wykładniczy czas obsługi, N konsultantów, nikt się nie rozłącza)
erlang_c <- function(N, A) {                    # A = natężenie ruchu w erlangach = λ · średni czas obsługi
  if (N <= A) return(1)                         # przy N ≤ A kolejka rośnie bez końca
  # Erlang B rekurencyjnie (stabilnie numerycznie), potem przejście do Erlanga C
  B <- 1
  for (k in 1:N) B <- A * B / (k + A * B)
  N * B / (N - A * (1 - B))
}
miary_erlang <- function(N, lambda_s, aht, t_cel = 20) {    # lambda_s: połączenia na sekundę, aht w sekundach
  A <- lambda_s * aht
  C <- erlang_c(N, A)
  stabilna <- N > A
  data.frame(N = N, A = A, obciazenie = A / N, P_czekania = C,
             ASA_s = if (stabilna) C * aht / (N - A) else Inf,                 # średni czas oczekiwania
             SL = if (stabilna) 1 - C * exp(-(N - A) * t_cel / aht) else 0)   # odsetek odebranych w ≤ 20 s
}
# Najmniejsza liczba konsultantów, przy której poziom obsługi 80/20 jest spełniony
min_N <- function(lambda_s, aht, cel = 0.80, t_cel = 20) {
  N <- max(1, floor(lambda_s * aht) + 1)
  while (miary_erlang(N, lambda_s, aht, t_cel)$SL < cel) N <- N + 1
  N
}
# Szczytowy kwadrans: średnia liczba połączeń o 10:00 z przepisu 1, średni czas rozmowy z przepisu 2
lambda_szczyt <- prof$srednia[prof$q == 9] / 900
aht <- mean(polaczenia$czas_obslugi_s)
tab <- do.call(rbind, lapply(26:40, miary_erlang, lambda_s = lambda_szczyt, aht = aht))
print(data.frame(polaczen_na_15_min = round(lambda_szczyt * 900, 1), aht_s = round(aht, 1),
                 erlangi = round(lambda_szczyt * aht, 2), N_dla_80_20 = min_N(lambda_szczyt, aht)))
print(transform(tab, A = round(A, 2), obciazenie = round(obciazenie, 3), P_czekania = round(P_czekania, 3),
                ASA_s = round(ASA_s, 1), SL = round(SL, 3)), row.names = FALSE)
# Prawo Little'a: średnia liczba osób czekających = λ · średni czas oczekiwania
N0 <- min_N(lambda_szczyt, aht)
cat("Średnio czeka w kolejce przy N =", N0, ":", round(lambda_szczyt * tab$ASA_s[tab$N == N0], 2), "osób\n")

tab_r <- tab[tab$N >= 29, ]                       # na wykresie od N = 29 (przy N = 28 czekanie trwa godzinami)
pA <- ggplot(tab_r, aes(N, 100 * SL)) +
  geom_hline(yintercept = 80, colour = kol[["cynober"]], linetype = "22") +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_point(aes(shape = SL >= 0.8), colour = kol[["niebieski"]], size = 2.4, show.legend = FALSE) +
  scale_shape_manual(values = c("FALSE" = 1, "TRUE" = 16)) +
  annotate("text", x = min(tab_r$N), y = 83, label = "cel 80/20", hjust = 0, colour = kol[["cynober"]], size = 4) +
  scale_x_continuous(breaks = seq(26, 40, 2)) +
  labs(x = "Liczba konsultantów (N)", y = "Odebrane w ≤ 20 s (%)", title = "A. Poziom obsługi") + motyw
pB <- ggplot(tab_r, aes(N)) +
  geom_line(aes(y = 100 * P_czekania, colour = "P(czekanie) w %", linetype = "P(czekanie) w %"), linewidth = 0.8) +
  geom_line(aes(y = ASA_s, colour = "średni czas oczekiwania (s)", linetype = "średni czas oczekiwania (s)"),
            linewidth = 0.8) +
  scale_colour_manual(values = c("P(czekanie) w %" = kol[["zielony"]], "średni czas oczekiwania (s)" = kol[["pomarancz"]]),
                      name = NULL) +
  scale_linetype_manual(values = c("P(czekanie) w %" = "solid", "średni czas oczekiwania (s)" = "42"), name = NULL) +
  coord_cartesian(ylim = c(0, 100)) + scale_x_continuous(breaks = seq(26, 40, 2)) +
  labs(x = "Liczba konsultantów (N)", y = "Wartość", title = "B. Czekanie i średni czas oczekiwania") + motyw
p3 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p3   # zapis: ggsave("infolinia-erlang-c.svg", p3, width = 10, height = 5.2)
Wynik w R
  polaczen_na_15_min aht_s erlangi N_dla_80_20
1               83.6   301   27.94          33
  N     A obciazenie P_czekania  ASA_s    SL
 26 27.94      1.075      1.000    Inf 0.000
 27 27.94      1.035      1.000    Inf 0.000
 28 27.94      0.998      0.987 4973.6 0.017
 29 27.94      0.963      0.781  221.9 0.272
 30 27.94      0.931      0.610   89.2 0.468
 31 27.94      0.901      0.470   46.2 0.616
 32 27.94      0.873      0.357   26.4 0.728
 33 27.94      0.847      0.266   15.8 0.810
 34 27.94      0.822      0.195    9.7 0.869
 35 27.94      0.798      0.141    6.0 0.912
 36 27.94      0.776      0.100    3.7 0.941
 37 27.94      0.755      0.070    2.3 0.962
 38 27.94      0.735      0.048    1.4 0.976
 39 27.94      0.716      0.032    0.9 0.985
 40 27.94      0.699      0.021    0.5 0.991
Średnio czeka w kolejce przy N = 33 : 1.47 osób
4. Symulacja zdarzeń dyskretnych: Rysunek 5
R
# Rysunek 5. Symulacja zdarzeń dyskretnych w bazowym R: wzór Erlanga C a kolejka z lognormalnym czasem rozmowy
# i rozłączeniami (korzysta z obiektów z przepisów 1–3)
# Kolejka FIFO z N konsultantami. Dla każdego połączenia (w kolejności przyjścia) szukamy konsultanta, który
# najwcześniej może je odebrać. Jeśli czekanie byłoby dłuższe niż cierpliwość klienta – klient się rozłącza
# i nie zajmuje konsultanta. N może zmieniać się w ciągu dnia (wektor N_q dla przedziałów od czasu 0).
symuluj_kolejke <- function(przyjscie, obsluga, cierpliwosc, N_q, dl_przedzialu = 900) {
  Nmax <- max(N_q); n <- length(przyjscie)
  wolny <- rep(0, Nmax)                          # od kiedy każdy konsultant jest wolny
  czekanie <- numeric(n); rozlaczyl <- logical(n)
  stale_N <- length(N_q) == 1
  if (!stale_N) {
    Q <- length(N_q)
    # dla konsultanta k i przedziału q: początek najbliższego przedziału ≥ q, w którym k jest na zmianie
    nast <- matrix(Inf, Nmax, Q)
    for (k in seq_len(Nmax)) {
      nxt <- Inf
      for (q in Q:1) { if (k <= N_q[q]) nxt <- (q - 1) * dl_przedzialu; nast[k, q] <- nxt }
    }
  }
  for (i in seq_len(n)) {
    a <- przyjscie[i]
    kand <- pmax(wolny, a)
    if (!stale_N) {
      q <- pmin(kand %/% dl_przedzialu + 1, Q)      # po zamknięciu kolejkę obsługuje skład z ostatniego przedziału
      poza <- seq_len(Nmax) > N_q[q]
      kand[poza] <- pmax(nast[cbind(which(poza), q[poza])], a)
    }
    j <- which.min(kand)
    czekanie[i] <- kand[j] - a
    if (czekanie[i] > cierpliwosc[i]) {
      rozlaczyl[i] <- TRUE; czekanie[i] <- cierpliwosc[i]    # rozłącza się po czasie cierpliwości
    } else wolny[j] <- kand[j] + obsluga[i]
  }
  data.frame(przyjscie, czekanie, rozlaczyl)
}
# Poziom obsługi: odebrane w ≤ 20 s spośród wszystkich połączeń (rozłączenia liczą się jako nieodebrane)
podsumuj <- function(w) data.frame(SL = mean(!w$rozlaczyl & w$czekanie <= 20),
                                   ASA_s = mean(w$czekanie[!w$rozlaczyl]), porzucone = mean(w$rozlaczyl))

# Szczytowe natężenie ze stałym λ przez 3 godziny; pierwsze 30 minut (rozgrzewka) pomijamy
set.seed(648)
czas_sym <- 3 * 3600; rozgrzewka <- 1800; powt <- 100
srednia_cierpliwosc <- 180                       # ręcznie: cierpliwość wykładnicza, średnio 3 min
warianty <- c("wykładniczy, bez rozłączeń", "lognormalny, bez rozłączeń", "lognormalny + rozłączenia")
wyniki <- do.call(rbind, lapply(29:38, function(N) do.call(rbind, lapply(seq_len(powt), function(r) {
  t <- cumsum(rexp(ceiling(lambda_szczyt * czas_sym * 1.2), lambda_szczyt)); t <- t[t < czas_sym]
  n <- length(t)
  s_exp <- rexp(n, 1 / aht); s_ln <- rlnorm(n, ml, sl); cierp <- rexp(n, 1 / srednia_cierpliwosc)
  okno <- t >= rozgrzewka
  rbind(cbind(N = N, wariant = warianty[1], podsumuj(symuluj_kolejke(t, s_exp, rep(Inf, n), N)[okno, ])),
        cbind(N = N, wariant = warianty[2], podsumuj(symuluj_kolejke(t, s_ln, rep(Inf, n), N)[okno, ])),
        cbind(N = N, wariant = warianty[3], podsumuj(symuluj_kolejke(t, s_ln, cierp, N)[okno, ])))
}))))
zest <- aggregate(cbind(SL, ASA_s, porzucone) ~ N + wariant, data = wyniki, FUN = mean)
zest$SL_bladMC <- aggregate(SL ~ N + wariant, data = wyniki, FUN = function(v) sd(v) / sqrt(length(v)))$SL
wzor <- do.call(rbind, lapply(29:38, miary_erlang, lambda_s = lambda_szczyt, aht = aht))
zest <- merge(zest, data.frame(N = wzor$N, SL_wzor = wzor$SL, ASA_wzor = wzor$ASA_s))
zest <- zest[order(match(zest$wariant, warianty), zest$N), ]
print(transform(zest, SL = round(100 * SL, 1), SL_bladMC = round(100 * SL_bladMC, 1), SL_wzor = round(100 * SL_wzor, 1),
                ASA_s = round(ASA_s, 1), ASA_wzor = round(ASA_wzor, 1), porzucone = round(100 * porzucone, 1)),
      row.names = FALSE)
# Najmniejsze N spełniające 80/20 według wzoru i w każdym wariancie symulacji
print(c("wzór Erlanga C" = min(wzor$N[wzor$SL >= 0.8]),
        sapply(split(zest, zest$wariant)[warianty], function(z) min(z$N[z$SL >= 0.8]))))

zest$wariant <- factor(zest$wariant, levels = warianty)
p4 <- ggplot(zest, aes(N, 100 * SL)) +
  geom_hline(yintercept = 80, colour = "grey45", linetype = "22") +
  geom_line(data = unique(zest[, c("N", "SL_wzor")]), aes(N, 100 * SL_wzor, linetype = "wzór Erlanga C"),
            colour = kol[["ciemny"]], linewidth = 0.7, inherit.aes = FALSE) +
  geom_errorbar(aes(ymin = 100 * (SL - 2 * SL_bladMC), ymax = 100 * (SL + 2 * SL_bladMC), colour = wariant),
                width = 0.25, linewidth = 0.5) +
  geom_point(aes(colour = wariant, shape = wariant), size = 2.4) +
  scale_colour_manual(values = setNames(kol[c("niebieski", "pomarancz", "cynober")], warianty), name = "Symulacja:") +
  scale_shape_manual(values = setNames(c(16, 17, 15), warianty), name = "Symulacja:") +
  scale_linetype_manual(values = c("wzór Erlanga C" = "solid"), name = NULL) +
  scale_x_continuous(breaks = 29:38) +
  guides(colour = guide_legend(nrow = 3), shape = guide_legend(nrow = 3)) +
  labs(x = "Liczba konsultantów (N)", y = "Odebrane w ≤ 20 s (%)",
       title = "Poziom obsługi w szczycie: wzór i 100 symulacji na każde N (±2 błędy MC)") + motyw
p4   # zapis: ggsave("infolinia-symulacja-vs-wzor.svg", p4, width = 10, height = 6.2)
Wynik w R
  N                    wariant   SL ASA_s porzucone SL_bladMC SL_wzor ASA_wzor
 29 wykładniczy, bez rozłączeń 32.5 148.0       0.0       2.1    27.2    221.9
 30 wykładniczy, bez rozłączeń 51.1  68.0       0.0       2.1    46.8     89.2
 31 wykładniczy, bez rozłączeń 66.6  32.7       0.0       1.5    61.6     46.2
 32 wykładniczy, bez rozłączeń 71.4  29.8       0.0       1.7    72.8     26.4
 33 wykładniczy, bez rozłączeń 80.6  16.5       0.0       1.3    81.0     15.8
 34 wykładniczy, bez rozłączeń 87.9   8.7       0.0       1.0    86.9      9.7
 35 wykładniczy, bez rozłączeń 90.9   6.3       0.0       0.7    91.2      6.0
 36 wykładniczy, bez rozłączeń 94.6   3.4       0.0       0.6    94.1      3.7
 37 wykładniczy, bez rozłączeń 96.7   2.0       0.0       0.4    96.2      2.3
 38 wykładniczy, bez rozłączeń 97.7   1.3       0.0       0.3    97.6      1.4
 29 lognormalny, bez rozłączeń 31.0 134.6       0.0       2.0    27.2    221.9
 30 lognormalny, bez rozłączeń 48.2  70.9       0.0       2.1    46.8     89.2
 31 lognormalny, bez rozłączeń 64.6  36.6       0.0       1.7    61.6     46.2
 32 lognormalny, bez rozłączeń 73.5  25.0       0.0       1.5    72.8     26.4
 33 lognormalny, bez rozłączeń 80.2  15.2       0.0       1.2    81.0     15.8
 34 lognormalny, bez rozłączeń 87.5   8.8       0.0       0.9    86.9      9.7
 35 lognormalny, bez rozłączeń 92.4   5.2       0.0       0.7    91.2      6.0
 36 lognormalny, bez rozłączeń 95.3   2.8       0.0       0.5    94.1      3.7
 37 lognormalny, bez rozłączeń 96.0   2.3       0.0       0.4    96.2      2.3
 38 lognormalny, bez rozłączeń 97.7   1.3       0.0       0.3    97.6      1.4
 29  lognormalny + rozłączenia 72.6  11.4       6.8       0.7    27.2    221.9
 30  lognormalny + rozłączenia 78.1   8.9       5.4       0.7    46.8     89.2
 31  lognormalny + rozłączenia 84.4   6.2       3.8       0.7    61.6     46.2
 32  lognormalny + rozłączenia 87.3   5.1       3.0       0.6    72.8     26.4
 33  lognormalny + rozłączenia 90.2   3.8       2.3       0.5    81.0     15.8
 34  lognormalny + rozłączenia 93.3   2.6       1.5       0.4    86.9      9.7
 35  lognormalny + rozłączenia 95.5   1.8       1.1       0.3    91.2      6.0
 36  lognormalny + rozłączenia 97.1   1.1       0.7       0.3    94.1      3.7
 37  lognormalny + rozłączenia 97.6   0.9       0.6       0.2    96.2      2.3
 38  lognormalny + rozłączenia 98.5   0.6       0.4       0.2    97.6      1.4
            wzór Erlanga C wykładniczy, bez rozłączeń
                        33                         33
lognormalny, bez rozłączeń  lognormalny + rozłączenia
                        33                         31
5. Grafik dnia: kwadranse a średnie godzinowe – Rysunek 6
R
# Rysunek 6. Od profilu dnia do grafiku obsady: plan na kwadranse a plan na średnich godzinowych
# (korzysta z obiektów z przepisów 1–4)
# Plan 1: Erlang C osobno dla każdego kwadransa (średnia liczba połączeń z 20 dni)
N_kwadrans <- sapply(prof$srednia / 900, min_N, aht = aht)
# Plan 2: Erlang C dla średniej godzinowej, ta sama obsada przez cztery kwadranse
N_godzina <- sapply(prof$godz_srednia / 900, min_N, aht = aht)
print(data.frame(plan = c("kwadranse", "godziny"),
                 konsultantogodziny = c(sum(N_kwadrans), sum(N_godzina)) / 4,
                 najwiecej_naraz = c(max(N_kwadrans), max(N_godzina))))
print(data.frame(kwadrans = etykieta[8:12], polaczen = round(prof$srednia[8:12], 1),
                 N_kwadrans = N_kwadrans[8:12], N_godzina = N_godzina[8:12]), row.names = FALSE)

# Symulacja 200 dni: natężenie dnia losowe (jak w danych), czas rozmowy lognormalny, rozłączenia
set.seed(648)
dni_sym <- 200
sym_dni <- do.call(rbind, lapply(seq_len(dni_sym), function(d) {
  m <- rgamma(1, shape = 100, rate = 100)
  n_q <- rpois(48, lambda_q * m)
  t <- unlist(mapply(function(s, k) sort(s + runif(k, 0, 900)), (seq_len(48) - 1) * 900, n_q))
  n <- length(t); s_ln <- rlnorm(n, ml, sl); cierp <- rexp(n, 1 / srednia_cierpliwosc)
  rbind(cbind(dzien = d, plan = "kwadranse", symuluj_kolejke(t, s_ln, cierp, N_kwadrans)),
        cbind(dzien = d, plan = "godziny", symuluj_kolejke(t, s_ln, cierp, N_godzina)))
}))
sym_dni$q <- sym_dni$przyjscie %/% 900 + 1
sym_dni$w20 <- !sym_dni$rozlaczyl & sym_dni$czekanie <= 20
dzienne <- aggregate(cbind(w20, rozlaczyl) ~ dzien + plan, data = sym_dni, FUN = mean)
kw <- aggregate(w20 ~ q + plan + dzien, data = sym_dni, FUN = mean)
print(data.frame(plan = c("kwadranse", "godziny"), t(sapply(c("kwadranse", "godziny"), function(p) {
  dz <- dzienne[dzienne$plan == p, ]; k <- kw[kw$plan == p, ]
  c(SL_dnia_proc = round(100 * mean(dz$w20), 1), dni_ponizej_80_proc = round(100 * mean(dz$w20 < 0.8), 1),
    blad_MC_pp = round(100 * sqrt(mean(dz$w20 < 0.8) * (1 - mean(dz$w20 < 0.8)) / nrow(dz)), 1),
    porzucone_proc = round(100 * mean(dz$rozlaczyl), 1),
    kwadranse_ponizej_80_proc = round(100 * mean(k$w20 < 0.8), 1))
}))), row.names = FALSE)
sl_q <- aggregate(w20 ~ q + plan, data = kw, FUN = mean)
print(data.frame(kwadrans = etykieta[8:12], SL_kwadranse = round(100 * sl_q$w20[sl_q$plan == "kwadranse"][8:12], 1),
                 SL_godziny = round(100 * sl_q$w20[sl_q$plan == "godziny"][8:12], 1)), row.names = FALSE)

plany <- c("kwadranse" = kol[["niebieski"]], "godziny" = kol[["cynober"]])
etyk_planu <- c("kwadranse" = "plan na kwadranse", "godziny" = "plan na średnich godzinowych")
obsada <- rbind(data.frame(start = prof$start, N = N_kwadrans, plan = "kwadranse"),
                data.frame(start = prof$start, N = N_godzina, plan = "godziny"))
pA <- ggplot(obsada, aes(start, N, colour = plan, linetype = plan)) +
  geom_step(linewidth = 0.85, direction = "hv") +
  scale_colour_manual(values = plany, labels = etyk_planu, name = NULL) +
  scale_linetype_manual(values = c("kwadranse" = "solid", "godziny" = "22"), labels = etyk_planu, name = NULL) +
  scale_x_continuous(breaks = seq(8, 20, 2), labels = function(x) paste0(x, ":00")) +
  guides(colour = "none", linetype = "none") +                      # legenda wspólna – pod panelem B
  labs(x = NULL, y = "Konsultanci na zmianie", title = "A. Grafik obsady z Erlanga C (cel 80/20)") + motyw
sl_q$start <- prof$start[sl_q$q] + 0.125
pB <- ggplot(sl_q, aes(start, 100 * w20, colour = plan, shape = plan)) +
  geom_hline(yintercept = 80, colour = "grey45", linetype = "22") +
  geom_line(aes(linetype = plan), linewidth = 0.5) + geom_point(size = 1.9) +
  scale_linetype_manual(values = c("kwadranse" = "solid", "godziny" = "22"), labels = etyk_planu, name = NULL) +
  scale_colour_manual(values = plany, labels = etyk_planu, name = NULL) +
  scale_shape_manual(values = c("kwadranse" = 16, "godziny" = 17), labels = etyk_planu, name = NULL) +
  scale_x_continuous(breaks = seq(8, 20, 2), labels = function(x) paste0(x, ":00")) +
  labs(x = "Godzina", y = "Odebrane w ≤ 20 s (%)",
       title = "B. Poziom obsługi w kwadransach – średnia z 200 symulowanych dni") + motyw
p5 <- pA / pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("infolinia-grafik-dnia.svg", p5, width = 10, height = 8.4)
Wynik w R
       plan konsultantogodziny najwiecej_naraz
1 kwadranse              196.5              33
2   godziny              197.0              28
 kwadrans polaczen N_kwadrans N_godzina
    09:45     61.0         25        23
    10:00     83.6         33        28
    10:15     74.8         30        28
    10:30     60.5         25        28
    10:45     52.4         22        28
      plan SL_dnia_proc dni_ponizej_80_proc blad_MC_pp porzucone_proc
 kwadranse         91.7                 6.0        1.7            2.2
   godziny         90.2                 7.5        1.9            2.7
 kwadranse_ponizej_80_proc
                      13.1
                      15.0
 kwadrans SL_kwadranse SL_godziny
    09:45         91.1       84.2
    10:00         95.9       83.0
    10:15         87.4       78.1
    10:30         90.5       94.7
    10:45         91.4       99.2
6. Schemat kolejki: Rysunek 1
R
# Rysunek 1. Schemat kolejki na infolinii: przyjścia → kolejka → konsultanci → rozłączenia
# (grafika w ggplot2: prostokąty, punkty i strzałki; liczby z przepisów 1–4)
bloki <- data.frame(
  x = c(1.2, 4.0, 7.0, 9.6, 4.0), y = c(3.0, 3.0, 3.0, 3.0, 0.9), w = c(2.0, 2.4, 2.4, 1.6, 2.4), h = c(1.9, 1.9, 1.9, 1.9, 1.3),
  wypelnienie = c("#CFE3F2", "#F6C9A9", "#CDEBDF", "grey92", "#F3D3E5"),
  tytul = c("Przyjścia", "Kolejka", "Konsultanci", "Koniec", "Rozłączenia"),
  opis = c(sprintf("proces Poissona\nλ zmienne w ciągu dnia\nszczyt: %.0f na 15 min", lambda_szczyt * 900),
           "kolejność zgłoszeń (FIFO)\nczekanie W\ncel: 80% w ≤ 20 s",
           sprintf("N na zmianie\nrozmowa lognormalna\nśrednio %.0f s", aht),
           "rozmowa\nzakończona",
           sprintf("cierpliwość klienta\nśrednio %d s (założenie)", srednia_cierpliwosc)))
strzalki <- data.frame(x = c(2.2, 5.2, 8.2, 4.0), y = c(3.0, 3.0, 3.0, 1.95), xend = c(2.8, 5.8, 8.8, 4.0),
                       yend = c(3.0, 3.0, 3.0, 1.55))
kolejka <- data.frame(x = seq(3.15, 4.85, length.out = 6), y = 2.35)        # czekający klienci
stanowiska <- expand.grid(x = seq(6.2, 7.8, length.out = 6), y = c(2.2, 2.5))  # konsultanci (część zajęta)
stanowiska$wyp <- c(rep(kol[["zielony"]], 9), rep("white", 3))   # zielone – rozmawiają, białe – wolni
wzory <- data.frame(x = c(1.2, 5.5, 9.0), y = -0.5,
                    t = c("A = λ · średni czas rozmowy\n(natężenie ruchu w erlangach)",
                          "Erlang C: P(czekanie), średni czas\noczekiwania i odsetek w ≤ 20 s dla N",
                          "symulacja: inny czas rozmowy,\nrozłączenia, zmienne λ i N"))
p6 <- ggplot() +
  geom_rect(data = bloki, aes(xmin = x - w / 2, xmax = x + w / 2, ymin = y - h / 2, ymax = y + h / 2,
                              fill = wypelnienie), colour = "grey35", linewidth = 0.4) +
  scale_fill_identity() +
  geom_text(data = bloki, aes(x, y + h / 2 - 0.25, label = tytul), fontface = "bold", size = 4.6, colour = "#0f1d3a") +
  geom_text(data = bloki[bloki$tytul != "Rozłączenia", ], aes(x, y - 0.05, label = opis), size = 3.5,
            colour = "grey20", lineheight = 0.95, vjust = 0.8) +
  geom_text(data = bloki[bloki$tytul == "Rozłączenia", ], aes(x, y - 0.15, label = opis), size = 3.5,
            colour = "grey20", lineheight = 0.95) +
  geom_point(data = kolejka, aes(x, y), shape = 21, size = 4, fill = kol[["cynober"]], colour = "white") +
  geom_point(data = stanowiska, aes(x, y, fill = wyp), shape = 22, size = 4, colour = "grey30") +
  geom_segment(data = strzalki, aes(x, y, xend = xend, yend = yend), linewidth = 0.9, colour = "grey25",
               arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("text", x = 4.25, y = 1.75, label = "czeka dłużej niż\nwytrzyma", size = 3.2, hjust = 0, colour = "grey30",
           lineheight = 0.9) +
  geom_text(data = wzory, aes(x, y, label = t), size = 3.4, colour = "grey25", lineheight = 0.95) +
  annotate("segment", x = 0.2, xend = 10.4, y = -0.05, yend = -0.05, colour = "grey75", linewidth = 0.4) +
  coord_cartesian(xlim = c(0.1, 10.5), ylim = c(-0.95, 4.05), expand = FALSE) +
  labs(title = "Infolinia jako kolejka: co liczy wzór, a co dokłada symulacja") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 10, 10, 10))
p6   # zapis: ggsave("infolinia-schemat-kolejki.svg", p6, width = 10, height = 5.2)
7. Sprawdzenie palety pod kątem zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (kwadranse / godziny; lognormalny / wykładniczy)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (symulacja: wykładniczy / lognormalny)" = c("#0072B2", "#E69F00"),
             "pomarańczowy – cynober (lognormalny / + rozłączenia)" = c("#E69F00", "#D55E00"),
             "zielony – pomarańczowy (P(czekanie) / średni czas)" = c("#009E73", "#E69F00"),
             "jasnoniebieski – jasnopomarańczowy (bloki schematu)" = c("#CFE3F2", "#F6C9A9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                     widzenie_typowe
niebieski – cynober (kwadranse / godziny; lognormalny / wykładniczy)           114.6
niebieski – pomarańczowy (symulacja: wykładniczy / lognormalny)                120.2
pomarańczowy – cynober (lognormalny / + rozłączenia)                            33.4
zielony – pomarańczowy (P(czekanie) / średni czas)                              88.7
jasnoniebieski – jasnopomarańczowy (bloki schematu)                             35.4
czerwony – zielony (do unikania)                                               121.7
                                                                     deuteranopia
niebieski – cynober (kwadranse / godziny; lognormalny / wykładniczy)        108.3
niebieski – pomarańczowy (symulacja: wykładniczy / lognormalny)             121.5
pomarańczowy – cynober (lognormalny / + rozłączenia)                         18.4
zielony – pomarańczowy (P(czekanie) / średni czas)                           66.3
jasnoniebieski – jasnopomarańczowy (bloki schematu)                          34.6
czerwony – zielony (do unikania)                                             21.1
                                                                     protanopia
niebieski – cynober (kwadranse / godziny; lognormalny / wykładniczy)       91.9
niebieski – pomarańczowy (symulacja: wykładniczy / lognormalny)           109.3
pomarańczowy – cynober (lognormalny / + rozłączenia)                       24.9
zielony – pomarańczowy (P(czekanie) / średni czas)                         51.5
jasnoniebieski – jasnopomarańczowy (bloki schematu)                        29.9
czerwony – zielony (do unikania)                                           31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, test K–S, wzór Erlanga C i symulacja kolejki – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Średnie godzinowe zamiast kwadransów. Spłaszczają szczyt; w przykładzie średnia godziny 10:00 to 67.8 połączenia, a szczytowego kwadransa – 83.6.
- Obsada „na styk” z natężenia ruchu. 28 konsultantów przy 27.94 erlanga to ponad godzina czekania. Kolejka potrzebuje zapasu ponad A.
- Poziom obsługi bez definicji. Napisz, czy rozłączenia liczysz w mianowniku i od ilu sekund. Różne definicje dają różne liczby.
- Jedna symulacja. Jeden przebieg dnia to anegdota – podaj liczbę powtórzeń i błąd Monte Carlo.
- Łączenie różnych dni. Poniedziałki po wysyłce faktur i spokojne piątki w jednej średniej dają nadmierną dyspersję i zły grafik dla obu.
Najczęstsze pytania
Jak policzyć liczbę konsultantów na infolinii ze wzoru Erlanga C?
Policz natężenie ruchu A = liczba połączeń na sekundę × średni czas obsługi (w sekundach). Dla kolejnych N > A oblicz prawdopodobieństwo czekania C(N, A) i odsetek odebranych w ≤ 20 s: 1 − C · exp(−(N − A) · 20 / średni czas obsługi). Najmniejsze N z wynikiem co najmniej 80% to obsada dla celu 80/20. W przykładzie przy 27.94 erlanga było to 33 konsultantów.
Czy połączenia na infolinię mają rozkład Poissona?
Zwykle w krótkich przedziałach – tak, ale natężenie zmienia się w ciągu dnia i między dniami. Sprawdź to w kwadransach: test Kołmogorowa–Smirnowa dla momentów połączeń w obrębie przedziałów (Kim i Whitt, 2014) i wskaźnik dyspersji (wariancja / średnia) z wielu dni. W przykładzie test nie wykazał odchyleń (p = .437), a mediana wskaźnika dyspersji wynosiła 1.49 z powodu różnic między dniami.
Dlaczego Erlang C zawyża liczbę konsultantów?
Bo zakłada, że nikt się nie rozłącza. Klient, który rezygnuje, skraca kolejkę następnym, więc pozostali czekają krócej (Garnett i in., 2002). W symulacji z cierpliwością średnio 180 s cel 80/20 w szczycie spełniało 31 konsultantów zamiast 33. Rozłączeni często dzwonią jednak ponownie – ten ruch też trzeba policzyć.
Czy do grafiku wystarczą średnie godzinowe liczby połączeń?
Nie, jeśli w godzinie jest krótki szczyt. W przykładzie średnia godziny 10:00 wynosiła 67.8 połączenia na kwadrans, a szczytowy kwadrans 83.6. Plan godzinowy, przy tej samej liczbie konsultantogodzin, dawał w szczycie 78.1% odebranych w 20 s, a plan na kwadranse 87.4%.
Jak zrobić symulację kolejki w R bez dodatkowych pakietów?
Wygeneruj momenty połączeń, czasy rozmów i cierpliwość klientów, a potem przejdź pętlą po połączeniach w kolejności przyjścia: dla każdego wybierz konsultanta, który najwcześniej się zwalnia; jeśli czekanie przekroczyłoby cierpliwość, klient się rozłącza. Powtórz to wiele razy (w przykładzie 100 razy dla każdej obsady) i podaj błąd Monte Carlo. Najpierw sprawdź, czy przy założeniach wzoru symulacja odtwarza Erlanga C.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z logistyki
Czasy dostaw i percentyle, błędy kompletacji na 1000 linii, przerwany szereg czasowy w magazynie, dostawcy jako skupienia i prognoza popytu: analizy, zdania APA i kod R.
Czytaj →PoradnikJak zaplanować badanie symulacyjne
Schemat ADEMP krok po kroku: cele, dane, estymandy, metody i miary jakości z błędem Monte Carlo, liczba powtórzeń i ziarna w SimDesign.
Czytaj →PoradnikModel gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →PoradnikRuch w sklepie a konwersja
Korekta licznika wejść, mały mianownik, model obciążenia obsługi i utracone transakcje – na fikcyjnej sieci salonów optycznych, z kodem R.
Czytaj →Planujesz obsadę lub analizujesz kolejki w pracy dyplomowej?
Pomożemy sprawdzić rozkład przyjść i czasów obsługi, policzyć Erlanga C, zbudować symulację kolejki z rozłączeniami i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L., Gans, N., Mandelbaum, A., Sakov, A., Shen, H., Zeltyn, S., & Zhao, L. (2005). Statistical analysis of a telephone call center: A queueing-science perspective. Journal of the American Statistical Association, 100(469), 36–50. https://doi.org/10.1198/016214504000001808
- Gans, N., Koole, G., & Mandelbaum, A. (2003). Telephone call centers: Tutorial, review, and research prospects. Manufacturing & Service Operations Management, 5(2), 79–141. https://doi.org/10.1287/msom.5.2.79.16071 ● Otwarty dostęp: pełny tekst
- Garnett, O., Mandelbaum, A., & Reiman, M. (2002). Designing a call center with impatient customers. Manufacturing & Service Operations Management, 4(3), 208–227. https://doi.org/10.1287/msom.4.3.208.7753
- Green, L. V., Kolesar, P. J., & Whitt, W. (2007). Coping with time-varying demand when setting staffing requirements for a service system. Production and Operations Management, 16(1), 13–39. https://doi.org/10.1111/j.1937-5956.2007.tb00164.x ● Otwarty dostęp: pełny tekst
- Kim, S.-H., & Whitt, W. (2014). Are call center and hospital arrivals well modeled by nonhomogeneous Poisson processes? Manufacturing & Service Operations Management, 16(3), 464–480. https://doi.org/10.1287/msom.2014.0490
- Little, J. D. C. (1961). A proof for the queuing formula: L = λW. Operations Research, 9(3), 383–387. https://doi.org/10.1287/opre.9.3.383
Cytowania BibTeX
@article{brown2005statistical, author={Brown, Lawrence and Gans, Noah and Mandelbaum, Avishai and Sakov, Anat and Shen, Haipeng and Zeltyn, Sergey and Zhao, Linda}, title={{Statistical analysis of a telephone call center: A queueing-science perspective}}, journal={Journal of the American Statistical Association}, year={2005}, volume={100}, number={469}, pages={36--50}, doi={10.1198/016214504000001808}}@article{gans2003telephone, author={Gans, Noah and Koole, Ger and Mandelbaum, Avishai}, title={{Telephone call centers: Tutorial, review, and research prospects}}, journal={Manufacturing \& Service Operations Management}, year={2003}, volume={5}, number={2}, pages={79--141}, doi={10.1287/msom.5.2.79.16071}}@article{garnett2002designing, author={Garnett, O. and Mandelbaum, A. and Reiman, M.}, title={{Designing a call center with impatient customers}}, journal={Manufacturing \& Service Operations Management}, year={2002}, volume={4}, number={3}, pages={208--227}, doi={10.1287/msom.4.3.208.7753}}@article{green2007coping, author={Green, Linda V. and Kolesar, Peter J. and Whitt, Ward}, title={{Coping with time-varying demand when setting staffing requirements for a service system}}, journal={Production and Operations Management}, year={2007}, volume={16}, number={1}, pages={13--39}, doi={10.1111/j.1937-5956.2007.tb00164.x}}@article{kim2014call, author={Kim, Song-Hee and Whitt, Ward}, title={{Are call center and hospital arrivals well modeled by nonhomogeneous Poisson processes?}}, journal={Manufacturing \& Service Operations Management}, year={2014}, volume={16}, number={3}, pages={464--480}, doi={10.1287/msom.2014.0490}}@article{little1961proof, author={Little, John D. C.}, title={{A proof for the queuing formula: L = λW}}, journal={Operations Research}, year={1961}, volume={9}, number={3}, pages={383--387}, doi={10.1287/opre.9.3.383}}