Przykład: piekarnie, chleb na zakwasie i mąka w magazynie
Fikcyjna sieć dwunastu piekarni codziennie rano decyduje, ile bochenków chleba na zakwasie upiec w każdym punkcie. Chleb jest jednodniowy: to, co zostanie po zamknięciu, idzie na paszę. Raz w tygodniu sieć zamawia też mąkę do magazynu centralnego, a młyn dostarcza ją po dwóch tygodniach. Dwa pytania biznesowe: ile upiec (część 1 – model gazeciarza) i ile mąki trzymać na zapas (część 2 – zapas bezpieczeństwa).
Wspólne sedno: popytu nie znasz z góry, a pomyłka w górę i w dół kosztuje różnie, więc potrzebny jest cały rozkład popytu albo błędów prognozy, nie średnia. Wpis prognoza sprzedaży z sezonowością i promocjami pokazuje, jak zbudować prognozę; tu zamieniamy prognozę na decyzję.
Dane są fikcyjne, więc znamy prawdziwy popyt. Parametry ustalono ręcznie: cena bochenka 12 zł, koszt wypieku 4.50 zł, odzysk z niesprzedanego bochenka 0.50 zł; średni dzienny popyt w jednej piekarni od 38 bochenków w niedzielę do 105 w sobotę; dotychczasowy stały wypiek „na średnią sprzedaż” (od 38 do 100 bochenków). Mąka: średnio 16 t tygodniowo z sezonowością i świętami. Ziarno 649 ustalono raz i nie zmieniano. Dane pobierzesz jako zapasy-piekarnia-sprzedaz-dzienna.csv (364 dni; kolumna z prawdziwym popytem, której w firmie nie ma) i zapasy-maka-zuzycie-tygodniowe.csv (156 tygodni).
Rysunek 1: koszt za mało i koszt za dużo
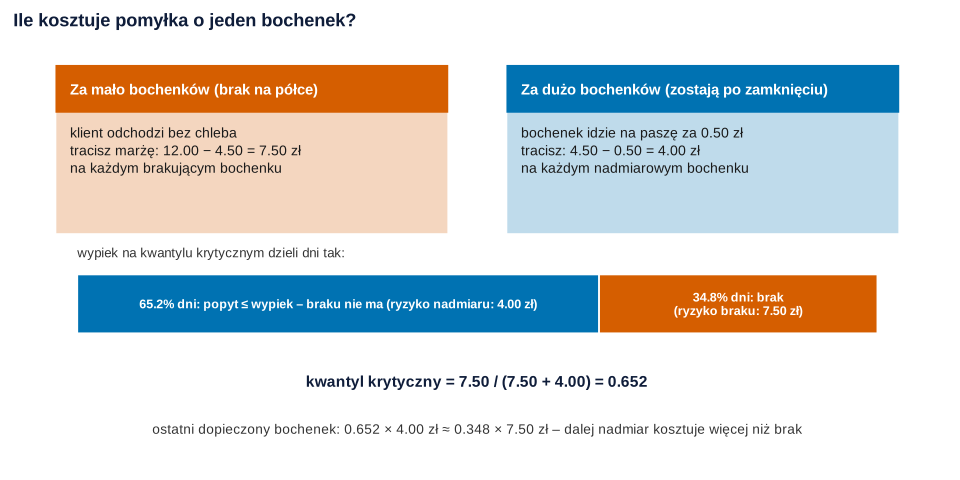
Co widać. Brakujący bochenek to utracona marża: 12.00 − 4.50 = 7.50 zł. Nadmiarowy bochenek to koszt wypieku minus odzysk: 4.50 − 0.50 = 4.00 zł. Model gazeciarza (ang. newsvendor model) mówi: piecz tyle, ile wynosi kwantyl krytyczny rozkładu popytu.
Słowami: optymalny wypiek to taki, przy którym popyt nie przekracza wypieku w 65.2% dni – to 65.2. percentyl rozkładu popytu. Dopieczenie kolejnego bochenka opłaca się, dopóki szansa, że zostanie (razy 4.00 zł), jest mniejsza niż szansa, że go zabraknie (razy 7.50 zł) – to porównanie dwóch wartości oczekiwanych. Na kwantylu krytycznym obie strony się równoważą: 0.652 × 4.00 ≈ 0.348 × 7.50.
Jak może zmylić. Kwantyl zależy od kosztów, nie tylko od popytu. Gdyby wczorajszy chleb sprzedawać po 3 zł, koszt nadmiaru spadłby do 1.50 zł, a kwantyl krytyczny wzrósłby do 0.833. Klienta, który zrazi się na dłużej, dolicz do 7.50 zł, jeśli umiesz go wycenić.
Podpis do pracy:
Rysunek 2: sprzedaż to nie popyt
Żeby wziąć kwantyl popytu, trzeba znać rozkład popytu. Piekarnia zna tylko sprzedaż. W dniu, w którym chleb się skończył, sprzedaż równa się wypiekowi, a ilu klientów odeszło z niczym – nie wiadomo. Taki dzień to obserwacja cenzurowana: wiemy tylko, że popyt był co najmniej taki jak wypiek. Conrad (1976) zwrócił uwagę na tę różnicę między sprzedażą a popytem właśnie w problemie gazeciarza.
Popyt opisujemy rozkładem ujemnym dwumianowym (zliczenia z rozrzutem większym niż w rozkładzie Poissona – jak w regresji ujemnej dwumianowej), z osobną średnią dla każdego dnia tygodnia. Parametry szacujemy metodą największej wiarygodności na dwa sposoby. Model naiwny traktuje sprzedaż jak popyt. Model z cenzurowaniem w dniu wyprzedanym używa prawdopodobieństwa, że popyt był co najmniej równy wypiekowi – tak samo działa model tobitowy dla zmiennych ciągłych. Nahmias (1994) porównał w symulacjach kilka takich estymatorów dla popytu normalnego.
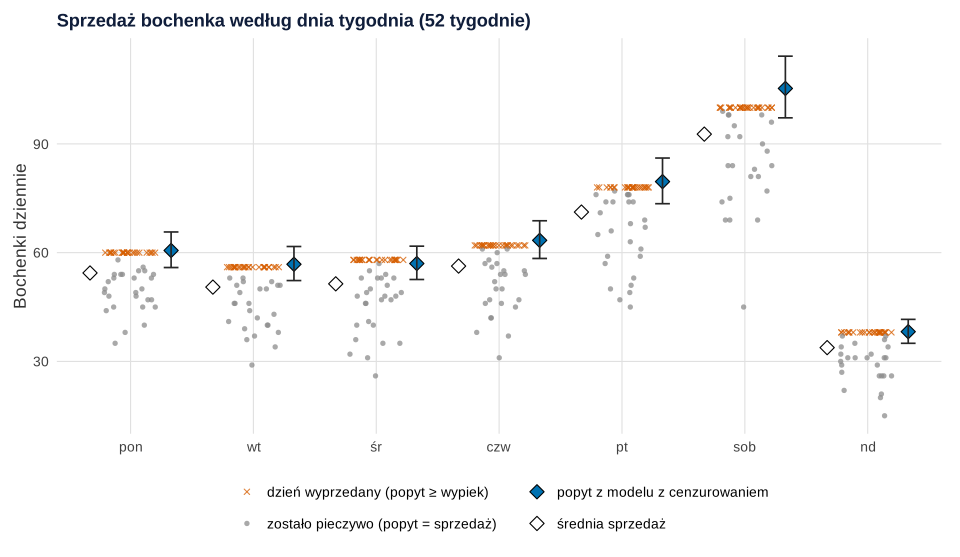
set.seed(649)).Co widać. Chleb skończył się w 51.1% dni. Krzyżyki tworzą „sufit” na wysokości wypieku. Średnia sprzedaż w sobotę to 92.7 bochenka, a model z cenzurowaniem szacuje średni popyt na 105.3, 95% przedział ufności [97.2, 114.2]. Prawdziwa wartość (znana tylko w symulacji) to 105. W pozostałe dni jest podobnie: średnia sprzedaż leży poniżej dolnej granicy przedziału dla popytu.
Jak może zmylić. Sufit zaniża nie tylko średnią, ale i rozrzut. W sobotę odchylenie standardowe sprzedaży to 11.9, a popytu 25.7. Model naiwny „widzi” więc popyt prawie bez wahań: parametr kształtu wyszedł 242.5 (rozkład niemal jak Poissona), a w modelu z cenzurowaniem 20.8. Zaniżony rozrzut przesuwa kwantyl w dół tak samo jak zaniżona średnia.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: koszt pomyłek w funkcji wypieku
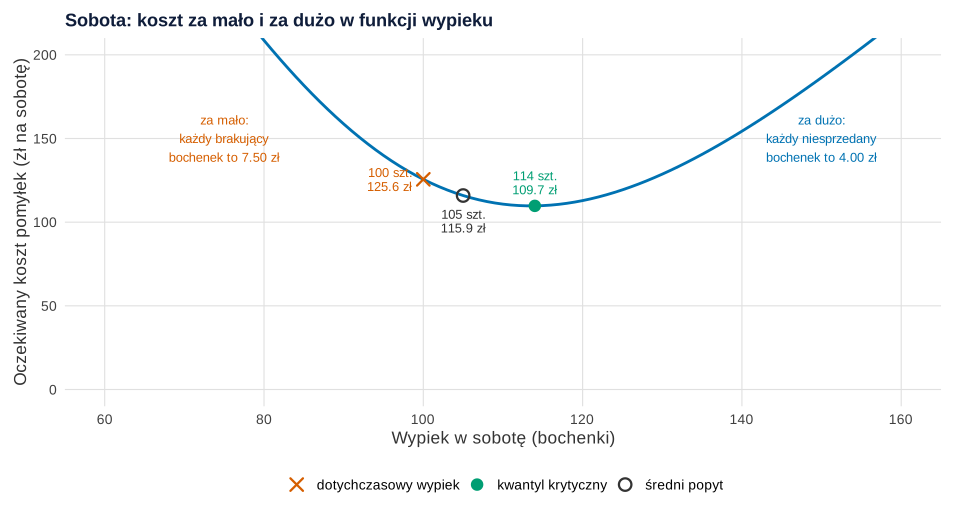
Co widać. Dla każdego wypieku liczymy średni koszt: 7.50 zł razy oczekiwana liczba brakujących bochenków plus 4.00 zł razy oczekiwana liczba niesprzedanych. Minimum leży przy 114 bochenkach (109.7 zł na sobotę) – dokładnie na kwantylu krytycznym. Wypiek równy średniemu popytowi (105) kosztuje 115.9 zł, dotychczasowe 100 bochenków – 125.6 zł. Lewe ramię jest bardziej strome, bo brak kosztuje więcej.
Ten sam rachunek dla wszystkich dni daje nowy plan wypieku: 66, 62, 62, 69, 86, 114 i 42 bochenki (od poniedziałku do niedzieli) zamiast 60, 56, 58, 62, 78, 100 i 38. Przy prawdziwym popycie tygodniowy koszt pomyłek spada z 575.8 zł do 521.2 zł; najlepszy możliwy plan (z prawdziwego rozkładu) to 519.0 zł. To 2839 zł rocznie w jednej piekarni i na jednym produkcie. Plany ze średniej sprzedaży (700.5 zł) i z modelu naiwnego (627.6 zł) są gorsze od obecnego.
Jak może zmylić. Dno krzywej jest płaskie: wypiek o 10 bochenków mniejszy albo większy od optimum kosztuje 117.5 albo 117.8 zł. Ważniejsze od pojedynczych sztuk jest, by nie stać systematycznie po złej stronie.
Zdanie do Wyników:
Rysunek 4: symulacja – plan ze sprzedaży zaniża wypiek
Jedna historia może być przypadkiem. Dlatego losujemy 1000 historii po 52 soboty (wypiek zawsze 100, prawdziwe optimum 113) i w każdej wyznaczamy wypiek trzema sposobami: 65.2. percentyl sprzedaży, model naiwny i model z cenzurowaniem. Drugi eksperyment to spirala w dół: piekarnia co tydzień ustala sobotni wypiek z ostatnich 12 sobót (200 powtórzeń, 40 tygodni). Zasady takich eksperymentów: jak zaplanować badanie symulacyjne.
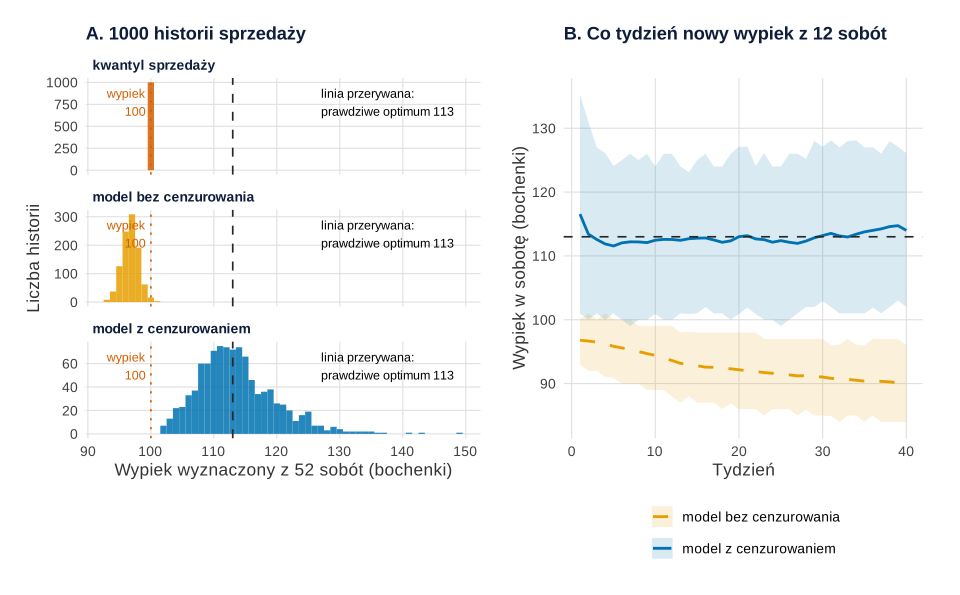
set.seed(649)).Co widać. Percentyl sprzedaży nigdy nie przekracza wypieku, więc zawsze wynosi 100. Model naiwny daje średnio 96.7 bochenka – mniej niż obecny wypiek, i to w 100% historii poniżej optimum. Model z cenzurowaniem daje średnio 113.7 (błąd Monte Carlo 0.2; SD = 6.3). Średni nadmiarowy koszt względem optimum: 15.00 zł, 23.70 zł i 2.92 zł na sobotę. W panelu B model naiwny co tydzień obcina wypiek: z 96.8 bochenka w 1. tygodniu do 90.0 w 40. Mniej chleba – mniej sprzedaży – jeszcze mniej chleba. Model z cenzurowaniem trzyma się okolic optimum (113.0 w 20. tygodniu, 114.0 w 40.).
Jak może zmylić. Przy 12 sobotach model z cenzurowaniem ma szerokie pasmo między 10. a 90. percentylem. Gdy prawie wszystkie dni są wyprzedane, wynik zależy głównie od założonego rozkładu – zbieraj lepsze dane albo czasem celowo upiecz więcej. Huh i in. (2011) proponują reguły zamawiania oparte na estymatorze Kaplana–Meiera, które nie wymagają zakładania rozkładu popytu.
Zdanie do Wyników:
Rysunek 5: mąka – niepewność to błąd prognozy, nie wahania sprzedaży
Część 2 to towar trwały: mąka w magazynie centralnym. Sieć zamawia co tydzień, dostawa przychodzi po dwóch tygodniach, więc każde zamówienie musi wystarczyć na okres ochrony 3 tygodni (1 tydzień do następnego zamówienia + 2 tygodnie dostawy). Stan magazynu po zamówieniu = prognoza zużycia na 3 tygodnie + zapas bezpieczeństwa.
Zużycie prognozujemy regresją z kalendarzem (fala roczna, tydzień przed Wielkanocą i świętami) i błędami AR(1). To szereg czasowy z sezonowością i autokorelacją: współczynnik AR(1) wyniósł 0.619, święta dodają 1.605 t, a Wielkanoc 0.873 t. Ocenę samej prognozy (MAE, RMSE) opisuje hasło miary błędu prognozy; tu potrzebny jest cały rozkład błędów.
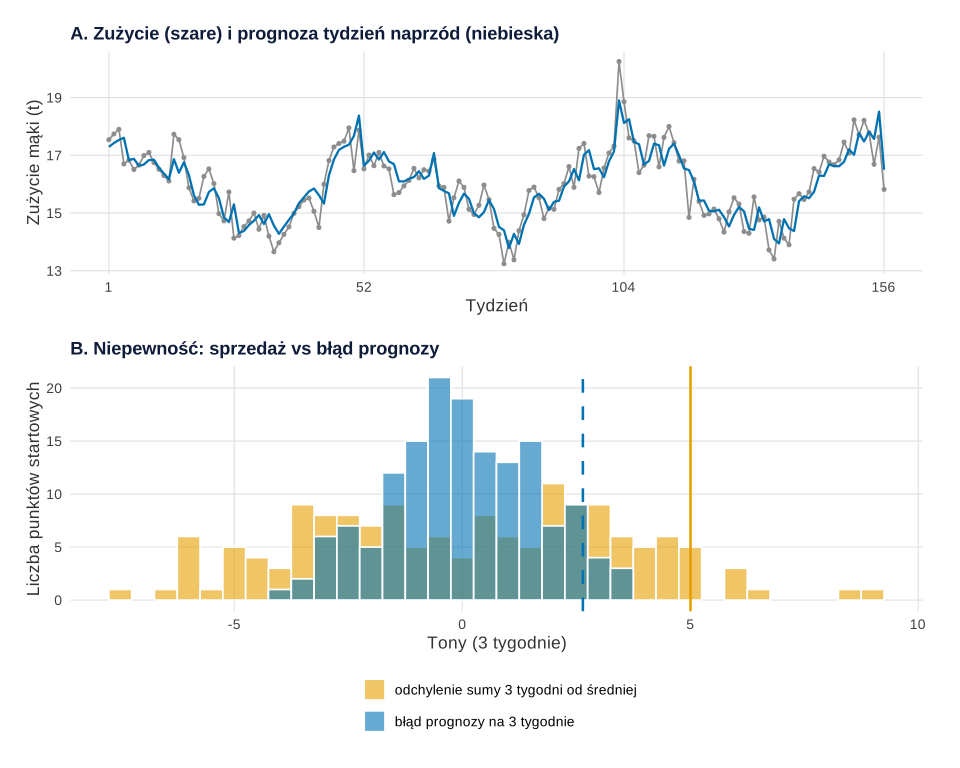
set.seed(649)).Co widać. Suma zużycia z 3 tygodni waha się wokół średniej z SD = 3.43 t, ale dużą część tych wahań – zimowy szczyt, letni dołek, święta – prognoza przewiduje. Błąd prognozy na 3 tygodnie ma SD = 1.645 t. Jego 95. percentyl to 2.65 t, a 95. percentyl odchyleń sprzedaży – 5.01 t. Zapas z wahań sprzedaży chroniłby przed sezonowością, którą znasz.
Jak może zmylić. Błędy liczymy na tej samej historii, na której dopasowano model, więc są nieco zbyt optymistyczne. Lepiej sprawdzić je na okresie, którego model nie widział.
Podpis do pracy:
Rysunek 6: zapas bezpieczeństwa, poziom obsługi α i β
Klasyczny wzór: zapas = z × odchylenie standardowe niepewności w okresie ochrony, gdzie z = 1.645 dla celu 95% (kwantyl rozkładu normalnego). Porównujemy trzy wersje „odchylenia”: (1) SD tygodniowej sprzedaży × √3, (2) SD błędu prognozy na 1 tydzień × √3, (3) SD błędu prognozy na całe 3 tygodnie. Każdą oceniamy na 5200 przyszłych tygodniach z tego samego mechanizmu.
Dwie miary poziomu obsługi: α (cykliczny poziom obsługi) – odsetek cykli zamówienia bez braku; β (wskaźnik realizacji, ang. fill rate) – odsetek popytu obsłużonego z zapasu. Braki liczymy w przybliżeniu jako nadwyżkę błędu prognozy nad zapasem.
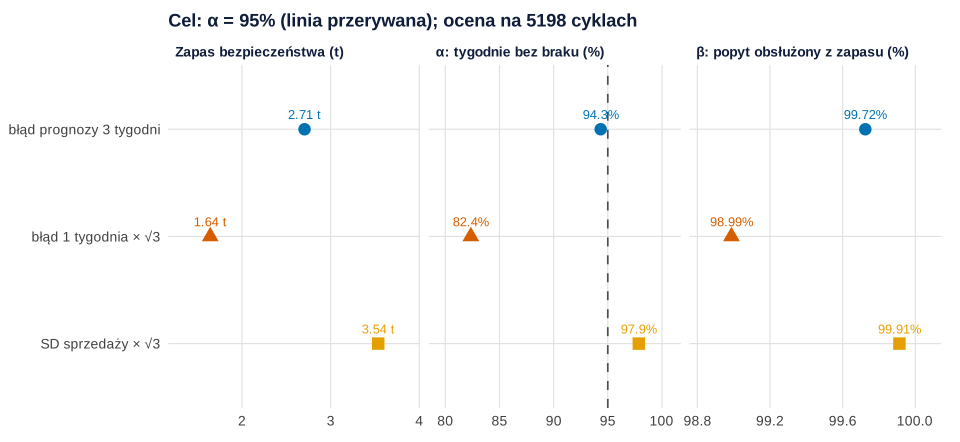
set.seed(649)).Co widać. Zapas ze zmienności sprzedaży (3.54 t) jest za duży: α = 97.9% zamiast 95%. Zapas z błędu jednego tygodnia razy √3 (1.64 t) jest za mały: α = 82.4% (błąd Monte Carlo 0.5 pp). Mnożenie przez √3 zakłada, że błędy kolejnych tygodni są niezależne – a nie są. Prak i in. (2017) pokazali, że błędy prognozy w kolejnych okresach czasu dostawy są dodatnio skorelowane nawet wtedy, gdy sam popyt nie ma autokorelacji. Zapas z błędu prognozy na całe 3 tygodnie (2.71 t) daje α = 94.3% (błąd MC 0.3 pp), blisko celu; empiryczny 95. percentyl błędów, bez założenia normalności, dałby 2.65 t.
Jak może zmylić: α i β to nie to samo. Nawet najsłabszy zapas obsłużył 98.99% popytu, bo braki są rzadkie i małe wobec 16.05 t tygodniowego zużycia. Cel „95%” bez nazwy miary jest niejednoznaczny: β = 95% pozwala na dużo częstsze braki niż α = 95%. Wybierz miarę według skutków braku. Dla mąki brak wstrzymuje produkcję, więc liczy się α.
Zdanie do Wyników:
Co z tym zrobić w firmie
- Zapisuj godzinę wyprzedania. Dzień wyprzedany o 9:00 mówi o popycie więcej niż wyprzedany o 18:55. Minimum to znacznik dnia wyprzedanego.
- Uzgodnij koszty z księgowością. Sprzedaż wczorajszego chleba po 3 zł podnosi kwantyl krytyczny z 0.652 do 0.833 – i plan wypieku.
- Plan wypieku osobno dla dni tygodnia, a dla świąt i promocji – z prognozy, nie z rozkładu „zwykłego” dnia.
- Nie poprawiaj planu „na oko” w stronę średniej. Schweitzer i Cachon (2000) pokazali w eksperymentach, że ludzie zamawiają za mało produktów z wysoką marżą i za dużo z niską, a szkolenie tego nie usuwało. Wdrażaj plan regułą, a wyjątki zapisuj.
- Zapas bezpieczeństwa licz z błędów prognozy na cały okres ochrony i sprawdzaj go co kwartał. Które indeksy w magazynie potrzebują takiej uwagi, pomaga wybrać analiza ABC/XYZ. Niepewność decyzji inwestycyjnych w podobny sposób modeluje symulacja Monte Carlo NPV.
Jak opisać w pracy
W Metodzie podaj: koszty niedoboru i nadmiaru (skąd je wzięto), kwantyl krytyczny, rozkład popytu i sposób uwzględnienia dni wyprzedanych, a w części o zapasach – czas dostawy, okres ochrony, model prognozy, sposób liczenia błędów i docelowy poziom obsługi z nazwą miary (α czy β). W Wynikach: plan zamówień, oczekiwany koszt przed i po zmianie oraz poziom obsługi z symulacji lub z okresu testowego. Inne projekty: statystyka w pracy z logistyki i statystyka w pracy z zarządzania i ekonomii.
Kod R: model gazeciarza, cenzurowanie i zapas bezpieczeństwa
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę i motyw, przepisy 2–4 dotyczą chleba, 5–6 mąki. Wystarczą pakiety ggplot2 i patchwork; wiarygodność z cenzurowaniem maksymalizuje optim(), a model prognozy dopasowuje arima() z bazowego R. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 2, 4, 5 i 6; każdy zaczyna się od własnego set.seed(649). Ziarno 649 ustalono raz i nie zmieniano go. Ręcznie ustalono: cenę (12 zł), koszt wypieku (4.50 zł), odzysk (0.50 zł; wariant 3 zł), średni popyt w dni tygodnia (62, 58, 60, 64, 82, 105 i 38 bochenków), parametr kształtu rozkładu ujemnego dwumianowego (20), dotychczasowy wypiek (60, 56, 58, 62, 78, 100 i 38), liczbę historii (1000 po 52 soboty), spiralę (200 powtórzeń, 40 tygodni, okno 12 sobót), mechanizm zużycia mąki (poziom 16 t, fala roczna 1.2 i 0.5 t, Wielkanoc +1.0 t, święta +1.5 t, AR(1) z φ = 0.6 i SD szoków 0.6 t), okres ochrony (3 tygodnie), cel α = 95% i długość oceny (5200 tygodni).
1. Paleta, koszty i kwantyl krytyczny: Rysunek 1
R
# Rysunek 1. Fikcyjna sieć piekarni: ile kosztuje bochenek za mało, a ile za dużo (schemat z prostokątów i tekstu)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Ekonomia jednego bochenka chleba na zakwasie (ceny ustalone ręcznie, w zł)
cena <- 12.00         # cena sprzedaży
koszt <- 4.50         # koszt wypieku (surowce, energia, praca)
odzysk <- 0.50        # bochenek niesprzedany: oddany na paszę za 0.50 zł
c_malo <- cena - koszt      # koszt niedoboru: utracona marża na kliencie, którego nie obsłużono
c_duzo <- koszt - odzysk    # koszt nadmiaru: wypiek, który trzeba oddać za grosze
kwantyl_krytyczny <- c_malo / (c_malo + c_duzo)
c(koszt_za_malo = c_malo, koszt_za_duzo = c_duzo, kwantyl_krytyczny = round(kwantyl_krytyczny, 3))
# Wariant: niesprzedane pieczywo sprzedajemy następnego dnia jako „wczorajsze” po 3 zł
round((cena - koszt) / ((cena - koszt) + (koszt - 3)), 3)

karty <- data.frame(x0 = c(0, 6.2), x1 = c(5.4, 11.6), y0 = 3.1, y1 = 5.4,
                    typ = c("za mało", "za dużo"),
                    tytul = c("Za mało bochenków (brak na półce)", "Za dużo bochenków (zostają po zamknięciu)"),
                    opis = c(sprintf("klient odchodzi bez chleba\ntracisz marżę: %.2f − %.2f = %.2f zł\nna każdym brakującym bochenku",
                                     cena, koszt, c_malo),
                             sprintf("bochenek idzie na paszę za %.2f zł\ntracisz: %.2f − %.2f = %.2f zł\nna każdym nadmiarowym bochenku",
                                     odzysk, koszt, odzysk, c_duzo)))
# Pasek: w jakiej części dni popyt zmieści się w wypieku przy wypieku optymalnym
x_podzial <- 0.3 + 11 * kwantyl_krytyczny
pasek <- data.frame(x0 = c(0.3, x_podzial), x1 = c(x_podzial, 11.3), typ = c("za dużo", "za mało"),
                    etykieta = c(sprintf("%.1f%% dni: popyt ≤ wypiek – braku nie ma (ryzyko nadmiaru: %.2f zł)",
                                         100 * kwantyl_krytyczny, c_duzo),
                                 sprintf("%.1f%% dni: brak\n(ryzyko braku: %.2f zł)", 100 * (1 - kwantyl_krytyczny), c_malo)))
p1 <- ggplot() +
  geom_rect(data = karty, aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1, fill = typ), colour = "white", alpha = 0.25) +
  geom_rect(data = karty, aes(xmin = x0, xmax = x1, ymin = y1 - 0.65, ymax = y1, fill = typ), colour = NA) +
  geom_text(data = karty, aes(x = x0 + 0.2, y = y1 - 0.33, label = tytul), hjust = 0, fontface = "bold",
            size = 3.9, colour = "white") +
  geom_text(data = karty, aes(x = x0 + 0.2, y = y1 - 0.85, label = opis), hjust = 0, vjust = 1, size = 3.7,
            lineheight = 1.05, colour = "grey10") +
  geom_rect(data = pasek, aes(xmin = x0, xmax = x1, ymin = 1.75, ymax = 2.55, fill = typ), colour = "white") +
  geom_text(data = pasek, aes(x = (x0 + x1) / 2, y = 2.15, label = etykieta), size = 3.3, colour = "white",
            fontface = "bold", lineheight = 0.9) +
  annotate("text", x = 0.3, y = 2.85, hjust = 0, size = 3.5, colour = "grey20",
           label = "wypiek na kwantylu krytycznym dzieli dni tak:") +
  annotate("text", x = 5.8, y = 1.1, size = 4.1, fontface = "bold", colour = "#0f1d3a",
           label = sprintf("kwantyl krytyczny = %.2f / (%.2f + %.2f) = %.3f", c_malo, c_malo, c_duzo, kwantyl_krytyczny)) +
  annotate("text", x = 5.8, y = 0.45, size = 3.6, colour = "grey20",
           label = sprintf("ostatni dopieczony bochenek: %.3f × %.2f zł ≈ %.3f × %.2f zł – dalej nadmiar kosztuje więcej niż brak",
                           kwantyl_krytyczny, c_duzo, 1 - kwantyl_krytyczny, c_malo)) +
  scale_fill_manual(values = c("za mało" = kol[["cynober"]], "za dużo" = kol[["niebieski"]]), guide = "none") +
  coord_cartesian(xlim = c(0, 11.6), ylim = c(0.2, 5.5)) +
  labs(title = "Ile kosztuje pomyłka o jeden bochenek?") + motyw +
  theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank(),
        panel.grid.major = element_blank())
p1   # zapis: ggsave("zapasy-schemat-koszt-za-malo-za-duzo.svg", p1, width = 10, height = 5)
Wynik w R
    koszt_za_malo     koszt_za_duzo kwantyl_krytyczny
            7.500             4.000             0.652
[1] 0.833
2. Dane piekarni i model z cenzurowaniem: Rysunek 2
R
# Rysunek 2. Sprzedaż to nie popyt: 52 tygodnie sprzedaży bochenka w jednej piekarni (dane symulowane)
set.seed(649)                                   # ziarno ustalone raz, bez dobierania pod wynik
dni_tyg <- c("pon", "wt", "śr", "czw", "pt", "sob", "nd")
mu_prawda <- c(62, 58, 60, 64, 82, 105, 38)     # prawdziwy średni popyt (ustalony ręcznie)
k_prawda <- 20                                  # parametr kształtu rozkładu ujemnego dwumianowego
wypiek_stary <- c(60, 56, 58, 62, 78, 100, 38)  # dotychczasowy stały wypiek „mniej więcej na średnią sprzedaż”
pk <- data.frame(tydzien = rep(1:52, each = 7), dzien = factor(rep(dni_tyg, 52), levels = dni_tyg))
pk$d <- as.integer(pk$dzien)
pk$popyt <- rnbinom(nrow(pk), size = k_prawda, mu = mu_prawda[pk$d])  # w prawdziwej firmie tego nie widać
pk$wypiek <- wypiek_stary[pk$d]
pk$sprzedaz <- pmin(pk$popyt, pk$wypiek)        # sprzedasz najwyżej tyle, ile upieczesz
pk$wyprzedane <- as.integer(pk$sprzedaz == pk$wypiek)
pk$niesprzedane <- pk$wypiek - pk$sprzedaz
write.csv(pk[, c("tydzien", "dzien", "wypiek", "sprzedaz", "wyprzedane", "niesprzedane", "popyt")],
          "zapasy-piekarnia-sprzedaz-dzienna.csv", row.names = FALSE)

# Ujemny dwumianowy dla popytu z dniem tygodnia: zwykła wiarygodność (sprzedaż = popyt)
# i wiarygodność z cenzurowaniem (dzień wyprzedany: wiemy tylko, że popyt ≥ wypiek)
nll <- function(par, s, d, cenz) {
  mu <- exp(par[1:7])[d]; k <- exp(par[8])
  -sum(ifelse(cenz == 1, pnbinom(s - 1, size = k, mu = mu, lower.tail = FALSE, log.p = TRUE),
              dnbinom(s, size = k, mu = mu, log = TRUE)))
}
start <- c(log(tapply(pk$sprzedaz, pk$d, mean)), log(10))
granice <- list(lower = c(rep(log(5), 7), log(0.5)), upper = c(rep(log(500), 7), log(1000)))  # k najwyżej 1000
fit_naiwny <- optim(start, nll, s = pk$sprzedaz, d = pk$d, cenz = rep(0, nrow(pk)), method = "L-BFGS-B",
                    lower = granice$lower, upper = granice$upper)
fit_cenz <- optim(start, nll, s = pk$sprzedaz, d = pk$d, cenz = pk$wyprzedane, method = "L-BFGS-B",
                  lower = granice$lower, upper = granice$upper, hessian = TRUE)
se_cenz <- sqrt(diag(solve(fit_cenz$hessian)))

opis <- data.frame(dzien = dni_tyg, wypiek = wypiek_stary,
                   dni_wyprzedane_proc = round(100 * tapply(pk$wyprzedane, pk$d, mean), 1),
                   srednia_sprzedaz = round(tapply(pk$sprzedaz, pk$d, mean), 1),
                   popyt_naiwny = round(exp(fit_naiwny$par[1:7]), 1),
                   popyt_cenzurowany = round(exp(fit_cenz$par[1:7]), 1),
                   ci95_od = round(exp(fit_cenz$par[1:7] - 1.96 * se_cenz[1:7]), 1),
                   ci95_do = round(exp(fit_cenz$par[1:7] + 1.96 * se_cenz[1:7]), 1),
                   prawdziwy_popyt = mu_prawda)
opis
c(dni = nrow(pk), wyprzedane_proc = round(100 * mean(pk$wyprzedane), 1),
  k_naiwny = round(exp(fit_naiwny$par[8]), 1), k_cenzurowany = round(exp(fit_cenz$par[8]), 1),
  niesprzedane_szt_tydz = round(sum(pk$niesprzedane) / 52, 1))
# Rozrzut w sobotę: sprzedaż jest „spokojniejsza” niż popyt, bo górę ucina wypiek
round(c(sd_sprzedazy_sob = sd(pk$sprzedaz[pk$d == 6]), sd_popytu_sob = sd(pk$popyt[pk$d == 6])), 1)

sr <- rbind(data.frame(dzien = factor(dni_tyg, levels = dni_tyg), wartosc = opis$srednia_sprzedaz,
                       co = "średnia sprzedaż"),
            data.frame(dzien = factor(dni_tyg, levels = dni_tyg), wartosc = opis$popyt_cenzurowany,
                       co = "popyt z modelu z cenzurowaniem"))
pk$stan <- ifelse(pk$wyprzedane == 1, "dzień wyprzedany (popyt ≥ wypiek)", "zostało pieczywo (popyt = sprzedaż)")
p2 <- ggplot(pk, aes(dzien, sprzedaz)) +
  geom_jitter(aes(shape = stan, colour = stan), width = 0.22, height = 0, size = 1.5, alpha = 0.75) +
  geom_point(data = sr, aes(y = wartosc, fill = co), shape = 23, size = 3.6, colour = "black",
             position = position_nudge(x = c(rep(-0.33, 7), rep(0.33, 7)))) +
  geom_errorbar(data = opis, aes(x = factor(dzien, levels = dni_tyg), ymin = ci95_od, ymax = ci95_do),
                inherit.aes = FALSE, width = 0.12, position = position_nudge(x = 0.33), colour = "grey15") +
  scale_shape_manual(values = c(4, 16), name = NULL) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["szary"]]), name = NULL) +
  scale_fill_manual(values = c("średnia sprzedaż" = "white", "popyt z modelu z cenzurowaniem" = kol[["niebieski"]]),
                    name = NULL) +
  guides(shape = guide_legend(nrow = 2), colour = guide_legend(nrow = 2), fill = guide_legend(nrow = 2)) +
  labs(x = NULL, y = "Bochenki dziennie", title = "Sprzedaż bochenka według dnia tygodnia (52 tygodnie)") + motyw
p2   # zapis: ggsave("zapasy-sprzedaz-a-popyt-cenzurowanie.svg", p2, width = 10, height = 5.8)
Wynik w R
  dzien wypiek dni_wyprzedane_proc srednia_sprzedaz popyt_naiwny
1   pon     60                48.1             54.4         54.4
2    wt     56                51.9             50.5         50.5
3    śr     58                48.1             51.4         51.4
4   czw     62                51.9             56.3         56.3
5    pt     78                50.0             71.2         71.3
6   sob    100                55.8             92.7         92.7
7    nd     38                51.9             33.8         33.7
  popyt_cenzurowany ci95_od ci95_do prawdziwy_popyt
1              60.6    55.9    65.7              62
2              56.8    52.3    61.7              58
3              57.0    52.6    61.8              60
4              63.4    58.4    68.8              64
5              79.6    73.5    86.1              82
6             105.3    97.2   114.2             105
7              38.2    35.0    41.6              38
                  dni       wyprzedane_proc              k_naiwny
                364.0                  51.1                 242.5
        k_cenzurowany niesprzedane_szt_tydz
                 20.8                  41.6
sd_sprzedazy_sob    sd_popytu_sob
            11.9             25.7
3. Oczekiwany koszt i plan wypieku: Rysunek 3
R
# Rysunek 3. Oczekiwany koszt pomyłki w funkcji wypieku (sobota) i wypiek optymalny dla każdego dnia
# Oczekiwany koszt: c_malo × E[brakujące bochenki] + c_duzo × E[niesprzedane bochenki], popyt ~ ujemny dwumianowy
koszt_oczek <- function(q, mu, k, x = 0:600) {
  p <- dnbinom(x, size = k, mu = mu)
  sapply(q, function(qq) sum(p * (c_malo * pmax(x - qq, 0) + c_duzo * pmax(qq - x, 0))))
}
wypiek_opt <- function(mu, k) qnbinom(kwantyl_krytyczny, size = k, mu = mu)   # najmniejsze q z F(q) ≥ 0.652
mu_cenz <- exp(fit_cenz$par[1:7]); k_cenz <- exp(fit_cenz$par[8])
mu_naiw <- exp(fit_naiwny$par[1:7]); k_naiw <- exp(fit_naiwny$par[8])

plan <- data.frame(dzien = dni_tyg, wypiek_stary = wypiek_stary,
                   q_srednia_sprzedazy = round(opis$srednia_sprzedaz),
                   q_model_naiwny = wypiek_opt(mu_naiw, k_naiw),
                   q_model_cenzurowany = wypiek_opt(mu_cenz, k_cenz),
                   q_prawdziwy = wypiek_opt(mu_prawda, k_prawda))
plan
# Tygodniowy koszt pomyłek każdego planu, liczony przy prawdziwym popycie (znanym tylko w symulacji)
tydz <- sapply(plan[, -1], function(q) sum(sapply(1:7, function(i) koszt_oczek(q[i], mu_prawda[i], k_prawda))))
round(tydz, 1)
round(52 * (tydz["wypiek_stary"] - tydz["q_model_cenzurowany"]), 0)   # oszczędność w roku, jedna piekarnia

# Sobota: krzywa kosztu według modelu z cenzurowaniem
q <- 60:160
sob <- data.frame(q = q, koszt = koszt_oczek(q, mu_cenz[6], k_cenz))
znaczniki <- data.frame(q = c(plan$wypiek_stary[6], round(mu_cenz[6]), plan$q_model_cenzurowany[6]),
                        co = c("dotychczasowy wypiek", "średni popyt", "kwantyl krytyczny"))
znaczniki$koszt <- koszt_oczek(znaczniki$q, mu_cenz[6], k_cenz)
znaczniki[, 1:3]
round(koszt_oczek(plan$q_model_cenzurowany[6] + c(-10, 10), mu_cenz[6], k_cenz), 2)  # ±10 bochenków od optimum

p3 <- ggplot(sob, aes(q, koszt)) +
  geom_line(colour = kol[["niebieski"]], linewidth = 1) +
  geom_point(data = znaczniki, aes(shape = co, colour = co), size = 3.6, stroke = 1.2) +
  geom_text(data = znaczniki, aes(label = sprintf("%d szt.\n%.1f zł", q, koszt), colour = co),
            hjust = c(1.25, 0.5, 0.5), vjust = c(0.5, 1.6, -0.5), size = 3.4, lineheight = 0.9, show.legend = FALSE) +
  annotate("text", x = 75, y = 150, label = "za mało:\nkażdy brakujący\nbochenek to 7.50 zł",
           colour = kol[["cynober"]], size = 3.4, hjust = 0.5) +
  annotate("text", x = 150, y = 150, label = "za dużo:\nkażdy niesprzedany\nbochenek to 4.00 zł",
           colour = kol[["niebieski"]], size = 3.4, hjust = 0.5) +
  scale_shape_manual(values = c("dotychczasowy wypiek" = 4, "średni popyt" = 1, "kwantyl krytyczny" = 16), name = NULL) +
  scale_colour_manual(values = c("dotychczasowy wypiek" = kol[["cynober"]], "średni popyt" = kol[["ciemny"]],
                                 "kwantyl krytyczny" = kol[["zielony"]]), name = NULL) +
  coord_cartesian(ylim = c(0, 200)) +
  labs(x = "Wypiek w sobotę (bochenki)", y = "Oczekiwany koszt pomyłek (zł na sobotę)",
       title = "Sobota: koszt za mało i za dużo w funkcji wypieku") + motyw
p3   # zapis: ggsave("zapasy-koszt-w-funkcji-wypieku.svg", p3, width = 10, height = 5.4)
Wynik w R
  dzien wypiek_stary q_srednia_sprzedazy q_model_naiwny q_model_cenzurowany
1   pon           60                  54             57                  66
2    wt           56                  50             53                  62
3    śr           58                  51             54                  62
4   czw           62                  56             59                  69
5    pt           78                  71             75                  86
6   sob          100                  93             97                 114
7    nd           38                  34             36                  42
  q_prawdziwy
1          67
2          63
3          65
4          69
5          89
6         113
7          41
       wypiek_stary q_srednia_sprzedazy      q_model_naiwny q_model_cenzurowany
              575.8               700.5               627.6               521.2
        q_prawdziwy
              519.0
wypiek_stary
        2839
    q                   co    koszt
1 100 dotychczasowy wypiek 125.5866
2 105         średni popyt 115.9175
3 114    kwantyl krytyczny 109.7391
[1] 117.48 117.79
4. Symulacja: 1000 historii i spirala w dół: Rysunek 4
R
# Rysunek 4. Symulacja: co się dzieje, gdy wypiek planujesz ze sprzedaży zamiast z popytu (sobota)
set.seed(649)
nll1 <- function(par, s, cenz) {                 # wiarygodność ujemnego dwumianowego dla jednego dnia tygodnia
  mu <- exp(par[1]); k <- exp(par[2])
  -sum(ifelse(cenz == 1, pnbinom(s - 1, size = k, mu = mu, lower.tail = FALSE, log.p = TRUE),
              dnbinom(s, size = k, mu = mu, log = TRUE)))
}
dopasuj <- function(s, cenz) {                    # zwraca wypiek z kwantylu krytycznego
  f <- optim(c(log(mean(s)), log(10)), nll1, s = s, cenz = cenz, method = "L-BFGS-B",
             lower = c(log(5), log(0.5)), upper = c(log(500), log(1000)))
  qnbinom(kwantyl_krytyczny, size = exp(f$par[2]), mu = exp(f$par[1]))
}
q_opt <- wypiek_opt(mu_prawda[6], k_prawda)       # prawdziwy optymalny wypiek w sobotę

# A. 1000 historii po 52 soboty, wypiek zawsze 100 bochenków
R <- 1000
wyn <- t(replicate(R, {
  popyt <- rnbinom(52, size = k_prawda, mu = mu_prawda[6])
  s <- pmin(popyt, 100); cenz <- as.integer(s == 100)
  c(kwantyl_sprzedazy = unname(quantile(s, kwantyl_krytyczny, type = 1)),
    model_naiwny = dopasuj(s, rep(0, 52)), model_cenzurowany = dopasuj(s, cenz))
}))
koszt_prawda <- function(q) koszt_oczek(q, mu_prawda[6], k_prawda)
podsum <- data.frame(metoda = colnames(wyn), srednia = round(colMeans(wyn), 1),
                     sd = round(apply(wyn, 2, sd), 1),
                     ponizej_optimum_proc = round(100 * colMeans(wyn < q_opt), 1),
                     nadwyzka_kosztu_zl = round(colMeans(apply(wyn, 2, koszt_prawda)) - koszt_prawda(q_opt), 2))
q_opt; podsum
# błąd Monte Carlo średniego wypieku z modelu z cenzurowaniem
round(sd(wyn[, "model_cenzurowany"]) / sqrt(R), 2)

# B. Spirala w dół: co tydzień nowy wypiek z ostatnich 12 sobót (200 powtórzeń, 40 tygodni)
R2 <- 200; T2 <- 40
sciezki <- lapply(c("model_naiwny", "model_cenzurowany"), function(m) {
  t(replicate(R2, {
    q <- rep(100, 12); s <- pmin(rnbinom(12, size = k_prawda, mu = mu_prawda[6]), 100)
    for (t in 1:T2) {
      ost <- tail(seq_along(s), 12)
      cenz <- if (m == "model_cenzurowany") as.integer(s[ost] == q[ost]) else rep(0, 12)
      q_nowy <- dopasuj(s[ost], cenz)
      q <- c(q, q_nowy); s <- c(s, min(rnbinom(1, size = k_prawda, mu = mu_prawda[6]), q_nowy))
    }
    tail(q, T2)
  }))
})
names(sciezki) <- c("model_naiwny", "model_cenzurowany")
round(sapply(sciezki, function(x) colMeans(x)[c(1, 10, 20, 40)]), 1)

wyn_dl <- data.frame(metoda = rep(colnames(wyn), each = R), q = as.vector(wyn))
wyn_dl$metoda <- factor(wyn_dl$metoda, levels = colnames(wyn),
                        labels = c("kwantyl sprzedaży", "model bez cenzurowania", "model z cenzurowaniem"))
p4a <- ggplot(wyn_dl, aes(q, fill = metoda)) +
  geom_histogram(binwidth = 1, colour = NA, alpha = 0.85, position = "identity") +
  geom_vline(xintercept = q_opt, linetype = "dashed", colour = "grey15") +
  geom_vline(xintercept = 100, linetype = "dotted", colour = kol[["cynober"]]) +
  annotate("text", x = 127, y = Inf, vjust = 1.4, hjust = 0, size = 3.3,
           label = paste0("linia przerywana:\nprawdziwe optimum ", q_opt)) +
  annotate("text", x = 99.2, y = Inf, vjust = 1.4, hjust = 1, size = 3.3, colour = kol[["cynober"]],
           label = "wypiek\n100") +
  facet_wrap(~ metoda, ncol = 1, scales = "free_y") +
  scale_fill_manual(values = c(kol[["cynober"]], kol[["pomarancz"]], kol[["niebieski"]]), guide = "none") +
  labs(x = "Wypiek wyznaczony z 52 sobót (bochenki)", y = "Liczba historii",
       title = "A. 1000 historii sprzedaży") + motyw
sc <- data.frame(tydzien = rep(1:T2, 2), metoda = rep(c("model bez cenzurowania", "model z cenzurowaniem"), each = T2),
                 srednia = c(colMeans(sciezki$model_naiwny), colMeans(sciezki$model_cenzurowany)),
                 dol = c(apply(sciezki$model_naiwny, 2, quantile, 0.1), apply(sciezki$model_cenzurowany, 2, quantile, 0.1)),
                 gora = c(apply(sciezki$model_naiwny, 2, quantile, 0.9), apply(sciezki$model_cenzurowany, 2, quantile, 0.9)))
p4b <- ggplot(sc, aes(tydzien, srednia, colour = metoda, fill = metoda, linetype = metoda)) +
  geom_ribbon(aes(ymin = dol, ymax = gora), alpha = 0.15, colour = NA) +
  geom_line(linewidth = 1) +
  geom_hline(yintercept = q_opt, linetype = "dashed", colour = "grey15") +
  scale_colour_manual(values = c(kol[["pomarancz"]], kol[["niebieski"]]), name = NULL) +
  scale_fill_manual(values = c(kol[["pomarancz"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(x = "Tydzień", y = "Wypiek w sobotę (bochenki)", title = "B. Co tydzień nowy wypiek z 12 sobót") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1.1, 1))
p4   # zapis: ggsave("zapasy-symulacja-cenzurowany-popyt.svg", p4, width = 10, height = 6.2)
Wynik w R
[1] 113
                             metoda srednia  sd ponizej_optimum_proc
kwantyl_sprzedazy kwantyl_sprzedazy   100.0 0.0                100.0
model_naiwny           model_naiwny    96.7 1.3                100.0
model_cenzurowany model_cenzurowany   113.7 6.3                 47.5
                  nadwyzka_kosztu_zl
kwantyl_sprzedazy              15.00
model_naiwny                   23.70
model_cenzurowany               2.92
[1] 0.2
     model_naiwny model_cenzurowany
[1,]         96.8             116.5
[2,]         94.4             112.5
[3,]         92.2             113.0
[4,]         90.0             114.0
5. Mąka: model prognozy i błędy na 3 tygodnie: Rysunek 5
R
# Rysunek 5. Mąka w magazynie centralnym: tygodniowe zużycie (3 lata), prognoza i błędy prognozy na 3 tygodnie
set.seed(649)
H <- 3                                           # okres ochrony: zamówienie co tydzień + dostawa po 2 tygodniach
tyg <- 1:156                                     # 3 lata po 52 tygodnie
kalendarz <- function(t) {                       # regresory znane z góry: fala roczna, tydzień przed Wielkanocą i świętami
  w <- (t - 1) %% 52 + 1
  cbind(cos = cos(2 * pi * w / 52), sin = sin(2 * pi * w / 52), wielkanoc = as.integer(w == 14),
        swieta = as.integer(w == 51))
}
X <- kalendarz(tyg)
beta_prawda <- c(16, 1.2, 0.5, 1.0, 1.5)         # ton tygodniowo: poziom, fala roczna, Wielkanoc, święta (ręcznie)
fi_prawda <- 0.6; sd_szoku <- 0.6                # autokorelacja i rozrzut szoków (ręcznie)
symuluj_zuzycie <- function(X, e0 = 0) {
  e <- numeric(nrow(X)); e_pop <- e0
  for (t in seq_len(nrow(X))) { e[t] <- fi_prawda * e_pop + rnorm(1, 0, sd_szoku); e_pop <- e[t] }
  as.vector(cbind(1, X) %*% beta_prawda) + e
}
zuzycie <- round(symuluj_zuzycie(X), 2)
write.csv(data.frame(tydzien = tyg, rok = rep(1:3, each = 52), tydzien_roku = (tyg - 1) %% 52 + 1, X,
                     zuzycie_t = zuzycie), "zapasy-maka-zuzycie-tygodniowe.csv", row.names = FALSE)

# Model prognozy: regresja z kalendarzem i błędami AR(1)
mod <- arima(zuzycie, order = c(1, 0, 0), xreg = X, method = "ML")
b <- coef(mod); fi <- b[["ar1"]]
prognoza_3 <- function(y, X, t0) {               # suma prognoz na tygodnie t0+1 … t0+3 z punktu t0
  baza <- function(t) b[["intercept"]] + as.vector(X[t, , drop = FALSE] %*% b[colnames(X)])
  e0 <- y[t0] - baza(t0)
  sum(sapply(1:H, function(h) baza(t0 + h) + fi^h * e0))
}
round(c(b, sigma = sqrt(mod$sigma2)), 3)

# Błędy prognozy 3-tygodniowej z kolejnych punktów startowych historii vs odchylenia samej sprzedaży
t0 <- 1:(156 - H)
suma3 <- sapply(t0, function(t) sum(zuzycie[t + 1:H]))
blad3 <- suma3 - sapply(t0, function(t) prognoza_3(zuzycie, X, t))
odch3 <- suma3 - mean(suma3)
round(c(sd_tygodnia = sd(zuzycie), sd_sumy3_sprzedazy = sd(odch3), sd_bledu1 = sqrt(mod$sigma2),
        sd_bledu3 = sd(blad3), srednia_bledu3 = mean(blad3), autokorelacja_bledow3_lag1 = acf(blad3, plot = FALSE)$acf[2]), 3)

dane_m <- data.frame(tydzien = tyg, zuzycie = zuzycie, dopasowanie = zuzycie - residuals(mod))
p5a <- ggplot(dane_m, aes(tydzien, zuzycie)) +
  geom_line(colour = kol[["szary"]]) + geom_point(colour = kol[["szary"]], size = 1) +
  geom_line(aes(y = dopasowanie), colour = kol[["niebieski"]], linewidth = 0.8) +
  scale_x_continuous(breaks = c(1, 52, 104, 156)) +
  labs(x = "Tydzień", y = "Zużycie mąki (t)", title = "A. Zużycie (szare) i prognoza tydzień naprzód (niebieska)") + motyw
rozk <- rbind(data.frame(co = "odchylenie sumy 3 tygodni od średniej", x = odch3),
              data.frame(co = "błąd prognozy na 3 tygodnie", x = blad3))
kw <- data.frame(co = c("odchylenie sumy 3 tygodni od średniej", "błąd prognozy na 3 tygodnie"),
                 q95 = c(quantile(odch3, 0.95), quantile(blad3, 0.95)))
round(setNames(kw$q95, c("q95_odchylenia", "q95_bledu")), 2)
rozk$co <- factor(rozk$co, levels = kw$co); kw$co <- factor(kw$co, levels = kw$co)
p5b <- ggplot(rozk, aes(x, fill = co)) +
  geom_histogram(binwidth = 0.5, alpha = 0.6, position = "identity", colour = "white") +
  geom_vline(data = kw, aes(xintercept = q95, colour = co, linetype = co), linewidth = 0.9, show.legend = FALSE) +
  scale_fill_manual(values = c(kol[["pomarancz"]], kol[["niebieski"]]), name = NULL) +
  scale_colour_manual(values = c(kol[["pomarancz"]], kol[["niebieski"]])) +
  scale_linetype_manual(values = c("solid", "dashed")) +
  guides(fill = guide_legend(nrow = 2)) +
  labs(x = "Tony (3 tygodnie)", y = "Liczba punktów startowych", title = "B. Niepewność: sprzedaż vs błąd prognozy") + motyw
p5 <- p5a / p5b + plot_layout(heights = c(1, 1.1))
p5   # zapis: ggsave("zapasy-maka-bledy-prognozy.svg", p5, width = 10, height = 8)
Wynik w R
      ar1 intercept       cos       sin wielkanoc    swieta     sigma
    0.619    15.937     1.267     0.274     0.873     1.605     0.576
               sd_tygodnia         sd_sumy3_sprzedazy
                     1.242                      3.432
                 sd_bledu1                  sd_bledu3
                     0.576                      1.645
            srednia_bledu3 autokorelacja_bledow3_lag1
                     0.004                      0.625
q95_odchylenia      q95_bledu
          5.01           2.65
6. Zapas bezpieczeństwa i poziomy obsługi α, β: Rysunek 6
R
# Rysunek 6. Trzy sposoby liczenia zapasu bezpieczeństwa i co z nich wychodzi przez 100 lat (symulacja)
alfa_cel <- 0.95; z <- qnorm(alfa_cel)
zapas <- c(z_odchylenia_sprzedazy = z * sd(zuzycie) * sqrt(H),        # częsty błąd: SD sprzedaży × √3
           z_bledu_1_tygodnia = z * sqrt(mod$sigma2) * sqrt(H),         # błąd tygodnia × √3 (zakłada niezależność)
           z_bledow_3_tygodni = z * sd(blad3))                         # SD błędów prognozy na całe 3 tygodnie
round(zapas, 2)
round(quantile(blad3, alfa_cel), 2)              # wersja bez założenia normalności: empiryczny kwantyl 95% błędów

# Ocena: przyszłość z tego samego mechanizmu, 100 lat = 5200 tygodni, model prognozy bez zmian
set.seed(649)
tf <- 156 + 1:5200
Xf <- kalendarz(tf)
e_ost <- zuzycie[156] - as.vector(cbind(1, X[156, , drop = FALSE]) %*% beta_prawda)
yf <- c(zuzycie, symuluj_zuzycie(Xf, e0 = e_ost))
Xall <- rbind(X, Xf)
starty <- 156:(156 + 5200 - H)
blad_f <- sapply(starty, function(t) sum(yf[t + 1:H]) - prognoza_3(yf, Xall, t))
sredni_tydz <- mean(yf[tf])
ocena <- t(sapply(zapas, function(ss) {
  brak <- pmax(blad_f - ss, 0)                   # tony brakujące w cyklu (przybliżenie przy zamówieniach co tydzień)
  a <- mean(brak == 0)
  c(zapas_t = ss, alfa = a, alfa_blad_mc = sqrt(a * (1 - a) / length(brak)),
    beta = 1 - sum(brak) / (sredni_tydz * length(brak)), brak_srednio_t = mean(brak))
}))
round(ocena, 4)
round(sredni_tydz, 2)

oc <- data.frame(metoda = factor(rownames(ocena), levels = rownames(ocena),
                                 labels = c("SD sprzedaży × √3", "błąd 1 tygodnia × √3", "błąd prognozy 3 tygodni")),
                 ocena)
oc_dl <- rbind(data.frame(metoda = oc$metoda, miara = "Zapas bezpieczeństwa (t)", wartosc = oc$zapas_t,
                          etykieta = sprintf("%.2f t", oc$zapas_t)),
               data.frame(metoda = oc$metoda, miara = "α: tygodnie bez braku (%)", wartosc = 100 * oc$alfa,
                          etykieta = sprintf("%.1f%%", 100 * oc$alfa)),
               data.frame(metoda = oc$metoda, miara = "β: popyt obsłużony z zapasu (%)", wartosc = 100 * oc$beta,
                          etykieta = sprintf("%.2f%%", 100 * oc$beta)))
oc_dl$miara <- factor(oc_dl$miara, levels = unique(oc_dl$miara))
cel <- data.frame(miara = factor("α: tygodnie bez braku (%)", levels = levels(oc_dl$miara)), y = 100 * alfa_cel)
p6 <- ggplot(oc_dl, aes(metoda, wartosc, colour = metoda, shape = metoda)) +
  geom_hline(data = cel, aes(yintercept = y), linetype = "dashed", colour = "grey30") +
  geom_point(size = 4) +
  geom_text(aes(label = etykieta), vjust = -1.1, size = 3.4, show.legend = FALSE) +
  facet_wrap(~ miara, ncol = 3, scales = "free_x") +
  coord_flip() +
  scale_y_continuous(expand = expansion(mult = 0.25)) +
  scale_colour_manual(values = c(kol[["pomarancz"]], kol[["cynober"]], kol[["niebieski"]]), guide = "none") +
  scale_shape_manual(values = c(15, 17, 16), guide = "none") +
  labs(x = NULL, y = NULL, title = sprintf("Cel: α = 95%% (linia przerywana); ocena na %d cyklach", length(blad_f))) + motyw
p6   # zapis: ggsave("zapasy-zapas-bezpieczenstwa-alfa-beta.svg", p6, width = 10, height = 4.6)
Wynik w R
z_odchylenia_sprzedazy     z_bledu_1_tygodnia     z_bledow_3_tygodni
                  3.54                   1.64                   2.71
 95%
2.65
                       zapas_t   alfa alfa_blad_mc   beta brak_srednio_t
z_odchylenia_sprzedazy  3.5372 0.9786       0.0020 0.9991         0.0140
z_bledu_1_tygodnia      1.6416 0.8236       0.0053 0.9899         0.1625
z_bledow_3_tygodni      2.7057 0.9434       0.0032 0.9972         0.0442
[1] 16.05
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Kontrola palety: odległość barw przy typowym widzeniu i w symulacji deuteranopii i protanopii
library(colorspace)
pary <- list("cynober – niebieski (za mało / za dużo; z cenzurowaniem)" = c("#D55E00", "#0072B2"),
             "pomarańczowy – niebieski (bez cenzurowania / z cenzurowaniem; sprzedaż / błąd)" = c("#E69F00", "#0072B2"),
             "cynober – pomarańczowy (kwantyl sprzedaży / model bez cenzurowania)" = c("#D55E00", "#E69F00"),
             "cynober – szary (dzień wyprzedany / zostało pieczywo)" = c("#D55E00", "#8C8C8C"),
             "zielony – cynober (optimum / dotychczasowy wypiek)" = c("#009E73", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                               widzenie_typowe
cynober – niebieski (za mało / za dużo; z cenzurowaniem)                                 114.6
pomarańczowy – niebieski (bez cenzurowania / z cenzurowaniem; sprzedaż / błąd)           120.2
cynober – pomarańczowy (kwantyl sprzedaży / model bez cenzurowania)                       33.4
cynober – szary (dzień wyprzedany / zostało pieczywo)                                     76.8
zielony – cynober (optimum / dotychczasowy wypiek)                                       102.4
czerwony – zielony (do unikania)                                                         121.7
                                                                               deuteranopia
cynober – niebieski (za mało / za dużo; z cenzurowaniem)                              108.3
pomarańczowy – niebieski (bez cenzurowania / z cenzurowaniem; sprzedaż / błąd)        121.5
cynober – pomarańczowy (kwantyl sprzedaży / model bez cenzurowania)                    18.4
cynober – szary (dzień wyprzedany / zostało pieczywo)                                  62.6
zielony – cynober (optimum / dotychczasowy wypiek)                                     53.5
czerwony – zielony (do unikania)                                                       21.1
                                                                               protanopia
cynober – niebieski (za mało / za dużo; z cenzurowaniem)                             91.9
pomarańczowy – niebieski (bez cenzurowania / z cenzurowaniem; sprzedaż / błąd)      109.3
cynober – pomarańczowy (kwantyl sprzedaży / model bez cenzurowania)                  24.9
cynober – szary (dzień wyprzedany / zostało pieczywo)                                54.8
zielony – cynober (optimum / dotychczasowy wypiek)                                   37.3
czerwony – zielony (do unikania)                                                     31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, rozkład ujemny dwumianowy, optymalizacja wiarygodności i model ARIMA – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Sprzedaż zamiast popytu. Dni wyprzedane zaniżają średnią i rozrzut; plan ze sprzedaży wpada w spiralę w dół (z 96.8 do 90.0 bochenka w 40 tygodni).
- Zapas z odchylenia sprzedaży. Obejmuje sezonowość, którą prognoza już przewidziała – zapas za duży.
- Błąd jednego tygodnia razy √L. Zakłada niezależne błędy; tu α spadło do 82.4%.
- „Poziom obsługi 95%” bez nazwy miary. α i β przy tym samym zapasie różnią się o kilka do kilkunastu punktów.
- Brak sprawdzenia na nowych danych. Rozkład błędów z danych uczących jest zbyt optymistyczny – stąd α = 94.3% zamiast 95%.
Pomoc przy analizie zapasów do pracy: analizy statystyczne dla studentów.
Najczęstsze pytania
Co to jest model gazeciarza?
To model decyzji o zamówieniu towaru na jeden okres sprzedaży, gdy popyt jest niepewny, a niesprzedany towar traci wartość (gazeta, pieczywo, kwiaty). Optymalne zamówienie to kwantyl rozkładu popytu rzędu cu / (cu + co), gdzie cu to koszt braku jednej sztuki, a co – koszt nadmiaru. W przykładzie piekarni 7.50 / (7.50 + 4.00) = 0.652.
Dlaczego nie zamawiać średniego popytu?
Średnia jest optymalna tylko wtedy, gdy brak i nadmiar kosztują tyle samo (przy symetrycznym rozkładzie). Gdy brak kosztuje więcej, opłaca się zamówić powyżej średniej. W przykładzie sobotni wypiek równy średniemu popytowi (105 bochenków) kosztował średnio 115.9 zł pomyłek, a wypiek 114 bochenków – 109.7 zł.
Jak oszacować popyt, gdy towar się wyprzedaje?
Dzień wyprzedany to obserwacja ocenzurowana: wiadomo tylko, że popyt był co najmniej równy zapasowi. Uwzględnij to w modelu (np. wiarygodność z cenzurowaniem albo estymator Kaplana–Meiera) zamiast traktować sprzedaż jak popyt. W przykładzie średnia sobotnia sprzedaż wynosiła 92.7, a popyt z modelu z cenzurowaniem 105.3 bochenka.
Jak policzyć zapas bezpieczeństwa?
Najprościej: z × odchylenie standardowe błędu prognozy na cały okres ochrony (czas dostawy plus okres między zamówieniami), gdzie z = 1.645 dla 95%. Nie używaj odchylenia samej sprzedaży (zawiera przewidywalną sezonowość) ani błędu jednego tygodnia pomnożonego przez pierwiastek z liczby tygodni, bo błędy kolejnych tygodni są skorelowane.
Czym różni się poziom obsługi α od β?
α (cykliczny poziom obsługi) to odsetek cykli zamówienia bez braku, a β (wskaźnik realizacji, fill rate) – odsetek popytu obsłużonego z zapasu. Przy tym samym zapasie β jest zwykle znacznie wyższe: w przykładzie zapas dający α = 82.4% obsłużył 98.99% popytu. Zawsze podawaj, o którą miarę chodzi.
Powiązane hasła
Przeczytaj też
Prognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →PoradnikAnaliza ABC/XYZ asortymentu
Hurtownia części: krzywa Lorenza, umowne progi ABC, CV popytu i tygodnie bez sprzedaży, macierz ABC × XYZ i stabilność klas – pięć rysunków z kodem R.
Czytaj →PoradnikMonte Carlo NPV – opłacalność projektu
Linia produkcyjna w mleczarni: NPV, rozkłady założeń, 10 000 symulacji, P(NPV < 0), tornado i korelacja ceny z popytem – sześć rysunków z kodem R.
Czytaj →PoradnikPrzecena końca sezonu
Sieć z odzieżą narciarską: krzywa wyprzedaży, elastyczność słabnąca z tygodniami, pułapka przecen słabych modeli i symulacja strategii – z kodem R.
Czytaj →Piszesz pracę o zapasach lub prognozowaniu popytu?
Pomożemy przygotować dane z firmy, uwzględnić dni z brakami towaru, wyznaczyć plan zamówień i zapas bezpieczeństwa oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Conrad, S. A. (1976). Sales data and the estimation of demand. Journal of the Operational Research Society, 27(1), 123–127. https://doi.org/10.1057/jors.1976.13
- Huh, W. T., Levi, R., Rusmevichientong, P., & Orlin, J. B. (2011). Adaptive data-driven inventory control with censored demand based on Kaplan-Meier estimator. Operations Research, 59(4), 929–941. https://doi.org/10.1287/opre.1100.0906
- Nahmias, S. (1994). Demand estimation in lost sales inventory systems. Naval Research Logistics, 41(6), 739–757. https://doi.org/10.1002/1520-6750(199410)41:6<739::aid-nav3220410605>3.0.co;2-a
- Prak, D., Teunter, R., & Syntetos, A. (2017). On the calculation of safety stocks when demand is forecasted. European Journal of Operational Research, 256(2), 454–461. https://doi.org/10.1016/j.ejor.2016.06.035 ● Otwarty dostęp
- Schweitzer, M. E., & Cachon, G. P. (2000). Decision bias in the newsvendor problem with a known demand distribution: Experimental evidence. Management Science, 46(3), 404–420. https://doi.org/10.1287/mnsc.46.3.404.12070
Cytowania BibTeX
@article{conrad1976sales, author={Conrad, S. A.}, title={{Sales data and the estimation of demand}}, journal={Journal of the Operational Research Society}, year={1976}, volume={27}, number={1}, pages={123--127}, doi={10.1057/jors.1976.13}}@article{huh2011adaptive, author={Huh, Woonghee Tim and Levi, Retsef and Rusmevichientong, Paat and Orlin, James B.}, title={{Adaptive data-driven inventory control with censored demand based on Kaplan-Meier estimator}}, journal={Operations Research}, year={2011}, volume={59}, number={4}, pages={929--941}, doi={10.1287/opre.1100.0906}}@article{nahmias1994demand, author={Nahmias, Steven}, title={{Demand estimation in lost sales inventory systems}}, journal={Naval Research Logistics}, year={1994}, volume={41}, number={6}, pages={739--757}, doi={10.1002/1520-6750(199410)41:6<739::aid-nav3220410605>3.0.co;2-a}}@article{prak2017calculation, author={Prak, Dennis and Teunter, Ruud and Syntetos, Aris}, title={{On the calculation of safety stocks when demand is forecasted}}, journal={European Journal of Operational Research}, year={2017}, volume={256}, number={2}, pages={454--461}, doi={10.1016/j.ejor.2016.06.035}}@article{schweitzer2000decision, author={Schweitzer, Maurice E. and Cachon, G{\'e}rard P.}, title={{Decision bias in the newsvendor problem with a known demand distribution: Experimental evidence}}, journal={Management Science}, year={2000}, volume={46}, number={3}, pages={404--420}, doi={10.1287/mnsc.46.3.404.12070}}