Przykład: sieć sklepów z odzieżą narciarską i 12 tygodni do końca sezonu
Fikcyjna sieć sklepów z odzieżą narciarską ma pod koniec zimy w sklepach 300 modeli: kurtki, spodnie, kombinezony i bluzy termiczne w cenach regularnych od 249 do 1799 zł. Do końca sezonu zostało 12 tygodni, a na półkach leży 30 218 sztuk w sześciu rozmiarach (XS–XXL). Sieć zna cztery poziomy ceny: pełna, −20%, −30% i −50%. Co zostanie po 12 tygodniach, trafi do odbiorcy hurtowego za 20% ceny regularnej.
Zarząd pyta: kiedy i o ile obniżać ceny, żeby zarobić najwięcej i nie zostać z zapasem?
W odróżnieniu od wpisu o głębokości rabatu (tygodniowa promocja, towar uzupełniany) zapas jest tu skończony, a czas ucieka. To klasyczny problem sprzedaży danego zapasu do określonego terminu, opisany przez Gallego i van Ryzina (1994); przegląd metod dają Elmaghraby i Keskinocak (2003).
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Popyt słabnie (w tygodniu 12 to 0.34 popytu z tygodnia 1), a prawdziwa elastyczność cenowa spada co do wartości bezwzględnej z −3.0 do −1.8. Klienci kupują głównie M i L, a sieć zamówiła za dużo XS i XXL. 150 modeli sieć przeceniała według reguły: obniżka o poziom, gdy przed tygodniem 4, 7 lub 10 sprzedano mniej niż 14%, 32% lub 50% zapasu. W pozostałych 150 (test losowy) przeceny losowano.
Wszystkie parametry ustawiliśmy ręcznie (lista przy kodzie). Po pierwszym uruchomieniu zmieniliśmy trzy rzeczy. (1) Cele reguły z 25%, 45% i 62% na 14%, 32% i 50% – przy pierwotnych sieć przeceniała 227 z 300 modeli już w tygodniu 4. (2) Dodaliśmy test losowy: na danych z samej reguły nawet model z efektami stałymi dawał elastyczność w tygodniu 1 równą −4.19 zamiast −3.0. (3) Test powiększyliśmy ze 100 do 150 modeli i usunęliśmy −50% w tygodniu 1 – taka przecena na starcie jest mało realistyczna i od razu wyprzedawała rozmiary; przy pierwotnych ustawieniach elastyczność w tygodniu 1 z testu wyszła −2.19. Ziarna 725 nie zmienialiśmy. Dane (21 600 wierszy: model × tydzień × rozmiar) pobierzesz jako przecena-konca-sezonu-odziez-narciarska.csv.
Rysunek 1: zapas – tygodnie – przecena
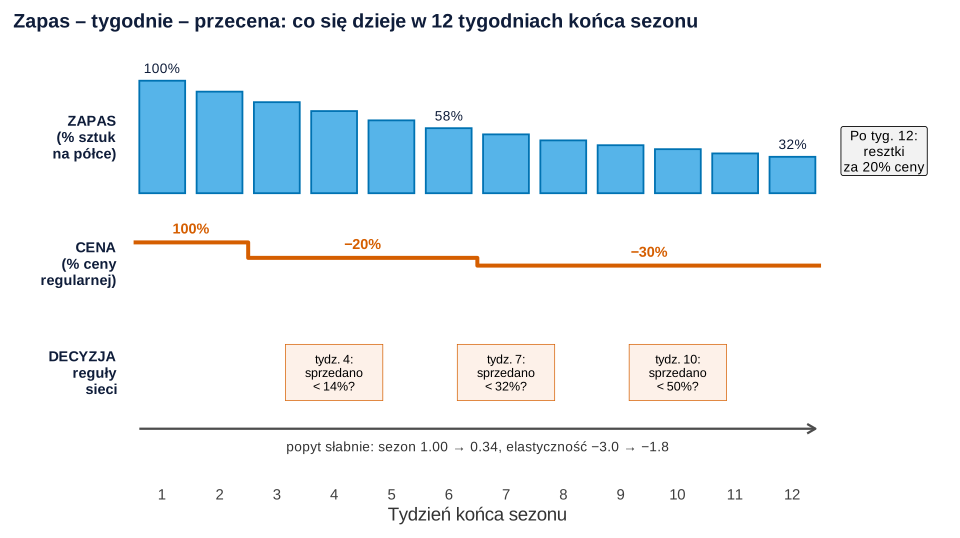
Co widać. Zapas topnieje, cena schodzi schodkami, a popyt i wrażliwość na cenę słabną. Każdy tydzień zwłoki to mniej klientów, słabiej reagujących na obniżkę; wczesna przecena oddaje jednak marżę na sztukach, które i tak by się sprzedały.
Jak może zmylić. Słupki to zapas całej sieci, a linia ceny – tylko przykład; każdy model ma własną ścieżkę cen.
Podpis do pracy:
Rysunek 2: krzywa wyprzedaży i Kaplan–Meier dla sztuki
Krzywa wyprzedaży to skumulowany odsetek zapasu sprzedany do danego tygodnia (sell-through). Ten sam obraz daje analiza przeżycia, jeśli za „obiekt” uznamy sztukę towaru, a za „zdarzenie” – jej sprzedaż. Sztuki niesprzedane do końca tygodnia 12 są obserwacjami cenzurowanymi: wiemy tylko, że „przeżyły” 12 tygodni. Dla takich danych służy estymator Kaplana i Meiera (1958); krzywa Kaplana–Meiera pokazuje odsetek „przeżywających”, więc rysujemy 1 − S(t) (procedura: Kaplan–Meier i model Coxa).
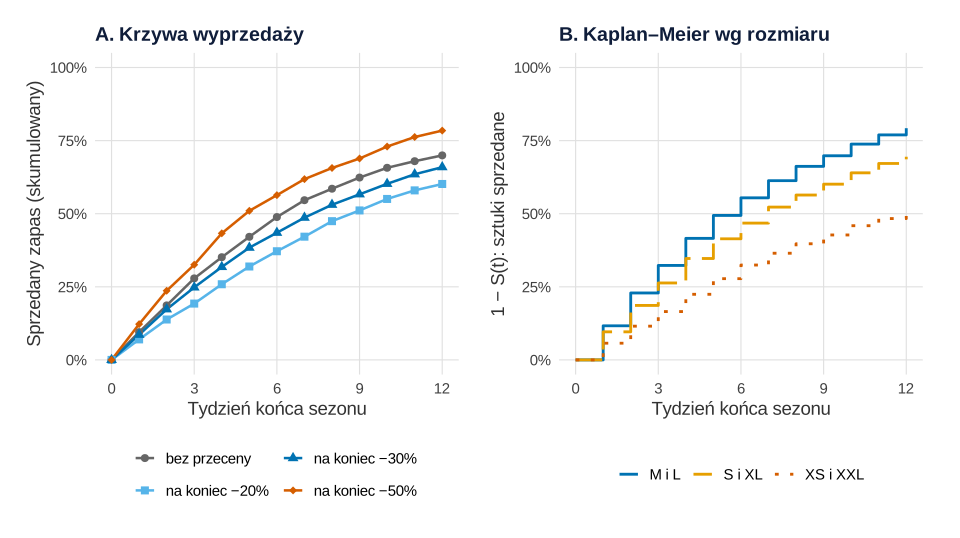
set.seed(725)).Co widać. Sieć sprzedała 21 112 z 30 218 sztuk (69.9%) za 15.81 mln zł. Mediana czasu do sprzedaży sztuki M lub L to 6 tygodni, S lub XL – 7, a XS lub XXL – 12 tygodni; po tygodniu 12 sprzedano 79.2%, 69.5% i 50.3% tych sztuk.
Jak może zmylić. W panelu A modele z przeceną −50% na koniec sprzedały najwięcej (78.4%), a modele z −20% – najmniej (60.2%). To nie efekt przeceny: grupy powstały według decyzji. Cenzurowanie jest tu tylko na końcu, więc Kaplan–Meier daje to samo co krzywa skumulowana; przydaje się, gdy modele wchodzą do sprzedaży w różnych tygodniach. Przedziały z survfit byłyby za wąskie, bo sztuki jednego modelu nie są niezależne.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: kogo sieć przecenia – i dlaczego naiwna elastyczność kłamie
Elastyczność cenowa mówi, o ile procent zmienia się sprzedaż, gdy cena zmienia się o 1%. Liczymy ją regresją Poissona tygodniowej sprzedaży modelu na logarytmie ceny względem regularnej. Reguła przecenia jednak słabe modele, więc atrakcyjność modelu jest zmienną zakłócającą. Cena ustalana w reakcji na popyt może znacznie obciążać oszacowania (Villas-Boas i Winer, 1999).
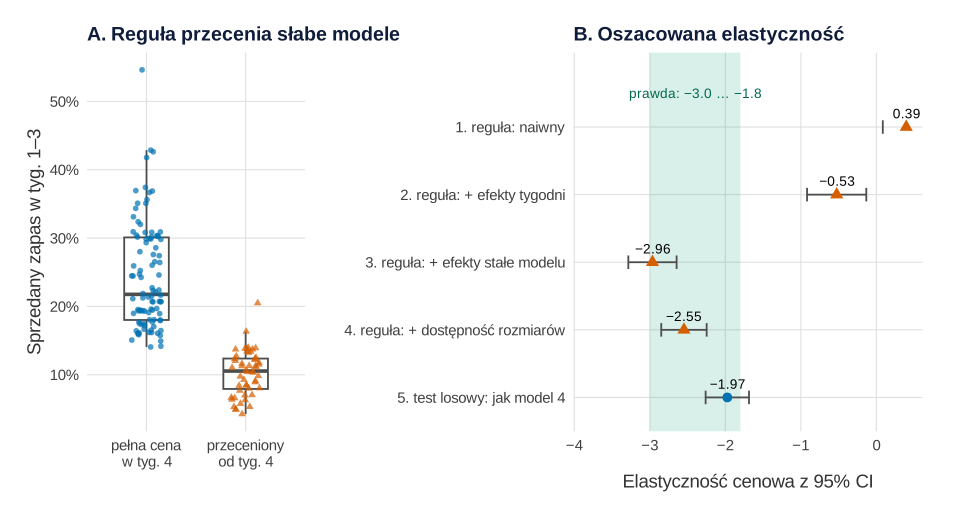
set.seed(725)).Co widać. Reguła przeceniła od tygodnia 4 modele, które w tygodniach 1–3 sprzedały średnio 10.3% zapasu (pozostałe: 24.3%). Naiwna regresja na modelach reguły daje elastyczność dodatnią: 0.39, 95% CI [0.08, 0.71] – jakby przecena zmniejszała sprzedaż. Efekty tygodni dają −0.53, dopiero efekty stałe modelu (porównanie modelu z nim samym) −2.96 [−3.28, −2.65], a z poprawką na brakujące rozmiary −2.55 [−2.85, −2.25]. Błędy standardowe są grupowane po modelu.
Jak może zmylić. Efekty stałe nie usuwają tego, że reguła reaguje na bieżące wahania: model po pechowych tygodniach dostaje przecenę i wraca do normy, co wygląda jak efekt przeceny. Test losowy nie ma tego problemu, ale jedna liczba na 12 tygodni (−1.97) miesza tygodnie o różnej elastyczności – stąd Rysunek 4.
Podpis do pracy:
Rysunek 4: elastyczność zależna od tygodnia sezonu
Do modelu dodajemy interakcję log(cena) × tydzień. Współczynnik przy log(cena) to elastyczność w tygodniu 1, a interakcja mówi, o ile zmienia się ona z każdym tygodniem:
αi – poziom popytu modelu, γt – tygodnia; dostępność – udział popytu na rozmiary obecne na półce.
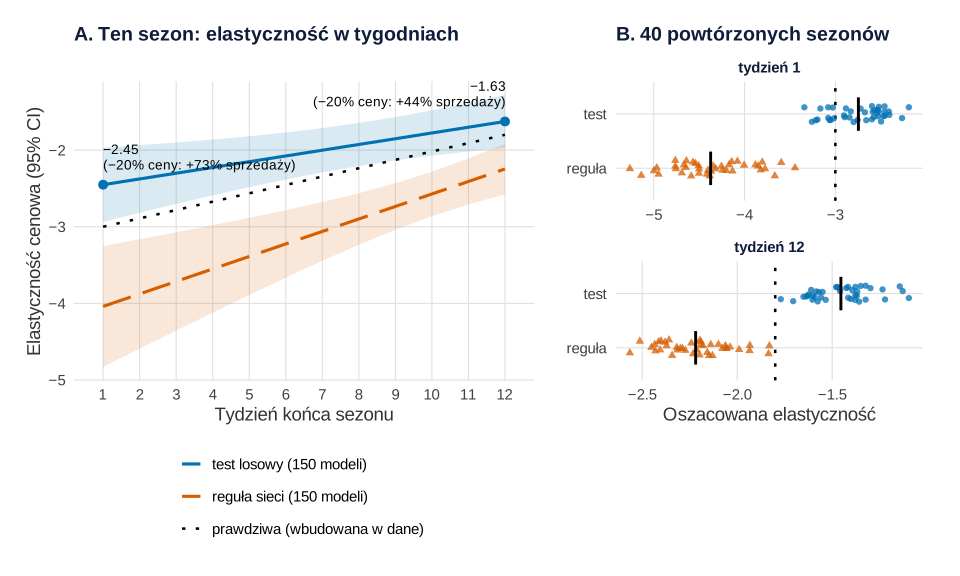
set.seed(725) i set.seed(7251)).Co widać. W teście losowym elastyczność w tygodniu 1 wynosi −2.45, 95% CI [−2.94, −1.97]: przecena o 20% podnosi sprzedaż o ok. 73%. Z każdym tygodniem słabnie o 0.075 (z = 2.71, p = .007), do −1.63 [−1.97, −1.28] w tygodniu 12 (+44% sprzedaży po obniżce o 20%). Model na danych z reguły pokazuje −4.04 – o ok. jedną trzecią za dużo.
Jak może zmylić. Prawdziwa elastyczność w tygodniu 1 to −3.0 i ten sezon ją chybia. Panel B pokazuje, że to w dużej części przypadek: w 40 nowych sezonach test daje średnio −2.74 (SD 0.30), a reguła −4.37 (SD 0.43). Test jednak lekko zaniża elastyczność, zwłaszcza w tygodniu 12 (−1.45 zamiast −1.8). Gdy rozmiar wyprzeda się w trakcie tygodnia, widzimy sprzedaż, a nie popyt – to cenzurowanie, jak przy popycie ukrytym przez braki towaru. Dla porównania: średnia elastyczność z metaanalizy 1851 oszacowań to −2.62, a uwzględnienie endogeniczności ceny zwiększa jej wartość bezwzględną (Bijmolt i in., 2005).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: wcześnie i płytko czy późno i głęboko? Symulacja z niepewnością
Model pozwala „zagrać” przyszły sezon dla tych samych 300 modeli i zapasu. Cztery strategie: bez przeceny; wcześnie i płytko (−20% od tygodnia 3, −30% od tygodnia 7); późno i głęboko (−50% od tygodnia 9) i regułę sieci. Miara: przychód plus odsprzedaż resztek (koszt towaru jest już poniesiony).
Niepewność: 1000 razy losujemy (β0, β1) z rozkładu normalnego o średnich i kowariancji z modelu, na nowo szacujemy poziomy popytu modeli i tygodni, a sprzedaż losujemy z rozkładu Poissona – wynik jako rozkład, jak przy progu rentowności z niepewnością.
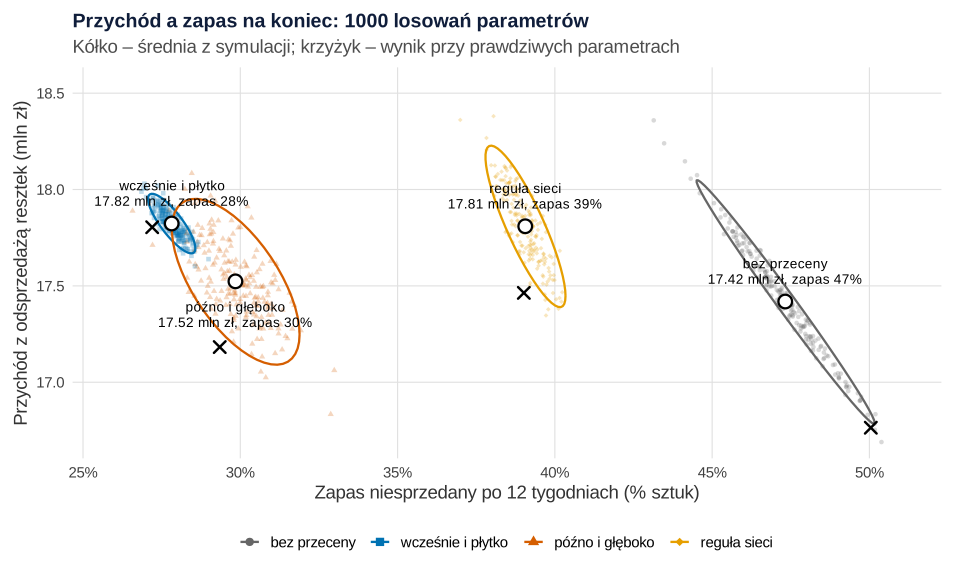
set.seed(7252)).Co widać. „Wcześnie i płytko” daje średnio 17.82 mln zł, 95% przedział symulacji [17.69, 17.96], i zostawia 27.8% zapasu. „Późno i głęboko” – 17.52 mln zł [17.14, 17.92] przy 29.8% zapasu: późna przecena trafia na mniej klientów, słabiej reagujących na cenę. Różnica wynosi 0.30 mln zł [−0.08, 0.66]; „wcześnie i płytko” wygrywa w 94.4% losowań. Bez przeceny zostaje 47.3% zapasu i 17.42 mln zł.
Jak może zmylić. Reguła sieci (17.81 mln zł) wygląda tu jak „wcześnie i płytko”, ale przy prawdziwych parametrach daje 17.46 mln zł wobec 17.80 (krzyżyki). Model zaniża elastyczność, więc przypisuje modelom wyższy popyt w pełnej cenie i przeszacowuje strategie, które długo trzymają pełną cenę – regułę i brak przeceny (16.76 mln zł przy prawdziwych parametrach). Symulacja nie obejmuje też niepewności co do kształtu krzywej ani klientów, którzy nauczą się czekać na przecenę.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: rozmiary – co naprawdę zostaje na półce
Klient w rozmiarze M nie kupi kurtki w XS. Tempo sprzedaży zależy od ceny, sezonu i asortymentu, który został na półce (Smith i Achabal, 1998).
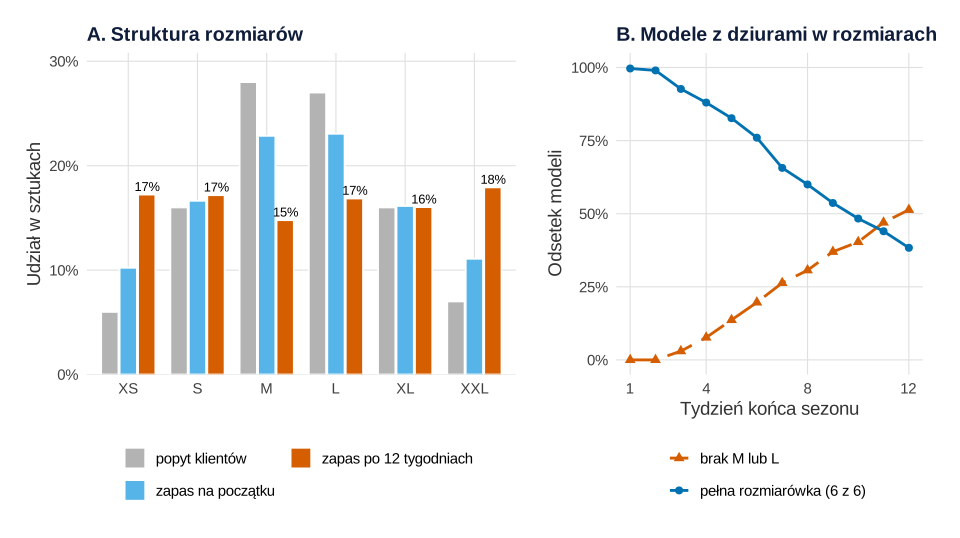
set.seed(725)).Co widać. Rozmiary M i L sprzedały się w 80.5% i 78.0%, a XS i XXL – w 49.2% i 51.3%. XS i XXL to 21.3% zapasu na początku, ale 35.2% resztek. W tygodniu 12 już tylko 38.3% modeli ma pełną rozmiarówkę, a 51.3% nie ma M lub L.
Jak może zmylić. Spadek sprzedaży pod koniec sezonu to częściowo brak rozmiarów, nie „słaby popyt mimo przeceny”. Bez poprawki na dostępność rozmiarów elastyczność w modelu 3 na Rysunku 3 wyszła −2.96 zamiast −2.55 – m.in. dlatego, że dobrze sprzedające się modele w pełnej cenie szybciej traciły rozmiary i „wyglądały” na słabsze.
Podpis do pracy:
Co z tym zrobić w firmie
- Przeceniaj wcześniej i płycej, zanim popyt osłabnie. W przykładzie dało to więcej niż −50% od tygodnia 9 w 94.4% symulacji.
- Nie licz elastyczności z samej historii przecen. Reguła „przeceniaj, co słabo schodzi” obciąża wynik. Zaplanuj test z losowym harmonogramem przecen na części modeli, jak w losowym teście ceny; podobny eksperyment terenowy w sieci odzieżowej zwiększył przychody z wyprzedaży o ok. 6% (Caro i Gallien, 2012).
- Patrz na rozmiary. Kupuj mniej XS i XXL, przesuwaj resztki między sklepami, a model bez M i L oceniaj osobno.
- Zbieraj dzienne stany półki. Dzień wyczerpania rozmiaru pozwala odróżnić sprzedaż od popytu (zob. zapasy przy niepewnym popycie).
- Pokaż rozkład, nie jedną liczbę. Przedział [−0.08, 0.66] mln zł mówi, że przewaga wczesnej przeceny jest prawdopodobna, ale niepewna.
Jak opisać w pracy
Opisz dane, przydział przecen, model z interakcją i symulację. Ogólne wskazówki: statystyka w pracy z zarządzania i ekonomii oraz statystyka w pracy z marketingu; o progach cenowych w tej serii – ceny psychologiczne 19.99 czy 20.00.
| Strategia | Przychód w sezonie (mln zł) | Zapas na koniec (%) | Przychód z resztkami (mln zł) [95% przedział] |
|---|---|---|---|
| Bez przeceny | 14.76 | 47.3 | 17.42 [16.83, 17.99] |
| Wcześnie i płytko | 16.25 | 27.8 | 17.82 [17.69, 17.96] |
| Późno i głęboko | 15.84 | 29.8 | 17.52 [17.14, 17.92] |
| Reguła sieci | 15.62 | 39.1 | 17.81 [17.43, 18.18] |
Kod R: krzywa wyprzedaży, elastyczność w czasie i symulacja strategii
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje, z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p2–p7; numer przepisu, nie rysunku), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(725)), 4 (set.seed(7251), 40 sezonów) i 5 (set.seed(7252), 1000 losowań parametrów i 200 powtórzeń przy prawdziwych parametrach); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 300 modeli w czterech kategoriach (kurtki 35%, spodnie 30%, kombinezony 15%, bluzy termiczne 20%) z cenami regularnymi 900–1600, 500–900, 1100–1800 i 250–450 zł; zapas startowy 40–160 sztuk na model; tempo sprzedaży w pełnej cenie średnio 5.5% zapasu tygodniowo (rozrzut logarytmiczny 0.5) z losowymi wahaniami tygodnia (rozkład gamma o średniej 1 i kształcie 8); udział rozmiarów XS–XXL w popycie 6, 16, 28, 27, 16 i 7% oraz w zapasie 10, 17, 23, 23, 16 i 11%; siłę popytu malejącą o 0.06 na tydzień (od 1.00 do 0.34); elastyczność od −3.0 do −1.8 liniowo; poziomy przeceny 0, 20, 30 i 50%; regułę sieci (cele 14, 32 i 50% przed tygodniem 4, 7 i 10, dodatkowa obniżka z szansą 0.08); test na 150 modelach (poziom w tygodniu 1: 0, 20 lub 30% z szansami 0.4, 0.3 i 0.3; obniżka o poziom z szansą 0.5 w tygodniach 4, 7 i 10); odzysk z resztek 20% ceny regularnej; plany strategii. Po pierwszym uruchomieniu zmieniono: cele reguły z 25, 45 i 62% na 14, 32 i 50%; dodano test losowy (najpierw 100 modeli z poziomem do 50% w tygodniu 1, potem 150 modeli bez 50% na starcie) – powody opisano w przykładzie na początku wpisu. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się ok. 30 sekund.
1. Dane: 300 modeli, 12 tygodni, 6 rozmiarów
R
# Przepis 1. Fikcyjna sieć sklepów z odzieżą narciarską: 300 modeli w 12 ostatnich tygodniach sezonu
library(ggplot2)
options(width = 120)                                   # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("niebieski" = "#0072B2", "cynober" = "#D55E00", "pomarańcz" = "#E69F00", "zielony" = "#009E73",
         "błękit" = "#56B4E9", "purpura" = "#CC79A7", "czarny" = "#000000")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)                # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie
n_modeli <- 300; tyg <- 1:12
rozmiary <- c("XS", "S", "M", "L", "XL", "XXL")
udzial_popytu <- c(0.06, 0.16, 0.28, 0.27, 0.16, 0.07)  # jakie rozmiary kupują klienci
udzial_zapasu <- c(0.10, 0.17, 0.23, 0.23, 0.16, 0.11)  # jak rozłożono zapas (skrajne rozmiary – za dużo)
poziomy <- c(0, 0.20, 0.30, 0.50)                       # 4 poziomy przeceny: 0%, 20%, 30%, 50%
sezon <- 1 - 0.06 * (tyg - 1)                           # popyt słabnie: tydzień 1 = 1.00, tydzień 12 = 0.34
elastycznosc <- -3.0 + 1.2 * (tyg - 1) / 11             # prawdziwa elastyczność: −3.0 w tyg. 1, −1.8 w tyg. 12
cel <- c("4" = 0.14, "7" = 0.32, "10" = 0.50)           # reguła sieci: cel odsetka sprzedanego zapasu przed tyg. 4, 7, 10
p_bez_powodu <- 0.08                                    # szansa przeceny modelu, który osiągnął cel
n_test <- 150                                           # modele w teście losowym: harmonogram przeceny losowany
p_start_test <- c(0.40, 0.30, 0.30, 0.00)               # test: poziom w tyg. 1 (0%, 20%, 30%; bez 50%)
p_krok_test <- 0.5                                      # test: szansa obniżki o jeden poziom w tyg. 4, 7 i 10
kategorie <- c("Kurtka", "Spodnie", "Kombinezon", "Bluza termiczna")
cena_od <- c(900, 500, 1100, 250); cena_do <- c(1600, 900, 1800, 450)

# Jeden sezon: modele, zapas w rozmiarach, decyzje o przecenie i sprzedaż tydzień po tygodniu
symuluj_sezon <- function() {
  modele <- data.frame(model = sprintf("M%03d", 1:n_modeli),
                       kategoria = sample(kategorie, n_modeli, replace = TRUE, prob = c(.35, .30, .15, .20)))
  k <- match(modele$kategoria, kategorie)
  modele$cena_reg <- round(runif(n_modeli, cena_od[k], cena_do[k]) / 10) * 10 - 1    # np. 1249 zł
  modele$zapas_start <- round(runif(n_modeli, 40, 160))                               # sztuki na początku 12 tygodni
  modele$tempo <- exp(rnorm(n_modeli, log(0.055), 0.5)) # ukryta atrakcyjność: tygodniowa sprzedaż / zapas w pełnej cenie
  modele$test <- seq_len(n_modeli) %in% sample(n_modeli, n_test)                     # TRUE = model w teście losowym
  zapas <- t(sapply(modele$zapas_start, function(z) as.vector(rmultinom(1, z, udzial_zapasu))))  # 300 × 6 rozmiarów
  poziom <- rep(1, n_modeli)
  poziom[modele$test] <- sample(1:4, n_test, replace = TRUE, prob = p_start_test)
  wiersze <- vector("list", length(tyg))
  for (t in tyg) {
    if (as.character(t) %in% names(cel)) {              # decyzja: reguła sieci albo losowanie w teście
      sprzedano <- 1 - rowSums(zapas) / modele$zapas_start
      w_dol <- ifelse(modele$test, runif(n_modeli) < p_krok_test,
                      sprzedano < cel[as.character(t)] | runif(n_modeli) < p_bez_powodu)
      poziom <- pmin(poziom + w_dol, 4)
    }
    przecena <- poziomy[poziom]
    lambda <- modele$zapas_start * modele$tempo * sezon[t] * (1 - przecena)^elastycznosc[t] *
      rgamma(n_modeli, shape = 8, rate = 8)             # losowe wahania tygodnia (średnio 1)
    popyt <- matrix(rpois(n_modeli * 6, outer(lambda, udzial_popytu)), n_modeli)
    sprzedaz <- pmin(popyt, zapas)                       # brak rozmiaru = klient nie kupuje
    wiersze[[t]] <- data.frame(model = rep(modele$model, 6), tydzien = t, rozmiar = rep(rozmiary, each = n_modeli),
                               przecena = rep(przecena, 6), zapas_pocz = as.vector(zapas), sprzedaz = as.vector(sprzedaz))
    zapas <- zapas - sprzedaz
  }
  dane <- merge(modele[, c("model", "kategoria", "test", "cena_reg")], do.call(rbind, wiersze), by = "model")
  dane$rozmiar <- factor(dane$rozmiar, levels = rozmiary)
  dane$cena <- round(dane$cena_reg * (1 - dane$przecena), 2)
  dane <- dane[order(dane$model, dane$tydzien, dane$rozmiar),
               c("model", "kategoria", "test", "cena_reg", "tydzien", "rozmiar", "przecena", "cena", "zapas_pocz", "sprzedaz")]
  rownames(dane) <- NULL
  # model × tydzień (suma po rozmiarach) i dostępność: udział popytu na rozmiary, które są na półce na początku tygodnia
  mt <- aggregate(cbind(zapas_pocz, sprzedaz) ~ model + kategoria + test + cena_reg + tydzien + przecena + cena,
                  data = dane, FUN = sum)
  dost <- aggregate(cbind(dostepnosc = udzial_popytu[as.integer(rozmiar)] * (zapas_pocz > 0)) ~ model + tydzien,
                    data = dane, FUN = sum)
  mt <- merge(mt, dost, by = c("model", "tydzien"))
  mt$lcena <- log(mt$cena / mt$cena_reg)                # log ceny względem regularnej: 0, −0.22, −0.36, −0.69
  list(modele = modele, dane = dane, mt = mt[order(mt$model, mt$tydzien), ])
}

set.seed(725)
s1 <- symuluj_sezon()
modele <- s1$modele; dane <- s1$dane; mt <- s1$mt
write.csv(dane, "przecena-konca-sezonu-odziez-narciarska.csv", row.names = FALSE, fileEncoding = "UTF-8")

c(modele = n_modeli, wierszy_csv = nrow(dane), sztuk_na_start = sum(modele$zapas_start),
  sprzedanych = sum(dane$sprzedaz), przychod_tys_zl = round(sum(dane$sprzedaz * dane$cena) / 1000))
round(100 * sum(dane$sprzedaz) / sum(modele$zapas_start), 1)          # odsetek sprzedanego zapasu po 12 tygodniach (%)
table(test = mt$test[mt$tydzien == 12], przecena_w_tyg_12 = 100 * mt$przecena[mt$tydzien == 12])   # modele wg poziomu przeceny na koniec
Wynik w R
         modele     wierszy_csv  sztuk_na_start     sprzedanych przychod_tys_zl
            300           21600           30218           21112           15812
[1] 69.9
       przecena_w_tyg_12
test     0 20 30 50
  FALSE 51 31 36 32
  TRUE   2 29 42 77
2. Krzywa wyprzedaży i Kaplan–Meier: Rysunek 2
R
# Przepis 2. Krzywa wyprzedaży i Kaplan–Meier „czasu do sprzedaży sztuki”: Rysunek 2
library(survival)
library(patchwork)

# A. Skumulowany odsetek sprzedanego zapasu po każdym tygodniu – według poziomu przeceny na koniec
koniec <- mt[mt$tydzien == 12, c("model", "przecena")]
names(koniec)[2] <- "przecena_koniec"
mt2 <- merge(mt, koniec, by = "model")
mt2$grupa <- factor(ifelse(mt2$przecena_koniec == 0, "bez przeceny", paste0("na koniec −", 100 * mt2$przecena_koniec, "%")),
                    levels = c("bez przeceny", "na koniec −20%", "na koniec −30%", "na koniec −50%"))
start <- aggregate(zapas_pocz ~ model, data = mt2[mt2$tydzien == 1, ], FUN = sum)
krzywa <- do.call(rbind, lapply(split(mt2, mt2$grupa), function(d) {
  s <- tapply(d$sprzedaz, d$tydzien, sum)
  data.frame(grupa = d$grupa[1], tydzien = c(0, tyg), modeli = length(unique(d$model)),
             sprzedano = c(0, cumsum(s)) / sum(start$zapas_pocz[start$model %in% d$model]))
}))
print(transform(krzywa[krzywa$tydzien %in% c(3, 6, 9, 12), ], sprzedano = round(100 * sprzedano, 1)), row.names = FALSE)

# B. Każda sztuka to obserwacja: czas = tydzień sprzedaży; sztuki niesprzedane – cenzurowane po tygodniu 12
dane$grupa_rozm <- factor(ifelse(dane$rozmiar %in% c("M", "L"), "M i L",
                          ifelse(dane$rozmiar %in% c("S", "XL"), "S i XL", "XS i XXL")),
                          levels = c("M i L", "S i XL", "XS i XXL"))
sprzed <- aggregate(sprzedaz ~ model + rozmiar + grupa_rozm + tydzien, data = dane, FUN = sum)
reszta <- aggregate(cbind(zostalo = zapas_pocz - sprzedaz) ~ model + rozmiar + grupa_rozm,
                    data = dane[dane$tydzien == 12, ], FUN = sum)
sztuki <- rbind(data.frame(grupa_rozm = rep(sprzed$grupa_rozm, sprzed$sprzedaz), czas = rep(sprzed$tydzien, sprzed$sprzedaz),
                           zdarzenie = 1),
                data.frame(grupa_rozm = rep(reszta$grupa_rozm, reszta$zostalo), czas = 12, zdarzenie = 0))
km <- survfit(Surv(czas, zdarzenie) ~ grupa_rozm, data = sztuki)
summary(km, times = c(4, 8, 12))$table[, c("records", "events", "median")]
s <- summary(km, times = c(4, 8, 12))
data.frame(grupa = sub("grupa_rozm=", "", s$strata), tydzien = s$time, sprzedano_proc = round(100 * (1 - s$surv), 1))

km_df <- data.frame(grupa = sub("grupa_rozm=", "", rep(names(km$strata), km$strata)), tydzien = km$time,
                    sprzedano = 1 - km$surv)
km_df <- rbind(data.frame(grupa = levels(sztuki$grupa_rozm), tydzien = 0, sprzedano = 0), km_df)

kol_grupy <- c("bez przeceny" = "grey40", "na koniec −20%" = kol[["błękit"]], "na koniec −30%" = kol[["niebieski"]],
               "na koniec −50%" = kol[["cynober"]])
pA <- ggplot(krzywa, aes(tydzien, sprzedano, colour = grupa, shape = grupa)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.4) +
  scale_colour_manual(values = kol_grupy, name = NULL) + scale_shape_manual(values = c(16, 15, 17, 18), name = NULL) +
  scale_x_continuous(breaks = c(0, 3, 6, 9, 12)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "A. Krzywa wyprzedaży", x = "Tydzień końca sezonu", y = "Sprzedany zapas (skumulowany)") + motyw
pB <- ggplot(km_df, aes(tydzien, sprzedano, colour = grupa, linetype = grupa)) +
  geom_step(linewidth = 1) +
  scale_colour_manual(values = c("M i L" = kol[["niebieski"]], "S i XL" = kol[["pomarańcz"]], "XS i XXL" = kol[["cynober"]]),
                      name = NULL) +
  scale_linetype_manual(values = c("M i L" = "solid", "S i XL" = "longdash", "XS i XXL" = "dotted"), name = NULL) +
  scale_x_continuous(breaks = c(0, 3, 6, 9, 12)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  labs(title = "B. Kaplan–Meier wg rozmiaru", x = "Tydzień końca sezonu", y = "1 − S(t): sztuki sprzedane") + motyw
p2 <- pA | pB
p2   # zapis: ggsave("przecena-konca-sezonu-krzywa-wyprzedazy.svg", p2, width = 10, height = 5.6)
Wynik w R
          grupa tydzien modeli sprzedano
   bez przeceny       3     53      27.9
   bez przeceny       6     53      48.9
   bez przeceny       9     53      62.4
   bez przeceny      12     53      69.9
 na koniec −20%       3     60      19.3
 na koniec −20%       6     60      37.2
 na koniec −20%       9     60      51.1
 na koniec −20%      12     60      60.2
 na koniec −30%       3     78      24.8
 na koniec −30%       6     78      43.5
 na koniec −30%       9     78      56.6
 na koniec −30%      12     78      65.9
 na koniec −50%       3    109      32.6
 na koniec −50%       6    109      56.3
 na koniec −50%       9    109      68.9
 na koniec −50%      12    109      78.4
                    records events median
grupa_rozm=M i L      13873  10992      6
grupa_rozm=S i XL      9906   6882      7
grupa_rozm=XS i XXL    6439   3238     12
     grupa tydzien sprzedano_proc
1    M i L       4           41.6
2    M i L       8           66.2
3    M i L      12           79.2
4   S i XL       4           34.7
5   S i XL       8           56.4
6   S i XL      12           69.5
7 XS i XXL       4           22.4
8 XS i XXL       8           39.7
9 XS i XXL      12           50.3
3. Kogo sieć przecenia i pięć modeli elastyczności: Rysunek 3
R
# Przepis 3. Kogo sieć przecenia i dlaczego naiwna elastyczność jest obciążona: Rysunek 3
library(fixest)
library(patchwork)
setFixest_notes(FALSE)                                  # bez komunikatów o usuniętych modelach bez sprzedaży

est <- subset(mt, zapas_pocz > 0 & dostepnosc > 0)      # tygodnie, w których model był w sklepie

# A. Modele z reguły sieci: sprzedaż w tygodniach 1–3 (pełna cena) a przecena od tygodnia 4
t13 <- aggregate(sprzedaz ~ model, data = mt[mt$tydzien <= 3 & !mt$test, ], FUN = sum)
t13 <- merge(t13, modele[, c("model", "zapas_start")], by = "model")
t13$sprzedano_1_3 <- t13$sprzedaz / t13$zapas_start
t13 <- merge(t13, mt[mt$tydzien == 4, c("model", "przecena")], by = "model")
t13$przeceniony_w_4 <- factor(ifelse(t13$przecena > 0, "przeceniony od tyg. 4", "w pełnej cenie w tyg. 4"),
                              levels = c("w pełnej cenie w tyg. 4", "przeceniony od tyg. 4"))
aggregate(sprzedano_1_3 ~ przeceniony_w_4, data = t13, FUN = function(x) c(modeli = length(x), srednia = round(mean(x), 3)))

# B. Modele Poissona dla tygodniowej sprzedaży modelu (błędy standardowe grupowane po modelu)
reg <- subset(est, !test); los <- subset(est, test)     # 200 modeli z reguły sieci i 100 z testu losowego
m1 <- fepois(sprzedaz ~ lcena, data = reg, cluster = ~model)                                  # naiwny: wszystko razem
m2 <- fepois(sprzedaz ~ lcena | tydzien, data = reg, cluster = ~model)                        # + efekty tygodni
m3 <- fepois(sprzedaz ~ lcena | model + tydzien, data = reg, cluster = ~model)                # + efekty stałe modelu
m4 <- fepois(sprzedaz ~ lcena | model + tydzien, data = reg, offset = ~log(dostepnosc), cluster = ~model)  # + rozmiary
m5 <- fepois(sprzedaz ~ lcena | model + tydzien, data = los, offset = ~log(dostepnosc), cluster = ~model)  # test losowy
oszac <- data.frame(model = c("1. reguła: naiwny", "2. reguła: + efekty tygodni", "3. reguła: + efekty stałe modelu",
                              "4. reguła: + dostępność rozmiarów", "5. test losowy: jak model 4"),
                    elastycznosc = sapply(list(m1, m2, m3, m4, m5), function(m) coef(m)[["lcena"]]),
                    se = sapply(list(m1, m2, m3, m4, m5), function(m) se(m)[["lcena"]]))
oszac$ci_dol <- oszac$elastycznosc - 1.96 * oszac$se
oszac$ci_gora <- oszac$elastycznosc + 1.96 * oszac$se
print(transform(oszac, elastycznosc = round(elastycznosc, 3), se = round(se, 3), ci_dol = round(ci_dol, 2),
                ci_gora = round(ci_gora, 2)), row.names = FALSE)
c(obserwacji_regula = nobs(m4), obserwacji_test = nobs(m5), srednia_prawdziwa_elastycznosc = round(mean(elastycznosc), 2))

pA <- ggplot(t13, aes(przeceniony_w_4, sprzedano_1_3)) +
  geom_boxplot(width = 0.45, outlier.shape = NA, colour = "grey30") +
  geom_jitter(aes(colour = przeceniony_w_4, shape = przeceniony_w_4), width = 0.15, height = 0, size = 1.6, alpha = 0.7) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]]), guide = "none") +
  scale_shape_manual(values = c(16, 17), guide = "none") +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  scale_x_discrete(labels = c("pełna cena\nw tyg. 4", "przeceniony\nod tyg. 4")) +
  labs(title = "A. Reguła przecenia słabe modele", x = NULL, y = "Sprzedany zapas w tyg. 1–3") + motyw
oszac$model <- factor(oszac$model, levels = rev(oszac$model))
pB <- ggplot(oszac, aes(elastycznosc, model)) +
  annotate("rect", xmin = -3.0, xmax = -1.8, ymin = -Inf, ymax = Inf, fill = kol[["zielony"]], alpha = 0.15) +
  annotate("text", x = -2.4, y = 5.5, label = minus("prawda: −3.0 … −1.8"), size = 3.6, colour = "#00694D") +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0.2, orientation = "y", colour = "grey30") +
  geom_point(aes(colour = grepl("test", model), shape = grepl("test", model)), size = 3) +
  scale_colour_manual(values = c("FALSE" = kol[["cynober"]], "TRUE" = kol[["niebieski"]]), guide = "none") +
  scale_shape_manual(values = c("FALSE" = 17, "TRUE" = 16), guide = "none") +
  geom_text(aes(label = minus(sprintf("%.2f", elastycznosc))), vjust = -0.9, size = 3.6) +
  scale_x_continuous(limits = c(-3.8, 0.4), labels = function(x) minus(format(x))) +
  scale_y_discrete(expand = expansion(add = c(0.5, 1.1))) +
  labs(title = "B. Oszacowana elastyczność", x = "Elastyczność cenowa z 95% CI", y = NULL) + motyw
p3 <- pA + pB + plot_layout(widths = c(1, 1.6))
p3   # zapis: ggsave("przecena-konca-sezonu-zaklocenie.svg", p3, width = 10, height = 5.4)
Wynik w R
          przeceniony_w_4 sprzedano_1_3.modeli sprzedano_1_3.srednia
1 w pełnej cenie w tyg. 4               98.000                 0.243
2   przeceniony od tyg. 4               52.000                 0.103
                             model elastycznosc    se ci_dol ci_gora
                 1. reguła: naiwny        0.395 0.158   0.08    0.71
       2. reguła: + efekty tygodni       -0.526 0.200  -0.92   -0.13
  3. reguła: + efekty stałe modelu       -2.965 0.163  -3.28   -2.65
 4. reguła: + dostępność rozmiarów       -2.548 0.153  -2.85   -2.25
       5. test losowy: jak model 4       -1.974 0.147  -2.26   -1.69
             obserwacji_regula                obserwacji_test srednia_prawdziwa_elastycznosc
                        1800.0                         1683.0                           -2.4
4. Elastyczność zależna od tygodnia i 40 powtórzonych sezonów: Rysunek 4
R
# Przepis 4. Elastyczność zależna od tygodnia sezonu: interakcja log(cena) × tydzień – Rysunek 4
interakcja <- function(d) {                              # tyg0 = 0 w tygodniu 1, więc lcena = elastyczność w tyg. 1
  d$tyg0 <- d$tydzien - 1
  fepois(sprzedaz ~ lcena + lcena:tyg0 | model + tydzien, data = d, offset = ~log(dostepnosc), cluster = ~model)
}
mi_los <- interakcja(los)                                # test losowy
mi_reg <- interakcja(reg)                                # reguła sieci
coeftable(mi_los)
coeftable(mi_reg)

krzywa_el <- function(m, nazwa) {
  V <- vcov(m); b <- coef(m)
  d <- data.frame(dane = nazwa, tydzien = tyg, oszacowana = b[["lcena"]] + b[["lcena:tyg0"]] * (tyg - 1),
                  se = sqrt(V[1, 1] + (tyg - 1)^2 * V[2, 2] + 2 * (tyg - 1) * V[1, 2]))
  d$ci_dol <- d$oszacowana - 1.96 * d$se; d$ci_gora <- d$oszacowana + 1.96 * d$se
  d$wzrost_20 <- 100 * (0.8^d$oszacowana - 1)          # o ile % rośnie sprzedaż po przecenie o 20%
  d
}
el <- rbind(krzywa_el(mi_los, "test losowy (150 modeli)"), krzywa_el(mi_reg, "reguła sieci (150 modeli)"))
el$prawdziwa <- elastycznosc[el$tydzien]
pokaz <- el[el$tydzien %in% c(1, 4, 8, 12), ]
pokaz[-1] <- round(pokaz[-1], 2)
print(pokaz, row.names = FALSE)

# Czy to pech jednego sezonu? 40 nowych sezonów z tymi samymi parametrami
set.seed(7251)
powt <- do.call(rbind, lapply(1:40, function(i) {
  m <- symuluj_sezon()$mt
  m <- subset(m, zapas_pocz > 0 & dostepnosc > 0)
  b_los <- coef(interakcja(subset(m, test))); b_reg <- coef(interakcja(subset(m, !test)))
  data.frame(sezon = i, dane = c("test losowy (150 modeli)", "reguła sieci (150 modeli)"),
             tydz_1 = c(b_los[1], b_reg[1]), tydz_12 = c(b_los[1] + 11 * b_los[2], b_reg[1] + 11 * b_reg[2]))
}))
aggregate(cbind(tydz_1, tydz_12) ~ dane, data = powt, FUN = function(x) round(c(srednia = mean(x), sd = sd(x)), 2))
c(prawda_tydz_1 = elastycznosc[1], prawda_tydz_12 = elastycznosc[12])

kol_el <- c("test losowy (150 modeli)" = kol[["niebieski"]], "reguła sieci (150 modeli)" = kol[["cynober"]],
            "prawdziwa (wbudowana w dane)" = "black")
pA <- ggplot(el, aes(tydzien)) +
  geom_ribbon(aes(ymin = ci_dol, ymax = ci_gora, fill = dane), alpha = 0.15) +
  geom_line(aes(y = oszacowana, colour = dane, linetype = dane), linewidth = 1.1) +
  geom_line(data = data.frame(tydzien = tyg, prawdziwa = elastycznosc, dane = "prawdziwa (wbudowana w dane)"),
            aes(y = prawdziwa, colour = dane, linetype = dane), linewidth = 0.9) +
  geom_point(data = el[el$tydzien %in% c(1, 12) & grepl("test", el$dane), ], aes(y = oszacowana), colour = kol[["niebieski"]],
             size = 2.6) +
  geom_text(data = el[el$tydzien %in% c(1, 12) & grepl("test", el$dane), ], aes(y = oszacowana,
            label = minus(sprintf("%.2f\n(−20%% ceny: +%.0f%% sprzedaży)", oszacowana, wzrost_20))),
            vjust = -0.6, hjust = c(0, 1), size = 3.6, lineheight = 0.95) +
  scale_colour_manual(values = kol_el, name = NULL, breaks = names(kol_el)) +
  scale_fill_manual(values = kol_el, guide = "none") +
  scale_linetype_manual(values = c("test losowy (150 modeli)" = "solid", "reguła sieci (150 modeli)" = "longdash",
                                   "prawdziwa (wbudowana w dane)" = "dotted"), name = NULL, breaks = names(kol_el)) +
  scale_x_continuous(breaks = tyg, expand = expansion(add = 0.8)) +
  scale_y_continuous(labels = function(x) minus(format(x))) +
  guides(colour = guide_legend(nrow = 3), linetype = guide_legend(nrow = 3)) +
  labs(title = "A. Ten sezon: elastyczność w tygodniach", x = "Tydzień końca sezonu",
       y = "Elastyczność cenowa (95% CI)") + motyw
powt_d <- rbind(data.frame(powt[, 1:2], tydzien = "tydzień 1", el = powt$tydz_1),
                data.frame(powt[, 1:2], tydzien = "tydzień 12", el = powt$tydz_12))
pB <- ggplot(powt_d, aes(el, dane, colour = dane, shape = dane)) +
  geom_vline(data = data.frame(tydzien = c("tydzień 1", "tydzień 12"), el = elastycznosc[c(1, 12)]),
             aes(xintercept = el), linetype = "dotted", linewidth = 0.9) +
  geom_jitter(height = 0.15, width = 0, size = 1.8, alpha = 0.75) +
  stat_summary(fun = mean, geom = "point", shape = 124, size = 9, colour = "black") +
  facet_wrap(~tydzien, ncol = 1, scales = "free_x") +
  scale_colour_manual(values = kol_el, guide = "none") + scale_shape_manual(values = c(17, 16), guide = "none") +
  scale_x_continuous(labels = function(x) minus(format(x))) +
  scale_y_discrete(labels = c("reguła", "test")) +
  labs(title = "B. 40 powtórzonych sezonów", x = "Oszacowana elastyczność", y = NULL) + motyw
p4 <- pA + pB + plot_layout(widths = c(1.5, 1))
p4   # zapis: ggsave("przecena-konca-sezonu-elastycznosc-tydzien.svg", p4, width = 10, height = 6)
Wynik w R
              Estimate Std. Error   z value     Pr(>|z|)
lcena      -2.45113852 0.24717065 -9.916786 3.519038e-23
lcena:tyg0  0.07500417 0.02767367  2.710308 6.722070e-03
attr(,"vcov_type")
[1] "Clustered (model)"
             Estimate Std. Error    z value     Pr(>|z|)
lcena      -4.0395165 0.40208733 -10.046366 9.531778e-24
lcena:tyg0  0.1630716 0.04108293   3.969329 7.207540e-05
attr(,"vcov_type")
[1] "Clustered (model)"
                      dane tydzien oszacowana   se ci_dol ci_gora wzrost_20 prawdziwa
  test losowy (150 modeli)       1      -2.45 0.25  -2.94   -1.97     72.80     -3.00
  test losowy (150 modeli)       4      -2.23 0.19  -2.59   -1.86     64.34     -2.67
  test losowy (150 modeli)       8      -1.93 0.14  -2.21   -1.65     53.69     -2.24
  test losowy (150 modeli)      12      -1.63 0.18  -1.97   -1.28     43.74     -1.80
 reguła sieci (150 modeli)       1      -4.04 0.40  -4.83   -3.25    146.30     -3.00
 reguła sieci (150 modeli)       4      -3.55 0.29  -4.12   -2.98    120.83     -2.67
 reguła sieci (150 modeli)       8      -2.90 0.17  -3.23   -2.56     90.92     -2.24
 reguła sieci (150 modeli)      12      -2.25 0.17  -2.57   -1.92     65.06     -1.80
                       dane tydz_1.srednia tydz_1.sd tydz_12.srednia tydz_12.sd
1 reguła sieci (150 modeli)          -4.37      0.43           -2.22       0.18
2  test losowy (150 modeli)          -2.74      0.30           -1.45       0.16
 prawda_tydz_1 prawda_tydz_12
          -3.0           -1.8
5. Symulacja czterech strategii z niepewnością parametrów: Rysunek 5
R
# Przepis 5. Symulacja strategii przeceny z niepewnością parametrów: Rysunek 5
# MASS::mvrnorm – losowanie parametrów z rozkładu oszacowań (przybliżenie normalne)

udzial_rozm <- prop.table(tapply(dane$sprzedaz[dane$tydzien == 1], dane$rozmiar[dane$tydzien == 1], sum))  # z danych
zapas0 <- matrix(dane$zapas_pocz[dane$tydzien == 1], ncol = 6, byrow = TRUE)   # zapas startowy: model × rozmiar
cena_reg <- modele$cena_reg
odzysk <- 0.20                                          # resztki po sezonie sprzedawane hurtowo za 20% ceny regularnej
strategie <- list("bez przeceny" = rep(0, 12),
                  "wcześnie i płytko" = c(0, 0, rep(0.2, 4), rep(0.3, 6)),   # −20% od tyg. 3, −30% od tyg. 7
                  "późno i głęboko" = c(rep(0, 8), rep(0.5, 4)),             # −50% od tyg. 9
                  "reguła sieci" = NA)                                        # cele 14%, 32%, 50% jak w danych

symuluj_strategie <- function(b, fe_model, fe_tydz, plan) {
  zapas <- zapas0; poziom <- rep(1, n_modeli); przychod <- 0
  for (t in tyg) {
    if (identical(plan, NA)) {                           # reguła sieci: obniżka, gdy sprzedano mniej niż cel
      if (as.character(t) %in% names(cel))
        poziom <- pmin(poziom + (1 - rowSums(zapas) / rowSums(zapas0) < cel[as.character(t)]), 4)
      d <- poziomy[poziom]
    } else d <- rep(plan[t], n_modeli)
    dost <- as.vector((zapas > 0) %*% udzial_rozm)
    lambda <- exp(fe_model + fe_tydz[t] + (b[1] + b[2] * (t - 1)) * log(1 - d)) * dost
    popyt <- matrix(rpois(n_modeli * 6, outer(lambda, udzial_rozm) / pmax(dost, 1e-9) * (zapas > 0)), n_modeli)
    sprzedaz <- pmin(popyt, zapas)
    przychod <- przychod + sum(rowSums(sprzedaz) * cena_reg * (1 - d))
    zapas <- zapas - sprzedaz
  }
  c(przychod_sezon = przychod, zapas_koniec = sum(zapas) / sum(zapas0),
    przychod_lacznie = przychod + odzysk * sum(rowSums(zapas) * cena_reg))
}

set.seed(7252)
B <- 1000
losowania <- MASS::mvrnorm(B, coef(mi_los), vcov(mi_los))     # elastyczność w tyg. 1 i jej zmiana na tydzień
wyniki <- do.call(rbind, lapply(seq_len(B), function(i) {
  b <- losowania[i, ]
  est$off <- log(est$dostepnosc) + (b[1] + b[2] * (est$tydzien - 1)) * est$lcena
  fe <- fixef(fepois(sprzedaz ~ 1 | model + tydzien, data = est, offset = ~off))    # poziom popytu modeli i tygodni
  fe_model <- fe$model[modele$model]; fe_model[is.na(fe_model)] <- -20
  do.call(rbind, lapply(names(strategie), function(s)
    data.frame(los = i, strategia = s, t(symuluj_strategie(b, fe_model, fe$tydzien[as.character(tyg)], strategie[[s]])))))
}))
wyniki$strategia <- factor(wyniki$strategia, levels = names(strategie))
podsum <- aggregate(cbind(przychod_sezon = przychod_sezon / 1e6, przychod_lacznie = przychod_lacznie / 1e6,
                          zapas_koniec = 100 * zapas_koniec) ~ strategia, data = wyniki,
                    FUN = function(x) round(c(sr = mean(x), q2.5 = quantile(x, .025, names = FALSE),
                                              q97.5 = quantile(x, .975, names = FALSE)), 2))
podsum
szer <- reshape(wyniki[, c("los", "strategia", "przychod_lacznie")], idvar = "los", timevar = "strategia", direction = "wide")
roznica <- (szer[["przychod_lacznie.wcześnie i płytko"]] - szer[["przychod_lacznie.późno i głęboko"]]) / 1e6
c(roznica_sr = mean(roznica), q2.5 = quantile(roznica, .025), q97.5 = quantile(roznica, .975),
  odsetek_wczesnie_lepiej = 100 * mean(roznica > 0))

# Kontrola: te same strategie przy prawdziwych parametrach (znamy je, bo dane są fikcyjne); 200 powtórzeń
udzial_est <- udzial_rozm; udzial_rozm <- udzial_popytu
prawda <- sapply(names(strategie), function(s) rowMeans(replicate(200,
  symuluj_strategie(c(elastycznosc[1], elastycznosc[2] - elastycznosc[1]), log(modele$zapas_start * modele$tempo),
                    log(sezon), strategie[[s]]))))
udzial_rozm <- udzial_est
round(rbind(przychod_sezon_mln = prawda[1, ] / 1e6, zapas_koniec_proc = 100 * prawda[2, ],
            przychod_lacznie_mln = prawda[3, ] / 1e6), 2)

kol_s <- c("bez przeceny" = "grey40", "wcześnie i płytko" = kol[["niebieski"]], "późno i głęboko" = kol[["cynober"]],
           "reguła sieci" = kol[["pomarańcz"]])
sr <- aggregate(cbind(zapas = 100 * zapas_koniec, przychod = przychod_lacznie / 1e6) ~ strategia, data = wyniki, FUN = mean)
sr$vjust <- c(-0.7, -0.7, 1.8, -0.7)                    # etykiety nad punktem, „późno i głęboko” – pod
pr <- data.frame(strategia = factor(names(strategie), levels = names(strategie)), zapas = 100 * prawda[2, ],
                 przychod = prawda[3, ] / 1e6)
p5 <- ggplot(wyniki, aes(100 * zapas_koniec, przychod_lacznie / 1e6, colour = strategia, shape = strategia)) +
  geom_point(data = wyniki[wyniki$los <= 200, ], alpha = 0.25, size = 1.2) +   # 200 z 1000 losowań (mniejszy plik)
  stat_ellipse(level = 0.95, linewidth = 0.8) +
  geom_point(data = sr, aes(zapas, przychod), size = 4, colour = "black", shape = 21, fill = "white", stroke = 1.2) +
  geom_point(data = pr, aes(zapas, przychod), size = 3.2, colour = "black", shape = 4, stroke = 1.3) +
  geom_text(data = sr, aes(zapas, przychod, label = sprintf("%s\n%.2f mln zł, zapas %.0f%%", strategia, przychod, zapas)),
            colour = "black", size = 3.6, vjust = sr$vjust, lineheight = 0.95) +
  scale_colour_manual(values = kol_s, name = NULL) + scale_shape_manual(values = c(16, 15, 17, 18), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), expand = expansion(mult = 0.08)) +
  scale_y_continuous(expand = expansion(mult = c(0.05, 0.15))) +
  guides(colour = guide_legend(override.aes = list(alpha = 1, size = 2.5))) +
  labs(title = "Przychód a zapas na koniec: 1000 losowań parametrów",
       subtitle = "Kółko – średnia z symulacji; krzyżyk – wynik przy prawdziwych parametrach",
       x = "Zapas niesprzedany po 12 tygodniach (% sztuk)", y = "Przychód z odsprzedażą resztek (mln zł)") + motyw
p5   # zapis: ggsave("przecena-konca-sezonu-strategie.svg", p5, width = 10, height = 6)
Wynik w R
          strategia przychod_sezon.sr przychod_sezon.q2.5 przychod_sezon.q97.5 przychod_lacznie.sr
1      bez przeceny             14.76               14.02                15.47               17.42
2 wcześnie i płytko             16.25               16.07                16.43               17.82
3   późno i głęboko             15.84               15.38                16.31               17.52
4      reguła sieci             15.62               15.19                16.04               17.81
  przychod_lacznie.q2.5 przychod_lacznie.q97.5 zapas_koniec.sr zapas_koniec.q2.5 zapas_koniec.q97.5
1                 16.83                  17.99           47.32             44.69              50.07
2                 17.69                  17.96           27.82             27.14              28.51
3                 17.14                  17.92           29.84             28.04              31.65
4                 17.43                  18.18           39.06             37.84              40.14
             roznica_sr               q2.5.2.5%             q97.5.97.5% odsetek_wczesnie_lepiej
             0.30015500             -0.07924687              0.66349217             94.40000000
                     bez przeceny wcześnie i płytko późno i głęboko reguła sieci
przychod_sezon_mln          13.94             16.25           15.51        15.27
zapas_koniec_proc           50.04             27.20           29.35        39.01
przychod_lacznie_mln        16.76             17.80           17.18        17.46
6. Rozmiary: co zostaje na półce – Rysunek 6
R
# Przepis 6. Pułapka rozmiarów: co zostaje na półce po 12 tygodniach – Rysunek 6
roz <- aggregate(cbind(start = zapas_pocz) ~ rozmiar, data = dane[dane$tydzien == 1, ], FUN = sum)
roz$sprzedano <- tapply(dane$sprzedaz, dane$rozmiar, sum)[as.character(roz$rozmiar)]
roz$zostalo <- roz$start - roz$sprzedano
roz$udzial_zapasu_start <- roz$start / sum(roz$start)
roz$udzial_resztek <- roz$zostalo / sum(roz$zostalo)
print(transform(roz, udzial_zapasu_start = round(100 * udzial_zapasu_start, 1), udzial_resztek = round(100 * udzial_resztek, 1),
                sprzedano_proc = round(100 * sprzedano / start, 1)), row.names = FALSE)
c(resztki_XS_XXL_proc = round(100 * sum(roz$udzial_resztek[roz$rozmiar %in% c("XS", "XXL")]), 1))

# Ile modeli ma na półce pełną rozmiarówkę (wszystkie 6 rozmiarów) na początku tygodnia
pelna <- aggregate(cbind(rozmiarow = zapas_pocz > 0) ~ model + tydzien, data = dane, FUN = sum)
pelna <- aggregate(cbind(pelna = rozmiarow == 6, bez_M_lub_L = rozmiarow < 6) ~ tydzien, data = pelna, FUN = mean)
mlz <- aggregate(cbind(brak_ML = zapas_pocz == 0) ~ model + tydzien, data = dane[dane$rozmiar %in% c("M", "L"), ], FUN = max)
pelna$brak_M_lub_L <- tapply(mlz$brak_ML, mlz$tydzien, mean)
pelna$bez_M_lub_L <- NULL
print(round(pelna[pelna$tydzien %in% c(1, 4, 8, 12), ], 3), row.names = FALSE)

roz_d <- rbind(data.frame(rozmiar = roz$rozmiar, co = "zapas na początku", udzial = roz$udzial_zapasu_start),
               data.frame(rozmiar = roz$rozmiar, co = "zapas po 12 tygodniach", udzial = roz$udzial_resztek),
               data.frame(rozmiar = roz$rozmiar, co = "popyt klientów", udzial = udzial_popytu))
roz_d$co <- factor(roz_d$co, levels = c("popyt klientów", "zapas na początku", "zapas po 12 tygodniach"))
pA <- ggplot(roz_d, aes(rozmiar, udzial, fill = co)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75, colour = "white") +
  geom_text(data = roz_d[roz_d$co == "zapas po 12 tygodniach", ], aes(label = sprintf("%.0f%%", 100 * udzial)),
            position = position_nudge(x = 0.27), vjust = -0.4, size = 3.4) +
  scale_fill_manual(values = c("grey70", kol[["błękit"]], kol[["cynober"]]), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), expand = expansion(mult = c(0, 0.1))) +
  guides(fill = guide_legend(nrow = 2)) +
  labs(title = "A. Struktura rozmiarów", x = NULL, y = "Udział w sztukach") + motyw
pel_d <- rbind(data.frame(tydzien = pelna$tydzien, co = "pełna rozmiarówka (6 z 6)", odsetek = pelna$pelna),
               data.frame(tydzien = pelna$tydzien, co = "brak M lub L", odsetek = pelna$brak_M_lub_L))
pB <- ggplot(pel_d, aes(tydzien, odsetek, colour = co, linetype = co, shape = co)) +
  geom_line(linewidth = 1) + geom_point(size = 2.4) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("longdash", "solid"), name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(breaks = c(1, 4, 8, 12)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(title = "B. Modele z dziurami w rozmiarach", x = "Tydzień końca sezonu", y = "Odsetek modeli") + motyw
p6 <- pA + pB + plot_layout(widths = c(1.4, 1))
p6   # zapis: ggsave("przecena-konca-sezonu-rozmiary.svg", p6, width = 10, height = 5.6)
Wynik w R
 rozmiar start sprzedano zostalo udzial_zapasu_start udzial_resztek sprzedano_proc
      XS  3090      1521    1569                10.2           17.2           49.2
       S  5029      3465    1564                16.6           17.2           68.9
       M  6907      5561    1346                22.9           14.8           80.5
       L  6966      5431    1535                23.1           16.9           78.0
      XL  4877      3417    1460                16.1           16.0           70.1
     XXL  3349      1717    1632                11.1           17.9           51.3
resztki_XS_XXL_proc
               35.2
 tydzien pelna brak_M_lub_L
       1 0.997        0.000
       4 0.880        0.077
       8 0.600        0.307
      12 0.383        0.513
7. Grafika: schemat „zapas – tygodnie – przecena” – Rysunek 1
R
# Przepis 7. Grafika: schemat „zapas – tygodnie – przecena” – Rysunek 1
zostalo <- sapply(tyg, function(t) sum(mt$zapas_pocz[mt$tydzien == t])) / sum(modele$zapas_start)  # zapas na początku tyg.
plan <- strategie[["wcześnie i płytko"]]
pas <- data.frame(tydzien = tyg, zapas = zostalo, cena = 1 - plan, sezon = sezon, el = elastycznosc)
round(pas, 2)

decyzje <- data.frame(tydzien = c(4, 7, 10), cel = sprintf("tydz. %d:\nsprzedano\n< %d%%?", c(4, 7, 10), round(100 * cel)))
p7 <- ggplot() +
  # pas 1: zapas (słupki)
  geom_rect(data = pas, aes(xmin = tydzien - 0.4, xmax = tydzien + 0.4, ymin = 3, ymax = 3 + 1.6 * zapas),
            fill = kol[["błękit"]], colour = kol[["niebieski"]]) +
  geom_text(data = pas[c(1, 6, 12), ], aes(tydzien, 3 + 1.6 * zapas + 0.18, label = sprintf("%.0f%%", 100 * zapas)),
            size = 3.6, colour = "#0f1d3a") +
  annotate("text", x = 0.2, y = 3.8, label = "ZAPAS\n(% sztuk\nna półce)", hjust = 1, size = 3.8, fontface = "bold",
           colour = "#0f1d3a", lineheight = 0.95) +
  # pas 2: cena (schodki) – przykład planu „wcześnie i płytko”
  geom_step(data = rbind(pas, transform(pas[12, ], tydzien = 12.999)), aes(tydzien - 0.5, 1.2 + 1.1 * cena),
            colour = kol[["cynober"]], linewidth = 1.4) +
  annotate("text", x = c(1.5, 4.5, 9.5), y = 1.2 + 1.1 * c(1, 0.8, 0.7) + 0.2, label = c("100%", minus("−20%"), minus("−30%")),
           size = 3.8, colour = kol[["cynober"]], fontface = "bold") +
  annotate("text", x = 0.2, y = 2.0, label = "CENA\n(% ceny\nregularnej)", hjust = 1, size = 3.8, fontface = "bold",
           colour = "#0f1d3a", lineheight = 0.95) +
  # pas 3: decyzje i słabnący popyt
  geom_tile(data = decyzje, aes(tydzien, 0.45), width = 1.7, height = 0.8, fill = "#FDF1E9", colour = kol[["cynober"]]) +
  geom_text(data = decyzje, aes(tydzien, 0.45, label = cel), size = 3.3, lineheight = 0.9) +
  annotate("segment", x = 0.6, xend = 12.4, y = -0.35, yend = -0.35, linewidth = 0.8,
           arrow = arrow(length = unit(0.25, "cm")), colour = "grey30") +
  annotate("text", x = 6.5, y = -0.6, size = 3.6, colour = "grey20",
           label = minus("popyt słabnie: sezon 1.00 → 0.34, elastyczność −3.0 → −1.8")) +
  annotate("text", x = 0.2, y = 0.45, label = "DECYZJA\nreguły\nsieci", hjust = 1, size = 3.8, fontface = "bold",
           colour = "#0f1d3a", lineheight = 0.95) +
  annotate("label", x = 13.6, y = 3.6, label = "Po tyg. 12:\nresztki\nza 20% ceny", size = 3.6, lineheight = 0.95,
           fill = "grey95", linewidth = 0.3) +
  scale_x_continuous(breaks = tyg, limits = c(-1.6, 14.6), expand = expansion(0)) +
  scale_y_continuous(limits = c(-0.8, 4.9)) +
  labs(title = "Zapas – tygodnie – przecena: co się dzieje w 12 tygodniach końca sezonu",
       x = "Tydzień końca sezonu", y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major = element_blank())
p7   # zapis: ggsave("przecena-konca-sezonu-schemat.svg", p7, width = 10, height = 5.6)
Wynik w R
   tydzien zapas cena sezon    el
1        1  1.00  1.0  1.00 -3.00
2        2  0.90  1.0  0.94 -2.89
3        3  0.81  0.8  0.88 -2.78
4        4  0.73  0.8  0.82 -2.67
5        5  0.65  0.8  0.76 -2.56
6        6  0.58  0.8  0.70 -2.45
7        7  0.52  0.7  0.64 -2.35
8        8  0.47  0.7  0.58 -2.24
9        9  0.43  0.7  0.52 -2.13
10      10  0.39  0.7  0.46 -2.02
11      11  0.35  0.7  0.40 -1.91
12      12  0.32  0.7  0.34 -1.80
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("wcześnie i płytko – późno i głęboko" = c("#0072B2", "#D55E00"),
             "późno i głęboko – reguła sieci" = c("#D55E00", "#E69F00"),
             "M i L – S i XL" = c("#0072B2", "#E69F00"), "−20% – −30% (krzywa)" = c("#56B4E9", "#0072B2"),
             "bez przeceny – reguła sieci" = c("grey40", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                    widzenie_typowe deuteranopia protanopia
wcześnie i płytko – późno i głęboko           114.6        108.3       91.9
późno i głęboko – reguła sieci                 33.4         18.4       24.9
M i L – S i XL                                120.2        121.5      109.3
−20% – −30% (krzywa)                           26.4         24.7       24.6
bez przeceny – reguła sieci                    81.2         79.1       73.7
czerwony – zielony (do unikania)              121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i obliczenia pomocnicze – pakiet stats i funkcje podstawowej instalacji R. Estymator Kaplana–Meiera – pakiet survival, regresja Poissona z efektami stałymi i błędami grupowanymi – pakiet fixest, losowanie z wielowymiarowego rozkładu normalnego – pakiet MASS. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- fixest (wersja 0.14.2): Bergé, L. (2018). Efficient estimation of maximum likelihood models with multiple fixed-effects: The R package FENmlm (CREA Discussion Paper No. 2018-13). University of Luxembourg. https://CRAN.R-project.org/package=fixest
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Przeceniane są tylko słabe modele – naiwna elastyczność wyszła 0.39 zamiast ok. −2.4.
- Efekty stałe nie wystarczą, gdy cena reaguje na bieżącą sprzedaż (−4.04 zamiast −3.0); o założeniach estymatora – dane panelowe: FE, RE i test Hausmana.
- Zostają skrajne rozmiary. Uwzględnij dostępność rozmiarów w modelu, a dzienne braki – jako cenzurowanie sprzedaży.
- Jedna elastyczność na cały sezon ukrywa zmianę reakcji klientów w czasie – najważniejszą dla decyzji „kiedy”.
- Wartość resztek. Gdy resztki można przechować do kolejnego sezonu, są warte więcej niż 20% – sprawdź wynik dla kilku założeń.
Najczęstsze pytania
Jak policzyć krzywą wyprzedaży (sell-through)?
Dla każdego tygodnia zsumuj sprzedane sztuki od początku okresu i podziel przez zapas na początku. W przykładzie po 12 tygodniach sieć sprzedała 69.9% zapasu. Jeśli modele wchodzą do sprzedaży lub schodzą z niej w różnych tygodniach, użyj estymatora Kaplana–Meiera, traktując sztuki niesprzedane jako obserwacje cenzurowane.
Dlaczego elastyczność cenowa z historii przecen bywa błędna?
Bo sieć przecenia zwykle modele, które sprzedają się słabo. Atrakcyjność modelu wpływa wtedy i na cenę, i na sprzedaż. W przykładzie naiwna regresja dała elastyczność 0.39, jakby przecena zmniejszała sprzedaż, a model z efektami stałymi – przesadzoną (−4.04 w tygodniu 1 wobec prawdziwych −3.0). Najpewniejszy jest test z losowym harmonogramem przecen.
Jak sprawdzić, czy elastyczność zmienia się w trakcie sezonu?
Dodaj do regresji interakcję logarytmu ceny z numerem tygodnia. Współczynnik przy log(cenie) to elastyczność w pierwszym tygodniu, a interakcja – jej zmiana na tydzień. W przykładzie elastyczność słabła o 0.075 na tydzień (p = .007): przecena o 20% podnosiła sprzedaż o ok. 73% w tygodniu 1 i o 44% w tygodniu 12.
Lepiej przeceniać wcześnie i płytko czy późno i głęboko?
To zależy od danych, ale gdy popyt i reakcja na cenę słabną z czasem, zwykle wygrywa wcześniejsza, płytsza przecena. W symulacji z 1000 losowaniami parametrów dała 17.82 mln zł wobec 17.52 mln zł i mniej zapasu na koniec (27.8% wobec 29.8%); przewaga była dodatnia w 94.4% losowań.
Dlaczego po wyprzedaży zostają skrajne rozmiary?
Bo zapas zamawia się bardziej równomiernie, niż kupują klienci. W przykładzie XS i XXL to 21.3% zapasu na początku, ale 35.2% resztek, a pod koniec ponad połowa modeli nie miała rozmiaru M lub L. Brak rozmiarów obniża sprzedaż niezależnie od ceny, więc uwzględnij dostępność rozmiarów w modelu.
Powiązane hasła
Przeczytaj też
Głębokość rabatu a sprzedaż
Sieć sklepów z elektroniką: krzywa odpowiedzi na rabat 10–40%, dołek po promocji, kanibalizacja, zysk zamiast przychodu i pułapka dobrych tygodni – z kodem R.
Czytaj →PoradnikElastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikModel gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →Analizujesz przeceny albo piszesz o nich pracę?
Pomożemy oszacować elastyczność cenową z danych sprzedażowych, oddzielić efekt przeceny od wyboru przecenianych produktów, zaplanować test i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bijmolt, T. H. A., van Heerde, H. J., & Pieters, R. G. M. (2005). New empirical generalizations on the determinants of price elasticity. Journal of Marketing Research, 42(2), 141–156. https://doi.org/10.1509/jmkr.42.2.141.62296
- Caro, F., & Gallien, J. (2012). Clearance pricing optimization for a fast-fashion retailer. Operations Research, 60(6), 1404–1422. https://doi.org/10.1287/opre.1120.1102 ● Otwarty dostęp: pełny tekst
- Elmaghraby, W., & Keskinocak, P. (2003). Dynamic pricing in the presence of inventory considerations: Research overview, current practices, and future directions. Management Science, 49(10), 1287–1309. https://doi.org/10.1287/mnsc.49.10.1287.17315
- Gallego, G., & van Ryzin, G. (1994). Optimal dynamic pricing of inventories with stochastic demand over finite horizons. Management Science, 40(8), 999–1020. https://doi.org/10.1287/mnsc.40.8.999
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Smith, S. A., & Achabal, D. D. (1998). Clearance pricing and inventory policies for retail chains. Management Science, 44(3), 285–300. https://doi.org/10.1287/mnsc.44.3.285
- Villas-Boas, J. M., & Winer, R. S. (1999). Endogeneity in brand choice models. Management Science, 45(10), 1324–1338. https://doi.org/10.1287/mnsc.45.10.1324
Cytowania BibTeX
@article{bijmolt2005new, author={Bijmolt, Tammo H. A. and van Heerde, Harald J. and Pieters, Rik G. M.}, title={{New empirical generalizations on the determinants of price elasticity}}, journal={Journal of Marketing Research}, year={2005}, volume={42}, number={2}, pages={141--156}, doi={10.1509/jmkr.42.2.141.62296}}@article{caro2012clearance, author={Caro, Felipe and Gallien, Jérémie}, title={{Clearance pricing optimization for a fast-fashion retailer}}, journal={Operations Research}, year={2012}, volume={60}, number={6}, pages={1404--1422}, doi={10.1287/opre.1120.1102}}@article{elmaghraby2003dynamic, author={Elmaghraby, Wedad and Keskinocak, Pınar}, title={{Dynamic pricing in the presence of inventory considerations: Research overview, current practices, and future directions}}, journal={Management Science}, year={2003}, volume={49}, number={10}, pages={1287--1309}, doi={10.1287/mnsc.49.10.1287.17315}}@article{gallego1994optimal, author={Gallego, Guillermo and van Ryzin, Garrett}, title={{Optimal dynamic pricing of inventories with stochastic demand over finite horizons}}, journal={Management Science}, year={1994}, volume={40}, number={8}, pages={999--1020}, doi={10.1287/mnsc.40.8.999}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{smith1998clearance, author={Smith, Stephen A. and Achabal, Dale D.}, title={{Clearance pricing and inventory policies for retail chains}}, journal={Management Science}, year={1998}, volume={44}, number={3}, pages={285--300}, doi={10.1287/mnsc.44.3.285}}@article{villasboas1999endogeneity, author={Villas-Boas, J. Miguel and Winer, Russell S.}, title={{Endogeneity in brand choice models}}, journal={Management Science}, year={1999}, volume={45}, number={10}, pages={1324--1338}, doi={10.1287/mnsc.45.10.1324}}