Przykład: nowa myjnia bezdotykowa
Fikcyjny przedsiębiorca pisze biznesplan myjni bezdotykowej z czterema stanowiskami. Bank pyta: ile myć miesięcznie trzeba sprzedać, żeby nie dokładać do interesu, i jak duża jest szansa, że pierwszy rok skończy się stratą? Pierwsze to próg rentowności (break-even point). Drugie wymaga symulacji Monte Carlo, bo popyt, ceny wody i energii oraz zima są niepewne.
Dane są fikcyjne, a wszystkie założenia ustaliliśmy ręcznie „z głowy”, jak właściciel z dostawcą urządzeń: nakład 1.2 mln zł (amortyzacja 10 lat, czyli 10 000 zł miesięcznie), koszty stałe gotówkowe 21 000 zł miesięcznie, 0.07 m³ wody i 1.5 kWh prądu na mycie, chemia i prowizje 2.00 zł na mycie, ogrzewanie stanowisk zimą 6000 kWh miesięcznie, otwarcie w marcu, wynik przed podatkiem. Po pierwszym uruchomieniu zwiększyliśmy ogrzewanie z 4000 do 6000 kWh i jego wrażliwość na mróz z 0.50 do 0.60, żeby efekt skorelowanych wejść (rysunek 6) był wyraźny; ziaren (711 i 7111) nie zmienialiśmy. Wpis ma charakter metodologiczny: pokazuje, jak policzyć i opisać ryzyko, a nie czy inwestować. 10 000 scenariuszy pobierzesz jako prog-rentownosci-myjnia-symulacje.csv (wiersz = scenariusz).
Wpis uzupełnia symulację Monte Carlo opłacalności projektu (NPV): tu liczymy próg rentowności, miesiące z sezonem, pierwszy rok i czas zwrotu małej firmy.
Rysunek 1: od niepewnych wejść do rozkładu zysku
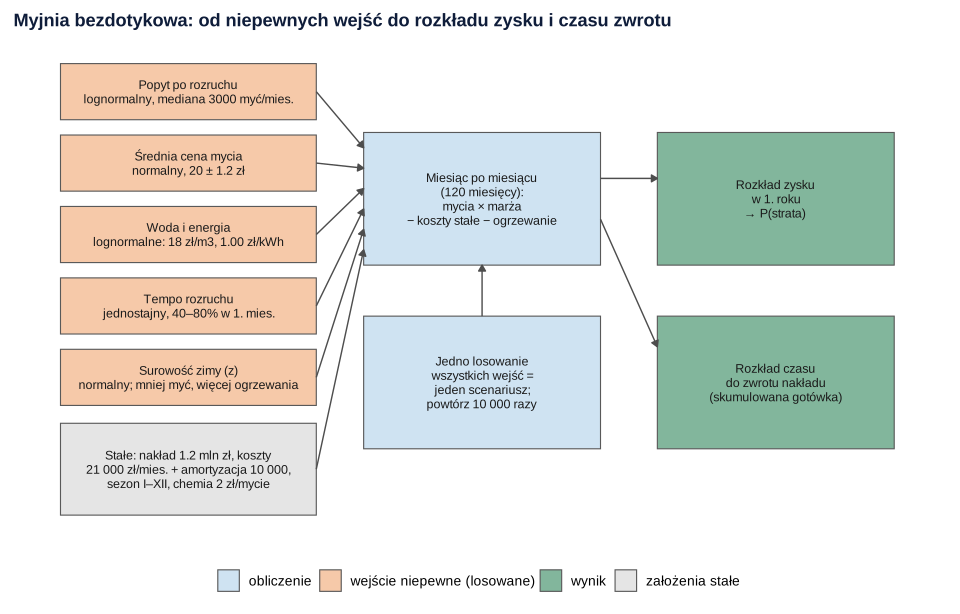
Co widać. Model liczy każdy miesiąc: liczba myć × marża − koszty stałe − ogrzewanie, a liczba myć to popyt × indeks sezonowy × rozruch × wpływ zimy. Sezonowość przyjęliśmy od 0.80 w styczniu do 1.15 w kwietniu i maju (średnia 1). Niepewne są:
- popyt po rozruchu – rozkład lognormalny z medianą 3000 myć miesięcznie i σ logarytmu 0.25;
- średnia cena mycia – rozkład normalny 20 zł, SD = 1.2;
- cena wody i ścieków oraz cena energii – lognormalne z medianami 18 zł/m³ i 1.00 zł/kWh (σ 0.15 i 0.20);
- tempo rozruchu – rozkład jednostajny: w 1. miesiącu od 40% do 80% docelowego popytu, liniowo do 100% w 12. miesiącu;
- surowość każdej zimy – z ze standardowego rozkładu normalnego; sroga zima (z > 0) zmniejsza liczbę myć w XII–II o 15% na jedno odchylenie i zwiększa zużycie prądu na ogrzewanie o 60% (również na jedno odchylenie).
Liczba myć w miesiącu ma rozkład Poissona wokół wartości oczekiwanej.
Jak może zmylić. Schemat wygląda jak model „z danych”, a każda strzałka to założenie właściciela. Kim (1973) zbudował modele, w których w rachunku koszt–wolumen–zysk cena i koszty są zmiennymi losowymi – ale ich rozkłady trzeba jakoś uzasadnić (zob. pułapki na końcu wpisu).
Podpis do pracy:
Rysunek 2: próg rentowności – wzór i rachunek
Próg rentowności to liczba myć, przy której przychód pokrywa wszystkie koszty. Słowami: koszty stałe dzielimy przez marżę na jednym myciu (cena minus koszt zmienny):
gdzie F to koszty stałe w miesiącu, p – średnia cena mycia, v – koszt zmienny mycia. Przy wartościach bazowych v = 0.07 × 18 + 1.5 × 1.00 + 2.00 = 4.76 zł, marża = 20 − 4.76 = 15.24 zł, a F = 21 000 + 10 000 (amortyzacja) = 31 000 zł. Stąd Q* = 31 000 / 15.24 = 2034 mycia miesięcznie. Bez amortyzacji (próg gotówkowy) wystarczy 1378 myć, ale w zimowym miesiącu, gdy dochodzi 6000 zł za ogrzewanie, potrzeba już 2428.
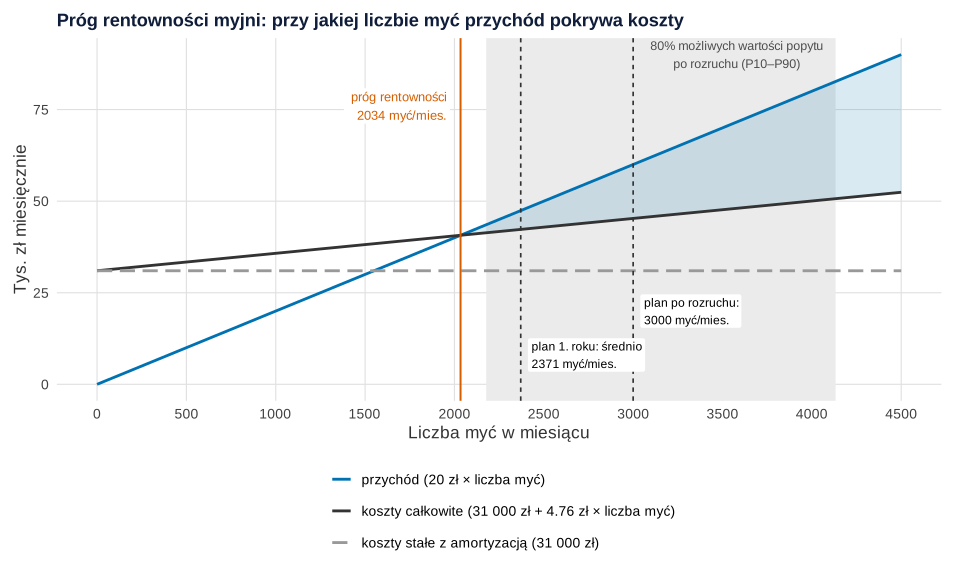
Co widać. Na prawo od progu niebieskie pole to zysk. Plan po rozruchu (3000 myć) daje 14 720 zł zysku miesięcznie, a margines bezpieczeństwa – o ile popyt może spaść, zanim pojawi się strata – wynosi 32.2%. W pierwszym roku plan zakłada średnio tylko 2371 myć (rozruch i sezon), czyli niewiele ponad próg: zysk roczny wynosi 37 592 zł, a marzec i styczeń są na minusie (−6568 i −1754 zł).
Jak może zmylić. Wykres pokazuje jeden „średni” miesiąc i jedną cenę. Próg sam jest niepewny: w symulacji (rysunek 3) jego 80% wartości mieści się między 1842 a 2278 myciami, bo zależy od ceny i kosztów. Jaedicke i Robichek (1964) zauważyli, że klasyczny rachunek koszt–wolumen–zysk pomija ryzyko, i zaproponowali podawanie prawdopodobieństw różnych poziomów zysku i straty – to robimy dalej.
Podpis do pracy:
Rysunek 3: 10 000 scenariuszy pierwszego roku
Jeden scenariusz to jedno losowanie wszystkich wejść i policzenie 120 miesięcy. Powtarzamy to 10 000 razy i oglądamy histogram zysku w pierwszym roku.
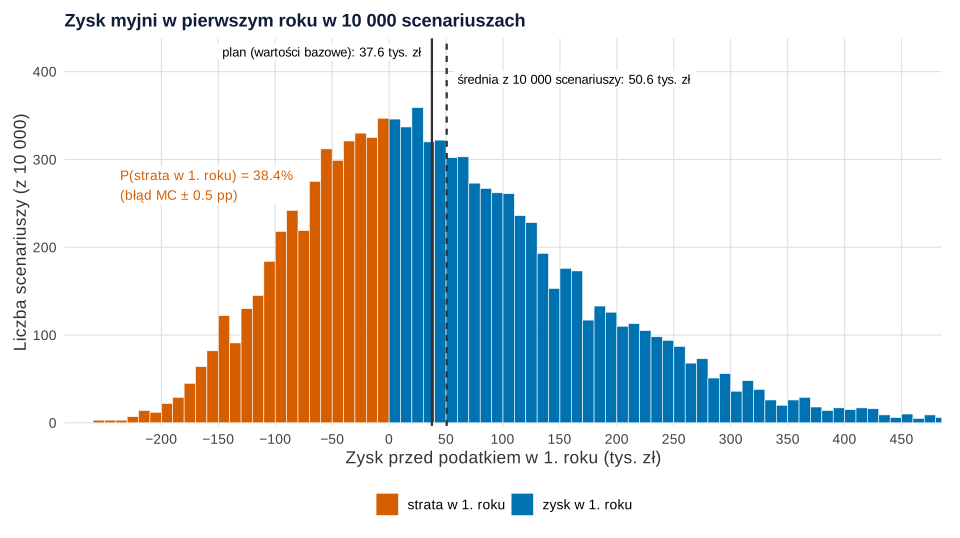
set.seed(711)).Co widać. Plan obiecuje 37 592 zł, a w 38.4% scenariuszy pierwszy rok kończy się stratą. To oszacowanie z symulacji, więc ma błąd Monte Carlo √(p(1 − p)/R) = 0.49 punktu procentowego; 95% przedział to 37.5–39.4%. Gdy myjnia traci, to średnio 68 744 zł, a strata ponad 50 000 zł zdarza się w 22.2% scenariuszy. 90% wyników mieści się między −129 694 a 283 872 zł (percentyle P5 i P95).
Średnia (50 583 zł) jest wyższa niż plan, a mediana (34 063 zł) niższa, bo rozkład popytu jest prawostronnie skośny. Wartość oczekiwana nie mówi, jak często będzie źle.
Jak może zmylić. P(strata) dotyczy modelu, a nie świata: nie ma w nim np. nowej konkurencji obok. Poza osią (−250 do 450 tys. zł) jest 0.82% scenariuszy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: czas do zwrotu nakładu
Strata w pierwszym roku nie przesądza o inwestycji. Drugie pytanie brzmi: po ilu miesiącach skumulowana gotówka (wynik przed amortyzacją i podatkiem) odda 1.2 mln zł nakładu? Plan: po 57 miesiącach.
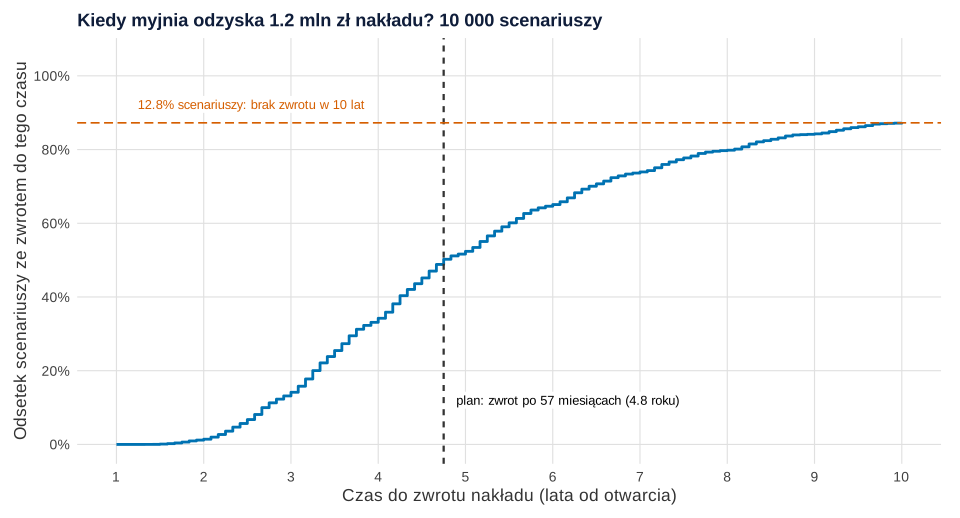
set.seed(711)).Co widać. Na osi pionowej czytasz, jaki odsetek scenariuszy zwraca nakład do danego czasu (dystrybuanta empiryczna). Mediana to 4.8 roku – tyle co plan – ale rozrzut jest duży: P10 = 2.8 roku, a w 12.8% scenariuszy (błąd MC 0.33 pp) nakład nie wraca w 10 lat. Do 5 lat zwraca się 52.4% scenariuszy, dłużej niż 7 lat czeka 26.1%. Wśród scenariuszy ze stratą w 1. roku 66.9% zwraca nakład w 10 lat.
Jak może zmylić. Prosty okres zwrotu nie dyskontuje pieniędzy i pomija to, co dzieje się po zwrocie; do pełnej oceny użyj NPV, jak we wspomnianym wpisie o symulacji NPV.
Podpis do pracy:
Rysunek 5: wykres tornado – co decyduje o wyniku
Wykres tornado zmienia jedno wejście naraz – od 10. do 90. percentyla jego rozkładu – przy pozostałych na wartościach bazowych i porządkuje wejścia od największego wpływu. Eschenbach (1992) zwraca uwagę, że taki diagram w prosty sposób podsumowuje wpływ wielu zmiennych. Dodaliśmy nielosowane koszty stałe ±10%.
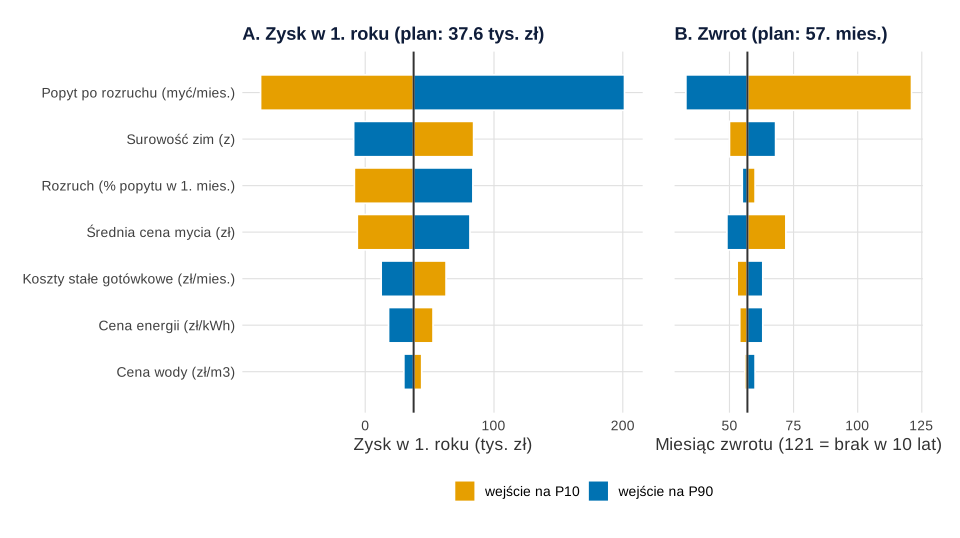
Co widać. O wszystkim decyduje popyt: przy P10 (2178 myć) pierwszy rok traci 81 270 zł, a nakład nie wraca w 10 lat; przy P90 (4133) zysk to 201 343 zł, a zwrot – po 33 miesiącach. Na drugim miejscu dla 1. roku jest surowość zim (od 84 179 zł przy łagodnej do −8995 zł przy srogiej), na trzecim rozruch (od −8427 do 83 611 zł). Ale w panelu B rozruch prawie znika (zwrot po 60 albo 55 miesiącach), a ważniejsza staje się cena (72 vs 49 miesięcy). Rozruch przesuwa pieniądze w czasie, a cena działa co miesiąc przez 10 lat.
Jak może zmylić. Tornado bada „korytarze” wokół planu i pomija kombinacje, np. słaby popyt razem z drogą energią. Do tego służy cała symulacja (rysunek 3). Zob. hasło analiza wrażliwości.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: skorelowane wejścia – sroga zima uderza dwa razy
W modelu ta sama mroźna zima robi dwie rzeczy naraz: mniej klientów przyjeżdża, a ogrzewanie stanowisk zużywa więcej prądu. Wejścia są więc skorelowane: w zimowym kwartale korelacja liczby myć i kosztu ogrzewania wynosi −.46. Dla porównania liczymy wariant niezależny: te same mycia, ale koszt ogrzewania z innej, niezależnie wylosowanej zimy (set.seed(7111)).
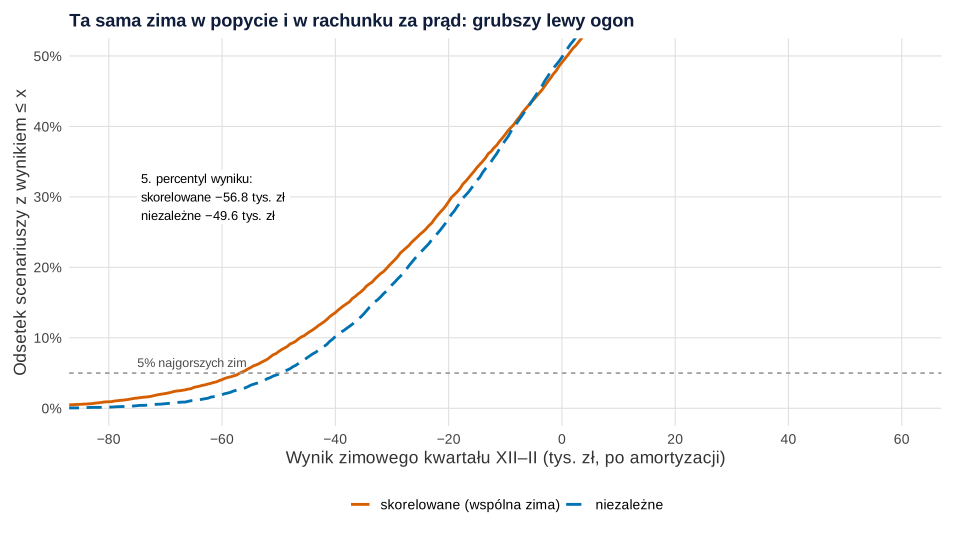
set.seed(711) i set.seed(7111)).Co widać. Średni wynik kwartału XII–II prawie się nie zmienia (4585 vs 4412 zł), ale lewy ogon jest grubszy, gdy zima działa na oba wejścia naraz: SD rośnie z 37 743 do 42 153 zł, 5. percentyl spada z −49 635 do −56 759 zł, a 1. percentyl z −65 884 do −79 258 zł. Pominięcie korelacji zaniża więc stratę w najgorszej zimie o ok. 13 000 zł.
Jak może zmylić. W skali całego roku efekt się rozmywa (P(strata) 38.4% vs 38.3%, strata ponad 100 000 zł w 9.56% vs 9.08% scenariuszy) – korelację widać w kwartale i w ogonie, nie w średniej.
Podpis do pracy:
Co z tym zrobić w firmie
- Pokaż bankowi rozkład, nie jedną liczbę. Próg 2034 myć, plan 37 592 zł w 1. roku, ale 38.4% szans na stratę i 12.8% na brak zwrotu w 10 lat.
- Zaplanuj rezerwę gotówki na pierwszy rok i zimę – np. z 5. percentyla wyniku, a nie z planu. Korelacja zimy dodaje do straty w złym kwartale ok. 13 000 zł.
- Kupuj informację tam, gdzie wskazuje tornado: liczenie ruchu na dojeździe i cen w okolicy da więcej niż negocjowanie taryfy za wodę.
- Rozruch to sprawa płynności, cena – opłacalności. Promocja otwarcia może przyspieszyć rozruch, ale średnia cena niższa o 1.54 zł (18.46 zł, P10) wydłuża zwrot z 57 do 72 miesięcy.
- Porównuj plan co miesiąc z wykonaniem i rozbijaj różnicę na cenę i liczbę myć – jak w analizie odchylenia plan–wykonanie. Jeśli myjnia obsługuje floty firmowe na fakturę, ryzyko gotówki dotyczy też terminów zapłaty (zob. opóźnienia płatności faktur).
Jak opisać w pracy
Próg rentowności z symulacją pasuje do prac z finansów, rachunkowości zarządczej i przedsiębiorczości (zob. statystyka w pracy z finansów i rachunkowości). Symulację traktuj jak każde badanie symulacyjne: Morris i in. (2019) proponują planować i raportować je według stałego schematu.
W Wynikach użyj zdań spod rysunków 3 i 5, a w ograniczeniach napisz wprost, że rozkłady pochodzą z ocen, a nie z danych,. O strukturze całej pracy przeczytasz we wpisie jak napisać pracę z finansów i rachunkowości.
Kod R: próg rentowności, symulacja Monte Carlo, czas zwrotu i tornado
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków w bazowym R i ggplot2 – bez pakietów do analizy ryzyka. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i funkcję miesiecznie(), przepis 3 – symulacje, z których korzystają kolejne. Do zapisu wykresu p1–p6 w SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 3 i 6; każdy zaczyna od własnego set.seed() (711 i 7111). Ziaren nie zmienialiśmy po pierwszym uruchomieniu. Ręcznie ustalono wszystkie parametry modelu i rozkładów (podane w przepisach 1 i 3 i na początku wpisu), liczbę symulacji (10 000) i warianty w przepisie 7; po pierwszym uruchomieniu zwiększyliśmy zużycie prądu na ogrzewanie z 4000 do 6000 kWh i jego wrażliwość na mróz z 0.50 do 0.60. Całość liczy się w kilka sekund.
1. Paleta, model miesięczny i próg rentowności: Rysunek 1
R
# Rysunek 1. Fikcyjna myjnia bezdotykowa (4 stanowiska): model miesięczny, próg rentowności i plan 1. roku
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "\u2212", format(x, trim = TRUE, scientific = FALSE))   # znak minus (U+2212) na osiach

# Założenia stałe (ustalone ręcznie przez autora przykładu, nie z danych): nakład 1.2 mln zł, amortyzacja 10 lat,
# koszty stałe gotówkowe 21 000 zł/mies., zużycie 0.07 m3 wody i 1.5 kWh na mycie, chemia i prowizje 2.00 zł/mycie,
# ogrzewanie stanowisk zimą 6000 kWh/mies. (XII–II; w XI i III połowa), start w marcu, wynik przed podatkiem
stale <- list(naklad = 1.2e6, amort = 1.2e6 / 120, koszty_got = 21000, woda_m3 = 0.07, kwh_mycie = 1.5,
              chemia = 2.00, kwh_grzanie = 6000, b_popyt = 0.15, b_grzanie = 0.60, miesiace = 120)
# Indeks sezonowy liczby myć (średnia = 1) i waga zimy dla miesięcy I–XII
sezon <- c(0.80, 0.85, 1.00, 1.15, 1.15, 1.05, 1.00, 0.95, 1.05, 1.10, 1.00, 0.90)
zima  <- c(1, 1, 0.5, 0, 0, 0, 0, 0, 0, 0, 0.5, 1)
# Wartości bazowe (plan właściciela) niepewnych wejść
baza <- c(popyt = 3000, cena = 20, woda = 18, energia = 1.00, rozruch = 0.60, zima = 0)
# popyt – myć/mies. po rozruchu; cena – średni przychód netto z mycia (zł); woda – zł/m3 z odprowadzeniem ścieków;
# energia – zł/kWh; rozruch – odsetek docelowego popytu w 1. miesiącu (do 100% w 12. miesiącu); zima – surowość (z)

m <- seq_len(stale$miesiace)
kal <- (m + 1) %% 12 + 1                     # miesiąc kalendarzowy: m = 1 to marzec
sezon_zimy <- (m + 2 + 1) %/% 12             # numer zimy (XI–III): 0 = marzec otwarcia, 1 = pierwsza pełna zima, ...
rampa <- function(a0) outer(a0, pmin(1, (m - 1) / 11), function(a, t) a + (1 - a) * t)

# Wynik miesięczny (zł) – działa na wektorach scenariuszy; z – macierz surowości zim (wiersz = scenariusz, kolumna = zima 0–10)
miesiecznie <- function(popyt, cena, woda, energia, rozruch, z_popyt, z_grzanie = z_popyt, s = stale, losuj = FALSE) {
  zp <- z_popyt[, sezon_zimy + 1, drop = FALSE]; zg <- z_grzanie[, sezon_zimy + 1, drop = FALSE]
  w <- matrix(zima[kal], nrow(zp), length(m), byrow = TRUE)
  mnoznik <- pmax(0.3, 1 - s$b_popyt * w * zp)                     # sroga zima (z > 0) = mniej myć
  oczek <- popyt * rampa(rozruch) * matrix(sezon[kal], nrow(zp), length(m), byrow = TRUE) * mnoznik
  myc <- if (losuj) matrix(rpois(length(oczek), oczek), nrow(oczek)) else oczek
  v <- s$woda_m3 * woda + s$kwh_mycie * energia + s$chemia          # koszt zmienny mycia (zł)
  grzanie <- s$kwh_grzanie * w * pmax(0, 1 + s$b_grzanie * zg) * energia  # sroga zima = więcej prądu na ogrzewanie
  list(myc = myc, gotowka = myc * (cena - v) - s$koszty_got - grzanie)  # przepływ przed podatkiem (bez amortyzacji)
}

# Próg rentowności: koszty stałe / marża jednostkowa (z amortyzacją – próg księgowy, bez niej – gotówkowy)
v_baza <- stale$woda_m3 * baza[["woda"]] + stale$kwh_mycie * baza[["energia"]] + stale$chemia
marza <- baza[["cena"]] - v_baza
prog <- data.frame(koszt_zmienny_zl = v_baza, marza_jednostkowa_zl = marza,
                   prog_ksiegowy_myc = (stale$koszty_got + stale$amort) / marza,
                   prog_gotowkowy_myc = stale$koszty_got / marza,
                   prog_ksiegowy_zima_myc = (stale$koszty_got + stale$amort + stale$kwh_grzanie * baza[["energia"]]) / marza,
                   margines_bezpieczenstwa_proc = 100 * (1 - (stale$koszty_got + stale$amort) / marza / baza[["popyt"]]))
print(round(prog, 2), row.names = FALSE)

# Plan 1. roku przy wartościach bazowych (bez losowania)
z0 <- matrix(0, 1, 11)
plan <- miesiecznie(baza[["popyt"]], baza[["cena"]], baza[["woda"]], baza[["energia"]], baza[["rozruch"]], z0)
rok1 <- data.frame(miesiac = as.character(as.roman(kal[1:12])), myc = round(plan$myc[1, 1:12]),
                   wynik_zl = round(plan$gotowka[1, 1:12] - stale$amort))
print(rok1, row.names = FALSE)
data.frame(myc_rok1 = round(sum(plan$myc[1, 1:12])), srednio_myc_mies = round(mean(plan$myc[1, 1:12])),
           zysk_rok1_zl = round(sum(plan$gotowka[1, 1:12]) - 12 * stale$amort),
           zwrot_mies = which(cumsum(plan$gotowka[1, ]) >= stale$naklad)[1])

# Rysunek 1: schemat „wejścia → model → rozkład zysku”
pola <- data.frame(
  x = c(1, 1, 1, 1, 1, 1, 4.1, 4.1, 7.2, 7.2),
  y = c(9.0, 7.6, 6.2, 4.8, 3.4, 1.6, 6.9, 3.3, 6.9, 3.3),
  w = c(2.7, 2.7, 2.7, 2.7, 2.7, 2.7, 2.5, 2.5, 2.5, 2.5), h = c(1.1, 1.1, 1.1, 1.1, 1.1, 1.8, 2.6, 2.6, 2.6, 2.6),
  rodzaj = c(rep("wejście niepewne (losowane)", 5), "założenia stałe", rep("obliczenie", 2), rep("wynik", 2)),
  tekst = c("Popyt po rozruchu\nlognormalny, mediana 3000 myć/mies.",
            "Średnia cena mycia\nnormalny, 20 ± 1.2 zł",
            "Woda i energia\nlognormalne: 18 zł/m3, 1.00 zł/kWh",
            "Tempo rozruchu\njednostajny, 40–80% w 1. mies.",
            "Surowość zimy (z)\nnormalny; mniej myć, więcej ogrzewania",
            "Stałe: nakład 1.2 mln zł, koszty\n21 000 zł/mies. + amortyzacja 10 000,\nsezon I–XII, chemia 2 zł/mycie",
            "Miesiąc po miesiącu\n(120 miesięcy):\nmycia × marża\n− koszty stałe − ogrzewanie",
            "Jedno losowanie\nwszystkich wejść =\njeden scenariusz;\npowtórz 10 000 razy",
            "Rozkład zysku\nw 1. roku\n→ P(strata)",
            "Rozkład czasu\ndo zwrotu nakładu\n(skumulowana gotówka)"))
strzalki <- data.frame(x = c(2.35, 2.35, 2.35, 2.35, 2.35, 2.35, 5.35, 5.35, 4.1),
                       y = c(9.0, 7.6, 6.2, 4.8, 3.4, 1.6, 7.3, 6.5, 4.6),
                       xend = c(2.85, 2.85, 2.85, 2.85, 2.85, 2.85, 5.95, 5.95, 4.1),
                       yend = c(7.9, 7.5, 7.1, 6.7, 6.3, 5.9, 7.3, 4.0, 5.6))
p1 <- ggplot(pola) +
  geom_rect(aes(xmin = x - w / 2, xmax = x + w / 2, ymin = y - h / 2, ymax = y + h / 2, fill = rodzaj),
            colour = "grey35", linewidth = 0.4) +
  geom_text(aes(x, y, label = tekst), size = 3.3, lineheight = 0.95, colour = "grey10") +
  geom_segment(data = strzalki, aes(x = x, y = y, xend = xend, yend = yend),
               arrow = arrow(length = unit(0.18, "cm"), type = "closed"), colour = "grey30", linewidth = 0.5) +
  scale_fill_manual(values = c("wejście niepewne (losowane)" = "#F6C9A9", "założenia stałe" = "grey90",
                               "obliczenie" = "#CFE3F2", "wynik" = "#82B69C"), name = NULL) +
  coord_cartesian(xlim = c(-0.4, 8.5), ylim = c(0.6, 9.6)) +
  labs(title = "Myjnia bezdotykowa: od niepewnych wejść do rozkładu zysku i czasu zwrotu") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank(),
                         panel.grid.major.x = element_blank(), panel.grid.major.y = element_blank())
p1   # zapis: ggsave("prog-rentownosci-schemat.svg", p1, width = 10, height = 6.4)
Wynik w R
 koszt_zmienny_zl marza_jednostkowa_zl prog_ksiegowy_myc prog_gotowkowy_myc
             4.76                15.24           2034.12            1377.95
 prog_ksiegowy_zima_myc margines_bezpieczenstwa_proc
                2427.82                         32.2
 miesiac  myc wynik_zl
     III 1800    -6568
      IV 2195     2459
       V 2321     4371
      VI 2234     3041
     VII 2236     3082
    VIII 2228     2957
      IX 2577     8278
       X 2820    11977
      XI 2673     6732
     XII 2504     1155
       I 2313    -1754
      II 2550     1862
  myc_rok1 srednio_myc_mies zysk_rok1_zl zwrot_mies
1    28451             2371        37592         57
2. Wykres progu rentowności: Rysunek 2
R
# Rysunek 2. Wykres progu rentowności (przychód i koszty a liczba myć); wymaga obiektów z przepisu 1. Niczego nie losuje
Q <- seq(0, 4500, by = 50)
linie <- rbind(data.frame(Q = Q, zl = baza[["cena"]] * Q, linia = "przychód (20 zł × liczba myć)"),
               data.frame(Q = Q, zl = stale$koszty_got + stale$amort + v_baza * Q,
                          linia = "koszty całkowite (31 000 zł + 4.76 zł × liczba myć)"),
               data.frame(Q = Q, zl = stale$koszty_got + stale$amort, linia = "koszty stałe z amortyzacją (31 000 zł)"))
linie$linia <- factor(linie$linia, levels = unique(linie$linia))
q_prog <- prog$prog_ksiegowy_myc
# Przedział P10–P90 popytu po rozruchu, gdy popyt ma rozkład lognormalny z medianą 3000 i sigma logarytmu 0.25
p10_90 <- qlnorm(c(0.1, 0.9), log(baza[["popyt"]]), 0.25)
data.frame(prog_myc = round(q_prog), popyt_P10 = round(p10_90[1]), popyt_P90 = round(p10_90[2]),
           P_popyt_ponizej_progu_proc = round(100 * plnorm(q_prog, log(baza[["popyt"]]), 0.25), 1),
           zysk_mies_przy_3000_zl = round(3000 * marza - stale$koszty_got - stale$amort))

p2 <- ggplot(linie, aes(Q, zl / 1000)) +
  annotate("rect", xmin = p10_90[1], xmax = p10_90[2], ymin = -Inf, ymax = Inf, fill = "grey92") +
  geom_ribbon(data = subset(linie, linia == levels(linie$linia)[1]),
              aes(ymin = pmin(zl, stale$koszty_got + stale$amort + v_baza * Q) / 1000, ymax = zl / 1000),
              fill = kol[["niebieski"]], alpha = 0.15) +
  geom_line(aes(colour = linia, linetype = linia), linewidth = 1) +
  annotate("label", x = 3580, y = 90, size = 3.3, colour = "grey30", fill = "grey92", border.colour = NA,
           label = "80% możliwych wartości popytu\npo rozruchu (P10–P90)") +
  geom_vline(xintercept = q_prog, colour = kol[["cynober"]], linewidth = 0.7) +
  annotate("label", x = q_prog - 60, y = 76, hjust = 1, size = 3.4, colour = kol[["cynober"]], border.colour = NA,
           label = sprintf("próg rentowności\n%.0f myć/mies.", q_prog)) +
  geom_vline(xintercept = c(mean(plan$myc[1, 1:12]), baza[["popyt"]]), colour = kol[["ciemny"]], linetype = "22") +
  annotate("label", x = c(mean(plan$myc[1, 1:12]), baza[["popyt"]]) + 40, y = c(8, 20), hjust = 0, size = 3.2,
           border.colour = NA, label = c(sprintf("plan 1. roku: średnio\n%.0f myć/mies.", mean(plan$myc[1, 1:12])),
                                         "plan po rozruchu:\n3000 myć/mies.")) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["ciemny"]], kol[["szary"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "42"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 4500, 500)) +
  labs(x = "Liczba myć w miesiącu", y = "Tys. zł miesięcznie",
       title = "Próg rentowności myjni: przy jakiej liczbie myć przychód pokrywa koszty") +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  motyw
p2   # zapis: ggsave("prog-rentownosci-wykres-progu.svg", p2, width = 10, height = 6)
Wynik w R
  prog_myc popyt_P10 popyt_P90 P_popyt_ponizej_progu_proc
1     2034      2178      4133                          6
  zysk_mies_przy_3000_zl
1                  14720
3. 10 000 scenariuszy i P(strata w 1. roku): Rysunek 3
R
# Rysunek 3. 10 000 scenariuszy Monte Carlo: rozkład zysku w 1. roku i P(strata) z błędem Monte Carlo; wymaga przepisów 1–2
set.seed(711)
R <- 10000
# Rozkłady wejść (ustalone ręcznie, „z głowy” właściciela i dostawcy myjni – nie z danych)
sym <- data.frame(popyt = rlnorm(R, log(3000), 0.25),     # myć/mies. po rozruchu
                  cena = rnorm(R, 20, 1.2),                # zł/mycie
                  woda = rlnorm(R, log(18), 0.15),         # zł/m3
                  energia = rlnorm(R, log(1.00), 0.20),    # zł/kWh
                  rozruch = runif(R, 0.40, 0.80))          # odsetek popytu w 1. miesiącu
z <- matrix(rnorm(R * 11), R, 11)                          # surowość 11 zim (0 = marzec otwarcia)
wyn <- with(sym, miesiecznie(popyt, cena, woda, energia, rozruch, z, losuj = TRUE))
sym$zysk_rok1 <- rowSums(wyn$gotowka[, 1:12]) - 12 * stale$amort
sym$prog_myc <- (stale$koszty_got + stale$amort) / (sym$cena - (stale$woda_m3 * sym$woda + stale$kwh_mycie * sym$energia + stale$chemia))

zysk_plan <- sum(plan$gotowka[1, 1:12]) - 12 * stale$amort
p_strata <- mean(sym$zysk_rok1 < 0)
se_p <- sqrt(p_strata * (1 - p_strata) / R)                 # błąd Monte Carlo odsetka
data.frame(zysk_plan_zl = round(zysk_plan), srednia_zl = round(mean(sym$zysk_rok1)),
           mediana_zl = round(median(sym$zysk_rok1)), sd_zl = round(sd(sym$zysk_rok1)),
           P5_zl = round(quantile(sym$zysk_rok1, 0.05)), P95_zl = round(quantile(sym$zysk_rok1, 0.95)), row.names = NULL)
data.frame(P_strata_proc = round(100 * p_strata, 1), blad_MC_pp = round(100 * se_p, 2),
           CI95_dol = round(100 * (p_strata - 1.96 * se_p), 1), CI95_gora = round(100 * (p_strata + 1.96 * se_p), 1),
           srednia_strata_gdy_strata_zl = round(mean(sym$zysk_rok1[sym$zysk_rok1 < 0])),
           P_strata_ponad_50_tys_proc = round(100 * mean(sym$zysk_rok1 < -50000), 1),
           poza_osia_rysunku_proc = round(100 * mean(sym$zysk_rok1 < -250000 | sym$zysk_rok1 > 450000), 2))
# Próg rentowności też jest niepewny: zależy od ceny i kosztu zmiennego
data.frame(prog_P10 = round(quantile(sym$prog_myc, 0.1)), prog_mediana = round(median(sym$prog_myc)),
           prog_P90 = round(quantile(sym$prog_myc, 0.9)),
           P_popyt_po_rozruchu_ponizej_progu_proc = round(100 * mean(sym$popyt < sym$prog_myc), 1), row.names = NULL)

# Rysunek 3: histogram zysku w 1. roku; scenariusze ze stratą w kolorze cynobrowym
sym$wynik <- factor(ifelse(sym$zysk_rok1 < 0, "strata w 1. roku", "zysk w 1. roku"),
                    levels = c("strata w 1. roku", "zysk w 1. roku"))
p3 <- ggplot(sym, aes(zysk_rok1 / 1000, fill = wynik)) +
  geom_histogram(binwidth = 10, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = zysk_plan / 1000, colour = kol[["ciemny"]], linewidth = 0.8) +
  geom_vline(xintercept = mean(sym$zysk_rok1) / 1000, colour = kol[["ciemny"]], linewidth = 0.8, linetype = "22") +
  annotate("label", x = zysk_plan / 1000 - 6, y = Inf, vjust = 1.3, hjust = 1, size = 3.4, border.colour = NA,
           label = sprintf("plan (wartości bazowe): %.1f tys. zł", zysk_plan / 1000)) +
  annotate("label", x = mean(sym$zysk_rok1) / 1000 + 6, y = Inf, vjust = 2.9, hjust = 0, size = 3.4, border.colour = NA,
           label = sprintf("średnia z 10 000 scenariuszy: %.1f tys. zł", mean(sym$zysk_rok1) / 1000)) +
  annotate("label", x = -240, y = Inf, vjust = 4.4, hjust = 0, size = 3.6, border.colour = NA, colour = kol[["cynober"]],
           label = sprintf("P(strata w 1. roku) = %.1f%%\n(błąd MC ± %.1f pp)", 100 * p_strata, 100 * se_p)) +
  scale_fill_manual(values = c("strata w 1. roku" = kol[["cynober"]], "zysk w 1. roku" = kol[["niebieski"]]), name = NULL) +
  scale_x_continuous(breaks = seq(-200, 450, 50), labels = minus) +
  scale_y_continuous(expand = expansion(mult = c(0.01, 0.22))) +
  coord_cartesian(xlim = c(-250, 450)) +
  labs(x = "Zysk przed podatkiem w 1. roku (tys. zł)", y = "Liczba scenariuszy (z 10 000)",
       title = "Zysk myjni w pierwszym roku w 10 000 scenariuszach") +
  motyw
p3   # zapis: ggsave("prog-rentownosci-zysk-1-rok.svg", p3, width = 10, height = 5.6)
Wynik w R
  zysk_plan_zl srednia_zl mediana_zl  sd_zl   P5_zl P95_zl
1        37592      50583      34063 128474 -129694 283872
  P_strata_proc blad_MC_pp CI95_dol CI95_gora srednia_strata_gdy_strata_zl
1          38.4       0.49     37.5      39.4                       -68744
  P_strata_ponad_50_tys_proc poza_osia_rysunku_proc
1                       22.2                   0.82
  prog_P10 prog_mediana prog_P90 P_popyt_po_rozruchu_ponizej_progu_proc
1     1842         2043     2278                                    7.1
4. Czas do zwrotu nakładu i plik CSV: Rysunek 4
R
# Rysunek 4. Czas do zwrotu nakładu 1.2 mln zł (skumulowana gotówka przed podatkiem); wymaga przepisów 1–3. Niczego nie losuje
skum <- t(apply(wyn$gotowka, 1, cumsum))
sym$zwrot_mies <- apply(skum >= stale$naklad, 1, function(x) if (any(x)) which(x)[1] else NA)   # NA = brak zwrotu w 10 lat
zwrot_plan <- which(cumsum(plan$gotowka[1, ]) >= stale$naklad)[1]
zw <- sym$zwrot_mies; zw_lata <- ifelse(is.na(zw), Inf, zw / 12)
data.frame(plan_mies = zwrot_plan, plan_lata = round(zwrot_plan / 12, 1),
           mediana_lata = round(median(zw_lata), 1), P10_lata = round(quantile(zw_lata, 0.1), 1),
           P90_lata = if (quantile(zw_lata, 0.9) == Inf) "ponad 10" else round(quantile(zw_lata, 0.9), 1),
           P_zwrot_do_5_lat_proc = round(100 * mean(zw_lata <= 5), 1),
           P_dluzej_niz_7_lat_proc = round(100 * mean(zw_lata > 7), 1),
           P_brak_zwrotu_w_10_lat_proc = round(100 * mean(is.na(zw)), 1),
           blad_MC_brak_pp = round(100 * sqrt(mean(is.na(zw)) * (1 - mean(is.na(zw))) / R), 2), row.names = NULL)
# Scenariusze, w których 1. rok przyniósł stratę, a mimo to nakład zwrócił się w 10 lat
data.frame(strata_w_1_roku_ale_zwrot_w_10_lat_proc = round(100 * mean(sym$zysk_rok1 < 0 & !is.na(zw)), 1),
           zwrot_w_10_lat_wsrod_strat_1_roku_proc = round(100 * mean(!is.na(zw[sym$zysk_rok1 < 0])), 1))
write.csv(transform(round(sym[, c("popyt", "cena", "woda", "energia", "rozruch", "zysk_rok1", "prog_myc", "zwrot_mies")], 3),
                    zima1 = round(z[, 2], 3)), "prog-rentownosci-myjnia-symulacje.csv", row.names = FALSE)

# Rysunek 4: dystrybuanta empiryczna czasu zwrotu liczona co miesiąc (scenariusze bez zwrotu w 10 lat – poza osią)
ec <- data.frame(lata = (12:120) / 12, odsetek = sapply(12:120, function(k) mean(zw_lata <= k / 12)))
p4 <- ggplot(ec, aes(lata, odsetek)) +
  geom_step(colour = kol[["niebieski"]], linewidth = 1) +
  geom_vline(xintercept = zwrot_plan / 12, colour = kol[["ciemny"]], linewidth = 0.8, linetype = "22") +
  annotate("label", x = zwrot_plan / 12 + 0.1, y = 0.12, hjust = 0, size = 3.4, border.colour = NA,
           label = sprintf("plan: zwrot po %d miesiącach (%.1f roku)", zwrot_plan, zwrot_plan / 12)) +
  geom_hline(yintercept = 1 - mean(is.na(zw)), colour = kol[["cynober"]], linetype = "42") +
  annotate("label", x = 1.2, y = 1 - mean(is.na(zw)) + 0.05, hjust = 0, size = 3.4, border.colour = NA,
           colour = kol[["cynober"]],
           label = sprintf("%.1f%% scenariuszy: brak zwrotu w 10 lat", 100 * mean(is.na(zw)))) +
  scale_x_continuous(breaks = 1:10, limits = c(1, 10)) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%"), limits = c(0, 1.05), breaks = seq(0, 1, 0.2)) +
  labs(x = "Czas do zwrotu nakładu (lata od otwarcia)", y = "Odsetek scenariuszy ze zwrotem do tego czasu",
       title = "Kiedy myjnia odzyska 1.2 mln zł nakładu? 10 000 scenariuszy") +
  motyw
p4   # zapis: ggsave("prog-rentownosci-czas-zwrotu.svg", p4, width = 10, height = 5.4)
Wynik w R
  plan_mies plan_lata mediana_lata P10_lata P90_lata P_zwrot_do_5_lat_proc
1        57       4.8          4.8      2.8 ponad 10                  52.4
  P_dluzej_niz_7_lat_proc P_brak_zwrotu_w_10_lat_proc blad_MC_brak_pp
1                    26.1                        12.8            0.33
  strata_w_1_roku_ale_zwrot_w_10_lat_proc
1                                    25.7
  zwrot_w_10_lat_wsrod_strat_1_roku_proc
1                                   66.9
5. Wykres tornado narysowany ręcznie: Rysunek 5
R
# Rysunek 5. Wykres tornado narysowany ręcznie (geom_rect): zysk w 1. roku i czas do zwrotu; wymaga przepisu 1. Niczego nie losuje
library(patchwork)
# P10 i P90 każdego wejścia (te same rozkłady co w przepisie 3); koszty stałe ±10% – nie losowane, dodane dla porównania
zakres <- list(popyt = qlnorm(c(0.1, 0.9), log(3000), 0.25), cena = qnorm(c(0.1, 0.9), 20, 1.2),
               woda = qlnorm(c(0.1, 0.9), log(18), 0.15), energia = qlnorm(c(0.1, 0.9), log(1.00), 0.20),
               rozruch = qunif(c(0.1, 0.9), 0.40, 0.80), zima = qnorm(c(0.1, 0.9)),
               koszty_stale = stale$koszty_got * c(0.9, 1.1))
etyk <- c(popyt = "Popyt po rozruchu (myć/mies.)", cena = "Średnia cena mycia (zł)", woda = "Cena wody (zł/m3)",
          energia = "Cena energii (zł/kWh)", rozruch = "Rozruch (% popytu w 1. mies.)", zima = "Surowość zim (z)",
          koszty_stale = "Koszty stałe gotówkowe (zł/mies.)")
licz <- function(zm = NULL, wart = NULL) {          # zysk w 1. roku i miesiąc zwrotu, gdy jedno wejście zmienione
  b <- as.list(baza); s <- stale
  if (!is.null(zm)) { if (zm == "koszty_stale") s$koszty_got <- wart else b[[zm]] <- wart }
  w <- miesiecznie(b$popyt, b$cena, b$woda, b$energia, b$rozruch, matrix(b$zima, 1, 11), s = s)
  c(zysk = sum(w$gotowka[1, 1:12]) - 12 * s$amort,
    zwrot = { k <- which(cumsum(w$gotowka[1, ]) >= s$naklad)[1]; if (is.na(k)) 121 else k })
}
b0 <- licz()
torn <- do.call(rbind, lapply(names(zakres), function(n) {
  lo <- licz(n, zakres[[n]][1]); hi <- licz(n, zakres[[n]][2])
  data.frame(wejscie = n, P10 = zakres[[n]][1], P90 = zakres[[n]][2], zysk_P10 = lo[["zysk"]], zysk_P90 = hi[["zysk"]],
             zwrot_P10 = lo[["zwrot"]], zwrot_P90 = hi[["zwrot"]])
}))
torn$rozpietosc_zysk <- abs(torn$zysk_P90 - torn$zysk_P10)
torn$rozpietosc_zwrot <- abs(torn$zwrot_P90 - torn$zwrot_P10)
print(transform(torn, P10 = signif(P10, 4), P90 = signif(P90, 4), zysk_P10 = round(zysk_P10), zysk_P90 = round(zysk_P90),
                rozpietosc_zysk = round(rozpietosc_zysk))[order(-torn$rozpietosc_zysk), ], row.names = FALSE)

rysuj <- function(lo, hi, srodek, os, tytul, kolejnosc, skala = 1, etykiety = TRUE) {
  d <- data.frame(wejscie = factor(etyk[torn$wejscie], levels = etyk[kolejnosc]),
                  P10 = lo / skala, P90 = hi / skala, s = srodek / skala)
  d2 <- rbind(data.frame(wejscie = d$wejscie, od = d$s, do = d$P10, wartosc = "wejście na P10"),
              data.frame(wejscie = d$wejscie, od = d$s, do = d$P90, wartosc = "wejście na P90"))
  ggplot(d2) +
    geom_rect(aes(xmin = pmin(od, do), xmax = pmax(od, do), ymin = as.numeric(wejscie) - 0.38,
                  ymax = as.numeric(wejscie) + 0.38, fill = wartosc), colour = "white") +
    geom_vline(xintercept = srodek / skala, colour = kol[["ciemny"]], linewidth = 0.7) +
    scale_x_continuous(labels = minus) +
    scale_y_continuous(breaks = seq_along(levels(d$wejscie)), labels = if (etykiety) levels(d$wejscie) else NULL,
                       expand = expansion(add = 0.5)) +
    scale_fill_manual(values = c("wejście na P10" = kol[["pomarancz"]], "wejście na P90" = kol[["niebieski"]]), name = NULL) +
    labs(x = os, y = NULL, title = tytul) + motyw
}
kolej <- order(torn$rozpietosc_zysk)                  # najszerszy słupek na górze
p5 <- rysuj(torn$zysk_P10, torn$zysk_P90, b0[["zysk"]], "Zysk w 1. roku (tys. zł)",
            sprintf("A. Zysk w 1. roku (plan: %.1f tys. zł)", b0[["zysk"]] / 1000), kolej, 1000) +
  rysuj(torn$zwrot_P10, torn$zwrot_P90, b0[["zwrot"]], "Miesiąc zwrotu (121 = brak w 10 lat)",
        sprintf("B. Zwrot (plan: %d. mies.)", b0[["zwrot"]]), kolej, etykiety = FALSE) +
  plot_layout(ncol = 2, widths = c(1, 0.62), guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("prog-rentownosci-tornado.svg", p5, width = 10, height = 5.6)
Wynik w R
      wejscie        P10       P90 zysk_P10 zysk_P90 zwrot_P10 zwrot_P90
        popyt  2178.0000  4133.000   -81270   201343       121        33
         zima    -1.2820     1.282    84179    -8995        50        68
      rozruch     0.4400     0.760    -8427    83611        60        55
         cena    18.4600    21.540    -6162    81345        72        49
 koszty_stale 18900.0000 23100.000    62792    12392        53        63
      energia     0.7739     1.292    52667    18112        54        63
         woda    14.8500    21.820    43861    29994        56        60
 rozpietosc_zysk rozpietosc_zwrot
          282613               88
           93174               18
           92039                5
           87507               23
           50400               10
           34555                9
           13867                4
6. Wejścia skorelowane i niezależne: Rysunek 6
R
# Rysunek 6. Skorelowane wejścia (sroga zima = mniej myć i więcej ogrzewania) a wejścia niezależne; wymaga przepisów 1–3
# Te same mycia co w przepisie 3; w wariancie „niezależnym” koszt ogrzewania liczymy z innej, niezależnej surowości zim
set.seed(7111)
z_niez <- matrix(rnorm(R * 11), R, 11)
grzanie <- function(zg, energia) {               # koszt ogrzewania stanowisk (zł/mies.), wiersz = scenariusz
  w <- matrix(zima[kal], nrow(zg), length(m), byrow = TRUE)
  stale$kwh_grzanie * w * pmax(0, 1 + stale$b_grzanie * zg[, sezon_zimy + 1, drop = FALSE]) * energia
}
got_niez <- wyn$gotowka + grzanie(z, sym$energia) - grzanie(z_niez, sym$energia)
zima_kw <- 10:12                                   # XII, I, II pierwszej pełnej zimy (miesiące 10–12 od otwarcia)
warianty <- list("skorelowane (wspólna zima)" = wyn$gotowka, "niezależne" = got_niez)
podsum <- do.call(rbind, lapply(names(warianty), function(n) {
  g <- warianty[[n]]
  zk <- rowSums(g[, zima_kw]) - 3 * stale$amort; r1 <- rowSums(g[, 1:12]) - 12 * stale$amort
  data.frame(wariant = n, zima_srednia = round(mean(zk)), zima_sd = round(sd(zk)), zima_P5 = round(quantile(zk, 0.05)),
             zima_P1 = round(quantile(zk, 0.01)), rok1_sd = round(sd(r1)), rok1_P5 = round(quantile(r1, 0.05)),
             rok1_P1 = round(quantile(r1, 0.01)), P_strata_rok1 = round(100 * mean(r1 < 0), 1),
             P_strata_ponad_100_tys = round(100 * mean(r1 < -1e5), 2), row.names = NULL)
}))
print(podsum[, 1:5], row.names = FALSE); print(podsum[, c(1, 6:10)], row.names = FALSE)
# Korelacja liczby myć i kosztu ogrzewania w zimowym kwartale
myc_zk <- rowSums(wyn$myc[, zima_kw])
data.frame(kor_skorelowane = round(cor(myc_zk, rowSums(grzanie(z, sym$energia)[, zima_kw])), 2),
           kor_niezalezne = round(cor(myc_zk, rowSums(grzanie(z_niez, sym$energia)[, zima_kw])), 2))

# Rysunek 6: lewy ogon wyniku zimowego kwartału – dystrybuanty empiryczne obu wariantów
d6 <- rbind(data.frame(wariant = names(warianty)[1], wynik = rowSums(wyn$gotowka[, zima_kw]) - 3 * stale$amort),
            data.frame(wariant = names(warianty)[2], wynik = rowSums(got_niez[, zima_kw]) - 3 * stale$amort))
d6$wariant <- factor(d6$wariant, levels = names(warianty))
siatka <- seq(-100000, 80000, by = 500)            # dystrybuanta liczona na siatce – mniejszy plik rysunku
e6 <- do.call(rbind, lapply(levels(d6$wariant), function(n)
  data.frame(wariant = n, x = siatka, odsetek = ecdf(d6$wynik[d6$wariant == n])(siatka))))
e6$wariant <- factor(e6$wariant, levels = names(warianty))
p6 <- ggplot(e6, aes(x / 1000, odsetek, colour = wariant, linetype = wariant)) +
  geom_line(linewidth = 1) +
  geom_hline(yintercept = 0.05, colour = kol[["szary"]], linetype = "22") +
  annotate("text", x = -75, y = 0.065, hjust = 0, size = 3.3, colour = "grey30", label = "5% najgorszych zim") +
  annotate("label", x = -75, y = 0.30, hjust = 0, size = 3.4, border.colour = NA, label = minus(sprintf(
    "5. percentyl wyniku:\nskorelowane %.1f tys. zł\nniezależne %.1f tys. zł", podsum$zima_P5[1] / 1000, podsum$zima_P5[2] / 1000))) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "42"), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%")) +
  scale_x_continuous(breaks = seq(-80, 60, 20), labels = minus) +
  coord_cartesian(xlim = c(-80, 60), ylim = c(0, 0.5)) +
  labs(x = "Wynik zimowego kwartału XII–II (tys. zł, po amortyzacji)", y = "Odsetek scenariuszy z wynikiem ≤ x",
       title = "Ta sama zima w popycie i w rachunku za prąd: grubszy lewy ogon") +
  motyw
p6   # zapis: ggsave("prog-rentownosci-zima-korelacja.svg", p6, width = 10, height = 5.6)
Wynik w R
                    wariant zima_srednia zima_sd zima_P5 zima_P1
 skorelowane (wspólna zima)         4585   42153  -56759  -79258
                 niezależne         4412   37743  -49635  -65884
                    wariant rok1_sd rok1_P5 rok1_P1 P_strata_rok1
 skorelowane (wspólna zima)  128474 -129694 -178324          38.4
                 niezależne  126543 -125961 -173687          38.3
 P_strata_ponad_100_tys
                   9.56
                   9.08
  kor_skorelowane kor_niezalezne
1           -0.46              0
7. Pułapki: optymizm planu i inne rozkłady
R
# Pułapki: optymizm planu i rozkłady „z głowy” – te same losowania z przepisu 3, inne założenia; wymaga przepisów 1–4
# Liczymy na oczekiwanej liczbie myć (bez losowania Poissona), żeby warianty różniły się tylko założeniem
ocen <- function(popyt, rozruch = sym$rozruch) {
  w <- miesiecznie(popyt, sym$cena, sym$woda, sym$energia, rozruch, z)
  r1 <- rowSums(w$gotowka[, 1:12]) - 12 * stale$amort
  zw <- apply(t(apply(w$gotowka, 1, cumsum)) >= stale$naklad, 1, function(x) if (any(x)) which(x)[1] / 12 else Inf)
  data.frame(P_strata_rok1_proc = round(100 * mean(r1 < 0), 1), mediana_zysku_rok1_tys = round(median(r1) / 1000, 1),
             mediana_zwrotu_lata = round(median(zw), 1), P_brak_zwrotu_10_lat_proc = round(100 * mean(!is.finite(zw)), 1))
}
zp <- log(sym$popyt / 3000) / 0.25                          # standaryzowane losowania popytu z przepisu 3
warianty <- list(
  "bazowy (mediana 3000, sigma 0.25)"               = 3000 * exp(0.25 * zp),
  "popyt jak w podobnych myjniach (mediana 2550)"   = 2550 * exp(0.25 * zp),
  "węższy rozkład popytu (sigma 0.15)"              = 3000 * exp(0.15 * zp),
  "szerszy rozkład popytu (sigma 0.35)"             = 3000 * exp(0.35 * zp))
wynik7 <- do.call(rbind, lapply(warianty, ocen))
wynik7 <- rbind(wynik7, "wolniejszy rozruch (20–50% w 1. mies.)" = ocen(warianty[[1]], 0.20 + 0.75 * (sym$rozruch - 0.40)))
print(wynik7)
Wynik w R
                                              P_strata_rok1_proc
bazowy (mediana 3000, sigma 0.25)                           38.3
popyt jak w podobnych myjniach (mediana 2550)               61.2
węższy rozkład popytu (sigma 0.15)                          33.9
szerszy rozkład popytu (sigma 0.35)                         41.2
wolniejszy rozruch (20–50% w 1. mies.)                      63.5
                                              mediana_zysku_rok1_tys
bazowy (mediana 3000, sigma 0.25)                               33.9
popyt jak w podobnych myjniach (mediana 2550)                  -30.8
węższy rozkład popytu (sigma 0.15)                              33.7
szerszy rozkład popytu (sigma 0.35)                             34.1
wolniejszy rozruch (20–50% w 1. mies.)                         -37.5
                                              mediana_zwrotu_lata
bazowy (mediana 3000, sigma 0.25)                             4.8
popyt jak w podobnych myjniach (mediana 2550)                 6.8
węższy rozkład popytu (sigma 0.15)                            4.8
szerszy rozkład popytu (sigma 0.35)                           4.8
wolniejszy rozruch (20–50% w 1. mies.)                        5.2
                                              P_brak_zwrotu_10_lat_proc
bazowy (mediana 3000, sigma 0.25)                                  12.8
popyt jak w podobnych myjniach (mediana 2550)                      30.0
węższy rozkład popytu (sigma 0.15)                                  4.6
szerszy rozkład popytu (sigma 0.35)                                20.3
wolniejszy rozruch (20–50% w 1. mies.)                             13.8
8. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (zysk / strata; niezależne / skorelowane)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (P90 / P10 w tornado)" = c("#0072B2", "#E69F00"),
             "jasnopomarańczowy – jasnoniebieski (wejście / obliczenie na schemacie)" = c("#F6C9A9", "#CFE3F2"),
             "jasnoniebieski – zielony (obliczenie / wynik na schemacie)" = c("#CFE3F2", "#82B69C"),
             "jasnopomarańczowy – zielony (wejście / wynik na schemacie)" = c("#F6C9A9", "#82B69C"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                       widzenie_typowe
niebieski – cynober (zysk / strata; niezależne / skorelowane)                    114.6
niebieski – pomarańczowy (P90 / P10 w tornado)                                   120.2
jasnopomarańczowy – jasnoniebieski (wejście / obliczenie na schemacie)            35.4
jasnoniebieski – zielony (obliczenie / wynik na schemacie)                        32.2
jasnopomarańczowy – zielony (wejście / wynik na schemacie)                        39.6
czerwony – zielony (do unikania)                                                 121.7
                                                                       deuteranopia
niebieski – cynober (zysk / strata; niezależne / skorelowane)                 108.3
niebieski – pomarańczowy (P90 / P10 w tornado)                                121.5
jasnopomarańczowy – jasnoniebieski (wejście / obliczenie na schemacie)         34.6
jasnoniebieski – zielony (obliczenie / wynik na schemacie)                     25.5
jasnopomarańczowy – zielony (wejście / wynik na schemacie)                     24.7
czerwony – zielony (do unikania)                                               21.1
                                                                       protanopia
niebieski – cynober (zysk / strata; niezależne / skorelowane)                91.9
niebieski – pomarańczowy (P90 / P10 w tornado)                              109.3
jasnopomarańczowy – jasnoniebieski (wejście / obliczenie na schemacie)       29.9
jasnoniebieski – zielony (obliczenie / wynik na schemacie)                   27.3
jasnopomarańczowy – zielony (wejście / wynik na schemacie)                   13.8
czerwony – zielony (do unikania)                                             31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, kwantyle, dystrybuanta empiryczna, korelacja – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Optymizm planu. Kahneman i Lovallo (1993) opisują „widok od wewnątrz”: prognozę zakotwiczoną w planie i scenariuszach własnego przedsięwzięcia, który prowadzi do nadmiernie optymistycznych przewidywań. Flyvbjerg (2006) proponuje prognozę z klasy referencyjnej – z faktycznych wyników podobnych projektów. Gdyby podobne myjnie w okolicy miały medianę 2550 myć (o 15% mniej niż plan), P(strata w 1. roku) wzrosłaby z 38.3% do 61.2%, mediana zwrotu z 4.8 do 6.8 roku, a brak zwrotu w 10 lat – z 12.8% do 30.0%.
- Rozkłady „z głowy” – ujawnij je. Ten sam popyt z σ logarytmu 0.15 zamiast 0.25 daje 33.9% szans na stratę i 4.6% braku zwrotu, a z σ 0.35 – 41.2% i 20.3%. Mediana zwrotu się nie zmienia – zmienia się ogon. O’Hagan (2019) zaleca pozyskiwać rozkłady od ekspertów według uznanego protokołu, który ogranicza ich błędy poznawcze, i zauważa, że najtrudniej ocenić zależności między kilkoma wielkościami – tu: zimą, popytem i kosztami.
- Wolny rozruch. Rozruch od 20–50% zamiast 40–80% podnosi P(strata w 1. roku) do 63.5%, ale zwrot opóźnia tylko do 5.2 roku.
- Próg ze „średniego miesiąca”. Zimą próg rośnie do 2428 myć, a popyt spada.
- Pominięte korelacje. Niezależność wejść to też założenie; przy wspólnej przyczynie (pogoda, koniunktura) zaniża straty w złych okresach (rysunek 6). O wpływie pogody na sprzedaż przeczytasz we wpisie pogoda a sprzedaż.
- Liczby z symulacji bez błędu MC i bez ziarna. Podawaj oba. (Warianty w tej sekcji liczono na oczekiwanej liczbie myć, stąd 38.3% zamiast 38.4%.)
Najczęstsze pytania
Jak obliczyć próg rentowności?
Podziel koszty stałe okresu przez marżę jednostkową, czyli cenę minus koszt zmienny jednej sztuki lub usługi. W przykładzie myjni: 31 000 zł kosztów stałych (z amortyzacją) / (20 − 4.76 zł) = 2034 mycia miesięcznie. Bez amortyzacji dostajesz próg gotówkowy (tu 1378 myć).
Po co symulacja Monte Carlo przy progu rentowności?
Wzór daje jedną liczbę przy jednej cenie i jednym popycie. Symulacja losuje tysiące kombinacji niepewnych wejść i pokazuje rozkład wyniku: jak często będzie strata, jak duża i kiedy wróci nakład. W przykładzie plan dawał zysk, a strata w 1. roku wystąpiła w 38.4% scenariuszy.
Co to jest margines bezpieczeństwa?
To odsetek, o jaki sprzedaż może spaść, zanim firma zacznie tracić: (sprzedaż planowana − próg) / sprzedaż planowana. Przy planie 3000 myć i progu 2034 wynosi 32.2%. Margines nie mówi jednak, jak prawdopodobny jest taki spadek – do tego potrzebny jest rozkład popytu.
Czy wejścia w symulacji muszą być niezależne?
Nie, a często nie powinny. Gdy wspólna przyczyna (np. mroźna zima) jednocześnie zmniejsza popyt i zwiększa koszty, wejścia są skorelowane. W przykładzie pominięcie tej zależności zaniżało stratę w najgorszym 1% zimowych kwartałów o ok. 13 000 zł, choć średnia prawie się nie zmieniała.
Skąd wziąć rozkłady do symulacji w biznesplanie?
Najlepiej z danych o podobnych firmach (klasa referencyjna), a gdy ich brak – z ocen ekspertów zebranych według protokołu. Zawsze ujawnij źródło i sprawdź, ile zmienia inny wybór: w przykładzie szerszy rozkład popytu zwiększał odsetek scenariuszy bez zwrotu w 10 lat z 12.8% do 20.3%.
Powiązane hasła
Przeczytaj też
Monte Carlo NPV – opłacalność projektu
Linia produkcyjna w mleczarni: NPV, rozkłady założeń, 10 000 symulacji, P(NPV < 0), tornado i korelacja ceny z popytem – sześć rysunków z kodem R.
Czytaj →PoradnikOdchylenie plan–wykonanie: cena, wolumen, struktura
Plan przekroczony o 3.29 mln zł: ile to wolumen, struktura, cena i kurs euro, czy kolejność rozbicia ma znaczenie i kiedy odchylenie coś znaczy – z kodem R.
Czytaj →PoradnikOpóźnienia płatności faktur w analizie przeżycia
Hurtownia, 20 tys. faktur: cenzurowanie, Kaplan–Meier, Cox z klientem jako klastrem, windykacja jako CIF i prognoza wpływów.
Czytaj →Piszesz biznesplan albo pracę o progu rentowności?
Pomożemy zbudować model kosztów, uzasadnić rozkłady założeń, przeprowadzić symulację Monte Carlo i analizę wrażliwości oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Eschenbach, T. G. (1992). Spiderplots versus tornado diagrams for sensitivity analysis. Interfaces, 22(6), 40–46. https://doi.org/10.1287/inte.22.6.40
- Flyvbjerg, B. (2006). From Nobel Prize to project management: Getting risks right. Project Management Journal, 37(3), 5–15. https://doi.org/10.1177/875697280603700302 ● Otwarty dostęp: pełny tekst
- Jaedicke, R. K., & Robichek, A. A. (1964). Cost-volume-profit analysis under conditions of uncertainty. The Accounting Review, 39(4), 917–926. https://doi.org/10.2308/tar-7109173
- Kahneman, D., & Lovallo, D. (1993). Timid choices and bold forecasts: A cognitive perspective on risk taking. Management Science, 39(1), 17–31. https://doi.org/10.1287/mnsc.39.1.17
- Kim, C. (1973). A stochastic cost volume profit analysis. Decision Sciences, 4(3), 329–342. https://doi.org/10.1111/j.1540-5915.1973.tb00559.x
- Morris, T. P., White, I. R., & Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. https://doi.org/10.1002/sim.8086 ● Otwarty dostęp
- O’Hagan, A. (2019). Expert knowledge elicitation: Subjective but scientific. The American Statistician, 73(sup1), 69–81. https://doi.org/10.1080/00031305.2018.1518265 ● Otwarty dostęp
Cytowania BibTeX
@article{eschenbach1992spiderplots, author={Eschenbach, Ted G.}, title={{Spiderplots versus tornado diagrams for sensitivity analysis}}, journal={Interfaces}, year={1992}, volume={22}, number={6}, pages={40--46}, doi={10.1287/inte.22.6.40}}@article{flyvbjerg2006nobel, author={Flyvbjerg, Bent}, title={{From Nobel Prize to project management: Getting risks right}}, journal={Project Management Journal}, year={2006}, volume={37}, number={3}, pages={5--15}, doi={10.1177/875697280603700302}}@article{jaedicke1964cost, author={Jaedicke, Robert K. and Robichek, Alexander A.}, title={{Cost-volume-profit analysis under conditions of uncertainty}}, journal={The Accounting Review}, year={1964}, volume={39}, number={4}, pages={917--926}, doi={10.2308/tar-7109173}}@article{kahneman1993timid, author={Kahneman, Daniel and Lovallo, Dan}, title={{Timid choices and bold forecasts: A cognitive perspective on risk taking}}, journal={Management Science}, year={1993}, volume={39}, number={1}, pages={17--31}, doi={10.1287/mnsc.39.1.17}}@article{kim1973stochastic, author={Kim, Chaiho}, title={{A stochastic cost volume profit analysis}}, journal={Decision Sciences}, year={1973}, volume={4}, number={3}, pages={329--342}, doi={10.1111/j.1540-5915.1973.tb00559.x}}@article{morris2019using, author={Morris, Tim P. and White, Ian R. and Crowther, Michael J.}, title={{Using simulation studies to evaluate statistical methods}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={11}, pages={2074--2102}, doi={10.1002/sim.8086}}@article{ohagan2019expert, author={O'Hagan, Anthony}, title={{Expert knowledge elicitation: Subjective but scientific}}, journal={The American Statistician}, year={2019}, volume={73}, number={sup1}, pages={69--81}, doi={10.1080/00031305.2018.1518265}}