Przykład: producent mrożonek i pytanie „skąd te 3 miliony?”
Fikcyjny producent mrożonek sprzedaje 8 linii produktów (pierogi, kopytka i kluski, mieszanki warzywne, warzywa na patelnię, owoce, frytki, pizzę i dania gotowe) w 4 kanałach: sieciach handlowych, hurcie i sklepach tradycyjnych, gastronomii i eksporcie. Co kwartał dział sprzedaży planuje wolumen (tony) i cenę (zł/kg) dla każdej z 32 par linia × kanał. Eksport rozlicza się w euro.
W III kwartale 2026 r. przychód wyniósł 92.10 mln zł wobec planu 88.81 mln zł, czyli o 3.29 mln zł (3.7%) więcej. Zarząd pyta: ile z tego to większa sprzedaż, ile zmiana tego, co sprzedajemy, a ile ceny – i czy to w ogóle coś niezwykłego?
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie (pełna lista przy kodzie). Wykonanie to plan razy losowe odchylenie. Dział sprzedaży planuje ostrożnie – wolumen wychodzi średnio o ok. 3.5% wyżej niż w planie. W ostatnim kwartale ukryliśmy pięć zdarzeń: pizza straciła część półki w sieciach (wolumen −30%), frytki dostały dla sieci cenę niższą o 6% w zamian za wolumen większy o 12%, gastronomia kupiła o 8% mniej, eksport owoców wzrósł o 15%, a euro było słabsze niż w planie (fikcyjne kursy: 4.12 zamiast 4.30 zł). Po pierwszym uruchomieniu zmieniliśmy raz jeden parametr: rozrzut szoku linii w kwartale z 5% na 3%, bo przy 5% przedziały z historii miały szerokość ok. ±20% i karta odchyleń nie wskazywała żadnej linii. Ziarna 710 nie zmienialiśmy. Dane (416 wierszy: 13 kwartałów × 32 pary) pobierzesz jako odchylenie-plan-wykonanie-mrozonki.csv.
Rysunek 1: plan i wykonanie według linii i kanałów
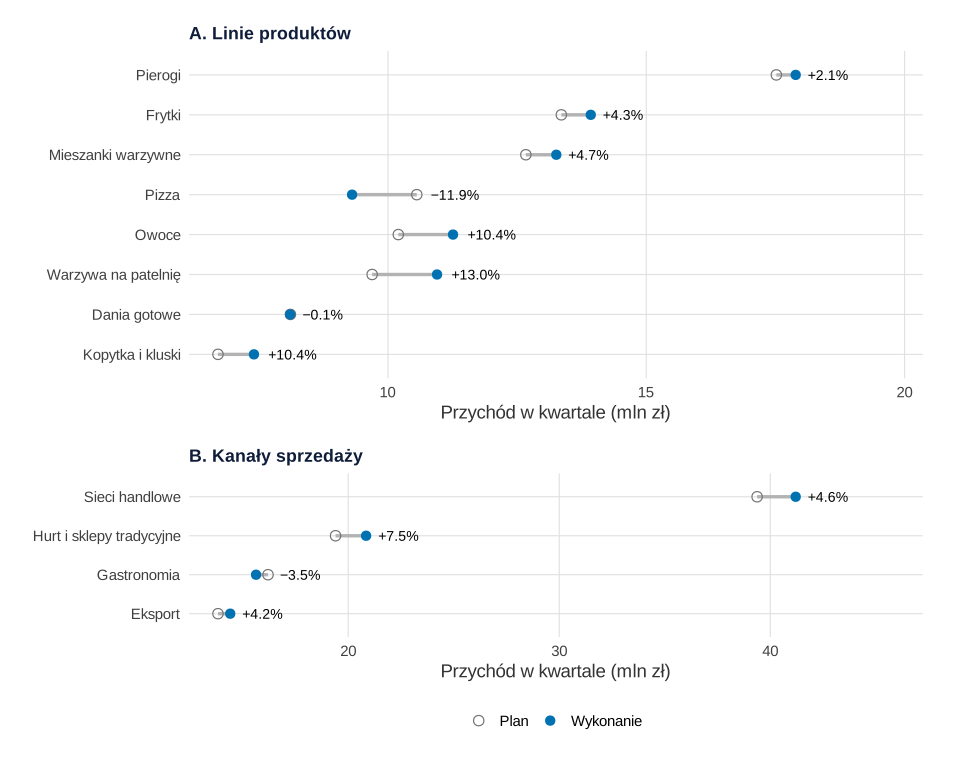
set.seed(710)).Co widać. Sześć linii przekroczyło plan, najmocniej warzywa na patelnię (+13.0%, +1.26 mln zł). Pizza ma 11.9% (1.25 mln zł) mniej. Wśród kanałów pod kreską jest tylko gastronomia (−3.5%).
Jak może zmylić. Procent nie mówi, skąd się wziął. +10.4% owoców może oznaczać więcej ton, wyższe ceny albo przesunięcie do droższego kanału. Na to odpowiada rozbicie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: cena, wolumen i struktura na wykresie wodospadowym
Przychód to suma po 32 parach: tony × cena. Odchylenie rozbijamy na trzy składniki; każdy zmienia jedną rzecz, a resztę trzyma bez zmian.
- Wolumen – więcej ton po średniej cenie planu: 537.2 t × 11.120 zł/kg = +5.97 mln zł.
- Struktura (mix) – inna mieszanka linii i kanałów przy cenach planu. Średnia cena planu przy strukturze wykonania to 10.909 zamiast 11.120 zł/kg, bo więcej poszło do tańszych sieci (46.8% wolumenu zamiast 45.6%), a mniej do droższej gastronomii (16.2% zamiast 17.9%): −1.80 mln zł.
- Cena – wolumen wykonany × różnica cen, zsumowane po parach. W eksporcie dzielimy ją na cenę w euro i kurs.
Q to tony łącznie, p̄P średnia cena planu, p̄P|W średnia cena planu przy strukturze wykonania, P – plan, W – wykonanie. Składniki sumują się dokładnie do odchylenia (3289.1 tys. zł). Pokazuje je wykres wodospadowy („mostek”): pierwszy i ostatni słupek to poziomy, środkowe – zmiany. (W słowniku wykres wodospadowy to posortowane zmiany u poszczególnych osób – zasada „jeden słupek, jedna zmiana” jest ta sama.)
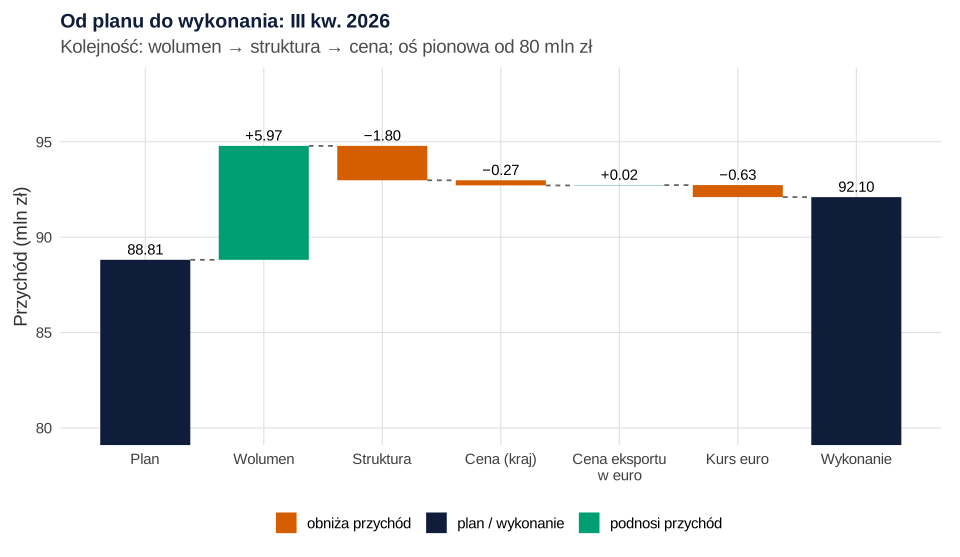
set.seed(710)).Co widać. Sprzedaliśmy o 6.7% więcej ton (8523.8 zamiast 7986.6 t). Ponad 30% zysku z wolumenu zjadła struktura. Ceny w kraju odjęły 0.27 mln zł – to m.in. obniżka dla sieci na frytki. Ceny eksportowe w euro trzymały plan (+0.02 mln zł), ale słabsze euro zabrało 0.63 mln zł.
Jak może zmylić. Oś zaczyna się od 80 mln zł, żeby składniki były widoczne – słupki planu i wykonania nie oddają więc proporcji całego przychodu. Napisz to w podpisie. Struktura po 32 parach miesza przesunięcia między kanałami i między liniami – w razie potrzeby rozbij ją na dwa poziomy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: czy wynik zależy od kolejności rozbicia?
Tak. Wyżej wolumen wyceniliśmy cenami planu, a cenę – wolumenem wykonania. Można odwrotnie: najpierw cena, na końcu wolumen. Trzy czynniki dają 6 kolejności; suma jest ta sama, podział – nie. To ten sam problem, co wybór wag w indeksach cen Laspeyresa i Paaschego i wybór grupy odniesienia w dekompozycji Oaxaki–Blindera. Wiele metod dekompozycji wywodzi się z teorii liczb indeksowych, a wybór między nimi zależy od tego, jakich własności oczekujesz (de Boer i Rodrigues, 2020).
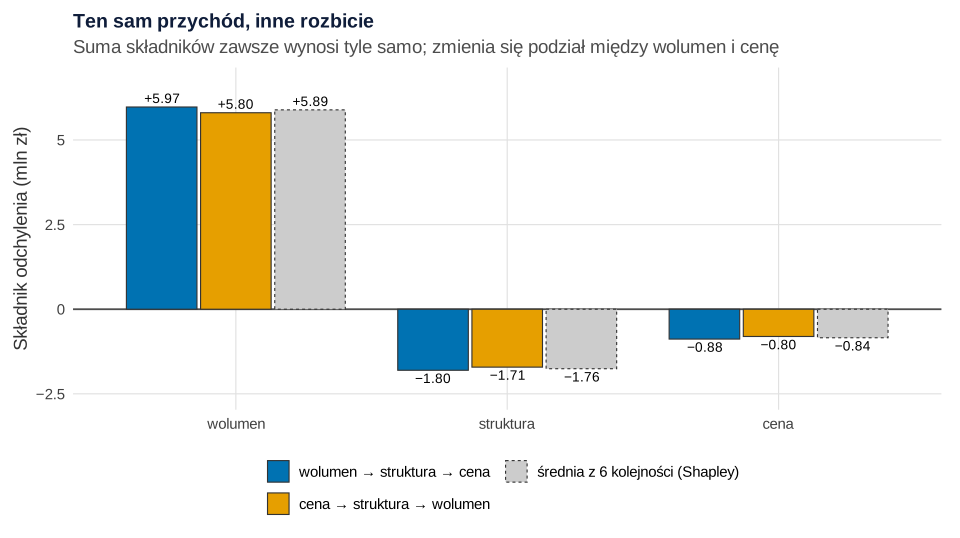
set.seed(710)).Co widać. Efekt wolumenu waha się od 5.80 do 5.97 mln zł, struktury od −1.83 do −1.69 mln zł, ceny od −0.88 do −0.80 mln zł. Różnica dla wolumenu to dokładnie przyrost ton razy zmiana średniej ceny: 537.2 t × (10.805 − 11.120) zł/kg = −0.17 mln zł. Ten wspólny kawałek każda kolejność przypisuje inaczej. Średnia ze wszystkich kolejności to wartość Shapleya – ta sama idea co w SHAP. Daje rozbicie, które sumuje się do całości i nie zależy od kolejności (Audoly i in., 2025): wolumen +5.89, struktura −1.76, cena −0.84 mln zł.
Jak może zmylić. Przy dużych zmianach (nowy produkt, kryzys) kolejność potrafi przesunąć miliony z „ceny” do „wolumenu” – i z premii jednego działu do drugiego. Ustal ją raz i nie zmieniaj co kwartał.
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: plan jako prognoza – czy +3.7% to sukces?
Plan to prognoza, a prognozy się mylą. Porównaj więc odchylenie z tym, jak plan mylił się wcześniej. W 12 poprzednich kwartałach liczymy odchylenie wykonania od planu w procentach, jego średnią i odchylenie standardowe, a potem przedział predykcji dla następnego kwartału:
To empiryczny przedział z historii błędów – podejście, które w prognozowaniu dawało rozsądne pokrycie przy niewielu założeniach (Gardner, 1988). W prognozach energetycznych rozkład normalny oszacowany na wcześniejszych błędach okazał się trafniejszy od scenariuszy (Kaack i in., 2017). Mnożnik z rozkładu t uwzględnia, że średnią i SD znamy tylko z 12 kwartałów.
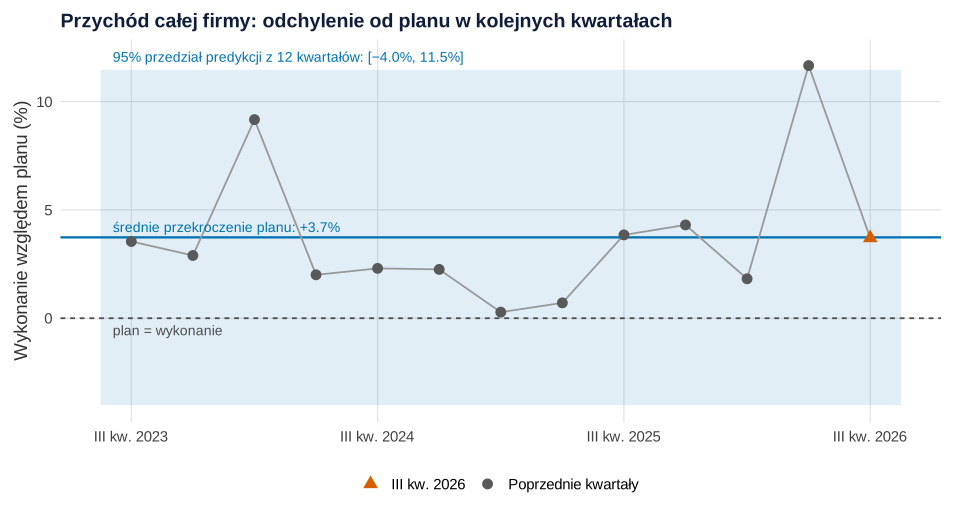
set.seed(710)).Co widać. We wszystkich 12 kwartałach firma przekroczyła plan, średnio o 3.73% (SD = 3.38). Test t dla jednej próby pokazuje, że plan jest systematycznie zaniżony: t(11) = 3.83, p = .003, 95% CI [1.59, 5.88]. Bieżące +3.70% leży na średniej – to norma, nie sukces.
Jak może zmylić. Dwanaście kwartałów to mało, więc przedział [−4.00, 11.47] jest szeroki – i symetryczny, choć błędy planu bywają skośne. Gdy zmienia się sposób planowania, historia błędów przestaje pasować. Dla codziennych wskaźników lepsza jest karta kontrolna (wpis o anomaliach w KPI).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: karta odchyleń – które linie wyszły poza zwykłe wahania?
To samo robimy dla każdej linii osobno: przedział predykcji z jej 12 kwartałów i bieżące odchylenie na tym tle.
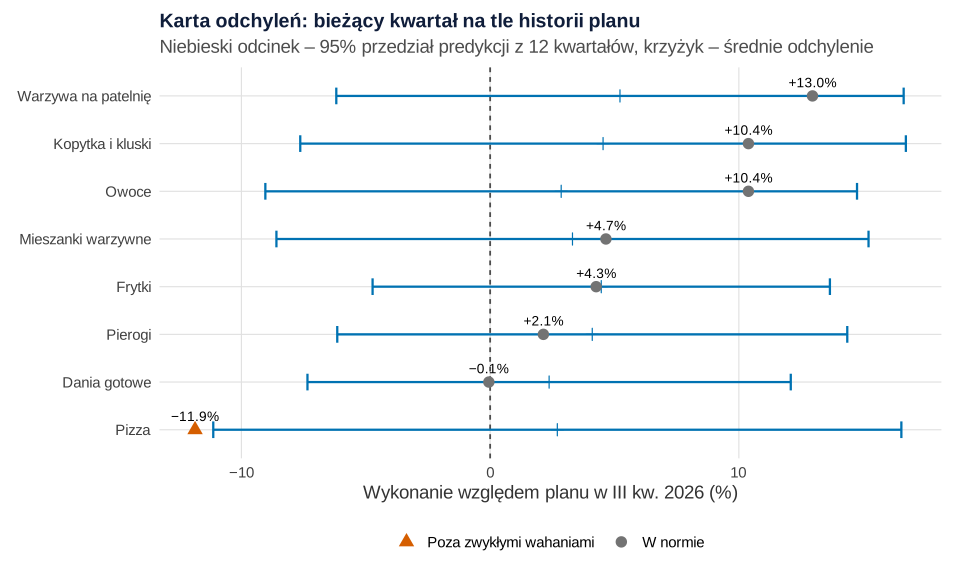
set.seed(710)).Co widać. Poza zwykłe wahania wyszła tylko pizza: −11.9% przy przedziale [−11.1, 16.5]. Rozbicie w kanałach wskazuje przyczynę: mniejszy wolumen w sieciach kosztował 1.52 mln zł – to ukryta przez nas utrata półki. Warzywa na patelnię (+13.0%) wyglądają na hit, ale ich plan był wcześniej zaniżany średnio o 5.2%, a przedział sięga 16.6%.
Jak może zmylić. Przedział wokół zera (bez uwzględnienia zaniżania planu) pokazałby odwrotny obraz: pochwaliłby warzywa (13.0% poza ±11.4%) i przeoczył pizzę (−11.9% w ±13.8%). Druga rzecz: przy 8 liniach i przedziałach 95% szansa, że co najmniej jedna wyjdzie poza przedział przez przypadek, wynosi 33.7% – to problem wielokrotnych porównań. Sygnał to powód, by sprawdzić linię, a nie dowód – u pizzy sprawdzenie kanałów wskazało przyczynę. Linia ze skrajnym wynikiem zwykle w następnym kwartale wraca bliżej średniej (regresja do średniej).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: jak czytać wodospad odchyleń
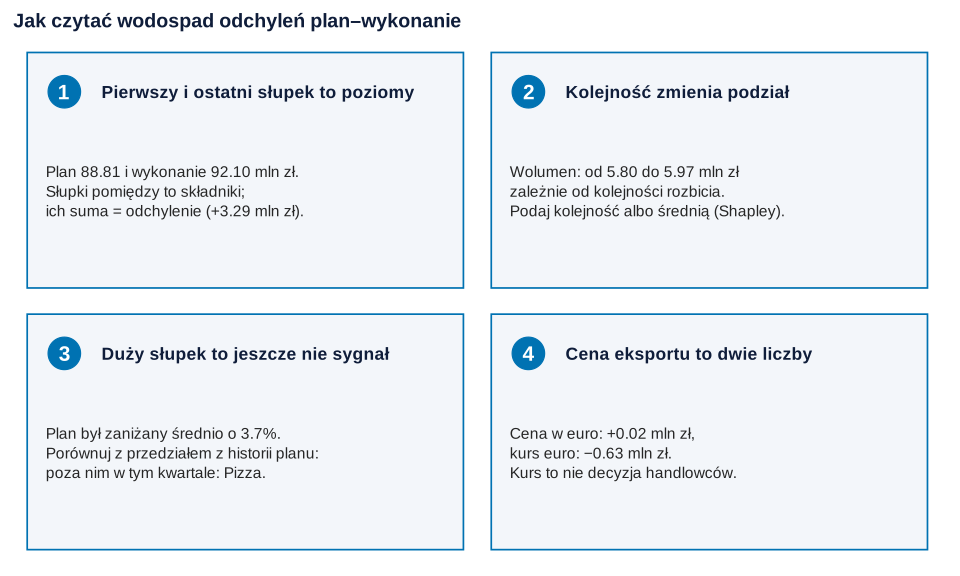
Co widać. Cztery pytania do każdego „mostka” w raporcie: czy składniki sumują się do odchylenia, w jakiej kolejności je liczono, czy odchylenie wychodzi poza zwykły błąd planu i czy cena nie zawiera kursu.
Jak może zmylić. Przy nowym lub wycofanym produkcie (brak planu albo wykonania) cena tej pozycji nie istnieje – pokaż ją osobnym słupkiem.
Podpis do pracy:
Co z tym zrobić w firmie
- Raportuj trzy liczby, nie jedną. +3.29 mln zł to +5.89 z wolumenu, −1.76 ze struktury i −0.84 mln zł z ceny (Shapley); każda ma innego właściciela: sprzedaż, kanały, cennik.
- Zajmij się strukturą. Przesunięcie do sieci kosztem gastronomii zjadło prawie jedną trzecią efektu wolumenu. Sprawdź marżę, nie tylko przychód (wpis o progu rentowności).
- Oddziel kurs od ceny. Ceny w euro trzymały plan; 0.63 mln zł straty to kurs (ryzyko kursowe – wpis o value at risk eksportera).
- Sprawdzaj pizzę, nie warzywa. Interweniuj tam, gdzie odchylenie wychodzi poza przedział z historii planu, nie tam, gdzie słupek jest najwyższy.
- Popraw planowanie. Plan przekroczony 12 razy na 12 jest zaniżany. Gdy premia zależy od „pobicia planu”, menedżerowie mają powód tworzyć rezerwę budżetową; w eksperymencie Stevensa (2002) ograniczały ją troska o reputację i poczucie odpowiedzialności etycznej. W danych firmy produkcyjnej rozbicie prognozy na źródła popytu zmniejszyło jej błąd i dodatnie obciążenie (Brüggen i in., 2021). Śledź średni błąd planu i jego trafność (hasło MAE, RMSE i MAPE); punktem wyjścia do planu może być prognoza sprzedaży z sezonowością.
Jak opisać w pracy
Podaj wzory, kolejność, poziom rozbicia i ocenę niepewności. Ogólne wskazówki: wpis statystyka w pracy z finansów i rachunkowości.
W Wynikach podaj tabelę składników:
| Kolejność rozbicia | Wolumen | Struktura | Cena |
|---|---|---|---|
| wolumen → struktura → cena | 5.97 | −1.80 | −0.88 |
| cena → struktura → wolumen | 5.80 | −1.71 | −0.80 |
| średnia z 6 kolejności (Shapley) | 5.89 | −1.76 | −0.84 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję minus(), z których korzystają następne; przepis 7 bierze liczby z przepisów 3–6. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1 (set.seed(710); ziarno ustalono raz i nie zmieniano). Ręcznie ustalono: ceny i wolumeny planu, udziały kanałów, mnożniki cen w kanałach, sezonowość, wzrost o 1% (wolumen) i 0.5% (cena) na kwartał, zaniżenie planu o ok. 3.5%, rozrzuty odchyleń (kwartał 3%, linia 3%, cena linii 1.5%, para linia × kanał 3% i 1%), fikcyjne kursy (plan 4.30 zł, wykonanie z rozrzutem 2%, w III kw. 2026 – 4.12 zł) i pięć zdarzeń ostatniego kwartału. Po pierwszym uruchomieniu zmieniono raz rozrzut szoku linii w kwartale z 5% na 3% (przy 5% przedziały z historii miały ok. ±20% i karta nie wskazywała żadnej linii). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: plan i wykonanie w 13 kwartałach
R
# Przepis 1. Fikcyjny producent mrożonek: 8 linii × 4 kanały, plan i wykonanie w 13 kwartałach
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Plan" = "grey45", "Wykonanie" = "#0072B2", "Wzrost" = "#009E73", "Spadek" = "#D55E00",
         "Suma" = "#0f1d3a", "W normie" = "grey45", "Poza zwykłymi wahaniami" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "\u2212", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie: cena planowana (zł/kg), wolumen planowany (t na kwartał), udziały kanałów
linie <- c("Pierogi", "Kopytka i kluski", "Mieszanki warzywne", "Warzywa na patelnię",
           "Owoce", "Frytki", "Pizza", "Dania gotowe")
kanaly <- c("Sieci handlowe", "Hurt i sklepy tradycyjne", "Gastronomia", "Eksport")
cena0 <- c(16, 11, 7.5, 10, 14, 6, 22, 19)
wolumen0 <- c(900, 500, 1400, 800, 600, 1800, 400, 350)
udzialy <- rbind(c(.45, .25, .15, .15), c(.45, .30, .15, .10), c(.50, .25, .10, .15), c(.50, .20, .15, .15),
                 c(.35, .15, .15, .35), c(.40, .15, .30, .15), c(.60, .20, .10, .10), c(.50, .20, .20, .10))
mnoznik_ceny <- c(0.92, 1.00, 1.08, 0.95)          # cena w kanale względem ceny bazowej linii
sezon <- c(0.95, 0.95, 1.05, 1.05)                 # kwartały I–IV
kurs_plan <- 4.30                                  # fikcyjny kurs planu, zł za euro

kwartaly <- data.frame(t = 1:13, rok = rep(2023:2026, each = 4)[3:15], kw = rep(1:4, 4)[3:15])
kwartaly$etykieta <- paste0(c("I", "II", "III", "IV")[kwartaly$kw], " kw. ", kwartaly$rok)

set.seed(710)
siatka <- expand.grid(kanal = 1:4, linia = 1:8, t = 1:13)
siatka$wolumen_plan <- wolumen0[siatka$linia] * udzialy[cbind(siatka$linia, siatka$kanal)] *
  sezon[kwartaly$kw[siatka$t]] * 1.01^(siatka$t - 1)
siatka$cena_plan <- cena0[siatka$linia] * mnoznik_ceny[siatka$kanal] * 1.005^(siatka$t - 1)

# Wykonanie = plan × exp(odchylenie). Plan sprzedaży jest celowo ostrożny: wolumen średnio o ok. 3.5% wyższy
# niż w planie. Do tego wspólny szok kwartału, szok linii w kwartale i szum komórki linia × kanał.
szok_kw <- rnorm(13, 0, 0.03)
szok_linii <- matrix(rnorm(13 * 8, 0, 0.03), 13, 8)
szok_ceny <- matrix(rnorm(13 * 8, 0, 0.015), 13, 8)
kurs_wyk <- round(kurs_plan * exp(rnorm(13, 0, 0.02)), 2)
siatka$wolumen <- siatka$wolumen_plan * exp(0.035 + szok_kw[siatka$t] +
                                              szok_linii[cbind(siatka$t, siatka$linia)] + rnorm(nrow(siatka), 0, 0.03))
siatka$cena <- siatka$cena_plan * exp(szok_ceny[cbind(siatka$t, siatka$linia)] + rnorm(nrow(siatka), 0, 0.01))

# Zdarzenia ukryte ręcznie w ostatnim kwartale (t = 13, III kw. 2026)
ost <- siatka$t == 13
kurs_wyk[13] <- 4.12                                               # euro słabsze niż w planie
siatka$wolumen[ost & siatka$linia == 7 & siatka$kanal == 1] <-
  0.70 * siatka$wolumen[ost & siatka$linia == 7 & siatka$kanal == 1]  # pizza: utrata miejsca na półce w sieci
siatka$cena[ost & siatka$linia == 6 & siatka$kanal == 1] <-
  0.94 * siatka$cena[ost & siatka$linia == 6 & siatka$kanal == 1]     # frytki: obniżka ceny dla sieci o 6%,
siatka$wolumen[ost & siatka$linia == 6 & siatka$kanal == 1] <-
  1.12 * siatka$wolumen[ost & siatka$linia == 6 & siatka$kanal == 1]  # … w zamian o 12% większy wolumen
siatka$wolumen[ost & siatka$kanal == 3] <- 0.92 * siatka$wolumen[ost & siatka$kanal == 3]   # gastronomia −8%
siatka$wolumen[ost & siatka$linia == 5 & siatka$kanal == 4] <-
  1.15 * siatka$wolumen[ost & siatka$linia == 5 & siatka$kanal == 4]  # owoce: większe zamówienia z eksportu

# Eksport rozlicza się w euro: cena w zł = cena w euro × kurs
siatka$kurs_plan <- ifelse(siatka$kanal == 4, kurs_plan, 1)
siatka$kurs <- ifelse(siatka$kanal == 4, kurs_wyk[siatka$t], 1)
siatka$cena_waluta_plan <- siatka$cena_plan / siatka$kurs_plan           # eksport: euro/kg, kraj: zł/kg
siatka$cena_waluta <- siatka$cena / siatka$kurs_plan                    # cena „handlowa” w walucie rozliczenia
siatka$cena <- siatka$cena_waluta * siatka$kurs                          # cena w zł/kg po kursie z kwartału

dane <- data.frame(kwartal = kwartaly$etykieta[siatka$t], t = siatka$t, linia = linie[siatka$linia],
                   kanal = kanaly[siatka$kanal],
                   wolumen_plan_t = round(siatka$wolumen_plan, 1),
                   wolumen_t = round(siatka$wolumen, 1),
                   cena_waluta_plan = round(siatka$cena_waluta_plan, 3), cena_waluta = round(siatka$cena_waluta, 3),
                   kurs_plan = siatka$kurs_plan, kurs = siatka$kurs)
dane$cena_plan_zl_kg <- dane$cena_waluta_plan * dane$kurs_plan        # zł/kg (w kraju kurs = 1)
dane$cena_zl_kg <- dane$cena_waluta * dane$kurs
# Przychód w tys. zł: tony × zł/kg = tys. zł
dane$przychod_plan <- dane$wolumen_plan_t * dane$cena_plan_zl_kg
dane$przychod <- dane$wolumen_t * dane$cena_zl_kg
write.csv(dane, "odchylenie-plan-wykonanie-mrozonki.csv", row.names = FALSE)

c(wierszy = nrow(dane), kwartalow = length(unique(dane$t)), linii = length(linie), kanalow = length(kanaly))
biezacy <- dane[dane$t == 13, ]
round(c(przychod_plan = sum(biezacy$przychod_plan), przychod = sum(biezacy$przychod),
        odchylenie = sum(biezacy$przychod) - sum(biezacy$przychod_plan),
        odchylenie_proc = 100 * (sum(biezacy$przychod) / sum(biezacy$przychod_plan) - 1),
        wolumen_plan = sum(biezacy$wolumen_plan_t), wolumen = sum(biezacy$wolumen_t)), 1)
kurs_wyk[13]
Wynik w R
  wierszy kwartalow     linii   kanalow
      416        13         8         4
  przychod_plan        przychod      odchylenie odchylenie_proc    wolumen_plan
        88811.9         92100.9          3289.1             3.7          7986.6
        wolumen
         8523.8
[1] 4.12
2. Plan i wykonanie według linii i kanałów: Rysunek 1
R
# Przepis 2. Plan i wykonanie w III kw. 2026 według linii i kanałów: Rysunek 1
# (korzysta z dane, kol, motyw i minus() z przepisu 1)
library(ggplot2)
library(patchwork)

biezacy <- dane[dane$t == 13, ]
zestaw <- function(grupa) {
  a <- aggregate(cbind(przychod_plan, przychod) ~ g, transform(biezacy, g = biezacy[[grupa]]), sum)
  a$roznica <- a$przychod - a$przychod_plan
  a$proc <- 100 * (a$przychod / a$przychod_plan - 1)
  a[order(a$przychod_plan), ]
}
po_liniach <- zestaw("linia"); po_kanalach <- zestaw("kanal")
print(transform(po_liniach, przychod_plan = round(przychod_plan), przychod = round(przychod),
                roznica = round(roznica), proc = round(proc, 1)), row.names = FALSE)
print(transform(po_kanalach, przychod_plan = round(przychod_plan), przychod = round(przychod),
                roznica = round(roznica), proc = round(proc, 1)), row.names = FALSE)

hantle <- function(a, tytul) {
  a$g <- factor(a$g, a$g)
  dl <- rbind(data.frame(g = a$g, co = "Plan", mln = a$przychod_plan / 1000),
              data.frame(g = a$g, co = "Wykonanie", mln = a$przychod / 1000))
  ggplot(dl, aes(mln, g)) +
    geom_line(aes(group = g), colour = "grey70", linewidth = 1.2) +
    geom_point(aes(colour = co, shape = co), size = 3.2) +
    geom_text(data = a, aes(x = pmax(przychod, przychod_plan) / 1000, y = g,
                            label = minus(sprintf("%+.1f%%", proc))), hjust = -0.3, size = 3.7) +
    scale_colour_manual(values = kol[c("Plan", "Wykonanie")], name = NULL) +
    scale_shape_manual(values = c(Plan = 1, Wykonanie = 16), name = NULL) +
    scale_x_continuous(expand = expansion(mult = c(0.05, 0.22))) +
    labs(x = "Przychód w kwartale (mln zł)", y = NULL, title = tytul) + motyw
}
p1 <- hantle(po_liniach, "A. Linie produktów") / hantle(po_kanalach, "B. Kanały sprzedaży") +
  plot_layout(heights = c(8, 4), guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("odchylenie-plan-wykonanie-linie-kanaly.svg", p1, width = 10, height = 8)
Wynik w R
                   g przychod_plan przychod roznica  proc
    Kopytka i kluski          6708     7405     697  10.4
        Dania gotowe          8111     8107      -4  -0.1
 Warzywa na patelnię          9693    10949    1256  13.0
               Owoce         10200    11259    1059  10.4
               Pizza         10557     9305   -1253 -11.9
  Mieszanki warzywne         12669    13258     590   4.7
              Frytki         13356    13925     569   4.3
             Pierogi         17518    17893     375   2.1
                        g przychod_plan przychod roznica proc
                  Eksport         13831    14412     581  4.2
              Gastronomia         16203    15636    -568 -3.5
 Hurt i sklepy tradycyjne         19402    20850    1447  7.5
           Sieci handlowe         39375    41204    1829  4.6
3. Rozbicie na wolumen, strukturę i cenę: Rysunek 2
R
# Przepis 3. Rozbicie odchylenia na wolumen, strukturę i cenę (z kursem w eksporcie): Rysunek 2
# (korzysta z dane, kol, motyw i minus() z przepisu 1)
library(ggplot2)

b <- dane[dane$t == 13, ]                    # 32 komórki: linia × kanał
Q_plan <- sum(b$wolumen_plan_t); Q <- sum(b$wolumen_t)
R_plan <- sum(b$przychod_plan); R <- sum(b$przychod)
cena_sr_plan <- R_plan / Q_plan              # średnia cena planu przy strukturze planu (zł/kg)
eksport <- b$kanal == "Eksport"

wolumen <- (Q - Q_plan) * cena_sr_plan                                   # więcej ton po średniej cenie planu
struktura <- sum(b$wolumen_t * b$cena_plan_zl_kg) - Q * cena_sr_plan     # inny udział komórek, ceny planu
cena_kraj <- sum((b$wolumen_t * (b$cena_zl_kg - b$cena_plan_zl_kg))[!eksport])
cena_eksport <- sum((b$wolumen_t * (b$cena_waluta - b$cena_waluta_plan) * b$kurs_plan)[eksport])  # w euro
kurs <- sum((b$wolumen_t * b$cena_waluta * (b$kurs - b$kurs_plan))[eksport])                     # przeliczenie
rozbicie <- c(wolumen = wolumen, struktura = struktura, cena_kraj = cena_kraj,
              cena_eksport_w_euro = cena_eksport, kurs = kurs)
round(c(cena_sr_plan = cena_sr_plan, cena_planu_przy_strukturze_wykonania = sum(b$wolumen_t * b$cena_plan_zl_kg) / Q,
        cena_sr_wykonanie = R / Q, wolumen_plan = Q_plan, wolumen = Q, roznica_wolumenu = Q - Q_plan,
        wzrost_wolumenu_proc = 100 * (Q / Q_plan - 1)), 3)
round(c(plan = R_plan, rozbicie, wykonanie = R, suma_skladnikow = sum(rozbicie), odchylenie = R - R_plan), 1)

# Udział kanałów w wolumenie: plan i wykonanie (źródło odchylenia struktury)
round(100 * cbind(plan = tapply(b$wolumen_plan_t, b$kanal, sum) / Q_plan,
                  wykonanie = tapply(b$wolumen_t, b$kanal, sum) / Q), 1)

# Wykres wodospadowy (most od planu do wykonania), wartości w mln zł
kroki <- c("Plan", "Wolumen", "Struktura", "Cena (kraj)", "Cena eksportu\nw euro", "Kurs euro", "Wykonanie")
wart <- c(R_plan, rozbicie, R) / 1000
koniec <- c(wart[1], wart[1] + cumsum(wart[2:6]), wart[7])
poczatek <- c(0, koniec[1:5], 0)
w <- data.frame(krok = factor(kroki, kroki), x = 1:7, poczatek, koniec,
                rodzaj = c("Suma", ifelse(wart[2:6] >= 0, "Wzrost", "Spadek"), "Suma"),
                etykieta = minus(c(sprintf("%.2f", wart[1]), sprintf("%+.2f", wart[2:6]), sprintf("%.2f", wart[7]))))
p2 <- ggplot(w) +
  geom_rect(aes(xmin = x - 0.38, xmax = x + 0.38, ymin = pmin(poczatek, koniec), ymax = pmax(poczatek, koniec),
                fill = rodzaj)) +
  geom_segment(data = w[1:6, ], aes(x = x + 0.38, xend = x + 0.62, y = koniec, yend = koniec),
               colour = "grey40", linetype = "22") +
  geom_text(aes(x, pmax(poczatek, koniec), label = etykieta), vjust = -0.5, size = 3.9) +
  scale_fill_manual(values = kol[c("Suma", "Wzrost", "Spadek")],
                    labels = c(Suma = "plan / wykonanie", Wzrost = "podnosi przychód", Spadek = "obniża przychód"),
                    name = NULL) +
  scale_x_continuous(breaks = 1:7, labels = kroki) +
  coord_cartesian(ylim = c(80, 98)) +
  labs(x = NULL, y = "Przychód (mln zł)",
       title = "Od planu do wykonania: III kw. 2026",
       subtitle = "Kolejność: wolumen → struktura → cena; oś pionowa od 80 mln zł") + motyw
p2   # zapis: ggsave("odchylenie-plan-wykonanie-wodospad.svg", p2, width = 10, height = 5.8)
Wynik w R
                        cena_sr_plan cena_planu_przy_strukturze_wykonania
                              11.120                               10.909
                   cena_sr_wykonanie                         wolumen_plan
                              10.805                             7986.600
                             wolumen                     roznica_wolumenu
                            8523.800                              537.200
                wzrost_wolumenu_proc
                               6.726
               plan             wolumen           struktura           cena_kraj
            88811.9              5973.7             -1803.1              -269.4
cena_eksport_w_euro                kurs           wykonanie     suma_skladnikow
               17.5              -629.6             92100.9              3289.1
         odchylenie
             3289.1
                         plan wykonanie
Eksport                  15.9      16.1
Gastronomia              17.9      16.2
Hurt i sklepy tradycyjne 20.7      20.9
Sieci handlowe           45.6      46.8
4. Sześć kolejności rozbicia i wartość Shapleya: Rysunek 3
R
# Przepis 4. Czy wynik zależy od kolejności rozbicia? Sześć kolejności i średnia (wartość Shapleya): Rysunek 3
# (korzysta z dane, motyw i minus() z przepisu 1)
library(ggplot2)

b <- dane[dane$t == 13, ]
# Przychód jako funkcja trzech czynników: wolumen łączny Q, struktura s (udziały komórek), ceny p (zł/kg)
przychod <- function(Q, s, p) Q * sum(s * p)
czynniki_plan <- list(Q = sum(b$wolumen_plan_t), s = b$wolumen_plan_t / sum(b$wolumen_plan_t), p = b$cena_plan_zl_kg)
czynniki_wyk <- list(Q = sum(b$wolumen_t), s = b$wolumen_t / sum(b$wolumen_t), p = b$cena_zl_kg)

rozbij <- function(kolejnosc) {      # zmieniamy czynniki z planu na wykonanie po kolei i zapisujemy przyrosty
  stan <- czynniki_plan; wynik <- c(Q = 0, s = 0, p = 0)
  for (k in kolejnosc) {
    przed <- do.call(przychod, stan); stan[[k]] <- czynniki_wyk[[k]]
    wynik[k] <- do.call(przychod, stan) - przed
  }
  wynik
}
kolejnosci <- list(c("Q", "s", "p"), c("Q", "p", "s"), c("s", "Q", "p"), c("s", "p", "Q"), c("p", "Q", "s"), c("p", "s", "Q"))
nazwy <- c(Q = "wolumen", s = "struktura", p = "cena")
tab <- t(sapply(kolejnosci, rozbij)); colnames(tab) <- nazwy[colnames(tab)]
rownames(tab) <- sapply(kolejnosci, function(k) paste(nazwy[k], collapse = " → "))
tab <- rbind(tab, "średnia z 6 kolejności (Shapley)" = colMeans(tab))
round(cbind(tab, suma = rowSums(tab)), 1)

# Skąd różnica? Wolumen wyceniony średnią ceną planu (wolumen pierwszy) albo średnią ceną wykonania (wolumen
# ostatni): różnica = (Q − Q_plan) × (średnia cena wykonania − średnia cena planu)
dQ <- czynniki_wyk$Q - czynniki_plan$Q
srednia_cena <- c(plan = sum(czynniki_plan$s * czynniki_plan$p), wykonanie = sum(czynniki_wyk$s * czynniki_wyk$p))
round(c(srednia_cena, roznica_wolumenu = dQ * unname(srednia_cena[2] - srednia_cena[1])), 3)

wybrane <- c("wolumen → struktura → cena", "cena → struktura → wolumen", "średnia z 6 kolejności (Shapley)")
dl <- data.frame(kolejnosc = rep(wybrane, each = 3), skladnik = rep(colnames(tab), 3),
                 tys = as.vector(t(tab[wybrane, ])))
dl$kolejnosc <- factor(dl$kolejnosc, wybrane)
dl$skladnik <- factor(dl$skladnik, c("wolumen", "struktura", "cena"))
p3 <- ggplot(dl, aes(skladnik, tys / 1000, fill = kolejnosc)) +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_col(aes(linetype = kolejnosc), position = position_dodge(0.82), width = 0.78, colour = "grey20",
           linewidth = 0.4) +
  geom_text(aes(label = minus(sprintf("%+.2f", tys / 1000)), vjust = ifelse(tys >= 0, -0.4, 1.3)),
            position = position_dodge(0.82), size = 3.6) +
  scale_fill_manual(values = c("#0072B2", "#E69F00", "grey80"), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "22"), name = NULL) +
  scale_y_continuous(expand = expansion(mult = 0.15), labels = minus) +
  labs(x = NULL, y = "Składnik odchylenia (mln zł)",
       title = "Ten sam przychód, inne rozbicie",
       subtitle = "Suma składników zawsze wynosi tyle samo; zmienia się podział między wolumen i cenę") +
  motyw + guides(fill = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2))
p3   # zapis: ggsave("odchylenie-plan-wykonanie-kolejnosc.svg", p3, width = 10, height = 5.6)
Wynik w R
                                 wolumen struktura   cena   suma
wolumen → struktura → cena        5973.7   -1803.1 -881.6 3289.1
wolumen → cena → struktura        5973.7   -1825.6 -859.1 3289.1
struktura → wolumen → cena        5860.1   -1689.5 -881.6 3289.1
struktura → cena → wolumen        5804.5   -1689.5 -826.0 3289.1
cena → wolumen → struktura        5919.6   -1825.6 -804.9 3289.1
cena → struktura → wolumen        5804.5   -1710.5 -804.9 3289.1
średnia z 6 kolejności (Shapley)  5889.4   -1757.3 -843.0 3289.1
            plan        wykonanie roznica_wolumenu
          11.120           10.805         -169.196
5. Historia błędów planu i przedział predykcji: Rysunek 4
R
# Przepis 5. Historia błędów planu: czy +3% to sukces? Przedział z 12 poprzednich kwartałów: Rysunek 4
# (korzysta z dane, kwartaly, motyw i minus() z przepisu 1)
library(ggplot2)

calosc <- aggregate(cbind(przychod_plan, przychod) ~ t, dane, sum)
calosc$blad <- 100 * (calosc$przychod / calosc$przychod_plan - 1)       # odchylenie od planu w %
hist <- calosc$blad[calosc$t <= 12]; teraz <- calosc$blad[calosc$t == 13]
n <- length(hist); m <- mean(hist); s <- sd(hist)
# Przedział predykcji dla kolejnego błędu planu (rozkład t, n − 1 df): m ± t × s × √(1 + 1/n)
polowa <- qt(0.975, n - 1) * s * sqrt(1 + 1 / n)
round(c(kwartalow = n, srednia = m, sd = s, dolna = m - polowa, gorna = m + polowa, teraz = teraz,
        kwartalow_powyzej_planu = sum(hist > 0), min = min(hist), max = max(hist)), 2)
# Wersja naiwna: zakłada, że plan jest nieobciążony (środek w 0)
round(c(naiwna_dolna = -polowa, naiwna_gorna = polowa), 2)
t.test(hist)                                                             # czy plan jest średnio zaniżany?

calosc$okres <- ifelse(calosc$t == 13, "III kw. 2026", "Poprzednie kwartały")
p4 <- ggplot(calosc, aes(t, blad)) +
  annotate("rect", xmin = 0.5, xmax = 13.5, ymin = m - polowa, ymax = m + polowa, fill = "#0072B2", alpha = 0.12) +
  geom_hline(yintercept = m, colour = "#0072B2", linewidth = 0.8) +
  geom_hline(yintercept = 0, colour = "grey30", linetype = "22") +
  geom_line(colour = "grey60") +
  geom_point(aes(shape = okres, colour = okres), size = 3.4) +
  annotate("text", x = 0.7, y = m + polowa + 0.6, hjust = 0, size = 3.7, colour = "#0072B2",
           label = minus(sprintf("95%% przedział predykcji z 12 kwartałów: [%.1f%%, %.1f%%]", m - polowa, m + polowa))) +
  annotate("text", x = 0.7, y = m + 0.25, hjust = 0, vjust = 0, size = 3.7, colour = "#0072B2",
           label = sprintf("średnie przekroczenie planu: %+.1f%%", m)) +
  annotate("text", x = 0.7, y = -0.55, hjust = 0, size = 3.7, colour = "grey30", label = "plan = wykonanie") +
  scale_colour_manual(values = c("III kw. 2026" = "#D55E00", "Poprzednie kwartały" = "grey35"), name = NULL) +
  scale_shape_manual(values = c("III kw. 2026" = 17, "Poprzednie kwartały" = 16), name = NULL) +
  scale_x_continuous(breaks = c(1, 5, 9, 13), labels = kwartaly$etykieta[c(1, 5, 9, 13)]) +
  scale_y_continuous(labels = minus) +
  labs(x = NULL, y = "Wykonanie względem planu (%)",
       title = "Przychód całej firmy: odchylenie od planu w kolejnych kwartałach") + motyw
p4   # zapis: ggsave("odchylenie-plan-wykonanie-historia-planu.svg", p4, width = 10, height = 5.4)
Wynik w R
              kwartalow                 srednia                      sd
                  12.00                    3.73                    3.38
                  dolna                   gorna                   teraz
                  -4.00                   11.47                    3.70
kwartalow_powyzej_planu                     min                     max
                  12.00                    0.28                   11.66
naiwna_dolna naiwna_gorna
       -7.74         7.74

	One Sample t-test

data:  hist
t = 3.8288, df = 11, p-value = 0.0028
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
 1.586624 5.877333
sample estimates:
mean of x
 3.731979
6. Karta odchyleń linii: Rysunek 5
R
# Przepis 6. Karta odchyleń linii: które wyszły poza zwykłe wahania planu? Rysunek 5
# (korzysta z dane, kol, motyw i minus() z przepisu 1)
library(ggplot2)

l <- aggregate(cbind(przychod_plan, przychod) ~ t + linia, dane, sum)
l$blad <- 100 * (l$przychod / l$przychod_plan - 1)
karta <- do.call(rbind, lapply(split(l, l$linia), function(d) {
  h <- d$blad[d$t <= 12]; n <- length(h)
  polowa <- qt(0.975, n - 1) * sd(h) * sqrt(1 + 1 / n)
  teraz <- d[d$t == 13, ]
  data.frame(linia = d$linia[1], srednia = mean(h), polowa = polowa, dolna = mean(h) - polowa, gorna = mean(h) + polowa,
             teraz = teraz$blad, tys_zl = teraz$przychod - teraz$przychod_plan,
             naiwnie_poza = abs(teraz$blad) > polowa)          # przedział wokół 0, bez obciążenia planu
}))
karta$ocena <- ifelse(karta$teraz < karta$dolna | karta$teraz > karta$gorna, "Poza zwykłymi wahaniami", "W normie")
karta <- karta[order(karta$teraz), ]
print(transform(karta, srednia = round(srednia, 1), polowa = round(polowa, 1), dolna = round(dolna, 1), gorna = round(gorna, 1),
                teraz = round(teraz, 1), tys_zl = round(tys_zl)), row.names = FALSE)
# Przy 8 liniach i przedziałach 95% sygnał „przez przypadek” w co najmniej jednej linii:
round(c(szansa_falszywego_sygnalu = 1 - 0.95^8), 3)

# Skąd odchylenie pizzy? Rozbicie w kanałach: wolumen po cenach planu i cena
pizza <- dane[dane$t == 13 & dane$linia == "Pizza", ]
round(data.frame(row.names = pizza$kanal, wolumen = (pizza$wolumen_t - pizza$wolumen_plan_t) * pizza$cena_plan_zl_kg,
                 cena = pizza$wolumen_t * (pizza$cena_zl_kg - pizza$cena_plan_zl_kg)))

karta$linia <- factor(karta$linia, karta$linia)
p5 <- ggplot(karta, aes(y = linia)) +
  geom_vline(xintercept = 0, colour = "grey30", linetype = "22") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.35, orientation = "y", colour = "#0072B2", linewidth = 0.8) +
  geom_point(aes(x = srednia), shape = 3, size = 2.6, colour = "#0072B2") +
  geom_point(aes(x = teraz, colour = ocena, shape = ocena), size = 3.6) +
  geom_text(aes(x = teraz, label = minus(sprintf("%+.1f%%", teraz))), vjust = -0.9, size = 3.6) +
  scale_x_continuous(labels = minus) +
  scale_colour_manual(values = kol[c("W normie", "Poza zwykłymi wahaniami")], name = NULL) +
  scale_shape_manual(values = c("W normie" = 16, "Poza zwykłymi wahaniami" = 17), name = NULL) +
  labs(x = "Wykonanie względem planu w III kw. 2026 (%)", y = NULL,
       title = "Karta odchyleń: bieżący kwartał na tle historii planu",
       subtitle = "Niebieski odcinek – 95% przedział predykcji z 12 kwartałów, krzyżyk – średnie odchylenie") + motyw
p5   # zapis: ggsave("odchylenie-plan-wykonanie-karta-odchylen.svg", p5, width = 10, height = 6)
Wynik w R
               linia srednia polowa dolna gorna teraz tys_zl naiwnie_poza
               Pizza     2.7   13.8 -11.1  16.5 -11.9  -1253        FALSE
        Dania gotowe     2.4    9.7  -7.3  12.1  -0.1     -4        FALSE
             Pierogi     4.1   10.3  -6.1  14.4   2.1    375        FALSE
              Frytki     4.5    9.2  -4.7  13.7   4.3    569        FALSE
  Mieszanki warzywne     3.3   11.9  -8.6  15.2   4.7    590        FALSE
               Owoce     2.9   11.9  -9.0  14.8  10.4   1059        FALSE
    Kopytka i kluski     4.5   12.2  -7.6  16.7  10.4    697        FALSE
 Warzywa na patelnię     5.2   11.4  -6.2  16.6  13.0   1256         TRUE
                   ocena
 Poza zwykłymi wahaniami
                W normie
                W normie
                W normie
                W normie
                W normie
                W normie
                W normie
szansa_falszywego_sygnalu
                    0.337
                         wolumen cena
Sieci handlowe             -1517   -6
Hurt i sklepy tradycyjne     145   23
Gastronomia                    5   20
Eksport                      111  -33
7. Grafika „jak czytać wodospad odchyleń”: Rysunek 6
R
# Przepis 7. Grafika: karta „jak czytać wodospad odchyleń” (Rysunek 6)
# (korzysta z motyw i minus() z przepisu 1, R_plan, R, rozbicie z przepisu 3, tab z przepisu 4, m z przepisu 5 i karta z przepisu 6)
library(ggplot2)

mln <- function(x) minus(sprintf("%+.2f mln zł", x / 1000))
zakres_wol <- range(tab[1:6, "wolumen"]) / 1000
poza <- as.character(karta$linia[karta$ocena == "Poza zwykłymi wahaniami"])
karty <- data.frame(
  x = c(0, 1, 0, 1), y = c(1, 1, 0, 0),
  nr = c("1", "2", "3", "4"),
  tytul = c("Pierwszy i ostatni słupek to poziomy", "Kolejność zmienia podział",
            "Duży słupek to jeszcze nie sygnał", "Cena eksportu to dwie liczby"),
  tekst = c(sprintf("Plan %.2f i wykonanie %.2f mln zł.\nSłupki pomiędzy to składniki;\nich suma = odchylenie (%s).",
                    R_plan / 1000, R / 1000, mln(R - R_plan)),
            sprintf("Wolumen: od %.2f do %.2f mln zł\nzależnie od kolejności rozbicia.\nPodaj kolejność albo średnią (Shapley).",
                    zakres_wol[1], zakres_wol[2]),
            sprintf("Plan był zaniżany średnio o %.1f%%.\nPorównuj z przedziałem z historii planu:\npoza nim w tym kwartale: %s.",
                    m, paste(poza, collapse = ", ")),
            sprintf("Cena w euro: %s,\nkurs euro: %s.\nKurs to nie decyzja handlowców.",
                    mln(rozbicie[["cena_eksport_w_euro"]]), mln(rozbicie[["kurs"]]))))
p6 <- ggplot(karty) +
  geom_rect(aes(xmin = x + 0.03, xmax = x + 0.97, ymin = y + 0.05, ymax = y + 0.95),
            fill = "#f3f6fa", colour = "#0072B2", linewidth = 0.6) +
  geom_point(aes(x + 0.11, y + 0.80), size = 11, colour = "#0072B2") +
  geom_text(aes(x + 0.11, y + 0.80, label = nr), colour = "white", fontface = "bold", size = 5.5) +
  geom_text(aes(x + 0.19, y + 0.80, label = tytul), hjust = 0, fontface = "bold", size = 4.6, colour = "#0f1d3a") +
  geom_text(aes(x + 0.07, y + 0.42, label = tekst), hjust = 0, size = 4.1, lineheight = 1.05, colour = "grey15") +
  scale_x_continuous(limits = c(0, 2), expand = c(0, 0)) + scale_y_continuous(limits = c(0, 2), expand = c(0, 0)) +
  labs(x = NULL, y = NULL, title = "Jak czytać wodospad odchyleń plan–wykonanie") +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p6   # zapis: ggsave("odchylenie-plan-wykonanie-jak-czytac-wodospad.svg", p6, width = 10, height = 6)
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("plan – wykonanie" = c("grey45", "#0072B2"), "wzrost – spadek" = c("#009E73", "#D55E00"),
             "wzrost – plan/wykonanie" = c("#009E73", "#0f1d3a"), "dwie kolejności" = c("#0072B2", "#E69F00"),
             "w normie – poza wahaniami" = c("grey45", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
plan – wykonanie                            41.5         45.1       38.2
wzrost – spadek                            102.4         53.5       37.3
wzrost – plan/wykonanie                     76.8         54.9       61.6
dwie kolejności                            120.2        121.5      109.3
w normie – poza wahaniami                   76.9         63.4       53.8
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, rozbicie, przedziały predykcji i test t – pakiet stats i funkcje podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Plan zaniżany celowo. „Pobiliśmy plan” znaczy coś tylko na tle historii błędów planu (Rysunek 4).
- Efekty kursowe w eksporcie. Cena w złotych miesza decyzję handlową i kurs; licz je osobno.
- Zbyt ogólny poziom. Licząc tylko po kanałach, przesunięcie między liniami „wpada” do ceny.
- Kolejność zmieniana po fakcie. Wybór kolejności, która lepiej wygląda w tym kwartale, to ukryta manipulacja wynikiem.
Najczęstsze pytania
Jak policzyć odchylenie cenowe, ilościowe i struktury sprzedaży?
Odchylenie ilościowe (wolumenu) to różnica łącznego wolumenu pomnożona przez średnią cenę planu. Odchylenie struktury to wolumen wykonany razy różnica średniej ceny planu przy strukturze wykonania i przy strukturze planu. Odchylenie cenowe to suma iloczynów wolumenu wykonanego i różnicy cen. Trzy składniki sumują się dokładnie do różnicy przychodu wykonanego i planowanego.
Dlaczego wynik analizy odchyleń zależy od kolejności?
Bo zmiana ceny i zmiana wolumenu mają część wspólną (przyrost ilości × zmiana ceny), którą każda kolejność przypisuje innemu składnikowi. W przykładzie efekt wolumenu wynosił od 5.80 do 5.97 mln zł zależnie od kolejności. Ustal kolejność raz albo podaj średnią ze wszystkich kolejności, czyli wartość Shapleya (Audoly i in., 2025).
Co to jest odchylenie struktury (mix) sprzedaży?
To część odchylenia przychodu, która wynika z tego, że sprzedano inną mieszankę produktów lub kanałów niż w planie, przy cenach z planu. Gdy rośnie udział tańszych pozycji, średnia cena spada i odchylenie struktury jest ujemne – w przykładzie przesunięcie sprzedaży z gastronomii do sieci kosztowało 1.80 mln zł.
Jak sprawdzić, czy odchylenie od planu jest istotne?
Potraktuj plan jak prognozę: policz odchylenia od planu z poprzednich okresów, ich średnią i odchylenie standardowe, a następnie przedział predykcji dla kolejnego okresu. Odchylenie poza przedziałem to sygnał do sprawdzenia, ale przy wielu liniach część sygnałów pojawi się przypadkiem – przy 8 liniach szansa na co najmniej jeden wynosi 33.7%.
Jak pokazać kurs walutowy w analizie odchyleń eksportu?
Podziel odchylenie ceny eksportowej na dwie części: zmianę ceny w walucie kontraktu przeliczoną po kursie planu oraz różnicę kursu pomnożoną przez przychód w walucie. W przykładzie ceny w euro dały +0.02 mln zł, a słabsze euro −0.63 mln zł – to nie jest wynik decyzji cenowych działu sprzedaży.
Powiązane hasła
Przeczytaj też
Indeks cen: Laspeyres, Paasche i Fisher
30 produktów bezglutenowych i 3 lata cen: trzy wzory ręcznie w R, substytucja, dryf łańcucha, przychód na ceny i ilości oraz mniejsza paczka.
Czytaj →PoradnikPróg rentowności z niepewnością
Ile myć pokryje koszty nowej myjni i jak często 1. rok kończy się stratą? Próg ze wzoru, 10 000 scenariuszy, czas zwrotu i tornado – z kodem R.
Czytaj →PoradnikAnomalie w KPI – karta kontrolna
Sklep sportowy i dzienna konwersja: karta p, dzień tygodnia, poprawka Laneya, EWMA, CUSUM i symulacja fałszywych alarmów – pięć rysunków z kodem R.
Czytaj →Analizujesz odchylenia od planu albo piszesz o nich pracę?
Pomożemy rozbić odchylenie na cenę, wolumen i strukturę, ocenić, które odchylenia wychodzą poza zwykłe wahania planu, i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Audoly, R., McGee, R., Ocampo, S., & Paz-Pardo, G. (2025). A practitioner's note on the Shapley-Owen-Shorrocks decomposition. Federal Reserve Bank of New York. https://doi.org/10.59576/sr.1163 ● Otwarty dostęp
- Brüggen, A., Grabner, I., & Sedatole, K. L. (2021). The folly of forecasting: The effects of a disaggregated demand forecasting system on forecast error, forecast positive bias, and inventory levels. The Accounting Review, 96(2), 127–152. https://doi.org/10.2308/tar-2018-0559 ● Otwarty dostęp: pełny tekst
- de Boer, P., & Rodrigues, J. F. D. (2020). Decomposition analysis: When to use which method? Economic Systems Research, 32(1), 1–28. https://doi.org/10.1080/09535314.2019.1652571 ● Otwarty dostęp
- Gardner, E. S. (1988). A simple method of computing prediction intervals for time series forecasts. Management Science, 34(4), 541–546. https://doi.org/10.1287/mnsc.34.4.541
- Kaack, L. H., Apt, J., Morgan, M. G., & McSharry, P. (2017). Empirical prediction intervals improve energy forecasting. Proceedings of the National Academy of Sciences, 114(33), 8752–8757. https://doi.org/10.1073/pnas.1619938114 ● Otwarty dostęp
- Stevens, D. E. (2002). The effects of reputation and ethics on budgetary slack. Journal of Management Accounting Research, 14(1), 153–171. https://doi.org/10.2308/jmar.2002.14.1.153 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@techreport{audoly2025practitioner, author={Audoly, Richard and McGee, Rory and Ocampo, Sergio and Paz-Pardo, Gonzalo}, title={{A practitioner's note on the Shapley-Owen-Shorrocks decomposition}}, year={2025}, eid={1163}, institution={Federal Reserve Bank of New York}, doi={10.59576/sr.1163}}@article{bruggen2021folly, author={Br{\"u}ggen, Alexander and Grabner, Isabella and Sedatole, Karen L.}, title={{The folly of forecasting: The effects of a disaggregated demand forecasting system on forecast error, forecast positive bias, and inventory levels}}, journal={The Accounting Review}, year={2021}, volume={96}, number={2}, pages={127--152}, doi={10.2308/tar-2018-0559}}@article{deboer2020decomposition, author={de Boer, Paul and Rodrigues, Jo{\~a}o F. D.}, title={{Decomposition analysis: When to use which method?}}, journal={Economic Systems Research}, year={2020}, volume={32}, number={1}, pages={1--28}, doi={10.1080/09535314.2019.1652571}}@article{gardner1988simple, author={Gardner, Everette S.}, title={{A simple method of computing prediction intervals for time series forecasts}}, journal={Management Science}, year={1988}, volume={34}, number={4}, pages={541--546}, doi={10.1287/mnsc.34.4.541}}@article{kaack2017empirical, author={Kaack, Lynn H. and Apt, Jay and Morgan, M. Granger and McSharry, Patrick}, title={{Empirical prediction intervals improve energy forecasting}}, journal={Proceedings of the National Academy of Sciences}, year={2017}, volume={114}, number={33}, pages={8752--8757}, doi={10.1073/pnas.1619938114}}@article{stevens2002effects, author={Stevens, Douglas E.}, title={{The effects of reputation and ethics on budgetary slack}}, journal={Journal of Management Accounting Research}, year={2002}, volume={14}, number={1}, pages={153--171}, doi={10.2308/jmar.2002.14.1.153}}