Przykład: wypożyczalnia samochodów i 8000 rezerwacji
Fikcyjna wypożyczalnia samochodów ma model, który dla każdej rezerwacji podaje ryzyko anulowania. Dział obsługi pyta: dlaczego ta rezerwacja ma 63% ryzyka i co z tym zrobić? Pokazujemy cztery narzędzia, które na to odpowiadają, i ich granice.
Mamy 8000 rezerwacji i sześć cech znanych w chwili rezerwacji: wyprzedzenie (dni do odbioru auta, mediana 30), przedpłatę (41.7% rezerwacji), kanał (porównywarka cen albo strona własna), długość wynajmu, wcześniejsze anulowania klienta i minutę złożenia rezerwacji. Anulowano 30.4% rezerwacji: 45% bez przedpłaty i 10% z przedpłatą.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustaliliśmy ręcznie: ryzyko rośnie z wyprzedzeniem i się wypłaszcza, przy przedpłacie słabiej (interakcja), a minuta nie działa wcale. Dodaliśmy cechę, której firma nie zna: „pewność planów” – pewni klienci częściej płacą z góry i rzadziej anulują. Ziarna 662 nie zmienialiśmy. Jeden parametr poprawiliśmy po pierwszym uruchomieniu: wyraz wolny prawdziwego modelu obniżyliśmy z −2.0 do −2.4, żeby odsetek anulowań spadł z 36% do bardziej realistycznych 30%; reszta parametrów została bez zmian. Dane pobierzesz jako anulowania-rezerwacji-wypozyczalnia.csv.
Uczymy dwa modele na 6000 losowo wybranych rezerwacjach: las losowy (300 drzew; zob. drzewa decyzyjne i lasy losowe) i regresję logistyczną z logarytmem wyprzedzenia. Na pozostałych 2000 rezerwacjach (30.6% anulowań) oba odróżniają anulowania podobnie: pole pod krzywą ROC wynosi AUC = .768 dla lasu i .778 dla regresji. Ocenę modelu opisuje wpis modele predykcyjne: walidacja i kalibracja. Tu pytamy: czego model się nauczył?
Rysunek 1: które cechy są ważne?
Ważność permutacyjna mówi, o ile pogorszy się model, jeśli jedną cechę przemieszamy losowo między rezerwacjami. Breiman (2001) liczył ją w lesie na obserwacjach spoza prób bootstrapowych. My liczymy ją na zbiorze testowym jako spadek AUC, dla obu modeli, na 100 próbach bootstrapowych zbioru testowego (za każdym razem nowa permutacja).
Las ma też miarę „wbudowaną”: ważność z nieczystości, czyli sumę spadków indeksu Giniego w podziałach drzew na danej cesze (zbiór uczący).
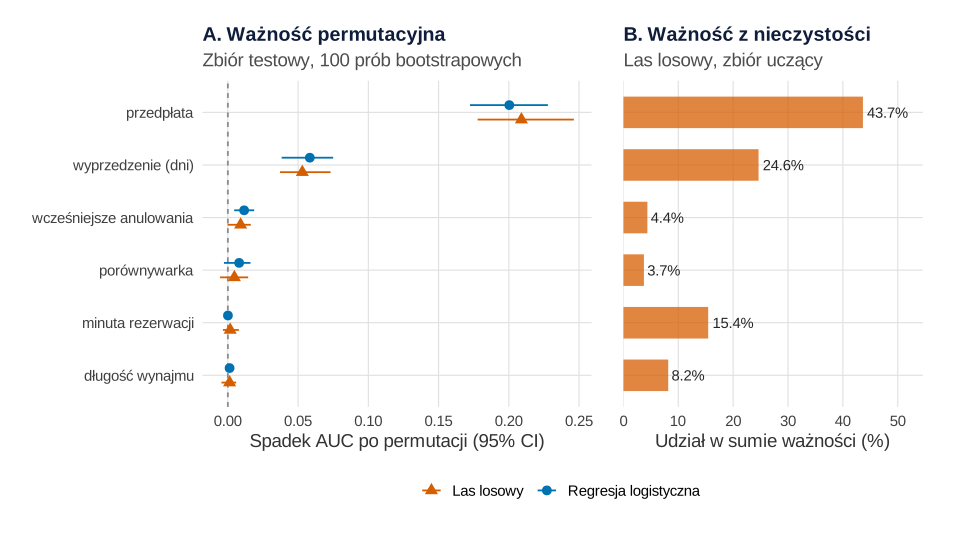
set.seed(662)).Co widać. Kolejność w obu modelach jest ta sama. Przemieszanie przedpłaty obniża AUC lasu o 0.209, 95% CI [0.178, 0.246], wyprzedzenia o 0.053 [0.037, 0.073]. Porównywarka, długość wynajmu i minuta mają przedziały obejmujące zero (minuta: 0.002 [−0.004, 0.008]).
Jak może zmylić. Ważność z nieczystości daje minucie rezerwacji, czyli czystemu szumowi, 15.4% sumy – więcej niż wcześniejszym anulowaniom (4.4%). Minuta ma 60 możliwych punktów podziału, a cecha zero-jedynkowa jeden, więc drzewa „znajdują” w niej przypadkowe różnice. Strobl i in. (2007) pokazali, że ta miara jest niewiarygodna, gdy cechy różnią się skalą pomiaru lub liczbą kategorii. W ważności permutacyjnej na danych testowych minuta ma 0.6% sumy. Przedział z bootstrapu opisuje niepewność zbioru testowego przy ustalonym modelu, nie zmienność samego modelu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: jak ryzyko zależy od wyprzedzenia – PDP i ICE
Ważność mówi, czy cecha pomaga, ale nie jak. Do tego służą wykres częściowej zależności (PDP) i krzywe ICE, liczone tu ręcznie. Każdej rezerwacji testowej ustawiamy wyprzedzenie kolejno na 0, 5, 10… 150 dni, resztę cech zostawiając bez zmian. Prognozy jednej rezerwacji tworzą krzywą ICE, a ich średnia to PDP.
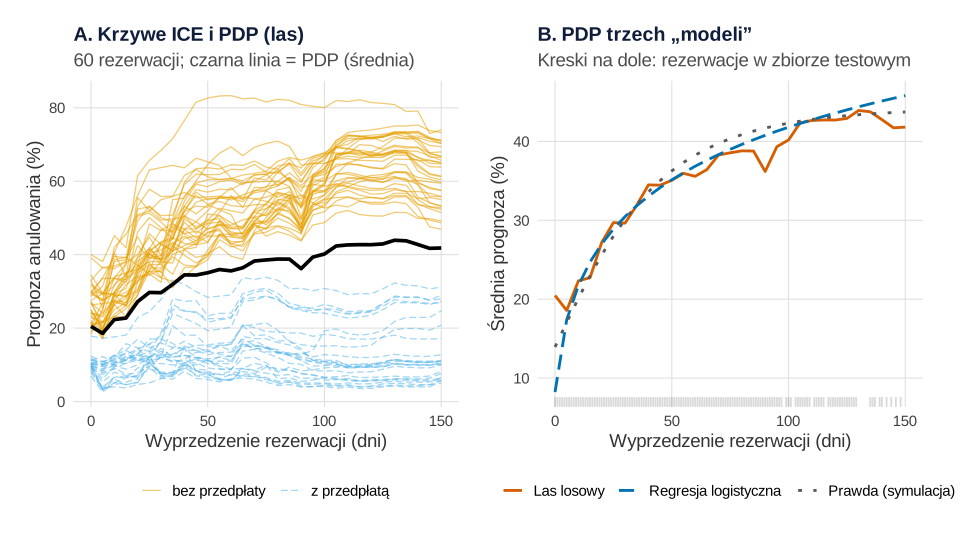
set.seed(662)).Co widać. PDP lasu rośnie od 20.5% przy rezerwacji na ten sam dzień do 35.6% przy 60 dniach. Krzywe ICE tworzą dwie rodziny: bez przedpłaty wydłużenie wyprzedzenia z 0 do 60 dni podnosi prognozę średnio o 25.2 punktu procentowego (pp), z przedpłatą – o 0.9 pp. Model nauczył się ukrytej interakcji, a PDP (+15.1 pp) ją uśrednia. Goldstein i in. (2015) zaproponowali krzywe ICE właśnie dlatego, że przy silnych interakcjach średnia krzywa zaciemnia to, co robi model.
Jak może zmylić. Między 30 a 120 dniami PDP obu modeli i prawda leżą blisko (przy 30 dniach: 29.6%, 30.5% i 30.1%), ale na krańcach się rozjeżdżają: przy zerze dni las daje 20.5%, regresja 8.2%, prawda 13.9%. Powyżej 120 dni jest tylko 2.9% rezerwacji. Zanim zinterpretujesz koniec krzywej, spójrz na kreski u dołu wykresu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: wartości SHAP – karta wyjaśnienia jednej rezerwacji
Weźmy rezerwację R0207: 122 dni przed odbiorem, bez przedpłaty, przez porównywarkę, na 6 dni, klient bez wcześniejszych anulowań. Las daje jej 63.5% ryzyka przy średniej 29.9%. Jak rozdzielić tę różnicę na cechy?
Wartości SHAP robią to regułą z teorii gier (wartość Shapleya): cechy to „gracze”, a „wygrana” to prognoza. Dla każdego podzbioru cech S liczymy v(S) – średnią prognozę, gdy cechy z S mają wartości rezerwacji R0207, a pozostałe pochodzą z 500 losowych rezerwacji uczących. Wkład cechy j to przyrost v po jej dołączeniu, uśredniony po wszystkich kolejnościach dołączania:
Przy sześciu cechach to 26 = 64 podzbiory – liczymy je wszystkie. Dla modeli z drzew Lundberg i in. (2020) podali szybki algorytm dokładny i pokazali, jak z wielu lokalnych wyjaśnień zbudować obraz całego modelu.
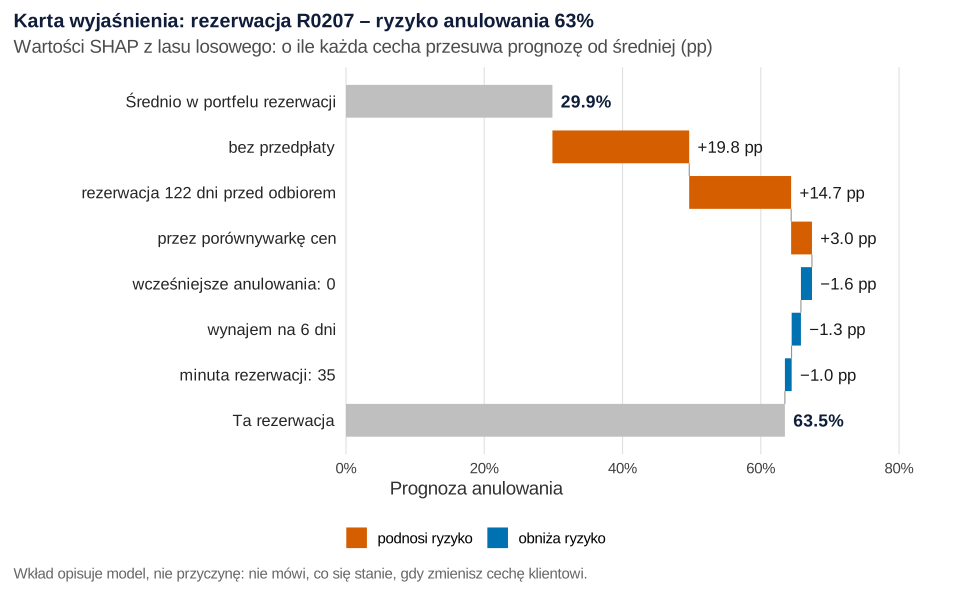
set.seed(662)).Co widać. Od średniej 29.9% brak przedpłaty dokłada 19.8 pp, długie wyprzedzenie 14.7 pp, a porównywarka 3.0 pp. Pozostałe cechy lekko je obniżają. Średnia plus wkłady daje dokładnie prognozę 63.5% – karta „zamyka się” rachunkowo. Regresja wyjaśnia tę rezerwację podobnie (brak przedpłaty +18.5 pp, wyprzedzenie +15.2 pp, porównywarka +6.3 pp; prognoza 66.6%).
Jak może zmylić. Minuta rezerwacji dostała w lesie −1.0 pp, choć nie ma wpływu (w regresji +0.1 pp): las dopasował się do szumu, a SHAP wyjaśnia model, nie rzeczywistość. Cechy spoza S bierzemy z tła niezależnie od cech z S, więc przy cechach skorelowanych powstają nierealne kombinacje. Aas i in. (2021) pokazali, że takie wyjaśnienia mogą być bardzo mylące nawet dla modelu liniowego, i zaproponowali wersję dla cech zależnych.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: skorelowane cechy psują ważność i PDP
W firmie cechy rzadko są niezależne. Załóżmy rabat za wczesną rezerwację: im większe wyprzedzenie, tym większy rabat. W symulacji anulowanie zależy od wyprzedzenia i kanału, a rabat nie ma żadnego wpływu. Dla korelacji rabatu z wyprzedzeniem r = 0, .5, .8 i .95 losujemy po 40 zbiorów (1500 rezerwacji uczących i 1500 testowych) i liczymy ważność permutacyjną obu modeli.
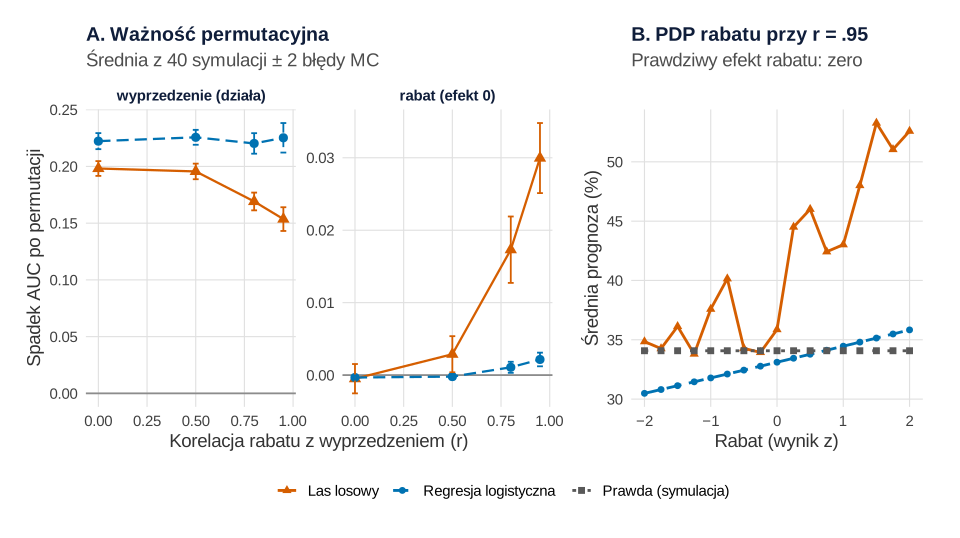
set.seed(662)).Co widać. Ważność rabatu w lesie rośnie z −0.0005 (błąd Monte Carlo 0.0010) przy r = 0 do 0.0300 (błąd MC 0.0024) przy r = .95. Ważność wyprzedzenia spada przy tym z 0.198 do 0.154 – las dzieli zasługę między dwie podobne cechy. W regresji rabat ma 0.0022, a wyprzedzenie stoi na około 0.22. W panelu B PDP lasu rośnie przy rabacie od −2 do +2 SD z 34.8% do 52.6% (o 17.7 pp; regresja: 5.3 pp), choć prawdziwy efekt wynosi zero.
Jak może zmylić. Las używa rabatu jako zastępcy wyprzedzenia. Strobl i in. (2008) opisali, że ważność w lasach faworyzuje cechy skorelowane, i zaproponowali ważność warunkową. Do tego permutacja i PDP tworzą nierealne rezerwacje: przy rabacie +2 SD aż 93.4% punktów PDP leży poza obszarem danych (duży rabat przy krótkim wyprzedzeniu), więc model ekstrapoluje. Hooker i in. (2021) pokazali, że metody „permutuj i przewiduj” mogą przez to bardzo przeceniać skorelowane cechy, i zalecają miary wymagające dodatkowego modelowania. Przy silnej współliniowości raportuj ważność grup skorelowanych cech łącznie.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: interpretacja to nie przyczynowość
PDP lasu mówi: gdyby wszyscy płacili z góry, anulowań byłoby o 32.9 pp mniej. Zarząd chce wprowadzić obowiązkową przedpłatę. Porównujemy to z prawdą i z symulowanym testem A/B: 4000 nowych rezerwacji, przedpłata przydzielona losowo połowie.
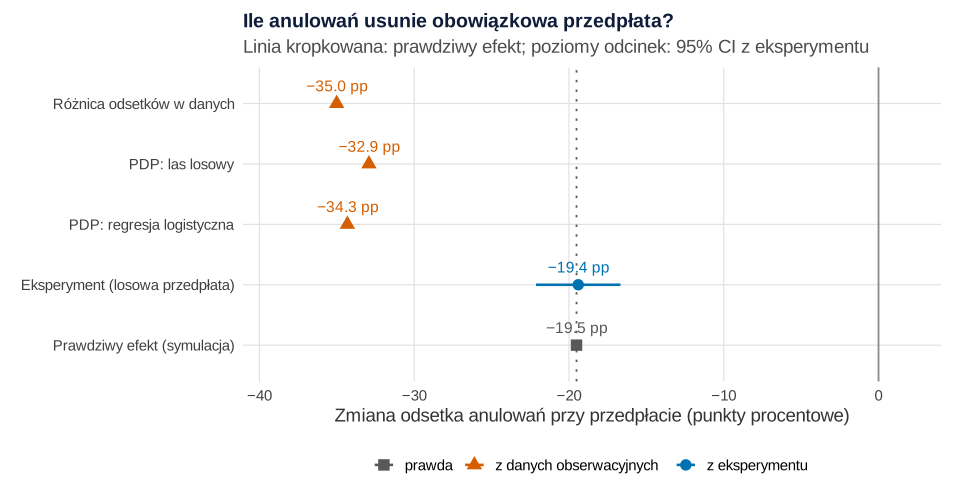
set.seed(662)).Co widać. Surowa różnica odsetków to −35.0 pp, PDP lasu −32.9 pp, regresji −34.3 pp. Prawdziwy efekt to −19.5 pp, eksperyment daje −19.4 pp, 95% CI [−22.1, −16.7]. Modele przeceniają efekt przedpłaty prawie dwukrotnie. Część „efektu” to pewność planów: pewni klienci częściej płacą z góry i rzadziej anulują, a tej cechy nie ma w danych.
Jak może zmylić. Model przewiduje dobrze, a wyciągnięte z niego wnioski są błędne. Zhao i Hastie (2021) zauważyli, że wzór PDP jest taki sam jak wzór korekty „tylnymi drzwiami” na zmienne zakłócające, ale interpretacja przyczynowa wymaga dobrego modelu, diagramu przyczynowego z wiedzy o zjawisku i odpowiedniej wizualizacji. Tu nieobserwowany zakłócacz łamie ten warunek. Szerzej: korelacja a przyczynowość.
Podpis do pracy:
Zdanie do Dyskusji:
Co z tym zrobić w firmie
- Do zarządu – ważność permutacyjna na danych testowych, z przedziałami, nie ważność z nieczystości.
- Do działu obsługi – karta SHAP przy rezerwacji. „Ryzyko 63%: brak przedpłaty, długie wyprzedzenie” to powód do przypomnienia albo oferty przedpłaty z rabatem. Pokazuj 3–4 największe wkłady.
- Sprawdzaj krzywe ICE, zanim napiszesz „wyprzedzenie podnosi ryzyko”. Tu dotyczyło to tylko rezerwacji bez przedpłaty.
- Decyzje o regułach testuj. Obowiązkowa przedpłata dałaby około −19 pp, a nie −33 pp, i może odstraszyć część klientów. Sprawdź ją w teście A/B na części klientów.
- Monitoruj wyjaśnienia po wdrożeniu. Nagły wzrost wkładu cechy może oznaczać zmianę jej definicji albo przeciek danych. Lundberg i in. (2020) używali lokalnych wyjaśnień do monitorowania wdrożonego modelu.
Podobne decyzje oparte na ryzyku z modelu opisują wpisy o modelu odejść klientów i wykrywaniu nadużyć. Te same narzędzia działają dla gradient boostingu.
Jak opisać w pracy
Podaj, na jakich danych i jaką miarą liczono ważność, jak liczono PDP i SHAP (tło, liczba podzbiorów) i że wyniki nie mają interpretacji przyczynowej (zob. też statystyka w pracy z zarządzania i ekonomii). Przy większych danych to samo liczą pakiety iml, DALEX czy fastshap.
W Wynikach podaj tabelę ważności dla obu modeli:
| Cecha | Las losowy: spadek AUC [95% CI] | Regresja: spadek AUC [95% CI] | Las: ważność z nieczystości (%) |
|---|---|---|---|
| Przedpłata | 0.209 [0.178, 0.246] | 0.200 [0.172, 0.228] | 43.7 |
| Wyprzedzenie | 0.053 [0.037, 0.073] | 0.058 [0.038, 0.075] | 24.6 |
| Wcześniejsze anulowania | 0.009 [0.000, 0.016] | 0.012 [0.005, 0.019] | 4.4 |
| Porównywarka | 0.005 [−0.006, 0.014] | 0.008 [−0.003, 0.016] | 3.7 |
| Minuta rezerwacji | 0.002 [−0.004, 0.008] | 0.000 [0.000, 0.001] | 15.4 |
| Długość wynajmu | 0.001 [−0.005, 0.006] | 0.001 [−0.002, 0.004] | 8.2 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – modele, funkcje prognozy f_las() i f_rl() oraz funkcję auc(), z których korzystają przepisy 3–6. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1–6: każdy zaczyna od własnego set.seed(662), a las losowy w przepisie 2 dostaje też seed = 662. Ziarno 662 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę rezerwacji, rozkłady cech, współczynniki prawdziwego modelu anulowania i ukrytą „pewność planów” (przepis 1); 300 drzew, minimalną wielkość węzła 25 i 100 prób bootstrapowych (przepis 2); siatkę wyprzedzenia 0–150 dni (przepis 3); tło 500 rezerwacji i regułę wyboru rezerwacji do wyjaśnienia (przepis 4); korelacje, liczebności, współczynniki i 40 powtórzeń symulacji (przepis 5); 4000 rezerwacji w eksperymencie (przepis 6). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Najdłużej liczą się przepisy 2 i 5 (do około minuty).
1. Dane i podział na zbiór uczący i testowy
R
# Przepis 1. Rezerwacje fikcyjnej wypożyczalni samochodów: 8000 rezerwacji, czy klient anuluje?
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Las losowy" = "#D55E00", "Regresja logistyczna" = "#0072B2", "Prawda (symulacja)" = "grey35")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(s) gsub("-", "\u2212", s, fixed = TRUE)    # znak minus (U+2212) w etykietach i na osiach

# Cechy znane w chwili rezerwacji. Parametry ustalono ręcznie (przykład, nie dane rynkowe).
set.seed(662)                                       # ziarno ustalone raz, bez dobierania pod wynik
n <- 8000
pewnosc <- rnorm(n)                                 # „pewność planów” klienta – NIE ma jej w danych firmy
wyprzedzenie <- pmin(180, round(rgamma(n, 1.4, 1 / 28)))  # dni od rezerwacji do odbioru auta
przedplata <- rbinom(n, 1, plogis(-0.4 + 1.3 * pewnosc))   # pewni swoich planów częściej płacą z góry
porownywarka <- rbinom(n, 1, 0.40)                  # rezerwacja przez porównywarkę cen (0 = strona własna)
dlugosc <- 1 + rpois(n, 4)                          # długość wynajmu (dni)
anulowania_wczesniej <- pmin(4, rpois(n, 0.3))      # wcześniejsze anulowania tego klienta
minuta <- sample(0:59, n, replace = TRUE)           # minuta złożenia rezerwacji – czysty szum

# Prawdziwy model anulowania (znany tylko dlatego, że dane są fikcyjne): efekt wyprzedzenia rośnie
# i się wypłaszcza, przy przedpłacie jest słabszy (interakcja); minuta nie ma żadnego wpływu
prawdziwy_logit <- function(wyprzedzenie, przedplata, porownywarka, dlugosc, anulowania_wczesniej, pewnosc)
  -2.4 + 2.4 * (1 - exp(-wyprzedzenie / 35)) * (1 - 0.55 * przedplata) - 0.5 * przedplata +
    0.6 * porownywarka + 0.45 * anulowania_wczesniej - 0.04 * (dlugosc - 5) - 1.0 * pewnosc
anulowanie <- rbinom(n, 1, plogis(prawdziwy_logit(wyprzedzenie, przedplata, porownywarka, dlugosc,
                                                  anulowania_wczesniej, pewnosc)))

rezerwacje <- data.frame(id = sprintf("R%04d", 1:n), wyprzedzenie, przedplata, porownywarka, dlugosc,
                         anulowania_wczesniej, minuta, anulowanie, pewnosc_ukryta = pewnosc)
write.csv(rezerwacje, "anulowania-rezerwacji-wypozyczalnia.csv", row.names = FALSE)

# Podział losowy: 6000 rezerwacji do uczenia, 2000 do oceny modeli i ich interpretacji
set.seed(662)
uczace <- sample(n, 6000)
train <- rezerwacje[uczace, ]; test <- rezerwacje[-uczace, ]
cechy <- c("wyprzedzenie", "przedplata", "porownywarka", "dlugosc", "anulowania_wczesniej", "minuta")
c(anulowane_proc = round(100 * mean(rezerwacje$anulowanie), 1), test_proc = round(100 * mean(test$anulowanie), 1),
  przedplata_proc = round(100 * mean(przedplata), 1), mediana_wyprzedzenia = median(wyprzedzenie),
  wyprzedzenie_ponad_120_proc = round(100 * mean(wyprzedzenie > 120), 1))
# Odsetek anulowanych: bez przedpłaty i z przedpłatą
round(100 * tapply(rezerwacje$anulowanie, rezerwacje$przedplata, mean), 1)
Wynik w R
             anulowane_proc                   test_proc
                       30.4                        30.6
            przedplata_proc        mediana_wyprzedzenia
                       41.7                        30.0
wyprzedzenie_ponad_120_proc
                        2.9
 0  1
45 10
2. Modele, ważność permutacyjna i z nieczystości: Rysunek 1
R
# Przepis 2. Las losowy i regresja logistyczna; ważność permutacyjna (z bootstrapem) i ważność z nieczystości
# (korzysta z train, test, cechy, kol i motyw z przepisu 1)
library(ggplot2)
library(patchwork)
library(ranger)

wzor <- reformulate(cechy, "anulowanie")
set.seed(662)
las <- ranger(wzor, data = transform(train, anulowanie = factor(anulowanie)), num.trees = 300,
              probability = TRUE, min.node.size = 25, importance = "impurity", seed = 662)
rl <- glm(anulowanie ~ log1p(wyprzedzenie) + przedplata + porownywarka + dlugosc + anulowania_wczesniej + minuta,
          family = binomial, data = train)
# Jednolity sposób liczenia prognoz: f(dane) zwraca prawdopodobieństwo anulowania
f_las <- function(d) predict(las, d)$predictions[, "1"]
f_rl <- function(d) predict(rl, d, type = "response")

auc <- function(p, y) { r <- rank(p); n1 <- sum(y); n0 <- length(y) - n1   # pole pod krzywą ROC z rang
  (sum(r[y == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0) }
c(AUC_las = auc(f_las(test), test$anulowanie), AUC_rl = auc(f_rl(test), test$anulowanie)) |> round(3)

# Ważność permutacyjna: o ile spada AUC na zbiorze testowym po przemieszaniu jednej cechy.
# 100 prób bootstrapowych zbioru testowego, w każdej nowa permutacja – przedział 95% (percentylowy).
waznosc_perm <- function(f, B = 100) {
  set.seed(662)
  wyn <- replicate(B, {
    d <- test[sample(nrow(test), replace = TRUE), ]
    a0 <- auc(f(d), d$anulowanie)
    sapply(cechy, function(v) { dp <- d; dp[[v]] <- sample(dp[[v]]); a0 - auc(f(dp), dp$anulowanie) })
  })
  data.frame(cecha = cechy, spadek_auc = rowMeans(wyn), dolna = apply(wyn, 1, quantile, 0.025),
             gorna = apply(wyn, 1, quantile, 0.975))
}
wp <- rbind(cbind(model = "Las losowy", waznosc_perm(f_las)), cbind(model = "Regresja logistyczna", waznosc_perm(f_rl)))
print(transform(wp, spadek_auc = round(spadek_auc, 3), dolna = round(dolna, 3), gorna = round(gorna, 3)), row.names = FALSE)

# Ważność z nieczystości (spadek indeksu Giniego w podziałach drzew) – jako % sumy
wn <- data.frame(cecha = names(las$variable.importance), udzial = 100 * las$variable.importance / sum(las$variable.importance))
wn$udzial_perm <- 100 * pmax(0, wp$spadek_auc[wp$model == "Las losowy"]) / sum(pmax(0, wp$spadek_auc[wp$model == "Las losowy"]))
print(transform(wn, udzial = round(udzial, 1), udzial_perm = round(udzial_perm, 1)), row.names = FALSE)

etykiety <- c(wyprzedzenie = "wyprzedzenie (dni)", przedplata = "przedpłata", porownywarka = "porównywarka",
              dlugosc = "długość wynajmu", anulowania_wczesniej = "wcześniejsze anulowania", minuta = "minuta rezerwacji")
kolejnosc <- rev(cechy[order(wp$spadek_auc[wp$model == "Las losowy"], decreasing = TRUE)])
wp$cecha <- factor(wp$cecha, kolejnosc, etykiety[kolejnosc]); wn$cecha <- factor(wn$cecha, kolejnosc, etykiety[kolejnosc])
wp$model <- factor(wp$model, names(kol)[1:2])

p1a <- ggplot(wp, aes(spadek_auc, cecha, colour = model, shape = model)) +
  geom_vline(xintercept = 0, colour = "grey55", linetype = "22") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", position = position_dodge(0.55)) +
  geom_point(size = 3, position = position_dodge(0.55)) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(x = "Spadek AUC po permutacji (95% CI)", y = NULL, title = "A. Ważność permutacyjna",
       subtitle = "Zbiór testowy, 100 prób bootstrapowych") + motyw
p1b <- ggplot(wn, aes(udzial, cecha)) +
  geom_col(fill = "#D55E00", alpha = 0.75, width = 0.6) +
  geom_text(aes(label = sprintf("%.1f%%", udzial)), hjust = -0.1, size = 3.9, colour = "grey15") +
  scale_x_continuous(expand = expansion(mult = c(0, 0.25))) +
  labs(x = "Udział w sumie ważności (%)", y = NULL, title = "B. Ważność z nieczystości",
       subtitle = "Las losowy, zbiór uczący") + motyw + theme(axis.text.y = element_blank())
p1 <- p1a + p1b + plot_layout(widths = c(1.3, 1), guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("interpretacja-waznosc-permutacyjna.svg", p1, width = 10, height = 5.6)
Wynik w R
AUC_las  AUC_rl
  0.768   0.778
                model                cecha spadek_auc  dolna gorna
           Las losowy         wyprzedzenie      0.053  0.037 0.073
           Las losowy           przedplata      0.209  0.178 0.246
           Las losowy         porownywarka      0.005 -0.006 0.014
           Las losowy              dlugosc      0.001 -0.005 0.006
           Las losowy anulowania_wczesniej      0.009  0.000 0.016
           Las losowy               minuta      0.002 -0.004 0.008
 Regresja logistyczna         wyprzedzenie      0.058  0.038 0.075
 Regresja logistyczna           przedplata      0.200  0.172 0.228
 Regresja logistyczna         porownywarka      0.008 -0.003 0.016
 Regresja logistyczna              dlugosc      0.001 -0.002 0.004
 Regresja logistyczna anulowania_wczesniej      0.012  0.005 0.019
 Regresja logistyczna               minuta      0.000  0.000 0.001
                cecha udzial udzial_perm
         wyprzedzenie   24.6        19.0
           przedplata   43.7        75.0
         porownywarka    3.7         1.7
              dlugosc    8.2         0.4
 anulowania_wczesniej    4.4         3.3
               minuta   15.4         0.6
3. PDP i krzywe ICE liczone ręcznie: Rysunek 2
R
# Przepis 3. PDP i krzywe ICE liczone ręcznie dla wyprzedzenia rezerwacji
# (korzysta z test, f_las, f_rl, prawdziwy_logit, kol i motyw z przepisów 1–2)
library(ggplot2)
library(patchwork)

siatka <- seq(0, 150, by = 5)
# ICE: każdej rezerwacji ustawiamy po kolei każdą wartość z siatki, resztę cech zostawiamy bez zmian
ice <- function(f, d, v, siatka) {
  duze <- d[rep(seq_len(nrow(d)), times = length(siatka)), ]
  duze[[v]] <- rep(siatka, each = nrow(d))
  matrix(f(duze), nrow(d), length(siatka))          # wiersz = rezerwacja, kolumna = punkt siatki
}
ice_las <- ice(f_las, test, "wyprzedzenie", siatka)
ice_rl <- ice(f_rl, test, "wyprzedzenie", siatka)
# Prawdziwa zależność z symulacji (średnia po tych samych rezerwacjach, z ich ukrytą pewnością planów)
prawda <- sapply(siatka, function(g) mean(plogis(prawdziwy_logit(g, test$przedplata, test$porownywarka,
                       test$dlugosc, test$anulowania_wczesniej, test$pewnosc_ukryta))))
pdp <- data.frame(wyprzedzenie = rep(siatka, 3), p = c(colMeans(ice_las), colMeans(ice_rl), prawda),
                  model = factor(rep(names(kol), each = length(siatka)), names(kol)))
# PDP w punktach 0, 30, 60 i 120 dni oraz zmiana 0 → 60 dni (w punktach procentowych)
round(100 * sapply(split(pdp$p, pdp$model), function(p) c(p[siatka %in% c(0, 30, 60, 120)], zmiana_0_60 = p[13] - p[1])), 1)
# ICE lasu: zmiana prognozy 0 → 60 dni osobno bez przedpłaty i z przedpłatą
zm <- ice_las[, 13] - ice_las[, 1]
round(100 * c(bez_przedplaty = mean(zm[test$przedplata == 0]), z_przedplata = mean(zm[test$przedplata == 1]),
              SD_zmian = sd(zm)), 1)

set.seed(662)
wybrane <- sample(nrow(test), 60)                   # 60 losowych krzywych ICE na rysunku
ice_df <- data.frame(id = rep(wybrane, times = length(siatka)), wyprzedzenie = rep(siatka, each = 60),
                     p = as.vector(ice_las[wybrane, ]),
                     przedplata = factor(rep(test$przedplata[wybrane], times = length(siatka)), 0:1,
                                         c("bez przedpłaty", "z przedpłatą")))
p2a <- ggplot(ice_df, aes(wyprzedzenie, 100 * p, group = id, colour = przedplata, linetype = przedplata)) +
  geom_line(alpha = 0.55, linewidth = 0.45) +
  geom_line(data = subset(pdp, model == "Las losowy"), aes(wyprzedzenie, 100 * p), inherit.aes = FALSE,
            colour = "black", linewidth = 1.3) +
  scale_colour_manual(values = c("#E69F00", "#56B4E9"), name = NULL) +
  scale_linetype_manual(values = c("solid", "42"), name = NULL) +
  labs(x = "Wyprzedzenie rezerwacji (dni)", y = "Prognoza anulowania (%)", title = "A. Krzywe ICE i PDP (las)",
       subtitle = "60 rezerwacji; czarna linia = PDP (średnia)") + motyw
p2b <- ggplot(pdp, aes(wyprzedzenie, 100 * p, colour = model, linetype = model)) +
  geom_rug(data = data.frame(w = test$wyprzedzenie[test$wyprzedzenie <= 150]), aes(x = w), inherit.aes = FALSE,
           alpha = 0.15, length = unit(0.03, "npc")) +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "42", "13"), name = NULL) +
  labs(x = "Wyprzedzenie rezerwacji (dni)", y = "Średnia prognoza (%)", title = "B. PDP trzech „modeli”",
       subtitle = "Kreski na dole: rezerwacje w zbiorze testowym") + motyw
p2 <- p2a + p2b & theme(legend.position = "bottom")
p2   # zapis: ggsave("interpretacja-pdp-ice.svg", p2, width = 10, height = 5.6)
Wynik w R
            Las losowy Regresja logistyczna Prawda (symulacja)
                  20.5                  8.2               13.9
                  29.6                 30.5               30.1
                  35.6                 36.9               38.3
                  42.7                 43.6               43.1
zmiana_0_60       15.1                 28.6               24.3
bez_przedplaty   z_przedplata       SD_zmian
          25.2            0.9           14.0
4. Dokładne wartości SHAP i karta wyjaśnienia: Rysunek 3
R
# Przepis 4. Dokładne wartości SHAP dla jednej rezerwacji: wszystkie 64 podzbiory 6 cech
# (korzysta z train, test, cechy, f_las, f_rl, motyw i minus z przepisów 1–2)
library(ggplot2)

# Rezerwacja do wyjaśnienia: pierwsza w zbiorze testowym z prognozą lasu 55–65%, bez przedpłaty, z porównywarki
p_test <- f_las(test)
k <- which(p_test > 0.55 & p_test < 0.65 & test$przedplata == 0 & test$porownywarka == 1 & test$wyprzedzenie > 60)[1]
x <- test[k, ]
x[, c("id", cechy)]

# Wartość koalicji S: średnia prognoza, gdy cechy z S mają wartości tej rezerwacji, a pozostałe pochodzą
# z tła (500 losowych rezerwacji uczących) – marginalizacja „interwencyjna”, bez warunkowania na S
set.seed(662)
tlo <- train[sample(nrow(train), 500), ]
v <- function(f, S) { d <- tlo; for (c in S) d[[c]] <- x[[c]]; mean(f(d)) }
shap <- function(f) {
  p <- length(cechy)
  podzbiory <- unlist(lapply(0:p, function(m) combn(cechy, m, simplify = FALSE)), recursive = FALSE)
  wartosci <- sapply(podzbiory, function(S) v(f, S))
  klucz <- sapply(podzbiory, function(S) paste(sort(S), collapse = "+"))
  sapply(cechy, function(j) {
    bez_j <- podzbiory[!sapply(podzbiory, function(S) j %in% S)]
    sum(sapply(bez_j, function(S) {
      w <- factorial(length(S)) * factorial(p - length(S) - 1) / factorial(p)   # waga Shapleya
      w * (wartosci[klucz == paste(sort(c(S, j)), collapse = "+")] - wartosci[klucz == paste(sort(S), collapse = "+")])
    }))
  })
}
phi_las <- shap(f_las); phi_rl <- shap(f_rl)
baza_las <- v(f_las, character(0)); baza_rl <- v(f_rl, character(0))
# Wkłady w punktach procentowych; suma wkładów + średnia z tła = prognoza dla tej rezerwacji
round(100 * rbind(las = c(srednia_tla = baza_las, phi_las, suma = baza_las + sum(phi_las), prognoza = f_las(x)),
                  regresja = c(srednia_tla = baza_rl, phi_rl, suma = baza_rl + sum(phi_rl), prognoza = f_rl(x))), 1)

# Karta wyjaśnienia dla działu obsługi: wykres wodospadowy wkładów lasu losowego
opis <- c(wyprzedzenie = sprintf("rezerwacja %d dni przed odbiorem", x$wyprzedzenie),
          przedplata = if (x$przedplata == 1) "przedpłata" else "bez przedpłaty",
          porownywarka = if (x$porownywarka == 1) "przez porównywarkę cen" else "przez stronę własną",
          dlugosc = sprintf("wynajem na %d dni", x$dlugosc),
          anulowania_wczesniej = sprintf("wcześniejsze anulowania: %d", x$anulowania_wczesniej),
          minuta = sprintf("minuta rezerwacji: %d", x$minuta))
o <- order(abs(phi_las), decreasing = TRUE)
wf <- data.frame(etykieta = opis[cechy[o]], phi = 100 * phi_las[o])
wf$koniec <- 100 * baza_las + cumsum(wf$phi); wf$start <- wf$koniec - wf$phi
wf$y <- nrow(wf):1 + 1                              # od góry: średnia, cechy, ta rezerwacja
wf$znak <- factor(ifelse(wf$phi >= 0, "podnosi ryzyko", "obniża ryzyko"), c("podnosi ryzyko", "obniża ryzyko"))
kraje <- data.frame(y = c(nrow(wf) + 2, 1), wart = c(100 * baza_las, 100 * f_las(x)),
                    etykieta = c("Średnio w portfelu rezerwacji", "Ta rezerwacja"))
p3 <- ggplot() +
  geom_rect(data = kraje, aes(xmin = 0, xmax = wart, ymin = y - 0.36, ymax = y + 0.36), fill = "grey75") +
  geom_rect(data = wf, aes(xmin = start, xmax = koniec, ymin = y - 0.36, ymax = y + 0.36, fill = znak)) +
  geom_segment(data = wf, aes(x = koniec, xend = koniec, y = y - 0.36, yend = y - 0.64), colour = "grey45",
               linewidth = 0.3) +
  geom_text(data = wf, aes(pmax(start, koniec) + 1.2, y, label = minus(sprintf("%+.1f pp", phi))), hjust = 0,
            size = 4.4, colour = "grey10") +
  geom_text(data = kraje, aes(wart + 1.2, y, label = sprintf("%.1f%%", wart)), hjust = 0, size = 4.6,
            fontface = "bold", colour = "#0f1d3a") +
  geom_text(data = rbind(kraje[, c("y", "etykieta")], wf[, c("y", "etykieta")]), aes(-1.5, y, label = etykieta),
            hjust = 1, size = 4.3, colour = "grey15") +
  scale_fill_manual(values = c("podnosi ryzyko" = "#D55E00", "obniża ryzyko" = "#0072B2"), name = NULL) +
  scale_x_continuous(limits = c(-42, 80), breaks = seq(0, 80, 20), labels = function(b) paste0(b, "%")) +
  labs(x = "Prognoza anulowania", y = NULL,
       title = sprintf("Karta wyjaśnienia: rezerwacja %s – ryzyko anulowania %.0f%%", x$id, 100 * f_las(x)),
       subtitle = "Wartości SHAP z lasu losowego: o ile każda cecha przesuwa prognozę od średniej (pp)",
       caption = "Wkład opisuje model, nie przyczynę: nie mówi, co się stanie, gdy zmienisz cechę klientowi.") +
  motyw + theme(panel.grid.major.y = element_blank(), axis.text.y = element_blank())
p3   # zapis: ggsave("interpretacja-shap-karta-rezerwacji.svg", p3, width = 10, height = 6.2)
Wynik w R
       id wyprzedzenie przedplata porownywarka dlugosc anulowania_wczesniej
207 R0207          122          0            1       6                    0
    minuta
207     35
         srednia_tla wyprzedzenie przedplata porownywarka dlugosc
las             29.9         14.7       19.8          3.0    -1.3
regresja        29.7         15.2       18.5          6.3    -1.0
         anulowania_wczesniej minuta suma prognoza.1
las                      -1.6   -1.0 63.5       63.5
regresja                 -2.1    0.1 66.6       66.6
5. Symulacja: skorelowane cechy: Rysunek 4
R
# Przepis 5. Symulacja: skorelowane cechy psują ważność permutacyjną i PDP
# Rabat za wczesną rezerwację rośnie z wyprzedzeniem, ale sam nie wpływa na anulowanie.
# (korzysta z auc, kol, motyw i minus z przepisów 1–2)
library(ggplot2)
library(patchwork)
library(ranger)

symuluj <- function(n, r) {                         # cechy w skali z (średnia 0, SD 1)
  wyprzedzenie <- rnorm(n)
  rabat <- r * wyprzedzenie + sqrt(1 - r^2) * rnorm(n)   # korelacja z wyprzedzeniem = r
  porownywarka <- rbinom(n, 1, 0.4); dlugosc <- rnorm(n)
  anulowanie <- rbinom(n, 1, plogis(-1 + 1.0 * wyprzedzenie + 0.6 * porownywarka))  # rabat: efekt 0
  data.frame(wyprzedzenie, rabat, porownywarka, dlugosc, anulowanie)
}
jeden <- function(r) {
  u <- symuluj(1500, r); t <- symuluj(1500, r)
  las <- ranger(factor(anulowanie) ~ ., data = u, num.trees = 200, probability = TRUE, min.node.size = 25,
                seed = sample.int(1e6, 1))
  rl <- glm(anulowanie ~ ., family = binomial, data = u)
  f <- list(las = function(d) predict(las, d)$predictions[, "1"], rl = function(d) predict(rl, d, type = "response"))
  sapply(f, function(fm) { a0 <- auc(fm(t), t$anulowanie)
    sapply(c("wyprzedzenie", "rabat"), function(v) { tp <- t; tp[[v]] <- sample(tp[[v]]); a0 - auc(fm(tp), tp$anulowanie) }) })
}
set.seed(662)
R <- 40                                             # powtórzeń na każdą wartość korelacji
wyniki <- do.call(rbind, lapply(c(0, 0.5, 0.8, 0.95), function(r) {
  m <- replicate(R, jeden(r))                       # 2 cechy × 2 modele × R
  do.call(rbind, lapply(c("las", "rl"), function(md) do.call(rbind, lapply(c("wyprzedzenie", "rabat"), function(v)
    data.frame(r = r, model = md, cecha = v, srednia = mean(m[v, md, ]), blad_mc = sd(m[v, md, ]) / sqrt(R))))))
}))
print(transform(wyniki, srednia = round(srednia, 4), blad_mc = round(blad_mc, 4)), row.names = FALSE)

# PDP rabatu przy r = .95 w jednym zbiorze: rabat nie działa, a PDP lasu rośnie
set.seed(662)
u <- symuluj(1500, 0.95)
las95 <- ranger(factor(anulowanie) ~ ., data = u, num.trees = 200, probability = TRUE, min.node.size = 25, seed = 662)
rl95 <- glm(anulowanie ~ ., family = binomial, data = u)
siatka <- seq(-2, 2, by = 0.25)
pdp_rabat <- function(f) sapply(siatka, function(g) { d <- u; d$rabat <- g; mean(f(d)) })
pdp95 <- data.frame(rabat = rep(siatka, 3),
  p = c(pdp_rabat(function(d) predict(las95, d)$predictions[, "1"]), pdp_rabat(function(d) predict(rl95, d, type = "response")),
        rep(mean(plogis(-1 + u$wyprzedzenie + 0.6 * u$porownywarka)), length(siatka))),
  model = factor(rep(names(kol), each = length(siatka)), names(kol)))
round(100 * sapply(split(pdp95$p, pdp95$model), function(p) c(rabat_m2 = p[1], rabat_p2 = p[length(p)], roznica = p[length(p)] - p[1])), 1)
# Ile punktów, na których PDP liczy prognozę dla rabatu +2, leży w obszarze danych? (|reszta| < 2 SD reszty)
c(punkty_poza_danymi_proc = round(100 * mean(abs(2 - 0.95 * u$wyprzedzenie) > 2 * sqrt(1 - 0.95^2)), 1))

wyniki$model <- factor(ifelse(wyniki$model == "las", "Las losowy", "Regresja logistyczna"), names(kol)[1:2])
wyniki$cecha <- factor(wyniki$cecha, c("wyprzedzenie", "rabat"), c("wyprzedzenie (działa)", "rabat (efekt 0)"))
p4a <- ggplot(wyniki, aes(r, srednia, colour = model, shape = model, linetype = model)) +
  geom_hline(yintercept = 0, colour = "grey55") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  geom_errorbar(aes(ymin = srednia - 2 * blad_mc, ymax = srednia + 2 * blad_mc), width = 0.03) +
  facet_wrap(~cecha, scales = "free_y") +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_linetype_manual(values = c("solid", "42"), name = NULL) +
  labs(x = "Korelacja rabatu z wyprzedzeniem (r)", y = "Spadek AUC po permutacji", title = "A. Ważność permutacyjna",
       subtitle = sprintf("Średnia z %d symulacji ± 2 błędy MC", R)) + motyw +
  guides(colour = "none", shape = "none", linetype = "none")       # legenda wspólna – w panelu B
p4b <- ggplot(pdp95, aes(rabat, 100 * p, colour = model, linetype = model)) +
  geom_line(linewidth = 1) + geom_point(aes(shape = model), size = 2) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "42", "13"), name = NULL) +
  scale_shape_manual(values = c(17, 16, 15), name = NULL) + scale_x_continuous(labels = function(b) minus(b)) +
  labs(x = "Rabat (wynik z)", y = "Średnia prognoza (%)", title = "B. PDP rabatu przy r = .95",
       subtitle = "Prawdziwy efekt rabatu: zero") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1.6, 1), guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("interpretacja-korelacja-cech.svg", p4, width = 10, height = 5.6)
Wynik w R
    r model        cecha srednia blad_mc
 0.00   las wyprzedzenie  0.1982  0.0033
 0.00   las        rabat -0.0005  0.0010
 0.00    rl wyprzedzenie  0.2223  0.0035
 0.00    rl        rabat -0.0003  0.0001
 0.50   las wyprzedzenie  0.1956  0.0034
 0.50   las        rabat  0.0029  0.0012
 0.50    rl wyprzedzenie  0.2256  0.0033
 0.50    rl        rabat -0.0002  0.0002
 0.80   las wyprzedzenie  0.1691  0.0039
 0.80   las        rabat  0.0173  0.0023
 0.80    rl wyprzedzenie  0.2202  0.0045
 0.80    rl        rabat  0.0011  0.0004
 0.95   las wyprzedzenie  0.1536  0.0052
 0.95   las        rabat  0.0300  0.0024
 0.95    rl wyprzedzenie  0.2252  0.0065
 0.95    rl        rabat  0.0022  0.0005
         Las losowy Regresja logistyczna Prawda (symulacja)
rabat_m2       34.8                 30.5               34.1
rabat_p2       52.6                 35.8               34.1
roznica        17.7                  5.3                0.0
punkty_poza_danymi_proc
                   93.4
6. PDP a eksperyment z przedpłatą: Rysunek 5
R
# Przepis 6. Interpretacja ≠ przyczynowość: co da obowiązkowa przedpłata?
# (korzysta z test, f_las, f_rl, prawdziwy_logit, motyw i minus z przepisów 1–2)
library(ggplot2)

# Różnica w PDP: wszystkim ustawiamy przedpłatę 1, potem 0 – tak model „odpowiada” na pytanie o przedpłatę
pdp_roznica <- function(f) { d1 <- test; d1$przedplata <- 1; d0 <- test; d0$przedplata <- 0; mean(f(d1)) - mean(f(d0)) }
# Prawdziwy efekt przyczynowy (znany z symulacji): ci sami klienci, z tą samą ukrytą pewnością planów
p_do <- function(pp) mean(plogis(prawdziwy_logit(test$wyprzedzenie, pp, test$porownywarka, test$dlugosc,
                                                 test$anulowania_wczesniej, test$pewnosc_ukryta)))
naiwna <- with(test, mean(anulowanie[przedplata == 1]) - mean(anulowanie[przedplata == 0]))

# Eksperyment: 4000 nowych rezerwacji, przedpłata przydzielona losowo (połowa), te same pozostałe mechanizmy
set.seed(662)
m <- 4000
nowe <- data.frame(pewnosc = rnorm(m), wyprzedzenie = pmin(180, round(rgamma(m, 1.4, 1 / 28))),
                   porownywarka = rbinom(m, 1, 0.40), dlugosc = 1 + rpois(m, 4),
                   anulowania_wczesniej = pmin(4, rpois(m, 0.3)), przedplata = sample(rep(0:1, m / 2)))
nowe$anulowanie <- rbinom(m, 1, plogis(with(nowe, prawdziwy_logit(wyprzedzenie, przedplata, porownywarka, dlugosc,
                                                                    anulowania_wczesniej, pewnosc))))
eksp <- prop.test(table(factor(nowe$przedplata, 1:0), factor(nowe$anulowanie, 1:0)))
efekty <- data.frame(
  zrodlo = c("Różnica odsetków w danych", "PDP: las losowy", "PDP: regresja logistyczna",
             "Eksperyment (losowa przedpłata)", "Prawdziwy efekt (symulacja)"),
  efekt = 100 * c(naiwna, pdp_roznica(f_las), pdp_roznica(f_rl), -diff(eksp$estimate), p_do(1) - p_do(0)),
  dolna = 100 * c(NA, NA, NA, eksp$conf.int[1], NA), gorna = 100 * c(NA, NA, NA, eksp$conf.int[2], NA))
print(transform(efekty, efekt = round(efekt, 1), dolna = round(dolna, 1), gorna = round(gorna, 1)), row.names = FALSE)

efekty$zrodlo <- factor(efekty$zrodlo, rev(efekty$zrodlo))
efekty$rodzaj <- c("z danych obserwacyjnych", "z danych obserwacyjnych", "z danych obserwacyjnych",
                   "z eksperymentu", "prawda")
p5 <- ggplot(efekty, aes(efekt, zrodlo, colour = rodzaj, shape = rodzaj)) +
  geom_vline(xintercept = 0, colour = "grey55") +
  geom_vline(xintercept = efekty$efekt[5], colour = "grey35", linetype = "13") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", na.rm = TRUE, linewidth = 0.9) +
  geom_point(size = 3.6) +
  geom_text(aes(label = minus(sprintf("%.1f pp", efekt))), vjust = -1.1, size = 4.1, show.legend = FALSE) +
  scale_colour_manual(values = c("z danych obserwacyjnych" = "#D55E00", "z eksperymentu" = "#0072B2", "prawda" = "grey35"),
                      name = NULL) +
  scale_shape_manual(values = c("z danych obserwacyjnych" = 17, "z eksperymentu" = 16, "prawda" = 15), name = NULL) +
  scale_x_continuous(limits = c(min(efekty$efekt, na.rm = TRUE) - 4, 2), labels = function(b) minus(b)) +
  labs(x = "Zmiana odsetka anulowań przy przedpłacie (punkty procentowe)", y = NULL,
       title = "Ile anulowań usunie obowiązkowa przedpłata?",
       subtitle = "Linia kropkowana: prawdziwy efekt; poziomy odcinek: 95% CI z eksperymentu") + motyw
p5   # zapis: ggsave("interpretacja-a-przyczynowosc.svg", p5, width = 10, height = 5.2)
Wynik w R
                          zrodlo efekt dolna gorna
       Różnica odsetków w danych -35.0    NA    NA
                 PDP: las losowy -32.9    NA    NA
       PDP: regresja logistyczna -34.3    NA    NA
 Eksperyment (losowa przedpłata) -19.4 -22.1 -16.7
     Prawdziwy efekt (symulacja) -19.5    NA    NA
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("las – regresja" = c("#D55E00", "#0072B2"), "las – prawda" = c("#D55E00", "#595959"),
             "regresja – prawda" = c("#0072B2", "#595959"), "ICE: bez przedpłaty – z przedpłatą" = c("#E69F00", "#56B4E9"),
             "SHAP: podnosi – obniża" = c("#D55E00", "#0072B2"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                   widzenie_typowe deuteranopia protanopia
las – regresja                               114.6        108.3       91.9
las – prawda                                  78.4         65.8       54.7
regresja – prawda                             42.2         45.3       39.9
ICE: bez przedpłaty – z przedpłatą           113.1        111.4      101.5
SHAP: podnosi – obniża                       114.6        108.3       91.9
czerwony – zielony (do unikania)             121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja logistyczna (glm()) i przedział dla różnicy odsetków (prop.test()) – pakiet stats z podstawowej instalacji R; las losowy – pakiet ranger. Ważność permutacyjną, PDP, krzywe ICE i wartości SHAP policzono w bazowym R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ranger (wersja 0.18.0): Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ważność z nieczystości. Szum dostał 15.4% (rysunek 1); licz ważność permutacyjną na danych testowych.
- Sam PDP. Uśrednia interakcje (+25.2 i +0.9 pp do +15.1 pp) i zawodzi przy małej liczbie danych (rysunek 2).
- Skorelowane cechy. Cecha bez efektu dostaje ważność i „efekt” na PDP (rysunek 4).
- Wyjaśnienie jako obietnica. „Bez przedpłaty +19.8 pp” nie znaczy, że przedpłata obniży ryzyko o tyle (rysunek 5).
- Interpretacja przeuczonego modelu. Wyjaśniasz także dopasowany szum – najpierw oceń model na danych testowych.
Najczęstsze pytania
Czym różni się ważność permutacyjna od ważności z nieczystości w lesie losowym?
Ważność permutacyjna to spadek trafności modelu po przemieszaniu wartości cechy, najlepiej liczony na danych testowych. Ważność z nieczystości sumuje spadki indeksu Giniego w podziałach drzew na danych uczących i faworyzuje cechy z wieloma możliwymi podziałami. W przykładzie losowa minuta rezerwacji dostała 15.4% ważności z nieczystości i 0.6% ważności permutacyjnej. Zob. ważność permutacyjna zmiennych.
Co pokazują wartości SHAP?
Rozkładają jedną prognozę na wkłady cech: średnia prognoza plus suma wkładów równa się prognozie dla danej obserwacji. W przykładzie rezerwacja z 63.5% ryzyka miała wkłady +19.8 pp za brak przedpłaty i +14.7 pp za wyprzedzenie 122 dni przy średniej 29.9%. Przy kilku cechach SHAP da się policzyć dokładnie ze wszystkich podzbiorów cech.
Co krzywe ICE pokazują w modelu ryzyka, czego nie widać na PDP?
Krzywa ICE pokazuje, jak zmienia się prognoza jednej obserwacji, gdy zmieniamy jedną cechę, a PDP jest średnią wszystkich krzywych ICE. Gdy krzywe ICE się rozchodzą, model zawiera interakcję, którą PDP uśrednia. W przykładzie wyprzedzenie podnosiło ryzyko o 25.2 pp bez przedpłaty i o 0.9 pp z przedpłatą, a PDP pokazał +15.1 pp. Zob. PDP i krzywe ICE.
Czy wartości SHAP i PDP pokazują efekt przyczynowy?
Nie. Opisują, jak model łączy cechy z prognozą. W przykładzie PDP przedpłaty wynosił −32.9 pp, a prawdziwy efekt i eksperyment z losową przedpłatą około −19.5 pp, bo przedpłatę częściej wybierali klienci pewni swoich planów. Skutki decyzji sprawdzaj eksperymentem – zob. korelacja a przyczynowość.
Dlaczego skorelowane zmienne zaburzają interpretację modelu?
Permutacja i PDP tworzą nierealne kombinacje cech, np. duży rabat przy krótkim wyprzedzeniu, i model musi ekstrapolować. W symulacji rabat bez żadnego efektu dostał przy korelacji .95 ważność 0.030 w lesie losowym, a jego PDP rósł o 17.7 pp. Skorelowane cechy interpretuj łącznie.
Powiązane hasła
Przeczytaj też
Drzewa decyzyjne i lasy losowe
CART i przycinanie w rpart, las losowy w ranger, ważność permutacyjna, zależność cząstkowa, walidacja na nowych danych i wzór opisu.
Czytaj →PoradnikModel odejść klientów i kampania retencyjna
Operator komórkowy, 10 000 abonentów: regresja i las losowy, gain i lift, kalibracja, macierz decyzji, krzywa zysku i przeciek danych – pięć rysunków z kodem R.
Czytaj →PoradnikPrzeciek danych i walidacja w czasie
Sieć siłowni i rezygnacje z karnetu: zmienne z przyszłości, losowy podział, wybór zmiennych na szumie i okno przesuwane – pięć rysunków z kodem R.
Czytaj →PoradnikAtrybucja wartością Shapleya
Sieć szkół językowych: wartość koalicji kanałów, Shapley na 3 i 5 kanałach, porównanie z Markowem i ostatnim kliknięciem, bootstrap – kod R.
Czytaj →Interpretujesz model predykcyjny w pracy z zarządzania?
Pomożemy policzyć ważność cech na danych testowych, przygotować PDP, krzywe ICE i wartości SHAP oraz opisać wyniki bez przyczynowych nadinterpretacji – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aas, K., Jullum, M., & Løland, A. (2021). Explaining individual predictions when features are dependent: More accurate approximations to Shapley values. Artificial Intelligence, 298, Article 103502. https://doi.org/10.1016/j.artint.2021.103502 ● Otwarty dostęp
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/a:1010933404324 ● Otwarty dostęp: pełny tekst
- Goldstein, A., Kapelner, A., Bleich, J., & Pitkin, E. (2015). Peeking inside the black box: Visualizing statistical learning with plots of individual conditional expectation. Journal of Computational and Graphical Statistics, 24(1), 44–65. https://doi.org/10.1080/10618600.2014.907095 ● Otwarty dostęp: pełny tekst
- Hooker, G., Mentch, L., & Zhou, S. (2021). Unrestricted permutation forces extrapolation: Variable importance requires at least one more model, or there is no free variable importance. Statistics and Computing, 31(6), Article 82. https://doi.org/10.1007/s11222-021-10057-z ● Otwarty dostęp
- Lundberg, S. M., Erion, G., Chen, H., DeGrave, A., Prutkin, J. M., Nair, B., Katz, R., Himmelfarb, J., Bansal, N., & Lee, S.-I. (2020). From local explanations to global understanding with explainable AI for trees. Nature Machine Intelligence, 2(1), 56–67. https://doi.org/10.1038/s42256-019-0138-9 ● Otwarty dostęp: pełny tekst
- Strobl, C., Boulesteix, A.-L., Kneib, T., Augustin, T., & Zeileis, A. (2008). Conditional variable importance for random forests. BMC Bioinformatics, 9(1), Article 307. https://doi.org/10.1186/1471-2105-9-307 ● Otwarty dostęp
- Strobl, C., Boulesteix, A.-L., Zeileis, A., & Hothorn, T. (2007). Bias in random forest variable importance measures: Illustrations, sources and a solution. BMC Bioinformatics, 8(1), Article 25. https://doi.org/10.1186/1471-2105-8-25 ● Otwarty dostęp
- Zhao, Q., & Hastie, T. (2021). Causal interpretations of black-box models. Journal of Business & Economic Statistics, 39(1), 272–281. https://doi.org/10.1080/07350015.2019.1624293 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{aas2021explaining, author={Aas, Kjersti and Jullum, Martin and L{\o}land, Anders}, title={{Explaining individual predictions when features are dependent: More accurate approximations to Shapley values}}, journal={Artificial Intelligence}, year={2021}, volume={298}, eid={103502}, doi={10.1016/j.artint.2021.103502}}@article{breiman2001random, author={Breiman, Leo}, title={{Random forests}}, journal={Machine Learning}, year={2001}, volume={45}, number={1}, pages={5--32}, doi={10.1023/a:1010933404324}}@article{goldstein2015peeking, author={Goldstein, Alex and Kapelner, Adam and Bleich, Justin and Pitkin, Emil}, title={{Peeking inside the black box: Visualizing statistical learning with plots of individual conditional expectation}}, journal={Journal of Computational and Graphical Statistics}, year={2015}, volume={24}, number={1}, pages={44--65}, doi={10.1080/10618600.2014.907095}}@article{hooker2021unrestricted, author={Hooker, Giles and Mentch, Lucas and Zhou, Siyu}, title={{Unrestricted permutation forces extrapolation: Variable importance requires at least one more model, or there is no free variable importance}}, journal={Statistics and Computing}, year={2021}, volume={31}, number={6}, eid={82}, doi={10.1007/s11222-021-10057-z}}@article{lundberg2020local, author={Lundberg, Scott M. and Erion, Gabriel and Chen, Hugh and DeGrave, Alex and Prutkin, Jordan M. and Nair, Bala and Katz, Ronit and Himmelfarb, Jonathan and Bansal, Nisha and Lee, Su-In}, title={{From local explanations to global understanding with explainable AI for trees}}, journal={Nature Machine Intelligence}, year={2020}, volume={2}, number={1}, pages={56--67}, doi={10.1038/s42256-019-0138-9}}@article{strobl2008conditional, author={Strobl, Carolin and Boulesteix, Anne-Laure and Kneib, Thomas and Augustin, Thomas and Zeileis, Achim}, title={{Conditional variable importance for random forests}}, journal={BMC Bioinformatics}, year={2008}, volume={9}, number={1}, eid={307}, doi={10.1186/1471-2105-9-307}}@article{strobl2007bias, author={Strobl, Carolin and Boulesteix, Anne-Laure and Zeileis, Achim and Hothorn, Torsten}, title={{Bias in random forest variable importance measures: Illustrations, sources and a solution}}, journal={BMC Bioinformatics}, year={2007}, volume={8}, number={1}, eid={25}, doi={10.1186/1471-2105-8-25}}@article{zhao2021causal, author={Zhao, Qingyuan and Hastie, Trevor}, title={{Causal interpretations of black-box models}}, journal={Journal of Business \& Economic Statistics}, year={2021}, volume={39}, number={1}, pages={272--281}, doi={10.1080/07350015.2019.1624293}}