Przykład: sieć szkół językowych i pytanie „który kanał zapisuje na kursy?”
Fikcyjna sieć szkół językowych prowadzi zapisy na kursy roczne od 15 sierpnia do 30 września. Osoby zainteresowane trafiają na stronę z pięciu źródeł: wyszukiwarki internetowej (W), reklamy w serwisie społecznościowym (S), newslettera e-mail (E), linku polecającego od znajomego (P) i wizyty bezpośredniej – wpisanego adresu strony (B). Dla każdej osoby mamy ścieżkę wizyt, np. „S > W > B”, i informację, czy zapisała się na kurs. Dyrektor marketingu pyta: ile zapisów dał każdy kanał i jak podzielić budżet?
To pytanie o atrybucję, czyli podział zasługi za konwersję między kontakty klienta z firmą (Shao i Li, 2011). Wcześniej opisaliśmy atrybucję łańcuchem Markowa na ścieżkach klientów biura podróży. Tu dokładamy wartość Shapleya i porównujemy obie metody na tych samych ścieżkach. Inne projekty z tej dziedziny znajdziesz we wpisie statystyka w pracy z marketingu.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Symulujemy 14 000 osób zainteresowanych kursem; 25% to dawni kursanci. Osoby bardziej zdecydowane częściej same szukają szkoły w wyszukiwarce i wchodzą na stronę bezpośrednio, a newsletter trafia głównie do dawnych kursantów. Prawdziwy wpływ kanałów na zapis ustaliliśmy ręcznie na skali logitu: polecenie +1.10, serwis społecznościowy +0.45, e-mail +0.35, wyszukiwarka +0.25, wizyta bezpośrednia +0.15 oraz +0.35, gdy osoba miała kontakt i z serwisem, i z wyszukiwarką (pełna lista parametrów przy kodzie). Parametrów ani ziarna 734 nie zmienialiśmy po pierwszym uruchomieniu.
Co najmniej jeden kontakt miało 11 504 osób, a 1675 z nich (14.56%) zapisało się na kurs. Ścieżka ma średnio 2.69 wizyty, a różnych zbiorów kanałów jest 31 – wszystkie możliwe. Z serwisem zetknęło się 63.3% osób, z poleceniem tylko 11.2%. Dane pobierzesz jako atrybucja-shapley-sciezki-szkola-jezykowa.csv (kolumny: id, ścieżka, zapis 0/1, kontakt z każdym kanałem 0/1 i zbiór kanałów).
Rysunek 1: wartość koalicji – odsetek zapisów dla każdego zbioru kanałów
Wartość Shapleya pochodzi z teorii gier kooperacyjnych: dzieli wygraną zespołu między graczy. Graczami są kanały, a „wygraną” koalicji S – wartość koalicji v(S). W najprostszej wersji v(S) to odsetek zapisów wśród ścieżek, które zawierają dokładnie zbiór kanałów S, bez względu na kolejność wizyt. Koalicja pusta ma v = 0. Do każdego odsetka liczymy przedział ufności dla proporcji (metodą Wilsona).
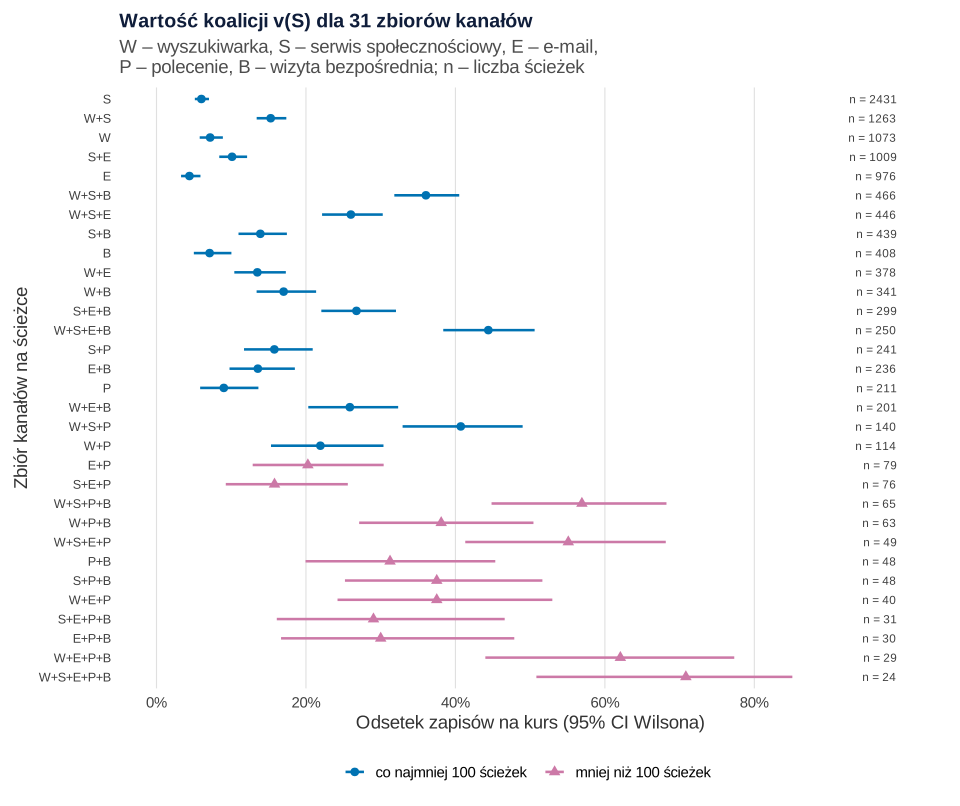
set.seed(734)).Co widać. Ścieżki z jednym kanałem mają niskie odsetki: 6.0% dla samego serwisu (n = 2431), 7.2% dla samej wyszukiwarki, 4.4% dla samego e-maila. Im więcej kanałów, tym wyższy odsetek – do 70.8% przy wszystkich pięciu. Dwanaście zbiorów ma mniej niż 100 ścieżek; łącznie to 582 osoby i 217 zapisów.
Jak może zmylić. Wyższy odsetek przy dłuższych ścieżkach nie znaczy, że każdy kanał „dokłada” zapisy – osoby zdecydowane same odwiedzają więcej kanałów. Rzadkie zbiory (trójkąty) mają przedziały szerokie na 16–34 punkty procentowe – a każdy z nich wejdzie do rachunku Shapleya.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: wartość Shapleya na trzech kanałach – wszystkie koalicje
Weźmy ścieżki z wyszukiwarką, serwisem i e-mailem (446 osób, 116 zapisów, v = 26.01%). Jak podzielić te 26.01 punktu procentowego między trzy kanały? Kanały „wchodzą” do koalicji po kolei, a każdy dostaje przyrost wartości koalicji w chwili swojego wejścia. Wynik zależy od kolejności, więc uśredniamy po sześciu kolejnościach. Słowami: wartość Shapleya kanału to jego średni przyrost wartości koalicji po wszystkich kolejnościach dołączania. Ogólny wzór dla m kanałów:
Waga to odsetek kolejności, w których kanał i dołącza do koalicji T: przy trzech kanałach 1/3 (wejście pierwsze albo ostatnie) i 1/6 (dołączenie do jednego kanału).
| Kolejność dołączania | Wyszukiwarka (pp) | Serwis (pp) | E-mail (pp) |
|---|---|---|---|
| W → S → E | 7.18 | 8.10 | 10.73 |
| W → E → S | 7.18 | 12.52 | 6.32 |
| S → W → E | 9.28 | 6.01 | 10.73 |
| S → E → W | 15.90 | 6.01 | 4.10 |
| E → W → S | 9.09 | 12.52 | 4.41 |
| E → S → W | 15.90 | 5.70 | 4.41 |
| Średnia = wartość Shapleya | 10.75 | 8.48 | 6.78 |
Pierwszy wiersz: sama wyszukiwarka ma v = 7.18%, więc wchodząc pierwsza, dostaje 7.18. Para W + S ma 15.28%, więc serwis dokłada 8.10. Cała trójka ma 26.01%, więc e-mail dokłada 10.73. Suma w każdym wierszu wynosi 26.01 – tak samo średnie: 10.75 + 8.48 + 6.78 = 26.01. To własność efektywności: rozdzielamy całą wartość koalicji. Udziały: 41.3%, 32.6% i 26.1%.
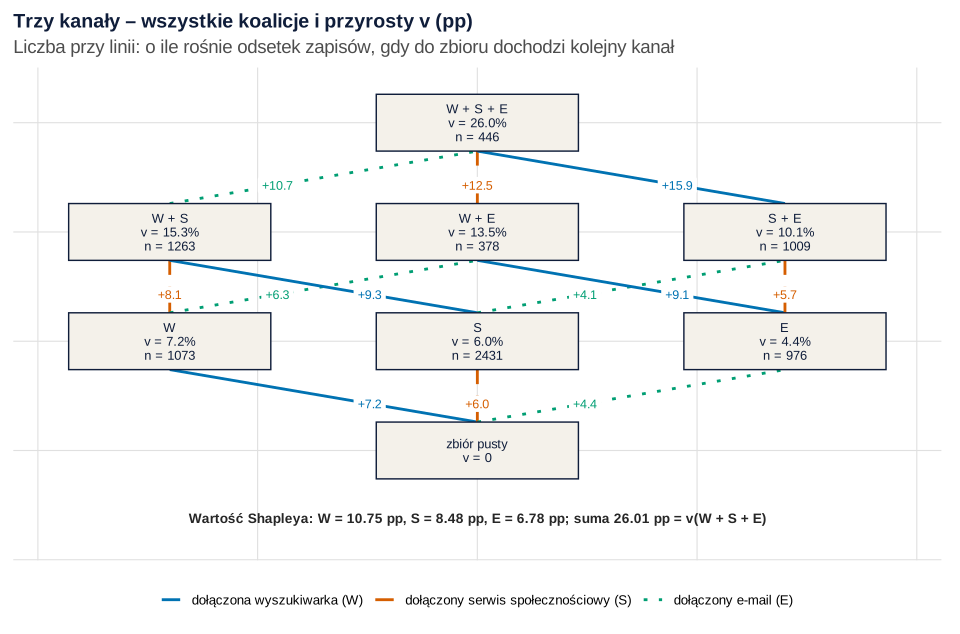
Co widać. Każda ścieżka od dołu do góry kratownicy to jedna kolejność z tabeli. Wyszukiwarka daje duże przyrosty, gdy dołącza do serwisu lub e-maila (+9.3 i +9.1) i jeszcze większy, gdy dołącza do obu (+15.9). Dlatego wygrywa, choć sama ma tylko 7.2%. W odróżnieniu od reguł kliknięć wartość Shapleya korzysta też ze ścieżek bez zapisu.
Jak może zmylić. Przyrost to różnica odsetków w różnych grupach osób, a nie efekt dodania kanału tej samej osobie.
Podpis do pracy:
Rysunek 3: te same ścieżki, cztery podziały zapisów
Dla pięciu kanałów robimy to samo w każdym z 31 zbiorów: liczymy wartości Shapleya na podzbiorach danego zbioru i dzielimy jego zapisy w ich proporcji. Żaden kanał w żadnym zbiorze nie dostał ujemnego wkładu (najmniejszy wynosił 1.77 pp). Do atrybucji z teorii gier kooperacyjnych nawiązują Dalessandro i in. (2012). Obok stawiamy trzy inne podziały: ostatnie kliknięcie, pierwsze kliknięcie i łańcuch Markowa z efektem usunięcia (Anderl i in., 2016). Szansa zapisu z macierzy przejść wynosi .1456, tyle co w danych.
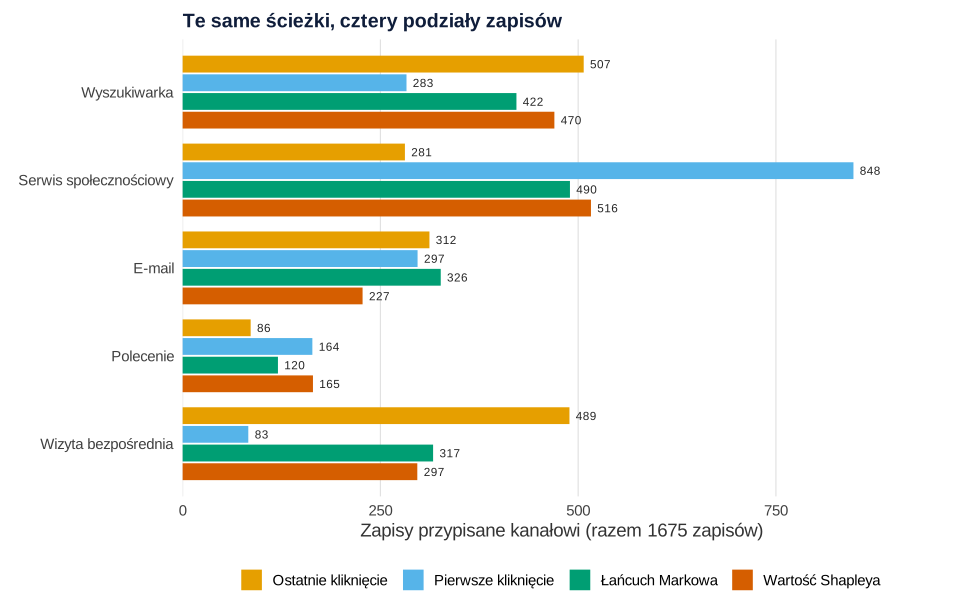
Co widać. Reguły skrajnie się różnią: ostatnie kliknięcie daje wizycie bezpośredniej 489 zapisów, pierwsze – 83; serwisowi odpowiednio 281 i 848. Markow i Shapley leżą pomiędzy i są podobne dla wyszukiwarki (422 i 470), serwisu (490 i 516) i wizyty bezpośredniej (317 i 297), a różnią się przy e-mailu (326 i 227) i poleceniu (120 i 165).
Jak może zmylić. Zgodność dwóch metod nie dowodzi, że mają rację – obie korzystają z tych samych ścieżek. Markow używa kolejności kroków, Shapley – zbiorów kanałów. Singal i in. (2022) pokazują, że popularne heurystyki mogą naruszać rozsądne aksjomaty podziału, a klasyczna wartość Shapleya w reklamie też wymaga korekty.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: niepewność udziałów – bootstrap ścieżek
Udział 28.1% to oszacowanie z jednej próby osób. Żeby zobaczyć jego niepewność, losujemy ze zwracaniem 11 504 osoby (całe ścieżki), liczymy oba podziały od nowa i powtarzamy 1000 razy. To bootstrap (Efron, 1979); 95% przedział to 2.5. i 97.5. percentyl wyników. Zobacz też bootstrap na obrazkach.
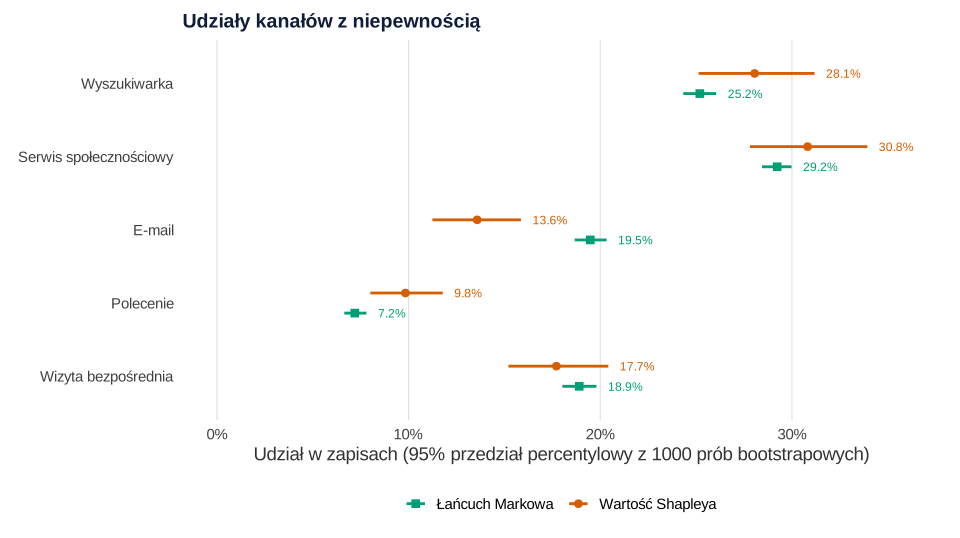
set.seed(7341)).Co widać. Przedziały Shapleya mają szerokość 3.8–6.1 punktu procentowego, Markowa – 1.2–1.8. Serwis wyprzedzał wyszukiwarkę w 85.8% prób u Shapleya i w 100% u Markowa. Przy e-mailu i poleceniu przedziały obu metod się nie pokrywają: różnica między metodami jest większa niż niepewność z próby.
Jak może zmylić. Wąski przedział Markowa nie znaczy, że Markow jest bliżej prawdy. Łańcuch łączy przejścia ze wszystkich ścieżek w jedną macierz i „zapomina” wcześniejsze kroki – to mocne założenie, które zmniejsza wariancję, ale nie obciążenie. Shapley opiera się na 31 osobnych odsetkach, więc rzadkie grupy poszerzają przedział.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: atrybucja a zapisy, których bez kanału by nie było
W symulacji możemy tym samym osobom, z tym samym „losem”, wyłączyć jeden kanał i policzyć, ile zapisów ubędzie. To porównanie dwóch potencjalnych wyników – świata z kanałem i bez niego. Łącznie zapisało się 1760 osób (85 bez zarejestrowanego kontaktu). Bez żadnego kanału zapisałoby się 938.
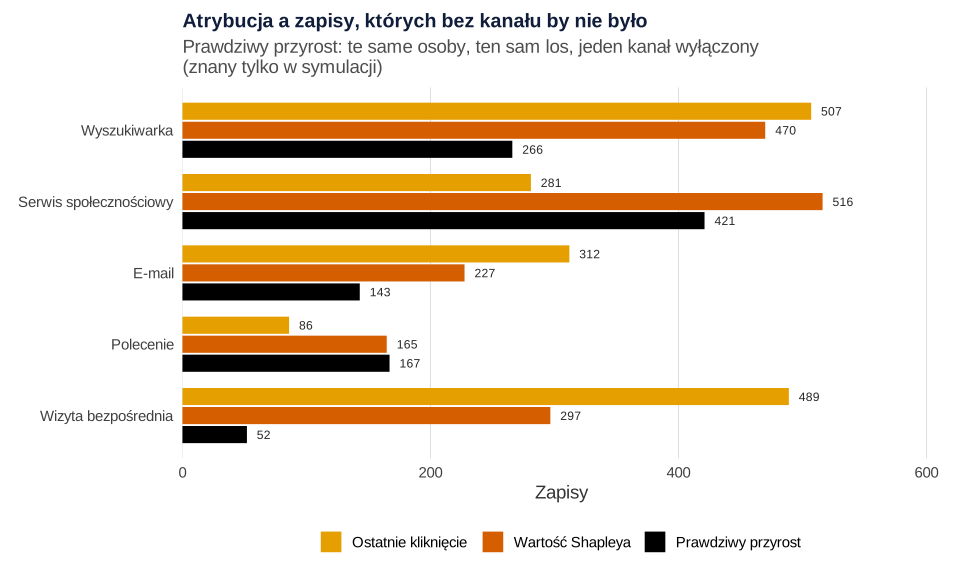
Co widać. Polecenie dostało od Shapleya 165 zapisów przy prawdziwym przyroście 167. Wizyta bezpośrednia dostała 297, a bez niej ubyłoby tylko 52 zapisy – 5.70 razy mniej. Wyszukiwarka dostała 1.77 razy więcej, niż wynosi jej przyrost, e-mail 1.59 razy, serwis 1.23 razy. Shapley wciąż przecenia kanały, którymi poruszają się osoby już zdecydowane.
Jak może zmylić. To korelacja, a nie przyczynowość: gotowość do zapisu jest zmienną zakłócającą, która zwiększa i szansę wizyty bezpośredniej, i szansę zapisu. Podobny wzór opisali Blake i in. (2015): kliknięcia w reklamy w wyszukiwarce były skorelowane z zamiarem zakupu, a zwrot z tych reklam w eksperymencie okazał się ułamkiem oszacowań nieeksperymentalnych.
Podpis do pracy:
Zdanie do Dyskusji:
Co z tym zrobić w marketingu
- Zrezygnuj z jednej reguły kliknięcia. Ostatnie kliknięcie zawyża wizytę bezpośrednią i wyszukiwarkę, a zaniża serwis społecznościowy i polecenia. Berman (2018) pokazuje w modelu teoretycznym, że ostatni dotyk zachęca do nadmiernej liczby ekspozycji reklam, a podział wartością Shapleya zwiększa zysk reklamodawcy.
- Licz dwie metody oparte na danych i porównuj. Gdy Shapley i Markow dają podobne udziały (tu wyszukiwarka i serwis), wynik jest odporniejszy. Gdy się rozjeżdżają (e-mail: 13.6% i 19.5%), zbadaj kanał eksperymentem.
- Podawaj przedziały. Udział 9.8% dla poleceń ma przedział [8.0, 11.8], a 60.9% zapisów przypisanych poleceniom pochodzi ze zbiorów kanałów, które mają mniej niż 100 ścieżek.
- Budżet sprawdzaj eksperymentem. Dla kanałów z największą rozbieżnością (tu wizyta bezpośrednia i wyszukiwarka) zaplanuj test wyłączenia reklamy (holdout) albo geo-eksperyment w regionach, w których działa sieć szkół. Cały budżet oceni marketing mix modeling.
- Polecenia traktuj osobno. W przykładzie to jedyny kanał, w którym atrybucja i prawdziwy przyrost się zgadzają – bo w symulacji tylko słabo zależą od gotowości do zapisu. Program poleceń i tak oceń testem A/B różnych nagród.
Jak opisać w pracy
Opisz okno czasowe, definicję konwersji i wartości koalicji, rzadkie zbiory i liczbę prób bootstrapowych. Konwersję w sklepie stacjonarnym opisujemy we wpisie ruch w sklepie a konwersja, a etapy – w analizie lejka konwersji.
| Kanał | Ostatnie kliknięcie (%) | Pierwsze kliknięcie (%) | Łańcuch Markowa (%) [95% CI] | Wartość Shapleya (%) [95% CI] |
|---|---|---|---|---|
| Wyszukiwarka | 30.3 | 16.9 | 25.2 [24.3, 26.0] | 28.1 [25.1, 31.2] |
| Serwis społecznościowy | 16.8 | 50.6 | 29.2 [28.4, 30.0] | 30.8 [27.8, 33.9] |
| 18.6 | 17.7 | 19.5 [18.7, 20.3] | 13.6 [11.2, 15.9] | |
| Polecenie | 5.1 | 9.8 | 7.2 [6.6, 7.8] | 9.8 [8.0, 11.8] |
| Wizyta bezpośrednia | 29.2 | 5.0 | 18.9 [18.0, 19.8] | 17.7 [15.2, 20.4] |
Kod R: wartość koalicji, Shapley, łańcuch Markowa i bootstrap w bazowym R
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 3 – funkcję shapley(), przepis 4 – funkcje atrybucji, z których korzystają następne. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Wartość Shapleya i łańcuch Markowa liczymy w bazowym R; dla wielu kanałów i milionów ścieżek są do tego gotowe pakiety, ale rachunek jest ten sam.
Losują przepisy 1 (set.seed(734)) i 5 (set.seed(7341)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: liczbę osób (14 000) i odsetek dawnych kursantów (25%); szansę kontaktu z kanałem (logit): wyszukiwarka −0.7 + 0.9 × gotowość, serwis 0.1 + 0.2 × gotowość, polecenie −2.3 + 0.3 × gotowość, wizyta bezpośrednia −1.8 + 1.1 × gotowość + 0.8 × dawny kursant; e-mail 0.75 u dawnych kursantów i 0.15 u pozostałych (gotowość ~ N(0, 1)); szansę zapisu (logit): −3.4 + 1.2 × gotowość + 0.7 × dawny kursant + 0.25 W + 0.45 S + 0.35 E + 1.10 P + 0.15 B + 0.35 W × S; liczbę wizyt z kanału 1 + Poisson(0.5) i ich moment w sezonie z rozkładów beta (wyszukiwarka 2.5, 2; serwis 1.3, 3; e-mail 1, 1; polecenie 1.5, 2.5; wizyta bezpośrednia 4, 1.5); próg „rzadkiego” zbioru – 100 ścieżek – i 1000 prób bootstrapowych. Po pierwszym uruchomieniu nie zmieniano parametrów danych; poprawiono tylko wygląd rysunków (zakres osi, podtytuły) i dodano trzy wydruki kontrolne w przepisach 4 i 5. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się ok. 10 sekund (najdłużej bootstrap).
1. Dane: 14 000 osób, pięć kanałów, ścieżki wizyt
R
# Przepis 1. Fikcyjna sieć szkół językowych: 14 000 osób zainteresowanych kursem w sezonie zapisów
# (15 sierpnia – 30 września) i ich kontakty z pięcioma kanałami.
library(ggplot2)
options(width = 120)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Ostatnie kliknięcie" = "#E69F00", "Pierwsze kliknięcie" = "#56B4E9",
         "Łańcuch Markowa" = "#009E73", "Wartość Shapleya" = "#D55E00",
         "Prawdziwy przyrost" = "#000000", "rzadka" = "#CC79A7", "czesta" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)                 # znak minus (−) w etykietach rysunków

# Kanały: W – wyszukiwarka internetowa, S – serwis społecznościowy, E – e-mail (newsletter),
# P – polecenie (link od znajomego), B – wizyta bezpośrednia (wpisany adres strony)
kanaly <- c(W = "Wyszukiwarka", S = "Serwis społecznościowy", E = "E-mail", P = "Polecenie", B = "Wizyta bezpośrednia")

# Parametry ustalone ręcznie
set.seed(734)
N <- 14000
osoby <- data.frame(id = seq_len(N),
                    zainteresowanie = rnorm(N),                 # ukryta gotowość do zapisu (w danych jej nie ma)
                    byly_kursant = rbinom(N, 1, 0.25))          # 25% to dawni kursanci
z <- osoby$zainteresowanie; b <- osoby$byly_kursant
p_kontakt <- cbind(W = plogis(-0.7 + 0.9 * z),                 # wyszukują częściej osoby już zainteresowane
                   S = plogis(0.1 + 0.2 * z),                  # reklama w serwisie dociera szeroko
                   E = ifelse(b == 1, 0.75, 0.15),             # newsletter głównie do dawnych kursantów
                   P = plogis(-2.3 + 0.3 * z),                 # polecenie od znajomego
                   B = plogis(-1.8 + 1.1 * z + 0.8 * b))       # wizyta bezpośrednia: zainteresowani i dawni kursanci
kontakt <- matrix(rbinom(N * 5, 1, p_kontakt), N, 5, dimnames = list(NULL, names(kanaly)))

# Prawdziwy wpływ kanałów na zapis (skala logitu) – w prawdziwych danych nieznany
beta <- c(W = 0.25, S = 0.45, E = 0.35, P = 1.10, B = 0.15)
logit_zapisu <- function(k) -3.4 + 1.2 * z + 0.7 * b + drop(k %*% beta) + 0.35 * k[, "W"] * k[, "S"]
osoby$u <- runif(N)                                    # „los” osoby: zapisuje się, gdy u < p
osoby$zapis <- as.integer(osoby$u < plogis(logit_zapisu(kontakt)))

# Kolejność kontaktów: każdy kanał 1 + Poisson(0.5) razy; serwis i polecenie raczej na początku,
# wyszukiwarka i wizyta bezpośrednia raczej pod koniec ścieżki
ksztalt <- list(W = c(2.5, 2), S = c(1.3, 3), E = c(1, 1), P = c(1.5, 2.5), B = c(4, 1.5))
sciezka <- character(N)
for (i in which(rowSums(kontakt) > 0)) {
  k <- names(kanaly)[kontakt[i, ] == 1]
  ile <- 1 + rpois(length(k), 0.5)
  kroki <- rep(k, ile)
  czas <- unlist(lapply(seq_along(k), function(j) rbeta(ile[j], ksztalt[[k[j]]][1], ksztalt[[k[j]]][2])))
  sciezka[i] <- paste(kroki[order(czas)], collapse = " > ")
}
osoby$sciezka <- sciezka
osoby <- cbind(osoby, kontakt)

# Dane analityka: tylko osoby z co najmniej jednym zarejestrowanym kontaktem
dane <- subset(osoby, sciezka != "", select = c(id, sciezka, zapis, W, S, E, P, B))
dane$zbior <- apply(dane[, names(kanaly)], 1, function(r) paste(names(kanaly)[r == 1], collapse = "+"))
write.csv(dane, "atrybucja-shapley-sciezki-szkola-jezykowa.csv", row.names = FALSE, fileEncoding = "UTF-8")

c(osoby = N, z_kontaktem = nrow(dane), zapisy_z_kontaktem = sum(dane$zapis),
  zapisy_bez_kontaktu = sum(osoby$zapis) - sum(dane$zapis))
round(c(odsetek_zapisow = 100 * mean(dane$zapis),
        srednia_dlugosc = mean(lengths(strsplit(dane$sciezka, " > "))),
        rozne_sciezki = length(unique(dane$sciezka)), rozne_zbiory = length(unique(dane$zbior))), 2)
round(100 * colMeans(dane[, names(kanaly)]), 1)        # odsetek osób z kontaktem z każdym kanałem
head(dane[, c("id", "sciezka", "zbior", "zapis")], 4)
Wynik w R
              osoby         z_kontaktem  zapisy_z_kontaktem zapisy_bez_kontaktu
              14000               11504                1675                  85
odsetek_zapisow srednia_dlugosc   rozne_sciezki    rozne_zbiory
          14.56            2.69         1628.00           31.00
   W    S    E    P    B
43.0 63.3 36.1 11.2 25.9
  id sciezka zbior zapis
1  1   P > E   E+P     0
2  2   S > E   S+E     0
3  3   W > W     W     0
4  4   S > S     S     0
2. Wartość koalicji v(S) z przedziałem Wilsona: Rysunek 1
R
# Przepis 2. Wartość koalicji v(S): odsetek zapisów wśród ścieżek, które zawierają DOKŁADNIE zbiór kanałów S
# Korzysta z obiektów przepisu 1: dane, kanaly, kol, motyw. Niczego nie losuje. Rysunek 1.
koalicje <- aggregate(zapis ~ zbior, data = dane, FUN = function(x) c(n = length(x), zapisy = sum(x)))
koalicje <- data.frame(zbior = koalicje$zbior, n = koalicje$zapis[, "n"], zapisy = koalicje$zapis[, "zapisy"])
koalicje$v <- koalicje$zapisy / koalicje$n
# 95% przedział Wilsona dla odsetka
wilson <- function(x, n, z = qnorm(0.975)) {
  p <- x / n; m <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  h <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  cbind(dolna = m - h, gorna = m + h)
}
koalicje <- cbind(koalicje, wilson(koalicje$zapisy, koalicje$n))
koalicje$liczba_kanalow <- lengths(strsplit(koalicje$zbior, "+", fixed = TRUE))
koalicje <- koalicje[order(-koalicje$n), ]
print(transform(koalicje, v = round(100 * v, 1), dolna = round(100 * dolna, 1), gorna = round(100 * gorna, 1)),
      row.names = FALSE)
rzadkie <- koalicje$n < 100
c(zbiorow = nrow(koalicje), rzadkich_n_ponizej_100 = sum(rzadkie),
  osob_w_rzadkich = sum(koalicje$n[rzadkie]), zapisow_w_rzadkich = sum(koalicje$zapisy[rzadkie]))

koalicje$typ <- factor(ifelse(rzadkie, "rzadka", "czesta"), levels = c("czesta", "rzadka"))
koalicje$etykieta <- factor(koalicje$zbior, levels = rev(koalicje$zbior))
p1 <- ggplot(koalicje, aes(v, etykieta)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna, colour = typ), width = 0, linewidth = 0.9, orientation = "y") +
  geom_point(aes(colour = typ, shape = typ), size = 2.6) +
  geom_text(aes(x = 0.99, label = paste0("n = ", n)), hjust = 1, size = 3.1, colour = "grey25") +
  scale_colour_manual(values = kol[c("czesta", "rzadka")], name = NULL,
                      labels = c(czesta = "co najmniej 100 ścieżek", rzadka = "mniej niż 100 ścieżek")) +
  scale_shape_manual(values = c(czesta = 16, rzadka = 17), name = NULL,
                     labels = c(czesta = "co najmniej 100 ścieżek", rzadka = "mniej niż 100 ścieżek")) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%"), breaks = seq(0, 0.8, 0.2), limits = c(0, 1)) +
  labs(x = "Odsetek zapisów na kurs (95% CI Wilsona)", y = "Zbiór kanałów na ścieżce",
       title = "Wartość koalicji v(S) dla 31 zbiorów kanałów",
       subtitle = "W – wyszukiwarka, S – serwis społecznościowy, E – e-mail,\nP – polecenie, B – wizyta bezpośrednia; n – liczba ścieżek") +
  motyw + theme(panel.grid.major.y = element_blank(), axis.text.y = element_text(size = 9.5))
p1   # zapis: ggsave("atrybucja-shapley-koalicje.svg", p1, width = 10, height = 8.4)
Wynik w R
     zbior    n zapisy    v dolna gorna liczba_kanalow
         S 2431    146  6.0   5.1   7.0              1
       W+S 1263    193 15.3  13.4  17.4              2
         W 1073     77  7.2   5.8   8.9              1
       S+E 1009    102 10.1   8.4  12.1              2
         E  976     43  4.4   3.3   5.9              1
     W+S+B  466    168 36.1  31.8  40.5              3
     W+S+E  446    116 26.0  22.2  30.3              3
       S+B  439     61 13.9  11.0  17.4              2
         B  408     29  7.1   5.0  10.0              1
       W+E  378     51 13.5  10.4  17.3              2
       W+B  341     58 17.0  13.4  21.4              2
     S+E+B  299     80 26.8  22.1  32.0              3
   W+S+E+B  250    111 44.4  38.4  50.6              4
       S+P  241     38 15.8  11.7  20.9              2
       E+B  236     32 13.6   9.8  18.5              2
         P  211     19  9.0   5.8  13.6              1
     W+E+B  201     52 25.9  20.3  32.3              3
     W+S+P  140     57 40.7  32.9  49.0              3
       W+P  114     25 21.9  15.3  30.4              2
       E+P   79     16 20.3  12.9  30.4              2
     S+E+P   76     12 15.8   9.3  25.6              3
   W+S+P+B   65     37 56.9  44.8  68.2              4
     W+P+B   63     24 38.1  27.1  50.4              3
   W+S+E+P   49     27 55.1  41.3  68.1              4
       P+B   48     15 31.2  19.9  45.3              2
     S+P+B   48     18 37.5  25.2  51.6              3
     W+E+P   40     15 37.5  24.2  53.0              3
   S+E+P+B   31      9 29.0  16.1  46.6              4
     E+P+B   30      9 30.0  16.7  47.9              3
   W+E+P+B   29     18 62.1  44.0  77.3              4
 W+S+E+P+B   24     17 70.8  50.8  85.1              5
               zbiorow rzadkich_n_ponizej_100        osob_w_rzadkich     zapisow_w_rzadkich
                    31                     12                    582                    217
3. Wartość Shapleya krok po kroku na trzech kanałach: Rysunek 2
R
# Przepis 3. Wartość Shapleya krok po kroku dla trzech kanałów: W, S i E (wszystkie podzbiory). Rysunek 2.
# Korzysta z obiektów przepisów 1–2: kanaly, koalicje, motyw. Niczego nie losuje.

klucz <- function(s) paste(names(kanaly)[names(kanaly) %in% s], collapse = "+")   # np. c("S", "W") -> "W+S"
v_dane <- function(s) {                                # v(S); zbiór pusty i zbiór bez ścieżek -> 0
  if (length(s) == 0) return(0)
  k <- match(klucz(s), koalicje$zbior)
  if (is.na(k)) 0 else koalicje$v[k]
}
# Wartość Shapleya: średni przyrost v po dołączeniu gracza, z wagą |T|! (m − |T| − 1)! / m!
shapley <- function(gracze, v) {
  m <- length(gracze); phi <- setNames(numeric(m), gracze)
  for (i in gracze) {
    inni <- setdiff(gracze, i)
    for (r in 0:(m - 1)) {
      waga <- factorial(r) * factorial(m - r - 1) / factorial(m)
      podzbiory <- if (r == 0) list(character(0)) else combn(inni, r, simplify = FALSE)
      for (T in podzbiory) phi[i] <- phi[i] + waga * (v(c(T, i)) - v(T))
    }
  }
  phi
}

trzy <- c("W", "S", "E")
podzbiory <- unlist(lapply(1:3, function(r) combn(trzy, r, simplify = FALSE)), recursive = FALSE)
tab_v <- data.frame(S = sapply(podzbiory, klucz), v_proc = round(100 * sapply(podzbiory, v_dane), 2),
                    n = sapply(podzbiory, function(s) koalicje$n[match(klucz(s), koalicje$zbior)]))
print(tab_v, row.names = FALSE)

# Sześć kolejności „wchodzenia” kanałów do koalicji i przyrosty v (w punktach procentowych)
kolejnosci <- list(c("W", "S", "E"), c("W", "E", "S"), c("S", "W", "E"), c("S", "E", "W"), c("E", "W", "S"), c("E", "S", "W"))
przyrosty <- t(sapply(kolejnosci, function(o) {
  wkl <- setNames(numeric(3), trzy)
  for (j in seq_along(o)) wkl[o[j]] <- v_dane(o[1:j]) - v_dane(o[seq_len(j - 1)])
  100 * wkl
}))
rownames(przyrosty) <- sapply(kolejnosci, paste, collapse = " → ")
round(przyrosty, 2)
phi3 <- shapley(trzy, v_dane)
round(rbind(srednia_z_kolejnosci = colMeans(przyrosty), shapley_proc = 100 * phi3, udzial_proc = 100 * phi3 / sum(phi3)), 2)
c(suma_phi_proc = round(100 * sum(phi3), 2), v_WSE_proc = round(100 * v_dane(trzy), 2))

# Rysunek 2 (grafika): kratownica wszystkich koalicji trzech kanałów
wezly <- data.frame(zbior = c("", "W", "S", "E", "W+S", "W+E", "S+E", "W+S+E"),
                    x = c(5, 1.5, 5, 8.5, 1.5, 5, 8.5, 5), y = c(0, 1, 1, 1, 2, 2, 2, 3))
wezly$v <- sapply(strsplit(wezly$zbior, "+", fixed = TRUE), v_dane)
wezly$n <- koalicje$n[match(wezly$zbior, koalicje$zbior)]
wezly$tekst <- ifelse(wezly$zbior == "", "zbiór pusty\nv = 0",
                      sprintf("%s\nv = %.1f%%\nn = %d", gsub("+", " + ", wezly$zbior, fixed = TRUE), 100 * wezly$v, wezly$n))
krawedzie <- do.call(rbind, lapply(seq_len(nrow(wezly)), function(a) do.call(rbind, lapply(seq_len(nrow(wezly)), function(d) {
  sa <- strsplit(wezly$zbior[a], "+", fixed = TRUE)[[1]]; sd <- strsplit(wezly$zbior[d], "+", fixed = TRUE)[[1]]
  if (length(sd) == length(sa) + 1 && all(sa %in% sd))
    data.frame(x = wezly$x[a], y = wezly$y[a], xend = wezly$x[d], yend = wezly$y[d],
               dodany = setdiff(sd, sa), przyrost = 100 * (wezly$v[d] - wezly$v[a]))
}))))
krawedzie$dodany <- factor(krawedzie$dodany, levels = trzy, labels = c("dołączona wyszukiwarka (W)",
                           "dołączony serwis społecznościowy (S)", "dołączony e-mail (E)"))
kol_k <- c("#0072B2", "#D55E00", "#009E73")
podsum <- sprintf("Wartość Shapleya: W = %.2f pp, S = %.2f pp, E = %.2f pp; suma %.2f pp = v(W + S + E)",
                  100 * phi3["W"], 100 * phi3["S"], 100 * phi3["E"], 100 * sum(phi3))
p2 <- ggplot() +
  geom_segment(data = krawedzie, aes(x, y + 0.26, xend = xend, yend = yend - 0.26, colour = dodany, linetype = dodany),
               linewidth = 1) +
  geom_label(data = krawedzie, aes(x + 0.35 * (xend - x), y + 0.26 + 0.35 * (yend - y - 0.52),
                                   label = sprintf("+%.1f", przyrost), colour = dodany),
             size = 3.3, linewidth = 0, fill = "white", show.legend = FALSE) +
  geom_tile(data = wezly, aes(x, y), width = 2.3, height = 0.52, fill = "#F4F1EA", colour = "#0f1d3a", linewidth = 0.5) +
  geom_text(data = wezly, aes(x, y, label = tekst), size = 3.4, lineheight = 0.9, colour = "#0f1d3a") +
  annotate("text", x = 5, y = -0.62, label = podsum, size = 3.6, colour = "grey15", fontface = "bold") +
  scale_colour_manual(values = kol_k, name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotted"), name = NULL) +
  scale_x_continuous(limits = c(0.2, 9.8)) + scale_y_continuous(limits = c(-0.8, 3.3)) +
  labs(title = "Trzy kanały – wszystkie koalicje i przyrosty v (pp)", x = NULL, y = NULL,
       subtitle = "Liczba przy linii: o ile rośnie odsetek zapisów, gdy do zbioru dochodzi kolejny kanał") +
  guides(colour = guide_legend(nrow = 1), linetype = guide_legend(nrow = 1)) +
  motyw + theme(panel.grid = element_blank(), axis.text = element_blank(), legend.text = element_text(size = 10))
p2   # zapis: ggsave("atrybucja-shapley-trzy-kanaly.svg", p2, width = 10, height = 6.6)
Wynik w R
     S v_proc    n
     W   7.18 1073
     S   6.01 2431
     E   4.41  976
   W+S  15.28 1263
   W+E  13.49  378
   S+E  10.11 1009
 W+S+E  26.01  446
              W     S     E
W → S → E  7.18  8.10 10.73
W → E → S  7.18 12.52  6.32
S → W → E  9.28  6.01 10.73
S → E → W 15.90  6.01  4.10
E → W → S  9.09 12.52  4.41
E → S → W 15.90  5.70  4.41
                         W     S     E
srednia_z_kolejnosci 10.75  8.48  6.78
shapley_proc         10.75  8.48  6.78
udzial_proc          41.34 32.59 26.07
suma_phi_proc    v_WSE_proc
        26.01         26.01
4. Ostatnie i pierwsze kliknięcie, łańcuch Markowa i Shapley na pięciu kanałach: Rysunek 3
R
# Przepis 4. Pięć kanałów: ostatnie kliknięcie, pierwsze kliknięcie, łańcuch Markowa (efekt usunięcia)
# i wartość Shapleya na tych samych ścieżkach. Rysunek 3.
# Korzysta z obiektów przepisów 1–3: dane, kanaly, koalicje, klucz, shapley, kol, motyw. Niczego nie losuje.
k5 <- names(kanaly)

# Wartość Shapleya: zapisy ze ścieżek o zbiorze S dzielimy między kanały z S w proporcji φ_i(S) / v(S),
# gdzie φ liczymy w grze ograniczonej do podzbiorów S (v = odsetek zapisów; zbiory bez ścieżek mają v = 0)
atrybucja_shapley <- function(koal) {
  v <- function(s) { if (length(s) == 0) return(0); k <- match(klucz(s), koal$zbior)
                     if (is.na(k) || koal$n[k] == 0) 0 else koal$zapisy[k] / koal$n[k] }
  wynik <- setNames(numeric(5), k5)
  for (j in which(koal$zapisy > 0)) {
    gracze <- strsplit(koal$zbior[j], "+", fixed = TRUE)[[1]]
    phi <- shapley(gracze, v)
    wynik[gracze] <- wynik[gracze] + koal$zapisy[j] * phi / sum(phi)
  }
  wynik
}
shap <- atrybucja_shapley(koalicje)
# Czy w którejś koalicji kanał ma ujemny wkład (dołączenie kanału obniża v)?
min_phi <- min(sapply(koalicje$zbior, function(s) min(shapley(strsplit(s, "+", fixed = TRUE)[[1]], v_dane))))
c(najmniejszy_wklad_pp = round(100 * min_phi, 2))

# Reguły: ostatnie i pierwsze kliknięcie
kroki <- strsplit(dane$sciezka, " > ", fixed = TRUE)
ostatni <- sapply(kroki, function(s) s[length(s)]); pierwszy <- sapply(kroki, `[`, 1)
ostatnie <- table(factor(ostatni[dane$zapis == 1], levels = k5))
pierwsze <- table(factor(pierwszy[dane$zapis == 1], levels = k5))

# Łańcuch Markowa pierwszego rzędu: przejścia start → kanał → … → zapis / brak zapisu
stany <- c("start", k5, "zapis", "brak")
przejscia <- do.call(rbind, lapply(seq_along(kroki), function(i) {
  s <- c("start", kroki[[i]], if (dane$zapis[i] == 1) "zapis" else "brak")
  data.frame(osoba = i, z = s[-length(s)], do = s[-1])
}))
przejscia$z <- factor(przejscia$z, levels = stany); przejscia$do <- factor(przejscia$do, levels = stany)
macierz_P <- function(wagi_osob) {                     # macierz przejść z (ważonych) zliczeń
  L <- tapply(wagi_osob[przejscia$osoba], list(przejscia$z, przejscia$do), sum)
  L[is.na(L)] <- 0
  L[c("zapis", "brak"), ] <- 0; L["zapis", "zapis"] <- 1; L["brak", "brak"] <- 1
  L / rowSums(L)
}
p_zapisu <- function(P) {                              # szansa dojścia ze startu do zapisu (stany pochłaniające)
  tr <- c("start", k5)
  solve(diag(length(tr)) - P[tr, tr], P[tr, "zapis"])[["start"]]
}
usun <- function(P, k) { P[, "brak"] <- P[, "brak"] + P[, k]; P[, k] <- 0; P }   # kanał znika: ścieżka się urywa
atrybucja_markow <- function(P, zapisy) {
  p0 <- p_zapisu(P)
  efekt <- 1 - sapply(k5, function(k) p_zapisu(usun(P, k))) / p0
  list(p0 = p0, efekt = efekt, zapisy = zapisy * efekt / sum(efekt))
}
P <- macierz_P(rep(1, nrow(dane)))
mark <- atrybucja_markow(P, sum(dane$zapis))
round(P[c("start", k5), ], 3)
round(c(p_zapisu_z_macierzy = mark$p0, odsetek_w_danych = mean(dane$zapis), suma_efektow = sum(mark$efekt)), 4)
round(mark$efekt, 3)

porownanie <- rbind("Ostatnie kliknięcie" = as.numeric(ostatnie), "Pierwsze kliknięcie" = as.numeric(pierwsze),
                    "Łańcuch Markowa" = mark$zapisy, "Wartość Shapleya" = shap)
colnames(porownanie) <- k5
round(cbind(porownanie, suma = rowSums(porownanie)), 1)
round(100 * porownanie / rowSums(porownanie), 1)        # udziały w zapisach (%)

dl <- data.frame(metoda = factor(rep(rownames(porownanie), 5), levels = rownames(porownanie)),
                 kanal = factor(rep(kanaly, each = 4), levels = rev(kanaly)), zapisy = as.vector(porownanie))
p3 <- ggplot(dl, aes(zapisy, kanal, fill = metoda)) +
  geom_col(position = position_dodge2(width = 0.85, reverse = TRUE), width = 0.85) +
  geom_text(aes(label = round(zapisy), x = zapisy + 8), position = position_dodge2(width = 0.85, reverse = TRUE),
            hjust = 0, size = 3.1, colour = "grey15") +
  scale_fill_manual(values = kol[rownames(porownanie)], name = NULL) +
  scale_x_continuous(limits = c(0, 940), expand = expansion(mult = c(0, 0.02))) +
  labs(x = sprintf("Zapisy przypisane kanałowi (razem %d zapisów)", sum(dane$zapis)), y = NULL,
       title = "Te same ścieżki, cztery podziały zapisów") +
  guides(fill = guide_legend(nrow = 1)) +
  motyw + theme(panel.grid.major.y = element_blank())
p3   # zapis: ggsave("atrybucja-shapley-porownanie-metod.svg", p3, width = 10, height = 6.4)
Wynik w R
najmniejszy_wklad_pp
                1.77
      start     W     S     E     P     B zapis  brak
start     0 0.178 0.511 0.195 0.061 0.055 0.000 0.000
W         0 0.239 0.106 0.089 0.024 0.131 0.069 0.344
S         0 0.181 0.268 0.130 0.039 0.086 0.026 0.269
E         0 0.121 0.142 0.209 0.023 0.101 0.051 0.354
P         0 0.158 0.166 0.101 0.229 0.085 0.044 0.217
B         0 0.116 0.038 0.081 0.013 0.251 0.110 0.391
p_zapisu_z_macierzy    odsetek_w_danych        suma_efektow
             0.1456              0.1456              1.9198
    W     S     E     P     B
0.484 0.561 0.374 0.138 0.363
                        W     S     E     P     B suma
Ostatnie kliknięcie 507.0 281.0 312.0  86.0 489.0 1675
Pierwsze kliknięcie 283.0 848.0 297.0 164.0  83.0 1675
Łańcuch Markowa     422.0 489.6 326.3 120.5 316.6 1675
Wartość Shapleya    469.9 516.2 227.5 164.8 296.7 1675
                       W    S    E   P    B
Ostatnie kliknięcie 30.3 16.8 18.6 5.1 29.2
Pierwsze kliknięcie 16.9 50.6 17.7 9.8  5.0
Łańcuch Markowa     25.2 29.2 19.5 7.2 18.9
Wartość Shapleya    28.1 30.8 13.6 9.8 17.7
5. Bootstrap ścieżek: przedziały dla udziałów: Rysunek 4
R
# Przepis 5. Niepewność udziałów: bootstrap ścieżek (osób), 1000 powtórzeń. Rysunek 4.
# Korzysta z obiektów przepisów 1–4: dane, kanaly, k5, atrybucja_shapley, macierz_P, atrybucja_markow, kol, motyw.
set.seed(7341)
B <- 1000
n <- nrow(dane)
zbiory_f <- factor(dane$zbior)
boot <- replicate(B, {
  w <- tabulate(sample.int(n, n, replace = TRUE), n)        # ile razy każda osoba trafiła do próby
  koal <- data.frame(zbior = levels(zbiory_f), n = as.numeric(tapply(w, zbiory_f, sum)),
                     zapisy = as.numeric(tapply(w * dane$zapis, zbiory_f, sum)))
  zap <- sum(w * dane$zapis)
  c(atrybucja_shapley(koal) / zap, atrybucja_markow(macierz_P(w), zap)$zapisy / zap)
})
rownames(boot) <- c(paste0("Shapley_", k5), paste0("Markow_", k5))
udzialy <- data.frame(metoda = rep(c("Wartość Shapleya", "Łańcuch Markowa"), each = 5), kanal = rep(k5, 2),
                      udzial = c(shap, mark$zapisy) / sum(dane$zapis),
                      dolna = apply(boot, 1, quantile, 0.025), gorna = apply(boot, 1, quantile, 0.975))
udzialy$szerokosc_pp <- 100 * (udzialy$gorna - udzialy$dolna)
print(transform(udzialy, udzial = round(100 * udzial, 1), dolna = round(100 * dolna, 1), gorna = round(100 * gorna, 1),
                szerokosc_pp = round(szerokosc_pp, 1)), row.names = FALSE)
# Jak często w próbach bootstrapowych serwis społecznościowy wyprzedza wyszukiwarkę?
round(c(Shapley_S_przed_W_proc = 100 * mean(boot["Shapley_S", ] > boot["Shapley_W", ]),
        Markow_S_przed_W_proc = 100 * mean(boot["Markow_S", ] > boot["Markow_W", ])), 1)
# Jaka część zapisów przypisanych poleceniu (P) pochodzi ze zbiorów rzadkich (n < 100)?
rzadkie_koal <- koalicje[koalicje$n < 100, ]
round(c(P_z_rzadkich_proc = 100 * atrybucja_shapley(rzadkie_koal)[["P"]] / shap[["P"]]), 1)

udzialy$metoda <- factor(udzialy$metoda, levels = c("Łańcuch Markowa", "Wartość Shapleya"))
udzialy$kanal <- factor(kanaly[udzialy$kanal], levels = rev(kanaly))
p4 <- ggplot(udzialy, aes(udzial, kanal, colour = metoda, shape = metoda)) +
  geom_pointrange(aes(xmin = dolna, xmax = gorna), position = position_dodge(width = 0.55), size = 0.55, linewidth = 1) +
  geom_text(aes(label = sprintf("%.1f%%", 100 * udzial), x = gorna + 0.006), position = position_dodge(width = 0.55),
            hjust = 0, size = 3.2, show.legend = FALSE) +
  scale_colour_manual(values = kol[c("Łańcuch Markowa", "Wartość Shapleya")], name = NULL) +
  scale_shape_manual(values = c("Łańcuch Markowa" = 15, "Wartość Shapleya" = 16), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.36)) +
  labs(x = "Udział w zapisach (95% przedział percentylowy z 1000 prób bootstrapowych)", y = NULL,
       title = "Udziały kanałów z niepewnością") +
  motyw + theme(panel.grid.major.y = element_blank())
p4   # zapis: ggsave("atrybucja-shapley-bootstrap.svg", p4, width = 10, height = 5.6)
Wynik w R
           metoda kanal udzial dolna gorna szerokosc_pp
 Wartość Shapleya     W   28.1  25.1  31.2          6.0
 Wartość Shapleya     S   30.8  27.8  33.9          6.1
 Wartość Shapleya     E   13.6  11.2  15.9          4.6
 Wartość Shapleya     P    9.8   8.0  11.8          3.8
 Wartość Shapleya     B   17.7  15.2  20.4          5.2
  Łańcuch Markowa     W   25.2  24.3  26.0          1.7
  Łańcuch Markowa     S   29.2  28.4  30.0          1.5
  Łańcuch Markowa     E   19.5  18.7  20.3          1.7
  Łańcuch Markowa     P    7.2   6.6   7.8          1.2
  Łańcuch Markowa     B   18.9  18.0  19.8          1.8
Shapley_S_przed_W_proc  Markow_S_przed_W_proc
                  85.8                  100.0
P_z_rzadkich_proc
             60.9
6. Pułapka: atrybucja a prawdziwy przyrost zapisów: Rysunek 5
R
# Przepis 6. Pułapka: atrybucja to nie przyczynowość. Prawdziwy przyrost zapisów z symulacji. Rysunek 5.
# Korzysta z obiektów przepisów 1–4: osoby, kontakt, logit_zapisu, kanaly, k5, porownanie, kol, motyw.
# Niczego nie losuje: dla tych samych osób z tym samym „losem” u wyłączamy jeden kanał i liczymy zapisy.
zapisy_wszystkie <- sum(osoby$zapis)
przyrost <- sapply(k5, function(k) {
  bez <- kontakt; bez[, k] <- 0
  zapisy_wszystkie - sum(osoby$u < plogis(logit_zapisu(bez)))
})
bez_zadnego <- sum(osoby$u < plogis(logit_zapisu(kontakt * 0)))
c(zapisy_wszystkie = zapisy_wszystkie, zapisy_bez_zadnego_kanalu = bez_zadnego,
  suma_przyrostow = sum(przyrost))
round(rbind(porownanie[c("Ostatnie kliknięcie", "Wartość Shapleya"), ], "Prawdziwy przyrost" = przyrost), 1)
# Zapisy przypisane przez Shapleya na jeden „prawdziwy” dodatkowy zapis
round(porownanie["Wartość Shapleya", ] / przyrost, 2)

dp <- data.frame(metoda = factor(rep(c("Ostatnie kliknięcie", "Wartość Shapleya", "Prawdziwy przyrost"), 5),
                                 levels = c("Ostatnie kliknięcie", "Wartość Shapleya", "Prawdziwy przyrost")),
                 kanal = factor(rep(kanaly, each = 3), levels = rev(kanaly)),
                 zapisy = as.vector(rbind(porownanie[c("Ostatnie kliknięcie", "Wartość Shapleya"), ], przyrost)))
p5 <- ggplot(dp, aes(zapisy, kanal, fill = metoda)) +
  geom_col(position = position_dodge2(width = 0.8, reverse = TRUE), width = 0.8) +
  geom_text(aes(label = round(zapisy), x = zapisy + 8), position = position_dodge2(width = 0.8, reverse = TRUE),
            hjust = 0, size = 3.2, colour = "grey15") +
  scale_fill_manual(values = kol[levels(dp$metoda)], name = NULL) +
  scale_x_continuous(limits = c(0, 600), expand = expansion(mult = c(0, 0.02))) +
  labs(x = "Zapisy", y = NULL, title = "Atrybucja a zapisy, których bez kanału by nie było",
       subtitle = "Prawdziwy przyrost: te same osoby, ten sam los, jeden kanał wyłączony\n(znany tylko w symulacji)") +
  guides(fill = guide_legend(nrow = 1)) +
  motyw + theme(panel.grid.major.y = element_blank())
p5   # zapis: ggsave("atrybucja-shapley-przyczynowosc.svg", p5, width = 10, height = 6)
Wynik w R
         zapisy_wszystkie zapisy_bez_zadnego_kanalu           suma_przyrostow
                     1760                       938                      1049
                        W     S     E     P     B
Ostatnie kliknięcie 507.0 281.0 312.0  86.0 489.0
Wartość Shapleya    469.9 516.2 227.5 164.8 296.7
Prawdziwy przyrost  266.0 421.0 143.0 167.0  52.0
   W    S    E    P    B
1.77 1.23 1.59 0.99 5.70
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Kontrola palety: symulacja zaburzeń widzenia barw (odległość barw ΔE w CIELAB)
library(colorspace)
pary <- list("ostatnie – pierwsze kliknięcie" = c("#E69F00", "#56B4E9"),
             "Markow – Shapley" = c("#009E73", "#D55E00"),
             "Shapley – prawdziwy przyrost" = c("#D55E00", "#000000"),
             "ścieżki częste – rzadkie" = c("#0072B2", "#CC79A7"),
             "wyszukiwarka – e-mail (grafika)" = c("#0072B2", "#009E73"),
             "serwis – e-mail (grafika)" = c("#D55E00", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) { lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2)) }
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
ostatnie – pierwsze kliknięcie             113.1        111.4      101.5
Markow – Shapley                           102.4         53.5       37.3
Shapley – prawdziwy przyrost                93.9         85.4       71.8
ścieżki częste – rzadkie                    53.6         42.0       22.5
wyszukiwarka – e-mail (grafika)             70.1         55.4       58.0
serwis – e-mail (grafika)                  102.4         53.5       37.3
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, przedziały Wilsona, wartość Shapleya, macierz przejść łańcucha Markowa (solve) i bootstrap – funkcje podstawowej instalacji R (pakiety base i stats). Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Atrybucja to nie przyczynowość. Wizyta bezpośrednia dostała 297 zapisów przy prawdziwym przyroście 52. Nie poprawi tego żadna formuła podziału, tylko eksperyment.
- Rzadkie kombinacje kanałów. Przy pięciu kanałach jest 31 zbiorów, przy dziesięciu – 1023. W przykładzie 12 zbiorów miało mniej niż 100 ścieżek, a z nich pochodzi 60.9% zapisów przypisanych poleceniom. Podawaj przedziały z bootstrapu, a przy wielu kanałach łącz rzadkie kanały w grupę „inne”.
- Zbiory bez ścieżek. Dla zbioru nieobecnego w danych przyjęliśmy v = 0 (tu wystąpiły wszystkie 31). Napisz w pracy, jak traktujesz puste zbiory.
- Tylko ścieżki z konwersją. Wartość koalicji to odsetek, więc potrzebne są też ścieżki bez zapisu; dane tylko o ścieżkach z zapisem to błąd selekcji.
- Interakcja kanałów. W danych ukryliśmy dodatkowy efekt wyszukiwarki z serwisem (efekt interakcji). Wartość Shapleya dzieli taki wspólny przyrost po równo między oba kanały – to umowa, nie odkrycie.
- Kolejność i liczba kontaktów. Prosta wartość koalicji ignoruje kolejność i liczbę wizyt; gdy kolejność jest ważna, porównaj wynik z łańcuchem Markowa.
- Mylenie z wartościami SHAP. Ta sama reguła z teorii gier służy do wyjaśniania modeli predykcyjnych (SHAP); tam graczami są cechy, a wartością – prognoza modelu.
Najczęstsze pytania
Co to jest atrybucja wartością Shapleya?
To podział konwersji między kanały marketingowe regułą z teorii gier kooperacyjnych. Kanały są „graczami”, a wartością koalicji jest np. odsetek konwersji ścieżek z danym zbiorem kanałów. Każdy kanał dostaje średni przyrost tej wartości po dołączeniu do koalicji, uśredniony po wszystkich kolejnościach dołączania; udziały sumują się do 100%.
Jak policzyć wartość Shapleya dla trzech kanałów?
Wypisz wartości wszystkich koalicji: trzech pojedynczych kanałów, trzech par i całej trójki. Dla każdej z sześciu kolejności dołączania policz przyrost wartości, jaki daje każdy kanał, i uśrednij. W przykładzie szkoły językowej wyszło: wyszukiwarka 10.75 pp, serwis społecznościowy 8.48 pp, e-mail 6.78 pp – razem 26.01%, czyli dokładnie odsetek zapisów ścieżek z wszystkimi trzema kanałami.
Czym różni się wartość Shapleya od łańcucha Markowa w atrybucji?
Łańcuch Markowa patrzy na kolejność kontaktów i pyta, o ile spadłaby szansa konwersji po usunięciu kanału ze ścieżek. Wartość Shapleya patrzy na zbiory kanałów i ich odsetki konwersji, bez kolejności. W przykładzie oba podziały były zbliżone dla wyszukiwarki i serwisu, ale e-mail dostał 19.5% od Markowa i 13.6% od Shapleya. Przedziały z bootstrapu były u Markowa węższe, bo model łączy informację ze wszystkich ścieżek.
Czy atrybucja pokazuje, ile sprzedaży dał kanał?
Nie. Atrybucja dzieli zaobserwowane konwersje między kanały na ścieżkach, a nie mierzy, ile konwersji by nie było bez kanału. Kanały, przez które przechodzą osoby już zdecydowane, dostają za dużo. Przyrost mierzy się eksperymentem, np. testem z grupą wyłączoną z reklamy albo testem w regionach.
Ile ścieżek potrzeba do atrybucji wartością Shapleya?
Tyle, żeby każda koalicja kanałów, która ma znaczenie, miała co najmniej kilkadziesiąt–sto ścieżek. Przy pięciu kanałach jest 31 koalicji i rzadkie kombinacje mają szerokie przedziały. W przykładzie 12 koalicji miało mniej niż 100 ścieżek, a pochodziło z nich 60.9% zapisów przypisanych poleceniom – dlatego podawaj przedziały z bootstrapu.
Powiązane hasła
Przeczytaj też
Atrybucja kanałów: łańcuch Markowa
Ścieżki klientów biura podróży, graf przejść, efekt usunięcia i porównanie z ostatnim kliknięciem oraz z prawdziwym wpływem – z kodem R.
Czytaj →PoradnikTest wyłączenia reklamy (holdout)
Sklep z odzieżą: przyrost sprzedaży z holdoutu, ITT i CACE, iCPA wobec CPA z panelu, duże zamówienia i wielkość holdoutu – kod R.
Czytaj →PoradnikInterpretacja modelu: ważność, PDP, ICE i SHAP
Wypożyczalnia aut, 8000 rezerwacji: ważność permutacyjna, PDP i ICE, dokładne SHAP jako karta wyjaśnienia, skorelowane cechy i przyczynowość – pięć rysunków z kodem R.
Czytaj →Analizujesz ścieżki klientów albo atrybucję kanałów w pracy?
Pomożemy przygotować dane o ścieżkach, policzyć atrybucję wartością Shapleya i łańcuchem Markowa z przedziałami z bootstrapu i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Anderl, E., Becker, I., von Wangenheim, F., & Schumann, J. H. (2016). Mapping the customer journey: Lessons learned from graph-based online attribution modeling. International Journal of Research in Marketing, 33(3), 457–474. https://doi.org/10.1016/j.ijresmar.2016.03.001 ● Otwarty dostęp: pełny tekst
- Berman, R. (2018). Beyond the last touch: Attribution in online advertising. Marketing Science, 37(5), 771–792. https://doi.org/10.1287/mksc.2018.1104 ● Otwarty dostęp: pełny tekst
- Blake, T., Nosko, C., & Tadelis, S. (2015). Consumer heterogeneity and paid search effectiveness: A large-scale field experiment. Econometrica, 83(1), 155–174. https://doi.org/10.3982/ecta12423 ● Otwarty dostęp: pełny tekst
- Dalessandro, B., Perlich, C., Stitelman, O., & Provost, F. (2012). Causally motivated attribution for online advertising. In Proceedings of the Sixth International Workshop on Data Mining for Online Advertising and Internet Economy (pp. 1–9). ACM. https://doi.org/10.1145/2351356.2351363
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Shao, X., & Li, L. (2011). Data-driven multi-touch attribution models. In Proceedings of the 17th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 258–264). ACM. https://doi.org/10.1145/2020408.2020453
- Singal, R., Besbes, O., Desir, A., Goyal, V., & Iyengar, G. (2022). Shapley meets uniform: An axiomatic framework for attribution in online advertising. Management Science, 68(10), 7457–7479. https://doi.org/10.1287/mnsc.2021.4263 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{anderl2016mapping, author={Anderl, Eva and Becker, Ingo and von Wangenheim, Florian and Schumann, Jan Hendrik}, title={{Mapping the customer journey: Lessons learned from graph-based online attribution modeling}}, journal={International Journal of Research in Marketing}, year={2016}, volume={33}, number={3}, pages={457--474}, doi={10.1016/j.ijresmar.2016.03.001}}@article{berman2018beyond, author={Berman, Ron}, title={{Beyond the last touch: Attribution in online advertising}}, journal={Marketing Science}, year={2018}, volume={37}, number={5}, pages={771--792}, doi={10.1287/mksc.2018.1104}}@article{blake2015consumer, author={Blake, Thomas and Nosko, Chris and Tadelis, Steven}, title={{Consumer heterogeneity and paid search effectiveness: A large-scale field experiment}}, journal={Econometrica}, year={2015}, volume={83}, number={1}, pages={155--174}, doi={10.3982/ecta12423}}@inproceedings{dalessandro2012causally, author={Dalessandro, Brian and Perlich, Claudia and Stitelman, Ori and Provost, Foster}, title={{Causally motivated attribution for online advertising}}, booktitle={Proceedings of the Sixth International Workshop on Data Mining for Online Advertising and Internet Economy}, year={2012}, pages={1--9}, publisher={ACM}, doi={10.1145/2351356.2351363}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@inproceedings{shao2011data, author={Shao, Xuhui and Li, Lexin}, title={{Data-driven multi-touch attribution models}}, booktitle={Proceedings of the 17th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining}, year={2011}, pages={258--264}, publisher={ACM}, doi={10.1145/2020408.2020453}}@article{singal2022shapley, author={Singal, Raghav and Besbes, Omar and Desir, Antoine and Goyal, Vineet and Iyengar, Garud}, title={{Shapley meets uniform: An axiomatic framework for attribution in online advertising}}, journal={Management Science}, year={2022}, volume={68}, number={10}, pages={7457--7479}, doi={10.1287/mnsc.2021.4263}}