Przykład: biuro podróży i pytanie „który kanał sprzedaje wyjazdy?”
Fikcyjne biuro podróży online sprzedaje wyjazdy weekendowe. Klienci trafiają na stronę z czterech źródeł: reklamy w mediach społecznościowych (na rysunkach „social”), newslettera (e-mail), reklamy w wyszukiwarce i wejścia bezpośredniego (wpisany adres, zakładka). System analityczny zapisuje każdą wizytę, więc dla każdej osoby mamy ścieżkę, np. „social → wyszukiwarka → rezerwacja”. Dział marketingu pyta: ile rezerwacji dał każdy kanał i gdzie przesunąć budżet? To pytanie o atrybucję, czyli podział zasługi za konwersję między kontakty klienta z marką (Shao i Li, 2011). Inne typowe projekty z marketingu opisuje wpis statystyka w pracy z marketingu, a dane o koszykach – analiza koszykowa i systemy rekomendacyjne.
Dane są fikcyjne, więc znamy prawdę. Symulujemy 12 000 osób w oknie 21 dni. 10% to osoby „zdecydowane”: i tak planują rezerwację, częściej same szukają biura w wyszukiwarce (.80 wobec .25) i częściej wchodzą bezpośrednio. Prawdziwy wpływ kanałów ustaliliśmy ręcznie na skali logitu: reklama social +1.1, newsletter +0.8, wyszukiwarka +0.3, wejście bezpośrednie 0. Reklama social dodatkowo zwiększa szansę późniejszego wyszukania biura (z .25 do .50). W danych zostaje 9233 osób z co najmniej jedną wizytą i 1122 rezerwacje (12.15%), z czego 691 to osoby zdecydowane. Po pierwszym uruchomieniu obniżyliśmy udział zdecydowanych z 15% do 10% i ich bazową szansę rezerwacji z .50 do .45, bo odsetek rezerwacji (16.5%) był nierealnie wysoki. Ziarno 610 ustalono raz i nie zmieniano go. Dane pobierzesz jako atrybucja-sciezki-klientow.csv (kolumny: klient, ścieżka, rezerwacja 0/1 i ukryta kolumna zdecydowany, której w prawdziwych danych nie ma).
Rysunek 1: jak wyglądają ścieżki klientów
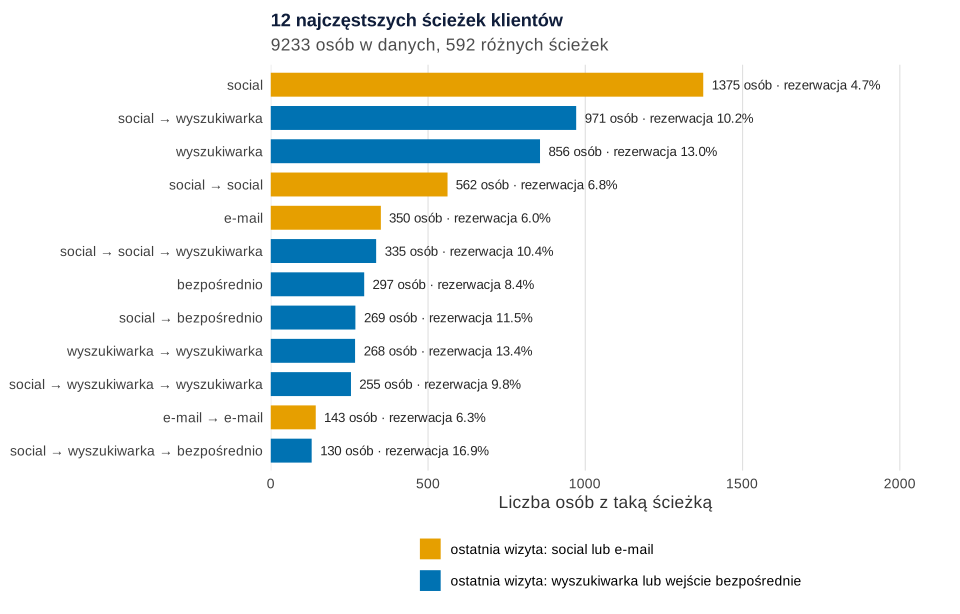
set.seed(610)).Co widać. Ścieżka ma średnio 2.31 wizyty, a różnych ścieżek jest 592. Dwanaście najczęstszych obejmuje 62.9% osób. Najczęstsza jest pojedyncza wizyta z reklamy social (1375 osób), ale tylko 4.7% z nich rezerwuje. Ścieżki kończące się wyszukiwarką lub wejściem bezpośrednim mają wyższy odsetek rezerwacji, np. „social → wyszukiwarka → bezpośrednio” – 16.9%.
Jak może zmylić. Wysoki odsetek rezerwacji po wyszukiwarce kusi, żeby uznać ją za najlepszy kanał. Ale do wyszukiwarki częściej trafiają osoby już zdecydowane. Ścieżki pokazują kolejność wizyt, a nie przyczyny.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: trzy proste reguły podziału
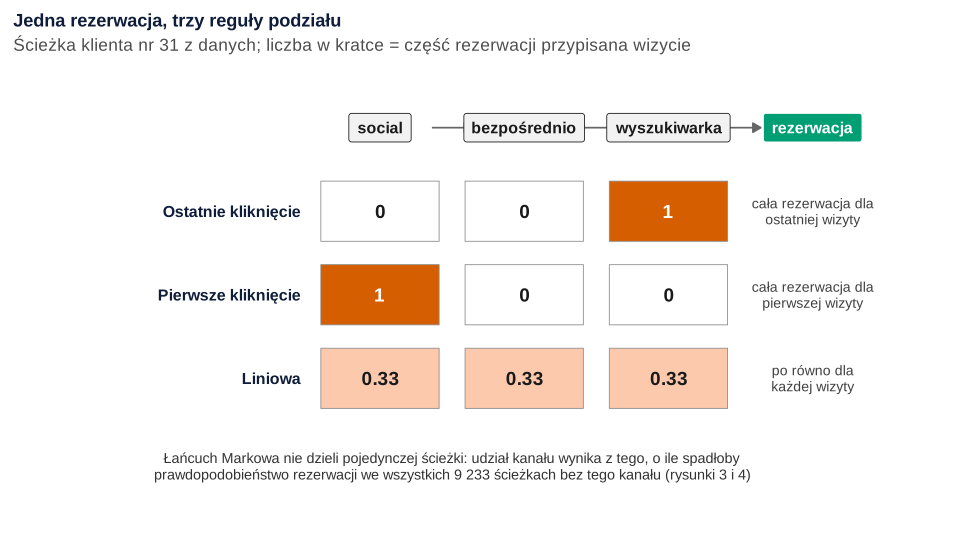
Co widać. Klient nr 31 (pierwsza w danych osoba z rezerwacją i trzema wizytami z trzech różnych kanałów) przyszedł z reklamy social, potem wszedł bezpośrednio, a zarezerwował po wizycie z wyszukiwarki. Ostatnie kliknięcie oddaje całą rezerwację wyszukiwarce, pierwsze kliknięcie – reklamie social, a reguła liniowa dzieli ją po równo. Po zsumowaniu wszystkich 1122 rezerwacji ostatnie kliknięcie daje wyszukiwarce 580, a reklamie social 150. Pierwsze kliknięcie odwraca obraz: social 561, wyszukiwarka 299.
Jak może zmylić. Każda reguła to arbitralna umowa, a nie pomiar. Żadna nie patrzy na ścieżki bez rezerwacji, więc nie wie, czy kanał w ogóle zmienia szansę zakupu.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: ścieżki jako łańcuch Markowa
Każdą ścieżkę rozbijamy na kroki „stan teraz → stan następny”, np. start → social, social → wyszukiwarka, wyszukiwarka → rezerwacja. Ścieżki bez rezerwacji kończą się stanem „brak rezerwacji”. Zliczamy kroki w tabeli i dzielimy przez sumę wiersza. Powstaje macierz przejść łańcucha Markowa: szansa następnego kroku zależy tylko od obecnego kanału.
nij to liczba przejść z kanału i do stanu j, a ni – wszystkie kroki z kanału i. Anderl i in. (2016) zastosowali takie łańcuchy pierwszego i wyższych rzędów do ścieżek klientów z czterech branż i otrzymali udziały kanałów wyraźnie inne niż przy ostatnim kliknięciu.
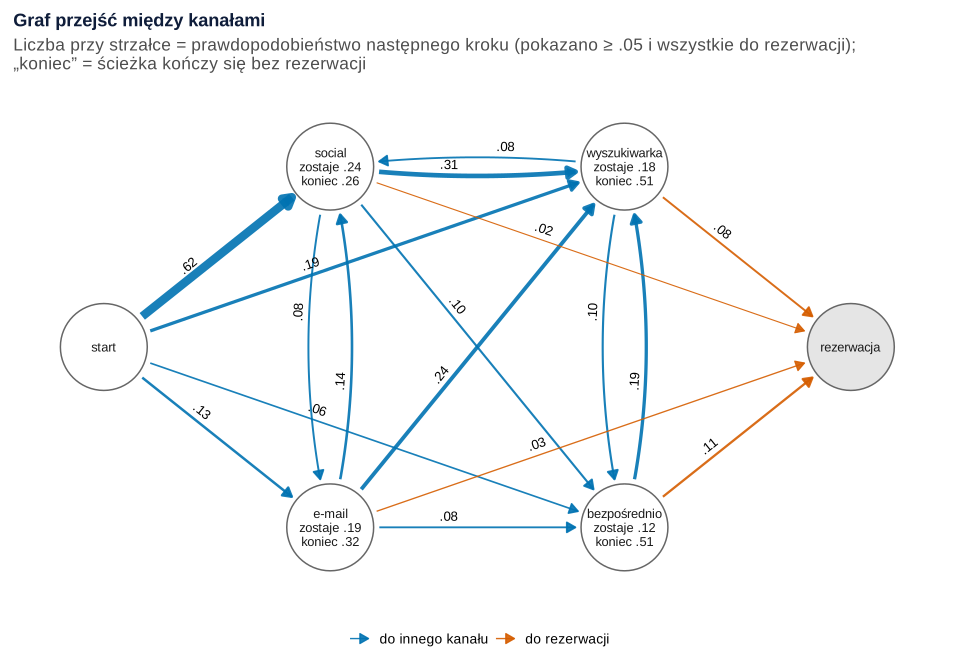
Co widać. 61.9% ścieżek zaczyna się od reklamy social. Z social najczęściej idzie się do wyszukiwarki (.305), a rzadko wprost do rezerwacji (.017). Z wyszukiwarki rezerwacja ma szansę .084, z wejścia bezpośredniego .112. Tego, że social „prowadzi” do wyszukiwarki, nie widzi żadna z reguł z rysunku 2. Z macierzy liczymy szansę dojścia od startu do rezerwacji (Norris, 1997, pokazuje, że takie wielkości łańcucha da się policzyć wprost): .1215, dokładnie tyle co w danych.
Jak może zmylić. Łańcuch pierwszego rzędu „zapomina” wcześniejsze kroki: osoba po social → wyszukiwarka ma tę samą szansę rezerwacji co osoba, która zaczęła od wyszukiwarki. Strzałki to częstości przejść, nie wpływ. Graf nie pokazuje też liczebności – rzadkie przejścia mają szerokie przedziały.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: efekt usunięcia – co by było bez kanału?
Atrybucja Markowa zadaje pytanie: o ile spadłaby szansa rezerwacji, gdyby kanał zniknął? „Zniknięcie” robimy w macierzy: każde przejście do kanału k kieruje do stanu „brak rezerwacji” i liczymy szansę rezerwacji od nowa (Anderl i in., 2016).
Efekty usunięcia sumują się do więcej niż 1, bo ta sama rezerwacja „wisi” na kilku kanałach. Dlatego dzielimy każdy przez ich sumę i mnożymy przez liczbę rezerwacji.
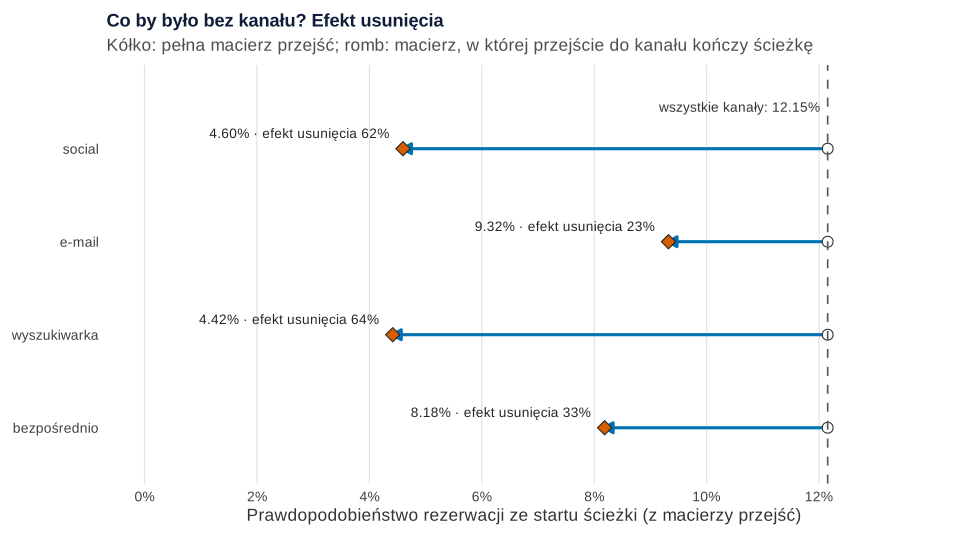
Co widać. Bez reklamy social szansa rezerwacji spada z 12.15% do 4.60% (efekt usunięcia .622), bez wyszukiwarki – do 4.42% (.637). Newsletter ma efekt .233, wejście bezpośrednie .327. Suma efektów wynosi 1.818. Po normalizacji łańcuch Markowa przypisuje 384 rezerwacje reklamie social, 144 newsletterowi, 393 wyszukiwarce i 202 wejściu bezpośredniemu. Reklama social dostaje ponad dwa razy więcej niż przy ostatnim kliknięciu, bo model widzi, że wiele ścieżek do rezerwacji przez nią przechodzi.
Jak może zmylić. Usunięcie kanału w macierzy zakłada, że osoby, które by do niego trafiły, odchodzą bez rezerwacji. Nie przechodzą do innego kanału i nie kupują „i tak”. To założenie, nie wynik.
Podpis do pracy:
Zdanie do Wyników:
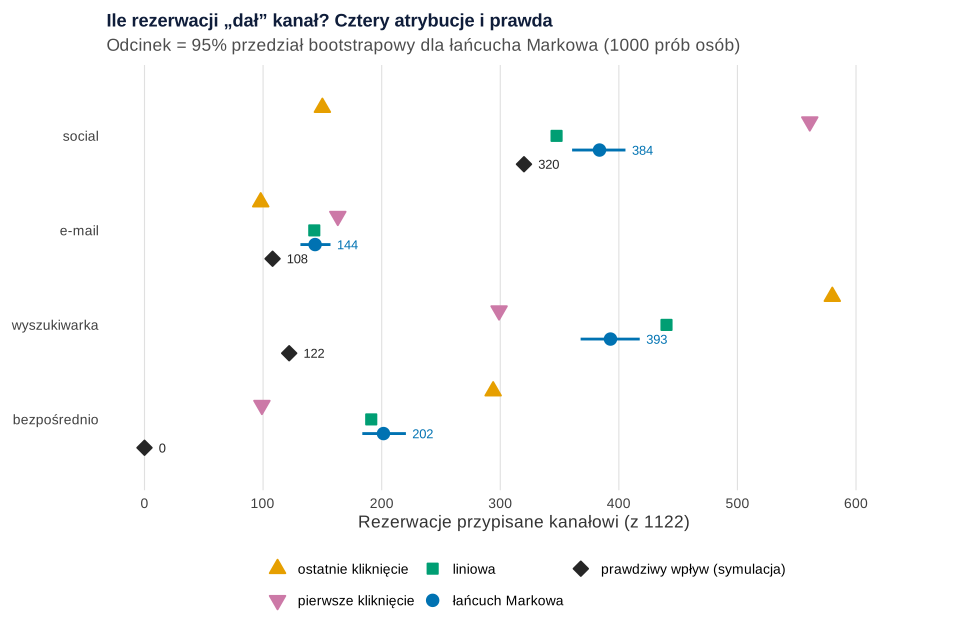
Rysunek 5: cztery atrybucje i prawdziwy wpływ
W symulacji możemy zrobić to, czego nie da się zrobić w prawdziwych danych: wyłączyć kanał dla tych samych osób z tymi samymi losami i policzyć rezerwacje, których by nie było. To porównanie wyników potencjalnych – świata z kanałem i bez niego. Niepewność atrybucji Markowa oceniamy bootstrapem osób (1000 prób).
set.seed(610)).| Metoda | social | wyszukiwarka | bezpośrednio | |
|---|---|---|---|---|
| ostatnie kliknięcie | 150 | 98 | 580 | 294 |
| pierwsze kliknięcie | 561 | 163 | 299 | 99 |
| liniowa | 347 | 143 | 440 | 191 |
| łańcuch Markowa [95% CI] | 384 [361, 406] | 144 [131, 157] | 393 [368, 418] | 202 [184, 220] |
| prawdziwy wpływ (symulacja) | 320 | 108 | 122 | 0 |
Co widać. Dla reklamy social łańcuch Markowa (384) jest bliżej prawdy (320) niż ostatnie kliknięcie (150). Dla wyszukiwarki i wejścia bezpośredniego wszystkie metody mocno przeszacowują: wyszukiwarka naprawdę dodała 122 rezerwacje, a dostaje od 299 do 580. Wejście bezpośrednie nie dodało żadnej, a dostaje od 99 do 294. Atrybucja zawsze rozdziela wszystkie 1122 rezerwacje, a bez reklamy social, newslettera i wyszukiwarki zostałoby 724 z 1190 rezerwacji w całej grupie 12 000 osób.
Jak może zmylić. Przedział bootstrapowy mówi tylko, jak bardzo wynik zależy od losu próby. Nie mówi, czy metoda mierzy właściwą rzecz – wąski przedział wokół 393 dla wyszukiwarki jest daleko od prawdziwych 122.
Podpis do pracy:
Zdanie do Wyników:
Atrybucja to nie efekt przyczynowy
Skąd ten rozjazd? 691 z 1122 rezerwacji to osoby zdecydowane, które i tak szukały biura w wyszukiwarce i wchodziły bezpośrednio. Kanał obecny na ścieżkach takich osób zbiera zasługę, choć niczego nie zmienił. Zamiar zakupu działa tu jak zmienna zakłócająca: wpływa i na to, którędy klient idzie, i na rezerwację. To klasyczny przypadek, że korelacja to nie przyczynowość.
Tak bywa w prawdziwych danych. W dużych eksperymentach terenowych z płatną reklamą w wyszukiwarce zwrot okazał się ułamkiem oszacowań nieeksperymentalnych, bo kliknięcia w reklamę są skorelowane z zamiarem zakupu. Reklamy na hasła z nazwą marki nie dawały mierzalnych korzyści (Blake i in., 2015). Dalessandro i in. (2012) proponują więc traktować atrybucję jako problem estymacji przyczynowej. Gdy założenia przyczynowe nie są spełnione, udziały kanałów są tylko miarą ważności zmiennych. Li i Kannan (2014) szacują przyrostowy wpływ kanałów modelem na danych indywidualnych i sprawdzają go eksperymentem terenowym.
Obok efektu usunięcia popularna jest wartość Shapleya z teorii gier kooperacyjnych. Dzieli konwersje według średniego wkładu kanału we wszystkie możliwe „koalicje” kanałów. To inny sposób podziału tej samej obserwacyjnej informacji – nie usuwa problemu osób zdecydowanych. Do pomiaru przyrostu potrzebny jest eksperyment: losowe wstrzymanie reklamy części osób (test A/B, grupa kontrolna), kampania w jednym regionie z syntetyczną kontrolą albo model na danych tygodniowych, czyli marketing mix modeling. Kontrolowany eksperyment najlepiej ustala, czy zmiana wpływa na zachowanie użytkowników (Kohavi i in., 2009).
Co z tym zrobić w marketingu
- Nie tnij reklamy social na podstawie ostatniego kliknięcia. Ostatnie kliknięcie dało jej 150 rezerwacji, prawda to 320. Social „otwiera” ścieżki, które kończą się w wyszukiwarce.
- Sprawdź reklamę w wyszukiwarce eksperymentem. Wstrzymaj ją na losowej części dni albo regionów. W naszych danych przyrost (122) był wielokrotnie mniejszy niż przypisane rezerwacje.
- Nie licz wejścia bezpośredniego jako kanału do inwestycji. To zwykle skutek wcześniejszego zamiaru albo innych kontaktów.
- Newsletter: mały, ale prawdziwy wpływ (108). Wysyłkę testuj na losowej grupie kontrolnej subskrybentów – efekt i jego zmienność między klientami opisuje wpis modelowanie uplift.
- Atrybucję Markowa traktuj jako mapę ścieżek i źródło hipotez do testów, nie jako rachunek zwrotu z budżetu. Gdzie klienci odpadają na stronie, pokaże lejek konwersji.
Jak opisać w pracy
W Metodzie podaj okno czasowe ścieżek, listę kanałów, liczbę osób i rezerwacji, rząd łańcucha i sposób liczenia efektu usunięcia. Podaj też, czy dane obejmują ścieżki bez konwersji. Wynik pokaż w tabeli obok co najmniej jednej reguły heurystycznej, z przedziałami bootstrapowymi. W Ograniczeniach napisz wprost, że atrybucja opisuje ścieżki, a nie przyczynowy wpływ kanałów.
Jeśli Twoja praca porównuje wersje strony albo kampanie w eksperymencie, zajrzyj do wpisów test A/B – plan i analiza i CUPED.
Kod R: ścieżki, macierz przejść i efekt usunięcia w bazowym R
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Macierz przejść, szansę rezerwacji (solve() dla łańcucha pochłaniającego) i efekt usunięcia liczy bazowy R – bez pakietów do atrybucji (na dużych danych to samo robi np. pakiet ChannelAttribution). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane) i 5 (bootstrap); oba zaczynają się od własnego set.seed(610). Ziarno 610 ustalono raz i nie zmieniano go. Ręcznie ustalono: 12 000 osób, udział zdecydowanych 10% (obniżony z 15% po pierwszym uruchomieniu) i subskrybentów 35%, szanse wizyt z kanałów, bazową szansę rezerwacji (.45 dla zdecydowanych – obniżoną z .50 po pierwszym uruchomieniu – i .015 dla pozostałych), wpływ kanałów na skali logitu (+1.1, +0.8, +0.3, 0), okna dni dla kanałów i średnią liczbę dodatkowych wizyt oraz próg .05 dla strzałek na rysunku 3. Całość liczy się w kilka sekund.
1. Paleta, dane i najczęstsze ścieżki: Rysunek 1
R
# Rysunek 1. Fikcyjne biuro podróży online: ścieżki klientów przez kanały marketingowe (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey60", ciemny = "grey15")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

kanaly <- c("social", "e-mail", "wyszukiwarka", "bezpośrednio")   # social = reklama w mediach społecznościowych

set.seed(610)                                  # ziarno ustalone raz, bez dobierania pod wynik
n <- 12000                                     # osoby, które w ciągu 21 dni odwiedziły stronę biura
zdecydowany <- rbinom(n, 1, 0.10) == 1         # ukryta cecha: i tak planuje rezerwację (w prawdziwych danych nieznana)
subskrybent <- rbinom(n, 1, 0.35) == 1         # jest na liście newslettera
# Liczby jednostajne zapisane raz – posłużą też do świata „bez kanału” (te same osoby, te same losy)
u <- matrix(runif(n * 5), n, 5, dimnames = list(NULL, c("social", "email", "szukaj", "wprost", "zakup")))

# Kto trafia na stronę z którego kanału (prawdopodobieństwa ustalone ręcznie)
widzi_kanaly <- function(bez = character()) {
  s <- u[, "social"] < ifelse(zdecydowany, 0.35, 0.55)
  e <- subskrybent & u[, "email"] < 0.50
  if ("social" %in% bez) s[] <- FALSE
  if ("e-mail" %in% bez) e[] <- FALSE
  # zdecydowani sami szukają biura w wyszukiwarce; reklama social i e-mail zachęcają innych do szukania
  w <- u[, "szukaj"] < ifelse(zdecydowany, 0.80, 0.25 + 0.25 * s + 0.10 * e)
  d <- u[, "wprost"] < ifelse(zdecydowany, 0.45, 0.10 + 0.10 * s)
  if ("wyszukiwarka" %in% bez) w[] <- FALSE
  if ("bezpośrednio" %in% bez) d[] <- FALSE
  cbind(social = s, `e-mail` = e, wyszukiwarka = w, `bezpośrednio` = d)
}
# Prawdziwy wpływ na rezerwację (skala logitu, ustalony ręcznie): social +1.1, e-mail +0.8, wyszukiwarka +0.3,
# wejście bezpośrednie 0 – to skutek zamiaru, nie kanał, który go wywołuje
p_zakupu <- function(K) plogis(ifelse(zdecydowany, qlogis(0.45), qlogis(0.015)) +
                                 1.1 * K[, "social"] + 0.8 * K[, "e-mail"] + 0.3 * K[, "wyszukiwarka"])
K <- widzi_kanaly()
zakup <- u[, "zakup"] < p_zakupu(K)

# Ścieżka: każdy kanał 1 lub więcej wizyt, wizyty uporządkowane w czasie (dni 0–21; zakresy ustalone ręcznie)
okno <- list(social = c(0, 12), `e-mail` = c(2, 16), wyszukiwarka = c(6, 20), `bezpośrednio` = c(8, 21))
ile_dod <- c(social = 0.4, `e-mail` = 0.4, wyszukiwarka = 0.3, `bezpośrednio` = 0.2)
sciezka <- character(n)
for (i in seq_len(n)) {
  k <- kanaly[K[i, ]]
  if (!length(k)) next
  wiz <- rep(k, 1 + rpois(length(k), ile_dod[k]))
  t <- mapply(function(a) runif(1, okno[[a]][1], okno[[a]][2]), wiz)
  sciezka[i] <- paste(wiz[order(t)], collapse = " > ")
}
obserwowani <- sciezka != ""                     # bez żadnej wizyty – poza danymi
dane <- data.frame(klient = which(obserwowani), sciezka = sciezka[obserwowani], zakup = as.integer(zakup[obserwowani]),
                   zdecydowany = as.integer(zdecydowany[obserwowani]))
write.csv(dane, "atrybucja-sciezki-klientow.csv", row.names = FALSE)
c(osoby = n, w_danych = nrow(dane), zakupy = sum(dane$zakup), odsetek_zakupu = round(100 * mean(dane$zakup), 2),
  zakupy_zdecydowanych = sum(dane$zakup[dane$zdecydowany == 1]),
  wizyt_na_sciezke = round(mean(lengths(strsplit(dane$sciezka, " > "))), 2))

# Najczęstsze ścieżki: liczba osób i odsetek rezerwacji
tab <- aggregate(zakup ~ sciezka, dane, function(z) c(n = length(z), zakupy = sum(z)))
tab <- data.frame(sciezka = tab$sciezka, n = tab$zakup[, "n"], zakupy = tab$zakup[, "zakupy"])
tab <- head(tab[order(-tab$n), ], 12)
tab$odsetek <- tab$zakupy / tab$n
c(rozne_sciezki = length(unique(dane$sciezka)), w_top12 = round(100 * sum(tab$n) / nrow(dane), 1))
print(transform(tab, odsetek = round(100 * odsetek, 1)), row.names = FALSE)

tab$etyk <- factor(gsub(" > ", " → ", tab$sciezka), levels = rev(gsub(" > ", " → ", tab$sciezka)))
tab$typ <- ifelse(grepl("wyszukiwarka|bezpośrednio", sub(".* > ", "", tab$sciezka)),
                  "ostatnia wizyta: wyszukiwarka lub wejście bezpośrednie", "ostatnia wizyta: social lub e-mail")
p1 <- ggplot(tab, aes(n, etyk, fill = typ)) +
  geom_col(width = 0.72) +
  geom_text(aes(label = sprintf("%d osób · rezerwacja %.1f%%", n, 100 * odsetek)), hjust = -0.05, size = 3.5,
            colour = "grey15") +
  scale_fill_manual(values = c("ostatnia wizyta: wyszukiwarka lub wejście bezpośrednie" = kol[["niebieski"]],
                               "ostatnia wizyta: social lub e-mail" = kol[["pomarancz"]]), name = NULL) +
  scale_x_continuous(limits = c(0, 1.55 * max(tab$n)), expand = c(0, 0)) +
  guides(fill = guide_legend(ncol = 1)) +
  labs(x = "Liczba osób z taką ścieżką", y = NULL, title = "12 najczęstszych ścieżek klientów",
       subtitle = sprintf("%d osób w danych, %d różnych ścieżek", nrow(dane), length(unique(dane$sciezka)))) +
  motyw + theme(panel.grid.major.y = element_blank())
p1   # zapis: ggsave("atrybucja-najczestsze-sciezki.svg", p1, width = 10, height = 6.4)
Wynik w R
               osoby             w_danych               zakupy
            12000.00              9233.00              1122.00
      odsetek_zakupu zakupy_zdecydowanych     wizyt_na_sciezke
               12.15               691.00                 2.31
rozne_sciezki       w_top12
        592.0          62.9
                              sciezka    n zakupy odsetek
                               social 1375     64     4.7
                social > wyszukiwarka  971     99    10.2
                         wyszukiwarka  856    111    13.0
                      social > social  562     38     6.8
                               e-mail  350     21     6.0
       social > social > wyszukiwarka  335     35    10.4
                         bezpośrednio  297     25     8.4
                social > bezpośrednio  269     31    11.5
          wyszukiwarka > wyszukiwarka  268     36    13.4
 social > wyszukiwarka > wyszukiwarka  255     25     9.8
                      e-mail > e-mail  143      9     6.3
 social > wyszukiwarka > bezpośrednio  130     22    16.9
2. Reguły heurystyczne i grafika jednej ścieżki: Rysunek 2
R
# Rysunek 2. Jedna ścieżka, trzy reguły: ostatnie kliknięcie, pierwsze kliknięcie, atrybucja liniowa
# Korzysta z obiektów przepisu 1: dane, kanaly, kol, motyw. Niczego nie losuje.
library(ggplot2)

kroki <- strsplit(dane$sciezka, " > ")          # lista wizyt każdej osoby
zak <- dane$zakup == 1
# Reguły heurystyczne dzielą każdą rezerwację między wizyty na jej ścieżce
ostatnie <- table(factor(sapply(kroki[zak], tail, 1), kanaly))
pierwsze <- table(factor(sapply(kroki[zak], `[`, 1), kanaly))
liniowa <- tapply(unlist(lapply(kroki[zak], function(k) rep(1 / length(k), length(k)))),
                  factor(unlist(kroki[zak]), kanaly), sum)
heur <- rbind(ostatnie = as.numeric(ostatnie), pierwsze = as.numeric(pierwsze), liniowa = as.numeric(liniowa))
colnames(heur) <- kanaly
round(cbind(heur, razem = rowSums(heur)), 1)

# Przykład do rysunku: pierwsza w danych osoba z rezerwacją, której ścieżka ma trzy wizyty z trzech różnych kanałów
nr <- which(zak & lengths(kroki) == 3 & sapply(kroki, function(k) length(unique(k))) == 3)[1]
przyklad <- kroki[[nr]]
c(klient = dane$klient[nr], sciezka = paste(przyklad, collapse = " → "))

m <- length(przyklad)
udzial <- rbind(`Ostatnie kliknięcie` = c(rep(0, m - 1), 1), `Pierwsze kliknięcie` = c(1, rep(0, m - 1)),
                `Liniowa` = rep(1 / m, m))
kafle <- data.frame(regula = rep(rownames(udzial), each = m), x = rep(seq_len(m), nrow(udzial)),
                    kanal = rep(przyklad, nrow(udzial)), udzial = as.vector(t(udzial)))
kafle$y <- match(kafle$regula, rownames(udzial))
kafle$etyk <- ifelse(kafle$udzial == 0, "0", ifelse(kafle$udzial == 1, "1", sprintf("%.2f", kafle$udzial)))
gora <- data.frame(x = c(seq_len(m), m + 1), lab = c(przyklad, "rezerwacja"), y = 0)

p2 <- ggplot() +
  # ścieżka klienta (góra)
  geom_segment(data = data.frame(x = 1:m), aes(x = x + 0.36, xend = x + 0.64, y = 0, yend = 0),
               arrow = arrow(length = unit(2.4, "mm"), type = "closed"), colour = "grey40") +
  geom_label(data = gora, aes(x, y, label = lab), size = 4.2, fill = c(rep("grey95", m), kol[["zielony"]]),
             colour = c(rep("grey10", m), "white"), label.padding = unit(0.45, "lines"), fontface = "bold") +
  # kafle udziałów
  geom_tile(data = kafle, aes(x, y, fill = udzial), width = 0.82, height = 0.72, colour = "grey55", linewidth = 0.3) +
  geom_text(data = kafle, aes(x, y, label = etyk, colour = udzial > 0.5), size = 5, fontface = "bold") +
  annotate("text", x = 0.45, y = 1:3, label = rownames(udzial), hjust = 1, size = 4.2, colour = "#0f1d3a",
           fontface = "bold") +
  annotate("text", x = m + 1, y = 1:3, size = 3.7, colour = "grey25", lineheight = 0.95,
           label = c("cała rezerwacja dla\nostatniej wizyty", "cała rezerwacja dla\npierwszej wizyty",
                     "po równo dla\nkażdej wizyty")) +
  annotate("text", x = (m + 1) / 2 - 0.5, y = 4.05, size = 3.8, colour = "grey20", lineheight = 0.95,
           label = paste0("Łańcuch Markowa nie dzieli pojedynczej ścieżki: udział kanału wynika z tego, o ile spadłoby\n",
                          "prawdopodobieństwo rezerwacji we wszystkich ", format(nrow(dane), big.mark = " "),
                          " ścieżkach bez tego kanału (rysunki 3 i 4)")) +
  scale_fill_gradient(low = "white", high = kol[["cynober"]], limits = c(0, 1), guide = "none") +
  scale_colour_manual(values = c(`TRUE` = "white", `FALSE` = "grey10"), guide = "none") +
  scale_y_reverse(limits = c(4.5, -0.5)) + scale_x_continuous(limits = c(-1.25, m + 1.6)) +
  labs(title = "Jedna rezerwacja, trzy reguły podziału",
       subtitle = sprintf("Ścieżka klienta nr %d z danych; liczba w kratce = część rezerwacji przypisana wizycie",
                          dane$klient[nr]), x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p2   # zapis: ggsave("atrybucja-jedna-sciezka-trzy-reguly.svg", p2, width = 10, height = 5.6)
Wynik w R
         social e-mail wyszukiwarka bezpośrednio razem
ostatnie  150.0   98.0        580.0        294.0  1122
pierwsze  561.0  163.0        299.0         99.0  1122
liniowa   347.5  143.2        440.2        191.2  1122
                                klient                                sciezka
                                  "31" "social → bezpośrednio → wyszukiwarka"
3. Macierz przejść i graf: Rysunek 3
R
# Rysunek 3. Ścieżki jako łańcuch Markowa: macierz przejść i graf przejść
# Korzysta z obiektów przepisów 1–2: dane, kroki, kanaly, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(igraph)
library(ggraph)

stany <- c("start", kanaly, "zakup", "brak")
koniec <- ifelse(dane$zakup == 1, "zakup", "brak")
# Każda ścieżka: start → wizyty → zakup albo brak zakupu; zliczamy pary „stan teraz → stan następny”
od <- unlist(lapply(seq_along(kroki), function(i) c("start", kroki[[i]])))
do <- unlist(lapply(seq_along(kroki), function(i) c(kroki[[i]], koniec[i])))
N <- table(od = factor(od, stany), do = factor(do, stany))
P <- prop.table(N[1:5, ], 1)                    # macierz przejść: wiersze sumują się do 1
N[1:5, ]
round(P, 3)

# Prawdopodobieństwo dojścia do zakupu ze startu (łańcuch pochłaniający: zakup i brak kończą ścieżkę)
p_rezerwacji <- function(P) {
  Q <- P[1:5, 1:5]; R <- P[1:5, c("zakup", "brak")]
  solve(diag(5) - Q, R)["start", "zakup"]
}
c(z_macierzy = round(p_rezerwacji(P), 4), w_danych = round(mean(dane$zakup), 4))

# Graf przejść: pętle („zostaje w kanale”) i koniec bez rezerwacji jako liczby w węźle, strzałki ≥ .05 i do rezerwacji
kraw <- as.data.frame(as.table(P), stringsAsFactors = FALSE)
names(kraw) <- c("od", "do", "p")
kraw <- kraw[kraw$od != kraw$do & kraw$do != "brak" & (kraw$p >= 0.05 | kraw$do == "zakup") & kraw$p > 0, ]
kraw$typ <- ifelse(kraw$do == "zakup", "do rezerwacji", "do innego kanału")
kraw$etyk <- sub("^0", "", sprintf("%.2f", kraw$p))
bp <- function(x) sub("^0", "", sprintf("%.2f", x))
wez <- data.frame(name = c("start", kanaly, "zakup"), x = c(0, 1, 1, 2.3, 2.3, 3.3), y = c(0, 1.1, -1.1, 1.1, -1.1, 0))
i <- match(wez$name, rownames(P))
wez$etyk <- ifelse(wez$name %in% kanaly, sprintf("%s\nzostaje %s\nkoniec %s", wez$name, bp(diag(P)[i]), bp(P[i, "brak"])),
                   ifelse(wez$name == "zakup", "rezerwacja", "start"))
g <- graph_from_data_frame(kraw, directed = TRUE, vertices = wez)
c(wezly = vcount(g), strzalki = ecount(g))

p3 <- ggraph(g, layout = "manual", x = wez$x, y = wez$y) +
  geom_edge_fan(aes(edge_width = p, edge_colour = typ, label = etyk), strength = 0.7,
                arrow = arrow(length = unit(2.6, "mm"), type = "closed"), end_cap = circle(13, "mm"),
                start_cap = circle(13, "mm"), angle_calc = "along", label_dodge = unit(3, "mm"), label_pos = 0.4,
                label_size = 3.5, alpha = 0.9) +
  geom_node_point(aes(fill = name == "zakup"), shape = 21, size = 30, colour = "grey40", stroke = 0.8) +
  geom_node_text(aes(label = etyk), size = 3.4, lineheight = 0.9, colour = "grey10") +
  scale_fill_manual(values = c(`TRUE` = "grey90", `FALSE` = "white"), guide = "none") +
  scale_edge_width(range = c(0.4, 3), guide = "none") +
  scale_edge_colour_manual(values = c("do rezerwacji" = kol[["cynober"]], "do innego kanału" = kol[["niebieski"]]),
                           name = NULL) +
  scale_x_continuous(expand = expansion(add = 0.4)) + scale_y_continuous(expand = expansion(add = 0.45)) +
  labs(title = "Graf przejść między kanałami",
       subtitle = "Liczba przy strzałce = prawdopodobieństwo następnego kroku (pokazano ≥ .05 i wszystkie do rezerwacji);\n„koniec” = ścieżka kończy się bez rezerwacji") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p3   # zapis: ggsave("atrybucja-graf-przejsc.svg", p3, width = 10, height = 7)
Wynik w R
              do
od             start social e-mail wyszukiwarka bezpośrednio zakup brak
  start            0   5718   1191         1763          561     0    0
  social           0   2138    742         2710          846   150 2298
  e-mail           0    400    557          693          221    98  935
  wyszukiwarka     0    526    344         1268          678   580 3544
  bezpośrednio     0    102     70          506          311   294 1334
              do
od             start social e-mail wyszukiwarka bezpośrednio zakup  brak
  start        0.000  0.619  0.129        0.191        0.061 0.000 0.000
  social       0.000  0.241  0.084        0.305        0.095 0.017 0.259
  e-mail       0.000  0.138  0.192        0.239        0.076 0.034 0.322
  wyszukiwarka 0.000  0.076  0.050        0.183        0.098 0.084 0.511
  bezpośrednio 0.000  0.039  0.027        0.193        0.119 0.112 0.510
z_macierzy   w_danych
    0.1215     0.1215
   wezly strzalki
       6       17
4. Efekt usunięcia i atrybucja Markowa: Rysunek 4
R
# Rysunek 4. Efekt usunięcia (removal effect): o ile spada prawdopodobieństwo rezerwacji bez danego kanału
# Korzysta z obiektów przepisów 1–3: P, p_rezerwacji, kanaly, dane, kol, motyw. Niczego nie losuje.
library(ggplot2)

# Usunięcie kanału k: każde przejście do k kończy ścieżkę bez rezerwacji
usun <- function(P, k) { P[, "brak"] <- P[, "brak"] + P[, k]; P[, k] <- 0; P }
p_pelne <- p_rezerwacji(P)
p_bez <- sapply(kanaly, function(k) p_rezerwacji(usun(P, k)))
efekt <- 1 - p_bez / p_pelne                     # efekt usunięcia
udzial <- efekt / sum(efekt)                     # efekty normalizowane do 100%
markow <- udzial * sum(dane$zakup)               # rezerwacje przypisane kanałom
round(data.frame(p_bez_proc = 100 * p_bez, efekt_usuniecia = efekt, udzial = udzial, rezerwacje = markow), 3)
c(p_pelne = round(p_pelne, 4), suma_efektow = round(sum(efekt), 3))

ef <- data.frame(kanal = factor(kanaly, levels = rev(kanaly)), p_bez, efekt)
p4 <- ggplot(ef, aes(p_bez, kanal)) +
  geom_segment(aes(x = p_pelne, xend = p_bez, yend = kanal), colour = kol[["niebieski"]], linewidth = 1.1,
               arrow = arrow(length = unit(2.6, "mm"), type = "closed")) +
  geom_point(aes(x = p_pelne), shape = 21, size = 3.4, fill = "white", colour = "grey20") +
  geom_point(shape = 23, size = 3.6, fill = kol[["cynober"]], colour = "grey15") +
  geom_text(aes(label = sprintf("%.2f%% · efekt usunięcia %.0f%%", 100 * p_bez, 100 * efekt)),
            hjust = 1.08, vjust = -1.1, size = 3.6, colour = "grey15") +
  geom_vline(xintercept = p_pelne, linetype = "dashed", colour = "grey35") +
  annotate("text", x = p_pelne, y = 4.45, label = sprintf("wszystkie kanały: %.2f%%", 100 * p_pelne),
           hjust = 1.05, size = 3.6, colour = "grey20") +
  scale_x_continuous(labels = function(x) paste0(x * 100, "%"), limits = c(0, 0.135), breaks = seq(0, 0.12, 0.02)) +
  scale_y_discrete(expand = expansion(add = c(0.6, 0.9))) +
  labs(x = "Prawdopodobieństwo rezerwacji ze startu ścieżki (z macierzy przejść)", y = NULL,
       title = "Co by było bez kanału? Efekt usunięcia",
       subtitle = "Kółko: pełna macierz przejść; romb: macierz, w której przejście do kanału kończy ścieżkę") +
  motyw + theme(panel.grid.major.y = element_blank())
p4   # zapis: ggsave("atrybucja-efekt-usuniecia.svg", p4, width = 10, height = 5.6)
Wynik w R
             p_bez_proc efekt_usuniecia udzial rezerwacje
social            4.598           0.622  0.342    383.688
e-mail            9.320           0.233  0.128    143.843
wyszukiwarka      4.416           0.637  0.350    392.942
bezpośrednio      8.184           0.327  0.180    201.528
     p_pelne suma_efektow
      0.1215       1.8180
5. Prawdziwy wpływ, bootstrap i porównanie metod: Rysunek 5
R
# Rysunek 5. Cztery atrybucje obok prawdziwego wpływu kanałów (znanego, bo dane są symulowane)
# Korzysta z obiektów przepisów 1–4: dane, kroki, stany, od, do, heur, markow, usun, p_rezerwacji,
# u, zakup, widzi_kanaly, p_zakupu, kanaly, kol, motyw.
library(ggplot2)

# Prawda z symulacji: te same osoby i te same losy (macierz u), ale kanał wyłączony.
# Liczymy rezerwacje, których by nie było – w tym te utracone przez mniej wyszukiwań po reklamie social.
prawda <- sapply(kanaly, function(k) sum(zakup & !(u[, "zakup"] < p_zakupu(widzi_kanaly(bez = k)))))
bez_marketingu <- sum(u[, "zakup"] < p_zakupu(widzi_kanaly(bez = c("social", "e-mail", "wyszukiwarka"))))
c(rezerwacje_wszystkie = sum(zakup), w_danych = sum(dane$zakup), bez_social_email_wyszukiwarki = bez_marketingu)
tabela <- rbind(heur, markow = markow, prawda = prawda)
round(tabela)

# Niepewność atrybucji Markowa: bootstrap osób (1000 prób)
idx <- (match(od, stany) - 1) * length(stany) + match(do, stany)       # numer komórki „od × do”
osoba <- rep(seq_len(nrow(dane)), lengths(kroki) + 1)
M <- unclass(table(factor(osoba, seq_len(nrow(dane))), factor(idx, seq_len(length(stany)^2))))
markow_z_licznosci <- function(liczn, n_zakupow) {
  Nb <- matrix(liczn, length(stany), length(stany), byrow = TRUE, dimnames = list(stany, stany))
  Pb <- Nb[1:5, ] / rowSums(Nb[1:5, ])
  e <- 1 - sapply(kanaly, function(k) p_rezerwacji(usun(Pb, k))) / p_rezerwacji(Pb)
  e / sum(e) * n_zakupow
}
all.equal(markow_z_licznosci(colSums(M), sum(dane$zakup)), markow)   # kontrola: to samo co w przepisie 4
set.seed(610)
B <- 1000
boot <- t(replicate(B, {
  w <- tabulate(sample(nrow(dane), replace = TRUE), nrow(dane))
  markow_z_licznosci(colSums(M * w), sum(w * dane$zakup))
}))
ci <- apply(boot, 2, quantile, c(0.025, 0.975))
round(rbind(markow = markow, ci), 0)

por <- data.frame(kanal = rep(kanaly, 5),
                  metoda = rep(c("ostatnie kliknięcie", "pierwsze kliknięcie", "liniowa", "łańcuch Markowa",
                                 "prawdziwy wpływ (symulacja)"), each = 4),
                  rezerwacje = c(heur["ostatnie", ], heur["pierwsze", ], heur["liniowa", ], markow, prawda))
por$metoda <- factor(por$metoda, levels = unique(por$metoda))
por$kanal <- factor(por$kanal, levels = rev(kanaly))
por$y <- as.numeric(por$kanal) + (2.5 - as.numeric(por$metoda) + 0.5) * 0.15
przedz <- data.frame(kanal = factor(kanaly, levels = levels(por$kanal)), dol = ci[1, ], gora = ci[2, ])
przedz$y <- as.numeric(przedz$kanal) + (2.5 - 4 + 0.5) * 0.15
p5 <- ggplot(por, aes(rezerwacje, y, colour = metoda, shape = metoda, fill = metoda)) +
  geom_segment(data = przedz, aes(x = dol, xend = gora, y = y, yend = y), inherit.aes = FALSE,
               colour = kol[["niebieski"]], linewidth = 1) +
  geom_point(size = 3.4, stroke = 1) +
  geom_text(data = por[por$metoda == "prawdziwy wpływ (symulacja)", ],
            aes(label = round(rezerwacje)), hjust = 0, nudge_x = 12, size = 3.4, show.legend = FALSE) +
  geom_text(data = przedz, aes(x = gora, y = y, label = round(markow)), inherit.aes = FALSE, hjust = -0.3,
            size = 3.4, colour = kol[["niebieski"]]) +
  scale_colour_manual(values = c(kol[["pomarancz"]], kol[["fiolet"]], kol[["zielony"]], kol[["niebieski"]], kol[["ciemny"]]),
                      name = NULL) +
  scale_fill_manual(values = c(kol[["pomarancz"]], kol[["fiolet"]], kol[["zielony"]], kol[["niebieski"]], kol[["ciemny"]]),
                    name = NULL) +
  scale_shape_manual(values = c(24, 25, 22, 21, 23), name = NULL) +
  scale_y_continuous(breaks = 1:4, labels = levels(por$kanal), expand = expansion(add = 0.45)) +
  scale_x_continuous(limits = c(0, 640), breaks = seq(0, 600, 100)) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2), fill = guide_legend(nrow = 2)) +
  labs(x = sprintf("Rezerwacje przypisane kanałowi (z %d)", sum(dane$zakup)), y = NULL,
       title = "Ile rezerwacji „dał” kanał? Cztery atrybucje i prawda",
       subtitle = sprintf("Odcinek = 95%% przedział bootstrapowy dla łańcucha Markowa (%d prób osób)", B)) +
  motyw + theme(panel.grid.major.y = element_blank())
p5   # zapis: ggsave("atrybucja-porownanie-metod.svg", p5, width = 10, height = 6.6)
Wynik w R
         rezerwacje_wszystkie                      w_danych
                         1190                          1122
bez_social_email_wyszukiwarki
                          724
         social e-mail wyszukiwarka bezpośrednio
ostatnie    150     98          580          294
pierwsze    561    163          299           99
liniowa     347    143          440          191
markow      384    144          393          202
prawda      320    108          122            0
[1] TRUE
       social e-mail wyszukiwarka bezpośrednio
markow    384    144          393          202
2.5%      361    131          368          184
97.5%     406    157          418          220
6. Pułapka: tylko ścieżki z rezerwacją
R
# Pułapka: atrybucja Markowa tylko na ścieżkach zakończonych rezerwacją (bez ścieżek bez konwersji)
# Korzysta z obiektów przepisów 1–5: dane, kroki, stany, kanaly, usun, p_rezerwacji, markow, prawda. Niczego nie losuje.
z <- dane$zakup == 1
od_z <- unlist(lapply(which(z), function(i) c("start", kroki[[i]])))
do_z <- unlist(lapply(which(z), function(i) c(kroki[[i]], "zakup")))
Pz <- prop.table(table(factor(od_z, stany), factor(do_z, stany))[1:5, ], 1)
round(Pz[, c(kanaly, "zakup")], 3)
c(p_rezerwacji_tylko_zakupy = p_rezerwacji(Pz))   # zawsze 1: każda ścieżka kończy się rezerwacją
ef_z <- 1 - sapply(kanaly, function(k) p_rezerwacji(usun(Pz, k)))
markow_z <- ef_z / sum(ef_z) * sum(z)
# Odsetek ścieżek z rezerwacją, na których kanał w ogóle wystąpił
obecny <- sapply(kanaly, function(k) mean(sapply(kroki[z], function(s) k %in% s)))
round(rbind(efekt_usuniecia = ef_z, obecny_na_sciezce = obecny), 3)
round(rbind(markow_pelne_dane = markow, markow_tylko_zakupy = markow_z, prawda = prawda))
Wynik w R
               social e-mail wyszukiwarka bezpośrednio zakup
  start         0.500  0.145        0.266        0.088 0.000
  social        0.237  0.125        0.344        0.132 0.161
  e-mail        0.145  0.170        0.324        0.140 0.222
  wyszukiwarka  0.060  0.063        0.166        0.178 0.533
  bezpośrednio  0.036  0.036        0.276        0.096 0.556
p_rezerwacji_tylko_zakupy
                        1
                  social e-mail wyszukiwarka bezpośrednio
efekt_usuniecia    0.569  0.296        0.679        0.380
obecny_na_sciezce  0.594  0.285        0.745        0.395
                    social e-mail wyszukiwarka bezpośrednio
markow_pelne_dane      384    144          393          202
markow_tylko_zakupy    332    172          396          222
prawda                 320    108          122            0
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (przejście do kanału / do rezerwacji; usunięcie)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (ostatnia wizyta: wyszukiwarka / social; rys. 1)" = c("#0072B2", "#E69F00"),
             "pomarańczowy – fioletowy (ostatnie / pierwsze kliknięcie)" = c("#E69F00", "#CC79A7"),
             "fioletowy – zielony (pierwsze kliknięcie / liniowa)" = c("#CC79A7", "#009E73"),
             "zielony – pomarańczowy (liniowa / ostatnie kliknięcie)" = c("#009E73", "#E69F00"),
             "zielony – niebieski (liniowa / Markow)" = c("#009E73", "#0072B2"),
             "niebieski – ciemnoszary (Markow / prawda)" = c("#0072B2", "#262626"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                          widzenie_typowe
niebieski – cynober (przejście do kanału / do rezerwacji; usunięcie)                114.6
niebieski – pomarańczowy (ostatnia wizyta: wyszukiwarka / social; rys. 1)           120.2
pomarańczowy – fioletowy (ostatnie / pierwsze kliknięcie)                            88.6
fioletowy – zielony (pierwsze kliknięcie / liniowa)                                  87.5
zielony – pomarańczowy (liniowa / ostatnie kliknięcie)                               88.7
zielony – niebieski (liniowa / Markow)                                               70.1
niebieski – ciemnoszary (Markow / prawda)                                            51.7
czerwony – zielony (do unikania)                                                    121.7
                                                                          deuteranopia
niebieski – cynober (przejście do kanału / do rezerwacji; usunięcie)             108.3
niebieski – pomarańczowy (ostatnia wizyta: wyszukiwarka / social; rys. 1)        121.5
pomarańczowy – fioletowy (ostatnie / pierwsze kliknięcie)                         81.3
fioletowy – zielony (pierwsze kliknięcie / liniowa)                               18.1
zielony – pomarańczowy (liniowa / ostatnie kliknięcie)                            66.3
zielony – niebieski (liniowa / Markow)                                            55.4
niebieski – ciemnoszary (Markow / prawda)                                         53.3
czerwony – zielony (do unikania)                                                  21.1
                                                                          protanopia
niebieski – cynober (przejście do kanału / do rezerwacji; usunięcie)            91.9
niebieski – pomarańczowy (ostatnia wizyta: wyszukiwarka / social; rys. 1)      109.3
pomarańczowy – fioletowy (ostatnie / pierwsze kliknięcie)                       87.6
fioletowy – zielony (pierwsze kliknięcie / liniowa)                             36.2
zielony – pomarańczowy (liniowa / ostatnie kliknięcie)                          51.5
zielony – niebieski (liniowa / Markow)                                          58.0
niebieski – ciemnoszary (Markow / prawda)                                       51.3
czerwony – zielony (do unikania)                                                31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, macierze, bootstrap – pakiety base i stats). Rysunki wykonano w ggplot2, graf przejść – pakietami igraph i ggraph; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- igraph (wersja 2.2.2): Csárdi, G., & Nepusz, T. (2006). The igraph software package for complex network research. InterJournal, Complex Systems, 1695. https://igraph.org
- ggraph (wersja 2.2.2): Pedersen, T. L. (2025). ggraph: An implementation of grammar of graphics for graphs and networks [R package]. https://doi.org/10.32614/CRAN.package.ggraph
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Atrybucja jako zwrot z inwestycji. Udziały dzielą wszystkie rezerwacje, także te, które zdarzyłyby się bez reklamy (rysunek 5).
- Brak ścieżek bez konwersji. Gdy masz tylko ścieżki zakończone rezerwacją (np. z systemu sprzedaży), szansa rezerwacji wynosi zawsze 1, a efekt usunięcia staje się prawie odsetkiem ścieżek z kanałem. W naszych danych wyszukiwarka występuje na 74.5% ścieżek z rezerwacją, a jej efekt usunięcia wynosi wtedy .679. Przypisane rezerwacje zmieniają się na 332 (social), 172 (e-mail), 396 (wyszukiwarka) i 222 (bezpośrednio). Kanał, który przyciąga wiele osób bez rezerwacji, wygląda wtedy lepiej, niż jest. To odmiana błędu selekcji.
- Za krótkie okno i brak śledzenia. Kontakty sprzed okna, offline i na innych urządzeniach znikają ze ścieżek.
- Rząd łańcucha. Pierwszy rząd ignoruje historię dalszą niż jeden krok; wyższe rzędy wymagają dużo więcej danych. Gdy stan klienta (np. faza decyzji) jest nieobserwowany, rozważ ukryty model Markowa.
- Za mało ścieżek na rzadkie przejścia. Podawaj liczby przejść i przedziały bootstrapowe. Przepływy między kolejnymi krokami dobrze pokazuje też diagram Sankeya.
Gdy potrzebujesz pomocy przy analizie ścieżek klientów w pracy dyplomowej, zobacz analizy statystyczne dla studentów.
Najczęstsze pytania
Na czym polega atrybucja metodą łańcucha Markowa?
Ścieżki klientów rozbija się na przejścia między stanami (start, kanały, konwersja, brak konwersji) i szacuje macierz przejść. Z niej liczy się szansę konwersji, a potem efekt usunięcia: o ile ta szansa spada, gdy przejścia do kanału kończą ścieżkę bez konwersji. Efekty normalizuje się do sumy 1 i mnoży przez liczbę konwersji (Anderl i in., 2016).
Dlaczego model ostatniego kliknięcia jest zły?
Oddaje całą konwersję ostatniemu kontaktowi, więc pomija kanały, które otwierają ścieżkę. W przykładzie reklama w mediach społecznościowych dostała przy ostatnim kliknięciu 150 rezerwacji, a jej prawdziwy wpływ wynosił 320, bo po reklamie klienci szukali biura w wyszukiwarce. Wyszukiwarka i wejście bezpośrednie były przy tym mocno przeszacowane.
Czy atrybucja Markowa pokazuje, ile sprzedaży dała reklama?
Nie. To podział obserwowanych konwersji, także tych, które zdarzyłyby się bez reklamy. W symulacji wejście bezpośrednie dostało 202 rezerwacje, choć nie dodało żadnej, a wyszukiwarka 393 przy przyroście 122. Przyrost mierzy eksperyment z grupą kontrolną (Blake i in., 2015; Kohavi i in., 2009).
Czym się różni wartość Shapleya od efektu usunięcia?
Obie metody dzielą konwersje między kanały. Wartość Shapleya uśrednia wkład kanału we wszystkie możliwe kombinacje kanałów, a efekt usunięcia porównuje szansę konwersji z kanałem i bez niego w macierzy przejść. Obie korzystają z tych samych danych obserwacyjnych, więc żadna nie zastępuje eksperymentu (Dalessandro i in., 2012).
Czy do atrybucji potrzebne są ścieżki bez konwersji?
Tak. Bez nich szansa konwersji w modelu wynosi zawsze 1, a efekt usunięcia staje się prawie odsetkiem ścieżek, na których kanał występuje. W przykładzie wyszukiwarka była na 74.5% ścieżek z rezerwacją i miała wtedy efekt usunięcia .679. Kanały przyciągające wiele osób bez zakupu wyglądają wówczas lepiej, niż są.
Powiązane hasła
Przeczytaj też
Marketing mix modeling (MMM)
Producent soków, 156 tygodni i dwa kanały reklamy: adstock, nasycenie, rozkład sprzedaży, ROI z bootstrapem blokowym i pułapki – sześć rysunków z kodem R.
Czytaj →PoradnikKampania w jednym regionie – syntetyczna kontrola
16 regionów i kampania tylko w jednym: wagi bliźniaka, luka, testy placebo i porównanie z DiD – pięć rysunków z kodem R.
Czytaj →PoradnikCUPED – krótszy test A/B
Wydatki sprzed testu jako kowariant: węższy przedział, symulacja 1000 testów, związek z ANCOVA i pułapka kowariantu po starcie – z kodem R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikAtrybucja wartością Shapleya
Sieć szkół językowych: wartość koalicji kanałów, Shapley na 3 i 5 kanałach, porównanie z Markowem i ostatnim kliknięciem, bootstrap – kod R.
Czytaj →Analizujesz w pracy ścieżki klientów albo skuteczność kanałów?
Pomożemy przygotować dane o ścieżkach, policzyć atrybucję regułami i łańcuchem Markowa, zaplanować test, który zmierzy prawdziwy wpływ kanału, i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Anderl, E., Becker, I., von Wangenheim, F., & Schumann, J. H. (2016). Mapping the customer journey: Lessons learned from graph-based online attribution modeling. International Journal of Research in Marketing, 33(3), 457–474. https://doi.org/10.1016/j.ijresmar.2016.03.001 ● Otwarty dostęp: pełny tekst
- Blake, T., Nosko, C., & Tadelis, S. (2015). Consumer heterogeneity and paid search effectiveness: A large-scale field experiment. Econometrica, 83(1), 155–174. https://doi.org/10.3982/ecta12423 ● Otwarty dostęp: pełny tekst
- Dalessandro, B., Perlich, C., Stitelman, O., & Provost, F. (2012). Causally motivated attribution for online advertising. In Proceedings of the Sixth International Workshop on Data Mining for Online Advertising and Internet Economy (pp. 1–9). ACM. https://doi.org/10.1145/2351356.2351363
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Li, H., & Kannan, P. K. (2014). Attributing conversions in a multichannel online marketing environment: An empirical model and a field experiment. Journal of Marketing Research, 51(1), 40–56. https://doi.org/10.1509/jmr.13.0050
- Norris, J. R. (1997). Markov chains. Cambridge University Press. https://doi.org/10.1017/cbo9780511810633
- Shao, X., & Li, L. (2011). Data-driven multi-touch attribution models. In Proceedings of the 17th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 258–264). ACM. https://doi.org/10.1145/2020408.2020453
Cytowania BibTeX
@article{anderl2016mapping, author={Anderl, Eva and Becker, Ingo and von Wangenheim, Florian and Schumann, Jan Hendrik}, title={{Mapping the customer journey: Lessons learned from graph-based online attribution modeling}}, journal={International Journal of Research in Marketing}, year={2016}, volume={33}, number={3}, pages={457--474}, doi={10.1016/j.ijresmar.2016.03.001}}@article{blake2015consumer, author={Blake, Thomas and Nosko, Chris and Tadelis, Steven}, title={{Consumer heterogeneity and paid search effectiveness: A large-scale field experiment}}, journal={Econometrica}, year={2015}, volume={83}, number={1}, pages={155--174}, doi={10.3982/ecta12423}}@inproceedings{dalessandro2012causally, author={Dalessandro, Brian and Perlich, Claudia and Stitelman, Ori and Provost, Foster}, title={{Causally motivated attribution for online advertising}}, booktitle={Proceedings of the Sixth International Workshop on Data Mining for Online Advertising and Internet Economy}, year={2012}, pages={1--9}, publisher={ACM}, doi={10.1145/2351356.2351363}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@article{li2014attributing, author={Li, Hongshuang and Kannan, P. K.}, title={{Attributing conversions in a multichannel online marketing environment: An empirical model and a field experiment}}, journal={Journal of Marketing Research}, year={2014}, volume={51}, number={1}, pages={40--56}, doi={10.1509/jmr.13.0050}}@book{norris1997markov, author={Norris, J. R.}, title={{Markov chains}}, year={1997}, publisher={Cambridge University Press}, doi={10.1017/cbo9780511810633}}@inproceedings{shao2011data, author={Shao, Xuhui and Li, Lexin}, title={{Data-driven multi-touch attribution models}}, booktitle={Proceedings of the 17th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining}, year={2011}, pages={258--264}, publisher={ACM}, doi={10.1145/2020408.2020453}}