Co to jest diagram Sankeya i wykres aluwialny?
Diagram Sankeya pokazuje przepływy między węzłami jako pasma, których szerokość jest proporcjonalna do wielkości przepływu. Schmidt (2008) opisuje jego historię: ponad sto lat temu Riall Sankey analizował nim sprawność cieplną maszyn parowych, a później diagram stosowano w bilansach energii i materiałów. Wykres aluwialny (ang. alluvial plot) to jego odmiana dla danych kategorialnych mierzonych w kilku punktach albo na kilku zmiennych. Na każdej pionowej osi stoją te same osoby podzielone na kategorie, a pasma łączą kategorie kolejnych osi. Rosvall i Bergstrom (2010) użyli takich diagramów do pokazania istotnych zmian struktury dużych sieci w czasie.
Jak czytać wykres
- Wysokość bloku to liczba osób w kategorii w danym pomiarze; bloki na każdej osi sumują się do tej samej liczby.
- Szerokość pasma to liczba osób, które przeszły z jednej kategorii do drugiej. Pasmo poziome to osoby, które zostały w tej samej kategorii.
- Kolor pasma zwykle oznacza kategorię startową; tę samą informację niesie położenie bloku i jego etykieta.
- Kategoria „brak pomiaru” pokazuje utratę uczestników jako osobny blok, zamiast cicho usuwać te osoby z wykresu.
Przykład
W symulowanych danych 200 pacjentów oceniono nasilenie objawów depresji na początku, po 3 i po 6 miesiącach. Na początku nasilenie ciężkie miało 75 osób, umiarkowane 86, a łagodne 39. Po 6 miesiącach było to 24, 57 i 80 osób, a 39 osób nie miało pomiaru. Z 75 osób z ciężkim nasileniem 15 nie miało już pomiaru po 3 miesiącach. Przejścia losowano z macierzy prawdopodobieństw jak w łańcuchu Markowa; prawdopodobieństwa ustawiono ręcznie tak, by poprawa i odpadanie były wyraźne, a ziarna (759) nie zmieniano.
Na rysunku
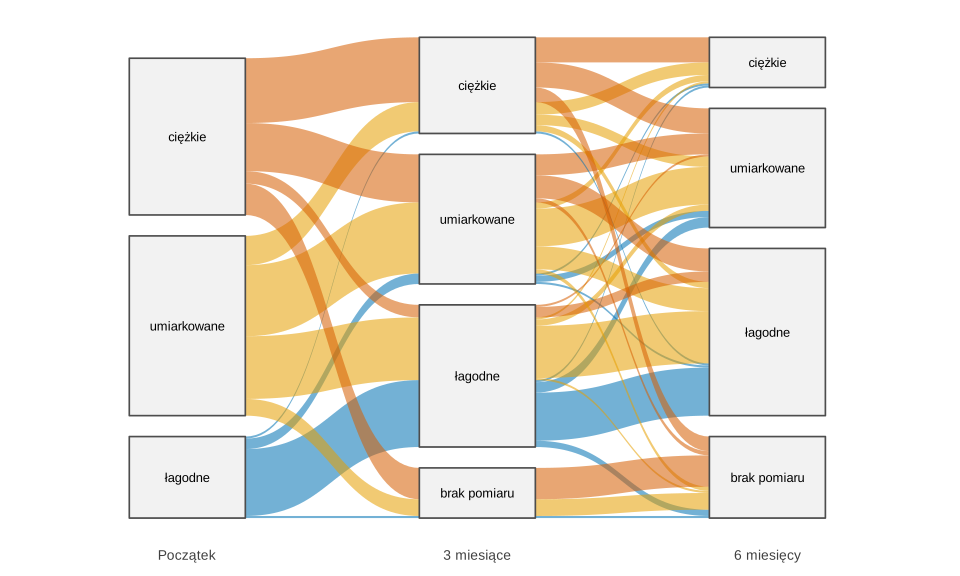
set.seed(759)).Co widać. Blok ciężkiego nasilenia maleje, a łagodnego rośnie. Pasma osób z ciężkim nasileniem na początku rozchodzą się do wszystkich kategorii, w tym do braku pomiaru. Z 39 osób z łagodnym nasileniem na początku 32 zostały w tej kategorii po 3 miesiącach. W danych wystąpiło 30 różnych ścieżek przez trzy pomiary.
Na co uważać. Wykres nie pokazuje niepewności – to opis próby, nie test. Cienkie pasma (1–2 osoby) przyciągają wzrok tak samo jak grube, a kolejność kategorii musi być taka sama na każdej osi.
Podpis do pracy:
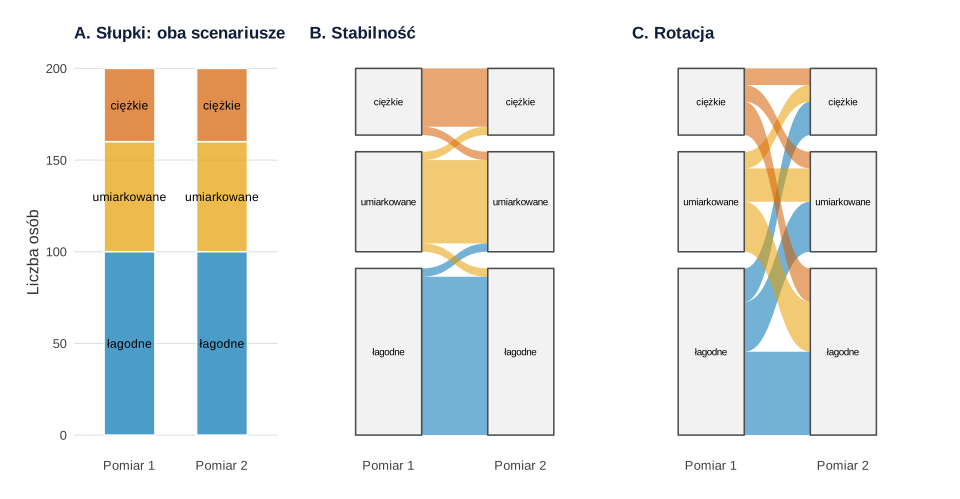
Co widać. Słupki skumulowane w panelu A są takie same w obu scenariuszach: 40, 60 i 100 osób w każdym pomiarze. W scenariuszu stabilności (B) kategorii nie zmienia 90% osób, w scenariuszu rotacji (C) – tylko 40%. Słupki pokazują tylko brzegi tabeli krzyżowej pomiar 1 × pomiar 2, a przejścia są w jej wnętrzu.
Na co uważać. Wykres aluwialny nie mówi, czy rotacja to prawdziwa zmiana, czy błąd pomiaru przy granicach kategorii. Przy ciągłym wyniku lepiej pokazać trajektorie na wykresie spaghetti albo zmianę na wykresie nachyleń.
Podpis do pracy:
Kod obu rysunków i tabele przejść znajdziesz w sekcji Wykres aluwialny w R.
Jak opisać w pracy
Na co uważać
- Usuwanie osób bez pomiaru. Na wykresie z samych pełnych danych odpadanie znika, a obraz zmiany bywa zbyt optymistyczny.
- Za dużo kategorii. Gdy pasma się plączą, połącz rzadkie kategorie albo pokaż tabelę przejść.
- Wykres zamiast testu. Do oceny zmiany w parach pomiarów potrzebny jest test, na przykład test McNemara dla dwóch kategorii.
Planowanie badań w kilku falach opisuje wpis ankieta w kilku falach.
Wykres aluwialny w R
Kod losuje trzy pomiary nasilenia objawów, liczy tabele przejść i rysuje wykres aluwialny funkcjami gather_set_data() i geom_parallel_sets() z pakietu ggforce. Druga część buduje dwie tabele przejść o tych samych brzegach (bez losowania) i składa rysunek 2 pakietem patchwork. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Tabele przejść i oba rysunki
R
# Rysunek 1. Wykres aluwialny: nasilenie objawów depresji w trzech pomiarach
suppressPackageStartupMessages({library(ggplot2); library(ggforce); library(patchwork)})
poz <- c("ciężkie", "umiarkowane", "łagodne", "brak pomiaru")
kol <- c("ciężkie" = "#D55E00", "umiarkowane" = "#E69F00", "łagodne" = "#0072B2", "brak pomiaru" = "grey60")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid = element_blank(), axis.text.y = element_blank(), legend.position = "none")
set.seed(759)                                       # 200 pacjentów, 3 pomiary
n <- 200
P <- rbind("ciężkie"      = c(0.45, 0.30, 0.10, 0.15),   # wiersz: stan teraz, kolumny: stan za 3 miesiące
           "umiarkowane"  = c(0.10, 0.45, 0.35, 0.10),   # prawdopodobieństwa ustawione ręcznie
           "łagodne"      = c(0.03, 0.12, 0.80, 0.05),
           "brak pomiaru" = c(0, 0, 0, 1))
colnames(P) <- poz
start <- sample(poz[1:3], n, replace = TRUE, prob = c(0.35, 0.45, 0.20))
krok <- function(stan) sapply(stan, function(s) sample(poz, 1, prob = P[s, ]))
m3 <- krok(start)
m6 <- krok(m3)
dane <- data.frame(start = factor(start, poz), m3 = factor(m3, poz), m6 = factor(m6, poz))
table(start = dane$start, `3 mies.` = dane$m3)       # przepływy między pomiarem 1 i 2
table(`3 mies.` = dane$m3, `6 mies.` = dane$m6)      # przepływy między pomiarem 2 i 3
przeplywy <- as.data.frame(table(dane))              # jedna linia na ścieżkę start → 3 mies. → 6 mies.
przeplywy <- przeplywy[przeplywy$Freq > 0, ]
nrow(przeplywy)                                     # ile różnych ścieżek wystąpiło
d <- gather_set_data(przeplywy, 1:3)
d$x <- factor(d$x, levels = c("start", "m3", "m6"), labels = c("Początek", "3 miesiące", "6 miesięcy"))
d$y <- factor(d$y, levels = poz)
p1 <- ggplot(d, aes(x, id = id, split = y, value = Freq)) +
  geom_parallel_sets(aes(fill = start), alpha = 0.55, axis.width = 0.4, n = 50) +
  geom_parallel_sets_axes(axis.width = 0.4, fill = "grey95", colour = "grey30") +
  geom_parallel_sets_labels(colour = "black", angle = 0, size = 3.4) +
  scale_fill_manual(values = kol) +
  labs(x = NULL, y = NULL) + motyw
p1

# Rysunek 2. Te same odsetki w obu pomiarach, różne przepływy (liczebności wpisane ręcznie, bez losowania)
st <- c("ciężkie", "umiarkowane", "łagodne")
stabilnosc <- matrix(c(35, 5, 0,   5, 50, 5,   0, 5, 95), 3, byrow = TRUE, dimnames = list(st, st))
rotacja    <- matrix(c(10, 10, 20, 10, 20, 30, 20, 30, 50), 3, byrow = TRUE, dimnames = list(st, st))
rbind(stabilnosc_pomiar1 = rowSums(stabilnosc), stabilnosc_pomiar2 = colSums(stabilnosc),
      rotacja_pomiar1 = rowSums(rotacja), rotacja_pomiar2 = colSums(rotacja))   # brzegi identyczne
c(stabilnosc = sum(diag(stabilnosc)), rotacja = sum(diag(rotacja))) / 200 * 100   # % osób bez zmiany
aluwialny <- function(M, tytul) {
  pr <- data.frame(przed = factor(rep(st, 3), st), po = factor(rep(st, each = 3), st), Freq = c(M))
  dd <- gather_set_data(pr, 1:2)
  dd$x <- factor(dd$x, levels = c("przed", "po"), labels = c("Pomiar 1", "Pomiar 2"))
  dd$y <- factor(dd$y, levels = st)
  ggplot(dd, aes(x, id = id, split = y, value = Freq)) +
    geom_parallel_sets(aes(fill = przed), alpha = 0.55, axis.width = 0.5, n = 50) +
    geom_parallel_sets_axes(axis.width = 0.5, fill = "grey95", colour = "grey30") +
    geom_parallel_sets_labels(colour = "black", angle = 0, size = 2.6) +
    scale_fill_manual(values = kol) + labs(title = tytul, x = NULL, y = NULL) + motyw
}
brzegi <- data.frame(pomiar = rep(c("Pomiar 1", "Pomiar 2"), each = 3),
                     stan = factor(rep(st, 2), st), n = c(rowSums(rotacja), colSums(rotacja)))
pA <- ggplot(brzegi, aes(pomiar, n, fill = stan)) +
  geom_col(width = 0.55, colour = "white", alpha = 0.7) +
  geom_text(aes(label = stan), position = position_stack(vjust = 0.5), size = 3.2) +
  scale_fill_manual(values = kol) +
  labs(title = "A. Słupki: oba scenariusze", x = NULL, y = "Liczba osób") +
  theme_minimal(base_size = 13) + theme(panel.grid.major.x = element_blank(), legend.position = "none")
p2 <- pA + aluwialny(stabilnosc, "B. Stabilność") + aluwialny(rotacja, "C. Rotacja") +
  plot_layout(widths = c(0.7, 1, 1))
p2
Wynik w R
              3 mies.
start          ciężkie umiarkowane łagodne brak pomiaru
  ciężkie           31          23       6           15
  umiarkowane       14          34      30            8
  łagodne            1           5      32            1
  brak pomiaru       0           0       0            0
              6 mies.
3 mies.        ciężkie umiarkowane łagodne brak pomiaru
  ciężkie           18          17       4            7
  umiarkowane        4          31      23            4
  łagodne            2           9      53            4
  brak pomiaru       0           0       0           24
[1] 30
                   ciężkie umiarkowane łagodne
stabilnosc_pomiar1      40          60     100
stabilnosc_pomiar2      40          60     100
rotacja_pomiar1         40          60     100
rotacja_pomiar2         40          60     100
stabilnosc    rotacja
        90         40
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety ggplot2, ggforce i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggforce (wersja 0.5.0): Pedersen, T. L. (2025). ggforce: Accelerating ggplot2 [R package]. https://doi.org/10.32614/CRAN.package.ggforce
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym wykres aluwialny różni się od diagramu Sankeya?
Diagram Sankeya to ogólny wykres przepływów między dowolnymi węzłami, na przykład energii w instalacji. Wykres aluwialny to jego odmiana, w której każda oś zawiera te same jednostki podzielone na kategorie, a osie są ułożone w kolejności, zwykle w czasie.
Jak pokazać na wykresie aluwialnym osoby, które odpadły z badania?
Dodaj kategorię „brak pomiaru” na osiach od drugiego pomiaru. Wtedy bloki na każdej osi sumują się do tej samej liczby osób, a odpadanie widać jako pasma prowadzące do tego bloku. W przykładzie po 6 miesiącach było to 39 z 200 pacjentów.
Jak narysować wykres aluwialny w R bez pakietu ggalluvial?
Pakiet ggforce ma funkcje gather_set_data() i geom_parallel_sets(). Najpierw policz liczebność każdej ścieżki, na przykład as.data.frame(table(dane)), potem przekształć dane funkcją gather_set_data() i narysuj pasma, osie oraz etykiety kategorii.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Ankieta w kilku falach
Łączenie fal, stałe pytania, książka kodów i analiza ubytku: kompletne przypadki, model mieszany i wagi IPW w R.
Czytaj →PoradnikTabela krzyżowa na wykresie
Słupki 100% w wierszach i kolumnach, mozaika, mapa reszt χ² z korektą i odsetki z CI – jedna tabela 3 × 4, pięć rysunków z R, podpisy APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Rosvall, M., & Bergstrom, C. T. (2010). Mapping change in large networks. PLoS ONE, 5(1), Article e8694. https://doi.org/10.1371/journal.pone.0008694 ● Otwarty dostęp
- Schmidt, M. (2008). The Sankey diagram in energy and material flow management: Part I: History. Journal of Industrial Ecology, 12(1), 82–94. https://doi.org/10.1111/j.1530-9290.2008.00004.x ● Otwarty dostęp
Cytowania BibTeX
@article{rosvall2010mapping, author={Rosvall, Martin and Bergstrom, Carl T.}, title={{Mapping change in large networks}}, journal={PLoS ONE}, year={2010}, volume={5}, number={1}, eid={e8694}, doi={10.1371/journal.pone.0008694}}@article{schmidt2008sankey, author={Schmidt, Mario}, title={{The Sankey diagram in energy and material flow management: Part I: History}}, journal={Journal of Industrial Ecology}, year={2008}, volume={12}, number={1}, pages={82--94}, doi={10.1111/j.1530-9290.2008.00004.x}}