Przykład: księgarnia internetowa i sekcja „następny tom serii”
Fikcyjna księgarnia internetowa chce sprawdzić, czy sekcja „następny tom serii” (podpowiada kolejną część serii, którą klient czyta) zwiększa wydatki stałych klientów. Robi test A/B: 16000 zalogowanych klientów losuje po połowie do wersji A (obecna strona) i B (strona z nową sekcją). Metryka główna to wydatki klienta w 2 tygodniach testu (zł).
Kłopot: wydatki skaczą od klienta do klienta. Średnia w teście wynosi 47.06 zł, ale SD = 112.43 zł, 67.86% klientów nic w tym czasie nie kupiło, a najwięksi klienci (1%) wydali ponad 493.18 zł. Taki szum (silna skośność) zagłusza efekt rzędu kilku złotych. Sklep ma jednak coś jeszcze: wydatki każdego klienta z 4 tygodni przed testem. CUPED (ang. Controlled-experiment Using Pre-Experiment Data) wykorzystuje te dane, żeby zmniejszyć zmienność metryki i zwiększyć czułość testu (Deng i in., 2013). Ogólny plan testu – metryka, liczebność, czas trwania – opisuje wpis test A/B – plan i analiza. Tu zajmujemy się jednym krokiem: jak wycisnąć więcej z tych samych klientów.
Dane są fikcyjne, więc znamy prawdziwy efekt. Ręcznie ustaliliśmy: każdy klient ma stałe tempo zamówień (rozkład gamma o kształcie 0.5, średnio 0.3 zamówienia tygodniowo), tygodniowe wahania tego tempa i typową kwotę zamówienia (75 zł). Wersja B zwiększa liczbę zamówień o 8%, czyli wydatki o 3.60 zł na klienta w 2 tygodniach. Kształt rozkładu i wahania dobraliśmy w próbnych uruchomieniach tak, by korelacja wydatków przed testem i w teście była umiarkowana (ok. .5–.6), a efekt 8% i liczbę klientów tak, by test bez korekty miał moc ok. 50–60%. Ziarna 613 (dane) i 6130 (symulacja) ustalono raz i nie zmieniano ich. Dane pobierzesz jako cuped-ksiegarnia-test.csv (wiersz = klient: grupa, wydatki przed testem, w 1. i 2. tygodniu testu).
Rysunek 1: CUPED w trzech krokach
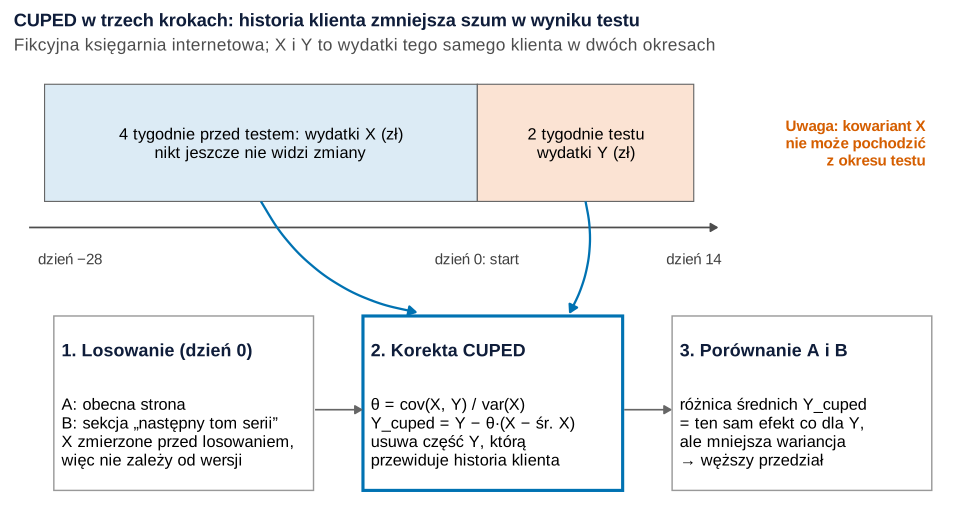
Co widać. Dla każdego klienta mamy dwie liczby: X – wydatki w 4 tygodniach przed startem i Y – wydatki w 2 tygodniach testu. X powstało, zanim ktokolwiek zobaczył nową sekcję, więc nie może zależeć od wersji. Korekta odejmuje od Y tę część, którą da się przewidzieć z X. Zostaje mniej szumu, a różnica między wersjami – ta sama.
Jak może zmylić. Schemat sugeruje, że wystarczy „jakaś” historia. Działa tylko historia, która naprawdę przewiduje wynik testu, i tylko ta zmierzona przed losowaniem (rysunki 4 i 5).
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: historia klienta przewiduje wynik testu
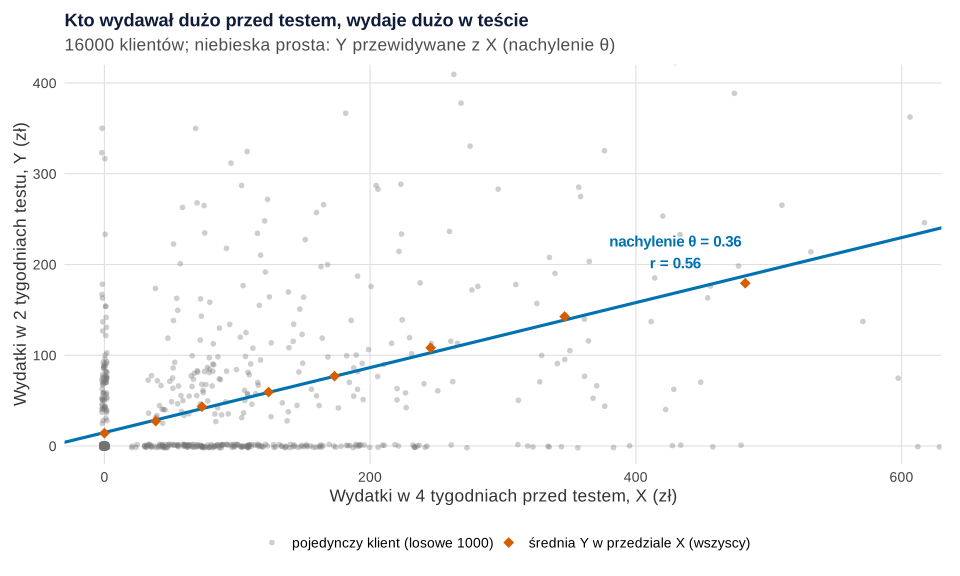
set.seed(613)).Co widać. Kto dużo wydawał przed testem, zwykle dużo wydaje i w teście. Korelacja Pearsona wydatków przed i w teście wynosi r = .56. Niebieska prosta to przewidywanie Y z X. Jej nachylenie to θ = 0.36: każda złotówka wydana w 4 tygodniach przed testem „zapowiada” ok. 36 groszy wydatków w 2 tygodniach testu. Pomarańczowe romby (średnie Y w przedziałach X, policzone na wszystkich klientach) leżą blisko prostej, więc związek jest w przybliżeniu liniowy.
Jak może zmylić. Większość punktów to zera: 54.74% klientów nic nie kupiło przed testem. Korelację tworzą głównie klienci kupujący często. Na rysunku jest tylko 1000 losowych klientów, a 3.3% wszystkich wypada poza osie – to właśnie oni najbardziej podbijają wariancję.
Podpis do pracy:
Zdanie do Wyników:
Korekta CUPED w jednym wzorze
Liczymy θ jako kowariancję X i Y podzieloną przez wariancję X – to dokładnie nachylenie prostej z rysunku 2, czyli współczynnik z regresji liniowej Y na X. Potem każdemu klientowi poprawiamy wynik:
Słowami: klient, który przed testem wydawał więcej niż przeciętnie, „oddaje” część wydatków z testu; ten, który wydawał mniej, dostaje dopisek. Średnia się nie zmienia (47.06 zł przed i po korekcie), ale SD spada ze 112.43 do 93.36 zł. Zostaje 68.9% wariancji, czyli mniej więcej 1 − r2: korekta zabiera tyle zmienności, ile wyjaśnia historia klienta.
Dlaczego efekt się nie zmienia? X zmierzono przed losowaniem, więc średnio jest takie samo w grupach A i B. Odejmujemy od obu grup „to samo w oczekiwaniu”, a różnica B − A celuje w ten sam efekt co bez korekty. Zmienia się tylko precyzja.
Rysunek 3: ten sam test, cztery analizy
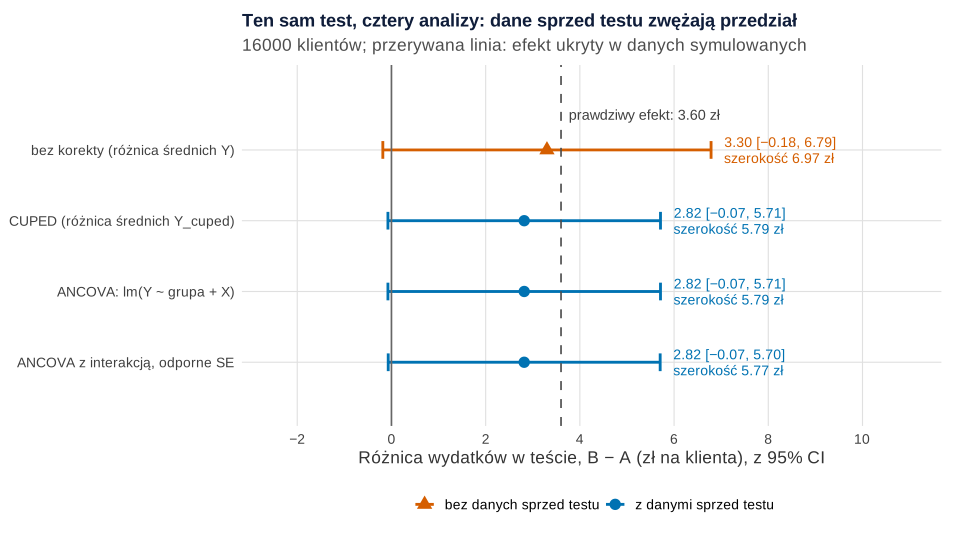
Co widać. Bez korekty wersja B dała 3.30 zł więcej na klienta, 95% CI [−0.18, 6.79], p = .063. Z CUPED: 2.82 zł, 95% CI [−0.07, 5.71], p = .056. Przedział ufności zwęził się z 6.97 do 5.79 zł, czyli do 0.83 dawnej szerokości. Taką precyzję test bez korekty osiągnąłby przy ok. 11032 klientach zamiast 16000.
Oszacowanie przesunęło się o 0.48 zł, bo grupa B przypadkiem wydawała przed testem trochę więcej (90.66 wobec 89.31 zł). Korekta odjęła tę przewagę razy θ. To nie błąd, tylko usunięcie przypadkowej różnicy na starcie.
CUPED to ANCOVA. Model lm(Y ~ grupa + X) daje co do grosza ten sam wynik. To ta sama idea co w ANCOVA z pomiarem wyjściowym jako kowariantem – geometrię równoległych prostych pokazuje wpis ANCOVA – wizualizacja na obrazkach. Czwarta wersja dodaje interakcję grupa × X i odporny błąd standardowy. Lin (2013) pokazuje, że korekta z pełnym zestawem interakcji nie pogarsza asymptotycznej precyzji, a poprawne przedziały daje estymator kanapkowy. Yang i Tsiatis (2001) wskazują ten wariant (obok GEE) jako asymptotycznie najbardziej efektywny w badaniu przed–po. Tu wynik prawie się nie zmienił: 2.82 zł, 95% CI [−0.07, 5.70].
Jak może zmylić. CUPED nie gwarantuje istotności. W tym teście oba wyniki są „na granicy”, choć prawdziwy efekt (3.60 zł) istnieje i mieści się w obu przedziałach. Test był po prostu za mały – rysunek 4 pokazuje, jak często tak się zdarza.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: 1000 testów – ile daje korelacja
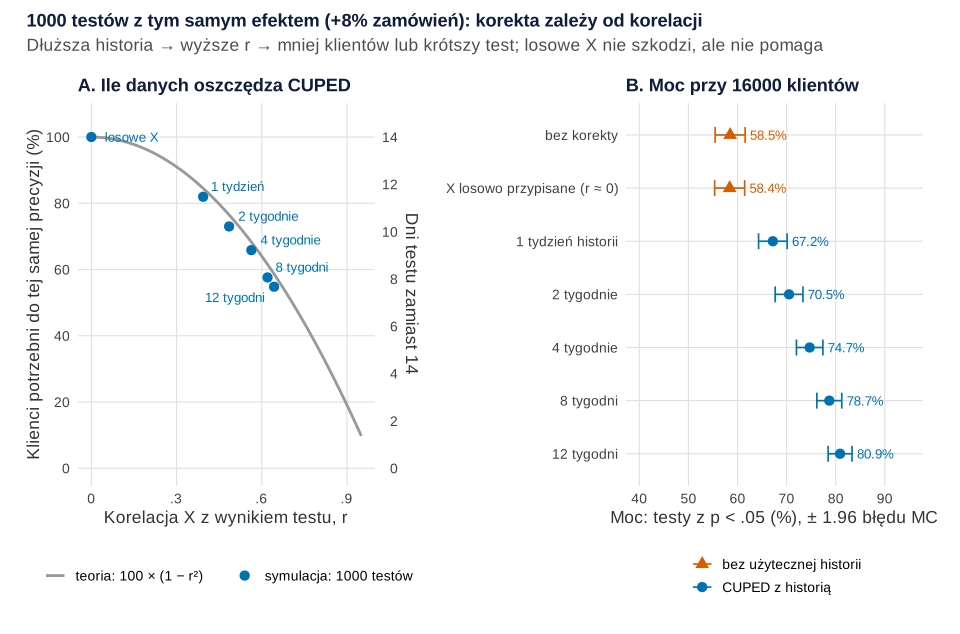
set.seed(6130)).Jeden test to jeden rzut monetą. Dlatego powtórzyliśmy go 1000 razy: za każdym razem nowych 16000 klientów, ten sam prawdziwy efekt (+8% zamówień) i 12 tygodni historii. W każdym teście liczymy efekt bez korekty i z CUPED przy różnej długości historii.
Co widać. Panel A: im wyższa korelacja historii z wynikiem testu, tym mniej klientów potrzeba do tej samej precyzji. Punkty z symulacji leżą przy krzywej 1 − r2. Historia z 4 tygodni (r = .56) zostawia 65.9% wariancji. Jeśli nowi klienci napływają w stałym tempie, to ok. 9.2 dnia zamiast 14. Dwanaście tygodni (r = .64) daje 54.8%, ale przyrost słabnie: 8 tygodni to już 57.6%. Panel B: moc testu rośnie z 58.5% bez korekty do 74.7% przy 4 tygodniach i 80.9% przy 12 tygodniach (błąd Monte Carlo ok. 1.2–1.6 pp). Historia przypisana losowo (r = .00) nie pomaga, ale też nie szkodzi: 58.4%.
Średni efekt ze wszystkich wariantów to 3.61–3.65 zł przy prawdziwych 3.60 zł. 95% przedziały obejmowały prawdziwy efekt w 94.9–95.3% testów, więc korekta nie psuje wnioskowania. Wynik zgadza się z tym, co opisują Deng i in. (2013): zmniejszenie wariancji o około połowę daje tę samą moc przy połowie użytkowników albo w połowie czasu.
Jak może zmylić. Prawa oś (dni) obowiązuje tylko wtedy, gdy liczba klientów rośnie z czasem proporcjonalnie. Gdy testujesz stałą bazę klientów, skrócenie testu zmienia samą metrykę (wydatki w 9 dni to coś innego niż w 14) i jej korelację z historią. Wtedy zysk wykorzystaj na mniejszą grupę testową albo mniejszy wykrywalny efekt.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: pułapka – kowariant z okresu testu
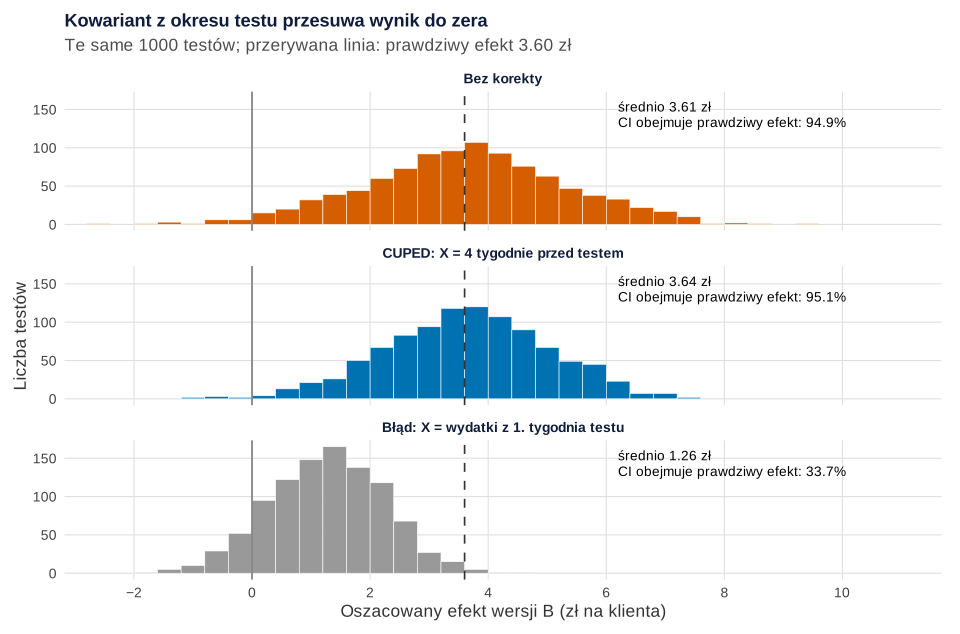
Co widać. Ktoś w zespole proponuje: „weźmy jako X wydatki z pierwszego tygodnia testu, bo jeszcze lepiej przewidują wynik”. I faktycznie: korelacja rośnie do r = .81, a wariancja spada do 32.4%. Tyle że histogram (szary) leży w złym miejscu: średni efekt to 1.26 zł zamiast 3.60 zł, a przedziały obejmują prawdziwy efekt tylko w 33.7% testów (błąd MC 1.5 pp). Moc spada do 25.2%. Powód: w pierwszym tygodniu wersja B już działała, więc X zawiera część efektu, a korekta go odejmuje.
Jak może zmylić. Ta sama pułapka kryje się w mniej oczywistych kowariantach: liczba wizyt w czasie testu, kliknięcia w nową sekcję, segment klienta wyliczony już po starcie. Wąski przedział nie świadczy, że analiza jest dobra. Zasada jest prosta: kowariant musi być ustalony, zanim klient zobaczył wersję.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- Planuj z CUPED od początku. Policz liczebność jak zwykle i pomnóż ją przez 1 − r2, gdzie r szacujesz na danych z poprzednich tygodni. Borm i in. (2007) pokazują to samo dla ANCOVA: grupy liczące (1 − ρ2)n osób dają taką moc jak test t na grupach po n. Najmniejszy efekt wart wykrycia ustal z góry (SESOI).
- Kowariant to zwykle ta sama metryka z okresu przed testem. W przykładzie 4–8 tygodni historii dało większość zysku; dłuższa historia dokłada coraz mniej.
- Nowi klienci nie mają historii. Wpisz im X = 0 i dodaj do modelu wskaźnik „nowy klient” albo analizuj ich osobno. Korekta zadziała wtedy tylko dla stałych klientów.
- Skrajne wydatki (np. zamówienia dla szkolnej biblioteki) podbijają wariancję bardziej niż cokolwiek innego. Zasadę przycinania ustal w planie, np. winsoryzację na 99. centylu.
- CUPED czy losowanie warstwowe? Xie i Aurisset (2016) w dużych eksperymentach zalecają techniki stosowane po przydziale (poststratyfikacja, CUPED) zamiast randomizacji warstwowej w chwili przydziału.
- Wskaźniki ilorazowe (średni koszyk, CTR) wymagają osobnego błędu standardowego – zob. wskaźniki ilorazowe w testach A/B.
- CUPED nie naprawia źle prowadzonego testu. Zaglądanie do wyników, nierówny podział ruchu i efekt nowości opisuje wpis pułapki testów A/B na obrazkach. Kontrolowany eksperyment jest najlepszym sposobem ustalania przyczyn zmian w zachowaniu użytkowników, ale wymaga mocy i poprawnej randomizacji (Kohavi i in., 2009).
- Gdy pytasz nie „czy działa”, lecz „u kogo działa”, przejdź do wpisu modelowanie uplift.
Jak opisać w pracy
W Metodzie podaj: kowariant i okres, z którego pochodzi (przed losowaniem), sposób liczenia θ (na obu grupach razem), to, że korekta była zaplanowana przed startem, oraz wynik bez korekty jako analizę uzupełniającą. Lin (2013) zwraca uwagę, że najmocniejszym argumentem za wynikiem bez korekty jest przejrzystość i brak ryzyka „szukania” specyfikacji, która da istotność. Więcej przykładów analiz do prac z tej dziedziny zebraliśmy we wpisie statystyka w pracy z marketingu.
W Wynikach podaj efekt w złotych z 95% CI dla obu analiz, korelację kowariantu z wynikiem i zwężenie przedziału. Tabela: analiza (bez korekty, CUPED), różnica średnich, 95% CI, p, szerokość przedziału.
Kod R: CUPED w bazowym R
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę i motyw, przepis 2 – funkcję symulującą klientów i dane, z których korzystają kolejne. CUPED i ANCOVA liczą funkcje cov(), var(), t.test() i lm(); odporny błąd standardowy – pakiet sandwich. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 2 (dane i wybór 1000 klientów do rysunku: set.seed(613), rozrzut punktów seed = 613) i 4 (1000 testów: set.seed(6130)). Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: 16000 klientów, podział 1:1, tempo zamówień z rozkładu gamma (kształt 0.5, średnio 0.3 zamówienia tygodniowo), tygodniowe wahania tempa (odchylenie logarytmu 0.5), typową kwotę zamówienia 75 zł (odchylenie logarytmu 0.4 między klientami i 0.25 między zamówieniami), efekt +8% zamówień oraz długości okresów (4 tygodnie przed testem, 2 tygodnie testu, w symulacji 1–12 tygodni historii). Przepis 4 liczy się ok. 40 sekund, pozostałe – poniżej sekundy.
1. Paleta, motyw i schemat CUPED: Rysunek 1
R
# Rysunek 1. Schemat CUPED: okres przed testem – test – korekta (grafika z ggplot2, bez danych)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         jasny = "#DCEBF5", jasny2 = "#FBE3D3", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Oś czasu: dni −28…−1 (okres przed testem) i 0…13 (test); pod nią trzy kroki analizy
okresy <- data.frame(od = c(-28, 0), do = c(0, 14), y = 3.0,
                     etykieta = c("4 tygodnie przed testem: wydatki X (zł)\nnikt jeszcze nie widzi zmiany",
                                  "2 tygodnie testu\nwydatki Y (zł)"),
                     wypelnienie = c("przed", "test"))
kroki <- data.frame(
  x = c(-19, 1, 21), y = 0.95,
  tytul = c("1. Losowanie (dzień 0)", "2. Korekta CUPED", "3. Porównanie A i B"),
  tekst = c("A: obecna strona\nB: sekcja „następny tom serii”\nX zmierzone przed losowaniem,\nwięc nie zależy od wersji",
            "θ = cov(X, Y) / var(X)\nY_cuped = Y − θ·(X − śr. X)\nusuwa część Y, którą\nprzewiduje historia klienta",
            "różnica średnich Y_cuped\n= ten sam efekt co dla Y,\nale mniejsza wariancja\n→ węższy przedział"))
p1 <- ggplot() +
  geom_rect(data = okresy, aes(xmin = od, xmax = do, ymin = y - 0.45, ymax = y + 0.45, fill = wypelnienie),
            colour = "grey40", linewidth = 0.4) +
  geom_text(data = okresy, aes((od + do) / 2, y, label = etykieta), size = 4.3, lineheight = 0.95) +
  geom_segment(aes(x = -29, xend = 15.5, y = 2.35, yend = 2.35), colour = "grey30",
               arrow = arrow(length = unit(0.2, "cm"), type = "closed")) +
  geom_text(aes(x = c(-28, 0, 14), y = 2.15, label = c("dzień −28", "dzień 0: start", "dzień 14")),
            size = 4, colour = "grey25", vjust = 1, hjust = c(0.1, 0.5, 0.5)) +
  geom_rect(data = kroki, aes(xmin = x - 8.4, xmax = x + 8.4, ymin = y - 0.62, ymax = y + 0.72),
            fill = "white", colour = c(kol[["szary"]], kol[["niebieski"]], kol[["szary"]]), linewidth = c(0.5, 1.1, 0.5)) +
  geom_text(data = kroki, aes(x - 7.9, y + 0.46, label = tytul), hjust = 0, fontface = "bold", size = 4.7,
            colour = "#0f1d3a") +
  geom_text(data = kroki, aes(x - 7.9, y - 0.17, label = tekst), hjust = 0, size = 4.3, lineheight = 0.95) +
  geom_curve(aes(x = -14, y = 2.55, xend = -4, yend = 1.7), curvature = 0.25, colour = kol[["niebieski"]],
             linewidth = 0.8, arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  geom_curve(aes(x = 7, y = 2.55, xend = 6, yend = 1.7), curvature = -0.2, colour = kol[["niebieski"]],
             linewidth = 0.8, arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  geom_segment(aes(x = c(-10.5, 9.5), xend = c(-7.5, 12.5), y = 0.95, yend = 0.95), colour = "grey40",
               arrow = arrow(length = unit(0.2, "cm"), type = "closed")) +
  annotate("text", x = 29, y = 3.0, hjust = 1, size = 4, colour = kol[["cynober"]], fontface = "bold",
           label = "Uwaga: kowariant X\nnie może pochodzić\nz okresu testu", lineheight = 0.95) +
  scale_fill_manual(values = c(przed = kol[["jasny"]], test = kol[["jasny2"]]), guide = "none") +
  coord_cartesian(xlim = c(-30, 30), ylim = c(0.22, 3.6), expand = FALSE) +
  labs(title = "CUPED w trzech krokach: historia klienta zmniejsza szum w wyniku testu",
       subtitle = "Fikcyjna księgarnia internetowa; X i Y to wydatki tego samego klienta w dwóch okresach") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(),
                panel.grid.major = element_blank(), panel.grid.minor = element_blank())
p1   # zapis: ggsave("cuped-schemat.svg", p1, width = 10, height = 5.6)
2. Dane: wydatki przed testem i w teście – Rysunek 2
R
# Rysunek 2. Wydatki klienta przed testem i w czasie testu (dane symulowane)
# Dane wejściowe: paleta kol i motyw z przepisu 1.
# Fikcyjna księgarnia internetowa. Parametry ustalone ręcznie:
# tempo zamówień klienta ~ Gamma(kształt 0.5, średnio 0.3 zamówienia na tydzień) – stałe dla klienta,
# tygodniowe wahania tempa (log-SD 0.5), typowa kwota zamówienia klienta 75 zł (log-SD 0.4),
# wahania kwoty (log-SD 0.25), prawdziwy efekt wersji B: +8% zamówień w czasie testu.
symuluj_klientow <- function(n, tyg_przed = 4, efekt = 0.08) {
  tempo <- rgamma(n, shape = 0.5, rate = 0.5 / 0.3)        # zamówienia na tydzień
  kwota <- 75 * exp(0.4 * rnorm(n) - 0.08)                  # typowa kwota zamówienia (zł)
  grupa <- sample(rep(c("A", "B"), length.out = n))         # losowanie 1:1
  tydzien <- function(mnoznik = 1) {                        # wydatki w jednym tygodniu
    z <- rpois(n, tempo * exp(0.5 * rnorm(n) - 0.125) * mnoznik)
    z * kwota * exp(0.25 * rnorm(n) - 0.03125)               # 0 zamówień = 0 zł
  }
  przed <- sapply(seq_len(tyg_przed), function(i) tydzien())       # kolumna 1 = tydzień tuż przed startem
  m <- ifelse(grupa == "B", 1 + efekt, 1)
  data.frame(grupa, przed = round(przed, 2), tydz1 = round(tydzien(m), 2), tydz2 = round(tydzien(m), 2))
}
efekt_prawdziwy <- 0.08 * 0.3 * 2 * 75   # 8% z oczekiwanych wydatków w 2 tygodniach (0.6 zamówienia × 75 zł)

set.seed(613)                                  # ziarno ustalone raz, bez dobierania pod wynik
s <- symuluj_klientow(16000)
dane <- data.frame(klient = seq_len(nrow(s)), grupa = s$grupa,
                   wydatki_przed = rowSums(s[, paste0("przed.", 1:4)]),   # X: 4 tygodnie przed testem
                   wydatki_tydz1 = s$tydz1, wydatki_tydz2 = s$tydz2)
dane$wydatki_test <- dane$wydatki_tydz1 + dane$wydatki_tydz2               # Y: 2 tygodnie testu
write.csv(dane, "cuped-ksiegarnia-test.csv", row.names = FALSE)

c(klienci = nrow(dane), w_grupie_B = sum(dane$grupa == "B"), efekt_prawdziwy = efekt_prawdziwy)
opis <- sapply(dane[c("wydatki_przed", "wydatki_test")], function(v)
  c(srednia = mean(v), SD = sd(v), mediana = median(v), zero_proc = 100 * mean(v == 0), p99 = unname(quantile(v, .99))))
round(opis, 2)
r <- cor(dane$wydatki_przed, dane$wydatki_test)
theta <- cov(dane$wydatki_przed, dane$wydatki_test) / var(dane$wydatki_przed)
round(c(r = r, theta = theta, redukcja_wariancji_proc = 100 * r^2), 3)

# Wykres: losowe 1000 klientów (czytelność), linia CUPED i średnie Y w przedziałach X (wszyscy klienci)
set.seed(613)
proba <- dane[sample(nrow(dane), 1000), ]
dane$przedzial <- cut(dane$wydatki_przed, c(-1, 0, 50, 100, 150, 200, 300, 400, 600, Inf))
srednie <- aggregate(cbind(x = wydatki_przed, y = wydatki_test) ~ przedzial, data = dane, FUN = mean)
srednie <- srednie[srednie$x < 600, ]
mx <- mean(dane$wydatki_przed); my <- mean(dane$wydatki_test)
c(poza_osiami_proc = round(100 * mean(dane$wydatki_przed > 600 | dane$wydatki_test > 400), 1))
p2 <- ggplot(proba, aes(wydatki_przed, wydatki_test)) +
  geom_point(aes(colour = "pojedynczy klient (losowe 1000)", shape = "pojedynczy klient (losowe 1000)"),
             alpha = 0.35, size = 1.6, position = position_jitter(width = 2, height = 2, seed = 613)) +
  geom_abline(intercept = my - theta * mx, slope = theta, colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_point(data = srednie, aes(x, y, colour = "średnia Y w przedziale X (wszyscy)",
                                 shape = "średnia Y w przedziale X (wszyscy)"), size = 3.4) +
  annotate("text", x = 430, y = my + theta * (430 - mx) + 45, size = 4, colour = kol[["niebieski"]],
           fontface = "bold", label = sprintf("nachylenie θ = %.2f\nr = %.2f", theta, r)) +
  scale_colour_manual(values = c("pojedynczy klient (losowe 1000)" = "grey45",
                                 "średnia Y w przedziale X (wszyscy)" = kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c("pojedynczy klient (losowe 1000)" = 16,
                                "średnia Y w przedziale X (wszyscy)" = 18), name = NULL) +
  coord_cartesian(xlim = c(0, 600), ylim = c(0, 400)) +
  labs(x = "Wydatki w 4 tygodniach przed testem, X (zł)", y = "Wydatki w 2 tygodniach testu, Y (zł)",
       title = "Kto wydawał dużo przed testem, wydaje dużo w teście",
       subtitle = sprintf("%d klientów; niebieska prosta: Y przewidywane z X (nachylenie θ)", nrow(dane))) + motyw
p2   # zapis: ggsave("cuped-wydatki-przed-i-w-tescie.svg", p2, width = 10, height = 6)
Wynik w R
        klienci      w_grupie_B efekt_prawdziwy
        16000.0          8000.0             3.6
          wydatki_przed wydatki_test
srednia           89.98        47.06
SD               175.05       112.43
mediana            0.00         0.00
zero_proc         54.74        67.86
p99              830.09       493.18
                      r                   theta redukcja_wariancji_proc
                  0.557                   0.358                  31.051
poza_osiami_proc
             3.3
3. CUPED, ANCOVA i wariant z interakcją: Rysunek 3
R
# Rysunek 3. Efekt wersji B: zwykła różnica średnich, CUPED i ANCOVA (te same dane)
# Dane wejściowe: dane, theta, efekt_prawdziwy, kol i motyw z przepisów 1–2.
library(sandwich)                                     # odporne błędy standardowe (wariant z interakcją)
X <- dane$wydatki_przed; Y <- dane$wydatki_test; B <- dane$grupa == "B"

# CUPED: Y_cuped = Y − θ (X − średnia X); θ liczone na wszystkich klientach razem (A i B)
dane$wydatki_cuped <- Y - theta * (X - mean(X))
round(c(sredniaY = mean(Y), sredniaY_cuped = mean(dane$wydatki_cuped),
        SD_Y = sd(Y), SD_Y_cuped = sd(dane$wydatki_cuped)), 2)
round(c(proc_wariancji_po_korekcie = 100 * var(dane$wydatki_cuped) / var(Y)), 1)

roznica <- function(y) {                              # różnica średnich B − A z 95% CI (test Welcha)
  t <- t.test(y[B], y[!B])
  c(efekt = unname(-diff(t$estimate)), dolna = t$conf.int[1], gorna = t$conf.int[2], p = t$p.value)
}
m_ancova <- lm(wydatki_test ~ grupa + wydatki_przed, data = dane)
dane$xc <- X - mean(X)                                # wariant z interakcją grupa × X i odpornym SE (HC2)
m_lin <- lm(wydatki_test ~ grupa * xc, data = dane)
se_lin <- sqrt(diag(vcovHC(m_lin, type = "HC2")))[["grupaB"]]
wyniki <- rbind(
  "bez korekty (różnica średnich Y)" = roznica(Y),
  "CUPED (różnica średnich Y_cuped)" = roznica(dane$wydatki_cuped),
  "ANCOVA: lm(Y ~ grupa + X)" = c(coef(m_ancova)[["grupaB"]], confint(m_ancova)["grupaB", ],
                                  summary(m_ancova)$coefficients["grupaB", 4]),
  "ANCOVA z interakcją, odporne SE" = c(coef(m_lin)[["grupaB"]], coef(m_lin)[["grupaB"]] + c(-1, 1) * qnorm(.975) * se_lin,
                                        2 * pnorm(-abs(coef(m_lin)[["grupaB"]] / se_lin))))
wyniki <- data.frame(metoda = rownames(wyniki), wyniki, row.names = NULL)
wyniki$szerokosc <- wyniki$gorna - wyniki$dolna
wyniki$wzrost_proc <- 100 * wyniki$efekt / mean(Y[!B])          # efekt względem średniej w grupie A
print(transform(wyniki, efekt = round(efekt, 2), dolna = round(dolna, 2), gorna = round(gorna, 2),
                p = round(p, 4), szerokosc = round(szerokosc, 2), wzrost_proc = round(wzrost_proc, 1)), row.names = FALSE)
round(c(srednia_A = mean(Y[!B]), srednia_B = mean(Y[B]),
        X_A = mean(X[!B]), X_B = mean(X[B]),
        stosunek_szerokosci = wyniki$szerokosc[2] / wyniki$szerokosc[1],
        rownowazna_liczba_klientow = nrow(dane) * var(dane$wydatki_cuped) / var(Y)), 2)

wyniki$metoda <- factor(wyniki$metoda, levels = rev(wyniki$metoda))
wyniki$rodzaj <- ifelse(grepl("bez", wyniki$metoda), "bez danych sprzed testu", "z danymi sprzed testu")
p3 <- ggplot(wyniki, aes(efekt, metoda, colour = rodzaj, shape = rodzaj)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 1, orientation = "y") +
  geom_point(size = 3.6) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_vline(xintercept = efekt_prawdziwy, colour = "grey30", linetype = "dashed") +
  annotate("text", x = efekt_prawdziwy, y = 4.5, label = sprintf("prawdziwy efekt: %.2f zł", efekt_prawdziwy),
           hjust = -0.05, size = 3.8, colour = "grey25") +
  geom_text(aes(x = gorna, label = gsub("-", "\u2212", sprintf("%.2f [%.2f, %.2f]\nszerokość %.2f zł", efekt, dolna, gorna, szerokosc))),
            hjust = -0.12, size = 3.7, lineheight = 0.95, show.legend = FALSE) +
  scale_colour_manual(values = c("bez danych sprzed testu" = kol[["cynober"]],
                                 "z danymi sprzed testu" = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c("bez danych sprzed testu" = 17, "z danymi sprzed testu" = 16), name = NULL) +
  scale_x_continuous(breaks = seq(-2, 10, 2), labels = function(v) gsub("-", "\u2212", v)) +
  coord_cartesian(xlim = c(-2.5, 11), ylim = c(0.7, 4.6)) +
  labs(x = "Różnica wydatków w teście, B − A (zł na klienta), z 95% CI", y = NULL,
       title = "Ten sam test, cztery analizy: dane sprzed testu zwężają przedział",
       subtitle = "16000 klientów; przerywana linia: efekt ukryty w danych symulowanych") + motyw
p3   # zapis: ggsave("cuped-przedzialy.svg", p3, width = 10, height = 5.6)
Wynik w R
      sredniaY sredniaY_cuped           SD_Y     SD_Y_cuped
         47.06          47.06         112.43          93.36
proc_wariancji_po_korekcie
                      68.9
                           metoda efekt dolna gorna      p szerokosc
 bez korekty (różnica średnich Y)  3.30 -0.18  6.79 0.0633      6.97
 CUPED (różnica średnich Y_cuped)  2.82 -0.07  5.71 0.0562      5.79
        ANCOVA: lm(Y ~ grupa + X)  2.82 -0.07  5.71 0.0562      5.79
  ANCOVA z interakcją, odporne SE  2.82 -0.07  5.70 0.0557      5.77
 wzrost_proc
         7.3
         6.2
         6.2
         6.2
                 srednia_A                  srednia_B
                     45.41                      48.71
                       X_A                        X_B
                     89.31                      90.66
       stosunek_szerokosci rownowazna_liczba_klientow
                      0.83                   11031.91
4. Symulacja 1000 testów: Rysunek 4
R
# Rysunek 4. 1000 symulowanych testów: im wyższa korelacja przed–po, tym mniej klientów potrzeba
# Dane wejściowe: funkcja symuluj_klientow(), efekt_prawdziwy, kol i motyw z przepisów 1–2.
# Każdy test: 16000 nowych klientów, 12 tygodni historii, ten sam prawdziwy efekt (+8% zamówień).
analiza <- function(y, x, B) {                       # efekt B − A po korekcie CUPED kowariantem x
  if (!is.null(x)) y <- y - cov(x, y) / var(x) * (x - mean(x))
  ef <- mean(y[B]) - mean(y[!B])
  se <- sqrt(var(y[B]) / sum(B) + var(y[!B]) / sum(!B))
  c(efekt = ef, se = se, istotny = abs(ef / se) > qnorm(.975),
    pokrywa = abs(ef - efekt_prawdziwy) < qnorm(.975) * se)
}
set.seed(6130)                                       # osobne ziarno symulacji, ustalone raz
R <- 1000
wyniki <- vector("list", R)
for (i in seq_len(R)) {
  s <- symuluj_klientow(16000, tyg_przed = 12)
  P <- as.matrix(s[, paste0("przed.", 1:12)])        # kolumna 1 = tydzień tuż przed startem
  y <- s$tydz1 + s$tydz2; B <- s$grupa == "B"
  kowarianty <- list("bez korekty" = NULL,
                     "X losowo przypisane (r ≈ 0)" = sample(rowSums(P[, 1:4])),   # historia innego klienta
                     "1 tydzień historii" = P[, 1], "2 tygodnie" = rowSums(P[, 1:2]),
                     "4 tygodnie" = rowSums(P[, 1:4]), "8 tygodni" = rowSums(P[, 1:8]),
                     "12 tygodni" = rowSums(P),
                     "BŁĄD: 1. tydzień testu" = s$tydz1)                # kowariant zmierzony po starcie
  wyniki[[i]] <- t(sapply(kowarianty, function(x)
    c(r = if (is.null(x)) NA else cor(x, y), analiza(y, x, B))))
}
sym <- data.frame(test = rep(seq_len(R), each = length(kowarianty)),
                  wariant = factor(rep(names(kowarianty), R), levels = names(kowarianty)),
                  do.call(rbind, wyniki), row.names = NULL)
podsum <- do.call(rbind, lapply(split(sym, sym$wariant), function(d) data.frame(
  wariant = d$wariant[1], r = mean(d$r), srednia_efektu = mean(d$efekt), sd_efektu = sd(d$efekt),
  wariancja_proc = 100 * var(d$efekt) / var(sym$efekt[sym$wariant == "bez korekty"]),
  moc_proc = 100 * mean(d$istotny), blad_MC_moc = 100 * sqrt(mean(d$istotny) * (1 - mean(d$istotny)) / nrow(d)),
  pokrycie_proc = 100 * mean(d$pokrywa))))
podsum$dni_zamiast_14 <- 14 * podsum$wariancja_proc / 100   # gdy klienci napływają w stałym tempie
print(transform(podsum, r = round(r, 3), srednia_efektu = round(srednia_efektu, 2), sd_efektu = round(sd_efektu, 2),
                wariancja_proc = round(wariancja_proc, 1), moc_proc = round(moc_proc, 1),
                blad_MC_moc = round(blad_MC_moc, 1), pokrycie_proc = round(pokrycie_proc, 1),
                dni_zamiast_14 = round(dni_zamiast_14, 1)), row.names = FALSE)

# Panel A: ile procent klientów (lub dni zbierania danych) potrzeba do tej samej precyzji – teoria 1 − r² i symulacja
ok <- podsum[!podsum$wariant %in% c("bez korekty", "BŁĄD: 1. tydzień testu"), ]
ok$etykieta <- sub(" historii", "", sub("X losowo przypisane \\(r ≈ 0\\)", "losowe X", ok$wariant))
ok$hj <- c(-0.25, -0.15, -0.15, -0.15, -0.15, 1.15); ok$vj <- c(0.5, -0.6, -0.6, -0.6, -0.6, 1.6)   # położenie etykiet
krzywa <- data.frame(r = seq(0, 0.95, 0.01)); krzywa$proc <- 100 * (1 - krzywa$r^2)
pA <- ggplot(krzywa, aes(r, proc)) +
  geom_line(aes(linetype = "teoria: 100 × (1 − r²)"), colour = kol[["szary"]], linewidth = 1) +
  geom_point(data = ok, aes(r, wariancja_proc, shape = "symulacja: 1000 testów"), colour = kol[["niebieski"]], size = 3.2) +
  geom_text(data = ok, aes(r, wariancja_proc, label = etykieta, hjust = hj, vjust = vj),
            colour = kol[["niebieski"]], size = 3.5) +
  scale_y_continuous(limits = c(0, 105), breaks = seq(0, 100, 20),
                     sec.axis = sec_axis(~ . * 14 / 100, name = "Dni testu zamiast 14", breaks = seq(0, 14, 2))) +
  scale_x_continuous(breaks = seq(0, 0.9, 0.3), labels = c("0", ".3", ".6", ".9")) +
  scale_linetype_manual(values = "solid", name = NULL) + scale_shape_manual(values = 16, name = NULL) +
  labs(x = "Korelacja X z wynikiem testu, r", y = "Klienci potrzebni do tej samej precyzji (%)",
       title = "A. Ile danych oszczędza CUPED") + motyw + theme(legend.direction = "vertical")
# Panel B: moc testu (odsetek 1000 testów z p < .05) z błędem Monte Carlo
mocdf <- podsum[podsum$wariant != "BŁĄD: 1. tydzień testu", ]
mocdf$wariant <- factor(mocdf$wariant, levels = rev(levels(droplevels(mocdf$wariant))))
mocdf$rodzaj <- ifelse(mocdf$wariant %in% c("bez korekty", "X losowo przypisane (r ≈ 0)"), "bez użytecznej historii", "CUPED z historią")
pB <- ggplot(mocdf, aes(moc_proc, wariant, colour = rodzaj, shape = rodzaj)) +
  geom_errorbar(aes(xmin = moc_proc - 1.96 * blad_MC_moc, xmax = moc_proc + 1.96 * blad_MC_moc),
                width = 0.3, orientation = "y") +
  geom_point(size = 3.2) +
  geom_text(aes(x = moc_proc + 1.96 * blad_MC_moc + 1, label = sprintf("%.1f%%", moc_proc)), hjust = 0,
            size = 3.5, show.legend = FALSE) +
  scale_colour_manual(values = c("bez użytecznej historii" = kol[["cynober"]], "CUPED z historią" = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c("bez użytecznej historii" = 17, "CUPED z historią" = 16), name = NULL) +
  scale_x_continuous(limits = c(40, 95), breaks = seq(40, 90, 10)) +
  labs(x = "Moc: testy z p < .05 (%), ± 1.96 błędu MC", y = NULL, title = "B. Moc przy 16000 klientów") +
  motyw + theme(legend.direction = "vertical")
library(patchwork)
p4 <- pA + pB + plot_annotation(
  title = "1000 testów z tym samym efektem (+8% zamówień): korekta zależy od korelacji",
  subtitle = "Dłuższa historia → wyższe r → mniej klientów lub krótszy test; losowe X nie szkodzi, ale nie pomaga",
  theme = motyw)
p4   # zapis: ggsave("cuped-symulacja-korelacja.svg", p4, width = 10, height = 6.4)
Wynik w R
                     wariant     r srednia_efektu sd_efektu wariancja_proc
                 bez korekty    NA           3.61      1.71          100.0
 X losowo przypisane (r ≈ 0) 0.000           3.61      1.71          100.0
          1 tydzień historii 0.393           3.65      1.55           82.0
                  2 tygodnie 0.485           3.64      1.46           73.0
                  4 tygodnie 0.563           3.64      1.39           65.9
                   8 tygodni 0.620           3.64      1.30           57.6
                  12 tygodni 0.643           3.64      1.27           54.8
      BŁĄD: 1. tydzień testu 0.814           1.26      0.97           32.4
 moc_proc blad_MC_moc pokrycie_proc dni_zamiast_14
     58.5         1.6          94.9           14.0
     58.4         1.6          94.9           14.0
     67.2         1.5          95.0           11.5
     70.5         1.4          95.1           10.2
     74.7         1.4          95.1            9.2
     78.7         1.3          95.3            8.1
     80.9         1.2          95.1            7.7
     25.2         1.4          33.7            4.5
5. Pułapka – kowariant z okresu testu: Rysunek 5
R
# Rysunek 5. Pułapka: kowariant zmierzony już w czasie testu „zjada” efekt
# Dane wejściowe: sym, podsum (1000 testów z przepisu 4), efekt_prawdziwy, kol i motyw. Ten przepis nie losuje.
wybrane <- c("bez korekty", "4 tygodnie", "BŁĄD: 1. tydzień testu")
d5 <- sym[sym$wariant %in% wybrane, ]
d5$panel <- factor(c("bez korekty" = "Bez korekty",
                     "4 tygodnie" = "CUPED: X = 4 tygodnie przed testem",
                     "BŁĄD: 1. tydzień testu" = "Błąd: X = wydatki z 1. tygodnia testu")[as.character(d5$wariant)],
                   levels = c("Bez korekty", "CUPED: X = 4 tygodnie przed testem", "Błąd: X = wydatki z 1. tygodnia testu"))
opis5 <- aggregate(cbind(efekt, pokrywa) ~ panel, data = d5, FUN = mean)
opis5$blad_MC_pokrycia <- sqrt(opis5$pokrywa * (1 - opis5$pokrywa) / 1000)
print(transform(opis5, efekt = round(efekt, 2), pokrywa = round(100 * pokrywa, 1),
                blad_MC_pokrycia = round(100 * blad_MC_pokrycia, 1)), row.names = FALSE)
opis5$etykieta <- sprintf("średnio %.2f zł\nCI obejmuje prawdziwy efekt: %.1f%%", opis5$efekt, 100 * opis5$pokrywa)
p5 <- ggplot(d5, aes(efekt, fill = panel)) +
  geom_histogram(binwidth = 0.4, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = efekt_prawdziwy, linetype = "dashed", colour = "grey20") +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_text(data = opis5, aes(x = 6.2, y = Inf, label = etykieta), hjust = 0, vjust = 1.4, size = 3.6,
            lineheight = 0.95, inherit.aes = FALSE) +
  facet_wrap(~ panel, ncol = 1) +
  scale_fill_manual(values = c(kol[["cynober"]], kol[["niebieski"]], kol[["szary"]]), guide = "none") +
  scale_x_continuous(breaks = seq(-2, 10, 2), labels = function(v) gsub("-", "−", v)) +
  coord_cartesian(xlim = c(-2.5, 11)) +
  labs(x = "Oszacowany efekt wersji B (zł na klienta)", y = "Liczba testów",
       title = "Kowariant z okresu testu przesuwa wynik do zera",
       subtitle = sprintf("Te same 1000 testów; przerywana linia: prawdziwy efekt %.2f zł", efekt_prawdziwy)) + motyw
p5   # zapis: ggsave("cuped-pulapka-kowariant-z-testu.svg", p5, width = 10, height = 6.6)
Wynik w R
                                 panel efekt pokrywa blad_MC_pokrycia
                           Bez korekty  3.61    94.9              0.7
    CUPED: X = 4 tygodnie przed testem  3.64    95.1              0.7
 Błąd: X = wydatki z 1. tygodnia testu  1.26    33.7              1.5
6. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (bez korekty / CUPED)" = c("#D55E00", "#0072B2"),
             "niebieski – szary (CUPED / błąd; linia / punkty)" = c("#0072B2", "#999999"),
             "cynober – szary (bez korekty / błąd; średnie / punkty)" = c("#D55E00", "#999999"),
             "jasnoniebieski – jasnopomarańczowy (okresy na schemacie)" = c("#DCEBF5", "#FBE3D3"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                         widzenie_typowe
cynober – niebieski (bez korekty / CUPED)                          114.6
niebieski – szary (CUPED / błąd; linia / punkty)                    44.9
cynober – szary (bez korekty / błąd; średnie / punkty)              77.2
jasnoniebieski – jasnopomarańczowy (okresy na schemacie)            19.4
czerwony – zielony (do unikania)                                   121.7
                                                         deuteranopia
cynober – niebieski (bez korekty / CUPED)                       108.3
niebieski – szary (CUPED / błąd; linia / punkty)                 48.9
cynober – szary (bez korekty / błąd; średnie / punkty)           62.9
jasnoniebieski – jasnopomarańczowy (okresy na schemacie)         18.9
czerwony – zielony (do unikania)                                 21.1
                                                         protanopia
cynober – niebieski (bez korekty / CUPED)                      91.9
niebieski – szary (CUPED / błąd; linia / punkty)               40.6
cynober – szary (bez korekty / błąd; średnie / punkty)         56.0
jasnoniebieski – jasnopomarańczowy (okresy na schemacie)       16.0
czerwony – zielony (do unikania)                               31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, kowariancja, test t Welcha, regresja liniowa – pakiety base i stats). Odporny błąd standardowy policzono pakietem sandwich. Rysunki wykonano w ggplot2 (panele – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Kowariant zmierzony po starcie testu. Obciąża efekt w stronę zera, choć przedział wygląda na wąski (rysunek 5).
- Szukanie kowariantu po zobaczeniu wyników. Kilka wersji korekty i wybór tej z najmniejszym p to ukryte wielokrotne testowanie. Kowariant wpisz do planu przed startem.
- Raportowanie średnich Ycuped jako „wydatków”. Skorygowane wartości służą do porównania grup. Średnie wydatki podaj z surowych danych.
- Oczekiwanie istotności „z automatu”. Przy r = .56 korekta zastępuje ok. jedną trzecią klientów – nie zamienia za małego testu w duży (rysunek 3).
- Korekta, gdy grupy nie były losowane. Przy grupach istniejących ANCOVA, a więc i CUPED, nie „wyrównuje” różnic – zob. hasło ANCOVA, sekcja o grupach nierandomizowanych.
Pomoc przy planie i analizie takiego testu: analizy statystyczne dla studentów.
Najczęstsze pytania
Co to jest CUPED w testach A/B?
CUPED (Controlled-experiment Using Pre-Experiment Data) to korekta wyniku testu A/B o dane tego samego użytkownika sprzed testu, np. wydatki z poprzednich tygodni. Od wyniku odejmuje się θ(X − MX), gdzie θ = cov(X, Y)/var(X). Efekt pozostaje ten sam, a wariancja spada, więc test jest czulszy (Deng i in., 2013).
Czym CUPED różni się od ANCOVA?
Przy jednym kowariancie i θ liczonym na obu grupach razem CUPED daje ten sam efekt i przedział co ANCOVA, czyli lm(Y ~ grupa + X). W przykładzie obie metody dały 2.82 zł, 95% CI [−0.07, 5.71]. CUPED to po prostu zapis ANCOVA wygodny przy milionach użytkowników: najpierw korekta, potem zwykłe porównanie średnich.
O ile CUPED skraca test A/B?
Mniej więcej do 1 − r2 pierwotnej liczby użytkowników, gdzie r to korelacja kowariantu z wynikiem. W symulacji przy r = .56 zostało 65.9% wariancji, czyli ok. 9.2 dnia zamiast 14, jeśli użytkownicy napływają w stałym tempie. Przy r poniżej .3 zysk jest niewielki.
Jaką zmienną wybrać jako kowariant w CUPED?
Najlepiej tę samą metrykę zmierzoną przed testem, np. wydatki z ostatnich 4–8 tygodni. Kowariant musi powstać przed losowaniem i nie może zależeć od wersji. Wydatki z pierwszego tygodnia testu obniżyły w symulacji średni efekt z 3.60 do 1.26 zł, a 95% CI obejmowały prawdziwy efekt tylko w 33.7% testów.
Czy CUPED działa dla konwersji i nowych użytkowników?
Dla metryki 0/1 (konwersja) wzór jest ten sam, a zysk zależy od tego, jak dobrze historia przewiduje konwersję. Nowi użytkownicy nie mają historii: wpisz im X = 0 i dodaj wskaźnik „nowy użytkownik” albo analizuj ich osobno. Im więcej nowych użytkowników, tym mniejsza redukcja wariancji.
Powiązane hasła
Przeczytaj też
Test A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →PoradnikPułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikWskaźniki ilorazowe w testach A/B – CTR i średni koszyk
Losujesz użytkowników, a liczysz wyświetlenia i zamówienia: naiwny przedział, metoda delta, bootstrap po użytkownikach i 1000 testów A/A – z kodem R.
Czytaj →Planujesz test A/B do pracy?
Pomożemy dobrać metrykę i kowariant, policzyć liczebność z uwzględnieniem korekty, przeprowadzić analizę w R i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Borm, G. F., Fransen, J., & Lemmens, W. A. J. G. (2007). A simple sample size formula for analysis of covariance in randomized clinical trials. Journal of Clinical Epidemiology, 60(12), 1234–1238. https://doi.org/10.1016/j.jclinepi.2007.02.006
- Deng, A., Xu, Y., Kohavi, R., & Walker, T. (2013). Improving the sensitivity of online controlled experiments by utilizing pre-experiment data. In Proceedings of the Sixth ACM International Conference on Web Search and Data Mining (pp. 123–132). ACM. https://doi.org/10.1145/2433396.2433413
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Lin, W. (2013). Agnostic notes on regression adjustments to experimental data: Reexamining Freedman’s critique. The Annals of Applied Statistics, 7(1), 295–318. https://doi.org/10.1214/12-aoas583 ● Otwarty dostęp
- Xie, H., & Aurisset, J. (2016). Improving the sensitivity of online controlled experiments: Case studies at Netflix. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 645–654). ACM. https://doi.org/10.1145/2939672.2939733 ● Otwarty dostęp
- Yang, L., & Tsiatis, A. A. (2001). Efficiency study of estimators for a treatment effect in a pretest–posttest trial. The American Statistician, 55(4), 314–321. https://doi.org/10.1198/000313001753272466
Cytowania BibTeX
@article{borm2007simple, author={Borm, George F. and Fransen, Jaap and Lemmens, Wim A. J. G.}, title={{A simple sample size formula for analysis of covariance in randomized clinical trials}}, journal={Journal of Clinical Epidemiology}, year={2007}, volume={60}, number={12}, pages={1234--1238}, doi={10.1016/j.jclinepi.2007.02.006}}@inproceedings{deng2013improving, author={Deng, Alex and Xu, Ya and Kohavi, Ron and Walker, Toby}, title={{Improving the sensitivity of online controlled experiments by utilizing pre-experiment data}}, booktitle={Proceedings of the Sixth ACM International Conference on Web Search and Data Mining}, year={2013}, pages={123--132}, publisher={ACM}, doi={10.1145/2433396.2433413}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@article{lin2013agnostic, author={Lin, Winston}, title={{Agnostic notes on regression adjustments to experimental data: Reexamining Freedman’s critique}}, journal={The Annals of Applied Statistics}, year={2013}, volume={7}, number={1}, pages={295--318}, doi={10.1214/12-aoas583}}@inproceedings{xie2016improving, author={Xie, Huizhi and Aurisset, Juliette}, title={{Improving the sensitivity of online controlled experiments: Case studies at Netflix}}, booktitle={Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining}, year={2016}, pages={645--654}, publisher={ACM}, doi={10.1145/2939672.2939733}}@article{yang2001efficiency, author={Yang, Li and Tsiatis, Anastasios A.}, title={{Efficiency study of estimators for a treatment effect in a pretest–posttest trial}}, journal={The American Statistician}, year={2001}, volume={55}, number={4}, pages={314--321}, doi={10.1198/000313001753272466}}