Przykład: sklep sportowy i blok „Kompletuj zestaw”
Internetowy sklep ze sprzętem sportowym testuje nową kartę produktu. Wersja B ma pod zdjęciem blok „Kompletuj zestaw” z trzema dopasowanymi produktami. Przez 14 dni każdy nowy użytkownik losowo trafia do wersji A albo B i zostaje w niej przy każdej wizycie. To test A/B, w którym losujemy użytkowników.
Dział marketingu pyta o dwie liczby. CTR bloku polecanych produktów to kliknięcia podzielone przez wyświetlenia bloku. Średni koszyk to przychód podzielony przez liczbę zamówień. Obie są wskaźnikami ilorazowymi: licznik i mianownik to sumy zliczane w jednostkach mniejszych niż użytkownik.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. W wersji B prawdziwy CTR wynosi 4.4% zamiast 4.0%, a prawdziwy koszyk jest o 4% wyższy. Każdy użytkownik ma własną skłonność do klikania i poziom koszyka; parametry, także 8000 użytkowników na wersję, ustawiliśmy ręcznie (szczegóły przy kodzie). Ziarno 614 ustalono raz i nie zmieniano go. Dane pobierzesz jako wskazniki-ilorazowe-uzytkownicy.csv (jeden wiersz na użytkownika) i wskazniki-ilorazowe-zamowienia.csv (jeden wiersz na zamówienie).
| Wersja | Użytkownicy | Wyświetlenia | Kliknięcia | CTR | Zamówienia | Przychód (zł) | Średni koszyk (zł) |
|---|---|---|---|---|---|---|---|
| A | 8000 | 56 383 | 2319 | 4.11% | 1524 | 374 186 | 245.53 |
| B | 8000 | 55 693 | 2447 | 4.39% | 1529 | 378 228 | 247.37 |
Plan testu i analizę zwykłej konwersji opisuje wpis test A/B – plan i analiza. Tu zajmujemy się jednym problemem: jak policzyć przedział ufności dla różnicy dwóch ilorazów, gdy losowaliśmy ludzi, a liczymy wyświetlenia i zamówienia.
Rysunek 1: kto jest jednostką?
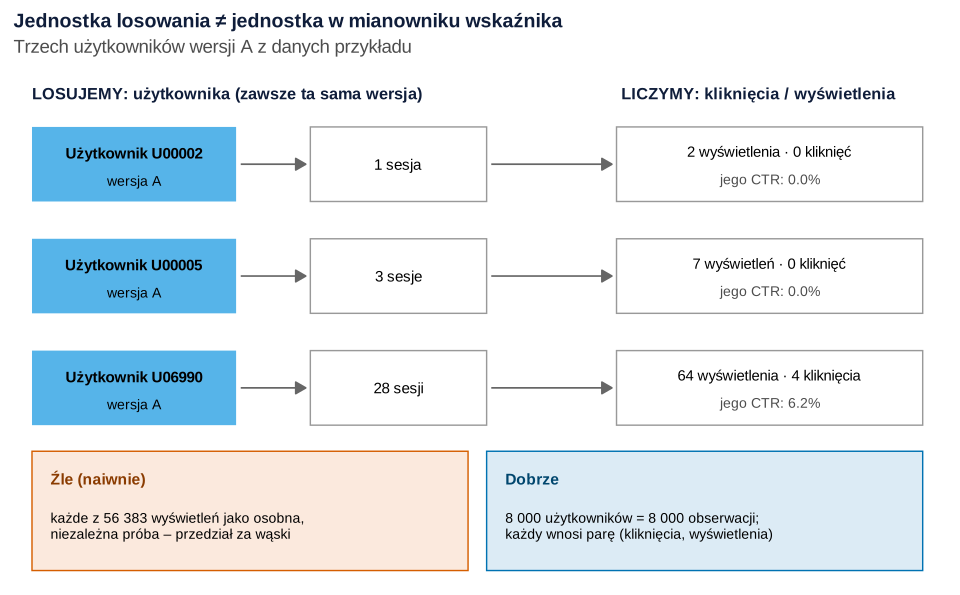
set.seed(614)).Co widać. Losujemy użytkownika, a on sam decyduje, ile razy wróci. U00002 zobaczył blok dwa razy, U06990 – 64 razy w 28 sesjach, czyli tyle, co 32 osoby takie jak U00002. Mediana to 5 wyświetleń na osobę, maksimum 70.
Naiwna analiza liczy CTR jak odsetek z 56 383 niezależnych rzutów monetą. Tymczasem wyświetlenia jednej osoby są do siebie podobne: ktoś, kto nie lubi poleceń, nie kliknie ani razu w 64 wyświetleniach. To pseudoreplikacja – test z błędem niewłaściwym dla jednostki, którą przydzielono do warunku (Hurlbert, 1984).
Jak może zmylić. Schemat pokazuje tylko trzy osoby. Sedno nie leży w liczbie sesji, tylko w tym, że ludzie różnią się skłonnością do klikania (rysunek 2).
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: ludzie różnią się bardziej niż rzut monetą
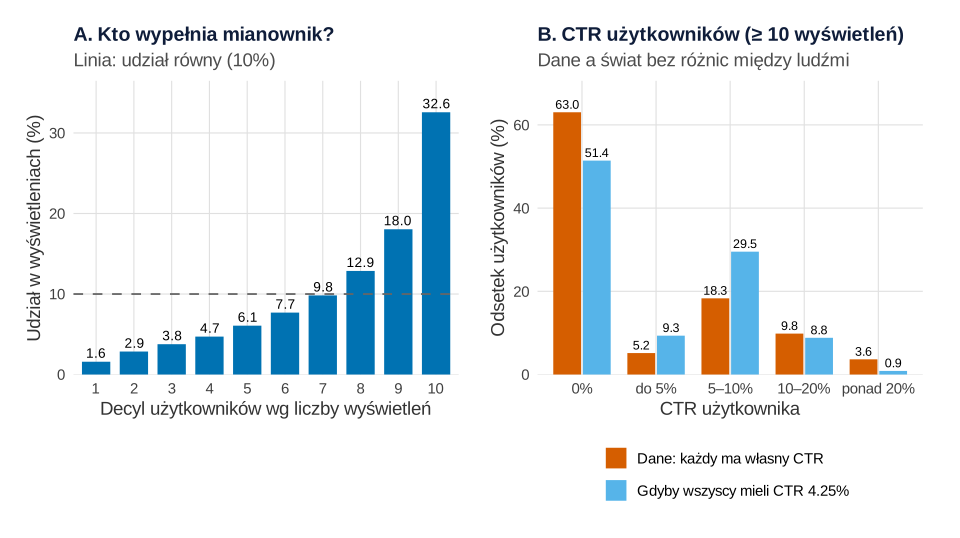
set.seed(614)).Co widać. Panel A: 10% najbardziej aktywnych użytkowników daje 32.6% wyświetleń, czyli jedną trzecią mianownika CTR. Panel B porównuje dane ze światem, w którym każdy ma CTR 4.25%. W danych więcej osób nie klika wcale (63.0% wobec 51.4%) i więcej klika często (3.6% wobec 0.9% powyżej 20%). Odchylenie standardowe CTR użytkowników wynosi 7.12 pp zamiast 5.25 pp.
Jak może zmylić. Skoro część kliknięć pochodzi od tych samych „klikaczy”, 56 383 wyświetlenia niosą mniej informacji niż tyle samo niezależnych prób. O ile mniej, mówi efekt schematu – w tym teście 1.79 dla CTR (rysunek 3). Średni koszyk ma ten problem w mniejszej skali: 38.3% zamówień złożyli klienci z co najmniej dwoma zamówieniami.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: ta sama różnica, trzy przedziały
Iloraz sum to to samo co iloraz średnich na użytkownika: CTR = (średnia liczba kliknięć na osobę) / (średnia liczba wyświetleń na osobę). Każdy użytkownik wnosi parę liczb – y (kliknięcia albo przychód) i x (wyświetlenia albo zamówienia) – i to te pary są niezależne. Metoda delta przybliża wariancję funkcji średnich (Oehlert, 1992). Dla ilorazu R = ȳ / x̄ daje:
gdzie n to liczba użytkowników. Słowami: liczy się rozrzut liczników, rozrzut mianowników i to, jak bardzo idą w parze (kowariancja). Deng i in. (2018) na przykładach z dużych testów A/B pokazują, jak metodą delta radzić sobie z metrykami, których poziom agregacji utrudnia wnioskowanie. Drugi sposób to bootstrap po użytkownikach: losujemy ze zwracaniem całych ludzi, z ich wszystkimi wyświetleniami i zamówieniami, 2000 razy.
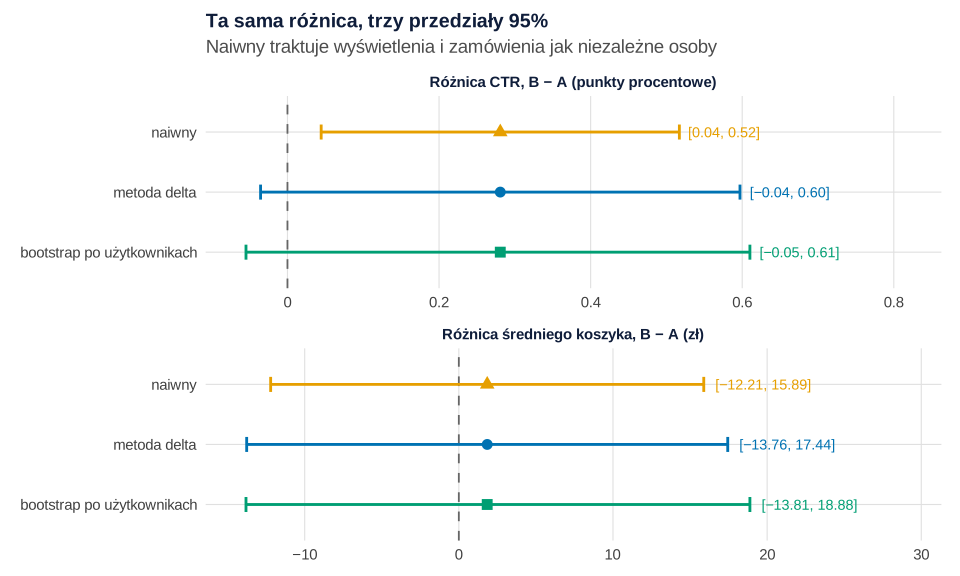
set.seed(614), 2000 prób bootstrapowych).Co widać. CTR wzrósł o 0.28 pp. Naiwny przedział dla proporcji wynosi [0.04, 0.52], a p = .020 – „wygrana B”. Metoda delta daje błąd standardowy 0.161 zamiast 0.121, przedział [−0.04, 0.60] i p = .082. Bootstrap: SE = 0.161, [−0.05, 0.61]. Naiwny SE jest 1.34 raza za mały, a kwadrat tej liczby (1.79) to efekt schematu. Dla koszyka różnica wynosi 1.84 zł, a naiwny SE jest za mały 1.11 raza.
Jak może zmylić. Prawdziwy efekt w danych istnieje (+0.4 pp), więc wynik znaczy: ten test nie rozstrzyga, a nie „brak efektu”. Naiwny wynik był istotny, bo przeszacował precyzję, a nie dlatego, że trafniej wykrył efekt. Prawdziwego wzrostu koszyka o 4% (ok. 10 zł) ten test nie wykryje żadną metodą – przedział ma ok. 31 zł szerokości.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: bootstrap po użytkownikach
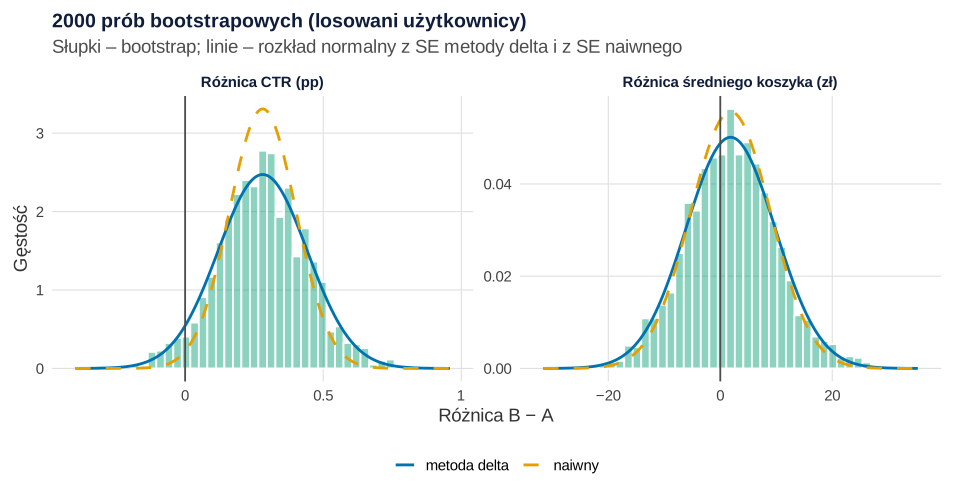
set.seed(614)).Co widać. Słupki to 2000 powtórzeń testu „na niby” z losowanymi ze zwracaniem użytkownikami. Krzywa metody delta leży na słupkach, a naiwna jest dla CTR wyraźnie za wąska i za wysoka. Rozkład jest prawie symetryczny (skośność −0.04 i 0.08), więc przybliżenie normalne działa. Efron (1979) pokazał bootstrap m.in. dla estymacji ilorazowej. Mechanikę losowania pokazuje wpis bootstrap – wizualizacja na obrazkach.
Jak może zmylić. Bootstrap jest poprawny tylko wtedy, gdy losujesz to, co było losowane. Losowanie pojedynczych wyświetleń odtworzyłoby błąd naiwny. Field i Welsh (2007) pokazują, że bootstrap całych klastrów daje zgodne oszacowania wariancji w obu rozważanych przez nich modelach danych pogrupowanych. Tu klastrem jest użytkownik.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: 1000 testów A/A
Jeden test nie oceni metody. Powtarzamy go więc 1000 razy jako test A/A: obie wersje są identyczne (CTR 4%, ten sam koszyk), a dobry 95% przedział powinien objąć zero w ok. 95% testów. Kohavi i in. (2020) podkreślają rolę testów wiarygodności, które ostrzegają o naruszonych założeniach; symulacja A/A jest takim sprawdzianem dla metody.
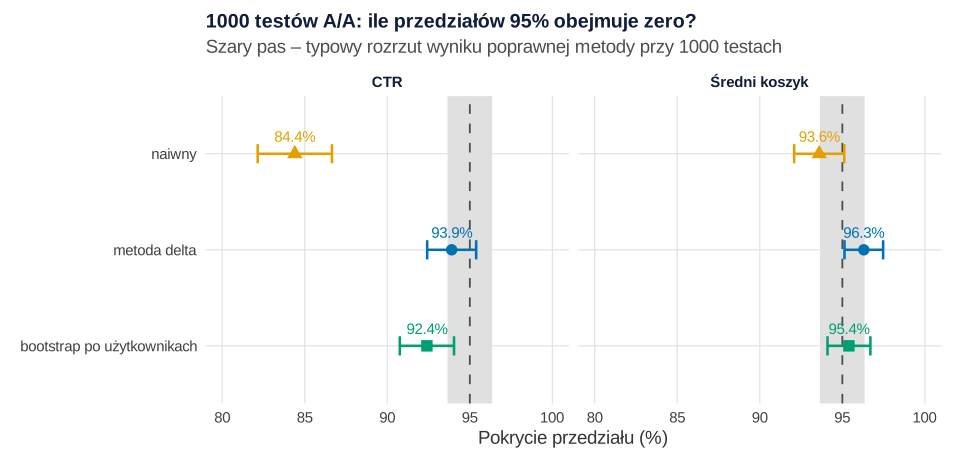
set.seed(614)).Co widać. Dla CTR naiwny przedział objął zero w 84.4% testów, czyli fałszywy alarm pojawił się w 15.6% testów zamiast 5% (błąd Monte Carlo 1.1 pp). Metoda delta – 93.9%, bootstrap – 92.4% (błąd MC 0.8 pp). Dla koszyka naiwny przedział jest za wąski w mniejszym stopniu (93.6%), a delta i bootstrap mieszczą się w oczekiwanym rozrzucie (96.3% i 95.4%).
Jak może zmylić. Delta i bootstrap dla CTR są nieco poniżej 95%. Mianownik jest bardzo nierówny, a przybliżenie normalne działa w dużych próbach. Bootstrap miał tu tylko 200 prób na test, co zaniża pokrycie przedziału percentylowego; w pojedynczej analizie użyj co najmniej 2000. Wynik dotyczy jednego schematu danych; przy większych różnicach między klientami naiwny przedział zawodzi mocniej.
Podpis do pracy:
Zdanie do Metody:
Rysunek 6: skośny koszyk – średnia, mediana, przycinanie
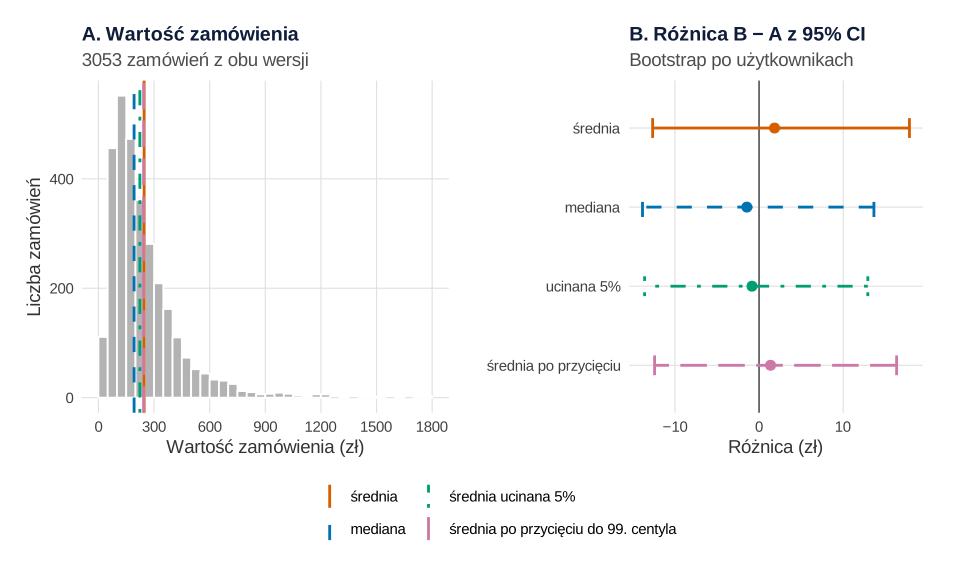
set.seed(614), 1000 prób).Co widać. Wartość zamówienia ma długi prawy ogon (skośność 2.48, maksimum 1792.40 zł). Średnia (246.45 zł) leży wyraźnie nad medianą (192.33 zł). Średnia ucinana 5% i mediana zmniejszają błąd standardowy różnicy z 8.02 do 7.09 i 7.15 zł. Przycięcie 31 zamówień do 99. centyla (1033.48 zł) – z 8.02 do 7.58 zł.
Jak może zmylić. Każda z tych miar odpowiada na inne pytanie. Przychód zależy od średniej, więc mediana koszyka nie powie, ile zarobisz. Przycięcie zmienia średnią najmniej, ale próg ustal przed testem, wspólny dla obu wersji. Także tu losujemy użytkowników, nie zamówienia.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- Nie ogłaszaj zwycięzcy na podstawie naiwnego p. Test nie rozstrzyga o CTR. Powtórz go z planem liczebności, bez codziennego zaglądania do wyniku (pułapki testów A/B).
- Ustal metryki i ich poziom przed startem. Kohavi i in. (2020) traktują zdefiniowanie kluczowych metryk jako osobny krok eksperymentu. Zapisz, czy CTR liczysz jako iloraz sum, czy jako średnią z CTR użytkowników – to dwa różne pytania (w drugim każdy klient waży tyle samo).
- Dołóż metrykę na użytkownika. Przychód na użytkownika łączy konwersję i koszyk, nie jest ilorazem i liczy się zwykłym testem t. Średni koszyk opisuje tylko kupujących, a ich skład może zmienić sama wersja.
- Policz moc dla koszyka. Kohavi i in. (2009) wymieniają moc, liczebność i redukcję wariancji jako składniki eksperymentu. Wariancję zmniejsza CUPED: dane sprzed testu jako kowariant.
- Lejek. Odsetki etapów lejka też bywają ilorazami – zob. lejek konwersji.
Jak opisać w pracy
W Metodzie podaj jednostkę randomizacji, licznik i mianownik wskaźników oraz metodę błędu standardowego. Metoda delta dla ilorazu to ten sam pomysł, co błędy standardowe odporne na klastrowanie: domyślne błędy przy danych pogrupowanych mogą znacznie zawyżać precyzję (Cameron i Miller, 2015). Losowanie całych sklepów czy miast to już randomizacja klastrowa. Inne projekty marketingowe do pracy dyplomowej zbiera wpis statystyka w pracy z marketingu.
| Wskaźnik | A | B | Różnica B − A | SE (delta) | 95% CI | p |
|---|---|---|---|---|---|---|
| CTR (%) | 4.11 | 4.39 | 0.28 | 0.16 | [−0.04, 0.60] | .082 |
| Średni koszyk (zł) | 245.53 | 247.37 | 1.84 | 7.96 | [−13.76, 17.44] | .817 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a przepis 4 – funkcje metody delta i wzorów naiwnych używane w przepisach 6 i 7. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 1, 3, 4, 6 i 7), zaczyna losowanie od własnego set.seed(614); skopiowany osobno (z przepisem 1, a przepisy 5 i 6 także z 4) da te same liczby co na stronie. Ziarno 614 ustalono raz i nie zmieniano go. Ręcznie ustalono parametry danych w przepisie 1: liczbę sesji 1 + rozkład ujemny dwumianowy (średnio 1.8, size = 0.7), średnio 1.5 dodatkowego wyświetlenia na sesję, CTR użytkownika z rozkładu beta (średnio 4.0% w A i 4.4% w B, koncentracja 15), szansę zamówienia w sesji z rozkładu beta (średnio 7%), wartość zamówienia lognormalną (mediana 190 zł, odchylenie poziomu klienta 0.45 i zamówienia 0.55 na skali log) i wzrost koszyka w B o 4%. Liczbę użytkowników podnieśliśmy po pierwszym uruchomieniu z 3000 do 8000 na wersję (przy 3000 żadna metoda nie dawała wyniku istotnego, a przykład miał pokazać, jak naiwny przedział tworzy „wygraną”); ziarna i pozostałych parametrów nie zmieniano. Ręcznie ustalono też: 2000 prób bootstrapowych (przepis 4), 1000 testów A/A z 200 próbami bootstrapu w każdym (przepis 6), 1000 prób, 5% ucięcia i próg 99. centyla (przepis 7). Przepis 1 zapisuje oba pliki CSV w katalogu roboczym. Przepis 6 liczy się ok. 40 sekund, reszta – kilka sekund.
1. Dane i podsumowanie testu
R
# Przepis 1. Fikcyjny test A/B w sklepie sportowym: dane na poziomie użytkownika i zamówienia
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol_wariant <- c("A (obecna strona)" = "#56B4E9", "B (blok „Kompletuj zestaw”)" = "#D55E00")
kol_metoda <- c("naiwny" = "#E69F00", "metoda delta" = "#0072B2", "bootstrap po użytkownikach" = "#009E73")
ksztalt_metoda <- c("naiwny" = 17, "metoda delta" = 16, "bootstrap po użytkownikach" = 15)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
os_minus <- function(x) sub("^-", "\u2212", as.character(x))   # liczby ujemne ze znakiem minus (U+2212) na osiach

# Generator danych. Parametry ustalono ręcznie, tak by przypominały typowy sklep internetowy:
# liczba sesji z rozkładu ujemnego dwumianowego (kilku bardzo aktywnych klientów), ok. 2.5 wyświetlenia
# bloku polecanych produktów na sesję, własny CTR każdego użytkownika (rozkład beta, średnio 4%),
# szansa zamówienia w sesji ok. 7% i skośna (lognormalna) wartość zamówienia z poziomem klienta.
generuj <- function(n, ctr = 0.04, mnoznik_koszyka = 1) {
  sesje <- 1 + rnbinom(n, mu = 1.8, size = 0.7)
  wyswietlenia <- sesje + rpois(n, 1.5 * sesje)
  p_klik <- rbeta(n, 15 * ctr, 15 * (1 - ctr))          # CTR użytkownika
  klikniecia <- rbinom(n, wyswietlenia, p_klik)
  zamowienia <- rbinom(n, sesje, rbeta(n, 0.56, 7.44))   # szansa zamówienia w sesji, średnio 7%
  poziom <- rnorm(n, 0, 0.45)                           # poziom koszyka klienta (log)
  uzytk <- rep(seq_len(n), zamowienia)
  wartosc <- round(mnoznik_koszyka * exp(log(190) + poziom[uzytk] + rnorm(length(uzytk), 0, 0.55)), 2)
  przychod <- as.numeric(rowsum(c(wartosc, numeric(n)), c(uzytk, seq_len(n)))[, 1])
  list(uzytkownicy = data.frame(sesje, wyswietlenia, klikniecia, zamowienia, przychod_zl = przychod),
       zamowienia = data.frame(uzytkownik = uzytk, wartosc_zl = wartosc))
}

# Test: 14 dni, 8000 użytkowników w każdej wersji. W wersji B prawdziwy CTR to 4.4% zamiast 4.0%,
# a koszyk jest o 4% wyższy – te efekty wpisaliśmy ręcznie, żeby było co wykrywać.
set.seed(614)                                     # ziarno ustalone raz, bez dobierania pod wynik
gA <- generuj(8000, ctr = 0.040, mnoznik_koszyka = 1.00)
gB <- generuj(8000, ctr = 0.044, mnoznik_koszyka = 1.04)
warianty <- names(kol_wariant)
uz <- rbind(cbind(wariant = warianty[1], gA$uzytkownicy), cbind(wariant = warianty[2], gB$uzytkownicy))
uz <- cbind(id = sprintf("U%05d", seq_len(nrow(uz))), uz)
zam <- rbind(data.frame(wariant = warianty[1], id = sprintf("U%05d", gA$zamowienia$uzytkownik), wartosc_zl = gA$zamowienia$wartosc_zl),
             data.frame(wariant = warianty[2], id = sprintf("U%05d", 8000 + gB$zamowienia$uzytkownik), wartosc_zl = gB$zamowienia$wartosc_zl))
write.csv(transform(uz, wariant = substr(wariant, 1, 1)), "wskazniki-ilorazowe-uzytkownicy.csv", row.names = FALSE)
write.csv(transform(zam, wariant = substr(wariant, 1, 1)), "wskazniki-ilorazowe-zamowienia.csv", row.names = FALSE)

# Podsumowanie testu: CTR i średni koszyk to ilorazy dwóch sum
podsum <- do.call(rbind, lapply(split(uz, uz$wariant), function(d) data.frame(
  uzytkownicy = nrow(d), sesje = sum(d$sesje), wyswietlenia = sum(d$wyswietlenia), klikniecia = sum(d$klikniecia),
  CTR_proc = round(100 * sum(d$klikniecia) / sum(d$wyswietlenia), 2), zamowienia = sum(d$zamowienia),
  przychod_zl = round(sum(d$przychod_zl)), sredni_koszyk_zl = round(sum(d$przychod_zl) / sum(d$zamowienia), 2))))
podsum[warianty, ]

# Jak nierówno użytkownicy dokładają się do mianownika CTR?
w <- sort(uz$wyswietlenia, decreasing = TRUE)
c(mediana_wyswietlen = median(uz$wyswietlenia), maks = max(uz$wyswietlenia),
  udzial_top10_proc = round(100 * sum(w[1:1600]) / sum(w), 1),
  uzytk_z_zamowieniem_proc = round(100 * mean(uz$zamowienia > 0), 1),
  zamowien_od_klientow_z_2plus_proc = round(100 * sum(uz$zamowienia[uz$zamowienia >= 2]) / sum(uz$zamowienia), 1))
Wynik w R
                            uzytkownicy sesje wyswietlenia klikniecia CTR_proc
A (obecna strona)                  8000 22485        56383       2319     4.11
B (blok „Kompletuj zestaw”)        8000 22229        55693       2447     4.39
                            zamowienia przychod_zl sredni_koszyk_zl
A (obecna strona)                 1524      374186           245.53
B (blok „Kompletuj zestaw”)       1529      378228           247.37
               mediana_wyswietlen                              maks
                              5.0                              70.0
                udzial_top10_proc          uzytk_z_zamowieniem_proc
                             32.6                              14.7
zamowien_od_klientow_z_2plus_proc
                             38.3
2. Schemat jednostek: Rysunek 1
R
# Rysunek 1. Grafika: użytkownik → sesje → wyświetlenia i kliknięcia (kto jest jednostką?)
# (korzysta z uz, warianty, kol_wariant i motyw z przepisu 1)
library(ggplot2)

# Trzech prawdziwych użytkowników wersji A z danych: jedna sesja, trzy sesje i najwięcej wyświetleń
A <- uz[uz$wariant == warianty[1], ]
trzej <- rbind(A[which(A$sesje == 1)[1], ], A[which(A$sesje == 3)[1], ], A[which.max(A$wyswietlenia), ])
print(trzej[c("id", "sesje", "wyswietlenia", "klikniecia", "zamowienia", "przychod_zl")], row.names = FALSE)
odm <- function(n, a, b, c) ifelse(n == 1, a, ifelse(n %% 10 %in% 2:4 & !(n %% 100 %in% 12:14), b, c))
trzej$y <- c(5.6, 4.1, 2.6)
trzej$t_sesje <- paste(trzej$sesje, odm(trzej$sesje, "sesja", "sesje", "sesji"))
trzej$t_licz <- sprintf("%d %s · %d %s", trzej$wyswietlenia, odm(trzej$wyswietlenia, "wyświetlenie", "wyświetlenia", "wyświetleń"),
                        trzej$klikniecia, odm(trzej$klikniecia, "kliknięcie", "kliknięcia", "kliknięć"))
trzej$t_ctr <- sprintf("jego CTR: %.1f%%", 100 * trzej$klikniecia / trzej$wyswietlenia)
n_wysw <- format(sum(A$wyswietlenia), big.mark = " "); n_uz <- format(nrow(A), big.mark = " ")

ramka <- function(x0, x1, y0, y1, wyp = "white", obw = "grey60")
  annotate("rect", xmin = x0, xmax = x1, ymin = y0, ymax = y1, fill = wyp, colour = obw, linewidth = 0.5)
strzalka <- function(x0, x1, y0, y1 = y0, kol = "grey40")
  annotate("segment", x = x0, xend = x1, y = y0, yend = y1, colour = kol, linewidth = 0.6,
           arrow = arrow(length = unit(0.12, "inches"), type = "closed"))
p1 <- ggplot() +
  annotate("text", x = 0.2, y = 6.55, label = "LOSUJEMY: użytkownika (zawsze ta sama wersja)", hjust = 0,
           fontface = "bold", size = 4.3, colour = "#0f1d3a") +
  annotate("text", x = 6.55, y = 6.55, label = "LICZYMY: kliknięcia / wyświetlenia", hjust = 0,
           fontface = "bold", size = 4.3, colour = "#0f1d3a") +
  lapply(trzej$y, function(y) ramka(0.2, 2.4, y - 0.5, y + 0.5, wyp = kol_wariant[1], obw = NA)) +
  annotate("text", x = 1.3, y = trzej$y + 0.15, label = paste("Użytkownik", trzej$id), size = 4, fontface = "bold") +
  annotate("text", x = 1.3, y = trzej$y - 0.22, label = "wersja A", size = 3.7) +
  lapply(trzej$y, function(y) strzalka(2.45, 3.15, y)) +
  lapply(trzej$y, function(y) ramka(3.2, 5.1, y - 0.5, y + 0.5)) +
  annotate("text", x = 4.15, y = trzej$y, label = trzej$t_sesje, size = 4) +
  lapply(trzej$y, function(y) strzalka(5.15, 6.45, y)) +
  lapply(trzej$y, function(y) ramka(6.5, 9.8, y - 0.5, y + 0.5)) +
  annotate("text", x = 8.15, y = trzej$y + 0.17, label = trzej$t_licz, size = 3.9) +
  annotate("text", x = 8.15, y = trzej$y - 0.2, label = trzej$t_ctr, size = 3.7, colour = "grey30") +
  ramka(0.2, 4.9, 0.15, 1.75, wyp = "#FBE9DD", obw = "#D55E00") +
  annotate("text", x = 0.4, y = 1.38, label = "Źle (naiwnie)", hjust = 0, fontface = "bold", size = 4.1, colour = "#8A3B00") +
  annotate("text", x = 0.4, y = 0.75, hjust = 0, size = 3.7, lineheight = 0.95,
           label = sprintf("każde z %s wyświetleń jako osobna,\nniezależna próba – przedział za wąski", n_wysw)) +
  ramka(5.1, 9.8, 0.15, 1.75, wyp = "#DCEBF5", obw = "#0072B2") +
  annotate("text", x = 5.3, y = 1.38, label = "Dobrze", hjust = 0, fontface = "bold", size = 4.1, colour = "#00466E") +
  annotate("text", x = 5.3, y = 0.75, hjust = 0, size = 3.7, lineheight = 0.95,
           label = sprintf("%s użytkowników = %s obserwacji;\nkażdy wnosi parę (kliknięcia, wyświetlenia)", n_uz, n_uz)) +
  coord_cartesian(xlim = c(0, 10), ylim = c(0, 6.9), expand = FALSE) +
  labs(title = "Jednostka losowania ≠ jednostka w mianowniku wskaźnika",
       subtitle = "Trzech użytkowników wersji A z danych przykładu") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(),
                panel.grid.major = element_blank(), panel.grid.minor = element_blank())
p1   # ggsave("wskazniki-ilorazowe-schemat-jednostek.svg", p1, width = 10, height = 6.2)
Wynik w R
     id sesje wyswietlenia klikniecia zamowienia przychod_zl
 U00002     1            2          0          0           0
 U00005     3            7          0          0           0
 U06990    28           64          4          0           0
3. Aktywność i CTR użytkowników: Rysunek 2
R
# Rysunek 2. Użytkownicy różnią się bardziej, niż wynikałoby z przypadku – i nierówno ważą w mianowniku
# (korzysta z uz i motyw z przepisu 1)
library(ggplot2)
library(patchwork)

# A. Udział decyli użytkowników (od najmniej do najbardziej aktywnych) w wyświetleniach
uz_sort <- uz[order(uz$wyswietlenia), ]
uz_sort$decyl <- ceiling(10 * seq_len(nrow(uz_sort)) / nrow(uz_sort))
decyle <- aggregate(cbind(wyswietlenia, klikniecia) ~ decyl, uz_sort, sum)
decyle$udzial_proc <- 100 * decyle$wyswietlenia / sum(decyle$wyswietlenia)
print(round(decyle, 1), row.names = FALSE)

# B. CTR użytkowników z co najmniej 10 wyświetleniami a CTR, gdyby wszyscy mieli ten sam (ogólny) CTR
akt <- uz[uz$wyswietlenia >= 10, ]
ctr_ogolny <- sum(uz$klikniecia) / sum(uz$wyswietlenia)
etykieta <- sprintf("Gdyby wszyscy mieli CTR %.2f%%", 100 * ctr_ogolny)
set.seed(614)
klik_wspolny <- rbinom(nrow(akt), akt$wyswietlenia, ctr_ogolny)    # świat bez różnic między użytkownikami
porownanie <- rbind(data.frame(swiat = "Dane: każdy ma własny CTR", ctr = 100 * akt$klikniecia / akt$wyswietlenia),
                    data.frame(swiat = etykieta, ctr = 100 * klik_wspolny / akt$wyswietlenia))
c(uzytkownicy_10plus = nrow(akt), CTR_ogolny_proc = round(100 * ctr_ogolny, 2))
porownanie$przedzial <- cut(porownanie$ctr, c(-Inf, 0, 5, 10, 20, Inf),
                            labels = c("0%", "do 5%", "5–10%", "10–20%", "ponad 20%"))
rozklad <- as.data.frame(prop.table(table(porownanie$swiat, porownanie$przedzial), 1) * 100)
names(rozklad) <- c("swiat", "przedzial", "proc")
print(reshape(rozklad, idvar = "przedzial", timevar = "swiat", direction = "wide"), digits = 3, row.names = FALSE)
aggregate(ctr ~ swiat, porownanie, function(v) round(sd(v), 2))

pA <- ggplot(decyle, aes(factor(decyl), udzial_proc)) +
  geom_col(fill = "#0072B2", width = 0.75) +
  geom_hline(yintercept = 10, linetype = "dashed", colour = "grey40") +
  geom_text(aes(label = sprintf("%.1f", udzial_proc)), vjust = -0.4, size = 3.6) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "A. Kto wypełnia mianownik?", subtitle = "Linia: udział równy (10%)",
       x = "Decyl użytkowników wg liczby wyświetleń", y = "Udział w wyświetleniach (%)") + motyw
rozklad$swiat <- factor(rozklad$swiat, c("Dane: każdy ma własny CTR", etykieta))
pB <- ggplot(rozklad, aes(przedzial, proc, fill = swiat)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75) +
  geom_text(aes(label = sprintf("%.1f", proc)), position = position_dodge(width = 0.8), vjust = -0.4, size = 3.3) +
  scale_fill_manual(values = setNames(c("#D55E00", "#56B4E9"), levels(rozklad$swiat)), name = NULL) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  guides(fill = guide_legend(ncol = 1)) +
  labs(title = "B. CTR użytkowników (≥ 10 wyświetleń)", subtitle = "Dane a świat bez różnic między ludźmi",
       x = "CTR użytkownika", y = "Odsetek użytkowników (%)") + motyw
p2 <- pA + pB
p2   # ggsave("wskazniki-ilorazowe-uzytkownicy.svg", p2, width = 10, height = 5.4)
Wynik w R
 decyl wyswietlenia klikniecia udzial_proc
     1         1785         75         1.6
     2         3200        129         2.9
     3         4223        176         3.8
     4         5284        230         4.7
     5         6803        304         6.1
     6         8616        347         7.7
     7        11012        478         9.8
     8        14421        628        12.9
     9        20225        835        18.0
    10        36507       1564        32.6
uzytkownicy_10plus    CTR_ogolny_proc
           3701.00               4.25
 przedzial proc.Dane: każdy ma własny CTR proc.Gdyby wszyscy mieli CTR 4.25%
        0%                          63.04                             51.419
     do 5%                           5.16                              9.349
     5–10%                          18.32                             29.533
    10–20%                           9.84                              8.835
 ponad 20%                           3.65                              0.865
                          swiat  ctr
1     Dane: każdy ma własny CTR 7.12
2 Gdyby wszyscy mieli CTR 4.25% 5.25
4. Przedział naiwny, metoda delta i bootstrap: Rysunek 3
R
# Rysunek 3. Trzy przedziały ufności dla tej samej różnicy: naiwny, metoda delta, bootstrap po użytkownikach
# (korzysta z uz, zam, warianty, kol_metoda, ksztalt_metoda i motyw z przepisu 1)
library(ggplot2)

# Iloraz sum R = suma(y) / suma(x) = średnia(y) / średnia(x), gdzie y i x to sumy jednego użytkownika
# (kliknięcia i wyświetlenia albo przychód i zamówienia). Metoda delta: SE z wariancji i kowariancji y oraz x.
iloraz_delta <- function(y, x) {
  n <- length(x); R <- mean(y) / mean(x)
  c(est = R, se = sqrt((var(y) - 2 * R * cov(y, x) + R^2 * var(x)) / (n * mean(x)^2)))
}
# Naiwnie: CTR jak odsetek z n = liczba wyświetleń; koszyk jak średnia z n = liczba zamówień
ctr_naiwny <- function(d) { p <- sum(d$klikniecia) / sum(d$wyswietlenia)
  c(est = p, se = sqrt(p * (1 - p) / sum(d$wyswietlenia))) }
koszyk_naiwny <- function(v) c(est = mean(v), se = sd(v) / sqrt(length(v)))

A <- uz[uz$wariant == warianty[1], ]; B <- uz[uz$wariant == warianty[2], ]
roznica <- function(a, b, skala) {          # różnica B − A, 95% CI z rozkładu normalnego i p
  r <- (b["est"] - a["est"]) * skala; se <- sqrt(a["se"]^2 + b["se"]^2) * skala
  c(roznica = unname(r), SE = unname(se), dolna = unname(r - 1.96 * se), gorna = unname(r + 1.96 * se),
    p = unname(2 * pnorm(-abs(r / se))))
}
wyn <- rbind(
  "CTR (pp) | naiwny" = roznica(ctr_naiwny(A), ctr_naiwny(B), 100),
  "CTR (pp) | metoda delta" = roznica(iloraz_delta(A$klikniecia, A$wyswietlenia),
                                      iloraz_delta(B$klikniecia, B$wyswietlenia), 100),
  "koszyk (zł) | naiwny" = roznica(koszyk_naiwny(zam$wartosc_zl[zam$wariant == warianty[1]]),
                                   koszyk_naiwny(zam$wartosc_zl[zam$wariant == warianty[2]]), 1),
  "koszyk (zł) | metoda delta" = roznica(iloraz_delta(A$przychod_zl, A$zamowienia),
                                         iloraz_delta(B$przychod_zl, B$zamowienia), 1))

# Bootstrap: losujemy ze zwracaniem całych użytkowników (z ich wszystkimi wyświetleniami i zamówieniami),
# osobno w każdej wersji, i liczymy różnicę ilorazów od nowa. 2000 powtórzeń.
set.seed(614)
B_boot <- 2000
boot <- t(replicate(B_boot, {
  a <- sample.int(nrow(A), replace = TRUE); b <- sample.int(nrow(B), replace = TRUE)   # numery użytkowników
  c(ctr = 100 * (sum(B$klikniecia[b]) / sum(B$wyswietlenia[b]) - sum(A$klikniecia[a]) / sum(A$wyswietlenia[a])),
    koszyk = sum(B$przychod_zl[b]) / sum(B$zamowienia[b]) - sum(A$przychod_zl[a]) / sum(A$zamowienia[a]))
}))
boot_wiersz <- function(v, est) c(roznica = est, SE = sd(v), dolna = unname(quantile(v, .025)),
                                  gorna = unname(quantile(v, .975)), p = NA)
wyn <- rbind(wyn,
  "CTR (pp) | bootstrap po użytkownikach" = boot_wiersz(boot[, "ctr"], wyn["CTR (pp) | naiwny", "roznica"]),
  "koszyk (zł) | bootstrap po użytkownikach" = boot_wiersz(boot[, "koszyk"], wyn["koszyk (zł) | naiwny", "roznica"]))
wyn <- wyn[c(1, 2, 5, 3, 4, 6), ]
print(round(wyn, 3))

# O ile naiwny błąd standardowy jest za mały? (kwadrat ilorazu SE to efekt schematu)
SE_iloraz <- c(CTR = wyn[2, "SE"] / wyn[1, "SE"], koszyk = wyn[5, "SE"] / wyn[4, "SE"])
round(rbind(SE_delta_do_naiwnego = SE_iloraz, efekt_schematu = SE_iloraz^2), 2)

tab <- data.frame(miara = sub(" \\|.*", "", rownames(wyn)), metoda = sub(".*\\| ", "", rownames(wyn)), wyn)
tab$miara <- factor(tab$miara, c("CTR (pp)", "koszyk (zł)"),
                    c("Różnica CTR, B − A (punkty procentowe)", "Różnica średniego koszyka, B − A (zł)"))
tab$metoda <- factor(tab$metoda, rev(names(kol_metoda)))
p3 <- ggplot(tab, aes(roznica, metoda, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 1, orientation = "y") +
  geom_point(size = 3.4) +
  geom_text(aes(x = gorna, label = sprintf("[%s, %s]", os_minus(sprintf("%.2f", dolna)), os_minus(sprintf("%.2f", gorna)))), hjust = -0.12, size = 3.8,
            show.legend = FALSE) +
  facet_wrap(~ miara, ncol = 1, scales = "free_x") +
  scale_colour_manual(values = kol_metoda, guide = "none") + scale_shape_manual(values = ksztalt_metoda, guide = "none") +
  scale_x_continuous(labels = os_minus, expand = expansion(mult = c(0.08, 0.38))) +
  labs(title = "Ta sama różnica, trzy przedziały 95%",
       subtitle = "Naiwny traktuje wyświetlenia i zamówienia jak niezależne osoby", x = NULL, y = NULL) +
  motyw
p3   # ggsave("wskazniki-ilorazowe-trzy-przedzialy.svg", p3, width = 10, height = 6)
Wynik w R
                                         roznica    SE   dolna  gorna     p
CTR (pp) | naiwny                          0.281 0.121   0.044  0.517 0.020
CTR (pp) | metoda delta                    0.281 0.161  -0.035  0.597 0.082
CTR (pp) | bootstrap po użytkownikach      0.281 0.161  -0.055  0.610    NA
koszyk (zł) | naiwny                       1.841 7.167 -12.207 15.889 0.797
koszyk (zł) | metoda delta                 1.841 7.961 -13.762 17.444 0.817
koszyk (zł) | bootstrap po użytkownikach   1.841 8.069 -13.807 18.883    NA
                      CTR koszyk
SE_delta_do_naiwnego 1.34   1.11
efekt_schematu       1.79   1.23
5. Rozkład bootstrapowy: Rysunek 4
R
# Rysunek 4. Rozkład bootstrapowy różnic na tle krzywych normalnych z metody delta i z wzoru naiwnego
# (korzysta z boot, B_boot i wyn z przepisu 4 oraz motyw i os_minus() z przepisu 1)
library(ggplot2)

roz <- rbind(data.frame(miara = "Różnica CTR (pp)", wartosc = boot[, "ctr"]),
             data.frame(miara = "Różnica średniego koszyka (zł)", wartosc = boot[, "koszyk"]))
krzywa <- function(miara, est, se_delta, se_naiwny) {
  x <- seq(est - 4.2 * se_delta, est + 4.2 * se_delta, length.out = 300)
  rbind(data.frame(miara, x, gestosc = dnorm(x, est, se_delta), krzywa = "metoda delta"),
        data.frame(miara, x, gestosc = dnorm(x, est, se_naiwny), krzywa = "naiwny"))
}
krzywe <- rbind(krzywa("Różnica CTR (pp)", wyn[1, "roznica"], wyn[2, "SE"], wyn[1, "SE"]),
                krzywa("Różnica średniego koszyka (zł)", wyn[4, "roznica"], wyn[5, "SE"], wyn[4, "SE"]))
# Odsetek prób bootstrapowych poniżej zera i skośność rozkładu bootstrapowego
skosnosc <- function(v) mean((v - mean(v))^3) / sd(v)^3
round(rbind(ponizej_zera_proc = 100 * colMeans(boot < 0), skosnosc = apply(boot, 2, skosnosc)), 2)

p4 <- ggplot(roz, aes(wartosc)) +
  geom_histogram(aes(y = after_stat(density)), bins = 45, fill = "#009E73", alpha = 0.45, colour = "white") +
  geom_line(data = krzywe, aes(x, gestosc, colour = krzywa, linetype = krzywa), linewidth = 1) +
  geom_vline(xintercept = 0, colour = "grey30") +
  facet_wrap(~ miara, ncol = 2, scales = "free") +
  scale_x_continuous(labels = os_minus) +
  scale_colour_manual(values = c("metoda delta" = "#0072B2", "naiwny" = "#E69F00"), name = NULL) +
  scale_linetype_manual(values = c("metoda delta" = "solid", "naiwny" = "dashed"), name = NULL) +
  labs(title = sprintf("%d prób bootstrapowych (losowani użytkownicy)", B_boot),
       subtitle = "Słupki – bootstrap; linie – rozkład normalny z SE metody delta i z SE naiwnego",
       x = "Różnica B − A", y = "Gęstość") +
  motyw
p4   # ggsave("wskazniki-ilorazowe-bootstrap.svg", p4, width = 10, height = 5)
Wynik w R
                    ctr koszyk
ponizej_zera_proc  4.55  40.40
skosnosc          -0.04   0.08
6. 1000 testów A/A: Rysunek 5
R
# Rysunek 5. 1000 testów A/A: jak często 95% przedział obejmuje prawdziwą różnicę (zero)?
# (korzysta z generuj(), iloraz_delta(), ctr_naiwny(), koszyk_naiwny(), roznica(), kol_metoda,
#  ksztalt_metoda i motyw z przepisów 1 i 4)
library(ggplot2)

# Bootstrap po użytkownikach w wersji szybkiej: wylosowanie n użytkowników ze zwracaniem to to samo,
# co wylosowanie z rozkładu wielomianowego, ilu razy trafi każdy typ użytkownika (ta sama para y, x).
boot_iloraz <- function(y, x, B) {
  klucz <- y * 1000 + x; typ <- !duplicated(klucz)        # x < 1000, więc klucz jednoznaczny
  ile <- tabulate(match(klucz, klucz[typ]), sum(typ))
  M <- rmultinom(B, length(x), ile / length(x))
  colSums(M * y[typ]) / colSums(M * x[typ])
}
set.seed(614)
n_testow <- 1000; B_sym <- 200
sym <- do.call(rbind, lapply(seq_len(n_testow), function(i) {
  a <- generuj(8000); b <- generuj(8000)          # obie wersje identyczne: prawdziwa różnica = 0
  A <- a$uzytkownicy; B <- b$uzytkownicy
  ctr_b <- 100 * (boot_iloraz(B$klikniecia, B$wyswietlenia, B_sym) - boot_iloraz(A$klikniecia, A$wyswietlenia, B_sym))
  kosz_b <- boot_iloraz(B$przychod_zl, B$zamowienia, B_sym) - boot_iloraz(A$przychod_zl, A$zamowienia, B_sym)
  obejmuje <- function(r) unname(r["dolna"] <= 0 & r["gorna"] >= 0)
  data.frame(miara = rep(c("CTR", "koszyk"), each = 3), metoda = rep(names(kol_metoda), 2), obejmuje = c(
    obejmuje(roznica(ctr_naiwny(A), ctr_naiwny(B), 100)),
    obejmuje(roznica(iloraz_delta(A$klikniecia, A$wyswietlenia), iloraz_delta(B$klikniecia, B$wyswietlenia), 100)),
    quantile(ctr_b, .025) <= 0 & quantile(ctr_b, .975) >= 0,
    obejmuje(roznica(koszyk_naiwny(a$zamowienia$wartosc_zl), koszyk_naiwny(b$zamowienia$wartosc_zl), 1)),
    obejmuje(roznica(iloraz_delta(A$przychod_zl, A$zamowienia), iloraz_delta(B$przychod_zl, B$zamowienia), 1)),
    quantile(kosz_b, .025) <= 0 & quantile(kosz_b, .975) >= 0))
}))
pokrycie <- aggregate(obejmuje ~ miara + metoda, sym, mean)
pokrycie$pokrycie_proc <- 100 * pokrycie$obejmuje
pokrycie$blad_MC_pp <- 100 * sqrt(pokrycie$obejmuje * (1 - pokrycie$obejmuje) / n_testow)
pokrycie$falszywe_alarmy_proc <- 100 - pokrycie$pokrycie_proc
print(pokrycie[order(pokrycie$miara, -pokrycie$pokrycie_proc), -3], row.names = FALSE, digits = 3)

pokrycie$miara <- factor(pokrycie$miara, c("CTR", "koszyk"), c("CTR", "Średni koszyk"))
pokrycie$metoda <- factor(pokrycie$metoda, rev(names(kol_metoda)))
p5 <- ggplot(pokrycie, aes(pokrycie_proc, metoda, colour = metoda, shape = metoda)) +
  annotate("rect", xmin = 95 - 1.96 * sqrt(.95 * .05 / n_testow) * 100, xmax = 95 + 1.96 * sqrt(.95 * .05 / n_testow) * 100,
           ymin = -Inf, ymax = Inf, fill = "grey88") +
  geom_vline(xintercept = 95, colour = "grey30", linetype = "dashed") +
  geom_errorbar(aes(xmin = pokrycie_proc - 1.96 * blad_MC_pp, xmax = pokrycie_proc + 1.96 * blad_MC_pp),
                width = 0.2, linewidth = 0.9, orientation = "y") +
  geom_point(size = 3.6) +
  geom_text(aes(label = sprintf("%.1f%%", pokrycie_proc)), vjust = -1.1, size = 4, show.legend = FALSE) +
  facet_wrap(~ miara, ncol = 2) +
  scale_colour_manual(values = kol_metoda, guide = "none") + scale_shape_manual(values = ksztalt_metoda, guide = "none") +
  scale_x_continuous(limits = c(80, 100), breaks = seq(80, 100, 5)) +
  labs(title = "1000 testów A/A: ile przedziałów 95% obejmuje zero?",
       subtitle = "Szary pas – typowy rozrzut wyniku poprawnej metody przy 1000 testach",
       x = "Pokrycie przedziału (%)", y = NULL) +
  motyw
p5   # ggsave("wskazniki-ilorazowe-1000-testow-aa.svg", p5, width = 10, height = 4.8)
Wynik w R
  miara                     metoda pokrycie_proc blad_MC_pp
    CTR               metoda delta          93.9      0.757
    CTR bootstrap po użytkownikach          92.4      0.838
    CTR                     naiwny          84.4      1.147
 koszyk               metoda delta          96.3      0.597
 koszyk bootstrap po użytkownikach          95.4      0.662
 koszyk                     naiwny          93.6      0.774
 falszywe_alarmy_proc
                  6.1
                  7.6
                 15.6
                  3.7
                  4.6
                  6.4
7. Skośny koszyk: Rysunek 6
R
# Rysunek 6. Skośny koszyk: średnia, mediana, średnia ucinana i średnia po przycięciu dużych zamówień
# (korzysta z uz, zam, warianty, iloraz_delta() z przepisów 1 i 4 oraz motyw i os_minus())
library(ggplot2)
library(patchwork)

# Próg przycięcia: 99. centyl wartości zamówienia w obu wersjach razem (ustalony z góry, ten sam dla A i B)
prog <- unname(quantile(zam$wartosc_zl, 0.99))
statystyki <- function(v) c("średnia" = mean(v), "mediana" = median(v), "średnia ucinana 5%" = mean(v, trim = 0.05),
                            "średnia po przycięciu do 99. centyla" = mean(pmin(v, prog)))
vA <- zam$wartosc_zl[zam$wariant == warianty[1]]; vB <- zam$wartosc_zl[zam$wariant == warianty[2]]
c(prog_zl = round(prog, 2), skosnosc = round(mean((zam$wartosc_zl - mean(zam$wartosc_zl))^3) / sd(zam$wartosc_zl)^3, 2),
  maks_zl = max(zam$wartosc_zl), przycietych = sum(zam$wartosc_zl > prog))
round(statystyki(zam$wartosc_zl), 2)              # obie wersje razem (linie na panelu A)

# Bootstrap po użytkownikach (losujemy klientów razem z ich wszystkimi zamówieniami), 1000 powtórzeń
idA <- split(vA, zam$id[zam$wariant == warianty[1]]); idB <- split(vB, zam$id[zam$wariant == warianty[2]])
nA <- sum(uz$wariant == warianty[1]); nB <- sum(uz$wariant == warianty[2])
losuj <- function(lista, n) {     # n użytkowników ze zwracaniem; ci bez zamówień nic nie wnoszą
  k <- rbinom(1, n, length(lista) / n)              # ilu wylosowanych ma zamówienia
  unlist(lista[sample.int(length(lista), k, replace = TRUE)], use.names = FALSE)
}
set.seed(614)
bt <- t(replicate(1000, statystyki(losuj(idB, nB)) - statystyki(losuj(idA, nA))))
tabela <- data.frame(statystyka = names(statystyki(vA)), A = statystyki(vA), B = statystyki(vB),
                     roznica = statystyki(vB) - statystyki(vA),
                     dolna = apply(bt, 2, quantile, .025), gorna = apply(bt, 2, quantile, .975), SE = apply(bt, 2, sd))
print(transform(tabela, A = round(A, 2), B = round(B, 2), roznica = round(roznica, 2), dolna = round(dolna, 2),
                gorna = round(gorna, 2), SE = round(SE, 2)), row.names = FALSE)

dl <- data.frame(statystyka = names(statystyki(zam$wartosc_zl)), wartosc = statystyki(zam$wartosc_zl))
dl$statystyka <- factor(dl$statystyka, dl$statystyka)
kol_stat <- setNames(c("#D55E00", "#0072B2", "#009E73", "#CC79A7"), levels(dl$statystyka))
lin_stat <- setNames(c("solid", "dashed", "dotdash", "longdash"), levels(dl$statystyka))
pA <- ggplot(zam, aes(wartosc_zl)) +
  geom_histogram(binwidth = 50, boundary = 0, fill = "grey70", colour = "white") +
  geom_vline(data = dl, aes(xintercept = wartosc, colour = statystyka, linetype = statystyka), linewidth = 1) +
  scale_x_continuous(breaks = seq(0, 1800, 300)) +
  scale_colour_manual(values = kol_stat, name = NULL) + scale_linetype_manual(values = lin_stat, name = NULL) +
  guides(colour = guide_legend(ncol = 2)) +
  labs(title = "A. Wartość zamówienia", subtitle = sprintf("%d zamówień z obu wersji", nrow(zam)),
       x = "Wartość zamówienia (zł)", y = "Liczba zamówień") + motyw
tabela$statystyka <- factor(tabela$statystyka, rev(levels(dl$statystyka)))
pB <- ggplot(tabela, aes(roznica, statystyka, colour = statystyka, linetype = statystyka)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 1, orientation = "y") +
  geom_point(size = 3) +
  scale_colour_manual(values = kol_stat, guide = "none") + scale_linetype_manual(values = lin_stat, guide = "none") +
  scale_x_continuous(labels = os_minus) +
  scale_y_discrete(labels = c("średnia po przycięciu do 99. centyla" = "średnia po przycięciu", "średnia ucinana 5%" = "ucinana 5%")) +
  labs(title = "B. Różnica B − A z 95% CI", subtitle = "Bootstrap po użytkownikach", x = "Różnica (zł)", y = NULL) + motyw
p6 <- (pA + pB + plot_layout(widths = c(1.25, 1))) & theme(legend.position = "bottom")
p6 <- p6 + plot_layout(guides = "collect")
p6   # ggsave("wskazniki-ilorazowe-skosny-koszyk.svg", p6, width = 10, height = 5.6)
Wynik w R
    prog_zl    skosnosc     maks_zl przycietych
    1033.48        2.48     1792.40       31.00
                             średnia                              mediana
                              246.45                               192.33
                  średnia ucinana 5% średnia po przycięciu do 99. centyla
                              223.44                               243.98
                           statystyka      A      B roznica  dolna gorna   SE
                              średnia 245.53 247.37    1.84 -12.65 17.88 8.02
                              mediana 192.85 191.40   -1.45 -13.86 13.65 7.15
                   średnia ucinana 5% 223.88 223.04   -0.84 -13.61 12.93 7.09
 średnia po przycięciu do 99. centyla 243.29 244.66    1.37 -12.42 16.35 7.58
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("naiwny – delta" = c("#E69F00", "#0072B2"), "naiwny – bootstrap" = c("#E69F00", "#009E73"),
             "delta – bootstrap" = c("#0072B2", "#009E73"), "wersja A – wersja B" = c("#56B4E9", "#D55E00"),
             "średnia – przycięta" = c("#D55E00", "#CC79A7"), "mediana – ucinana" = c("#0072B2", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica_barw <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica_barw(k), deuteranopia = roznica_barw(deutan(k)),
                                   protanopia = roznica_barw(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
naiwny – delta                             120.2        121.5      109.3
naiwny – bootstrap                          88.7         66.3       51.5
delta – bootstrap                           70.1         55.4       58.0
wersja A – wersja B                        113.6        101.1       89.0
średnia – przycięta                         74.3         70.2       71.9
mediana – ucinana                           70.1         55.4       58.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, metoda delta (var(), cov()), bootstrap (sample.int(), rmultinom()) i kwantyle – pakiet stats z podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Odsetek z wyświetleń jak z osób. Test proporcji na 56 383 wyświetleniach dał p = .020, poprawna analiza p = .082. W 1000 testach A/A naiwny przedział dał fałszywy alarm w 15.6% testów (rysunek 5).
- Mediana zamiast średniej bez uzasadnienia. Mediana koszyka nie przekłada się na przychód. Przycinanie ustal przed testem (rysunek 6).
- Zmiana mianownika przez wersję. Jeśli wersja B zmienia liczbę wyświetleń albo zamówień, iloraz może urosnąć, bo spadł mianownik. Zawsze pokaż licznik i mianownik osobno, na użytkownika.
- Niezgodny podział ruchu. 8000 i 8000 to plan; sprawdź podział testem χ², zanim policzysz wskaźniki (test A/B – plan i analiza).
- Względny wzrost bez przedziału. Wzrost względny (B / A − 1) to iloraz dwóch ilorazów; jego przedział też policz metodą delta albo bootstrapem.
Najczęstsze pytania
Dlaczego nie można policzyć CTR w teście A/B zwykłym testem proporcji?
Bo test proporcji zakłada, że każde wyświetlenie to niezależna próba, a losowano użytkowników. Wyświetlenia jednej osoby są do siebie podobne: jedni klikają często, inni wcale. W przykładzie naiwny błąd standardowy był 1.34 raza za mały, a w 1000 testach A/A naiwny przedział dał fałszywy alarm w 15.6% testów zamiast 5%.
Jak policzyć przedział ufności dla średniego koszyka w teście A/B?
Potraktuj średni koszyk jako iloraz średniego przychodu i średniej liczby zamówień na użytkownika. Błąd standardowy policz metodą delta z wariancji i kowariancji tych dwóch sum albo bootstrapem, losując ze zwracaniem całych użytkowników z ich zamówieniami. W przykładzie obie metody dały prawie ten sam przedział: [−13.76, 17.44] i [−13.81, 18.88] zł.
Metoda delta czy bootstrap – co wybrać w teście A/B?
Przy tysiącach użytkowników dają prawie to samo (SE różnicy CTR 0.161 w obu metodach). Metoda delta to jeden wzór, liczy się natychmiast i łatwo ją opisać. Bootstrap jest dobrym sprawdzianem, ale tylko wtedy, gdy losujesz użytkowników, a nie wyświetlenia czy zamówienia, i użyjesz co najmniej 2000 prób.
Czy przy skośnym koszyku lepiej porównać medianę niż średnią?
Mediana i średnia ucinana dają węższy przedział, ale odpowiadają na inne pytanie: przychód sklepu zależy od średniej. Częsty kompromis to przycięcie największych zamówień do progu ustalonego przed testem (np. 99. centyla, wspólnego dla obu wersji) i podanie wyniku dla zwykłej średniej jako głównego.
Czym jest test A/A i po co go robić?
To test, w którym obie wersje są identyczne, więc prawdziwa różnica wynosi zero. Powtórzony wiele razy (na danych albo w symulacji) pokazuje, czy metoda analizy daje fałszywy alarm w ok. 5% przypadków. W przykładzie metoda delta objęła zero w 93.9% testów, a naiwny przedział CTR tylko w 84.4%.
Powiązane hasła
Przeczytaj też
Pułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikCUPED – krótszy test A/B
Wydatki sprzed testu jako kowariant: węższy przedział, symulacja 1000 testów, związek z ANCOVA i pułapka kowariantu po starcie – z kodem R.
Czytaj →PoradnikTest A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →Analizujesz test A/B do pracy z marketingu?
Pomożemy zaplanować test, dobrać metryki, policzyć przedziały na poziomie użytkownika i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Deng, A., Knoblich, U., & Lu, J. (2018). Applying the delta method in metric analytics. In Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining (pp. 233–242). ACM. https://doi.org/10.1145/3219819.3219919 ● Otwarty dostęp: pełny tekst
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Field, C. A., & Welsh, A. H. (2007). Bootstrapping clustered data. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(3), 369–390. https://doi.org/10.1111/j.1467-9868.2007.00593.x
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Oehlert, G. W. (1992). A note on the delta method. The American Statistician, 46(1), 27–29. https://doi.org/10.1080/00031305.1992.10475842
Cytowania BibTeX
@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@inproceedings{deng2018applying, author={Deng, Alex and Knoblich, Ulf and Lu, Jiannan}, title={{Applying the delta method in metric analytics}}, booktitle={Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery \& Data Mining}, year={2018}, pages={233--242}, publisher={ACM}, doi={10.1145/3219819.3219919}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{field2007bootstrapping, author={Field, Christopher A. and Welsh, Alan H.}, title={{Bootstrapping clustered data}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2007}, volume={69}, number={3}, pages={369--390}, doi={10.1111/j.1467-9868.2007.00593.x}}@article{hurlbert1984pseudoreplication, author={Hurlbert, Stuart H.}, title={{Pseudoreplication and the design of ecological field experiments}}, journal={Ecological Monographs}, year={1984}, volume={54}, number={2}, pages={187--211}, doi={10.2307/1942661}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{oehlert1992note, author={Oehlert, Gary W.}, title={{A note on the delta method}}, journal={The American Statistician}, year={1992}, volume={46}, number={1}, pages={27--29}, doi={10.1080/00031305.1992.10475842}}