Co to jest drzewo decyzyjne (CART)?
Drzewo decyzyjne dzieli próbę na coraz mniejsze grupy pytaniami typu „czy średnia ocen jest co najmniej 4.11?”. Każde pytanie dotyczy jednego predyktora i jednego progu. Grupy końcowe to liście. Prognozą jest odsetek lub klasa przeważająca w liściu (drzewo klasyfikacyjne) albo średnia wyniku (drzewo regresyjne). CART (ang. classification and regression trees) to metoda opisana przez Breimana i in. (1984): drzewo rośnie przez podziały binarne, a potem jest przycinane. Strobl i in. (2009) omawiają drzewa i lasy losowe dla psychologów razem z ich pułapkami. Drzewo samo wyszukuje progi i interakcje.
Jak czytać drzewo
- Węzeł zawiera warunek. Osoby spełniające warunek idą w lewo („tak”), pozostałe w prawo („nie”).
- Liść podaje prognozowaną klasę, odsetek zdarzeń i liczbę osób.
- Podział przestrzeni predyktorów: przy dwóch predyktorach każdy liść to prostokąt o bokach równoległych do osi.
Przykład
W symulowanych danych 300 studentów szansa rezygnacji ze studiów malała gładko ze średnią ocen i rosła z liczbą godzin pracy zarobkowej (współczynniki modelu logistycznego ustawiono ręcznie, by oba predyktory były widoczne; ziarna 784, 7841 i 7842 nie były zmieniane). Zrezygnowało 171 osób. Pełne drzewo miało 7 liści. Po przycięciu do minimum błędu w 10-krotnej walidacji krzyżowej zostały 4 liście. Błąd klasyfikacji w walidacji wyniósł .21, a trafność w tej samej próbie .80. Pierwszy podział to średnia ocen ≥ 4.11 (w tej grupie zrezygnowało 23% ze 108 osób). Wśród słabszych studentów decydowała praca: przy 14.6 h tygodniowo lub więcej zrezygnowało 88% ze 131 osób.
Na rysunku
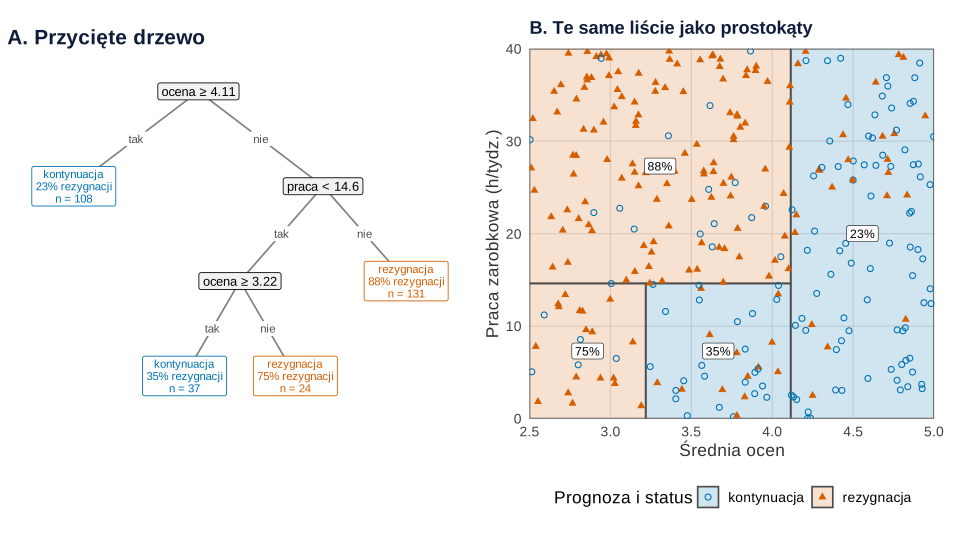
set.seed(784)).Co widać. Każdy liść z panelu A to jeden prostokąt w panelu B. Prawdziwa granica biegnie ukośnie, a drzewo przybliża ją schodkami. Liść podaje odsetek, nie pewną prognozę: w prostokącie „88%” są też kółka.
Na co uważać. Rysunek nie pokazuje, jak bardzo drzewo zmieniłoby się w innej próbie. Trafność .80 policzona na danych, na których drzewo rosło, jest zawyżona względem walidacji krzyżowej.
Podpis do pracy:
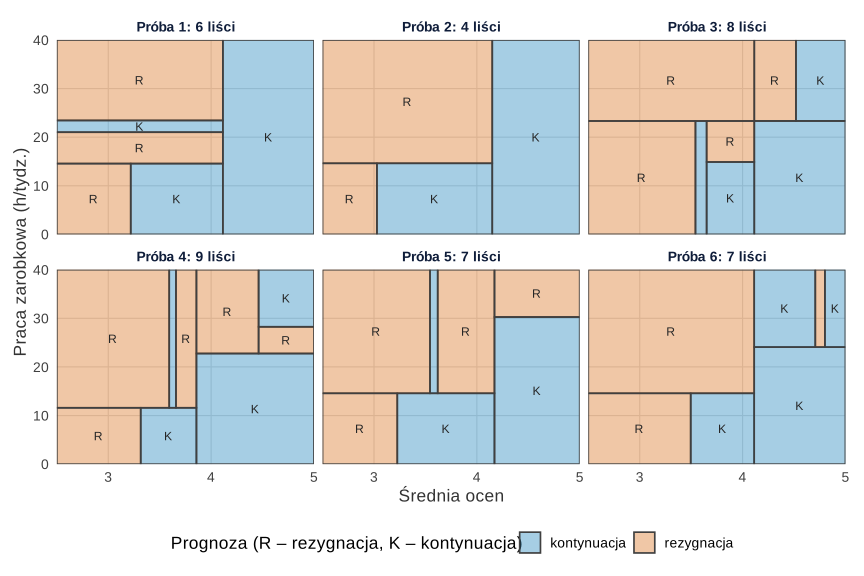
set.seed(7842)).Co widać. Tę samą procedurę powtórzono na 200 próbach bootstrapowych, przycinając drzewa tym samym parametrem złożoności. Korzeń zawsze dzielił według średniej ocen, ale próg wahał się od 3.54 do 4.38. Drzewa miały od 3 do 13 liści. Średnio klasyfikowały tak samo jak drzewo z rysunku 1 88.0% osób, w najgorszej próbie tylko 70.3%.
Na co uważać. Najmniej stabilne są dolne podziały, oparte na coraz mniejszych grupach.
Podpis do pracy:
Rysunki na stronie powstały z tych samych obiektów z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Drzewo regresyjne, las losowy i ważność zmiennych na jednym przykładzie pokazuje wpis Drzewa decyzyjne i lasy losowe.
Jak opisać w pracy
Na co uważać
- Nieprzycięte drzewo się przeucza. Rośnie, aż liście są prawie czyste, i dopasowuje szum (zob. przeuczenie). Raportuj błąd z walidacji.
- Jedno drzewo jest niestabilne. Mała zmiana danych zmienia progi i kształt drzewa. Gdy liczy się trafność, uśrednij wiele drzew (las losowy).
- Schodki zamiast gładkiej zależności. Przy zależności liniowej regresja logistyczna zwykle będzie trafniejsza i prostsza.
- Progi są dopasowane do danych. Próg „4.11” nie jest odkrytym punktem odcięcia.
- Drzewo to nie model przyczynowy. Kształt zależności w modelach z wielu drzew pokazuje wykres częściowej zależności.
Drzewo CART w R
Kod symuluje dane, dopasowuje drzewo klasyfikacyjne funkcją rpart(), przycina je według walidacji krzyżowej i powtarza całą procedurę na 200 próbach bootstrapowych. Drzewo i prostokąty liści rysuje ręcznie w ggplot2 z obiektu rpart (obiekty p1 i p2).
Drzewo, przycinanie, bootstrap i oba rysunki
R
# Drzewo klasyfikacyjne CART (rpart): drzewo, podział przestrzeni predyktorów i niestabilność w bootstrapie
suppressPackageStartupMessages({library(rpart); library(ggplot2); library(patchwork)})
kol <- c(kontynuacja = "#0072B2", rezygnacja = "#D55E00")   # Okabe–Ito; klasy różnią się też kształtem
ksz <- c(kontynuacja = 1, rezygnacja = 17)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(784)                                              # 300 studentów, gładka (nie schodkowa) zależność
n <- 300
dane <- data.frame(ocena = runif(n, 2.5, 5),               # średnia ocen
                   praca = runif(n, 0, 40))                # godziny pracy zarobkowej w tygodniu
p <- plogis(7 - 2.2 * dane$ocena + 0.07 * dane$praca)
dane$status <- factor(ifelse(runif(n) < p, "rezygnacja", "kontynuacja"), levels = names(kol))
table(dane$status)
ster <- rpart.control(cp = 0.001, minbucket = 10, xval = 10)
set.seed(7841)                                             # losowy podział na 10 części walidacji krzyżowej
pelne <- rpart(status ~ ocena + praca, data = dane, method = "class", control = ster)
cp_min <- pelne$cptable[which.min(pelne$cptable[, "xerror"]), "CP"]
drzewo <- prune(pelne, cp = cp_min)                        # przycięcie do minimum błędu walidacji krzyżowej
print(round(pelne$cptable, 3))
korzen <- function(f) paste(f$frame$var[1], round(f$splits[1, "index"], 2))
round(c(liscie_pelne = sum(pelne$frame$var == "<leaf>"), liscie_przyciete = sum(drzewo$frame$var == "<leaf>"),
        trafnosc_w_probie = mean(predict(drzewo, type = "class") == dane$status),
        blad_cv = min(pelne$cptable[, "xerror"]) * pelne$frame$dev[1] / n), 3)   # xerror jest względny
korzen(drzewo)
# Niestabilność: 200 drzew na próbach bootstrapowych, przycinanych tym samym cp
set.seed(7842)
boot <- lapply(1:200, function(b) {
  d <- dane[sample(n, replace = TRUE), ]
  prune(rpart(status ~ ocena + praca, data = d, method = "class", control = ster), cp = cp_min)
})
zm_korzenia <- sapply(boot, function(f) f$frame$var[1])
prog_ocena <- sapply(boot, function(f) if (f$frame$var[1] == "ocena") f$splits[1, "index"] else NA)
liscie <- sapply(boot, function(f) sum(f$frame$var == "<leaf>"))
zgodnosc <- sapply(boot, function(f) mean(predict(f, dane, type = "class") == predict(drzewo, type = "class")))
table(zm_korzenia)
round(c(quantile(prog_ocena, c(0, .25, .5, .75, 1), na.rm = TRUE)), 2)
table(liscie)
round(c(zgodnosc_srednia = mean(zgodnosc), zgodnosc_min = min(zgodnosc)), 3)
# Rysunki: drzewo rysowane ręcznie z obiektu rpart i prostokąty liści w przestrzeni predyktorów
etykiety <- function(f) gsub(">=", " ≥ ", gsub("< ?", " < ", labels(f, digits = 3)))
uklad <- function(f) {                                     # ramka rpart jest w porządku preorder
  fr <- f$frame; w <- as.integer(rownames(fr)); lisc <- fr$var == "<leaf>"
  x <- numeric(nrow(fr)); x[lisc] <- seq_len(sum(lisc))
  for (i in rev(which(!lisc))) x[i] <- mean(x[match(c(2 * w[i], 2 * w[i] + 1), w)])
  et <- etykiety(f); klasa <- levels(dane$status)[fr$yval2[, 1]]
  tekst <- ifelse(lisc, sprintf("%s\n%.0f%% rezygnacji\nn = %d", klasa, 100 * fr$yval2[, 5], fr$n),
                  et[match(2 * w, w)])                     # w węźle warunek prowadzący w lewo („tak”)
  data.frame(w, x, y = -floor(log2(w)), lisc, tekst, klasa)
}
prostokaty <- function(f) {                                # granice każdego liścia z warunków na ścieżce
  fr <- f$frame; w <- as.integer(rownames(fr)); et <- labels(f, digits = 10)
  do.call(rbind, lapply(which(fr$var == "<leaf>"), function(i) {
    g <- c(x0 = 2.5, x1 = 5, y0 = 0, y1 = 40); v <- w[i]
    while (v > 1) {
      war <- et[match(v, w)]; liczba <- as.numeric(sub(".*[<=>] ?", "", war))
      if (grepl("^ocena", war)) { if (grepl("<", war)) g["x1"] <- min(g["x1"], liczba) else g["x0"] <- max(g["x0"], liczba) }
      else { if (grepl("<", war)) g["y1"] <- min(g["y1"], liczba) else g["y0"] <- max(g["y0"], liczba) }
      v <- v %/% 2
    }
    data.frame(t(g), klasa = levels(dane$status)[fr$yval2[i, 1]], proc = 100 * fr$yval2[i, 5])
  }))
}
u <- uklad(drzewo)
kraw <- merge(transform(u[u$w > 1, c("w", "x", "y")], rodzic = w %/% 2), u[, c("w", "x", "y")],
              by.x = "rodzic", by.y = "w", suffixes = c("", "_r"))
kraw$strona <- ifelse(kraw$w %% 2 == 0, "tak", "nie")
pA <- ggplot(u, aes(x, y)) +
  geom_segment(data = kraw, aes(x = x_r, y = y_r, xend = x, yend = y), colour = "grey50") +
  geom_label(data = kraw, aes(x = (x + x_r) / 2, y = (y + y_r) / 2, label = strona),
             size = 3, linewidth = 0, colour = "grey30", fill = "white") +
  geom_label(data = u[!u$lisc, ], aes(label = tekst), size = 3.4, fill = "grey95") +
  geom_label(data = u[u$lisc, ], aes(label = tekst, colour = klasa), size = 3, fill = "white",
             show.legend = FALSE, lineheight = 0.9) +
  scale_colour_manual(values = kol) +
  scale_x_continuous(expand = expansion(add = 0.6)) + scale_y_continuous(expand = expansion(add = 0.45)) +
  labs(title = "A. Przycięte drzewo") + theme_void(base_size = 13)
pr <- prostokaty(drzewo)
pB <- ggplot() +
  geom_rect(data = pr, aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1, fill = klasa),
            alpha = 0.18, colour = "grey30") +
  geom_point(data = dane, aes(ocena, praca, colour = status, shape = status), size = 1.7) +
  geom_label(data = pr, aes((x0 + x1) / 2, (y0 + y1) / 2, label = sprintf("%.0f%%", proc)),
             size = 3.2, fill = "white", linewidth = 0.2) +
  scale_fill_manual(values = kol, name = "Prognoza i status") +
  scale_colour_manual(values = kol, name = "Prognoza i status") +
  scale_shape_manual(values = ksz, name = "Prognoza i status") +
  coord_cartesian(xlim = c(2.5, 5), ylim = c(0, 40), expand = FALSE) +
  labs(title = "B. Te same liście jako prostokąty", x = "Średnia ocen", y = "Praca zarobkowa (h/tydz.)")
p1 <- pA + (pB + motyw) + plot_layout(widths = c(1.15, 1))
pB_boot <- do.call(rbind, lapply(1:6, function(b) transform(prostokaty(boot[[b]]),
  proba = sprintf("Próba %d: %d liści", b, liscie[b]))))
p2 <- ggplot(pB_boot) +
  geom_rect(aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1, fill = klasa), alpha = 0.35, colour = "grey25") +
  geom_text(data = function(d) d[d$x1 - d$x0 > 0.15, ],     # litera tylko w szerszych prostokątach
            aes((x0 + x1) / 2, (y0 + y1) / 2, label = ifelse(klasa == "rezygnacja", "R", "K")),
            size = 3.2, colour = "grey15") +
  facet_wrap(~ proba, ncol = 3) + scale_x_continuous(breaks = 3:5) +
  scale_fill_manual(values = kol, name = "Prognoza (R – rezygnacja, K – kontynuacja)") +
  coord_cartesian(xlim = c(2.5, 5), ylim = c(0, 40), expand = FALSE) +
  labs(x = "Średnia ocen", y = "Praca zarobkowa (h/tydz.)") + motyw
p1
p2
Wynik w R
kontynuacja  rezygnacja
        129         171
     CP nsplit rel error xerror  xstd
1 0.450      0     1.000  1.000 0.066
2 0.043      1     0.550  0.566 0.058
3 0.008      3     0.465  0.488 0.055
4 0.001      6     0.442  0.550 0.057
     liscie_pelne  liscie_przyciete trafnosc_w_probie           blad_cv
             7.00              4.00              0.80              0.21
[1] "ocena 4.11"
zm_korzenia
ocena
  200
  0%  25%  50%  75% 100%
3.54 4.11 4.11 4.17 4.38
liscie
 3  4  5  6  7  8  9 10 11 13
 2 24 14 43 38 31 29 11  7  1
zgodnosc_srednia     zgodnosc_min
           0.880            0.703
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rpart (wersja 4.1.24): Therneau, T., & Atkinson, B. (2025). rpart: Recursive partitioning and regression trees [R package]. https://doi.org/10.32614/CRAN.package.rpart
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym drzewo decyzyjne różni się od regresji logistycznej?
Regresja logistyczna zakłada gładką zależność i podaje jeden współczynnik na predyktor. Drzewo dzieli dane progami i daje stałą prognozę w każdym liściu, więc samo znajduje interakcje i progi, ale gładką zależność przybliża schodkami.
Dlaczego drzewo decyzyjne jest niestabilne?
Każdy podział wybiera najlepszy próg w danej próbie, a kolejne podziały zależą od poprzednich. Gdy inny próg wygra o włos, zmienia się cała dalsza część drzewa. Widać to po dopasowaniu drzew do prób bootstrapowych.
Co oznacza liczba w liściu drzewa klasyfikacyjnego?
To odsetek osób z danym wynikiem wśród obserwacji, które trafiły do liścia, czyli prognozowane prawdopodobieństwo. Czytaj go razem z liczebnością liścia: odsetek z kilkunastu osób jest mało precyzyjny.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and regression trees. Wadsworth International Group.
- Strobl, C., Malley, J., & Tutz, G. (2009). An introduction to recursive partitioning: Rationale, application, and characteristics of classification and regression trees, bagging, and random forests. Psychological Methods, 14(4), 323–348. https://doi.org/10.1037/a0016973 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@book{breiman1984classification, author={Breiman, Leo and Friedman, Jerome H. and Olshen, Richard A. and Stone, Charles J.}, title={{Classification and regression trees}}, year={1984}, publisher={Wadsworth International Group}}@article{strobl2009introduction, author={Strobl, Carolin and Malley, James and Tutz, Gerhard}, title={{An introduction to recursive partitioning: Rationale, application, and characteristics of classification and regression trees, bagging, and random forests}}, journal={Psychological Methods}, year={2009}, volume={14}, number={4}, pages={323--348}, doi={10.1037/a0016973}}