Po co drzewa i lasy w badaniu naukowym
Drzewa decyzyjne i lasy losowe to metody uczenia nadzorowanego. Przewidują wynik z wielu predyktorów i nie wymagają, żebyś z góry zapisał(a) postać zależności. Strobl, Malley i Tutz (2009) wprowadzają je do psychologii jako narzędzie do danych z wieloma predyktorami i złożonymi interakcjami. Lasy losowe osiągają w takich danych wysoką trafność predykcji i dają opisowe miary ważności zmiennych.
To narzędzia do przewidywania, a nie do szacowania efektów przyczynowych. Yarkoni i Westfall (2017) przekonują, że psychologia zyskałaby na takim myśleniu, ale wymaga ono innego sposobu oceny modelu: liczy się trafność na nowych danych, a nie p przy współczynniku. Różnicę między modelem predykcyjnym a wyjaśniającym, walidację krzyżową i kalibrację omawiamy we wpisie o modelach predykcyjnych. Tu skupiamy się na samych drzewach i lasach. Szerszy kontekst eksploracji danych opisuje hasło data mining.
| Sytuacja | Rozsądny wybór |
|---|---|
| Testujesz hipotezę o kierunku i sile związku | regresja z predyktorami wybranymi z teorii |
| Chcesz prostych reguł „jeśli…, to…”, np. do opisu grup ryzyka | pojedyncze drzewo, przycięte |
| Liczy się trafność prognozy, a zależności mogą być nieliniowe i z interakcjami | las losowy, porównany z regresją na tych samych danych testowych |
| Wiele predyktorów, zależności prawie liniowe | regresja z karą (LASSO, regresja grzbietowa) |
| Nieliniowość jednej lub kilku zmiennych w modelu wyjaśniającym | splajny i GAM |
Las nie wygrywa z regresją automatycznie. W przeglądzie 71 badań nad klinicznymi modelami predykcyjnymi modele uczenia maszynowego, najczęściej drzewa i lasy losowe, nie przewyższały regresji logistycznej w porównaniach o niskim ryzyku błędu. Przewaga pojawiała się głównie w porównaniach o wysokim ryzyku błędu (Christodoulou i in., 2019). Dlatego zawsze porównuj las z regresją na tych samych danych testowych.
Jak działa drzewo regresyjne
Drzewo (CART) dzieli próbę na dwie części według tej zmiennej i tego punktu podziału, które najbardziej zmniejszają zróżnicowanie wyniku w powstałych grupach. Potem powtarza to w każdej grupie osobno. Prognozą jest średnia w końcowym węźle, czyli liściu. Interakcje pojawiają się same: inny podział w każdej gałęzi oznacza, że wpływ zmiennej zależy od wcześniejszych podziałów.
Duże drzewo dopasowuje się do szumu, czyli ulega przeuczeniu. Dlatego drzewo się przycina. W rpart parametr złożoności cp wybiera się walidacją krzyżową, często regułą jednego błędu standardowego. Wybierasz wtedy najmniejsze drzewo, którego błąd walidacji mieści się w 1 SE od minimum. Pojedyncze drzewo jest też niestabilne: inna próba może dać zupełnie inne podziały (Strobl i in., 2009). Każdy podział to dychotomizacja, więc drzewo ma część wad dzielenia zmiennej medianą: zależność liniową przybliża schodkami.
Przykład: wypalenie zawodowe pielęgniarek
Zbadano 1000 pielęgniarek i pielęgniarzy (dane symulowane). Wynikiem jest nasilenie wypalenia (0–100). Wśród 11 predyktorów są godziny pracy w tygodniu, dyżury nocne, wsparcie przełożonego (1–5), konflikt praca–dom (1–5), liczba pacjentów na dyżurze, staż, wiek, płeć i oddział. Są też dwie zmienne czysto losowe. Zależności zbudowano tak, jak mogłyby wyglądać w rzeczywistości:
- skok wypalenia powyżej 48 godzin pracy;
- dyżury nocne szkodzą tylko przy słabym wsparciu, czyli interakcja;
- wyższe wypalenie na początku kariery.
Wiek nie ma własnego efektu, ale koreluje ze stażem (r = .93). Modele budujemy na 700 osobach, a oceniamy na 300 pozostałych, których nie używamy wcześniej do żadnej decyzji.
Drzewo przycięte i nieprzycięte
Duże drzewo miało 55 liści, a po przycięciu regułą 1 SE zostało 11. Pierwszy podział przebiega przy 48.5 godziny pracy, czyli tam, gdzie w danych jest próg. Kolejne podziały dotyczą wsparcia przełożonego i konfliktu praca–dom. Najwyższe średnie wypalenie, 53.2 pkt, miały 53 osoby pracujące co najmniej 48.5 godziny przy wsparciu poniżej 3.05. Najniższe, 24.4 pkt, miało 85 osób pracujących krócej, z niskim konfliktem praca–dom i wsparciem co najmniej 3.75. Takie reguły łatwo przedstawić, ale pamiętaj o niestabilności drzewa.
| Model | R² (próba ucząca) | R² (próba testowa) | RMSE (próba testowa) |
|---|---|---|---|
| Regresja liniowa (efekty główne) | .611 | .518 | 7.24 |
| Drzewo bez przycinania (55 liści) | .755 | .480 | 7.52 |
| Drzewo przycięte (11 liści) | .609 | .509 | 7.31 |
| Las losowy (1000 drzew) | .920 | .596 | 6.63 |
Drzewo bez przycinania najlepiej pasowało do próby uczącej, a na nowych danych wypadło najgorzej. Przycięcie zmniejszyło tę różnicę. Las losowy przewidywał najlepiej: R² = .596 na próbie testowej, przy .518 dla regresji liniowej. Prawdziwa funkcja z symulacji, gdyby ją znać, osiągnęłaby .663. Bardzo wysokie R² lasu w próbie uczącej (.920) niczego nie mówi o jego trafności, bo las prawie zapamiętuje dane uczące. Las ocenia się na obserwacjach spoza próby bootstrapowej (OOB) albo na próbie testowej.
Las losowy: wiele drzew zamiast jednego
Breiman (2001) zaproponował las jako zespół drzew. Każde drzewo powstaje na losowej próbie bootstrapowej, a przy każdym podziale bierze pod uwagę tylko losowy podzbiór zmiennych (mtry). Prognozą jest średnia z drzew. Losowanie zmiennych zmniejsza korelację między drzewami. Obserwacje, które nie trafiły do danej próby bootstrapowej, służą do wewnętrznej oceny błędu (OOB) i do pomiaru ważności zmiennych.
W R najszybszą implementacją jest pakiet ranger (Wright i Ziegler, 2017). Las ma kilka hiperparametrów: liczbę drzew, mtry, minimalną wielkość węzła i sposób losowania obserwacji. Zwykle działa dość dobrze z wartościami domyślnymi, a strojenie może go poprawić (Probst i in., 2019). W przykładzie domyślne mtry = 3 dało R²OOB = .611. Strojenie na błędzie OOB poprawiło wynik najwyżej do .621 przy mtry = 6. Stroić można tylko na próbie uczącej albo w wewnętrznej walidacji krzyżowej. Strojenie na próbie testowej to wyciek informacji.
Ważność zmiennych: wybierz permutacyjną
Las nie ma współczynników ani wartości p. Zamiast nich podaje ważność zmiennych. Ważność permutacyjna mówi, o ile rośnie błąd prognozy, gdy wymieszasz wartości jednej zmiennej i zerwiesz jej związek z wynikiem. Ważność z nieczystości węzłów (ang. impurity) sumuje spadki zróżnicowania przy podziałach według danej zmiennej.
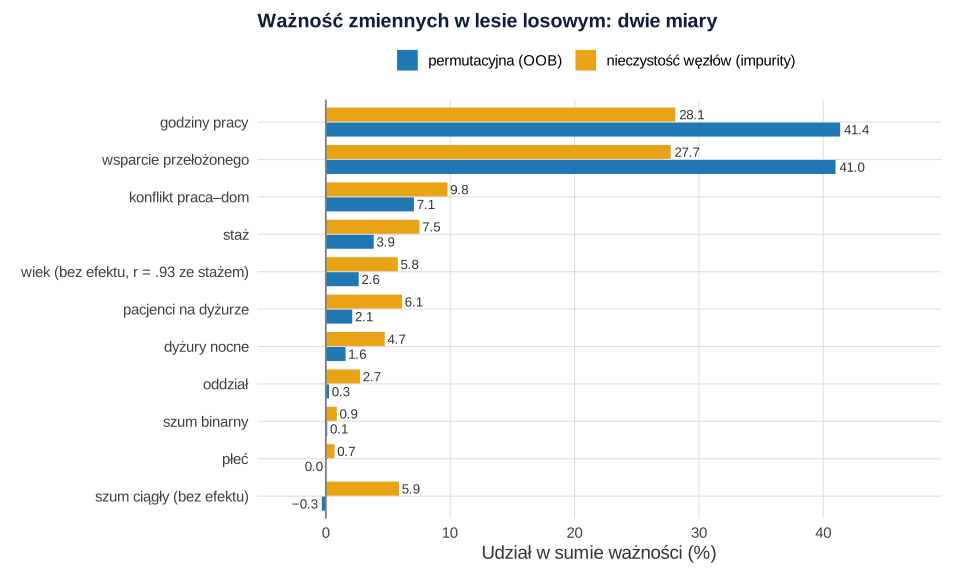
Rysunek 1 pokazuje dwa znane problemy.
- Obciążenie miary z nieczystości. Zmienna ciągła ma wiele możliwych punktów podziału, więc częściej trafia do drzew przypadkiem. Ciągły szum dostał 5.9% ważności z nieczystości, więcej niż dyżury nocne (4.7%), a w mierze permutacyjnej −0.3%. Strobl i in. (2007) pokazali, że ważność w lasach jest niewiarygodna, gdy predyktory różnią się skalą pomiaru lub liczbą kategorii.
- Predyktory skorelowane. Wiek nie wpływa na wynik, ale dostał 2.6% ważności permutacyjnej, bo zastępuje staż. Strobl i in. (2008) opisują ten mechanizm i proponują warunkową ważność permutacyjną. Przy silnej współliniowości raportuj ważność ostrożnie.
Ważność można też policzyć na próbie testowej, tak jak w teście permutacyjnym. Wymieszanie godzin pracy zwiększyło RMSE o 3.34 pkt, wsparcia o 2.70, a konfliktu praca–dom o 0.74. Ważność nie mówi jednak nic o kierunku ani o przyczynowości. Duża ważność oznacza tylko, że zmienna pomaga przewidywać wynik. Pytania o efekty przyczynowe wymagają innego podejścia, np. grafu przyczynowego.
Zależność cząstkowa: jak wygląda związek
Kierunek i kształt związku pokazuje wykres zależności cząstkowej. Każdej osobie ustawiasz tę samą wartość predyktora, np. 40 godzin, i uśredniasz prognozy lasu. Potem powtarzasz to dla kolejnych wartości.
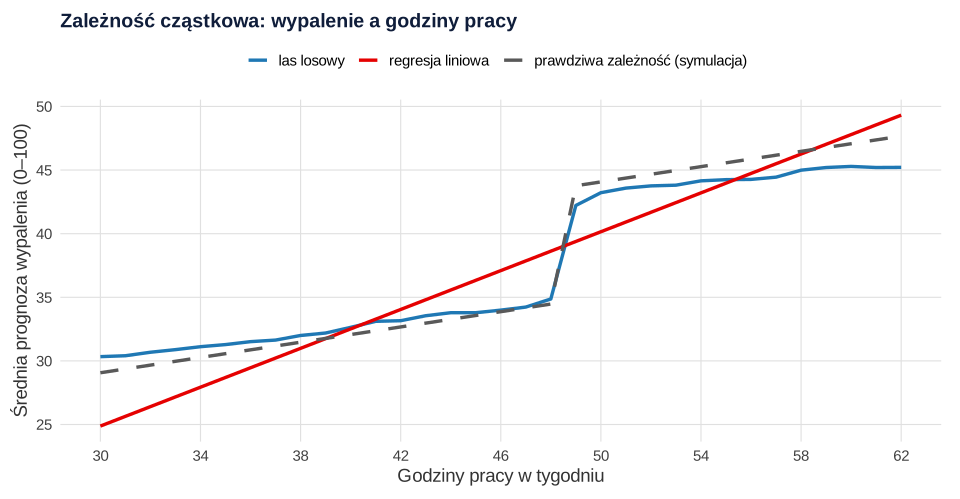
Las odtworzył próg: średnia prognoza rośnie z 34.9 pkt przy 48 godzinach do 42.2 pkt przy 49. Regresja liniowa rozłożyła ten skok na cały zakres jako 0.76 pkt na godzinę. Przy krótkiej pracy zawyża więc różnice, a wokół progu je zaniża. Na krańcach zakresu, gdzie jest mało danych, krzywa lasu się spłaszcza, bo las nie ekstrapoluje.
Walidacja i raportowanie
- Odłóż próbę testową przed analizą albo użyj zagnieżdżonej walidacji krzyżowej. Strojenie, dobór zmiennych i imputację wykonuj tylko na części uczącej (szczegóły w poradniku o walidacji).
- Raportuj punkt odniesienia. Podaj trafność regresji na tych samych danych testowych.
- Przy wyniku dwuwartościowym oceniaj dyskryminację (krzywa ROC) i kalibrację, nie tylko trafność klasyfikacji.
- Zadbaj o liczebność. Elastyczne modele potrzebują więcej danych niż regresja (zob. ile predyktorów przy danej próbie).
- Raport modelu predykcyjnego porównaj z listą TRIPOD+AI, która obejmuje modele budowane zarówno regresją, jak i uczeniem maszynowym (Collins i in., 2024).
Jak opisać las losowy w artykule
Podaj pakiet i wersję, liczbę drzew, mtry, minimalną wielkość węzła, sposób strojenia, schemat walidacji, miarę ważności i punkt odniesienia:
Jeśli chcesz porównać las z regresją albo przygotować odpowiedź recenzentowi pytającemu o walidację, możemy pomóc w ramach wsparcia statystycznego dla badaczy. Więcej o planowaniu analiz znajdziesz w przewodniku po doktoracie i publikacjach.
Drzewo i las losowy w R: rpart i ranger
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik drzewa-lasy-dane.csv (możesz go pobrać tutaj), dzieli próbę i buduje regresję oraz drzewa. Drugi buduje las losowy, liczy ważność zmiennych i zależność cząstkową. Potrzebne pakiety: rpart i ranger.
1. Podział próby, regresja i drzewo CART z przycinaniem
R
# Dane symulowane: wypalenie zawodowe (0–100, wyższy = silniejsze) u 1000 pielęgniarek i pielęgniarzy
# Zależności celowo nieliniowe: próg nadgodzin, interakcja dyżurów nocnych ze słabym wsparciem, wyższe ryzyko na początku kariery
set.seed(2081)
N <- 1000
staz <- round(runif(N, 0.5, 35), 1)
dane <- data.frame(
  godziny   = pmin(pmax(round(rnorm(N, 44, 7)), 24), 70),           # godziny pracy w tygodniu
  nocne     = rpois(N, 4),                                          # dyżury nocne w miesiącu
  wsparcie  = round(pmin(pmax(rnorm(N, 3.4, 0.8), 1), 5), 1),       # wsparcie przełożonego (1–5)
  konflikt  = round(pmin(pmax(rnorm(N, 2.8, 0.9), 1), 5), 1),       # konflikt praca–dom (1–5)
  pacjenci  = pmax(round(rnorm(N, 12, 4)), 3),                      # pacjenci na dyżurze
  staz      = staz,                                                 # staż pracy (lata)
  wiek      = round(23 + staz + rnorm(N, 0, 4)),                    # silnie skorelowany ze stażem, bez własnego efektu
  plec      = factor(sample(c("K", "M"), N, TRUE, prob = c(.85, .15))),
  oddzial   = factor(sample(c("internistyczny", "chirurgiczny", "intensywna terapia", "psychiatryczny", "pediatryczny"), N, TRUE)),
  szum_ciagly  = round(rnorm(N), 2),                                # bez związku z wynikiem
  szum_binarny = rbinom(N, 1, .5)                                   # bez związku z wynikiem
)
dane$wypalenie <- with(dane, round(pmin(pmax(
  30 + 9 * (godziny > 48) + 0.3 * (godziny - 44) + 1.6 * nocne * (wsparcie < 3) - 3 * (wsparcie - 3.4) +
    3.5 * (konflikt - 2.8) + 0.4 * (pacjenci - 12) + 10 * exp(-staz / 4) +
    3 * (oddzial == "intensywna terapia") + rnorm(N, 0, 6), 0), 100)))
write.csv(dane, "drzewa-lasy-dane.csv", row.names = FALSE)
summary(dane$wypalenie)
round(cor(dane$staz, dane$wiek), 2)

# Podział na próbę uczącą (700) i testową (300) – testowej nie używamy do budowy modeli
library(rpart)
ucz_id <- sample(N, 700)
ucz <- dane[ucz_id, ]; test <- dane[-ucz_id, ]
r2 <- function(y, p) 1 - sum((y - p)^2) / sum((y - mean(y))^2)
rmse <- function(y, p) sqrt(mean((y - p)^2))
ocena <- function(model, p_ucz, p_test) data.frame(model, R2_ucz = r2(ucz$wypalenie, p_ucz),
  R2_test = r2(test$wypalenie, p_test), RMSE_test = rmse(test$wypalenie, p_test))

# Punkt odniesienia: regresja liniowa ze wszystkimi predyktorami (efekty główne)
lin <- lm(wypalenie ~ ., data = ucz)

# Drzewo regresyjne CART: najpierw duże drzewo, potem przycinanie według 10-krotnej walidacji krzyżowej
drzewo_duze <- rpart(wypalenie ~ ., data = ucz, method = "anova", control = rpart.control(cp = 0.001, xval = 10))
cpt <- drzewo_duze$cptable
prog_1se <- min(cpt[, "xerror"]) + cpt[which.min(cpt[, "xerror"]), "xstd"]   # reguła 1 SE
cp_1se <- cpt[which(cpt[, "xerror"] <= prog_1se)[1], "CP"]
drzewo <- prune(drzewo_duze, cp = cp_1se)
c(liscie_duze = sum(drzewo_duze$frame$var == "<leaf>"), liscie_przyciete = sum(drzewo$frame$var == "<leaf>"))
print(drzewo, digits = 3)

wyniki <- rbind(ocena("regresja liniowa", fitted(lin), predict(lin, test)),
                ocena("drzewo bez przycinania", predict(drzewo_duze), predict(drzewo_duze, test)),
                ocena("drzewo przycięte (1 SE)", predict(drzewo), predict(drzewo, test)))
print(cbind(wyniki[1], round(wyniki[-1], 3)), row.names = FALSE)

# Sufit: R² prawdziwej funkcji z symulacji (bez szumu) na próbie testowej
prawda <- with(test, 30 + 9 * (godziny > 48) + 0.3 * (godziny - 44) + 1.6 * nocne * (wsparcie < 3) - 3 * (wsparcie - 3.4) +
  3.5 * (konflikt - 2.8) + 0.4 * (pacjenci - 12) + 10 * exp(-staz / 4) + 3 * (oddzial == "intensywna terapia"))
round(r2(test$wypalenie, prawda), 3)
Wynik w R
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   5.00   28.00   35.00   35.63   42.00   73.00
[1] 0.93
     liscie_duze liscie_przyciete
              55               11
n= 700

node), split, n, deviance, yval
      * denotes terminal node

 1) root 700 78500 35.5
   2) godziny< 48.5 536 45100 32.6
     4) wsparcie>=2.95 387 21000 29.4
       8) konflikt< 2.85 198  8800 27.0
        16) wsparcie>=3.75 85  3170 24.4 *
        17) wsparcie< 3.75 113  4590 29.0 *
       9) konflikt>=2.85 189  9810 32.0
        18) godziny< 39.5 56  2930 27.9 *
        19) godziny>=39.5 133  5570 33.7
          38) wsparcie>=4.05 38  1160 29.6 *
          39) wsparcie< 4.05 95  3540 35.3 *
     5) wsparcie< 2.95 149 10500 40.7
      10) nocne< 5.5 120  6880 39.0
        20) konflikt< 3.05 68  3080 36.5 *
        21) konflikt>=3.05 52  2800 42.3 *
      11) nocne>=5.5 29  1850 47.7 *
   3) godziny>=48.5 164 13300 45.2
     6) wsparcie>=3.05 111  5680 41.4
      12) konflikt< 3 64  2920 39.2 *
      13) konflikt>=3 47  2060 44.3 *
     7) wsparcie< 3.05 53  2640 53.2 *
                   model R2_ucz R2_test RMSE_test
        regresja liniowa  0.611   0.518     7.240
  drzewo bez przycinania  0.755   0.480     7.521
 drzewo przycięte (1 SE)  0.609   0.509     7.311
[1] 0.663
2. Las losowy, ważność zmiennych i zależność cząstkowa
R
# Las losowy w ranger: ocena OOB i na próbie testowej, ważność permutacyjna i zależność cząstkowa
# Kontynuacja przepisu 1 (obiekty ucz, test, wyniki, ocena)
library(ranger)
las <- ranger(wypalenie ~ ., data = ucz, num.trees = 1000, importance = "permutation", seed = 2082)
c(mtry = las$mtry, min_wezel = las$min.node.size, R2_OOB = round(las$r.squared, 3))
p_las <- predict(las, test)$predictions
wyniki <- rbind(wyniki, ocena("las losowy (1000 drzew)", predict(las, ucz)$predictions, p_las))
print(cbind(wyniki[1], round(wyniki[-1], 3)), row.names = FALSE)

# Strojenie mtry na błędzie OOB (bez zaglądania do próby testowej)
sapply(c(2, 3, 4, 6, 8, 11), function(m)
  round(ranger(wypalenie ~ ., data = ucz, num.trees = 1000, mtry = m, seed = 2082)$r.squared, 3))

# Ważność zmiennych: permutacyjna (OOB) i oparta na nieczystości węzłów (impurity)
las_imp <- ranger(wypalenie ~ ., data = ucz, num.trees = 1000, importance = "impurity", seed = 2082)
waznosc <- data.frame(permutacyjna = las$variable.importance, nieczystosc = las_imp$variable.importance)
waznosc$perm_proc <- 100 * waznosc$permutacyjna / sum(pmax(waznosc$permutacyjna, 0))
waznosc$niecz_proc <- 100 * waznosc$nieczystosc / sum(waznosc$nieczystosc)
round(waznosc[order(-waznosc$permutacyjna), c("permutacyjna", "perm_proc", "niecz_proc")], 2)

# Ważność permutacyjna na próbie testowej: wzrost RMSE po wymieszaniu jednej zmiennej (średnia z 20 permutacji)
set.seed(2083)
wzrost <- sapply(setdiff(names(test), "wypalenie"), function(v) mean(replicate(20, {
  t2 <- test; t2[[v]] <- sample(t2[[v]]); rmse(test$wypalenie, predict(las, t2)$predictions) })) - rmse(test$wypalenie, p_las))
round(sort(wzrost, decreasing = TRUE), 2)

# Zależność cząstkowa: średnia prognoza lasu przy ustawieniu wszystkim tej samej liczby godzin pracy
siatka <- 30:62
pd <- sapply(siatka, function(g) { t2 <- ucz; t2$godziny <- g; mean(predict(las, t2)$predictions) })
round(setNames(pd, siatka)[as.character(c(40, 44, 48, 49, 52, 60))], 1)
round(coef(lin)[["godziny"]], 2)
Wynik w R
     mtry min_wezel    R2_OOB
    3.000     5.000     0.611
                   model R2_ucz R2_test RMSE_test
        regresja liniowa  0.611   0.518     7.240
  drzewo bez przycinania  0.755   0.480     7.521
 drzewo przycięte (1 SE)  0.609   0.509     7.311
 las losowy (1000 drzew)  0.920   0.596     6.634
[1] 0.585 0.611 0.619 0.621 0.618 0.617
             permutacyjna perm_proc niecz_proc
godziny             51.13     41.36      28.10
wsparcie            50.66     40.98      27.74
konflikt             8.76      7.08       9.78
staz                 4.76      3.85       7.52
wiek                 3.27      2.64       5.79
pacjenci             2.62      2.12       6.12
nocne                1.96      1.59       4.74
oddzial              0.32      0.26       2.74
szum_binarny         0.14      0.11       0.88
plec                -0.03     -0.03       0.70
szum_ciagly         -0.40     -0.33       5.89
     godziny     wsparcie     konflikt         staz        nocne     pacjenci
        3.34         2.70         0.74         0.26         0.16         0.14
        wiek      oddzial  szum_ciagly szum_binarny         plec
        0.11         0.06         0.01         0.01         0.00
  40   44   48   49   52   60
32.6 33.8 34.9 42.2 43.8 45.3
[1] 0.76
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami rpart i ranger; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rpart (wersja 4.1.24): Therneau, T., & Atkinson, B. (2025). rpart: Recursive partitioning and regression trees [R package]. https://doi.org/10.32614/CRAN.package.rpart
- ranger (wersja 0.18.0): Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Trafność liczona na danych uczących. Las w próbie uczącej miał R² = .920, a na nowych danych .596.
- Ważność z nieczystości jako ranking zmiennych. Faworyzuje zmienne ciągłe i o wielu kategoriach.
- Ważność jako efekt przyczynowy albo dowód, że zmienna „działa”.
- Interpretacja pojedynczego, nieprzyciętego drzewa bez sprawdzenia jego stabilności.
- Brak porównania z regresją, która przy prostych zależnościach bywa równie dobra.
- Strojenie hiperparametrów na próbie testowej i raportowanie najlepszego wyniku.
Najczęstsze pytania
Czy las losowy jest lepszy od regresji?
Nie zawsze. Las wygrywa, gdy zależności są nieliniowe albo zawierają interakcje, których nie zapisano w regresji. W przeglądzie badań klinicznych uczenie maszynowe nie przewyższało regresji logistycznej w porównaniach o niskim ryzyku błędu (Christodoulou i in., 2019). Rozstrzyga porównanie na tych samych danych testowych.
Jak przyciąć drzewo decyzyjne w rpart?
Zbuduj duże drzewo z małym cp, odczytaj tabelę cptable z błędem walidacji krzyżowej (xerror) i wybierz najmniejsze drzewo, którego błąd mieści się w 1 SE od minimum. Przytnij je funkcją prune(). W przykładzie 55 liści zredukowano do 11.
Którą miarę ważności zmiennych w lesie losowym wybrać?
Wybierz ważność permutacyjną. Miara z nieczystości węzłów faworyzuje zmienne ciągłe i o wielu kategoriach (Strobl i in., 2007): w przykładzie czysty szum dostał w niej 5.9% sumy ważności. Przy silnie skorelowanych predyktorach ważność permutacyjna też jest zawyżona, więc interpretuj ją ostrożnie.
Co to jest błąd OOB w lesie losowym?
Każde drzewo powstaje na próbie bootstrapowej, więc około jednej trzeciej obserwacji do niego nie trafia. Prognozy dla tych obserwacji (ang. out-of-bag) dają wewnętrzną ocenę błędu bez osobnej próby testowej. Na tym błędzie możesz stroić hiperparametry, np. mtry.
Jak pokazać kierunek zależności w lesie losowym?
Użyj wykresu zależności cząstkowej. Każdej osobie ustawiasz tę samą wartość predyktora i uśredniasz prognozy, a potem powtarzasz to dla kolejnych wartości. Wykres pokazuje kształt związku, np. próg, ale tak jak ważność opisuje prognozę, a nie efekt przyczynowy.
Powiązane hasła
Przeczytaj też
Modele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikNieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikIle predyktorów w regresji?
Reguła 10 zdarzeń na predyktor i jej słabości, minimalna liczebność według Rileya i in., regresja liniowa i logistyczna oraz symulacja przeuczenia w R.
Czytaj →Chcesz sprawdzić, czy las losowy naprawdę przewiduje lepiej niż regresja?
Pomożemy zaplanować walidację, zbudować i porównać modele oraz opisać ważność zmiennych tak, żebyś mógł(a) samodzielnie zinterpretować i obronić wyniki.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/a:1010933404324 ● Otwarty dostęp: pełny tekst
- Christodoulou, E., Ma, J., Collins, G. S., Steyerberg, E. W., Verbakel, J. Y., & Van Calster, B. (2019). A systematic review shows no performance benefit of machine learning over logistic regression for clinical prediction models. Journal of Clinical Epidemiology, 110, 12–22. https://doi.org/10.1016/j.jclinepi.2019.02.004 ● Otwarty dostęp: pełny tekst
- Collins, G. S., Moons, K. G. M., Dhiman, P., Riley, R. D., Beam, A. L., Van Calster, B., Ghassemi, M., Liu, X., Reitsma, J. B., van Smeden, M., Boulesteix, A.-L., Camaradou, J. C., Celi, L. A., Denaxas, S., Denniston, A. K., Glocker, B., Golub, R. M., Harvey, H., Heinze, G., . . . Logullo, P. (2024). TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ, 385, Article e078378. https://doi.org/10.1136/bmj-2023-078378 ● Otwarty dostęp
- Probst, P., Wright, M. N., & Boulesteix, A.-L. (2019). Hyperparameters and tuning strategies for random forest. WIREs Data Mining and Knowledge Discovery, 9(3), Article e1301. https://doi.org/10.1002/widm.1301 ● Otwarty dostęp: pełny tekst
- Strobl, C., Boulesteix, A.-L., Kneib, T., Augustin, T., & Zeileis, A. (2008). Conditional variable importance for random forests. BMC Bioinformatics, 9(1), Article 307. https://doi.org/10.1186/1471-2105-9-307 ● Otwarty dostęp
- Strobl, C., Boulesteix, A.-L., Zeileis, A., & Hothorn, T. (2007). Bias in random forest variable importance measures: Illustrations, sources and a solution. BMC Bioinformatics, 8(1), Article 25. https://doi.org/10.1186/1471-2105-8-25 ● Otwarty dostęp
- Strobl, C., Malley, J., & Tutz, G. (2009). An introduction to recursive partitioning: Rationale, application, and characteristics of classification and regression trees, bagging, and random forests. Psychological Methods, 14(4), 323–348. https://doi.org/10.1037/a0016973 ● Otwarty dostęp: pełny tekst
- Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1). https://doi.org/10.18637/jss.v077.i01 ● Otwarty dostęp
- Yarkoni, T., & Westfall, J. (2017). Choosing prediction over explanation in psychology: Lessons from machine learning. Perspectives on Psychological Science, 12(6), 1100–1122. https://doi.org/10.1177/1745691617693393 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{breiman2001random, author={Breiman, Leo}, title={{Random forests}}, journal={Machine Learning}, year={2001}, volume={45}, number={1}, pages={5--32}, doi={10.1023/a:1010933404324}}@article{christodoulou2019systematic, author={Christodoulou, Evangelia and Ma, Jie and Collins, Gary S. and Steyerberg, Ewout W. and Verbakel, Jan Y. and Van Calster, Ben}, title={{A systematic review shows no performance benefit of machine learning over logistic regression for clinical prediction models}}, journal={Journal of Clinical Epidemiology}, year={2019}, volume={110}, pages={12--22}, doi={10.1016/j.jclinepi.2019.02.004}}@article{collins2024tripod, author={Collins, Gary S. and Moons, Karel G. M. and Dhiman, Paula and Riley, Richard D. and Beam, Andrew L. and Van Calster, Ben and Ghassemi, Marzyeh and Liu, Xiaoxuan and Reitsma, Johannes B. and van Smeden, Maarten and Boulesteix, Anne-Laure and Camaradou, Jennifer Catherine and Celi, Leo Anthony and Denaxas, Spiros and Denniston, Alastair K. and Glocker, Ben and Golub, Robert M. and Harvey, Hugh and Heinze, Georg and Hoffman, Michael M. and Kengne, André Pascal and Lam, Emily and Lee, Naomi and Loder, Elizabeth W. and Maier-Hein, Lena and Mateen, Bilal A. and McCradden, Melissa D. and Oakden-Rayner, Lauren and Ordish, Johan and Parnell, Richard and Rose, Sherri and Singh, Karandeep and Wynants, Laure and Logullo, Patricia}, title={{TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods}}, journal={BMJ}, year={2024}, volume={385}, eid={e078378}, doi={10.1136/bmj-2023-078378}}@article{probst2019hyperparameters, author={Probst, Philipp and Wright, Marvin N. and Boulesteix, Anne-Laure}, title={{Hyperparameters and tuning strategies for random forest}}, journal={WIREs Data Mining and Knowledge Discovery}, year={2019}, volume={9}, number={3}, eid={e1301}, doi={10.1002/widm.1301}}@article{strobl2008conditional, author={Strobl, Carolin and Boulesteix, Anne-Laure and Kneib, Thomas and Augustin, Thomas and Zeileis, Achim}, title={{Conditional variable importance for random forests}}, journal={BMC Bioinformatics}, year={2008}, volume={9}, number={1}, eid={307}, doi={10.1186/1471-2105-9-307}}@article{strobl2007bias, author={Strobl, Carolin and Boulesteix, Anne-Laure and Zeileis, Achim and Hothorn, Torsten}, title={{Bias in random forest variable importance measures: Illustrations, sources and a solution}}, journal={BMC Bioinformatics}, year={2007}, volume={8}, number={1}, eid={25}, doi={10.1186/1471-2105-8-25}}@article{strobl2009introduction, author={Strobl, Carolin and Malley, James and Tutz, Gerhard}, title={{An introduction to recursive partitioning: Rationale, application, and characteristics of classification and regression trees, bagging, and random forests}}, journal={Psychological Methods}, year={2009}, volume={14}, number={4}, pages={323--348}, doi={10.1037/a0016973}}@article{wright2017ranger, author={Wright, Marvin N. and Ziegler, Andreas}, title={{ranger: A fast implementation of random forests for high dimensional data in C++ and R}}, journal={Journal of Statistical Software}, year={2017}, volume={77}, number={1}, doi={10.18637/jss.v077.i01}}@article{yarkoni2017choosing, author={Yarkoni, Tal and Westfall, Jacob}, title={{Choosing prediction over explanation in psychology: Lessons from machine learning}}, journal={Perspectives on Psychological Science}, year={2017}, volume={12}, number={6}, pages={1100--1122}, doi={10.1177/1745691617693393}}