Co to jest gradient boosting?
Gradient boosting (wzmacnianie gradientowe) to metoda uczenia maszynowego, która buduje model predykcyjny jako sumę wielu małych drzew decyzyjnych dopasowywanych jedno po drugim. Każde kolejne drzewo poprawia błędy dotychczasowej sumy: jest dopasowywane do gradientu funkcji straty, czyli w regresji z kwadratem błędu po prostu do reszt. Friedman (2001) opisał tę ideę jako spadek gradientowy w przestrzeni funkcji i podał wersje dla różnych funkcji straty, w tym dla klasyfikacji z wiarygodnością logistyczną.
W odróżnieniu od lasu losowego, gdzie drzewa są głębokie i niezależne, tu drzewa są płytkie, a każde wnosi tylko ułamek poprawki. Najważniejsze hiperparametry to liczba drzew, współczynnik uczenia (shrinkage), głębokość drzew (rząd interakcji) i frakcja losowanej próby. Natekin i Knoll (2013) omawiają je jako sposoby kontrolowania złożoności modelu. Skalowalną implementacją boostingu drzew dla bardzo dużych zbiorów jest XGBoost (Chen i Guestrin, 2016).
Przykład
W symulowanych danych 2000 osób prawdopodobieństwo zdarzenia zależało od x1 nieliniowo, a od x3 tylko wtedy, gdy x2 > 0. Na 1500 osobach dopasowano regresję logistyczną i boosting (drzewa głębokości 2, współczynnik uczenia 0.01). Pięciokrotna walidacja krzyżowa wskazała 1135 drzew. Na 500 osobach testowych pole pod krzywą ROC wyniosło 0.764 dla boostingu wobec 0.733 dla regresji logistycznej. Przy 3000 drzewach AUC na zbiorze uczącym rosło do 0.877, a na testowym spadało do 0.757 – to typowy obraz przeuczenia.
Na rysunku
Rysunek pokazuje model z przykładu (te same dane, ziarno 687 i ustawienia gbm()) po 1, 10, 20, … 3000 drzewach. Błąd mierzy dewiancja Bernoulliego na osobę (im mniejsza, tym lepiej), a trafność – AUC. Ziarna nie dobierano.
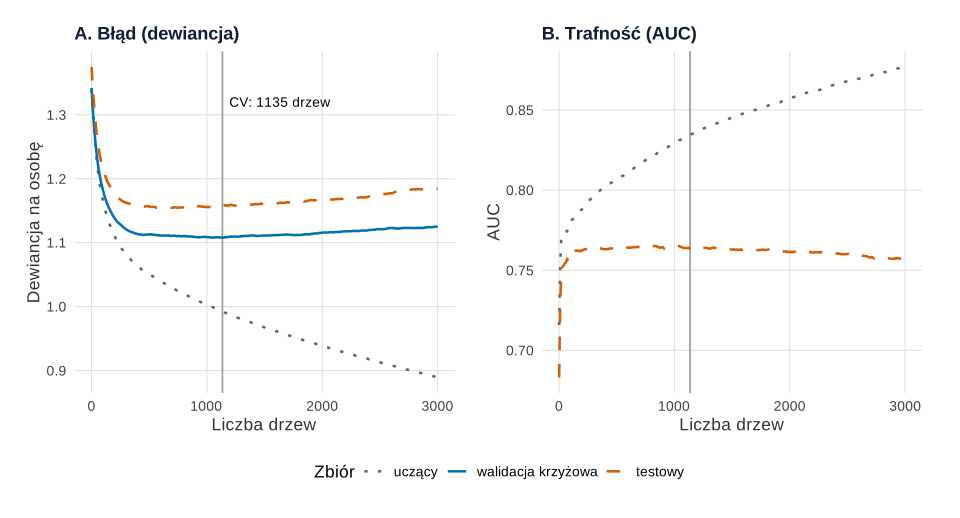
Co widać. Na zbiorze uczącym każde kolejne drzewo poprawia wynik: dewiancja spada z 1.165 po 100 drzewach do 0.889 po 3000, a AUC rośnie do 0.877. Na danych, których model nie widział, poprawa kończy się po kilkuset drzewach. Krzywa walidacji krzyżowej ma płaskie minimum przy 1135 drzewach (1.108), a zbiór testowy – przy 660 (1.154). Dalej oba błędy powoli rosną. Ta rosnąca różnica między krzywą uczącą a testową to przeuczenie. Zatrzymanie dodawania drzew w minimum krzywej walidacyjnej nazywa się wczesnym zatrzymaniem (early stopping).
Na co uważać. Minimum jest płaskie: AUC testowe wynosi 0.765 przy 660 drzewach i 0.764 przy 1135, więc dokładna liczba drzew ma tu małe znaczenie. Liczby drzew nie wybieraj z krzywej testowej, bo wtedy zbiór testowy przestaje być niezależny. Położenie minimum zależy od współczynnika uczenia i głębokości drzew, więc wyznacza się je osobno dla każdego zestawu ustawień. Rysunek przypomina krzywą uczenia, ale na osi poziomej jest złożoność modelu, nie liczebność próby.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby; paletę Okabe–Ito i motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (inny krój czcionki i siatka).
Kod R rysunku 1
# Rysunek 1. Błąd i AUC gradient boostingu w funkcji liczby drzew: zbiór uczący, walidacja krzyżowa, zbiór testowy
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(gbm))

kol <- c("uczący" = "grey40", "walidacja krzyżowa" = "#0072B2", "testowy" = "#D55E00")   # Okabe–Ito
typ <- c("uczący" = "dotted", "walidacja krzyżowa" = "solid", "testowy" = "dashed")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

# Dane i model z przykładu w haśle (to samo ziarno, te same losowania, te same ustawienia gbm)
set.seed(687)
n <- 2000
d <- data.frame(x1 = runif(n, -2, 2), x2 = runif(n, -2, 2), x3 = rnorm(n), x4 = rnorm(n))
eta <- -0.5 + 1.5 * sin(1.5 * d$x1) + 1.2 * (d$x2 > 0) * d$x3
d$y <- rbinom(n, 1, plogis(eta))
ucz <- d[1:1500, ]; test <- d[1501:2000, ]
invisible(capture.output(
  gb <- gbm(y ~ x1 + x2 + x3 + x4, data = ucz, distribution = "bernoulli",
            n.trees = 3000, interaction.depth = 2, shrinkage = 0.01,
            bag.fraction = 0.5, cv.folds = 5, n.cores = 1)))
m_opt <- gbm.perf(gb, method = "cv", plot.it = FALSE)

# Dewiancja Bernoulliego na osobę (−2 × średnia log-wiarygodność) i AUC po kolejnych 10 drzewach
dewiancja <- function(f, y) -2 * mean(y * f - log1p(exp(f)))
auc <- function(p, y) { r <- rank(p); n1 <- sum(y); (sum(r[y == 1]) - n1 * (n1 + 1) / 2) / (n1 * sum(1 - y)) }
drzewa <- c(1, seq(10, 3000, by = 10))
F_ucz <- predict(gb, ucz, n.trees = drzewa, type = "link")
F_test <- predict(gb, test, n.trees = drzewa, type = "link")
krzywe <- data.frame(
  drzewa = rep(drzewa, 3),
  zbior = factor(rep(names(kol), each = length(drzewa)), names(kol)),
  dewiancja = c(apply(F_ucz, 2, dewiancja, y = ucz$y), gb$cv.error[drzewa], apply(F_test, 2, dewiancja, y = test$y)),
  auc = c(apply(F_ucz, 2, auc, y = ucz$y), rep(NA, length(drzewa)), apply(F_test, 2, auc, y = test$y)))
m_test <- drzewa[which.min(krzywe$dewiancja[krzywe$zbior == "testowy"])]
cat("liczba drzew (CV):", m_opt, " minimum dewiancji testowej przy:", m_test, "drzewach\n")
oceny <- function(k) {
  f_u <- predict(gb, ucz, n.trees = k, type = "link"); f_t <- predict(gb, test, n.trees = k, type = "link")
  c(drzewa = k, dew_ucz = dewiancja(f_u, ucz$y), dew_cv = gb$cv.error[k], dew_test = dewiancja(f_t, test$y),
    auc_ucz = auc(f_u, ucz$y), auc_test = auc(f_t, test$y))
}
round(t(sapply(c(100, m_test, m_opt, 3000), oceny)), 3)

pA <- ggplot(krzywe, aes(drzewa, dewiancja, colour = zbior, linetype = zbior)) +
  geom_vline(xintercept = m_opt, colour = "grey60") +
  annotate("text", x = m_opt + 60, y = 1.32, label = paste0("CV: ", m_opt, " drzew"), hjust = 0, size = 3.6) +
  geom_line(linewidth = 0.9) +
  scale_colour_manual("Zbiór", values = kol) + scale_linetype_manual("Zbiór", values = typ) +
  labs(x = "Liczba drzew", y = "Dewiancja na osobę", title = "A. Błąd (dewiancja)") + motyw
pB <- ggplot(subset(krzywe, !is.na(auc)), aes(drzewa, auc, colour = zbior, linetype = zbior)) +
  geom_vline(xintercept = m_opt, colour = "grey60") +
  geom_line(linewidth = 0.9) +
  scale_colour_manual("Zbiór", values = kol, guide = "none") +      # legenda wspólna z panelem A
  scale_linetype_manual("Zbiór", values = typ, guide = "none") +
  labs(x = "Liczba drzew", y = "AUC", title = "B. Trafność (AUC)") + motyw
p1 <- (pA + pB) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1
Wynik w R
liczba drzew (CV): 1135  minimum dewiancji testowej przy: 660 drzewach
     drzewa dew_ucz dew_cv dew_test auc_ucz auc_test
[1,]    100   1.165  1.182    1.216   0.778    0.756
[2,]    660   1.033  1.111    1.154   0.814    0.765
[3,]   1135   0.992  1.108    1.158   0.835    0.764
[4,]   3000   0.889  1.125    1.184   0.877    0.757
Jak opisać w pracy
Na co uważać
- Liczbę drzew dobieraj walidacją, nie na zbiorze uczącym – wynik na danych uczących zawsze się poprawia.
- Względny wpływ to nie efekt przyczynowy. W przykładzie szum x4 dostał 11.5% wpływu, choć nie miał związku z wynikiem.
- Sprawdź kalibrację, nie tylko AUC, jeśli model ma podawać prawdopodobieństwa ryzyka.
- Przy małej próbie prostszy model z karą, np. LASSO, często działa równie dobrze i jest łatwiejszy do opisania.
Gradient boosting w R
Kod symuluje dane z efektem nieliniowym i interakcją, dopasowuje regresję logistyczną i model gbm(), dobiera liczbę drzew walidacją krzyżową (gbm.perf()) i porównuje AUC na zbiorze testowym. Liczby w tekście pochodzą z tego kodu.
Boosting drzew a regresja logistyczna na zbiorze testowym
R
set.seed(687)                                        # dane symulowane: 2000 osób, efekt nieliniowy i interakcja
n <- 2000
d <- data.frame(x1 = runif(n, -2, 2), x2 = runif(n, -2, 2), x3 = rnorm(n), x4 = rnorm(n))
eta <- -0.5 + 1.5 * sin(1.5 * d$x1) + 1.2 * (d$x2 > 0) * d$x3
d$y <- rbinom(n, 1, plogis(eta))
ucz <- d[1:1500, ]; test <- d[1501:2000, ]
auc <- function(p, y) { r <- rank(p); n1 <- sum(y); (sum(r[y == 1]) - n1 * (n1 + 1) / 2) / (n1 * sum(1 - y)) }
logit <- glm(y ~ x1 + x2 + x3 + x4, family = binomial, data = ucz)
suppressPackageStartupMessages(library(gbm))
invisible(capture.output(                           # wycisza komunikaty "CV: k"
  gb <- gbm(y ~ x1 + x2 + x3 + x4, data = ucz, distribution = "bernoulli",
            n.trees = 3000, interaction.depth = 2, shrinkage = 0.01,
            bag.fraction = 0.5, cv.folds = 5, n.cores = 1)))
m_opt <- gbm.perf(gb, method = "cv", plot.it = FALSE)  # liczba drzew z 5-krotnej walidacji krzyżowej
cat("liczba drzew (CV):", m_opt, "\n")
p_log <- predict(logit, test, type = "response")
p_gb  <- predict(gb, test, n.trees = m_opt, type = "response")
p_3000 <- predict(gb, test, n.trees = 3000, type = "response")
round(c(AUC_logistyczna = auc(p_log, test$y), AUC_boosting = auc(p_gb, test$y),
        AUC_boosting_3000_drzew = auc(p_3000, test$y),
        AUC_3000_drzew_zbior_uczacy = auc(predict(gb, ucz, n.trees = 3000, type = "response"), ucz$y)), 3)
print(summary(gb, n.trees = m_opt, plotit = FALSE), digits = 3, row.names = FALSE)  # względny wpływ predyktorów
Wynik w R
liczba drzew (CV): 1135
            AUC_logistyczna                AUC_boosting
                      0.733                       0.764
    AUC_boosting_3000_drzew AUC_3000_drzew_zbior_uczacy
                      0.757                       0.877
 var rel.inf
  x1    47.9
  x3    25.1
  x2    15.4
  x4    11.5
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet gbm 2.3.1). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- gbm (wersja 2.3.1): Ridgeway, G., & GBM Developers. (2026). gbm: Generalized boosted regression models (R package version 2.3.1) [Computer software]. https://doi.org/10.32614/CRAN.package.gbm
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym gradient boosting różni się od lasu losowego?
Las losowy uśrednia wiele głębokich drzew budowanych niezależnie na próbach bootstrapowych. Boosting dodaje płytkie drzewa po kolei, a każde poprawia błędy poprzednich. Boosting zwykle wymaga staranniejszego strojenia, bo przy zbyt wielu drzewach łatwiej się przeucza.
Jak dobrać liczbę drzew i współczynnik uczenia?
Zwykle ustala się mały współczynnik uczenia (np. 0.01–0.1), a liczbę drzew wybiera walidacją krzyżową lub na zbiorze walidacyjnym. Mniejszy współczynnik wymaga więcej drzew, ale daje stabilniejszy model.
Czy gradient boosting nadaje się do małej próby?
Przy kilkudziesięciu czy stu kilkudziesięciu obserwacjach elastyczny model łatwo się przeucza, a oszacowanie jego trafności jest niestabilne. Wtedy lepiej sprawdza się regresja z karą lub prosty model zaplanowany z góry.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Drzewa decyzyjne i lasy losowe
CART i przycinanie w rpart, las losowy w ranger, ważność permutacyjna, zależność cząstkowa, walidacja na nowych danych i wzór opisu.
Czytaj →PoradnikModele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Chen, T., & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 785–794). ACM. https://doi.org/10.1145/2939672.2939785 ● Otwarty dostęp
- Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. The Annals of Statistics, 29(5), 1189–1232. https://doi.org/10.1214/aos/1013203451
- Natekin, A., & Knoll, A. (2013). Gradient boosting machines, a tutorial. Frontiers in Neurorobotics, 7, Article 21. https://doi.org/10.3389/fnbot.2013.00021 ● Otwarty dostęp
Cytowania BibTeX
@inproceedings{chen2016xgboost, author={Chen, Tianqi and Guestrin, Carlos}, title={{XGBoost: A scalable tree boosting system}}, booktitle={Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining}, year={2016}, pages={785--794}, publisher={ACM}, doi={10.1145/2939672.2939785}}@article{friedman2001greedy, author={Friedman, Jerome H.}, title={{Greedy function approximation: A gradient boosting machine}}, journal={The Annals of Statistics}, year={2001}, volume={29}, number={5}, pages={1189--1232}, doi={10.1214/aos/1013203451}}@article{natekin2013gradient, author={Natekin, Alexey and Knoll, Alois}, title={{Gradient boosting machines, a tutorial}}, journal={Frontiers in Neurorobotics}, year={2013}, volume={7}, eid={21}, doi={10.3389/fnbot.2013.00021}}