Co to jest krzywa uczenia?
Krzywa uczenia (ang. learning curve) to wykres błędu modelu predykcyjnego w funkcji liczebności próby uczącej. Zwykle ma dwie linie: błąd w próbie uczącej (na tych samych osobach, na których model oszacowano) i błąd w próbie walidacyjnej albo z walidacji krzyżowej. Odpowiada na praktyczne pytanie: czy więcej danych poprawi przewidywania, czy model jest po prostu za prosty? W psychologii to pytanie wraca coraz częściej, bo rośnie liczba badań o celu predykcyjnym (Yarkoni i Westfall, 2017).
Nie myl jej z wykresem błędu w funkcji złożoności modelu przy stałym n (krzywą walidacyjną) – ten pokazuje hasło przeuczenie.
Jak czytać krzywą uczenia
- Luka między liniami to miara przeuczenia: model dopasował się do szumu próby uczącej. Duża luka, która maleje z n, oznacza, że więcej danych pomoże.
- Obie linie zbiegają się wysoko – wyraźnie powyżej błędu nieusuwalnego (szumu w wyniku) – model jest za prosty (obciążony). Więcej osób tego nie zmieni; potrzebne są lepsze predyktory albo bardziej giętki model.
- Nachylenie linii walidacyjnej na prawym końcu mówi, ile da kolejna porcja danych. Linia płaska – niewiele.
Przykład
Zasymulowano wynik ilościowy, który zależy od 3 z 10 predyktorów (jeden wpływ jest nieliniowy, falisty), z szumem o SD = 1 – to najmniejszy możliwy błąd, jaki może osiągnąć nawet idealny model. Dla prób uczących od 50 do 1600 osób (po 20 powtórzeń) oszacowano regresję liniową (model prosty) i las losowy (model złożony), a błąd mierzono pierwiastkiem błędu średniokwadratowego (RMSE) w tej samej próbie walidacyjnej 5000 osób. Współczynniki prawdziwego modelu ustawiono ręcznie tak, by różnica między modelami była wyraźna; ziarna (786) nie zmieniano.
Regresja liniowa przy n = 50 miała RMSE 1.098 w próbie uczącej i 1.445 w walidacyjnej (luka 0.347). Przy n = 1600 linie prawie się zeszły: 1.258 i 1.270. Las losowy przy n = 1600 miał w walidacji 1.074, ale w próbie uczącej tylko 0.457 – luka 0.617.
Na rysunku
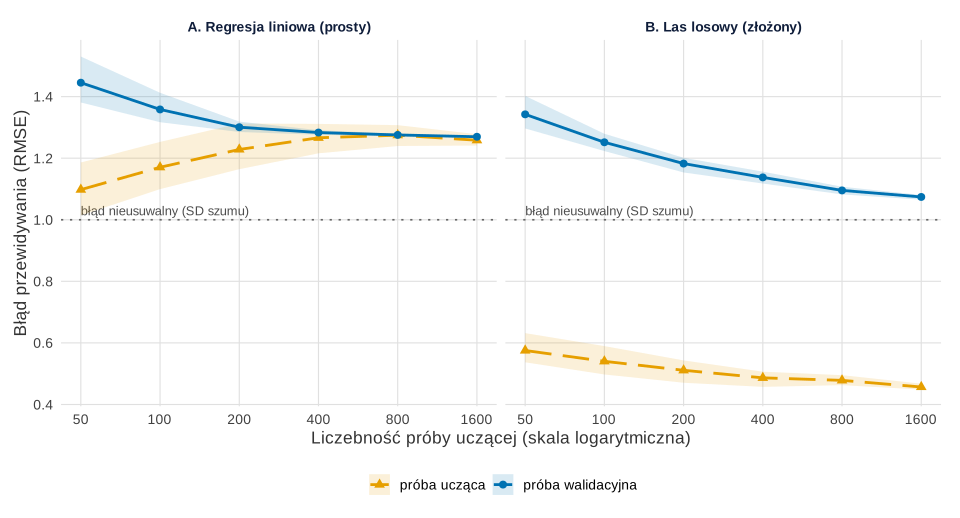
set.seed(786)).Co widać. Regresja liniowa szybko przestaje zyskiwać: od około 400 osób obie linie leżą razem na poziomie ok. 1.27, czyli z dala od błędu nieusuwalnego. Prosta nie uchwyci falistej zależności, ile by danych nie było. Las losowy ma odwrotny problem: ogromną lukę (przeuczenie), ale jego linia walidacyjna wciąż opada i zbliża się do 1.0. Ten model skorzysta na kolejnych danych.
Na co uważać. Niski błąd lasu w próbie uczącej to w dużej mierze zapamiętanie osób, nie trafność – dlatego zawsze patrz na linię walidacyjną. Wykres nie powie też, czy błąd 1.07 wystarcza w praktyce. Pojedynczy podział na próbę uczącą i walidacyjną daje poszarpaną krzywą – stąd powtórzenia i pasma.
Podpis do pracy:
Jak opisać w pracy
Opisz, jak liczono błąd walidacyjny, ile było powtórzeń i liczebności. Wniosek sformułuj jako decyzję: zbierać dane czy zmienić model.
Na co uważać
- Wyciek informacji. Jeśli tej samej próby walidacyjnej używasz do strojenia modelu, jej błąd staje się zbyt optymistyczny. Strojenie rób wewnątrz walidacji krzyżowej, jak we wpisie o walidacji modeli predykcyjnych.
- Przedłużanie krzywej. Krzywą można dopasować funkcją potęgową i przewidzieć błąd przy większym n (Figueroa i in., 2012), ale to szacunek, nie gwarancja. Liczebność próby dla modelu klinicznego planuj formalnymi wzorami (Riley i in., 2020).
- Duża luka przy małej próbie to sygnał do prostszego modelu lub kary za złożoność – regresja grzbietowa i LASSO zwykle wyraźnie ją zmniejsza. Więcej o lasach losowych – we wpisie drzewa decyzyjne i lasy losowe.
Krzywa uczenia w R
Kod w pętli losuje próbę uczącą o danej liczebności, dopasowuje oba modele i liczy RMSE w próbie uczącej i w stałej próbie walidacyjnej. Las losowy ma 200 drzew i jeden wątek, żeby wynik był powtarzalny; całość trwa kilkadziesiąt sekund. Rysunek na stronie powstał z obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Błąd uczący i walidacyjny w funkcji liczebności próby
R
# Krzywa uczenia: błąd w próbie uczącej i walidacyjnej w funkcji liczebności próby
suppressPackageStartupMessages({library(ggplot2); library(ranger)})
kol <- c("próba ucząca" = "#E69F00", "próba walidacyjna" = "#0072B2")   # Okabe–Ito; linie różnią się też typem i kształtem punktów
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
# Prawdziwy model: wynik zależy od 3 z 10 predyktorów, jeden wpływ jest nieliniowy, szum SD = 1
generuj <- function(n) {
  X <- as.data.frame(matrix(rnorm(n * 10), n, 10, dimnames = list(NULL, paste0("x", 1:10))))
  X$y <- 0.6 * X$x1 + 0.5 * X$x2 + 1.2 * sin(2 * X$x3) + rnorm(n, sd = 1)
  X
}
rmse <- function(y, y_hat) sqrt(mean((y - y_hat)^2))
set.seed(786)
walidacyjna <- generuj(5000)                      # duża próba walidacyjna, ta sama dla wszystkich modeli
liczebnosci <- c(50, 100, 200, 400, 800, 1600)
powtorzenia <- 20
wyniki <- do.call(rbind, lapply(liczebnosci, function(n) do.call(rbind, lapply(1:powtorzenia, function(r) {
  uczaca <- generuj(n)
  lin <- lm(y ~ ., data = uczaca)
  las <- ranger(y ~ ., data = uczaca, num.trees = 200, num.threads = 1)
  data.frame(n = n, model = rep(c("A. Regresja liniowa (prosty)", "B. Las losowy (złożony)"), each = 2),
             proba = rep(c("próba ucząca", "próba walidacyjna"), 2),
             rmse = c(rmse(uczaca$y, fitted(lin)), rmse(walidacyjna$y, predict(lin, walidacyjna)),
                      rmse(uczaca$y, predict(las, uczaca)$predictions),
                      rmse(walidacyjna$y, predict(las, walidacyjna)$predictions)))
}))))
srednie <- aggregate(rmse ~ n + model + proba, data = wyniki, FUN = mean)
srednie$dolna <- aggregate(rmse ~ n + model + proba, data = wyniki, FUN = quantile, probs = 0.1)$rmse
srednie$gorna <- aggregate(rmse ~ n + model + proba, data = wyniki, FUN = quantile, probs = 0.9)$rmse
p1 <- ggplot(srednie, aes(n, rmse, colour = proba, fill = proba, linetype = proba, shape = proba)) +
  geom_hline(yintercept = 1, linetype = "dotted", colour = "grey40") +
  annotate("text", x = 50, y = 1, label = "błąd nieusuwalny (SD szumu)", vjust = -0.5, hjust = 0, size = 3.4, colour = "grey30") +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), alpha = 0.15, colour = NA) +
  geom_line(linewidth = 1) + geom_point(size = 2.4) +
  facet_wrap(~ model) +
  scale_x_log10(breaks = liczebnosci) +
  scale_colour_manual(values = kol, name = NULL) + scale_fill_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("longdash", "solid"), name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(x = "Liczebność próby uczącej (skala logarytmiczna)", y = "Błąd przewidywania (RMSE)") + motyw
tabela <- reshape(srednie[, c("n", "model", "proba", "rmse")], idvar = c("model", "n"), timevar = "proba", direction = "wide")
names(tabela) <- c("n", "model", "ucząca", "walidacyjna")
tabela$luka <- tabela$walidacyjna - tabela$ucząca
tabela$model <- ifelse(startsWith(tabela$model, "A"), "liniowa", "las")
tabela[, 3:5] <- round(tabela[, 3:5], 3)
print(tabela[order(tabela$model, tabela$n), ], row.names = FALSE)
p1
Wynik w R
    n   model ucząca walidacyjna  luka
   50     las  0.575       1.342 0.767
  100     las  0.540       1.252 0.711
  200     las  0.511       1.183 0.672
  400     las  0.486       1.138 0.651
  800     las  0.478       1.095 0.617
 1600     las  0.457       1.074 0.617
   50 liniowa  1.098       1.445 0.347
  100 liniowa  1.171       1.358 0.188
  200 liniowa  1.228       1.301 0.072
  400 liniowa  1.266       1.283 0.017
  800 liniowa  1.275       1.276 0.001
 1600 liniowa  1.258       1.270 0.011
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe lm(), predict(), aggregate(); las losowy – pakiet ranger; rysunek – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ranger (wersja 0.18.0): Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Jak rozpoznać przeuczenie na krzywej uczenia?
Po dużej luce między błędem w próbie uczącej (niskim) a błędem w próbie walidacyjnej (wysokim). Jeśli luka maleje wraz z liczebnością próby, więcej danych zmniejszy przeuczenie; jeśli nie maleje, uprość model albo dodaj karę za złożoność.
Czy więcej danych zawsze poprawi model predykcyjny?
Nie. Gdy linie błędu uczącego i walidacyjnego już się zeszły, a błąd jest wyraźnie wyższy od szumu w danych, model jest za prosty – kolejne osoby niewiele dadzą. Wtedy pomagają lepsze predyktory albo bardziej giętki model.
Czym różni się krzywa uczenia od krzywej walidacyjnej?
Krzywa uczenia pokazuje błąd w funkcji liczebności próby przy stałym modelu. Krzywa walidacyjna pokazuje błąd w funkcji złożoności modelu (np. stopnia wielomianu, siły kary) przy stałej próbie. Pierwsza mówi, czy zbierać dane, druga – jaki model wybrać.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Modele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikDrzewa decyzyjne i lasy losowe
CART i przycinanie w rpart, las losowy w ranger, ważność permutacyjna, zależność cząstkowa, walidacja na nowych danych i wzór opisu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Figueroa, R. L., Zeng-Treitler, Q., Kandula, S., & Ngo, L. H. (2012). Predicting sample size required for classification performance. BMC Medical Informatics and Decision Making, 12(1), Article 8. https://doi.org/10.1186/1472-6947-12-8 ● Otwarty dostęp
- Riley, R. D., Ensor, J., Snell, K. I. E., Harrell, F. E., Martin, G. P., Reitsma, J. B., Moons, K. G. M., Collins, G., & van Smeden, M. (2020). Calculating the sample size required for developing a clinical prediction model. BMJ, 368, Article m441. https://doi.org/10.1136/bmj.m441 ● Otwarty dostęp
- Yarkoni, T., & Westfall, J. (2017). Choosing prediction over explanation in psychology: Lessons from machine learning. Perspectives on Psychological Science, 12(6), 1100–1122. https://doi.org/10.1177/1745691617693393 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{figueroa2012predicting, author={Figueroa, Rosa L. and Zeng-Treitler, Qing and Kandula, Sasikiran and Ngo, Long H.}, title={{Predicting sample size required for classification performance}}, journal={BMC Medical Informatics and Decision Making}, year={2012}, volume={12}, number={1}, eid={8}, doi={10.1186/1472-6947-12-8}}@article{riley2020calculating, author={Riley, Richard D. and Ensor, Joie and Snell, Kym I. E. and Harrell, Frank E. and Martin, Glen P. and Reitsma, Johannes B. and Moons, Karel G. M. and Collins, Gary and van Smeden, Maarten}, title={{Calculating the sample size required for developing a clinical prediction model}}, journal={BMJ}, year={2020}, volume={368}, eid={m441}, doi={10.1136/bmj.m441}}@article{yarkoni2017choosing, author={Yarkoni, Tal and Westfall, Jacob}, title={{Choosing prediction over explanation in psychology: Lessons from machine learning}}, journal={Perspectives on Psychological Science}, year={2017}, volume={12}, number={6}, pages={1100--1122}, doi={10.1177/1745691617693393}}