Przykład: sieć siłowni i pytanie „kto zrezygnuje z karnetu?”
Fikcyjna sieć czterech siłowni (kluby Centrum, Północ, Południe i Zachód) chce co miesiąc wskazać klientów, którzy w ciągu trzech miesięcy zrezygnują z karnetu. Recepcja zadzwoni do nich z ofertą zajęć z trenerem. Analityk ma 27 miesięcy historii: wizyty z bramek, staż, rodzaj karnetu (miesięczny, roczny, firmowy), wiek, odległość od klubu.
Wiersz danych to klient × miesiąc: stan na koniec miesiąca m i wynik „zrezygnował w miesiącach m + 1 … m + 3” (1 = tak). Razem 45 013 wierszy od 3727 klientów; w 11.7% wierszy klient rezygnuje w ciągu trzech miesięcy. Model budujemy na miesiącach 3–21 (39 262 wiersze). Wdrożenie to prognoza z końca miesiąca 24 dla 1907 klientów, z których 208 (10.9%) zrezygnowało. Dane są fikcyjne, więc tę „przyszłość” znamy i możemy sprawdzić, która ocena modelu mówiła prawdę.
Parametry ustawiliśmy ręcznie i wiemy, co w danych ukryliśmy. Liczba wizyt zależy od motywacji i zaangażowania klienta, których analityk nie widzi. Karnet roczny chroni przed rezygnacją poza miesiącem odnowienia. Od miesiąca 16 obok klubu Zachód działa konkurencyjna siłownia. Kto rezygnuje, w ostatnim miesiącu prawie nie przychodzi. Po pierwszym uruchomieniu zmieniliśmy raz dwa parametry wizyt (szczegóły w przepisie 1); ziarna 664 nie zmienialiśmy. Dane pobierzesz jako przeciek-silownia-klient-miesiac.csv.
Przeciek danych (ang. data leakage) to sytuacja, w której model w czasie uczenia lub oceny korzysta z informacji o wyniku, której w chwili prognozy nie da się mieć (Kaufman i in., 2012). Kapoor i Narayanan (2023) znaleźli go w 294 publikacjach z 17 dziedzin i opisali osiem jego rodzajów. W firmie najczęstsze są cztery:
- Zmienne z przyszłości – np. liczba wizyt w miesiącu rezygnacji albo data wypowiedzenia.
- Przygotowanie danych na całości przed podziałem – standaryzacja, imputacja, a przede wszystkim wybór zmiennych na danych razem ze zbiorem testowym.
- Ten sam klient w zbiorze uczącym i testowym – zwłaszcza gdy jego kolejne wiersze mają ten sam wynik.
- Losowy podział danych z czasem – model uczy się na „jutrze”, a sprawdzany jest na „wczoraj”.
Rysunek 1: co wolno wiedzieć w chwili prognozy
Najprostsza obrona przed przeciekiem to data przy każdej kolumnie. Zanim zbudujesz model, ustal chwilę prognozy T i sprawdź, czy każda informacja była znana przed nią.
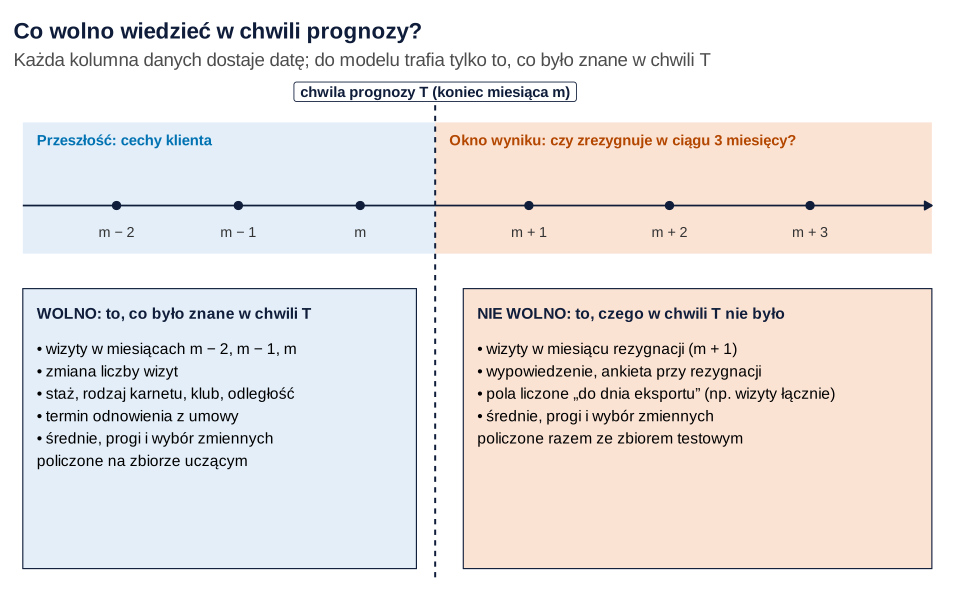
Co widać. Po lewej jest to, co recepcja wie na koniec miesiąca: wizyty, staż, karnet. Termin odnowienia karnetu rocznego wolno użyć, choć dotyczy przyszłości, bo zapisano go w umowie. Po prawej są informacje z okna wyniku, a także średnie i progi policzone razem ze zbiorem testowym – on udaje przyszłość, więc nie może wpływać na budowę modelu.
Jak może zmylić. Przeciek rzadko nazywa się „wynik”. Zwykle to niewinna kolumna z hurtowni danych, przeliczana co noc „do dziś”: łączna liczba wizyt, ostatnia wizyta, status klienta. W tabeli historycznej takie pole zawiera już przyszłość.
Podpis do pracy:
Rysunek 2: rezygnacje w czasie i wizyty przed rezygnacją
Dwa zjawiska tworzą okazję do przecieku: odsetek rezygnacji zmienia się w czasie, a rezygnujący klient przestaje przychodzić.
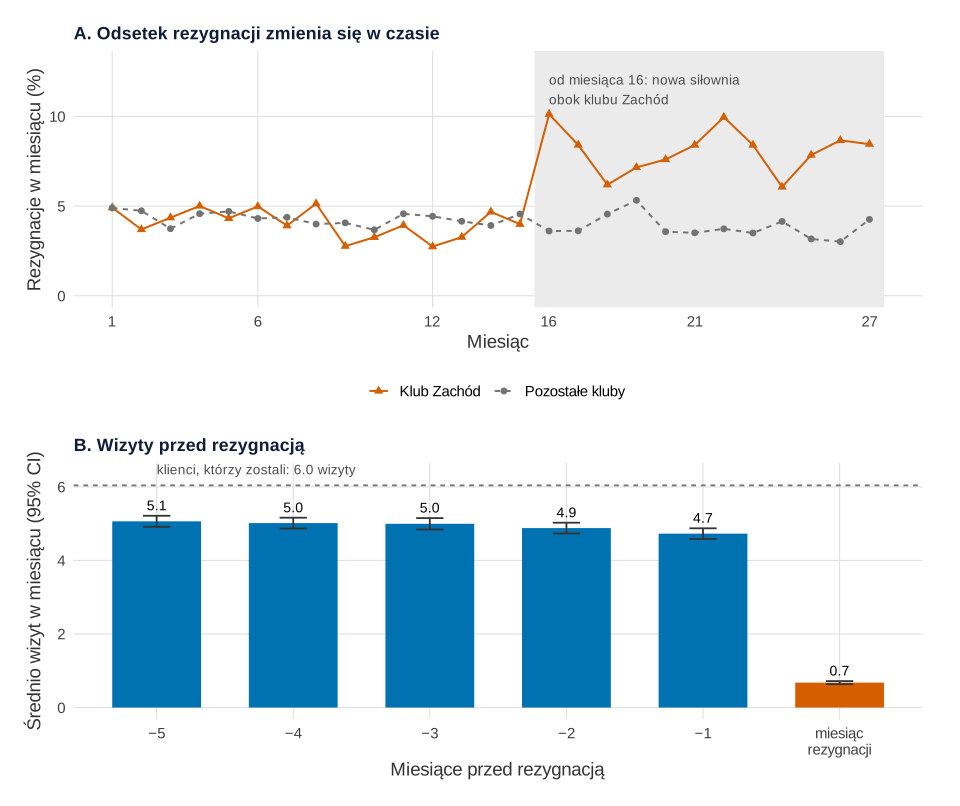
set.seed(664)).Co widać. W klubie Zachód miesięczny odsetek rezygnacji wzrósł z 4.07% (miesiące 1–15) do 8.11% (miesiące 16–27); w pozostałych klubach wynosił 4.31% i 3.83%. Panel B pokazuje 1566 klientów, którzy zrezygnowali po co najmniej sześciu miesiącach. Jeszcze miesiąc przed rezygnacją chodzili średnio 4.73 razy, czyli niewiele rzadziej niż wcześniej (5.06) i niż ci, którzy zostali (6.04). W miesiącu rezygnacji – tylko 0.68 razy.
Jak może zmylić. Słupek „miesiąc rezygnacji” wygląda jak świetny predyktor, ale to skutek decyzji klienta, a nie jej zapowiedź. Prawdziwe sygnały (słupki −5 do −1) są dużo słabsze.
Zdanie do Metody:
Rysunek 3: AUC w raporcie a AUC po wdrożeniu
Ten sam las losowy (300 drzew) oceniamy trzema sposobami i porównujemy pole pod krzywą ROC (AUC) w raporcie z AUC we wdrożeniu (miesiąc 24):
- A. W czasie, z przerwą. Uczenie na miesiącach 3–15, test na 18–21. Miesiące 16–17 pomijamy, bo ich wynik sięga już okresu testowego.
- B. Zmienna z przyszłości. Jak A, ale z wizytami w miesiącu m + 1. We wdrożeniu tej liczby nie ma, więc system podstawia ostatnią znaną wartość.
- C. Losowy podział wierszy 70/30. 96.2% klientów ze zbioru testowego ma też wiersze w uczącym, a ich sąsiednie miesiące mają często ten sam wynik.
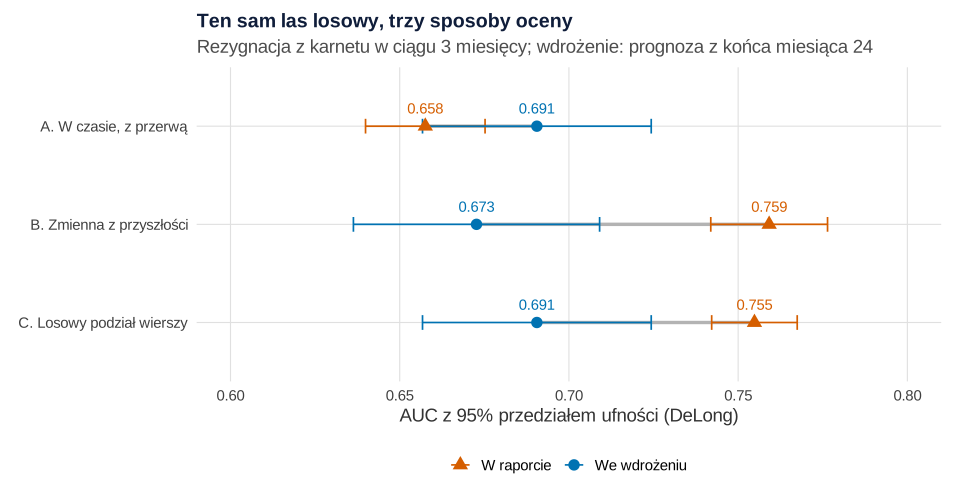
set.seed(664)).Co widać. Uczciwa ocena A dała AUC = .658 [.640, .675], a we wdrożeniu model osiągnął .691 [.657, .724]. Raport był ostrożny, bo wdrożony model uczył się na sześciu miesiącach więcej. Zmienna z przyszłości podniosła AUC w raporcie do .759 [.742, .776], a we wdrożeniu dała .673 [.636, .709] – mniej niż uczciwy model. Losowy podział wierszy dał .755 [.742, .767], choć wdrożony model (ten sam przepis) osiąga .691.
Jak może zmylić. Przeciek zmienia też wybór modelu. Regresja logistyczna z tymi samymi cechami miała w ocenie A AUC = .711, a w losowym podziale .698. Kto porównuje modele losowym podziałem, wybierze las (.755 wobec .698). Ocena w czasie wskazuje regresję. Las może rozpoznawać tych samych klientów po wieku i odległości, a regresja nie ma tej swobody (o przeuczeniu szerzej w haśle).
A standaryzacja na całych danych? Policzyliśmy to dla LASSO, gdzie skala zmiennych ma znaczenie. AUC w ocenie A: .7043 przy średnich i odchyleniach ze zbioru uczącego i .7042 przy tych z całych danych. Standaryzacja nie patrzy na wynik, więc szkodzi niewiele, ale i tak licz ją na zbiorze uczącym.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: trafny model z samego szumu
Najbardziej podstępny przeciek to wybór zmiennych na całych danych. W pilotażu w jednym klubie (400 klientów, 20% rezygnacji) wybieramy 10 wskaźników z aplikacji najsilniej skorelowanych z rezygnacją i budujemy regresję logistyczną na połowie klientów. Drugą połową sprawdzamy model. Haczyk: wszystkie wskaźniki to czysty szum, a rezygnacje wylosowano niezależnie od nich. Każdy wariant powtarzamy 500 razy.
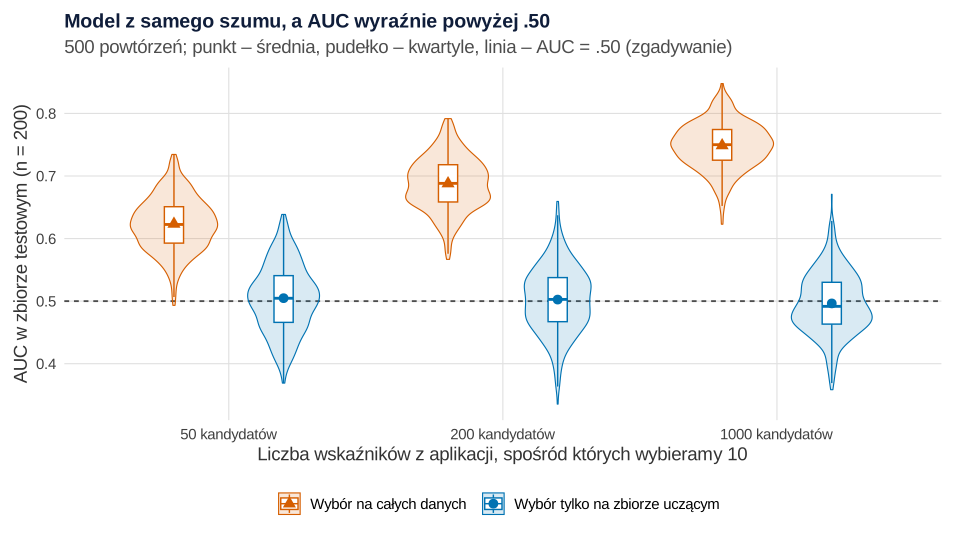
set.seed(664)).Co widać. Przy wyborze na całych danych średnie AUC wynosi .623 dla 50 kandydatów, .688 dla 200 i .749 dla 1000 (błąd Monte Carlo .002). Przy 200 kandydatach AUC ≥ .60 wyszło w 98.2% powtórzeń, przy 1000 – w każdym. Przy wyborze na zbiorze uczącym średnie AUC to .505, .502 i .496, czyli zgadywanie. Wśród 1000 losowych kolumn zawsze znajdzie się 10 „pasujących” do wyniku tych 400 osób.
Jak może zmylić. Zbiór testowy był odłożony, a model uczył się tylko na połowie danych – wszystko wygląda poprawnie. Przeciek siedzi o krok wcześniej, w wyborze zmiennych. Ambroise i McLachlan (2002) pokazali to na danych genetycznych: reguły z kilku genów miały błąd bliski zera, bo geny wybierano na tych samych próbkach, na których potem liczono błąd. Ta sama zasada dotyczy strojenia parametrów (Varma i Simon, 2006), metody krokowej i kodowania kategorii średnią wyniku. Jeden taki przykład na danych psychologicznych pokazuje poradnik modele predykcyjne: walidacja i kalibracja.
Podpis do pracy:
Rysunek 5: walidacja w czasie z oknem przesuwanym
Jeden podział w czasie to jedna liczba. Lepiej powtórzyć go w kilku punktach prognozy T: uczymy na siedmiu miesiącach, robimy przerwę na okno wyniku, sprawdzamy na miesiącu T i przesuwamy okno o trzy miesiące. Porównujemy to z losową 5-krotną walidacją krzyżową na tych samych wierszach.
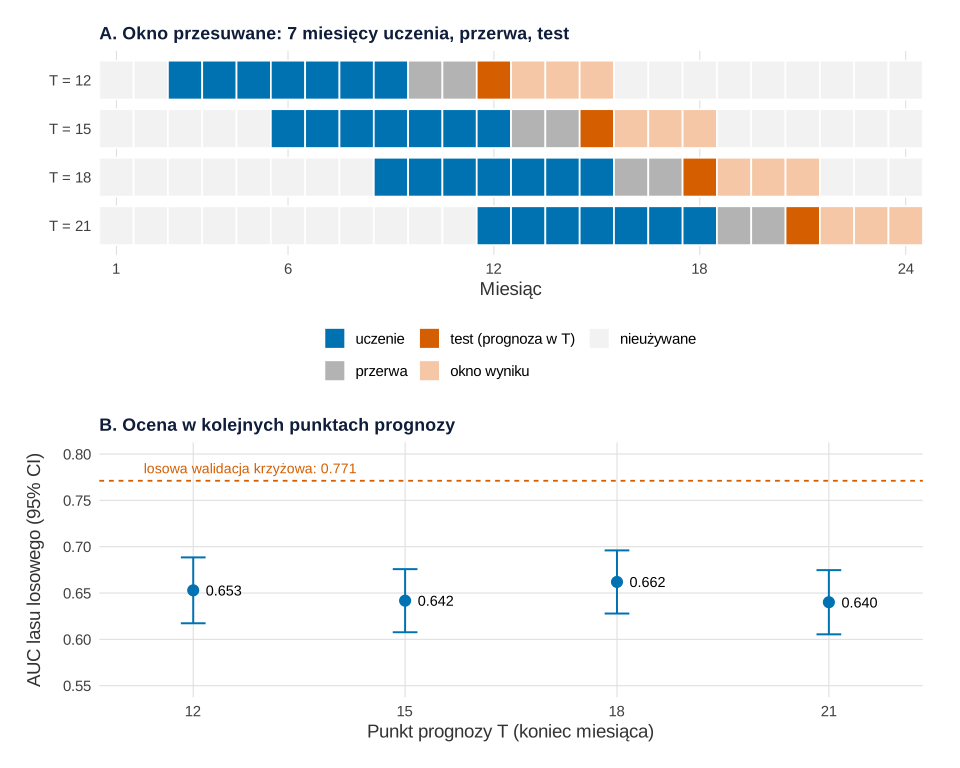
set.seed(664)).Co widać. W czterech punktach prognozy AUC lasu wynosi od .640 do .662 (średnio .649), a losowa walidacja krzyżowa daje .771. Regresja logistyczna ma w oknach średnio .697, a w losowej walidacji – też .697. Przeciek uderza więc w model elastyczny, zdolny zapamiętać pojedyncze osoby. Regresja wygrała z lasem w każdym z czterech okien (od .681 do .722).
Jak może zmylić. Wyniki z kolejnych okien nie są niezależnymi próbami. Okno przesuwane „zapomina” stare miesiące, co pomaga przy zmianach rynku, ale daje mniej danych do uczenia. Roberts i in. (2017) pokazali, że losowa walidacja krzyżowa danych z czasem lub grupami poważnie niedoszacowuje błędu, i zalecają podział blokami. Cerqueira i in. (2020) porównali metody oceny prognoz na 174 szeregach: przy niestacjonarnych danych najtrafniej wypadał test na odłożonym okresie powtórzony w kilku okresach. Tak samo ocenia się prognozy sprzedaży we wpisie prognoza sprzedaży: sezonowość, święta i promocje.
Podpis do pracy:
Zdanie do Wyników:
Lista kontrolna przed oddaniem modelu
- Chwila prognozy. Każda kolumna ma datę sprzed T; pola liczone „do dziś” odtwórz na dzień T.
- Podział. Dane z czasem dziel w czasie, z przerwą równą długości okna wyniku. Jeden klient – w jednym zbiorze.
- Przygotowanie. Standaryzację, imputację, kodowanie, wybór zmiennych i strojenie wykonuj na zbiorze uczącym (w walidacji krzyżowej – w każdej pętli osobno).
- Zbyt dobry wynik. Bardzo wysokie AUC albo jedna zmienna dominująca w ważności permutacyjnej to sygnał do sprawdzenia przecieku.
- Porównanie z prostym modelem. Jeśli las „wygrywa” z regresją tylko w losowym podziale, wygrywa przeciekiem.
- Po wdrożeniu. Po kilku miesiącach policz AUC i kalibrację na prawdziwych prognozach.
Co z tym zrobić w firmie
- Wybierz model oceną w czasie. W przykładzie zwykła regresja logistyczna była lepsza od lasu, a losowy podział mówił odwrotnie.
- Licz tabelę uczącą tą samą procedurą co w dniu prognozy. Kaufman i in. (2012) nazywają to rozdzieleniem danych do uczenia i do przewidywania.
- Planuj kampanię z AUC z oceny w czasie. Zawyżone AUC to obietnica, której recepcja nie dotrzyma. Zysk kampanii przy danym progu liczy wpis model odejść klientów i kampania retencyjna.
- Śledź zmiany rynku. Konkurencja przy klubie Zachód zmieniła poziom rezygnacji; model trzeba co kwartał sprawdzać na nowych miesiącach i w razie potrzeby uczyć na nowo.
Walidację w czasie w finansach opisuje wpis prognoza upadłości firm, a czas do rezygnacji modeluje wprost wpis churn jako analiza przeżycia.
Jak opisać w pracy
Napisz, co było znane w chwili prognozy, jak podzielono dane i gdzie przygotowano dane. Ogólne wskazówki do pracy z zarządzania znajdziesz we wpisie statystyka w pracy z zarządzania i ekonomii.
W Wynikach podaj tabelę porównania schematów oceny:
| Schemat oceny | Las losowy | Regresja logistyczna |
|---|---|---|
| Okno przesuwane (średnia z 4 punktów) | .649 | .697 |
| Losowa 5-krotna walidacja krzyżowa | .771 | .697 |
| Podział w czasie z przerwą (miesiące 18–21) | .658 | .711 |
| Losowy podział wierszy 70/30 | .755 | .698 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 4 – funkcje las(), przewidz() i auc_ci() oraz wzór regresji, z których korzysta przepis 6. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki 2–5 na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka), a rysunek 1 zapisano bez zmian – dane, geometrie i skale są identyczne.
Losują przepisy 1, 4, 5 i 6: każdy zaczyna losowanie od własnego set.seed(664), a las losowy dostaje to samo ziarno w argumencie seed. Ziarno 664 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę klientów, klubów i miesięcy, parametry wizyt i ryzyka rezygnacji, efekt konkurencji w klubie Zachód od miesiąca 16 oraz spadek wizyt w miesiącu rezygnacji (po pierwszym uruchomieniu zmieniono raz udział wizyt w miesiącu rezygnacji z 30% na 15% i wpływ motywacji i zaangażowania na wizyty, bo pierwsza wersja dawała do 52 wizyt w miesiącu) – przepis 1; podziały na okresy, przerwę i proporcję 70/30 (przepis 4); liczebność pilotażu, 20% rezygnacji, liczby kandydatów i 500 powtórzeń (przepis 5); długość okna i punkty prognozy (przepis 6). Las ma 300 drzew i domyślne pozostałe ustawienia pakietu ranger. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się około minuty.
1. Dane: sieć siłowni, klient × miesiąc
R
# Przepis 1. Fikcyjna sieć siłowni: 4 kluby, 27 miesięcy, wizyty i rezygnacje z karnetu
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("W raporcie" = "#D55E00", "We wdrożeniu" = "#0072B2", "Wybór na całych danych" = "#D55E00",
         "Wybór tylko na zbiorze uczącym" = "#0072B2", "Pozostali" = "grey45", "Rezygnujący" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie: 2400 klientów na starcie i 90 nowych co miesiąc; liczba wizyt zależy od stałej
# motywacji klienta i od zaangażowania, które zmienia się z miesiąca na miesiąc (analityk widzi tylko wizyty).
# Ryzyko rezygnacji rośnie przy spadku zaangażowania, karnet roczny chroni poza miesiącem odnowienia,
# a w klubie Zachód od miesiąca 16 działa nowa konkurencyjna siłownia. Kto rezygnuje, w ostatnim miesiącu
# przychodzi rzadko (15% zwykłej liczby wizyt). Po pierwszym uruchomieniu zmieniono raz: ten udział z 30% na 15%
# (wyraźniejszy spadek wizyt przy rezygnacji) i wpływ motywacji oraz zaangażowania na wizyty z 0.35 i 0.45
# na 0.30 i 0.35 (pierwsza wersja dawała do 52 wizyt w miesiącu).
set.seed(664)                                     # ziarno ustalone raz, bez dobierania pod wynik
M <- 27; n_start <- 2400; nowi <- 90
n <- n_start + nowi * M
klienci <- data.frame(id = sprintf("K%05d", 1:n),
                      start = c(sample(-35:0, n_start, replace = TRUE), rep(1:M, each = nowi)),  # miesiąc zakupu
                      klub = sample(c("Centrum", "Północ", "Południe", "Zachód"), n, replace = TRUE),
                      karnet = sample(c("miesięczny", "roczny", "firmowy"), n, replace = TRUE, prob = c(.55, .30, .15)),
                      wiek = round(pmin(pmax(rnorm(n, 34, 10), 18), 70)),
                      odleglosc = round(rexp(n, 1 / 3) + 0.3, 1))                               # km do klubu
motywacja <- rnorm(n); zaang <- rnorm(n)
wizyty <- matrix(NA_integer_, n, M); rezygnacja <- rep(NA_integer_, n)        # miesiąc rezygnacji
for (m in 1:M) {
  akt <- klienci$start <= m & is.na(rezygnacja)
  zaang <- 0.7 * zaang + 0.55 * rnorm(n)
  staz <- m - klienci$start + 1
  odnowienie <- klienci$karnet == "roczny" & staz %% 12 == 0
  logit <- -3.3 - 0.45 * motywacja - 0.75 * zaang + 0.5 * (staz <= 6) +
    ifelse(klienci$karnet == "roczny", ifelse(odnowienie, 0.8, -1.8), ifelse(klienci$karnet == "firmowy", -0.4, 0)) +
    0.08 * pmin(klienci$odleglosc, 10) + 0.9 * (klienci$klub == "Zachód" & m >= 16)
  odchodzi <- akt & runif(n) < plogis(logit)
  lambda <- exp(log(5.5) + 0.3 * motywacja + 0.35 * zaang - 0.04 * pmin(klienci$odleglosc, 10))
  wizyty[akt, m] <- rpois(sum(akt), ifelse(odchodzi[akt], 0.15, 1) * lambda[akt])
  rezygnacja[odchodzi] <- m
}

# Wiersz = klient × miesiąc m (stan na koniec miesiąca, klient nadal ma karnet, co najmniej 3 miesiące stażu).
# Wynik: rezygnacja w ciągu 3 kolejnych miesięcy. Dodatkowo kolumna z przyszłości: wizyty w miesiącu m + 1.
wiersze <- list()
for (m in 3:(M - 3)) {
  ok <- klienci$start <= m - 2 & (is.na(rezygnacja) | rezygnacja > m)
  nast <- if (m < M) wizyty[ok, m + 1] else NA
  wiersze[[m]] <- data.frame(klienci[ok, c("id", "klub", "karnet", "wiek", "odleglosc")], miesiac = m,
    staz = m - klienci$start[ok] + 1, wizyty = wizyty[ok, m], wizyty_3m = rowSums(wizyty[ok, (m - 2):m]),
    zmiana = wizyty[ok, m] - (wizyty[ok, m - 1] + wizyty[ok, m - 2]) / 2,
    odnowienie_3m = as.integer(klienci$karnet[ok] == "roczny" & ((m - klienci$start[ok] + 1) %% 12) >= 9),
    wizyty_nast = nast,                                      # PRZECIEK: znane dopiero po miesiącu m + 1
    rezygnuje = as.integer(!is.na(rezygnacja[ok]) & rezygnacja[ok] <= m + 3))
}
dane <- do.call(rbind, wiersze); rownames(dane) <- NULL
dane$klub <- factor(dane$klub); dane$karnet <- factor(dane$karnet)
write.csv(dane, "przeciek-silownia-klient-miesiac.csv", row.names = FALSE)

# Ile wierszy, klientów i rezygnacji? Budowa modelu: miesiące 3–21; „wdrożenie”: miesiąc 24
c(wiersze = nrow(dane), klienci = length(unique(dane$id)), rezygnacje_3m_proc = round(100 * mean(dane$rezygnuje), 1))
budowa <- dane[dane$miesiac <= 21, ]; wdrozenie <- dane[dane$miesiac == 24, ]
c(budowa_wiersze = nrow(budowa), budowa_klienci = length(unique(budowa$id)),
  wdrozenie_klienci = nrow(wdrozenie), wdrozenie_rezygnacje = sum(wdrozenie$rezygnuje),
  wdrozenie_proc = round(100 * mean(wdrozenie$rezygnuje), 1))
Wynik w R
           wiersze            klienci rezygnacje_3m_proc
           45013.0             3727.0               11.7
      budowa_wiersze       budowa_klienci    wdrozenie_klienci
             39262.0               3509.0               1907.0
wdrozenie_rezygnacje       wdrozenie_proc
               208.0                 10.9
2. Grafika „co wolno wiedzieć w chwili prognozy”: Rysunek 1
R
# Przepis 2. Grafika: oś czasu „co wolno wiedzieć w chwili prognozy” (Rysunek 1)
# Samodzielny przepis: niczego nie losuje i nie korzysta z innych przepisów.
library(ggplot2)

T0 <- 4.6                                            # chwila prognozy na osi grafiki
miesiace <- data.frame(x = c(1.2, 2.5, 3.8, 5.6, 7.1, 8.6),
                       etykieta = c("m − 2", "m − 1", "m", "m + 1", "m + 2", "m + 3"))
karty <- data.frame(
  x0 = c(0.2, 4.9), x1 = c(4.4, 9.9), y0 = c(0.15, 0.15), y1 = c(3.35, 3.35),
  kolor = c("#e3eef8", "#fbe3d4"),
  tytul = c("WOLNO: to, co było znane w chwili T", "NIE WOLNO: to, czego w chwili T nie było"),
  tresc = c(paste("• wizyty w miesiącach m − 2, m − 1, m", "• zmiana liczby wizyt", "• staż, rodzaj karnetu, klub, odległość",
                  "• termin odnowienia z umowy", "• średnie, progi i wybór zmiennych\n   policzone na zbiorze uczącym", sep = "\n"),
            paste("• wizyty w miesiącu rezygnacji (m + 1)", "• wypowiedzenie, ankieta przy rezygnacji",
                  "• pola liczone „do dnia eksportu” (np. wizyty łącznie)",
                  "• średnie, progi i wybór zmiennych\n   policzone razem ze zbiorem testowym", sep = "\n")))
p1 <- ggplot() +
  annotate("rect", xmin = 0.2, xmax = T0, ymin = 3.75, ymax = 5.25, fill = "#e3eef8") +
  annotate("rect", xmin = T0, xmax = 9.9, ymin = 3.75, ymax = 5.25, fill = "#fbe3d4") +
  annotate("text", x = 0.35, y = 5.05, hjust = 0, size = 3.9, fontface = "bold", colour = "#0072B2",
           label = "Przeszłość: cechy klienta") +
  annotate("text", x = T0 + 0.15, y = 5.05, hjust = 0, size = 3.9, fontface = "bold", colour = "#B34700",
           label = "Okno wyniku: czy zrezygnuje w ciągu 3 miesięcy?") +
  annotate("segment", x = 0.2, xend = 9.9, y = 4.3, yend = 4.3, colour = "#0f1d3a", linewidth = 0.6,
           arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  geom_point(data = miesiace, aes(x, 4.3), size = 2.4, colour = "#0f1d3a") +
  geom_text(data = miesiace, aes(x, 4.0, label = etykieta), size = 3.8, colour = "grey20") +
  annotate("segment", x = T0, xend = T0, y = 0.05, yend = 5.6, linetype = "22", colour = "#0f1d3a", linewidth = 0.7) +
  annotate("label", x = T0, y = 5.6, label = "chwila prognozy T (koniec miesiąca m)", size = 3.9,
           fontface = "bold", colour = "#0f1d3a", fill = "white", linewidth = 0.3) +
  geom_rect(data = karty, aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1, fill = kolor), colour = "#0f1d3a", linewidth = 0.4) +
  geom_text(data = karty, aes(x0 + 0.15, y1 - 0.28, label = tytul), hjust = 0, fontface = "bold", size = 4.1, colour = "#0f1d3a") +
  geom_text(data = karty, aes(x0 + 0.15, y1 - 0.62, label = tresc), hjust = 0, vjust = 1, size = 4.1, lineheight = 1.2) +
  scale_fill_identity() +
  coord_cartesian(xlim = c(0.1, 10), ylim = c(0, 5.85), expand = FALSE) +
  labs(title = "Co wolno wiedzieć w chwili prognozy?",
       subtitle = "Każda kolumna danych dostaje datę; do modelu trafia tylko to, co było znane w chwili T") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p1   # zapis: ggsave("przeciek-os-czasu-co-wolno.svg", p1, width = 10, height = 6.2)
3. Rezygnacje w czasie i wizyty przed rezygnacją: Rysunek 2
R
# Przepis 3. Rezygnacje w czasie i wizyty przed rezygnacją: Rysunek 2
# (korzysta z klienci, wizyty, rezygnacja, M, kol i motyw z przepisu 1)
library(ggplot2)
library(patchwork)

# A. Miesięczny odsetek rezygnacji wśród klientów z karnetem: klub Zachód i pozostałe kluby
aktywni <- function(sel, m) sum(sel & klienci$start <= m & (is.na(rezygnacja) | rezygnacja >= m))
mies <- do.call(rbind, lapply(1:M, function(m) data.frame(
  miesiac = m, grupa = c("Klub Zachód", "Pozostałe kluby"),
  proc = 100 * c(sum(klienci$klub == "Zachód" & rezygnacja %in% m) / aktywni(klienci$klub == "Zachód", m),
                 sum(klienci$klub != "Zachód" & rezygnacja %in% m) / aktywni(klienci$klub != "Zachód", m)))))
round(tapply(mies$proc, list(mies$grupa, ifelse(mies$miesiac < 16, "miesiace_1_15", "miesiace_16_27")), mean), 2)

# B. Średnia liczba wizyt w 6 ostatnich miesiącach przed rezygnacją (0 = miesiąc rezygnacji)
rez <- which(!is.na(rezygnacja) & rezygnacja >= 7 & klienci$start <= rezygnacja - 5)
przed <- sapply(5:0, function(k) wizyty[cbind(rez, rezygnacja[rez] - k)])
sr <- data.frame(wzgl = -(5:0), srednia = colMeans(przed),
                 se = apply(przed, 2, sd) / sqrt(length(rez)))
pozostali <- mean(wizyty[is.na(rezygnacja), 7:M], na.rm = TRUE)   # klienci, którzy nie zrezygnowali
c(rezygnujacych = length(rez), srednio_wizyt_u_pozostalych = round(pozostali, 2))
print(round(sr, 2), row.names = FALSE)

pA <- ggplot(mies, aes(miesiac, proc, colour = grupa, shape = grupa, linetype = grupa)) +
  annotate("rect", xmin = 15.5, xmax = 27.5, ymin = -Inf, ymax = Inf, fill = "grey92") +
  annotate("text", x = 16, y = 11.5, hjust = 0, size = 3.6, colour = "grey30",
           label = "od miesiąca 16: nowa siłownia\nobok klubu Zachód") +
  geom_line(linewidth = 0.7) + geom_point(size = 2) +
  scale_colour_manual(values = c("Klub Zachód" = "#D55E00", "Pozostałe kluby" = "grey45"), name = NULL) +
  scale_shape_manual(values = c("Klub Zachód" = 17, "Pozostałe kluby" = 16), name = NULL) +
  scale_linetype_manual(values = c("Klub Zachód" = "solid", "Pozostałe kluby" = "22"), name = NULL) +
  scale_x_continuous(breaks = c(1, 6, 12, 16, 21, 27)) + scale_y_continuous(limits = c(0, 13)) +
  labs(x = "Miesiąc", y = "Rezygnacje w miesiącu (%)", title = "A. Odsetek rezygnacji zmienia się w czasie") +
  motyw
pB <- ggplot(sr, aes(wzgl, srednia)) +
  geom_hline(yintercept = pozostali, linetype = "22", colour = "grey45") +
  annotate("text", x = -5, y = pozostali + 0.3, hjust = 0, vjust = 0, size = 3.6, colour = "grey30",
           label = sprintf("klienci, którzy zostali: %.1f wizyty", pozostali)) +
  geom_col(aes(fill = wzgl == 0), width = 0.65) +
  geom_errorbar(aes(ymin = srednia - 1.96 * se, ymax = srednia + 1.96 * se), width = 0.2, colour = "grey20") +
  geom_text(aes(label = sprintf("%.1f", srednia), y = srednia + 1.96 * se + 0.15), vjust = 0, size = 3.7) +
  scale_fill_manual(values = c("FALSE" = "#0072B2", "TRUE" = "#D55E00"), guide = "none") +
  scale_x_continuous(breaks = -(5:0), labels = c(paste0("−", 5:1), "miesiąc\nrezygnacji")) +
  labs(x = "Miesiące przed rezygnacją", y = "Średnio wizyt w miesiącu (95% CI)",
       title = "B. Wizyty przed rezygnacją") +
  motyw
p2 <- pA / pB
p2   # zapis: ggsave("przeciek-dane-silowni.svg", p2, width = 10, height = 8.4)
Wynik w R
                miesiace_1_15 miesiace_16_27
Klub Zachód              4.07           8.11
Pozostałe kluby          4.31           3.83
              rezygnujacych srednio_wizyt_u_pozostalych
                    1566.00                        6.04
 wzgl srednia   se
   -5    5.06 0.08
   -4    5.02 0.07
   -3    5.00 0.08
   -2    4.88 0.08
   -1    4.73 0.07
    0    0.68 0.02
4. AUC w raporcie i we wdrożeniu: Rysunek 3
R
# Przepis 4. Trzy sposoby oceny tego samego lasu losowego: AUC w raporcie i we wdrożeniu (miesiąc 24)
# (korzysta z dane, budowa, wdrozenie, kol i motyw z przepisu 1)
library(ggplot2)
library(ranger)
library(pROC)

cechy <- c("wizyty", "wizyty_3m", "zmiana", "staz", "karnet", "odnowienie_3m", "wiek", "odleglosc", "klub")
las <- function(ucz, x = cechy) {
  ranger(x = ucz[, x], y = factor(ucz$rezygnuje), num.trees = 300, probability = TRUE, seed = 664)
}
przewidz <- function(model, nowe, x = cechy) predict(model, nowe[, x])$predictions[, "1"]
auc_ci <- function(y, p) as.numeric(ci.auc(roc(y, p, quiet = TRUE), method = "delong"))[c(2, 1, 3)]

# A. Uczciwie: uczenie na miesiącach 3–15, przerwa (16–17), test na 18–21 – okna wyniku się nie nakładają
ucz_A <- budowa[budowa$miesiac <= 15, ]; test_A <- budowa[budowa$miesiac >= 18, ]
raport_A <- auc_ci(test_A$rezygnuje, przewidz(las(ucz_A), test_A))

# B. Zmienna z przyszłości: to samo, ale z wizytami w miesiącu m + 1 (w tabeli historycznej są „dostępne”)
cechy_B <- c(cechy, "wizyty_nast")
raport_B <- auc_ci(test_A$rezygnuje, przewidz(las(ucz_A, cechy_B), test_A, cechy_B))

# C. Losowy podział wierszy klient × miesiąc 70/30: te same osoby i te same miesiące w obu zbiorach
set.seed(664)
los <- sample(nrow(budowa), round(0.7 * nrow(budowa)))
raport_C <- auc_ci(budowa$rezygnuje[-los], przewidz(las(budowa[los, ]), budowa[-los, ]))
c(klienci_testu_C_obecni_w_uczacym_proc = round(100 * mean(unique(budowa$id[-los]) %in% budowa$id[los]), 1))

# Wdrożenie: model uczony na wszystkich miesiącach 3–21, prognoza na koniec miesiąca 24 dla 1907 klientów.
# Przy B wizyt w miesiącu 25 jeszcze nie ma – system podstawia ostatnią znaną wartość (wizyty w miesiącu 24).
model_AC <- las(budowa); model_B <- las(budowa, cechy_B)
wdr_B <- transform(wdrozenie, wizyty_nast = wizyty)
wdroz_AC <- auc_ci(wdrozenie$rezygnuje, przewidz(model_AC, wdrozenie))
wdroz_B <- auc_ci(wdrozenie$rezygnuje, przewidz(model_B, wdr_B, cechy_B))

wyniki <- data.frame(scenariusz = rep(c("A. W czasie, z przerwą", "B. Zmienna z przyszłości", "C. Losowy podział wierszy"), 2),
                     ocena = rep(c("W raporcie", "We wdrożeniu"), each = 3),
                     rbind(raport_A, raport_B, raport_C, wdroz_AC, wdroz_B, wdroz_AC))
names(wyniki)[3:5] <- c("AUC", "dolna", "gorna")
print(transform(wyniki, AUC = round(AUC, 3), dolna = round(dolna, 3), gorna = round(gorna, 3)), row.names = FALSE)

# Dla porównania: regresja logistyczna przy podziale w czasie (A) i losowym (C)
wzor <- rezygnuje ~ wizyty + wizyty_3m + zmiana + staz + karnet + odnowienie_3m + wiek + odleglosc + klub
reg_A <- glm(wzor, binomial, ucz_A); reg_C <- glm(wzor, binomial, budowa[los, ])
round(c(regresja_A = auc_ci(test_A$rezygnuje, predict(reg_A, test_A))[1],
        regresja_C = auc_ci(budowa$rezygnuje[-los], predict(reg_C, budowa[-los, ]))[1]), 3)

# Standaryzacja na całych danych (miesiące 3–21) zamiast na zbiorze uczącym – LASSO, w którym skala ma znaczenie
library(glmnet)
X_ucz <- model.matrix(wzor, ucz_A)[, -1]; X_test <- model.matrix(wzor, test_A)[, -1]; X_cale <- model.matrix(wzor, budowa)[, -1]
lasso_auc <- function(srodek, skala) {
  set.seed(664)
  fit <- cv.glmnet(scale(X_ucz, srodek, skala), ucz_A$rezygnuje, family = "binomial", standardize = FALSE, nfolds = 5)
  auc_ci(test_A$rezygnuje, as.numeric(predict(fit, scale(X_test, srodek, skala), s = "lambda.1se")))[1]
}
round(c(lasso_skala_z_uczacego = lasso_auc(colMeans(X_ucz), apply(X_ucz, 2, sd)),
        lasso_skala_z_calych_danych = lasso_auc(colMeans(X_cale), apply(X_cale, 2, sd))), 4)

wyniki$scenariusz <- factor(wyniki$scenariusz, rev(unique(wyniki$scenariusz)))
p3 <- ggplot(wyniki, aes(AUC, scenariusz, colour = ocena, shape = ocena)) +
  geom_line(aes(group = scenariusz), colour = "grey70", linewidth = 1.2) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, orientation = "y", linewidth = 0.6) +
  geom_point(size = 3.6) +
  geom_text(aes(label = sprintf("%.3f", AUC)), vjust = -1.2, size = 3.9, show.legend = FALSE) +
  scale_colour_manual(values = kol[c("W raporcie", "We wdrożeniu")], name = NULL) +
  scale_shape_manual(values = c("W raporcie" = 17, "We wdrożeniu" = 16), name = NULL) +
  scale_x_continuous(limits = c(0.6, 0.8), breaks = seq(0.6, 0.8, 0.05)) +
  labs(x = "AUC z 95% przedziałem ufności (DeLong)", y = NULL,
       title = "Ten sam las losowy, trzy sposoby oceny",
       subtitle = "Rezygnacja z karnetu w ciągu 3 miesięcy; wdrożenie: prognoza z końca miesiąca 24") +
  motyw
p3   # zapis: ggsave("przeciek-auc-raport-wdrozenie.svg", p3, width = 10, height = 5.2)
Wynik w R
klienci_testu_C_obecni_w_uczacym_proc
                                 96.2
                scenariusz        ocena   AUC dolna gorna
    A. W czasie, z przerwą   W raporcie 0.658 0.640 0.675
  B. Zmienna z przyszłości   W raporcie 0.759 0.742 0.776
 C. Losowy podział wierszy   W raporcie 0.755 0.742 0.767
    A. W czasie, z przerwą We wdrożeniu 0.691 0.657 0.724
  B. Zmienna z przyszłości We wdrożeniu 0.673 0.636 0.709
 C. Losowy podział wierszy We wdrożeniu 0.691 0.657 0.724
regresja_A regresja_C
     0.711      0.698
     lasso_skala_z_uczacego lasso_skala_z_calych_danych
                     0.7043                      0.7042
5. Wybór zmiennych na danych bez sygnału: Rysunek 4
R
# Przepis 5. Dane bez żadnego sygnału: wybór 10 „najlepszych” zmiennych na całych danych a tylko na zbiorze uczącym
# (korzysta z kol i motyw z przepisu 1; poza tym samodzielny)
library(ggplot2)

# Parametry ustalone ręcznie: pilotaż w jednym klubie, 400 klientów, 20% rezygnacji wylosowanych niezależnie
# od czegokolwiek; aplikacja klubu zapisuje p wskaźników aktywności (czysty szum). Połowa klientów uczy model,
# połowa go sprawdza. Każdy wariant: 500 powtórzeń.
auc <- function(y, p) {                      # AUC = P(wynik rezygnującego > wynik pozostającego), wzór z rang
  r <- rank(p); n1 <- sum(y == 1); n0 <- sum(y == 0)
  (sum(r[y == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0)
}
jedno_badanie <- function(p_zm, n = 400, k = 10) {
  X <- matrix(rnorm(n * p_zm), n, p_zm); y <- rbinom(n, 1, 0.2)
  ucz <- sample(n, n / 2)
  najlepsze <- function(wiersze) order(-abs(cor(X[wiersze, ], y[wiersze])))[1:k]
  ocena <- function(wybrane) {
    d <- data.frame(y = y, X[, wybrane])
    fit <- suppressWarnings(glm(y ~ ., binomial, d[ucz, ]))
    auc(y[-ucz], predict(fit, d[-ucz, ]))
  }
  c(cale = ocena(najlepsze(1:n)), uczacy = ocena(najlepsze(ucz)))
}
set.seed(664)
sym <- do.call(rbind, lapply(c(50, 200, 1000), function(p_zm)
  data.frame(p_zm, t(replicate(500, jedno_badanie(p_zm))))))

# Średnie AUC w zbiorze testowym z błędem Monte Carlo i odsetek powtórzeń z AUC ≥ .60
podsumowanie <- do.call(rbind, lapply(split(sym, sym$p_zm), function(d) data.frame(
  zmiennych = d$p_zm[1], AUC_cale = mean(d$cale), MC_cale = sd(d$cale) / sqrt(nrow(d)),
  AUC_uczacy = mean(d$uczacy), MC_uczacy = sd(d$uczacy) / sqrt(nrow(d)),
  proc_AUC_60_cale = 100 * mean(d$cale >= .6), proc_AUC_60_uczacy = 100 * mean(d$uczacy >= .6))))
print(round(podsumowanie, 3), row.names = FALSE)

dl <- rbind(data.frame(p_zm = sym$p_zm, wybor = "Wybór na całych danych", AUC = sym$cale),
            data.frame(p_zm = sym$p_zm, wybor = "Wybór tylko na zbiorze uczącym", AUC = sym$uczacy))
dl$p_zm <- factor(paste(dl$p_zm, "kandydatów"), paste(c(50, 200, 1000), "kandydatów"))
dl$wybor <- factor(dl$wybor, c("Wybór na całych danych", "Wybór tylko na zbiorze uczącym"))
p4 <- ggplot(dl, aes(p_zm, AUC, colour = wybor, fill = wybor)) +
  geom_hline(yintercept = 0.5, linetype = "22", colour = "grey30") +
  geom_violin(alpha = 0.15, position = position_dodge(0.8), width = 0.75, linewidth = 0.4) +
  geom_boxplot(width = 0.14, position = position_dodge(0.8), outlier.shape = NA, fill = "white", linewidth = 0.5) +
  stat_summary(aes(shape = wybor), fun = mean, geom = "point", size = 3, position = position_dodge(0.8)) +
  scale_colour_manual(values = kol[c("Wybór na całych danych", "Wybór tylko na zbiorze uczącym")], name = NULL) +
  scale_fill_manual(values = kol[c("Wybór na całych danych", "Wybór tylko na zbiorze uczącym")], name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(x = "Liczba wskaźników z aplikacji, spośród których wybieramy 10", y = "AUC w zbiorze testowym (n = 200)",
       title = "Model z samego szumu, a AUC wyraźnie powyżej .50",
       subtitle = "500 powtórzeń; punkt – średnia, pudełko – kwartyle, linia – AUC = .50 (zgadywanie)") +
  motyw + guides(colour = guide_legend(nrow = 1), fill = guide_legend(nrow = 1), shape = guide_legend(nrow = 1))
p4   # zapis: ggsave("przeciek-wybor-zmiennych-szum.svg", p4, width = 10, height = 5.6)
Wynik w R
 zmiennych AUC_cale MC_cale AUC_uczacy MC_uczacy proc_AUC_60_cale
        50    0.623   0.002      0.505     0.002             70.4
       200    0.688   0.002      0.502     0.002             98.2
      1000    0.749   0.002      0.496     0.002            100.0
 proc_AUC_60_uczacy
                3.4
                3.0
                2.2
6. Okno przesuwane a losowa walidacja krzyżowa: Rysunek 5
R
# Przepis 6. Walidacja w czasie z oknem przesuwanym a losowa walidacja krzyżowa (5 części)
# (korzysta z budowa, cechy, las(), przewidz(), auc_ci(), wzor, kol i motyw z przepisów 1 i 4)
library(ggplot2)
library(patchwork)

# Punkt prognozy T = koniec miesiąca 12, 15, 18 i 21. Uczenie: wiersze z miesięcy T − 9 … T − 3 (7 miesięcy;
# ich wynik jest już znany w chwili T), test: wiersze z miesiąca T (wynik w T + 1 … T + 3).
punkty <- c(12, 15, 18, 21)
okna <- do.call(rbind, lapply(punkty, function(T) {
  ucz <- budowa[budowa$miesiac >= T - 9 & budowa$miesiac <= T - 3, ]; test <- budowa[budowa$miesiac == T, ]
  a_las <- auc_ci(test$rezygnuje, przewidz(las(ucz), test))
  a_reg <- auc_ci(test$rezygnuje, predict(glm(wzor, binomial, ucz), test))
  data.frame(T, uczace = nrow(ucz), testowe = nrow(test), rezygnacje = sum(test$rezygnuje),
             AUC_las = a_las[1], dolna = a_las[2], gorna = a_las[3], AUC_regresja = a_reg[1])
}))
print(transform(okna, AUC_las = round(AUC_las, 3), dolna = round(dolna, 3), gorna = round(gorna, 3),
                AUC_regresja = round(AUC_regresja, 3)), row.names = FALSE)
round(c(srednie_AUC_las = mean(okna$AUC_las), srednie_AUC_regresja = mean(okna$AUC_regresja)), 3)

# Losowa 5-krotna walidacja krzyżowa na wierszach z miesięcy 3–21 (miesza klientów i miesiące)
set.seed(664)
czesc <- sample(rep(1:5, length.out = nrow(budowa)))
cv_las <- sapply(1:5, function(i) auc_ci(budowa$rezygnuje[czesc == i],
                                         przewidz(las(budowa[czesc != i, ]), budowa[czesc == i, ]))[1])
cv_reg <- sapply(1:5, function(i) auc_ci(budowa$rezygnuje[czesc == i],
                                         predict(glm(wzor, binomial, budowa[czesc != i, ]), budowa[czesc == i, ]))[1])
round(c(losowa_CV_las = mean(cv_las), losowa_CV_regresja = mean(cv_reg)), 3)

# Rysunek: A – schemat okien, B – AUC lasu w kolejnych punktach prognozy
schemat <- do.call(rbind, lapply(seq_along(punkty), function(j) {
  T <- punkty[j]
  data.frame(krok = j, miesiac = 1:24,
             rola = ifelse(1:24 >= T - 9 & 1:24 <= T - 3, "uczenie", ifelse(1:24 > T - 3 & 1:24 < T, "przerwa",
                    ifelse(1:24 == T, "test (prognoza w T)", ifelse(1:24 > T & 1:24 <= T + 3, "okno wyniku", "nieużywane")))))
}))
schemat$rola <- factor(schemat$rola, c("uczenie", "przerwa", "test (prognoza w T)", "okno wyniku", "nieużywane"))
pA <- ggplot(schemat, aes(miesiac, factor(krok, 4:1), fill = rola)) +
  geom_tile(colour = "white", linewidth = 0.6, height = 0.8) +
  scale_fill_manual(values = c("uczenie" = "#0072B2", "przerwa" = "grey70", "test (prognoza w T)" = "#D55E00",
                               "okno wyniku" = "#F5C7A6", "nieużywane" = "grey95"), name = NULL) +
  scale_x_continuous(breaks = c(1, 6, 12, 18, 24), expand = c(0, 0)) +
  scale_y_discrete(labels = paste0("T = ", rev(punkty))) +
  labs(x = "Miesiąc", y = NULL, title = "A. Okno przesuwane: 7 miesięcy uczenia, przerwa, test") +
  motyw + theme(panel.grid = element_blank()) + guides(fill = guide_legend(nrow = 2))
pB <- ggplot(okna, aes(T, AUC_las)) +
  geom_hline(yintercept = mean(cv_las), linetype = "22", colour = "#D55E00") +
  annotate("text", x = 11.3, y = mean(cv_las) + 0.008, hjust = 0, vjust = 0, size = 3.7, colour = "#D55E00",
           label = sprintf("losowa walidacja krzyżowa: %.3f", mean(cv_las))) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.35, colour = "#0072B2", linewidth = 0.7) +
  geom_point(size = 3.4, colour = "#0072B2") +
  geom_text(aes(label = sprintf("%.3f", AUC_las)), hjust = -0.35, size = 3.8) +
  scale_x_continuous(breaks = punkty, limits = c(11.2, 21.8)) + scale_y_continuous(limits = c(0.55, 0.8)) +
  labs(x = "Punkt prognozy T (koniec miesiąca)", y = "AUC lasu losowego (95% CI)",
       title = "B. Ocena w kolejnych punktach prognozy") +
  motyw
p5 <- pA / pB + plot_layout(heights = c(1, 1.25))
p5   # zapis: ggsave("przeciek-okno-przesuwane.svg", p5, width = 10, height = 8)
Wynik w R
  T uczace testowe rezygnacje AUC_las dolna gorna AUC_regresja
 12  14885    2086        232   0.653 0.617 0.689        0.681
 15  14706    2063        278   0.642 0.608 0.676        0.689
 18  14592    1990        253   0.662 0.628 0.696        0.697
 21  14340    1933        228   0.640 0.605 0.675        0.722
     srednie_AUC_las srednie_AUC_regresja
               0.649                0.697
     losowa_CV_las losowa_CV_regresja
             0.771              0.697
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("w raporcie – we wdrożeniu" = c("#D55E00", "#0072B2"), "klub Zachód – pozostałe" = c("#D55E00", "grey45"),
             "uczenie – test" = c("#0072B2", "#D55E00"), "przerwa – okno wyniku" = c("grey70", "#F5C7A6"),
             "karta wolno – nie wolno" = c("#e3eef8", "#fbe3d4"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
w raporcie – we wdrożeniu                  114.6        108.3       91.9
klub Zachód – pozostałe                     76.9         63.4       53.8
uczenie – test                             114.6        108.3       91.9
przerwa – okno wyniku                       27.6         27.1       22.2
karta wolno – nie wolno                     18.1         17.8       15.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i regresja logistyczna (glm()) – pakiet stats z podstawowej instalacji R; las losowy – pakiet ranger; krzywe ROC i przedziały ufności AUC metodą DeLonga – pakiet pROC; LASSO z walidacją krzyżową – pakiet glmnet. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ranger (wersja 0.18.0): Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- glmnet (wersja 5.0): Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Nakładające się okna wyniku. Bez przerwy między uczeniem a testem wynik z uczenia sięga okresu testowego.
- Wiele wierszy jednego klienta. Dziel według klientów i czasu, nie według wierszy.
- Przeciek jako odkrycie. „Kto przestaje przychodzić, rezygnuje” to nie wniosek z modelu, tylko opis rezygnacji.
Najczęstsze pytania
Co to jest przeciek danych (data leakage) w modelu predykcyjnym?
To sytuacja, w której model podczas uczenia lub oceny korzysta z informacji o wyniku, której w chwili prognozy nie da się mieć (Kaufman i in., 2012) – np. liczby wizyt w miesiącu rezygnacji. Model wygląda wtedy na trafniejszy, niż będzie po wdrożeniu. W przykładzie taka zmienna podniosła AUC w raporcie do .759, a po wdrożeniu model miał .673.
Dlaczego nie wolno losowo dzielić danych z czasem na zbiór uczący i testowy?
Bo model uczy się wtedy na późniejszych miesiącach i na tych samych klientach, których potem sprawdza. W przykładzie losowa walidacja krzyżowa dała lasowi losowemu AUC .771, a walidacja w czasie – średnio .649. Dziel dane w czasie i zostaw przerwę równą długości okna wyniku (Roberts i in., 2017).
Czy standaryzacja przed podziałem danych to przeciek?
Formalnie tak, bo korzysta ze średnich zbioru testowego, ale zwykle niewielki: w przykładzie AUC modelu LASSO zmieniło się z .7043 na .7042. Groźne są kroki, które patrzą na wynik – wybór zmiennych, strojenie parametrów, kodowanie kategorii średnią wyniku. Na danych bez sygnału wybór zmiennych na całości dał AUC .623–.749.
Jak rozpoznać przeciek danych w modelu?
Podejrzane są: AUC wyraźnie wyższe niż w podobnych badaniach, jedna zmienna dominująca w ważności, przewaga modelu złożonego nad regresją tylko przy losowym podziale i spadek trafności po wdrożeniu. Sprawdź datę każdej kolumny i powtórz ocenę w czasie. Kapoor i Narayanan (2023) proponują kartę informacji o modelu, która przeprowadza przez osiem rodzajów przecieku.
Co to jest walidacja z oknem przesuwanym?
To walidacja w czasie powtórzona w kilku punktach prognozy: model uczy się na ostatnich miesiącach, których wynik jest już znany, i jest sprawdzany na następnym okresie; potem okno przesuwa się do przodu. Przy danych zmiennych w czasie test na odłożonym okresie powtórzony w kilku okresach dawał najtrafniejsze oceny (Cerqueira i in., 2020).
Powiązane hasła
Przeczytaj też
Modele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikModel odejść klientów i kampania retencyjna
Operator komórkowy, 10 000 abonentów: regresja i las losowy, gain i lift, kalibracja, macierz decyzji, krzywa zysku i przeciek danych – pięć rysunków z kodem R.
Czytaj →PoradnikPrognoza upadłości firm – regresja logistyczna
1500 firm transportowych: winsoryzacja wskaźników, ilorazy szans, walidacja w czasie, AUC i kalibracja oraz złudna trafność – pięć rysunków z kodem R.
Czytaj →PoradnikNowcasting sprzedaży z wyszukiwań
Dealer kamperów zna sprzedaż po 6 tygodniach: ARIMA z indeksem i zapytaniami, ocena w kroczącym oknie, rewizje i zależność pozorna – z kodem R.
Czytaj →Budujesz model predykcyjny do pracy dyplomowej?
Pomożemy przygotować dane bez przecieku, zaplanować walidację w czasie, porównać modele i opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ambroise, C., & McLachlan, G. J. (2002). Selection bias in gene extraction on the basis of microarray gene-expression data. Proceedings of the National Academy of Sciences, 99(10), 6562–6566. https://doi.org/10.1073/pnas.102102699 ● Otwarty dostęp: pełny tekst
- Cerqueira, V., Torgo, L., & Mozetič, I. (2020). Evaluating time series forecasting models: An empirical study on performance estimation methods. Machine Learning, 109(11), 1997–2028. https://doi.org/10.1007/s10994-020-05910-7 ● Otwarty dostęp
- Kapoor, S., & Narayanan, A. (2023). Leakage and the reproducibility crisis in machine-learning-based science. Patterns, 4(9), Article 100804. https://doi.org/10.1016/j.patter.2023.100804 ● Otwarty dostęp
- Kaufman, S., Rosset, S., Perlich, C., & Stitelman, O. (2012). Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 1–21. https://doi.org/10.1145/2382577.2382579
- Roberts, D. R., Bahn, V., Ciuti, S., Boyce, M. S., Elith, J., Guillera-Arroita, G., Hauenstein, S., Lahoz-Monfort, J. J., Schröder, B., Thuiller, W., Warton, D. I., Wintle, B. A., Hartig, F., & Dormann, C. F. (2017). Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure. Ecography, 40(8), 913–929. https://doi.org/10.1111/ecog.02881
- Varma, S., & Simon, R. (2006). Bias in error estimation when using cross-validation for model selection. BMC Bioinformatics, 7(1), Article 91. https://doi.org/10.1186/1471-2105-7-91 ● Otwarty dostęp
Cytowania BibTeX
@article{ambroise2002selection, author={Ambroise, Christophe and McLachlan, Geoffrey J.}, title={{Selection bias in gene extraction on the basis of microarray gene-expression data}}, journal={Proceedings of the National Academy of Sciences}, year={2002}, volume={99}, number={10}, pages={6562--6566}, doi={10.1073/pnas.102102699}}@article{cerqueira2020evaluating, author={Cerqueira, Vitor and Torgo, Luis and Mozetič, Igor}, title={{Evaluating time series forecasting models: An empirical study on performance estimation methods}}, journal={Machine Learning}, year={2020}, volume={109}, number={11}, pages={1997--2028}, doi={10.1007/s10994-020-05910-7}}@article{kapoor2023leakage, author={Kapoor, Sayash and Narayanan, Arvind}, title={{Leakage and the reproducibility crisis in machine-learning-based science}}, journal={Patterns}, year={2023}, volume={4}, number={9}, eid={100804}, doi={10.1016/j.patter.2023.100804}}@article{kaufman2012leakage, author={Kaufman, Shachar and Rosset, Saharon and Perlich, Claudia and Stitelman, Ori}, title={{Leakage in data mining: Formulation, detection, and avoidance}}, journal={ACM Transactions on Knowledge Discovery from Data}, year={2012}, volume={6}, number={4}, pages={1--21}, doi={10.1145/2382577.2382579}}@article{roberts2017cross, author={Roberts, David R. and Bahn, Volker and Ciuti, Simone and Boyce, Mark S. and Elith, Jane and Guillera-Arroita, Gurutzeta and Hauenstein, Severin and Lahoz-Monfort, José J. and Schröder, Boris and Thuiller, Wilfried and Warton, David I. and Wintle, Brendan A. and Hartig, Florian and Dormann, Carsten F.}, title={{Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure}}, journal={Ecography}, year={2017}, volume={40}, number={8}, pages={913--929}, doi={10.1111/ecog.02881}}@article{varma2006bias, author={Varma, Sudhir and Simon, Richard}, title={{Bias in error estimation when using cross-validation for model selection}}, journal={BMC Bioinformatics}, year={2006}, volume={7}, number={1}, eid={91}, doi={10.1186/1471-2105-7-91}}