Przykład: 1500 firm transportowych i pięć lat sprawozdań
Fikcyjna firma leasingowa finansuje ciągniki siodłowe i co roku ocenia swoich klientów – firmy przewozowe. Dział ryzyka pyta: które firmy mogą upaść w ciągu 12 miesięcy od ostatniego sprawozdania?
Mamy 1500 firm i pięć lat sprawozdań. Z każdego liczymy cztery wskaźniki: płynność bieżącą (aktywa obrotowe / zobowiązania krótkoterminowe), zadłużenie ogólne (zobowiązania / aktywa), rentowność aktywów ROA (zysk netto / aktywa, w %) i rotację aktywów (przychody / aktywa). Wynik to upadłość w ciągu 12 miesięcy po dniu bilansowym (1 = tak). Razem: 7085 sprawozdań i 232 upadłości (3.27%); firma, która upadła, znika z danych. W latach 1–3 upadało od 2.0% do 3.3% firm rocznie, w latach 4–5 – 3.9% i 4.7%, bo w naszym scenariuszu rosną koszty paliwa i płac kierowców.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie: wskaźniki zależą od kondycji firmy, której analityk nie widzi, a około 2% wartości to skrajności (firma prawie bez zobowiązań krótkoterminowych, jednorazowa duża strata, flota w leasingu poza bilansem). Wyrazy wolne prawdziwego modelu zmieniliśmy raz (z −4.6 i −3.9 na −4.2 i −3.5), bo pierwsze uruchomienie dało tylko 2.5% upadłości. Ziarna 635 nie zmienialiśmy. Dane pobierzesz jako upadlosc-firmy-transportowe.csv.
Plan jest taki jak w praktyce: model uczymy na latach 1–3 (4371 sprawozdań, 116 upadłości), a sprawdzamy na latach 4–5 (2714 sprawozdań, 116 upadłości). Próbę dobraną parami i podstawy opisuje wpis statystyka w pracy z finansów i rachunkowości.
Rysunek 1: wskaźniki finansowe i winsoryzacja
Gdy mianownik wskaźnika jest bliski zera, wynik eksploduje: płynność bieżąca ma medianę 1.25, ale maksimum 114.58, a ROA jednej firmy wyniosło −128.57%. Dlatego wartości poniżej 1. percentyla i powyżej 99. zastępujemy wartościami tych percentyli – to winsoryzacja. Ważny szczegół: granice liczymy tylko na latach 1–3 i te same stosujemy do lat 4–5. Inaczej dane testowe przeciekają do przygotowania danych.
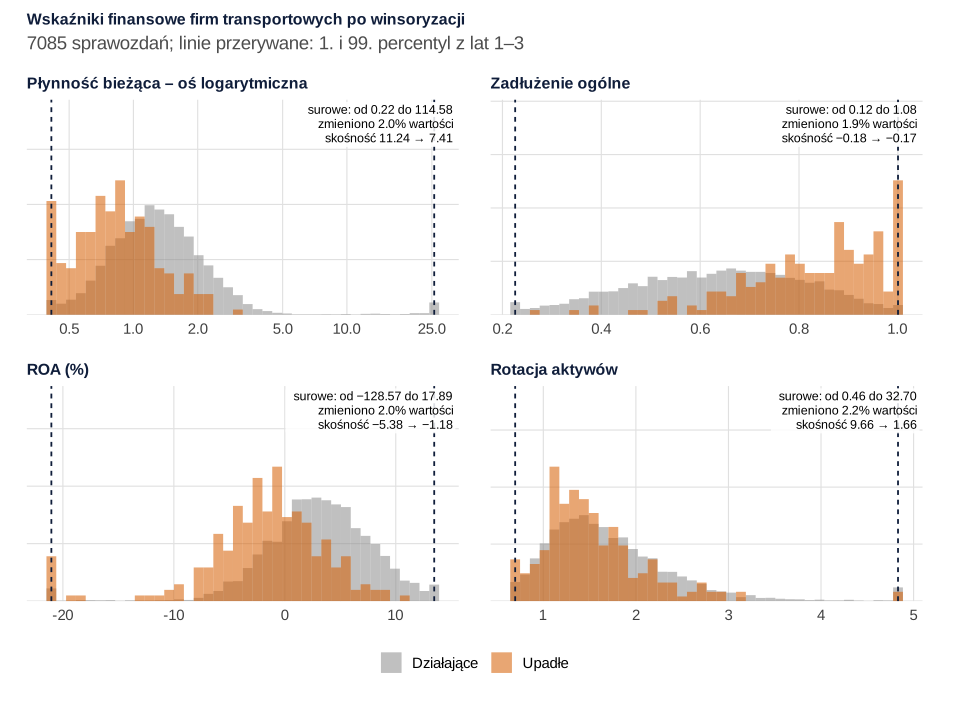
set.seed(635)).Co widać. Winsoryzacja zmieniła około 2% wartości każdego wskaźnika (od 1.88% do 2.17%). Skośność ROA spadła z −5.38 do −1.18, rotacji aktywów – z 9.66 do 1.66. Płynność nadal jest bardzo skośna (7.41), dlatego do modelu wchodzi jej logarytm (zob. transformacja logarytmiczna) – stąd oś logarytmiczna w pierwszym panelu. Mediany różnią firmy upadłe od pozostałych: płynność 0.82 wobec 1.27, zadłużenie 0.86 wobec 0.64, ROA −1.41% wobec 3.15%, rotacja 1.42 wobec 1.59.
Jak może zmylić. Słupek przy granicy to „przyklejone” skrajności. Leone i in. (2019) przypominają, że progi winsoryzacji wybiera badacz, więc mogą zmienić prawidłowe obserwacje; zalecają porównać wynik z regresją odporną albo podać analizę wrażliwości. Tu takim sprawdzianem jest model na surowych wskaźnikach (rysunek 2).
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: regresja logistyczna i ilorazy szans
Regresja logistyczna modeluje logarytm szans upadłości jako sumę ważonych wskaźników. Każde sprawozdanie jest osobną obserwacją, więc ta sama firma pojawia się do trzech razy. Shumway (2001) pokazał, że taki model „firma × rok” to dyskretny model hazardu, który szacuje się zwykłym programem do regresji logitowej, i że jest właściwszy niż model z jednym sprawozdaniem na firmę (więcej o hazardzie: analiza przeżycia). Błędy standardowe liczymy odpornie na grupowanie w firmach.
Jednostki wybraliśmy tak, żeby wynik dało się opowiedzieć: podwojenie płynności i rotacji, 10 punktów procentowych zadłużenia, 5 punktów procentowych ROA. Na 116 upadłości przypadają 4 predyktory, czyli 29 zdarzeń na predyktor (zob. EPV).
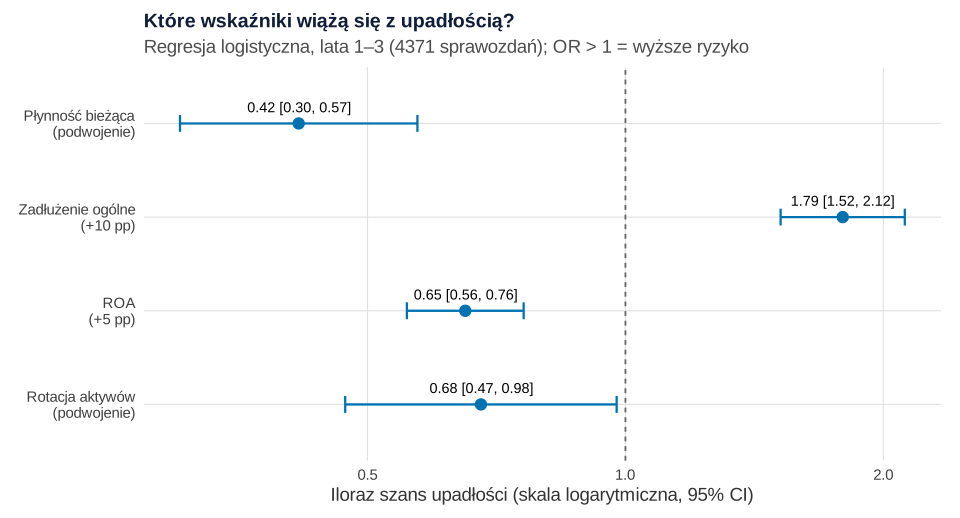
set.seed(635)).Co widać. Podwojenie płynności bieżącej wiąże się z ponad dwukrotnie mniejszymi szansami upadłości (OR = 0.42, 95% CI [0.30, 0.57]). Zadłużenie wyższe o 10 punktów procentowych – z szansami większymi o 79% (OR = 1.79 [1.52, 2.12]). ROA wyższe o 5 punktów: OR = 0.65 [0.56, 0.76]. Rotacja aktywów ma najsłabszy związek (OR = 0.68 [0.47, 0.98], p = .037).
Jak może zmylić. Bez winsoryzacji ROA dostaje OR = 0.88 zamiast 0.65: kilka strat rzędu −100% „spłaszcza” zależność. Dane są fikcyjne, więc znamy prawdziwe ilorazy: 0.47, 1.49, 0.61 i 0.66. Zadłużenie wyszło za wysokie (1.79 zamiast 1.49), bo łączy się z kondycją firmy, której model nie widzi. Ilorazy szans opisują więc związek, a nie dźwignię: spłata części długu nie obniży ryzyka dokładnie o tyle.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: od sprawozdania do prawdopodobieństwa
Jak model zamienia sprawozdanie w liczbę? Rysunek 3 pokazuje to na fikcyjnej firmie z ręcznie ustalonym sprawozdaniem.
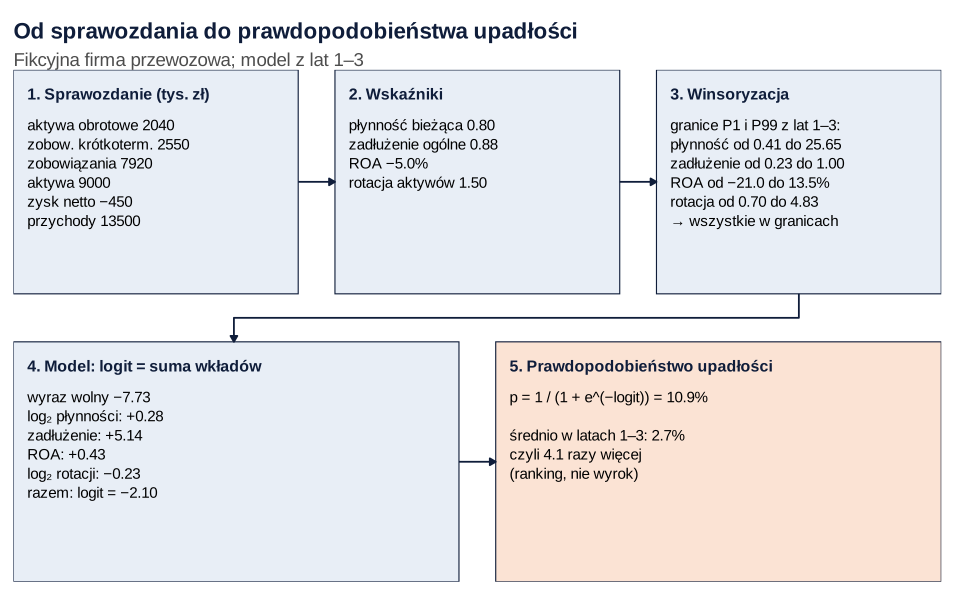
Co widać. Ze sprawozdania wychodzą cztery wskaźniki: płynność 0.80, zadłużenie 0.88, ROA −5.0%, rotacja 1.50. Wszystkie mieszczą się w granicach winsoryzacji. Każdy wskaźnik dodaje do logitu swój wkład (współczynnik × wartość); najwięcej dokłada zadłużenie. Suma to −2.10, a wzór p = 1 / (1 + e−logit) daje 10.9% – 4.1 razy więcej niż średnie ryzyko w latach 1–3 (2.7%).
Jak może zmylić. Duże wkłady zadłużenia (+5.14) i wyrazu wolnego (−7.73) to skutek skali (wyraz wolny dotyczy firmy bez długu); liczy się suma. A 10.9% to nie wyrok: dziewięć na dziesięć takich firm przetrwa rok. Model daje ranking ryzyka; o działaniach decyduje próg (rysunek 5). Tę samą logikę „wkład każdej zmiennej” w postaci punktów pokazuje wpis scoring kredytowy – WoE, IV i karta punktowa.
Podpis do pracy (np. w rozdziale o zastosowaniu modelu):
Rysunek 4: walidacja w czasie zamiast losowego podziału
Częsty błąd w pracach: sprawozdania z pięciu lat losowo dzielimy na 70% do uczenia i 30% do testu. Model „zna” wtedy warunki z lat 4–5 i widzi te same firmy w obu zbiorach, a leasingodawca uczy się na przeszłości i przewiduje przyszłość. Dlatego porównujemy dwa schematy: losowy (2125 sprawozdań testowych, 77 upadłości) i w czasie (uczenie na latach 1–3, test na latach 4–5). Model oceniamy dwiema miarami, jak radzą Steyerberg i in. (2010): dyskryminacją – polem pod krzywą ROC (AUC) z 95% CI (DeLong i in., 1988) i kalibracją.
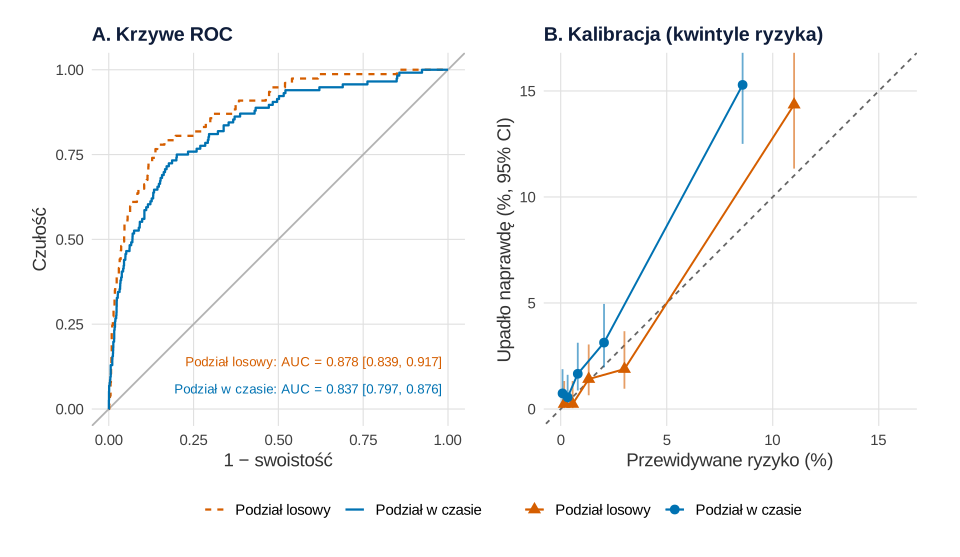
set.seed(635)).Co widać. Losowy podział daje AUC = .878 [.839, .917], podział w czasie – .837 [.797, .876]. Przedziały się pokrywają; prawdziwy problem jest w kalibracji (panel B). Przy losowym podziale średnie przewidywane ryzyko to 3.2% przy 3.6% upadłości. W latach 4–5 model przewiduje średnio 2.4%, a upada 4.3% firm. W najwyższym kwintylu ryzyka przewiduje 8.6%, a upada 15.3%. Wyraz wolny kalibracji wynosi 0.68 (ideał = 0), nachylenie 0.97 (ideał = 1): kolejność firm jest dobra, ale poziom ryzyka – za niski. Wynik Briera: .030 przy losowym podziale i .037 w czasie.
Jak może zmylić. Losowy podział nie widzi zmiany warunków, bo test i uczenie pochodzą z tych samych lat. Pomaga aktualizacja wyrazu wolnego na najnowszym roku. Korekta oszacowana na roku 4 (+0.51) podniosła średnie ryzyko w roku 5 z 2.2% do 3.5% (upadło 4.7%) – lepiej, choć nadal za nisko, bo warunki dalej się pogarszały. Model bez winsoryzacji miał prawie to samo AUC (.832): winsoryzacja zmieniła interpretację ROA, nie ranking. Szerzej o przecieku i walidacji w czasie piszemy we wpisie przeciek danych w modelach biznesowych, a o walidacji krzyżowej i korekcie optymizmu – w poradniku modele predykcyjne: walidacja i kalibracja.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: rzadkie upadłości i złudna trafność
W latach 4–5 upadło 4.3% firm. „Model”, który o każdej firmie mówi „nie upadnie”, ma więc 95.7% trafnych klasyfikacji – i jest bezużyteczny. Sprawdzamy trafność, czułość i precyzję przy różnych progach ryzyka, od których firmę oznaczamy jako zagrożoną.
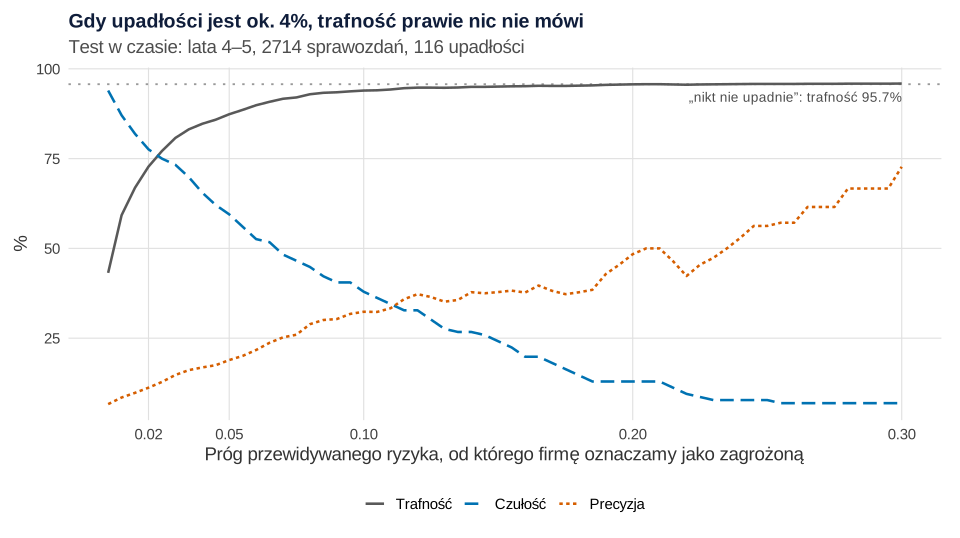
set.seed(635)).Co widać. Przy domyślnym progu 0.5 model oznacza jedną firmę (0.04%) i nie wyłapuje żadnej upadłości, a trafność wynosi 95.7% – tyle co „nikt nie upadnie”. Przy progu 0.05 oznacza 365 firm (13.4%), wyłapuje 59.5% upadłości, a co piąta oznaczona firma (precyzja 18.9%) naprawdę upada; trafność spada do 87.4%. Przy progu 0.10: 136 firm, czułość 37.9%, precyzja 32.4%.
Jak może zmylić. Trafność nagradza mówienie „nie upadnie”. Patrz na czułość i precyzję albo na krzywą precyzja–czułość. Sztuczne wyrównanie klas (SMOTE, losowe usuwanie firm zdrowych) nie pomaga: w symulacjach van den Goorbergha i in. (2022) psuło kalibrację, zawyżając ryzyko klasy rzadkiej, i nie poprawiało AUC; ten sam efekt daje przesunięcie progu (zob. nierównowaga klas). Jeśli dobierasz wszystkie upadłe i tylko część zdrowych firm, wyniki trzeba skorygować (King i Zeng, 2001). Jak wybrać próg z kosztów fałszywego alarmu i przeoczenia, pokazuje wpis wykrywanie nadużyć przy rzadkich zdarzeniach.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Używaj modelu do listy obserwacyjnej. Firmy o najwyższym ryzyku to kandydaci do dodatkowej analizy, wyższego zabezpieczenia albo krótszego terminu płatności; próg wynika z kosztów, nie z 0.5.
- Co roku aktualizuj wyraz wolny. W latach 4–5 model z lat 1–3 zaniżał ryzyko prawie o połowę. Aktualizacja na najnowszym roku to tani pierwszy krok.
- Gotowy Z-score sprawdź na własnych danych. Altman i in. (2017) sprawdzili wersję Z″ na firmach z 31 krajów europejskich i trzech spoza Europy: ogólny model klasyfikował z trafnością ok. 0.75, a oszacowany dla danego kraju z dodatkowymi zmiennymi – powyżej 0.90.
- Ilorazy szans to nie plan naprawczy. Zadłużenie miało OR wyższy od prawdziwego, bo niosło informację o niewidocznej kondycji firmy.
Podobny schemat – model, kalibracja, próg z kosztów – w marketingu opisuje wpis model przewidywania odejść klientów.
Jak opisać w pracy
Napisz, co było znane w dniu bilansowym, jak podzielono dane i jak oceniono model. Przy pracy z transportu zajrzyj też do wpisu statystyka w pracy z logistyki.
W Wynikach podaj tabelę porównania schematów walidacji:
| Schemat | n (upadłości) | AUC [95% CI] | Średnie ryzyko (%) | Upadło (%) | Wyraz wolny kal. | Nachylenie kal. | Brier |
|---|---|---|---|---|---|---|---|
| Podział losowy | 2125 (77) | .878 [.839, .917] | 3.2 | 3.6 | 0.14 | 1.21 | .030 |
| Podział w czasie | 2714 (116) | .837 [.797, .876] | 2.4 | 4.3 | 0.68 | 0.97 | .037 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – wskaźniki po winsoryzacji, przepis 3 – model, przepis 5 – przewidywania na zbiorze testowym. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki 1, 2, 4 i 5 na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka), a rysunek 3 zapisano bez zmian – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 i 5: każdy zaczyna od własnego set.seed(635). Ziarno 635 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę firm i lat, rozkłady wskaźników i odsetki skrajności, współczynniki prawdziwego modelu upadłości (wyrazy wolne zmienione raz z −4.6 i −3.9 na −4.2 i −3.5, gdy pierwsze uruchomienie dało 2.5% upadłości) oraz wyższy wyraz wolny w latach 4–5 (przepis 1); granice winsoryzacji na 1. i 99. percentylu (przepis 2); jednostki ilorazów szans (przepis 3); sprawozdanie przykładowej firmy (przepis 4); proporcję 70/30 losowego podziału (przepis 5); zakres progów (przepis 6). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane: 1500 firm, pięć lat sprawozdań
R
# Przepis 1. Fikcyjne firmy transportowe: 1500 firm, 5 lat sprawozdań, upadłość w kolejnych 12 miesiącach
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Podział w czasie" = "#0072B2", "Podział losowy" = "#D55E00", "Działające" = "grey55",
         "Upadłe" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie: kondycja firmy (stała część + zmiany z roku na rok), z niej cztery wskaźniki
# z dodatkiem szumu i rzadkich wartości skrajnych; prawdziwe ryzyko upadłości zależy od wskaźników
# „przyciętych” do rozsądnego zakresu i od kondycji, której analityk nie widzi. W latach 4–5 rosną koszty
# (paliwo, płace kierowców), więc wyraz wolny prawdziwego modelu jest wyższy niż w latach 1–3.
# Wyrazy wolne zmieniono raz (z −4.6 i −3.9 na −4.2 i −3.5), bo pierwsze uruchomienie dało 2.5% upadłości.
set.seed(635)                                    # ziarno ustalone raz, bez dobierania pod wynik
n_firm <- 1500
stala <- rnorm(n_firm)                           # trwała kondycja firmy (nieobserwowana)
firmy <- list(); dziala <- rep(TRUE, n_firm); h <- rnorm(n_firm)
for (rok in 1:5) {
  h <- 0.6 * h + 0.8 * rnorm(n_firm)             # zmiana kondycji z roku na rok
  k <- 0.7 * stala + 0.5 * h                     # kondycja w danym roku
  plynnosc <- exp(0.20 + 0.30 * k + rnorm(n_firm, 0, 0.40))
  plynnosc <- ifelse(runif(n_firm) < 0.015, plynnosc * runif(n_firm, 5, 40), plynnosc)  # prawie brak zobowiązań krótkoterm.
  zadluzenie <- 1.15 * plogis(0.30 - 0.60 * k + rnorm(n_firm, 0, 0.50))                   # zobowiązania / aktywa
  roa <- 3 + 3 * k + rnorm(n_firm, 0, 3.5)                                                # zysk netto / aktywa, %
  roa <- ifelse(runif(n_firm) < 0.03, roa - rexp(n_firm, 1 / 25), roa)                    # jednorazowe duże straty
  rotacja <- exp(0.45 + 0.10 * k + rnorm(n_firm, 0, 0.35))                                # przychody / aktywa
  rotacja <- ifelse(runif(n_firm) < 0.01, rotacja * runif(n_firm, 4, 10), rotacja)        # flota w leasingu poza bilansem
  logit <- ifelse(rok <= 3, -4.2, -3.5) - 1.1 * log(pmin(pmax(plynnosc, 0.3), 4)) +
    4.0 * (pmin(pmax(zadluzenie, 0.2), 1.1) - 0.6) - 0.10 * pmin(pmax(roa, -20), 15) -
    0.6 * log(pmin(pmax(rotacja, 0.5), 5)) - 0.5 * stala
  upadlosc <- rbinom(n_firm, 1, plogis(logit))   # upadłość w 12 miesiącach po dniu bilansowym (1 = tak)
  firmy[[rok]] <- data.frame(firma = sprintf("T%04d", 1:n_firm), rok, plynnosc = round(plynnosc, 3),
                             zadluzenie = round(zadluzenie, 3), roa = round(roa, 2), rotacja = round(rotacja, 3),
                             upadlosc)[dziala, ]
  dziala <- dziala & upadlosc == 0               # firma upadła – nie składa kolejnych sprawozdań
}
dane <- do.call(rbind, firmy); rownames(dane) <- NULL
write.csv(dane, "upadlosc-firmy-transportowe.csv", row.names = FALSE)

# Ile firm i upadłości w kolejnych latach?
data.frame(rok = 1:5, firmy = as.vector(table(dane$rok)), upadlosci = as.vector(tapply(dane$upadlosc, dane$rok, sum)),
           proc = round(100 * as.vector(tapply(dane$upadlosc, dane$rok, mean)), 1))
c(firmolata = nrow(dane), upadlosci = sum(dane$upadlosc), proc = round(100 * mean(dane$upadlosc), 2))
Wynik w R
  rok firmy upadlosci proc
1   1  1500        50  3.3
2   2  1450        29  2.0
3   3  1421        37  2.6
4   4  1384        54  3.9
5   5  1330        62  4.7
firmolata upadlosci      proc
  7085.00    232.00      3.27
2. Rozkłady i winsoryzacja wskaźników: Rysunek 1
R
# Przepis 2. Rozkłady wskaźników i winsoryzacja na 1. i 99. percentylu (granice z lat 1–3)
# (korzysta z dane, kol i motyw z przepisu 1)
library(ggplot2)

wskazniki <- c(plynnosc = "Płynność bieżąca", zadluzenie = "Zadłużenie ogólne",
               roa = "ROA (%)", rotacja = "Rotacja aktywów")
uczace <- dane$rok <= 3                                   # lata 1–3: tu liczymy granice i uczymy model
granice <- sapply(names(wskazniki), function(v) quantile(dane[uczace, v], c(0.01, 0.99)))
winsor <- function(x, g) pmin(pmax(x, g[1]), g[2])
for (v in names(wskazniki)) dane[[paste0(v, "_w")]] <- winsor(dane[[v]], granice[, v])

skosnosc <- function(x) mean((x - mean(x))^3) / sd(x)^3
opis <- t(sapply(names(wskazniki), function(v) {
  x <- dane[[v]]; w <- dane[[paste0(v, "_w")]]
  c(mediana = median(x), srednia = mean(x), SD = sd(x), min = min(x), max = max(x), skosnosc = skosnosc(x),
    P1 = granice[1, v], P99 = granice[2, v], zmienione_proc = 100 * mean(x != w),
    srednia_w = mean(w), SD_w = sd(w), skosnosc_w = skosnosc(w))
}))
round(opis, 2)

# Mediany wskaźników (po winsoryzacji) w firmach, które w kolejnych 12 miesiącach upadły, i pozostałych
round(sapply(paste0(names(wskazniki), "_w"), function(v) tapply(dane[[v]], dane$upadlosc, median)), 2)

# Rysunek: histogram każdego wskaźnika po winsoryzacji, granice P1 i P99, w ramce zakres surowych danych;
# płynność ma nawet po winsoryzacji ogromną skośność, więc rysujemy ją na osi logarytmicznej (tak też wejdzie do modelu)
library(patchwork)
status <- factor(ifelse(dane$upadlosc == 1, "Upadłe", "Działające"), c("Działające", "Upadłe"))
panel <- function(v, log_x = FALSE) {
  d <- data.frame(x = dane[[paste0(v, "_w")]], status)
  etykieta <- gsub("-", "\u2212", sprintf("surowe: od %.2f do %.2f\nzmieniono %.1f%% wartości\nskośność %.2f → %.2f",
                     opis[v, "min"], opis[v, "max"], opis[v, "zmienione_proc"], opis[v, "skosnosc"], opis[v, "skosnosc_w"]))
  ggplot(d, aes(x, fill = status)) +
    geom_histogram(aes(y = after_stat(density)), bins = 40, position = "identity", alpha = 0.55, colour = NA) +
    geom_vline(xintercept = granice[, v], linetype = "22", colour = "#0f1d3a") +
    annotate("label", x = Inf, y = Inf, label = etykieta, hjust = 1.02, vjust = 1.05, size = 3.3,
             linewidth = 0, fill = "white", alpha = 0.85, lineheight = 0.95) +
    { if (log_x) scale_x_log10(breaks = c(0.5, 1, 2, 5, 10, 25)) else scale_x_continuous() } +
    scale_fill_manual(values = kol[c("Działające", "Upadłe")], name = NULL, drop = FALSE) +
    scale_y_continuous(expand = expansion(mult = c(0, 0.6))) +
    labs(title = paste0(wskazniki[[v]], if (log_x) " – oś logarytmiczna" else ""), x = NULL, y = NULL) +
    motyw + theme(axis.text.y = element_blank(), plot.title = element_text(size = rel(0.85)))
}
p1 <- (panel("plynnosc", TRUE) | panel("zadluzenie")) / (panel("roa") | panel("rotacja")) +
  plot_layout(guides = "collect") +
  plot_annotation(title = "Wskaźniki finansowe firm transportowych po winsoryzacji",
                  subtitle = "7085 sprawozdań; linie przerywane: 1. i 99. percentyl z lat 1–3", theme = motyw) &
  theme(legend.position = "bottom")
p1   # zapis: ggsave("upadlosc-wskazniki-winsoryzacja.svg", p1, width = 10, height = 7.4)
Wynik w R
           mediana srednia   SD     min    max skosnosc     P1   P99
plynnosc      1.25    1.94 5.06    0.22 114.58    11.24   0.41 25.65
zadluzenie    0.65    0.64 0.18    0.12   1.08    -0.18   0.23  1.00
roa           3.02    2.55 6.90 -128.57  17.89    -5.38 -21.04 13.47
rotacja       1.58    1.80 1.38    0.46  32.70     9.66   0.70  4.83
           zmienione_proc srednia_w SD_w skosnosc_w
plynnosc             1.99      1.73 2.80       7.41
zadluzenie           1.88      0.64 0.18      -0.17
roa                  1.96      2.76 5.17      -1.18
rotacja              2.17      1.72 0.70       1.66
  plynnosc_w zadluzenie_w roa_w rotacja_w
0       1.27         0.64  3.15      1.59
1       0.82         0.86 -1.41      1.42
3. Regresja logistyczna i ilorazy szans: Rysunek 2
R
# Przepis 3. Regresja logistyczna na latach 1–3 i ilorazy szans z 95% CI (błędy odporne na grupowanie w firmach)
# (korzysta z dane, uczace, kol i motyw z przepisów 1–2)
library(ggplot2)
library(sandwich)

# Jednostki dobrane tak, żeby OR dało się opowiedzieć: podwojenie płynności i rotacji (log2),
# 10 punktów procentowych zadłużenia, 5 punktów procentowych ROA
dane <- transform(dane, l2_plyn = log2(plynnosc_w), zadl_10 = zadluzenie_w * 10, roa_5 = roa_w / 5,
                  l2_rot = log2(rotacja_w),
                  l2_plyn_s = log2(plynnosc), zadl_10_s = zadluzenie * 10, roa_5_s = roa / 5, l2_rot_s = log2(rotacja))
ucz <- dane[uczace, ]; test <- dane[!uczace, ]
c(sprawozdania = nrow(ucz), upadlosci = sum(ucz$upadlosc), zdarzenia_na_predyktor = sum(ucz$upadlosc) / 4)

model <- glm(upadlosc ~ l2_plyn + zadl_10 + roa_5 + l2_rot, family = binomial, data = ucz)
model_surowe <- glm(upadlosc ~ l2_plyn_s + zadl_10_s + roa_5_s + l2_rot_s, family = binomial, data = ucz)

# Ta sama firma ma do trzech sprawozdań, więc błędy standardowe liczymy odpornie na grupowanie w firmach
se_firmy <- sqrt(diag(vcovCL(model, cluster = ~ firma)))
or <- data.frame(zmienna = names(coef(model)), OR = exp(coef(model)),
                 dolna = exp(coef(model) - 1.96 * se_firmy), gorna = exp(coef(model) + 1.96 * se_firmy),
                 p = 2 * pnorm(-abs(coef(model) / se_firmy)))[-1, ]
print(transform(or, OR = round(OR, 2), dolna = round(dolna, 2), gorna = round(gorna, 2), p = signif(p, 2)),
      row.names = FALSE)
round(exp(coef(model_surowe))[-1], 2)          # dla porównania: model na wskaźnikach bez winsoryzacji
# Prawdziwe OR z przepisu 1 w tych samych jednostkach (znane, bo dane są fikcyjne)
round(c(l2_plyn = exp(-1.1 * log(2)), zadl_10 = exp(4.0 * 0.1), roa_5 = exp(-0.10 * 5), l2_rot = exp(-0.6 * log(2))), 2)

or$etykieta <- factor(c("Płynność bieżąca\n(podwojenie)", "Zadłużenie ogólne\n(+10 pp)", "ROA\n(+5 pp)",
                        "Rotacja aktywów\n(podwojenie)"),
                      rev(c("Płynność bieżąca\n(podwojenie)", "Zadłużenie ogólne\n(+10 pp)", "ROA\n(+5 pp)",
                            "Rotacja aktywów\n(podwojenie)")))
p2 <- ggplot(or, aes(OR, etykieta)) +
  geom_vline(xintercept = 1, linetype = "22", colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.18, orientation = "y", colour = "#0072B2", linewidth = 0.8) +
  geom_point(size = 3.5, colour = "#0072B2") +
  geom_text(aes(label = sprintf("%.2f [%.2f, %.2f]", OR, dolna, gorna)), vjust = -1.1, size = 3.8) +
  scale_x_log10(breaks = c(0.25, 0.5, 1, 2, 4)) +
  labs(x = "Iloraz szans upadłości (skala logarytmiczna, 95% CI)", y = NULL,
       title = "Które wskaźniki wiążą się z upadłością?",
       subtitle = "Regresja logistyczna, lata 1–3 (4371 sprawozdań); OR > 1 = wyższe ryzyko") +
  motyw
p2   # zapis: ggsave("upadlosc-ilorazy-szans.svg", p2, width = 10, height = 5.4)
Wynik w R
          sprawozdania              upadlosci zdarzenia_na_predyktor
                  4371                    116                     29
 zmienna   OR dolna gorna       p
 l2_plyn 0.42  0.30  0.57 6.9e-08
 zadl_10 1.79  1.52  2.12 7.0e-12
   roa_5 0.65  0.56  0.76 7.6e-08
  l2_rot 0.68  0.47  0.98 3.7e-02
l2_plyn_s zadl_10_s   roa_5_s  l2_rot_s
     0.39      1.87      0.88      0.73
l2_plyn zadl_10   roa_5  l2_rot
   0.47    1.49    0.61    0.66
4. Karta dla jednej firmy: Rysunek 3
R
# Przepis 4. Karta „od sprawozdania do prawdopodobieństwa” dla jednej fikcyjnej firmy (grafika z prostokątów i tekstu)
# (korzysta z model, granice, winsor() i ucz z przepisów 2–3)
library(ggplot2)

# Sprawozdanie fikcyjnej firmy przewozowej (tys. zł) – liczby ustalone ręcznie jako przykład
spr <- c(aktywa_obrotowe = 2040, zobow_krotkoterminowe = 2550, zobowiazania = 7920, aktywa = 9000,
         zysk_netto = -450, przychody = 13500)
x <- c(plynnosc = spr[["aktywa_obrotowe"]] / spr[["zobow_krotkoterminowe"]],
       zadluzenie = spr[["zobowiazania"]] / spr[["aktywa"]],
       roa = 100 * spr[["zysk_netto"]] / spr[["aktywa"]], rotacja = spr[["przychody"]] / spr[["aktywa"]])
xw <- sapply(names(x), function(v) winsor(x[[v]], granice[, v]))      # w granicach P1–P99: bez zmian
b <- coef(model)
wklad <- c(wyraz_wolny = b[[1]], plynnosc = b[["l2_plyn"]] * log2(xw[["plynnosc"]]),
           zadluzenie = b[["zadl_10"]] * 10 * xw[["zadluzenie"]], roa = b[["roa_5"]] * xw[["roa"]] / 5,
           rotacja = b[["l2_rot"]] * log2(xw[["rotacja"]]))
p_firma <- plogis(sum(wklad))
round(c(x, logit = sum(wklad), p_proc = 100 * p_firma, srednia_lata_1_3_proc = 100 * mean(ucz$upadlosc),
        razy_wiecej = p_firma / mean(ucz$upadlosc)), 3)
round(wklad, 3)

# Grafika: pięć kart połączonych strzałkami (dwa rzędy, żeby była czytelna na telefonie)
minus <- function(s) gsub("-", "\u2212", s)              # znak minus zamiast dywizu
karty <- data.frame(
  x0 = c(0, 3.5, 7, 0, 5.25), x1 = c(3.1, 6.6, 10.1, 4.85, 10.1), y0 = c(3.6, 3.6, 3.6, 0, 0), y1 = c(6.4, 6.4, 6.4, 3.0, 3.0),
  kolor = c("#e8eef6", "#e8eef6", "#e8eef6", "#e8eef6", "#fbe3d4"),
  tytul = c("1. Sprawozdanie (tys. zł)", "2. Wskaźniki", "3. Winsoryzacja", "4. Model: logit = suma wkładów",
            "5. Prawdopodobieństwo upadłości"),
  tresc = minus(c(
    sprintf("aktywa obrotowe %s\nzobow. krótkoterm. %s\nzobowiązania %s\naktywa %s\nzysk netto %s\nprzychody %s",
            spr[1], spr[2], spr[3], spr[4], spr[5], spr[6]),
    sprintf("płynność bieżąca %.2f\nzadłużenie ogólne %.2f\nROA %.1f%%\nrotacja aktywów %.2f", x[1], x[2], x[3], x[4]),
    sprintf("granice P1 i P99 z lat 1–3:\npłynność od %.2f do %.2f\nzadłużenie od %.2f do %.2f\nROA od %.1f do %.1f%%\nrotacja od %.2f do %.2f\n→ wszystkie w granicach",
            granice[1, 1], granice[2, 1], granice[1, 2], granice[2, 2], granice[1, 3], granice[2, 3],
            granice[1, 4], granice[2, 4]),
    sprintf("wyraz wolny %.2f\nlog\u2082 płynności: %+.2f\nzadłużenie: %+.2f\nROA: %+.2f\nlog\u2082 rotacji: %+.2f\nrazem: logit = %.2f",
            wklad[1], wklad[2], wklad[3], wklad[4], wklad[5], sum(wklad)),
    sprintf("p = 1 / (1 + e^(-logit)) = %.1f%%\n\nśrednio w latach 1–3: %.1f%%\nczyli %.1f razy więcej\n(ranking, nie wyrok)",
            100 * p_firma, 100 * mean(ucz$upadlosc), p_firma / mean(ucz$upadlosc)))))
strzalki <- data.frame(x = c(3.1, 6.6, 4.85), xend = c(3.5, 7, 5.25), y = c(5, 5, 1.5), yend = c(5, 5, 1.5))
lamana <- data.frame(x = c(8.55, 8.55, 2.4, 2.4), y = c(3.6, 3.3, 3.3, 3.0))     # z karty 3 do karty 4
p3 <- ggplot(karty) +
  geom_rect(aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1, fill = kolor), colour = "#0f1d3a", linewidth = 0.4) +
  geom_text(aes(x = x0 + 0.15, y = y1 - 0.3, label = tytul), hjust = 0, fontface = "bold", size = 4.2, colour = "#0f1d3a") +
  geom_text(aes(x = x0 + 0.15, y = y1 - 0.62, label = tresc), hjust = 0, vjust = 1, size = 4, lineheight = 1.05) +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = yend),
               arrow = arrow(length = unit(0.18, "cm"), type = "closed"), colour = "#0f1d3a") +
  geom_path(data = lamana, aes(x, y), arrow = arrow(length = unit(0.18, "cm"), type = "closed"), colour = "#0f1d3a") +
  scale_fill_identity() + coord_cartesian(xlim = c(0, 10.1), ylim = c(0, 6.4), expand = FALSE) +
  labs(title = "Od sprawozdania do prawdopodobieństwa upadłości",
       subtitle = "Fikcyjna firma przewozowa; model z lat 1–3") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p3   # zapis: ggsave("upadlosc-karta-od-sprawozdania.svg", p3, width = 10, height = 6.2)
Wynik w R
             plynnosc            zadluzenie                   roa
                0.800                 0.880                -5.000
              rotacja                 logit                p_proc
                1.500                -2.103                10.881
srednia_lata_1_3_proc           razy_wiecej
                2.654                 4.100
wyraz_wolny    plynnosc  zadluzenie         roa     rotacja
     -7.727       0.283       5.138       0.430      -0.227
5. Walidacja w czasie a losowy podział: Rysunek 4
R
# Przepis 5. Walidacja w czasie (uczenie: lata 1–3, test: lata 4–5) a losowy podział sprawozdań
# (korzysta z dane, ucz, test, model, model_surowe, kol i motyw z przepisów 1–3)
library(ggplot2)
library(patchwork)
library(pROC)

wzor <- upadlosc ~ l2_plyn + zadl_10 + roa_5 + l2_rot
test$p <- predict(model, test, type = "response")

# Losowy podział: 70% sprawozdań ze wszystkich lat do uczenia, 30% do testu (tak robi wielu studentów)
set.seed(635)
los <- sample(nrow(dane), round(0.7 * nrow(dane)))
ucz_los <- dane[los, ]; test_los <- dane[-los, ]
model_los <- glm(wzor, family = binomial, data = ucz_los)
test_los$p <- predict(model_los, test_los, type = "response")

logit <- function(p) log(p / (1 - p))
ocena <- function(y, p) {
  r <- roc(y, p, quiet = TRUE); ci <- ci.auc(r, method = "delong")
  c(n = length(y), upadlosci = sum(y), AUC = ci[2], AUC_dolna = ci[1], AUC_gorna = ci[3],
    srednie_ryzyko_proc = 100 * mean(p), odsetek_upadlosci_proc = 100 * mean(y), Brier = mean((p - y)^2),
    wyraz_wolny = unname(coef(glm(y ~ offset(logit(p)), family = binomial))[1]),
    nachylenie = unname(coef(glm(y ~ logit(p), family = binomial))[2]))
}
wyniki <- rbind("Podział losowy" = ocena(test_los$upadlosc, test_los$p),
                "Podział w czasie" = ocena(test$upadlosc, test$p),
                "W czasie, bez winsoryzacji" = ocena(test$upadlosc, predict(model_surowe, test, type = "response")))
round(wyniki, 3)
# Test w czasie osobno dla lat 4 i 5: przewidywane i obserwowane odsetki upadłości (%)
round(100 * sapply(split(test, test$rok), function(d) c(przewidywane = mean(d$p), obserwowane = mean(d$upadlosc))), 1)
# Aktualizacja wyrazu wolnego na najnowszym roku (rok 4) i sprawdzenie na roku 5; współczynniki bez zmian
r4 <- test$rok == 4
korekta <- unname(coef(glm(upadlosc ~ offset(logit(p)), family = binomial, data = test[r4, ]))[1])
p5_kor <- plogis(logit(test$p[!r4]) + korekta)
round(c(korekta_wyrazu_wolnego = korekta, rok5_przed_proc = 100 * mean(test$p[!r4]),
        rok5_po_proc = 100 * mean(p5_kor), rok5_obserwowane_proc = 100 * mean(test$upadlosc[!r4])), 3)

# Rysunek A: krzywe ROC; rysunek B: kalibracja w pięciu grupach ryzyka (kwintyle)
krzywa <- function(y, p, nazwa) { r <- roc(y, p, quiet = TRUE)
  data.frame(podzial = nazwa, fpr = 1 - r$specificities, tpr = r$sensitivities) }
dr <- rbind(krzywa(test_los$upadlosc, test_los$p, "Podział losowy"), krzywa(test$upadlosc, test$p, "Podział w czasie"))
dr <- dr[order(dr$podzial, dr$fpr, dr$tpr), ]
zmiana <- c(TRUE, diff(dr$tpr) != 0 | diff(as.numeric(factor(dr$podzial))) != 0)
dr <- dr[zmiana | c(zmiana[-1], TRUE), ]                 # z poziomych odcinków zostają tylko końce (mniejszy plik SVG)
kalib <- function(y, p, nazwa) {
  g <- cut(rank(p, ties.method = "first"), 5, labels = FALSE)
  do.call(rbind, lapply(split(data.frame(y, p), g), function(d) {
    ci <- prop.test(sum(d$y), nrow(d), correct = FALSE)$conf.int          # przedział Wilsona
    data.frame(podzial = nazwa, przewidywane = 100 * mean(d$p), obserwowane = 100 * mean(d$y),
               dolna = 100 * ci[1], gorna = 100 * ci[2]) }))
}
dk <- rbind(kalib(test_los$upadlosc, test_los$p, "Podział losowy"), kalib(test$upadlosc, test$p, "Podział w czasie"))
print(transform(dk[, 1:3], przewidywane = round(przewidywane, 1), obserwowane = round(obserwowane, 1)), row.names = FALSE)

etyk <- sprintf("%s: AUC = %.3f [%.3f, %.3f]", rownames(wyniki)[1:2], wyniki[1:2, "AUC"],
                wyniki[1:2, "AUC_dolna"], wyniki[1:2, "AUC_gorna"])
names(etyk) <- rownames(wyniki)[1:2]
pa <- ggplot(dr, aes(fpr, tpr, colour = podzial, linetype = podzial)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey70") +
  geom_step(linewidth = 0.8) +
  annotate("text", x = 0.98, y = c(0.14, 0.06), label = etyk[c("Podział losowy", "Podział w czasie")],
           hjust = 1, size = 3.5, colour = kol[c("Podział losowy", "Podział w czasie")]) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_linetype_manual(values = c("22", "solid"), name = NULL) +
  coord_equal() + labs(x = "1 − swoistość", y = "Czułość", title = "A. Krzywe ROC") + motyw
pb <- ggplot(dk, aes(przewidywane, obserwowane, colour = podzial, shape = podzial)) +
  geom_abline(slope = 1, intercept = 0, linetype = "22", colour = "grey40") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0, alpha = 0.6,
                position = position_dodge(width = 0.6)) +
  geom_line(linewidth = 0.7) + geom_point(size = 3) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  coord_equal(xlim = c(0, 16), ylim = c(0, 16)) +
  labs(x = "Przewidywane ryzyko (%)", y = "Upadło naprawdę (%, 95% CI)", title = "B. Kalibracja (kwintyle ryzyka)") +
  motyw
p4 <- (pa | pb) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("upadlosc-walidacja-w-czasie.svg", p4, width = 10, height = 5.8)
Wynik w R
                              n upadlosci   AUC AUC_dolna AUC_gorna
Podział losowy             2125        77 0.878     0.839     0.917
Podział w czasie           2714       116 0.837     0.797     0.876
W czasie, bez winsoryzacji 2714       116 0.832     0.793     0.872
                           srednie_ryzyko_proc odsetek_upadlosci_proc Brier
Podział losowy                           3.212                  3.624 0.030
Podział w czasie                         2.369                  4.274 0.037
W czasie, bez winsoryzacji               2.426                  4.274 0.037
                           wyraz_wolny nachylenie
Podział losowy                   0.139      1.207
Podział w czasie                 0.679      0.968
W czasie, bez winsoryzacji       0.648      0.968
               4   5
przewidywane 2.5 2.2
obserwowane  3.9 4.7
korekta_wyrazu_wolnego        rok5_przed_proc           rok5_po_proc
                 0.510                  2.228                  3.499
 rok5_obserwowane_proc
                 4.662
          podzial przewidywane obserwowane
   Podział losowy          0.2         0.2
   Podział losowy          0.6         0.2
   Podział losowy          1.3         1.4
   Podział losowy          3.0         1.9
   Podział losowy         11.0        14.4
 Podział w czasie          0.1         0.7
 Podział w czasie          0.3         0.6
 Podział w czasie          0.8         1.7
 Podział w czasie          2.0         3.1
 Podział w czasie          8.6        15.3
6. Trafność, czułość i precyzja a próg: Rysunek 5
R
# Przepis 6. Rzadkość upadłości: trafność, czułość i precyzja w zależności od progu (test w czasie: lata 4–5)
# (korzysta z test i p z przepisu 5 oraz kol i motyw z przepisu 1)
library(ggplot2)

miary <- function(prog, y = test$upadlosc, p = test$p) {
  alarm <- p >= prog
  c(prog = prog, oznaczone = sum(alarm), oznaczone_proc = 100 * mean(alarm), trafnosc = 100 * mean(alarm == (y == 1)),
    czulosc = 100 * sum(alarm & y == 1) / sum(y == 1),
    precyzja = if (any(alarm)) 100 * sum(alarm & y == 1) / sum(alarm) else NA)
}
c(trafnosc_model_nikt_nie_upadnie = round(100 * mean(test$upadlosc == 0), 1))
print(round(t(sapply(c(0.02, 0.05, 0.10, 0.20, 0.50), miary)), 3), digits = 6)

progi <- seq(0.005, 0.30, by = 0.005)     # powyżej 0.30 oznaczonych firm jest kilka – precyzja skacze
dp <- as.data.frame(t(sapply(progi, miary)))
dl <- rbind(data.frame(prog = dp$prog, miara = "Trafność", wartosc = dp$trafnosc),
            data.frame(prog = dp$prog, miara = "Czułość", wartosc = dp$czulosc),
            data.frame(prog = dp$prog, miara = "Precyzja", wartosc = dp$precyzja))
dl$miara <- factor(dl$miara, c("Trafność", "Czułość", "Precyzja"))
kol_m <- c("Trafność" = "grey35", "Czułość" = "#0072B2", "Precyzja" = "#D55E00")
p5 <- ggplot(dl, aes(prog, wartosc, colour = miara, linetype = miara)) +
  geom_hline(yintercept = 100 * mean(test$upadlosc == 0), colour = "grey60", linetype = "dotted") +
  annotate("text", x = 0.3, y = 100 * mean(test$upadlosc == 0) - 3.5, hjust = 1, size = 3.6, colour = "grey30",
           label = sprintf("„nikt nie upadnie”: trafność %.1f%%", 100 * mean(test$upadlosc == 0))) +
  geom_line(linewidth = 0.9, na.rm = TRUE) +
  scale_colour_manual(values = kol_m, name = NULL) + scale_linetype_manual(values = c("solid", "42", "11"), name = NULL) +
  scale_x_continuous(breaks = c(0.02, 0.05, 0.1, 0.2, 0.3)) +
  labs(x = "Próg przewidywanego ryzyka, od którego firmę oznaczamy jako zagrożoną", y = "%",
       title = "Gdy upadłości jest ok. 4%, trafność prawie nic nie mówi",
       subtitle = "Test w czasie: lata 4–5, 2714 sprawozdań, 116 upadłości") +
  motyw
p5   # zapis: ggsave("upadlosc-trafnosc-a-prog.svg", p5, width = 10, height = 5.6)
Wynik w R
trafnosc_model_nikt_nie_upadnie
                           95.7
     prog oznaczone oznaczone_proc trafnosc czulosc precyzja
[1,] 0.02       803         29.587   72.771  77.586   11.208
[2,] 0.05       365         13.449   87.362  59.483   18.904
[3,] 0.10       136          5.011   93.957  37.931   32.353
[4,] 0.20        31          1.142   95.689  12.931   48.387
[5,] 0.50         1          0.037   95.689   0.000    0.000
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("podział w czasie – losowy" = c("#0072B2", "#D55E00"), "działające – upadłe" = c("grey55", "#D55E00"),
             "czułość – precyzja" = c("#0072B2", "#D55E00"), "trafność – czułość" = c("grey35", "#0072B2"),
             "karta – karta wyniku" = c("#e8eef6", "#fbe3d4"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
podział w czasie – losowy                  114.6        108.3       91.9
działające – upadłe                         76.8         62.6       54.8
czułość – precyzja                         114.6        108.3       91.9
trafność – czułość                          42.2         45.3       39.9
karta – karta wyniku                        16.3         15.8       14.1
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja logistyczna (glm()) i przedziały Wilsona (prop.test()) – pakiet stats z podstawowej instalacji R; błędy standardowe odporne na grupowanie – pakiet sandwich; krzywe ROC i przedziały ufności AUC metodą DeLonga – pakiet pROC. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Losowy podział lat. Daje zbyt dobry obraz: AUC .878 zamiast .837 i ukrytą zmianę poziomu ryzyka (rysunek 4).
- Trafność przy rzadkim zdarzeniu. 95.7% trafności osiąga model, który nie wskazuje żadnej upadłości (rysunek 5).
- Granice winsoryzacji z całych danych. Licz je na zbiorze uczącym i stosuj do testowego.
- Wskaźniki ze sprawozdania po upadłości. Predyktor musi pochodzić sprzed okna wyniku; ostatnie sprawozdanie firmy w stanie upadłości to przeciek.
- Za dużo wskaźników na za mało upadłości. Tu 29 zdarzeń na predyktor; z 20 wskaźnikami przy tej samej liczbie upadłości model byłby niestabilny (przeuczenie).
Najczęstsze pytania
Dlaczego do prognozy upadłości używa się regresji logistycznej?
Bo wynik jest dwuwartościowy (upadła lub nie w ciągu roku), a regresja logistyczna daje wprost prawdopodobieństwo i ilorazy szans dla wskaźników. Gdy każda firma ma kilka sprawozdań, model „firma × rok” jest dyskretnym modelem hazardu, który szacuje się tą samą procedurą (Shumway, 2001); błędy standardowe licz wtedy odpornie na grupowanie w firmach.
Czym różni się walidacja w czasie od losowego podziału danych?
W walidacji w czasie model uczy się na wcześniejszych latach i jest sprawdzany na późniejszych, tak jak będzie używany. Losowy podział miesza lata i firmy, więc daje zbyt dobry obraz. W przykładzie AUC spadło z .878 do .837, a przewidywane ryzyko w latach 4–5 było prawie dwa razy niższe od rzeczywistego.
Jak winsoryzować wskaźniki finansowe w modelu upadłości?
Zwykle tak, bo ułamki z małym mianownikiem dają wartości skrajne (tu płynność do 114.58, ROA do −128.57%). Winsoryzacja na 1. i 99. percentylu zmieniła ok. 2% wartości i zmieniła OR dla ROA z 0.88 na 0.65. Granice licz na zbiorze uczącym, a wynik porównaj z modelem bez winsoryzacji lub z regresją odporną.
Dlaczego trafność modelu upadłości jest myląca?
Bo upadłości są rzadkie. Przy 4.3% upadłości model mówiący „nikt nie upadnie” ma 95.7% trafności. Patrz na czułość, precyzję, AUC i kalibrację, a próg wybierz z kosztów fałszywego alarmu i przeoczenia – zob. wykrywanie nadużyć przy rzadkich zdarzeniach.
Czy można po prostu użyć Z-score Altmana?
Można jako punkt odniesienia, ale trzeba go sprawdzić na własnych danych. W badaniu firm z 31 krajów europejskich i trzech spoza Europy ogólna wersja modelu Z″ klasyfikowała z trafnością ok. 0.75, a oszacowana dla danego kraju z dodatkowymi zmiennymi – powyżej 0.90 (Altman i in., 2017).
Powiązane hasła
Przeczytaj też
Scoring kredytowy: WoE, IV i karta punktowa
Kasa spółdzielcza, 6000 pożyczek: przedziały, WoE i IV ręcznie, karta punktowa z PDO, Gini i KS, PSI i przetrenowane przedziały – pięć rysunków z kodem R.
Czytaj →PoradnikWykrywanie nadużyć przy rzadkich zdarzeniach
Ubezpieczyciel, 60 000 szkód i 200 kontroli miesięcznie: krzywe ROC i PR, macierz kosztów, wybór według zysku, SMOTE a kalibracja i etykiety z kontroli – pięć rysunków z kodem R.
Czytaj →PoradnikPrzeciek danych w modelach biznesowych – walidacja w czasie i zawyżona trafność
Czytaj →Budujesz model upadłości do pracy z finansów?
Pomożemy przygotować wskaźniki, zaplanować walidację w czasie, ocenić dyskryminację i kalibrację oraz opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, E. I., Iwanicz-Drozdowska, M., Laitinen, E. K., & Suvas, A. (2017). Financial distress prediction in an international context: A review and empirical analysis of Altman's Z-score model. Journal of International Financial Management & Accounting, 28(2), 131–171. https://doi.org/10.1111/jifm.12053 ● Otwarty dostęp: pełny tekst
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- King, G., & Zeng, L. (2001). Logistic regression in rare events data. Political Analysis, 9(2), 137–163. https://doi.org/10.1093/oxfordjournals.pan.a004868 ● Otwarty dostęp
- Leone, A. J., Minutti-Meza, M., & Wasley, C. E. (2019). Influential observations and inference in accounting research. The Accounting Review, 94(6), 337–364. https://doi.org/10.2308/accr-52396 ● Otwarty dostęp: pełny tekst
- Shumway, T. (2001). Forecasting bankruptcy more accurately: A simple hazard model. The Journal of Business, 74(1), 101–124. https://doi.org/10.1086/209665 ● Otwarty dostęp: pełny tekst
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
- van den Goorbergh, R., van Smeden, M., Timmerman, D., & Van Calster, B. (2022). The harm of class imbalance corrections for risk prediction models: Illustration and simulation using logistic regression. Journal of the American Medical Informatics Association, 29(9), 1525–1534. https://doi.org/10.1093/jamia/ocac093 ● Otwarty dostęp
Cytowania BibTeX
@article{altman2017financial, author={Altman, Edward I. and Iwanicz-Drozdowska, Ma{\l}gorzata and Laitinen, Erkki K. and Suvas, Arto}, title={{Financial distress prediction in an international context: A review and empirical analysis of Altman's Z-score model}}, journal={Journal of International Financial Management \& Accounting}, year={2017}, volume={28}, number={2}, pages={131--171}, doi={10.1111/jifm.12053}}@article{delong1988comparing, author={DeLong, Elizabeth R. and DeLong, David M. and Clarke-Pearson, Daniel L.}, title={{Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach}}, journal={Biometrics}, year={1988}, volume={44}, number={3}, pages={837--845}, doi={10.2307/2531595}}@article{king2001logistic, author={King, Gary and Zeng, Langche}, title={{Logistic regression in rare events data}}, journal={Political Analysis}, year={2001}, volume={9}, number={2}, pages={137--163}, doi={10.1093/oxfordjournals.pan.a004868}}@article{leone2019influential, author={Leone, Andrew J. and Minutti-Meza, Miguel and Wasley, Charles E.}, title={{Influential observations and inference in accounting research}}, journal={The Accounting Review}, year={2019}, volume={94}, number={6}, pages={337--364}, doi={10.2308/accr-52396}}@article{shumway2001forecasting, author={Shumway, Tyler}, title={{Forecasting bankruptcy more accurately: A simple hazard model}}, journal={The Journal of Business}, year={2001}, volume={74}, number={1}, pages={101--124}, doi={10.1086/209665}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}@article{vandengoorbergh2022harm, author={van den Goorbergh, Ruben and van Smeden, Maarten and Timmerman, Dirk and Van Calster, Ben}, title={{The harm of class imbalance corrections for risk prediction models: Illustration and simulation using logistic regression}}, journal={Journal of the American Medical Informatics Association}, year={2022}, volume={29}, number={9}, pages={1525--1534}, doi={10.1093/jamia/ocac093}}