Co to jest krzywa precyzja–czułość?
Krzywa precyzja–czułość (ang. precision–recall curve, krzywa PR) pokazuje, co dzieje się z trafnością wyników dodatnich, gdy obniżamy próg wskaźnika lub modelu. Na osi poziomej jest czułość (w uczeniu maszynowym recall): odsetek przypadków, które wskaźnik wykrył. Na osi pionowej jest precyzja, czyli wartość predykcyjna dodatnia (PPV): odsetek prawdziwych przypadków wśród wyników dodatnich. Oba odsetki pochodzą z macierzy pomyłek przy każdym możliwym progu. W odróżnieniu od krzywej ROC krzywa PR nie używa liczby prawdziwie ujemnych, więc reaguje na częstość wyniku. Saito i Rehmsmeier (2015) pokazali, że przy silnie niezrównoważonych klasach wykres PR lepiej niż ROC oddaje, jak klasyfikator sprawdzi się w praktyce.
Jak czytać krzywą PR
- Lewy koniec to najwyższe progi: niewiele wyników dodatnich. Krzywa bywa tam poszarpana, bo precyzję liczy się z kilku osób.
- Prawy koniec to próg najniższy: wszyscy są „dodatni”, więc precyzja spada do częstości wyniku.
- Linia bazowa to pozioma linia na wysokości częstości wyniku, a nie przekątna jak w ROC. Tyle uzyskałby wskaźnik losowy.
- Pole pod krzywą zwykle podaje się jako średnią precyzję (AP). Porównuj je z częstością, nie z 0.5.
Przykład
Symulowany wskaźnik ma wyniki z rozkładu normalnego: u osób bez zaburzenia średnia 0, u osób z zaburzeniem 1.5 (SD = 1 w obu grupach; różnicę ustawiono ręcznie, ziarno 785 nie było zmieniane). W pierwszym zbiorze zaburzenie ma 1900 z 3800 osób (50%), w drugim 100 z 2000 (5%) – to te same 1900 osób zdrowych. Pole pod krzywą ROC jest podobne: .842 i .820 (różnica wynika z losowania 100 przypadków). Średnia precyzja spada jednak z .841 do .337. Przy progu wykrywającym 80% przypadków precyzja wynosi .733 przy częstości 50%, ale tylko .111 przy 5%. Żeby znaleźć 80 osób z zaburzeniem, wskaźnik daje 643 fałszywe alarmy.
Na rysunku
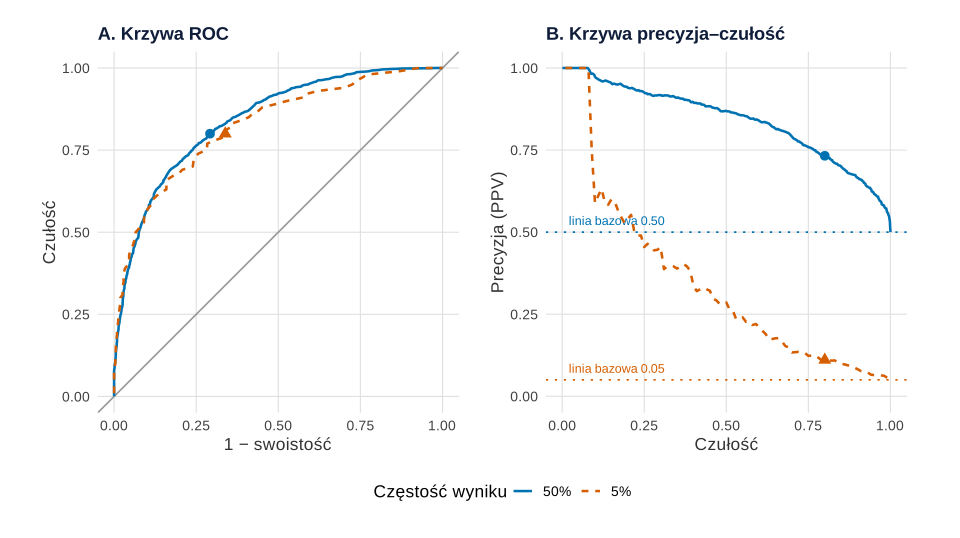
set.seed(785)).Co widać. Panel A sugeruje, że w obu zbiorach wskaźnik działa tak samo dobrze. Panel B pokazuje różnicę: przy rzadkim wyniku precyzja szybko spada, a w punkcie czułości 80% tylko co dziewiąty wynik dodatni jest trafny. Krzywa ROC tego nie pokaże, bo 643 fałszywe alarmy to tylko 34% z 1900 zdrowych.
Na co uważać. Krzywa PR opisuje wskaźnik w populacji o tej częstości, jaką ma próba. Przy innej częstości (np. w badaniu przypadek–kontrola) precyzja będzie inna. Davis i Goadrich (2006) pokazali też, że punktów krzywej PR nie wolno łączyć liniowo, jak w przestrzeni ROC.
Podpis do pracy:
Rysunek na stronie powstał z tych samych obiektów z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Krok po kroku od rozkładów do krzywej ROC prowadzi wpis Krzywa ROC w obrazkach.
Jak opisać w pracy
Na co uważać
- AP porównane z 0.5. AP = .34 przy częstości 5% to wynik prawie siedem razy lepszy od losowego. Zawsze podawaj linię bazową.
- Porównanie krzywych PR z prób o różnej częstości. Różnica może wynikać z częstości, a nie z jakości modelu.
- Sztuczne zrównoważenie klas. Po losowym dobraniu przypadków lub kontroli precyzja nie odpowiada populacji (zob. nierównowaga klas).
- Liniowa interpolacja punktów PR daje błędne pole pod krzywą. Licz średnią precyzję.
- Sama krzywa nie wybiera progu. Próg zależy od kosztu fałszywych alarmów i pominięć. Odsetek przypadków w kolejnych decylach ryzyka pokazuje też wykres lift i gain.
Krzywa PR w R
Kod symuluje wyniki wskaźnika, liczy czułość, 1 − swoistość i precyzję dla wszystkich progów, pole pod krzywą ROC (jako odsetek par przypadek–kontrola uporządkowanych poprawnie) i średnią precyzję, a na końcu buduje rysunek (obiekt p1). Nie wymaga pakietów do ROC.
Krzywe ROC i PR przy częstości 50% i 5%
R
# Krzywa precyzja–czułość (PR) i krzywa ROC tego samego wskaźnika przy częstości 50% i 5%
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("50%" = "#0072B2", "5%" = "#D55E00")   # Okabe–Ito; częstości różnią się też rodzajem linii
lin <- c("50%" = "solid", "5%" = "22")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(785)                                    # wynik wskaźnika: przypadki N(1.5, 1), pozostali N(0, 1)
ujemne <- rnorm(1900, 0, 1)
dodatnie <- rnorm(1900, 1.5, 1)
zbiory <- list("50%" = data.frame(wynik = c(dodatnie, ujemne), y = rep(1:0, c(1900, 1900))),
               "5%" = data.frame(wynik = c(dodatnie[1:100], ujemne), y = rep(1:0, c(100, 1900))))
krzywe <- function(d) {                          # progi od najwyższego wyniku w dół
  d <- d[order(d$wynik, decreasing = TRUE), ]
  tp <- cumsum(d$y); fp <- cumsum(1 - d$y)
  data.frame(prog = d$wynik, czulosc = tp / sum(d$y), fpr = fp / sum(1 - d$y),
             precyzja = tp / (tp + fp), tp, fp, y = d$y)
}
wyniki <- lapply(names(zbiory), function(k) {
  d <- zbiory[[k]]; kr <- krzywe(d)
  i80 <- which(kr$czulosc >= 0.80)[1]            # pierwszy próg z czułością co najmniej 80%
  c(czestosc = mean(d$y),
    AUC_ROC = mean(outer(d$wynik[d$y == 1], d$wynik[d$y == 0], ">")),
    AP = mean(kr$precyzja[kr$y == 1]),           # średnia precyzja = pole pod krzywą PR (bez interpolacji)
    prog_80 = kr$prog[i80], swoistosc_80 = 1 - kr$fpr[i80], precyzja_80 = kr$precyzja[i80],
    TP_80 = kr$tp[i80], FP_80 = kr$fp[i80])
})
names(wyniki) <- names(zbiory)
round(do.call(rbind, wyniki), 3)
# Rysunek: ROC (A) i PR (B) dla obu częstości; punkt = próg z czułością 80%
kr <- do.call(rbind, lapply(names(zbiory), function(k) cbind(krzywe(zbiory[[k]]), czestosc = k)))
kr$czestosc <- factor(kr$czestosc, levels = names(kol))
kr <- kr[kr$y == 1 | !duplicated(kr$czestosc, fromLast = TRUE), ]  # do rysunku: wierzchołki schodków i koniec
kr <- kr[!duplicated(data.frame(kr$czestosc, round(kr$czulosc / 0.005), round(kr$fpr / 0.005))), ]
pkt <- do.call(rbind, lapply(names(wyniki), function(k)
  data.frame(czestosc = factor(k, levels = names(kol)), fpr = 1 - wyniki[[k]][["swoistosc_80"]],
             czulosc = 0.80, precyzja = wyniki[[k]][["precyzja_80"]])))
baza <- data.frame(czestosc = factor(names(kol), levels = names(kol)), y = c(0.50, 0.05),
                   etykieta = c("linia bazowa 0.50", "linia bazowa 0.05"))
skale <- list(scale_colour_manual(values = kol, name = "Częstość wyniku"),
              scale_linetype_manual(values = lin, name = "Częstość wyniku"),
              scale_shape_manual(values = c("50%" = 16, "5%" = 17), name = "Częstość wyniku"))
pA <- ggplot(kr, aes(fpr, czulosc, colour = czestosc, linetype = czestosc)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60") +
  geom_line(linewidth = 0.9) +
  geom_point(data = pkt, aes(shape = czestosc), size = 3, show.legend = FALSE) +
  skale + coord_equal() +
  labs(title = "A. Krzywa ROC", x = "1 − swoistość", y = "Czułość")
pB <- ggplot(kr, aes(czulosc, precyzja, colour = czestosc, linetype = czestosc)) +
  geom_hline(data = baza, aes(yintercept = y, colour = czestosc), linetype = "dotted", show.legend = FALSE) +
  geom_text(data = baza, aes(x = 0.02, y = y + 0.035, label = etykieta, colour = czestosc),
            hjust = 0, size = 3.3, inherit.aes = FALSE, show.legend = FALSE) +
  geom_line(linewidth = 0.9) +
  geom_point(data = pkt, aes(shape = czestosc), size = 3, show.legend = FALSE) +
  skale + coord_equal(ylim = c(0, 1)) +
  labs(title = "B. Krzywa precyzja–czułość", x = "Czułość", y = "Precyzja (PPV)")
p1 <- (pA + pB + plot_layout(guides = "collect")) & motyw
p1
Wynik w R
    czestosc AUC_ROC    AP prog_80 swoistosc_80 precyzja_80 TP_80 FP_80
50%     0.50   0.842 0.841   0.633        0.708       0.733  1520   555
5%      0.05   0.820 0.337   0.482        0.662       0.111    80   643
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy wybrać krzywą precyzja–czułość zamiast krzywej ROC?
Gdy wynik dodatni jest rzadki i ważne jest, ilu fałszywych alarmów wymaga wykrycie przypadków, np. w badaniach przesiewowych. Krzywa ROC zostaje przydatna do opisu rozdzielenia grup; przy rzadkim wyniku warto pokazać obie.
Jaka jest linia bazowa krzywej precyzja–czułość?
To pozioma linia na wysokości częstości wyniku dodatniego w próbie. Wskaźnik losowy ma precyzję równą tej częstości przy każdej czułości. Przy częstości 5% linia bazowa wynosi 0.05, a nie 0.5.
Co to jest średnia precyzja (AP)?
To średnia precyzji obliczonej w miejscach, w których kolejny przypadek trafia do wyników dodatnich. Jest popularnym sposobem liczenia pola pod krzywą PR. Interpretuj ją względem częstości wyniku, a nie względem 0.5.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Krzywa ROC w obrazkach
Dwa rozkłady i próg, punkty na krzywej, AUC jako odsetek wygranych par, d a kształt krzywej, Youden i koszty, CI dla AUC – sześć rysunków z R.
Czytaj →PoradnikWykrywanie nadużyć przy rzadkich zdarzeniach
Ubezpieczyciel, 60 000 szkód i 200 kontroli miesięcznie: krzywe ROC i PR, macierz kosztów, wybór według zysku, SMOTE a kalibracja i etykiety z kontroli – pięć rysunków z kodem R.
Czytaj →PoradnikWykrywanie nietypowych transakcji
Karty podarunkowe, 10 sprawdzeń dziennie: Mahalanobis klasyczny i odporny, LOF, las losowy, maskowanie i nowy wzorzec nadużyć – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Davis, J., & Goadrich, M. (2006). The relationship between precision-recall and ROC curves. In Proceedings of the 23rd International Conference on Machine Learning (ICML '06) (pp. 233–240). ACM. https://doi.org/10.1145/1143844.1143874 ● Otwarty dostęp: pełny tekst
- Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLOS ONE, 10(3), Article e0118432. https://doi.org/10.1371/journal.pone.0118432 ● Otwarty dostęp
Cytowania BibTeX
@inproceedings{davis2006relationship, author={Davis, Jesse and Goadrich, Mark}, title={{The relationship between precision-recall and ROC curves}}, booktitle={Proceedings of the 23rd International Conference on Machine Learning (ICML '06)}, year={2006}, pages={233--240}, publisher={ACM}, doi={10.1145/1143844.1143874}}@article{saito2015precision, author={Saito, Takaya and Rehmsmeier, Marc}, title={{The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets}}, journal={PLOS ONE}, year={2015}, volume={10}, number={3}, eid={e0118432}, doi={10.1371/journal.pone.0118432}}