Co to jest wykres lift i wykres gain?
Wykres gain (ang. cumulative gains chart, wykres skumulowanych zysków) i wykres lift pokazują, jak dobrze model porządkuje osoby według ryzyka. Osoby sortuje się od najwyższego przewidywanego prawdopodobieństwa, np. z regresji logistycznej, i dzieli na decyle. Wykres gain mówi, jaki odsetek wszystkich zdarzeń trafia do górnych k% osób. Lift to iloraz: odsetek zdarzeń w danej grupie podzielony przez odsetek zdarzeń ogółem. Lift = 2 oznacza, że w tej grupie zdarzenie występuje dwa razy częściej niż przy wyborze losowym. Vuk i Curk (2006) opisują wykres lift razem z krzywą ROC i wykresem kalibracji jako trzy powiązane sposoby oceny klasyfikatora.
Jak czytać wykresy
- Gain: przekątna to wybór losowy (10% osób – 10% zdarzeń), łamana u góry – model idealny, który najpierw wskazuje wszystkie osoby ze zdarzeniem. Im wyżej nad przekątną krzywa modelu, tym lepiej.
- Lift w decylach powinien maleć od pierwszego decyla do ostatniego; linia 1 to poziom losowy. Lift skumulowany to wysokość krzywej gain podzielona przez odsetek objętych osób.
- Maksymalny lift to 1 / odsetek zdarzeń – przy rzadkim wyniku liczby są duże, przy częstym małe. Lifty z prób o różnej częstości nie są porównywalne.
- Związek z ROC: krzywa gain ma na osi poziomej odsetek wszystkich wskazanych osób, a krzywa ROC – odsetek fałszywie dodatnich. Lift w grupie to jej precyzja (wartość predykcyjna dodatnia) podzielona przez częstość, więc jest bliżej krzywej precyzja–czułość, która przy rzadkich zdarzeniach mówi więcej niż ROC (Saito i Rehmsmeier, 2015).
Przykład
W symulowanym badaniu podłużnym 2000 osób model logistyczny przewidywał, kto nie wróci na drugi pomiar (wiek, liczba pominiętych pytań, zaangażowanie w pierwszej fali). Model oszacowano na 1000 osób, a wykresy liczono na pozostałych 1000. Współczynniki ustawiono ręcznie tak, by rezygnowało ok. 20% osób (wyraz wolny zmieniono raz, po pierwszym uruchomieniu dającym 35%); ziarna (787) nie zmieniano.
W próbie testowej zrezygnowało 22.6% osób, więc maksymalny możliwy lift wynosi 4.42. W pierwszym decylu ryzyka zrezygnowało 47 ze 100 osób – lift 2.08. Górne 30% osób objęło 54.4% wszystkich rezygnacji (lift skumulowany 1.81), górna połowa – 76.5%. AUC wyniosło .727.
Na rysunku
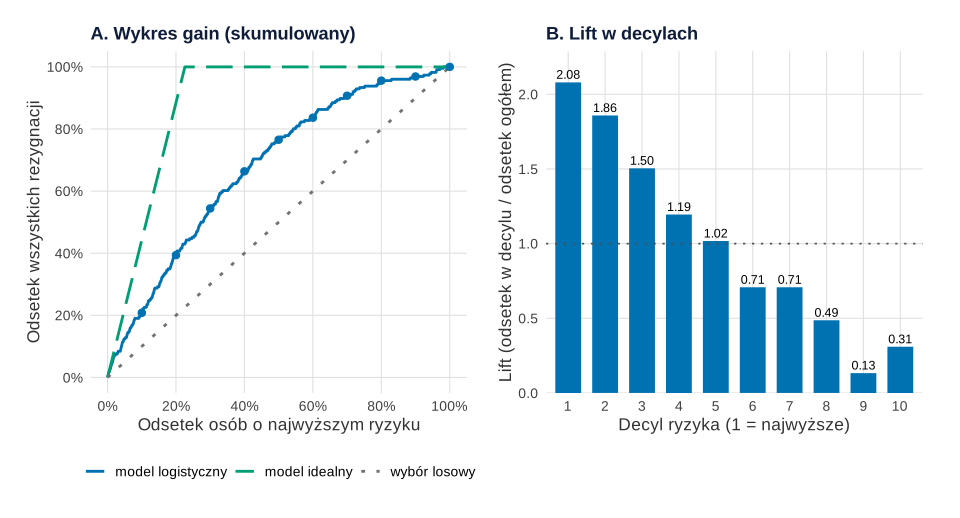
set.seed(787)).Co widać. Krzywa modelu leży wyraźnie nad przekątną, ale daleko pod modelem idealnym: przypominając o drugim pomiarze tylko 30% osób z najwyższym ryzykiem, dotrzesz do ponad połowy przyszłych rezygnacji. Lift spada z 2.08 w pierwszym decylu poniżej 1 od szóstego decyla. Nierówne słupki 9 i 10 to zmienność przy 100 osobach w decylu.
Na co uważać. Oba wykresy oceniają tylko kolejność osób (dyskryminację). Nie mówią, czy przewidywane prawdopodobieństwa są trafne – to sprawdza kalibracja modelu. Policzone na próbie, na której model oszacowano, są zbyt optymistyczne. Brakuje też progu decyzyjnego: którą część osób objąć działaniem, zależy od kosztów, nie od wykresu.
Podpis do pracy:
Jak opisać w pracy
Podaj częstość zdarzenia, próbę, na której liczono wykres, i jedną–dwie liczby praktyczne (lift w górnym decylu, gain dla progu, który rozważasz). Dodaj AUC i informację o kalibracji.
Na co uważać
- Mylenie liftu z ilorazem szans. Lift to iloraz odsetków w wybranej grupie i w całej próbie, zależny od częstości zdarzenia; nie jest parametrem modelu.
- Porównywanie liftów między próbami o różnej częstości zdarzenia. Do porównań dyskryminacji lepsze jest AUC: pole między krzywą gain a przekątną, odniesione do tego pola dla modelu idealnego, równa się 2 × AUC − 1 – w przykładzie .453 w obu rachunkach (Hanley i McNeil, 1982, wyjaśniają AUC jako prawdopodobieństwo poprawnego uporządkowania pary).
- Decyle przy remisach. Gdy model daje niewiele różnych wartości ryzyka, podział na decyle jest arbitralny; użyj krzywej dla każdej osoby albo grup o równych wartościach.
- Pojedynczy próg i liczby z niego opisz macierzą pomyłek; związek progu z czułością i swoistością pokazuje wpis krzywa ROC w obrazkach.
Wykres lift i gain w R
Kod sortuje osoby z próby testowej według przewidywanego ryzyka, dzieli je na decyle i liczy odsetek zdarzeń, lift, gain skumulowany i lift skumulowany – bez dodatkowych pakietów. Na końcu sprawdza związek z ROC: wskaźnik z pola pod krzywą gain równa się 2 × AUC − 1. Rysunek na stronie powstał z obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Decyle ryzyka, lift i gain dla regresji logistycznej
R
# Wykres gain (skumulowany zysk) i wykres lift dla modelu logistycznego
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("model logistyczny" = "#0072B2", "model idealny" = "#009E73", "wybór losowy" = "grey45")  # Okabe–Ito + szary
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
# Dane: badanie podłużne, kto nie wróci na drugi pomiar (1 = rezygnacja)
set.seed(787)
n <- 2000
dane <- data.frame(wiek = round(runif(n, 18, 65)), pominiete = rpois(n, 2), zaangazowanie = rnorm(n, 0, 1))
dane$rezygnacja <- rbinom(n, 1, plogis(-2.0 - 0.03 * (dane$wiek - 40) + 0.25 * dane$pominiete - 0.8 * dane$zaangazowanie))
uczaca <- dane[1:1000, ]; testowa <- dane[1001:2000, ]
model <- glm(rezygnacja ~ wiek + pominiete + zaangazowanie, family = binomial, data = uczaca)
testowa$ryzyko <- predict(model, testowa, type = "response")
# Decyle ryzyka w próbie testowej (1 = 10% osób z najwyższym ryzykiem)
testowa <- testowa[order(-testowa$ryzyko), ]
testowa$decyl <- ceiling(10 * seq_len(nrow(testowa)) / nrow(testowa))
odsetek_ogolem <- mean(testowa$rezygnacja)
decyle <- aggregate(rezygnacja ~ decyl, data = testowa, FUN = function(x) c(n = length(x), zdarzenia = sum(x)))
decyle <- data.frame(decyl = decyle$decyl, decyle$rezygnacja)
decyle$odsetek <- decyle$zdarzenia / decyle$n
decyle$lift <- decyle$odsetek / odsetek_ogolem
decyle$gain_skum <- cumsum(decyle$zdarzenia) / sum(decyle$zdarzenia)
decyle$lift_skum <- decyle$gain_skum / (cumsum(decyle$n) / sum(decyle$n))
# Krzywa gain dla każdej osoby: odsetek wszystkich rezygnacji wśród k% osób o najwyższym ryzyku
gain <- data.frame(objete = c(0, seq_len(nrow(testowa)) / nrow(testowa)),
                   model = c(0, cumsum(testowa$rezygnacja) / sum(testowa$rezygnacja)))
gain$idealny <- pmin(gain$objete / odsetek_ogolem, 1)
gain_dlugi <- rbind(data.frame(objete = gain$objete, gain = gain$model, krzywa = "model logistyczny"),
                    data.frame(objete = gain$objete, gain = gain$idealny, krzywa = "model idealny"),
                    data.frame(objete = c(0, 1), gain = c(0, 1), krzywa = "wybór losowy"))
gain_dlugi$krzywa <- factor(gain_dlugi$krzywa, levels = names(kol))
pA <- ggplot(gain_dlugi, aes(objete, gain, colour = krzywa, linetype = krzywa)) +
  geom_line(linewidth = 1) +
  geom_point(data = decyle, aes(decyl / 10, gain_skum), inherit.aes = FALSE, colour = kol[["model logistyczny"]], size = 2.2) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "longdash", "dotted"), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x * 100, "%"), breaks = seq(0, 1, 0.2)) +
  scale_y_continuous(labels = function(x) paste0(x * 100, "%"), breaks = seq(0, 1, 0.2)) +
  labs(title = "A. Wykres gain (skumulowany)", x = "Odsetek osób o najwyższym ryzyku", y = "Odsetek wszystkich rezygnacji")
pB <- ggplot(decyle, aes(factor(decyl), lift)) +
  geom_col(fill = kol[["model logistyczny"]], width = 0.7) +
  geom_hline(yintercept = 1, linetype = "dotted", colour = "grey30") +
  geom_text(aes(label = sprintf("%.2f", lift)), vjust = -0.4, size = 3.3) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.1))) +
  labs(title = "B. Lift w decylach", x = "Decyl ryzyka (1 = najwyższe)", y = "Lift (odsetek w decylu / odsetek ogółem)")
p1 <- (pA + pB) & motyw
# Związek z ROC: pole pod krzywą gain przekłada się na AUC
pozytywne <- testowa$ryzyko[testowa$rezygnacja == 1]; negatywne <- testowa$ryzyko[testowa$rezygnacja == 0]
auc <- mean(outer(pozytywne, negatywne, ">") + 0.5 * outer(pozytywne, negatywne, "=="))
pole <- function(x, y) sum(diff(x) * (head(y, -1) + tail(y, -1)) / 2)
wskaznik_trafnosci <- (pole(gain$objete, gain$model) - 0.5) / (pole(gain$objete, gain$idealny) - 0.5)
round(c(odsetek_ogolem = odsetek_ogolem, max_lift = 1 / odsetek_ogolem, AUC = auc,
        wskaznik_trafnosci = wskaznik_trafnosci, `2*AUC-1` = 2 * auc - 1), 3)
print(transform(decyle, odsetek = round(odsetek, 3), lift = round(lift, 2), gain_skum = round(gain_skum, 3),
                lift_skum = round(lift_skum, 2)), row.names = FALSE)
p1
Wynik w R
    odsetek_ogolem           max_lift                AUC wskaznik_trafnosci
             0.226              4.425              0.727              0.453
           2*AUC-1
             0.453
 decyl   n zdarzenia odsetek lift gain_skum lift_skum
     1 100        47    0.47 2.08     0.208      2.08
     2 100        42    0.42 1.86     0.394      1.97
     3 100        34    0.34 1.50     0.544      1.81
     4 100        27    0.27 1.19     0.664      1.66
     5 100        23    0.23 1.02     0.765      1.53
     6 100        16    0.16 0.71     0.836      1.39
     7 100        16    0.16 0.71     0.907      1.30
     8 100        11    0.11 0.49     0.956      1.19
     9 100         3    0.03 0.13     0.969      1.08
    10 100         7    0.07 0.31     1.000      1.00
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe glm(), predict(), aggregate(); rysunek – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Co to jest lift w modelu predykcyjnym?
To iloraz odsetka zdarzeń w grupie wskazanej przez model (np. 10% osób o najwyższym ryzyku) i odsetka zdarzeń w całej próbie. Lift = 2 oznacza, że w tej grupie zdarzenie występuje dwa razy częściej niż przy wyborze losowym.
Jak czytać wykres gain?
Na osi poziomej jest odsetek osób o najwyższym przewidywanym ryzyku, na pionowej – odsetek wszystkich zdarzeń, które się wśród nich znalazły. Przekątna to wybór losowy; im wyżej nad nią leży krzywa modelu, tym lepiej model porządkuje osoby.
Czy wykres lift zastępuje krzywą ROC?
Nie, uzupełnia ją. Oba oceniają dyskryminację, ale lift zależy od częstości zdarzenia i odpowiada na pytanie praktyczne: ile zyskam, obejmując działaniem tylko część osób. Do porównań modeli między próbami lepsze jest AUC, a trafność prawdopodobieństw sprawdza kalibracja.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza koszykowa i rekomendacje
Wsparcie, ufność i lift na przykładzie sklepu z kawą, sieć reguł, test na nowych paragonach i rekomendacje „klienci kupili też” z kodem R.
Czytaj →PoradnikKrzywa ROC w obrazkach
Dwa rozkłady i próg, punkty na krzywej, AUC jako odsetek wygranych par, d a kształt krzywej, Youden i koszty, CI dla AUC – sześć rysunków z R.
Czytaj →PoradnikModele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikSegmentacja RFM: kwintyle czy model
125 komórek RFM, wynik sumaryczny i regresja ujemna dwumianowa ocenione na kolejnym półroczu – gain, lift, kalibracja i kod R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLOS ONE, 10(3), Article e0118432. https://doi.org/10.1371/journal.pone.0118432 ● Otwarty dostęp
- Vuk, M., & Curk, T. (2006). ROC curve, lift chart and calibration plot. Advances in Methodology and Statistics, 3(1). https://doi.org/10.51936/noqf3710 ● Otwarty dostęp
Cytowania BibTeX
@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@article{saito2015precision, author={Saito, Takaya and Rehmsmeier, Marc}, title={{The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets}}, journal={PLOS ONE}, year={2015}, volume={10}, number={3}, eid={e0118432}, doi={10.1371/journal.pone.0118432}}@article{vuk2006roc, author={Vuk, Miha and Curk, Tomaž}, title={{ROC curve, lift chart and calibration plot}}, journal={Advances in Methodology and Statistics}, year={2006}, volume={3}, number={1}, doi={10.51936/noqf3710}}