Przykład: eksporter maszyn rolniczych i 3 mln euro należności
Fikcyjny producent pras do słomy i siewników sprzedaje maszyny dealerom w strefie euro, a koszty ponosi w złotych. Za 10 dni roboczych spłyną mu należności: 3 mln EUR. Dziś (ostatni dzień danych) kurs wynosi 4.0313 zł, a należności są warte 12.094 mln zł. Zarząd pyta: ile możemy stracić w ciągu tych 10 dni i jak bardzo możemy się pomylić?
Odpowiadają na to dwie miary. Value at Risk (VaR) na poziomie 99% to strata, której w 99 na 100 podobnych okresów nie przekroczymy – czyli 99. percentyl rozkładu strat. Expected shortfall (ES) na tym samym poziomie to średnia strata w tym 1% najgorszych okresów, czyli wartość oczekiwana straty pod warunkiem, że przekroczyła VaR:
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Kurs nie odpowiada żadnym prawdziwym notowaniom: 1500 dni roboczych wylosowaliśmy z modelu GARCH(1, 1) z rozkładem t o 5 stopniach swobody. Parametry ustawiliśmy ręcznie: dzienna zmienność długookresowa 0.40% (ω = 0.0048, α = 0.07, β = 0.90), a od dnia 1251 zmienność długookresowa rośnie 1.6 raza (zmiana reżimu). Ziaren nie zmienialiśmy; zmiany po pierwszym uruchomieniu opisujemy przy kodzie. Wpis pokazuje, jak policzyć i opisać ryzyko, a nie, czy firma ma się zabezpieczać. Dzienny kurs pobierzesz jako var-es-kurs-eur-pln-symulowany.csv.
Rysunek 1: kurs raz spokojny, raz nerwowy
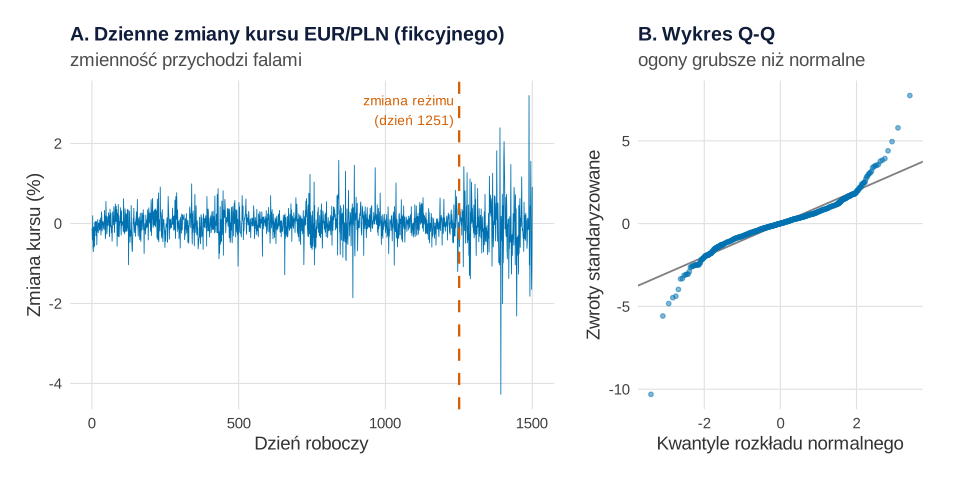
set.seed(713)).Co widać. Odchylenie standardowe dziennych zmian wynosi 0.414%, ale w dniach 1–1250 tylko 0.315%, a po zmianie reżimu 0.729%. Duże wahania przychodzą seriami: kwadraty zmian są autoskorelowane (test Ljunga–Boxa, 10 opóźnień: Q = 219.6, p < .001). Kurtoza nadwyżkowa wynosi 13.23 (w rozkładzie normalnym 0), a dni ze zmianą większą niż 3 odchylenia standardowe było 27 zamiast oczekiwanych 4. Na wykresie Q-Q to końce odchodzące od prostej.
Jak może zmylić. Grube ogony i grupowanie zmienności to tzw. stylizowane fakty o zwrotach finansowych, które podważają wiele typowych metod statystycznych (Cont, 2001). Część kurtozy bierze się tu ze zmiany reżimu: zmieszanie spokojnego i nerwowego okresu samo ją podnosi.
Podpis do pracy:
Rysunek 2: trzy metody, trzy odpowiedzi
Każda metoda bierze te same ostatnie 500 dni i zamienia zmianę kursu na stratę w złotych (przybliżenie liniowe: strata = −12.094 mln zł × zmiana kursu).
- Historyczna – VaR to 99. percentyl 500 zaobserwowanych strat, ES to średnia strat od tego miejsca w górę. Każdy z 500 dni waży tyle samo.
- Parametryczna (normalna) – średnia i odchylenie standardowe z 500 dni oraz kwantyl rozkładu normalnego.
- GARCH-t – model GARCH(1, 1) (Bollerslev, 1986) z rozkładem t, dopasowany pakietem rugarch. Daje zmienność na jutro, która zależy od ostatnich dni.
Na jeden dzień VaR 99% wynosi 168 tys. zł (historyczna), 159 tys. zł (normalna) i 345 tys. zł (GARCH-t); ES 99% – odpowiednio 292, 181 i 486 tys. zł. Skąd różnica? Model szacuje zmienność na jutro na 1.068% dziennie, a SD z 500 dni to 0.552%: ostatnie tygodnie były nerwowe, a metody bez modelu zmienności rozmywają je na dwa lata.
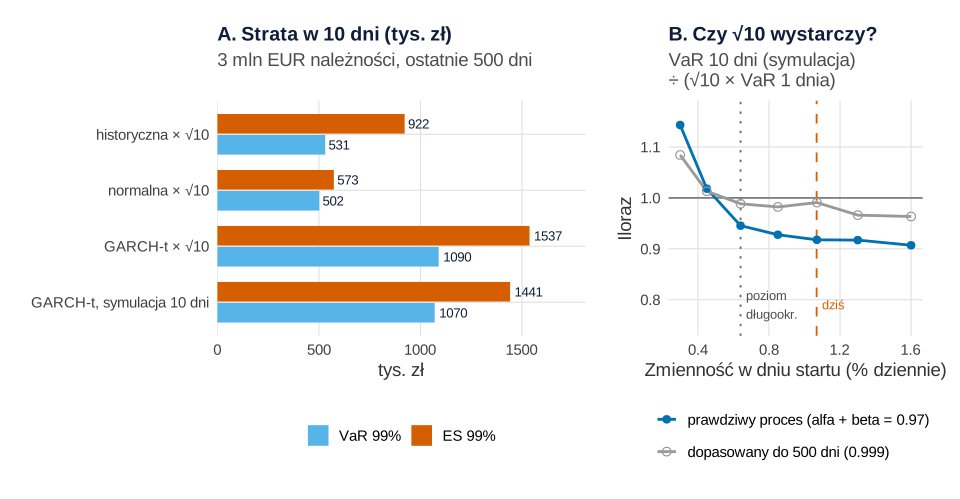
set.seed(7131) i set.seed(7132)).Co widać. Najprostszy sposób na 10 dni to pomnożyć VaR jednego dnia przez √10 ≈ 3.16. Dla GARCH-t daje to 1090 tys. zł, a symulacja 20 000 ścieżek 10-dniowych z tego samego modelu – 1070 tys. zł (błąd Monte Carlo ok. 19 tys. zł). Metody historyczna i normalna podają mniej więcej połowę: 531 i 502 tys. zł. ES różnicuje metody mocniej: historyczna ma ES 922 tys. zł, bo w jej 500 dniach są pojedyncze bardzo złe dni, normalna – 573 tys. zł.
Jak może zmylić. Reguła √10 zakłada, że dni są niezależne i jednakowo zmienne. Panel B pokazuje, kiedy to nie działa. W prawdziwym procesie (α + β = 0.97) zmienność wraca do poziomu długookresowego 0.64%: gdy startujemy ze spokoju (0.30%), symulacja daje VaR o 14% wyższy niż reguła √10 (iloraz 1.14), a gdy z nerwowego dnia (1.60%) – o 9% niższy (0.91). Model dopasowany do 500 dni ma trwałość 0.999, bo zmiana reżimu w oknie wygląda dla niego jak bardzo długa fala – i dlatego „nie widzi” powrotu do normy.
Podpis do pracy:
Rysunek 3: VaR i ES na jednym rozkładzie
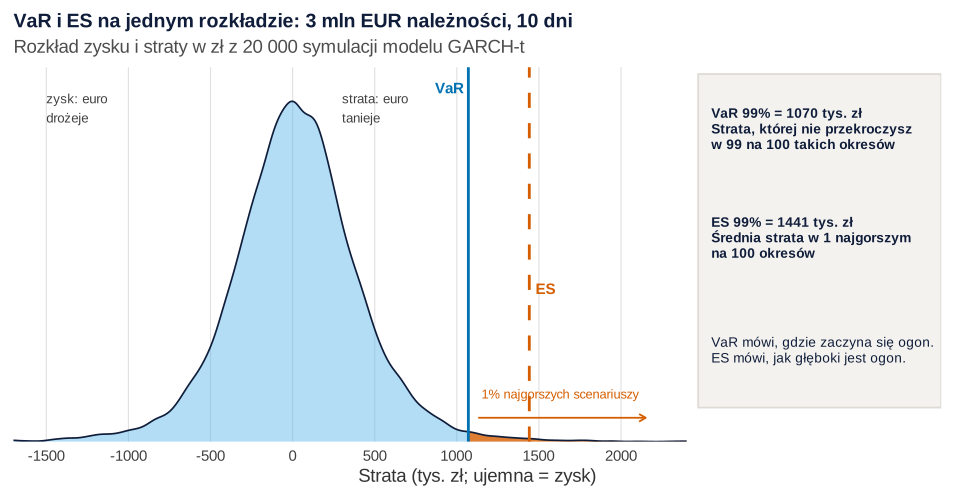
set.seed(7131)).Co widać. W 52.3% scenariuszy euro tanieje i firma traci, w pozostałych zyskuje. VaR 99% to jedna kreska: 1070 tys. zł. Za nią leży 1% najgorszych scenariuszy, ze stratami od 1070 do 3845 tys. zł, a ich średnia to ES 99% = 1441 tys. zł, czyli 1.35 raza więcej niż VaR.
Jak może zmylić. VaR nic nie mówi o tym, co dzieje się za kreską: dwa rozkłady z tym samym VaR mogą mieć bardzo różne ogony. Artzner i in. (1999) zaproponowali cztery własności „koherentnej” miary ryzyka i pokazali, że miary oparte na kwantylach nie spełniają subaddytywności (ryzyko dwóch pozycji razem może wyjść większe niż suma osobno). Acerbi i Tasche (2002) wskazują ES jako odpowiedź na te wady VaR. Ceną jest to, że ES zależy od kilku najgorszych obserwacji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: test wsteczny – czy VaR trafiał w przeszłości
VaR to prognoza, więc trzeba ją sprawdzić. Bierzemy ostatnie 1000 dni. Na każdy dzień liczymy jednodniowy VaR 99% z 500 poprzednich dni (GARCH-t dopasowujemy na nowo co 25 dni) i zapisujemy, czy strata go przekroczyła. Przy dobrym modelu liczba przekroczeń ma rozkład dwumianowy z prawdopodobieństwem 0.01 – średnio 10 na 1000 dni.
Test Kupca (pokrycie bezwarunkowe) porównuje odsetek przekroczeń x/T z deklarowanym p testem ilorazu wiarygodności; statystyka ma w przybliżeniu rozkład χ² z 1 stopniem swobody:
Test Christoffersena dodaje niezależność: traktuje ciąg „przekroczenie / brak” jak łańcuch Markowa i sprawdza, czy po przekroczeniu następne jest bardziej prawdopodobne. Christoffersen (1998) zwrócił uwagę, że samo poprawne pokrycie nie wystarcza, gdy zmienność zmienia się w czasie – a to jest właśnie przypadek kursu walut.
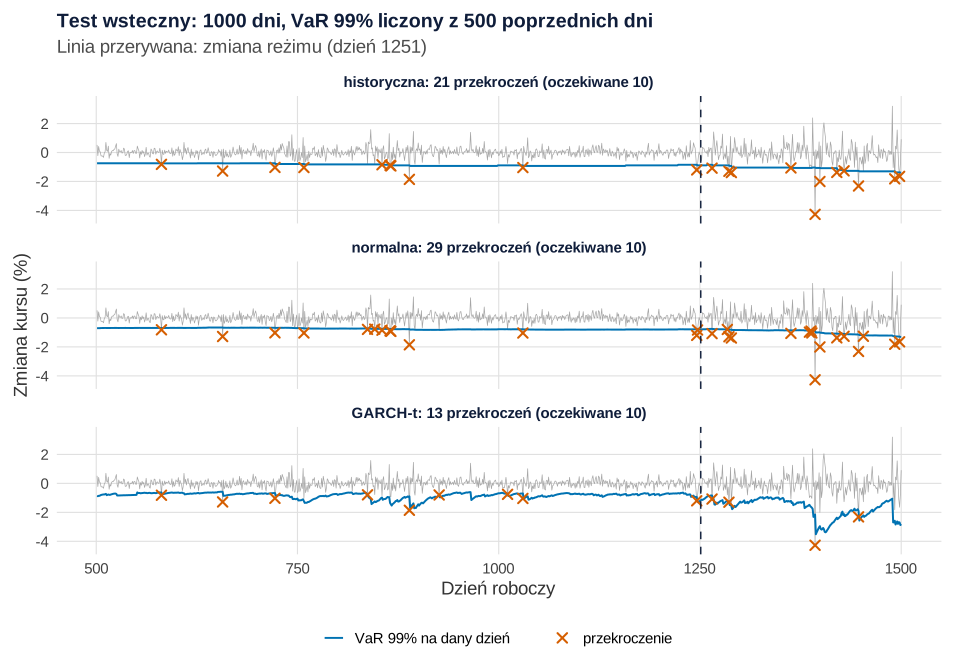
set.seed(7133)).Co widać. Metoda historyczna miała 21 przekroczeń (test Kupca: LRuc = 9.28, p = .002), normalna – 29 (LRuc = 24.12, p < .001), GARCH-t – 13 (LRuc = 0.83, p = .362). Linie historyczna i normalna są prawie płaskie, więc po zmianie reżimu przekroczenia się zagęszczają: 11 i 16 w ostatnich 250 dniach. Linia GARCH-t opada razem z falą zmienności i w tych 250 dniach przepuściła 4 przekroczenia.
Jak może zmylić. Test Christoffersena nie odrzucił niezależności dla żadnej metody (historyczna: p = .459; normalna: p = .056; GARCH-t: p = .558). Patrzy tylko na dzień po dniu, a przekroczenia po zmianie reżimu przychodziły co kilka dni, nie dzień po dniu. Wykres w czasie pokazuje skupienie lepiej. Ręczne obliczenia zgadzają się z funkcją VaRTest() z pakietu rugarch.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: grube ogony i krótka historia
Dwa osobne eksperymenty. W panelu A losujemy 2000 historii po 500 dni z rozkładu t o 4 stopniach swobody (SD 0.4% dziennie, bez fal zmienności) i z każdej liczymy VaR normalny i historyczny. Prawdziwy rozkład znamy, więc wiemy, jak często strata naprawdę przekroczy każdy VaR. W panelu B sprawdzamy moc testu Kupca: jak często odrzuci model, który naprawdę przepuszcza 1.5%, 2% albo 3% dni zamiast 1% (10 000 symulacji na punkt).
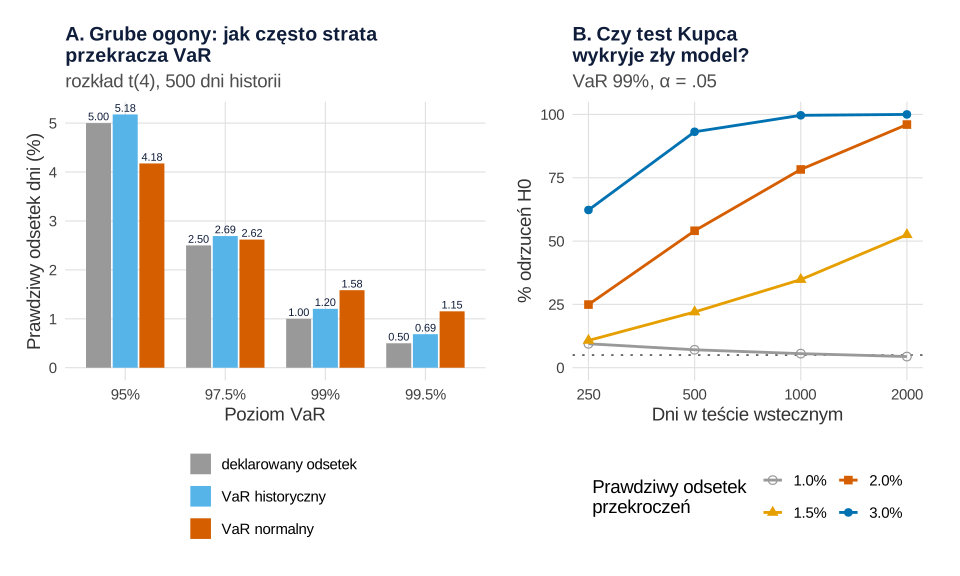
set.seed(7134) i set.seed(7135)).Co widać. Przy 95% VaR normalny wygląda nawet ostrożnie (4.18% przekroczeń zamiast 5%). Im dalej w ogon, tym gorzej: przy 99% strata przekracza go w 1.58% dni, a przy 99.5% – w 1.15%, ponad dwa razy częściej, niż obiecuje. Rozkład normalny ma za cienkie ogony, a wzór na ES pomyliłby się jeszcze bardziej: przy tym samym odchyleniu standardowym normalny ES 99% wynosi 1.066%, a prawdziwy 1.477%, czyli jest zaniżony o 27.8%. VaR historyczny nie zakłada rozkładu, ale z 500 dni też jest za niski (1.20% przekroczeń przy 99%). Panel B: przy roku danych (250 dni) test Kupca wykrywa model z 2% przekroczeń tylko w 24.9% przypadków, a z 1.5% – w 10.8%.
Jak może zmylić. „Test Kupca nie odrzucił modelu” przy krótkiej historii niewiele znaczy. Kupiec (1995) pokazał, że im mniejsze prawdopodobieństwo w ogonie, tym trudniej statystycznie potwierdzić trafność VaR. Przy 250 dniach i poprawnym modelu test odrzuca go też częściej niż w 5% (9.4%), bo liczba przekroczeń jest mała i dyskretna.
Podpis do pracy:
Co z tym zrobić w firmie
- Podawaj VaR i ES razem, z horyzontem i poziomem. „VaR 99% na 10 dni: 1.07 mln zł; ES 99%: 1.44 mln zł” mówi więcej niż sama pierwsza liczba.
- Licz kilkoma metodami. Gdy GARCH-t daje dwa razy więcej niż metoda historyczna, ostatnie dni są nerwowsze niż średnia z dwóch lat.
- Nie mnóż przez √10 bez zastanowienia. Po spokojnym okresie reguła zaniża ryzyko, po nerwowym – zawyża (rysunek 2B).
- Rób test wsteczny i oglądaj go na wykresie. Sama liczba przekroczeń nie pokaże, że wszystkie przyszły po zmianie reżimu.
- Licz skutki decyzji, nie tylko ryzyko. Przykład rachunku (nie rekomendacja): jeśli firma ustali dziś kurs dla połowy należności, ryzyko kursowe dotyczy tylko otwartych 1.5 mln EUR, więc VaR 99% spada do 535 tys. zł, a ES 99% do 721 tys. zł; przy 75% – do 268 i 360 tys. zł. Czy to się opłaca, zależy od kosztu zabezpieczenia i od tego, ile straty firma może przyjąć – tego model nie rozstrzyga.
Kiedy klienci naprawdę płacą, opisuje wpis o opóźnieniach płatności faktur, a symulację niepewnych założeń biznesplanu – wpisy o progu rentowności z niepewnością i symulacji Monte Carlo NPV.
Jak opisać w pracy
Opisz pozycję (kwota, waluta, horyzont), definicję straty, okno danych, poziomy ufności, metody i sposób przejścia z 1 do 10 dni, a w części o trafności – test wsteczny z liczbą przekroczeń i testami. Podaj źródło i okres danych. Więcej o analizach w takich pracach: statystyka w pracy z finansów i rachunkowości.
Jeśli VaR liczysz dla danych o 10-dniowych zmianach, pamiętaj, że okresy nakładające się na siebie są zależne – do przedziałów ufności użyj wtedy bootstrapu blokowego, a nie zwykłego.
Kod R: VaR, ES, GARCH i test wsteczny
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, parametry i dane, przepis 2 – funkcje używane dalej. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 713 w przepisie 1, 7131 i 7132 w przepisie 2, 7133 w przepisie 4 (solver dopasowujący GARCH może losować punkty startowe), 7134 i 7135 w przepisie 5; przepisy 3 i 6 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): należności 3 mln EUR, horyzont 10 dni, okno 500 dni, 1500 dni danych, parametry procesu kursu (ω = 0.0048, α = 0.07, β = 0.90, rozkład t z 5 stopniami swobody, kurs początkowy 4.30) i zmianę reżimu od dnia 1251 (ω × 2.56); w przepisie 2: 20 000 ścieżek symulacji i siatkę zmienności startowej 0.30–1.60%; w przepisie 4: ponowne dopasowanie GARCH co 25 dni; w przepisie 5: rozkład t(4), SD 0.4%, 2000 historii, długości testu 250–2000 dni i prawdziwe odsetki przekroczeń 1–3%. Po pierwszym uruchomieniu nie zmieniano parametrów danych. Zmieniono: w panelu B rysunku 2 pierwotnie liczono iloraz tylko dla modelu dopasowanego, w jednostkach jego zmienności długookresowej; ponieważ model dopasowany ma trwałość 0.999 (a więc zmienność długookresową 1.87%, której w danych nie ma), dodano prawdziwy proces, oś opisano w procentach dziennie i zwiększono liczbę ścieżek z 20 000 do 100 000 na punkt, bo przy 20 000 krzywa była poszarpana przez błąd Monte Carlo. Z wydruku przepisu 1 usunięto test Ljunga–Boxa dla samych zwrotów (przy zmiennej wariancji odrzucał niezależność, co w tym wpisie myliłoby czytelnika); w panelu B rysunku 1 przerzedzono środek wykresu Q-Q, na rysunku 4 punkty zastąpiono linią (mniejsze pliki), przesunięto też etykiety na rysunkach 2 i 3. Wszystkie przepisy liczą się w kilka sekund.
1. Dane: kurs, zwroty i Rysunek 1
R
# Rysunek 1. Fikcyjny eksporter maszyn rolniczych: 1500 dni symulowanego kursu EUR/PLN
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie (wspólne dla przepisów 2–5)
ekspozycja_eur <- 3e6      # należności w euro, płatne za 10 dni roboczych
horyzont <- 10             # dni roboczych do wpływu należności
okno <- 500                # dni historii używane do oszacowania VaR (ok. 2 lata)
N <- 1500                  # dni roboczych symulowanego kursu
# Proces kursu (fikcyjny): GARCH(1, 1) z rozkładem t o 5 stopniach swobody; zwroty w %.
omega <- 0.0048; alfa <- 0.07; beta <- 0.90; nu <- 5   # zmienność długookresowa 0.40% dziennie
dzien_zmiany <- 1251; mnoznik_omega <- 2.56            # od dnia 1251 zmienność długookresowa × 1.6

set.seed(713)
rozgrzewka <- 500
n_all <- N + rozgrzewka
z <- rt(n_all, df = nu) / sqrt(nu / (nu - 2))          # standaryzowany rozkład t (wariancja 1)
om <- ifelse(seq_len(n_all) - rozgrzewka >= dzien_zmiany, omega * mnoznik_omega, omega)
s2 <- numeric(n_all); r <- numeric(n_all)
s2[1] <- omega / (1 - alfa - beta)
for (t in seq_len(n_all)) {
  if (t > 1) s2[t] <- om[t] + alfa * r[t - 1]^2 + beta * s2[t - 1]
  r[t] <- sqrt(s2[t]) * z[t]
}
kurs_dane <- data.frame(dzien = 1:N, zwrot_proc = r[-(1:rozgrzewka)],
                        sigma_prawdziwa = sqrt(s2[-(1:rozgrzewka)]))
kurs_dane$kurs <- 4.30 * exp(cumsum(kurs_dane$zwrot_proc / 100))
write.csv(data.frame(dzien = kurs_dane$dzien, kurs = round(kurs_dane$kurs, 4),
                     zwrot_proc = round(kurs_dane$zwrot_proc, 4)),
          "var-es-kurs-eur-pln-symulowany.csv", row.names = FALSE)

x <- kurs_dane$zwrot_proc
kurtoza_nadwyzkowa <- function(v) mean((v - mean(v))^4) / mean((v - mean(v))^2)^2 - 3
cat("Kurs: pierwszy dzień", round(kurs_dane$kurs[1], 4), "| ostatni dzień", round(kurs_dane$kurs[N], 4), "\n")
cat("Dzienne zwroty (%): średnia", round(mean(x), 3), "| SD", round(sd(x), 3),
    "| min", round(min(x), 2), "| max", round(max(x), 2), "\n")
cat("SD przed zmianą reżimu (dni 1–1250):", round(sd(x[1:1250]), 3),
    "| po zmianie (dni 1251–1500):", round(sd(x[1251:N]), 3), "\n")
cat("Kurtoza nadwyżkowa:", round(kurtoza_nadwyzkowa(x), 2), "(rozkład normalny: 0)\n")
cat("Dni z |zwrotem| > 3 SD:", sum(abs(x - mean(x)) > 3 * sd(x)),
    "| oczekiwane przy rozkładzie normalnym:", round(N * 2 * pnorm(-3), 1), "\n")
lb2 <- Box.test(x^2, lag = 10, type = "Ljung-Box")
cat("Ljung–Box (10 opóźnień) dla kwadratów zwrotów: Q =", round(lb2$statistic, 1),
    ifelse(lb2$p.value < .001, "p < .001", paste("p =", round(lb2$p.value, 3))), "\n")
cat("Autokorelacja przy opóźnieniu 1: zwroty", round(acf(x, plot = FALSE)$acf[2], 3),
    "| kwadraty", round(acf(x^2, plot = FALSE)$acf[2], 3), "\n")

pA <- ggplot(kurs_dane, aes(dzien, zwrot_proc)) +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.3) +
  geom_vline(xintercept = dzien_zmiany, linetype = "dashed", colour = kol[["pomaranczowy"]], linewidth = 0.8) +
  annotate("text", x = dzien_zmiany - 20, y = max(x), hjust = 1, vjust = 1, size = 3.6, colour = kol[["pomaranczowy"]],
           label = "zmiana reżimu\n(dzień 1251)") +
  labs(title = "A. Dzienne zmiany kursu EUR/PLN (fikcyjnego)", subtitle = "zmienność przychodzi falami",
       x = "Dzień roboczy", y = "Zmiana kursu (%)") + motyw
qq <- data.frame(teoretyczne = qnorm(ppoints(N)), probka = sort((x - mean(x)) / sd(x)))
qq <- qq[abs(qq$teoretyczne) > 1.5 | seq_len(N) %% 5 == 0, ]   # środek przerzedzony co 5. punkt (mniejszy plik)
pB <- ggplot(qq, aes(teoretyczne, probka)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey50") +
  geom_point(colour = kol[["niebieski"]], alpha = 0.5, size = 1.2) +
  labs(title = "B. Wykres Q-Q", subtitle = "ogony grubsze niż normalne",
       x = "Kwantyle rozkładu normalnego", y = "Zwroty standaryzowane") + motyw
p1 <- pA + pB + plot_layout(widths = c(1.7, 1))
p1                       # do pliku: ggsave("var-es-kurs-i-zwroty.svg", p1, width = 10, height = 5)
Wynik w R
Kurs: pierwszy dzień 4.2949 | ostatni dzień 4.0313
Dzienne zwroty (%): średnia -0.004 | SD 0.414 | min -4.27 | max 3.2
SD przed zmianą reżimu (dni 1–1250): 0.315 | po zmianie (dni 1251–1500): 0.729
Kurtoza nadwyżkowa: 13.23 (rozkład normalny: 0)
Dni z |zwrotem| > 3 SD: 27 | oczekiwane przy rozkładzie normalnym: 4
Ljung–Box (10 opóźnień) dla kwadratów zwrotów: Q = 219.6 p < .001
Autokorelacja przy opóźnieniu 1: zwroty 0.036 | kwadraty 0.072
2. VaR i ES trzema metodami, skalowanie √10: Rysunek 2
R
# Rysunek 2. VaR i ES trzema metodami oraz skalowanie √10
# (korzysta z kol, motyw, parametrów i kurs_dane z przepisu 1)
library(ggplot2)
library(patchwork)
library(rugarch)

# Strata w zł z należności przy zmianie kursu r (%): przybliżenie liniowe, kurs z ostatniego dnia
kurs_dzis <- kurs_dane$kurs[N]
pozycja_zl <- ekspozycja_eur * kurs_dzis
strata <- function(r_proc) -pozycja_zl * r_proc / 100
hist_r <- tail(kurs_dane$zwrot_proc, okno)              # ostatnie 500 dni
cat("Kurs dziś:", round(kurs_dzis, 4), "| należności:", ekspozycja_eur / 1e6, "mln EUR =",
    round(pozycja_zl / 1e6, 3), "mln zł\n")

var_es <- function(straty, poziom) {                    # VaR = kwantyl strat, ES = średnia strat ≥ VaR
  v <- unname(quantile(straty, poziom, type = 7)); c(VaR = v, ES = mean(straty[straty >= v]))
}
# 1) Metoda historyczna: kwantyl 500 zaobserwowanych dziennych zmian
L_hist <- strata(hist_r)
# 2) Metoda parametryczna (normalna): średnia i SD z 500 dni
mu <- mean(hist_r); sdv <- sd(hist_r)
norm_var_es <- function(poziom, m = mu, s = sdv) {
  zq <- qnorm(poziom); c(VaR = strata(m - s * zq), ES = strata(m - s * dnorm(zq) / (1 - poziom)))
}
# 3) GARCH(1, 1) z rozkładem t (rugarch), dopasowany do tych samych 500 dni
spec <- ugarchspec(variance.model = list(model = "sGARCH", garchOrder = c(1, 1)),
                   mean.model = list(armaOrder = c(0, 0), include.mean = TRUE), distribution.model = "std")
fit <- ugarchfit(spec, hist_r, solver = "hybrid")
wsp <- coef(fit)
prog <- ugarchforecast(fit, n.ahead = 1)
sig1 <- as.numeric(sigma(prog)); mu1 <- as.numeric(fitted(prog))
garch_var_es <- function(poziom) {
  q <- function(u) qdist("std", u, mu = mu1, sigma = sig1, shape = wsp[["shape"]])
  c(VaR = strata(q(1 - poziom)), ES = strata(integrate(q, 0, 1 - poziom)$value / (1 - poziom)))
}
print(round(wsp, 4))
cat("Trwałość alfa + beta:", round(wsp[["alpha1"]] + wsp[["beta1"]], 3),
    "| sigma na jutro:", round(sig1, 3), "% | SD z 500 dni:", round(sdv, 3),
    "% | zmienność długookresowa z modelu:", round(sqrt(wsp[["omega"]] / (1 - wsp[["alpha1"]] - wsp[["beta1"]])), 3), "%\n")

tab1 <- do.call(rbind, lapply(c(0.95, 0.99), function(pz) rbind(
  data.frame(metoda = "historyczna", poziom = pz, t(var_es(L_hist, pz))),
  data.frame(metoda = "normalna", poziom = pz, t(norm_var_es(pz))),
  data.frame(metoda = "GARCH-t", poziom = pz, t(garch_var_es(pz))))))
cat("\nJednodniowe VaR i ES (tys. zł):\n")
print(transform(tab1, VaR = round(VaR / 1e3), ES = round(ES / 1e3)), row.names = FALSE)

# 10 dni: skalowanie √10 kontra symulacja 10 dni z modelu GARCH (20 000 ścieżek)
symuluj_10 <- function(s2_start, R, w = wsp) {
  s2 <- rep(s2_start, R); suma <- numeric(R); eps_pop <- NULL
  for (h in 1:horyzont) {
    if (h > 1) s2 <- w[["omega"]] + w[["alpha1"]] * eps_pop^2 + w[["beta1"]] * s2
    eps_pop <- sqrt(s2) * rt(R, w[["shape"]]) / sqrt(w[["shape"]] / (w[["shape"]] - 2))
    suma <- suma + w[["mu"]] + eps_pop
  }
  suma
}
set.seed(7131)
R10 <- symuluj_10(sig1^2, 20000)
L10_garch <- strata(R10)
tab10 <- rbind(
  data.frame(metoda = "historyczna × √10", t(var_es(L_hist, 0.99) * sqrt(horyzont))),
  data.frame(metoda = "normalna × √10", t(norm_var_es(0.99) * sqrt(horyzont))),
  data.frame(metoda = "GARCH-t × √10", t(garch_var_es(0.99) * sqrt(horyzont))),
  data.frame(metoda = "GARCH-t, symulacja 10 dni", t(var_es(L10_garch, 0.99))))
cat("\nDziesięciodniowe VaR 99% i ES 99% (tys. zł):\n")
print(transform(tab10, VaR = round(VaR / 1e3), ES = round(ES / 1e3)), row.names = FALSE)
cat("Błąd Monte Carlo VaR 99% z symulacji (bootstrap 200 razy, tys. zł):",
    round(sd(replicate(200, quantile(sample(L10_garch, replace = TRUE), 0.99))) / 1e3, 1), "\n")

# Kiedy √10 zawodzi: start z niskiej albo wysokiej zmienności. Dwa modele: prawdziwy proces po zmianie
# reżimu (znany tylko w symulacji, alfa + beta = 0.97) i model dopasowany do 500 dni.
prawdziwy <- c(mu = 0, omega = omega * mnoznik_omega, alpha1 = alfa, beta1 = beta, shape = nu)
sig_dl <- sqrt(prawdziwy[["omega"]] / (1 - alfa - beta))
krat <- c(0.3, 0.45, 0.64, 0.85, 1.07, 1.3, 1.6)       # zmienność dnia startu, % dziennie
set.seed(7132)
skal <- do.call(rbind, lapply(list(prawdziwy = prawdziwy, dopasowany = wsp), function(w)
  do.call(rbind, lapply(krat, function(s_start) {
    v10 <- quantile(strata(symuluj_10(s_start^2, 100000, w)), 0.99)
    v1 <- strata(qdist("std", 0.01, mu = w[["mu"]], sigma = s_start, shape = w[["shape"]]))
    data.frame(sigma_start = s_start, iloraz = unname(v10 / (sqrt(horyzont) * v1)))
  }))))
skal$model <- factor(rep(c("prawdziwy proces (alfa + beta = 0.97)", "dopasowany do 500 dni (0.999)"), each = length(krat)),
                     levels = c("prawdziwy proces (alfa + beta = 0.97)", "dopasowany do 500 dni (0.999)"))
cat("\nZmienność długookresowa prawdziwego procesu po zmianie reżimu:", round(sig_dl, 3),
    "% | sigma na jutro z modelu:", round(sig1, 3), "% | prawdziwa sigma ostatniego dnia:",
    round(kurs_dane$sigma_prawdziwa[N], 3), "%\n")
print(data.frame(model = as.character(skal$model), sigma_start = skal$sigma_start, iloraz = round(skal$iloraz, 3)), row.names = FALSE)

dl <- data.frame(metoda = rep(tab10$metoda, 2), miara = rep(c("VaR 99%", "ES 99%"), each = 4),
                 tys = c(tab10$VaR, tab10$ES) / 1e3)
dl$metoda <- factor(dl$metoda, levels = rev(tab10$metoda))
dl$miara <- factor(dl$miara, levels = c("VaR 99%", "ES 99%"))
pA <- ggplot(dl, aes(tys, metoda, fill = miara)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = round(tys)), position = position_dodge(width = 0.75), hjust = -0.15, size = 3.5,
            colour = "#0f1d3a") +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.18))) +
  labs(title = "A. Strata w 10 dni (tys. zł)", subtitle = "3 mln EUR należności, ostatnie 500 dni",
       x = "tys. zł", y = NULL) + motyw
pB <- ggplot(skal, aes(sigma_start, iloraz, colour = model, shape = model)) +
  geom_hline(yintercept = 1, colour = "grey50") +
  geom_vline(xintercept = sig_dl, linetype = "dotted", colour = "grey40") +
  geom_vline(xintercept = sig1, linetype = "dashed", colour = kol[["pomaranczowy"]]) +
  annotate("text", x = sig1 + 0.03, y = 0.79, hjust = 0, size = 3.4, colour = kol[["pomaranczowy"]], label = "dziś") +
  annotate("text", x = sig_dl + 0.03, y = 0.79, hjust = 0, size = 3.4, colour = "grey30", label = "poziom\ndługookr.") +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c(16, 1), name = NULL) +
  coord_cartesian(ylim = c(0.75, 1.17)) +
  labs(title = "B. Czy √10 wystarczy?", subtitle = "VaR 10 dni (symulacja)\n÷ (√10 × VaR 1 dnia)",
       x = "Zmienność w dniu startu (% dziennie)", y = "Iloraz") + motyw +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1))
p2 <- pA + pB + plot_layout(widths = c(1.45, 1))
p2                       # do pliku: ggsave("var-es-trzy-metody.svg", p2, width = 10, height = 5.2)
Wynik w R
Kurs dziś: 4.0313 | należności: 3 mln EUR = 12.094 mln zł
     mu   omega  alpha1   beta1   shape
-0.0134  0.0035  0.0952  0.9038  3.8156
Trwałość alfa + beta: 0.999 | sigma na jutro: 1.068 % | SD z 500 dni: 0.552 % | zmienność długookresowa z modelu: 1.869 %

Jednodniowe VaR i ES (tys. zł):
      metoda poziom VaR  ES
 historyczna   0.95  97 163
    normalna   0.95 113 141
     GARCH-t   0.95 194 295
 historyczna   0.99 168 292
    normalna   0.99 159 181
     GARCH-t   0.99 345 486

Dziesięciodniowe VaR 99% i ES 99% (tys. zł):
                    metoda  VaR   ES
         historyczna × √10  531  922
            normalna × √10  502  573
             GARCH-t × √10 1090 1537
 GARCH-t, symulacja 10 dni 1070 1441
Błąd Monte Carlo VaR 99% z symulacji (bootstrap 200 razy, tys. zł): 18.9

Zmienność długookresowa prawdziwego procesu po zmianie reżimu: 0.64 % | sigma na jutro z modelu: 1.068 % | prawdziwa sigma ostatniego dnia: 0.968 %
                                 model sigma_start iloraz
 prawdziwy proces (alfa + beta = 0.97)        0.30  1.143
 prawdziwy proces (alfa + beta = 0.97)        0.45  1.018
 prawdziwy proces (alfa + beta = 0.97)        0.64  0.945
 prawdziwy proces (alfa + beta = 0.97)        0.85  0.928
 prawdziwy proces (alfa + beta = 0.97)        1.07  0.918
 prawdziwy proces (alfa + beta = 0.97)        1.30  0.917
 prawdziwy proces (alfa + beta = 0.97)        1.60  0.907
         dopasowany do 500 dni (0.999)        0.30  1.084
         dopasowany do 500 dni (0.999)        0.45  1.013
         dopasowany do 500 dni (0.999)        0.64  0.988
         dopasowany do 500 dni (0.999)        0.85  0.982
         dopasowany do 500 dni (0.999)        1.07  0.991
         dopasowany do 500 dni (0.999)        1.30  0.966
         dopasowany do 500 dni (0.999)        1.60  0.963
3. Karta VaR i ES, rachunek zabezpieczenia: Rysunek 3
R
# Rysunek 3. Karta „VaR vs ES na jednym rozkładzie” i rachunek zabezpieczenia części należności
# (korzysta z kol, motyw z przepisu 1 oraz L10_garch, var_es z przepisu 2 – bez nowego losowania)
library(ggplot2)

ve <- var_es(L10_garch, 0.99)
ve95 <- var_es(L10_garch, 0.95)
cat("10 dni, GARCH-t: VaR 95% =", round(ve95[["VaR"]] / 1e3), "tys. zł | VaR 99% =", round(ve[["VaR"]] / 1e3),
    "tys. zł | ES 99% =", round(ve[["ES"]] / 1e3), "tys. zł | ES/VaR =", round(ve[["ES"]] / ve[["VaR"]], 2), "\n")
cat("Odsetek scenariuszy ze stratą (kurs euro spada):", round(100 * mean(L10_garch > 0), 1), "%\n")
cat("Najgorszy 1% scenariuszy: od", round(ve[["VaR"]] / 1e3), "do", round(max(L10_garch) / 1e3), "tys. zł\n")

# Przykład rachunku (nie rekomendacja): część należności zabezpieczona po kursie znanym dziś.
# Ryzyko kursowe dotyczy tylko części otwartej, więc VaR i ES maleją proporcjonalnie.
zab <- data.frame(zabezpieczone_proc = c(0, 50, 75))
zab$otwarte_mln_eur <- ekspozycja_eur * (1 - zab$zabezpieczone_proc / 100) / 1e6
zab$VaR99_tys_zl <- round(ve[["VaR"]] * (1 - zab$zabezpieczone_proc / 100) / 1e3)
zab$ES99_tys_zl <- round(ve[["ES"]] * (1 - zab$zabezpieczone_proc / 100) / 1e3)
print(zab, row.names = FALSE)

g <- density(L10_garch / 1e3, n = 1024, from = -1800, to = 2400)
gd <- data.frame(x = g$x, y = g$y)
v <- ve[["VaR"]] / 1e3; e <- ve[["ES"]] / 1e3
ymax <- max(gd$y)
karty <- data.frame(
  x = c(2550, 2550, 2550), y = ymax * c(0.92, 0.6, 0.27),
  tekst = c(sprintf("VaR 99%% = %s tys. zł\nStrata, której nie przekroczysz\nw 99 na 100 takich okresów", round(v)),
            sprintf("ES 99%% = %s tys. zł\nŚrednia strata w 1 najgorszym\nna 100 okresów", round(e)),
            "VaR mówi, gdzie zaczyna się ogon.\nES mówi, jak głęboki jest ogon."))
p3 <- ggplot(gd, aes(x, y)) +
  geom_area(data = subset(gd, x <= v), fill = kol[["blekit"]], alpha = 0.45) +
  geom_area(data = subset(gd, x >= v), fill = kol[["pomaranczowy"]], alpha = 0.8) +
  geom_line(colour = "#0f1d3a", linewidth = 0.6) +
  geom_vline(xintercept = v, colour = kol[["niebieski"]], linewidth = 1) +
  geom_vline(xintercept = e, colour = kol[["pomaranczowy"]], linewidth = 1, linetype = "dashed") +
  annotate("text", x = v, y = ymax * 1.04, label = "VaR", hjust = 1.15, colour = kol[["niebieski"]], fontface = "bold", size = 4) +
  annotate("text", x = e, y = ymax * 0.45, label = "ES", colour = kol[["pomaranczowy"]], fontface = "bold",
           size = 4, hjust = -0.3) +
  annotate("segment", x = v + 60, xend = 2150, y = ymax * 0.07, yend = ymax * 0.07,
           arrow = arrow(length = unit(0.2, "cm")), colour = kol[["pomaranczowy"]]) +
  annotate("text", x = v + 80, y = ymax * 0.14, hjust = 0, size = 3.4, colour = kol[["pomaranczowy"]],
           label = "1% najgorszych scenariuszy") +
  annotate("text", x = -1500, y = ymax * 0.98, hjust = 0, size = 3.5, colour = "grey25",
           label = "zysk: euro\ndrożeje") +
  annotate("text", x = 300, y = ymax * 0.98, hjust = 0, size = 3.5, colour = "grey25",
           label = "strata: euro\ntanieje") +
  annotate("rect", xmin = 2470, xmax = 3950, ymin = ymax * 0.1, ymax = ymax * 1.08, fill = "#f4f2ee", colour = "#dedbd4") +
  geom_text(data = karty, aes(x, y, label = tekst), hjust = 0, vjust = 0.5, size = 3.6, lineheight = 0.95,
            colour = "#0f1d3a", fontface = c("bold", "bold", "plain")) +
  coord_cartesian(xlim = c(-1700, 3950), ylim = c(0, ymax * 1.1), expand = FALSE) +
  scale_x_continuous(breaks = seq(-1500, 2000, 500)) +
  labs(title = "VaR i ES na jednym rozkładzie: 3 mln EUR należności, 10 dni",
       subtitle = "Rozkład zysku i straty w zł z 20 000 symulacji modelu GARCH-t",
       x = "Strata (tys. zł; ujemna = zysk)", y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
p3                       # do pliku: ggsave("var-es-karta-var-i-es.svg", p3, width = 10, height = 5.2)
Wynik w R
10 dni, GARCH-t: VaR 95% = 658 tys. zł | VaR 99% = 1070 tys. zł | ES 99% = 1441 tys. zł | ES/VaR = 1.35
Odsetek scenariuszy ze stratą (kurs euro spada): 52.3 %
Najgorszy 1% scenariuszy: od 1070 do 3845 tys. zł
 zabezpieczone_proc otwarte_mln_eur VaR99_tys_zl ES99_tys_zl
                  0            3.00         1070        1441
                 50            1.50          535         721
                 75            0.75          268         360
4. Test wsteczny, test Kupca i Christoffersena: Rysunek 4
R
# Rysunek 4. Test wsteczny jednodniowego VaR 99% na ostatnich 1000 dniach: test Kupca i Christoffersena
# (korzysta z kol, motyw, parametrów i kurs_dane z przepisu 1 oraz spec z przepisu 2)
library(ggplot2)
library(rugarch)

x <- kurs_dane$zwrot_proc
dni_testu <- (okno + 1):N                          # 1000 dni: prognoza na dzień t z 500 poprzednich dni
p <- 0.01                                          # VaR 99%: oczekujemy przekroczeń w 1% dni
var_hist <- sapply(dni_testu, function(t) quantile(x[(t - okno):(t - 1)], p, type = 7))
var_norm <- sapply(dni_testu, function(t) { h <- x[(t - okno):(t - 1)]; mean(h) + sd(h) * qnorm(p) })
set.seed(7133)                                     # solver „hybrid” może losować punkty startowe
roll <- ugarchroll(spec, x, n.start = okno, refit.every = 25, refit.window = "moving", window.size = okno,
                   solver = "hybrid", calculate.VaR = TRUE, VaR.alpha = p)
var_garch <- as.data.frame(roll, which = "VaR")[, 1]
wyniki <- data.frame(dzien = dni_testu, zwrot = x[dni_testu], historyczna = var_hist,
                     normalna = var_norm, `GARCH-t` = var_garch, check.names = FALSE)

kupiec <- function(I, p) {                          # test zgodności liczby przekroczeń (pokrycie bezwarunkowe)
  T <- length(I); n1 <- sum(I); ph <- n1 / T
  ll0 <- (T - n1) * log(1 - p) + n1 * log(p)
  ll1 <- (T - n1) * log(1 - ph) + ifelse(n1 > 0, n1 * log(ph), 0)
  LR <- -2 * (ll0 - ll1); c(LR_uc = LR, p_uc = 1 - pchisq(LR, 1))
}
christoffersen <- function(I) {                     # test niezależności: czy przekroczenie zwiększa szansę następnego
  a <- I[-length(I)]; b <- I[-1]
  n00 <- sum(a == 0 & b == 0); n01 <- sum(a == 0 & b == 1); n10 <- sum(a == 1 & b == 0); n11 <- sum(a == 1 & b == 1)
  lg <- function(k, q) ifelse(k > 0, k * log(q), 0)
  p01 <- n01 / (n00 + n01); p11 <- ifelse(n10 + n11 > 0, n11 / (n10 + n11), 0); pp <- (n01 + n11) / (n00 + n01 + n10 + n11)
  ll0 <- lg(n00 + n10, 1 - pp) + lg(n01 + n11, pp)
  ll1 <- lg(n00, 1 - p01) + lg(n01, p01) + lg(n10, 1 - p11) + lg(n11, p11)
  LR <- -2 * (ll0 - ll1); c(n11 = n11, LR_ind = LR, p_ind = 1 - pchisq(LR, 1))
}
metody <- c("historyczna", "normalna", "GARCH-t")
tab <- do.call(rbind, lapply(metody, function(m) {
  I <- as.integer(wyniki$zwrot < wyniki[[m]])
  k <- kupiec(I, p); ch <- christoffersen(I)
  data.frame(metoda = m, przekroczenia = sum(I), oczekiwane = length(I) * p,
             przed_zmiana = sum(I[wyniki$dzien < dzien_zmiany]), po_zmianie = sum(I[wyniki$dzien >= dzien_zmiany]),
             dni_pod_rzad = ch[["n11"]], LR_uc = round(k[["LR_uc"]], 2), p_uc = round(k[["p_uc"]], 3),
             LR_ind = round(ch[["LR_ind"]], 2), p_ind = round(ch[["p_ind"]], 3),
             p_cc = round(1 - pchisq(k[["LR_uc"]] + ch[["LR_ind"]], 2), 3))
}))
print(tab, row.names = FALSE)
cat("Dni testu przed zmianą reżimu:", sum(dni_testu < dzien_zmiany), "| po zmianie:", sum(dni_testu >= dzien_zmiany), "\n")
cat("Sprawdzenie GARCH-t funkcją rugarch::VaRTest (LR.uc, LR.cc):\n")
vt <- VaRTest(p, wyniki$zwrot, wyniki$`GARCH-t`)
print(round(unlist(vt[c("actual.exceed", "uc.LRstat", "uc.LRp", "cc.LRstat", "cc.LRp")]), 3))

dl <- do.call(rbind, lapply(metody, function(m) data.frame(dzien = wyniki$dzien, zwrot = wyniki$zwrot,
                                                         VaR = wyniki[[m]], metoda = m)))
dl$przekr <- dl$zwrot < dl$VaR
dl$metoda <- factor(dl$metoda, levels = metody,
                    labels = sprintf("%s: %d przekroczeń (oczekiwane 10)", metody, tab$przekroczenia))
p4 <- ggplot(dl, aes(dzien)) +
  geom_line(aes(y = zwrot), colour = "grey65", linewidth = 0.25) +
  geom_line(aes(y = VaR, linetype = "VaR 99% na dany dzień"), colour = kol[["niebieski"]], linewidth = 0.7) +
  geom_point(data = subset(dl, przekr), aes(y = zwrot, shape = "przekroczenie"), colour = kol[["pomaranczowy"]],
             size = 2.6, stroke = 1.1) +
  geom_vline(xintercept = dzien_zmiany, linetype = "dashed", colour = "#0f1d3a", linewidth = 0.5) +
  facet_wrap(~ metoda, ncol = 1) +
  scale_shape_manual(values = 4, name = NULL) + scale_linetype_manual(values = "solid", name = NULL) +
  coord_cartesian(ylim = c(-4.5, 3.5)) +
  labs(title = "Test wsteczny: 1000 dni, VaR 99% liczony z 500 poprzednich dni",
       subtitle = "Linia przerywana: zmiana reżimu (dzień 1251)",
       x = "Dzień roboczy", y = "Zmiana kursu (%)") + motyw
p4                       # do pliku: ggsave("var-es-test-wsteczny.svg", p4, width = 10, height = 7)
Wynik w R
      metoda przekroczenia oczekiwane przed_zmiana po_zmianie dni_pod_rzad
 historyczna            21         10           10         11            1
    normalna            29         10           13         16            3
     GARCH-t            13         10            9          4            0
 LR_uc  p_uc LR_ind p_ind  p_cc
  9.28 0.002   0.55 0.459 0.007
 24.12 0.000   3.65 0.056 0.000
  0.83 0.362   0.34 0.558 0.556
Dni testu przed zmianą reżimu: 750 | po zmianie: 250
Sprawdzenie GARCH-t funkcją rugarch::VaRTest (LR.uc, LR.cc):
actual.exceed     uc.LRstat        uc.LRp     cc.LRstat        cc.LRp
       13.000         0.831         0.362         1.173         0.556
5. Grube ogony i moc testu Kupca: Rysunek 5
R
# Rysunek 5. Dlaczego normalny VaR zaniża ryzyko przy grubych ogonach (A) i ile dni potrzebuje test Kupca (B)
# (korzysta z kol, motyw, okno z przepisu 1 i funkcji kupiec z przepisu 4)
library(ggplot2)
library(patchwork)

# A. 2000 historii po 500 dni z rozkładu t o 4 stopniach swobody (bez zmienności falami), SD = 0.4% dziennie.
#    Z każdej historii liczymy VaR normalny i historyczny; prawdziwy odsetek przekroczeń znamy z rozkładu t.
df_t <- 4; sd_dz <- 0.4; skala <- sd_dz / sqrt(df_t / (df_t - 2))
poziomy <- c(0.95, 0.975, 0.99, 0.995)
set.seed(7134)
A <- do.call(rbind, lapply(1:2000, function(i) {
  h <- skala * rt(okno, df_t)
  do.call(rbind, lapply(poziomy, function(pz) {
    v_norm <- mean(h) + sd(h) * qnorm(1 - pz); v_hist <- quantile(h, 1 - pz, type = 7)
    data.frame(poziom = pz, normalna = pt(v_norm / skala, df_t), historyczna = pt(v_hist / skala, df_t))
  }))
}))
podsA <- aggregate(cbind(normalna, historyczna) ~ poziom, data = A, FUN = mean)
podsA$oczekiwany <- 1 - podsA$poziom
podsA$norm_iloraz <- podsA$normalna / podsA$oczekiwany
cat("A. Prawdziwy odsetek przekroczeń VaR (%), średnio z 2000 historii po 500 dni, rozkład t(4):\n")
print(transform(podsA, normalna = round(100 * normalna, 2), historyczna = round(100 * historyczna, 2),
                oczekiwany = 100 * oczekiwany, norm_iloraz = round(norm_iloraz, 2)), row.names = FALSE)
# ES 99%: prawdziwy dla t(4) kontra wzór normalny przy tej samej SD (bez błędu szacowania)
q99 <- skala * qt(0.01, df_t)
es_t <- -integrate(function(u) skala * qt(u, df_t), 0, 0.01)$value / 0.01
es_n <- sd_dz * dnorm(qnorm(0.99)) / 0.01
cat("VaR 99% (% zwrotu): prawdziwy t(4)", round(-q99, 3), "| normalny", round(sd_dz * qnorm(0.99), 3),
    "\nES 99%: prawdziwy t(4)", round(es_t, 3), "| normalny", round(es_n, 3), "| niedoszacowanie ES o",
    round(100 * (1 - es_n / es_t), 1), "%\n")

# B. Moc testu Kupca: odsetek odrzuceń H0 (p = 1%) przy α = .05, 10 000 symulacji na punkt
dlug <- c(250, 500, 1000, 2000)
prawdziwe_p <- c(0.01, 0.015, 0.02, 0.03)
set.seed(7135)
B <- expand.grid(T = dlug, p_prawdziwe = prawdziwe_p)
B$odrzucenia <- mapply(function(T, pp) {
  x <- rbinom(10000, T, pp)
  mean(sapply(x, function(n1) kupiec(c(rep(1, n1), rep(0, T - n1)), 0.01)[["p_uc"]] < 0.05))
}, B$T, B$p_prawdziwe)
B$bladMC <- sqrt(B$odrzucenia * (1 - B$odrzucenia) / 10000)
cat("\nB. Odsetek odrzuceń w teście Kupca (VaR 99%, α = .05):\n")
print(transform(B, odrzucenia = round(100 * odrzucenia, 1), bladMC = round(100 * bladMC, 1)), row.names = FALSE)

dA <- rbind(data.frame(poziom = podsA$poziom, proc = 100 * podsA$normalna, co = "VaR normalny"),
            data.frame(poziom = podsA$poziom, proc = 100 * podsA$historyczna, co = "VaR historyczny"),
            data.frame(poziom = podsA$poziom, proc = 100 * podsA$oczekiwany, co = "deklarowany odsetek"))
dA$etyk <- factor(paste0(100 * dA$poziom, "%"), levels = paste0(100 * poziomy, "%"))
dA$co <- factor(dA$co, levels = c("deklarowany odsetek", "VaR historyczny", "VaR normalny"))
pA <- ggplot(dA, aes(etyk, proc, fill = co)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75) +
  geom_text(aes(label = sprintf("%.2f", proc)), position = position_dodge(width = 0.8), vjust = -0.35, size = 2.9,
            colour = "#0f1d3a") +
  scale_fill_manual(values = c(kol[["szary"]], kol[["blekit"]], kol[["pomaranczowy"]]), name = NULL) +
  labs(title = "A. Grube ogony: jak często strata\nprzekracza VaR", subtitle = "rozkład t(4), 500 dni historii",
       x = "Poziom VaR", y = "Prawdziwy odsetek dni (%)") + motyw +
  guides(fill = guide_legend(ncol = 1))
B$etyk <- factor(sprintf("%.1f%%", 100 * B$p_prawdziwe), levels = sprintf("%.1f%%", 100 * prawdziwe_p))
pB <- ggplot(B, aes(T, 100 * odrzucenia, colour = etyk, shape = etyk)) +
  geom_hline(yintercept = 5, linetype = "dotted", colour = "grey40") +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  scale_x_continuous(trans = "log10", breaks = dlug) + scale_y_continuous(limits = c(0, 100)) +
  scale_colour_manual(values = unname(kol[c("szary", "zolty", "pomaranczowy", "niebieski")]),
                      name = "Prawdziwy odsetek\nprzekroczeń") +
  scale_shape_manual(values = c(1, 17, 15, 16), name = "Prawdziwy odsetek\nprzekroczeń") +
  labs(title = "B. Czy test Kupca\nwykryje zły model?", subtitle = "VaR 99%, α = .05",
       x = "Dni w teście wstecznym", y = "% odrzuceń H0") + motyw +
  guides(colour = guide_legend(ncol = 2), shape = guide_legend(ncol = 2))
p5 <- pA + pB + plot_layout(widths = c(1.2, 1))
p5                       # do pliku: ggsave("var-es-grube-ogony-i-moc.svg", p5, width = 10, height = 6)
Wynik w R
A. Prawdziwy odsetek przekroczeń VaR (%), średnio z 2000 historii po 500 dni, rozkład t(4):
 poziom normalna historyczna oczekiwany norm_iloraz
  0.950     4.18        5.18        5.0        0.84
  0.975     2.62        2.69        2.5        1.05
  0.990     1.58        1.20        1.0        1.58
  0.995     1.15        0.69        0.5        2.31
VaR 99% (% zwrotu): prawdziwy t(4) 1.06 | normalny 0.931
ES 99%: prawdziwy t(4) 1.477 | normalny 1.066 | niedoszacowanie ES o 27.8 %

B. Odsetek odrzuceń w teście Kupca (VaR 99%, α = .05):
    T p_prawdziwe odrzucenia bladMC
  250       0.010        9.4    0.3
  500       0.010        7.1    0.3
 1000       0.010        5.6    0.2
 2000       0.010        4.4    0.2
  250       0.015       10.8    0.3
  500       0.015       22.0    0.4
 1000       0.015       34.8    0.5
 2000       0.015       52.5    0.5
  250       0.020       24.9    0.4
  500       0.020       54.1    0.5
 1000       0.020       78.3    0.4
 2000       0.020       96.0    0.2
  250       0.030       62.3    0.5
  500       0.030       93.2    0.3
 1000       0.030       99.7    0.1
 2000       0.030      100.0    0.0
6. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "szary – niebieski" = c("#999999", "#0072B2"), "żółty – pomarańczowy" = c("#E69F00", "#D55E00"),
             "szary – żółty" = c("#999999", "#E69F00"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
szary – niebieski                           44.9         48.9       40.6
żółty – pomarańczowy                        33.4         18.4       24.9
szary – żółty                               76.8         73.9       70.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, kwantyle, test Ljunga–Boxa i testy Kupca oraz Christoffersena (liczone ręcznie) wykonano pakietem stats z podstawowej instalacji R. Model GARCH dopasowano i sprawdzono pakietem rugarch, rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rugarch (wersja 1.5.6): Galanos, A. (2026). rugarch: Univariate GARCH models (R package version 1.5-6) [Computer software]. https://CRAN.R-project.org/package=rugarch
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Normalny VaR przy grubych ogonach – im wyższy poziom, tym bardziej zaniża (rysunek 5A).
- Krótka historia – rok danych to 2–3 spodziewane przekroczenia VaR 99%; test Kupca prawie niczego nie wykryje (rysunek 5B), a ES opiera się na kilku obserwacjach.
- Zmiana reżimu – okno 500 dni miesza spokój i nerwowość; metody bez modelu zmienności reagują z opóźnieniem, a GARCH zawyża trwałość (rysunki 2 i 4).
- Dane niestacjonarne – licz VaR ze zmian kursu, nie z poziomów; o stacjonarności przeczytasz w słowniku.
- VaR to nie najgorszy scenariusz – o ile większa bywa strata, mówi ES.
Najczęstsze pytania
Co to jest Value at Risk (VaR)?
VaR na poziomie 99% to strata, której w danym horyzoncie nie przekroczysz w 99 na 100 podobnych okresów – czyli 99. percentyl rozkładu strat. Zawsze podawaj poziom i horyzont, np. „VaR 99% na 10 dni: 1.07 mln zł”. VaR nie mówi, ile stracisz w pozostałym 1% okresów.
Czym różni się expected shortfall od VaR?
Expected shortfall (ES, także CVaR) to średnia strata w okresach, w których strata przekroczyła VaR. VaR wskazuje, gdzie zaczyna się ogon rozkładu, a ES – jak głęboki jest. W przykładzie należności 3 mln EUR VaR 99% wynosił 1070 tys. zł, a ES 99% 1441 tys. zł. ES jest miarą koherentną, a VaR w ogólności nie.
Czy VaR na 10 dni można policzyć, mnożąc VaR dzienny przez pierwiastek z 10?
Tylko w przybliżeniu. Reguła √10 zakłada niezależne dni o stałej zmienności. Gdy zmienność wraca do średniej, po spokojnym okresie reguła zaniża ryzyko (w symulacji o 14%), a po nerwowym zawyża (o 9%). Lepiej zasymulować 10-dniowe ścieżki z modelu zmienności, np. GARCH.
Jak sprawdzić, czy model VaR jest dobry?
Zrób test wsteczny: na każdy dzień z przeszłości policz VaR z wcześniejszych danych i zlicz przekroczenia. Test Kupca sprawdza, czy ich odsetek zgadza się z deklarowanym, a test Christoffersena – czy nie przychodzą seriami. Przy krótkiej historii testy mają małą moc: przy 250 dniach model z 2% przekroczeń zamiast 1% wykryto tylko w 24.9% symulacji.
Dlaczego VaR z rozkładu normalnego zaniża ryzyko?
Bo zwroty z kursów i cen mają grubsze ogony niż rozkład normalny. W symulacji z rozkładem t o 4 stopniach swobody normalny VaR 99% był przekraczany w 1.58% dni zamiast 1%, a normalny ES 99% był zaniżony o 27.8%. Przy poziomie 95% błąd jest mały, dlatego łatwo go przeoczyć.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z finansów i rachunkowości
Ankieta wśród przedsiębiorców, skośne wskaźniki i winsoryzacja, regresja z błędami odpornymi, dane panelowe i model upadłości – z gotowymi zdaniami APA i kodem R.
Czytaj →PoradnikOpóźnienia płatności faktur w analizie przeżycia
Hurtownia, 20 tys. faktur: cenzurowanie, Kaplan–Meier, Cox z klientem jako klastrem, windykacja jako CIF i prognoza wpływów.
Czytaj →PoradnikMonte Carlo NPV – opłacalność projektu
Linia produkcyjna w mleczarni: NPV, rozkłady założeń, 10 000 symulacji, P(NPV < 0), tornado i korelacja ceny z popytem – sześć rysunków z kodem R.
Czytaj →Piszesz pracę o ryzyku finansowym?
Pomożemy dobrać metodę VaR i ES, dopasować model zmienności, przeprowadzić test wsteczny i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Acerbi, C., & Tasche, D. (2002). On the coherence of expected shortfall. Journal of Banking & Finance, 26(7), 1487–1503. https://doi.org/10.1016/s0378-4266(02)00283-2
- Artzner, P., Delbaen, F., Eber, J.-M., & Heath, D. (1999). Coherent measures of risk. Mathematical Finance, 9(3), 203–228. https://doi.org/10.1111/1467-9965.00068 ● Otwarty dostęp
- Bollerslev, T. (1986). Generalized autoregressive conditional heteroskedasticity. Journal of Econometrics, 31(3), 307–327. https://doi.org/10.1016/0304-4076(86)90063-1 ● Otwarty dostęp: pełny tekst
- Christoffersen, P. F. (1998). Evaluating interval forecasts. International Economic Review, 39(4), 841–862. https://doi.org/10.2307/2527341
- Cont, R. (2001). Empirical properties of asset returns: Stylized facts and statistical issues. Quantitative Finance, 1(2), 223–236. https://doi.org/10.1080/713665670
- Kupiec, P. H. (1995). Techniques for verifying the accuracy of risk measurement models. The Journal of Derivatives, 3(2), 73–84. https://doi.org/10.3905/jod.1995.407942 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{acerbi2002coherence, author={Acerbi, Carlo and Tasche, Dirk}, title={{On the coherence of expected shortfall}}, journal={Journal of Banking \& Finance}, year={2002}, volume={26}, number={7}, pages={1487--1503}, doi={10.1016/s0378-4266(02)00283-2}}@article{artzner1999coherent, author={Artzner, Philippe and Delbaen, Freddy and Eber, Jean-Marc and Heath, David}, title={{Coherent measures of risk}}, journal={Mathematical Finance}, year={1999}, volume={9}, number={3}, pages={203--228}, doi={10.1111/1467-9965.00068}}@article{bollerslev1986generalized, author={Bollerslev, Tim}, title={{Generalized autoregressive conditional heteroskedasticity}}, journal={Journal of Econometrics}, year={1986}, volume={31}, number={3}, pages={307--327}, doi={10.1016/0304-4076(86)90063-1}}@article{christoffersen1998evaluating, author={Christoffersen, Peter F.}, title={{Evaluating interval forecasts}}, journal={International Economic Review}, year={1998}, volume={39}, number={4}, pages={841--862}, doi={10.2307/2527341}}@article{cont2001empirical, author={Cont, R.}, title={{Empirical properties of asset returns: Stylized facts and statistical issues}}, journal={Quantitative Finance}, year={2001}, volume={1}, number={2}, pages={223--236}, doi={10.1080/713665670}}@article{kupiec1995techniques, author={Kupiec, Paul H.}, title={{Techniques for verifying the accuracy of risk measurement models}}, journal={The Journal of Derivatives}, year={1995}, volume={3}, number={2}, pages={73--84}, doi={10.3905/jod.1995.407942}}