Co to jest bootstrap blokowy i wild bootstrap?
Zwykły bootstrap losuje obserwacje ze zwracaniem i zakłada, że są niezależne i mają ten sam rozkład. Bootstrap blokowy (ang. block bootstrap) i wild bootstrap to dwie odmiany na sytuacje, w których to założenie nie działa: pierwsza dla danych zależnych w czasie, druga dla regresji z niejednorodną wariancją reszt.
Bootstrap blokowy
Przy autokorelacji losowanie pojedynczych punktów niszczy strukturę szeregu i zaniża błąd standardowy. Künsch (1989) zaproponował losowanie ze zwracaniem bloków l kolejnych obserwacji z szeregu stacjonarnego; zgodność wymaga, by l rosło z n, ale wolniej niż n. W R służy do tego tsboot() z pakietu boot: sim = "fixed" to bloki ruchome o stałej długości, a sim = "geom" – bloki o losowej długości.
W przykładzie dla średniej szeregu AR(1) (φ = 0.6, n = 200) zwykły bootstrap dał SE = 0.096, blokowy z l = 10 – 0.158, a wartość teoretyczna wynosi 0.177. Bloki usunęły większość zaniżenia, choć nie całe.
Wild bootstrap
Gdy wariancja reszt zależy od predyktora (brak homoskedastyczności), losowanie reszt ze zwracaniem przenosi je między obserwacjami i gubi heteroskedastyczność. Wild bootstrap zostawia każdą resztę przy jej obserwacji i tylko mnoży ją przez losową wagę, np. ±1 z prawdopodobieństwem 1/2 (wagi Rademachera). Wu (1986) wykazał, że część klasycznych odmian bootstrapu daje obciążone oszacowania wariancji w regresji i zaproponował ogólną metodę losowania reszt odporną na to obciążenie, a Liu (1988) zbadała jej własności drugiego rzędu przy heteroskedastyczności. W przykładzie z wariancją rosnącą z x SE nachylenia wyniosło 0.058 według OLS, 0.062 z wild bootstrapu i 0.063 według HC3.
Na rysunku
Panel A to szereg z przykładu bootstrapu blokowego (AR(1), φ = 0.6, n = 200, set.seed(56801)) z 95% przedziałami percentylowymi średniej. Panel B powtarza to samo w 1000 nowych szeregach o prawdziwej średniej 0 (set.seed(5681), 999 prób bootstrapowych na szereg); długości bloków 5, 10 i 20 wybrano ręcznie jako dzielniki n.
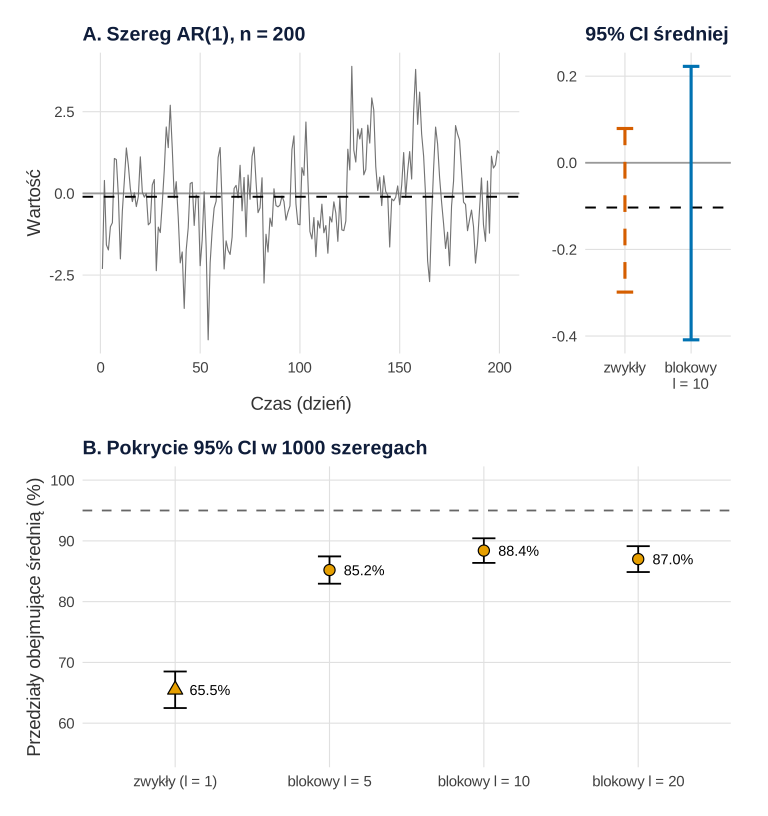
set.seed(56801), set.seed(5681)).Co widać. Szereg tworzy długie serie wartości po jednej stronie średniej – sąsiednie dni niosą prawie tę samą informację. Zwykły bootstrap tego nie widzi i daje przedział [−0.30, 0.08], a bloki po 10 dni – [−0.41, 0.22], prawie dwa razy dłuższy. W 1000 szeregach zwykły przedział objął prawdziwą średnią tylko w 65.5% przypadków (błąd Monte Carlo 1.5 pp), a blokowy w 85.2–88.4%.
Na co uważać. Bloki usuwają większość zaniżenia, ale nie całe: żadna długość bloku nie dała 95% przy 200 obserwacjach i tak silnej autokorelacji, a bloki 20-dniowe nie były lepsze niż 10-dniowe. Rysunek dotyczy szeregu stacjonarnego – przy trendzie żaden z przedziałów nie ma sensu. W panelu B bloki ruchome losowano ręcznie (ten sam pomysł co tsboot(sim = "fixed")), żeby 1000 szeregów liczyło się w kilka sekund. Jak wygląda zwykły bootstrap przy niezależnych obserwacjach, pokazuje wpis Bootstrap – wizualizacja na obrazkach, a samą zależność w czasie – hasło autokorelacja reszt.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Kod losuje w dwóch miejscach, każde z własnym ziarnem: set.seed(56801) odtwarza przykład hasła, set.seed(5681) – 1000 szeregów. Ziaren nie zmieniano.
Kod R rysunku 1
# Rysunek 1. Szereg AR(1) z przedziałami ze zwykłego i blokowego bootstrapu (A) oraz pokrycie w 1000 szeregach (B)
suppressPackageStartupMessages(library(boot))
library(ggplot2)
library(patchwork)

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# A: szereg z przykładu hasła (AR(1), phi = 0.6, n = 200, prawdziwa średnia 0)
set.seed(56801)
y <- as.numeric(arima.sim(list(ar = 0.6), n = 200))
b_iid <- boot(y, function(d, i) mean(d[i]), R = 2000)
b_blok <- tsboot(y, mean, R = 2000, l = 10, sim = "fixed")         # bloki ruchome, l = 10
ci <- data.frame(metoda = c("zwykły bootstrap", "bootstrap blokowy (l = 10)"),
                 lo = c(quantile(b_iid$t, .025), quantile(b_blok$t, .025)),
                 hi = c(quantile(b_iid$t, .975), quantile(b_blok$t, .975)),
                 SE = c(sd(b_iid$t), sd(b_blok$t)))
print(ci[, 1:4], digits = 3, row.names = FALSE)

ci$metoda <- factor(c("zwykły", "blokowy\nl = 10"), levels = c("zwykły", "blokowy\nl = 10"))
pa1 <- ggplot(data.frame(t = 1:200, y), aes(t, y)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_line(colour = "grey45", linewidth = 0.4) +
  geom_hline(yintercept = mean(y), linetype = "dashed", linewidth = 0.7) +
  labs(title = "A. Szereg AR(1), n = 200", x = "Czas (dzień)", y = "Wartość") + motyw
pa2 <- ggplot(ci, aes(metoda, ymin = lo, ymax = hi)) +            # powiększenie: same przedziały
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_hline(yintercept = mean(y), linetype = "dashed", linewidth = 0.7) +
  geom_errorbar(aes(colour = metoda, linetype = metoda), width = 0.25, linewidth = 1.1) +
  scale_colour_manual(values = c("#D55E00", "#0072B2"), guide = "none") +
  scale_linetype_manual(values = c("dashed", "solid"), guide = "none") +
  labs(title = "95% CI średniej", x = NULL, y = NULL) + motyw

# B: 1000 szeregów AR(1); czy 95% przedział percentylowy obejmuje prawdziwą średnią 0?
set.seed(5681)
B <- 999; n <- 200
ci_blok <- function(x, l) {                        # bloki ruchome długości l, ręcznie (n/l bloków na próbę)
  srednie_blokow <- stats::filter(x, rep(1 / l, l), sides = 1)[l:n]   # średnie wszystkich bloków
  t_b <- rowMeans(matrix(sample(srednie_blokow, B * n / l, replace = TRUE), B))
  quantile(t_b, c(.025, .975), names = FALSE)
}
jeden <- function() {
  x <- as.numeric(arima.sim(list(ar = 0.6), n = n))
  rbind(ci_blok(x, 1), ci_blok(x, 5), ci_blok(x, 10), ci_blok(x, 20))   # l = 1 to zwykły bootstrap
}
wyn <- replicate(1000, jeden())
pokrycie <- data.frame(metoda = factor(c("zwykły (l = 1)", "blokowy l = 5", "blokowy l = 10", "blokowy l = 20"),
                                       levels = c("zwykły (l = 1)", "blokowy l = 5", "blokowy l = 10", "blokowy l = 20")),
                       pokrycie = rowMeans(wyn[, 1, ] <= 0 & wyn[, 2, ] >= 0),
                       srednia_szerokosc = rowMeans(wyn[, 2, ] - wyn[, 1, ]))
pokrycie$blad_MC <- sqrt(pokrycie$pokrycie * (1 - pokrycie$pokrycie) / 1000)
print(transform(pokrycie, pokrycie = round(100 * pokrycie, 1), blad_MC = round(100 * blad_MC, 1),
                srednia_szerokosc = round(srednia_szerokosc, 3)), row.names = FALSE)

pb <- ggplot(pokrycie, aes(metoda, 100 * pokrycie)) +
  geom_hline(yintercept = 95, linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(ymin = 100 * (pokrycie - 2 * blad_MC), ymax = 100 * (pokrycie + 2 * blad_MC)), width = 0.15) +
  geom_point(aes(shape = metoda == "zwykły (l = 1)"), size = 3.5, fill = "#E69F00") +
  geom_text(aes(label = sprintf("%.1f%%", 100 * pokrycie)), hjust = -0.35, size = 3.8) +
  scale_shape_manual(values = c(21, 24), guide = "none") +
  scale_y_continuous(limits = c(55, 100)) +
  labs(title = "B. Pokrycie 95% CI w 1000 szeregach", x = NULL,
       y = "Przedziały obejmujące średnią (%)") + motyw

p1 <- (pa1 + pa2 + plot_layout(widths = c(3, 1))) / pb
p1   # zapis: ggsave("bootstrap-blokowy-pokrycie.svg", p1, width = 8, height = 8.5)
Wynik w R
                     metoda     lo     hi     SE
           zwykły bootstrap -0.299 0.0791 0.0956
 bootstrap blokowy (l = 10) -0.409 0.2226 0.1580
         metoda pokrycie srednia_szerokosc blad_MC
 zwykły (l = 1)     65.5             0.340     1.5
  blokowy l = 5     85.2             0.542     1.1
 blokowy l = 10     88.4             0.596     1.0
 blokowy l = 20     87.0             0.602     1.1
Jak opisać w pracy
Na co uważać
- Długość bloku zmienia wynik – sprawdź kilka wartości i podaj wybraną.
- Bootstrap blokowy zakłada stacjonarność; przy trendzie najpierw go usuń lub modeluj szereg.
- Dla danych grupowanych (uczniowie w klasach) losuje się całe klastry, a nie bloki czasu; alternatywą są błędy standardowe odporne na klastrowanie.
Bootstrap blokowy i wild bootstrap w R
Kod porównuje zwykły i blokowy bootstrap dla średniej szeregu AR(1) oraz wild bootstrap z wagami Rademachera z klasycznym SE i HC3 w regresji z heteroskedastycznością.
tsboot() i wild bootstrap ręcznie
R
library(boot); library(sandwich)
# 1) Bootstrap blokowy: średnia szeregu AR(1) z phi = 0.6
set.seed(56801)
y <- as.numeric(arima.sim(list(ar = 0.6), n = 200))
se_iid <- sd(boot(y, function(d, i) mean(d[i]), R = 2000)$t)
se_blok <- sd(tsboot(y, mean, R = 2000, l = 10, sim = "fixed")$t)   # bloki ruchome, l = 10
se_teoria <- sqrt(1 / (1 - 0.6^2) / 200 * (1 + 0.6) / (1 - 0.6))
round(c(SE_iid = se_iid, SE_blokowy = se_blok, SE_teoretyczny = se_teoria), 3)
# 2) Wild bootstrap: regresja z heteroskedastycznością
set.seed(56802)
x <- runif(100, 0, 10)
yy <- 2 + 0.5 * x + rnorm(100, sd = 0.3 * x)
m <- lm(yy ~ x); e <- resid(m); f <- fitted(m)
b_wild <- replicate(2000, {
  v <- sample(c(-1, 1), 100, replace = TRUE)        # wagi Rademachera
  coef(lm(f + e * v ~ x))[2]
})
round(c(SE_OLS = summary(m)$coef[2, 2], SE_HC3 = sqrt(vcovHC(m, type = "HC3")[2, 2]),
        SE_wild = sd(b_wild)), 3)
Wynik w R
        SE_iid     SE_blokowy SE_teoretyczny
         0.096          0.158          0.177
 SE_OLS  SE_HC3 SE_wild
  0.058   0.063   0.062
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety boot i sandwich; rysunek 1 – pakiety boot, ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy zamiast zwykłego bootstrapu użyć bootstrapu blokowego?
Gdy obserwacje tworzą szereg czasowy z autokorelacją, np. pomiary dzienne. Zwykły bootstrap zaniża wtedy błąd standardowy; w przykładzie 0.096 wobec 0.158 dla bloków i 0.177 teoretycznie.
Jak dobrać długość bloku w bootstrapie blokowym?
Blok powinien obejmować zasięg autokorelacji, ale być wyraźnie krótszy od szeregu. W praktyce sprawdź kilka długości i podaj wybraną wraz z liczbą replikacji.
Czym wild bootstrap różni się od błędów HC3?
Oba chronią przed heteroskedastycznością. HC3 to wzór na macierz kowariancji, a wild bootstrap tworzy rozkład statystyki z reszt mnożonych przez losowe wagi; w przykładzie dały SE 0.063 i 0.062.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Szeregi czasowe i ARIMA w praktyce
Trend, sezonowość, ACF i test Ljunga–Boxa, wybór modelu ARIMA w stats::arima, prognoza kontrfaktyczna i regresja segmentowa z kodem R.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217–1241. https://doi.org/10.1214/aos/1176347265 ● Otwarty dostęp
- Liu, R. Y. (1988). Bootstrap procedures under some non-i.i.d. models. The Annals of Statistics, 16(4), 1696–1708. https://doi.org/10.1214/aos/1176351062 ● Otwarty dostęp
- Wu, C. F. J. (1986). Jackknife, bootstrap and other resampling methods in regression analysis. The Annals of Statistics, 14(4), 1261–1295. https://doi.org/10.1214/aos/1176350142 ● Otwarty dostęp
Cytowania BibTeX
@article{kunsch1989jackknife, author={Künsch, Hans R.}, title={{The jackknife and the bootstrap for general stationary observations}}, journal={The Annals of Statistics}, year={1989}, volume={17}, number={3}, pages={1217--1241}, doi={10.1214/aos/1176347265}}@article{liu1988bootstrap, author={Liu, Regina Y.}, title={{Bootstrap procedures under some non-i.i.d. models}}, journal={The Annals of Statistics}, year={1988}, volume={16}, number={4}, pages={1696--1708}, doi={10.1214/aos/1176351062}}@article{wu1986jackknife, author={Wu, C. F. J.}, title={{Jackknife, bootstrap and other resampling methods in regression analysis}}, journal={The Annals of Statistics}, year={1986}, volume={14}, number={4}, pages={1261--1295}, doi={10.1214/aos/1176350142}}