Przykład: zakład mleczarski i nowa linia do jogurtu pitnego
Fikcyjny zakład mleczarski rozważa zakup linii do jogurtu pitnego w butelkach. Zarząd pyta: czy inwestycja za ok. 12 mln zł się zwróci i jak bardzo możemy się pomylić? Klasyczna odpowiedź to NPV (wartość bieżąca netto): suma przyszłych przepływów pieniężnych sprowadzona do dziś stopą dyskontową minus nakład. Kłopot w tym, że każdy składnik rachunku – popyt, cena, koszt mleka, nakład – jest prognozą. Symulacja Monte Carlo zamienia te prognozy w rozkłady, losuje z nich tysiące scenariuszy i pokazuje, jak często projekt traci.
Dane są fikcyjne, a wszystkie założenia ustaliliśmy ręcznie, tak by przykład był realistyczny i by ryzyko było wyraźnie widoczne: horyzont 8 lat, rozruch 60% i 85% docelowej sprzedaży w latach 1–2, moc linii 11 mln opakowań rocznie, inne koszty zmienne 0.45 zł na opakowanie, koszty stałe 3.2 mln zł rocznie, CIT 19%, amortyzacja liniowa, stopa dyskontowa 9%. Pomijamy kapitał obrotowy i wartość rezydualną – w prawdziwej pracy trzeba je dodać. Ziarna (640 i 6401) ustalono raz i ich nie zmienialiśmy. Wpis ma charakter metodologiczny: pokazuje, jak policzyć i opisać ryzyko, a nie czy inwestować. 10 000 wylosowanych scenariuszy pobierzesz jako npv-monte-carlo-symulacje.csv (wiersz = scenariusz).
Rysunek 1: model – od założeń do NPV
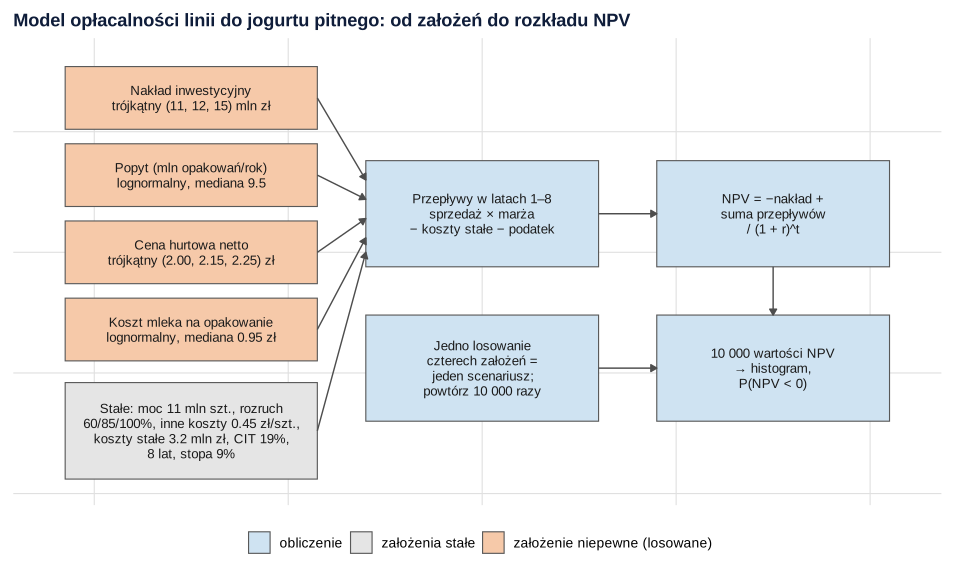
Co widać. Model ma trzy piętra. Założenia (pomarańczowe są losowane, szare – stałe) dają przepływ w każdym roku: sprzedaż × marża jednostkowa − koszty stałe − podatek. Przepływy dyskontujemy:
gdzie I0 to nakład, CFt – przepływ w roku t, a r – stopa dyskontowa. Przy wartościach bazowych (najbardziej prawdopodobnych) marża wynosi 0.75 zł na opakowanie, a rachunek wygląda tak:
| Rok | Sprzedaż (mln szt.) | Przepływ (mln zł) | Zdyskontowany (mln zł) |
|---|---|---|---|
| 0 | – | −12.00 | −12.00 |
| 1 | 5.70 | 1.08 | 0.99 |
| 2 | 8.07 | 2.60 | 2.19 |
| 3–8 (każdy) | 9.50 | 3.46 | od 2.68 do 1.74 |
| NPV | 4.25 |
NPV deterministyczne wynosi 4.25 mln zł, a wewnętrzna stopa zwrotu 16.8%. Na tym zwykle kończy się biznesplan.
Jak może zmylić. Schemat zakłada niezależne założenia; rysunek 5 to sprawdza.
Podpis do pracy:
Rysunek 2: skąd rozkłady założeń
Każdemu niepewnemu założeniu przypisujemy rozkład. Wybór trzeba uzasadnić – to najsłabiej sprawdzalna część analizy.
- Nakład – rozkład trójkątny (11, 12, 15 mln zł). Kosztorysant podaje minimum, wartość najbardziej prawdopodobną i maksimum. Rozkład jest asymetryczny, bo przekroczenia budżetu są częstsze i większe niż oszczędności.
- Cena hurtowa – trójkątny (2.00, 2.15, 2.25 zł). Sieci handlowe częściej wymuszają obniżkę niż godzą się na podwyżkę, więc dłuższy ogon jest w dół.
- Popyt i koszt mleka – lognormalne (mediany 9.5 mln opakowań i 0.95 zł, σ logarytmu 0.20 i 0.08). Zmiany są procentowe, wartości dodatnie, a prawy ogon dłuższy – typowy przypadek rozkładu lognormalnego. Limpert i in. (2001) zauważają, że rozkład normalny przyjmuje się często bez sprawdzenia, także dla wielkości o rozkładzie skośnym.
Rozkład trójkątny łatwo liczyć ręcznie. Losujemy u z rozkładu jednostajnego na [0, 1] i przekształcamy go odwrotną dystrybuantą (a – minimum, c – moda, b – maksimum):
Johnson (1997) pokazuje, że rozkład trójkątny zwykle niewiele różni się od elastyczniejszego rozkładu beta, a jego parametry da się oszacować z dwóch skrajnych percentyli i mediany – co ułatwia rozmowę z ekspertem.
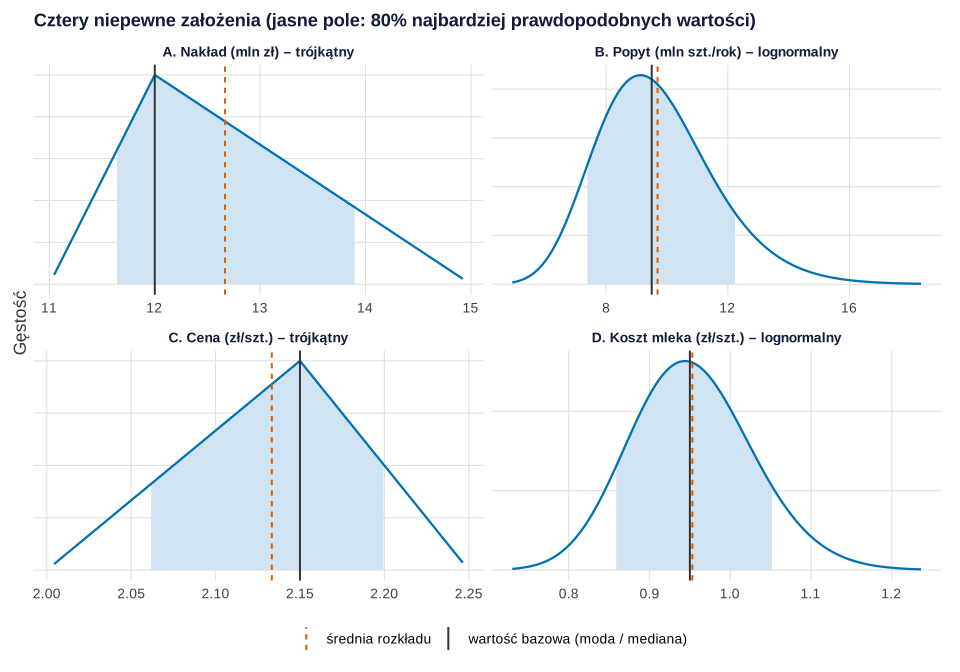
Co widać. Wartość bazowa (moda lub mediana) nie jest średnią. Średni nakład to 12.67 mln zł, a nie 12, średnia cena 2.13 zł, a nie 2.15. 80% wartości popytu mieści się między 7.35 a 12.28 mln opakowań, a koszt mleka – między 0.86 a 1.05 zł.
Jak może zmylić. Ładne krzywe sprawiają wrażenie wiedzy. Ich granice pochodzą z ocen ekspertów, a nie z danych – dlatego na rysunku 6 sprawdzamy, ile zmienia inny wybór.
Podpis do pracy:
Rysunek 3: 10 000 scenariuszy NPV
Jedna symulacja to jedno losowanie czterech założeń i policzenie NPV. Powtarzamy to 10 000 razy i oglądamy histogram wyników.
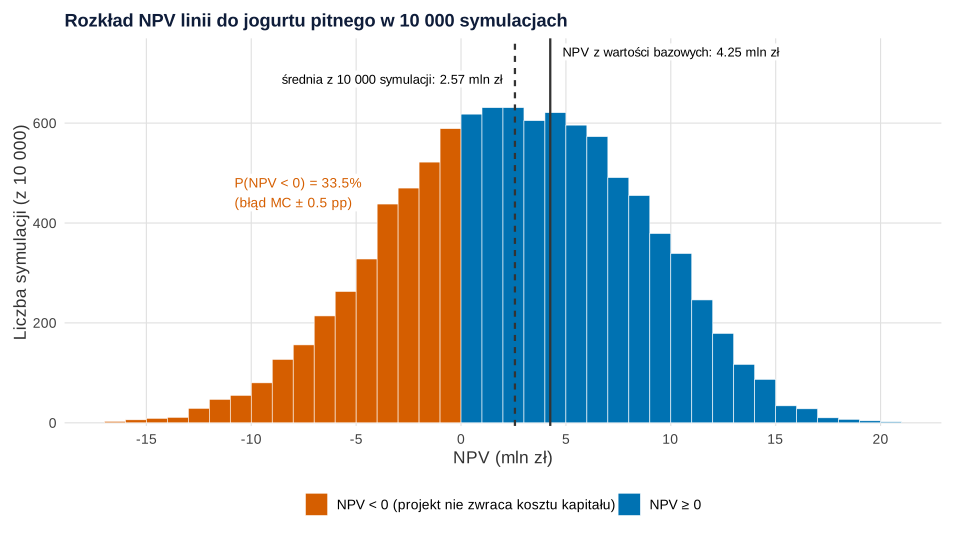
set.seed(640)).Co widać. Średnie NPV wynosi 2.57 mln zł (SD = 5.81), a 90% scenariuszy mieści się między −7.14 a 11.87 mln zł (P5 i P95). W 33.5% scenariuszy NPV jest ujemne – projekt nie zarabia na koszt kapitału. Ten odsetek to oszacowanie z symulacji, więc ma błąd Monte Carlo √(p(1 − p)/R) = 0.47 punktu procentowego; 95% przedział to 32.5–34.4% (Morris i in., 2019, proponują ustrukturyzowane raportowanie symulacji – podawaj więc nie tylko wynik, ale i jego dokładność). Gdy projekt traci, to średnio 3.88 mln zł.
Dlaczego średnia (2.57) jest niższa niż NPV deterministyczne (4.25)? Z dwóch powodów. Po pierwsze, wartości bazowe to mody i mediany, a nie średnie: samo wstawienie średnich daje 3.46 mln zł. Po drugie, model jest nieliniowy – w 23.5% scenariuszy popyt przekracza moc linii (11 mln), więc dobre lata są „ucięte”, a złe nie. To dlatego wartość oczekiwana NPV nie jest równa NPV policzonemu z oczekiwanych założeń.
Jak może zmylić. P(NPV < 0) dotyczy modelu, a nie świata – pomija ryzyka spoza modelu (np. nową konkurencję).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: wykres tornado i korelacja rang
Które założenie najbardziej decyduje o wyniku? Są dwa sposoby. Wykres tornado podsumowuje na jednym rysunku wpływ wielu zmiennych (Eschenbach, 1992): zmienia jedno założenie naraz – tu od 10. do 90. percentyla jego rozkładu – przy pozostałych na wartościach bazowych. Dodaliśmy do niego stopę dyskontową 7–11%: to decyzja zarządu, więc jej nie losujemy. Drugi sposób korzysta z całej symulacji: liczy korelację rang Spearmana między każdym założeniem a NPV. Helton i Davis (2002) pokazują, że miary oparte na rangach dobrze działają, gdy wynik zmienia się monotonicznie z założeniami – tak jak tutaj.
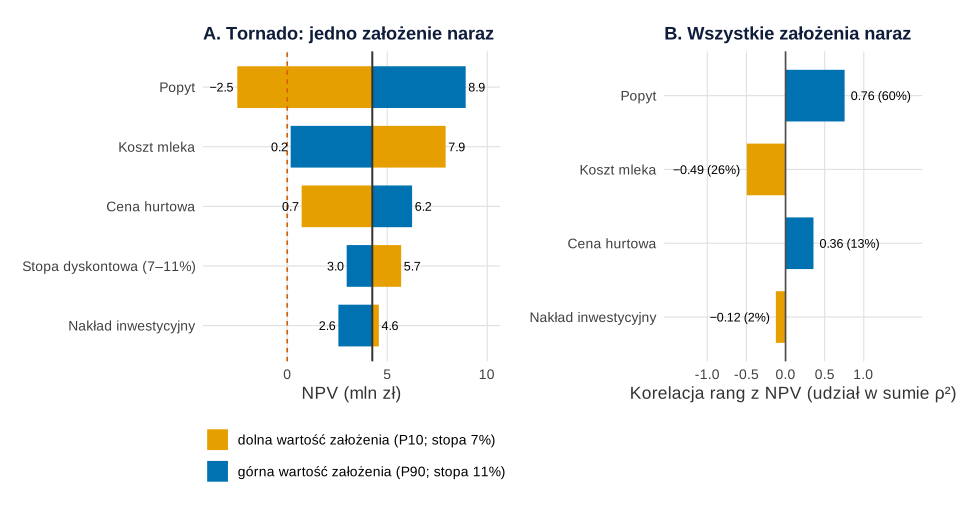
set.seed(640)).Co widać. Oba wykresy zgadzają się co do kolejności: najważniejszy jest popyt (NPV od −2.50 do 8.92 mln zł; ρ = .76, 60% sumy ρ²), potem koszt mleka (od 7.92 do 0.17; ρ = −.49) i cena (od 0.72 do 6.24; ρ = .36). Nakład, choć to największa pojedyncza kwota, zmienia NPV tylko o 2.02 mln zł. Słupek popytu jest asymetryczny: przy P90 (12.28 mln) linia i tak sprzeda najwyżej 11 mln opakowań.
Jak może zmylić. Tornado ma sens tylko przy porównywalnych zakresach – tu wszystkie to P10–P90. Zmienia też jedno założenie naraz, czyli bada „korytarze” wokół wartości bazowych. Saltelli i in. (2019) wskazują, że takie analizy często pomijają większość przestrzeni możliwych kombinacji; panel B jej nie pomija. Więcej o samym pojęciu w haśle analiza wrażliwości.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: korelacja ceny i popytu zmienia ryzyko
Do tej pory cena i popyt były niezależne. W rzeczywistości mogą iść w parze: wyższa cena zmniejsza popyt (ujemna korelacja), ale w dobrym roku dla całego rynku rosną oba naraz (dodatnia). Iman i Conover (1982) zaproponowali metodę, która nadaje zmiennym wejściowym zadaną korelację rang i zachowuje ich rozkłady. Używamy jej uproszczonej wersji: te same 10 000 wartości ceny i popytu ustawiamy w nowej kolejności, wziętej z rang skorelowanych zmiennych normalnych.
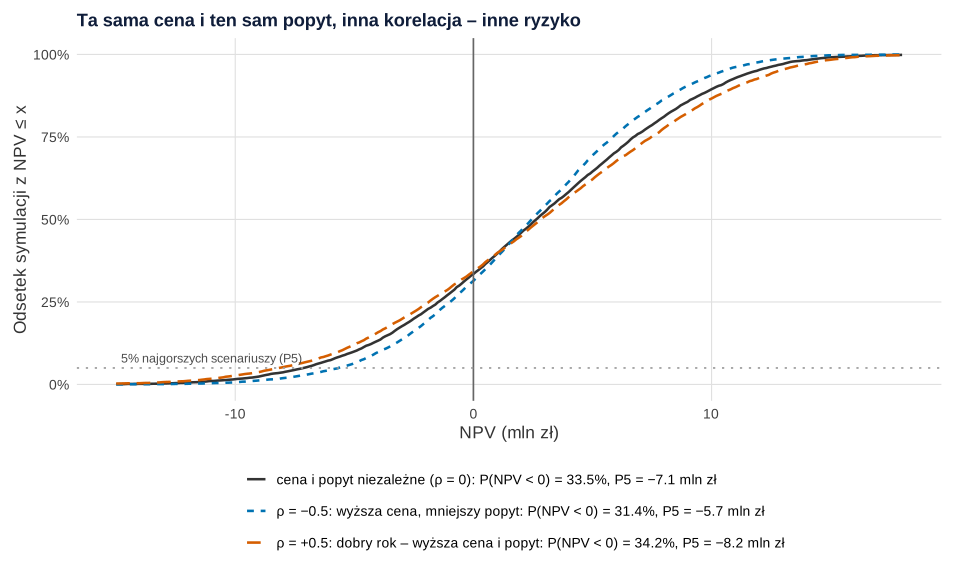
set.seed(640) i set.seed(6401)).Co widać. Na osi pionowej czytasz, jaki odsetek scenariuszy kończy się NPV poniżej danej wartości (dystrybuanta empiryczna). Uzyskane korelacje rang to −.499 i .495. Przy ujemnej korelacji ryzyka się częściowo znoszą: SD NPV spada z 5.81 do 4.95, P5 rośnie z −7.14 do −5.66 mln zł, a strata większa niż 5 mln zł zdarza się w 6.5% scenariuszy zamiast 10.0%. Przy dodatniej – odwrotnie: SD 6.41, P5 −8.16, strata ponad 5 mln w 12.1%.
Jak może zmylić. P(NPV < 0) zmienia się niewiele (31.4%, 33.5% i 34.2%), bo zero leży blisko środka rozkładu. Korelacja działa głównie na ogony – a o ogony zwykle pyta zarząd.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: fałszywa precyzja i rozkłady „z sufitu”
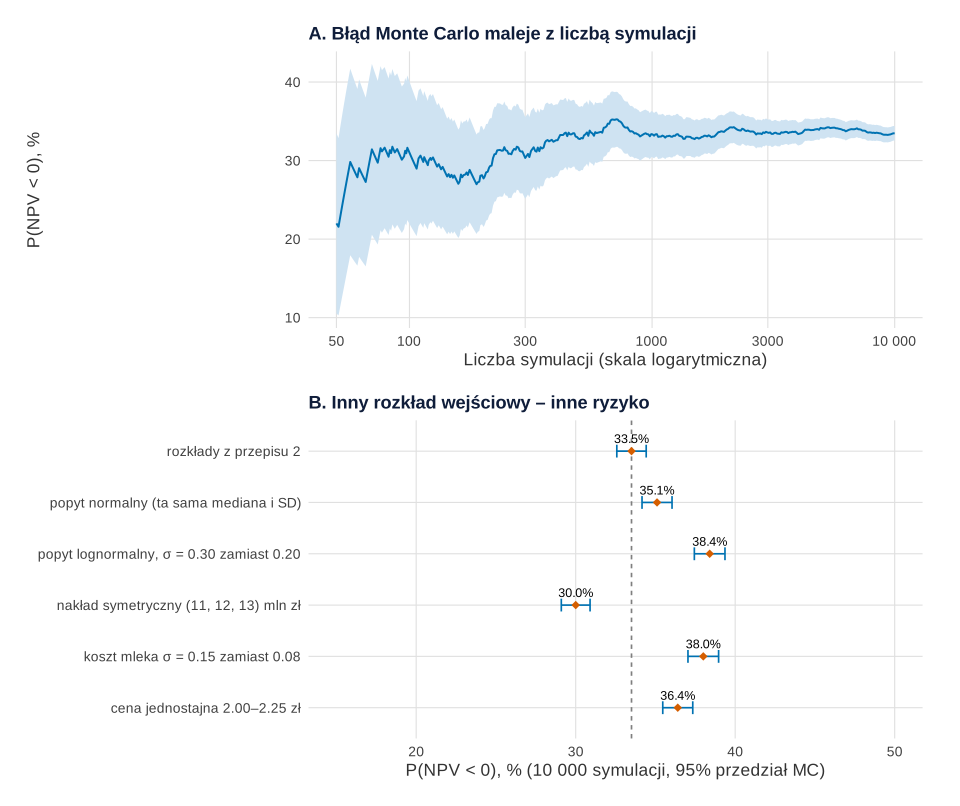
set.seed(640)).Co widać – panel A. Po 100 symulacjach P(NPV < 0) wynosi 31.0% z błędem MC 4.6 pp, po 1000 – 33.4% (1.5 pp), po 10 000 – 33.5% (0.47 pp). Liczbę powtórzeń dobieraj do wymaganej precyzji, tak jak w każdym badaniu symulacyjnym.
Co widać – panel B. Te same liczby losowe, ale inne – równie obronione – rozkłady dają P(NPV < 0) od 30.0% (nakład symetryczny 11–13 mln) do 38.4% (σ popytu 0.30 zamiast 0.20). Rozpiętość 8.4 punktu procentowego jest wielokrotnie większa niż błąd Monte Carlo (ok. 0.5 pp). Milion symulacji nie naprawi rozkładu wziętego z sufitu: zwiększa tylko precyzję odpowiedzi na źle postawione pytanie.
Jak może zmylić. Wynik „33.5%” wygląda dokładnie; bez panelu B nie widać, że niepewność samych założeń jest dużo większa.
Podpis do pracy:
Co z tym zrobić w firmie
- Raportuj rozkład, nie jedną liczbę. Zarząd powinien zobaczyć: NPV deterministyczne 4.25 mln zł, średnie 2.57 mln zł, jedną trzecią szans na stratę i P5 = −7.14 mln zł.
- Kupuj informację tam, gdzie wskazuje tornado. Popyt i koszt mleka odpowiadają za ok. 85% sumy ρ². Pilotaż w kilku sieciach lub kontrakt na dostawy mleka zmniejszy ryzyko bardziej niż negocjowanie nakładu.
- Rozważ mniejszą skalę albo etapy. Moc linii obcina dobre scenariusze; jeśli rynek okaże się duży, rozbudowa później może być tańsza niż ryzyko całej inwestycji dziś.
- Ustal korelacje z danymi z przeszłości (np. ceny i wolumeny podobnych produktów), a nie z intuicji – zmieniają ogony rozkładu.
- Powiąż wynik z progiem decyzji. Czy 33.5% szans na stratę jest do przyjęcia, zależy od skali firmy i innych projektów – to decyzja zarządu, nie statystyki.
Podobną logikę – niepewny popyt zamieniony w rozkład i decyzję – znajdziesz we wpisie zapasy przy niepewnym popycie, a pomiar reakcji rynku na ogłoszenia spółek – w badaniu zdarzeń (event study).
Jak opisać w pracy
Symulacja NPV pasuje do prac z finansów przedsiębiorstw, zarządzania projektami i controllingu (zob. statystyka w pracy z zarządzania i ekonomii oraz w pracy z finansów i rachunkowości). Briggs i in. (2012) traktują szacowanie parametrów i ich niepewności jako jeden proces i zalecają raportować niepewność zarówno deterministyczną analizą wrażliwości, jak i metodami probabilistycznymi. W Metodzie podaj: strukturę modelu, rozkłady i ich źródła, korelacje, liczbę symulacji, ziarno i oprogramowanie.
W Wynikach użyj zdań spod rysunków 3–5, a w ograniczeniach napisz wprost, że rozkłady pochodzą z ocen eksperckich i że inne uzasadnione rozkłady dawały P(NPV < 0) od 30.0% do 38.4%. Wskazówki co do struktury całej pracy – we wpisie jak napisać pracę z zarządzania i ekonomii.
Kod R: model NPV, symulacja Monte Carlo, tornado i korelacja
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków w bazowym R i ggplot2 – bez pakietów do symulacji ryzyka (rozkład trójkątny i korelację rang liczymy ręcznie). Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i funkcję npv(), przepis 2 – rozkłady, przepis 3 – symulacje, z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 3, 5 i 6; każdy zaczyna losowanie od własnego set.seed() (640, 6401 i 640 – przepis 6 odtwarza te same liczby losowe co przepis 3). Ziaren nie zmienialiśmy po pierwszym uruchomieniu. Ręcznie ustalono wszystkie parametry modelu i rozkładów (podane w przepisach 1–2 i na początku wpisu), liczbę symulacji (10 000), korelacje ±0.5 i warianty alternatywnych rozkładów w przepisie 6. Całość liczy się w kilka sekund.
1. Paleta, model i NPV deterministyczne: Rysunek 1
R
# Rysunek 1. Fikcyjny zakład mleczarski: model opłacalności nowej linii do jogurtu pitnego i NPV deterministyczne
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Założenia stałe (ustalone ręcznie): 8 lat, rozruch 60% / 85% / 100%, moc linii 11 mln opakowań rocznie,
# inne koszty zmienne (opakowanie, energia) 0.45 zł/szt., koszty stałe 3.2 mln zł/rok, CIT 19%,
# amortyzacja liniowa przez 8 lat, stopa dyskontowa 9%
stale <- list(lata = 8, rozruch = c(0.60, 0.85, rep(1, 6)), moc = 11, inne = 0.45, koszty_stale = 3.2,
              cit = 0.19, stopa = 0.09)
# Wartości bazowe czterech niepewnych założeń (najbardziej prawdopodobne według działu sprzedaży i zakupów)
baza <- c(naklad = 12, popyt = 9.5, cena = 2.15, mleko = 0.95)   # mln zł; mln szt./rok; zł/szt.; zł/szt.

# Przepływy pieniężne projektu (mln zł) – działa na wektorach, więc posłuży też symulacji
przeplywy <- function(naklad, popyt, cena, mleko, s = stale) {
  q <- outer(pmin(popyt, s$moc), s$rozruch)                # sprzedaż w latach 1–8 (mln szt.)
  ebitda <- q * (cena - mleko - s$inne) - s$koszty_stale
  podatek <- pmax(0, s$cit * (ebitda - naklad / s$lata))  # podatek od zysku po amortyzacji (bez ujemnego)
  ebitda - podatek                                         # macierz: wiersz = scenariusz, kolumna = rok
}
npv <- function(naklad, popyt, cena, mleko, stopa = stale$stopa, s = stale) {
  cf <- przeplywy(naklad, popyt, cena, mleko, s)
  -naklad + as.vector(cf %*% (1 + stopa)^-seq_len(s$lata))
}

# NPV deterministyczne: jedna liczba z wartości bazowych
cf_baza <- as.vector(przeplywy(baza[["naklad"]], baza[["popyt"]], baza[["cena"]], baza[["mleko"]]))
tabela <- data.frame(rok = 0:8, sprzedaz_mln_szt = c(0, baza[["popyt"]] * stale$rozruch),
                     przeplyw = c(-baza[["naklad"]], cf_baza))
tabela$zdyskontowany <- tabela$przeplyw / (1 + stale$stopa)^tabela$rok
print(round(tabela, 2), row.names = FALSE)
npv_det <- npv(baza[["naklad"]], baza[["popyt"]], baza[["cena"]], baza[["mleko"]])
irr <- uniroot(function(r) npv(baza[["naklad"]], baza[["popyt"]], baza[["cena"]], baza[["mleko"]], stopa = r), c(0, 1))$root
data.frame(npv_deterministyczne_mln_zl = round(npv_det, 2), irr_proc = round(100 * irr, 1),
           marza_jednostkowa_zl = baza[["cena"]] - baza[["mleko"]] - stale$inne)

# Rysunek 1: schemat modelu – założenia niepewne i stałe → przepływy roczne → NPV → rozkład NPV
pola <- data.frame(
  x = c(1, 1, 1, 1, 1, 4, 4, 7, 7),
  y = c(8.2, 6.6, 5.0, 3.4, 1.3, 5.8, 2.6, 5.8, 2.6),
  w = c(2.6, 2.6, 2.6, 2.6, 2.6, 2.4, 2.4, 2.4, 2.4), h = c(1.3, 1.3, 1.3, 1.3, 2.0, 2.2, 2.2, 2.2, 2.2),
  rodzaj = c(rep("założenie niepewne (losowane)", 4), "założenia stałe", rep("obliczenie", 4)),
  tekst = c("Nakład inwestycyjny\ntrójkątny (11, 12, 15) mln zł",
            "Popyt (mln opakowań/rok)\nlognormalny, mediana 9.5",
            "Cena hurtowa netto\ntrójkątny (2.00, 2.15, 2.25) zł",
            "Koszt mleka na opakowanie\nlognormalny, mediana 0.95 zł",
            "Stałe: moc 11 mln szt., rozruch\n60/85/100%, inne koszty 0.45 zł/szt.,\nkoszty stałe 3.2 mln zł, CIT 19%,\n8 lat, stopa 9%",
            "Przepływy w latach 1–8\nsprzedaż × marża\n− koszty stałe − podatek",
            "Jedno losowanie\nczterech założeń =\njeden scenariusz;\npowtórz 10 000 razy",
            "NPV = −nakład +\nsuma przepływów\n/ (1 + r)^t",
            "10 000 wartości NPV\n→ histogram,\nP(NPV < 0)"))
strzalki <- data.frame(x = c(2.3, 2.3, 2.3, 2.3, 2.3, 5.2, 7, 5.2), y = c(8.2, 6.6, 5.0, 3.4, 1.3, 5.8, 4.7, 2.6),
                       xend = c(2.8, 2.8, 2.8, 2.8, 2.8, 5.8, 7, 5.8), yend = c(6.5, 6.1, 5.7, 5.3, 5.0, 5.8, 3.7, 2.6))
p1 <- ggplot(pola) +
  geom_rect(aes(xmin = x - w / 2, xmax = x + w / 2, ymin = y - h / 2, ymax = y + h / 2, fill = rodzaj),
            colour = "grey35", linewidth = 0.4) +
  geom_text(aes(x, y, label = tekst), size = 3.5, lineheight = 0.95, colour = "grey10") +
  geom_segment(data = strzalki, aes(x = x, y = y, xend = xend, yend = yend),
               arrow = arrow(length = unit(0.18, "cm"), type = "closed"), colour = "grey30", linewidth = 0.5) +
  scale_fill_manual(values = c("założenie niepewne (losowane)" = "#F6C9A9", "założenia stałe" = "grey90",
                               "obliczenie" = "#CFE3F2"), name = NULL) +
  coord_cartesian(xlim = c(-0.4, 8.3), ylim = c(0.2, 9)) +
  labs(title = "Model opłacalności linii do jogurtu pitnego: od założeń do rozkładu NPV") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
p1   # zapis: ggsave("npv-monte-carlo-schemat-modelu.svg", p1, width = 10, height = 6)
Wynik w R
 rok sprzedaz_mln_szt przeplyw zdyskontowany
   0             0.00   -12.00        -12.00
   1             5.70     1.08          0.99
   2             8.07     2.60          2.19
   3             9.50     3.46          2.68
   4             9.50     3.46          2.45
   5             9.50     3.46          2.25
   6             9.50     3.46          2.07
   7             9.50     3.46          1.90
   8             9.50     3.46          1.74
  npv_deterministyczne_mln_zl irr_proc marza_jednostkowa_zl
1                        4.25     16.8                 0.75
2. Rozkłady założeń, w tym trójkątny liczony ręcznie: Rysunek 2
R
# Rysunek 2. Rozkłady czterech niepewnych założeń (wzory, bez losowania); wymaga obiektów z przepisu 1
# Rozkład trójkątny (min a, moda c, max b) liczony ręcznie: gęstość, dystrybuanta odwrotna i średnia
dtri <- function(x, a, c, b) ifelse(x < a | x > b, 0, ifelse(x < c, 2 * (x - a) / ((b - a) * (c - a)),
                                                               2 * (b - x) / ((b - a) * (b - c))))
qtri <- function(u, a, c, b) {
  Fc <- (c - a) / (b - a)
  ifelse(u < Fc, a + sqrt(u * (b - a) * (c - a)), b - sqrt((1 - u) * (b - a) * (b - c)))
}
# Parametry rozkładów (ustalone ręcznie): nakład – ryzyko przekroczenia kosztorysu, cena – presja sieci handlowych,
# popyt i koszt mleka – zmiany mnożące się (procentowe), więc lognormalne z medianą = wartość bazowa
rozklady <- list(
  naklad = list(typ = "trójkątny", a = 11, c = 12, b = 15),
  popyt  = list(typ = "lognormalny", mediana = 9.5, sigma = 0.20),
  cena   = list(typ = "trójkątny", a = 2.00, c = 2.15, b = 2.25),
  mleko  = list(typ = "lognormalny", mediana = 0.95, sigma = 0.08))
kwantyl <- function(r, u) if (r$typ == "trójkątny") qtri(u, r$a, r$c, r$b) else qlnorm(u, log(r$mediana), r$sigma)
srednia <- function(r) if (r$typ == "trójkątny") (r$a + r$b + r$c) / 3 else r$mediana * exp(r$sigma^2 / 2)
gestosc <- function(r, x) if (r$typ == "trójkątny") dtri(x, r$a, r$c, r$b) else dlnorm(x, log(r$mediana), r$sigma)

podsum <- do.call(rbind, lapply(names(rozklady), function(n) {
  r <- rozklady[[n]]
  data.frame(zalozenie = n, rozklad = r$typ, baza = baza[[n]], P10 = kwantyl(r, 0.1), mediana = kwantyl(r, 0.5),
             srednia = srednia(r), P90 = kwantyl(r, 0.9))
}))
print(podsum, digits = 3, row.names = FALSE)

# Rysunek 2: gęstości z zaznaczonym przedziałem P10–P90, wartością bazową i średnią
etyk <- c(naklad = "A. Nakład (mln zł) – trójkątny", popyt = "B. Popyt (mln szt./rok) – lognormalny",
          cena = "C. Cena (zł/szt.) – trójkątny", mleko = "D. Koszt mleka (zł/szt.) – lognormalny")
krzywe <- do.call(rbind, lapply(names(rozklady), function(n) {
  r <- rozklady[[n]]; x <- seq(kwantyl(r, 0.0005), kwantyl(r, 0.9995), length.out = 300)
  data.frame(zalozenie = etyk[[n]], x, g = gestosc(r, x), w_80 = x >= kwantyl(r, 0.1) & x <= kwantyl(r, 0.9))
}))
linie <- data.frame(zalozenie = rep(etyk[podsum$zalozenie], 2), x = c(podsum$baza, podsum$srednia),
                    miara = rep(c("wartość bazowa (moda / mediana)", "średnia rozkładu"), each = 4))
p2 <- ggplot(krzywe, aes(x, g)) +
  geom_area(data = subset(krzywe, w_80), fill = "#CFE3F2") +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_vline(data = linie, aes(xintercept = x, linetype = miara, colour = miara), linewidth = 0.7) +
  scale_colour_manual(values = c("wartość bazowa (moda / mediana)" = kol[["ciemny"]], "średnia rozkładu" = kol[["cynober"]]),
                      name = NULL) +
  scale_linetype_manual(values = c("wartość bazowa (moda / mediana)" = "solid", "średnia rozkładu" = "22"), name = NULL) +
  facet_wrap(~ zalozenie, scales = "free", ncol = 2) +
  labs(x = NULL, y = "Gęstość", title = "Cztery niepewne założenia (jasne pole: 80% najbardziej prawdopodobnych wartości)") +
  motyw + theme(axis.text.y = element_blank())
p2   # zapis: ggsave("npv-monte-carlo-rozklady-zalozen.svg", p2, width = 10, height = 7)
Wynik w R
 zalozenie     rozklad  baza    P10 mediana srednia   P90
    naklad   trójkątny 12.00 11.632   12.55  12.667 13.90
     popyt lognormalny  9.50  7.352    9.50   9.692 12.28
      cena   trójkątny  2.15  2.061    2.14   2.133  2.20
     mleko lognormalny  0.95  0.857    0.95   0.953  1.05
3. 10 000 symulacji NPV: Rysunek 3
R
# Rysunek 3. 10 000 symulacji Monte Carlo: rozkład NPV i P(NPV < 0) z błędem Monte Carlo; wymaga przepisów 1–2
set.seed(640)
R <- 10000
losuj <- function(R) {                        # cztery założenia losowane niezależnie metodą odwrotnej dystrybuanty
  u <- matrix(runif(4 * R), ncol = 4)
  data.frame(naklad = kwantyl(rozklady$naklad, u[, 1]), popyt = kwantyl(rozklady$popyt, u[, 2]),
             cena = kwantyl(rozklady$cena, u[, 3]), mleko = kwantyl(rozklady$mleko, u[, 4]))
}
sym <- losuj(R)
sym$npv <- npv(sym$naklad, sym$popyt, sym$cena, sym$mleko)
write.csv(round(sym, 4), "npv-monte-carlo-symulacje.csv", row.names = FALSE)

p_strata <- mean(sym$npv < 0)
se_p <- sqrt(p_strata * (1 - p_strata) / R)                   # błąd Monte Carlo odsetka
data.frame(npv_deterministyczne = round(npv_det, 2),
           npv_przy_srednich_zalozen = round(npv(srednia(rozklady$naklad), srednia(rozklady$popyt),
                                                 srednia(rozklady$cena), srednia(rozklady$mleko)), 2),
           srednia_npv = round(mean(sym$npv), 2), se_sredniej = round(sd(sym$npv) / sqrt(R), 3),
           mediana_npv = round(median(sym$npv), 2), sd_npv = round(sd(sym$npv), 2))
data.frame(P5 = round(quantile(sym$npv, 0.05), 2), P95 = round(quantile(sym$npv, 0.95), 2),
           P_npv_ujemne_proc = round(100 * p_strata, 1), blad_MC_pp = round(100 * se_p, 2),
           CI95_dol = round(100 * (p_strata - 1.96 * se_p), 1), CI95_gora = round(100 * (p_strata + 1.96 * se_p), 1),
           sredni_niedobor_gdy_strata = round(mean(sym$npv[sym$npv < 0]), 2),
           popyt_powyzej_mocy_proc = round(100 * mean(sym$popyt > stale$moc), 1), row.names = NULL)

# Rysunek 3: histogram NPV; scenariusze ze stratą w kolorze cynobrowym, linie: NPV deterministyczne i średnia
sym$wynik <- factor(ifelse(sym$npv < 0, "NPV < 0 (projekt nie zwraca kosztu kapitału)", "NPV ≥ 0"),
                    levels = c("NPV < 0 (projekt nie zwraca kosztu kapitału)", "NPV ≥ 0"))
p3 <- ggplot(sym, aes(npv, fill = wynik)) +
  geom_histogram(binwidth = 1, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = npv_det, colour = kol[["ciemny"]], linewidth = 0.8) +
  geom_vline(xintercept = mean(sym$npv), colour = kol[["ciemny"]], linewidth = 0.8, linetype = "22") +
  annotate("label", x = npv_det + 0.4, y = Inf, vjust = 1.3, hjust = 0, size = 3.4, border.colour = NA,
           label = sprintf("NPV z wartości bazowych: %.2f mln zł", npv_det)) +
  annotate("label", x = mean(sym$npv) - 0.4, y = Inf, vjust = 2.9, hjust = 1, size = 3.4, border.colour = NA,
           label = sprintf("średnia z 10 000 symulacji: %.2f mln zł", mean(sym$npv))) +
  annotate("label", x = -11, y = Inf, vjust = 4.6, hjust = 0, size = 3.6, border.colour = NA, colour = kol[["cynober"]],
           label = sprintf("P(NPV < 0) = %.1f%%\n(błąd MC ± %.1f pp)", 100 * p_strata, 100 * se_p)) +
  scale_fill_manual(values = c("NPV < 0 (projekt nie zwraca kosztu kapitału)" = kol[["cynober"]], "NPV ≥ 0" = kol[["niebieski"]]),
                    name = NULL) +
  scale_x_continuous(breaks = seq(-15, 20, 5)) +
  scale_y_continuous(expand = expansion(mult = c(0.01, 0.22))) +
  labs(x = "NPV (mln zł)", y = "Liczba symulacji (z 10 000)",
       title = "Rozkład NPV linii do jogurtu pitnego w 10 000 symulacjach") +
  motyw
p3   # zapis: ggsave("npv-monte-carlo-histogram.svg", p3, width = 10, height = 5.6)
Wynik w R
  npv_deterministyczne npv_przy_srednich_zalozen srednia_npv se_sredniej
1                 4.25                      3.46        2.57       0.058
  mediana_npv sd_npv
1        2.64   5.81
     P5   P95 P_npv_ujemne_proc blad_MC_pp CI95_dol CI95_gora
1 -7.14 11.87              33.5       0.47     32.5      34.4
  sredni_niedobor_gdy_strata popyt_powyzej_mocy_proc
1                      -3.88                    23.5
4. Wykres tornado i korelacja rang: Rysunek 4
R
# Rysunek 4. Wykres tornado (jedno założenie naraz, P10–P90) i korelacje rang z NPV z symulacji; wymaga przepisów 1–3
library(patchwork)
nazwy <- c(naklad = "Nakład inwestycyjny", popyt = "Popyt", cena = "Cena hurtowa", mleko = "Koszt mleka",
           stopa = "Stopa dyskontowa (7–11%)")
# Każde założenie przesuwamy od P10 do P90 jego rozkładu, pozostałe zostają na wartościach bazowych;
# stopę dyskontową (decyzja zarządu, nie losowana) zmieniamy od 7% do 11%
tornado <- do.call(rbind, lapply(names(nazwy), function(n) {
  wynik <- sapply(1:2, function(k) {
    x <- as.list(baza); stopa <- stale$stopa
    if (n == "stopa") stopa <- c(0.07, 0.11)[k] else x[[n]] <- kwantyl(rozklady[[n]], c(0.1, 0.9)[k])
    npv(x$naklad, x$popyt, x$cena, x$mleko, stopa = stopa)
  })
  data.frame(zalozenie = nazwy[[n]], npv_przy_dolnej = wynik[1], npv_przy_gornej = wynik[2],
             rozpietosc = abs(wynik[2] - wynik[1]))
}))
tornado <- tornado[order(-tornado$rozpietosc), ]
print(cbind(tornado[1], round(tornado[-1], 2)), row.names = FALSE)

# Korelacja rang (Spearmana) każdego założenia z NPV w 10 000 symulacjach i udział w sumie kwadratów korelacji
rho <- sapply(names(rozklady), function(n) cor(sym[[n]], sym$npv, method = "spearman"))
wklad <- data.frame(zalozenie = unname(nazwy[names(rho)]), rho_spearmana = round(unname(rho), 3),
                    udzial_proc = round(100 * unname(rho)^2 / sum(rho^2), 1))
print(wklad[order(-abs(wklad$rho_spearmana)), ], row.names = FALSE)

# Rysunek 4A: tornado – słupek od NPV przy wartości „niższej” do NPV przy „wyższej”, pionowa linia: NPV bazowe
td <- rbind(data.frame(zalozenie = tornado$zalozenie, od = npv_det, do = tornado$npv_przy_dolnej,
                       koniec = "dolna wartość założenia (P10; stopa 7%)"),
            data.frame(zalozenie = tornado$zalozenie, od = npv_det, do = tornado$npv_przy_gornej,
                       koniec = "górna wartość założenia (P90; stopa 11%)"))
td$zalozenie <- factor(td$zalozenie, levels = rev(tornado$zalozenie))
p4a <- ggplot(td, aes(y = zalozenie)) +
  geom_rect(aes(xmin = pmin(od, do), xmax = pmax(od, do), ymin = as.numeric(zalozenie) - 0.35,
                ymax = as.numeric(zalozenie) + 0.35, fill = koniec)) +
  geom_vline(xintercept = npv_det, colour = kol[["ciemny"]], linewidth = 0.7) +
  geom_vline(xintercept = 0, colour = kol[["cynober"]], linetype = "22") +
  geom_text(aes(x = do, label = sub("-", "−", sprintf("%.1f", do)), hjust = ifelse(do < npv_det, 1.15, -0.15)), size = 3.3) +
  scale_fill_manual(values = c("dolna wartość założenia (P10; stopa 7%)" = kol[["pomarancz"]],
                               "górna wartość założenia (P90; stopa 11%)" = kol[["niebieski"]]), name = NULL) +
  scale_x_continuous(expand = expansion(mult = 0.15)) +
  labs(x = "NPV (mln zł)", y = NULL, title = "A. Tornado: jedno założenie naraz") +
  motyw + guides(fill = guide_legend(ncol = 1))
# Rysunek 4B: korelacja rang z NPV (znak = kierunek wpływu)
wklad$zalozenie <- factor(wklad$zalozenie, levels = wklad$zalozenie[order(abs(wklad$rho_spearmana))])
p4b <- ggplot(wklad, aes(rho_spearmana, zalozenie)) +
  geom_col(aes(fill = rho_spearmana > 0), width = 0.7) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_text(aes(label = sub("-", "−", sprintf("%.2f (%.0f%%)", rho_spearmana, udzial_proc)),
                hjust = ifelse(rho_spearmana > 0, -0.1, 1.1)), size = 3.3) +
  scale_fill_manual(values = c("TRUE" = kol[["niebieski"]], "FALSE" = kol[["pomarancz"]]), guide = "none") +
  scale_x_continuous(limits = c(-1.4, 1.6), breaks = seq(-1, 1, 0.5)) +
  labs(x = "Korelacja rang z NPV (udział w sumie ρ²)", y = NULL,
       title = "B. Wszystkie założenia naraz") +
  motyw
p4 <- p4a + p4b + plot_layout(widths = c(1.15, 1))
p4   # zapis: ggsave("npv-monte-carlo-tornado.svg", p4, width = 10, height = 5.4)
Wynik w R
                zalozenie npv_przy_dolnej npv_przy_gornej rozpietosc
                    Popyt           -2.50            8.92      11.42
              Koszt mleka            7.92            0.17       7.75
             Cena hurtowa            0.72            6.24       5.52
 Stopa dyskontowa (7–11%)            5.70            2.97       2.72
      Nakład inwestycyjny            4.58            2.56       2.02
           zalozenie rho_spearmana udzial_proc
               Popyt         0.755        59.5
         Koszt mleka        -0.495        25.6
        Cena hurtowa         0.357        13.3
 Nakład inwestycyjny        -0.124         1.6
5. Korelacja ceny i popytu: Rysunek 5
R
# Rysunek 5. Korelacja ceny i popytu zmienia ryzyko projektu; wymaga przepisów 1–3
# Metoda w duchu Imana i Conovera: rozkłady brzegowe zostają te same, zmieniamy tylko kolejność (rangi)
# wylosowanych wartości tak, by naśladowała rangi skorelowanych zmiennych normalnych
set.seed(6401)
z1 <- rnorm(R); e <- rnorm(R)
koreluj <- function(rho_s) {
  r_n <- 2 * sin(pi * rho_s / 6)                          # korelacja Pearsona normalnych dająca rho Spearmana
  z2 <- r_n * z1 + sqrt(1 - r_n^2) * e
  d <- sym[, c("naklad", "popyt", "cena", "mleko")]
  d$popyt <- sort(sym$popyt)[rank(z1)]                    # te same 10 000 wartości popytu w nowej kolejności
  d$cena  <- sort(sym$cena)[rank(z2)]                     # te same 10 000 wartości ceny w nowej kolejności
  d$npv <- npv(d$naklad, d$popyt, d$cena, d$mleko)
  d
}
warianty <- list("cena i popyt niezależne (ρ = 0)" = sym,
                 "ρ = −0.5: wyższa cena, mniejszy popyt" = koreluj(-0.5),
                 "ρ = +0.5: dobry rok – wyższa cena i popyt" = koreluj(0.5))
wyniki_kor <- do.call(rbind, lapply(names(warianty), function(n) {
  d <- warianty[[n]]; p <- mean(d$npv < 0)
  data.frame(wariant = n, rho_uzyskane = round(cor(d$cena, d$popyt, method = "spearman"), 3),
             srednia = round(mean(d$npv), 2), sd = round(sd(d$npv), 2), P5 = round(quantile(d$npv, 0.05), 2),
             P_ponizej_minus5_proc = round(100 * mean(d$npv < -5), 1),
             P_ujemne_proc = round(100 * p, 1), blad_MC_pp = round(100 * sqrt(p * (1 - p) / R), 2), row.names = NULL)
}))
print(wyniki_kor, row.names = FALSE)

# Rysunek 5: dystrybuanty empiryczne NPV w trzech wariantach; odczyt na osi pionowej przy NPV = 0 to P(NPV < 0)
opis <- sub("= -", "= −", sprintf("%s: P(NPV < 0) = %.1f%%, P5 = %.1f mln zł", names(warianty), wyniki_kor$P_ujemne_proc, wyniki_kor$P5))
siatka <- seq(-15, 18, by = 0.1)                          # dystrybuanta liczona w punktach siatki (mniejszy plik)
ecdf_d <- do.call(rbind, lapply(seq_along(warianty), function(i)
  data.frame(wariant = opis[i], npv = siatka, F = ecdf(warianty[[i]]$npv)(siatka))))
ecdf_d$wariant <- factor(ecdf_d$wariant, levels = opis)
p5 <- ggplot(ecdf_d, aes(npv, F, colour = wariant, linetype = wariant)) +
  geom_line(linewidth = 0.9) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_hline(yintercept = 0.05, colour = "grey60", linetype = "dotted") +
  annotate("text", x = -14.8, y = 0.08, label = "5% najgorszych scenariuszy (P5)", hjust = 0, size = 3.3, colour = "grey30") +
  scale_colour_manual(values = unname(kol[c("ciemny", "niebieski", "cynober")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "22", "42"), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  coord_cartesian(xlim = c(-15, 18)) +
  labs(x = "NPV (mln zł)", y = "Odsetek symulacji z NPV ≤ x",
       title = "Ta sama cena i ten sam popyt, inna korelacja – inne ryzyko") +
  motyw + guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1))
p5   # zapis: ggsave("npv-monte-carlo-korelacja.svg", p5, width = 10, height = 6)
Wynik w R
                                   wariant rho_uzyskane srednia   sd    P5
           cena i popyt niezależne (ρ = 0)        0.031    2.57 5.81 -7.14
     ρ = −0.5: wyższa cena, mniejszy popyt       -0.499    2.43 4.95 -5.66
 ρ = +0.5: dobry rok – wyższa cena i popyt        0.495    2.68 6.41 -8.16
 P_ponizej_minus5_proc P_ujemne_proc blad_MC_pp
                  10.0          33.5       0.47
                   6.5          31.4       0.46
                  12.1          34.2       0.47
6. Błąd Monte Carlo i alternatywne rozkłady: Rysunek 6
R
# Rysunek 6. Fałszywa precyzja: błąd Monte Carlo maleje z liczbą symulacji, ale wybór rozkładów zmienia wynik bardziej
# Wymaga przepisów 1–3
# A: oszacowanie P(NPV < 0) po pierwszych k symulacjach z pasmem ±1.96 błędu Monte Carlo
k <- seq_len(R)
bieg <- data.frame(k, p = cumsum(sym$npv < 0) / k)
bieg$se <- sqrt(bieg$p * (1 - bieg$p) / k)
print(bieg[c(100, 1000, 10000), ], digits = 3, row.names = FALSE)

# B: te same 10 000 liczb losowych (u), inne założenia o rozkładach – „co by było, gdyby analityk przyjął…”
set.seed(640)
u <- matrix(runif(4 * R), ncol = 4)                      # identyczne jak w przepisie 3
p_wariant <- function(zm = list()) {
  r <- modifyList(rozklady, zm)
  q <- function(n, j) if (is.function(r[[n]])) r[[n]](u[, j]) else kwantyl(r[[n]], u[, j])
  v <- npv(q("naklad", 1), q("popyt", 2), q("cena", 3), q("mleko", 4))
  c(p = mean(v < 0), se = sqrt(mean(v < 0) * (1 - mean(v < 0)) / R))
}
sd_popyt <- 9.5 * sqrt((exp(0.2^2) - 1) * exp(0.2^2))  # SD rozkładu lognormalnego popytu z przepisu 2
alternatywy <- list(
  "rozkłady z przepisu 2" = list(),
  "popyt normalny (ta sama mediana i SD)" = list(popyt = function(x) qnorm(x, 9.5, sd_popyt)),
  "popyt lognormalny, σ = 0.30 zamiast 0.20" = list(popyt = list(typ = "lognormalny", mediana = 9.5, sigma = 0.30)),
  "nakład symetryczny (11, 12, 13) mln zł" = list(naklad = list(typ = "trójkątny", a = 11, c = 12, b = 13)),
  "koszt mleka σ = 0.15 zamiast 0.08" = list(mleko = list(typ = "lognormalny", mediana = 0.95, sigma = 0.15)),
  "cena jednostajna 2.00–2.25 zł" = list(cena = function(x) qunif(x, 2.00, 2.25)))
porown <- do.call(rbind, lapply(names(alternatywy), function(n) {
  w <- p_wariant(alternatywy[[n]])
  data.frame(wariant = n, P_ujemne_proc = round(100 * w[["p"]], 1), blad_MC_pp = round(100 * w[["se"]], 2))
}))
print(porown, row.names = FALSE)

punkty <- unique(round(10^seq(log10(50), log10(R), length.out = 400)))   # 400 punktów wystarczy do rysunku
pA <- ggplot(bieg[punkty, ], aes(k, 100 * p)) +
  geom_ribbon(aes(ymin = 100 * (p - 1.96 * se), ymax = 100 * (p + 1.96 * se)), fill = "#CFE3F2") +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.7) +
  scale_x_log10(breaks = c(50, 100, 300, 1000, 3000, 10000), labels = c("50", "100", "300", "1000", "3000", "10 000")) +
  labs(x = "Liczba symulacji (skala logarytmiczna)", y = "P(NPV < 0), %",
       title = "A. Błąd Monte Carlo maleje z liczbą symulacji") + motyw
porown$wariant <- factor(porown$wariant, levels = rev(porown$wariant))
pB <- ggplot(porown, aes(P_ujemne_proc, wariant)) +
  geom_vline(xintercept = porown$P_ujemne_proc[porown$wariant == "rozkłady z przepisu 2"], colour = "grey50", linetype = "22") +
  geom_errorbar(aes(xmin = P_ujemne_proc - 1.96 * blad_MC_pp, xmax = P_ujemne_proc + 1.96 * blad_MC_pp),
                width = 0.25, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 2.6, colour = kol[["cynober"]], shape = 18) +
  geom_text(aes(label = sprintf("%.1f%%", P_ujemne_proc)), vjust = -0.9, size = 3.3) +
  scale_x_continuous(limits = c(15, 50)) +
  labs(x = "P(NPV < 0), % (10 000 symulacji, 95% przedział MC)", y = NULL,
       title = "B. Inny rozkład wejściowy – inne ryzyko") + motyw
p6 <- pA / pB + plot_layout(heights = c(1, 1.15))
p6   # zapis: ggsave("npv-monte-carlo-falszywa-precyzja.svg", p6, width = 10, height = 8.4)
Wynik w R
     k     p      se
   100 0.310 0.04625
  1000 0.334 0.01491
 10000 0.335 0.00472
                                  wariant P_ujemne_proc blad_MC_pp
                    rozkłady z przepisu 2          33.5       0.47
    popyt normalny (ta sama mediana i SD)          35.1       0.48
 popyt lognormalny, σ = 0.30 zamiast 0.20          38.4       0.49
   nakład symetryczny (11, 12, 13) mln zł          30.0       0.46
        koszt mleka σ = 0.15 zamiast 0.08          38.0       0.49
            cena jednostajna 2.00–2.25 zł          36.4       0.48
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (NPV ≥ 0 / NPV < 0; ρ = −0.5 / ρ = +0.5)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (górna / dolna wartość w tornado)" = c("#0072B2", "#E69F00"),
             "ciemnoszary – cynober (ρ = 0 / ρ = +0.5)" = c("#333333", "#D55E00"),
             "jasnopomarańczowy – jasnoniebieski (założenie / obliczenie na schemacie)" = c("#F6C9A9", "#CFE3F2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                         widzenie_typowe
niebieski – cynober (NPV ≥ 0 / NPV < 0; ρ = −0.5 / ρ = +0.5)                       114.6
niebieski – pomarańczowy (górna / dolna wartość w tornado)                         120.2
ciemnoszary – cynober (ρ = 0 / ρ = +0.5)                                            83.4
jasnopomarańczowy – jasnoniebieski (założenie / obliczenie na schemacie)            35.4
czerwony – zielony (do unikania)                                                   121.7
                                                                         deuteranopia
niebieski – cynober (NPV ≥ 0 / NPV < 0; ρ = −0.5 / ρ = +0.5)                    108.3
niebieski – pomarańczowy (górna / dolna wartość w tornado)                      121.5
ciemnoszary – cynober (ρ = 0 / ρ = +0.5)                                         72.7
jasnopomarańczowy – jasnoniebieski (założenie / obliczenie na schemacie)         34.6
czerwony – zielony (do unikania)                                                 21.1
                                                                         protanopia
niebieski – cynober (NPV ≥ 0 / NPV < 0; ρ = −0.5 / ρ = +0.5)                   91.9
niebieski – pomarańczowy (górna / dolna wartość w tornado)                    109.3
ciemnoszary – cynober (ρ = 0 / ρ = +0.5)                                       59.9
jasnopomarańczowy – jasnoniebieski (założenie / obliczenie na schemacie)       29.9
czerwony – zielony (do unikania)                                               31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, kwantyle, korelacje – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Fałszywa precyzja. „P(NPV < 0) = 33.47%” przy rozkładach z jednej rozmowy z kierownikiem. Podawaj błąd MC i analizę alternatywnych rozkładów (rysunek 6).
- Rozkłady „z sufitu”. Rozkład normalny dla nakładu albo symetryczny przedział ±10% „bo tak się robi”. Uzasadnij kształt (asymetria, dodatniość) i źródło granic.
- Wartości bazowe jako średnie. Moda rozkładu trójkątnego nie jest jego średnią; NPV z wartości bazowych nie jest średnim NPV.
- Pominięte korelacje. Niezależność to też założenie – i zwykle nie najlepsze.
- Brak ziarna. Bez niego nikt nie odtworzy wyniku.
- Niepewność stopy dyskontowej losowana razem z przepływami. Stopa wyraża koszt kapitału i wymaganą stopę zwrotu; pokaż jej wpływ osobno (tornado), zamiast mieszać ją z ryzykiem operacyjnym.
Najczęstsze pytania
Jak policzyć prawdopodobieństwo, że NPV będzie ujemne?
Przypisz niepewnym założeniom rozkłady, wylosuj z nich wiele scenariuszy (np. 10 000), dla każdego policz NPV i sprawdź, jaki odsetek wyników jest mniejszy od zera. Podaj też błąd Monte Carlo √(p(1 − p)/R): w przykładzie 33.5% ± 0.47 pp.
Dlaczego średnie NPV z symulacji jest inne niż NPV z biznesplanu?
Bo w biznesplanie wpisuje się zwykle wartości najbardziej prawdopodobne (mody, mediany), a nie średnie, a model bywa nieliniowy – np. moc produkcyjna ucina dobre scenariusze, a podatek działa tylko przy zysku. W przykładzie NPV z wartości bazowych wynosiło 4.25 mln zł, a średnie z symulacji 2.57 mln zł.
Jaki rozkład przyjąć dla założeń w symulacji Monte Carlo?
Taki, który oddaje kształt niepewności: rozkład trójkątny, gdy ekspert podaje minimum, wartość najbardziej prawdopodobną i maksimum (Johnson, 1997), lognormalny dla wielkości dodatnich zmieniających się procentowo. Uzasadnij wybór i sprawdź, jak bardzo wynik zmienia się przy innych rozsądnych rozkładach.
Czym różni się wykres tornado od symulacji Monte Carlo?
Wykres tornado zmienia jedno założenie naraz przy pozostałych na wartościach bazowych i pokazuje, które z nich najbardziej przesuwa wynik. Symulacja zmienia wszystkie naraz i daje cały rozkład NPV. Wkład założeń w symulacji oceń korelacją rang z NPV (Helton i Davis, 2002).
Ile symulacji Monte Carlo wystarczy?
Tyle, by błąd Monte Carlo był mały wobec różnic, które mają znaczenie dla decyzji. Dla odsetka bliskiego 33% błąd wynosi ok. 4.6 pp przy 100 symulacjach, 1.5 pp przy 1000 i 0.47 pp przy 10 000. Większa liczba symulacji nie poprawi jednak źle dobranych rozkładów.
Powiązane hasła
Przeczytaj też
Jak zaplanować badanie symulacyjne
Schemat ADEMP krok po kroku: cele, dane, estymandy, metody i miary jakości z błędem Monte Carlo, liczba powtórzeń i ziarna w SimDesign.
Czytaj →PoradnikModel gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →PoradnikBadanie zdarzeń (event study)
60 fikcyjnych ogłoszeń skupu akcji: model rynkowy, AR i CAR z przedziałami, testy t, BMP i bootstrap oraz fałszywe alarmy przy wspólnej dacie zdarzenia.
Czytaj →PoradnikWielkość rynku z ankiety
Abonament na sprzątanie mieszkań: rynek jako iloczyn, raking próby online, bootstrap iloczynu, tornado i kontrola top-down – pięć rysunków z kodem R.
Czytaj →PoradnikPróg rentowności z niepewnością
Ile myć pokryje koszty nowej myjni i jak często 1. rok kończy się stratą? Próg ze wzoru, 10 000 scenariuszy, czas zwrotu i tornado – z kodem R.
Czytaj →Piszesz pracę o opłacalności inwestycji?
Pomożemy zbudować model NPV, uzasadnić rozkłady założeń, przeprowadzić symulację Monte Carlo i analizę wrażliwości oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Briggs, A. H., Weinstein, M. C., Fenwick, E. A. L., Karnon, J., Sculpher, M. J., & Paltiel, A. D. (2012). Model parameter estimation and uncertainty analysis. Medical Decision Making, 32(5), 722–732. https://doi.org/10.1177/0272989x12458348 ● Otwarty dostęp
- Eschenbach, T. G. (1992). Spiderplots versus tornado diagrams for sensitivity analysis. Interfaces, 22(6), 40–46. https://doi.org/10.1287/inte.22.6.40
- Helton, J. C., & Davis, F. J. (2002). Illustration of sampling-based methods for uncertainty and sensitivity analysis. Risk Analysis, 22(3), 591–622. https://doi.org/10.1111/0272-4332.00041 ● Otwarty dostęp
- Iman, R. L., & Conover, W. J. (1982). A distribution-free approach to inducing rank correlation among input variables. Communications in Statistics – Simulation and Computation, 11(3), 311–334. https://doi.org/10.1080/03610918208812265
- Johnson, D. (1997). The triangular distribution as a proxy for the beta distribution in risk analysis. Journal of the Royal Statistical Society: Series D (The Statistician), 46(3), 387–398. https://doi.org/10.1111/1467-9884.00091
- Limpert, E., Stahel, W. A., & Abbt, M. (2001). Log-normal distributions across the sciences: Keys and clues. BioScience, 51(5), 341–352. https://doi.org/10.1641/0006-3568(2001)051[0341:lndats]2.0.co;2
- Morris, T. P., White, I. R., & Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. https://doi.org/10.1002/sim.8086 ● Otwarty dostęp
- Saltelli, A., Aleksankina, K., Becker, W., Fennell, P., Ferretti, F., Holst, N., Li, S., & Wu, Q. (2019). Why so many published sensitivity analyses are false: A systematic review of sensitivity analysis practices. Environmental Modelling & Software, 114, 29–39. https://doi.org/10.1016/j.envsoft.2019.01.012 ● Otwarty dostęp
Cytowania BibTeX
@article{briggs2012model, author={Briggs, Andrew H. and Weinstein, Milton C. and Fenwick, Elisabeth A. L. and Karnon, Jonathan and Sculpher, Mark J. and Paltiel, A. David}, title={{Model parameter estimation and uncertainty analysis}}, journal={Medical Decision Making}, year={2012}, volume={32}, number={5}, pages={722--732}, doi={10.1177/0272989x12458348}}@article{eschenbach1992spiderplots, author={Eschenbach, Ted G.}, title={{Spiderplots versus tornado diagrams for sensitivity analysis}}, journal={Interfaces}, year={1992}, volume={22}, number={6}, pages={40--46}, doi={10.1287/inte.22.6.40}}@article{helton2002illustration, author={Helton, J. C. and Davis, F. J.}, title={{Illustration of sampling-based methods for uncertainty and sensitivity analysis}}, journal={Risk Analysis}, year={2002}, volume={22}, number={3}, pages={591--622}, doi={10.1111/0272-4332.00041}}@article{iman1982distribution, author={Iman, Ronald L. and Conover, W. J.}, title={{A distribution-free approach to inducing rank correlation among input variables}}, journal={Communications in Statistics – Simulation and Computation}, year={1982}, volume={11}, number={3}, pages={311--334}, doi={10.1080/03610918208812265}}@article{johnson1997triangular, author={Johnson, David}, title={{The triangular distribution as a proxy for the beta distribution in risk analysis}}, journal={Journal of the Royal Statistical Society: Series D (The Statistician)}, year={1997}, volume={46}, number={3}, pages={387--398}, doi={10.1111/1467-9884.00091}}@article{limpert2001log, author={Limpert, Eckhard and Stahel, Werner A. and Abbt, Markus}, title={{Log-normal distributions across the sciences: Keys and clues}}, journal={BioScience}, year={2001}, volume={51}, number={5}, pages={341--352}, doi={10.1641/0006-3568(2001)051[0341:lndats]2.0.co;2}}@article{morris2019using, author={Morris, Tim P. and White, Ian R. and Crowther, Michael J.}, title={{Using simulation studies to evaluate statistical methods}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={11}, pages={2074--2102}, doi={10.1002/sim.8086}}@article{saltelli2019why, author={Saltelli, Andrea and Aleksankina, Ksenia and Becker, William and Fennell, Pamela and Ferretti, Federico and Holst, Niels and Li, Sushan and Wu, Qiongli}, title={{Why so many published sensitivity analyses are false: A systematic review of sensitivity analysis practices}}, journal={Environmental Modelling \& Software}, year={2019}, volume={114}, pages={29--39}, doi={10.1016/j.envsoft.2019.01.012}}