Przykład: abonament na sprzątanie mieszkań w dużym mieście
Fikcyjna firma chce uruchomić abonament na sprzątanie mieszkań w mieście, które ma ok. 600 tys. mieszkańców. Zarząd i inwestor pytają: ile ten rynek jest wart rocznie i jak bardzo możemy się pomylić? Danych sprzedażowych jeszcze nie ma, więc firma zamawia ankietę online w panelu badawczym: 1200 gospodarstw domowych, z każdego jedna osoba. Pytamy o intencję zakupu abonamentu (skala 1–5), a osoby zainteresowane – o to, jak często chciałyby sprzątania i ile zapłaciłyby za jedną wizytę.
Tak powstaje typowy szacunek „od dołu” (bottom-up). Pokażemy, jak policzyć go z przedziałem, który obejmuje wszystkie źródła niepewności, i który składnik waży najwięcej. To kolejna część serii o statystyce w pracy z marketingu.
Dane są fikcyjne, a parametry ustaliliśmy ręcznie: 260 000 gospodarstw w mieście, ich strukturę według wieku osoby odpowiadającej i liczby osób, nadreprezentację młodszych w panelu, model intencji, częstości i kwoty oraz zakres współczynnika k (niżej). Po pierwszym uruchomieniu zwiększyliśmy różnicę intencji między grupami wieku (efekty 1.0 i 0.5 zamiast 0.6 i 0.3) i przesunęliśmy progi skali, żeby efekt ważenia był wyraźny; ziaren (681, 6811 i 6812) nie zmienialiśmy. Odpowiedzi 1200 gospodarstw pobierzesz jako wielkosc-rynku-ankieta.csv (wiersz = gospodarstwo).
Wielkość rynku jako iloczyn czterech liczb
Roczną wartość rynku zapisujemy jako iloczyn:
gdzie N to liczba gospodarstw w mieście (z rejestru), p – odsetek gospodarstw deklarujących zakup (odpowiedź 4 lub 5 na skali 1–5, tzw. top-2-box), k – odsetek deklarujących, którzy naprawdę kupią, a m – średni roczny wydatek zainteresowanego gospodarstwa, czyli średnia z iloczynu „wizyt na rok × zł za wizytę”. Dwa składniki (p, m) mierzy ankieta, N pochodzi z danych zewnętrznych, a k jest założeniem. Ankieta nie mówi, ile deklaracji zamieni się w zakup – o tym, jak to oszacować z danych sprzedaży, piszemy we wpisie o deklaracji zakupu a faktycznym zakupie. Tu przyjmujemy k = 0.35, a jego niepewność opisujemy rozkładem jednostajnym od 0.20 do 0.50.
Morwitz i in. (2007) pokazali, że deklaracje słabiej przewidują zakupy nowych produktów niż istniejących oraz przy pytaniu o konkretną markę niż o całą kategorię. Abonament na sprzątanie to nowa kategoria w tym mieście – dlatego zakres k jest szeroki.
Rysunek 1: ważenie próby internetowej
W panelu internetowym łatwiej o młodszych. W naszej próbie osoby w wieku 18–34 lata stanowią 41%, a w populacji gospodarstw 24%; osoby 55+ – 17% wobec 40%. Młodsi częściej deklarują zakup (32.1% wobec 16.7% wśród 55+), więc surowy odsetek zawyża penetrację. Wagi dopasowujemy rakingiem do dwóch rozkładów brzegowych: wieku i liczby osób w gospodarstwie. Raking nie wymaga znajomości liczebności wszystkich komórek skrzyżowania zmiennych i nie rozbija próby na wiele małych komórek (Battaglia i in., 2009). Cały proces budowy wag opisuje wpis ważenie danych sondażowych krok po kroku.
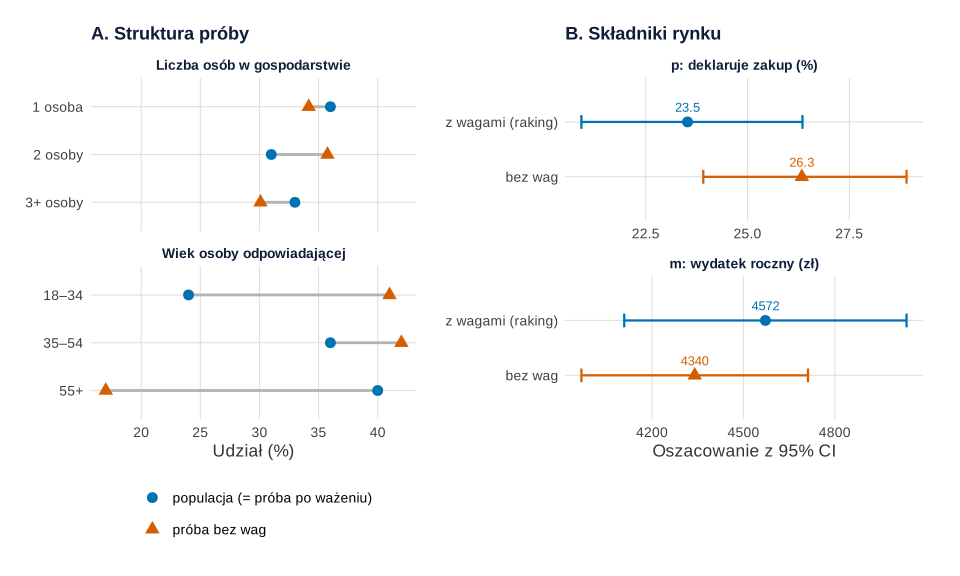
set.seed(681)).Co widać. Po rakingu próba ma dokładnie strukturę populacji. Odsetek deklarujących zakup spada z 26.3% (95% CI [23.9, 28.9]) do 23.5% (95% CI [20.9, 26.4]). Średni roczny wydatek zainteresowanych rośnie z 4340 do 4572 zł (95% CI [4109, 5035]), bo ważenie zmienia też skład grupy zainteresowanych – średnia liczba wizyt rośnie z 23.5 do 24.8 rocznie. Przedziały bez wag i z wagami w dużej części się pokrywają. Wagi wahają się od 103 do 651 gospodarstw na respondenta. Efekt ważenia Kisha wynosi 1.43, czyli 1200 ankiet „waży” tyle co 840 bez wag, a efekt schematu dla odsetka p – 1.28.
Jak może zmylić. Ważenie naprawia strukturę tylko w zmiennych użytych do ważenia. Jeśli w panelu są osoby bardziej otwarte na nowe usługi niż ich rówieśnicy spoza panelu, wagi tego nie poprawią. Elliott i Valliant (2017) przypominają, że do prób nielosowych nie stosuje się wnioskowania opartego na schemacie losowania; każde oszacowanie z takiej próby opiera się na modelu. Dlatego przedziały z tej ankiety traktuj jak margines błędu „przy założeniu, że wagi wystarczą” – zob. też dobór nielosowy w obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: drzewo szacunku rynku
Iloczyn najłatwiej pokazać jako drzewo: rynek dzieli się na liczbę klientów i wydatek na klienta, a te – na składniki. Kolor i napis w polu mówią, skąd pochodzi liczba.
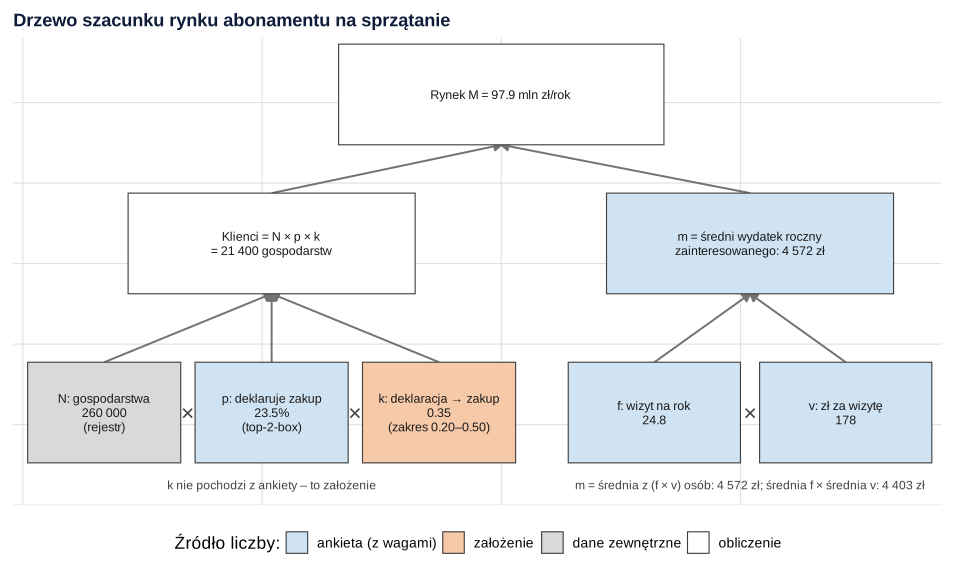
Co widać. 23.5% z 260 000 to 61 175 gospodarstw deklarujących zakup. Przy k = 0.35 zostaje ok. 21 400 klientów. Każdy wydaje średnio 4572 zł rocznie, więc rynek wynosi 97.9 mln zł rocznie. Zwróć uwagę na prawą gałąź: m to średnia z iloczynów f × v policzonych dla każdej osoby, a nie iloczyn średnich (4403 zł). Częstość i kwota są dodatnio skorelowane (r = .19 – zamożniejsze gospodarstwa chcą częściej i płacą więcej), więc mnożenie średnich zaniżyłoby rynek do 94.3 mln zł.
Jak może zmylić. Drzewo wygląda jak rachunek księgowy, a każda gałąź ma inną jakość. Liczby z rejestru i ankiety mają znaną niepewność, założenie k – tylko taką, jaką mu nadaliśmy.
Podpis do pracy:
Rysunek 3: bootstrap całego iloczynu
Każdy składnik ma swój przedział, ale potrzebujemy przedziału dla iloczynu. Goodman (1960) podał dokładny wzór na wariancję iloczynu dwóch zmiennych losowych i pokazał, że popularne przybliżenie ją zaniża, gdy zmienne są niezależne. Przy czterech składnikach, wagach i korelacji częstości z kwotą prościej użyć bootstrapu (Efron i Tibshirani, 1993): losujemy ze zwracaniem 1200 gospodarstw, w każdej próbie od nowa liczymy wagi, potem p i m, a na końcu cały iloczyn. Powtarzamy to 2000 razy. Losowanie całych odpowiedzi zachowuje związek częstości z kwotą. Obok losujemy założenia: k z przedziału 0.20–0.50 i N z błędem względnym 2% (rejestr sprzed kilku lat). Alternatywą jest metoda delta na logarytmie iloczynu – przy małej niepewności składników daje zbliżony wynik.
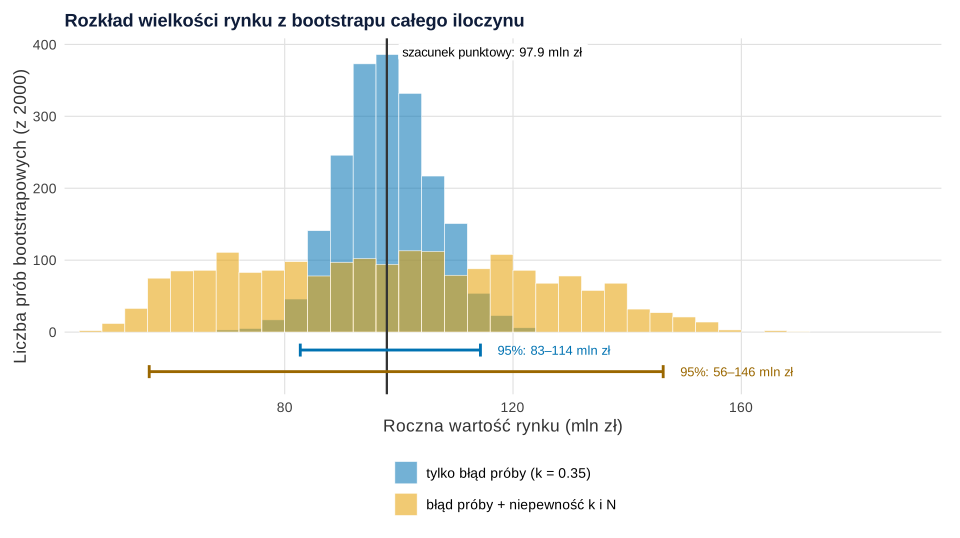
set.seed(6811)).Co widać. Gdy uwzględniamy tylko błąd próby, 95% przedział percentylowy wynosi 82.7–114.3 mln zł – jego szerokość to 32% szacunku punktowego. Po dodaniu niepewności k i N przedział rośnie do 56.3–146.3 mln zł, czyli 92% szacunku. Średnie z obu wariantów (98.0 i 98.3 mln zł) są bliskie szacunkowi punktowemu, więc iloczyn nie jest tu wyraźnie obciążony.
Jak może zmylić. Wąski niebieski rozkład to przedział, który najczęściej trafia do raportów, bo wynika „z danych”. Opisuje jednak tylko losowość ankiety – przy założeniu, że k = 0.35 jest pewne.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: który składnik daje najwięcej niepewności
To pytanie analizy wrażliwości. Wykres tornado podsumowuje wpływ wielu składników na jednym rysunku (Eschenbach, 1992): zmieniamy jeden składnik od dolnej do górnej granicy (dla p i m – bootstrapowy 95% CI), pozostałe zostawiamy na wartościach bazowych. Saltelli i in. (2019) zwracają uwagę, że zmiana jednego założenia naraz bada tylko „korytarze” wokół wartości bazowych, a nie całą przestrzeń możliwych kombinacji. Dlatego panel B korzysta z pełnej symulacji. Ponieważ logarytm iloczynu to suma logarytmów, wariancję ln M da się rozłożyć na części pochodzące od poszczególnych składników. Ten sam podział – tornado plus symulacja – znajdziesz we wpisie o symulacji Monte Carlo opłacalności projektu, tam dla NPV inwestycji.
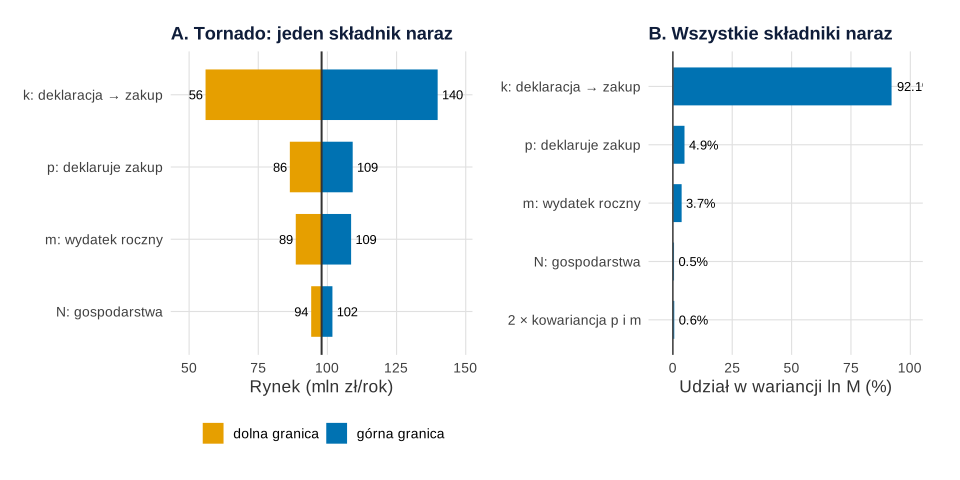
set.seed(6811)).Co widać. Współczynnik k przesuwa rynek od 55.9 do 139.9 mln zł i odpowiada za 92.1% wariancji ln M. Składniki z ankiety – p (86.4–109.1 mln zł) i m (88.6–108.6 mln zł) – dają razem niecałe 10%, liczba gospodarstw – 0.5%. Wniosek praktyczny: dwa razy większa ankieta zmniejszyłaby odchylenie standardowe ln M zaledwie do 99% obecnego, a pilotaż sprzedaży, który zawęziłby k do 0.30–0.40, – do 44%.
Jak może zmylić. Kolejność słupków zależy od przyjętych zakresów. Gdybyśmy dla k wpisali wąski zakres „bo tak się wydaje”, tornado pokazałoby, że wszystko zależy od ankiety.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: od deklaracji do rynku i kontrola top-down
Ostatni rysunek zbiera sześć odpowiedzi na to samo pytanie. Pierwsze dwie to iloczyn samych deklaracji (k = 1), trzecia i czwarta – nasz szacunek z dwoma rodzajami przedziału. Piąta to częsty skrót: „scenariusz optymistyczny” jako iloczyn wszystkich górnych granic i „pesymistyczny” jako iloczyn dolnych. Szósta to szacunek „od góry” (top-down): liczba gospodarstw × odsetek tych, które już płacą za sprzątanie, × ich roczny wydatek. Te dwie liczby wzięliśmy z fikcyjnego raportu branżowego (6–10% gospodarstw, 3000–4500 zł rocznie) i opisaliśmy rozkładami jednostajnymi. Szacunek top-down dotyczy całego rynku sprzątania, nie tylko abonamentu, więc służy jako kontrola rzędu wielkości.
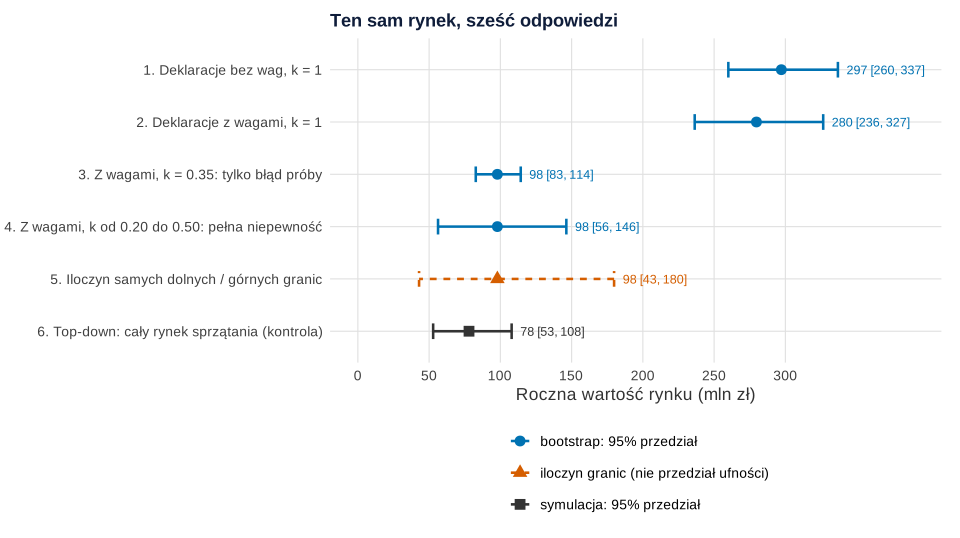
set.seed(6811) i set.seed(6812)).Co widać. Same deklaracje dają 297.2 mln zł bez wag i 279.7 mln zł z wagami – 3.8 raza więcej niż cały obecny rynek sprzątania z szacunku top-down (78.0 mln zł, 95% przedział 52.8–107.9). To sygnał, że deklaracji nie wolno mnożyć wprost. Iloczyn skrajnych granic daje zakres 43.0–179.8 mln zł; jego górna granica jest 1.23 raza wyższa niż górny kraniec przedziału z symulacji (146.3), a żadna z 2000 symulacji jej nie przekroczyła.
Jak może zmylić. Nasz szacunek (97.9 mln zł) przewyższa obecny rynek sprzątania (78.0 mln zł). Może to znaczyć, że abonament stworzy nowy popyt, ale równie dobrze, że k = 0.35 jest zbyt optymistyczne. Porównanie top-down nie rozstrzyga sporu, ale pokazuje, gdzie zacząć sprawdzanie.
Podpis do pracy:
Co z tym zrobić w marketingu
- Podawaj rynek z przedziałem i napisz, co on obejmuje. „98 mln zł, 95% przedział 56–146 mln zł przy niepewnym k” mówi zarządowi więcej niż „98 mln zł”.
- Nie zwiększaj ankiety, tylko zbadaj k. Tornado wskazało, że 92% niepewności to założenie o realizacji deklaracji. Pilotaż sprzedaży w jednej dzielnicy lub przedsprzedaż z zadatkiem zwęzi przedział bardziej niż drugie tyle ankiet.
- Zawsze porównaj bottom-up z top-down. Jeśli „rynek z ankiety” przekracza cały obecny rynek kategorii, uzasadnij to (nowy popyt) albo obniż założenia.
- Ważenie traktuj jako minimum. Zmiana p z 26.3% na 23.5% nie jest kosmetyczna. O tym, kto odpowiada na ankiety i jak ważyć danymi z CRM, piszemy we wpisie o ankiecie po zakupie i braku odpowiedzi.
- Kwotę z ankiety sprawdź osobnym badaniem ceny. „Ile zapłaciłbyś za wizytę?” to deklaracja; metody badania wrażliwości na cenę porównujemy we wpisie badanie ceny: van Westendorp i Gabor–Granger.
Wielkość rynku to potencjał. Jak szybko firma do niego dojdzie, opisuje model dyfuzji Bassa.
Jak opisać w pracy
W Metodzie opisz: populację i operat (skąd N), sposób doboru próby i ważenia, definicję każdego składnika, źródło założeń spoza ankiety i sposób liczenia przedziału.
W Wynikach użyj zdań spod rysunków 1, 3 i 4. W ograniczeniach napisz wprost, że próba jest nielosowa, że k jest założeniem i że dominuje w niepewności wyniku. Szerzej o źródłach błędu w ankiecie – we wpisie o całkowitym błędzie badania sondażowego, a o przedziałach dla pojedynczego odsetka – w haśle przedział ufności dla proporcji.
Kod R: ważenie, iloczyn, bootstrap i analiza wrażliwości
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Ważenie liczymy pakietem survey, a w bootstrapie – prostą pętlą rakingu w bazowym R (przepis 4 sprawdza, że obie drogi dają to samo). Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – wagi i składniki, przepis 4 – próby bootstrapowe, z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1, 4 i 6; każdy zaczyna losowanie od własnego set.seed() (681, 6811 i 6812). Ziaren nie zmienialiśmy po pierwszym uruchomieniu. Ręcznie ustalono: liczbę i strukturę gospodarstw, strukturę próby internetowej, współczynniki i progi modelu intencji (po pierwszym uruchomieniu zwiększone, by efekt ważenia był wyraźny), model częstości i kwoty, k = 0.35 z zakresem 0.20–0.50, błąd względny N (2%), liczbę prób (2000) i założenia top-down. Całość liczy się w ok. 25 s.
1. Dane: ankieta online w fikcyjnym mieście
R
# Fikcyjna firma: abonament na sprzątanie mieszkań w mieście ok. 600 tys. mieszkańców – ankieta online (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Populacja (ustalona ręcznie): liczba gospodarstw domowych i struktura według wieku osoby
# odpowiadającej oraz liczby osób w gospodarstwie
N_gosp <- 260000
pop_wiek <- c("18–34" = 0.24, "35–54" = 0.36, "55+" = 0.40)
pop_wielkosc <- c("1 osoba" = 0.36, "2 osoby" = 0.31, "3+ osoby" = 0.33)

# Próba internetowa: 1200 gospodarstw (jedna osoba z gospodarstwa); młodsi są w niej nadreprezentowani
set.seed(681)
n <- 1200
wiek <- sample(names(pop_wiek), n, replace = TRUE, prob = c(0.42, 0.40, 0.18))
p_wielkosc <- rbind("18–34" = c(0.50, 0.30, 0.20), "35–54" = c(0.20, 0.30, 0.50), "55+" = c(0.45, 0.42, 0.13))
wielkosc <- vapply(wiek, function(w) sample(names(pop_wielkosc), 1, prob = p_wielkosc[w, ]), "")
dochod <- rnorm(n, mean = ifelse(wiek == "35–54", 0.2, 0))         # indeks dochodu (standaryzowany)

# Intencja zakupu abonamentu 1–5 („zdecydowanie nie” … „zdecydowanie tak”) z modelu progowego
skl <- 1.0 * (wiek == "18–34") + 0.5 * (wiek == "35–54") + 0.25 * (wielkosc == "1 osoba") +
  0.2 * (wielkosc == "3+ osoby") + 0.5 * dochod + rlogis(n)
intencja <- as.integer(cut(skl, c(-Inf, -0.3, 1.0, 1.9, 2.8, Inf)))
zainteresowany <- intencja >= 4                                        # „top-2-box”: 4 lub 5

# Tylko zainteresowani odpowiadają na pytania o częstość i kwotę
s <- 0.5 * dochod + 0.4 * (wielkosc == "3+ osoby") + rnorm(n)
czestosc <- c(6, 12, 26, 52)[as.integer(cut(s, c(-Inf, -1.2, 0.2, 1.3, Inf)))]      # wizyt na rok
kwota <- 10 * round(16 * exp(0.15 * (wielkosc == "3+ osoby") - 0.10 * (wielkosc == "1 osoba") +
                               0.12 * dochod + rnorm(n, 0, 0.25)))                    # zł za wizytę
ankieta <- data.frame(id = 1:n, wiek, wielkosc, intencja, zainteresowany,
                      czestosc_rok = ifelse(zainteresowany, czestosc, NA),
                      kwota_wizyta = ifelse(zainteresowany, kwota, NA), row.names = NULL)
ankieta$wydatek_rok <- ankieta$czestosc_rok * ankieta$kwota_wizyta     # deklarowany wydatek roczny (zł)
write.csv(ankieta, "wielkosc-rynku-ankieta.csv", row.names = FALSE)

# Struktura próby a populacja (%)
rbind(proba = round(100 * prop.table(table(ankieta$wiek)), 1), populacja = 100 * pop_wiek)
rbind(proba = round(100 * prop.table(table(ankieta$wielkosc)), 1), populacja = 100 * pop_wielkosc)
# Rozkład intencji (%) i odsetek zainteresowanych w grupach wieku
round(100 * prop.table(table(ankieta$intencja)), 1)
round(100 * tapply(ankieta$zainteresowany, ankieta$wiek, mean), 1)
data.frame(zainteresowani = sum(ankieta$zainteresowany),
           odsetek_bez_wag_proc = round(100 * mean(ankieta$zainteresowany), 1))
Wynik w R
          18–34 35–54 55+
proba        41    42  17
populacja    24    36  40
          1 osoba 2 osoby 3+ osoby
proba        34.2    35.8     30.1
populacja    36.0    31.0     33.0

   1    2    3    4    5
27.8 27.8 18.1 13.8 12.5
18–34 35–54   55+
 32.1  24.6  16.7
  zainteresowani odsetek_bez_wag_proc
1            316                 26.3
2. Ważenie (raking) i składniki rynku z 95% CI: Rysunek 1
R
# Rysunek 1. Ważenie próby internetowej do struktury gospodarstw (raking) i składniki rynku z 95% CI; wymaga przepisu 1
library(survey)
library(patchwork)

# Raking do sum populacyjnych: wagi sumują się do liczby gospodarstw w mieście
proj0 <- svydesign(ids = ~1, weights = ~rep(1, n), data = ankieta)
cele_wiek <- data.frame(wiek = names(pop_wiek), Freq = N_gosp * unname(pop_wiek))
cele_wielkosc <- data.frame(wielkosc = names(pop_wielkosc), Freq = N_gosp * unname(pop_wielkosc))
proj <- rake(proj0, list(~wiek, ~wielkosc), list(cele_wiek, cele_wielkosc))
w <- weights(proj)
data.frame(waga_min = round(min(w)), waga_max = round(max(w)), iloraz_max_min = round(max(w) / min(w), 2),
           deff_kisha = round(1 + var(w) / mean(w)^2, 3), n_efektywne = round(n / (1 + var(w) / mean(w)^2)))

# Składniki z 95% CI: bez wag (proj0) i z wagami (proj); p – odsetek top-2-box,
# f, v, m – średnie wśród zainteresowanych (częstość, kwota za wizytę, wydatek roczny = f × v)
skladniki <- function(d) {
  p <- svyciprop(~zainteresowany, d, method = "logit")
  z <- subset(d, zainteresowany)
  sr <- svymean(~czestosc_rok + kwota_wizyta + wydatek_rok, z, na.rm = TRUE)
  ci <- confint(sr)
  data.frame(skladnik = c("p: odsetek top-2-box", "f: wizyt na rok", "v: zł za wizytę", "m: wydatek roczny (zł)"),
             ocena = c(coef(p), coef(sr)), dol = c(confint(p)[1], ci[, 1]), gora = c(confint(p)[2], ci[, 2]),
             row.names = NULL)
}
wyniki <- rbind(cbind(wariant = "bez wag", skladniki(proj0)), cbind(wariant = "z wagami (raking)", skladniki(proj)))
print(cbind(wyniki[1:2], signif(wyniki[3:5], 4)), row.names = FALSE)
# Efekt schematu dla odsetka (wagi zwiększają wariancję) i iloczyn średnich f × v wobec średniej iloczynu m
data.frame(deff_p = round(as.numeric(deff(svymean(~zainteresowany, proj, deff = TRUE)))[2], 3),
           f_razy_v = round(prod(wyniki$ocena[wyniki$wariant == "z wagami (raking)"][2:3])),
           m = round(wyniki$ocena[8]),
           korelacja_f_v = round(cor(ankieta$czestosc_rok, ankieta$kwota_wizyta, use = "complete.obs"), 2))

# Rysunek 1A: struktura próby przed i po ważeniu wobec populacji
struktura <- rbind(
  data.frame(zmienna = "Wiek osoby odpowiadającej", kategoria = names(pop_wiek),
             proba = as.vector(prop.table(table(ankieta$wiek))[names(pop_wiek)]),
             po_wazeniu = as.vector(tapply(w, ankieta$wiek, sum)[names(pop_wiek)]) / N_gosp, populacja = unname(pop_wiek)),
  data.frame(zmienna = "Liczba osób w gospodarstwie", kategoria = names(pop_wielkosc),
             proba = as.vector(prop.table(table(ankieta$wielkosc))[names(pop_wielkosc)]),
             po_wazeniu = as.vector(tapply(w, ankieta$wielkosc, sum)[names(pop_wielkosc)]) / N_gosp,
             populacja = unname(pop_wielkosc)))
sd1 <- rbind(data.frame(struktura[1:2], udzial = struktura$proba, zrodlo = "próba bez wag"),
             data.frame(struktura[1:2], udzial = struktura$populacja, zrodlo = "populacja (= próba po ważeniu)"))
sd1$kategoria <- factor(sd1$kategoria, levels = rev(c(names(pop_wiek), names(pop_wielkosc))))
p1a <- ggplot(sd1, aes(100 * udzial, kategoria, colour = zrodlo, shape = zrodlo)) +
  geom_line(aes(group = kategoria), colour = "grey70", linewidth = 1) +
  geom_point(size = 3.4) +
  facet_wrap(~zmienna, ncol = 1, scales = "free_y") +
  scale_colour_manual(values = c("próba bez wag" = kol[["cynober"]], "populacja (= próba po ważeniu)" = kol[["niebieski"]]),
                      name = NULL) +
  scale_shape_manual(values = c("próba bez wag" = 17, "populacja (= próba po ważeniu)" = 16), name = NULL) +
  labs(x = "Udział (%)", y = NULL, title = "A. Struktura próby") +
  motyw + guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1))
# Rysunek 1B: p i m bez wag i z wagami, z 95% CI
wb <- wyniki[wyniki$skladnik %in% c("p: odsetek top-2-box", "m: wydatek roczny (zł)"), ]
wb$skala <- ifelse(grepl("^p", wb$skladnik), 100, 1)
wb$skladnik <- factor(wb$skladnik, levels = c("p: odsetek top-2-box", "m: wydatek roczny (zł)"),
                      labels = c("p: deklaruje zakup (%)", "m: wydatek roczny (zł)"))
p1b <- ggplot(wb, aes(ocena * skala, wariant, colour = wariant, shape = wariant)) +
  geom_errorbar(aes(xmin = dol * skala, xmax = gora * skala), width = 0.25, linewidth = 0.8) +
  geom_point(size = 3.4) +
  geom_text(aes(label = ifelse(skala == 100, sprintf("%.1f", 100 * ocena), sprintf("%.0f", ocena))),
            vjust = -1.1, size = 3.4, show.legend = FALSE) +
  facet_wrap(~skladnik, ncol = 1, scales = "free_x") +
  scale_colour_manual(values = c("bez wag" = kol[["cynober"]], "z wagami (raking)" = kol[["niebieski"]]), guide = "none") +
  scale_shape_manual(values = c("bez wag" = 17, "z wagami (raking)" = 16), guide = "none") +
  scale_y_discrete(expand = expansion(add = 0.8)) +
  labs(x = "Oszacowanie z 95% CI", y = NULL, title = "B. Składniki rynku") +
  motyw
p1 <- p1a + p1b + plot_layout(widths = c(1, 1.1))
p1   # zapis: ggsave("wielkosc-rynku-wazenie.svg", p1, width = 10, height = 6)
Wynik w R
  waga_min waga_max iloraz_max_min deff_kisha n_efektywne
1      103      651           6.35      1.428         840
           wariant               skladnik     ocena       dol      gora
           bez wag   p: odsetek top-2-box    0.2633    0.2391    0.2890
           bez wag        f: wizyt na rok   23.4900   21.8500   25.1400
           bez wag        v: zł za wizytę  178.3000  172.4000  184.1000
           bez wag m: wydatek roczny (zł) 4340.0000 3969.0000 4712.0000
 z wagami (raking)   p: odsetek top-2-box    0.2353    0.2092    0.2635
 z wagami (raking)        f: wizyt na rok   24.7500   22.7200   26.7800
 z wagami (raking)        v: zł za wizytę  177.9000  171.2000  184.5000
 z wagami (raking) m: wydatek roczny (zł) 4572.0000 4109.0000 5035.0000
  deff_p f_razy_v    m korelacja_f_v
1  1.281     4403 4572          0.19
3. Szacunek punktowy i drzewo szacunku: Rysunek 2
R
# Rysunek 2. Drzewo szacunku rynku: M = N × p × k × m; wymaga przepisów 1–2
# k – odsetek deklarujących, którzy naprawdę kupią (założenie ustalone ręcznie: 0.35, zakres 0.20–0.50)
k_baza <- 0.35
zw <- wyniki[wyniki$wariant == "z wagami (raking)", ]
p_w <- zw$ocena[1]; f_w <- zw$ocena[2]; v_w <- zw$ocena[3]; m_w <- zw$ocena[4]
klienci <- N_gosp * p_w * k_baza
M0 <- klienci * m_w
data.frame(deklaruje_gosp = round(N_gosp * p_w), klienci = round(klienci), m_zl = round(m_w),
           rynek_mln_zl = round(M0 / 1e6, 1), rynek_z_f_razy_v_mln_zl = round(klienci * f_w * v_w / 1e6, 1))

# Rysunek 2: drzewo – korzeń (rynek), dwie gałęzie (klienci, wydatek na klienta), liście (składniki)
pola <- data.frame(
  x = c(5, 2.6, 7.6, 0.85, 2.6, 4.35, 6.6, 8.6), y = c(5.1, 3.25, 3.25, 1.15, 1.15, 1.15, 1.15, 1.15),
  w = c(3.4, 3.0, 3.0, 1.6, 1.6, 1.6, 1.8, 1.8), h = 1.25,
  zrodlo = c("obliczenie", "obliczenie", "ankieta (z wagami)", "dane zewnętrzne", "ankieta (z wagami)",
             "założenie", "ankieta (z wagami)", "ankieta (z wagami)"),
  tekst = c(sprintf("Rynek M = %.1f mln zł/rok", M0 / 1e6),
            sprintf("Klienci = N × p × k\n= %s gospodarstw", format(round(klienci, -2), big.mark = " ")),
            sprintf("m = średni wydatek roczny\nzainteresowanego: %s zł", format(round(m_w), big.mark = " ")),
            sprintf("N: gospodarstwa\n%s\n(rejestr)", format(N_gosp, big.mark = " ")),
            sprintf("p: deklaruje zakup\n%.1f%%\n(top-2-box)", 100 * p_w),
            sprintf("k: deklaracja → zakup\n%.2f\n(zakres 0.20–0.50)", k_baza),
            sprintf("f: wizyt na rok\n%.1f", f_w), sprintf("v: zł za wizytę\n%.0f", v_w)))
pola$zrodlo <- factor(pola$zrodlo, levels = c("ankieta (z wagami)", "założenie", "dane zewnętrzne", "obliczenie"))
krawedzie <- data.frame(od = c(1, 1, 2, 2, 2, 3, 3), do = c(2, 3, 4, 5, 6, 7, 8))
kr <- data.frame(x = pola$x[krawedzie$od], y = pola$y[krawedzie$od] - pola$h[krawedzie$od] / 2,
                 xend = pola$x[krawedzie$do], yend = pola$y[krawedzie$do] + pola$h[krawedzie$do] / 2)
p2 <- ggplot() +
  geom_segment(data = kr, aes(x, y, xend = xend, yend = yend), colour = "grey45", linewidth = 0.7,
               arrow = arrow(length = unit(2.2, "mm"), type = "closed", ends = "first")) +
  geom_rect(data = pola, aes(xmin = x - w / 2, xmax = x + w / 2, ymin = y - h / 2, ymax = y + h / 2, fill = zrodlo),
            colour = "grey25", linewidth = 0.4) +
  geom_text(data = pola, aes(x, y, label = tekst), size = 3.3, lineheight = 0.95, colour = "grey10") +
  annotate("text", x = c(1.72, 3.47, 7.6), y = 1.15, label = "×", size = 6, colour = "grey25") +
  annotate("text", x = 7.6, y = 0.25, size = 3.2, colour = "grey25",
           label = sprintf("m = średnia z (f × v) osób: %s zł; średnia f × średnia v: %s zł",
                           format(round(m_w), big.mark = " "), format(round(f_w * v_w), big.mark = " "))) +
  annotate("text", x = 2.6, y = 0.25, size = 3.2, colour = "grey25", label = "k nie pochodzi z ankiety – to założenie") +
  scale_fill_manual(values = c("ankieta (z wagami)" = "#CFE3F2", "założenie" = "#F6C9A9",
                               "dane zewnętrzne" = "grey85", "obliczenie" = "white"), name = "Źródło liczby:") +
  coord_cartesian(xlim = c(-0.1, 9.6), ylim = c(0, 5.8), expand = FALSE) +
  labs(x = NULL, y = NULL, title = "Drzewo szacunku rynku abonamentu na sprzątanie") +
  motyw + theme(axis.text = element_blank(), panel.grid = element_blank())
p2   # zapis: ggsave("wielkosc-rynku-drzewo.svg", p2, width = 10, height = 6)
Wynik w R
  deklaruje_gosp klienci m_zl rynek_mln_zl rynek_z_f_razy_v_mln_zl
1          61175   21411 4572         97.9                    94.3
4. Bootstrap całego iloczynu z ponownym ważeniem: Rysunek 3
R
# Rysunek 3. Bootstrap całego iloczynu: rozkład wielkości rynku z samym błędem próby i z niepewnością założeń;
# wymaga przepisów 1–3
# Raking ręcznie (te same sumy co w przepisie 2) – w każdej próbie bootstrapowej wagi liczymy od nowa
rake_recznie <- function(d, iter = 30) {
  w <- rep(1, nrow(d))
  for (i in seq_len(iter)) {
    w <- w * (N_gosp * pop_wiek)[d$wiek] / tapply(w, d$wiek, sum)[d$wiek]
    w <- w * (N_gosp * pop_wielkosc)[d$wielkosc] / tapply(w, d$wielkosc, sum)[d$wielkosc]
  }
  unname(w)
}
oszacuj <- function(d, w) {
  z <- d$zainteresowany
  c(p = sum(w * z) / sum(w), m = sum(w[z] * d$wydatek_rok[z]) / sum(w[z]))
}
# Sprawdzenie: ręczny raking daje te same p i m co pakiet survey
round(rbind(recznie = oszacuj(ankieta, rake_recznie(ankieta)), survey = c(p_w, m_w)), 4)

set.seed(6811)
B <- 2000
bt <- t(replicate(B, {
  d <- ankieta[sample(n, n, replace = TRUE), ]
  c(oszacuj(d, rake_recznie(d)), setNames(oszacuj(d, rep(1, n)), c("p_bez_wag", "m_bez_wag")))
}))
# Niepewność założeń losowana obok: k ~ jednostajny(0.20, 0.50), N z błędem względnym 2% (rejestr sprzed lat)
k_los <- runif(B, 0.20, 0.50)
N_los <- N_gosp * exp(rnorm(B, 0, 0.02))
sym <- data.frame(bt, k = k_los, N = N_los,
                  M_proba = N_gosp * bt[, "p"] * k_baza * bt[, "m"],       # tylko błąd próby (k = 0.35)
                  M_pelna = N_los * bt[, "p"] * k_los * bt[, "m"],         # błąd próby + niepewność k i N
                  M_bez_wag_k1 = N_gosp * bt[, "p_bez_wag"] * bt[, "m_bez_wag"],
                  M_wagi_k1 = N_gosp * bt[, "p"] * bt[, "m"])
opis <- function(x) round(c(srednia = mean(x), mediana = median(x), dol_2.5 = unname(quantile(x, 0.025)),
                            gora_97.5 = unname(quantile(x, 0.975))) / 1e6, 1)
rbind(tylko_blad_proby = opis(sym$M_proba), blad_proby_i_zalozenia = opis(sym$M_pelna))
# Bootstrapowe 95% CI składników (percentylowe) i korelacja p z m między próbami bootstrapowymi
round(rbind(p = quantile(sym$p, c(0.025, 0.975)), m = quantile(sym$m, c(0.025, 0.975))), 4)
data.frame(kor_p_m = round(cor(sym$p, sym$m), 3),
           szer_proba_proc_M0 = round(100 * unname(diff(quantile(sym$M_proba, c(0.025, 0.975)))) / M0),
           szer_pelna_proc_M0 = round(100 * unname(diff(quantile(sym$M_pelna, c(0.025, 0.975)))) / M0))

# Rysunek 3: dwa rozkłady wielkości rynku z 95% przedziałami
sd3 <- rbind(data.frame(M = sym$M_proba / 1e6, rodzaj = "tylko błąd próby (k = 0.35)"),
             data.frame(M = sym$M_pelna / 1e6, rodzaj = "błąd próby + niepewność k i N"))
sd3$rodzaj <- factor(sd3$rodzaj, levels = c("tylko błąd próby (k = 0.35)", "błąd próby + niepewność k i N"))
przedz <- aggregate(M ~ rodzaj, sd3, function(x) quantile(x, c(0.025, 0.975)))
przedz <- data.frame(rodzaj = przedz$rodzaj, dol = przedz$M[, 1], gora = przedz$M[, 2], y = c(-25, -55))
p3 <- ggplot(sd3, aes(M, fill = rodzaj)) +
  geom_histogram(binwidth = 4, boundary = 0, position = "identity", alpha = 0.55, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = M0 / 1e6, colour = kol[["ciemny"]], linewidth = 0.8) +
  geom_errorbar(data = przedz, aes(xmin = dol, xmax = gora, y = y, colour = rodzaj), width = 18, linewidth = 1,
                inherit.aes = FALSE) +
  geom_text(data = przedz, aes(x = gora + 3, y = y, label = sprintf("95%%: %.0f–%.0f mln zł", dol, gora), colour = rodzaj),
            hjust = 0, size = 3.4, inherit.aes = FALSE, show.legend = FALSE) +
  annotate("label", x = M0 / 1e6 + 2, y = Inf, vjust = 1.3, hjust = 0, size = 3.4, border.colour = NA,
           label = sprintf("szacunek punktowy: %.1f mln zł", M0 / 1e6)) +
  scale_fill_manual(values = c("tylko błąd próby (k = 0.35)" = kol[["niebieski"]],
                               "błąd próby + niepewność k i N" = kol[["pomarancz"]]), name = NULL) +
  scale_colour_manual(values = c("tylko błąd próby (k = 0.35)" = kol[["niebieski"]],
                                 "błąd próby + niepewność k i N" = "#9A6700"), guide = "none") +
  scale_x_continuous(expand = expansion(mult = c(0.02, 0.18))) +
  labs(x = "Roczna wartość rynku (mln zł)", y = "Liczba prób bootstrapowych (z 2000)",
       title = "Rozkład wielkości rynku z bootstrapu całego iloczynu") +
  motyw
p3   # zapis: ggsave("wielkosc-rynku-bootstrap.svg", p3, width = 10, height = 5.6)
Wynik w R
             p        m
recznie 0.2353 4572.239
survey  0.2353 4572.239
                       srednia mediana dol_2.5 gora_97.5
tylko_blad_proby          98.0    97.7    82.7     114.3
blad_proby_i_zalozenia    98.3    98.3    56.3     146.3
       2.5%     97.5%
p    0.2077    0.2623
m 4135.9106 5070.5633
  kor_p_m szer_proba_proc_M0 szer_pelna_proc_M0
1   0.067                 32                 92
5. Tornado i udział składników w wariancji: Rysunek 4
R
# Rysunek 4. Analiza wrażliwości: wykres tornado i udział składników w niepewności; wymaga przepisów 1–4
library(patchwork)
nazwy <- c(k = "k: deklaracja → zakup", p = "p: deklaruje zakup", m = "m: wydatek roczny", N = "N: gospodarstwa")
baza <- c(k = k_baza, p = p_w, m = m_w, N = N_gosp)
# Zakresy: p i m – bootstrapowe 95% CI z przepisu 4; k – założenie 0.20–0.50; N – ±1.96 × 2%
zakres <- rbind(k = c(0.20, 0.50), p = quantile(sym$p, c(0.025, 0.975)), m = quantile(sym$m, c(0.025, 0.975)),
                N = N_gosp * exp(c(-1.96, 1.96) * 0.02))
# Model jest iloczynem, więc zmiana jednego składnika zmienia M proporcjonalnie
tornado <- data.frame(skladnik = unname(nazwy[rownames(zakres)]),
                      M_przy_dolnej = M0 * zakres[, 1] / baza[rownames(zakres)] / 1e6,
                      M_przy_gornej = M0 * zakres[, 2] / baza[rownames(zakres)] / 1e6, row.names = NULL)
tornado$rozpietosc <- tornado$M_przy_gornej - tornado$M_przy_dolnej
print(cbind(tornado[1], round(tornado[-1], 1)), row.names = FALSE)

# Udział w wariancji ln M (ln iloczynu = suma logarytmów składników) w symulacji z przepisu 4
L <- log(sym[, c("N", "p", "k", "m")])
skladowe <- c(var(L$k), var(L$p), var(L$m), var(L$N), 2 * cov(L$p, L$m))
udzialy <- data.frame(skladnik = c(unname(nazwy[c("k", "p", "m", "N")]), "2 × kowariancja p i m"),
                      udzial_proc = round(100 * skladowe / var(log(sym$M_pelna)), 1))
print(udzialy, row.names = FALSE)
# Co zwęzi 95% przedział bardziej: dwa razy większa ankieta czy pilotaż sprzedaży, który zawęzi k do 0.30–0.40?
v_proba <- var(L$p) + var(L$m) + 2 * cov(L$p, L$m)
k_pilot <- 0.30 + (sym$k - 0.20) / 0.30 * 0.10                 # te same losowania przeskalowane do 0.30–0.40
v_teraz <- var(log(sym$M_pelna))
data.frame(wariant = c("obecnie", "2 razy większa ankieta", "pilotaż: k od 0.30 do 0.40"),
           sd_ln_M_jako_proc_obecnego = round(100 * sqrt(c(1, (var(L$k) + var(L$N) + v_proba / 2) / v_teraz,
                                                         (var(log(k_pilot)) + var(L$N) + v_proba) / v_teraz))))

# Rysunek 4A: tornado wokół szacunku punktowego
td <- rbind(data.frame(skladnik = tornado$skladnik, od = M0 / 1e6, do = tornado$M_przy_dolnej, koniec = "dolna granica"),
            data.frame(skladnik = tornado$skladnik, od = M0 / 1e6, do = tornado$M_przy_gornej, koniec = "górna granica"))
td$skladnik <- factor(td$skladnik, levels = rev(tornado$skladnik[order(-tornado$rozpietosc)]))
p4a <- ggplot(td, aes(y = skladnik)) +
  geom_rect(aes(xmin = pmin(od, do), xmax = pmax(od, do), ymin = as.numeric(skladnik) - 0.35,
                ymax = as.numeric(skladnik) + 0.35, fill = koniec)) +
  geom_vline(xintercept = M0 / 1e6, colour = kol[["ciemny"]], linewidth = 0.7) +
  geom_text(aes(x = do, label = sprintf("%.0f", do), hjust = ifelse(do < M0 / 1e6, 1.2, -0.2)), size = 3.4) +
  scale_fill_manual(values = c("dolna granica" = kol[["pomarancz"]], "górna granica" = kol[["niebieski"]]), name = NULL) +
  scale_x_continuous(expand = expansion(mult = 0.15)) +
  labs(x = "Rynek (mln zł/rok)", y = NULL, title = "A. Tornado: jeden składnik naraz") +
  motyw
# Rysunek 4B: udział składników w wariancji ln M
udzialy$skladnik <- factor(udzialy$skladnik, levels = rev(udzialy$skladnik))
p4b <- ggplot(udzialy, aes(udzial_proc, skladnik)) +
  geom_col(fill = kol[["niebieski"]], width = 0.65) +
  geom_text(aes(label = sprintf("%.1f%%", udzial_proc), hjust = ifelse(udzial_proc >= 0, -0.15, 1.15)), size = 3.4) +
  geom_vline(xintercept = 0, colour = "grey30") +
  scale_x_continuous(limits = c(-5, 100), breaks = seq(0, 100, 25)) +
  labs(x = "Udział w wariancji ln M (%)", y = NULL, title = "B. Wszystkie składniki naraz") +
  motyw
p4 <- p4a + p4b + plot_layout(widths = c(1.1, 1))
p4   # zapis: ggsave("wielkosc-rynku-tornado.svg", p4, width = 10, height = 5)
Wynik w R
              skladnik M_przy_dolnej M_przy_gornej rozpietosc
 k: deklaracja → zakup          55.9         139.9       83.9
    p: deklaruje zakup          86.4         109.1       22.7
     m: wydatek roczny          88.6         108.6       20.0
       N: gospodarstwa          94.1         101.8        7.7
              skladnik udzial_proc
 k: deklaracja → zakup        92.1
    p: deklaruje zakup         4.9
     m: wydatek roczny         3.7
       N: gospodarstwa         0.5
 2 × kowariancja p i m         0.6
                     wariant sd_ln_M_jako_proc_obecnego
1                    obecnie                        100
2     2 razy większa ankieta                         99
3 pilotaż: k od 0.30 do 0.40                         44
6. Sześć odpowiedzi i kontrola top-down: Rysunek 5
R
# Rysunek 5. Od surowych deklaracji do szacunku rynku, mnożenie skrajnych założeń i kontrola top-down;
# wymaga przepisów 1–5
pc <- function(x) unname(quantile(x, c(0.025, 0.975)) / 1e6)
p_raw <- wyniki$ocena[1]; m_raw <- wyniki$ocena[4]
# Mnożenie samych górnych (dolnych) granic czterech składników – „scenariusz optymistyczny (pesymistyczny)”
M_wszystko_gora <- prod(zakres[, 2]) / 1e6
M_wszystko_dol <- prod(zakres[, 1]) / 1e6
# Top-down (założenia ręczne, fikcyjny raport branżowy): odsetek gospodarstw, które już płacą za sprzątanie,
# u ~ jednostajny(0.06, 0.10), i ich roczny wydatek s ~ jednostajny(3000, 4500) zł; to CAŁY rynek usług sprzątania
set.seed(6812)
u <- runif(B, 0.06, 0.10); s_wyd <- runif(B, 3000, 4500)
M_top <- N_los * u * s_wyd
szacunki <- data.frame(
  wariant = c("1. Deklaracje bez wag, k = 1", "2. Deklaracje z wagami, k = 1", "3. Z wagami, k = 0.35: tylko błąd próby",
              "4. Z wagami, k od 0.20 do 0.50: pełna niepewność", "5. Iloczyn samych dolnych / górnych granic",
              "6. Top-down: cały rynek sprzątania (kontrola)"),
  ocena = c(N_gosp * p_raw * m_raw, N_gosp * p_w * m_w, M0, M0, M0, N_gosp * 0.08 * 3750) / 1e6,
  dol = c(pc(sym$M_bez_wag_k1)[1], pc(sym$M_wagi_k1)[1], pc(sym$M_proba)[1], pc(sym$M_pelna)[1], M_wszystko_dol,
          pc(M_top)[1]),
  gora = c(pc(sym$M_bez_wag_k1)[2], pc(sym$M_wagi_k1)[2], pc(sym$M_proba)[2], pc(sym$M_pelna)[2], M_wszystko_gora,
           pc(M_top)[2]),
  rodzaj = c(rep("bootstrap: 95% przedział", 4), "iloczyn granic (nie przedział ufności)", "symulacja: 95% przedział"))
print(cbind(szacunki[1], round(szacunki[2:4], 1)), row.names = FALSE)
data.frame(gora_iloczynu_wobec_P97.5 = round(M_wszystko_gora / pc(sym$M_pelna)[2], 2),
           P_M_pelna_powyzej_iloczynu_gornych_proc = round(100 * mean(sym$M_pelna / 1e6 > M_wszystko_gora), 2),
           deklaracje_bez_wag_wobec_top_down = round(szacunki$ocena[1] / szacunki$ocena[6], 1))

# Rysunek 5: drabinka szacunków
szacunki$wariant <- factor(szacunki$wariant, levels = rev(szacunki$wariant))
p5 <- ggplot(szacunki, aes(ocena, wariant, colour = rodzaj, shape = rodzaj, linetype = rodzaj)) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.3, linewidth = 0.9) +
  geom_point(size = 3.4) +
  geom_text(aes(x = gora + 6, label = sprintf("%.0f [%.0f, %.0f]", ocena, dol, gora)), hjust = 0, size = 3.3,
            show.legend = FALSE) +
  scale_colour_manual(values = c("bootstrap: 95% przedział" = kol[["niebieski"]],
                                 "iloczyn granic (nie przedział ufności)" = kol[["cynober"]],
                                 "symulacja: 95% przedział" = kol[["ciemny"]]), name = NULL) +
  scale_shape_manual(values = c("bootstrap: 95% przedział" = 16, "iloczyn granic (nie przedział ufności)" = 17,
                                "symulacja: 95% przedział" = 15), name = NULL) +
  scale_linetype_manual(values = c("bootstrap: 95% przedział" = "solid", "iloczyn granic (nie przedział ufności)" = "22",
                                   "symulacja: 95% przedział" = "solid"), name = NULL) +
  scale_x_continuous(limits = c(0, 390), breaks = seq(0, 300, 50)) +
  labs(x = "Roczna wartość rynku (mln zł)", y = NULL, title = "Ten sam rynek, sześć odpowiedzi") +
  motyw + guides(colour = guide_legend(ncol = 1))
p5   # zapis: ggsave("wielkosc-rynku-porownanie.svg", p5, width = 10, height = 5.6)
Wynik w R
                                          wariant ocena   dol  gora
                     1. Deklaracje bez wag, k = 1 297.2 260.0 336.9
                    2. Deklaracje z wagami, k = 1 279.7 236.4 326.5
          3. Z wagami, k = 0.35: tylko błąd próby  97.9  82.7 114.3
 4. Z wagami, k od 0.20 do 0.50: pełna niepewność  97.9  56.3 146.3
       5. Iloczyn samych dolnych / górnych granic  97.9  43.0 179.8
    6. Top-down: cały rynek sprzątania (kontrola)  78.0  52.8 107.9
  gora_iloczynu_wobec_P97.5 P_M_pelna_powyzej_iloczynu_gornych_proc
1                      1.23                                       0
  deklaracje_bez_wag_wobec_top_down
1                               3.8
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
# Pary barw z rysunków 1–5; para czerwony–zielony dla porównania
library(colorspace)
pary <- list("niebieski – cynober" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy" = c("#0072B2", "#E69F00"),
             "ciemnoszary – cynober" = c("#333333", "#D55E00"),
             "jasnoniebieskie – jasnopomarańczowe pole" = c("#CFE3F2", "#F6C9A9"),
             "jasnopomarańczowe – jasnoszare pole" = c("#F6C9A9", "#D9D9D9"),
             "czerwony – zielony (unikać)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                         widzenie_typowe deuteranopia
niebieski – cynober                                114.6        108.3
niebieski – pomarańczowy                           120.2        121.5
ciemnoszary – cynober                               83.4         72.7
jasnoniebieskie – jasnopomarańczowe pole            35.4         34.6
jasnopomarańczowe – jasnoszare pole                 25.0         23.9
czerwony – zielony (unikać)                        121.7         21.1
                                         protanopia
niebieski – cynober                            91.9
niebieski – pomarańczowy                      109.3
ciemnoszary – cynober                          59.9
jasnoniebieskie – jasnopomarańczowe pole       29.9
jasnopomarańczowe – jasnoszare pole            20.4
czerwony – zielony (unikać)                    31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, kwantyle, raking w pętli – pakiety base i stats; wagi, przedziały ufności i efekt schematu – pakiet survey). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Deklaracje jako zakupy. Mnożenie odsetka „zdecydowanie tak” przez liczbę gospodarstw daje w przykładzie rynek prawie cztery razy większy niż cała obecna kategoria. Zawsze dodaj krok „deklaracja → zakup”.
- Mnożenie optymistycznych założeń. Iloczyn górnych granic nie jest górną granicą przedziału – zawyża ją, bo zakłada, że wszystko pójdzie dobrze naraz.
- Iloczyn średnich zamiast średniej iloczynu. Gdy częstość i kwota są skorelowane, średnia częstość × średnia kwota ≠ średnia z (częstość × kwota); w przykładzie 94.3 zamiast 97.9 mln zł.
- Przedział tylko z ankiety. Błąd próby to tu mniej niż 10% wariancji wyniku. Reszta siedzi w założeniach, których ankieta nie mierzy.
- Brak ważenia próby internetowej. Nadreprezentacja młodszych zawyżyła odsetek deklarujących zakup o 2.8 punktu procentowego.
Najczęstsze pytania
Jak oszacować wielkość rynku na podstawie ankiety?
Rozpisz rynek na iloczyn: liczba gospodarstw (z rejestru) × odsetek deklarujących zakup × odsetek deklaracji, które zamienią się w zakup × średni roczny wydatek kupującego. Składniki z ankiety licz po zważeniu próby, a dla całego iloczynu podaj przedział z bootstrapu. W przykładzie: 260 000 × 23.5% × 0.35 × 4572 zł = 97.9 mln zł rocznie.
Czym różni się szacowanie wielkości rynku top-down od bottom-up?
Bottom-up zaczyna od pojedynczych klientów (ankieta: kto kupi, jak często i za ile) i mnoży w górę. Top-down zaczyna od dużej liczby, np. wartości całej kategorii, i zawęża ją udziałami. Policz oba: jeśli szacunek z ankiety przekracza cały obecny rynek kategorii, tak jak surowe deklaracje w przykładzie (3.8 raza), założenia są zbyt optymistyczne.
Jak policzyć przedział ufności dla wielkości rynku?
Najprościej bootstrapem: losuj respondentów ze zwracaniem, w każdej próbie od nowa licz wagi i składniki, a potem cały iloczyn; 2.5. i 97.5. percentyl 2000 takich iloczynów to 95% przedział. Założenia spoza ankiety (np. odsetek deklaracji zamienianych w zakup) losuj równocześnie z przyjętych zakresów, bo inaczej przedział obejmie tylko błąd próby.
Czy można pomnożyć odsetek deklarujących zakup przez liczbę gospodarstw?
Nie bez korekty. Deklaracje słabiej przewidują zakupy nowych produktów i kategorii niż istniejących marek (Morwitz i in., 2007). W przykładzie same deklaracje dawały rynek 279.7 mln zł, a po uwzględnieniu współczynnika realizacji 0.35 – 97.9 mln zł.
Który składnik wielkości rynku jest najbardziej niepewny?
Sprawdź to wykresem tornado i rozkładem wariancji logarytmu iloczynu. Zwykle nie są to składniki z ankiety, lecz założenia: w przykładzie współczynnik realizacji deklaracji odpowiadał za 92.1% wariancji, a dwa razy większa ankieta zmniejszyłaby niepewność tylko o 1%.
Powiązane hasła
Przeczytaj też
Deklaracja zakupu a faktyczny zakup
Catering dietetyczny: top-2-box, wykres kalibracji, konwersje deklaracji w segmentach i prognoza sprzedaży z bootstrapem – pięć rysunków z kodem R.
Czytaj →PoradnikMonte Carlo NPV – opłacalność projektu
Linia produkcyjna w mleczarni: NPV, rozkłady założeń, 10 000 symulacji, P(NPV < 0), tornado i korelacja ceny z popytem – sześć rysunków z kodem R.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →Szacujesz wielkość rynku w pracy lub biznesplanie?
Pomożemy zaplanować ankietę, zważyć próbę, policzyć wielkość rynku z przedziałem niepewności i analizą wrażliwości oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Battaglia, M. P., Hoaglin, D. C., & Frankel, M. R. (2009). Practical considerations in raking survey data. Survey Practice, 2(5), 1–10. https://doi.org/10.29115/sp-2009-0019 ● Otwarty dostęp
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall.
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
- Eschenbach, T. G. (1992). Spiderplots versus tornado diagrams for sensitivity analysis. Interfaces, 22(6), 40–46. https://doi.org/10.1287/inte.22.6.40
- Goodman, L. A. (1960). On the exact variance of products. Journal of the American Statistical Association, 55(292), 708–713. https://doi.org/10.1080/01621459.1960.10483369
- Morwitz, V. G., Steckel, J. H., & Gupta, A. (2007). When do purchase intentions predict sales? International Journal of Forecasting, 23(3), 347–364. https://doi.org/10.1016/j.ijforecast.2007.05.015 ● Otwarty dostęp: pełny tekst
- Saltelli, A., Aleksankina, K., Becker, W., Fennell, P., Ferretti, F., Holst, N., Li, S., & Wu, Q. (2019). Why so many published sensitivity analyses are false: A systematic review of sensitivity analysis practices. Environmental Modelling & Software, 114, 29–39. https://doi.org/10.1016/j.envsoft.2019.01.012 ● Otwarty dostęp
Cytowania BibTeX
@article{battaglia2009practical, author={Battaglia, Michael P. and Hoaglin, David C. and Frankel, Martin R.}, title={{Practical considerations in raking survey data}}, journal={Survey Practice}, year={2009}, volume={2}, number={5}, pages={1--10}, doi={10.29115/sp-2009-0019}}@book{efron1993introduction, author={Efron, Bradley and Tibshirani, Robert J.}, title={{An introduction to the bootstrap}}, year={1993}, publisher={Chapman \& Hall}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}@article{eschenbach1992spiderplots, author={Eschenbach, Ted G.}, title={{Spiderplots versus tornado diagrams for sensitivity analysis}}, journal={Interfaces}, year={1992}, volume={22}, number={6}, pages={40--46}, doi={10.1287/inte.22.6.40}}@article{goodman1960exact, author={Goodman, Leo A.}, title={{On the exact variance of products}}, journal={Journal of the American Statistical Association}, year={1960}, volume={55}, number={292}, pages={708--713}, doi={10.1080/01621459.1960.10483369}}@article{morwitz2007when, author={Morwitz, Vicki G. and Steckel, Joel H. and Gupta, Alok}, title={{When do purchase intentions predict sales?}}, journal={International Journal of Forecasting}, year={2007}, volume={23}, number={3}, pages={347--364}, doi={10.1016/j.ijforecast.2007.05.015}}@article{saltelli2019why, author={Saltelli, Andrea and Aleksankina, Ksenia and Becker, William and Fennell, Pamela and Ferretti, Federico and Holst, Niels and Li, Sushan and Wu, Qiongli}, title={{Why so many published sensitivity analyses are false: A systematic review of sensitivity analysis practices}}, journal={Environmental Modelling \& Software}, year={2019}, volume={114}, pages={29--39}, doi={10.1016/j.envsoft.2019.01.012}}