Przykład: czujnik jakości powietrza i pytanie „ile sprzedamy?”
Fikcyjna firma wprowadza na rynek domowy czujnik jakości powietrza. To produkt kupowany raz: kto już ma czujnik, drugiego zwykle nie kupi. Zarząd pyta: ile czujników sprzedamy łącznie, kiedy będzie szczyt sprzedaży i ile zamówić u producenta na kolejne miesiące? Zwykłe metody (zob. prognoza sprzedaży z sezonowością, świętami i promocjami) potrzebują długiej historii, której nowy produkt nie ma. Tu przydaje się model dyfuzji Bassa.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy potencjał rynku m = 50 000 sztuk oraz parametry: innowacji 0.004 i naśladownictwa 0.25 na miesiąc (znaczenie – niżej). Co miesiąc część osób bez czujnika kupuje go; doliczyliśmy losowe wahania popytu (ok. ±12%). Mamy 36 miesięcy sprzedaży: najwięcej sprzedano w 17. miesiącu (4512 sztuk), a do końca 36. miesiąca – 49 773 sztuki, czyli 99.5% potencjału. Ziarno 630 ustalono raz i nie zmieniano go. Dane pobierzesz jako model-bassa-sprzedaz-czujnika.csv (miesiąc, sprzedaż, sprzedaż łączna).
Najpierw dopasujemy model do całej historii, potem cofniemy się w czasie: co model powiedziałby po 6, 12 i 24 miesiącach? To szereg czasowy o szczególnym kształcie: sprzedaż rośnie, osiąga szczyt i gaśnie, bo kończą się klienci.
Model Bassa w trzech liczbach
Bass (1969) założył, że moment pierwszego zakupu zależy od tego, ilu ludzi już kupiło. Opisał to dwoma rodzajami zachowań: innowacyjnym i naśladowczym. Model dobrze przewidywał szczyt sprzedaży i jego czas na danych 11 dóbr trwałego użytku. Trzy parametry:
- m – potencjał rynku: ile osób kupi produkt kiedykolwiek;
- p – współczynnik innowacji: szansa, że osoba bez produktu kupi go w danym miesiącu „sama z siebie” (reklama, recenzje);
- q – współczynnik naśladownictwa: o ile rośnie ta szansa, gdy produkt ma coraz więcej znajomych i sąsiadów.
Słowami: w każdym miesiącu kupuje część tych, którzy jeszcze nie kupili. Ta część rośnie wraz z liczbą dotychczasowych nabywców N:
Pierwszy nawias to szansa zakupu, drugi – ilu klientów zostało. Najpierw kupują głównie innowatorzy, potem wzrost napędza naśladownictwo, a pod koniec brakuje klientów. Sprzedaż łączna ma kształt litery S, podobnie jak krzywa w regresji logistycznej. Szczyt sprzedaży przypada na miesiąc ln(q/p) / (p + q): w przykładzie 16.3. Przegląd modeli dyfuzji i ich rozszerzeń podają Mahajan i in. (1990).
Rysunek 1: innowatorzy i naśladowcy
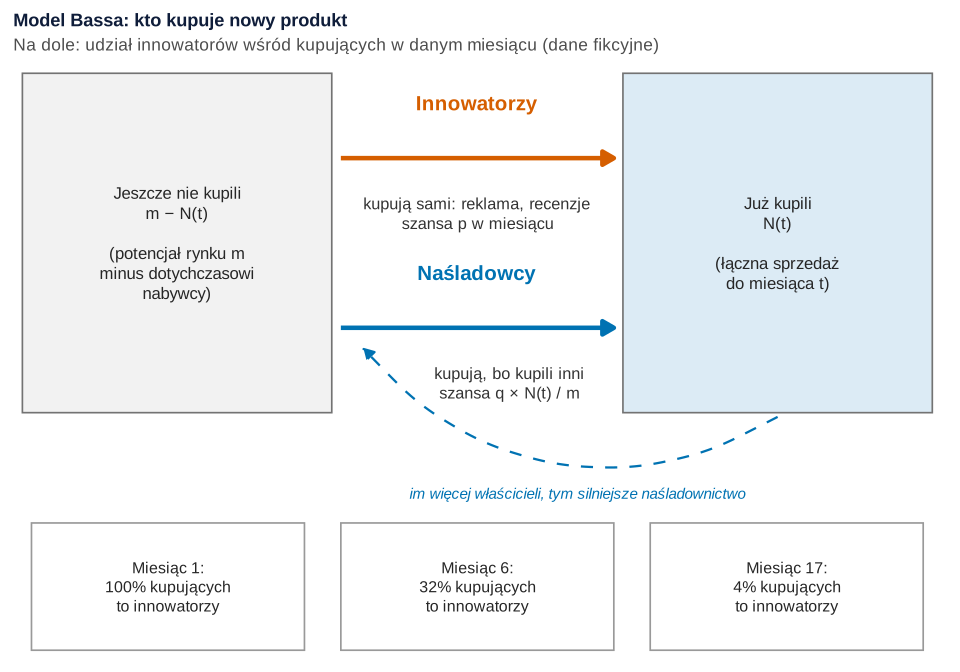
Co widać. Klienci przechodzą z lewego pola do prawego dwiema drogami. Droga naśladowców poszerza się, gdy w prawym polu przybywa ludzi (przerywana strzałka). W 1. miesiącu wszyscy kupujący to innowatorzy. W 6. miesiącu, przy 1698 wcześniejszych nabywcach, innowatorzy to już tylko 32% kupujących, a w 17. – 3.6%.
Jak może zmylić. „Innowator” to zakup bez wpływu innych w danym miesiącu, a nie typ osobowości. Nie da się wskazać, który klient nim był.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: model dopasowany do 36 miesięcy
Parametry szacujemy nieliniową metodą najmniejszych kwadratów: szukamy p, q i m, przy których suma kwadratów różnic między sprzedażą a modelem jest najmniejsza (jak na rysunkach we wpisie metoda najmniejszych kwadratów w obrazkach). Srinivasan i Mason (1986) zaproponowali to podejście dla modelu Bassa, bo daje poprawne błędy standardowe. W R robi to nls(), a punkt startowy daje optim() z kilku startów.
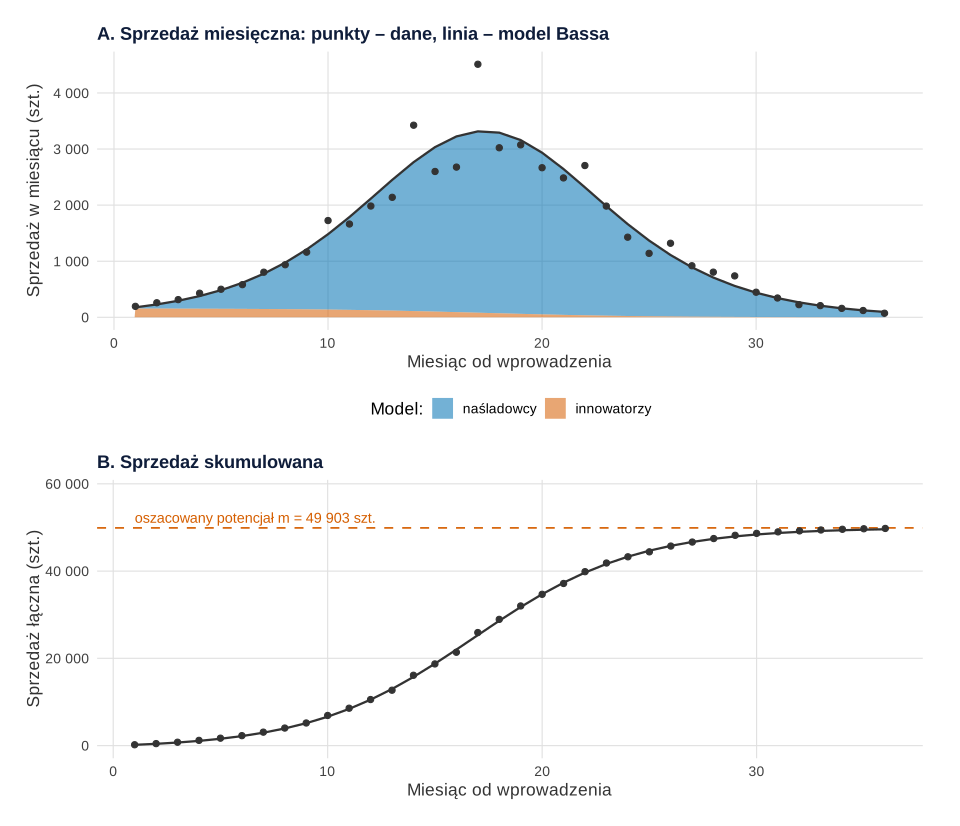
set.seed(630)).Co widać. Model z oszacowaniami m = 49 903 sztuk (95% CI z profilu [46 314, 53 565]), p równym 0.0031 i q równym 0.260 wyjaśnia 93.3% zmienności miesięcznej sprzedaży. Szczyt według modelu przypada na 16.8. miesiąc. Innowatorzy dają tylko 5.3% sprzedaży, ale uruchamiają naśladownictwo.
Jak może zmylić. Dopasowanie po fakcie to nie prognoza: po 36 miesiącach rynek jest prawie nasycony, więc m odczytujemy niemal wprost z danych. Miesiąc 17. z nagłym skokiem do 4512 sztuk to losowe wahanie: reszta modelu, a nie zmiana trendu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: prognoza po 6, 12 i 24 miesiącach
Prognoza jest potrzebna wtedy, gdy danych jest mało. Dopasowujemy więc model tylko do pierwszych 6, 12 i 24 miesięcy.
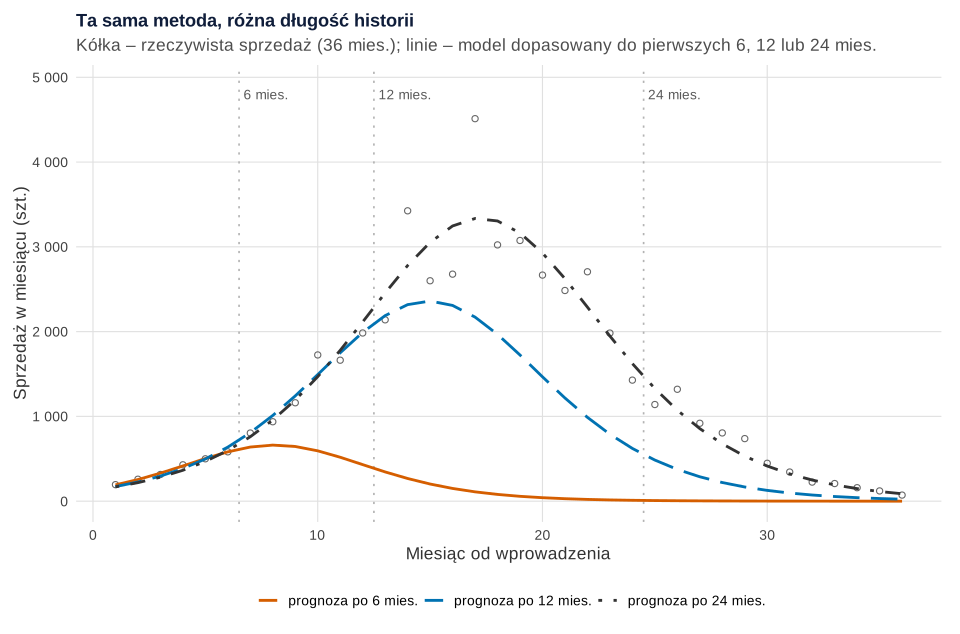
Co widać. Po 6 miesiącach model „widzi” szczyt w 7.6. miesiącu i potencjał 7123 sztuk – siedem razy za mało. Średni błąd bezwzględny (MAE) prognoz na kolejne miesiące to 1422 sztuki. Po 12 miesiącach: szczyt w 14.4. miesiącu, m = 32 690, MAE = 717. Dopiero po 24 miesiącach, już za szczytem, prognoza trafia: m = 49 407, MAE = 80.
Jak może zmylić. Przed szczytem początek małego i dużego rynku wyglądają prawie tak samo. To znany problem: Heeler i Hustad (1980) opisali niestabilność oszacowań przy niewielu danych i systematyczne zaniżanie czasu do szczytu. Van den Bulte i Lilien (1997) pokazali, że szacowany potencjał zwykle rośnie wraz z dopisywaniem kolejnych miesięcy, nawet gdy model jest poprawny.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: jak niepewny jest potencjał m
Potrzebujemy więc przedziału. Liczymy go dwoma sposobami dla historii 6, 9, …, 36 miesięcy. Bootstrap reszt (Efron, 1979): do krzywej modelu dokładamy losowo przetasowane reszty, dopasowujemy model 200 razy i bierzemy 2.5. i 97.5. percentyl m (mechanizm na rysunkach: bootstrap – wizualizacja na obrazkach). Przedział z profilu: ustalamy m na kolejnych wartościach, dopasowujemy p i q od nowa i sprawdzamy, o ile rośnie suma kwadratów reszt. Optymalizację ograniczyliśmy do m ≤ 2 mln.
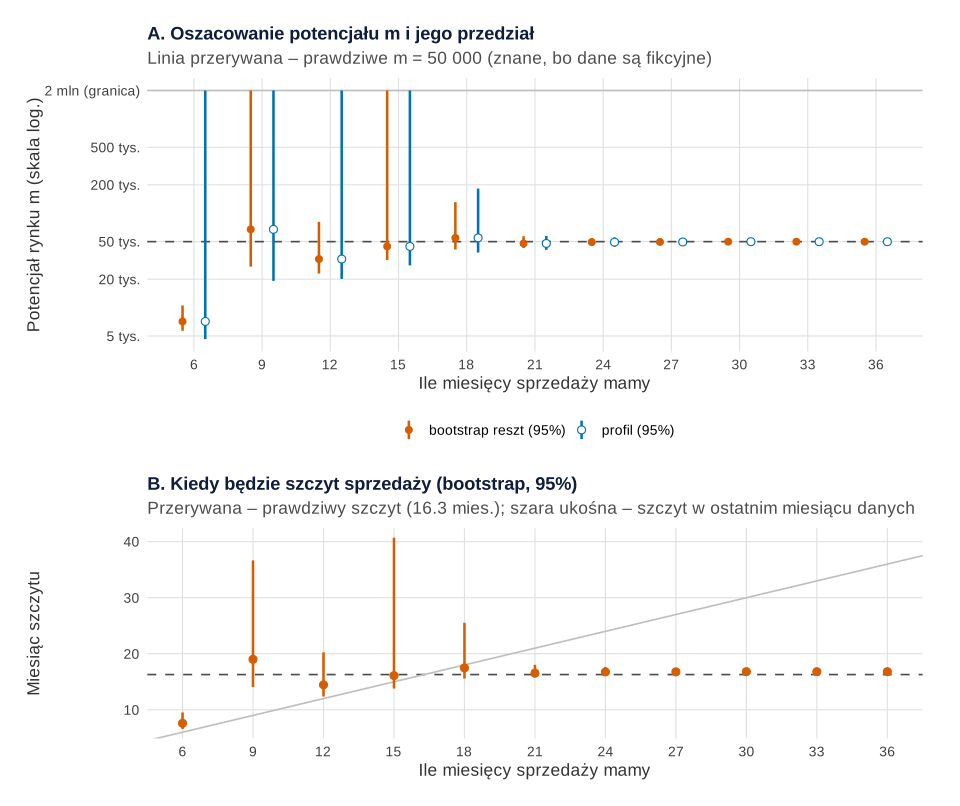
set.seed(630)).Co widać. Po 12 miesiącach profil mówi: m od 20 114 do co najmniej 2 mln – dane nie dają górnej granicy. Bootstrap daje [22 939, 81 016]. Przedziały zawężają się wyraźnie dopiero za szczytem: po 21 miesiącach [42 810, 57 076] (bootstrap) i [40 909, 57 595] (profil). Po 36 miesiącach dolna granica profilu to po prostu 49 773 – tyle już sprzedano, a mniej być nie może.
Jak może zmylić. Po 6 miesiącach bootstrap daje wąski przedział [5 671, 10 532], który nie obejmuje prawdziwych 50 000. Sześć reszt to za mało, by bootstrap pokazał prawdziwą niepewność. Profil przy tej samej historii jest otwarty od góry i uczciwiej mówi „nie wiadomo”. To nie jest też pasmo predykcji dla pojedynczego miesiąca – losowe wahania sprzedaży doszłyby do niego osobno.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: analogia z podobnym produktem
Gdy danych jest mało, w praktyce pożycza się p i q od podobnego produktu, którego sprzedaż już się zakończyła. Z danych szacuje się wtedy tylko m. Przy znanych p i q sprzedaż to m razy przyrost F(t), więc m daje zwykła regresja przez zero (lm()). W przykładzie analogią jest oczyszczacz powietrza tej samej firmy. Jego parametry ustaliliśmy ręcznie: innowacji 0.005 i naśladownictwa 0.22. To bliskie prawdy, ale nie równe prawdziwym 0.004 i 0.25.
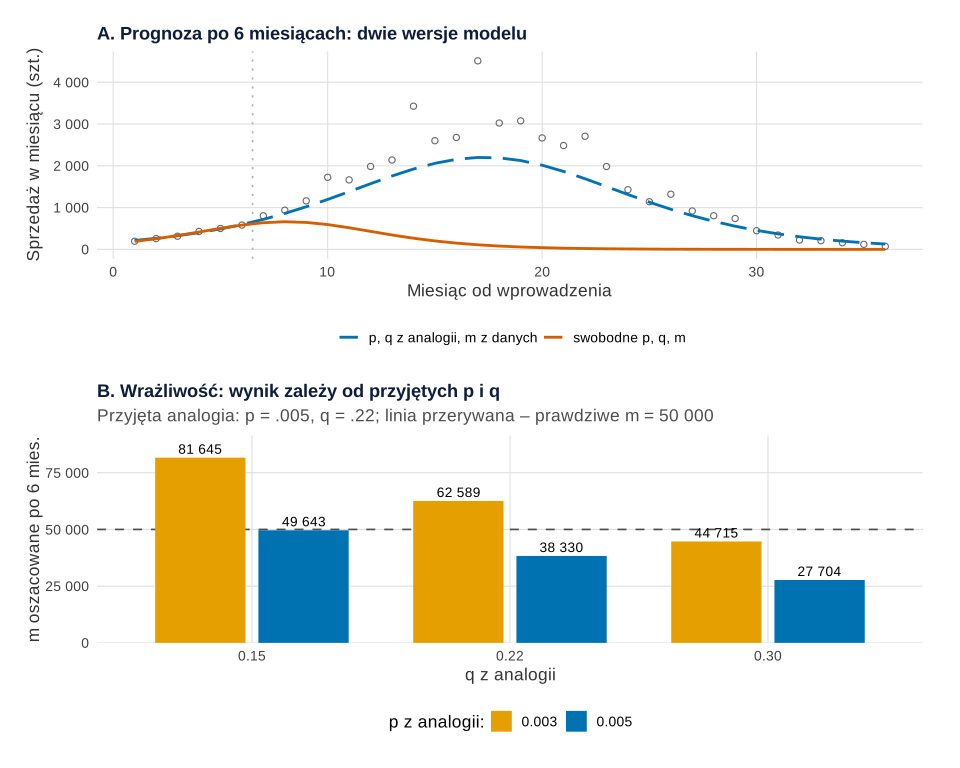
Co widać. Z analogią model już po 6 miesiącach przewiduje szczyt w 16.8. miesiącu i m = 38 330 sztuk (95% CI [36 544, 40 117]). To dużo bliżej prawdy niż 7123 z modelu swobodnego. Po 12 miesiącach: m = 46 527 [43 263, 49 791]. Panel B to analiza wrażliwości: przy innych, równie „rozsądnych” p i q te same 6 miesięcy dają m od 27 704 do 81 645.
Jak może zmylić. Przedział [36 544, 40 117] jest wąski, bo traktuje p i q jako pewne. Nie obejmuje prawdziwych 50 000. Prawdziwą niepewność pokazuje dopiero panel B.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: pułapka zmiany ceny
Model Bassa zakłada, że warunki rynku się nie zmieniają. Sprawdźmy, co się dzieje, gdy w 10. miesiącu firma obniża cenę o 20%. W symulacji szansa zakupu rośnie wtedy 1.4 raza (mnożnik ustalony ręcznie), a potencjał zostaje 50 000. Do 9. miesiąca dane są takie same jak wcześniej (to samo ziarno).
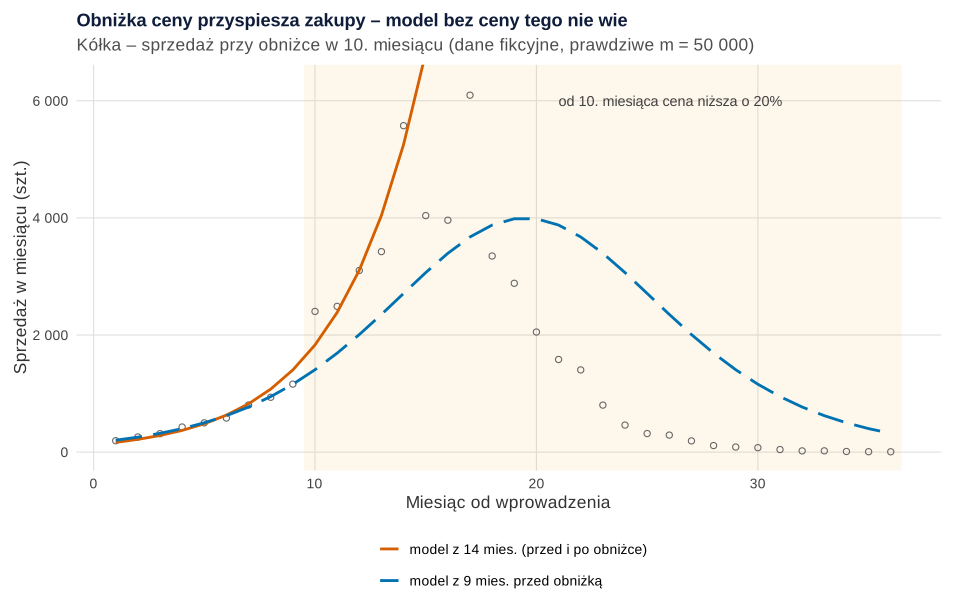
set.seed(630)).Co widać. Po obniżce sprzedaż rośnie szybciej i szczyt przychodzi w 17. miesiącu z 6095 sztukami. Model z 9 miesięcy przed obniżką przewiduje szczyt w 19. miesiącu i m ok. 67 500. Model z 14 miesięcy, który miesza okres przed i po obniżce, czyta przyspieszenie jako początek ogromnego rynku: m dochodzi do granicy 2 mln, a szczyt przesuwa się na 30.8. miesiąc. Tymczasem łączna sprzedaż do 36. miesiąca to 49 989 sztuk.
Jak może zmylić. Obniżka przyspiesza zakupy, ale w tej symulacji nie zwiększa liczby klientów. Bass i in. (1994) uogólnili model o cenę i reklamę. Gdy cena się zmienia, uwzględnij ją w modelu albo dopasuj model ponownie od momentu zmiany i opisz to. Jak cena wpływa na sprzedaż produktu już obecnego na rynku, opisuje wpis elastyczność cenowa z danych sprzedażowych.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Przed szczytem podawaj scenariusze, nie jedną liczbę. Np. m z analogii i z dwóch innych analogii, z ich miesiącem szczytu.
- Aktualizuj prognozę co miesiąc i pokazuj, jak zmienia się m (jak na rysunku 4). Gdy oszacowania przestają rosnąć, a sprzedaż spada, szczyt minął.
- Szukaj analogii celowo: produkt o podobnej cenie, kanale i grupie klientów.
- Notuj zmiany ceny i kampanii z datami. Bez tego nie odróżnisz przyspieszenia od większego rynku.
- Odróżniaj pierwszy zakup od kolejnych. Model Bassa liczy nabywców. Zakupy powtórne, np. filtry do czujnika, licz osobno – zob. analiza kohortowa retencji klientów i wartość klienta w czasie (CLV).
- Po szczycie przejdź na stały monitoring: nagły spadek sprzedaży wykryje karta kontrolna dla KPI.
Jak opisać w pracy
W Metodzie podaj źródło danych (sprzedaż miesięczna, pierwsze zakupy), liczbę miesięcy, sposób estymacji (nieliniowa MNK, nls(), punkty startowe), sposób liczenia przedziałów i ewentualne parametry z analogii ze źródłem. W Wynikach – p, q, m z przedziałami i miesiąc szczytu. W Ograniczeniach – długość historii względem szczytu i brak zmiennych marketingowych w modelu. Inne typowe analizy do pracy z marketingu zebraliśmy we wpisie statystyka w pracy z marketingu.
Kod R: model Bassa od danych do prognozy
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, funkcje modelu i dane, z których korzystają kolejne. Model liczą funkcje z podstawowej instalacji R (nls(), optim(), lm(), uniroot()). Przepisy z rysunkiem kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 5 (bootstrap) i 7 (dane z obniżką ceny); każdy zaczyna losowanie od własnego set.seed(630). Ziarno 630 ustalono raz i nie zmieniano go. Ręcznie ustalono: prawdziwe parametry (m = 50 000, innowacji 0.004, naśladownictwa 0.25 na miesiąc), wahania popytu (odchylenie standardowe 0.12 na skali logarytmu), 36 miesięcy historii, punkty startowe optymalizacji, górną granicę m = 2 mln, 200 prób bootstrapowych, parametry analogii (innowacji 0.005, naśladownictwa 0.22) i siatkę analizy wrażliwości, obniżkę ceny w 10. miesiącu z mnożnikiem szansy zakupu 1.4. Pierwsza wersja danych dodawała szum do oczekiwanej sprzedaży i dawała łącznie więcej sztuk niż potencjał rynku; dlatego przed liczeniem wyników zmieniliśmy ją na losowanie nabywców spośród osób, które jeszcze nie kupiły. Ziarna przy tym nie zmieniano.
1. Paleta, funkcje modelu Bassa i dane
R
# Przepis 1. Fikcyjny czujnik jakości powietrza: 36 miesięcy sprzedaży z modelu Bassa (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Model Bassa: F(t) – odsetek potencjału rynku, który kupił do końca miesiąca t
bass_F <- function(t, p, q) (1 - exp(-(p + q) * t)) / (1 + (q / p) * exp(-(p + q) * t))
bass_n <- function(t, p, q, m) m * (bass_F(t, p, q) - bass_F(t - 1, p, q))   # sprzedaż w miesiącu t
szczyt <- function(p, q) log(q / p) / (p + q)                                  # miesiąc szczytu sprzedaży

# Dopasowanie metodą najmniejszych kwadratów (optim, kilka punktów startowych, parametry w logarytmach)
dopasuj <- function(y, starty = NULL, m_max = 2e6) {
  t <- seq_along(y); N <- sum(y)
  sse <- function(th) sum((y - bass_n(t, exp(th[1]), exp(th[2]), exp(th[3])))^2)
  if (is.null(starty)) starty <- expand.grid(p = c(0.002, 0.01, 0.03), q = c(0.1, 0.3, 0.6), m = c(1.5, 4, 15) * N)
  najlepszy <- NULL
  for (i in seq_len(nrow(starty))) {
    o <- optim(log(unlist(starty[i, ])), sse, method = "L-BFGS-B",
               lower = log(c(1e-5, 1e-3, N)), upper = log(c(0.3, 2, m_max)))
    if (is.null(najlepszy) || o$value < najlepszy$value) najlepszy <- o
  }
  wsp <- exp(najlepszy$par)
  c(p = wsp[[1]], q = wsp[[2]], m = wsp[[3]], sse = najlepszy$value)
}

# Prawdziwe parametry (ustalone ręcznie): potencjał 50 000 sztuk, innowacja .004, naśladownictwo .25 na miesiąc
prawda <- c(p = .004, q = .25, m = 50000)
set.seed(630)                               # ziarno ustalone raz, bez dobierania pod wynik
miesiac <- 1:36
sprzedaz <- numeric(36); kupili <- 0
for (t in miesiac) {   # co miesiąc kupuje część tych, którzy jeszcze nie mają czujnika
  szansa <- (prawda[["p"]] + prawda[["q"]] * kupili / prawda[["m"]]) * exp(rnorm(1, 0, 0.12))  # wahania popytu ok. ±12%
  sprzedaz[t] <- rbinom(1, prawda[["m"]] - kupili, min(szansa, 1))
  kupili <- kupili + sprzedaz[t]
}
dane <- data.frame(miesiac, sprzedaz, skumulowana = cumsum(sprzedaz))
write.csv(dane, "model-bassa-sprzedaz-czujnika.csv", row.names = FALSE)

head(dane, 6)
c(prawdziwy_szczyt_miesiac = round(szczyt(prawda[["p"]], prawda[["q"]]), 1),
  najwyzsza_sprzedaz = max(sprzedaz), miesiac_najwyzszej = which.max(sprzedaz),
  sprzedane_po_36 = sum(sprzedaz), procent_potencjalu = round(100 * sum(sprzedaz) / prawda[["m"]], 1))
Wynik w R
  miesiac sprzedaz skumulowana
1       1      195         195
2       2      259         454
3       3      315         769
4       4      429        1198
5       5      500        1698
6       6      582        2280
prawdziwy_szczyt_miesiac       najwyzsza_sprzedaz       miesiac_najwyzszej
                    16.3                   4512.0                     17.0
         sprzedane_po_36       procent_potencjalu
                 49773.0                     99.5
2. Schemat innowatorzy – naśladowcy: Rysunek 1
R
# Rysunek 1. Schemat modelu Bassa: innowatorzy i naśladowcy (grafika z prostokątów, strzałek i tekstu)
# (korzysta z kol, motyw, prawda i dane z przepisu 1)
library(ggplot2)

# Udział innowatorów wśród kupujących w miesiącu t: p / (p + q · N(t−1) / m), N – kupili wcześniej
N_przed <- c(0, head(dane$skumulowana, -1))
udzial_innow <- prawda[["p"]] / (prawda[["p"]] + prawda[["q"]] * N_przed / prawda[["m"]])
wybrane <- c(1, 6, 17)
round(data.frame(miesiac = wybrane, kupili_wczesniej = N_przed[wybrane],
                 procent_innowatorow = 100 * udzial_innow[wybrane]), 1)

pola <- data.frame(xmin = c(0, 6.6), xmax = c(3.4, 10), ymin = c(2.2, 2.2), ymax = c(6.2, 6.2),
                   etyk = c("Jeszcze nie kupili\nm − N(t)\n\n(potencjał rynku m\nminus dotychczasowi\nnabywcy)",
                            "Już kupili\nN(t)\n\n(łączna sprzedaż\ndo miesiąca t)"),
                   wyp = c("#F2F2F2", "#DCEBF5"))
strzalki <- data.frame(x = c(3.5, 3.5), xend = c(6.5, 6.5), y = c(5.2, 3.2), yend = c(5.2, 3.2),
                       kolor = c(kol[["cynober"]], kol[["niebieski"]]), typ = c("solid", "solid"))
opisy <- data.frame(x = c(5, 5, 5, 5.35), y = c(5.85, 4.55, 3.85, 2.55),
                    etyk = c("Innowatorzy", "kupują sami: reklama, recenzje\nszansa p w miesiącu",
                             "Naśladowcy", "kupują, bo kupili inni\nszansa q × N(t) / m"),
                    kolor = c(kol[["cynober"]], "grey20", kol[["niebieski"]], "grey20"),
                    font = c("bold", "plain", "bold", "plain"), rozm = c(5.4, 4.3, 5.4, 4.3))
karty <- data.frame(x = c(1.6, 5, 8.4), etyk = sprintf("Miesiąc %d:\n%s kupujących\nto innowatorzy", wybrane,
                    paste0(round(100 * udzial_innow[wybrane]), "%")))
p1 <- ggplot() +
  geom_rect(data = pola, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax, fill = wyp), colour = "grey45") +
  geom_text(data = pola, aes(x = (xmin + xmax) / 2, y = (ymin + ymax) / 2, label = etyk), size = 4.4, lineheight = 1.0,
            colour = "grey15") +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = yend, colour = kolor), linewidth = 1.6,
               arrow = arrow(length = unit(0.35, "cm"), type = "closed")) +
  geom_text(data = opisy, aes(x = x, y = y, label = etyk, colour = kolor, fontface = font, size = rozm), lineheight = 1.0) +
  geom_curve(aes(x = 8.3, y = 2.15, xend = 3.75, yend = 2.95), curvature = -0.4, linetype = "dashed",
             colour = kol[["niebieski"]], linewidth = 0.8, arrow = arrow(length = unit(0.3, "cm"), type = "closed")) +
  annotate("text", x = 6.1, y = 1.25, label = "im więcej właścicieli, tym silniejsze naśladownictwo",
           size = 4.0, colour = kol[["niebieski"]], fontface = "italic") +
  geom_rect(data = karty, aes(xmin = x - 1.5, xmax = x + 1.5, ymin = -0.6, ymax = 0.9), fill = "white", colour = "grey60") +
  geom_text(data = karty, aes(x = x, y = 0.15, label = etyk), size = 4.2, lineheight = 1.0, colour = "grey15") +
  scale_fill_identity() + scale_colour_identity() + scale_size_identity() +
  coord_cartesian(xlim = c(-0.1, 10.1), ylim = c(-0.7, 6.3), expand = FALSE) +
  labs(title = "Model Bassa: kto kupuje nowy produkt",
       subtitle = "Na dole: udział innowatorów wśród kupujących w danym miesiącu (dane fikcyjne)") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("model-bassa-schemat-innowatorzy-nasladowcy.svg", p1, width = 10, height = 7)
Wynik w R
  miesiac kupili_wczesniej procent_innowatorow
1       1                0               100.0
2       6             1698                32.0
3      17            21396                 3.6
3. Dopasowanie nls() do 36 miesięcy: Rysunek 2
R
# Rysunek 2. Model Bassa dopasowany do 36 miesięcy sprzedaży: nls() i podział na innowatorów i naśladowców
# (korzysta z kol, motyw, bass_F, bass_n, szczyt, dopasuj i dane z przepisu 1)
library(ggplot2)
library(patchwork)

start <- dopasuj(dane$sprzedaz)                 # punkty startowe z optim (nls bywa wrażliwy na start)
fit36 <- nls(sprzedaz ~ bass_n(miesiac, p, q, m), data = dane,
             start = as.list(start[c("p", "q", "m")]))
wsp <- coef(fit36)
round(summary(fit36)$coefficients[, 1:2], 4)       # oszacowanie i błąd standardowy
c(szczyt_miesiac = round(szczyt(wsp[["p"]], wsp[["q"]]), 1),
  R2 = round(1 - sum(resid(fit36)^2) / sum((dane$sprzedaz - mean(dane$sprzedaz))^2), 3))
round(confint(fit36), 4)                        # przedziały z profilu (pełna historia)

# Dopasowana sprzedaż rozbita na innowatorów i naśladowców: udział innowatorów p / (p + q · F) w połowie miesiąca
udzial <- wsp[["p"]] / (wsp[["p"]] + wsp[["q"]] * bass_F(dane$miesiac - 0.5, wsp[["p"]], wsp[["q"]]))
rozklad <- rbind(data.frame(miesiac = dane$miesiac, grupa = "innowatorzy", n = fitted(fit36) * udzial),
                 data.frame(miesiac = dane$miesiac, grupa = "naśladowcy", n = fitted(fit36) * (1 - udzial)))
rozklad$grupa <- factor(rozklad$grupa, c("naśladowcy", "innowatorzy"))
c(innowatorzy_lacznie_proc = round(100 * sum(rozklad$n[rozklad$grupa == "innowatorzy"]) / sum(rozklad$n), 1))

pa <- ggplot() +
  geom_area(data = rozklad, aes(miesiac, n, fill = grupa), alpha = 0.55) +
  geom_point(data = dane, aes(miesiac, sprzedaz), colour = kol[["ciemny"]], size = 1.8) +
  geom_line(aes(dane$miesiac, fitted(fit36)), colour = kol[["ciemny"]], linewidth = 0.8) +
  scale_fill_manual(values = c("innowatorzy" = kol[["cynober"]], "naśladowcy" = kol[["niebieski"]]), name = "Model:") +
  scale_y_continuous(labels = scales::label_number(big.mark = " ")) +
  labs(x = "Miesiąc od wprowadzenia", y = "Sprzedaż w miesiącu (szt.)",
       title = "A. Sprzedaż miesięczna: punkty – dane, linia – model Bassa") + motyw
pb <- ggplot(dane, aes(miesiac, skumulowana)) +
  geom_hline(yintercept = wsp[["m"]], linetype = "dashed", colour = kol[["cynober"]]) +
  annotate("text", x = 1, y = wsp[["m"]], vjust = -0.5, hjust = 0, colour = kol[["cynober"]], size = 3.8,
           label = sprintf("oszacowany potencjał m = %s szt.", format(round(wsp[["m"]]), big.mark = " "))) +
  geom_point(colour = kol[["ciemny"]], size = 1.8) +
  geom_line(aes(y = cumsum(fitted(fit36))), colour = kol[["ciemny"]], linewidth = 0.8) +
  scale_y_continuous(labels = scales::label_number(big.mark = " "), limits = c(0, 58000)) +
  labs(x = "Miesiąc od wprowadzenia", y = "Sprzedaż łączna (szt.)", title = "B. Sprzedaż skumulowana") + motyw
p2 <- pa / pb
p2   # zapis: ggsave("model-bassa-dopasowanie-36-miesiecy.svg", p2, width = 10, height = 8.6)
Wynik w R
    Estimate Std. Error
p     0.0031     0.0005
q     0.2603     0.0126
m 49902.9806  1771.2739
szczyt_miesiac             R2
        16.800          0.933
        2.5%      97.5%
p     0.0022     0.0043
q     0.2351     0.2874
m 46313.5039 53564.9310
innowatorzy_lacznie_proc
                     5.3
4. Prognozy po 6, 12 i 24 miesiącach: Rysunek 3
R
# Rysunek 3. Prognoza po 6, 12 i 24 miesiącach: co model Bassa „wiedziałby” wcześniej
# (korzysta z kol, motyw, bass_n, szczyt, dopasuj i dane z przepisu 1)
library(ggplot2)

historie <- c(6, 12, 24)
oceny <- t(sapply(historie, function(h) dopasuj(dane$sprzedaz[1:h])))
tabela <- data.frame(miesiecy_danych = historie, p = round(oceny[, "p"], 4), q = round(oceny[, "q"], 3),
                     m = round(oceny[, "m"]), szczyt_miesiac = round(szczyt(oceny[, "p"], oceny[, "q"]), 1),
                     prognoza_lacznie_36 = round(sapply(seq_along(historie), function(i)
                       sum(bass_n(1:36, oceny[i, "p"], oceny[i, "q"], oceny[i, "m"])))),
                     MAE_kolejne_miesiace = round(sapply(seq_along(historie), function(i) {
                       h <- historie[i]; przysz <- (h + 1):36
                       mean(abs(dane$sprzedaz[przysz] - bass_n(przysz, oceny[i, "p"], oceny[i, "q"], oceny[i, "m"]))) })))
tabela
c(prawdziwa_sprzedaz_36 = sum(dane$sprzedaz))

prognozy <- do.call(rbind, lapply(seq_along(historie), function(i) data.frame(
  miesiac = 1:36, n = bass_n(1:36, oceny[i, "p"], oceny[i, "q"], oceny[i, "m"]),
  historia = sprintf("prognoza po %d mies.", historie[i]))))
prognozy$historia <- factor(prognozy$historia, sprintf("prognoza po %d mies.", historie))
p3 <- ggplot() +
  geom_vline(xintercept = historie + 0.5, colour = "grey70", linetype = "dotted") +
  annotate("text", x = historie + 0.7, y = 4800, label = sprintf("%d mies.", historie), hjust = 0, size = 3.6,
           colour = "grey35") +
  geom_point(data = dane, aes(miesiac, sprzedaz), colour = "grey40", size = 1.8, shape = 1) +
  geom_line(data = prognozy, aes(miesiac, n, colour = historia, linetype = historia), linewidth = 1) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]], kol[["ciemny"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotdash"), name = NULL) +
  scale_y_continuous(labels = scales::label_number(big.mark = " ")) +
  coord_cartesian(ylim = c(0, 4900)) +
  labs(x = "Miesiąc od wprowadzenia", y = "Sprzedaż w miesiącu (szt.)",
       title = "Ta sama metoda, różna długość historii",
       subtitle = "Kółka – rzeczywista sprzedaż (36 mies.); linie – model dopasowany do pierwszych 6, 12 lub 24 mies.") + motyw
p3   # zapis: ggsave("model-bassa-prognozy-krotka-historia.svg", p3, width = 10, height = 6.6)
Wynik w R
  miesiecy_danych      p     q     m szczyt_miesiac prognoza_lacznie_36
1               6 0.0232 0.324  7123            7.6                7123
2              12 0.0046 0.280 32690           14.4               32619
3              24 0.0030 0.265 49407           16.8               49119
  MAE_kolejne_miesiace
1                 1422
2                  717
3                   80
prawdziwa_sprzedaz_36
                49773
5. Bootstrap reszt i profil dla potencjału m: Rysunek 4
R
# Rysunek 4. Jak niepewny jest potencjał rynku m przy krótkiej historii: bootstrap reszt i profil
# (korzysta z kol, motyw, bass_n, szczyt, dopasuj i dane z przepisu 1)
library(ggplot2)
library(patchwork)

M_MAX <- 2e6                                     # górna granica m w optymalizacji (40 razy więcej niż prawda)
profil_m <- function(y, ocena, poziom = 0.95) {  # przedział z profilu: m ustalone, p i q dopasowane od nowa
  t <- seq_along(y); h <- length(y)
  sse_m <- function(m) {
    f <- function(th) sum((y - bass_n(t, exp(th[1]), exp(th[2]), m))^2)
    min(optim(log(ocena[c("p", "q")]), f)$value, optim(log(c(0.01, 0.3)), f)$value)
  }
  # to samo kryterium co confint() dla nls: przyrost SSE względem s² porównany z kwadratem wartości t
  kryt <- function(m) (sse_m(m) - ocena[["sse"]]) / (ocena[["sse"]] / (h - 3)) - qt(1 - (1 - poziom) / 2, h - 3)^2
  dol <- if (kryt(sum(y)) < 0) sum(y) else uniroot(kryt, c(sum(y), ocena[["m"]]), tol = 1)$root
  otwarta <- kryt(M_MAX) < 0
  gor <- if (otwarta) M_MAX else uniroot(kryt, c(ocena[["m"]], M_MAX), tol = 1)$root
  c(dolna = dol, gorna = gor, otwarta = otwarta)
}

set.seed(630)                                    # bootstrap reszt: ziarno ustalone raz
historie <- seq(6, 36, by = 3); B <- 200
wyniki <- do.call(rbind, lapply(historie, function(h) {
  y <- dane$sprzedaz[1:h]
  ocena <- dopasuj(y)
  dopas <- bass_n(1:h, ocena[["p"]], ocena[["q"]], ocena[["m"]])
  reszty <- y - dopas
  boot <- t(replicate(B, {
    y_b <- pmax(round(dopas + sample(reszty - mean(reszty), h, replace = TRUE)), 0)
    dopasuj(y_b, starty = rbind(ocena[c("p", "q", "m")], c(0.01, 0.3, 2 * sum(y_b)), c(0.002, 0.5, 6 * sum(y_b))),
            m_max = M_MAX)
  }))
  pr <- profil_m(y, ocena)
  data.frame(h, m = ocena[["m"]], boot_dolna = quantile(boot[, "m"], 0.025), boot_gorna = quantile(boot[, "m"], 0.975),
             boot_na_granicy_proc = 100 * mean(boot[, "m"] > 0.95 * M_MAX),
             prof_dolna = pr[["dolna"]], prof_gorna = pr[["gorna"]], prof_otwarta = pr[["otwarta"]] == 1,
             szczyt = szczyt(ocena[["p"]], ocena[["q"]]),
             szczyt_dolna = quantile(szczyt(boot[, "p"], boot[, "q"]), 0.025),
             szczyt_gorna = quantile(szczyt(boot[, "p"], boot[, "q"]), 0.975), row.names = NULL)
}))
format(transform(wyniki, m = round(m), boot_dolna = round(boot_dolna), boot_gorna = round(boot_gorna),
                 prof_dolna = round(prof_dolna), prof_gorna = round(prof_gorna), szczyt = round(szczyt, 1),
                 szczyt_dolna = round(szczyt_dolna, 1), szczyt_gorna = round(szczyt_gorna, 1)), big.mark = " ")

dl <- rbind(data.frame(h = wyniki$h - 0.5, sr = wyniki$m, dol = wyniki$boot_dolna, gor = wyniki$boot_gorna,
                       metoda = "bootstrap reszt (95%)"),
            data.frame(h = wyniki$h + 0.5, sr = wyniki$m, dol = wyniki$prof_dolna, gor = wyniki$prof_gorna,
                       metoda = "profil (95%)"))
pa <- ggplot(dl, aes(h, sr, ymin = dol, ymax = gor, colour = metoda, shape = metoda)) +
  geom_hline(yintercept = 50000, linetype = "dashed", colour = "grey30") +
  geom_hline(yintercept = M_MAX, colour = "grey75") +
  geom_linerange(linewidth = 0.9) + geom_point(size = 2.4, fill = "white") +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(16, 21), name = NULL) +
  scale_y_log10(breaks = c(2000, 5000, 20000, 50000, 2e5, 5e5, 2e6), labels = c("2 tys.", "5 tys.", "20 tys.", "50 tys.", "200 tys.", "500 tys.", "2 mln (granica)")) +
  scale_x_continuous(breaks = historie) +
  labs(x = "Ile miesięcy sprzedaży mamy", y = "Potencjał rynku m (skala log.)",
       title = "A. Oszacowanie potencjału m i jego przedział",
       subtitle = "Linia przerywana – prawdziwe m = 50 000 (znane, bo dane są fikcyjne)") + motyw
pb <- ggplot(wyniki, aes(h, szczyt, ymin = szczyt_dolna, ymax = szczyt_gorna)) +
  geom_hline(yintercept = szczyt(0.004, 0.25), linetype = "dashed", colour = "grey30") +
  geom_abline(slope = 1, intercept = 0, colour = "grey75") +
  geom_linerange(colour = kol[["cynober"]], linewidth = 0.9) + geom_point(colour = kol[["cynober"]], size = 2.4) +
  scale_x_continuous(breaks = historie) +
  labs(x = "Ile miesięcy sprzedaży mamy", y = "Miesiąc szczytu",
       title = "B. Kiedy będzie szczyt sprzedaży (bootstrap, 95%)",
       subtitle = "Przerywana – prawdziwy szczyt (16.3 mies.); szara ukośna – szczyt w ostatnim miesiącu danych") + motyw
p4 <- pa / pb + plot_layout(heights = c(1.3, 1))
p4   # zapis: ggsave("model-bassa-niepewnosc-potencjalu.svg", p4, width = 10, height = 8.4)
Wynik w R
    h      m boot_dolna boot_gorna boot_na_granicy_proc prof_dolna prof_gorna
1   6  7 123      5 671     10 532                  0.0      4 633  2 000 000
2   9 67 478     27 127  2 000 000                 19.5     19 200  2 000 000
3  12 32 690     22 939     81 016                  0.5     20 114  2 000 000
4  15 44 473     31 935  2 000 000                  3.0     27 998  2 000 000
5  18 54 819     41 281    131 053                  0.5     38 322    182 407
6  21 47 827     42 810     57 076                  0.0     40 909     57 595
7  24 49 407     45 457     54 447                  0.0     44 155     55 341
8  27 49 580     46 290     54 761                  0.0     46 654     54 266
9  30 49 936     46 483     54 022                  0.0     48 644     54 136
10 33 49 911     47 104     53 946                  0.0     49 421     53 793
11 36 49 903     47 138     53 668                  0.0     49 773     53 565
   prof_otwarta szczyt szczyt_dolna szczyt_gorna
1          TRUE    7.6          6.6          9.5
2          TRUE   19.0         14.0         36.7
3          TRUE   14.4         12.4         20.2
4          TRUE   16.1         13.8         40.7
5         FALSE   17.5         15.6         25.5
6         FALSE   16.5         15.7         18.0
7         FALSE   16.8         16.2         17.6
8         FALSE   16.8         16.2         17.3
9         FALSE   16.8         16.3         17.3
10        FALSE   16.8         16.3         17.3
11        FALSE   16.8         16.4         17.2
6. Analogia i analiza wrażliwości: Rysunek 5
R
# Rysunek 5. Analogia: p i q z podobnego produktu, z danych szacujemy tylko potencjał m
# (korzysta z kol, motyw, bass_n, bass_F, szczyt, dopasuj i dane z przepisu 1)
library(ggplot2)
library(patchwork)

analog <- c(p = .005, q = .22)     # ustalone ręcznie: oczyszczacz powietrza tej samej firmy sprzed kilku lat
m_z_analogii <- function(h, p, q) {  # przy znanych p i q sprzedaż = m × przyrost F(t): regresja przez zero
  x <- bass_F(1:h, p, q) - bass_F(0:(h - 1), p, q)
  model <- lm(dane$sprzedaz[1:h] ~ 0 + x)
  c(m = coef(model)[[1]], confint(model)[1, ])
}
porownanie <- do.call(rbind, lapply(c(6, 12), function(h) {
  a <- m_z_analogii(h, analog[["p"]], analog[["q"]])
  data.frame(miesiecy = h, m_swobodny = round(dopasuj(dane$sprzedaz[1:h])[["m"]]),
             m_analogia = round(a[["m"]]), dolna_95 = round(a[[2]]), gorna_95 = round(a[[3]]))
}))
porownanie
c(szczyt_z_analogii = round(szczyt(analog[["p"]], analog[["q"]]), 1))

# Wrażliwość: co jeśli analogia jest chybiona? Inne q przy tych samych 6 miesiącach
wrazliwosc <- expand.grid(q = c(0.15, 0.22, 0.30), p = c(0.003, 0.005))
wrazliwosc$m_po_6 <- round(mapply(function(p, q) m_z_analogii(6, p, q)[["m"]], wrazliwosc$p, wrazliwosc$q))
wrazliwosc$szczyt <- round(szczyt(wrazliwosc$p, wrazliwosc$q), 1)
wrazliwosc

# Prognozy z 6 miesięcy: model swobodny vs analogia
sw6 <- dopasuj(dane$sprzedaz[1:6]); an6 <- m_z_analogii(6, analog[["p"]], analog[["q"]])
krzywe <- rbind(data.frame(miesiac = 1:36, n = bass_n(1:36, sw6[["p"]], sw6[["q"]], sw6[["m"]]), wersja = "swobodne p, q, m"),
                data.frame(miesiac = 1:36, n = bass_n(1:36, analog[["p"]], analog[["q"]], an6[["m"]]),
                           wersja = "p, q z analogii, m z danych"))
pa <- ggplot() +
  geom_vline(xintercept = 6.5, colour = "grey70", linetype = "dotted") +
  geom_point(data = dane, aes(miesiac, sprzedaz), colour = "grey40", size = 1.8, shape = 1) +
  geom_line(data = krzywe, aes(miesiac, n, colour = wersja, linetype = wersja), linewidth = 1) +
  scale_colour_manual(values = c("swobodne p, q, m" = kol[["cynober"]], "p, q z analogii, m z danych" = kol[["niebieski"]]),
                      name = NULL) +
  scale_linetype_manual(values = c("swobodne p, q, m" = "solid", "p, q z analogii, m z danych" = "longdash"), name = NULL) +
  scale_y_continuous(labels = scales::label_number(big.mark = " ")) +
  labs(x = "Miesiąc od wprowadzenia", y = "Sprzedaż w miesiącu (szt.)",
       title = "A. Prognoza po 6 miesiącach: dwie wersje modelu") + motyw
pb <- ggplot(wrazliwosc, aes(sprintf("%.2f", q), m_po_6, fill = factor(p))) +
  geom_hline(yintercept = 50000, linetype = "dashed", colour = "grey30") +
  geom_col(position = position_dodge(0.8), width = 0.7) +
  geom_text(aes(label = format(m_po_6, big.mark = " ")), position = position_dodge(0.8), vjust = -0.4, size = 3.6) +
  scale_fill_manual(values = c("0.003" = kol[["pomarancz"]], "0.005" = kol[["niebieski"]]), name = "p z analogii:") +
  scale_y_continuous(labels = scales::label_number(big.mark = " "), expand = expansion(mult = c(0, 0.12))) +
  labs(x = "q z analogii", y = "m oszacowane po 6 mies.",
       title = "B. Wrażliwość: wynik zależy od przyjętych p i q",
       subtitle = "Przyjęta analogia: p = .005, q = .22; linia przerywana – prawdziwe m = 50 000") + motyw
p5 <- pa / pb
p5   # zapis: ggsave("model-bassa-analogia.svg", p5, width = 10, height = 8)
Wynik w R
  miesiecy m_swobodny m_analogia dolna_95 gorna_95
1        6       7123      38330    36544    40117
2       12      32690      46527    43263    49791
szczyt_z_analogii
             16.8
     q     p m_po_6 szczyt
1 0.15 0.003  81645   25.6
2 0.22 0.003  62589   19.3
3 0.30 0.003  44715   15.2
4 0.15 0.005  49643   21.9
5 0.22 0.005  38330   16.8
6 0.30 0.005  27704   13.4
7. Pułapka: obniżka ceny w 10. miesiącu: Rysunek 6
R
# Rysunek 6. Pułapka: obniżka ceny w 10. miesiącu, a model Bassa bez ceny
# (korzysta z kol, motyw, bass_n, szczyt, dopasuj i prawda z przepisu 1)
library(ggplot2)

# Ten sam produkt i ten sam potencjał, ale od 10. miesiąca cena niższa o 20%:
# szansa zakupu wśród niekupujących rośnie 1.4 raza (mnożnik ustalony ręcznie)
set.seed(630)
mnoznik <- ifelse(1:36 >= 10, 1.4, 1)
sprzedaz_c <- numeric(36); kupili <- 0
for (t in 1:36) {
  szansa <- (prawda[["p"]] + prawda[["q"]] * kupili / prawda[["m"]]) * mnoznik[t] * exp(rnorm(1, 0, 0.12))
  sprzedaz_c[t] <- rbinom(1, prawda[["m"]] - kupili, min(szansa, 1))
  kupili <- kupili + sprzedaz_c[t]
}
cena <- data.frame(miesiac = 1:36, sprzedaz = sprzedaz_c)
c(najwyzsza = max(sprzedaz_c), miesiac_najwyzszej = which.max(sprzedaz_c), lacznie_36 = sum(sprzedaz_c))

przed <- dopasuj(sprzedaz_c[1:9])     # tylko miesiące przed obniżką
po14 <- dopasuj(sprzedaz_c[1:14])     # 9 miesięcy przed i 5 po obniżce w jednym modelu
signif(rbind(przed_obnizka_9 = c(przed[1:3], szczyt = szczyt(przed[["p"]], przed[["q"]])),
             z_obnizka_14 = c(po14[1:3], szczyt = szczyt(po14[["p"]], po14[["q"]]))), 3)

linie <- rbind(data.frame(miesiac = 1:36, n = bass_n(1:36, przed[["p"]], przed[["q"]], przed[["m"]]),
                          wersja = "model z 9 mies. przed obniżką"),
               data.frame(miesiac = 1:36, n = bass_n(1:36, po14[["p"]], po14[["q"]], po14[["m"]]),
                          wersja = "model z 14 mies. (przed i po obniżce)"))
p6 <- ggplot() +
  annotate("rect", xmin = 9.5, xmax = 36.5, ymin = -Inf, ymax = Inf, fill = kol[["pomarancz"]], alpha = 0.08) +
  annotate("text", x = 21, y = 6000, label = "od 10. miesiąca cena niższa o 20%", hjust = 0, size = 3.8, colour = "grey25") +
  geom_point(data = cena, aes(miesiac, sprzedaz), colour = "grey40", size = 1.8, shape = 1) +
  geom_line(data = linie, aes(miesiac, n, colour = wersja, linetype = wersja), linewidth = 1) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  scale_y_continuous(labels = scales::label_number(big.mark = " ")) +
  coord_cartesian(ylim = c(0, 6300)) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "Miesiąc od wprowadzenia", y = "Sprzedaż w miesiącu (szt.)",
       title = "Obniżka ceny przyspiesza zakupy – model bez ceny tego nie wie",
       subtitle = "Kółka – sprzedaż przy obniżce w 10. miesiącu (dane fikcyjne, prawdziwe m = 50 000)") + motyw
p6   # zapis: ggsave("model-bassa-zmiana-ceny.svg", p6, width = 10, height = 6.4)
Wynik w R
         najwyzsza miesiac_najwyzszej         lacznie_36
              6095                 17              49989
                       p     q       m szczyt
przed_obnizka_9 2.69e-03 0.232   67500   19.0
z_obnizka_14    7.28e-05 0.267 2000000   30.8
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (innowatorzy / naśladowcy; bootstrap / profil)" = c("#D55E00", "#0072B2"),
             "pomarańczowy – niebieski (p = .003 / p = .005)" = c("#E69F00", "#0072B2"),
             "niebieski – ciemnoszary (prognoza po 12 / po 24 mies.)" = c("#0072B2", "#333333"),
             "cynober – ciemnoszary (prognoza po 6 / po 24 mies.)" = c("#D55E00", "#333333"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                   widzenie_typowe
cynober – niebieski (innowatorzy / naśladowcy; bootstrap / profil)           114.6
pomarańczowy – niebieski (p = .003 / p = .005)                               120.2
niebieski – ciemnoszary (prognoza po 12 / po 24 mies.)                        48.3
cynober – ciemnoszary (prognoza po 6 / po 24 mies.)                           83.4
czerwony – zielony (do unikania)                                             121.7
                                                                   deuteranopia
cynober – niebieski (innowatorzy / naśladowcy; bootstrap / profil)        108.3
pomarańczowy – niebieski (p = .003 / p = .005)                            121.5
niebieski – ciemnoszary (prognoza po 12 / po 24 mies.)                     50.3
cynober – ciemnoszary (prognoza po 6 / po 24 mies.)                        72.7
czerwony – zielony (do unikania)                                           21.1
                                                                   protanopia
cynober – niebieski (innowatorzy / naśladowcy; bootstrap / profil)       91.9
pomarańczowy – niebieski (p = .003 / p = .005)                          109.3
niebieski – ciemnoszary (prognoza po 12 / po 24 mies.)                   47.4
cynober – ciemnoszary (prognoza po 6 / po 24 mies.)                      59.9
czerwony – zielony (do unikania)                                         31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, nls(), optim(), lm(), confint() i uniroot() – pakiety base i stats). Rysunki wykonano w ggplot2 (opisy osi liczbowych – pakiet scales), panele złożono pakietem patchwork, pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Prognoza sprzed szczytu jako pewnik. Po 6 miesiącach model przewidział 7123 sztuki zamiast 50 000 i szczyt o ok. 9 miesięcy za wcześnie (rysunek 3).
- Wąski przedział z kilku punktów. Bootstrap z 6 reszt dał przedział, który nie obejmował prawdy. Gdy profil jest otwarty, napisz wprost, że górnej granicy nie da się wyznaczyć.
- Granica optymalizacji jako wynik. m = 2 mln w przykładzie to granica przeszukiwania, a nie oszacowanie. Sprawdzaj, czy parametr nie „przykleił się” do granicy.
- Zmiana ceny lub kampanii bez śladu w modelu (rysunek 6).
- Dopasowanie po fakcie jako dowód trafności. R² = .933 na pełnych danych nic nie mówi o prognozie z 6 miesięcy. Oceniaj prognozy na miesiącach, których model nie widział.
Pomoc przy prognozie dla nowego produktu w pracy dyplomowej: analizy statystyczne dla studentów.
Najczęstsze pytania
Co oznaczają parametry p, q i m w modelu Bassa?
m to potencjał rynku – ile osób kupi produkt kiedykolwiek. p (współczynnik innowacji) to szansa, że osoba bez produktu kupi go w danym okresie bez wpływu innych nabywców, a q (współczynnik naśladownictwa) mówi, jak ta szansa rośnie wraz z udziałem osób, które już kupiły. W przykładzie oszacowano p równe 0.0031 i q równe 0.260 na miesiąc oraz m = 49 903 sztuk.
Ile danych potrzeba, żeby oszacować model Bassa?
Najlepiej danych, które obejmują szczyt sprzedaży. W przykładzie po 6 i 12 miesiącach potencjał rynku był mocno zaniżony (7123 i 32 690 wobec 50 000), a przedział z profilu nie miał górnej granicy. Oszacowanie ustabilizowało się dopiero po 21 miesiącach, kilka miesięcy po szczycie.
Jak oszacować model Bassa w R?
Najprościej nieliniową metodą najmniejszych kwadratów: funkcja nls() z wzorem na sprzedaż w okresie jako m razy przyrost F(t). Punkty startowe dobierz np. funkcją optim() z kilku startów, a przedziały policz z profilu (confint()) lub bootstrapem reszt. Pełny kod jest na tej stronie.
Jak prognozować sprzedaż nowego produktu bez historii sprzedaży?
Przyjmij p i q z podobnego produktu (analogii), a z pierwszych miesięcy szacuj tylko potencjał m. W przykładzie po 6 miesiącach dało to m = 38 330 zamiast 7123 z modelu swobodnego. Zawsze dodaj analizę wrażliwości: przy innych rozsądnych p i q wynik wahał się od 27 704 do 81 645 sztuk.
Czy model Bassa uwzględnia cenę i reklamę?
Podstawowy model nie. Gdy cena lub intensywność kampanii zmienia się w czasie, użyj uogólnionego modelu Bassa ze zmiennymi decyzyjnymi albo dopasuj model ponownie od momentu zmiany. W przykładzie po obniżce ceny model bez ceny dopasowany do 14 miesięcy nie wyznaczył potencjału (oszacowanie na granicy 2 mln sztuk).
Powiązane hasła
Przeczytaj też
Prognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →PoradnikAnaliza kohortowa retencji klientów
Sklep z karmą, 30 kohort i 18 tys. transakcji: tabela kohortowa, mapa ciepła, krzywe z przedziałami i pułapki oceny programu lojalnościowego – pięć rysunków z kodem R.
Czytaj →PoradnikElastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →Prognozujesz sprzedaż nowego produktu w pracy?
Pomożemy dopasować model Bassa, policzyć przedziały dla potencjału rynku, dobrać analogię i uczciwie opisać niepewność prognozy – tak, żebyś umiał(a) ją obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bass, F. M. (1969). A new product growth model for consumer durables. Management Science, 15(5), 215–227. https://doi.org/10.1287/mnsc.15.5.215
- Bass, F. M., Krishnan, T. V., & Jain, D. C. (1994). Why the Bass model fits without decision variables. Marketing Science, 13(3), 203–223. https://doi.org/10.1287/mksc.13.3.203
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Heeler, R. M., & Hustad, T. P. (1980). Problems in predicting new product growth for consumer durables. Management Science, 26(10), 1007–1020. https://doi.org/10.1287/mnsc.26.10.1007
- Mahajan, V., Muller, E., & Bass, F. M. (1990). New product diffusion models in marketing: A review and directions for research. Journal of Marketing, 54(1), 1–26. https://doi.org/10.1177/002224299005400101
- Srinivasan, V., & Mason, C. H. (1986). Technical note—Nonlinear least squares estimation of new product diffusion models. Marketing Science, 5(2), 169–178. https://doi.org/10.1287/mksc.5.2.169 ● Otwarty dostęp
- Van den Bulte, C., & Lilien, G. L. (1997). Bias and systematic change in the parameter estimates of macro-level diffusion models. Marketing Science, 16(4), 338–353. https://doi.org/10.1287/mksc.16.4.338
Cytowania BibTeX
@article{bass1969new, author={Bass, Frank M.}, title={{A new product growth model for consumer durables}}, journal={Management Science}, year={1969}, volume={15}, number={5}, pages={215--227}, doi={10.1287/mnsc.15.5.215}}@article{bass1994why, author={Bass, Frank M. and Krishnan, Trichy V. and Jain, Dipak C.}, title={{Why the Bass model fits without decision variables}}, journal={Marketing Science}, year={1994}, volume={13}, number={3}, pages={203--223}, doi={10.1287/mksc.13.3.203}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{heeler1980problems, author={Heeler, Roger M. and Hustad, Thomas P.}, title={{Problems in predicting new product growth for consumer durables}}, journal={Management Science}, year={1980}, volume={26}, number={10}, pages={1007--1020}, doi={10.1287/mnsc.26.10.1007}}@article{mahajan1990new, author={Mahajan, Vijay and Muller, Eitan and Bass, Frank M.}, title={{New product diffusion models in marketing: A review and directions for research}}, journal={Journal of Marketing}, year={1990}, volume={54}, number={1}, pages={1--26}, doi={10.1177/002224299005400101}}@article{srinivasan1986nonlinear, author={Srinivasan, V. and Mason, Charlotte H.}, title={{Technical note—Nonlinear least squares estimation of new product diffusion models}}, journal={Marketing Science}, year={1986}, volume={5}, number={2}, pages={169--178}, doi={10.1287/mksc.5.2.169}}@article{vandenbulte1997bias, author={Van den Bulte, Christophe and Lilien, Gary L.}, title={{Bias and systematic change in the parameter estimates of macro-level diffusion models}}, journal={Marketing Science}, year={1997}, volume={16}, number={4}, pages={338--353}, doi={10.1287/mksc.16.4.338}}