Co to jest wykres tornado?
Wykres tornado (ang. tornado diagram) pokazuje wynik jednokierunkowej analizy wrażliwości: jak zmienia się wynik modelu, gdy jedno założenie przesuwamy od dolnej do górnej granicy jego wiarygodnego zakresu, a pozostałe zostawiamy na wartościach bazowych. Każde założenie to jeden poziomy słupek wokół pionowej linii wyniku bazowego. Słupki układa się od najszerszego u góry do najwęższego u dołu, stąd kształt lejka. Eschenbach (1992) opisuje wykres tornado jako prosty sposób podsumowania wpływu wielu zmiennych naraz. Wykres jest standardem w modelach decyzyjnych i ekonomicznych w ochronie zdrowia, ale nadaje się też do planowania badania.
Jak czytać wykres
- Długość słupka to zakres wyniku przy zmianie jednego założenia. Najdłuższe słupki wskazują założenia, które trzeba najstaranniej uzasadnić.
- Strona słupka mówi o kierunku: czy niższa wartość parametru podnosi, czy obniża wynik.
- Asymetria słupka zdradza nieliniowość – ta sama zmiana parametru w górę i w dół daje różne przesunięcie wyniku.
Przykład
Planujesz badanie z dwiema grupami i testem t. Założenia bazowe: różnica średnich 5 pkt, SD = 10 pkt, α = .05, moc .80 i 15% rezygnacji. Daje to łącznie N = 152 osoby. Wiarygodne zakresy przyjęto ręcznie do ilustracji: różnica 4–6 pkt, SD 8–12, α od .01 do .10, moc .70–.90, rezygnacje 5–25%. Obliczenia są deterministyczne, bez losowania. Samo wyznaczanie liczebności omawia wpis Dobór liczebności próby.
Na rysunku
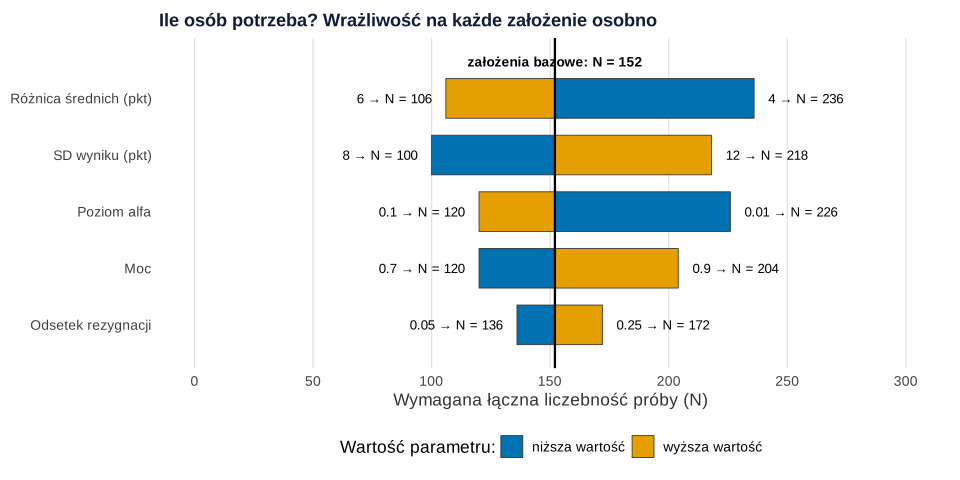
power.t.test i pakiet ggplot2 (bez danych, wartości wyliczone).Co widać. Najwięcej zależy od różnicy średnich: przy 4 pkt potrzeba 236 osób, przy 6 pkt – 106. Niewiele mniej waży SD (100–218) i poziom alfa (120–226). Odsetek rezygnacji zmienia N najmniej, od 136 do 172. Słupek różnicy średnich jest asymetryczny – spadek o 1 pkt dodaje 84 osoby, wzrost o 1 pkt zabiera 46 – bo liczebność rośnie z odwrotnością kwadratu efektu.
Na co uważać. Kolejność słupków zależy od przyjętych zakresów, a nie tylko od modelu. Przy węższym zakresie α jej słupek byłby krótszy, a kolejność inna. Wykres zmienia też jedno założenie naraz: przy różnicy 4 pkt i SD = 12 jednocześnie potrzeba 338 osób, czego na żadnym słupku nie widać.
Podpis do pracy:
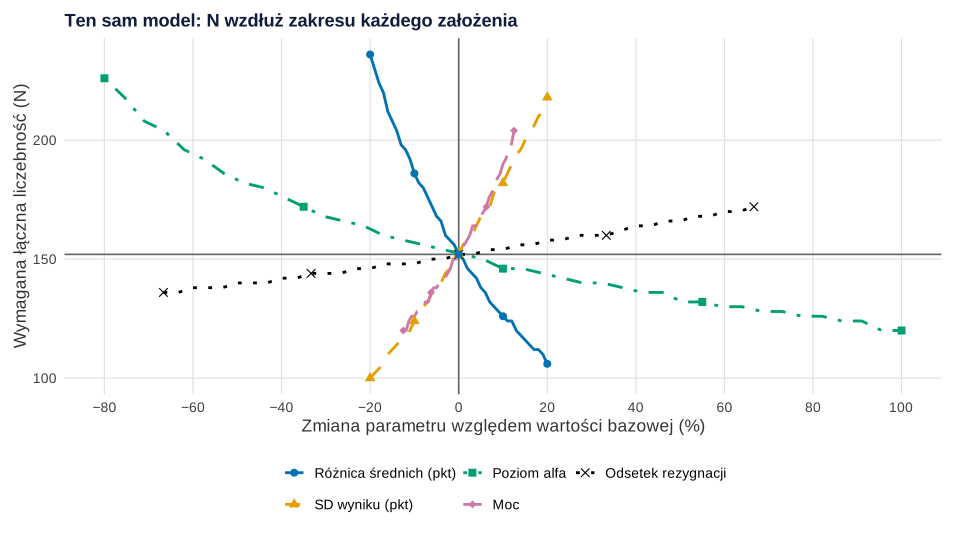
power.t.test i pakiet ggplot2.Co widać. Wykres pajęczy pokazuje to, co wykres tornado spłaszcza do dwóch końców: kształt zależności i szerokość przyjętego zakresu. Linie różnicy średnich i SD są strome, choć obejmują tylko ±20%. Linia alfa jest łagodna, a długi słupek w tornado zawdzięcza szerokiemu zakresowi (od −80% do +100%). Eschenbach (1992) zaleca używać obu wykresów, bo ich zalety się uzupełniają.
Na co uważać. Schodki na liniach wynikają z zaokrąglania liczebności w górę. Oba wykresy dotyczą jednego założenia naraz; łączną niepewność ocenia probabilistyczna analiza wrażliwości (Briggs i in., 2012).
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Uzasadnij zakresy. Zakres powinien wynikać z literatury, badania pilotażowego albo minimalnego efektu, który ma znaczenie; Lakens (2022) omawia, jakie wielkości efektu rozważyć przy uzasadnianiu liczebności.
- Nie myl z analizą wrażliwości mocy. Wykres tornado sprawdza, jak wynik analizy mocy a priori (wymagane N) zależy od założeń. Analiza wrażliwości mocy odpowiada na inne pytanie: jaki najmniejszy efekt wykryjesz przy danym N.
- Uwzględnij utratę uczestników jako osobne założenie, a nie dopisek po obliczeniach.
Wykres tornado w R
Kod liczy wymaganą liczebność funkcją power.t.test z poprawką na rezygnacje, zmienia każde założenie w jego zakresie, rysuje wykres tornado (p1) i wykres pajęczy (p2). Kod sam definiuje paletę Okabe–Ito i motyw. Rysunki na stronie powstały z tych samych obiektów z motywem serwisu – dane, geometrie i skale są identyczne, różni się krój czcionki i siatka.
Jednokierunkowa analiza wrażliwości liczebności próby
R
# Wykres tornado: jednokierunkowa analiza wrażliwości wymaganej liczebności próby (test t, dwie grupy)
library(ggplot2)
kol <- c("niższa wartość" = "#0072B2", "wyższa wartość" = "#E69F00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))

# Wymagana łączna liczebność: n na grupę z power.t.test, powiększone o odsetek rezygnacji
N_calk <- function(roznica, sd, alfa, moc, odpad) {
  n_gr <- ceiling(power.t.test(delta = roznica, sd = sd, sig.level = alfa, power = moc)$n)
  2 * ceiling(n_gr / (1 - odpad))
}
baza <- list(roznica = 5, sd = 10, alfa = 0.05, moc = 0.80, odpad = 0.15)   # założenia bazowe
zakres <- data.frame(                                                   # wiarygodny zakres każdego założenia
  par   = c("roznica", "sd", "alfa", "moc", "odpad"),
  nazwa = c("Różnica średnich (pkt)", "SD wyniku (pkt)", "Poziom alfa", "Moc", "Odsetek rezygnacji"),
  min   = c(4, 8, 0.01, 0.70, 0.05),
  max   = c(6, 12, 0.10, 0.90, 0.25))
N_baza <- do.call(N_calk, baza)
N_przy <- function(par, wart) { b <- baza; b[[par]] <- wart; do.call(N_calk, b) }
zakres$N_min <- mapply(N_przy, zakres$par, zakres$min)   # N przy dolnej granicy parametru
zakres$N_max <- mapply(N_przy, zakres$par, zakres$max)   # N przy górnej granicy parametru
zakres$rozpietosc <- abs(zakres$N_max - zakres$N_min)
zakres <- zakres[order(zakres$rozpietosc), ]               # najszerszy słupek na górze
N_baza
zakres[, c("nazwa", "min", "max", "N_min", "N_max", "rozpietosc")]
N_pesym <- N_przy("roznica", 4); b <- baza; b$roznica <- 4; b$sd <- 12; N_obie <- do.call(N_calk, b)
c(tylko_roznica_4 = N_pesym, roznica_4_i_sd_12 = N_obie)  # dwa założenia naraz – poza wykresem tornado

# Rysunek 1: wykres tornado
fmt <- function(x) formatC(x, format = "fg", digits = 2)
dl <- rbind(data.frame(nazwa = zakres$nazwa, N = zakres$N_min, wart = fmt(zakres$min), strona = "niższa wartość"),
            data.frame(nazwa = zakres$nazwa, N = zakres$N_max, wart = fmt(zakres$max), strona = "wyższa wartość"))
dl$nazwa <- factor(dl$nazwa, levels = zakres$nazwa)
dl$y <- as.numeric(dl$nazwa)
dl$wyr <- ifelse(dl$N >= N_baza, 0, 1)                     # etykieta po zewnętrznej stronie słupka
dl$x_et <- dl$N + ifelse(dl$wyr == 0, 6, -6)
p1 <- ggplot(dl) +
  geom_rect(aes(xmin = pmin(N, N_baza), xmax = pmax(N, N_baza), ymin = y - 0.35, ymax = y + 0.35, fill = strona),
            colour = "grey20", linewidth = 0.3) +
  geom_vline(xintercept = N_baza, linewidth = 0.8) +
  geom_text(aes(x = x_et, y = y, label = paste0(wart, " → N = ", N), hjust = wyr), size = 3.5) +
  annotate("text", x = N_baza, y = 5.65, label = paste0("założenia bazowe: N = ", N_baza), size = 3.6, fontface = "bold") +
  scale_y_continuous(breaks = 1:5, labels = levels(dl$nazwa), limits = c(0.5, 5.8)) +
  scale_x_continuous(limits = c(0, 300), breaks = seq(0, 300, 50)) +
  scale_fill_manual(values = kol, name = "Wartość parametru:") +
  labs(title = "Ile osób potrzeba? Wrażliwość na każde założenie osobno",
       x = "Wymagana łączna liczebność próby (N)", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank())

# Rysunek 2: wykres pajęczy – N wzdłuż całego zakresu każdego założenia (zmiana w % od wartości bazowej)
siatka <- do.call(rbind, lapply(seq_len(nrow(zakres)), function(i) {
  w <- seq(zakres$min[i], zakres$max[i], length.out = 41)
  data.frame(nazwa = zakres$nazwa[i], zmiana = 100 * (w / baza[[zakres$par[i]]] - 1),
             N = sapply(w, function(v) N_przy(zakres$par[i], v)))
}))
siatka$nazwa <- factor(siatka$nazwa, levels = rev(zakres$nazwa))
p2 <- ggplot(siatka, aes(zmiana, N, colour = nazwa, linetype = nazwa, shape = nazwa)) +
  geom_hline(yintercept = N_baza, colour = "grey40") +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_line(linewidth = 1) +
  geom_point(data = siatka[ave(siatka$zmiana, siatka$nazwa, FUN = seq_along) %% 10 == 1, ], size = 2.4) +
  scale_colour_manual(values = c("#0072B2", "#E69F00", "#009E73", "#CC79A7", "#000000"), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash", "longdash", "dotted"), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15, 18, 4), name = NULL) +
  scale_x_continuous(breaks = seq(-80, 100, 20), labels = function(x) sub("-", "−", x)) +
  labs(title = "Ten sam model: N wzdłuż zakresu każdego założenia",
       x = "Zmiana parametru względem wartości bazowej (%)", y = "Wymagana łączna liczebność (N)") +
  motyw + guides(colour = guide_legend(nrow = 2))
p1
p2
Wynik w R
[1] 152
                   nazwa  min   max N_min N_max rozpietosc
5     Odsetek rezygnacji 0.05  0.25   136   172         36
4                    Moc 0.70  0.90   120   204         84
3            Poziom alfa 0.01  0.10   226   120        106
2        SD wyniku (pkt) 8.00 12.00   100   218        118
1 Różnica średnich (pkt) 4.00  6.00   236   106        130
  tylko_roznica_4 roznica_4_i_sd_12
              236               338
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja power.t.test z pakietu stats i pakiet ggplot2). Rysunki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak czytać wykres tornado?
Pionowa linia to wynik przy założeniach bazowych, a każdy słupek pokazuje, jak daleko przesuwa się wynik, gdy zmienisz jedno założenie od dolnej do górnej granicy. Im dłuższy słupek, tym bardziej wynik zależy od tego założenia, więc tym staranniej trzeba je uzasadnić.
Czym wykres tornado różni się od wykresu pajęczego?
Wykres tornado pokazuje tylko dwa końce zakresu każdego założenia i sortuje założenia według wpływu. Wykres pajęczy rysuje wynik wzdłuż całego zakresu, więc widać kształt zależności (np. nieliniowość) i to, jak szeroki zakres przyjęto.
Czy wykres tornado uwzględnia zmianę kilku parametrów jednocześnie?
Nie – zmienia jedno założenie naraz, a pozostałe trzyma na wartościach bazowych. Gdy kilka założeń może być jednocześnie niekorzystnych, policz scenariusz pesymistyczny albo przeprowadź probabilistyczną analizę wrażliwości.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikMoc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →PoradnikAnaliza wrażliwości w artykule naukowym
Jak dobrać warianty, policzyć je w R (braki danych, obserwacje odstające, specyfikacje), zbudować krzywą specyfikacji i opisać wyniki w artykule.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Briggs, A. H., Weinstein, M. C., Fenwick, E. A. L., Karnon, J., Sculpher, M. J., & Paltiel, A. D. (2012). Model parameter estimation and uncertainty analysis. Medical Decision Making, 32(5), 722–732. https://doi.org/10.1177/0272989x12458348 ● Otwarty dostęp
- Eschenbach, T. G. (1992). Spiderplots versus tornado diagrams for sensitivity analysis. Interfaces, 22(6), 40–46. https://doi.org/10.1287/inte.22.6.40
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
Cytowania BibTeX
@article{briggs2012model, author={Briggs, Andrew H. and Weinstein, Milton C. and Fenwick, Elisabeth A. L. and Karnon, Jonathan and Sculpher, Mark J. and Paltiel, A. David}, title={{Model parameter estimation and uncertainty analysis}}, journal={Medical Decision Making}, year={2012}, volume={32}, number={5}, pages={722--732}, doi={10.1177/0272989x12458348}}@article{eschenbach1992spiderplots, author={Eschenbach, Ted G.}, title={{Spiderplots versus tornado diagrams for sensitivity analysis}}, journal={Interfaces}, year={1992}, volume={22}, number={6}, pages={40--46}, doi={10.1287/inte.22.6.40}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}